

O TorchNeuron é o backend de PyTorch de código aberto da AWS para os chips Trainium, em beta pública desde 20 de outubro de 2026. Ele registra o Trainium como um dispositivo PyTorch normal chamado neuron, então, para a maior parte do código, a portabilidade realmente é transformar .to('cuda') em .to('neuron'). A biblioteca é gratuita sob Apache 2.0, e você paga pelo tempo de Trainium: US$ 2,235 por hora de chip Trainium2 no EC2 Capacity Blocks, contra US$ 5,970 de uma H100.
A manchete esconde a pegadinha. O modo eager é o caminho fácil e depurável, mas a velocidade de produção vem do torch.compile, que no Neuron exige formas estáticas e falha em qualquer operador que não consiga traduzir. Ele também roda apenas em Trainium2 e Trainium3, então quem usa Trainium1 e Inferentia fica na pilha antiga.
Se você treina ou serve seus próprios modelos na AWS, esta é a semana de rodar um piloto. Se você só quer uma IA que faça um trabalho, como responder tickets, ignore a questão do chip: um colega de IA da eesel cuida da camada de modelos, e a SE Ranking roda um em três produtos, com cerca de 4.650 conversas por mês.
O que é o TorchNeuron?
O TorchNeuron é um backend nativo de PyTorch para o AWS Trainium, a família de chips de IA própria que a Amazon desenvolve desde que comprou a Annapurna Labs em 2015. Foi anunciado no blog do PyTorch em 19 de outubro de 2026 e entrou no ar como beta pública de código aberto na PyTorch Conference North America em 20 de outubro. O código está em aws-neuron/torch-neuronx sob Apache 2.0.
Eu construo integrações e APIs para a eesel, e "funciona com a mudança de uma linha" é a afirmação em que menos confio, principalmente porque eu mesmo já a escrevi em nossas próprias páginas. Então li a documentação, o repositório e o material de lançamento antes de acreditar. A versão curta: a afirmação vale para o modo eager, e o trabalho real de engenharia se desloca para a etapa de compilação.
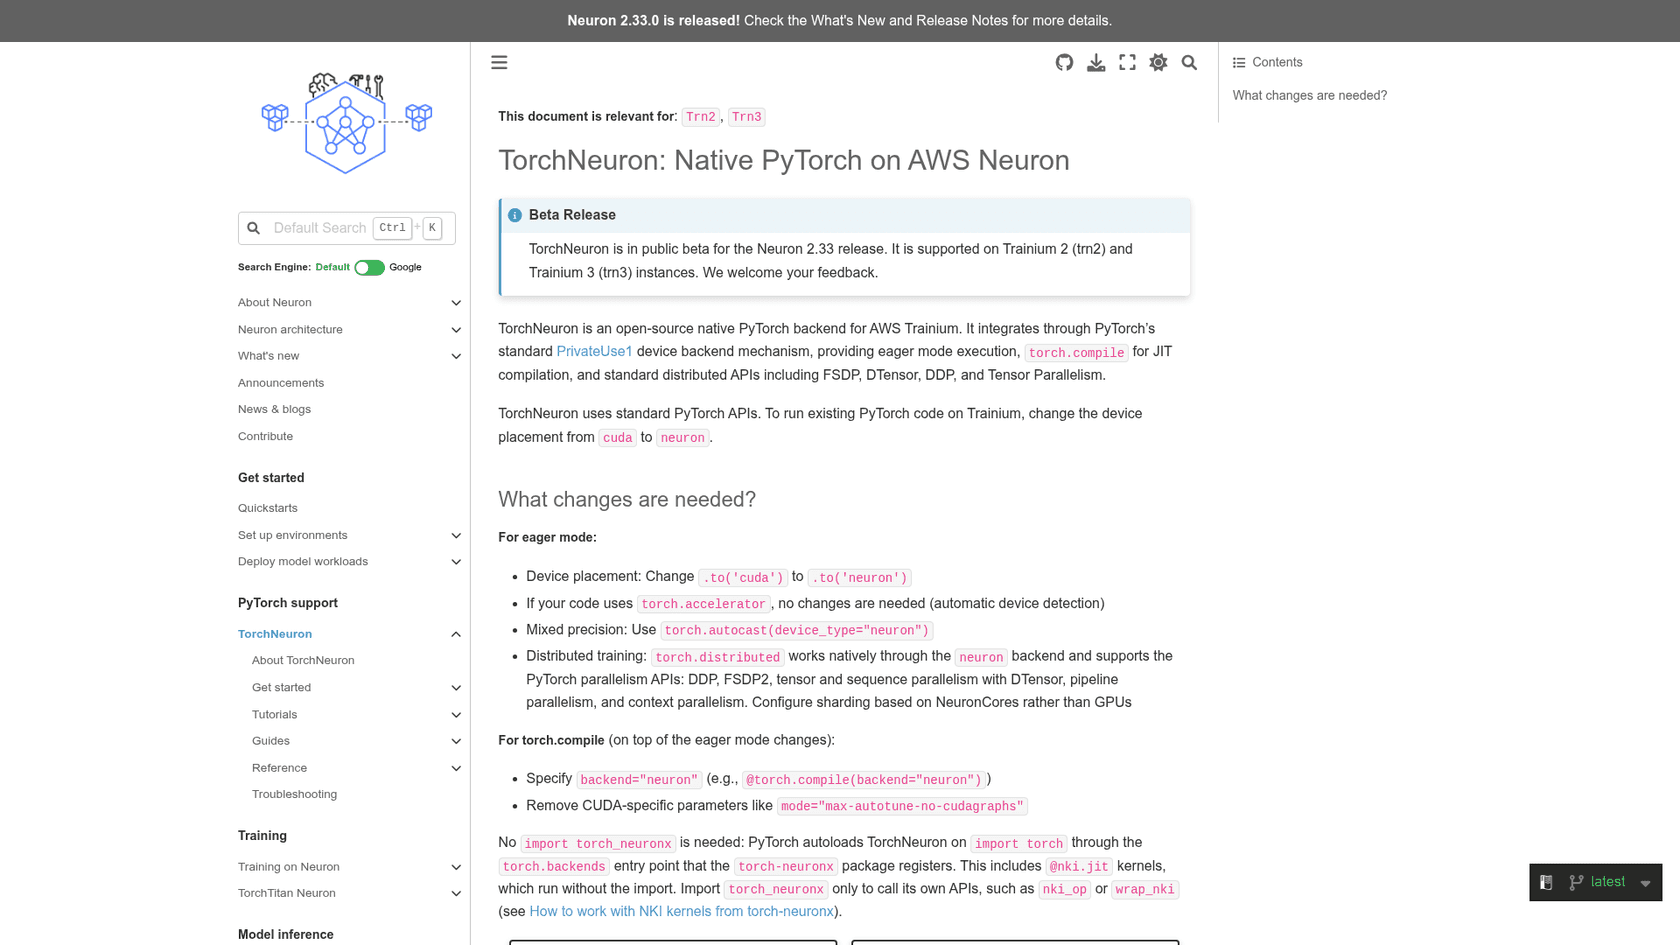
A documentação oficial diz com clareza: o TorchNeuron está em beta pública para a versão Neuron 2.33 e roda em instâncias Trainium2 (trn2) e Trainium3 (trn3). O discurso da própria Amazon no About Amazon é que 85% dos pesquisadores e desenvolvedores de IA escrevem seu código em PyTorch, e que, até agora, levar esse código para chips novos significava meses de reescrita e revalidação.
Andy Jassy, CEO da Amazon, apresentou o argumento de negócio no X no mesmo dia:
"Trying a new AI chip used to be a lot of work. You often had to rewrite your code, revalidate it, and sink many weeks in, betting this new chip is the right one for your workload."
O que realmente há de novo
O Trainium roda PyTorch há anos, então é justo perguntar o que mudou. A resposta está na tubulação por baixo. Até o PyTorch 2.9, o Neuron executava o PyTorch por meio do PyTorch/XLA, que usava tensores preguiçosos: nada rodava até que um grafo fosse rastreado e compilado, então prints, breakpoints e o fluxo de controle do Python se comportavam de forma estranha. A AWS anunciou que o PyTorch 2.9 seria a última versão baseada em XLA, com a 2.10 e as seguintes passando ao suporte nativo.
O TorchNeuron se conecta ao PrivateUse1, o ponto de extensão oficial do PyTorch para hardware personalizado. Para o PyTorch, o Trainium passa a ser só mais um dispositivo ao lado de CPU e CUDA. É por isso que a publicação de lançamento pode dizer que torch.nn, torch.autocast, torch.distributed e torch.profiler funcionam no dispositivo neuron do jeito que estão escritos.
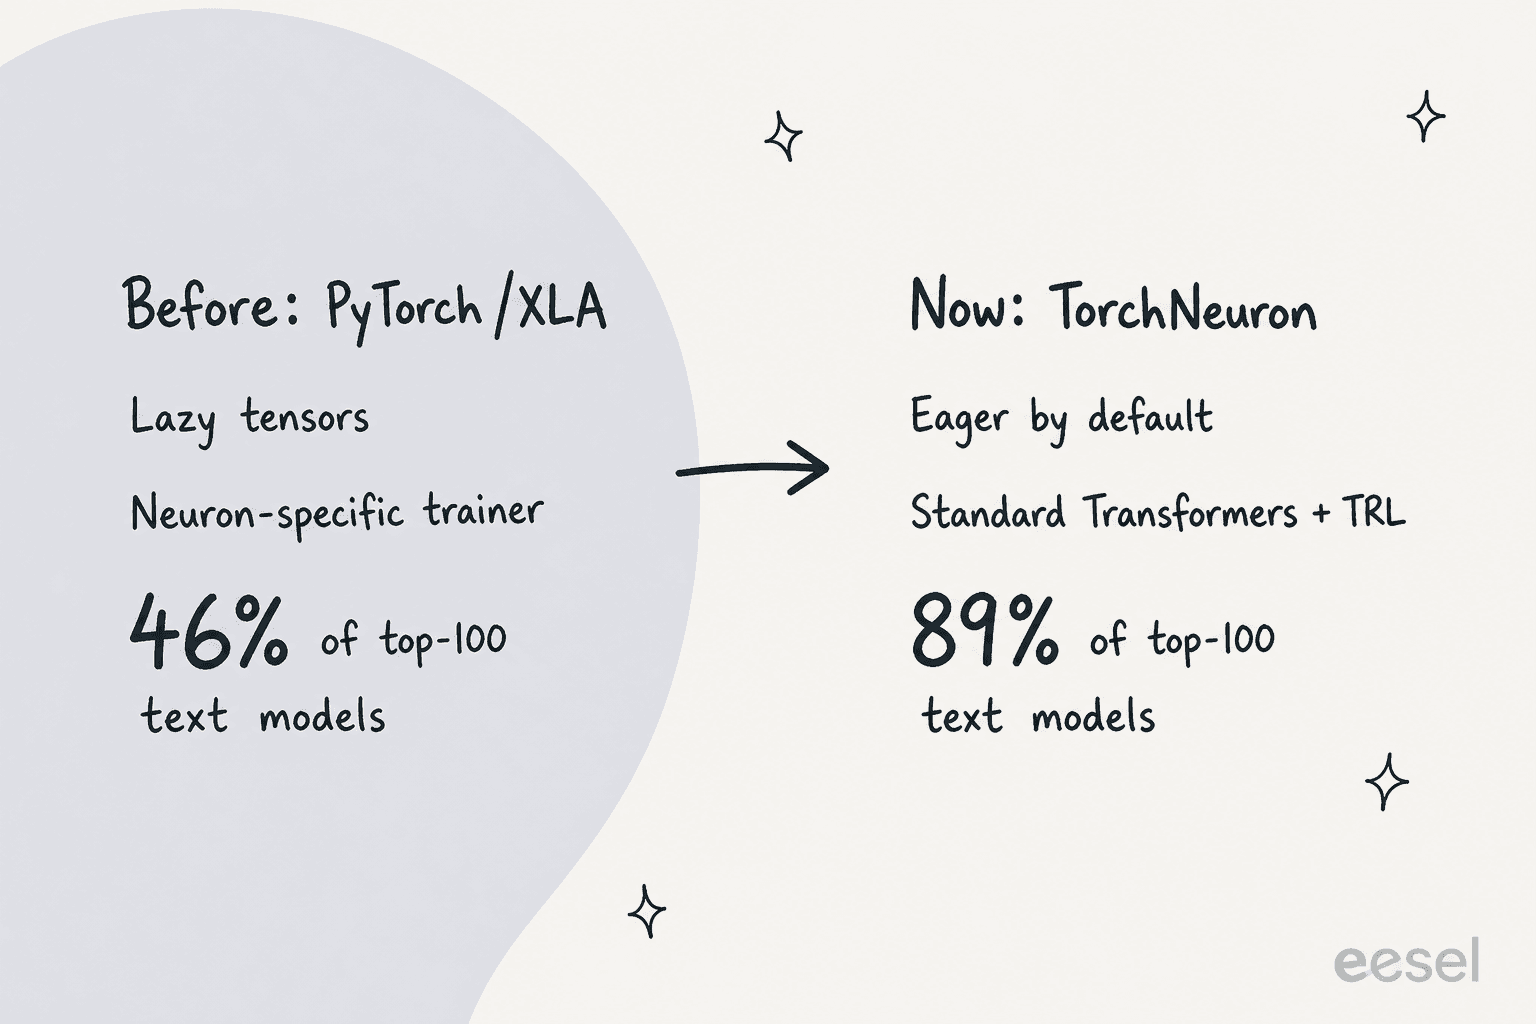
A medida mais clara da mudança vem da Hugging Face. Na sua publicação de lançamento, a Hugging Face diz que 89% das 100 principais arquiteturas de geração de texto agora funcionam sem ajustes, contra 46% pela sua antiga biblioteca Optimum Neuron v0.4.5. Ela agora recomenda usar Transformers, Diffusers, Accelerate, PEFT e TRL diretamente no Trainium, em vez de passar pelo Optimum Neuron.
Aqui está o antes e o depois em uma tabela:
| PyTorch/XLA (torch-neuronx antes da 2.14) | TorchNeuron (torch-neuronx 2.14+) | |
|---|---|---|
| Execução | Tensores preguiçosos, grafos rastreados | Eager por padrão, torch.compile opcional |
| Depuração | Em nível de grafo, prints atrasados | Prints e breakpoints do Python funcionam |
| Caminho da Hugging Face | Wrapper Optimum Neuron | Transformers, TRL, Diffusers diretamente |
| Distribuído | APIs específicas do Neuron | DDP, FSDP2, DTensor, TP, PP |
| Chips | Trn1, Trn2, Inferentia | Apenas Trn2 e Trn3 |
| Versões do PyTorch | Até a 2.9 | 2.14 na versão atual |
Essa última linha importa mais do que a cobertura do lançamento sugere, e volto a ela na seção de limites.
Como o TorchNeuron funciona
Por baixo dos panos, o TorchNeuron tem dois backends: um registrado no dispatcher do PyTorch para o modo eager e outro registrado no TorchDynamo para o torch.compile. Ambos entregam o trabalho ao compilador Neuron, que gera arquivos NEFF (Neuron Executable File Format) que o runtime do Neuron executa no chip.
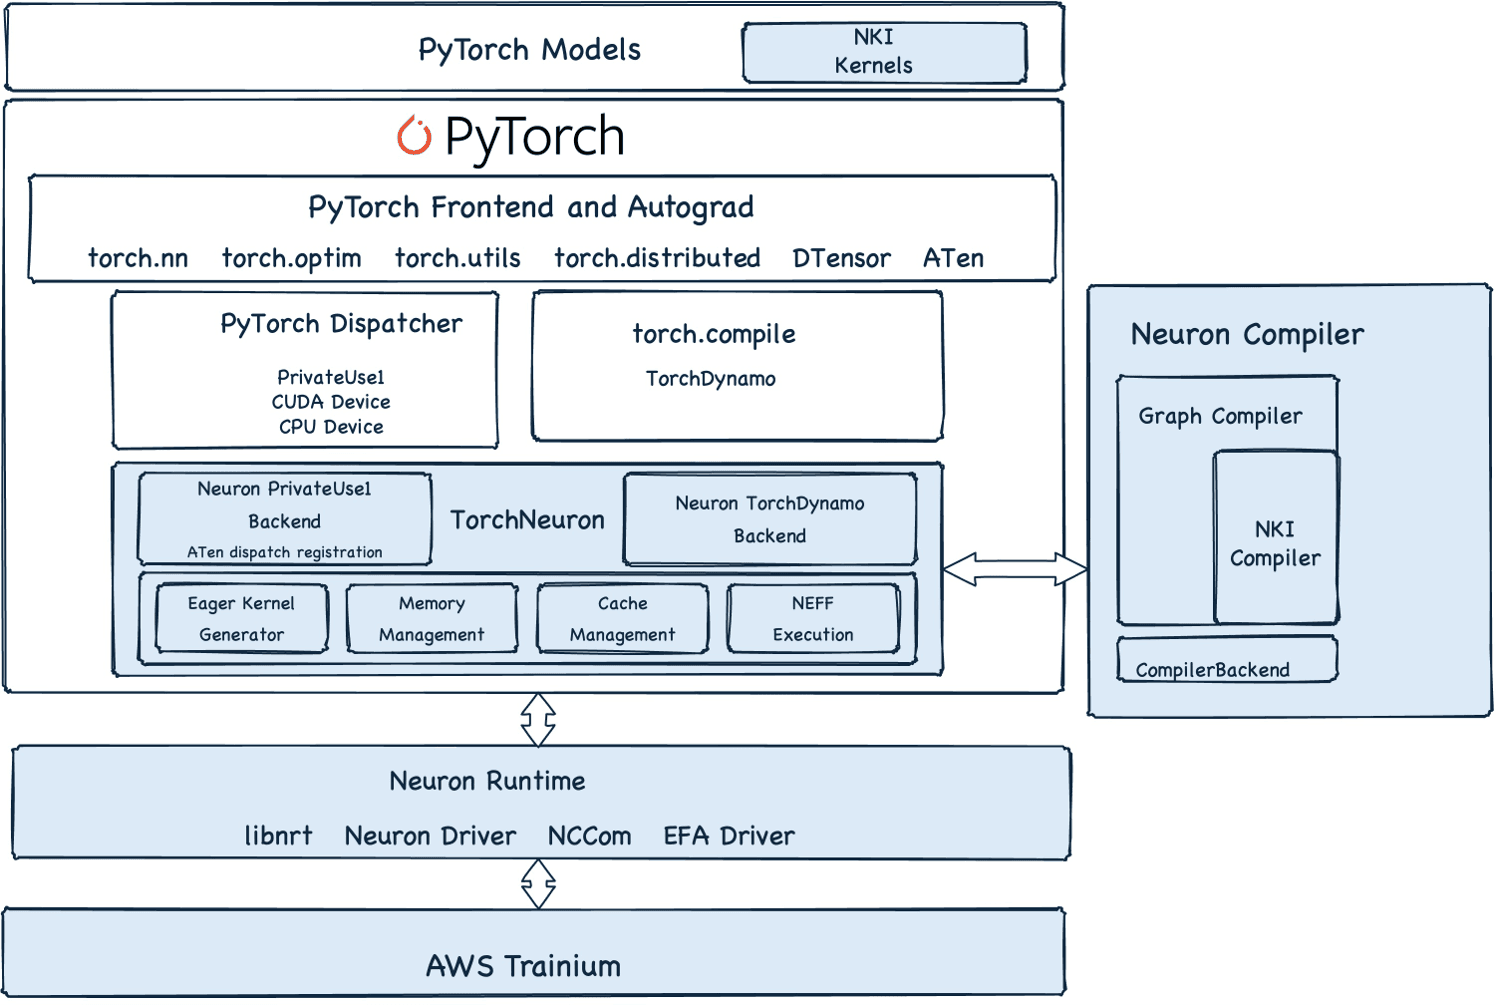
A página About TorchNeuron explica os dois caminhos em detalhe. Eles se comportam de forma tão diferente que eu os trataria como dois produtos.
O modo eager executa cada operação assim que você a chama. Na primeira vez que um operador roda, ele é compilado para o seu próprio NEFF e vai para um cache em disco; depois disso, é servido do cache. Se um operador não tem implementação no Neuron, ele recorre à CPU com um aviso, então o modelo roda do mesmo jeito. Há também um modo eager adaptativo experimental (defina TORCH_NEURONX_ENABLE_CONCATENATION=1) que funde operações elegíveis para reduzir a sobrecarga de disparo.
O torch.compile captura o modelo em um grafo pelo TorchDynamo e pelo AOTAutograd, converte para StableHLO via Torch-MLIR e compila o grafo inteiro em um único NEFF. É o caminho de produção. A contrapartida é o rigor: segundo o README no GitHub, dynamic deve ser False, mode só aceita "default", os tensores devem ser contíguos e cada nova forma de entrada dispara uma nova compilação. Um operador capturado que o backend não consiga traduzir faz a compilação falhar por padrão.
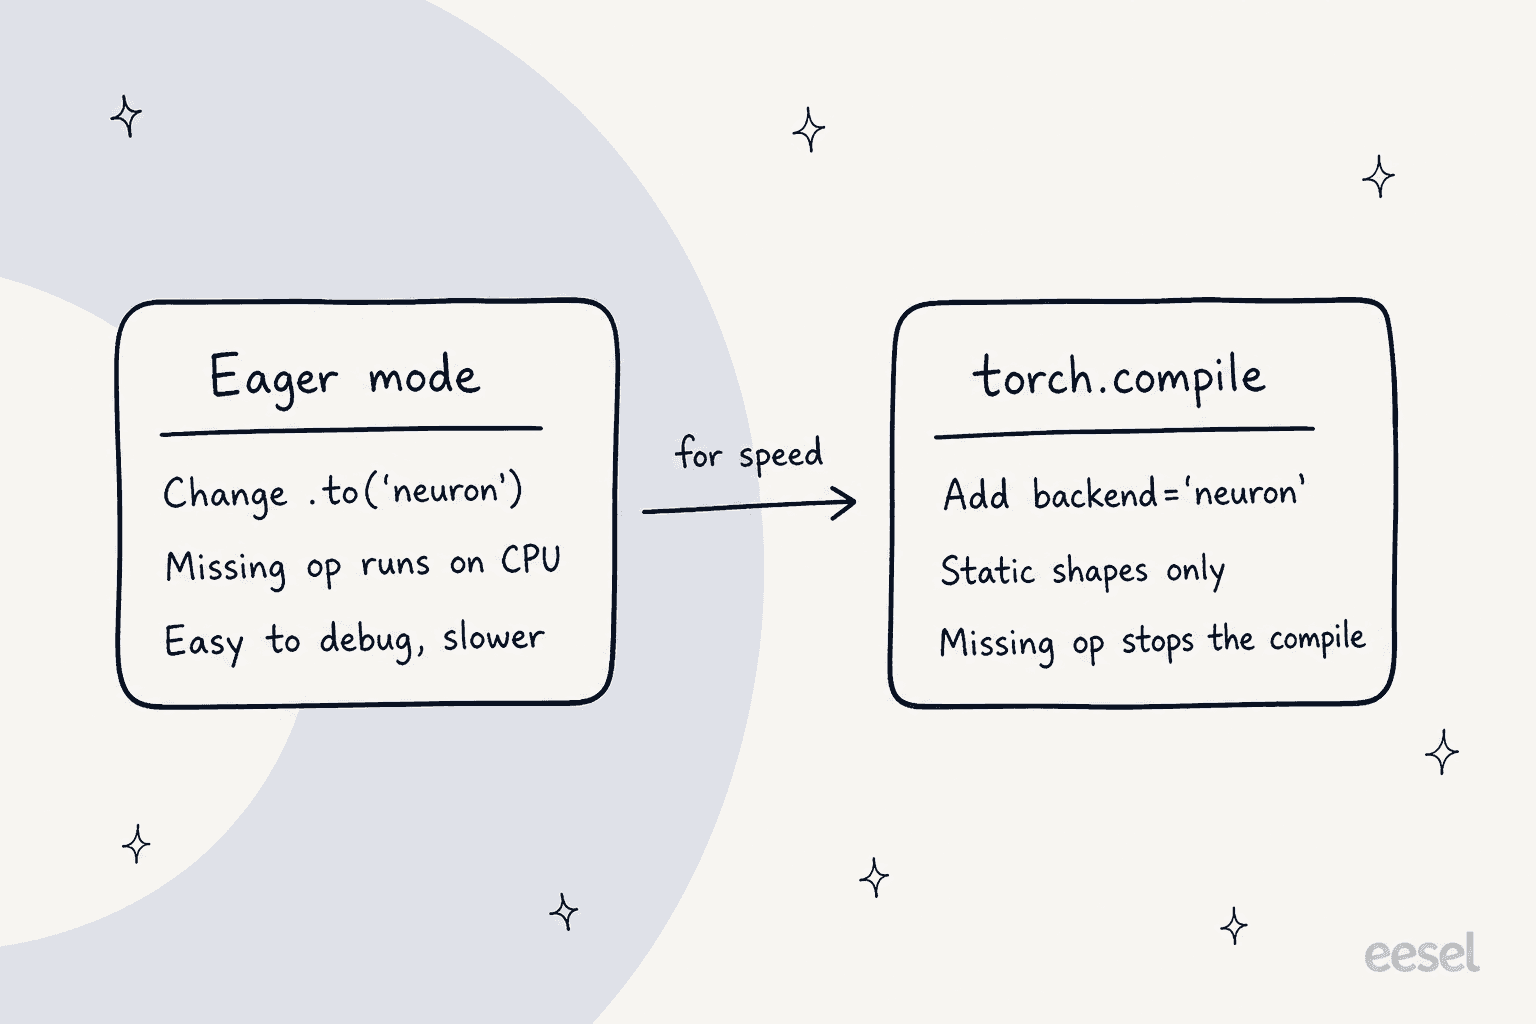
Então a leitura honesta de "uma mudança de configuração" é: uma mudança para começar e uma segunda rodada de trabalho para ficar rápido. Na prática, essa segunda rodada consiste principalmente em preencher ou agrupar as entradas em poucas formas fixas e apontar TORCH_NEURONX_NEFF_CACHE_DIR para um armazenamento compartilhado (a documentação sugere o Amazon FSx), para que uma frota não recompile os mesmos grafos em cada instância.
Acima dos dois modos fica o NKI, a Neuron Kernel Interface, para escrever kernels personalizados quando o compilador não basta. Você registra um kernel NKI como um operador PyTorch normal com nki_op, e ele funciona no modo eager e dentro de um grafo compilado. A AWS também abriu o código da NKI-lib, um conjunto de kernels otimizados que inclui FlashAttention e kernels blockwise para MoE.
Como é a mudança no código
Para um loop de treinamento, a publicação de lançamento mostra o diff inteiro como uma única linha:
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
Para a versão compilada, você indica o backend uma vez com torch.compiler.set_default_backend("neuron"), ou a cada chamada com torch.compile(model, backend="neuron"). O código escrito para torch.accelerator, a API do PyTorch independente de dispositivo, não precisa de nenhuma mudança. Você nem precisa de import torch_neuronx: o pacote se registra pelo entry point torch.backends e é carregado com import torch.
A lista completa de edições da documentação é curta:
- Troque
.to('cuda')por.to('neuron'), ou conte comtorch.accelerator. - Use
torch.autocast(device_type="neuron")para precisão mista. - Em jobs distribuídos, configure o sharding por NeuronCores em vez de por GPUs.
- Para o
torch.compile, adicionebackend="neuron"e remova ajustes exclusivos do CUDA, comomode="max-autotune-no-cudagraphs".
Para modelos da Hugging Face é ainda mais curto. Carregar um modelo com device_map="neuron" coloca os pesos no Trainium, e device_map="auto" encontra o dispositivo sozinho. O exemplo da Hugging Face faz fine-tuning com um script TRL SFTTrainer padrão em 8 chips Trainium2 (metade de uma trn2.48xlarge), com um único ajuste específico do Neuron: HF_DEACTIVATE_ASYNC_LOAD=1, porque o carregamento assíncrono de pesos ainda não é suportado. O checkpoint salvo é um checkpoint normal do Transformers, que você pode carregar em qualquer hardware.
Esse é o tipo de portabilidade mecânica em que os agentes de programação são bons. Se você está migrando um repositório, uma ferramenta como o Claude Code ou o OpenAI Codex pode encontrar as chamadas específicas do CUDA e trocá-las, desde que você confira os logs de compilação por conta própria.
Quanto custa o TorchNeuron?
A biblioteca é gratuita. O TorchNeuron usa Apache 2.0, se instala com pip install torch-neuronx a partir do repositório pip do Neuron e vem pré-instalado na Neuron Deep Learning AMI e nos Deep Learning Containers. O custo é o tempo de Trainium.
A AWS publica os preços do Trainium na sua página de preços de Capacity Blocks, onde você reserva capacidade de aceleradores por uma janela fixa. Estas são as tarifas horárias efetivas listadas em 20 de outubro de 2026, e a AWS diz que a próxima atualização de preços prevista é em janeiro de 2027:
| Instância | Aceleradores | Por hora de instância | Por hora de chip | Funciona com o TorchNeuron? |
|---|---|---|---|---|
| trn2.48xlarge (US East, Ohio) | 16 x Trainium2 | US$ 35,7608 | US$ 2,235 | Sim |
| trn2.3xlarge (regiões selecionadas) | 1 x Trainium2 | US$ 2,235 | US$ 2,235 | Sim |
| trn1.32xlarge | 16 x Trainium | US$ 9,532 | US$ 0,596 | Não |
| p5.48xlarge | 8 x H100 | US$ 47,757 | US$ 5,970 | GPU, não Neuron |
| p5e.48xlarge | 8 x H200 | US$ 54,924 | US$ 6,866 | GPU, não Neuron |
| p5en.48xlarge | 8 x H200 | US$ 63,158 | US$ 7,895 | GPU, não Neuron |
O Linux não tem taxa extra de sistema operacional nesses blocos. Os Trn3 UltraServers, que escalam até 144 chips Trainium3, não têm tarifa horária pública nessa página.
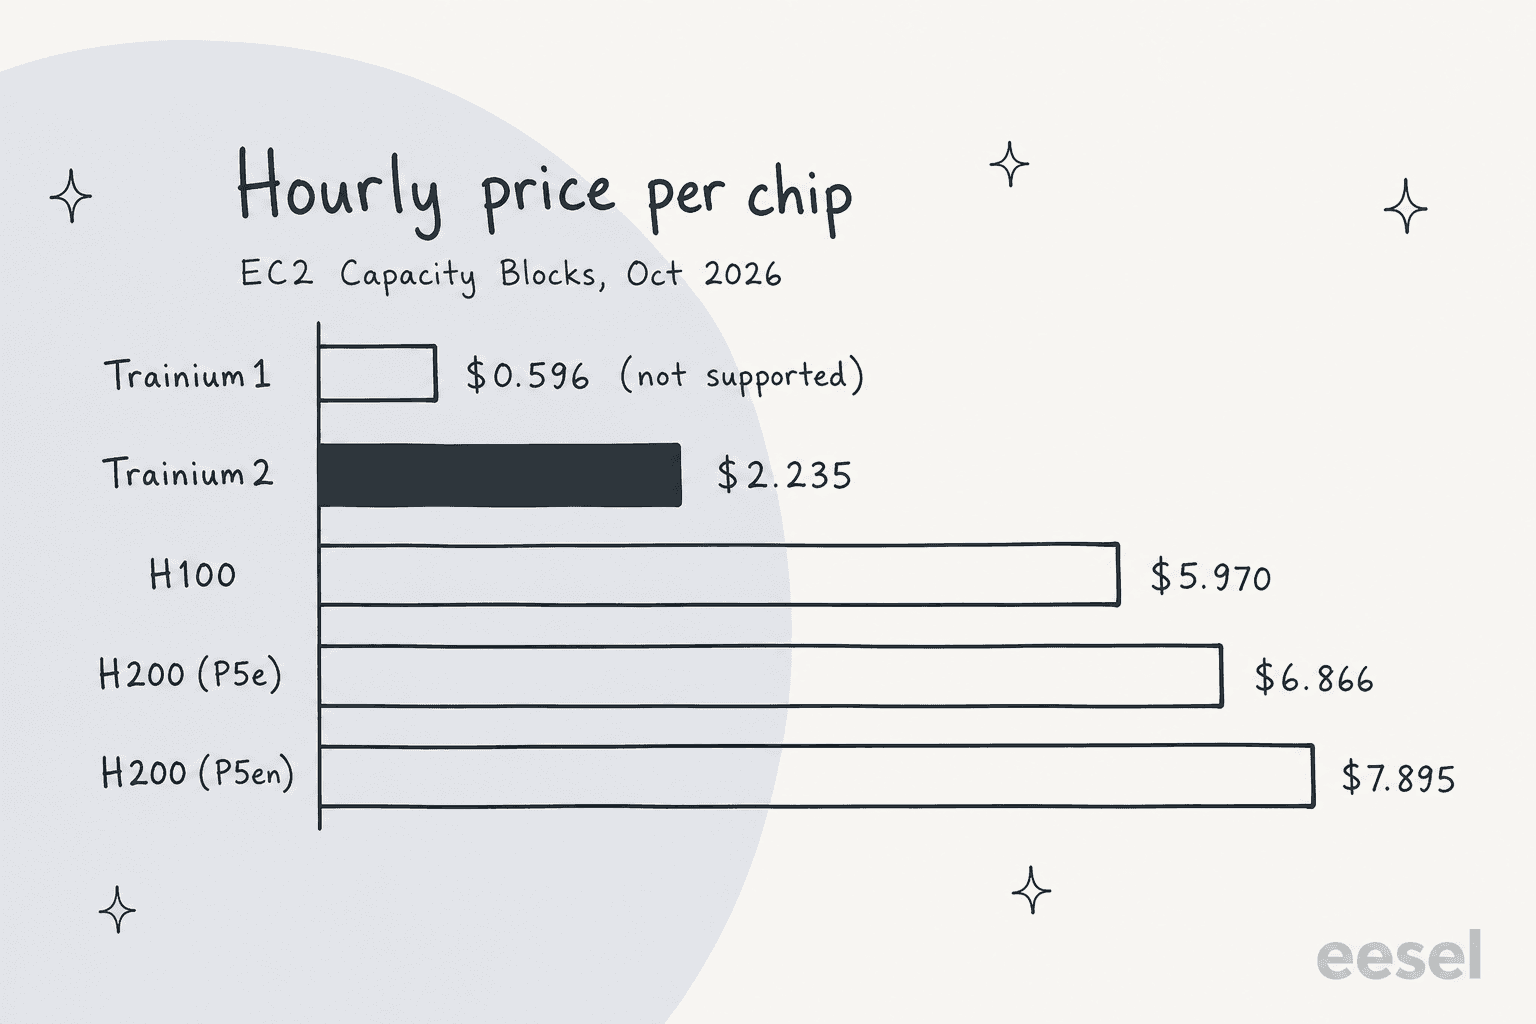
Por chip, uma hora de Trainium2 custa cerca de 37% de uma hora de H100. Isso não significa que o seu job custa 37%, porque um chip Trainium2 e uma H100 fazem quantidades diferentes de trabalho. A afirmação da própria AWS na página do Trn2 é mais restrita: as instâncias Trn2 oferecem "30-40% better price performance than GPU-based EC2 P5e and P5en instances." Uma trn2.48xlarge tem 16 chips Trainium2, 1,5 TB de HBM e até 20,8 petaflops FP8.
O único número de cliente do lançamento é da Deepgram, a empresa de reconhecimento de fala:
"In the benchmarks we evaluated, Trainium processes about 60% more input audio seconds per dollar than our existing GPU baselines, which helps us bring better models to customers at lower prices."
Adam Sypniewski, CTO da Deepgram, no blog do PyTorch
Note o contexto por trás desse número: a Deepgram portou seu modelo ao longo de um projeto de vários meses com o AWS Generative AI Innovation Center. É um resultado real, mas é uma migração com apoio, não uma troca de fim de semana. Para comparar nuvens de GPU, minhas análises de preços da CoreWeave e preços da Lambda cobrem o outro lado da tabela, e o guia de preços da AWS cobre o resto da conta.
Benchmarks e cobertura de testes
A AWS não publicou um ranking de velocidade de modelos com o lançamento. O que ela publicou foram testes de cobertura, que considero o número mais útil para uma beta. Segundo a publicação de lançamento, a AWS executa continuamente cerca de 100.000 modelos da Hugging Face, escolhidos para cobrir 99,9% do uso real por número de downloads, em uma configuração reduzida no Trainium. Cada execução verifica se o modelo carrega, se as passagens forward e backward rodam e se ele compila.
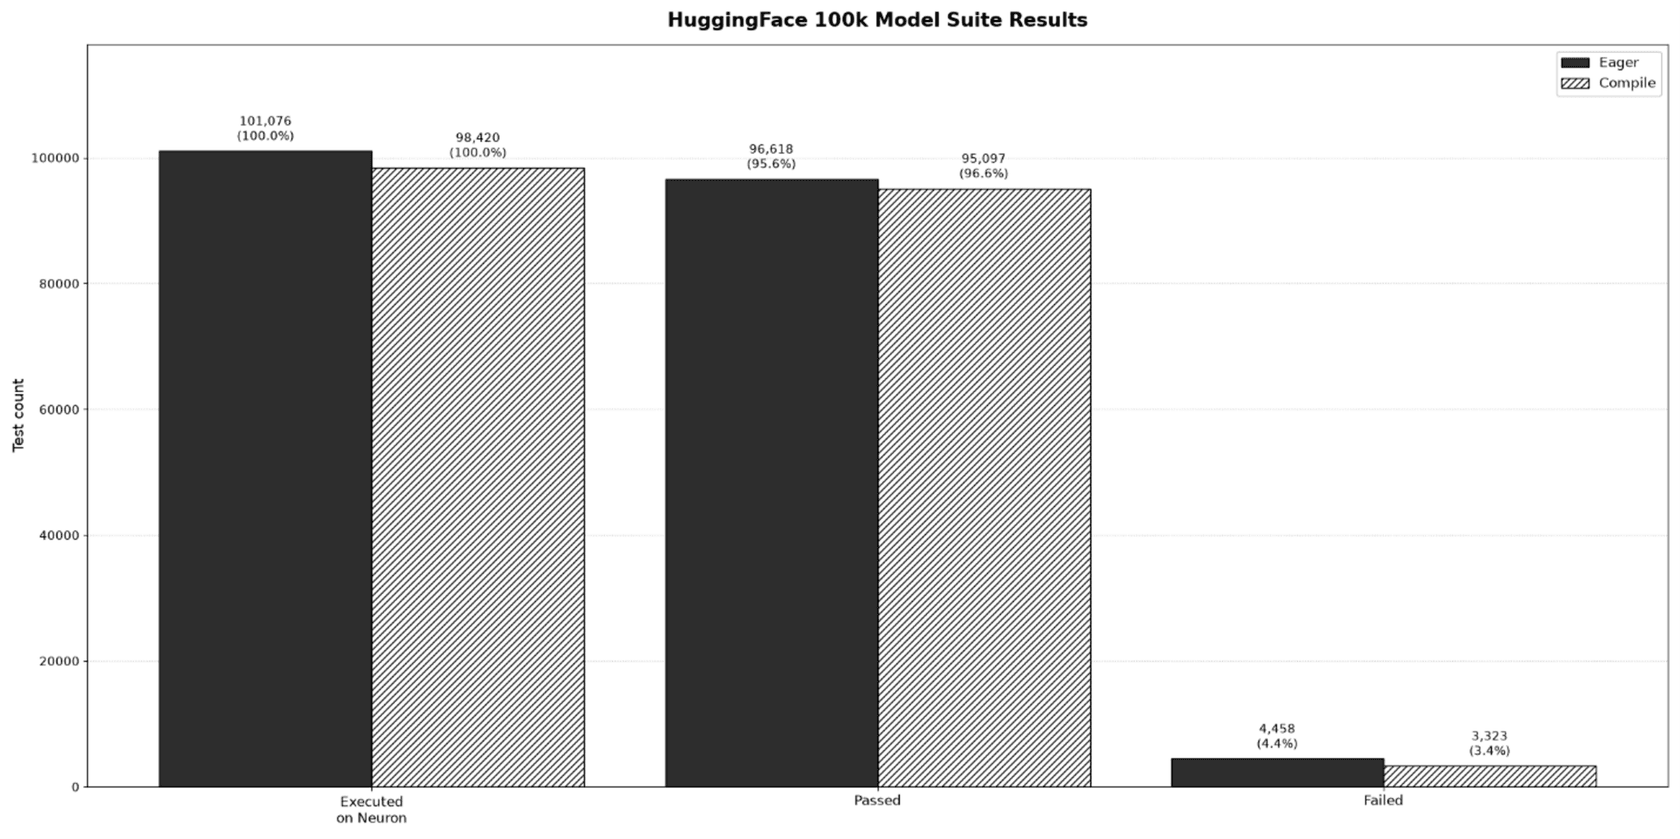
Os resultados de setembro de 2026: 95,6% passam no modo eager e 96,6% com o torch.compile, com 4.458 e 3.323 falhas, respectivamente. É um número forte para uma beta e é o tipo certo de teste. Na eesel, aprendi a mesma lição pelo outro lado: um agente de suporte que parece ótimo na demo ainda pode dar respostas erradas com muita confiança em tickets reais, e por isso simulamos cada implantação contra os tickets históricos de um cliente antes de entrar no ar. Uma varredura de 100.000 modelos reais é a AWS fazendo o equivalente para um compilador.
A suíte de testes do PyTorch upstream mostra onde estão as lacunas. A execução de agosto de 2026 produziu cerca de 154.000 resultados de teste, dos quais cerca de 69.000 foram ignorados. Aproximadamente 30.000 foram ignorados pelas próprias verificações de elegibilidade do PyTorch (testes exclusivos de CUDA e de CPU). Os outros ~39.000 foram omissões deliberadas do Neuron, sendo o maior grupo ~22.000 testes de operadores que ainda não têm uma tradução nativa para o Neuron.
Quanto ao hardware, a página do Trn3 afirma que os Trn3 UltraServers entregam até 4,4 vezes o desempenho e 4 vezes o desempenho por watt dos Trn2 UltraServers, com até 362 petaflops MXFP8 em 144 chips. Esses são números da AWS para o chip, não resultados do TorchNeuron, e ainda não vi benchmarks independentes de nenhum dos dois.
O que o TorchNeuron ainda não faz
Esta é uma primeira versão, e a AWS é incomumente direta sobre o que deixou de fora. Segundo a publicação de lançamento e o README:
- Chips mais antigos. Apenas Trn2 e Trn3 são suportados. O Trainium1, que a US$ 0,596 por hora de chip é o acelerador mais barato da tabela acima, e o Inferentia continuam na linha do torch-neuronx baseada em XLA (versões anteriores à 2.14).
- Formas dinâmicas. O
torch.compileexige formas estáticas. Entradas de tamanho variável significam preencher ou agrupar, e cada forma nova recompila. - Precisão. float64 roda como float32, o que pode mudar resultados que exigem precisão de 64 bits. O suporte a int64 depende da operação.
- Recursos deixados de fora de propósito. Tensores esparsos, NestedTensor, autograd em modo forward, máscaras de atenção arbitrárias na atenção multi-head nativa (sem máscara e causal funcionam), quantização por canal e upsampling bilinear/bicúbico não estão nesta versão.
- FP8 e TorchAO. Estão em beta privada, com disponibilidade geral prevista para a próxima versão. O suporte ao FlexAttention é limitado.
- Tempo de compilação na primeira execução. A primeira chamada de uma operação ou de um grafo compilado inclui a compilação, que "can be significant for a large model", segundo o README.
A reação da comunidade até agora é, em sua maioria, de otimismo cauteloso de quem já fez esse tipo de portabilidade. Respondendo a Jassy, um engenheiro disse:
"Big if this works flawlessly. I have been on the other end, it's not been pretty."
Outra resposta sob a publicação do CEO da AWS, Matt Garman, apontou o teste de mais longo prazo: se a AWS continuará enviando suas mudanças para o próprio PyTorch.
"Open sourcing is the easy half, upstreaming is the harder promise."
A AWS já começou: a publicação de lançamento lista 26 pull requests para o PyTorch e o TorchTitan, abertos para melhorar a qualidade dos testes e remover suposições de CUDA embutidas no código.
Antes de reservar um Capacity Block, vale rodar seu código contra essa lista. Marque o que se aplica:
Marque o que a sua carga de trabalho usa para ver a solução de cada bloqueio, tirada da documentação e do README do TorchNeuron.
Como o TorchNeuron se compara a outras formas de rodar modelos
O verdadeiro rival do TorchNeuron é a GPU. A escolha para uma equipe que treina ou serve seus próprios modelos fica assim:
| Opção | O que você gerencia | Mudanças de código | Ideal para |
|---|---|---|---|
| TorchNeuron no Trainium | Instâncias, cache de compilação, formas | Nome do dispositivo, formas estáticas para compilar | Equipes comprometidas com a AWS com jobs grandes e constantes |
| GPUs NVIDIA na AWS (P5, P5e, P5en) | Instâncias | Nenhuma para código CUDA | Código com kernels CUDA próprios, início mais rápido |
| Nuvens de GPU (CoreWeave, Lambda) | Instâncias ou clusters | Nenhuma para código CUDA | Capacidade de GPU fora das grandes nuvens |
| GPUs serverless (Modal, Baseten) | O código do seu modelo | Pequenos wrappers | Inferência com picos, sem planejar capacidade |
| APIs de modelos hospedados (Together AI, Groq) | Nada | Apenas chamadas de API | Modelos abertos sem mexer em hardware |
O interessante é que a primeira linha costumava ter "reescrever sua pilha de treinamento" na coluna de mudanças de código. Agora ela está mais próxima das linhas de GPU, e esse é todo o objetivo do lançamento. A AWS lista parceiros que já constroem sobre isso, incluindo Anyscale, Modular e Nota AI, e, com o suporte da Hugging Face, a maioria dos modelos abertos dos meus textos sobre Kimi K3 ou DeepSeek V4 Flash está a um device_map do Trainium.
Em serving, o TorchNeuron alimenta o mesmo backend do torch.compile no vLLM Neuron, um plugin que adiciona um servidor compatível com a OpenAI, batching contínuo e um cache KV paginado. Se o seu objetivo final é um agente gerenciado na AWS em vez de uma pilha própria de serving, o Bedrock Managed Agents fica uma camada acima de tudo isso.
Primeiros passos
Você precisa de uma instância Trn2 ou Trn3 e do Python 3.12, 3.13 ou 3.14. Na Neuron Deep Learning AMI, o TorchNeuron já vem instalado. Em outra instância Linux, o README manda instalar o driver e o runtime do Neuron e depois fixar as versões:
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
Mantenha as versões fixadas: as versões anteriores do torch-neuronx são o produto baseado em XLA com o mesmo nome de pacote, o que é um jeito fácil de instalar a coisa errada. A verificação collect_env deve informar que o dispositivo é utilizável pelo torch.
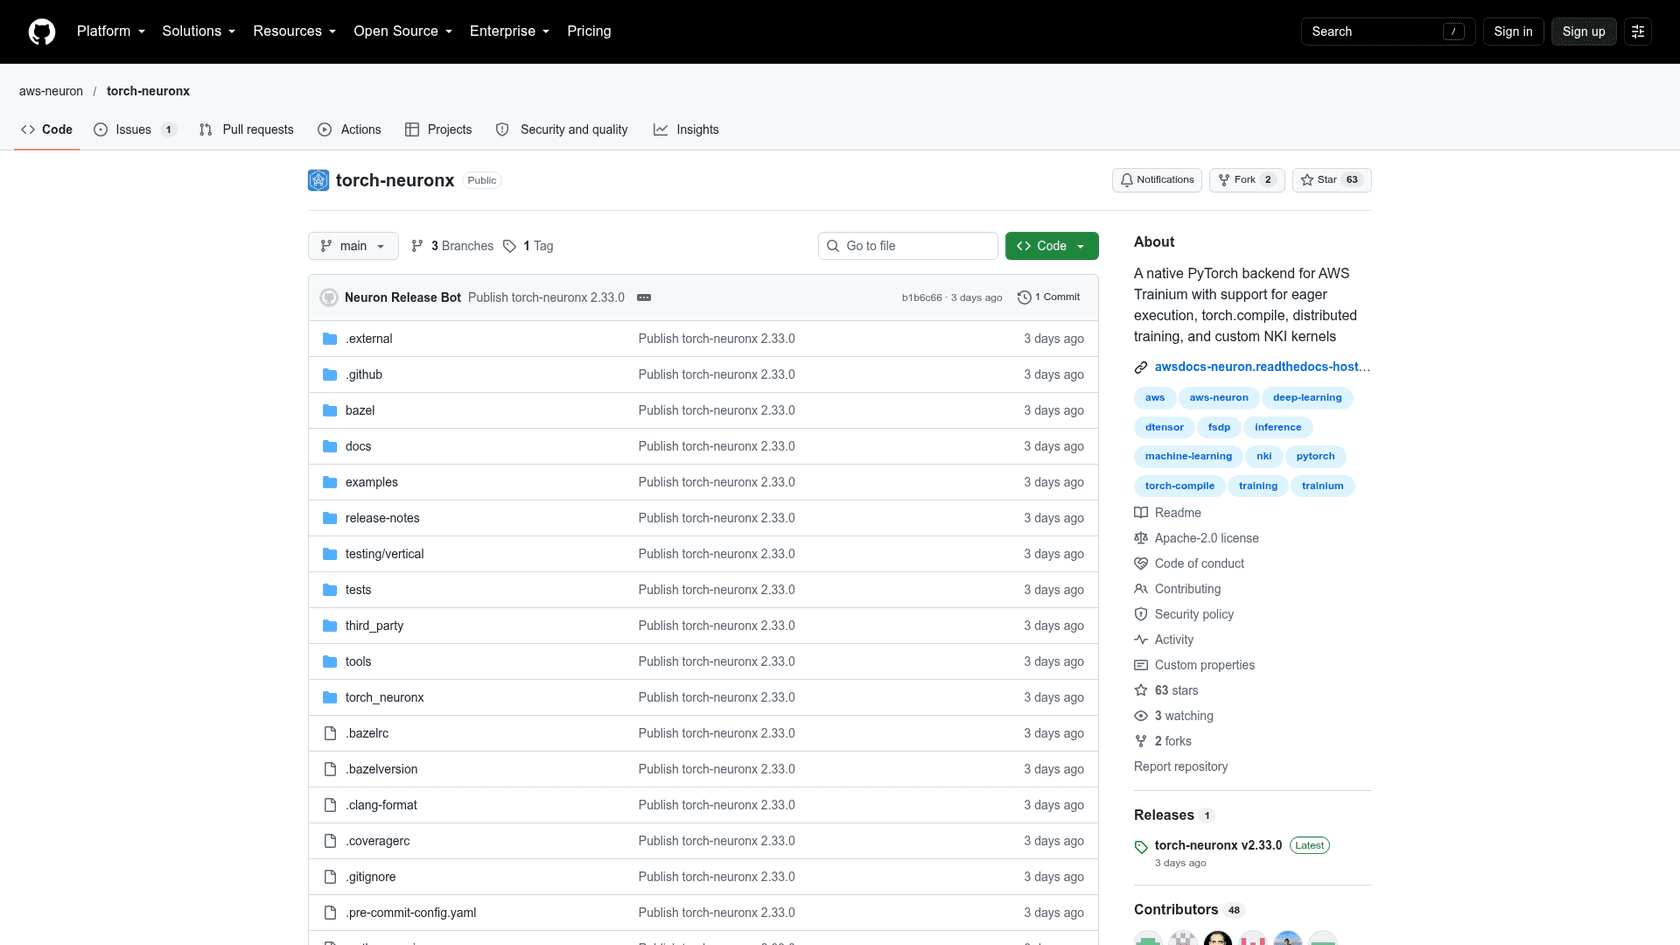
O repositório tinha 63 estrelas e 48 colaboradores quando o capturei no dia do lançamento, com exemplos de Llama, Whisper, Qwen2, um modelo de mistura de especialistas, treinamento do GPT-2 e execuções multinó. Para treinamento em larga escala, o torchtitan-neuron traz receitas do TorchTitan ajustadas para o Trainium. A publicação de lançamento mostra o treinamento do Llama 3 8B com SimpleFSDP e torch.compile em uma única trn2.48xlarge.
Minha ordem sugerida para um piloto:
- Rode seu modelo no modo eager em uma trn2.3xlarge ou trn2.48xlarge e leia cada aviso de fallback para CPU.
- Corrija as formas e depois leve o caminho crítico para o
torch.compilecomfullgraph=True. - Compartilhe o cache de NEFF entre as instâncias antes de escalar.
- Compare o custo por passo de treinamento ou por token com as suas GPUs atuais, não o custo por hora.
Para quem é o TorchNeuron
O TorchNeuron é para equipes que treinam ou servem seus próprios modelos PyTorch, já rodam na AWS e gastam com aceleradores o bastante para que uma diferença de 30-40% em desempenho por preço compense um sprint de engenharia. Equipes de pesquisa aproveitam mais o modo eager, já que a depuração finalmente funciona como em qualquer outro dispositivo. Equipes de produção aproveitam mais o lado do custo, depois que formas e cache estão resolvidos.
Não é para você se o seu código depende de kernels CUDA personalizados que você ainda não consegue reescrever, se você precisa de Trainium1 ou Inferentia, ou se você nunca mexe nos pesos de um modelo. A maioria das empresas que usam IA, inclusive a maioria das que conheço na eesel, está nesse último grupo: querem que a IA faça um trabalho, e o chip em que ela roda é problema de outra pessoa.
Onde a eesel se encaixa: isto é infraestrutura, a eesel é a funcionária
O TorchNeuron torna a camada de hardware mais barata e mais fácil de trocar. Isso é uma boa notícia para todos que constroem modelos e, com o tempo, reduz o custo dos produtos de IA construídos sobre eles. Mas ele não responde a um ticket, não redige uma resposta nem escreve um post de blog. Esses são trabalhos, e trabalhos precisam de contexto: sua central de ajuda, suas conversas passadas, suas regras de reembolso.
Essa é a camada em que a eesel atua. A eesel é uma plataforma de colegas de IA: você contrata colegas prontos para trabalhar em tarefas específicas, hoje um colega de IA para helpdesk e um redator de blog com IA. O colega de helpdesk entra na sua fila atual, aprende com a sua central de ajuda e com tickets anteriores e é simulado contra as suas conversas históricas antes de responder a um cliente de verdade.
A SE Ranking é um bom exemplo para um público técnico. Ela roda um agente da eesel por produto para SE Ranking, Planable e SE Visible no Zendesk, e entre 8 de agosto e 8 de setembro de 2026 a eesel atendeu cerca de 4.650 conversas, incluindo cerca de 2.100 chats ao vivo. Perguntas sobre a API e o Looker Studio são encaminhadas a um grupo de nível 2 com as evidências já reunidas, em vez de o bot chutar.
Se você é do tipo de leitor que acabou de instalar um backend de PyTorch a partir de um índice pip fixado, provavelmente também prefere configurar isto por um terminal. A CLI da eesel opera o mesmo colega e o mesmo workspace do painel, então tudo que você configura lá aparece na interface e vice-versa. npx @eesel/cli init chat-bubble --site https://your-site.com cria um agente, adiciona um balão de chat ao site e começa a ler o seu site, sem precisar de conta; depois, eesel login mantém o workspace. A partir daí, eesel chat conversa com o agente, eesel files upload adiciona conhecimento, eesel integrations connect conecta o seu helpdesk, eesel automations define o que ele faz sozinho e eesel approvals deixa você aprovar ações retidas.
Todo comando imprime JSON, os erros voltam como {error, hint, retryable} e --dry-run mostra a chamada exata ao servidor que uma escrita faria. É isso que o torna utilizável por agentes de programação como o Claude Code ou o Cursor: o agente pode executar a configuração e ler os próprios resultados. Todo workspace também é um servidor MCP, e eesel mcp token imprime uma linha de configuração pronta para colar.

O mesmo registro que você vê acima no painel é o que eesel activity imprime no terminal, do mais recente para o mais antigo.
Experimente a eesel
O TorchNeuron deixa você escolher o chip mais barato para os seus modelos. A eesel deixa você pular essa decisão no trabalho de suporte: um colega de helpdesk que se conecta ao Zendesk, Freshdesk ou Gorgias, treina com os seus tickets passados e prova seu valor em conversas históricas antes de tocar em uma ao vivo. Para equipes de SaaS com perguntas pesadas de API, a API de helpdesk com IA e a CLI permitem automatizar toda a configuração por script. Experimente a eesel grátis, ou comece pelo terminal com npx @eesel/cli.
Perguntas frequentes
O que é o TorchNeuron?
neuron ao PyTorch padrão, de modo que o modo eager, o torch.compile e o torch.distributed funcionam no Trainium2 e no Trainium3. Foi lançado em beta pública em 20 de outubro de 2026. Se você quer uma IA que faça um trabalho, e não um chip para rodar modelos, um colega de IA fica na outra ponta da pilha.O TorchNeuron é gratuito?
O TorchNeuron realmente exige mudar só uma linha de código?
.to('cuda') por .to('neuron'), ou não mude nada se o seu código já usa torch.accelerator. Para ter velocidade de produção, você também adiciona backend="neuron" ao torch.compile, usa formas estáticas e remove as opções exclusivas do CUDA. Ferramentas agênticas como o Claude Code lidam bem com esse tipo de portabilidade mecânica.