

O que a Z.ai realmente lançou em 12 de outubro
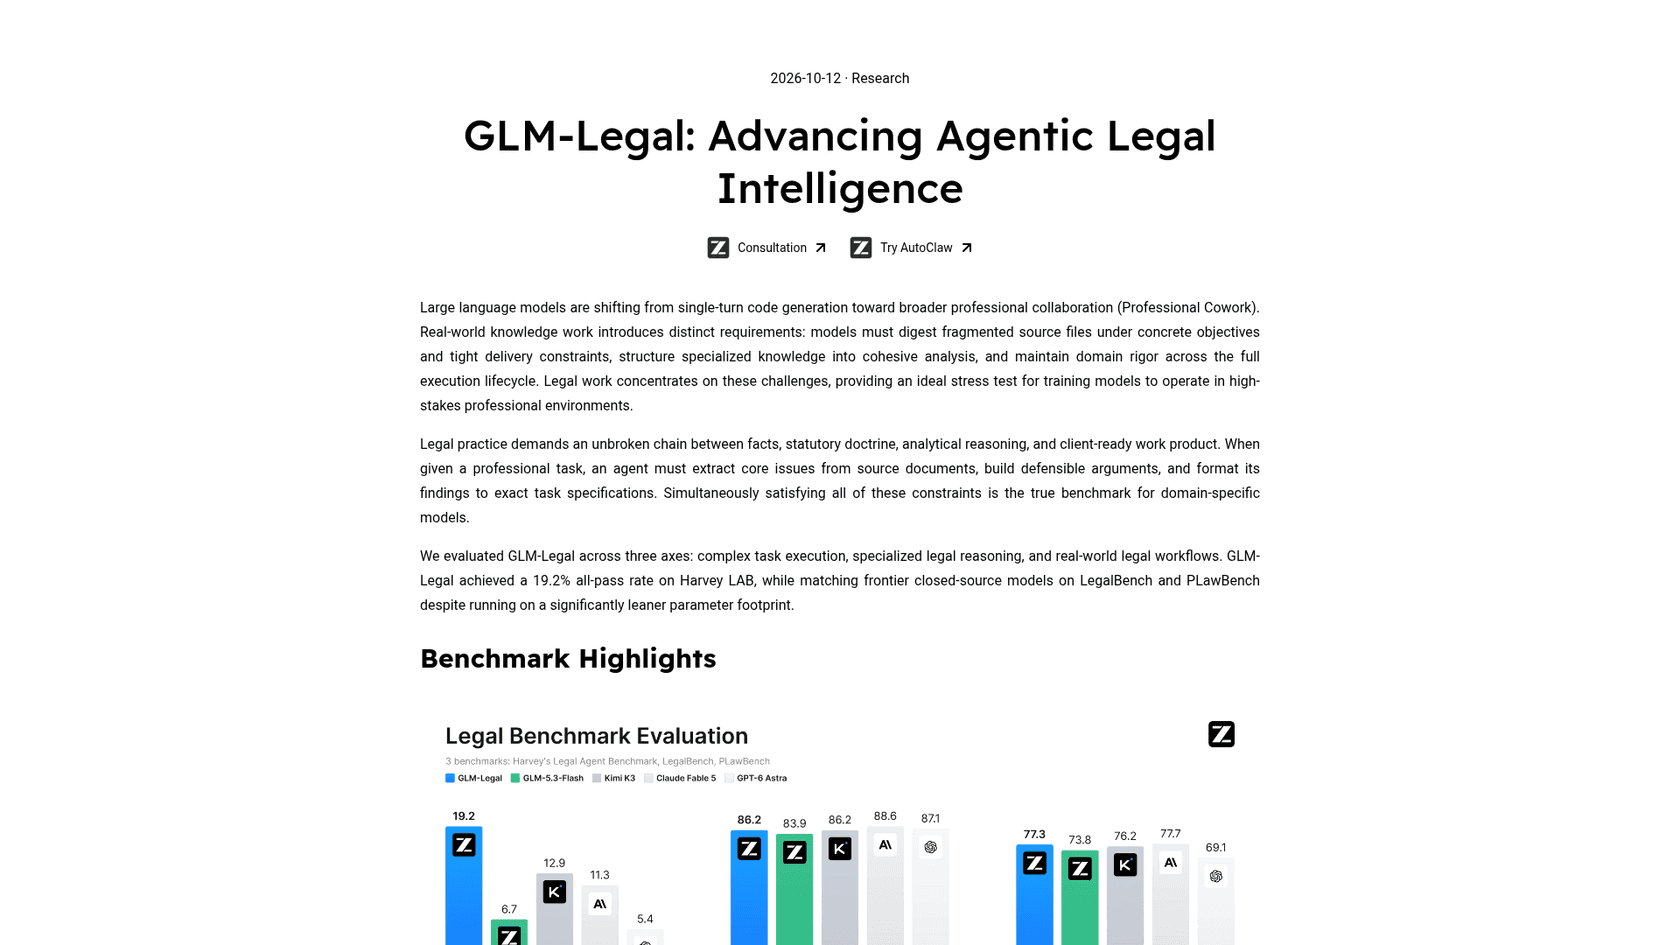
A Z.ai publicou o GLM-Legal como um post de pesquisa intitulado "Advancing Agentic Legal Intelligence", com dois botões no topo: um para um formulário de consulta e outro para o AutoClaw, seu aplicativo de agente para desktop. O post de lançamento no X tem mais de 7.000 curtidas, e a discussão no Hacker News chegou a 594 pontos e 332 comentários.
O que vem na caixa, e o que não vem:
| O que a Z.ai diz ou mostra | |
|---|---|
| Modelo base | GLM-5.3-Flash, um modelo de mistura de especialistas de 320B parâmetros com 18B ativos |
| Janela de contexto | 1M de tokens; 128k de saída máxima (ficha do modelo na Vals) |
| Entrada | Apenas texto nos testes da Vals, embora o modelo base processe imagens |
| Trabalho-alvo | Revisão de contratos, análise de provas, pesquisa de conformidade |
| Usuários-alvo | Escritórios de advocacia, empresas de legal tech, equipes internas, advogados autônomos |
| Acesso | Teste de API por solicitação; suporte ao AutoClaw "em breve" |
| Preço | Não publicado |
| Pesos | Sem download na página da Z.ai no Hugging Face em 14 de outubro |
Se você acompanhou o lançamento do GLM-5.2 ou o do Flash em agosto, o padrão vai soar familiar: a Z.ai pega um modelo geral forte e o aponta para uma tarefa específica. O novo é que a tarefa é uma profissão regulada e o lançamento é restrito.
Como o GLM-Legal funciona por dentro
A Z.ai descreve três etapas de treinamento, e a terceira é a interessante.
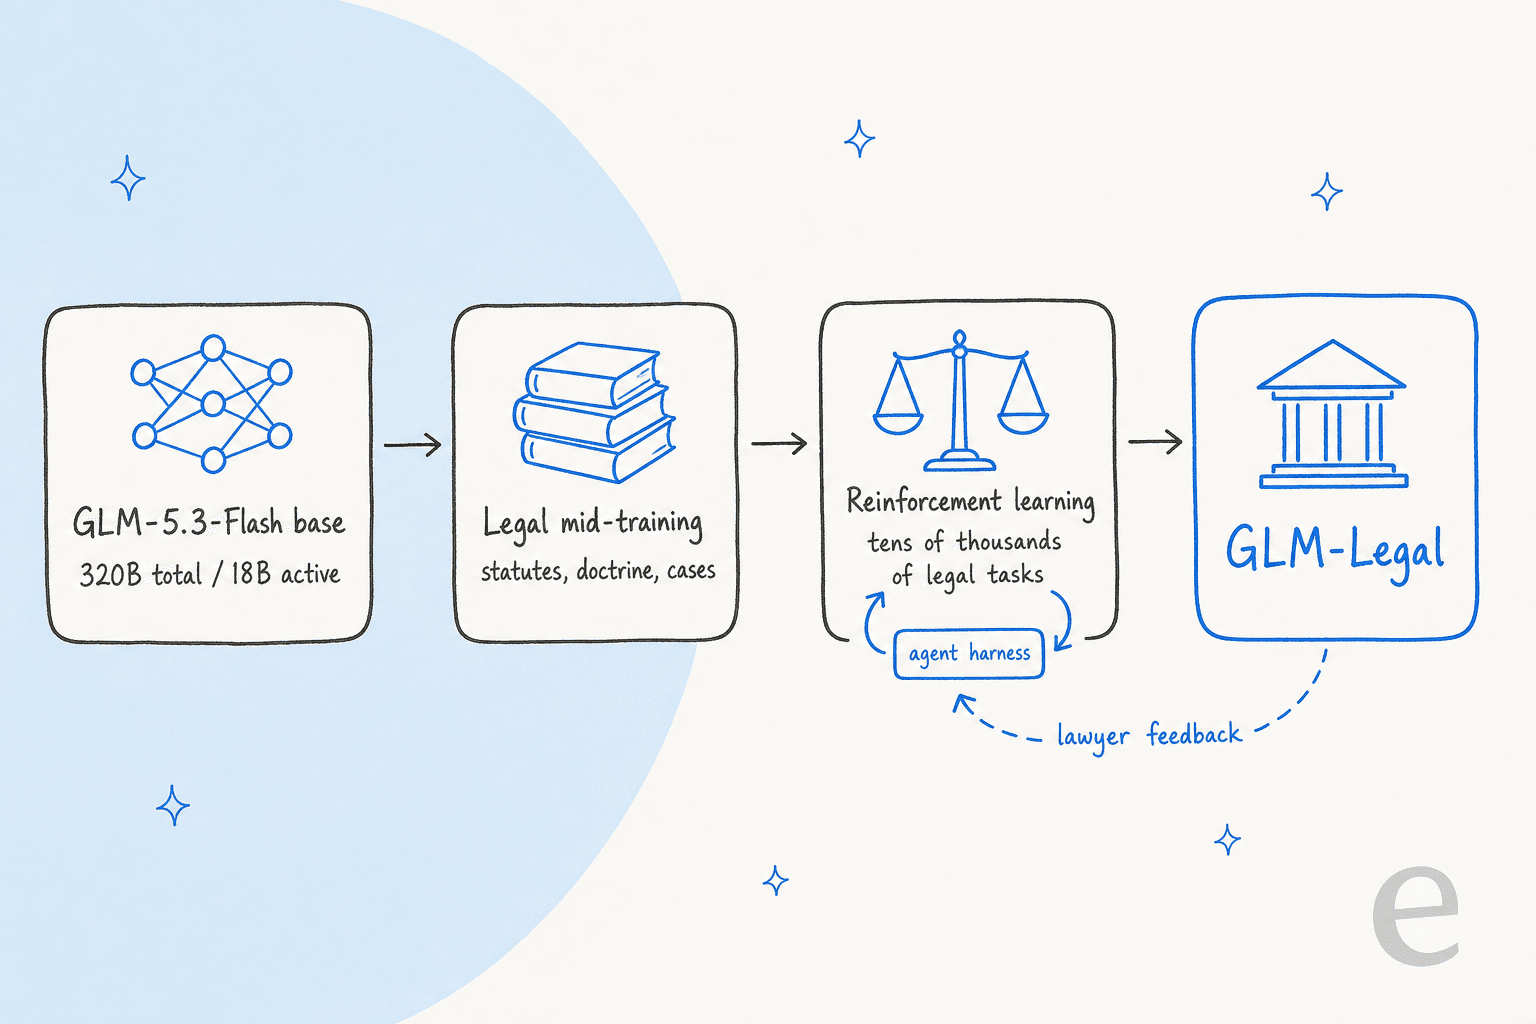
1. Treinamento intermediário em texto jurídico. A Z.ai "expanded the volume of high-quality legal corpora" para que o modelo aprenda leis, doutrina e como os advogados as interpretam. É a jogada padrão dos LLMs de domínio específico e, sozinha, ajuda sobretudo na lembrança de informações.
2. Aprendizado por reforço dentro de um arnês de agente. Esta é a parte a que eu prestaria atenção. O modelo foi treinado "across tens of thousands of realistic legal environments", onde planeja uma análise, abre arquivos, redige um entregável e recebe nota. O arnês (o código que entrega ao modelo seus arquivos e ferramentas) foi treinado junto. Quando o modelo falhava, a Z.ai corrigia também o arnês, e vice-versa.
Faz anos que construo agentes sobre modelos gerais, e a maioria dos bugs que persigo não é "o modelo é burro". É "o modelo não leu o arquivo certo" ou "formatou a resposta errado para a etapa seguinte". Treinar modelo e arnês juntos ataca exatamente essa classe de falha. Também significa que o GLM-Legal provavelmente se comportará melhor dentro do arnês da própria Z.ai, o AutoClaw, e de forma menos previsível dentro do seu.
3. Um ciclo com advogados em atividade. A Z.ai diz que advogados avaliam as saídas com perguntas como "Are all critical issues and edge cases addressed?" e "Are arguments well-substantiated and citations legally sound?" Essas notas alimentam a rodada seguinte de treinamento.
Nada disso é publicado como um artigo com as fontes de dados. Um comentarista do HN apontou que, sem conhecer o conjunto de treinamento, não dá para descartar tarefas muito parecidas com as do teste. Tenha isso em mente na próxima seção.
As três demos que a Z.ai mostra
O post de lançamento compara o GLM-5.3-Flash e o GLM-Legal nas mesmas três tarefas. A diferença é sobretudo de especificidade. Num contrato de serviços de software, o modelo base sugere "consider shortening the notice period". O GLM-Legal diz para reduzir "from 60 to 30 days", remover o prazo de correção para violações de propriedade intelectual, confidencialidade e segurança de dados, e acrescentar "up to 90 days of transition assistance".
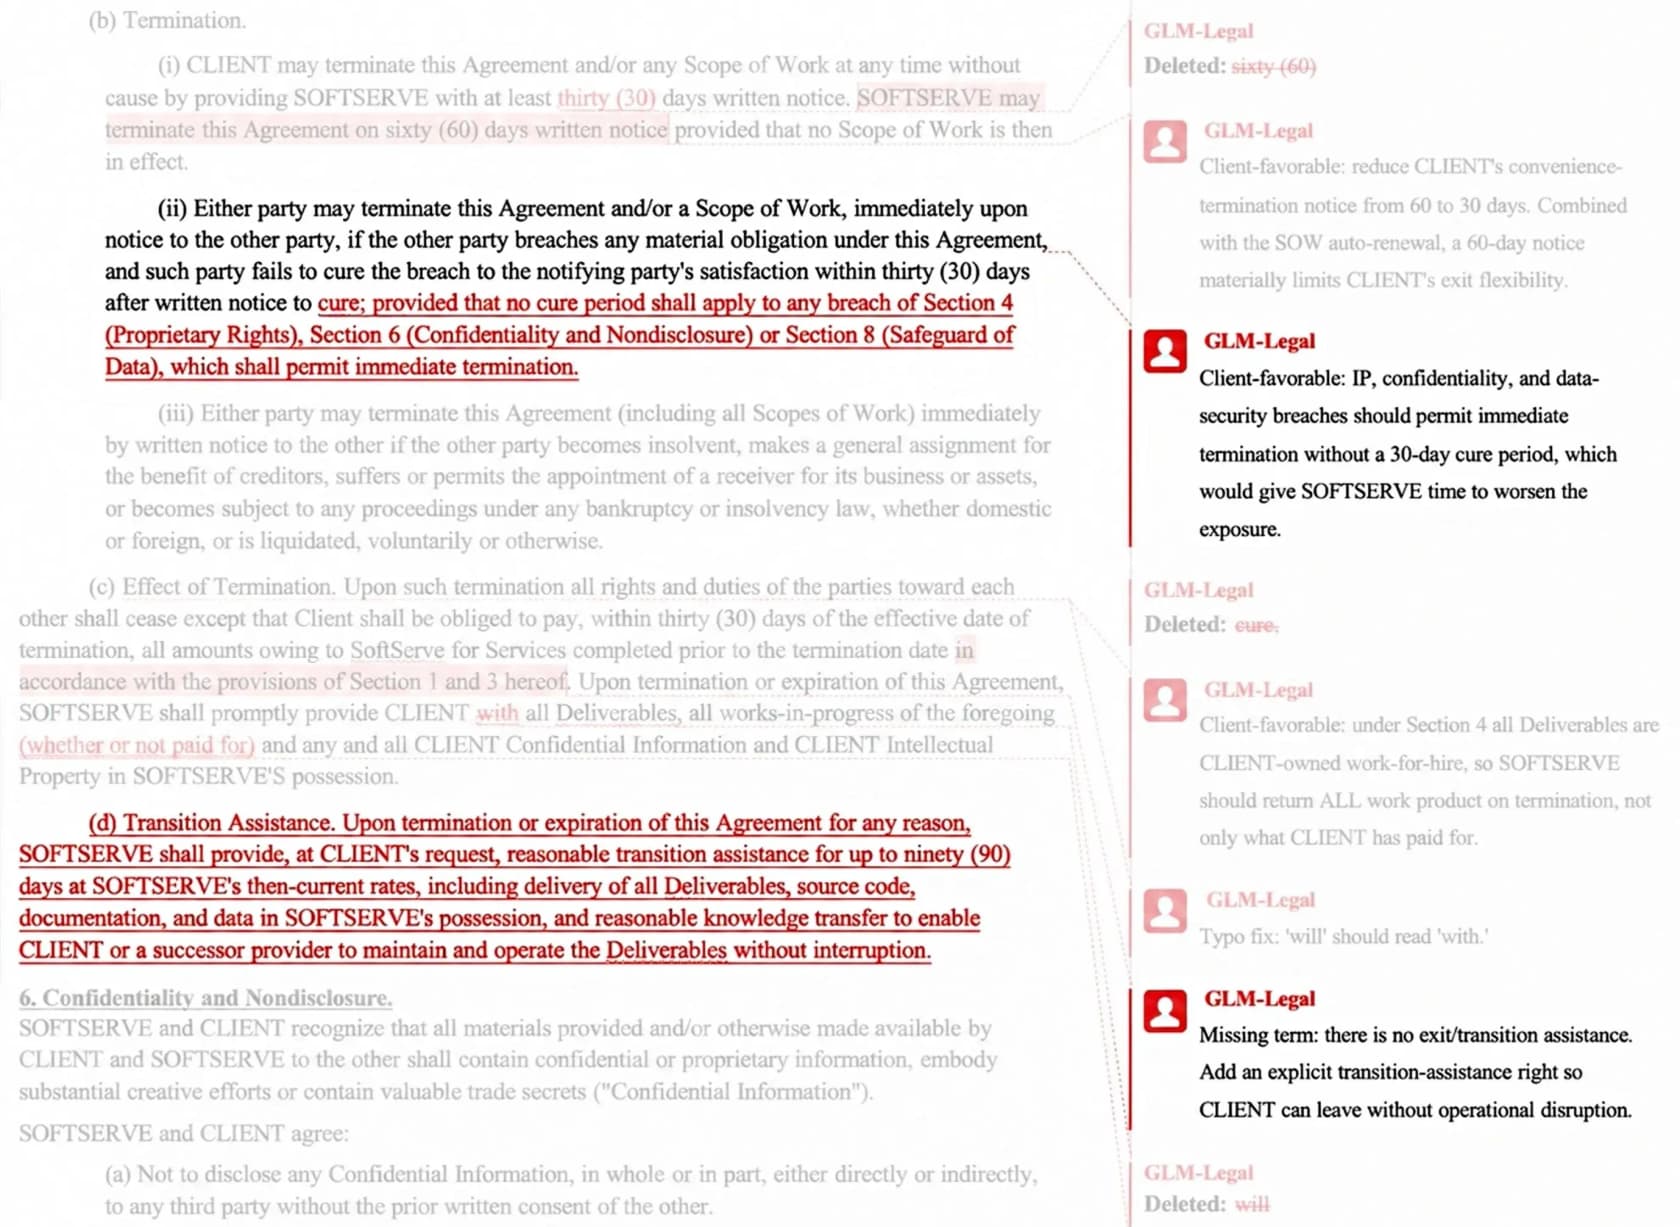
A saída chega como alterações rastreadas e comentários num arquivo do Word, que é o formato certo: o advogado aceita ou rejeita cada edição em vez de confiar num resumo.
A segunda demo lê 40 documentos de uma disputa de projeto de software e monta uma cronologia com cada item citado a um número de documento. O GLM-Legal liga um relatório ao cliente de "60% complete" a um instantâneo interno de cerca de 41% e a um e-mail mandando a equipe continuar faturando. A terceira planeja a conformidade de privacidade para um lançamento em Singapura, Malásia e Indonésia, com referências a seções da lei de dados de cada país.
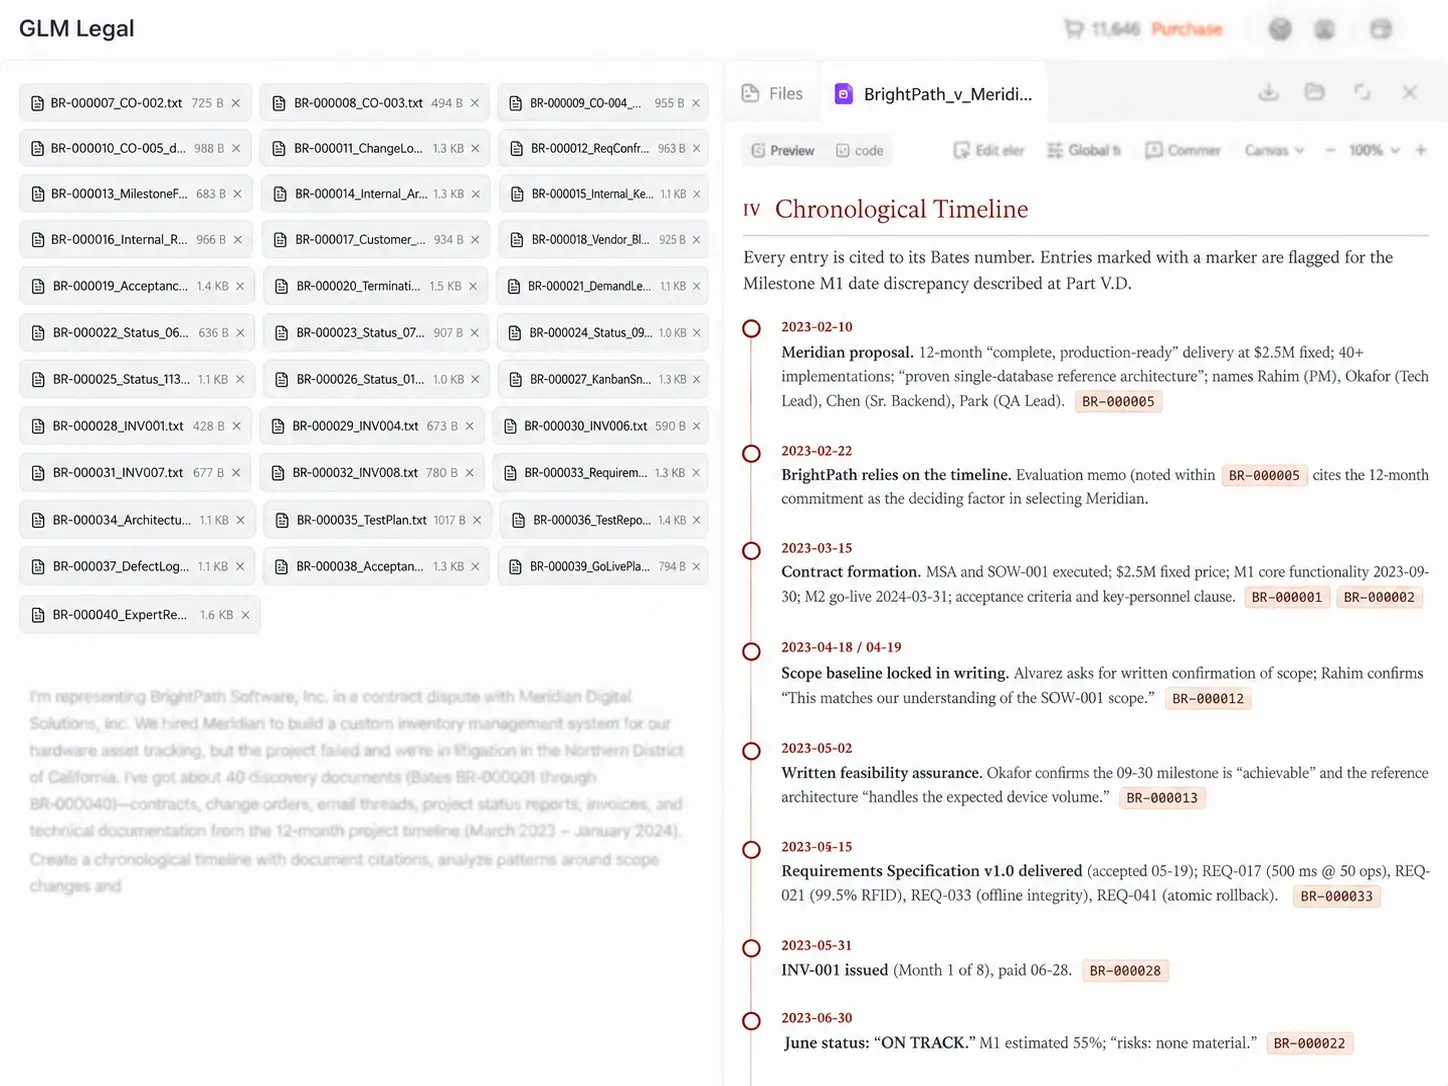
Esses exemplos são escolhidos a dedo por definição. Ainda assim, o hábito que mostram (citar o documento-fonte de cada afirmação) é o que torna a saída da IA verificável, e verificável importa mais que esperto no trabalho jurídico.
Benchmarks do GLM-Legal: o que os 19,2% realmente significam
O gráfico da Z.ai compara o GLM-Legal com seu próprio modelo base, o Kimi K3, o Claude Fable 5 e o GPT-6 Astra em três testes.
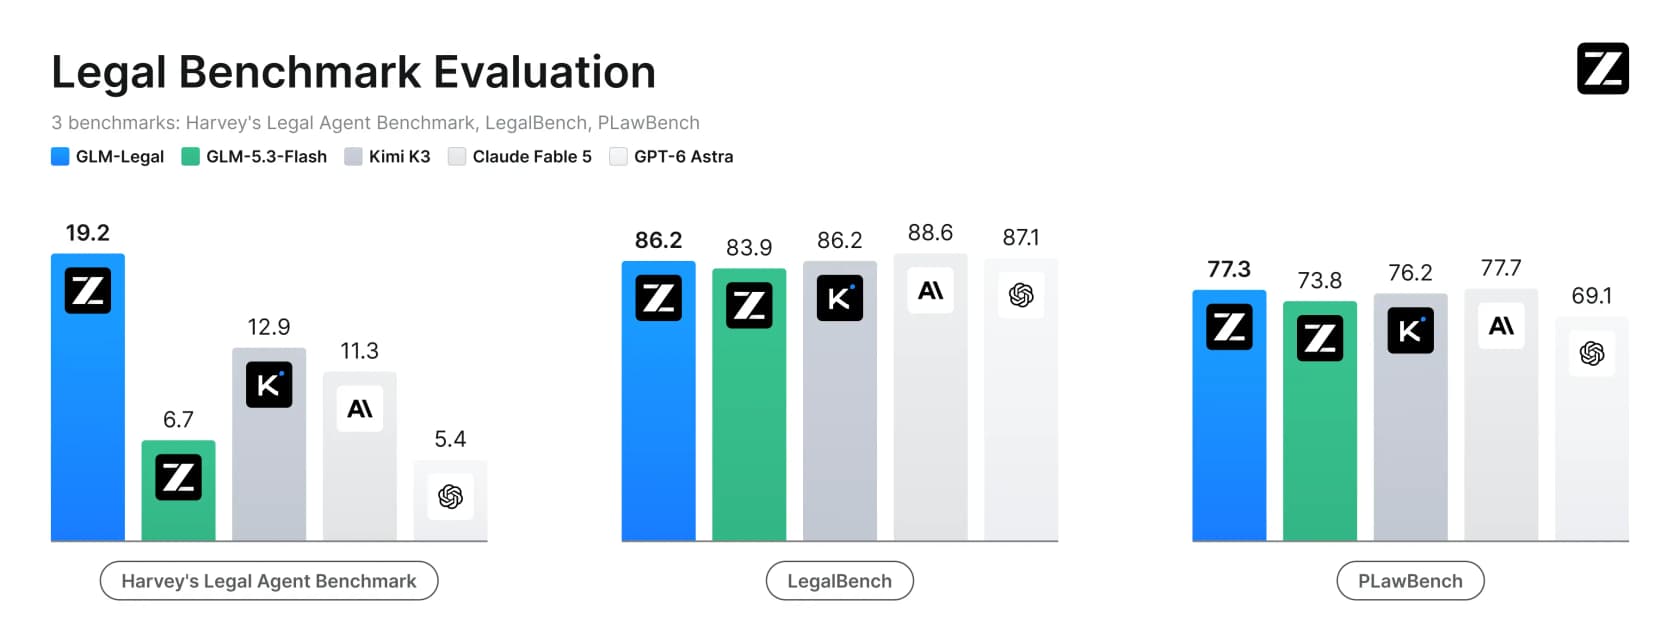
| Benchmark (gráfico da Z.ai) | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench (direito chinês) | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
Lendo com atenção, "matches frontier models" quer dizer algo mais estreito do que parece. O GLM-Legal vence uma coluna com clareza. No LegalBench e no PLawBench, empata ou fica um ou dois pontos atrás do Claude Fable 5. Ainda é um resultado forte para um modelo com 18B de parâmetros ativos, mas é paridade nos testes mais antigos e liderança num novo.
Por que as notas parecem tão baixas
O Legal Agent Benchmark da Harvey dá a um agente uma pasta de arquivos, seis ferramentas (ler, editar e gravar arquivos, mais busca e um shell) e habilidades de Word, Excel e PowerPoint. Cada tarefa tem uma rubrica de critérios, e o número principal é uma taxa de aprovação total: a tarefa só conta se todos os critérios forem aprovados.
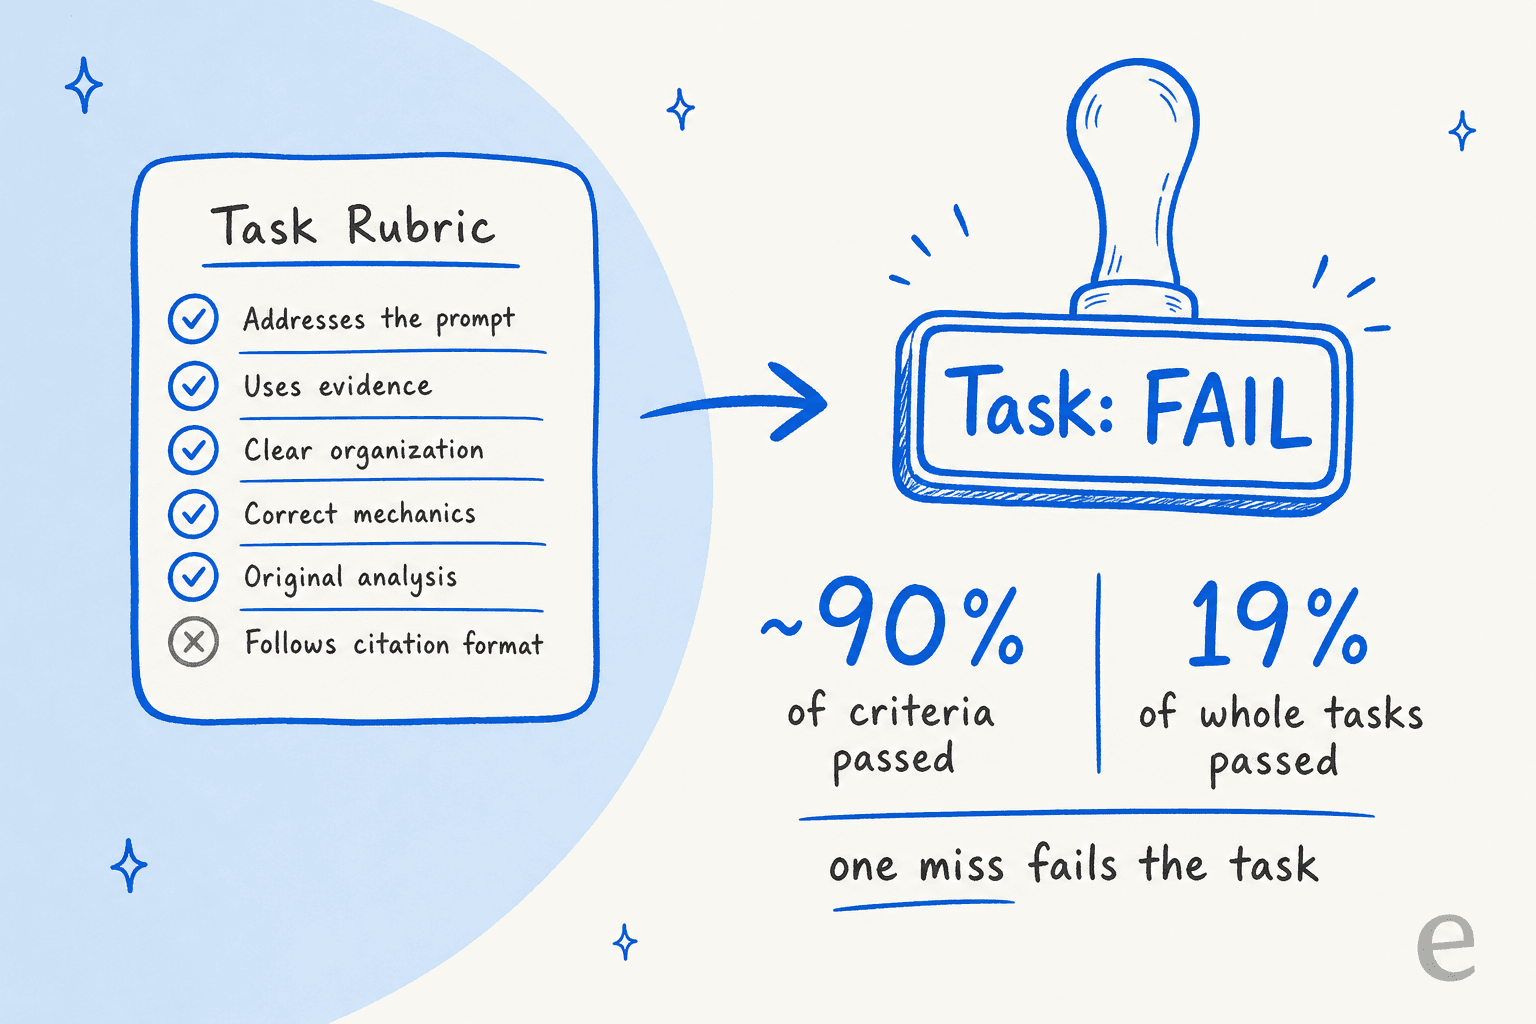
A Vals observa que os melhores modelos aprovam cerca de 90% dos critérios individuais, enquanto a melhor nota por tarefa inteira é 25,42%. Então um modelo de 19% não erra quatro em cada cinco vezes. Normalmente acerta a maior parte do trabalho e deixa passar um requisito. No trabalho jurídico, essa única falha pode ser o problema todo, e por isso a pontuação rigorosa é defensável.
"This is why I severely dislike using all pass rate. A model could be at like 93%, meeting practically every requirement except the broken ones and all pass would give it like 20%."

O que o ranking independente acrescenta
A Z.ai enviou o GLM-Legal à Vals AI para teste independente, e o ranking HLAB da Vals é a visão mais útil porque inclui todo mundo:
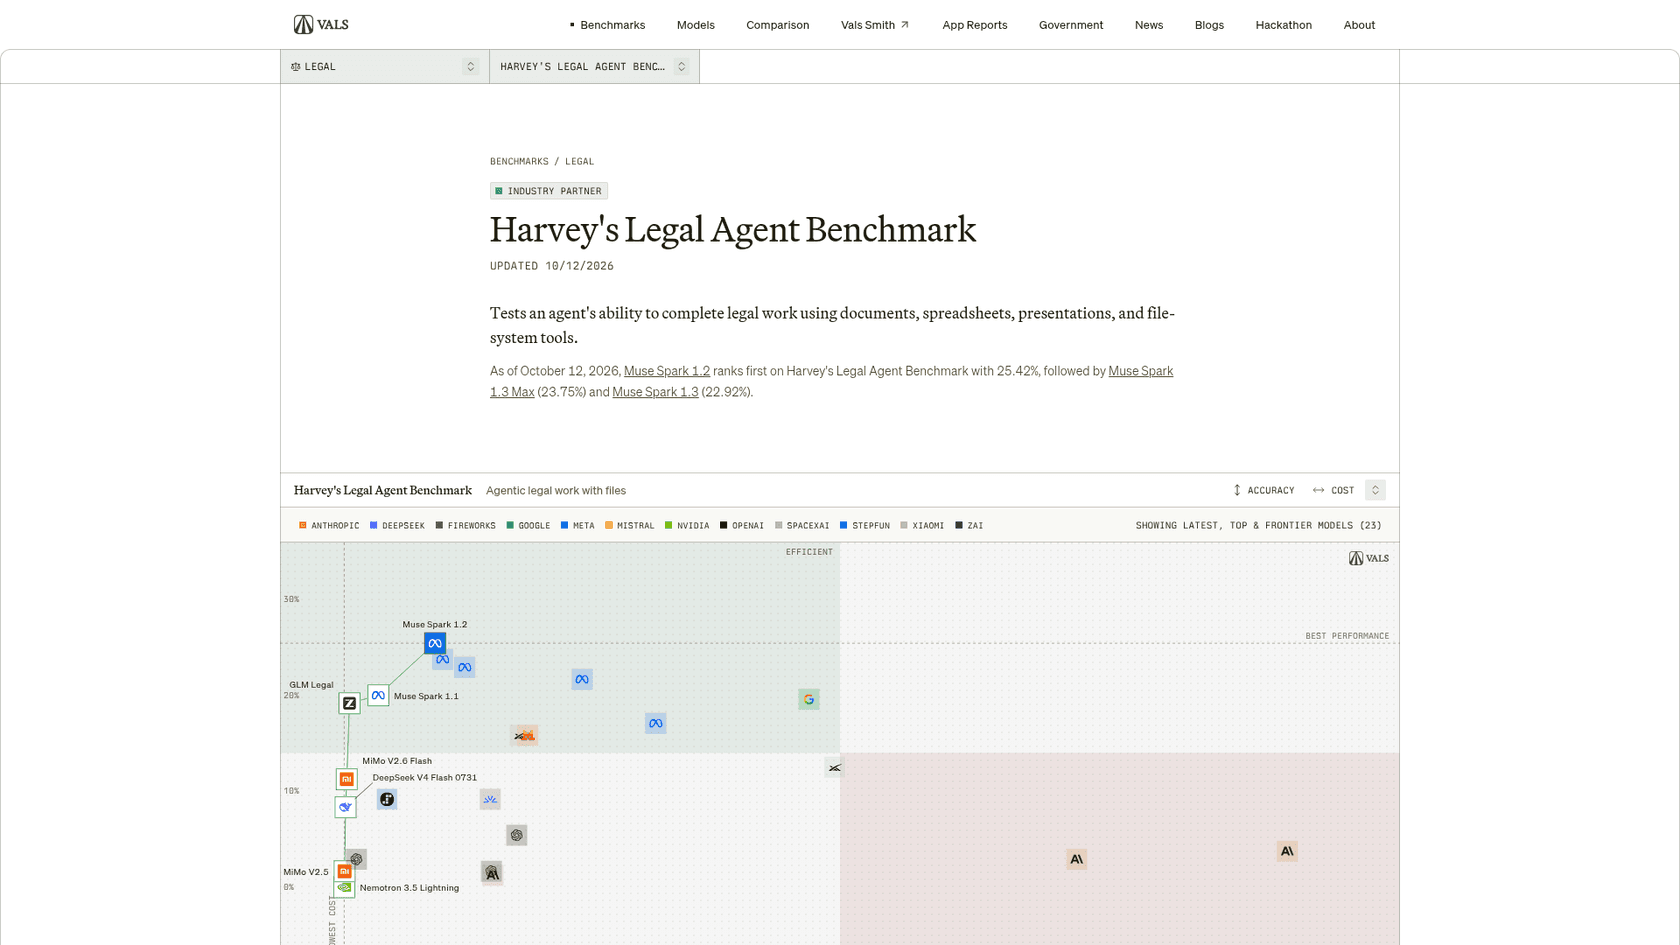
| Posição | Modelo | Taxa de aprovação por tarefa | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25.42% | $2.09 | 24m16s |
| 2 | Muse Spark 1.3 Max | 23.75% | $2.26 | 14m43s |
| 3 | Muse Spark 1.3 | 22.92% | $2.76 | 17m04s |
| 4 | Muse Wonder Full | 21.67% | $5.41 | 53m21s |
| 6 | Gemini 4 Argon | 19.58% | $10.55 | 43m55s |
| 7 | GLM-Legal | 19.17% | $0.15 | 1h12m |
| 9 | Mistral Large 4 | 15.83% | $4.18 | 39m25s |
| 12 | Kimi K3 | 12.92% | $3.83 | 13m58s |
| 31 | GLM-5.3-Flash (base) | 6.67% | $0.57 | 52m17s |
| 41 | Claude Opus 5.5 | 3.75% | $21.38 | 52m55s |
Duas coisas se destacam. Primeiro, o salto de 6,67% para 19,17% são exatamente os 12,5 pontos que a Z.ai afirma, então o número do fornecedor se sustenta. Segundo, quatro modelos da Meta superam o GLM-Legal e nenhum aparece no gráfico da Z.ai. Um comentarista do HN notou isso no dia do lançamento. Na página do modelo na Vals, o GLM-Legal também marca 86,23% no LegalBench (14º de 150, o melhor resultado de um GLM ali) e 41,83% no Legal Research Bench (24º de 78).
O teste da Harvey em si também tem críticos. Um comentarista do HN que examinou rastros de agentes disse ter "found multiple problematic tasks and rubrics" e linkou uma issue aberta no repositório da Harvey. Uma margem de ±3,25 pontos sobre uma nota de 19% é ampla. Eu trataria o GLM-Legal e o Gemini 4 Argon como empatados, não como ordenados.
A história de verdade: custo por tarefa e a espera
Se o GLM-Legal tivesse chegado a 19% por US$ 10 a tarefa, ninguém estaria escrevendo sobre ele. O que importa é a conta.
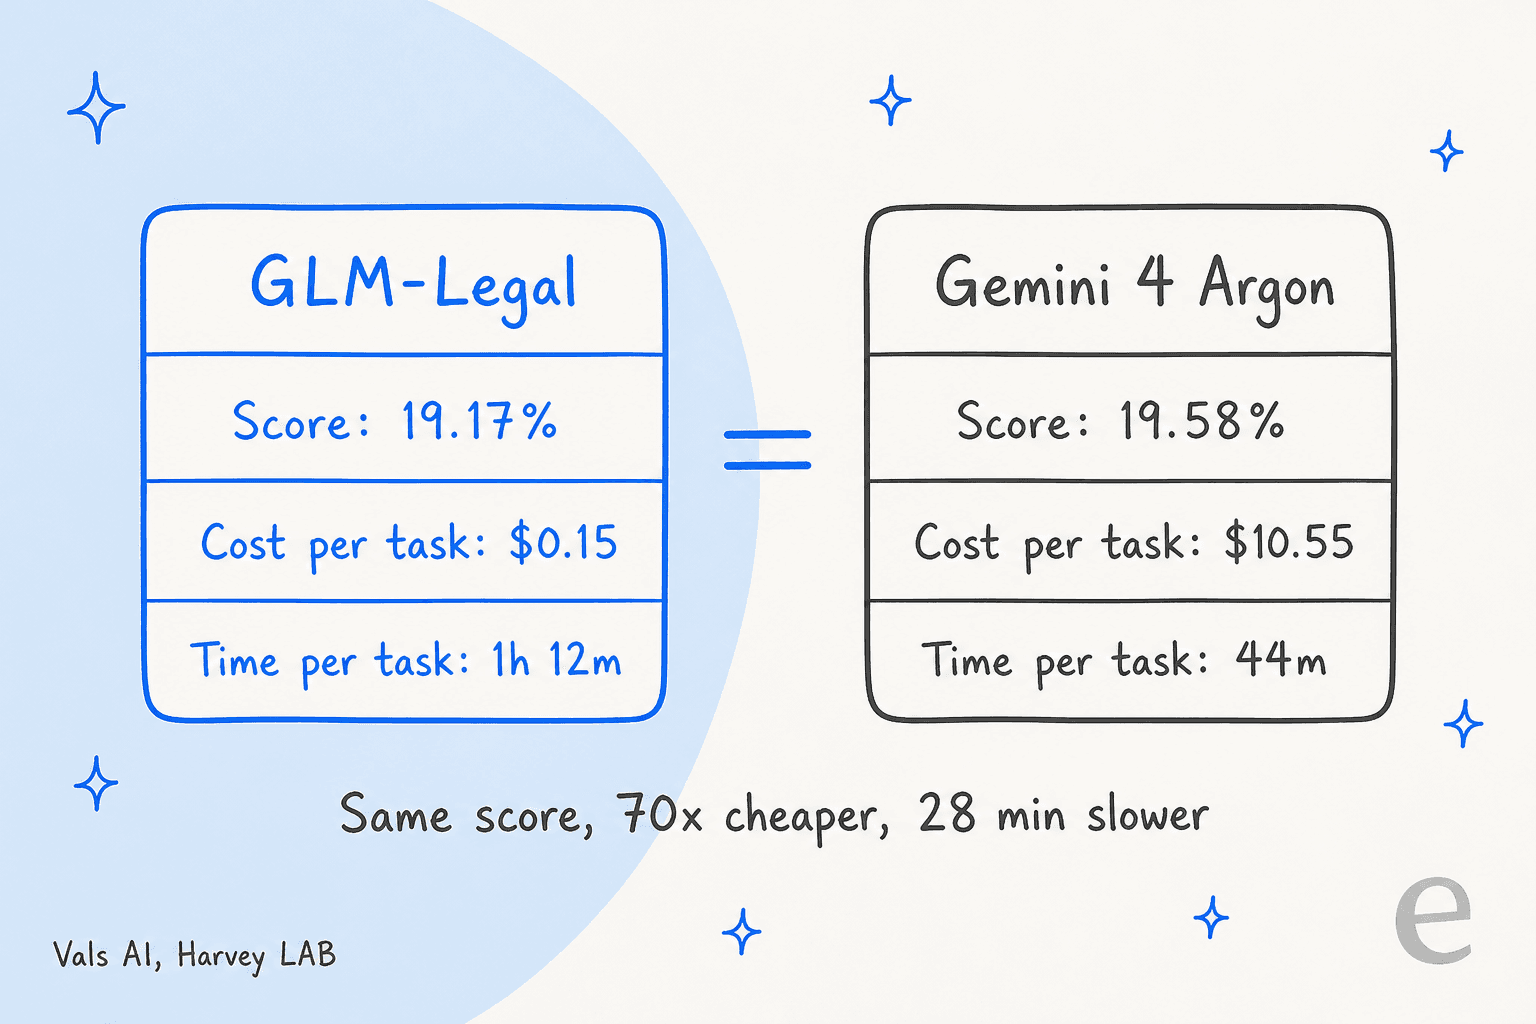
Pelos números da Vals, o GLM-Legal alcança a nota do Gemini 4 Argon por cerca de 1/70 do custo, e a Vals o chama de o modelo mais barato do top 10. O porém é o tempo: 72 minutos por tarefa contra 44 do Argon e 24 do líder. Para um lote noturno de revisões de due diligence, isso não importa. Para um advogado esperando um redline antes de uma ligação, importa.
Informe o seu volume mensal de tarefas para ver como a troca se comporta:
Com 500 tarefas por mês, os números da Vals dão cerca de US$ 75 para o GLM-Legal contra US$ 5.275 para o Gemini 4 Argon, com aproximadamente 600 horas de agente contra 366. O Muse Spark 1.2 fica no meio, com cerca de US$ 1.045, e aprova mais tarefas que os dois. Se você olhar só nota por dólar, o GLM-Legal ganha com folga. Se olhar aprovações por hora, ganha o modelo da Meta.
Preço e acesso do GLM-Legal
Esta é a parte do lançamento que ainda está quase em branco. Tudo o que é público hoje:
| Pergunta | Resposta em 14 de outubro de 2026 |
|---|---|
| Posso me cadastrar e usar? | Não. Você preenche o formulário de consulta (empresa, porte, cargo, caso de uso) para solicitar acesso à API |
| Existe preço do GLM-Legal? | Não na página de preços da Z.ai |
| Quanto custa o modelo base? | GLM-5.3-Flash: US$ 0,15 por 1M de tokens de entrada, US$ 0,03 em cache, US$ 0,50 de saída |
| Em que tarifa a Vals testou? | US$ 0,075 de entrada e US$ 0,25 de saída, a promoção de lançamento do Flash que terminou em 9 de setembro |
| Posso usar no AutoClaw? | "Soon", segundo o post de lançamento |
| Posso baixar os pesos? | Hoje não; não há repositório do GLM-Legal na página da Z.ai no Hugging Face |
A questão dos pesos está em aberto. A ficha do modelo na Vals diz "Weights: Open", enquanto o post de lançamento da Z.ai nunca menciona licença e vários leitores do HN concluíram que é fechado. O modelo base é aberto, como mostra minha análise do GLM-5.3-Flash. Até a Z.ai publicar pesos ou uma licença, eu planejaria como se o GLM-Legal fosse só por API. Para um detalhamento completo da tabela de preços do modelo base, veja preços do GLM-5.3-Flash.
Isso importa por um motivo acima dos demais: para onde vão os documentos dos clientes. Escritórios que não enviam um contrato à API de um laboratório americano dificilmente o enviarão à de um chinês, e um lançamento só por API fecha o caminho de hospedagem própria que tornou modelos GLM anteriores populares entre equipes sensíveis à privacidade.
"Wait, so this not an open weight model, correct? Only available via z.ai?"
O que advogados e desenvolvedores estão dizendo
A discussão no HN se dividiu em mais ou menos três grupos. Advogados em atividade não ficaram impressionados com o número absoluto:
"As an attorney, I am not particularly impressed about a 20% pass rate on a benchmark. The name of the game for litigation practice is about being prepared for novel situations, not relitigating past ones."
Quem conhece o benchmark apontou a posição relativa:
"To be fair to them, on this particular benchmark (Harvey's Legal Agent) 20% puts it almost top of the pack of any model, and certainly top for any remotely in its price class."
E um terceiro grupo se preocupou com o problema mais antigo da IA jurídica: jurisprudência inventada. Um comentarista notou que o lançamento se apoia em "tracked changes and human review", mas não diz nada sobre pegar "LLMs outright hallucinating cases or holdings". Outro, advogado, fez uma observação mais sutil sobre redlining: "I don't just see what's there but also what is missing." Perceber uma cláusula ausente é mais difícil para um modelo do que editar uma presente.
No X, a resposta mais votada ao anúncio da Z.ai foi simplesmente "We need glm illegal", com mais de 1.200 curtidas. A internet continua sendo a internet.
GLM-Legal versus modelos de fronteira e produtos de IA jurídica
Vale manter três comparações separadas.
Contra os modelos gerais de fronteira, o GLM-Legal vence no teste de agentes da Harvey e empata mais ou menos no LegalBench. O Claude Opus 5.5 custa cerca de 140 vezes mais por tarefa na execução da Vals e marca 3,75%. Um modelo geral continua sendo a melhor escolha se o seu trabalho jurídico está misturado com todo o resto, ou se você precisa de entrada de imagem, que o GLM-Legal não aceitou nos testes da Vals.
Contra a linha Muse Spark da Meta, o GLM-Legal perde em nota e velocidade. O Muse Spark 1.2 aprova um terço a mais de tarefas em um terço do tempo, por cerca de US$ 2 cada. Se US$ 2 por tarefa é aceitável, o modelo da Meta é hoje a escolha mais forte.
Contra produtos jurídicos como a Harvey AI, não é a mesma categoria. A Harvey vende os fluxos de trabalho, permissões, trilhas de auditoria e a implantação no escritório em torno dos modelos, e seu preço reflete isso. O GLM-Legal é um componente sobre o qual uma empresa de legal tech poderia construir. O comentarista do HN que se perguntou se isso tem relação com as margens da Harvey apontava para isso: modelos especializados baratos deixam a camada de produto como a única parte pela qual ainda se pode cobrar. Minha análise da Harvey AI mostra o que essa camada realmente faz.
Então, quem deve solicitar a beta? Equipes de legal tech com revisão de primeira passada noturna e de alto volume (due diligence, triagem de contratos, cronologias de discovery) em que uma pessoa confere cada saída de qualquer forma. Aí, US$ 0,15 e 72 minutos é uma ótima troca. Todos os demais podem esperar por preço, pesos e uma análise independente de alguém que o tenha usado em casos reais. Se você procura uma ferramenta pronta em vez de um modelo, minha lista de ferramentas de escrita com IA para escritórios de advocacia é um ponto de partida melhor.
O que o GLM-Legal significa se você lidera uma equipe de suporte
A maioria das pessoas que lê sobre um modelo jurídico não trabalha num escritório de advocacia. Lidera uma equipe de suporte ou operações que responde a perguntas com arestas jurídicas: termos de reembolso, pedidos de garantia, solicitações de exclusão de dados, "can you send me a copy of my data under GDPR."
Um modelo jurídico é a ferramenta errada para isso. Essas perguntas não tratam de jurisprudência. Tratam da sua política, escrita na sua central de ajuda e nos seus documentos internos, e a resposta certa é o que a sua política diz, mesmo que um modelo mais inteligente pudesse argumentar o contrário. É um problema de recuperação com repasse para uma pessoa, não de raciocínio.
Passei anos construindo na eesel os agentes que ficam em filas de suporte reais, e a lição do benchmark do GLM-Legal é a que continuamos reaprendendo: a saída perigosa é a que passa em 90% das verificações. Um líder de suporte de uma marca DTC de suplementos colocou a exigência com clareza numa ligação conosco:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
É por isso que rodamos cada implantação da eesel contra os tickets históricos de uma equipe antes que ela responda a um cliente de verdade, e por isso tudo que envolva reembolsos, ameaças legais ou conformidade de dados pode ser encaminhado direto a uma pessoa. Nosso guia de alucinações cobre a configuração. Se você atende clientes do setor jurídico, atendimento ao cliente com IA para o jurídico aprofunda esse caso.
Experimente a eesel
O GLM-Legal é infraestrutura: um modelo que você solicita, conecta a um arnês, escreve prompts, monitora e paga por token. A eesel é o funcionário. O colega de helpdesk com IA entra na sua fila atual no Zendesk, Freshdesk, Gorgias e nos demais, aprende suas políticas de reembolso, garantia e dados a partir da sua central de ajuda e de tickets antigos, e passa para uma pessoa, com um resumo, tudo de que não tiver certeza. Antes de responder a qualquer pessoa, você pode ver como ele teria respondido a centenas dos seus tickets históricos.

Se a sua equipe preferir operá-lo pelo terminal, a CLI da eesel permite ler e editar as regras permanentes do colega, revisar ações aguardando aprovação e ver o que ele fez e por quê, para que um agente de código gerencie seu colega de suporte como gerencia seu repositório. Se você escreve conteúdo, a mesma equipe inclui um redator de blog com IA.
Quer uma IA que responda perguntas de política a partir das suas próprias políticas e saiba quando parar? Experimente a eesel nos tickets do mês passado e veja quais ela teria resolvido.