

O Granite 4.2 da IBM é uma família de pesos abertos realmente boa: três modelos de raciocínio pequenos (3B, 8B, 30B), Apache 2.0, pensamento alternável e barato de operar. A maioria procura uma alternativa por um de três motivos: quer mais capacidade bruta (geralmente para programação), quer algo ainda mais barato em escala, ou precisa de um modelo com licença mais amigável ou de uma API gerenciada e hospedada.
Aqui vai a versão curta de quem escolher:
- Qwen 3.8 se você quer a maior capacidade bruta, principalmente em programação. Checkpoint aberto de 27B, Apache 2.0.
- DeepSeek V4 Flash se o custo em escala é o que importa. Licença MIT, a opção séria mais barata aqui.
- GLM 5.3 Flash se você quer agentes baratos, multimodais e bons em ferramentas com pesos abertos.
- Kimi K3 se você roda trabalho agêntico de longo prazo e aceita pagar mais por isso.
- Mistral (Large 3 + modelos abertos) se você valoriza um fornecedor europeu e licenciamento on-prem limpo.
- Google Gemini 3.6 Flash se você prefere uma API gerenciada e hospedada a hospedar qualquer coisa por conta própria.
- NVIDIA Nemotron 3 se você vive em hardware NVIDIA, ou quer pesos e receitas de treinamento abertas.
Uma coisa que vale dizer logo de início, porque construir IA de suporte é o meu trabalho diário: todo modelo desta lista é um motor, não um produto. Se o que você quer de verdade é um agente de IA que resolva tickets, o modelo é os 10% fáceis; o conhecimento, as integrações e as barreiras de segurança são os outros 90%. Mais sobre isso no final.
Por que as pessoas procuram uma alternativa ao Granite 4.2
Primeiro, vamos ser justos com o Granite, porque ele merece (mergulhei fundo na família na minha análise completa do Granite 4.2). O Granite 4.2 foi lançado em 25 de agosto de 2026 como três modelos de raciocínio densos sob a licença Apache 2.0. Os pequenos rodam rápido em hardware comum (o 3B é um download de 2,2 GB), os dados de treinamento são recentes, e o consenso da comunidade é que o Granite é discretamente excelente em trabalho estruturado e embasado: chamada de ferramentas, resumos, e marcação de documentos e extração. Se você precisa de um modelo on-prem e licenciável que se comporte bem em um loop de agente, é um padrão forte.
Então por que trocar? Alguns motivos reais aparecem o tempo todo, e nenhum deles é conversa de marketing.
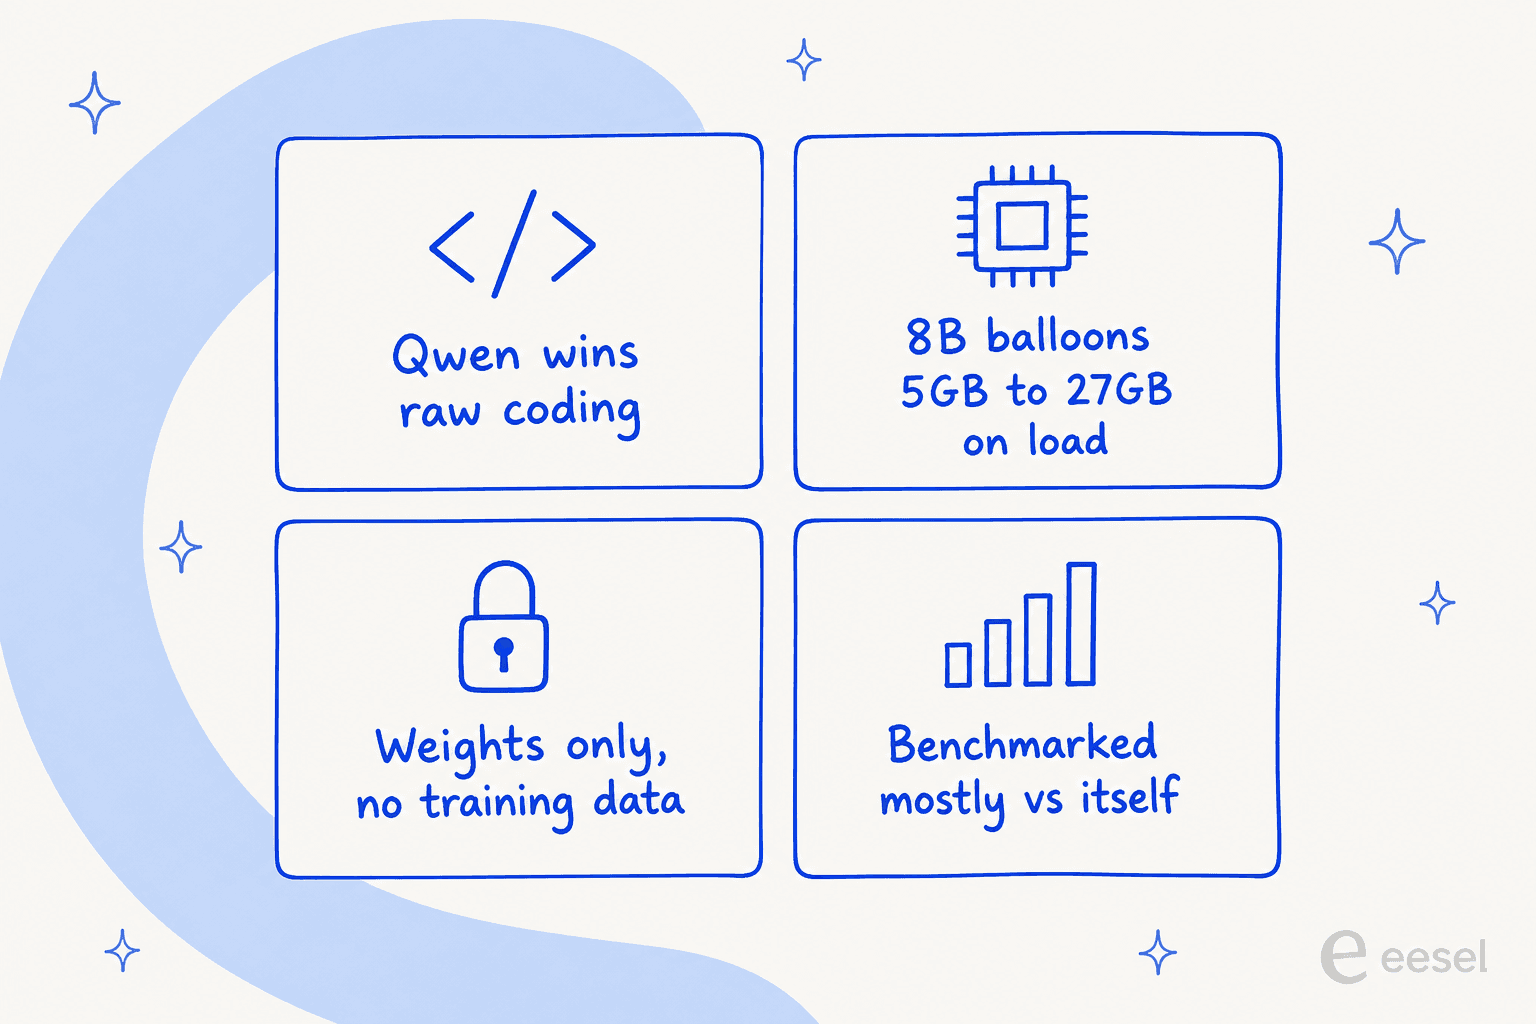
Capacidade bruta, principalmente em programação. Esse é o motivo mais citado. No Hacker News, a frase recorrente é direta:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."

Mesmo quem gostou do Granite manteve o velho favorito para o trabalho pesado:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly. Qwen3.6 35b a3b is still my local champion but I may use this for auto complete and small tasks."
A IBM se compara principalmente consigo mesma. As fichas de modelo do Granite o comparam com versões anteriores do Granite e um conjunto restrito de rivais como o Nemotron da NVIDIA e o Gemma do Google, não com o Qwen. Isso gera um tipo específico de ceticismo:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."
Um problema operacional real. O 8B é um download de 5,3 GB, mas uma thread do r/LocalLLaMA bastante compartilhada apontou que ele pode inchar para 27 GB na memória ao carregar, depois que o cache KV é alocado, o suficiente para tirá-lo de uma GPU de consumo. Vale checar isso antes de se comprometer.
"Só pesos não é realmente código aberto." O Granite entrega pesos sob Apache 2.0, mas não os dados nem a receita de treinamento, e parte da comunidade mantém uma linha mais rígida sobre o que "aberto" deveria significar. Se reprodutibilidade importa para você, essa lacuna é um motivo para olhar modelos que publicam mais.
Há também o ângulo prático do custo. Digamos que você rode uma carga de suporte de 5 milhões de tokens de saída por mês. Na tarifa hospedada confirmada mais barata do Granite 4.2, isso dá cerca de $1.25; no Kimi K3, os mesmos tokens custam $75. Essa diferença de 60 vezes é exatamente o motivo pelo qual vale responder com cuidado à pergunta "qual alternativa", em vez de pegar o que liderou um ranking na semana passada.
Como escolhi estas alternativas
Pesei a lista em direção ao que o Granite realmente é: um modelo aberto, de porte pequeno a médio e com capacidade de raciocínio que você pode hospedar por conta própria a baixo custo. Então o critério foi:
- Pesos abertos primeiro. Seis dos sete publicam pesos para download, porque esse é o motivo de as pessoas rodarem o Granite em vez de uma API fechada. O Gemini 3.6 Flash é a única escolha só hospedada, incluída porque muitas equipes trocariam de bom grado a abertura por um endpoint gerenciado.
- Raciocínio e uso de ferramentas. O destaque do Granite é o pensamento alternável e a chamada de ferramentas apoiada em raciocínio, então todo modelo aqui consegue raciocinar e chamar ferramentas em um loop de agente.
- Preços reais e verificáveis. Nada de "fale com vendas". Todo preço abaixo remete a uma página do fornecedor. (Se a sua pergunta real é qual motor colocar atrás de um bot de suporte, comparei isso separadamente em melhor modelo de IA para tickets de suporte.)
- Apenas fontes primárias. As especificações vêm de fichas de modelo e páginas de preços; a opinião vem do Hacker News, Reddit e X, não de listas de agregadores.
Aqui está o panorama inteiro de relance antes de irmos ferramenta por ferramenta.
| Modelo | Melhor para | Pesos abertos | Licença | Contexto | Hospedado entrada/saída por 1M | Raciocínio |
|---|---|---|---|---|---|---|
| Granite 4.2 (o atual) | Agentes corporativos on-prem | Sim | Apache 2.0 | 128K–512K | $0.06 / $0.25 | Alternável |
| Qwen 3.8 | Capacidade bruta de programação | Sim (27B Apache) | Mista | 1M | $2 / $6 (Max) | Ligado (xhigh) |
| DeepSeek V4 Flash | Custo em escala | Sim | MIT | 1M | $0.22 / $0.66 (fora do pico) | Ligado (high) |
| GLM 5.3 Flash | Agentes multimodais baratos | Sim | Aberta | 1M | $0.075 / $0.25 (promo) | Só pensamento |
| Kimi K3 | Agentes de longo prazo | Sim | Modificada | 1M | $3 / $15 | Sempre ligado |
| Mistral Large 3 | Europeu / on-prem | Parcial (modelos pequenos Apache) | Mista | 128K+ | $0.50 / $1.50 | Opcional |
| Gemini 3.6 Flash | API gerenciada hospedada | Não | Proprietária | 1M | $1.50 / $7.50 | Opcional |
| NVIDIA Nemotron 3 | Stack NVIDIA, receitas abertas | Sim | Aberta | até 1M | Endpoints gratuitos / computação | Sim |
As 7 melhores alternativas ao Granite 4.2 em 2026
1. Qwen 3.8 - o melhor em capacidade bruta e programação
Melhor para: equipes que escolheram o Granite pela licença mas esbarram sempre no teto dele em programação e raciocínio difíceis.
Se há um único modelo que a turma de LLMs locais escolhe no lugar do Granite, é o Qwen. A comparação é tão automática que, quando o Granite 4.2 foi lançado, a pergunta mais comum no X era literalmente como ele se comparava:
"Anyone tested Granite 4.2 30B from IBM yet? How does it compare to Qwen-3.8-27B?"
O Qwen 3.8 vem em dois formatos. O carro-chefe Qwen 3.8 Max é um modelo de mistura de especialistas de 2,4T parâmetros (95B ativos) com contexto de 1M de tokens, vendido como API hospedada. Abaixo dele fica o checkpoint aberto Qwen3.8-27B sob uma licença Apache 2.0 de verdade, a comparação direta com os tamanhos abertos do Granite. Vale saber: os pesos base abertos do Max usam a licença restritiva da própria Alibaba, não Apache, então "Qwen aberto" com liberdade comercial significa o 27B, não o gigante.
Onde supera o Granite: capacidade bruta, ponto final. No LMArena, o Qwen 3.8 Max fica perto do topo em texto e desenvolvimento web, e o veredito da comunidade sobre programação é definitivo. O contexto de 1M também deixa pequeno os 128K nativos do Granite.
Onde fica a dever: a opção limpa com Apache é o 27B, não o Max de vitrine, então a história de abertura é mais estreita do que parece. E o arnês de programação do próprio Qwen vem configurado com um teto de saída de 64K, então o número de "1M de contexto" é mais teórico do que a maioria das cargas jamais vai tocar.
Preços: o 27B aberto é grátis para hospedar. O Qwen 3.8 Max na nuvem da Alibaba custa $2 por milhão de tokens de entrada e $6 por milhão de saída, com leituras de entrada em cache a $0.25.
Veredito: se você saiu do Granite porque ele não acompanhava em programação ou raciocínio difícil, o Qwen é o primeiro lugar para olhar. Fique com o 27B se uma licença limpa importa, ou com o Max hospedado se quer a versão mais forte e não se incomoda com os termos da Alibaba.
2. DeepSeek V4 Flash - o melhor em custo em escala
Melhor para: cargas de alto volume em que a conta por token é o que de fato decide a arquitetura.
O DeepSeek V4 Flash é o campeão de orçamento desta lista e, ao contrário do modelo principal do Qwen, tem licença MIT de verdade, uma das mais permissivas que existem.
É um modelo de mistura de especialistas de 284B parâmetros (13B ativos) com contexto de 1M de tokens, lançado como cerca de 167 GB de pesos abertos. O raciocínio vem ligado por padrão em "high", e aqui está a peculiaridade que o torna interessante: a configuração barata e a boa são literalmente execuções diferentes dos mesmos pesos (a troca entre RAG e LLM puro aparece aqui também, já que pensar mais significa mais tokens cobrados). Os números da própria DeepSeek mostram o Flash marcando 8.1 no HLE com pensamento desligado contra 34.8 com esforço máximo. Você escolhe o quanto ele pensa, e paga os tokens de raciocínio pela tarifa de saída.
Onde supera o Granite: preço e uma licença mais limpa. Também é um modelo muito maior que o 30B do Granite, então com esforço máximo alcança capacidades que os tamanhos pequenos do Granite não alcançam.
Onde fica a dever: é só texto (sem entrada de imagem documentada), pode ser prolixo, e há um problema real de governança de dados. Os termos da API paga da DeepSeek não dizem nada sobre treinar ou não com suas entradas, e o serviço opera sob a lei da RPC, então não serve de imediato para dados regulados de clientes (se você lida com dados de suporte, o ângulo de SOC 2 e GDPR importa aqui). Fique de olho também no relógio de preços: as tarifas dobram nos horários de pico (01:00–04:00 e 06:00–10:00 UTC), que por acaso são fora de expediente para a maioria das filas ocidentais.
Preços: fora do pico, a entrada sem cache custa $0.22 por milhão e a saída $0.66; as tarifas de pico são exatamente o dobro. Hospedar por conta própria os pesos MIT é grátis.
Veredito: se sua carga é grande e seus dados não são regulados, nada aqui bate o DeepSeek em custo por unidade de capacidade. Só monte seu modelo de custos sobre a tarifa de pico para que uma mudança de fuso nunca te surpreenda, e mantenha dados pessoais de clientes fora da API própria.
3. GLM 5.3 Flash - o melhor em agentes multimodais baratos
Melhor para: quem constrói e quer agentes multimodais bons em ferramentas com pesos abertos sem pagar preços de ponta.
O GLM 5.3 Flash, da Z.ai (Zhipu), é o modelo mais novo aqui, e aposta exatamente no nicho agêntico e de chamada de ferramentas onde o Granite é mais forte, e então o supera em preço.
É um MoE de 320B parâmetros (18B ativos), o primeiro modelo nativamente multimodal da linha GLM-5, com contexto de 1M e pesos abertos no Hugging Face. Ele marca 57 no Artificial Analysis Intelligence Index, igualando modelos muito mais caros, a uma fração do custo por tarefa.
Onde supera o Granite: é nativamente multimodal (o Granite 4.2 não tem variante de visão), o contexto é 8 vezes maior, e o preço promocional é quase de graça. Ele também liderou por um tempo os gráficos de uso do OpenRouter, então está testado em volume.
Onde fica a dever: o raciocínio fica sempre ligado e não pode ser desativado, então não há um verdadeiro modo "rápido, barato e sem pensar" como o que o Granite oferece. A API própria também é lenta (~49 tokens/segundo); você vai querer um host mais rápido, como o Databricks, para trabalho sensível à latência.
Preços: tarifas promocionais de $0.075 por milhão de entrada e $0.25 por milhão de saída (tabela $0.15/$0.50), com a promoção valendo até 9 de setembro de 2026, e entrada em cache a $0.015. Um GLM Coding Plan à parte custa $18/$80/$168 por mês. Os pesos abertos são grátis para hospedar.
Veredito: para agentes baratos que precisam ver imagens e chamar ferramentas, o GLM 5.3 Flash é a troca mais direta de "Granite, mas maior e multimodal" desta lista. Só considere que ele sempre pensa.
4. Kimi K3 - o melhor em trabalho agêntico de longo prazo
Melhor para: execuções de agentes complexas e de várias etapas em que você prefere pagar mais a ficar cuidando de um modelo mais fraco.
O Kimi K3, da Moonshot AI, é a opção premium de pesos abertos: maior, mais cara e ajustada para raciocínio agêntico sustentado em vez de vazão barata.
É um MoE de 2,8T parâmetros (104B ativos) com contexto de 1M de tokens e visão nativa, e a Moonshot lançou os pesos abertos no prazo. No Artificial Analysis Intelligence Index ele fica em torno de 57 (4º no geral), superando alguns modelos de ponta em muitas tarefas.
Onde supera o Granite: é um modelo muito mais forte em tarefas difíceis e longas, e um raciocinador agêntico sério onde os tamanhos pequenos do Granite ficam sem fôlego.
Onde fica a dever: o preço. A $3 de entrada / $15 de saída por milhão de tokens, fica na mesma faixa do Claude Sonnet, cerca de 50 vezes a tarifa de saída do DeepSeek, então é o oposto de uma escolha econômica. O raciocínio também não pode ser desligado em nenhum nível (o ajuste de esforço é um controle de latência, não uma faixa de custo), e os pesos abertos são um download de 1.561 GB, então "hospedar por conta própria" aqui significa infraestrutura séria.
Preços: $3 por milhão de entrada, $0.30 em acerto de cache, $15 por milhão de saída. Os planos do app de consumo são Free / $19 / $39 / $99 / $199 por mês.
Veredito: o Kimi K3 é o que você escolhe quando a tarefa é difícil o bastante para um modelo mais barato falhar, e o custo da falha supera o custo dos tokens. Para trabalho rotineiro de alto volume, é exagero ao lado do Granite ou do DeepSeek.
5. Mistral (Large 3 + modelos abertos) - o melhor para equipes europeias e on-prem limpo
Melhor para: equipes que querem um fornecedor não americano, residência de dados na UE e licenciamento realmente permissivo para modelos pequenos.
A Mistral é a resposta europeia à proposta de "aberto, licenciável, on-prem" que atrai as pessoas ao Granite logo de início, e seus modelos pequenos saem sob Apache 2.0.
A linha se divide de forma clara: o Mistral Large 3 é o carro-chefe hospedado, o Codestral e o Devstral cobrem programação e trabalho agêntico, e uma família de modelos abertos menores cobre o caso de hospedagem própria. O assistente de consumo da Mistral, antes chamado Le Chat, agora se chama Vibe.
Onde supera o Granite: jurisdição europeia e uma proposta empresarial madura (residência de dados na UE, implantação on-prem). Os modelos abertos pequenos dão um caminho de hospedagem própria com licença Apache e um fornecedor ocidental por trás, o que pesa em compras de um jeito que o texto da licença sozinho não captura.
Onde fica a dever: os melhores e maiores modelos da Mistral são os hospedados e pagos, então a faixa aberta não é a ponta. E em capacidade pura de benchmark, os modelos abertos chineses (Qwen, DeepSeek, GLM) tendem a liderar no momento.
Preços: o Mistral Large 3 custa cerca de $0.50 por milhão de entrada e $1.50 por milhão de saída; o Codestral, aproximadamente $0.30/$0.90. Os planos de consumo do Vibe são Free / $14.99 / $24.99 por usuário por mês. Os modelos abertos pequenos são grátis para hospedar.
Veredito: se o seu motivo para ir ao aberto foi governança e jurisdição do fornecedor, e não espremer o último centavo de um benchmark, a Mistral é o encaixe mais confortável aqui. Se foi capacidade bruta, olhe primeiro Qwen ou DeepSeek.
6. Google Gemini 3.6 Flash - o melhor em API gerenciada e hospedada
Melhor para: equipes que preferem nunca encostar em pesos e só querem um endpoint hospedado rápido, barato e confiável.
Nem todo usuário do Granite quer de fato hospedar; alguns querem só um burro de carga barato e meio aberto, e escolheram o Granite porque era barato. Para eles, o Gemini 3.6 Flash é a alternativa fechada, porém fácil.
É a faixa Flash "burro de carga" do Google, lançada em 21 de julho de 2026, com ~1M de tokens de contexto, uso de computador integrado e corte de conhecimento em março de 2026. O Google informa que ele usa cerca de 17% menos tokens de saída que o Flash anterior nas mesmas tarefas, o que reduz discretamente a conta real.
Onde supera o Granite: zero sobrecarga operacional. Sem GPUs, sem configuração de vLLM, sem surpresas de cache KV. É forte em uso de computador e tarefas de contexto longo, e é realmente rápido.
Onde fica a dever: é proprietário e só hospedado, então não há hospedagem própria, nem on-prem, nem liberdade de licença, justamente o que a maioria procurava no Granite. E o preço de saída é alto para esta lista.
Preços: $1.50 por milhão de entrada e $7.50 por milhão de saída, com requisições em lote a 50% de desconto ($0.75/$3.75).
Veredito: se você nunca ligou para pesos abertos e só queria uma API barata e capaz, o Gemini 3.6 Flash é uma vida mais limpa do que rodar o Granite por conta própria. Se abertura ou on-prem eram o ponto, é a direção errada.
7. NVIDIA Nemotron 3 - o melhor para o stack NVIDIA e receitas realmente abertas
Melhor para: equipes que já usam hardware NVIDIA e quem quer a reprodutibilidade que o Granite não entrega.
A família Nemotron da NVIDIA é um dos rivais contra os quais a IBM de fato compara o Granite, o que a torna um confronto direto natural, e responde diretamente à reclamação de que "só pesos não é aberto".
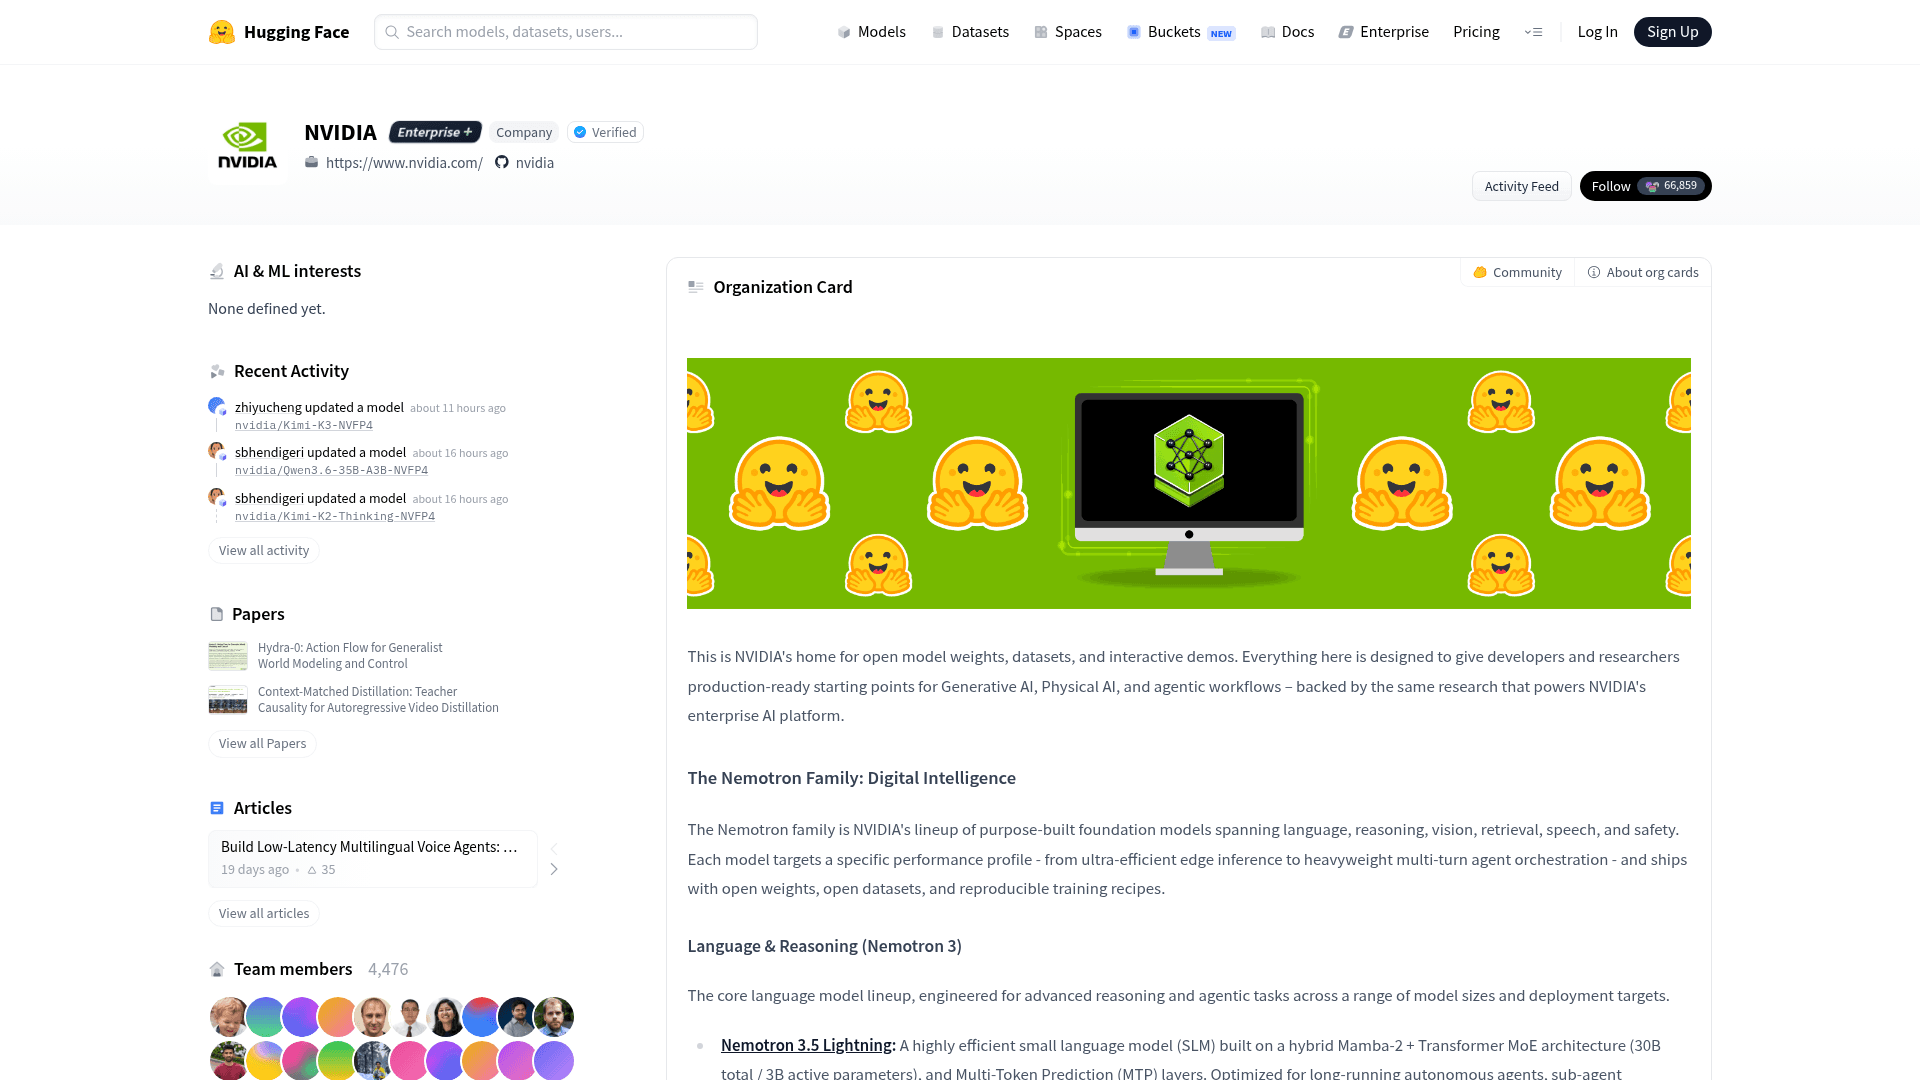
O Nemotron é a linha de modelos de base da NVIDIA feitos sob medida para linguagem, raciocínio, visão e recuperação. Os modelos de linguagem atuais vão do nemotron-3.5-lightning-30b-a3b (um MoE de 30B totais / 3B ativos ajustado para agentes autônomos de longa execução) até o nemotron-3-ultra-550b-a55b (um MoE híbrido aberto Mamba-Transformer com contexto de 1M, feito para raciocínio agêntico, programação e chamada de ferramentas). O crucial: a NVIDIA diz que a família vem com "open weights, open datasets, and reproducible training recipes."
Onde supera o Granite: essa linha de reprodutibilidade é todo o argumento. Onde o Granite dá pesos, o Nemotron dá pesos, dados e receita, a definição mais rígida de aberto que parte da comunidade defende. Também é otimizado para silício NVIDIA, e você pode chamar os modelos de graça em build.nvidia.com antes de se comprometer.
Onde fica a dever: os modelos Nemotron mais fortes são grandes (o ultra tem 550B), então a história de "roda no notebook" que torna o 3B do Granite tão querido não se aplica no topo da linha. E o preço de varejo por token é menos claro que o dos demais aqui; a hospedagem em produção passa pelo NVIDIA NIM ou por parceiros de nuvem e é cobrada por computação.
Preços: os pesos abertos são grátis para baixar, e a NVIDIA oferece endpoints hospedados gratuitos em build.nvidia.com. A hospedagem em produção via NVIDIA NIM ou parceiro de nuvem é cobrada pela computação subjacente, e não por uma tarifa pública por token.
Veredito: se você já está em infraestrutura NVIDIA, ou se a pergunta "é realmente aberto?" é o motivo de deixar o Granite, o Nemotron é a troca mais coerente da lista. Só dimensione para o seu hardware.
O que todo modelo desta lista tem em comum
Esta é a parte que se perde nas threads de benchmark. Seja Granite, Qwen, DeepSeek ou Nemotron, você escolheu um motor. Um modelo, sozinho, não conhece sua política de reembolso, não enxerga seus tickets do Zendesk e não faz ideia se a resposta que acabou de gerar é segura para enviar a um cliente real. Esse é todo o motivo de a IA para atendimento ao cliente ser uma categoria de produto e não só uma chave de API.
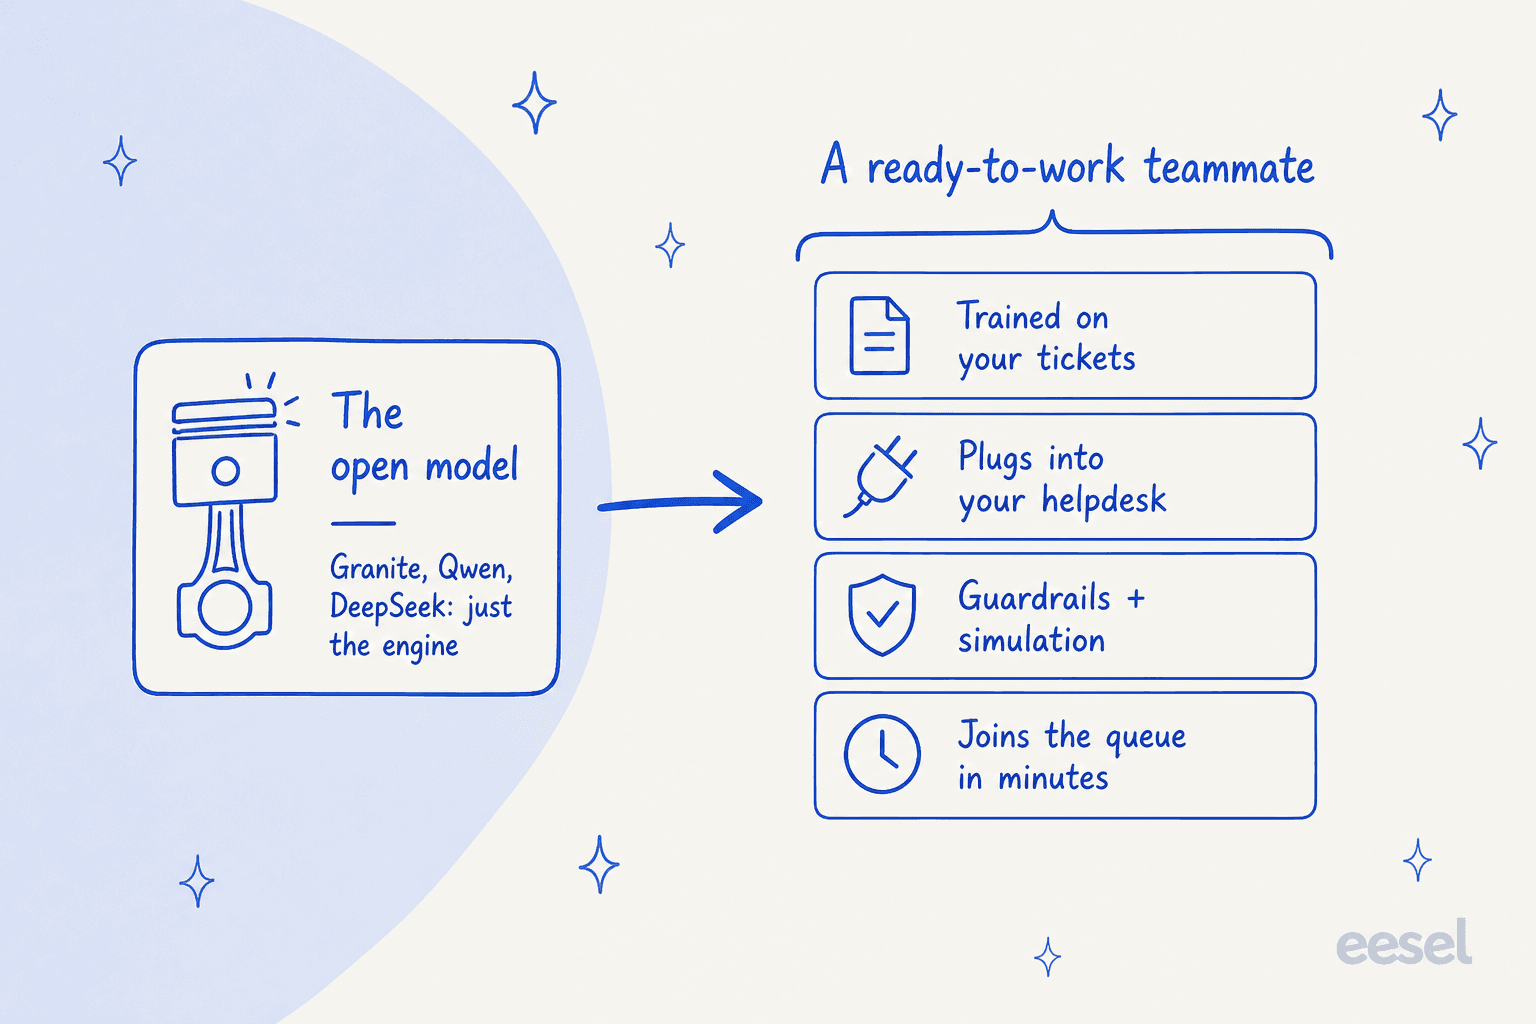
Se você está escolhendo entre esses modelos para construir algo, ótimo; escolha o motor que serve e siga em frente. Mas se o objetivo real é um agente de IA que resolva tickets de suporte, trocar o Granite pelo Qwen muda os 10% fáceis e deixa intactos os 90% difíceis: conectar à sua base de conhecimento, integrar ao helpdesk, escrever as barreiras de segurança e provar que é seguro antes de ir ao ar. Essa é a diferença entre um agente de IA e um chatbot baseado em regras, e é onde está todo o trabalho de verdade.
Experimente a eesel: a camada que nenhum modelo desta lista entrega
Se o seu objetivo é responder tickets e não escolher um modelo para construir em cima, é exatamente essa a lacuna que a eesel preenche. Todo modelo acima te dá um motor. A eesel é a colega de IA para helpdesk pronta para trabalhar que já tem um motor, mais tudo ao redor: ela treina com seus tickets antigos e sua central de ajuda, se conecta ao helpdesk que você já usa (Zendesk, Freshdesk, Gorgias e mais de 1.000 outras integrações), e entra na fila em minutos em vez de trimestres.

O diferencial é a rede de segurança que um modelo nu, Granite ou outro, não traz: antes de a eesel responder a um único cliente real, você pode simulá-la em milhares de tickets históricos para ver exatamente como ela teria respondido e o que teria resolvido. Use qualquer modelo desta lista se estiver construindo. Use uma colega de IA para helpdesk se o que você quer é responder tickets. Você pode experimentar a eesel de graça, sem cartão de crédito e sem ligação de vendas para começar.
Perguntas frequentes
Qual é a melhor alternativa de pesos abertos ao IBM Granite 4.2?
Em capacidade bruta, a comunidade de LLMs locais aponta sempre para o Qwen: seu checkpoint aberto de 27B é Apache 2.0 e supera o Granite em programação. Se o custo for o fator decisivo, o DeepSeek V4 Flash tem licença MIT e é mais barato de operar em escala. Ambos são tratados em detalhe acima, junto com nossa visão geral do Granite 4.2.
Existe uma alternativa mais barata ao Granite 4.2?
O Granite já está perto do piso: os pesos são Apache 2.0, então hospedar por conta própria é grátis, e o 8B da Replicate custa $0.06/$0.25 por milhão de tokens. Entre as tarifas hospedadas, o preço promocional do GLM 5.3 Flash ($0.075/$0.25) é comparável, e a saída do DeepSeek V4 Flash fora do horário de pico custa $0.66. Mesmo assim, o modelo raramente é a parte cara de um agente de IA; o caro é o conhecimento, as integrações e as barreiras de segurança.
Qual alternativa ao Granite 4.2 é a melhor para programação?
O Qwen é a escolha consensual para programação entre quem roda modelos localmente, e o DeepSeek V4 Flash também se sai bem. O 30B do Granite 4.2 é crível (57.0 no SWE-Bench Verified), mas para geração de código pura a maioria dos analistas ainda recorre ao Qwen. Se você está escolhendo um modelo para automatizar o suporte, e não uma ferramenta de programação, veja nosso guia do melhor modelo de IA para tickets de suporte.
As alternativas ao Granite 4.2 rodam no seu próprio hardware?
A maioria roda. Qwen, DeepSeek V4 Flash, GLM 5.3 Flash, Kimi K3, os modelos pequenos da Mistral e o NVIDIA Nemotron publicam pesos abertos que você pode baixar e rodar com Ollama, vLLM ou llama.cpp. O Gemini 3.6 Flash, do Google, é a exceção; ele só é hospedado. Para usar qualquer um deles com clientes reais, você ainda precisa de recuperação e barreiras de segurança em volta do modelo.
O que devo usar no lugar do Granite 4.2 para criar um agente de suporte?
Se o objetivo é resolver tickets e não construir infraestrutura, você não quer um modelo bruto, e sim a camada por cima dele. A eesel é uma colega de IA para helpdesk que treina com seus tickets antigos e sua central de ajuda, se conecta ao seu helpdesk atual e pode ser simulada com tickets históricos antes de responder a um único cliente real. O modelo por baixo é a parte fácil.