

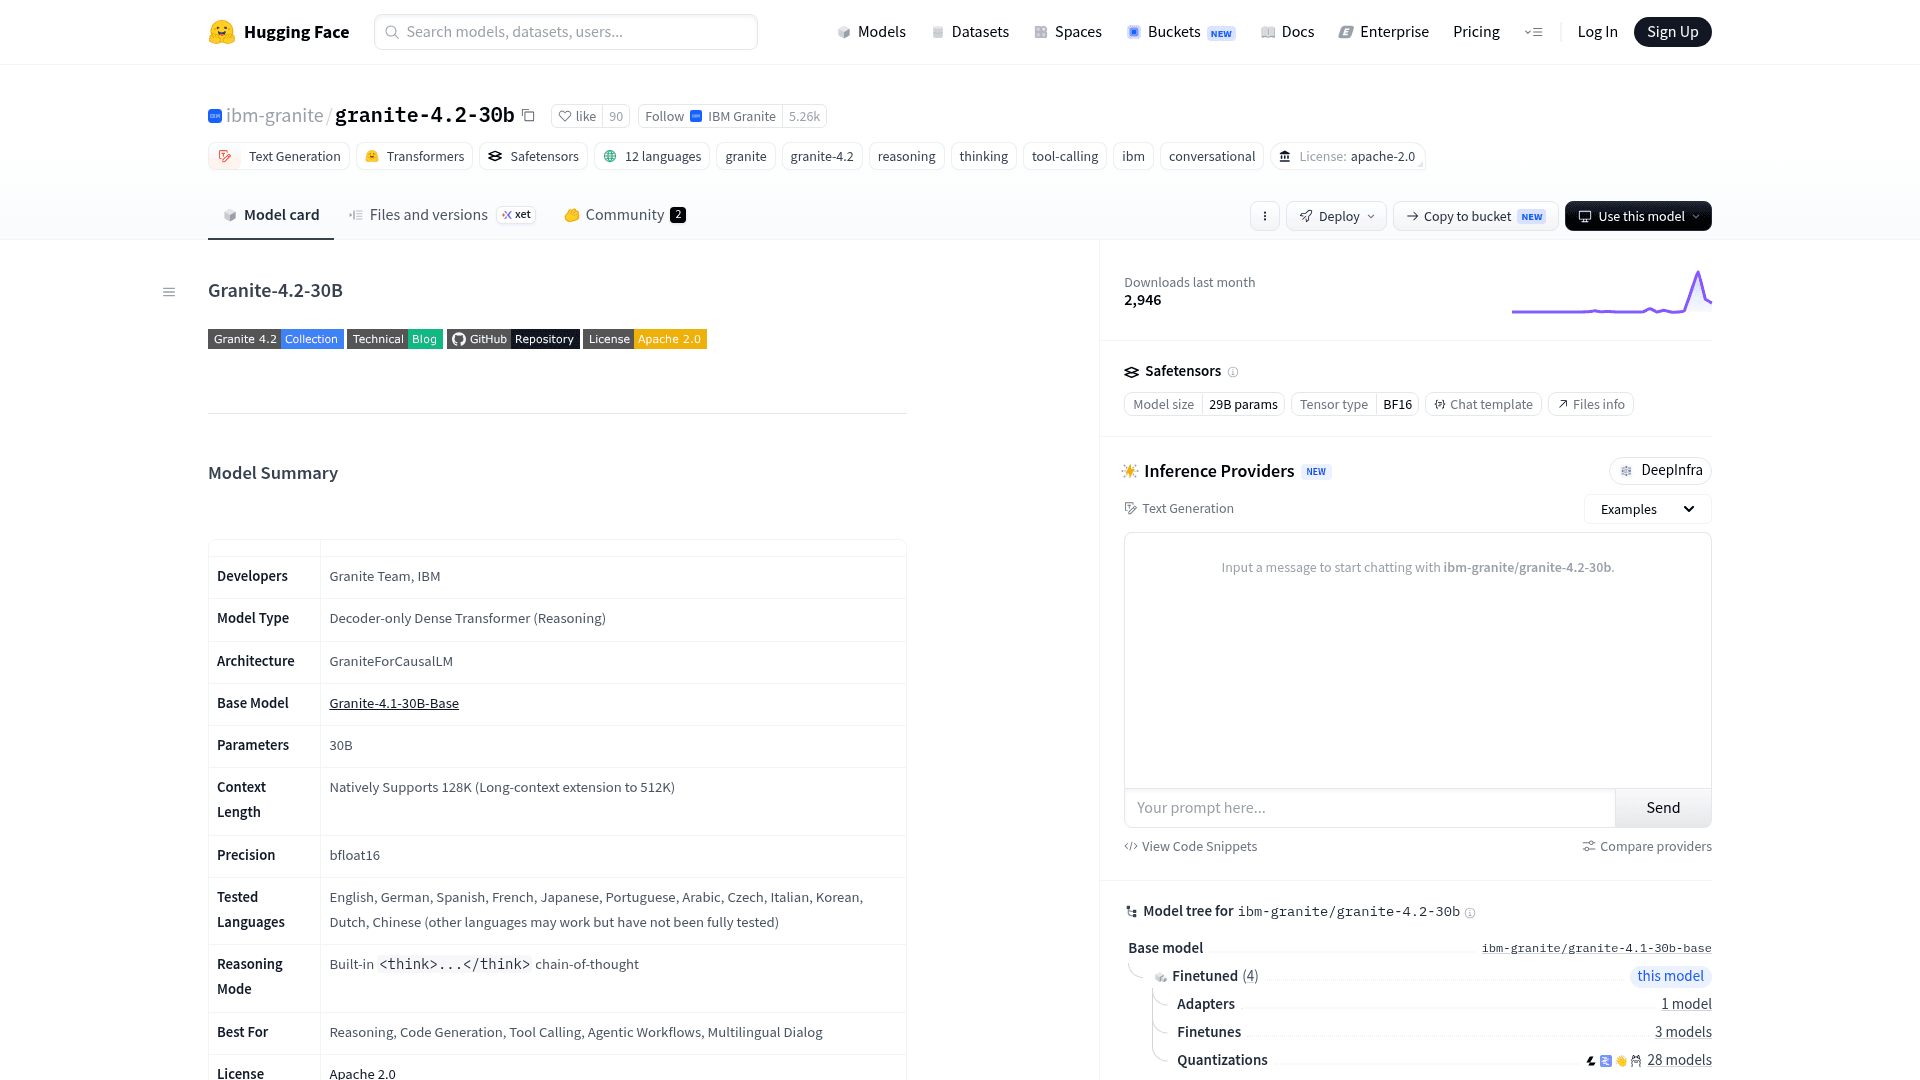
O IBM Granite 4.2 é a família de modelos de raciocínio abertos da IBM, lançada em 25 de agosto de 2026 em três tamanhos (3B, 8B, 30B), todos sob a licença permissiva Apache 2.0. A grande mudança em relação ao Granite 4.0 é o raciocínio "thinking" nativo embutido no modelo, com três modos alternáveis (thinking completo, sem thinking e baixo esforço) e uma chamada de ferramentas muito mais forte.
Vale a pena? Depende do que você valoriza:
- Você quer uma IA confiável, licenciável e em infraestrutura própria: sim. Pesos assinados, uma das melhores notas de transparência de Stanford e Apache 2.0 fazem do Granite a escolha segura para empresas, e os modelos pequenos rodam rápido em hardware comum.
- Você quer a maior pontuação bruta em programação ou agentes: provavelmente não. A comunidade de LLMs locais ainda recorre ao Qwen quando o assunto é capacidade pura, e a IBM compara principalmente consigo mesma.
- Você quer um agente de suporte pronto: essa é a camada errada. O Granite é um motor, não um colega de IA para o helpdesk. Você ainda precisa construir por cima a recuperação de informações, as barreiras de proteção e os testes.
O jeito mais barato de testar: ele é gratuito para hospedar por conta própria sob Apache 2.0 (o 3B é um download de 2,2 GB pelo Ollama). Como API hospedada, a Replicate oferece o 8B a $0.06/$0.25 por milhão de tokens.
O que eu procuro em um modelo aberto como o Granite 4.2
Um pouco de contexto sobre o meu ponto de vista. Eu construo agentes de IA na eesel, e há anos colocamos IA em filas de suporte reais, então leio o lançamento de um modelo de forma diferente de quem persegue benchmarks. Uma pontuação alta no AIME é legal. O que realmente me importa é se um modelo consegue seguir instruções de que não gosta, chamar a ferramenta certa sem inventar uma, manter-se ancorado em uma base de conhecimento e se comportar no ticket nº 4.000 como se comportou na demo. Já vimos modelos de tom confiante darem respostas erradas sem ninguém perceber, e é exatamente por isso que simulamos cada implantação com tickets históricos antes que ela toque em um cliente.
Então esta análise olha o Granite 4.2 por essa lente: o que realmente mudou, onde os benchmarks ficam com honestidade, quanto custa rodar e para quem ele serve.
O que mudou no Granite 4.2
A versão em uma linha: o Granite 4.2 adiciona raciocínio nativo. Enquanto o Granite 4.0 era um modelo instruct rápido e eficiente, o 4.2 consegue planejar, se autocorrigir e raciocinar passo a passo dentro de tags <think>...</think> antes de responder. Isso ajuda mais em matemática, lógica de vários passos e, o que mais me importa, em decidir qual ferramenta chamar e por quê.
O mais esperto é que o raciocínio é alternável em um único modelo, então você não paga por chain-of-thought em perguntas que não precisam dele:
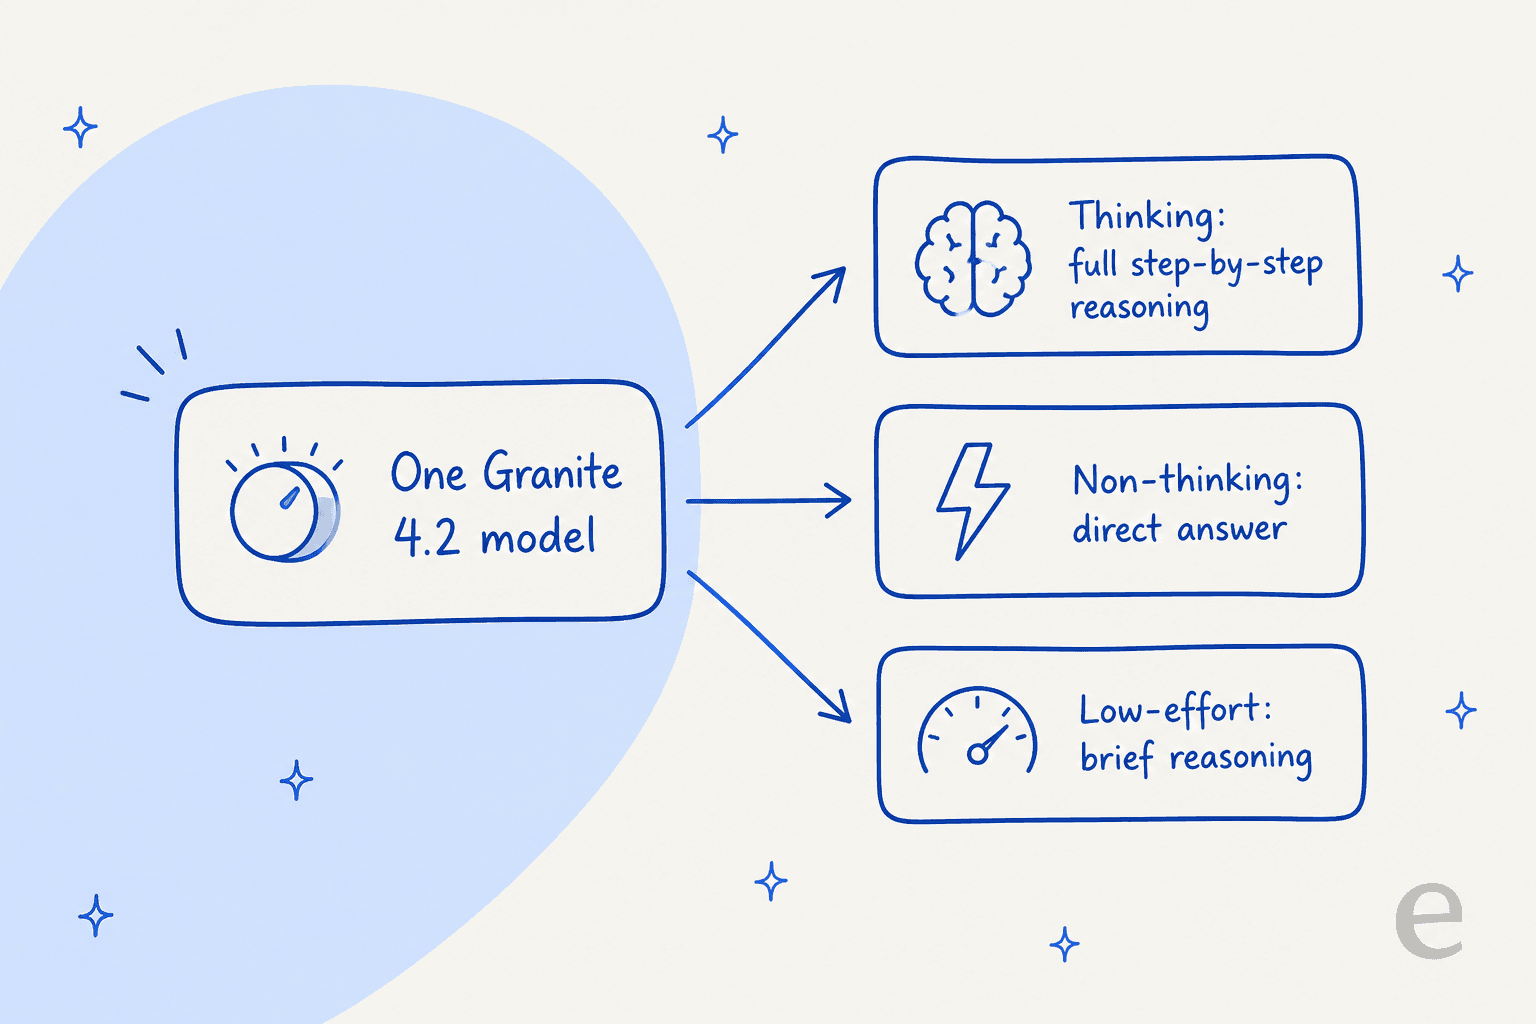
- Thinking (o padrão) entrega chain-of-thought completo.
- Sem thinking pula o raciocínio por completo para uma resposta direta, o que importa quando você atende alto volume e não quer a latência nem o custo em tokens.
- Baixo esforço faz um raciocínio breve para consultas mais simples, uma marcha intermediária.
No Ollama você alterna entre eles com /set think e /set nothink, um bom detalhe para quem ajusta custo versus qualidade por caso de uso.
Também há uma história de arquitetura, e vale destacá-la porque ela vai contra a tendência. O Granite 4.0 usava um design híbrido Mamba-2/transformer com uma mistura de especialistas para eficiência de memória. O Granite 4.2 é um simples transformer denso somente decodificador. O argumento da IBM é que "its dense architecture supports broad compatibility", o que é um ponto real se você implanta em hardware misto e diferentes stacks de serviço. Também significa que a contagem de parâmetros do título é o modelo inteiro, sem malabarismo de ativos versus totais.
Para fechar o lançamento: o diálogo multilíngue foi testado em 12 idiomas, e a IBM lançou dois minúsculos modelos de transcrição Granite Speech 5.0 Turbo (470M de parâmetros) junto com os LLMs para áudio na borda.
Os três modelos: 3B, 8B e 30B
O Granite 4.2 são exatamente três modelos densos, cada um pós-treinado a partir da base Granite 4.1 correspondente. Todos lidam nativamente com um contexto de 128K tokens, e o 30B se estende a 512K.
| Modelo | Parâmetros | Camadas | Contexto | Download no Ollama | Melhor para |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B denso | 40 | 128K / 512K | 2,2 GB | Edge, notebooks, tarefas baratas de alto volume |
| granite-4.2-8b | 8B denso | 40 | 128K / 512K | 5,3 GB | Cavalo de batalha equilibrado de uso geral |
| granite-4.2-30b | 30B denso | 64 | 128K / 512K | 18 GB | Carro-chefe para raciocínio e tarefas com agentes |
A IBM também oferece quantizações oficiais (fp8, mxfp4, nvfp4) de todos os tamanhos, além de versões GGUF da comunidade para llama.cpp e LM Studio. Vale saber: as fichas dos modelos recomendam explicitamente rodar o Granite junto com o Granite Guardian 4.1 8B, um modelo de segurança separado para detecção de riscos. O rótulo "4.2" cobre apenas os três modelos de linguagem; Vision, Guardian e Speech seguem suas próprias versões.
Benchmarks: onde o Granite 4.2 realmente fica
Esta é a comparação principal da IBM, o 30B contra o Nemotron 3 Super 120B, da Nvidia, e o Gemma 4 31B, do Google:
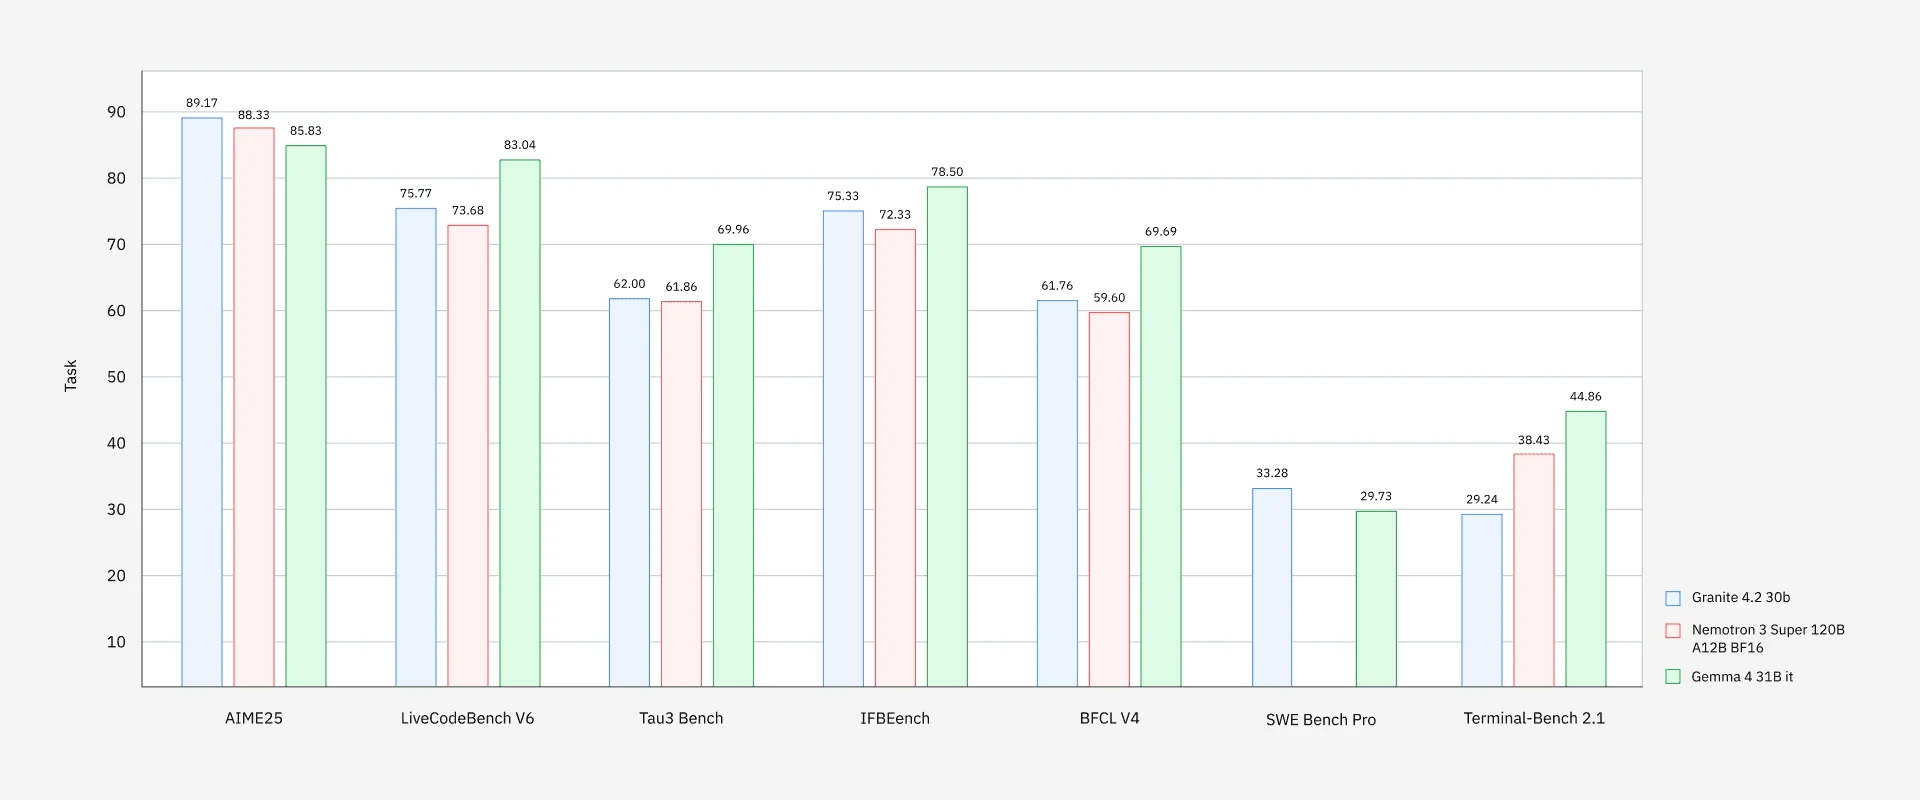
A história que a IBM quer contar é real: no AIME25 o 30B marca 89.17, superando por pouco um modelo Nemotron de 120B parâmetros, e também lidera em LiveCodeBench, IFBench e BFCL. "Competitivo com modelos thinking maiores por uma fração do custo" é um resumo justo desse gráfico.
As ressalvas honestas importam tanto quanto:
- O quadro se inverte na programação agêntica mais difícil. O Gemma 4 31B supera o Granite tanto no SWE-Bench Pro quanto no Terminal-Bench 2.1. Os números brutos do Granite como agente de programação (33.29 no SWE-Bench Pro, 29.24 no Terminal-Bench) são decentes para o tamanho, mas não lideram a categoria.
- A IBM compara com um conjunto de pares escolhido com cuidado. Ainda é a IBM quem escolhe a comparação. Como disse um comentarista do Hacker News durante o lançamento do 4.1:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models. At least this is the most reasonable assumption until data comes out to the contrary."

Nos números que me importam para a automação de suporte, o quadro é animador: o 30B atinge 62.00 no tau3-bench (uso agêntico de ferramentas), 61.39 no BFCL v4 (chamada de funções) e 77.60 no MMLU-Pro. Esses são os músculos de chamada de ferramentas e de seguimento de instruções em que um agente de suporte realmente se apoia, e o 8B chega perto o bastante (52.39 no BFCL, 74.04 no MMLU-Pro) para ser interessante em implantações sensíveis a custo.
Como funciona o ciclo de raciocínio e chamada de ferramentas
A melhoria mais útil para quem constrói agentes é que o Granite 4.2 raciocina sobre as ferramentas antes de chamá-las. Em vez de casar padrões com o nome de uma função, o modelo pensa em qual ferramenta se encaixa e por quê, e só então faz a chamada. Essa é a diferença entre um agente que consulta um pedido de forma confiável e um que inventa uma função que não existe.
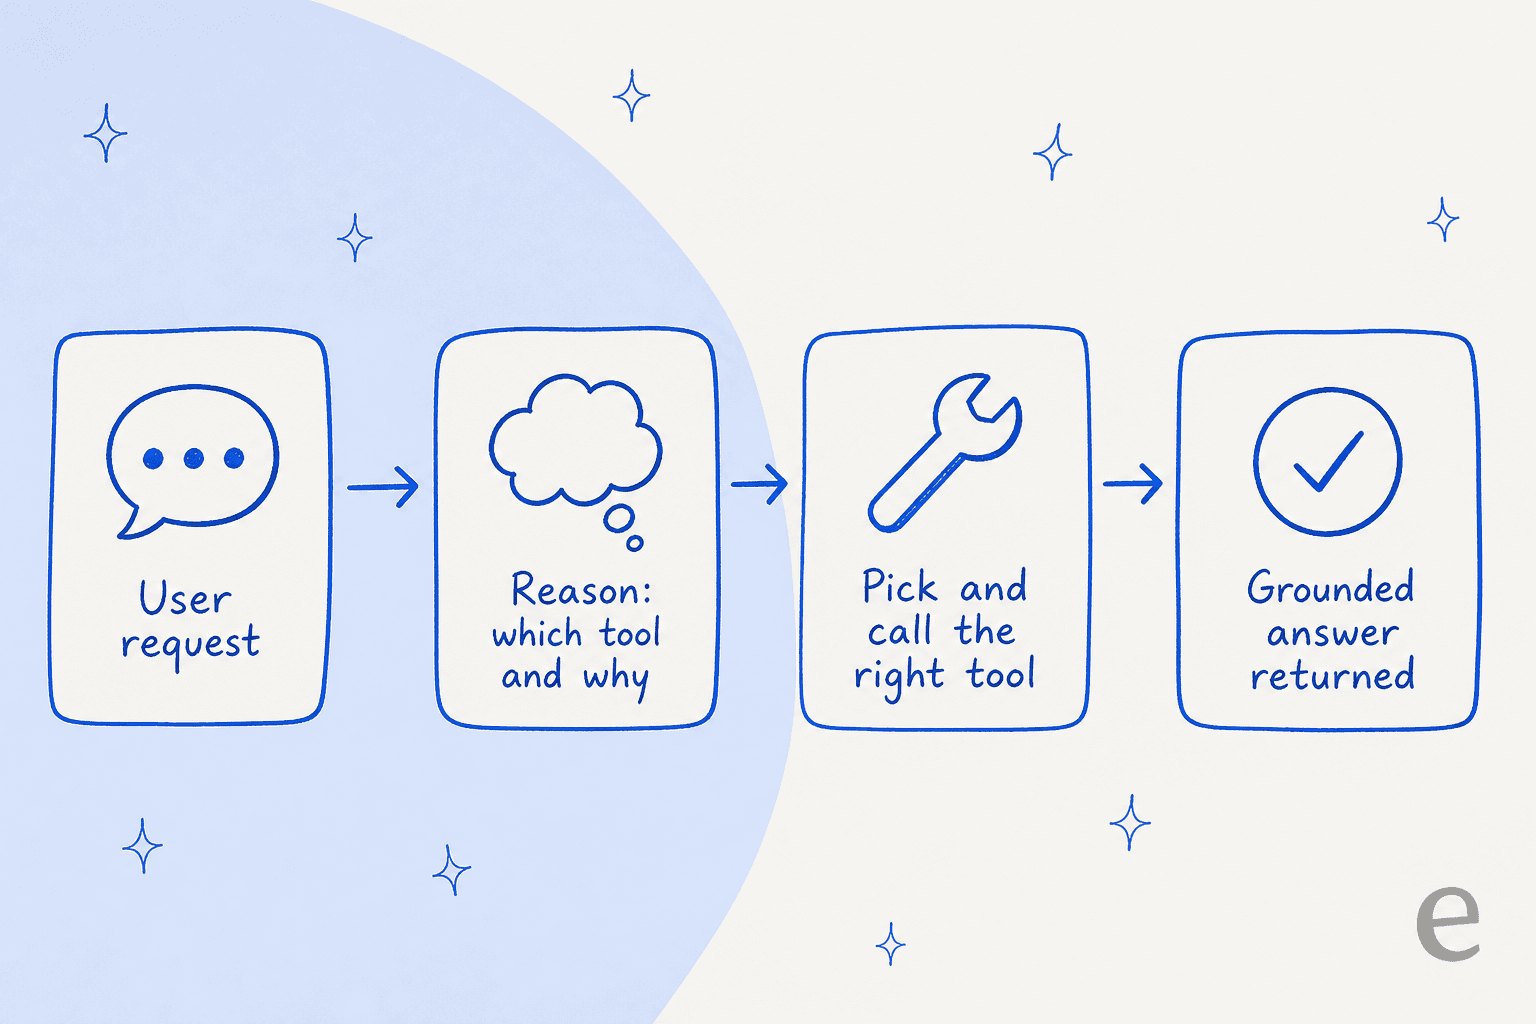
Ele é exposto por uma API compatível com a OpenAI e funciona de imediato com ambientes de programação agêntica como OpenCode e OpenHands. A leitura da comunidade respalda o design: os modelos pequenos do Granite são discretamente bons em trabalho estruturado.
"IBM Granite 4H-Small, it's very good with tool calls. most tool-calling issues come from the model not sticking to the exact structure you"

Essa é a camada em que a escolha do modelo encontra um produto real. A chamada de ferramentas confiável é o que separa um agente de IA de um chatbot baseado em regras, e é o que permite a um agente consultar um pedido, etiquetar um ticket ou acionar um reembolso em vez de apenas digitar uma frase plausível sobre isso.
Acesso e preços
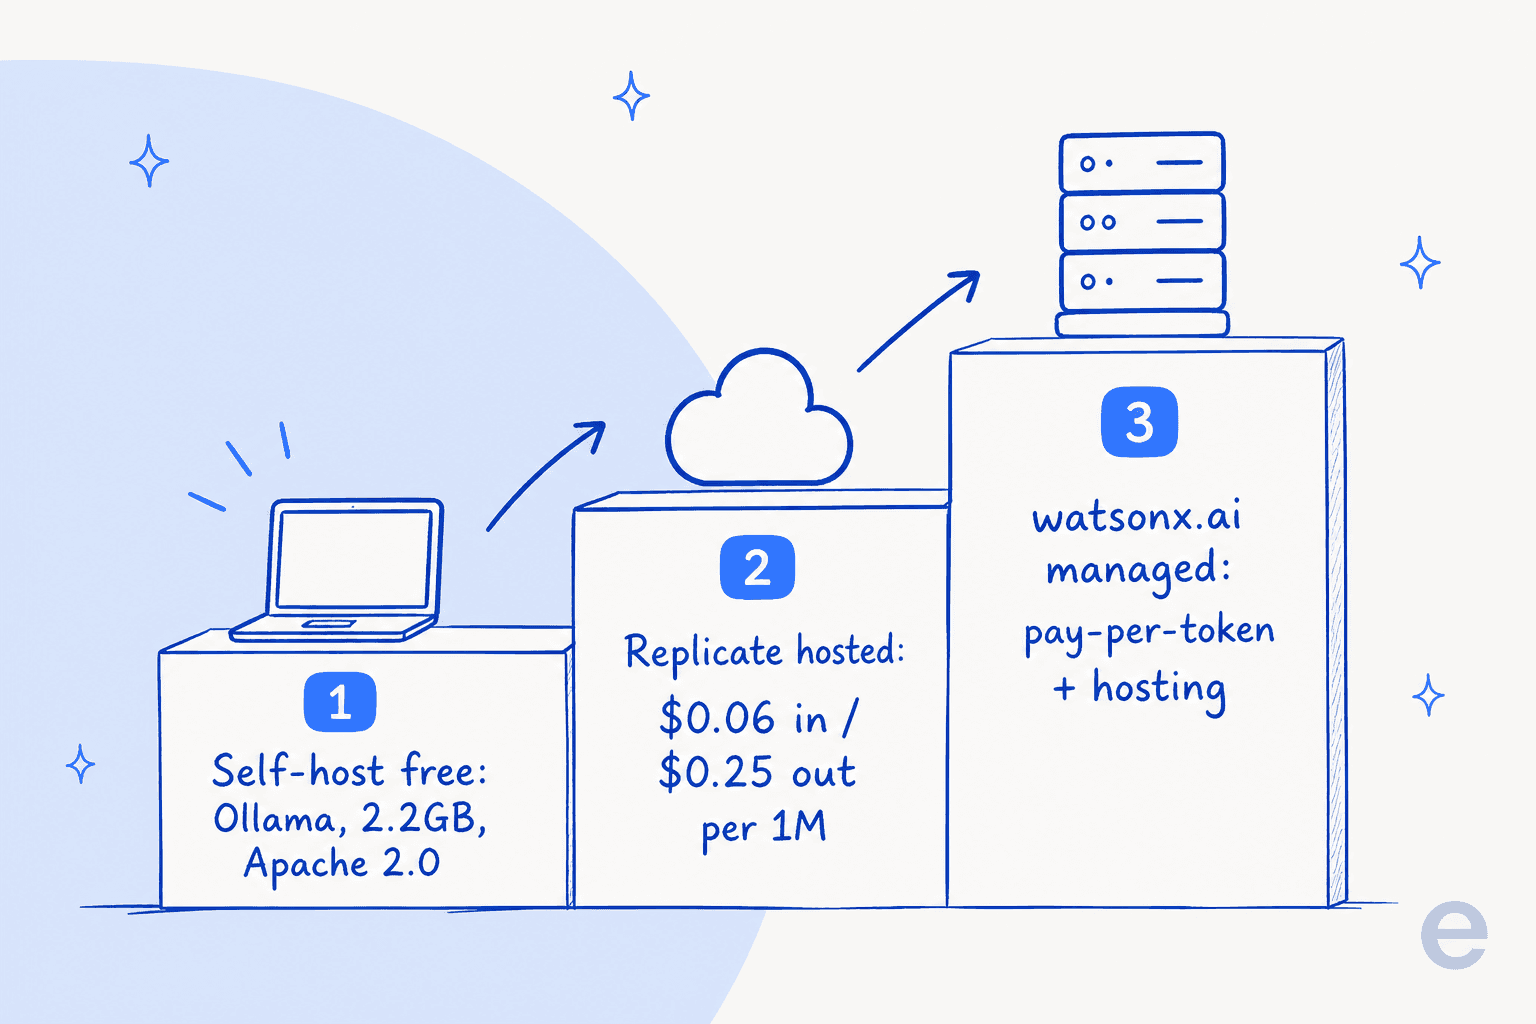
É aqui que o Granite fica atraente: por ser Apache 2.0, o piso é gratuito. Você pode baixar, ajustar e colocar em produção sem taxa de licença e sem custo por token além do poder de computação em que o executa. Há três caminhos práticos, que sobem em comodidade e custo:
| Caminho | Preço | Observações |
|---|---|---|
| Hospedagem própria (Ollama, vLLM, llama.cpp) | Grátis (seu poder de computação) | O 3B roda em um notebook; o 30B precisa de ~18 GB+ de VRAM |
| API hospedada da Replicate | $0.06 / 1M entrada, $0.25 / 1M saída | ~$0.0014 por execução típica; só 8B, confirmado |
| watsonx.ai | Pagamento por 1M tokens + hospedagem por hora | Plano Standard ~$1,050/mês; plataforma gerenciada da IBM |
Duas observações honestas. Primeiro, o watsonx.ai da própria IBM é o caminho corporativo, e seu modelo de preços (pay-as-you-go por milhão de tokens, em que historicamente 1 Resource Unit = 1.000 tokens, mais hospedagem sob demanda por hora) está confirmado, mas a tabela da documentação ao vivo retornou erro 500 quando verifiquei, então não consegui fixar a linha exata do Granite 4.2. A tarifa confirmada mais próxima do Granite 4 fica em torno de $0.06 por milhão de entrada e $0.27 de saída. Segundo, até a data deste texto os modelos 4.2 ainda não estavam listados no OpenRouter, que continuava mostrando apenas o Granite 4.1 8B e o 4.0 Micro.
Aqui está o caminho gratuito em ação no Ollama, que é como a maioria das pessoas vai experimentar:
Uma pegadinha que a comunidade percebeu rápido: o tamanho do download engana sobre a memória de que você precisa. Um tópico no r/LocalLLaMA apontou o 8B inchando muito além do seu tamanho:
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"
Isso é o cache KV e a alocação de contexto trabalhando, e é algo normal de prever, mas se você dimensionar uma GPU pelo número do download, vai ficar curto. Deixe folga, principalmente com contexto longo.
O que a comunidade realmente pensa
A opinião sobre o Granite 4.x é consistente e, acho, correta. Os elogios se concentram exatamente no que a IBM construiu: os modelos pequenos rodam rápido em hardware comum, têm dados de treinamento recentes e uma licença comercial sem restrições.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly... Granite has recent training data which is nice."
A crítica é igualmente consistente: em capacidade bruta, principalmente em programação, as pessoas ainda recorrem ao Qwen.
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
E um comentarista no X captou o posicionamento melhor do que o próprio marketing da IBM: o Granite compete em confiança, em vez de tentar liderar um ranking.
"IBM just released a model built to need less of your trust, not more of your capability. Granite 4.2 ships in 3, 8, and 30 billion parameter sizes, fully open under Apache 2.0. It's trained specifically for tool use, terminal work, and multistep agent tasks."
Essa é a análise inteira em um parágrafo, sinceramente. O Granite 4.2 não tenta ser o modelo mais inteligente que você pode rodar. Ele tenta ser aquele que suas equipes de segurança e jurídico aprovam: pesos assinados, certificação ISO, uma das melhores notas de transparência de Stanford e uma licença que não o prende. Para uma empresa regulada que monta modelos específicos de domínio em infraestrutura própria, essa combinação vale mais do que dois pontos em um benchmark de programação.
Onde o Granite 4.2 se encaixa para equipes de suporte e de IA
Então uma equipe de suporte ou de operações deveria se importar? Sim, mas ajuda ser claro sobre o que você realmente tem em mãos. O Granite 4.2 é infraestrutura, um motor. Sozinho, ele não é um agente de atendimento ao cliente, assim como um V8 não é um carro.
Se você tem uma equipe de ML e quer controle máximo (dados que nunca saem da sua VPC, um modelo ajustado com os seus próprios tickets, nenhuma conta por token em escala), hospedar por conta própria um modelo aberto como o Granite é um caminho real e cada vez mais popular. O 8B é um ponto de partida sensato para a automação do atendimento ao cliente: boa chamada de ferramentas, barato de rodar, licenciável. Depois você construiria o resto sozinho: recuperação sobre a sua central de ajuda, lógica de escalada, barreiras contra alucinação, uma forma de medir a taxa de resolução e um jeito seguro de testar antes de entrar no ar.
Esse "construir o resto sozinho" é o trabalho todo, e é a parte que as análises de modelos pulam. Escolher o modelo é talvez 10% de entregar um agente de suporte que realmente desvia tickets de nível 1 sem piorar as coisas. Os outros 90% são a infraestrutura, os testes e a segurança operacional, que é onde a maioria dos projetos internos empaca.
Experimente a eesel: a camada que o Granite não oferece
Se o seu objetivo é um agente de suporte funcionando, e não um modelo para construir por cima, é exatamente essa a lacuna que a eesel preenche. O Granite entrega um motor. A eesel é o colega de IA para o helpdesk pronto para trabalhar que já vem com o motor, mais tudo ao redor: ela aprende com seus tickets passados e sua central de ajuda, se conecta ao helpdesk que você já usa (Zendesk, Freshdesk, Gorgias e mais de 1.000 integrações) e entra na fila em minutos, não em trimestres.

O diferencial é aquilo que eu disse no começo que me importa: antes que a eesel responda a um único cliente real, você pode simulá-la com milhares dos seus tickets históricos para ver exatamente como ela teria respondido e o que teria resolvido. Essa é a rede de segurança que um modelo bruto, Granite ou outro, não traz consigo. Um cliente, a Global Pay, relatou até 80% de economia de tempo com ela.
Use o Granite 4.2 se você está construindo. Use um colega de IA para o helpdesk se você quer responder tickets. Você pode testar a eesel grátis, sem cartão de crédito e sem conversa com vendas para começar.