

Resumo
O Muse Spark Open é o primeiro modelo Muse de pesos abertos da Meta, lançado em 15 de outubro de 2026: 816B de parâmetros no total, 42B ativos, janela de contexto de 1M de tokens e entrada de texto, imagem, vídeo e áudio. Ele é excelente em chamar ferramentas e muito difícil de fazer jailbreak, liderando a tabela comparativa da própria Meta em MCP-Atlas (89,2) e JobBench (61,8).
O problema é duplo. Ele não é o modelo aberto mais inteligente: marca 39 no Artificial Analysis Intelligence Index, atrás de GLM 5.3 (45), Kimi K3 (44) e Qwen 3.8 (40), e fica atrás dos dois líderes em código. E tem preço de modelo fechado: todo provedor cobra $1,25 de entrada e $4,25 de saída por milhão de tokens, o mesmo da API fechada Muse Spark 1.3 da Meta, porque a licença dá à Meta voz sobre os grandes provedores.
Meu veredito: 3,5/5. Escolha se precisa de pesos que dá para hospedar por conta própria, para um agente que usa muitas ferramentas, e quer comportamento de segurança conservador. Pule se quer o melhor modelo aberto para código ou os tokens mais baratos. E se o que você realmente quer é um agente respondendo tickets de suporte, o modelo é a menor parte do trabalho; o teammate de IA para helpdesk da eesel cuida do resto.
O que é o Meta Muse Spark Open?
Eu construo agentes de IA como profissão na eesel, e a primeira coisa que faço com qualquer modelo novo é ler o model card antes do post de lançamento. O model card do Muse Spark Open no Hugging Face descreve um modelo mixture-of-experts de 816B parâmetros que ativa 42B parâmetros por token, com 256 especialistas e 8 ativos por token, janela de contexto de 1M de tokens e um codificador de visão de 1,8B parâmetros acoplado para imagens e vídeo.
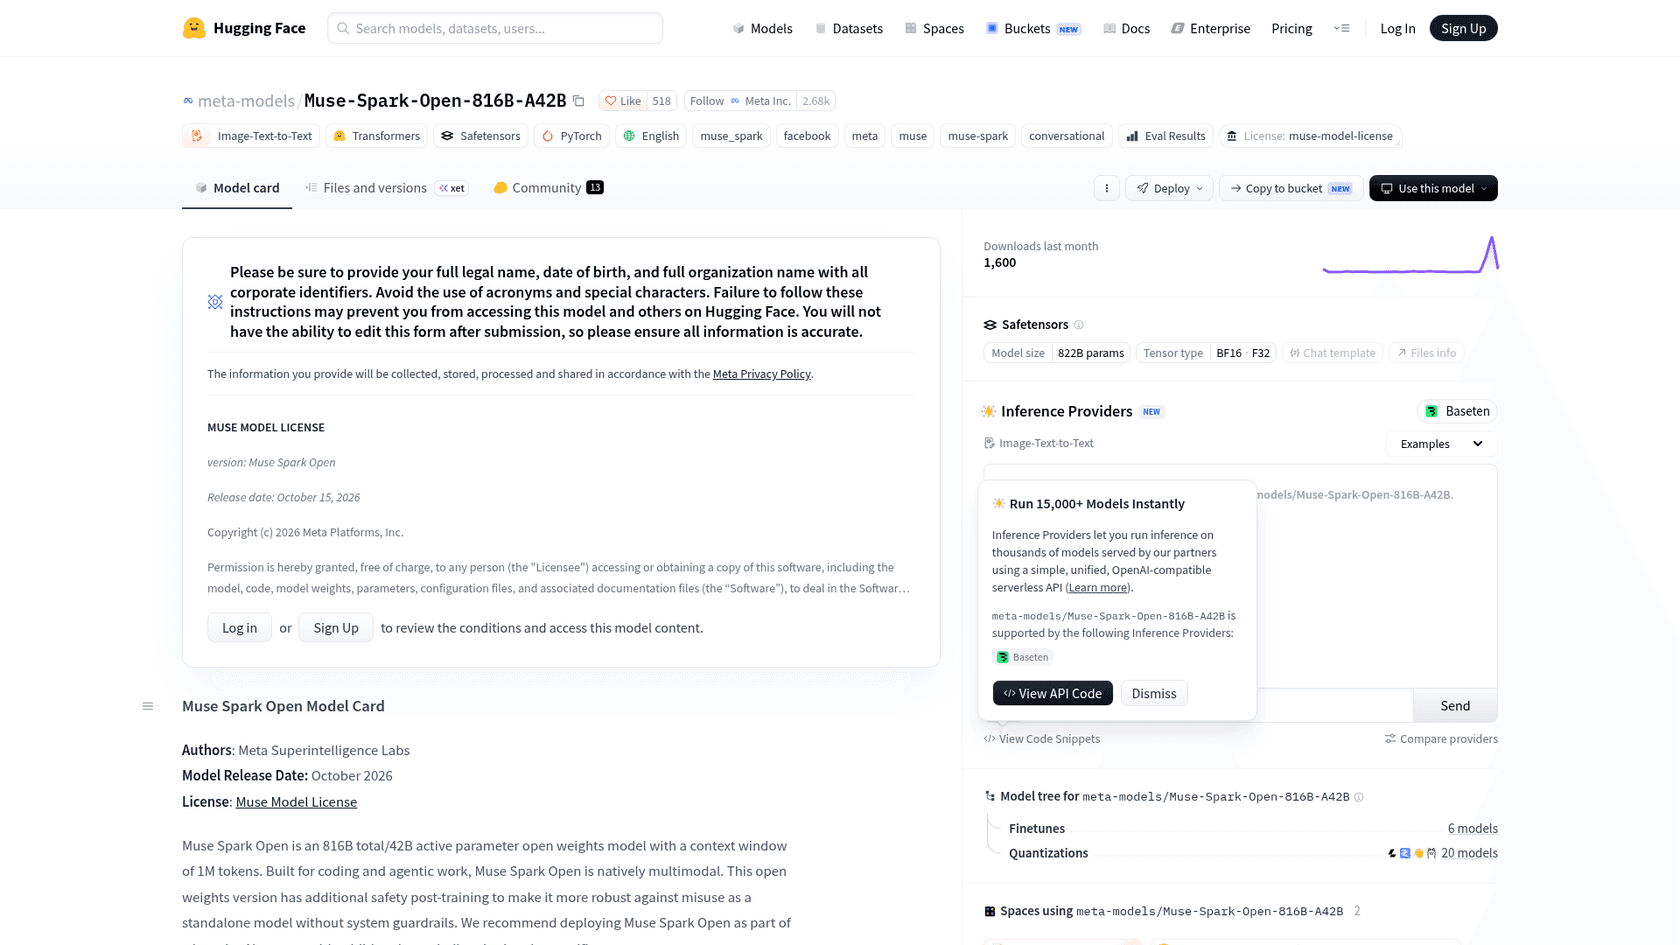
Ele é o irmão de pesos abertos da linha fechada Muse Spark, não uma família separada. O mesmo nome Muse também cobre o Muse Code, o harness de código da Meta, e o agente pessoal Muse.
O post de pesquisa da Meta o chama de "the most capable US open-weight model to date" e diz que ele vem com pós-treinamento extra de segurança porque, depois que os pesos são divulgados, ninguém pode adicionar proteções no lado do servidor. O post para desenvolvedores acrescenta um detalhe que importa para o meu mundo: a Meta o treinou para trabalho de agentes de longo prazo "such as coding and customer service agents."
Algumas especificações práticas do card:
| Especificação | Muse Spark Open |
|---|---|
| Parâmetros | 816B no total, 42B ativos |
| Contexto | 1M de tokens |
| Entrada | Texto, imagem, vídeo, áudio |
| Saída | Texto |
| Esforço de raciocínio | low, medium, high, xhigh (padrão xhigh) |
| Pesos | BF16 (cerca de 1,6TB) e NVFP4 (cerca de 530GB) |
| Lançamento | 15 de outubro de 2026 |
Um ponto a notar: o raciocínio fica sempre ligado. A página do modelo na Groq diz que ele "always reasons before answering", e o esforço padrão é o mais caro, xhigh. Se você quer respostas curtas e baratas, precisa pedir low ou medium por conta própria.
Como eu avaliei
Não rodei este modelo em uma fila de suporte por um ano, e não vou fingir que rodei. Esta análise é construída a partir da tabela de benchmarks da própria Meta, dos resultados independentes da Artificial Analysis, dos dados de preço e velocidade ao vivo em cada provedor de lançamento, do texto completo da licença e do que os desenvolvedores disseram nas primeiras 72 horas no Hacker News. Onde os números da Meta e os independentes divergem, eu aviso.
A lente que trago é a que uso na eesel para escolher modelos para o teammate de helpdesk: ele chama ferramentas de forma confiável, fica dentro das regras e quanto custa um mês de tráfego real. Passei anos na eesel vendo modelos confiantes darem respostas erradas em filas ao vivo, e por isso toda implantação da eesel é simulada com tickets históricos antes. Uma vitória em benchmark só importa se aparecer ali, e essa é a ideia por trás dos teammates de IA testados com os seus dados antes de entrar no ar.
Onde o Muse Spark Open lidera
A Meta compara o modelo com outros sete modelos de pesos abertos: Inkling, Nemotron 3 Ultra, Reflection Beam, Mistral Large 4, Qwen 3.8, GLM 5.3 e Kimi K3. Aqui está o placar como a Meta o publicou.
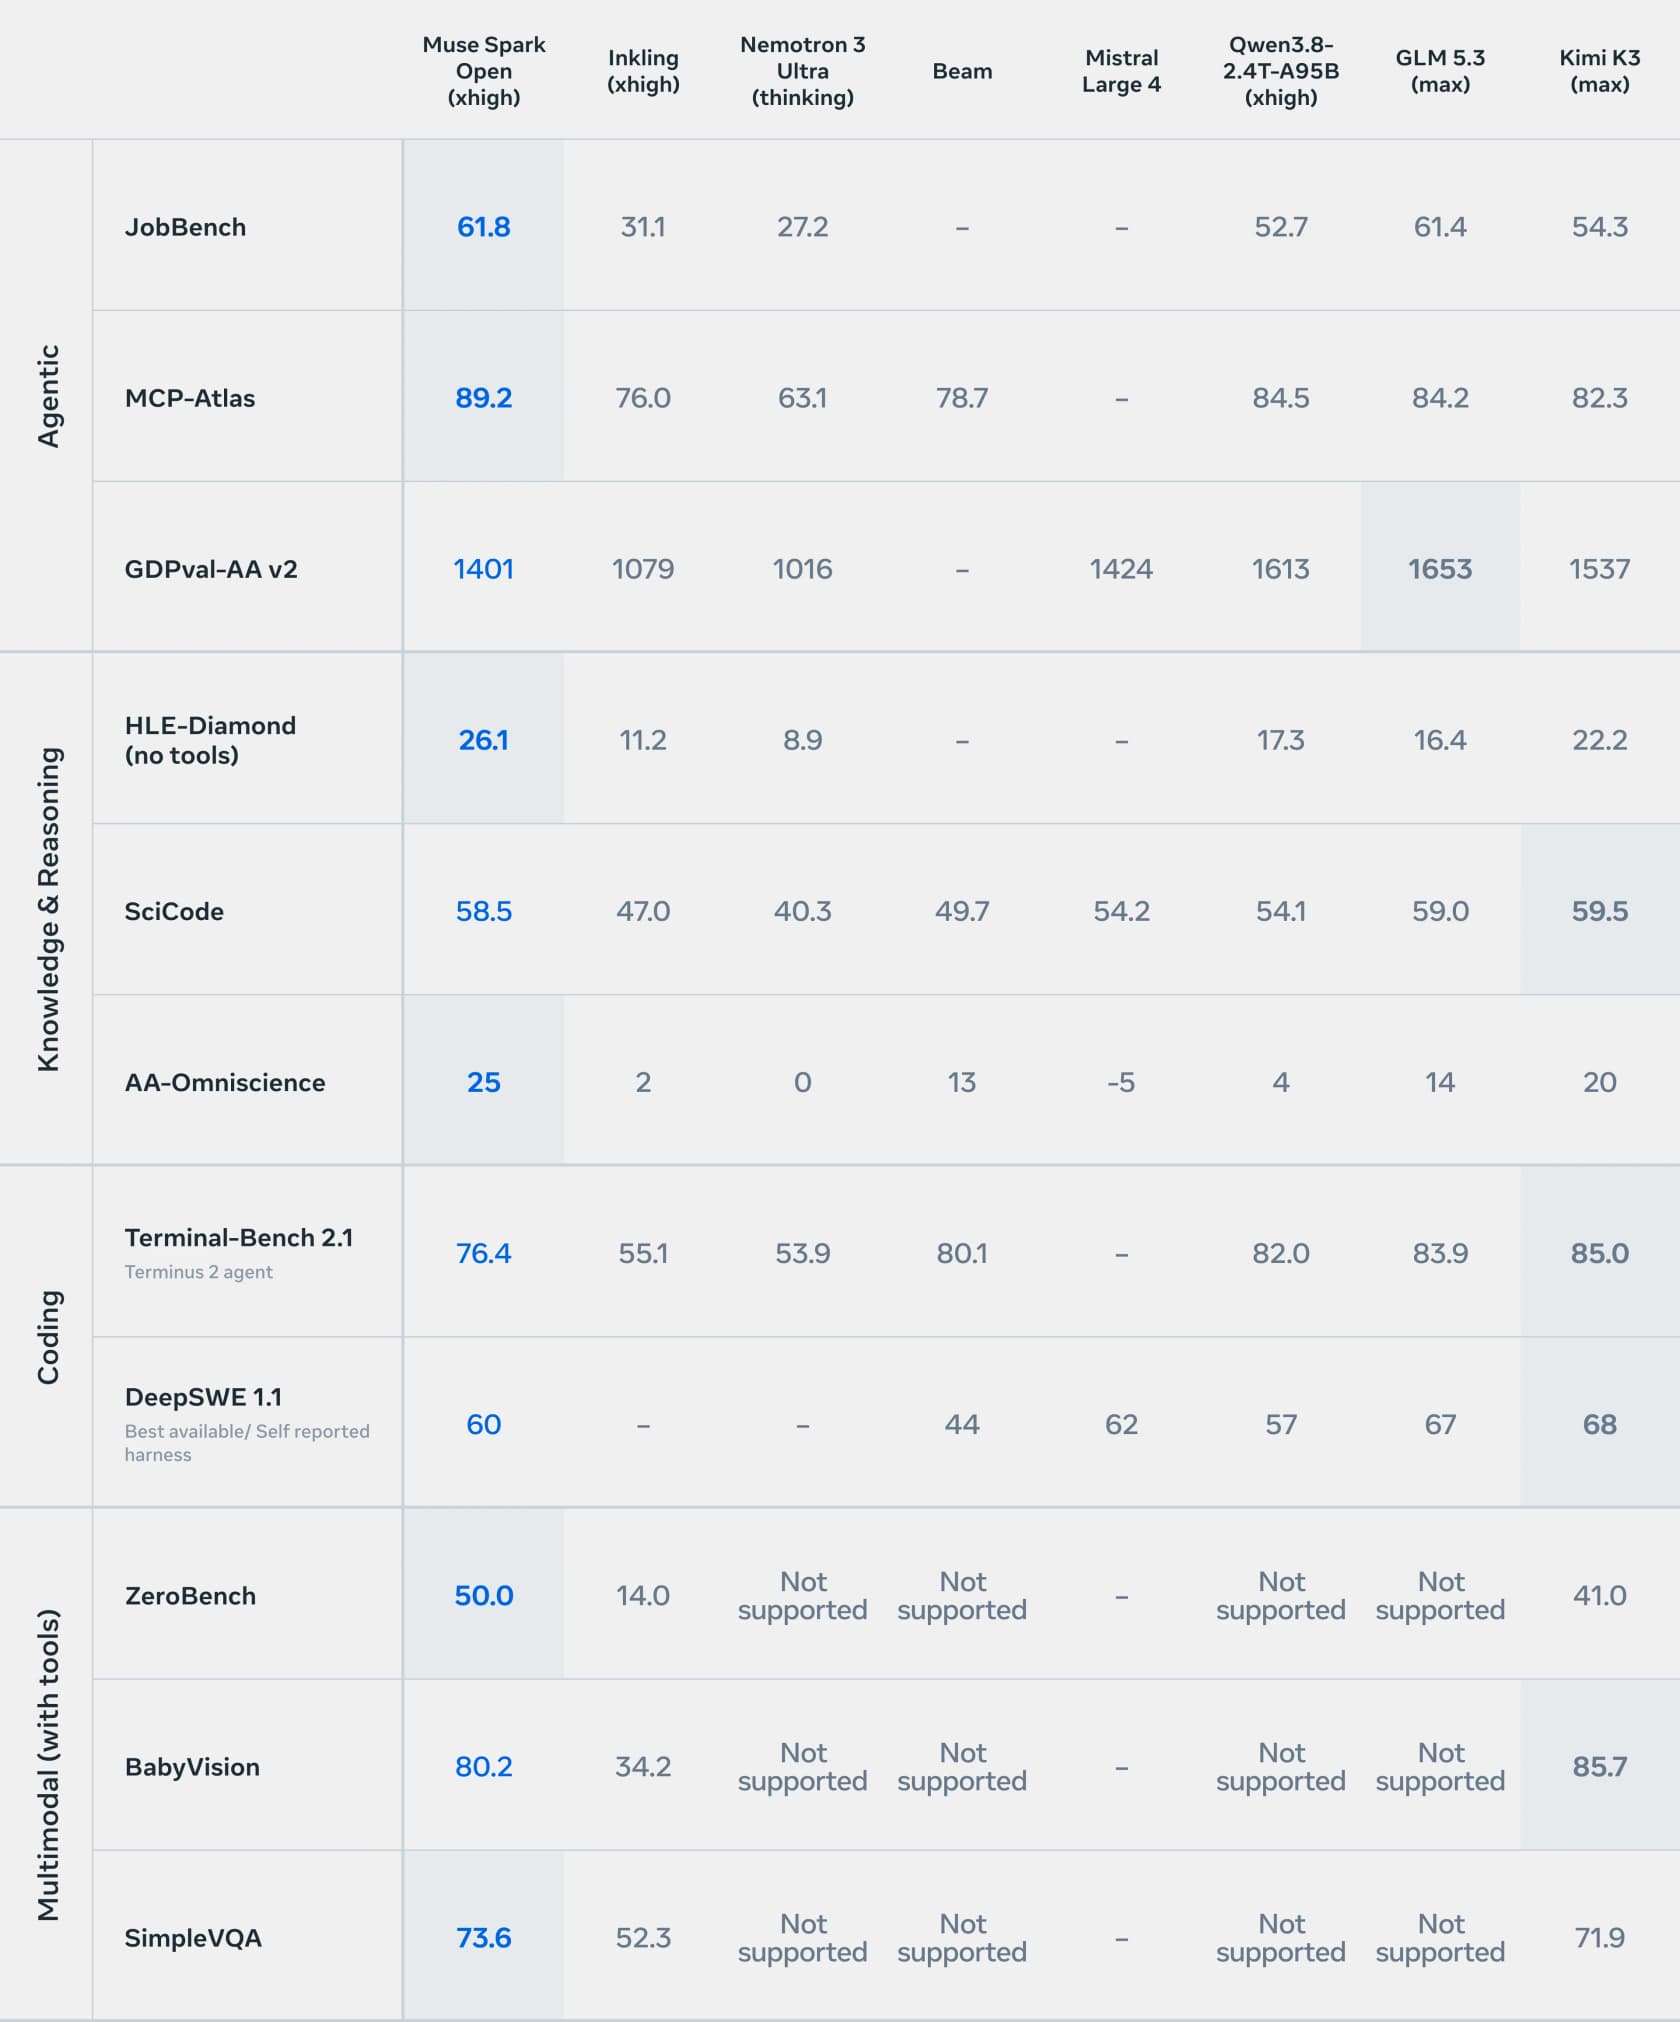
As vitórias são reais e se concentram em um só lugar: agentes que chamam ferramentas.
- MCP-Atlas
89,2, a maior pontuação da tabela. Testa a chamada de ferramentas expostas por servidores MCP, a infraestrutura que a maioria dos agentes usa hoje para acessar um helpdesk, CRM ou banco de dados. - JobBench
61,8, superando por pouco os61,4do GLM 5.3 e bem à frente dos54,3do Kimi K3. - HLE-Diamond
26,1sem ferramentas e AA-Omniscience25, os melhores do conjunto em perguntas difíceis de conhecimento em que inventar coisas é penalizado. - Multimodal: lidera ZeroBench (
50,0) e SimpleVQA (73,6) contra o único outro modelo que suporta esses testes, o Kimi K3.
Os dois parceiros de lançamento citados pela Meta combinam com esse quadro.
"Muse Spark Open consistently selected the right next tool and kept its responses compact, exactly the decisiveness production agents need."
Zimu Li, Member of Technical Staff at Factory, quoted in Meta's developer post
Os dados independentes concordam quanto à eficiência. A Artificial Analysis mediu 110M de tokens de saída para completar todo o seu índice, abaixo da mediana de 130M, e registrou 130,7 tokens por segundo. Isso importa porque o irmão fechado foi no sentido oposto: como cobri na minha análise do Muse Spark 1.3, o 1.3 consumiu 120M de tokens e gerou reclamações de verbosidade.
Onde ele fica atrás
A mesma tabela que o coroa em uso de ferramentas mostra que ele perde nas categorias que a maioria dos desenvolvedores procura.
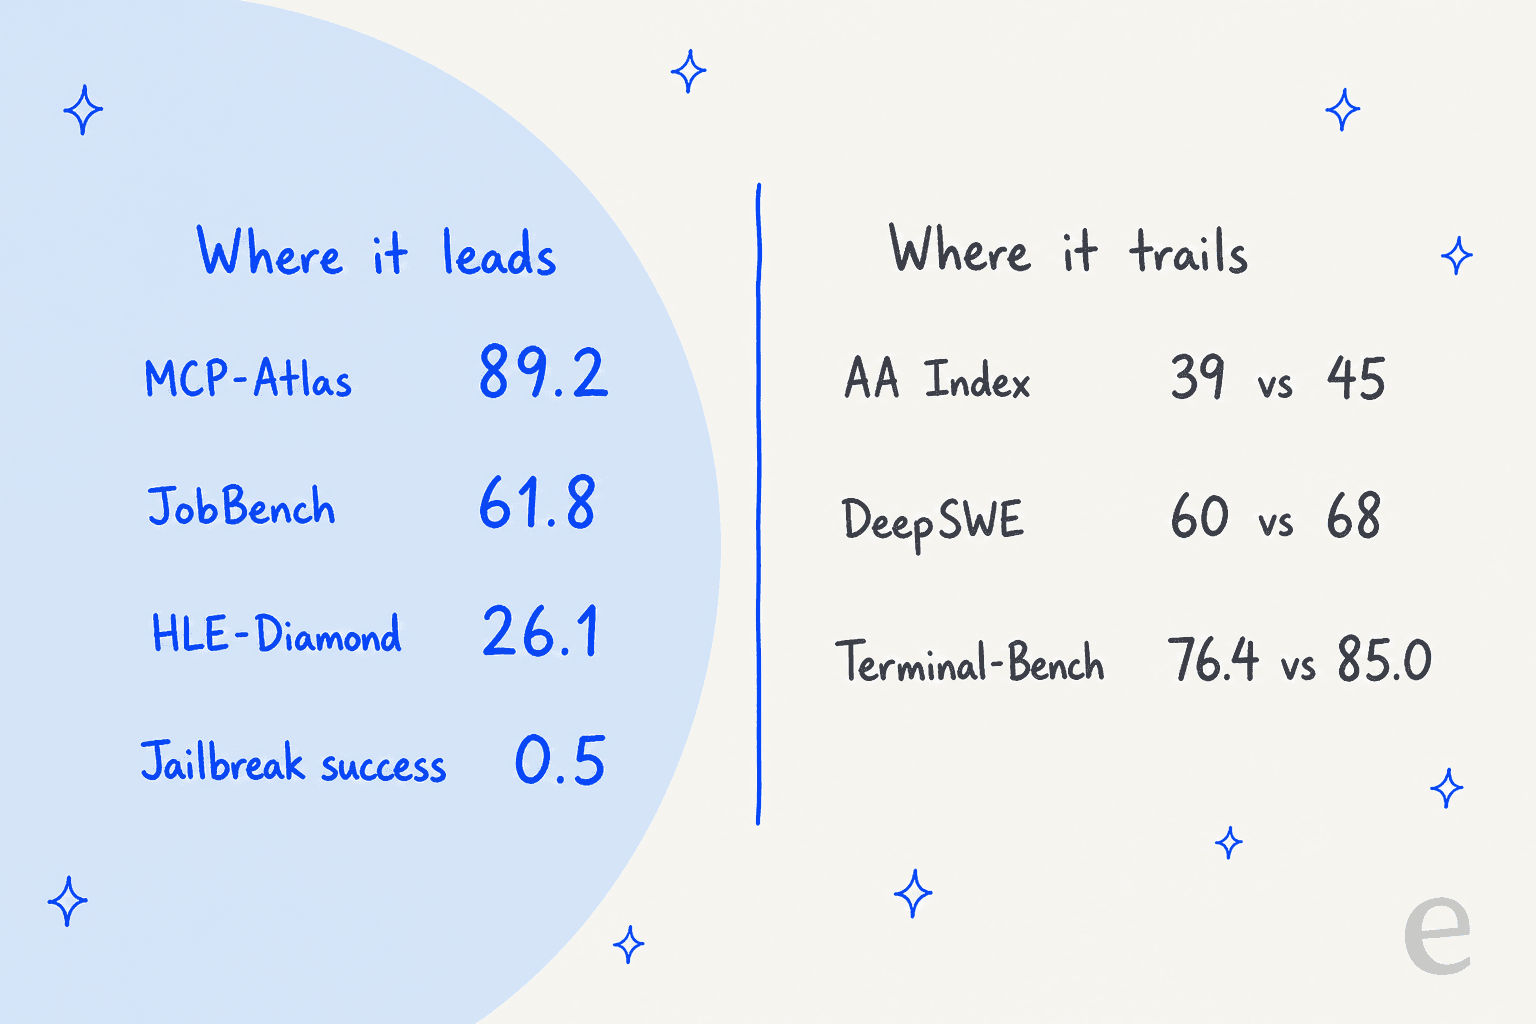
- Inteligência geral. Na linha do Artificial Analysis Intelligence Index da tabela da própria Meta, ele marca
39, atrás de GLM 5.3 (45), Kimi K3 (44) e Qwen 3.8 (40), e um ponto à frente do Mistral Large 4 (38). A Artificial Analysis o coloca em#10entre os 120 modelos que acompanha. - Código. No DeepSWE 1.1 ele marca
60, contra68do Kimi K3 e67do GLM 5.3. No Terminal-Bench 2.1 marca76,4, contra85,0do Kimi K3. Até o Reflection Beam o supera ali, com80,1. - Tarefas de trabalho do mundo real. No GDPval-AA v2 ele marca
1401, abaixo de Mistral Large 4 (1424), Kimi K3 (1537), Qwen 3.8 (1613) e GLM 5.3 (1653).
Os desenvolvedores perceberam. A impressão inicial mais citada na discussão do lançamento foi curta:
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."

Outro comentarista o situou entre seus dois irmãos fechados: "somewhat worse benchmarks than Muse Spark 1.3, closer to 1.2" (modeless, Hacker News). Isso bate com o que os números dizem. Se seu trabalho principal é escrever código, Kimi K3 ou GLM 5.3 é a melhor escolha aberta hoje.
O trade-off de segurança de que ninguém fala
A Meta abre com segurança, e o número principal impressiona. No StrongREJECT v2, um teste adaptativo de jailbreak em que menor é melhor, o Muse Spark Open marca 0,5. O Kimi K3 marca 66,6, o GLM 5.3 62,9, o Qwen 3.8 65,6. O card também reporta 99,2% de recusa de jailbreaks de ciberataque no benchmark interno da Meta e 98,1% de taxa de honestidade no MASK.
Mas a mesma tabela traz um segundo número que a maior parte da cobertura ignorou. O FORTRESS reporta duas pontuações: uma pontuação de risco adversarial (ARS, com que frequência dá ajuda prejudicial) e uma pontuação de recusa excessiva (ORS, com que frequência recusa o que deveria responder). Menor é melhor nas duas.
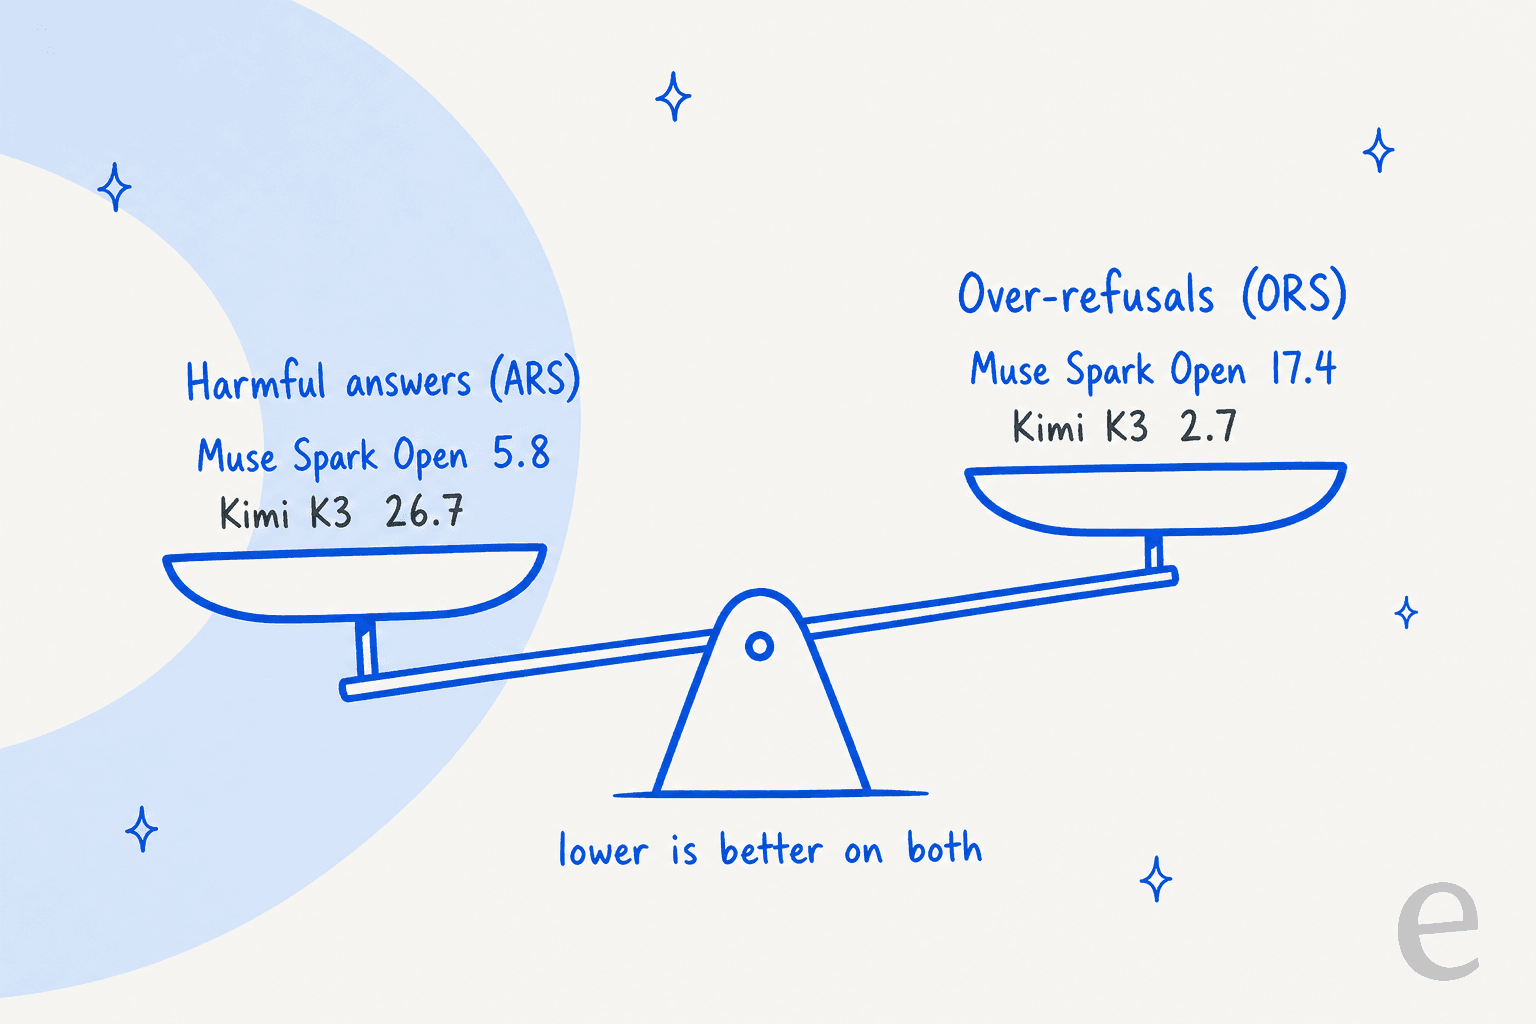
O ORS do Muse Spark Open é 17,4. O do Kimi K3 é 2,7, o do GLM 5.3 é 3,2. Em termos simples: é o modelo mais difícil de enganar da tabela e o mais propenso a dizer não a um pedido legítimo. Para um agente de atendimento ao cliente, isso é uma troca real. Uma pergunta sobre reembolso formulada de modo estranho, ou um cliente descrevendo uma falha em um dispositivo médico, é exatamente o tipo de mensagem inofensiva que um modelo excessivamente cauteloso pode recusar. Eu o testaria com seus próprios tickets bagunçados antes de confiar no destaque de segurança em qualquer direção.
Preços: pesos abertos, tarifas de modelo fechado
Esta é a parte que mais me surpreendeu. Todo provedor de lançamento no OpenRouter cobra exatamente a mesma tarifa.
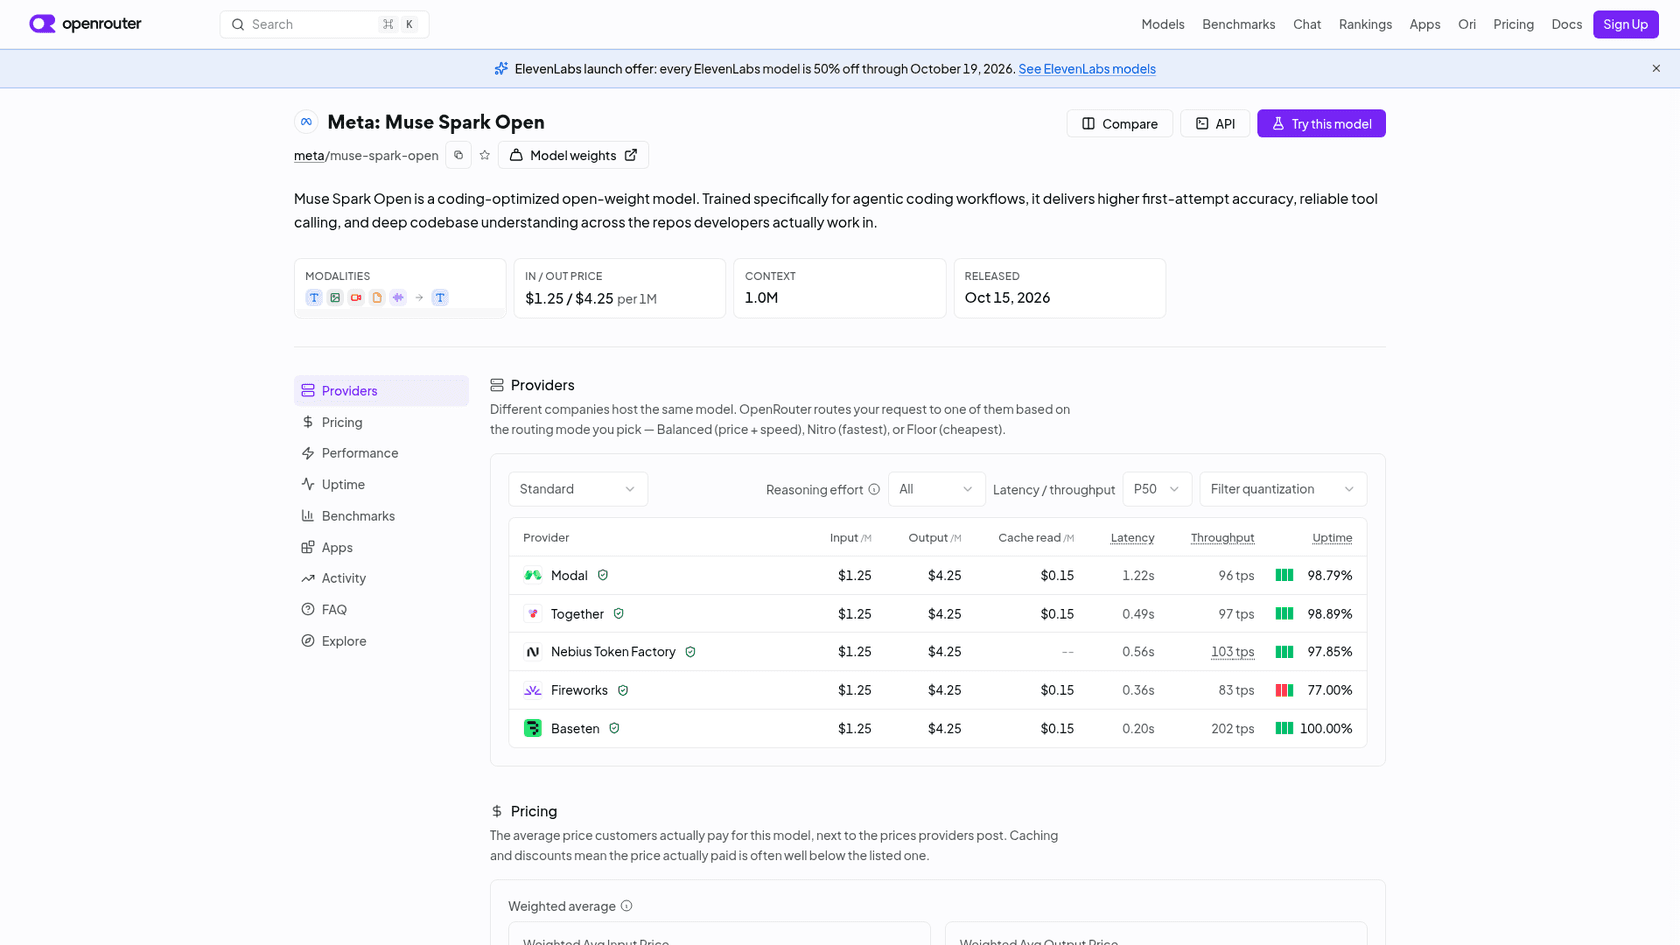
| Provedor | Entrada / 1M | Saída / 1M | Entrada em cache / 1M | Observações |
|---|---|---|---|---|
| Baseten | $1,25 | $4,25 | $0,15 | NVFP4, contexto de 1M, cerca de 200 tokens/s, veja preços da Baseten |
| Fireworks AI | $1,25 | $4,25 | $0,15 | Fine-tuning LoRA serverless, veja preços da Fireworks |
| Together AI | $1,25 | $4,25 | $0,15 | Endpoints dedicados com SLA de 99,9%, veja preços da Together |
| Modal | $1,25 | $4,25 | $0,15 | Endpoints compartilhados ou dedicados |
| Nebius Token Factory | $1,25 | $4,25 | n/d | |
| Groq | Não listado | Não listado | n/d | Prévia limitada, contexto de 131K, ~350+ tokens/s |
Essa tarifa de $1,25 / $4,25 é idêntica à que a Meta cobra pelo Muse Spark 1.3 fechado em xhigh. A Artificial Analysis aponta isso diretamente: o modelo é "particularly expensive when comparing to other open weight models of similar size", contra uma mediana de $0,43 de entrada e $1,68 de saída. O custo para rodar uma tarefa do índice é $0,84.
Por que cinco provedores concorrentes chegariam ao mesmo preço? A licença é a provável razão. Um desenvolvedor na discussão do lançamento explicou:
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model... The usual effect of separate licensing is decreased price competition from public providers."
O contraponto justo, na mesma discussão: um preço fixo também impede que os provedores sirvam uma versão quebrada ou degradada para se underquotar (dannyw, Hacker News). As duas coisas podem ser verdade.
Quanto isso custa na prática? Um exemplo aproximado para um agente que lê muito e escreve pouco (saída precificada a $4,25 por milhão):
| Volume mensal | Entrada | Saída | Fatura mensal aprox. |
|---|---|---|---|
| Piloto pequeno | 10M de tokens | 2M de tokens | $21 |
| Um agente ocupado | 100M de tokens | 20M de tokens | $210 |
| Implantação em toda a equipe | 1B de tokens | 200M de tokens | $2.100 |
Colocar em cache o contexto repetido a $0,15 em vez de $1,25 pode reduzir bastante o lado da entrada se seu agente reutiliza a mesma base de conhecimento em cada chamada. Lembre que o raciocínio xhigh é o padrão, então passe para medium em respostas curtas.
Rodando por conta própria: o que o hardware realmente exige
O argumento que mais chamou atenção foi o da Apple: rodar um modelo de nível de ponta na sua mesa. A publicação da Apple sobre o MLX é honesta sobre o que isso significa. Os pesos NVFP4 ocupam cerca de 493GB e, com a memória de trabalho por cima, "the model cannot fit on a single machine."
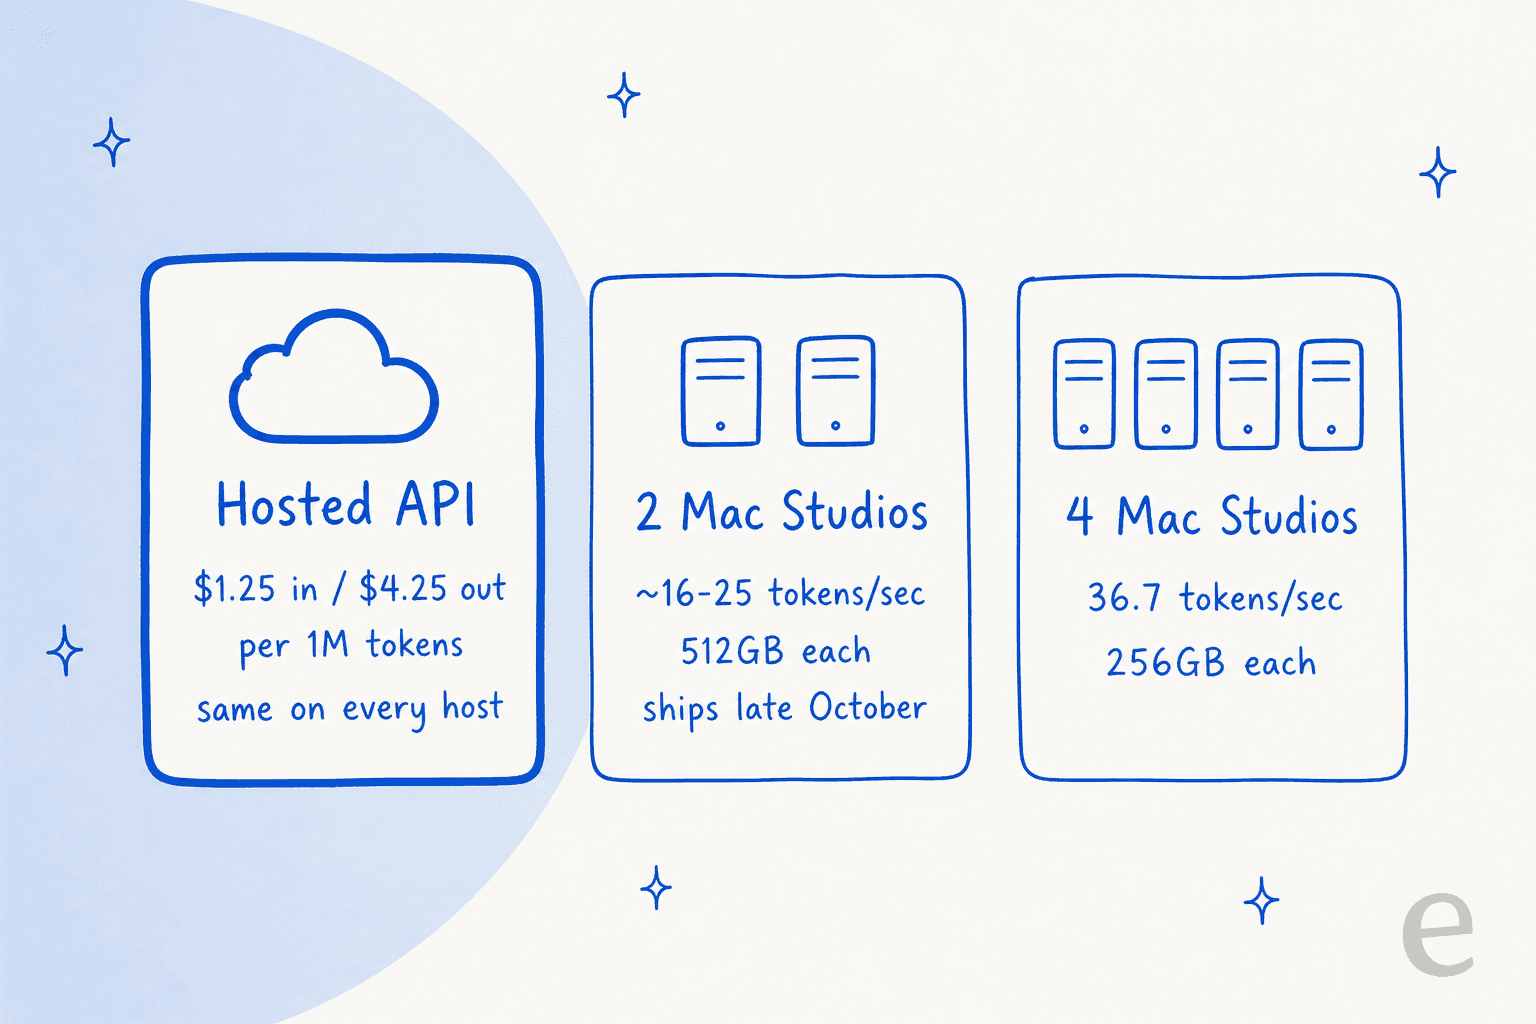
Velocidades de decodificação medidas pela Apple com contexto de 8.192 tokens:
| Configuração | Velocidade de decodificação |
|---|---|
| 2 Mac Studios (M5 Ultra), divisão em pipeline | 15,74 tokens/s |
| 2 Mac Studios (M5 Ultra), divisão por tensor | 24,99 tokens/s |
| 4 Mac Studios (M5 Ultra), divisão por tensor | 36,73 tokens/s |
A configuração com duas máquinas exige o M5 Ultra de 512GB, que a loja da Apple lista como "coming late October", ainda sem preço. As configurações M5 Ultra começam em $5.499 com muito menos memória. Um comentarista resumiu a reação:
"A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah."
Em GPUs, o model card pede pelo menos 700GB de VRAM para NVFP4 e 2TB para BF16; o post para desenvolvedores da Meta diz que o NVFP4 roda em quatro GPUs Blackwell Ultra ou oito H200. A versão de 2 bits da Unsloth reduz isso para cerca de 300GB de memória combinada, com alguma perda de qualidade.
Para crédito da Meta, o suporte desde o primeiro dia é incomumente completo: SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp e Unsloth funcionaram no lançamento, com fine-tuning via TorchTitan, Fireworks e Together. Como notou um desenvolvedor, a Meta "did the actual work of testing and documenting deployments on several platforms" (bahmboo, Hacker News).
Então quem deveria hospedar por conta própria? A resposta da discussão combina com a minha: equipes com motivo contratual ou legal para manter os dados no próprio hardware (mbreese, Hacker News). Para todos os outros, a $210 por mês para um agente ocupado, uma API hospedada continua mais barata por muito tempo do que uma configuração com dois Macs que os comentaristas já precificam acima de $20.000.
As letras miúdas da licença
A Muse Model License é permissiva na superfície: uso livre, fine-tuning, destilação e revenda. As condições que importam:
- Atribuição no seu produto. Você deve "prominently display 'Built with Muse Spark Open'" na interface, na documentação, no site ou nas configurações de qualquer produto que o use ou use algo derivado dele, incluindo modelos treinados com suas saídas.
- Um limite de $20 milhões para provedores. Se você vende acesso ao modelo como serviço e a receita da sua empresa passa de
$20 milhõesem qualquer período de 12 meses, precisa antes de um acordo escrito separado com a Meta. - Proibido para menores de 18. A política de uso diz que o modelo "is not intended for individuals under the age of 18", e quem o implanta carrega a responsabilidade se menores puderem acessá-lo.
- Uma política de uso ampla. Ela proíbe o exercício profissional sem licença (jurídico, médico, financeiro), o uso para processar dados pessoais sensíveis sem ter direito a isso e a apresentação de suas saídas como escritas por humanos.
Esse quarto ponto importa para equipes de suporte em setores regulados. Um agente que redige respostas para uma empresa de saúde ou finanças precisa de um desenho com humano no circuito de qualquer forma, e o próprio card da Meta recomenda "human-in-the-loop confirmation for irreversible actions." Se é "código aberto" é um debate justo; na discussão do lançamento, vários desenvolvedores o chamaram de "open-weight" no máximo (isityettime, Hacker News).
Muse Spark Open vs as alternativas
| Modelo | AA Index (tabela da Meta) | DeepSWE 1.1 | MCP-Atlas | StrongREJECT (menor é melhor) | Melhor para |
|---|---|---|---|---|---|
| Muse Spark Open | 39 | 60 | 89,2 | 0,5 | Agentes com muitas ferramentas, implantações cautelosas |
| Kimi K3 | 44 | 68 | 82,3 | 66,6 | Código e terminal com modelo aberto |
| GLM 5.3 | 45 | 67 | 84,2 | 62,9 | Melhor pontuação geral entre os abertos |
| Qwen 3.8 | 40 | 57 | 84,5 | 65,6 | Uso geral amplo |
| Mistral Large 4 | 38 | 62 | n/d | n/d | Implantações hospedadas na UE |
Se você pode usar um modelo fechado, a diferença aumenta. A faixa de ponta da própria Meta é coberta na minha análise do Muse Wonder, e o Claude Opus 5.5 recebe o mesmo tratamento na minha análise do Opus 5.5. Ambos marcam bem acima de 39 no mesmo índice.
Se preço importa mais que uso de ferramentas, comece pela minha análise do DeepSeek V4 Flash. O Qwen 3.8 é o outro modelo aberto que vale a pena olhar, coberto na minha análise do Qwen 3.8.
Veredito: quem deve usar o Muse Spark Open
Nota: 3,5/5.
- Escolha se precisa de pesos para baixar, seu agente vive ou morre por chamar a ferramenta certa e você prefere que ele recuse demais a recuse de menos. As pontuações de MCP e o ajuste de segurança são pontos fortes reais.
- Pule se você escreve principalmente código (Kimi K3 ou GLM 5.3), quer os tokens abertos mais baratos (o piso de
$1,25 / $4,25está definido) ou esperava rodá-lo em uma única máquina. - Teste antes de confiar na taxa de recusa excessiva com o seu próprio tráfego.
A lição maior para equipes de suporte é que o modelo raramente é o que quebra. Nas próprias ligações de vendas da eesel, a falha de que mais ouço falar é um bot que respondeu a clientes reais com detalhes inventados quando a base de conhecimento não tinha nada relevante. Outro comprador, um avaliador técnico de uma empresa de hardware, perguntou diretamente se a IA recorreria ao conhecimento geral da web quando não soubesse, e se isso poderia ser desativado. Esses são problemas de recuperação, de proteção e de transferência. Trocar por um modelo mais inteligente ou mais seguro não os resolve sozinho. Meu guia sobre automatizar o suporte com agentes de IA percorre as camadas que resolvem.
Experimente a eesel no seu helpdesk
Se você estava olhando o Muse Spark Open porque quer um agente de IA trabalhando na sua fila de suporte, o teammate de IA para helpdesk da eesel dispensa a compra de GPUs. Ele se conecta ao Zendesk, Freshdesk, Gorgias e outros em minutos, aprende com seus tickets passados e sua central de ajuda, e é simulado com seus tickets históricos antes de responder a um único cliente. Você decide quais tickets ele responde, quais ele redige como notas internas e quando ele passa para uma pessoa.

Se preferir integrar um modelo por conta própria, meu guia sobre conectar o Claude ao seu helpdesk mostra o trabalho envolvido. O caminho da própria Meta é coberto em Muse para atendimento ao cliente.
Os planos começam em $299 por mês na página de preços da eesel, e você pode experimentar grátis antes. Experimente a eesel e veja o que ela teria respondido nos tickets do mês passado.