

Resumo
O Meta Muse Wonder é a primeira família de modelos de ponta da Meta, lançada em 12 de outubro de 2026, em duas versões: o Muse Wonder na API, a US$ 4/US$ 20 por milhão de tokens, e o Muse Wonder Full, que você só consegue dentro de uma assinatura do Muse Code a partir de US$ 50. As notas de destaque são do Wonder Full, não do modelo que você pode comprar por token. O Wonder Full empata com o Claude Opus 5.5 em seis vitórias para cada lado nos 14 benchmarks da Meta; o Wonder simples vence um e custa exatamente o mesmo que o Opus 5.5.
Meu veredito: o Wonder Full é o primeiro modelo da Meta que eu colocaria na lista de candidatos para execuções longas de agentes e trabalho jurídico ou financeiro. O Wonder simples é um modelo sólido, com um preço que ainda não dá motivo para trocar o Opus 5.5. E se você é de uma equipe de suporte lendo a cobertura do lançamento, o modelo é a menor parte do trabalho: um teammate de IA como o agente de helpdesk da eesel roda em modelos de ponta como este e é testado nos seus tickets anteriores antes de falar com um cliente.
O que é o Meta Muse Wonder?
O Muse Wonder é a série de modelos mais recente do Meta Superintelligence Labs, e a Meta chama o par de "our most capable models" até agora. Ele fica acima da linha de modelos Muse Spark 1.3 e é algo separado do Meta Muse, o agente pessoal para consumidores lançado em setembro. Pense no Wonder como o motor e no Muse como um dos carros em que ele vai entrar em breve.
Eu construo integrações e APIs na eesel, então leio páginas de lançamento como leio a documentação de qualquer fornecedor: o que posso de fato chamar, a que preço e com quais condições. Passei a semana do lançamento na documentação dos modelos da Meta, na página de preços e limites de uso, na tabela de benchmarks e na discussão do Hacker News com 362 comentários. Esta análise é construída a partir disso, não de um comunicado de imprensa.
Veja o que a Meta entrega, em uma tabela:
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| ID do modelo | muse-wonder-1.0 | muse-wonder-full-1.0 |
| Onde obter | Meta Model API, OpenRouter, todos os planos do Muse Code | Apenas nos planos Muse Code Power Usage e Maximum Usage |
| Janela de contexto | 1.048.576 tokens | 1M tokens |
| Tipos de entrada | Texto, imagem, vídeo, áudio, PDF | Não documentado separadamente |
| Esforço de raciocínio | "minimal" a "max" | Exibido em max (xhigh no SWE-Marathon) |
| Preço | US$ 4,00 entrada / US$ 0,20 em cache / US$ 20,00 saída por 1M de tokens | Incluído em um plano mensal de US$ 50 ou US$ 200 |
| Status | Prévia | Somente por assinatura |
Dois detalhes na documentação dos modelos importam mais do que parecem. Primeiro, o Muse Wonder está marcado como prévia. Segundo, a Meta afirma que "setting reasoning effort to 'max' on Muse Wonder doesn't select" o Wonder Full. Não existe nenhum parâmetro de API que desbloqueie o modelo maior.
Os benchmarks: onde o Wonder Full vence e onde não vence
A página do modelo da Meta publica uma tabela de 14 linhas comparando os dois modelos Wonder com o Claude Fable 5.1, o GPT-6 Astra e o Claude Opus 5.5, todos com raciocínio em max. Contei o vencedor em negrito de cada linha.
| Benchmark | O que testa | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index | Índice composto interno da Meta | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | Trabalho de agentes jurídicos | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | Pesquisa financeira | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | Consultas abertas de saúde | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | Fluxos de trabalho empresariais de ponta a ponta | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | Trabalho profissional | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | Uso profissional de ferramentas | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (parcial) | Uso de computador | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| MemoryBench | Lembrar do contexto | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | Programação no terminal | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | Programação de longo prazo | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | Engenharia de duração ultralonga | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | Programação do zero | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | Geral | 56 | 52 | 53 | 53 | 58 |
O saldo: o Wonder Full vence 6 linhas, o Opus 5.5 vence 6, o GPT-6 Astra vence 1 e o Muse Wonder simples vence 1 (MemoryBench, por 0,1 ponto sobre o próprio irmão maior). O Claude Fable 5.1 não vence nenhuma.
Esse é um resultado real. Um ano atrás ninguém incluía a Meta entre os laboratórios de ponta, e o Wonder Full vencer o GPT-6 Astra em 11 das 14 linhas é um salto enorme. O número jurídico é o que mais chama atenção: 13,1 no benchmark de agentes jurídicos da Harvey é baixo em termos absolutos, mas é mais de três vezes os 4,2 do Opus 5.5. Se você acompanha a Harvey AI, sabe como esse benchmark é difícil para todos os modelos.
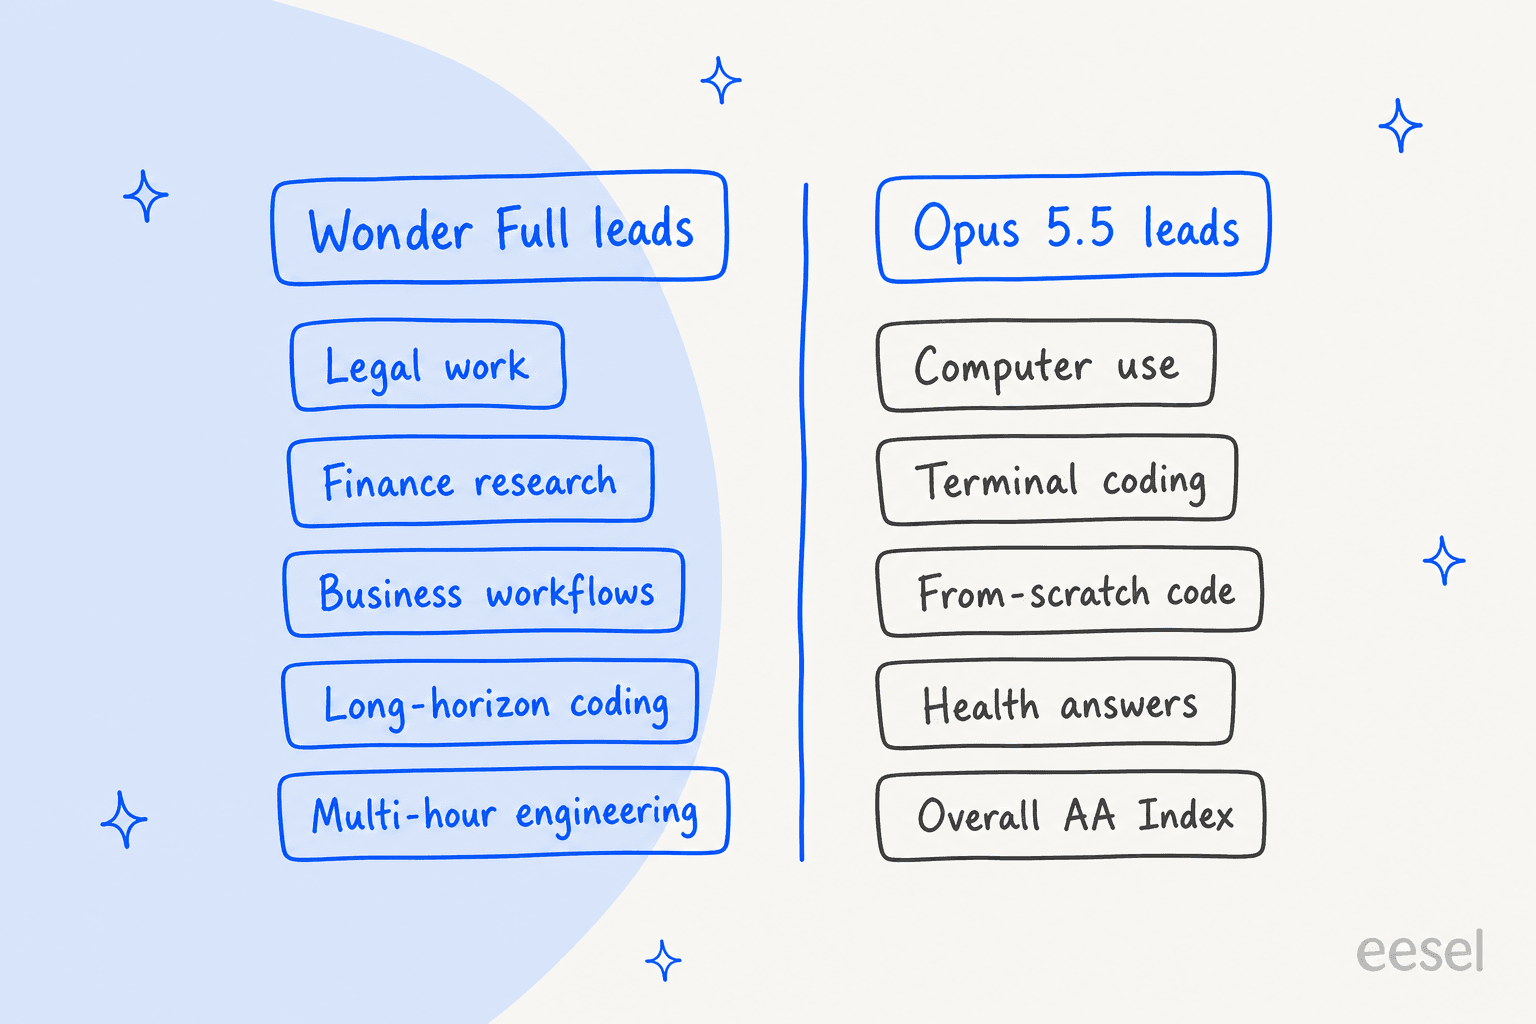
A divisão tem um padrão. O Wonder Full vence quando a tarefa é longa e cheia de documentos: um trabalho jurídico, um relatório de pesquisa financeira, um projeto de programação de várias horas. O Opus 5.5 ainda vence quando o modelo precisa operar um computador ou escrever algo do zero, e sua vantagem no ProgramBench (70,5 contra 59,0) é a maior diferença de toda a tabela. Uma ressalva sobre o enquadramento da Meta: o Personal Superintelligence Index é um índice composto interno da própria Meta, então eu daria a ele menos peso do que às linhas de terceiros.
O blog de lançamento da Meta também mostra o ranking independente do Artificial Analysis em 12 de outubro, em que o Wonder Full aparece em segundo.
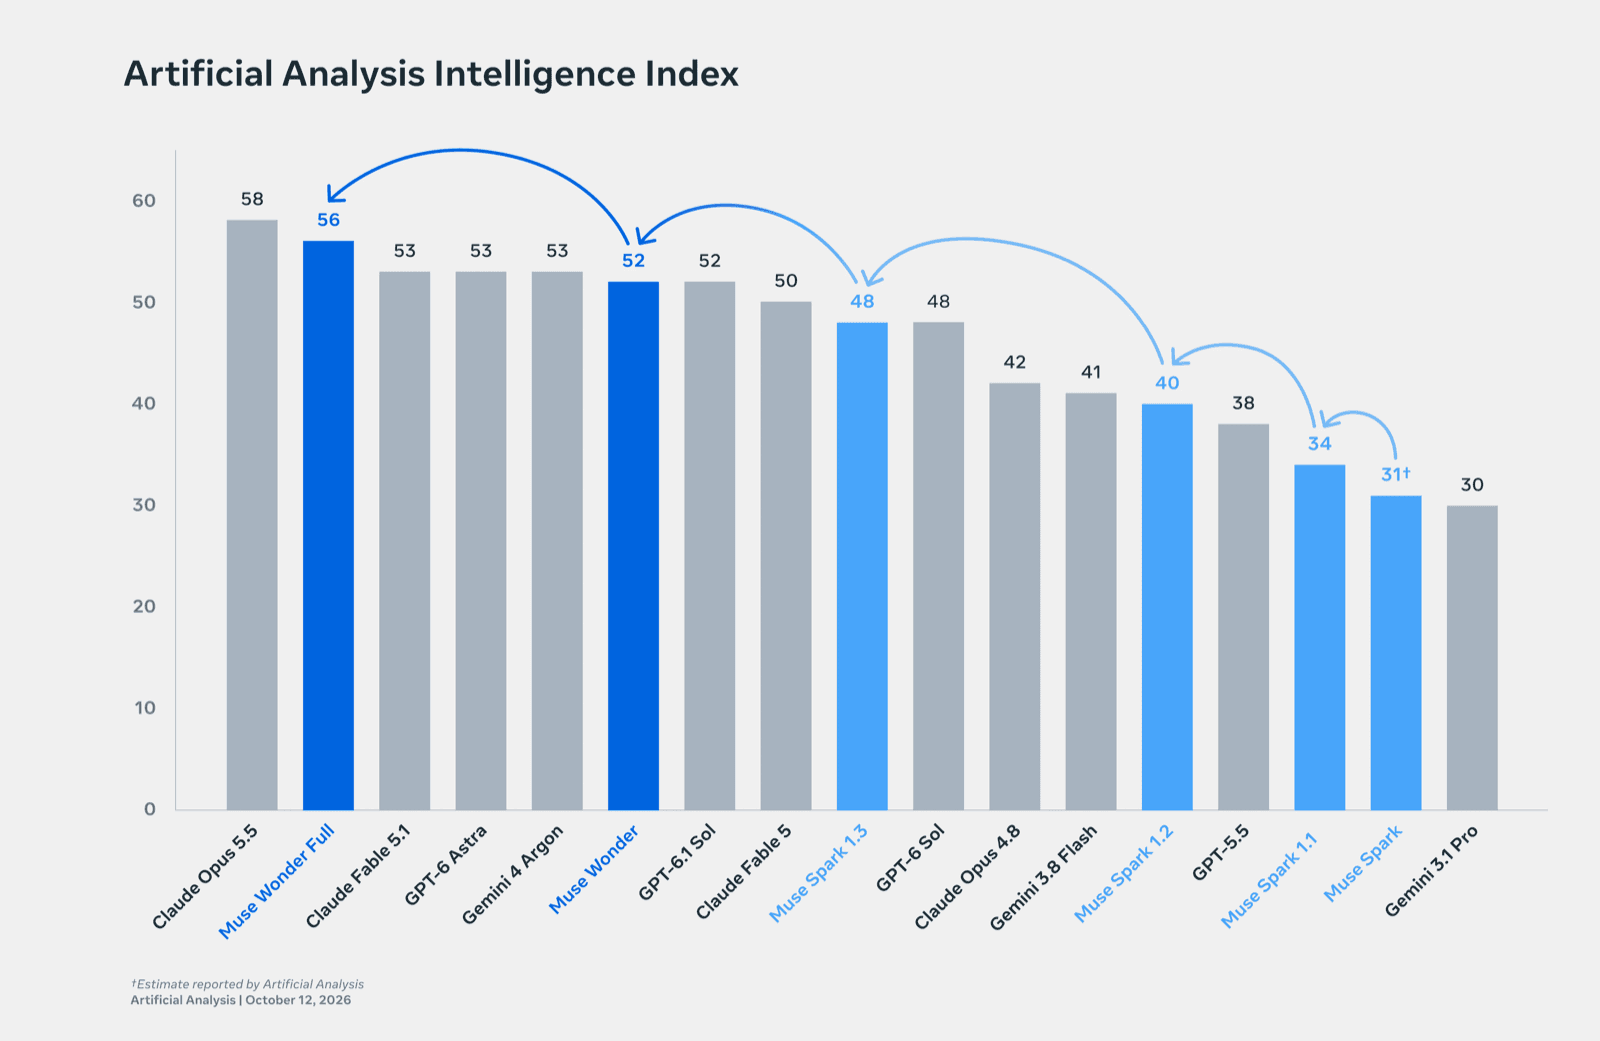
O pessoal do HN reagiu a esse segundo lugar mais ou menos como você imaginaria:
"2nd place model on aa according to them, losing only to opus 5.5 is really really not bad"

Os rankings mudam rápido, porém. Mais tarde no mesmo dia, outro comentarista relatou que o Wonder Full tinha caído para o quinto lugar no placar ao vivo, atrás do Gemini 4 Argon. Trate qualquer captura de tela isolada de ranking como um instantâneo.
A pegadinha: o Wonder que você pode comprar não é o Wonder do gráfico
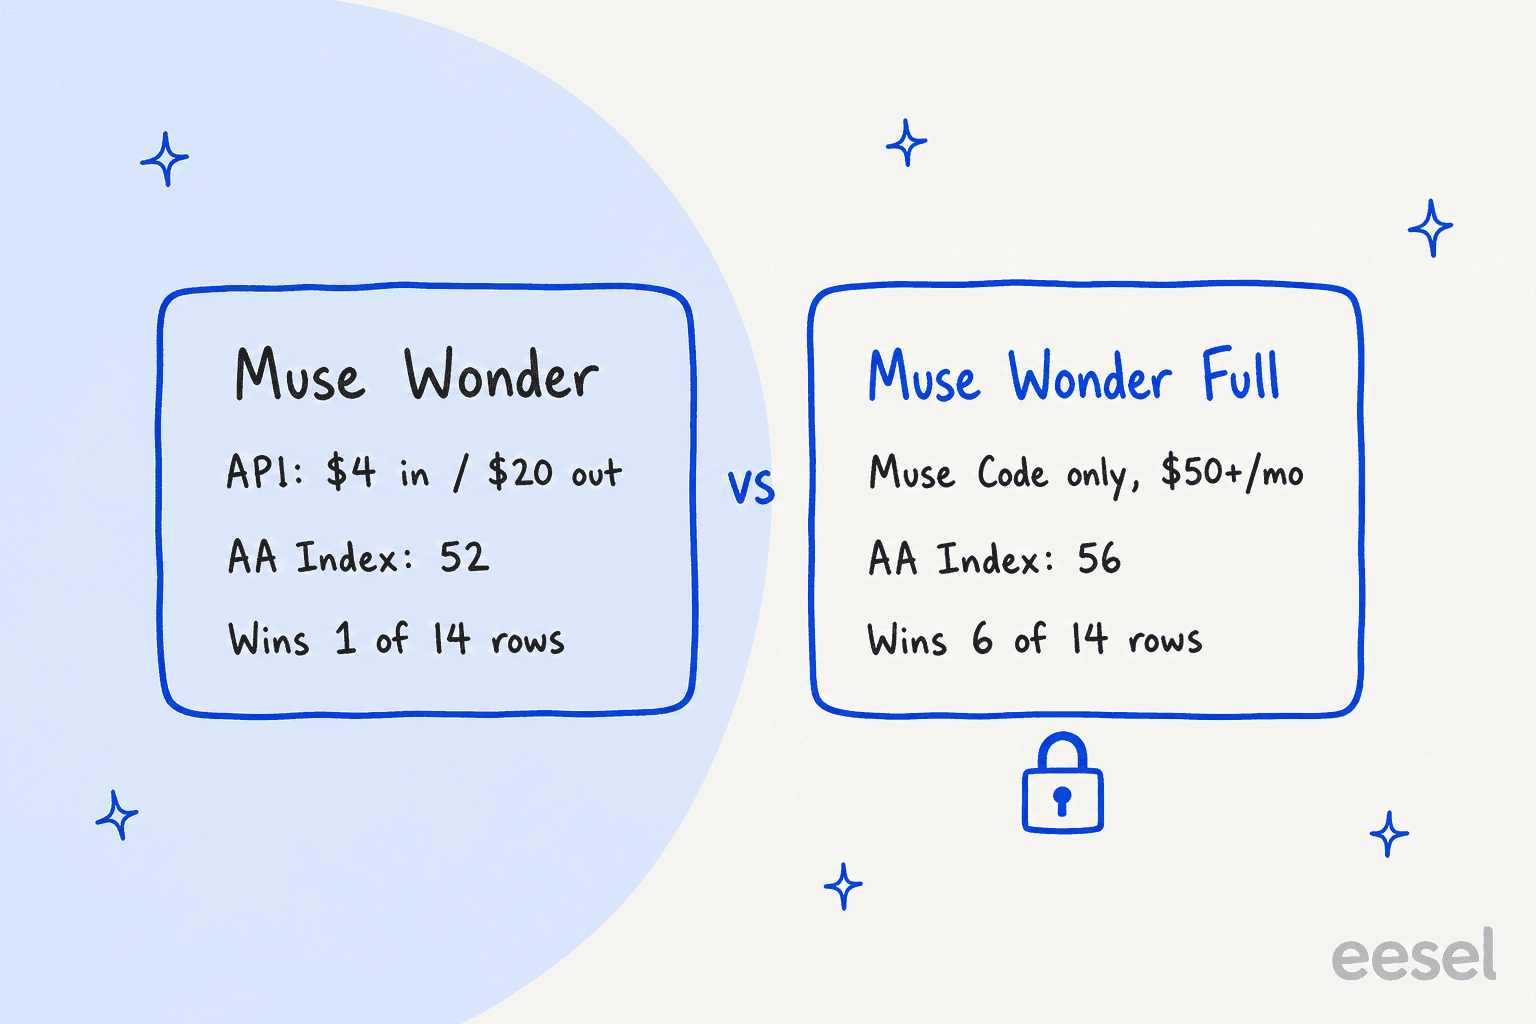
Esta é a parte que a maioria da cobertura do lançamento deixa passar. Olhe o gráfico do AA de novo: o modelo que você pode chamar pela API marca 52. Isso está abaixo do Fable 5.1, do GPT-6 Astra e do Gemini 4 Argon (todos com 53) e no mesmo nível do GPT-6.1 Sol. Ainda é um modelo forte, cerca de quatro pontos acima do Muse Spark 1.3 no mesmo gráfico. Mas não é ele que supera o Opus 5.5.
Um comentarista do HN percebeu isso poucas horas após o lançamento:
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Simon Willison listou os modelos que sua chave de API conseguia ver, e o muse-wonder-1.0 era o único Wonder da lista. Então, se você é um desenvolvedor construindo um produto, a decisão não é "Muse Wonder Full contra Opus 5.5". É "Muse Wonder com 52 contra Opus 5.5 com 58, pelo mesmo preço". Uma venda bem mais difícil.
Preços do Muse Wonder
Os preços vêm em dois formatos separados, que não se sobrepõem.
Pagamento por uso na Meta Model API (da tabela de preços da Meta):
| Uso | Muse Wonder (modo Standard) | Modo Contributor |
|---|---|---|
| Entrada | US$ 4,00 por 1M de tokens | Não disponível |
| Entrada em cache | US$ 0,20 por 1M de tokens | Não disponível |
| Saída | US$ 20,00 por 1M de tokens | Não disponível |
| Grounding com busca na web | US$ 2,50 por 1.000 consultas | Não disponível |
| Limite de taxa | 3.000 requisições e 4M de tokens por minuto | Não disponível |
A Meta também afirma que não há sobretaxa para contexto longo e que os tokens de direcionamento injetados em cada prompt não são cobrados. É uma tabela de preços justa e limpa. Também é uma grande mudança em relação ao antigo hábito da Meta de cobrar menos que todo mundo. O preço do Muse Spark 1.3 é US$ 1,25/US$ 4,25, e a faixa Contributor cai para US$ 0,10/US$ 0,20. O Wonder não tem faixa com desconto na API.
"$4/$20 in vs out making it higher than Sol and on par with Opus."
Veja como isso se compara aos concorrentes da tabela da Meta, todos nas tarifas padrão de API de cada página de preços do fornecedor:
| Modelo | Entrada por 1M | Entrada em cache por 1M | Saída por 1M |
|---|---|---|---|
| Muse Wonder | US$ 4,00 | US$ 0,20 | US$ 20,00 |
| Claude Opus 5.5 | US$ 4,00 | US$ 0,20 | US$ 20,00 |
| GPT-6 Astra | US$ 10,00 | US$ 1,00 | US$ 50,00 |
| Claude Fable 5.1 | US$ 10,00 | US$ 0,25 | US$ 50,00 |
| Muse Spark 1.3 | US$ 1,25 | US$ 0,15 | US$ 4,25 |
O Muse Wonder e o Opus 5.5 custam o mesmo até o centavo, inclusive na tarifa de cache. Coloque seu próprio volume mensal abaixo para ver a diferença em relação aos outros.
As assinaturas do Muse Code, o único caminho até o Wonder Full, vêm em quatro planos:
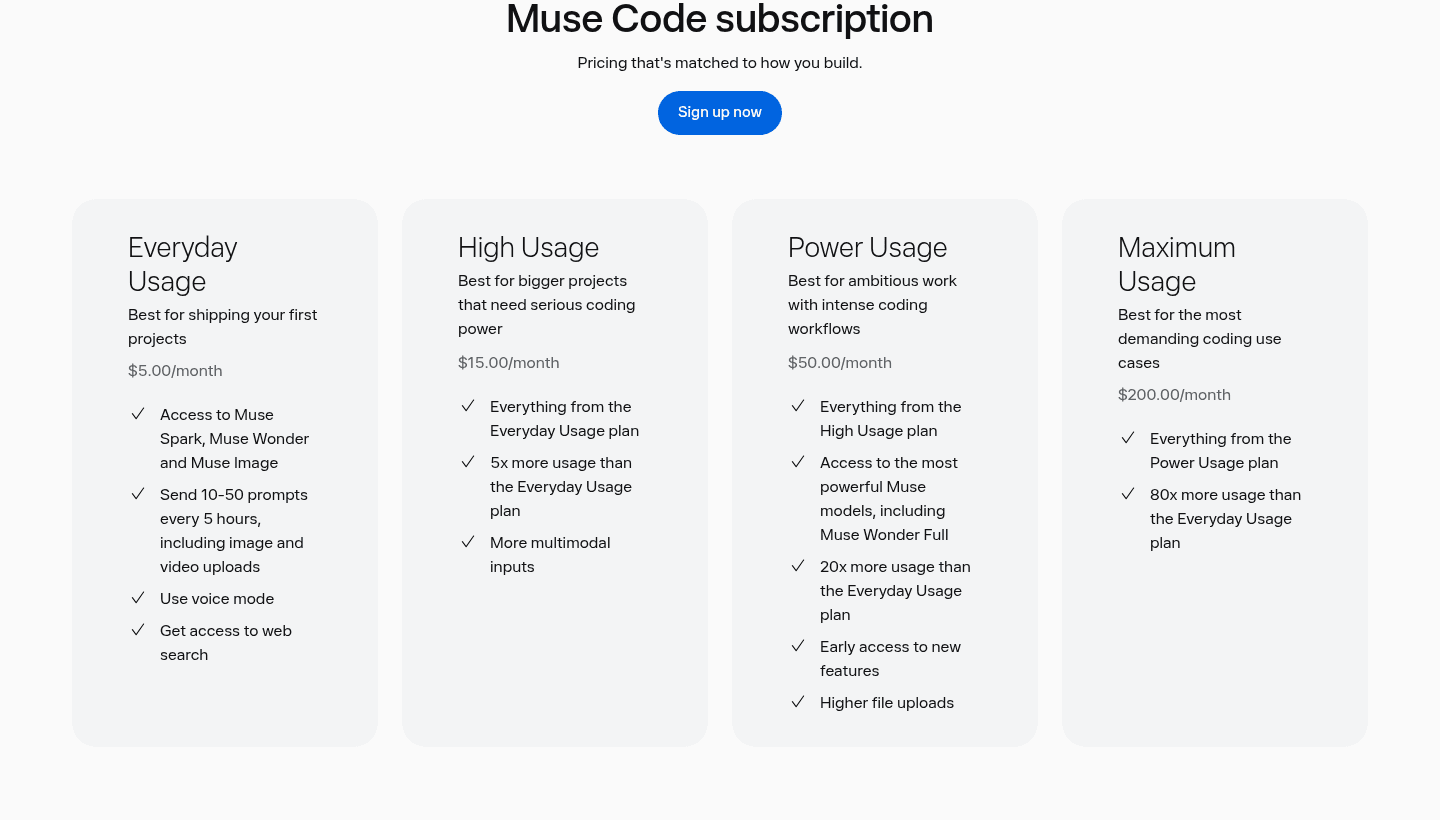
| Plano | Preço | Uso | Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | US$ 5/mês | 10-50 prompts a cada 5 horas | Sim | Não |
| High Usage | US$ 15/mês | 5x o Everyday | Sim | Não |
| Power Usage | US$ 50/mês | 20x o Everyday | Sim | Sim |
| Maximum Usage | US$ 200/mês | 80x o Everyday | Sim | Sim |
Os preços vêm da página do Muse Code; as regras dos planos estão na documentação de assinaturas. Vale ler as letras miúdas: é preciso ter 18 anos ou mais, a disponibilidade "may vary by region", não há reembolso no cancelamento e a Meta pode revogar uma assinatura imediatamente por violação de política. Além disso, uma chave de assinatura só funciona dentro da CLI do Muse Code, então você não pode direcionar o tráfego do seu aplicativo por um plano de US$ 50. Para o custo completo do agente de programação em si, veja minha análise de preços do Muse Code.
No plano de entrada, um dos primeiros usuários achou os limites apertados:
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
Ele relatou que três prompts curtos consumiram 17% da cota semanal. Como o Wonder Full começa na faixa de US$ 50 de qualquer forma, eu planejaria o orçamento para o Power Usage se o Full for o motivo de você estar aqui.
Active Memory e Active Focus: o que realmente há de novo
A Meta enquadra o Wonder em torno de duas capacidades com nome. O Active Memory é "carrying important context about you across conversations and actively retrieving the details relevant to the task at hand." O Active Focus é como o modelo continua trabalhando em direção a um objetivo difícil: "trying alternative approaches, working through blockers, and adapting to new information", enquanto pede esclarecimentos e confirma "before taking important actions."
Ambas correspondem a linhas da tabela. O MemoryBench é o único lugar onde o Wonder simples vence de forma isolada (85,6), e o SWE-Marathon é onde a vantagem do Full é maior (57,5 contra 46,3 do Opus 5.5). Isso combina com a documentação para desenvolvedores da Meta, que vende o Wonder para "long-running, complex tasks where capability matters more than cost per token, such as multi-file coding changes, multi-hour agent runs, and sub-agent orchestration," e manda tudo que for de alto volume ou sensível à latência de volta para o Muse Spark.
As demonstrações do lançamento têm um tom mais pessoal do que corporativo: um plano de corrida montado entre apps, brindes personalizados pedidos a partir de fotos do Instagram, um mapa de lugares de casamento, uma reclamação de seguro. É uma prévia de para onde esse modelo está indo, o agente pessoal Muse, que a Meta diz que o Wonder "will soon power", começando pelos assinantes.
Em segurança, a Meta chama o Wonder de seu "most aligned model to date", com as salvaguardas mais fortes contra uso indevido químico, biológico e cibernético, sem deixar de permitir trabalho cibernético defensivo sob seu framework de escalonamento. O relatório completo de segurança está listado como "available soon", então essa parte ainda não pode ser verificada.
Dados e acesso: o modo Contributor vem ativado por padrão
Esta é a configuração que eu verificaria antes de qualquer outra.
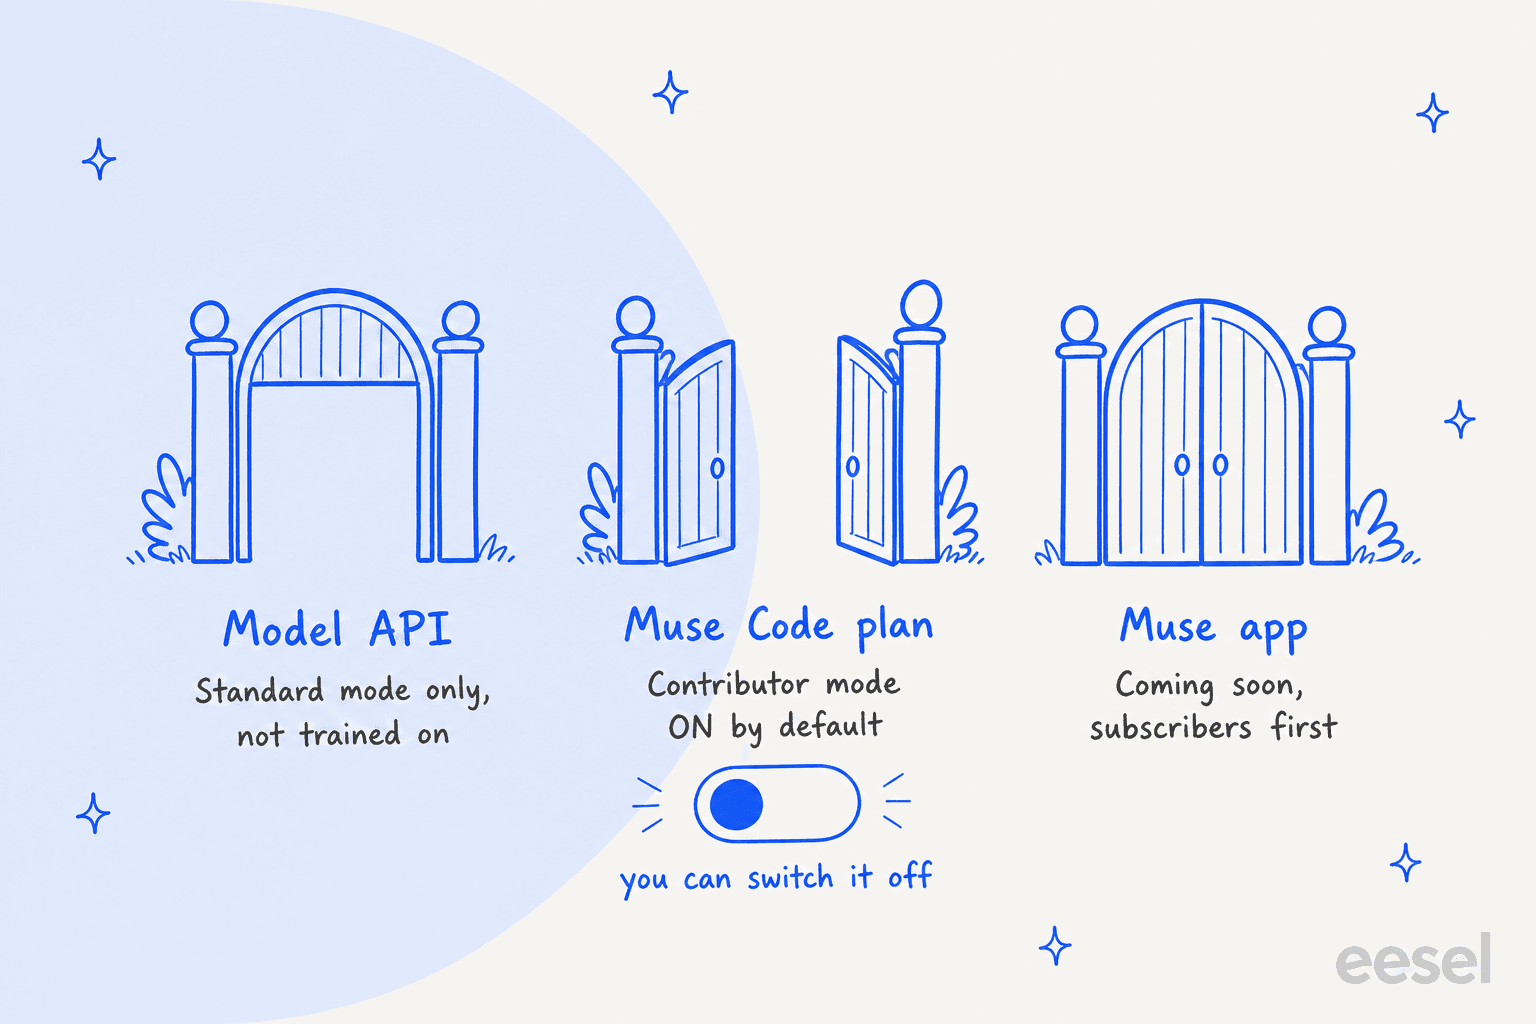
Na API, o Muse Wonder roda apenas no modo Standard: a documentação da Meta diz que seu conteúdo "is not used to train Meta models." Dentro do Muse Code é o oposto. A página de assinaturas diz "Muse Code subscriptions default to Contributor mode", o que dá mais uso "in exchange for letting Meta use your content to train future Meta models." Conteúdo significa seus prompts, código, arquivos e contexto, além das respostas. Você pode desativar a qualquer momento, e a partir daí o novo conteúdo deixa de ser usado.
Ou seja, o caminho mais barato até o Wonder Full, um plano do Muse Code, é também o que treina com o seu código, a menos que você mude uma configuração. É uma troca justa para um projeto de hobby. Para o repositório de uma empresa, desative no primeiro dia.
Essa pergunta aparece mais nas ligações de vendas da eesel do que qualquer benchmark. Um avaliador técnico de uma empresa de hardware perguntou certa vez, em uma demo, se a eesel recorre discretamente a algum outro ChatGPT quando não sabe uma resposta, e se isso poderia ser desligado. O que ele queria era simples: respostas apenas do conhecimento aprovado da empresa, e esse conhecimento continuando seu. Qual modelo de ponta fica por baixo importava muito menos para ele do que essa regra.
O que os primeiros usuários estão dizendo
O veredito da comunidade, dois dias depois, é "números impressionantes, verifique você mesmo". Alguns relatos práticos se destacaram.
Em visão, o Wonder simples teve dificuldade no teste de um desenvolvedor:
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test."
Depois ele confirmou que era o Wonder simples, já que o Full não estava no OpenRouter, que é a mesma lacuna da seção anterior aparecendo na prática.
Sobre o harness, um usuário pagante teve problemas de configuração antes mesmo de o modelo importar:
"I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux (both very stock installs, nothing special)."
E sobre a linha Muse em geral, usuários frequentes do modelo anterior estão animados. Um escreveu que o Muse Spark 1.3 é "very fast and powerful" e seu "work horse for open source development." Outro comentarista observou que a assinatura é só para a América do Norte por enquanto, enquanto a API pode ser acessada pelo OpenRouter.
Prós e contras
Prós
- O Wonder Full empata com o Opus 5.5 em seis vitórias cada na tabela de 14 linhas da Meta e lidera com folga em jurídico (13,1 contra 4,2) e engenharia ultralonga (57,5 contra 46,3)
- Segundo lugar no índice do Artificial Analysis no lançamento (56), o melhor resultado da Meta por larga margem
- Tabela de preços da API limpa: sem sobretaxa para contexto longo, tokens de direcionamento não cobrados, entrada em cache a US$ 0,20
- Contexto de 1M de tokens, cinco tipos de entrada e limites generosos de 3.000 RPM / 4M TPM desde o primeiro dia
- Disponível no OpenRouter, então você pode testá-lo dentro de ferramentas que já usa
Contras
- O modelo da API (52 no AA) não é o modelo por trás das notas de destaque e custa o mesmo que o Opus 5.5 (58)
- O Wonder Full está preso às assinaturas do Muse Code a US$ 50 ou US$ 200 por mês, sem rota com preço por token
- Os planos do Muse Code usam o modo Contributor por padrão, que treina com seu conteúdo até você desativar
- Status de prévia, um relatório de segurança ainda "coming soon" e posições no ranking que mudaram no mesmo dia
- O Wonder simples fica atrás do Opus 5.5 em uso de computador, programação no terminal e programação do zero
Quem deve usar o Meta Muse Wonder?
Escolha o Wonder Full se você é um desenvolvedor individual ou uma equipe pequena que faz projetos de programação longos, redação jurídica ou pesquisa financeira, e US$ 50 por mês pelo Muse Code é fácil de justificar. Desative o modo Contributor primeiro. É o motivo mais forte até agora para testar o agente de programação da Meta, e as alternativas ao Muse Code merecem uma olhada com o mesmo orçamento.
Escolha o Muse Wonder simples na API se você precisa de execuções longas de agentes com boa memória e quer um segundo fornecedor de ponta ao lado da Anthropic. Com preços idênticos, eu faria um teste A/B contra o Opus 5.5 nas suas próprias tarefas antes de mover qualquer tráfego de produção.
Pule por enquanto se você precisa principalmente de uso de computador ou geração de código do zero, onde o Opus 5.5 ainda lidera, ou se sua carga é de alto volume e sensível a preço, caso em que a própria documentação da Meta indica o Muse Spark. Se você está comparando de forma ampla, minha lista dos melhores assistentes de programação com IA e o guia de preços do Claude Code cobrem as outras opções.
E se você lidera uma equipe de suporte, o lançamento de um modelo é o lugar errado para começar. O Wonder pode alimentar um agente de IA, mas alguém ainda precisa conectá-lo ao seu helpdesk, mantê-lo dentro do seu conhecimento, decidir quando ele passa o atendimento e provar que está certo antes de ele tocar em um cliente. Essa é a diferença entre um modelo e um teammate, e é por isso que escolher o melhor modelo para tickets de suporte é apenas o primeiro passo. Minhas notas sobre usar o Muse com o Zendesk mostram quanta cola isso exige.
Contrate a eesel em vez de montar um modelo
O Muse Wonder é infraestrutura; a eesel é o funcionário. A eesel é uma plataforma de teammates de IA em que você contrata teammates prontos para trabalhar em tarefas específicas, e hoje são dois papéis: um teammate de IA para helpdesk e um redator de blog com IA.
Para equipes de suporte, o teammate de helpdesk se conecta ao Zendesk, ao Freshdesk ou ao Gorgias, aprende com seus tickets anteriores, central de ajuda e documentação, e responde apenas com base no que você aprovou. Antes de responder a qualquer pessoa, você pode simulá-lo nos seus tickets históricos e ver exatamente o que ele teria dito. Já vi um bot que soava confiante dar uma resposta errada numa fila real, e é por isso que esse teste existe. Os planos têm mensalidade fixa em que um ticket equivale a um crédito, a partir de US$ 299/mês por 500 créditos, com 100 créditos grátis para testar, conforme a página de preços da eesel.

Se você estava lendo sobre o Muse Wonder porque quer IA trabalhando na sua fila, pule a escolha de modelos. Experimente a eesel grátis e veja-a redigir respostas nos seus próprios tickets.