

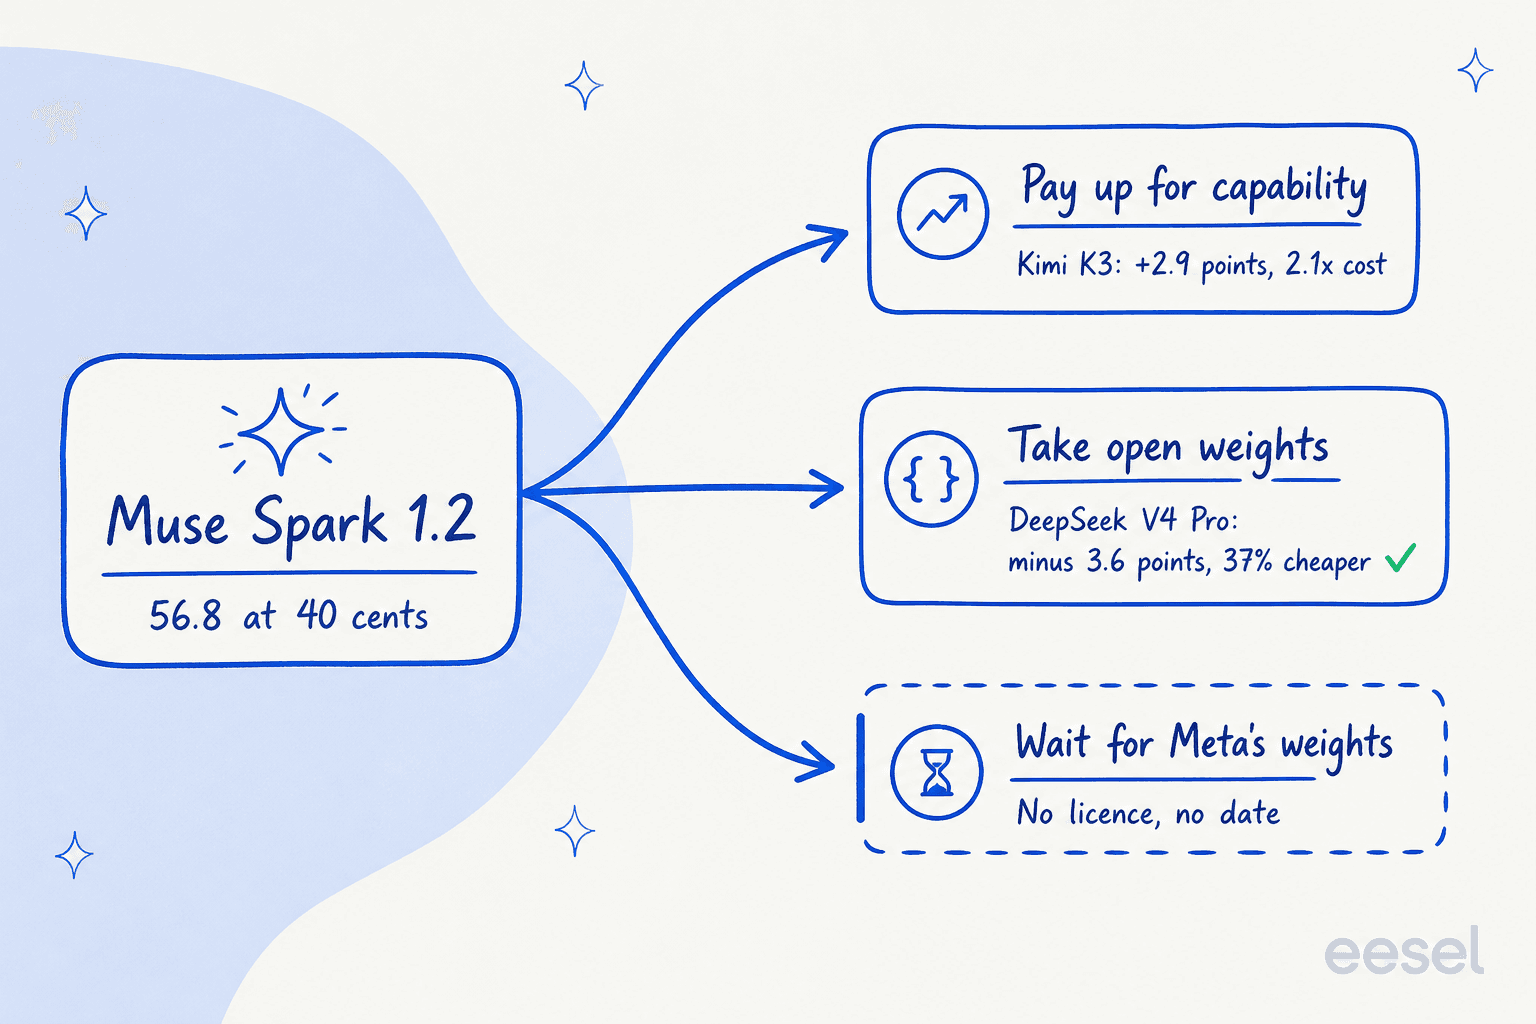
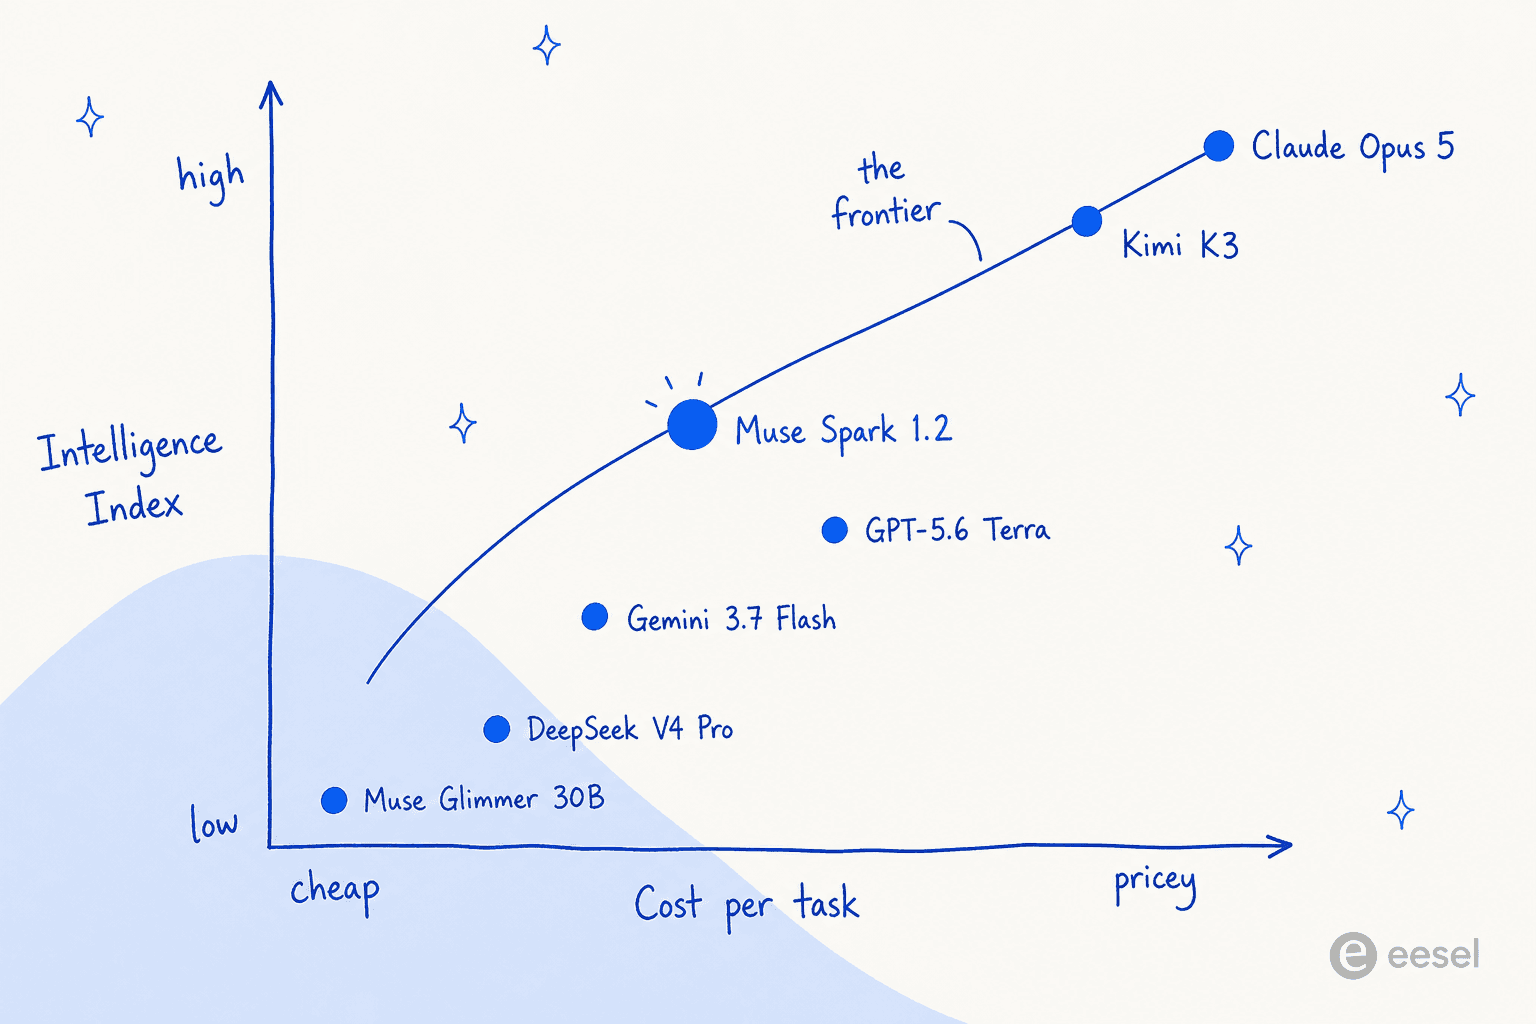
A maioria dos posts sobre "alternativas ao Muse Spark 1.2" começa dizendo que o modelo ficou para trás. Não ficou. No Artificial Analysis Intelligence Index, nada pontua mais que o Muse Spark 1.2 com custo por tarefa menor. Ele está em 7º de 20 com 56,76, e isso por US$ 0,3992 a tarefa. Todo modelo acima dele no ranking custa mais.
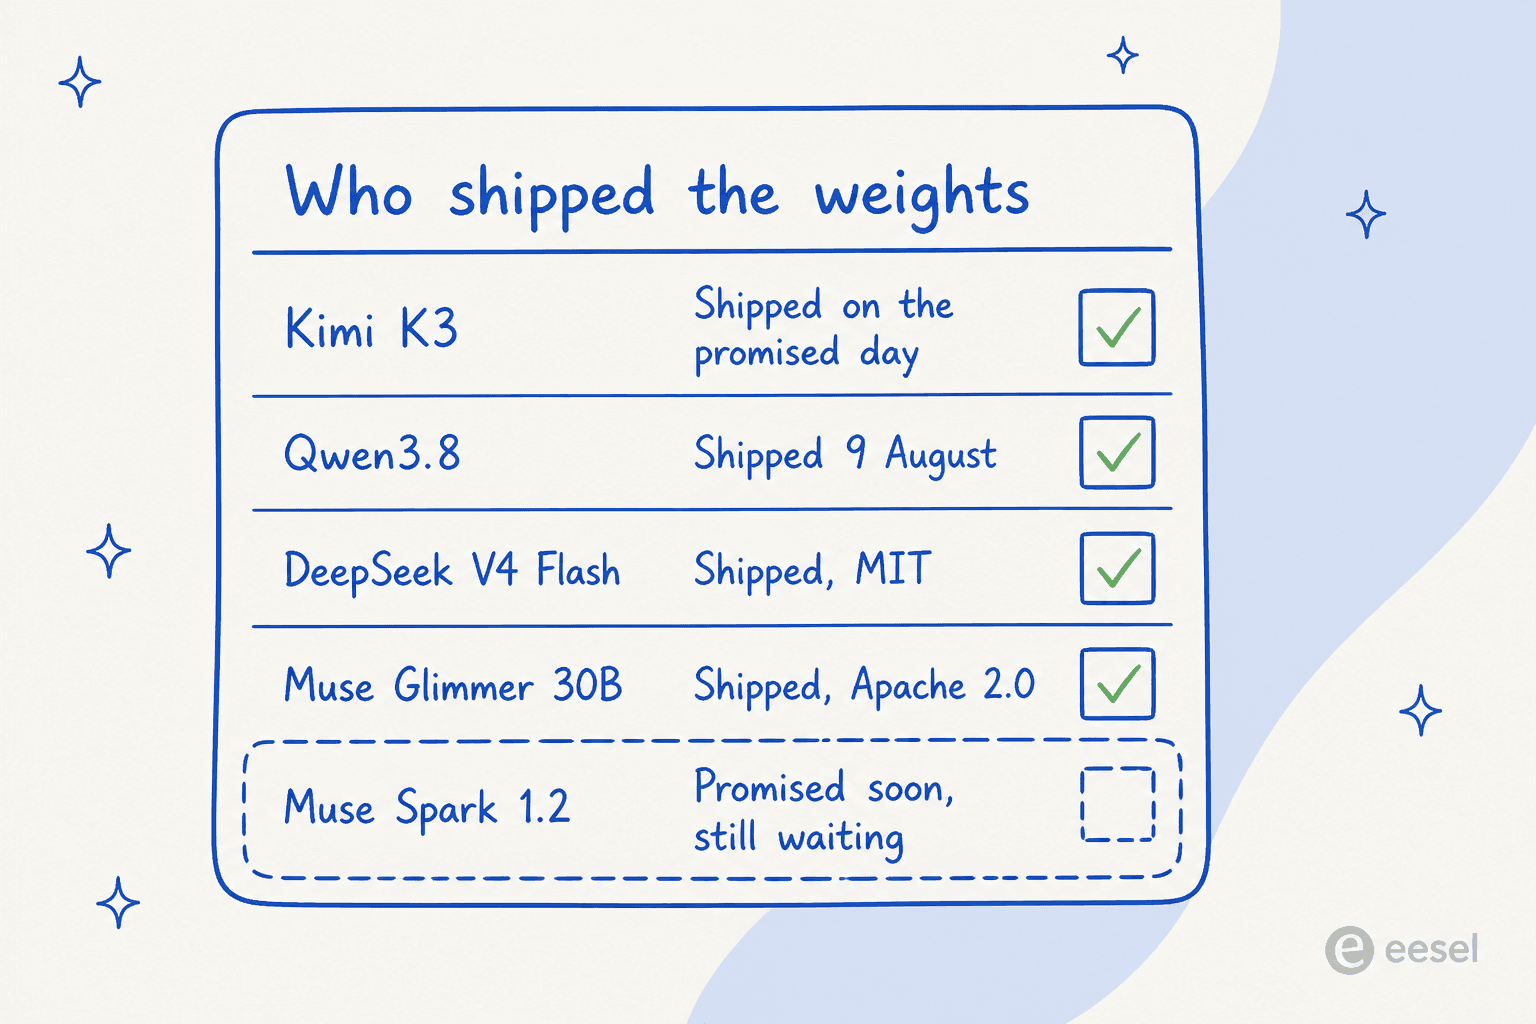
Então o motivo honesto para sair não tem nada a ver com capacidade. O que importa é que o Chief AI Officer da Meta prometeu pesos abertos para o Muse Spark 1.2 em 10 de agosto, sem licença nem data, e oito dias depois nada foi publicado. A Moonshot, enquanto isso, publicou o Kimi K3 exatamente no dia que prometeu. A Qwen publicou em 9 de agosto, e a DeepSeek já é MIT há meses.
Isso divide suas opções de forma bem clara. Pague mais por um salto real de capacidade, ou abra mão de pontos do índice por pesos que realmente são seus. O que não existe é a opção que entrega as duas coisas por menos. Abaixo classifico 8 alternativas com os números reais.
Um aviso antes de você gastar uma semana nisso. Se o modelo que você está escolhendo vai responder tickets de suporte, o modelo em si raramente é o gargalo. Uma equipe com quem trabalhei tinha uma IA dizendo com toda a confiança aos clientes "sim, damos suporte ao modelo do seu carro" para marcas que nem estavam no banco de dados, e isso porque a central de ajuda dizia "damos suporte a todos os modelos". Nenhuma pontuação de índice conserta essa frase. A recuperação conserta.
Por que as pessoas estão olhando além do Muse Spark 1.2
Eu construo integrações e a infraestrutura de APIs na eesel, então a cada lançamento de modelo meu instinto é pular o post de lançamento e ir ler a tabela de preços, os limites de uso e depois a página do modelo. O Muse Spark 1.2 é interessante por um motivo preciso: aqui o marketing e os dados discordam na direção oposta à habitual. A apresentação do lançamento subestimou onde ele ficou em preço-desempenho e exagerou o que você chegaria a possuir.
Há três coisas que realmente levam as pessoas a olhar para outro lugar.
Os pesos são uma promessa, não um download. O Chief AI Officer da Meta disse que uma versão de pesos abertos viria "em breve". A organização verificada da Meta no Hugging Face mostra quatro repositórios no momento, e os quatro são do Muse Glimmer. Se você buscar Muse-Spark no Hugging Face, não aparece nenhum resultado, de ninguém.
Ninguém consegue verificar o modelo de forma independente. Para a maior parte do ranking, a Artificial Analysis publica velocidade de saída e latência. Para o Muse Spark 1.2 esses dois campos estão em branco. O Muse Glimmer está na mesma tabela e os tem. Você consegue precificar este modelo, mas não consegue medir a rapidez com que ele responde.
O nível barato custa o seu tráfego. O ID muse-spark-1.2-contributor é 12,5 vezes mais barato na entrada, e a própria documentação da Meta descreve isso como preço com desconto, dado em troca de permissão para treinar com seus prompts e suas respostas. A conta dessa troca eu já cobri no detalhamento dos preços do Muse Spark 1.2.
Quatro dias antes do anúncio da Meta, um comentarista do Hacker News defendeu a causa dos pesos melhor do que o próprio post da Meta:
"Meta, please go back to publishing weights. Your models aren't top-tier, this wouldn't hurt you at all at your current position in the rankings. They wouldn't have the best open-weight models, but the best western open-weight models."

A Meta fez exatamente isso quatro dias depois, mas com um modelo aluno de 30B. O modelo de fronteira ganhou um adjetivo.
Como escolhi estes 8
Classifiquei por três critérios, nesta ordem.
Pontuação independente, não gráficos do fornecedor. Cada número de índice nesta página é do Artificial Analysis Intelligence Index v4.1.1. Ele roda nove avaliações, então nenhum laboratório escolhe o próprio conjunto de comparação. Isso importa aqui, porque os gráficos do lançamento do Muse Spark 1.2 trocaram o arnês de agente entre as versões.
Custo por tarefa, não preço de tabela. A verbosidade é o que as tarifas por milhão de tokens escondem. O Muse Spark 1.2 gasta 30.430 tokens de saída em cada tarefa do índice, então o custo real fica bem acima do que os US$ 1,25 do título sugerem. O custo por tarefa é o número que sobrevive ao contato com uma fatura de verdade.
Se os pesos existem. Para cada modelo da lista fui conferir o campo de licença no repositório real, em vez de confiar em um comunicado de imprensa. Dois dos oito têm licença diferente da que costumam descrever.
Deixei de fora um nome óbvio. Não há nenhum modelo da eesel nesta lista, porque a eesel não é fornecedora de modelos, e colocar meu próprio empregador numa tabela de benchmarks seria exatamente o que torna esses posts inúteis.
A tabela comparativa
As pontuações do índice e o custo por tarefa vêm do ranking de modelos da Artificial Analysis, consultado em 18 de agosto de 2026. As tarifas por token vêm da página de preços de cada fornecedor, consultada no mesmo dia.
| Modelo | Índice | Custo / tarefa | Entrada /1M | Saída /1M | Contexto | Pesos | Licença | Melhor para |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5 | 63.05 | $2.3369 | $5.00 | $25.00 | 1M | Não | Proprietária | O teto mais alto do ranking |
| GPT-5.6 Sol | 60.93 | $1.2312 | $5.00 | $30.00 | 1.05M | Não | Proprietária | Trabalho de fronteira com ferramentas da OpenAI |
| Grok 4.6 | 60.92 | $0.8367 | varia | varia | 2M | Não | Proprietária | Quase fronteira a custo médio |
| Kimi K3 | 59.70 | $0.8375 | $3.00 | $15.00 | 1.05M | Sim | Kimi K3 License | Pesos abertos que de fato superam o Muse Spark |
| Qwen3.8 Max | 58.08 | $1.1320 | $2.00 | $6.00 | 1M | Só a base | qwen3.8-max | Potência hospedada com alternativa aberta |
| Muse Spark 1.2 | 56.76 | $0.3992 | $1.25 | $4.25 | 1.05M | Não | Proprietária | O modelo estabelecido sobre o qual você está lendo |
| GPT-5.6 Terra | 56.58 | $0.5080 | $2.00 | $12.00 | 1.05M | Não | Proprietária | Troca equivalente com ferramentas melhores |
| Gemini 3.7 Flash | 56.03 | $0.4022 | $0.75 | $3.75 | 1.05M | Não | Proprietária | Velocidade a custo quase idêntico |
| DeepSeek V4 Pro | 53.20 | $0.2521 | $0.66 | $1.98 | 1M | Sim | MIT | A licença permissiva mais barata daqui |
| GPT-5.6 Luna | 52.32 | $0.0471 | $0.20 | $1.20 | 1.05M | Não | Proprietária | O piso de preço para modelos hospedados |
| Muse Glimmer 30B | 35.06 | $0.0732 | local | local | 131K | Sim | Apache 2.0 | Rodar um modelo da Meta na sua própria GPU |
As tarifas da DeepSeek mostradas aqui são as de fora do horário de pico. As tarifas do Gemini mostradas são promocionais, válidas até 31 de dezembro de 2026.
Se você colocar custo contra capacidade num gráfico, o formato da decisão fica bem mais fácil de enxergar.
Escolha a sua rota de fuga
Em vez de ler os oito, responda só à pergunta que realmente divide o campo.
O que você realmente precisa que o Muse Spark 1.2 não está entregando?
Escolha uma. Cada resposta custa alguma coisa, e o número aparece.
Topo do Intelligence Index com 63,05, ou seja, 6,29 pontos à frente do Muse Spark 1.2. Traz o contexto completo de 1M a preço padrão, sem acréscimo para contexto longo.
A troca: US$ 2,3369 por tarefa contra US$ 0,3992. Você paga 5,9 vezes mais por um ganho de capacidade de cerca de 11%.
59,70 no índice, e o único modelo de pesos abertos do ranking de 20 linhas que supera o Muse Spark 1.2. Os pesos saíram no dia em que a Moonshot disse que sairiam.
A troca: US$ 0,8375 por tarefa, ou seja, 2,1 vezes o custo por 2,94 pontos do índice. A licença é própria, não MIT.
Licença MIT sem termos especiais, 53,20 no índice e o mais barato por tarefa entre as opções confiáveis daqui, a US$ 0,2521. Existem 662 repositórios da comunidade, 316 deles quantizados.
A troca: 3,56 pontos do índice abaixo do Muse Spark 1.2, e a tarifa dobra em horários de pico UTC.
O modelo Apache 2.0 da própria Meta, destilado do Muse Spark, rodando abaixo de 20 GB a cerca de 4 bits. É o modelo da Meta que você realmente pode baixar hoje.
A troca: 35,06 no índice, ou seja, 21,70 pontos abaixo do Muse Spark 1.2. Um agente local capaz, não um substituto de fronteira.
1. Claude Opus 5
Melhor para: equipes em que uma resposta errada custa mais que a conta da API.
O modelo principal da Anthropic ocupa o topo do ranking com 63,05. É também o único modelo daqui em que a diferença para o Muse Spark 1.2 é grande o bastante para você perceber sem nenhum arnês de benchmark.
Onde supera o Muse Spark 1.2. Seis pontos do índice, e na prática isso aparece nas tarefas longas de vários passos, aquelas em que um erro inicial se acumula. Ele também traz o contexto completo de 1M a preço padrão, e a Anthropic afirma claramente que uma requisição de 900k tokens é cobrada na mesma tarifa por token que uma de 9k. Nem a OpenAI nem a xAI fazem isso.
Onde não. Custo, e por uma margem grande. Depois o que a maior parte da cobertura ignora: a taxa de alucinação AA-Omniscience do Opus 5 subiu 14 pontos, para 50%. Uma pontuação de índice maior não é a mesma coisa que um modelo mais verdadeiro.
Preços. US$ 5,00 de entrada, US$ 0,50 de leitura de cache, US$ 25,00 de saída por milhão. Batch sai pela metade do preço. Gravações de cache custam US$ 6,25 com TTL de 5 minutos. Se esse teto for mais do que você precisa, o Claude Sonnet 5 agora custa de forma permanente US$ 2,00 e US$ 10,00, depois que a Anthropic cancelou o aumento previsto para 1º de setembro.
Veredicto: a escolha certa quando um erro é caro e a conta de tokens não. Pule se você faz classificação de alto volume, porque aí pagaria 5,9 vezes mais por tarefa por uma capacidade que a tarefa nunca usa.
2. Kimi K3
Melhor para: quem tem como requisito real "pesos abertos, e melhor do que o que tenho".
O modelo principal da Moonshot é a entrada mais interessante desta lista, e o motivo é que ele é o único modelo que cumpre as duas metades do que as pessoas dizem querer da Meta. Pontua 59,70, acima do Muse Spark 1.2, e os pesos estão disponíveis para download agora, hoje.
Onde supera o Muse Spark 1.2. Quase três pontos do índice, e ainda 2,8 trilhões de parâmetros que você mesmo pode hospedar. O que vale a pena notar é isto: o blog técnico da Moonshot disse que os pesos seriam lançados até 27 de julho de 2026, e o primeiro commit público no Hugging Face é de 27 de julho de 2026. Uma data nomeada, cumprida no dia.
Onde não. Duas coisas. O custo por tarefa é US$ 0,8375, mais do que o dobro. Depois a licença, que não é o que a maioria das análises afirma: os metadados do próprio repositório dizem license: other com license_name: "kimi-k3", uma licença própria da Moonshot. Pesos abertos, sim. Código aberto permissivo, não. O Openness Index é 38,89, abaixo dos 44,44 do Muse Glimmer.
Preços. US$ 3,00 de entrada, US$ 0,30 de acerto de cache, US$ 15,00 de saída por milhão, ou seja, território de Claude Sonnet e não de orçamento baixo. Minha análise completa do Kimi K3 entra no comportamento do esforço de raciocínio, que não dá para desligar em nenhum nível.
Veredicto: a resposta padrão para quem estava esperando os pesos da Meta. Você paga cerca do dobro por tarefa e lê a licença com cuidado antes de ir para produção, mas ele existe hoje e é claramente melhor.
3. Qwen3.8 Max
Melhor para: equipes que querem um modelo hospedado agora e uma alternativa autohospedada depois.
O modelo principal da Alibaba pontua 58,08 hospedado, e nesta entrada minha própria pesquisa me corrigiu no meio do rascunho. No início deste mês os pesos do Qwen 3.8 estavam prometidos e sem publicação, exatamente na posição em que o Muse Spark 1.2 está agora. Depois saíram em 9 de agosto.
Onde supera o Muse Spark 1.2. 1,32 ponto do índice hospedado, enquanto a base aberta Qwen3.8-2.4T-A95B sozinha ainda marca 57,70. Ou seja, até a versão para download supera o modelo que você está pensando em deixar.
Onde não. O custo por tarefa é US$ 1,1320, quase o triplo. A versão aberta também não equivale em recursos ao produto hospedado: a própria ficha do modelo da Qwen afirma que o Max hospedado acrescenta entrada de visão, suporte sem raciocínio, contexto de 1M por padrão e ferramentas integradas. E a licença é novamente própria, qwen3.8-max, não Apache.
Preços. US$ 2,00 de entrada, US$ 0,25 de leitura de cache implícito, US$ 6,00 de saída por milhão. A leitura de cache explícito é mais barata, US$ 0,17, mas custa US$ 2,50 por milhão para criar, então só compensa em prefixos muito repetidos. As rotas práticas de acesso coloquei em como acessar o Qwen3.8 Max.
Veredicto: a melhor proteção desta lista, já que você pode começar hospedado e depois migrar para o seu próprio hardware sem trocar de família de modelos. A análise do Qwen3.8 Max traz os números de preferência humana, e eles apontam numa direção mais favorável do que o índice automatizado.
4. GPT-5.6 Terra
Melhor para: uma troca equivalente em que as ferramentas ao redor importam mais do que a pontuação.
O modelo intermediário da OpenAI fica em 56,58, ou seja, 0,18 ponto abaixo do Muse Spark 1.2. Na prática os dois modelos têm a mesma capacidade a preços diferentes, e é por isso que o post de lançamento da Meta comparou com o Terra e não com o GPT-5.6 Sol. Um comentarista percebeu isso na época:
"They chose to compare against Open AI's mid tier model Terra instead of Sol and still lost some benchmark against it. They left Opus in and got beat in all but one benchmark. Nothing wrong with trying to improve, but why the marketing games?"
Onde supera o Muse Spark 1.2. Sobretudo no ecossistema. O Terra roda dentro das ferramentas que sua equipe provavelmente já usa, e a OpenAI publica números de velocidade e latência que a Meta não publica.
Onde não. É 27% mais caro por tarefa, por uma pontuação marginalmente menor. Há também um penhasco de contexto longo: prompts acima de 272K tokens de entrada são cobrados a 2x na entrada e 1,5x na saída na requisição inteira, não só no excedente, segundo a página do modelo da OpenAI. O Muse Spark 1.2 não tem nenhum acréscimo para contexto longo.
Preços. US$ 2,00 de entrada, US$ 0,20 em cache, US$ 12,00 de saída por milhão, e isso antes do multiplicador de contexto longo. Onde exatamente esse penhasco pega está no detalhamento dos preços do GPT-5.6.
Veredicto: troque pelas ferramentas e pelos números de latência publicados, não pela capacidade. Se seus prompts passam rotineiramente de 272K tokens, faça as contas antes de migrar.
5. Gemini 3.7 Flash
Melhor para: cargas de alto volume em que a vazão é a restrição.
A linha Flash do Google pontua 56,03 a US$ 0,4022 a tarefa, ficando dentro de um erro de arredondamento do Muse Spark 1.2 nos dois eixos. A diferença é que o Google publica a velocidade do modelo. A Artificial Analysis mede 340,1 tokens por segundo, o primeiro entre 188 modelos medidos.
Onde supera o Muse Spark 1.2. Velocidade medida, mais uma tarifa de tabela menor, US$ 0,75 de entrada. É o único modelo daqui em que você também pode reduzir a capacidade de propósito: no esforço low ele marca 50,9 a US$ 0,16 a tarefa, e para classificação isso costuma ser a escolha certa.
Onde não. Há duas ressalvas reais. A tarifa atual é promocional até 31 de dezembro de 2026 e dobra para US$ 1,50 e US$ 7,50 em 1º de janeiro de 2027, então qualquer modelo de custos que você montar hoje tem um penhasco dentro. A taxa de alucinação também piorou, para 64,5% contra os 55,6% da versão anterior, o que investiguei na análise do Gemini 3.7 Flash.
Preços. US$ 0,75 de entrada, US$ 0,075 em cache, US$ 3,75 de saída por milhão até o fim de 2026. A saída máxima é de 65.536 tokens, notavelmente mais apertada que o resto desta lista.
Veredicto: a melhor escolha se a latência é a reclamação real que você tem do Muse Spark 1.2, já que você nem consegue medir a da Meta. Orce desde já a mudança de preço de janeiro, em vez de se surpreender depois.
6. DeepSeek V4 Pro e V4 Flash
Melhor para: os pesos mais baratos com os quais você pode fazer o que quiser.
Esta é a entrada que vence na licença, e não na pontuação. O V4 Pro pontua 53,20 a US$ 0,2521 a tarefa, e tanto ele quanto o DeepSeek V4 Flash trazem uma licença mit simples nos metadados do repositório. Sem termos especiais. Nem uma política de uso ao lado.
Onde supera o Muse Spark 1.2. Preço e liberdade. É 37% mais barato por tarefa, tem licença MIT e o ecossistema de comunidade mais profundo de toda esta comparação: uma busca retorna 662 repositórios, 316 deles quantizados. Esse ecossistema é o que torna o autohospedamento realista em vez de teórico.
Onde não. Perde 3,56 pontos do índice. Há também uma peculiaridade para planejar: a DeepSeek cobra o dobro no horário de pico, definido como 01:00 a 04:00 e 06:00 a 10:00 UTC. Uma fila de suporte europeia cai nessa janela todo dia; uma americana quase nunca. Quanto à política de dados, os termos da API paga da DeepSeek são omissos sobre o uso para treinamento, em vez de permissivos, e a infraestrutura fica sob a lei da RPC.
Preços. O V4 Pro custa US$ 0,66 de entrada e US$ 1,98 de saída fora do pico, e dobra no pico. O V4 Flash sai bem mais barato, US$ 0,22 e US$ 0,66 fora do pico, e pontua 51,77. A conta do horário de pico está explicada direito no post de preços do DeepSeek V4 Flash.
Veredicto: se o seu requisito é "pesos MIT, baratos", esta é a resposta e nada mais da lista concorre. Se a carga toca dados regulados de clientes, a residência de dados é a primeira questão a resolver.
7. GPT-5.6 Luna
Melhor para: o trabalho de volume que você nunca deveria ter rodado em um modelo de fronteira.
O Luna pontua 52,32 a US$ 0,0471 a tarefa. Isso é 8,5 vezes mais barato que o Muse Spark 1.2 por 92% da pontuação do índice, e é o único número daqui que deveria fazer qualquer um que roda classificação em massa repensar toda a configuração.
Onde supera o Muse Spark 1.2. Custo, e de forma dramática. A maioria das cargas de produção não tem formato de fronteira: marcação e roteamento, extração e resumo raramente precisam de 56 pontos de índice. O Luna é totalmente hospedado e com latência publicada, o que o modelo da Meta não tem.
Onde não. Está 4,44 pontos abaixo, e essa diferença aparece em qualquer coisa realmente de vários passos. Um cavalo de carga, não um raciocinador.
Preços. US$ 0,20 de entrada, US$ 0,02 em cache, US$ 1,20 de saída por milhão, com o mesmo multiplicador de contexto longo >272K que o resto da família GPT-5.6 carrega.
Veredicto: a linha mais subestimada da tabela. Antes de migrar tudo para um modelo mais caro, divida seu tráfego e veja quanto dele realmente precisa do modelo caro.
8. Muse Glimmer 30B
Melhor para: rodar um modelo da Meta em hardware próprio, hoje.
Se você chegou aqui porque queria pesos da Meta, isto é o que realmente existe. O Glimmer tem 29,78 bilhões de parâmetros sob Apache 2.0, destilado do Muse Spark, com contexto de 131.072 tokens e corte de conhecimento em janeiro de 2026.
Onde supera o Muse Spark 1.2. Você pode baixá-lo. A Meta quantiza para cerca de 4 bits, o que deixa o modelo de linguagem abaixo de 20 GB e cabe numa placa de 24 GB. O custo por tarefa é US$ 0,0732, e é o único modelo da Meta com um Openness Index, de 44,44. A resposta da comunidade foi imediata: já existem 296 repositórios do Glimmer, e a versão GGUF da unsloth, com 755.125 downloads, supera o próprio repositório de pesos da Meta.
Onde não. 35,06 contra 56,76 é uma diferença de 21,70 pontos, e nenhuma comodidade local fecha isso. Há também uma nota de rodapé de licença que vale conhecer: junto com o texto real da Apache 2.0, o repositório traz um USAGE_POLICY.md escrito pela Meta que restringe o uso por menores e proíbe aplicações militares, de armas e de infraestrutura crítica. A Apache 2.0 não impõe nenhum desses termos, então a superfície prática aqui é Apache mais um documento de política.
Preços. Download gratuito, depois o seu próprio poder de computação. Um desenvolvedor que o rodou num Mac mini de 32 GB foi sincero sobre o que isso significa na prática:
"I am getting good results with muse-glimmer running locally, with the caveat that everything runs slowly (e.g., give it a task and then go walk outside or do Qi Gong exercises for a while)."
Veredicto: um modelo de agente local muito bom e um péssimo substituto do Muse Spark. Trate como uma ferramenta diferente, não como um caminho de rebaixamento.
O que a comunidade realmente diz
A opinião sobre o Muse Spark 1.2 se divide nitidamente em uma única linha. Quem leu os benchmarks ataca a posição dele; quem o usou elogia quão poucos tokens ele desperdiça. Os dois lados têm razão, e é por isso que a reação ao lançamento parece tão contraditória.
A leitura cética mais afiada veio no dia do lançamento:
"Somewhat surprised that Meta with all their resources couldn't make a model that matches Composer on any frontier. All the Sparks are dominated by some other model everywhere along the frontier. The use traces must be crucial to functionality which is why they're keeping prices so low."
Duas semanas de medição independente responderam parcialmente a isso. No ranking atual da Artificial Analysis, o Muse Spark 1.2 não é dominado em preço-desempenho de jeito nenhum; ele está na fronteira no seu próprio ponto de custo. A segunda metade do comentário, a do preço como jogada de aquisição de dados, se sustenta bem melhor.
Sobre os pesos, a objeção não é realmente sobre este anúncio. É sobre o anterior:
"Meta in this case, started nicely with Llama, then switched to closed models, kicked out researchers to build data labeler CEO empire inside Meta. Now opening again, what's next? closing again?"
E a posição que mais vi não era "troque" nem "fique". Era pegar o artefato aberto e recusar o produto hospedado:
"I'd also argue this is the case for any company releasing open weights. They're not righteous, they're marketing. That's not necessarily a bad thing! [...] I still will not use a hosted Meta product, but damn this model looks solid."
Para equilibrar: a voz positiva mais forte sobre o anúncio foi o CEO da Box, e ele o leu como uma mudança de categoria, não como um lançamento de produto:
"Meta releasing Muse Spark 1.2 as open weights is a very big deal. America now finally has its response to the open weights AI race."
Essa reação foi à promessa, porém. Oito dias depois, o download ainda não existe.
O que nenhuma dessas trocas resolve
Esta é a parte que mais me importa, porque passo a vida profissional na camada que fica por baixo desses modelos.
Se você está escolhendo entre os oito para uma carga geral de programação ou pesquisa, a tabela acima é quase tudo de que precisa. Mas boa parte de quem busca alternativas ao Muse Spark 1.2 está tentando consertar uma automação de suporte que dá respostas erradas, e trocar de modelo quase nunca é a solução para isso.
O exemplo com que abri é o mais claro que conheço. Uma equipe de suporte técnico B2B tinha uma IA dizendo com confiança aos clientes "sim, damos suporte ao modelo do seu carro" para marcas de veículos que não estavam no banco de dados. O modelo não estava quebrado. A central de ajuda dizia "damos suporte a todos os modelos", a IA recuperou essa frase e então respondeu corretamente a partir do texto que recebeu. Passar de um modelo de 56,8 para um de 63,1 não muda nada nesse resultado, porque a falha aconteceu na recuperação e não no raciocínio.
Dá para ver a mesma coisa nos dados de benchmark. A precisão AA-Omniscience do Muse Spark 1.2 na verdade caiu em relação à 1.1, de 52,0% para 45,4%, enquanto a taxa de alucinação melhorou de 50,0% para 33,3%. Ele não ficou mais sábio. Ficou melhor em recusar. Para um assistente geral é uma troca razoável, e para um agente de suporte é ruim, porque ali uma resposta recusada ainda é um ticket.
Três coisas mexem mais na precisão do suporte do que o modelo:
- O que a IA consegue ver. Tickets resolvidos do passado, e não só artigos da central de ajuda. A maioria das ferramentas treina só com a documentação publicada, que é exatamente o motivo pelo qual elas repetem "damos suporte a todos os modelos" para você.
- O que ela faz quando não tem certeza. Roteamento baseado em confiança para um rascunho em vez de uma resposta ao vivo, de modo que uma resposta de baixa confiança vire uma escalação em vez de um erro diante do cliente.
- Se você testou antes dos seus clientes. Simular contra seus próprios tickets históricos é o que mostra a taxa de resolução real. Uma pontuação pública de índice só mostra a de outra pessoa.
Entro mais a fundo em tudo isso em modelos de IA para suporte, e no padrão de falha em si em alucinações de IA no suporte.
Experimente a eesel no trabalho de suporte
Se você chegou a uma comparação de modelos porque sua IA de suporte continua respondendo errado, então o nível do modelo é o botão errado para girar. A eesel é uma colega de equipe com IA que se conecta ao Zendesk, Freshdesk, Gorgias, HubSpot ou Front, e aprende com seu histórico de tickets resolvidos desde o primeiro dia, não só com sua base de conhecimento pública.
O que importa para tudo acima: antes de tocar em qualquer cliente, você a executa em simulação sobre seus próprios tickets passados e vê a taxa de resolução real, dividida por tema. A Gridwise viu 73% das solicitações de nível 1 resolvidas no primeiro mês. A cobrança é um crédito por ticket (planos a partir de US$ 299 por mês por 500 créditos), e não por milhão de tokens que você não consegue prever, então a aritmética de horário de pico e de contexto longo desta página deixa de ser problema seu.

Teste grátis, sem cartão, e em um dia você saberá se o modelo algum dia foi o seu problema. Experimente a eesel.
Então, qual você deve escolher
Se você levar só uma coisa desta página, que seja esta: o Muse Spark 1.2 não é um mau negócio em capacidade por dólar, e trocar só pela pontuação vai custar mais do que entrega.
Saia, em vez disso, por um motivo concreto. Se uma resposta errada é cara, o Claude Opus 5 compra a maior diferença real. Se o que você precisa são pesos que superem o que tem hoje, o Kimi K3 é o único modelo que faz as duas coisas, a cerca do dobro do custo por tarefa. Se MIT especificamente é o requisito, a DeepSeek é a resposta e a licença ali é limpa. E se a reclamação é velocidade, o Gemini 3.7 Flash é o único dos dois cuja velocidade alguém publicou.
E se você ainda espera os pesos da Meta, vale lembrar o balanço. A Moonshot deu uma data e cumpriu. A Alibaba publicou em menos de uma semana. A DeepSeek é MIT o tempo todo. A Meta publicou o modelo aluno e um adjetivo.
Perguntas frequentes
Quais são as melhores alternativas ao Meta Muse Spark 1.2?
O Muse Spark 1.2 é de código aberto?
muse-spark-1.2 é um modelo proprietário de API sem pesos publicados. A Meta anunciou em 10 de agosto que uma versão de pesos abertos chegaria em breve, sem citar licença nem data, e nada foi publicado desde então. O modelo da Meta que é aberto é o Muse Glimmer 30B, sob Apache 2.0. Para o panorama geral, veja meu resumo de agentes de IA de código aberto.Como o preço do Muse Spark 1.2 se compara ao das alternativas?
muse-spark-1.2 custa US$ 1,25 por milhão de tokens de entrada e US$ 4,25 de saída, o que dá US$ 0,3992 por tarefa do Intelligence Index. Isso é mais barato por tarefa do que os preços do Kimi K3, de US$ 0,8375, e mais barato que o Claude Opus 5, de US$ 2,3369. O detalhamento completo dos preços do Muse Spark 1.2 está na minha análise de preços.Qual modelo de pesos abertos é o mais próximo do Muse Spark 1.2?
Devo sair do Muse Spark 1.2 para um caso de atendimento ao cliente?
O que é o Muse Glimmer 30B e ele pode substituir o Muse Spark 1.2?
O Muse Spark 1.2 tem plano gratuito?
muse-spark-1.2-contributor custa US$ 0,10 de entrada e US$ 0,20 de saída em troca de a Meta usar o seu tráfego para treinar modelos futuros, e é limitado a 100 requisições por minuto. Se o objetivo é uma conta baixa sem essa troca de dados, o GPT-5.6 Luna, a US$ 0,0471 por tarefa, é a opção hospedada mais barata do ranking.