

O Nanbeige 4.3 é um modelo aberto gratuito, com licença Apache 2.0 e 33 bilhões de parâmetros, que supera o Qwen3.8-27B em 18 dos 20 benchmarks publicados por seu laboratório, com as maiores vantagens em codificação agentic: 65,5 vs 42,5 no DeepSWE e 23,8 vs 6,3 no Terminal-Bench 4.0. Ele foi lançado no Hugging Face em 24 de outubro de 2026, e o Nanbeige o chama de "professor": o alvo real é um Nanbeige4.3-3B destilado que ainda não foi lançado.
O porém é a memória. É um modelo simples e denso no estilo Llama, então seu cache de contexto custa cerca de 0,2 MB por token. Em um contexto de 128K, isso representa ~28 GB de cache além dos ~21 GB de pesos de 4 bits, o que descarta a maioria das GPUs domésticas individuais.
E se você está pensando nele para trabalho de suporte, leia as letras miúdas: no gráfico JobBench do próprio Nanbeige, ele marcou 21,1 em tarefas de atendimento ao cliente contra 31,6 do Qwen. Um agente de suporte depende inteiramente da configuração do seu helpdesk, não de uma pontuação de codificação, e é por isso que equipes como a smava utilizam um companheiro de helpdesk com IA pronto para o uso sobre modelos como este, em vez de tentarem montar um do zero.
O que é o Nanbeige 4.3?
O Nanbeige 4.3 é a quarta geração (e um pouco mais) de modelos do Nanbeige LLM Lab, a equipe de IA dentro do BOSS Zhipin, a plataforma de recrutamento chinesa operada pela Kanzhun Limited. A série possui um modelo público até agora, o Nanbeige4.3-33B, além do seu modelo base não ajustado. Ambos foram lançados em 24 de outubro de 2026, e o laboratório anunciou no X no dia seguinte, onde a postagem alcançou 2.248 curtidas.
Eu desenvolvo integrações e APIs no eesel, então um novo modelo aberto sempre me faz a mesma pergunta: o que seria necessário para realmente rodar isso em um produto real? Essa é a perspectiva aqui.
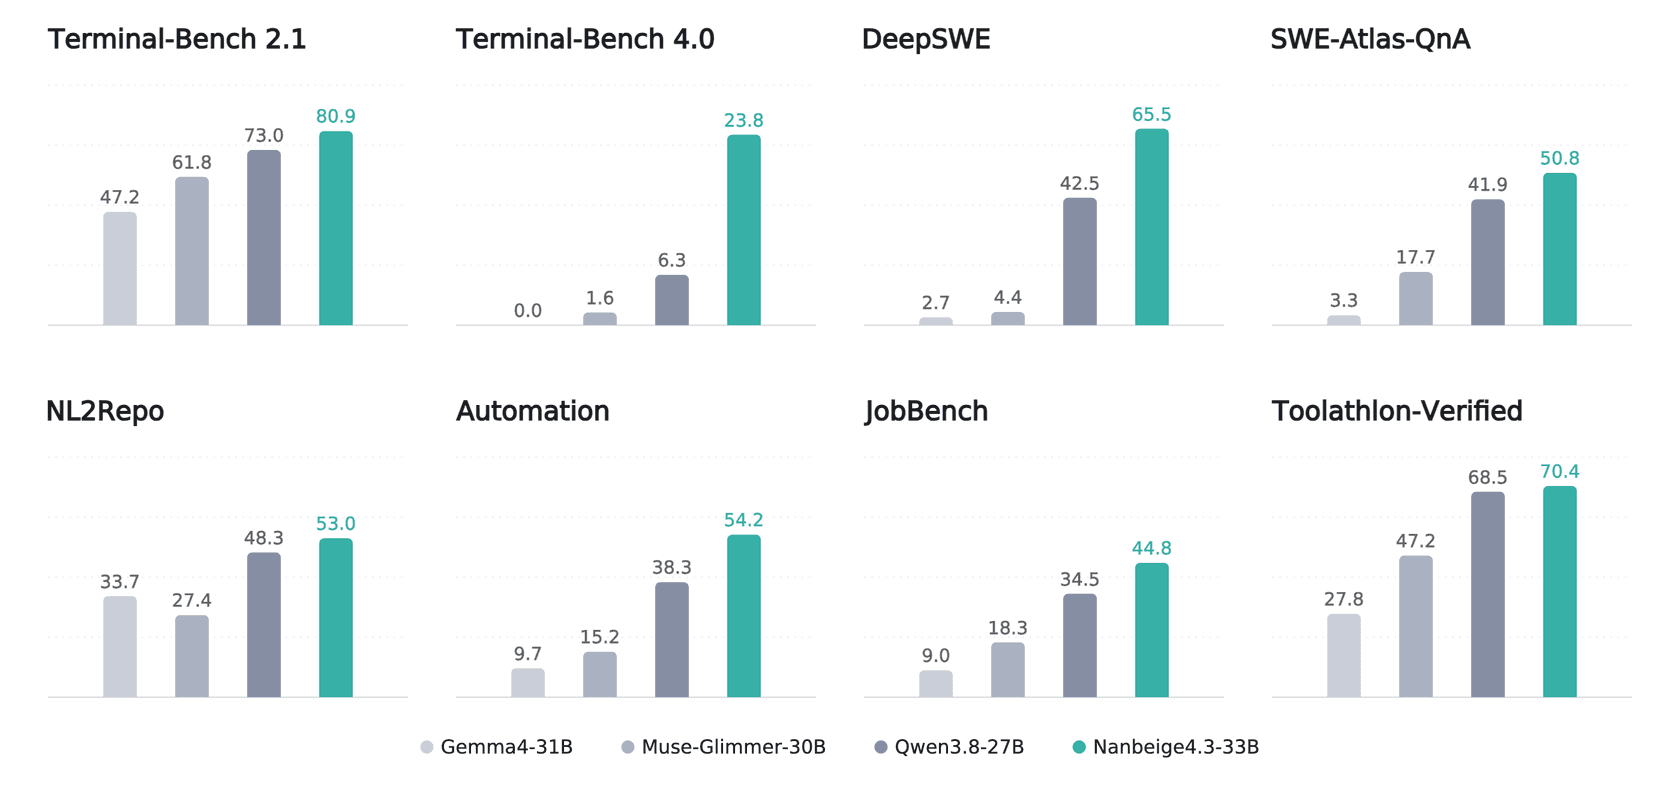
A parte interessante não é o tamanho. O Nanbeige ficou conhecido por seus modelos de linguagem pequenos: o Nanbeige4.2-3B, um "Looped Transformer" de 3B que reutiliza suas camadas para processar mais por token (a mesma ideia que chamou a atenção no GPT-6 Astra), teve mais de 116.000 downloads no último mês. Então, por que lançar um 33B? O cartão do modelo responde diretamente: a estratégia é "construir primeiro um agente professor de alta capacidade", para depois destilar suas habilidades em modelos pequenos, o que a postagem de lançamento diz que começará "com o Nanbeige4.3-3B".
Em outras palavras, o 33B é um passo no caminho. Ele é útil por si só, mas o modelo que realmente importa para o Nanbeige é o aluno de 3B.
As especificações em resumo
Tudo abaixo vem do cartão do modelo e do arquivo de configuração no repositório.
| Especificação | Nanbeige4.3-33B |
|---|---|
| Parâmetros | 33,1 bilhões, denso |
| Arquitetura | LlamaForCausalLM, 52 camadas, 56 cabeças de atenção, 8 cabeças de chave-valor |
| Janela de contexto | 524.288 tokens (512K) |
| Entrada / saída | Apenas texto, Inglês e Chinês |
| Licença | Apache 2.0 |
| Tamanho dos pesos | 66,2 GB em BF16 distribuídos em 14 arquivos |
| Variantes | Modelo Instruct e Modelo Base |
| Modo de pensamento | Ativado por padrão, alterne com enable_thinking |
| Chamada de ferramentas | XML recomendado, JSON suportado |
| Execução em | Transformers, vLLM, SGLang |
Uma resposta abaixo da postagem de lançamento poupou o download para muita gente:
"33B denso, apenas texto sem visão, caso isso economize o tempo de alguém"
Quão bom é o Nanbeige 4.3 em benchmarks?
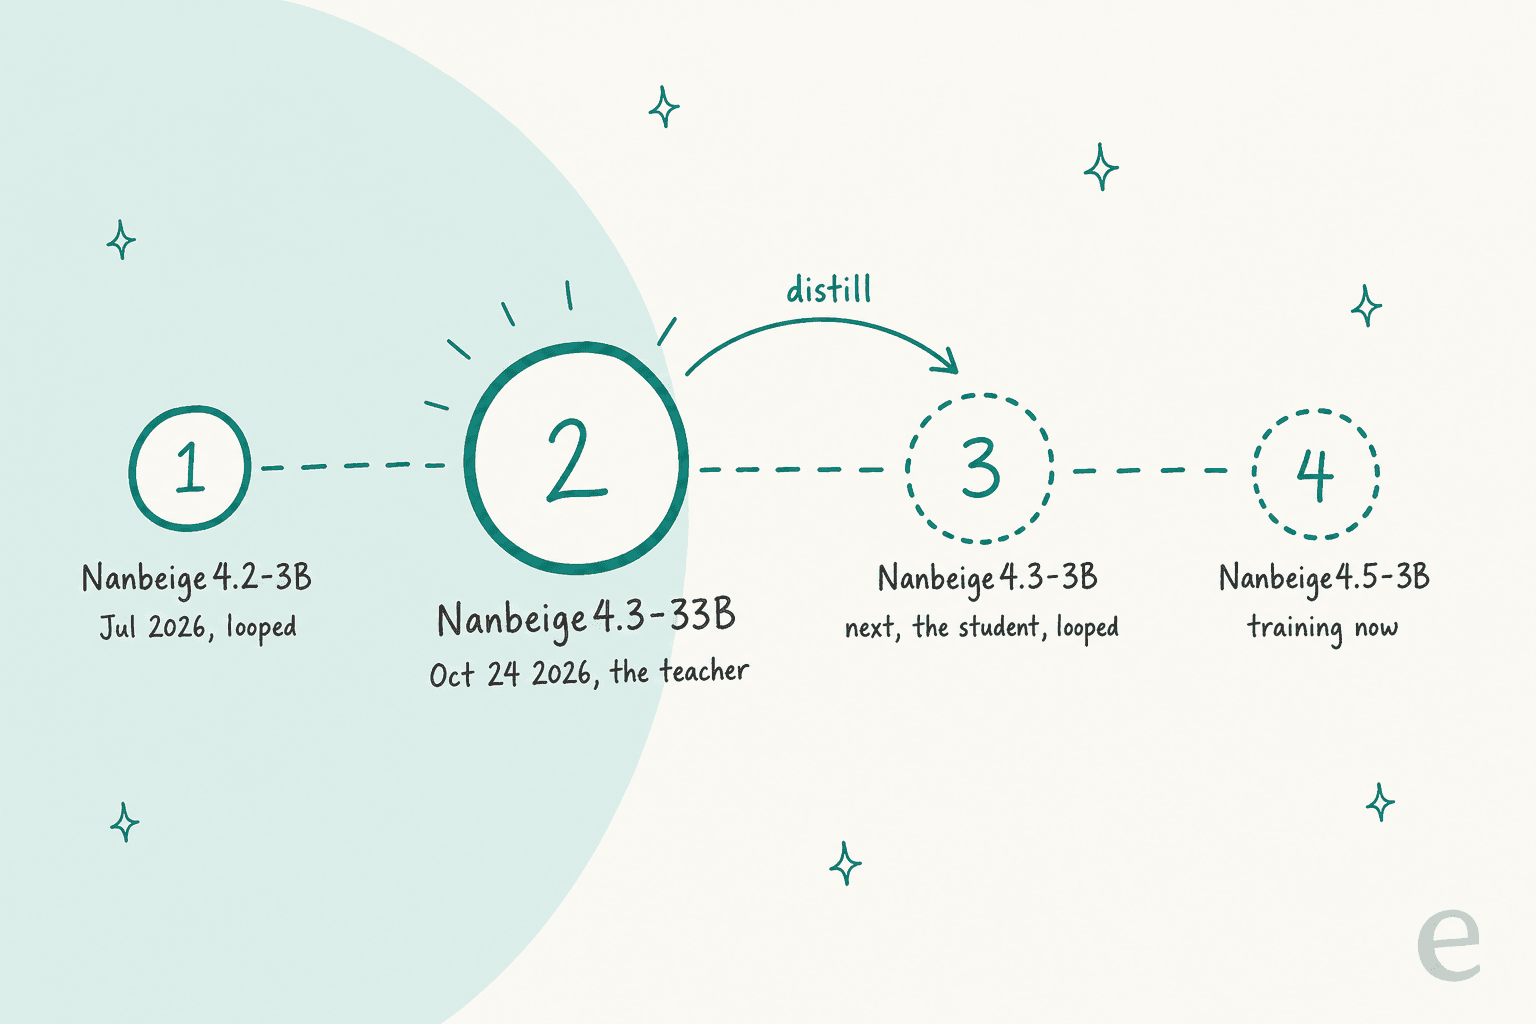
Muito bom, no papel. O Nanbeige o comparou com três modelos abertos de tamanho similar, todos em seu maior esforço de pensamento, e publicou 20 pontuações. O Nanbeige4.3-33B supera todos os três rivais em 17 delas e vence o Qwen3.8-27B, seu competidor mais próximo, em 18. Aqui está a tabela completa do cartão do modelo:
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 36,9 | 51,2 |
| SWE-Atlas-QnA | 50,8 | 41,9 | 17,7 | 3,3 |
| NL2Repo | 53,0 | 48,3 | 27,4 | 33,8 |
| Scicode | 52,6 | 46,7 | 44,9 | 45,5 |
| SkillsBench | 61,1 | 56,4 | 39,7 | 28,9 |
| Automation Bench | 54,2 | 38,3 | 15,2 | 9,7 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| Claw-Eval (pass^3) | 78,3 | 75,2 | 57,3 | 44,2 |
| Toolathlon-Verified | 70,4 | 68,5 | 47,2 | 27,8 |
| DeepPlanning | 63,3 | 49,2 | 21,4 | 19,4 |
| EnterpriseOps-Gym | 41,0 | 40,2 | 30,5 | 27,3 |
| YC-bench | $1.025.437 | $641.290 | $513.978 | $265.152 |
| Tau3-Bench | 48,8 | 48,5 | 33,7 | 18,6 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Os números de codificação são o grande destaque. O Terminal-Bench 4.0 é uma versão mais nova e muito mais difícil do teste de linha de comando, e o Nanbeige atinge 23,8 enquanto o próximo melhor modelo de sua classe chega a 6,3. O DeepSWE segue a mesma linha: 65,5 contra 42,5. Se você executa um agente de codificação de terminal como o Claude Code ou o OpenClaw com um modelo local, essa é a diferença que você notaria. Meu guia de CLI de codificação agentic aborda como essas ferramentas diferem.
Três avisos sinceros antes de alguém printar essa tabela:
- São as execuções do próprio laboratório. O Nanbeige usou as mesmas ferramentas e configurações para todos os modelos, o que é justo, mas nenhum testador independente repetiu os testes ainda. O Artificial Analysis lista modelos anteriores do Nanbeige, mas ainda não este.
- A ferramenta utilizada importa. O Terminal-Bench 2.1 rodou no Terminus 2, o DeepSWE no mini-swe-agent v2.4.6 e o NL2Repo dentro do Claude Code. A configuração do seu agente mudará esses números.
- As letras miúdas oscilam. O gráfico de barras e a tabela discordam em duas células (o JobBench do Muse-Glimmer é
18,3no gráfico e16,6na tabela). É um detalhe pequeno, mas vale saber se você for citar os dados.
Onde o Nanbeige 4.3 fica para trás?
Olhando além das linhas de codificação, a vantagem diminui rapidamente. Contra o Qwen3.8-27B especificamente (um irmão menor do Qwen3.8 Max), ele perde no SWE-Bench Pro (60,3 vs 61,7) e no GDPval (84,8 vs 86,4), e fica basicamente empatado no Tau3-Bench, o benchmark que simula um agente de IA atendendo clientes de uma companhia aérea ou varejista (48,8 vs 48,5).
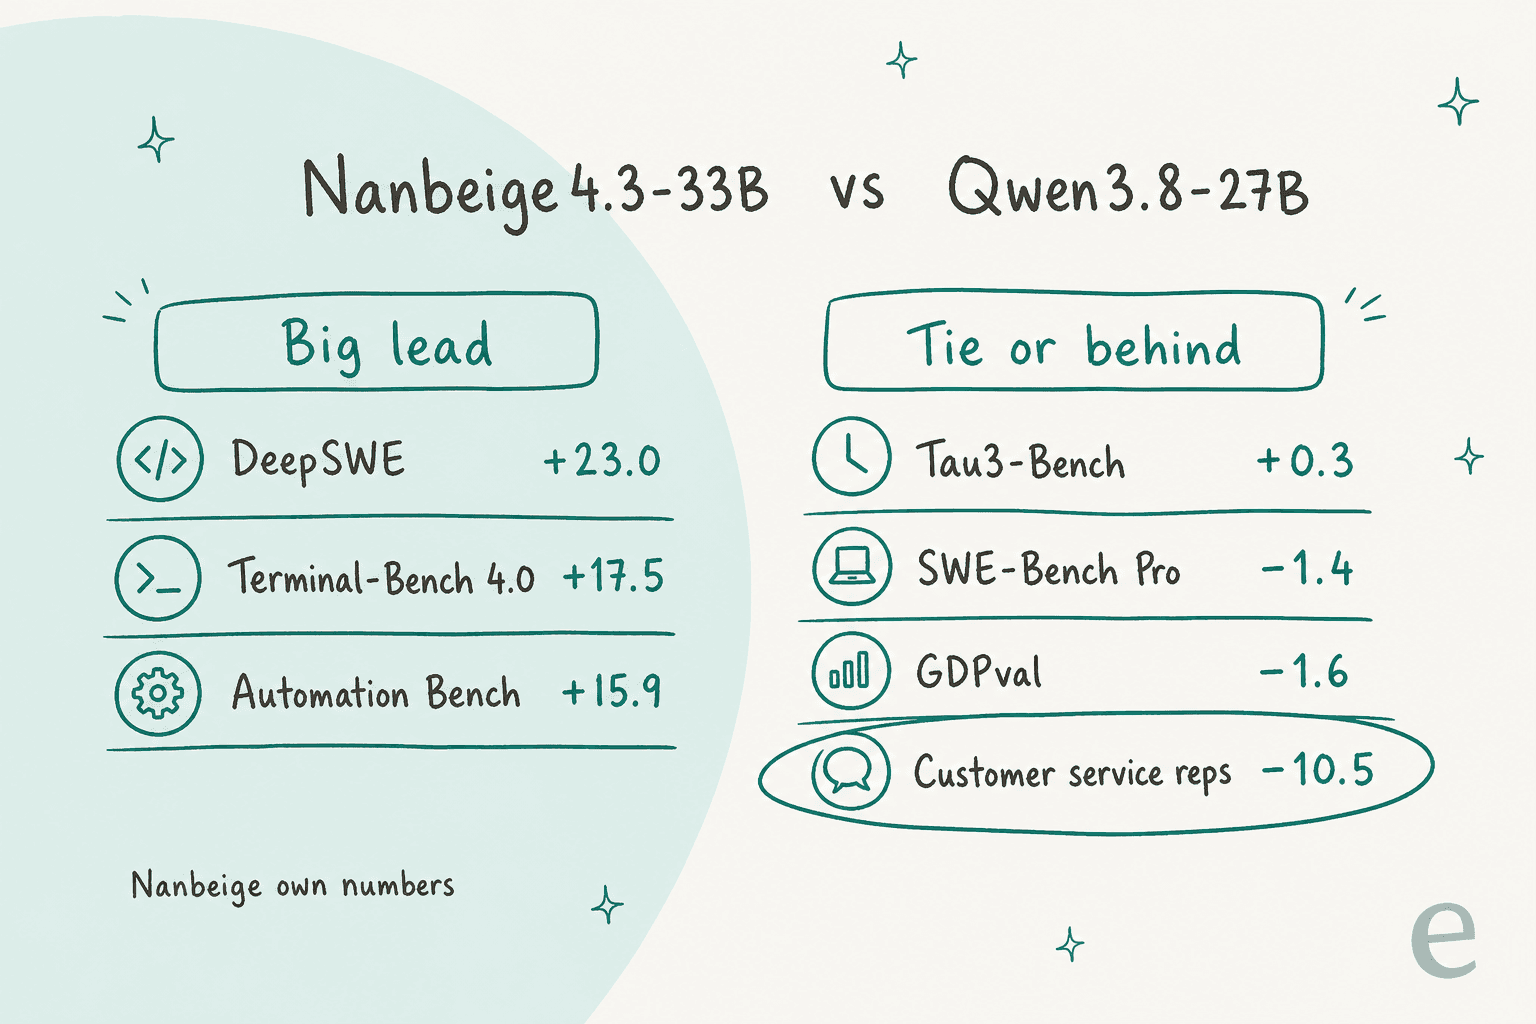
O detalhe que eu destacaria está dentro do gráfico JobBench, que divide a pontuação entre 35 ocupações. O Nanbeige vence na maioria delas, e com folga para administradores de sistemas web (72,0 vs 36,0) e redatores técnicos (72,1 vs 53,7). No entanto, em tarefas de representante de atendimento ao cliente, ele marca 21,1 contra 31,6 do Qwen, perdendo também para secretários e assistentes administrativos (28,8 vs 47,5).
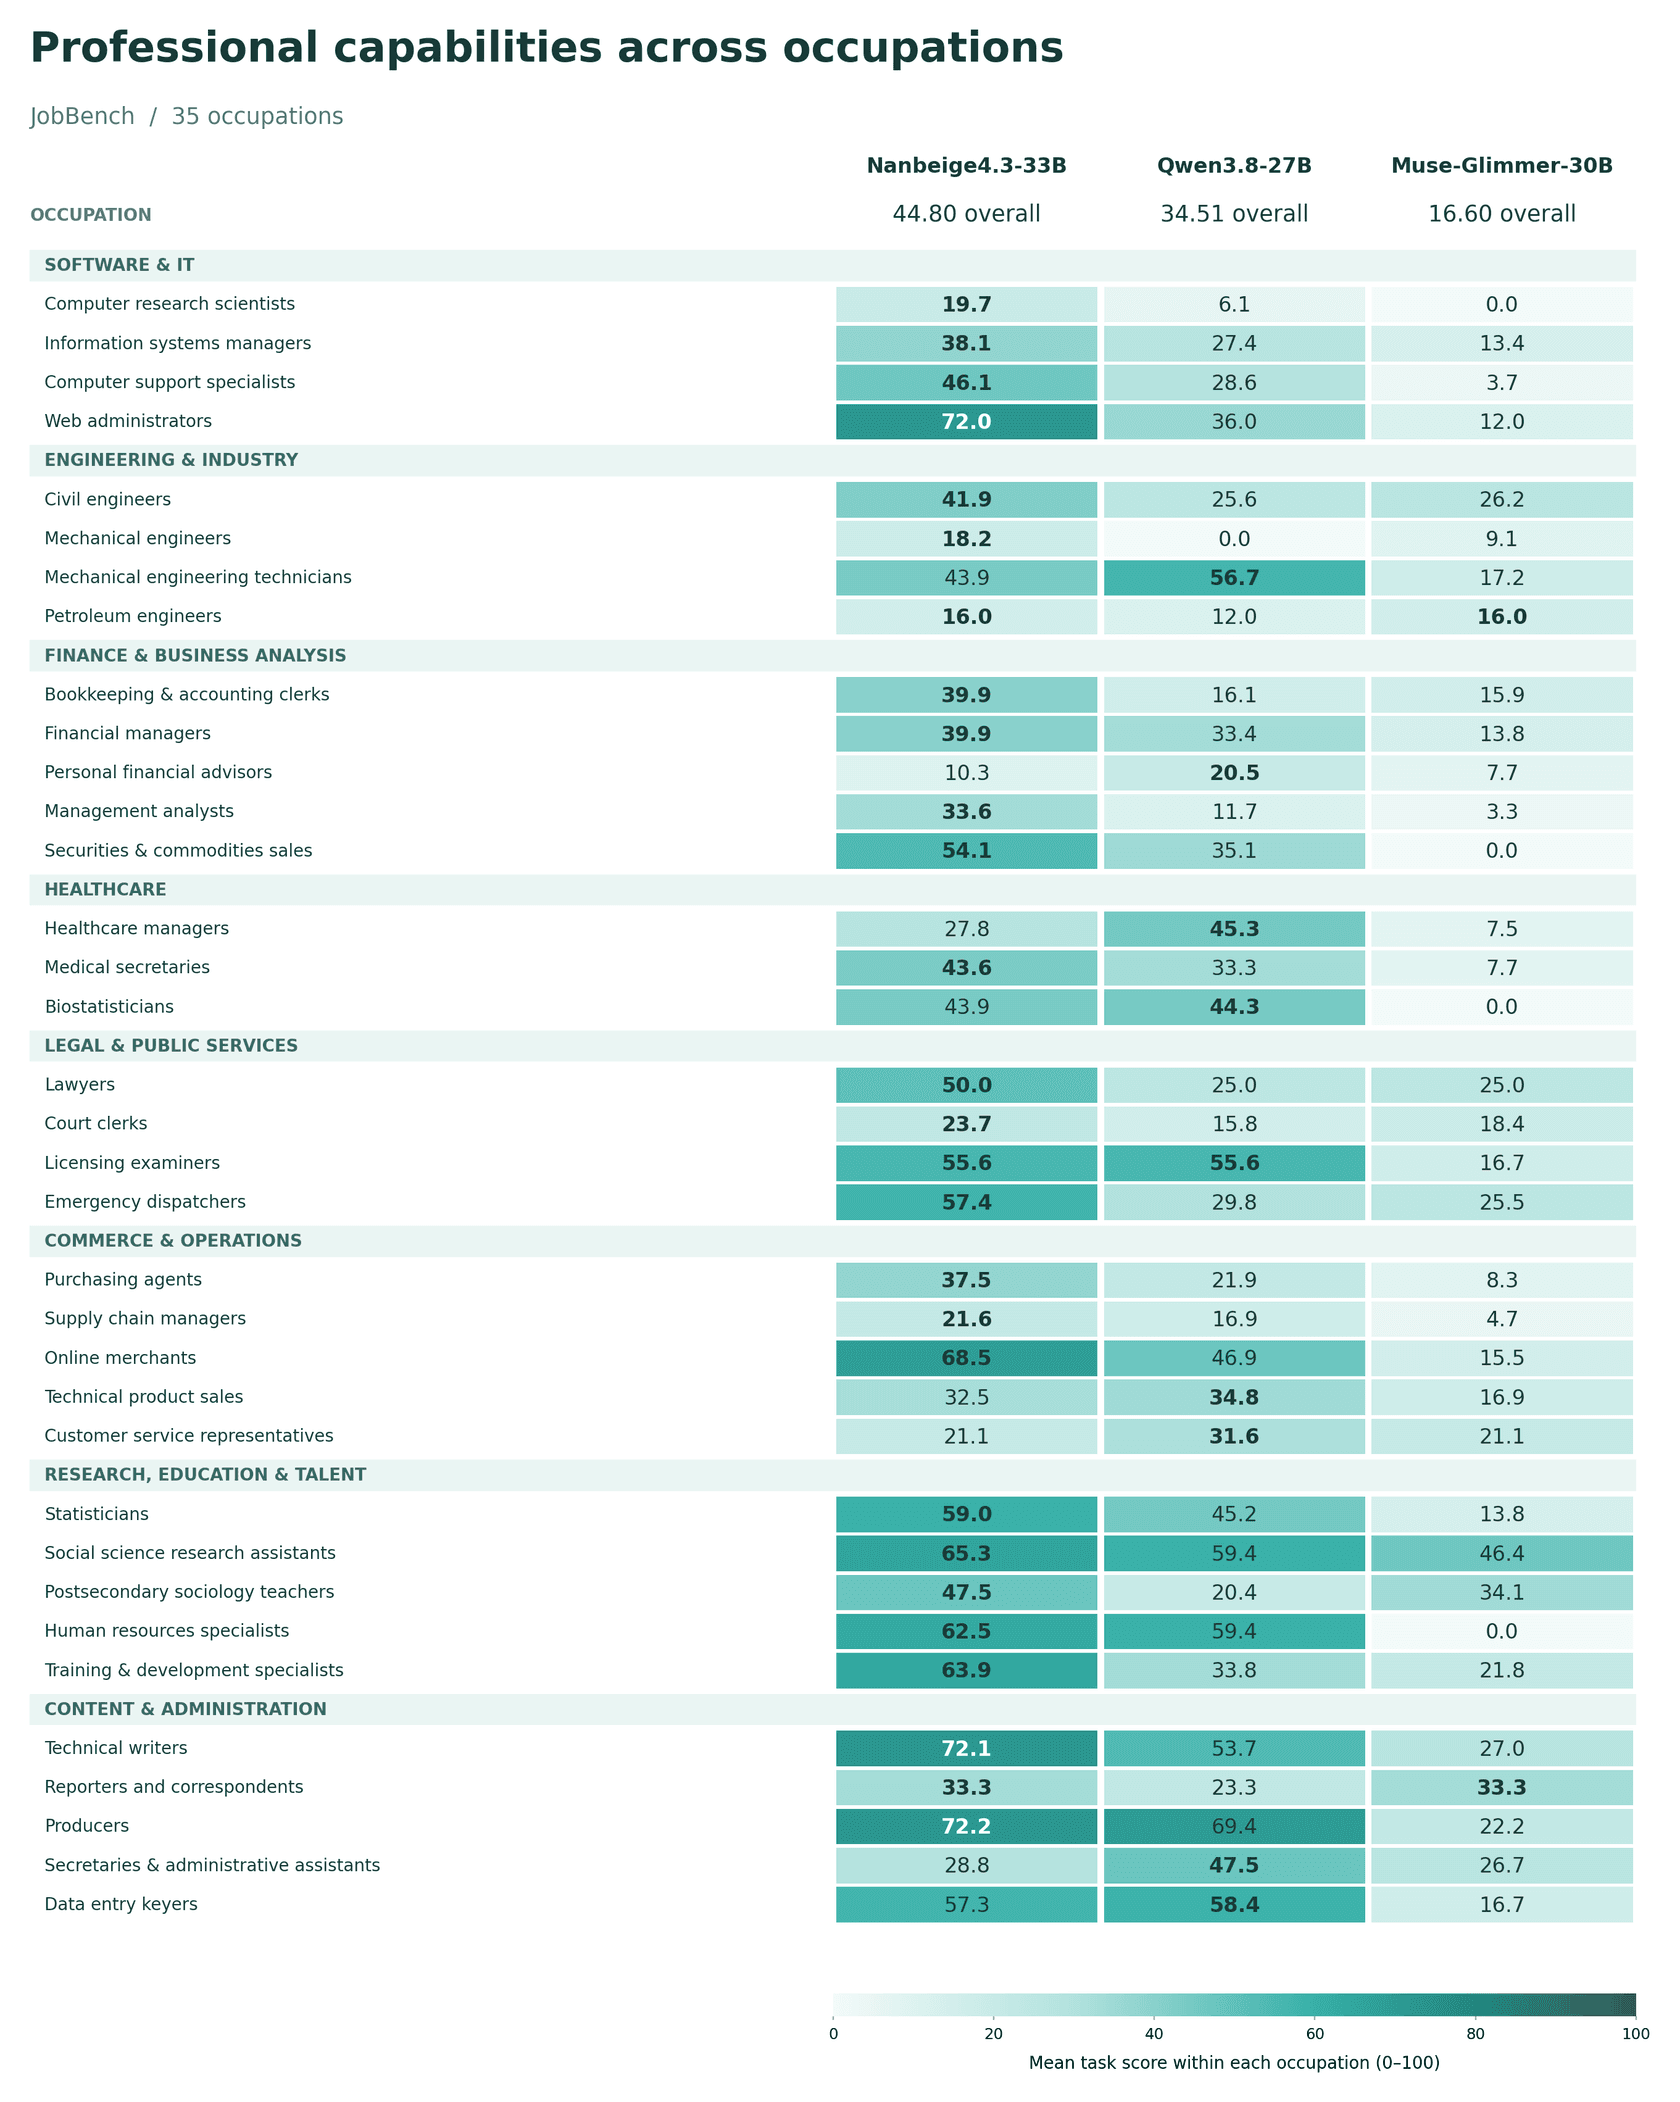
Isso condiz com o que vejo no trabalho de suporte. Ser excelente em escrever código em um terminal não se traduz automaticamente em responder a um cliente irritado com um reembolso, que é também o motivo pelo qual um agente de IA e um chatbot não são a mesma coisa. A qualidade do suporte depende muito mais do que o modelo pode consultar do que do modelo em si. No meu levantamento de modelos para tickets de suporte, o mesmo modelo caiu 68 pontos no benchmark Tau da Sierra no momento em que a resposta estava em documentos em vez de uma ferramenta.
O Nanbeige rodou o Tau3-Bench com o repositório oficial, mas sua pontuação não está no ranking público da Sierra, portanto não a compare diretamente com os números de lá.
Quanta memória o Nanbeige 4.3 precisa?
Esta é a parte que a postagem de lançamento omite. Os pesos são gerenciáveis: um GGUF de 4 bits da comunidade feito por bartowski tem 20,79 GB em Q4_K_M e 35,2 GB em Q8_0. O problema é o contexto.
O Nanbeige4.3-33B é um transformador denso clássico com atenção de consulta agrupada (grouped-query attention): 52 camadas, 8 cabeças de chave-valor de 128 dimensões cada. Cada token mantido no contexto custa 2 × 52 × 8 × 128 × 2 bytes, ou 212.992 bytes por token em 16 bits. Esse é o número que decide sua GPU, não a contagem de parâmetros.
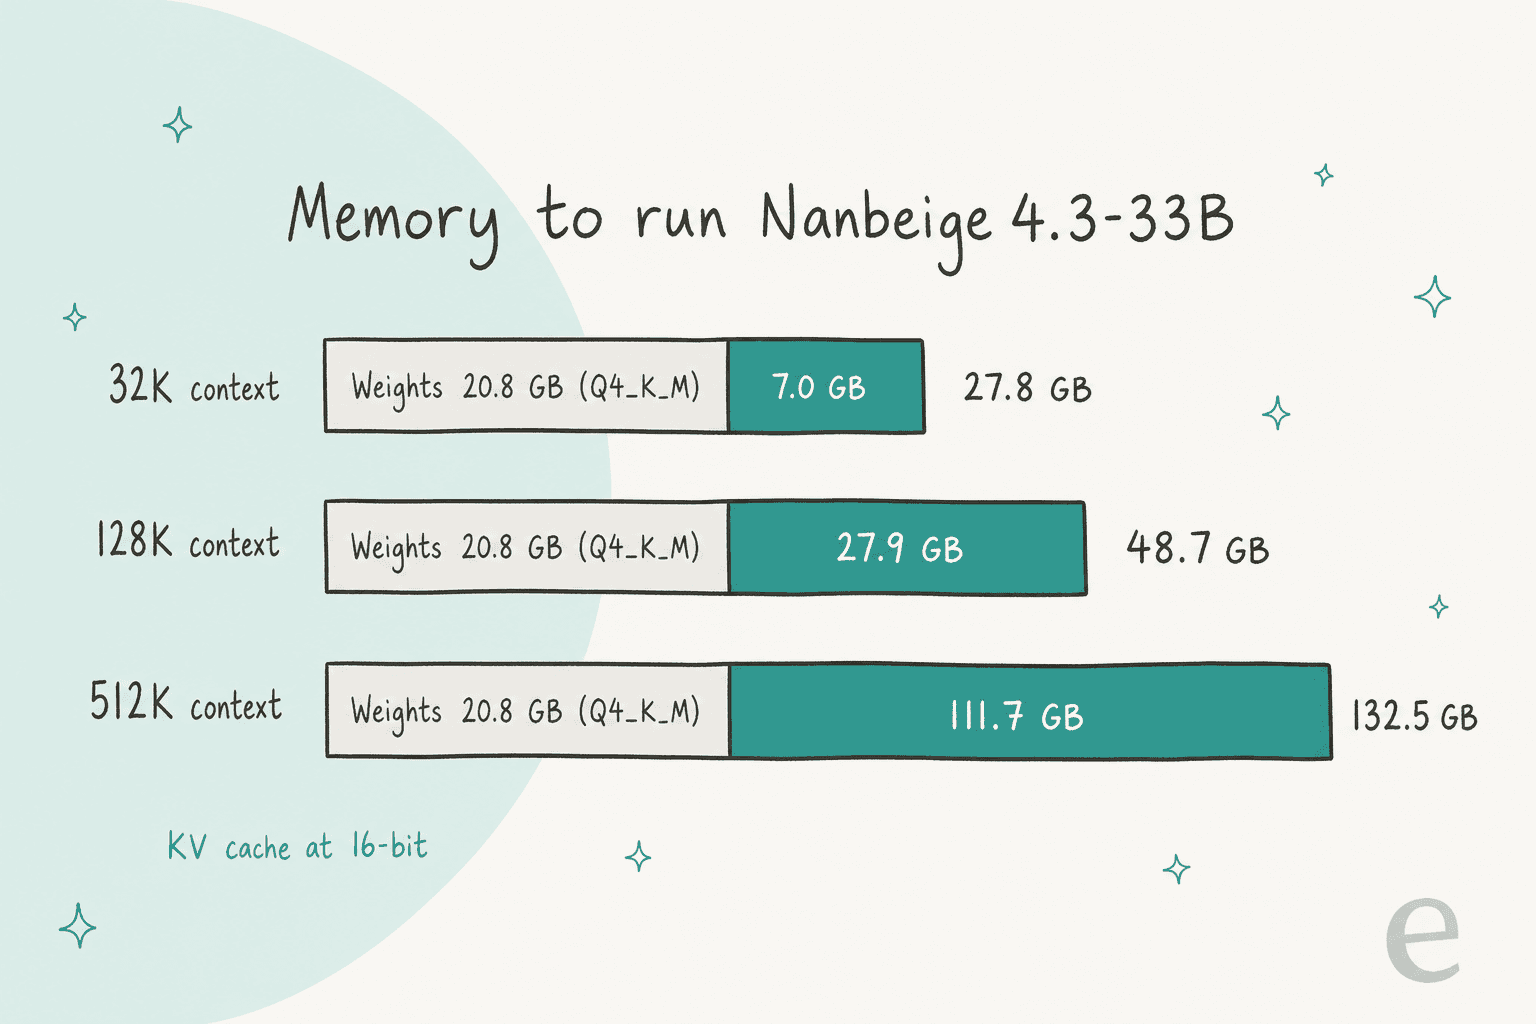
| Comprimento do contexto | Cache KV (16-bit) | Cache KV (8-bit) | Total com pesos Q4_K_M (cache 16-bit) |
|---|---|---|---|
| 32K | 7,0 GB | 3,5 GB | ~27,8 GB |
| 128K | 27,9 GB | 14,0 GB | ~48,7 GB |
| 256K | 55,8 GB | 27,9 GB | ~76,6 GB |
| 512K | 111,7 GB | 55,8 GB | ~132,5 GB |
Portanto, a manchete de "contexto de 512K" é real, mas usar tudo isso exige hardware de servidor. Os próprios exemplos de servidor do Nanbeige para vLLM e SGLang configuram o paralelismo de tensores para 4, o que significa quatro GPUs.
Os usuários notaram isso em um dia. A discussão mais comentada no repositório é um pedido para otimizar o cache de KV, onde as pessoas apontam que alguns rivais nesta classe de tamanho precisam de muito menos cache para o mesmo contexto. É um ponto válido contra a alegação de "custo-benefício" do cartão do modelo: em contextos longos, um modelo 33B denso é o oposto de barato.
A vantagem do design simples é a compatibilidade. Como é uma arquitetura Llama padrão, pelo menos 30 conversões da comunidade (GGUF, MLX para Apple Silicon, NVFP4, FP8) apareceram no Hugging Face em dois dias, e ele funciona no vLLM e SGLang originais com os analisadores (parsers) de raciocínio e ferramentas do Qwen.
Como executar o Nanbeige 4.3?
Não há uma API hospedada pelo Nanbeige, e o OpenRouter não listava o modelo até 26 de outubro de 2026. Você deve baixar os pesos e executá-los. O cartão do modelo oferece três caminhos:
- Transformers para testes rápidos. Carregue
Nanbeige/Nanbeige4.3-33Bcomtrust_remote_code=Trueedevice_map='auto'. - vLLM para servir o modelo. O exemplo do cartão usa
--tensor-parallel-size 4,--reasoning-parser qwen3e--tool-call-parser qwen3_coder. - SGLang, com os mesmos dois analisadores e
--tp-size 4.
Duas configurações de modelo de chat (chat-template) importam mais do que parecem:
enable_thinkingestá ativado por padrão. Desative para respostas rápidas.preserve_thinkingmantém o raciocínio de turnos anteriores. O Nanbeige recomendaTruepara uso de ferramentas e agentes de codificação, eFalsepara chat comum. As pontuações de benchmark foram obtidas com essa opção ativada.
As configurações recomendadas também variam conforme a tarefa: temperatura 1,0 com até 65.536 novos tokens para trabalho com agentes e ferramentas, e temperatura 0,6 com até 262.144 novos tokens para raciocínio e chat.
Se você está comparando opções locais, outros modelos abertos que abordei recentemente, como o Gemma 4, o Mistral Large 4 e o DeepSeek V4 Flash, fazem concessões diferentes entre tamanho, custo de contexto e acesso hospedado. Minha lista de agentes de IA de código aberto cobre as ferramentas nas quais você conectaria qualquer um deles, e o levantamento de assistentes de codificação com IA aborda o lado hospedado. Para acesso via API em vez de auto-hospedagem, o Kimi K3 e o MiniMax 3 são as opções óbvias.
O que vem a seguir para o Nanbeige?
A equipe do Nanbeige tem respondido perguntas diretamente na página do modelo no Hugging Face, e três respostas delineiam o roteiro. Ao ser perguntado se o 33B reutiliza o design em loop do 4.2, um membro da equipe disse que não, e explicou por quê:
"Com base em nossos experimentos, a arquitetura Looped Transformer oferece um melhor equilíbrio entre qualidade e computação em modelos menores. Nossos próximos modelos pequenos, como o Nanbeige4.3-3B e o Nanbeige4.5-3B, usarão a arquitetura Looped Transformer e entregarão um desempenho aprimorado."
O mesmo membro da equipe afirmou que um relatório técnico será lançado com o Nanbeige4.3-3B, que um módulo de decodificação especulativa DFlash2 está planejado para uma geração mais rápida e que pesos em FP8 estão "chegando em breve". Em setembro, o laboratório também disse no X que o Nanbeige4.5 já estava em treinamento.
Minha leitura: se você executa agentes pequenos em hardware modesto, o lançamento pelo qual vale a pena esperar é o Nanbeige4.3-3B, não este. O 33B é a prova de que o professor é forte. Se o aluno de 3B manterá a maior parte dessa vantagem em codificação, em um modelo que caiba em um notebook, é a pergunta real, e ninguém poderá responder até que ele seja lançado.
Você deve usar o Nanbeige 4.3?
Depende do que você está construindo, e a tabela de benchmarks já diz quase tudo:
- Agentes de codificação em seu próprio hardware: sim, experimente. As vantagens no Terminal-Bench 4.0 e no DeepSWE são grandes o suficiente para resistir a variações de ferramentas, e a licença Apache 2.0 significa que não haverá dores de cabeça com licenças. Reserve orçamento para o cache de KV ou limite o contexto entre 32K e 64K.
- Trabalho com documentos longos em uma única GPU: provavelmente não. Um prompt de 128K precisa de cerca de 49 GB com pesos de 4 bits.
- Ajuste fino (fine-tuning) do seu próprio agente: o modelo Base é um bom ponto de partida. O Nanbeige relata que ele supera o Gemma4-31B-Base em todos os oito benchmarks de base testados, incluindo o MMLU-Pro (
66,9vs59,3). - Suporte ao cliente: não com base nestes números. Ele perde para o Qwen em tarefas de atendimento ao cliente e apenas empata no Tau3-Bench: além disso, um modelo sozinho não responde tickets. Minha escolha do melhor agente de IA para atendimento ao cliente analisa a configuração completa.
Executando IA em tickets de suporte reais, não em benchmarks
Esse último ponto é onde passo meus dias. Um modelo como o Nanbeige4.3-33B é infraestrutura. Para responder a um ticket real, algo ainda precisa estar integrado ao seu helpdesk, ler suas macros e tickets anteriores, saber quais clientes pertencem a um humano e seguir as regras sobre o que nunca é permitido dizer. Esse é o trabalho para o qual o companheiro de helpdesk com IA do eesel foi construído: um dos companheiros de IA prontos para o trabalho que você contrata para uma função específica. Ele roda dentro de ferramentas como as configurações do Zendesk AI em vez de substituí-las, e a conta do custo por ticket é o que geralmente define a decisão.
A smava, uma plataforma de comparação de empréstimos de Berlim, mostra como isso funciona na prática. O eesel lidou com cerca de 27.000 tickets do Zendesk em um mês entre a smava e sua marca irmã Finanzcheck, categorizando cerca de 14.600 e preparando cerca de 15.300 rascunhos de resposta a partir de aproximadamente 820 macros e artigos da central de ajuda. Clientes que já possuem um consultor de crédito são ignorados para que falem diretamente com seu consultor, e o eesel nunca envia as respostas finais sozinho: um agente aprova cada uma. Nada disso aparece em um benchmark de codificação, mas tudo isso decide se a IA ajuda ou atrapalha.

Antes de entrar em produção, o eesel testa sua configuração contra centenas de seus tickets anteriores para que você veja as respostas antes do cliente, o que diz mais do que qualquer benchmark citado por um fornecedor. Eu descrevi como esses testes funcionam separadamente. A SamCart seguiu o mesmo caminho no Freshdesk, com um agente para tickets de e-mail e outro para o chat do site, ambos respondendo com base em cerca de 280 artigos da central de ajuda. Se você gosta de trabalhar pelo terminal da mesma forma que faria com um modelo local, o CLI do eesel permite que você, um script ou um agente de codificação como o Claude Code conectem integrações, editem as instruções permanentes do agente, aprovem ou neguem ações pendentes e leiam o log de atividades, tudo em JSON.
Experimente o eesel
O Nanbeige 4.3 é um motor aberto potente para agentes de codificação. Se o que você realmente precisa é de um agente respondendo à sua fila de suporte ainda esta semana, o companheiro de helpdesk com IA do eesel se integra ao seu Zendesk, Freshdesk ou Gorgias em minutos, aprende com seus tickets passados e central de ajuda, e rascunha ou envia respostas dentro das regras que você definir.
O eesel AI custa $0,40 por ticket ou sessão de chat e $4,00 por post de blog, começando com um teste gratuito de $50 e sem a exigência de mínimos mensais ou taxas de plataforma. É gratuito para começar com 100 créditos e sem necessidade de cartão, para que você possa testar em tickets reais antes de decidir. Experimente o eesel.
Perguntas frequentes
O que é o Nanbeige 4.3?
O Nanbeige 4.3 é uma série de modelos do Nanbeige LLM Lab no BOSS Zhipin (Kanzhun). Seu primeiro lançamento, o Nanbeige4.3-33B, foi disponibilizado no Hugging Face em 24 de outubro de 2026 sob a licença Apache 2.0. É um modelo de texto denso de 33 bilhões de parâmetros com uma janela de contexto de 512K, construído para codificação agentic (agentic coding) e tarefas de escritório, e serve para ensinar um modelo menor, o Nanbeige4.3-3B. Ele faz parte do mesmo grupo de modelos abertos que o Gemma 4 e o Qwen.
O Nanbeige 4.3 é gratuito?
Sim. Os pesos (weights) para o Nanbeige4.3-33B e o Nanbeige4.3-33B-Base são lançados sob a licença Apache 2.0, que permite o uso comercial. Você paga pelo hardware: apenas os pesos em BF16 ocupam 66 GB, e um GGUF de 4 bits tem cerca de 21 GB antes de qualquer memória de contexto. Para ter uma ideia do custo de modelos hospedados, veja o preço do DeepSeek V4 Flash.
Quanta VRAM o Nanbeige 4.3 33B precisa?
Aproximadamente 21 GB para os pesos de 4 bits, mais cerca de 0,2 MB de cache de KV por token em 16 bits. Isso resulta em cerca de 28 GB no total com contexto de 32K, 49 GB com 128K e mais de 130 GB com o contexto total de 512K. Os exemplos de vLLM e SGLang do próprio Nanbeige usam paralelismo de tensores (tensor parallelism) de 4 vias. Se você precisa de algo que caiba em uma única placa pequena, os modelos de linguagem pequenos anteriores da linha Nanbeige são de 3B.
O Nanbeige 4.3 é melhor que o Qwen3.8-27B?
Na tabela do próprio Nanbeige, o Nanbeige4.3-33B supera o Qwen3.8-27B em 18 de 20 benchmarks, com as maiores diferenças no DeepSWE (65,5 vs 42,5) e no Terminal-Bench 4.0 (23,8 vs 6,3). O Qwen ainda vence no SWE-Bench Pro e no GDPval, e nenhum laboratório independente recalculou os números ainda. O irmão maior do Qwen é abordado na análise do Qwen3.8 Max.
Posso usar o Nanbeige 4.3 para suporte ao cliente?
Você pode, mas os números próprios do modelo não sustentam esse caso. No JobBench, ele marcou 21,1 em tarefas de representante de atendimento ao cliente contra 31,6 do Qwen3.8-27B, e sua pontuação no Tau3-Bench é um empate de 48,8 a 48,5. Um agente de suporte também precisa do seu helpdesk, macros e regras de transferência integrados, que é a parte que um agente de helpdesk com IA como o eesel resolve para você.
O Nanbeige 4.3 tem uma API?
O Nanbeige fornece os pesos, não uma API hospedada. O cartão do modelo (model card) aborda como executá-lo por conta própria com Transformers, vLLM ou SGLang, e o OpenRouter não o listava até 26 de outubro de 2026. Se você preferir chamar um modelo aberto hospedado, o Kimi K3 e o GLM-5.3 Flash estão disponíveis via APIs.
Quando o Nanbeige4.3-3B será lançado?
O Nanbeige ainda não deu uma data. Um membro da equipe Nanbeige afirmou na página do modelo no Hugging Face que o relatório técnico para a série 4.3 será lançado junto com o Nanbeige4.3-3B, e que o 3B usará o design Looped Transformer do Nanbeige4.2-3B. Para entender mais sobre modelos em loop (looped models), veja a explicação sobre o GPT-6 Astra.