

A Meta lançou o Muse Spark 1.2 em 5 de agosto de 2026 e o chamou de versão de programação. Leia os números independentes e essa é a única coisa que ele quase não é. Na Artificial Analysis, o Terminal-Bench subiu 2,2 pontos enquanto o índice agêntico subiu 9,6 e o Elo do GDPval subiu 254. O colapso em agentes gerais que atrapalhava o 1.1 foi corrigido, e a Meta mencionou isso em uma frase.
A segunda coisa a saber é que os principais gráficos de programação da Meta mudam duas variáveis ao mesmo tempo. O Muse Spark 1.2 é medido dentro do Muse Code, o novo agente de terminal da Meta, enquanto o 1.1 é medido no mini-swe-agent. Os modelos também foram treinados em conjunto com esse harness. Então a diferença que você vê é um modelo mais um harness, e o gráfico não consegue separá-los para você.
A terceira é o preço, e é a parte mais interessante do lançamento. O mesmo modelo tem dois IDs: $1,25/$4,25 por milhão de tokens, ou $0,10/$0,20 se você deixar a Meta treinar com o seu tráfego. Isso dá cerca de 16x em uma mistura normal. Na eesel, eu construo agentes de IA para filas de suporte, e o padrão que eu apontaria é um que já vi acabar com negócios: o modelo nunca foi o gargalo. Um comprador fez certa vez uma avaliação metódica de 67 testes do nosso agente, chamou as respostas de conhecimento de sólidas e foi embora mesmo assim porque o widget de chat era lento e travava. Tokens mais baratos não consertam o que fica em volta dos tokens.
O que a Meta realmente lançou em 5 de agosto
Duas coisas chegaram juntas, de Matthias Reso e Josh Walters no blog para desenvolvedores da Meta: o modelo e o agente criado para executá-lo.
O Muse Spark 1.2 é o modelo. A descrição da própria Meta é incomumente contida: ela chama o 1.2 de "a moderate improvement over Muse Spark 1.1", otimizado para "multi-file refactors, long debugging sessions and tasks that run well past a single prompt". O post de pesquisa é ainda mais direto, apresentando o lançamento como "our next step toward the frontier, with larger and much more capable models on the way." Ninguém na Meta está afirmando ter um modelo de fronteira aqui, e eu acreditaria na palavra deles. É uma postura diferente do resto do movimento de IA da Meta, onde o trabalho voltado ao consumidor recebe promessas maiores.
O Muse Code é o agente, em beta. Ele se instala com um comando, roda no seu terminal, cria subagentes paralelos e registra tudo o que faz. É a peça nova deste lançamento, e acho que é a que a maior parte da cobertura ignorou. Se você nunca usou uma ferramenta de programação com IA no terminal, é a categoria em que ele entra.
Três coisas vieram do Muse Spark 1.1 sem mudança: a janela de contexto de 1.048.576 tokens, a tabela de preços padrão e os pesos fechados. O que mudou fora do modelo foi a disponibilidade. A Meta ampliou a prévia pública para além dos Estados Unidos, o que, para quem tentou acessar o 1.1 de fora dos EUA, foi a verdadeira manchete.
A Artificial Analysis já marcou o Muse Spark 1.1 como obsoleto e o aponta para o 1.2, o que mostra como a Meta quer que a linhagem seja lida.
Onde o Muse Spark 1.2 realmente melhorou
Esta é a parte que eu colocaria no quadro branco. A Meta vendeu isto como um modelo de programação. Os números de programação foram os que menos se mexeram.
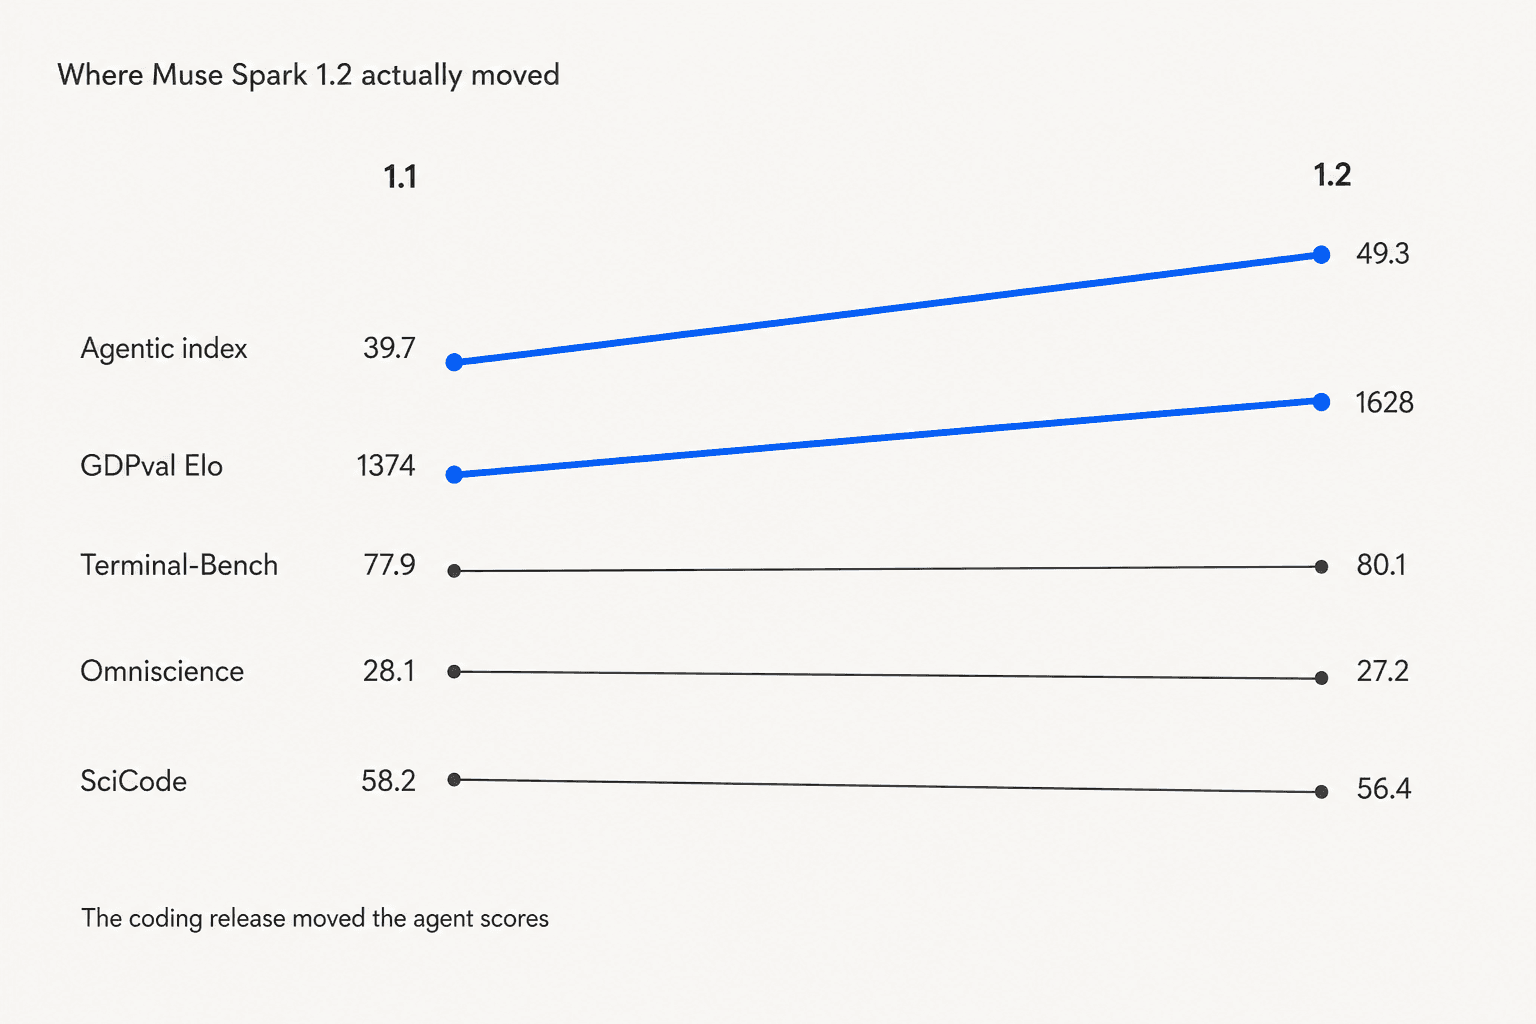
Tudo isto vem da Artificial Analysis, que rodou as duas versões no mesmo harness, o que faz a comparação valer alguma coisa:
| Benchmark | Muse Spark 1.1 | Muse Spark 1.2 | Variação |
|---|---|---|---|
| Índice agêntico | 39.7 | 49.3 | +9.6 |
| GDPval-AA v2 (Elo) | 1374 | 1628 | +254 |
| Intelligence Index | 53.2 | 56.8 | +3.6 |
| tau-3 Banking | 31.8% | 34.9% | +3.1 |
| CritPt | 15.1% | 17.7% | +2.6 |
| Terminal-Bench 2.1 | 77.9% | 80.1% | +2.2 |
| AA-LCR (contexto longo) | 81.3% | 83.3% | +2.0 |
| GPQA Diamond | 89.8% | 90.4% | +0.6 |
| Humanity's Last Exam | 46.2% | 45.5% | -0.7 |
| AA-Omniscience Index | 28.1 | 27.2 | -0.9 |
| SciCode | 58.2% | 56.4% | -1.8 |
O SciCode, um benchmark de programação, andou para trás. O Terminal-Bench, o benchmark de programação com o qual a Meta abriu, se mexeu cerca de um quinto do que o índice agêntico. Já o GDPval-AA v2, a avaliação que pontua comparações cegas em pares de entregas profissionais reais, subiu 254 pontos de Elo, o que levou o modelo do fundo dessa tabela ao segundo lugar, atrás do Opus 5, no gráfico da própria Meta.
Na minha análise do Muse Spark 1.1 apontei que a coisa mais estranha daquele modelo era a contradição no seu centro: a Meta comercializava um modelo para agentes, e as avaliações agênticas independentes eram os seus piores resultados. Esse é o buraco que o 1.2 preenche. Só que não é o buraco para o qual o post de lançamento da Meta aponta.
Para dar contexto sobre a companhia em que ele agora está, 56,8 coloca o Muse Spark 1.2 em décimo terceiro de vinte nessa tabela, atrás do Claude Opus 5 com 63,1 e do Grok 4.6 com 60,9, e um fio à frente do GPT-5.6 Terra com 56,6.
O número de alucinação precisa ser lido duas vezes
Mais uma linha da mesma fonte, porque é o tipo de coisa que uma única pontuação de índice esconde. A Artificial Analysis divide o AA-Omniscience em precisão e taxa de alucinação:
| Medida | Muse Spark 1.1 | Muse Spark 1.2 |
|---|---|---|
| Precisão | 52.0% | 45.4% |
| Taxa de alucinação | 50.0% | 33.3% |
O 1.2 alucina cerca de um terço a menos e acerta cerca de um oitavo a menos das respostas. Ele aprendeu a se recusar a responder. Isso é uma melhoria real para qualquer coisa com um cliente do outro lado e uma regressão real para qualquer coisa que precise de uma resposta, e o resultado é um índice composto ligeiramente pior. Se você está escolhendo um modelo para um fluxo de trabalho em que uma resposta errada sai cara, essa troca é provavelmente o número mais relevante deste post, e ele não está em nenhum gráfico da Meta. A versão mais ampla desse problema está em alucinações de IA no suporte, e o lado das ferramentas para detectá-las está em ferramentas de rastreamento de LLM.
A pegadinha do harness nos próprios gráficos da Meta
Agora a parte que me fez voltar e reler o post de lançamento.
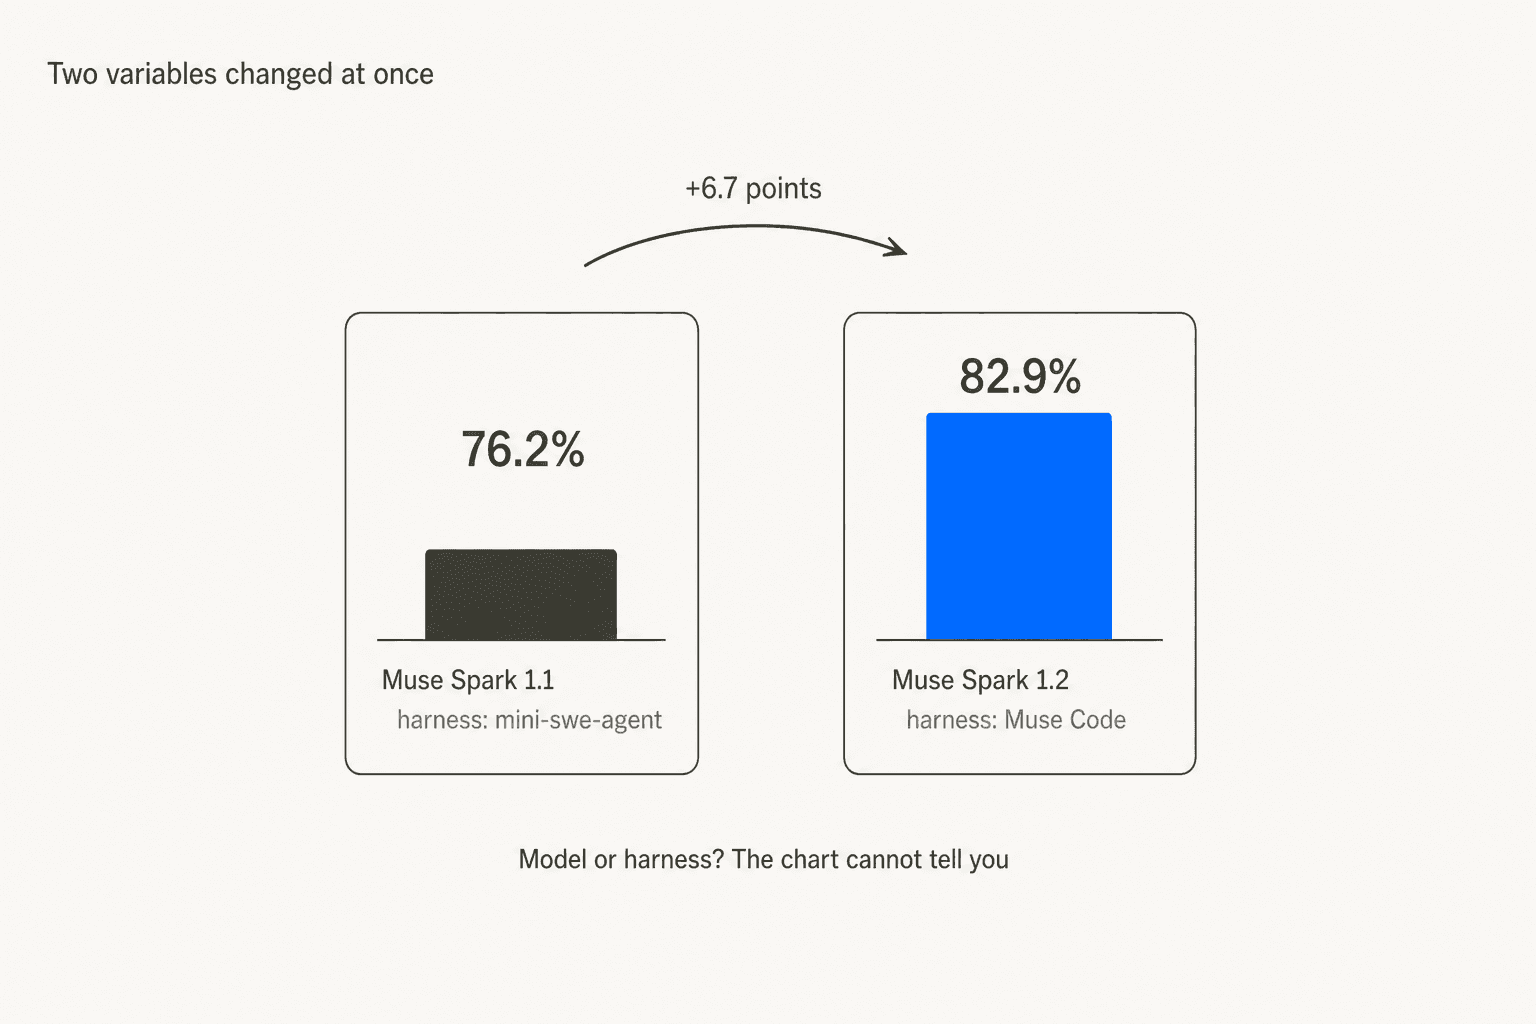
O gráfico do Terminal-Bench 2.1 da Meta mostra o Muse Spark 1.2 com 82,9% e o Muse Spark 1.1 com 76,2%. No pequeno texto cinza sob cada barra, ele também nomeia o harness em que cada modelo rodou: o 1.2 rodou no Muse Code, o 1.1 rodou no mini-swe-agent. O mesmo vale para o gráfico do DeepSWE. A Meta não esconde isso, está impresso ali mesmo, mas o olho lê as barras e não a nota de rodapé.
A Meta também diz abertamente que "co-trained Muse Spark 1.2 with Muse Code", incluindo "rejection sampled harness trajectories" e otimizações de receita para objetivos, compactação e subagentes. Ou seja, o modelo foi ajustado ao harness em que é avaliado.
O único gráfico em que nenhum harness é citado é o benchmark interno de programação da Meta, e é o mais plano da página:
| Modelo | Meta Internal Coding Bench |
|---|---|
| Opus 5 (max) | 79.4% |
| Muse Spark 1.2 | 70.6% |
| Muse Spark 1.1 | 68.3% |
| GPT 5.6 Terra (max) | 65.4% |
| Gemini 3.6 Flash (high) | 63.9% |
2,3 pontos, no gráfico em que o harness deixa de ser uma variável. Compare com os 6,7 pontos do Terminal-Bench e os 6,3 do DeepSWE, onde ele é. Não estou dizendo que a Meta maquiou nada. Estou dizendo que, se você vai rodar este modelo nas suas próprias ferramentas, o número com harness controlado é o que prevê a sua experiência, e é o menor número da página.
Um comentarista no thread de lançamento no Hacker News colocou a versão geral disso melhor do que eu consigo:
"Outputs are a little bit more deterministic if you control the harness. It is easy to benchmark across one harness, one system prompt and extract the most performance when you control the harness."

Aliás, isso não é um problema específico da Meta. Todo laboratório agora lança um agente próprio e mede dentro dele, do Claude Code ao Codex e ao Grok Build. Só fica especialmente legível aqui porque a Meta imprimiu os nomes dos harnesses no gráfico.
Muse Code, a parte que é realmente nova
O Muse Code se instala em uma linha e roda como muse em qualquer diretório de projeto:
curl -fsSL https://dev.meta.ai/install.sh | bash
A ideia de design é o fan-out. Você entrega ao agente principal um lote de tarefas em um único prompt, e ele cria um filho com permissão de escrita por tarefa, cada um em seu próprio git worktree, para que filhos paralelos nunca toquem nos mesmos arquivos.
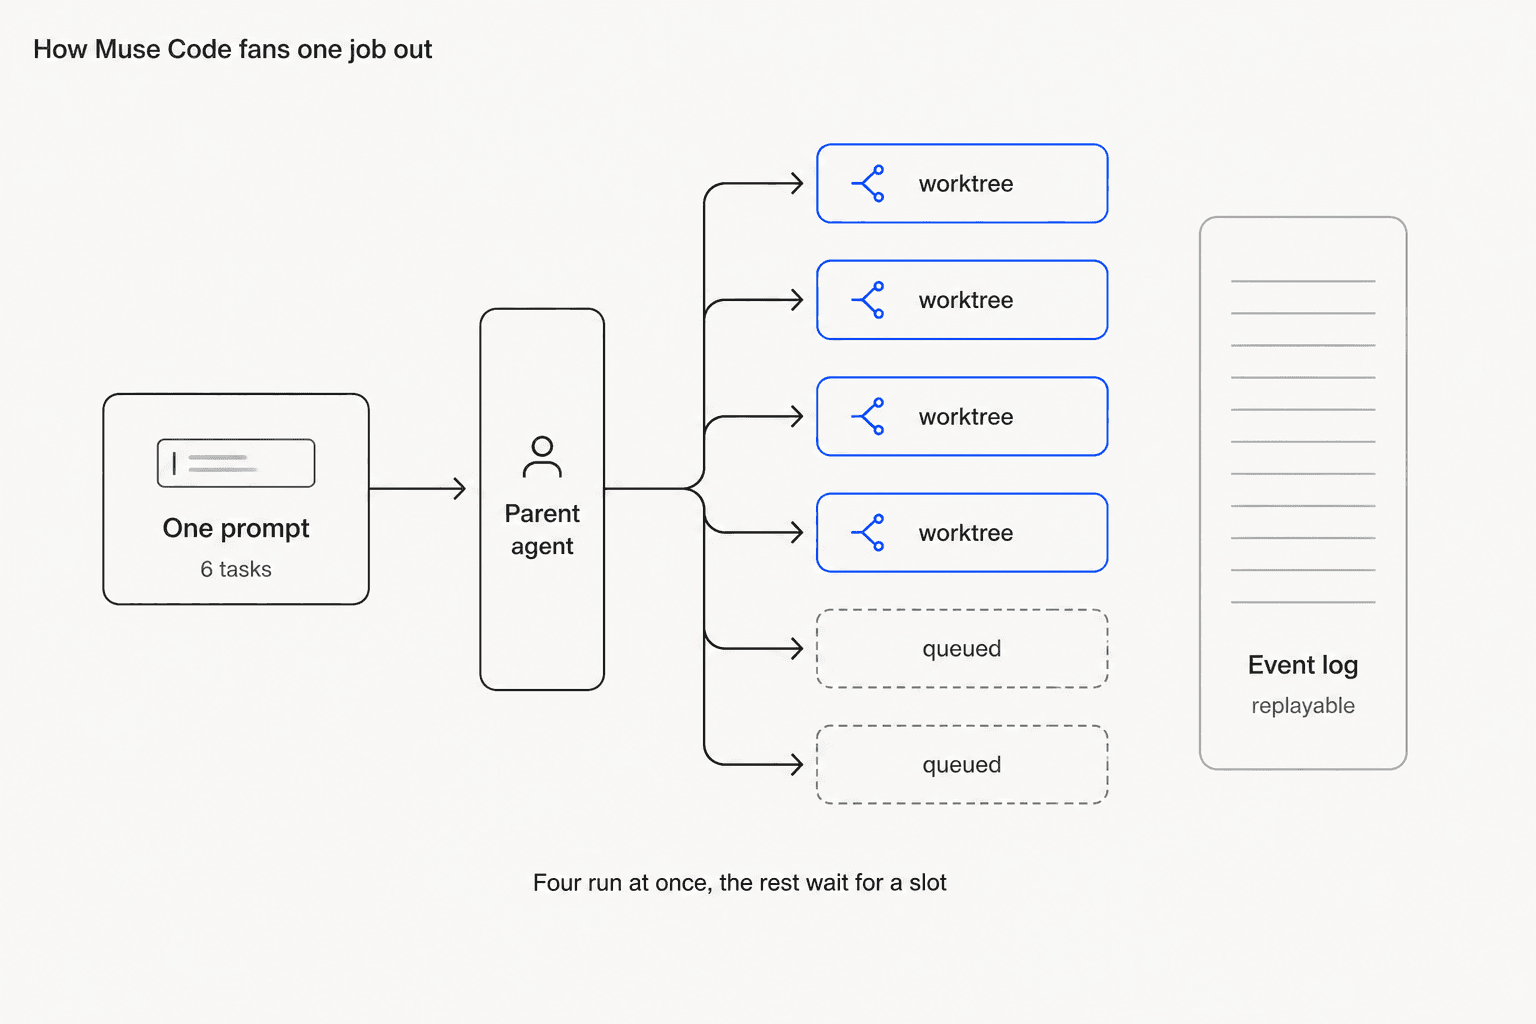
O próprio cookbook de fan-out da Meta percorre um lote de seis tarefas em um repositório de jogo de exemplo. O agente principal cria seis filhos, o limite de concorrência do host resulta em quatro, e as tarefas cinco e seis ficam na fila até liberar vagas.
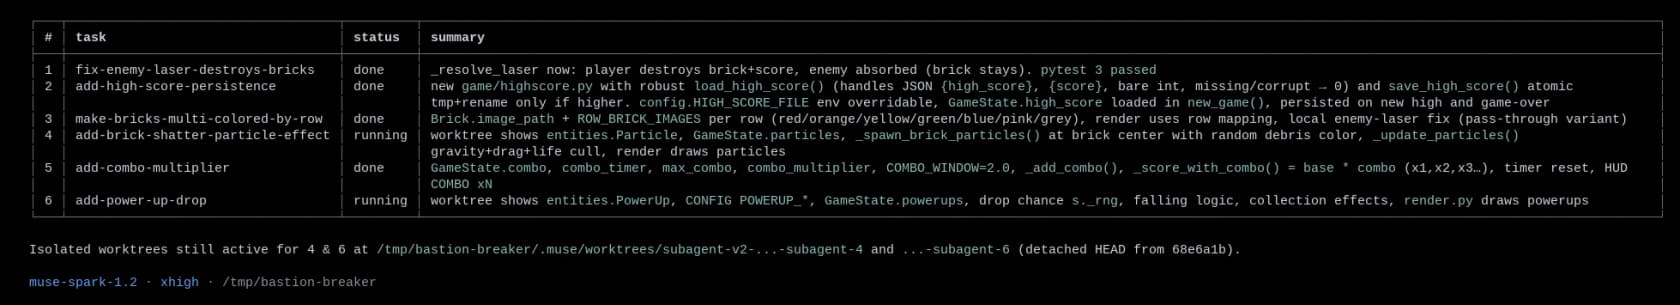
O subagent_status retorna essa lista, com a tarefa de cada filho, o estado e um resumo de uma linha do que mudou. Repare na barra de status na captura da própria Meta: muse-spark-1.2 · xhigh. O esforço está alto na demo, o que vale lembrar ao comparar os números com a sua própria conta. Os worktrees ficam em .muse/worktrees/ em estado detached HEAD, obtidos do HEAD do agente principal, sem nenhum comando git worktree manual. Na execução da Meta, o filho que corrigiu o bug passa toda a suíte de testes dentro do seu próprio worktree enquanto o master do agente principal ainda falha nesse mesmo teste.
Duas outras peças merecem menção:
- Um log de eventos reproduzível. Cada chamada ao modelo, execução de ferramenta, aprovação e edição é anexada a JSONL simples no seu disco, que você pode pesquisar com
jq. O mesmo log alimenta omuse resume, de modo que uma sessão que caiu continua do último passo registrado em vez de ser pedida de novo do zero. - Skills incluídas. Quatro playbooks vêm embutidos:
/plan(baseia um plano nos seus arquivos reais e depois para para aprovação),/grilling(faz uma entrevista com uma pergunta que força uma decisão por vez),/grill-with-docse/taste(uma checklist anti-slop de padrões visuais a evitar). Eles só funcionam por invocação explícita, então o agente não vai recorrer ao/grillpor conta própria, e um skill só é carregado no turno em que você o invoca.
Se você quer um olhar mais longo sobre como essa categoria está se desenhando, meu artigo sobre a CLI de programação agêntica cobre o cenário. Montar o seu próprio é outro projeto, e o passo a passo do Claude Code SDK é a comparação mais próxima do que a Meta construiu aqui.
Para o mercado de ferramentas em geral, há o resumo das melhores ferramentas de assistente de programação com IA. Quem estiver comparando com o líder atual deve começar pela visão geral do assistente de programação Claude AI.
A leitura honesta sobre o Muse Code: isolamento de worktree por subagente e um log de eventos com reprodução exata são boa engenharia, e a reação de um comentarista do Hacker News foi igual à minha, que "Muse code is more interesting than the new model." Se ele supera o harness que você já usa, uma beta e um post de blog não conseguem responder.
Preço do Muse Spark 1.2 e a troca do contributor
A Meta publica dois IDs de modelo para um único modelo, e a diferença entre eles é a história.
| ID do modelo | Contexto | Entrada / Mtok | Entrada em cache / Mtok | Saída / Mtok | Política de dados |
|---|---|---|---|---|---|
muse-spark-1.2-contributor | 1M | $0.10 | $0.002 | $0.20 | "Used to improve our products" |
muse-spark-1.2 | 1M | $1.25 | $0.15 | $4.25 | "Not used to improve our products" |
Esses rótulos são o texto da própria Meta, da sua página do modelo. A tarifa padrão não mudou em relação ao 1.1, então, se você já pagava pelo modelo antigo, o 1.2 é uma atualização gratuita em preço.
O nível contributor tem limite de tokens em uma janela móvel de 5 horas em vez de por número de requisições, e a Meta diz que está disponível em países selecionados. A Meta também observa que agora aceita pedidos de retenção zero de dados por meio de vendas, que é a porta empresarial do nível padrão.
Em uma mistura normal de 3:1 entre entrada e saída, isso dá $0,125 por milhão de tokens no ID contributor contra $2,00 no padrão. 16x, e a taxa de câmbio é o seu tráfego.
Dois números para conferir isso. A Artificial Analysis mediu o Muse Spark 1.2 em $0,399 por tarefa do Intelligence Index na tarifa padrão, 37% acima dos $0,292 do 1.1 porque o modelo pensa mais. Aplique a mesma mistura de tokens à tabela do contributor e dá perto de $0,017 por tarefa, o que ficaria abaixo do DeepSeek V4 Flash com $0,027, o modelo mais barato dessa tabela. Esse segundo valor é aritmética minha sobre os custos de tokens por tarefa publicados pela AA, não um resultado medido, e assume que escritas em cache são cobradas pela tarifa de entrada, o que a Meta não publica. A comparação com o DeepSeek é aquela em que vale parar, porque esse modelo tem pesos abertos e você pode rodá-lo onde ninguém treina com você. Minha análise do DeepSeek V4 Flash traz o quadro completo.
Mesmo na tarifa padrão, o argumento de valor se sustenta. O Muse Spark 1.2 marca 56,8 no Intelligence Index a $0,399 por tarefa; o Claude Opus 5 marca 63,1 a $2,34. Seis vezes o custo por onze por cento a mais de índice. Se esses onze por cento importam é inteiramente uma questão sobre a sua carga de trabalho, o mesmo argumento que fiz em alternativas ao Claude Opus 5.
Uma ressalva sobre a conta de raciocínio: $339,82 dos $639,27 que custou à Artificial Analysis rodar o índice completo foram em tokens de raciocínio que você nunca vê. O controle /effort da Meta aumenta e diminui isso, e em tarefas simples é o primeiro botão que eu giraria. É o mesmo item oculto que torna o preço da API da Anthropic difícil de prever só a partir de uma tabela de preços.
O que os desenvolvedores estão dizendo
O thread de lançamento rendeu 333 pontos e 266 comentários, e a reação se dividiu em uma linha clara: o preço é interessante, a questão da confiança não está resolvida e a dependência do harness é real.
Sobre o preço, a leitura foi imediata:
"If you are happy to share data for training, the contributor mode offers amazing price $0.10 / $0.20"
Outra pessoa enquadrou o mesmo fato como uma pergunta aberta sobre quanto valem os dados:
"Very interesting they have a way cheaper "contributor" version "used to improve our products", how much of that is price discrimination vs the data being that valuable? Roughly DeepSeek V4 Flash pricing, though you can get V4 from providers that don't train on your data"
O dado mais cortante para quem planeja usar o modelo fora do agente da própria Meta veio de um desenvolvedor que tentou exatamente isso:
"It's useless. Tried with OpenCode + OpenRouter and it couldn't complete an simple task. It stuck using grep/search tools. I think Muse Spark was so heavily RL'd on the Meta harness that it make it useless or very token inneficient to use in other harness like Opencode."
É a execução de uma pessoa e vai direto contra a afirmação da Meta de que treinou em vários harnesses para que o modelo "still generalizes to other coding agents you already use." Eu não trataria nenhuma das duas como resolvida. Trataria como a coisa específica a testar primeiro, com uma pequena execução paga nas suas próprias ferramentas, antes de mover um fluxo de trabalho para ele. O mesmo conselho vale para qualquer modelo específico de domínio ajustado a fundo a um único ambiente.
Outro comentarista mediu no OpenRouter uma vazão de cerca de 150 tokens por segundo, o que é rápido para essa classe. A API em si aceita requisições no formato OpenAI, então trocá-la é principalmente uma mudança de URL base, o mesmo tipo de migração coberto em APIs da OpenAI vs Anthropic.
E a linha de "acesso global ampliado" recebeu uma contradição direta de pelo menos um usuário, que relatou que o nível contributor ainda era só nos EUA. A redação da própria Meta é mais estreita que a manchete: o ID barato está "available in select countries", o que não é a mesma promessa de um modelo disponível globalmente.
Pesos abertos estão chegando, sem data
Quatro dias após o lançamento, o Chief AI Officer da Meta fez o anúncio que muita gente esperava havia três gerações de modelos:
"1/ big announcement today: we will be releasing an open weight version of muse spark 1.2 soon. we also are releasing muse glimmer, a 30B agentic model with open weights under apache 2.0. muse glimmer can run on 24GB of VRAM without losing agentic reliability. 🧵"
O Glimmer foi lançado. Os pesos do Spark 1.2 não, e "soon" não traz licença nem data. Eu planejaria com o que de fato dá para baixar hoje, que é o Glimmer de 30B sob Apache 2.0, e trataria o Spark de pesos abertos como uma boa surpresa se chegar. A Meta tem histórico de lançar primeiro o item vizinho: o mesmo padrão apareceu com o Muse Image.
Se pesos abertos são o motivo todo de você estar lendo isto, o Qwen3.8 Max é a alternativa séria disponível hoje. A comparação DeepSeek vs Kimi K3 é a que eu leria antes de escolher entre os outros dois.
Então, quem deve realmente usar o Muse Spark 1.2?
Onde ele cai, depois de uma semana com os números:
- Vale testar se você roda trabalhos agênticos longos com orçamento apertado. O salto no índice agêntico é real, o contexto é um 1M genuíno e, a $0,40 por tarefa na tarifa padrão, custa cerca de um sexto do Opus 5. O estudo de caso de otimização de kernel mostra o formato honesto: com mais de 1.000 chamadas de ferramentas e até 24 horas, o Muse Spark 1.2 chegou a +68,7% sobre a linha de base, quarto de seis, atrás do Opus 5 com +74,0%, do GPT-5.6 Sol com +71,2% e do Opus 4.8 com +69,6%. Leia a curva em vez do ponto final e ele também é mais lento na largada: ficou perto de 27% com 200 chamadas de ferramentas enquanto o Opus 5 já passava de 60%. Ele chega lá. Pega o caminho longo.
- Vale testar se o seu código não é sensível. O nível contributor tem preço de modelo de pesos abertos e a Meta diz exatamente com o que você está pagando. Para projetos pessoais, trabalho OSS e protótipos descartáveis, é um sim direto.
- Provavelmente não, se você precisa do topo da tabela. O Opus 5 lidera todos os gráficos que a Meta publicou, inclusive o interno da própria Meta. O GPT-5.6 Sol também está à frente no índice. Se o que falta é velocidade bruta e não inteligência, o Gemini 3.6 Flash é a resposta mais barata.
- Provavelmente não, ainda, se você está se comprometendo com um harness. Os melhores números de programação vêm do par com o Muse Code, o Muse Code está em beta e o único relato público de rodar o modelo em outro lugar foi ruim. Essa combinação pede um teste, não uma migração.
- Não por si só, se o trabalho é atendimento ao cliente. A queda de precisão junto com a queda de alucinação é exatamente a troca que importa a uma carga de suporte, e nenhum dos dois números dá para corrigir pela API. As escolhas que de fato se sustentam numa fila estão no meu resumo dos melhores agentes de IA, e o quadro de orçamento está em custo do atendimento ao cliente com IA.
Experimente a eesel
É nesse último ponto que quero terminar, porque é o erro que vejo as equipes cometerem todo trimestre. Um lançamento de modelo como este faz um projeto de automação de suporte parecer uma decisão de preço. Não é. Entre o muse-spark-1.2 e uma IA que consiga responder com segurança a um cliente real estão a recuperação sobre o seu próprio conteúdo, limites de confiança, regras de escalonamento e uma forma de saber o que ela fará antes de fazer. Essa é a diferença entre um agente de IA e um chatbot, e é onde o projeto realmente vive.
A eesel é essa camada. Ela se conecta ao helpdesk que você já usa, aprende com os seus próprios tickets resolvidos em vez de uma varredura genérica da web e simula primeiro sobre o seu histórico de tickets para que você veja a taxa de resolução e as respostas antes que um único cliente as veja. Esse passo de simulação existe porque já vi um bot com ar confiante dar respostas erradas em silêncio, e uma taxa de alucinação de 33% não é um número que você quer descobrir em produção.

Se você está avaliando modelos porque sua fila está se afogando, comece pela outra ponta. Rode uma simulação nos seus últimos milhares de tickets, veja o que realmente é desviado e só depois discuta tokens. Grátis para testar e sem cartão para começar.
Duas leituras a mais se você está no início dessa decisão. Meu artigo sobre o melhor LLM para suporte cobre bem a escolha do modelo. Para o caso de negócio, os números estão em custo de agente de IA vs agente humano.
Perguntas frequentes
Quanto custa o Meta Muse Spark 1.2?
muse-spark-1.2 custa $1,25 por milhão de tokens de entrada, $0,15 em cache e $4,25 de saída, idêntico ao preço do Muse Spark 1.1. O ID muse-spark-1.2-contributor custa $0,10 de entrada, $0,002 em cache e $0,20 de saída, e a página do modelo da Meta informa que o tráfego é usado para melhorar seus produtos. Tokens de raciocínio são cobrados pela tarifa de saída em ambos.