

Resumo
O Muse Spark Open é o primeiro modelo Muse de pesos abertos da Meta, lançado em 15 de outubro de 2026. Tem 816B de parâmetros com 42B ativos por token, aceita texto, imagens, vídeo e áudio, comporta 1M de tokens de contexto e compartilha o modelo base com o Muse Spark 1.3 fechado. Você pode baixá-lo no Hugging Face ou alugá-lo de sete provedores.
Eis o que a cobertura do lançamento deixa de fora. Hospedado, ele custa $1,25 de entrada e $4,25 de saída por milhão de tokens, exatamente a tarifa que a Meta cobra pelo Muse Spark 1.3 fechado. Na tabela da própria Meta, ele marca 39 no Artificial Analysis Index, atrás do GLM 5.3 (45) e do Kimi K3 (44). Ou seja, pesos abertos aqui não compram um modelo mais barato nem mais inteligente. Compram controle: onde o modelo roda, quem vê o tráfego e se você pode ajustá-lo. Ele também registra a menor taxa de jailbreak da comparação, com folga.
Eu construo os agentes de IA da eesel, e essa pergunta sobre controle é a que mais ouço. Uma equipe B2B de telemática que usa Zendesk interrompeu uma demo uma vez para perguntar se tickets com números de cartão e senhas ficariam dentro do ambiente deles. O Muse Spark Open é o primeiro modelo Muse para o qual a resposta honesta pode ser "sim, rode você mesmo." Mas um modelo hospedado por conta própria continua sendo um modelo, não um colega de equipe. Se o que você quer é um colega de helpdesk com IA que já conhece a sua central de ajuda, essa é a camada que a eesel vende.
O que a Meta realmente lançou em 15 de outubro
O blog de pesquisa da Meta chama o Muse Spark Open de "o modelo de pesos abertos mais capaz dos EUA até hoje", feito para programação e trabalho com agentes. O post da equipe do PyTorch acrescenta o detalhe mais importante: ele "compartilha o mesmo modelo base do Muse Spark 1.3", com pós-treinamento extra de segurança para que se sustente "como um modelo independente, sem proteções no nível do sistema." É uma grande mudança para uma empresa que passou boa parte de 2026 mantendo o Muse Spark fechado.
O model card no Hugging Face lista as especificações:
| Especificação | Muse Spark Open |
|---|---|
| Data de lançamento | 15 de outubro de 2026 |
| Parâmetros | 816B no total, 42B ativos por token |
| Arquitetura | Mistura de especialistas, 256 especialistas, 8 ativos por token, 62 camadas |
| Contexto | 1M de tokens na inferência |
| Entrada / saída | Entrada de texto, imagem, vídeo e áudio; saída de texto |
| Idiomas | Treinado com dados de mais de 100 idiomas |
| Esforço de raciocínio | low, medium, high, xhigh (padrão xhigh) |
| Pesos | BF16 e NVFP4 |
| Licença | Muse Model License |
O lançamento foi barulhento. A discussão no Hacker News chegou a 914 pontos e 477 comentários no primeiro dia, e o post de pesquisa em ML da própria Apple sobre rodá-lo em Mac Studios rendeu mais 363 pontos.
Como funcionam 42B ativos de 816B
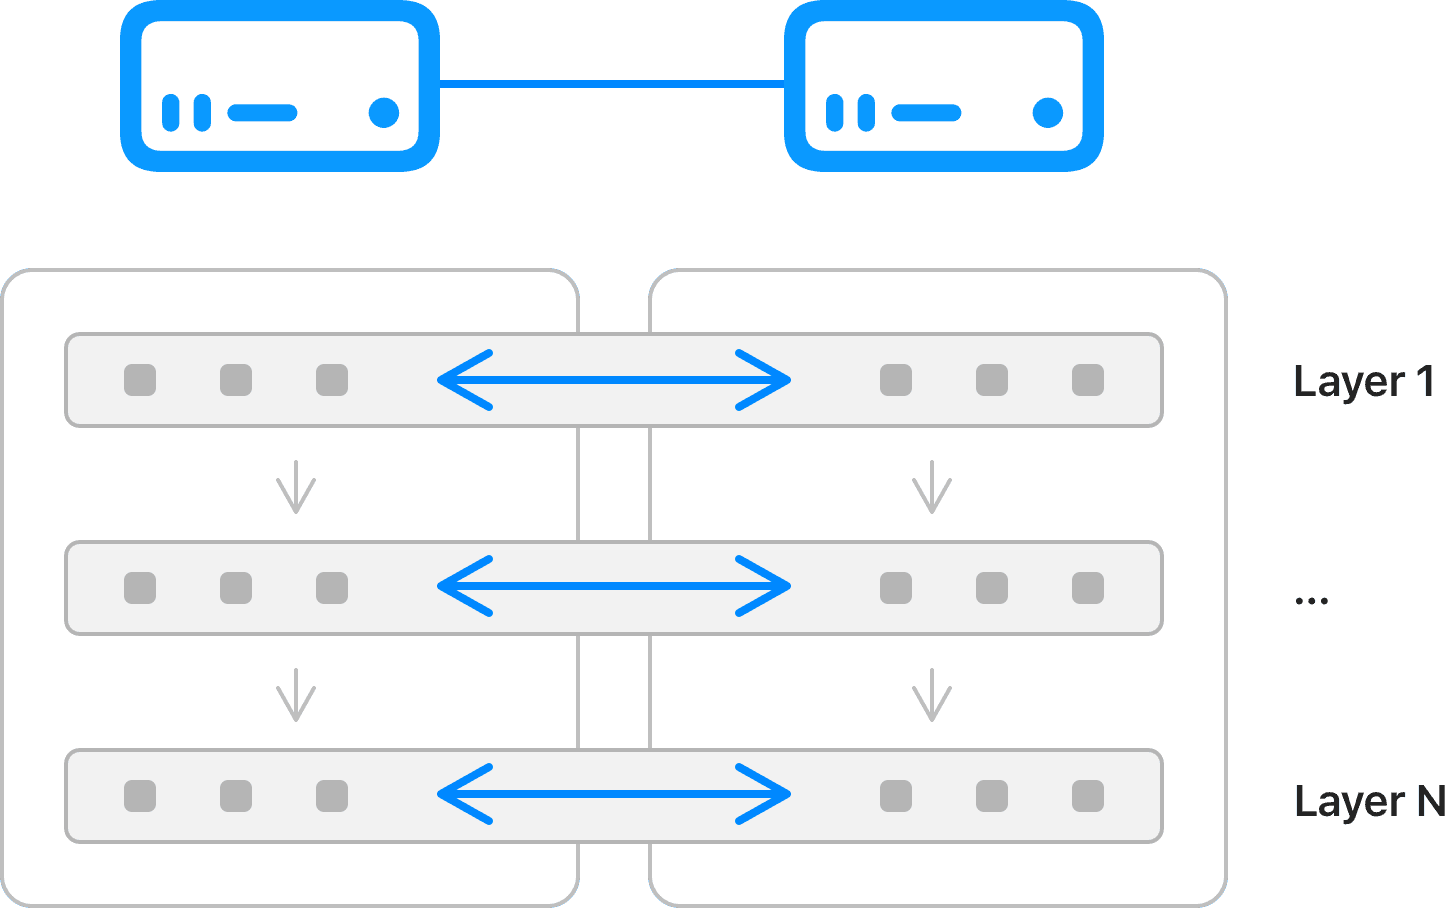
Esta é a parte que acho mais interessante, porque explica tanto a questão do hardware quanto a do preço. O Muse Spark Open é um modelo de mistura de especialistas. Cada camada tem 256 pequenas redes de especialistas, e um roteador escolhe 8 delas para cada token. Assim, o modelo armazena 816B de parâmetros, mas cada token passa por apenas cerca de 42B deles.
Essa divisão tem duas consequências que as pessoas confundem:
- A memória é definida pelos 816B. Todos os especialistas precisam estar na memória, porque qualquer token pode precisar de qualquer especialista. Por isso os pesos em BF16 ocupam cerca de 1,6TB.
- A velocidade é definida pelos 42B. Cada token lê apenas a sua fatia, então a geração fica mais próxima do ritmo de um modelo de 42B. A Apple diz sem rodeios: a largura de banda de 1,2 TB/s do M5 Ultra "é rápida o bastante para ler a pequena fatia de que cada token precisa."
O post de desenvolvedores da Meta diz que o checkpoint NVFP4 quantiza apenas os especialistas, o que o leva a cerca de 530GB. Ainda é grande demais para qualquer desktop individual, então Meta e Apple o dividem entre duas máquinas com paralelismo de tensores: cada Mac guarda metade de cada camada e faz metade do cálculo de cada token.
O model card também descreve um codificador de percepção separado, de 1,8B de parâmetros, para imagens e vídeo. Na prática, isso significa que você não precisa acoplar um modelo de visão ao lado. Um único checkpoint lê capturas de tela, gravações e documentos, o que importa se você está construindo agentes que usam um computador e não apenas uma caixa de chat.
Preço do Muse Spark Open: o mesmo cartão do modelo fechado
Os pesos são gratuitos. O número interessante é quanto custa alugar. A Meta não serve o Muse Spark Open na própria API; a página de preços lista apenas o Muse Wonder e os modelos Spark fechados. Em vez disso, sete parceiros o hospedam, e os que têm tarifas públicas chegaram todos à mesma tabela.
| Onde | Entrada / 1M | Cache / 1M | Saída / 1M | Observações |
|---|---|---|---|---|
| OpenRouter | $1,25 | $0,15 | $4,25 | Roteia entre Modal, Together, Nebius, Fireworks, Baseten; saída máxima de 262.144 |
| Fireworks AI | $1,25 | $0,15 | $4,25 | Treinamento LoRA serverless via API |
| Baseten | $1,25 | $0,15 | $4,25 | NVFP4 com um rascunhador especulativo |
| Groq | Não público | Não público | Não público | Prévia limitada, contexto de 131K |
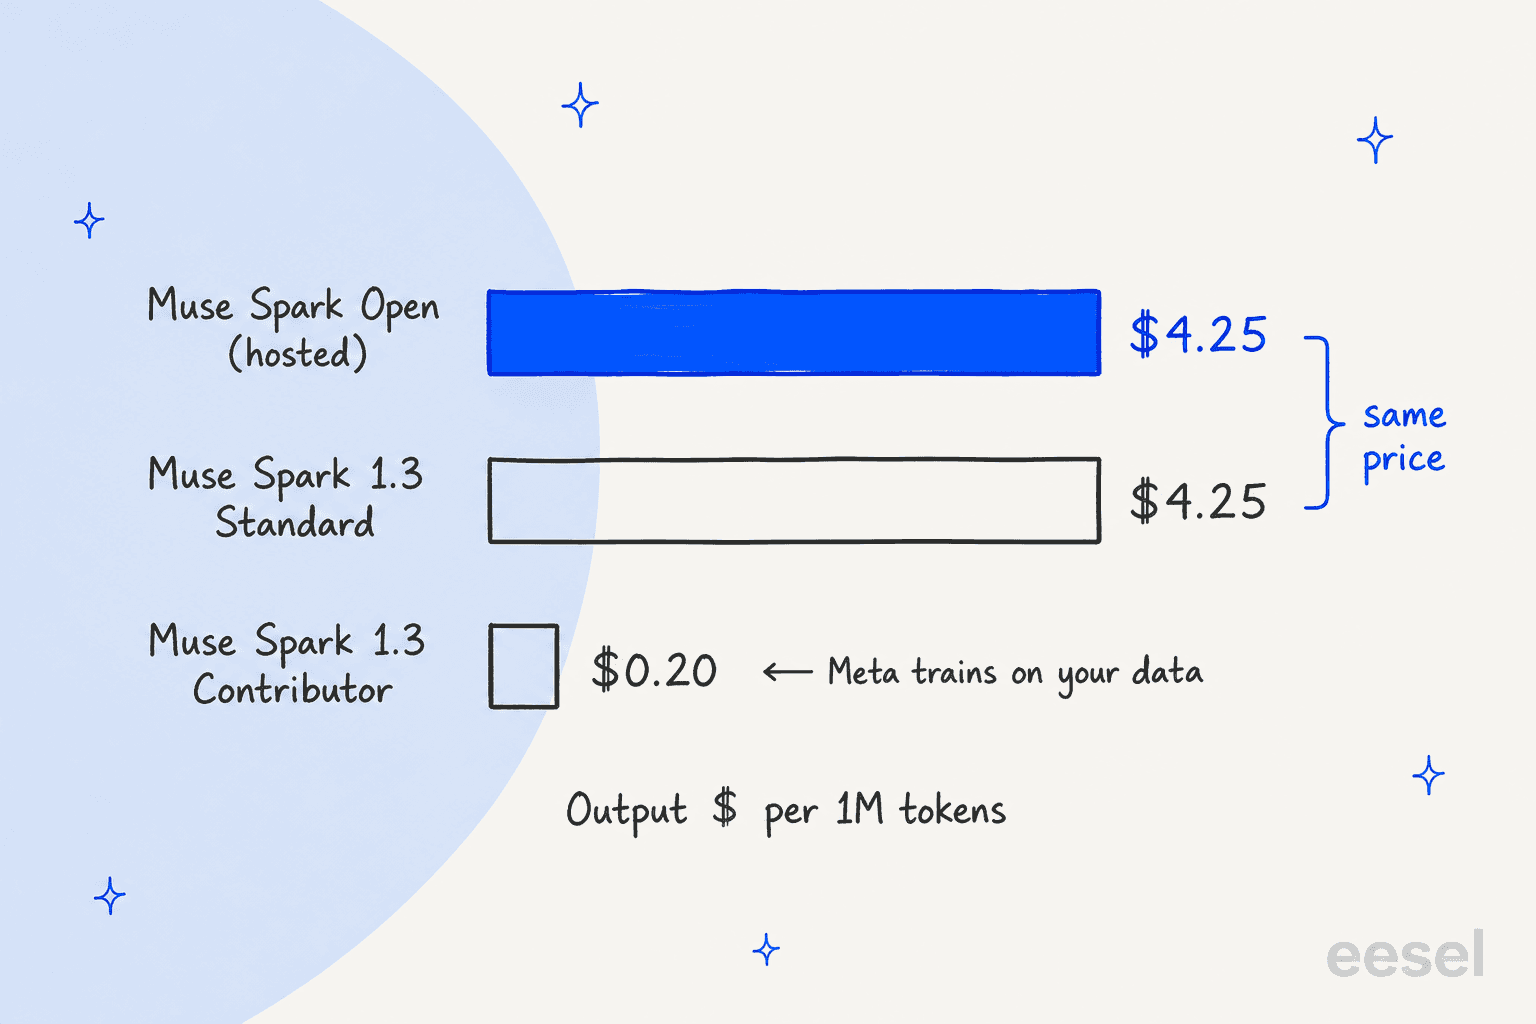
| API da Meta: Muse Spark 1.3 Standard | $1,25 | $0,15 | $4,25 | Fechado, preços da Meta |
| API da Meta: Muse Spark 1.3 Contributor | $0,10 | $0,002 | $0,20 | Fechado, a Meta treina com seus dados |
O modelo aberto é alugado exatamente pelo que o fechado custa. E o token mais barato da Meta continua sendo o plano contributor fechado, a cerca de um vigésimo do preço de saída, em troca de deixar a Meta treinar com o seu tráfego. Se você calculou o preço do Muse Spark Open esperando o desconto habitual dos pesos abertos, ele ainda não existe. Meu post sobre preços do Muse Spark 1.3 explica como funciona esse acordo de dois níveis.
Duas coisas suavizam isso. O cache é agressivo: o OpenRouter informa um preço médio ponderado de entrada de cerca de $0,35 por milhão no tráfego real, porque as taxas de acerto de cache passam de 70% na maioria dos provedores. E a Artificial Analysis constatou que o modelo é bastante conciso, usando 110M de tokens de saída para concluir seu índice contra uma mediana de 130M, a cerca de $0,84 por tarefa.
Um comentarista do Hacker News interpretou o preço único como efeito colateral do licenciamento:
"The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

É uma leitura justa da licença, que abordo mais abaixo. Se os provedores começarão a baixar preços uns dos outros em algumas semanas é o que eu acompanharia. Para ver como outros provedores precificam modelos abertos, veja preços da Together AI e preços da Fireworks AI.
A promessa do Mac Studio e a pegadinha
A manchete da Meta é que o Muse Spark Open é "o primeiro modelo da sua classe a rodar no seu desktop usando dois Mac Studios Apple M5 Ultra." É verdade, e a Apple publicou os números. Nas tabelas de benchmark dela, com contexto de 8.192 tokens:
| Configuração | Tempo até o primeiro token | Velocidade de decodificação |
|---|---|---|
| 2 Mac Studios, paralelismo de pipeline | 8,4s | 15,74 tok/s |
| 2 Mac Studios, paralelismo de tensores | 8,2s | 24,99 tok/s |
| 4 Mac Studios, paralelismo de tensores | 4,8s | 36,73 tok/s |
Vinte e cinco tokens por segundo é utilizável para um agente de programação trabalhando em segundo plano. A Meta diz que entregou correções reais de iOS para o cliente Mastodon Ice Cubes e conduziu o DaVinci Resolve de ponta a ponta assim, tudo no próprio dispositivo pelo Muse Code.
Agora a pegadinha. A configuração com dois Macs exige 512GB de memória por máquina, e a própria loja da Apple lista a opção de 512GB do M5 Ultra como "chegando no fim de outubro". Hoje não dá para pedir. A página de Mac Studio na loja começa as configurações M5 Ultra em $5.499 com 96GB de memória, antes de qualquer upgrade. O post de desenvolvedores da Meta oferece um caminho com quatro Macs de 256GB cada, que chega ao mesmo 1TB de memória agregada.
Se você não tem hardware Apple, esta é a escada completa do que é preciso:
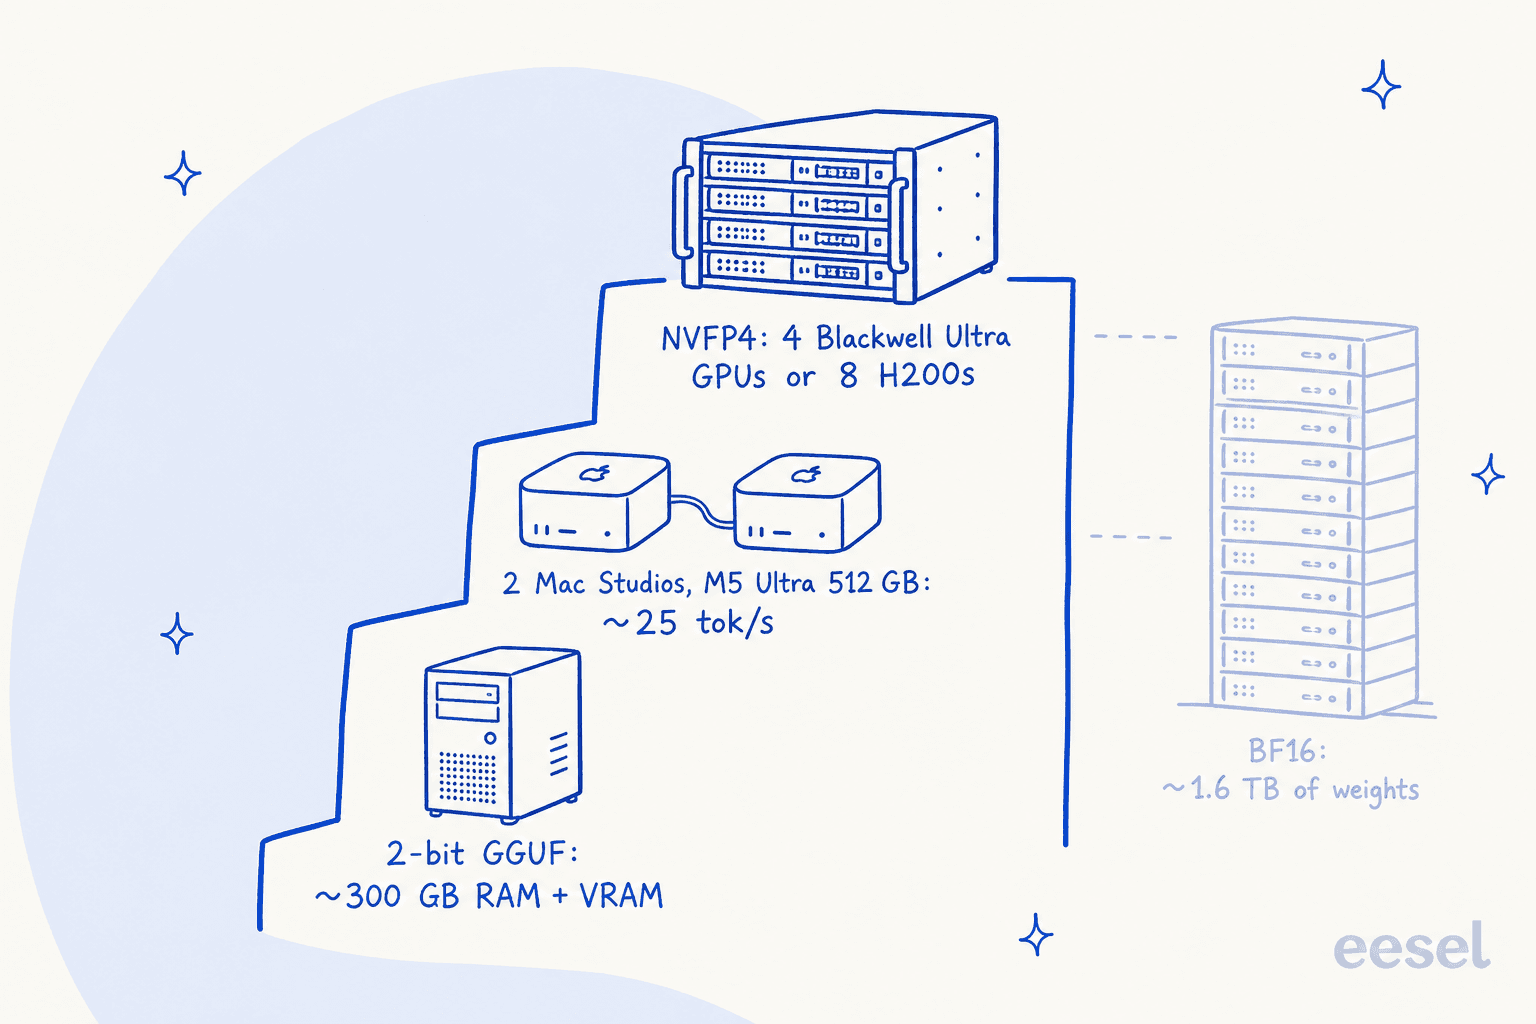
- GPUs de datacenter. O model card pede pelo menos 700GB de memória de GPU para NVFP4 e 2TB para BF16. O post de desenvolvedores da Meta diz que o NVFP4 roda em quatro GPUs Blackwell Ultra ou oito H200, via SGLang, vLLM ou TensorRT-LLM.
- Uma workstation grande. O GGUF dinâmico de 2 bits da Unsloth cabe em cerca de 300GB de RAM do sistema e VRAM combinadas, rodando via llama.cpp. Espere perda de qualidade com essa compressão; o próprio model card avisa que versões quantizadas podem diferir em casos extremos.
- Catálogos de nuvem. Amazon SageMaker AI, Google Cloud Model Garden e Microsoft Foundry Models oferecem os pesos se você quiser uma instância privada na sua própria conta de nuvem.
O resumo mais honesto veio de um comentarista que leu o guia da Unsloth: "You & Me won't be running this one" (spwa4, Hacker News). Para a maioria das equipes, "aberto" vai significar alugar de um provedor ou rodar na própria nuvem por motivos de dados.
Como o Muse Spark Open se sai nos benchmarks contra outros modelos abertos
A Meta comparou o Muse Spark Open com sete pares de pesos abertos, incluindo Kimi K3, Mistral Large 4, Inkling e o Beam da Reflection. Rodou o próprio modelo com esforço xhigh. Esta é a tabela publicada:
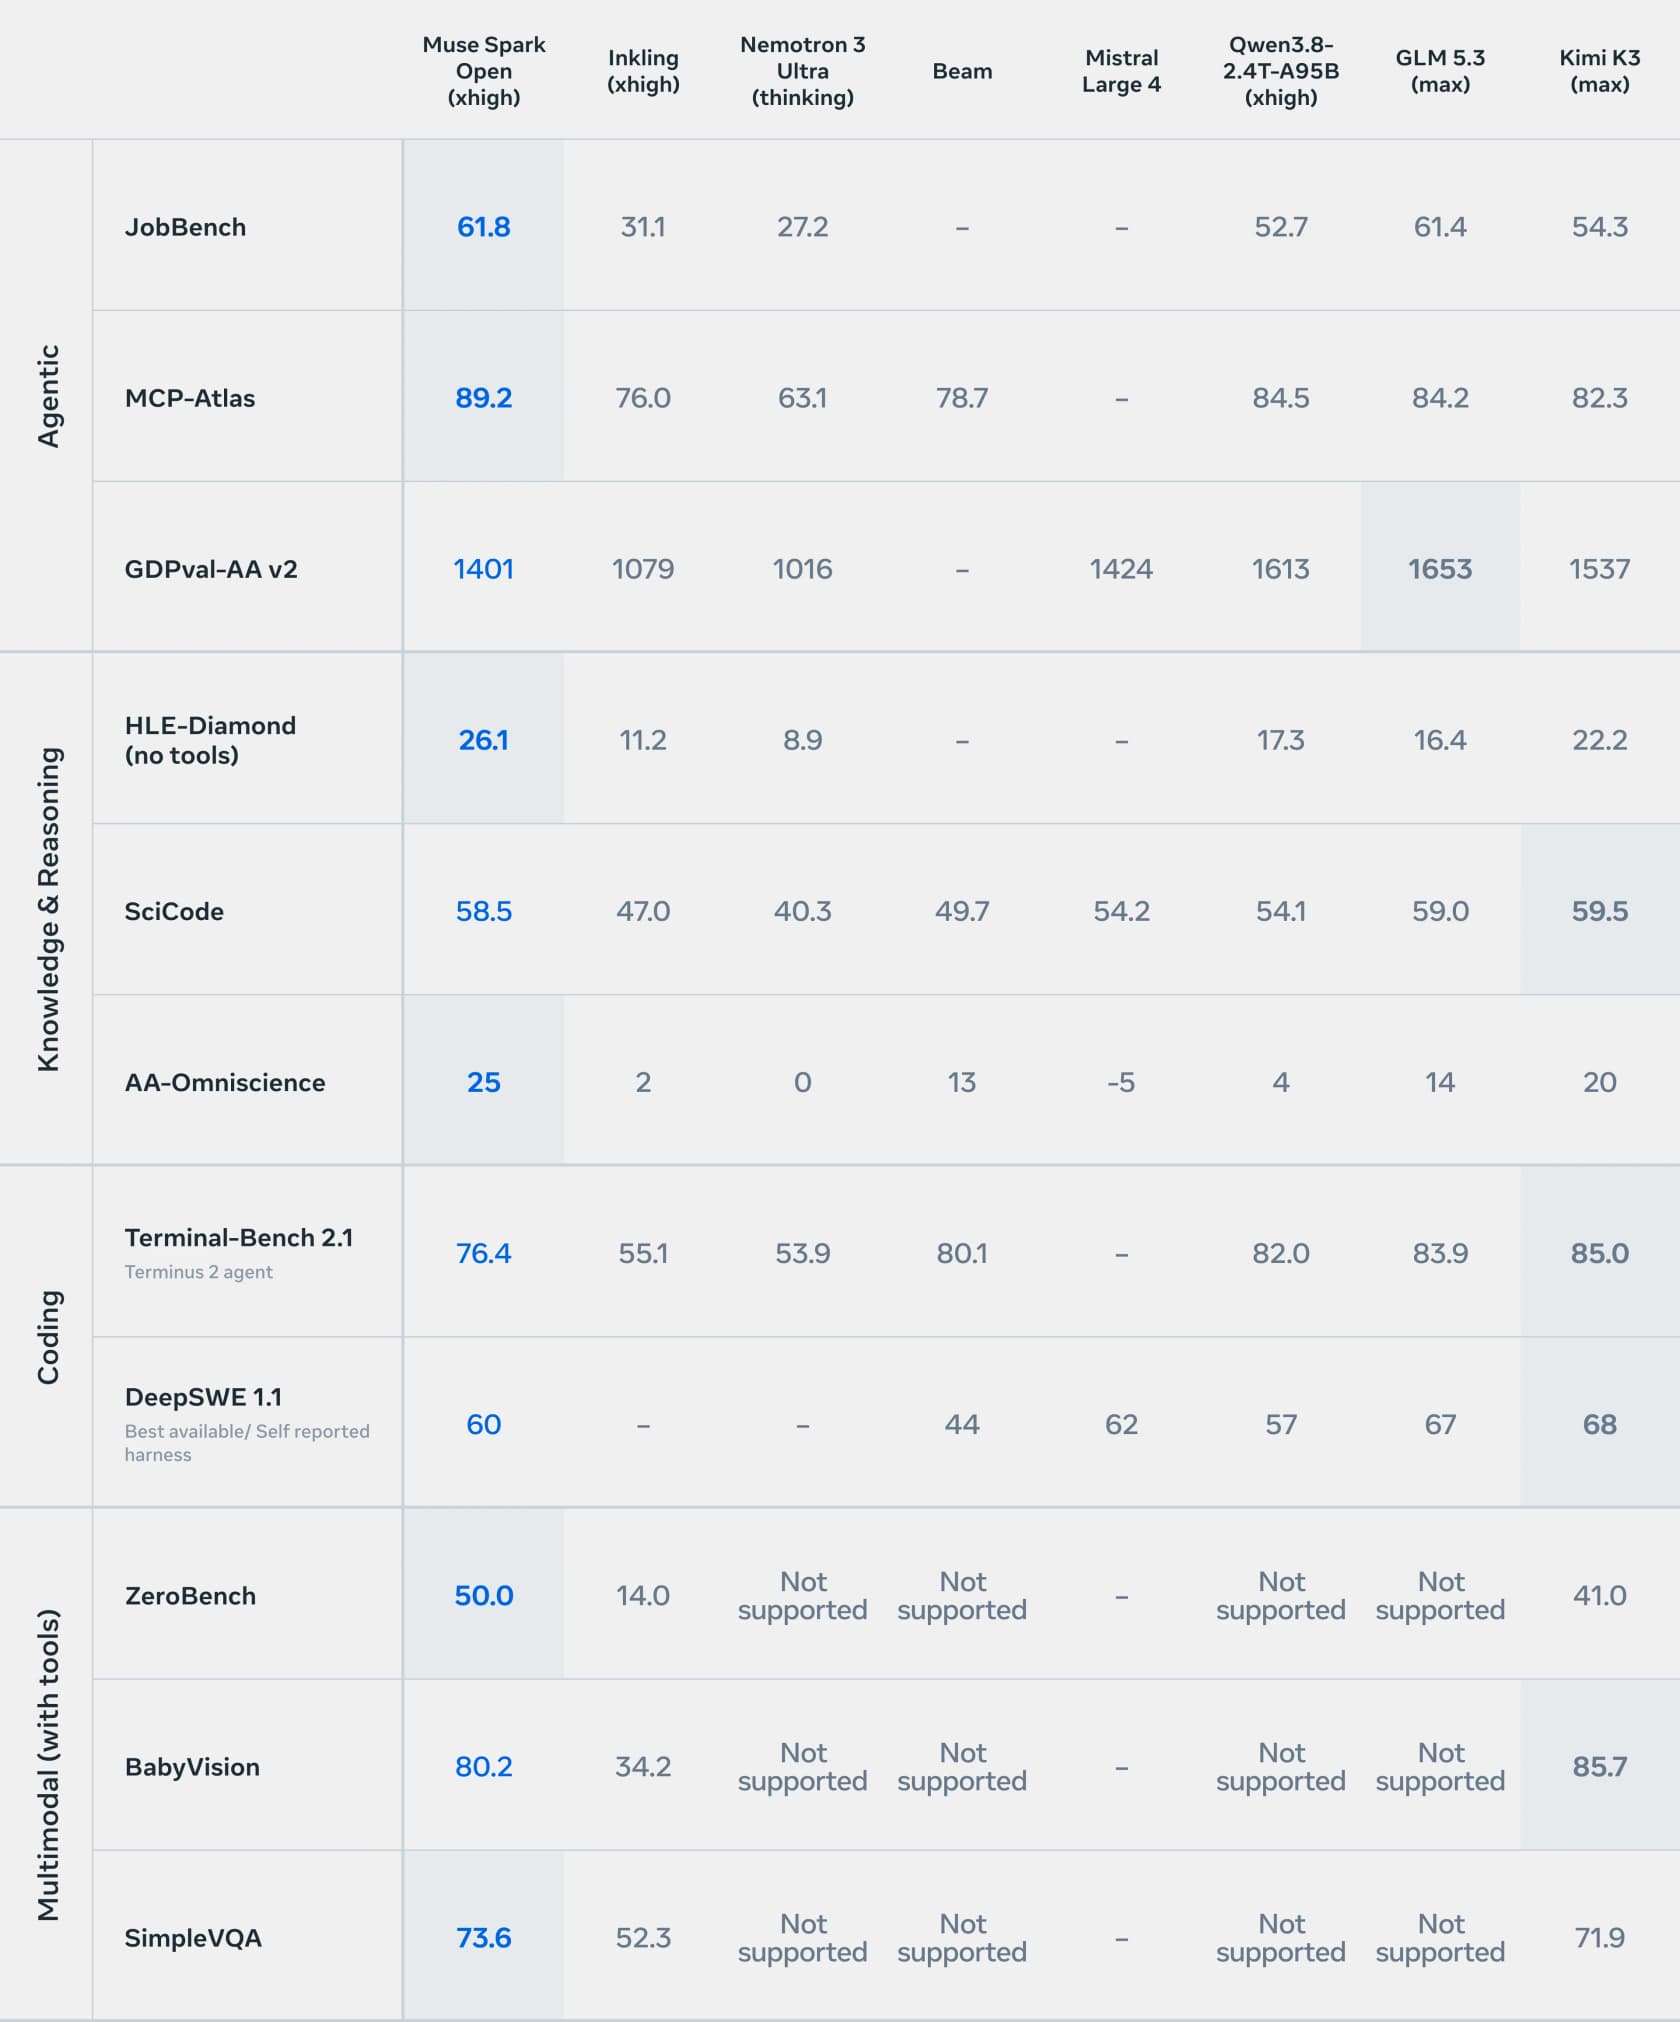
Lendo linha por linha, surge um padrão claro:
- Onde lidera: uso de ferramentas e tarefas de agentes (MCP-Atlas 89,2, JobBench 61,8), conhecimento sem ferramentas (HLE-Diamond 26,1, AA-Omniscience 25) e vários testes multimodais (ZeroBench 50,0, SimpleVQA 73,6).
- Onde fica atrás: o índice geral e a programação. No Artificial Analysis Index ele marca 39, atrás do GLM 5.3 (45), do Kimi K3 (44) e do Qwen3.8 (40). No Terminal-Bench 2.1 faz 76,4 contra 85,0 do Kimi K3; no DeepSWE, 60 contra 68.
- Onde está em outra liga: segurança. No StrongREJECT, um teste adaptativo de jailbreak em que menor é melhor, ele marca 0,5. Todos os outros modelos testados pela Meta ficam entre 62,9 e 86,4.
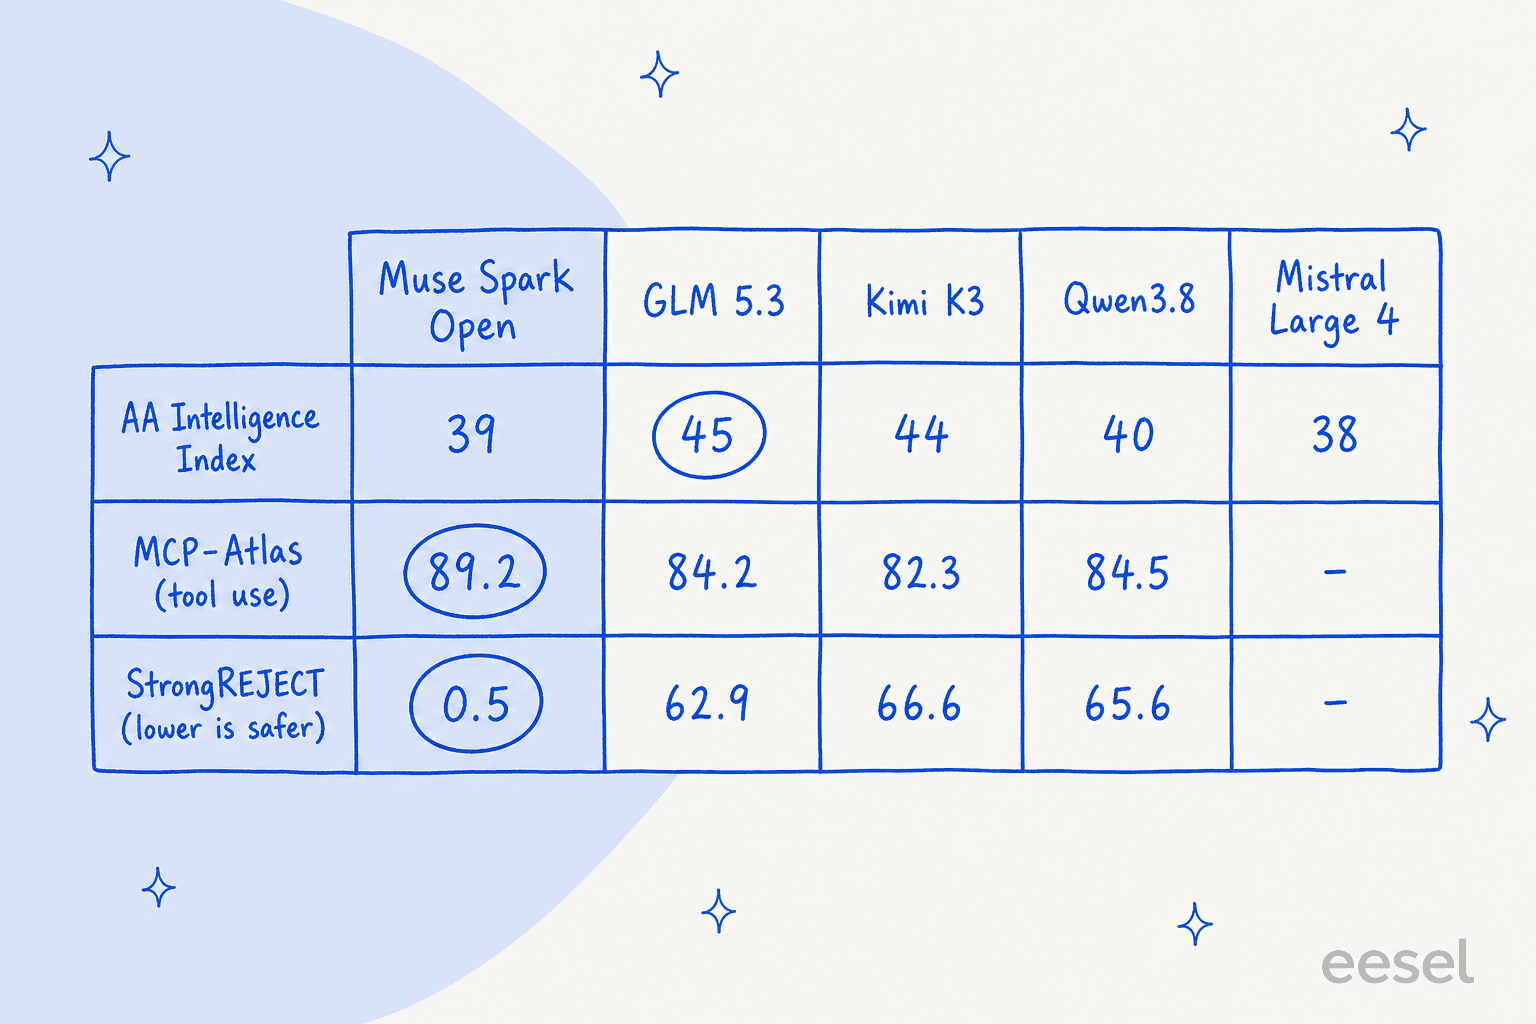
O número independente bate com o da Meta. A Artificial Analysis lista o Muse Spark Open com 39 no seu índice, bem acima da mediana de 19 de modelos comparáveis, a 131 tokens por segundo. O Hacker News colocou isso em contexto rapidamente:
"39 on AA, about the same as Deepseek v4.1 flash and Mimo 2.5 Flash. Behind Glm 5.3 flash and Qwen3.8-Flash-Next"
Essa comparação dói, porque o DeepSeek V4.1 Flash e o GLM 5.3 Flash são modelos bem menores. Os relatos práticos até agora concordam com o padrão: um testador o achou "dumber than GLM 5.3" mas "really fast" na Fireworks (eknkc, Hacker News), e outro o colocou "closer to 1.2" do que do 1.3 nos benchmarks (modeless, Hacker News). A Meta não publicou uma comparação direta com seus próprios modelos fechados, então trate este último como uma impressão inicial.
Minha leitura: é um modelo de chamada de ferramentas e de ciclos de agente em primeiro lugar, com forte comportamento de segurança, e não o melhor programador aberto. Os primeiros usuários citados no post de desenvolvedores da Meta dizem o mesmo, elogiando-o por escolher "the right next tool" e pelas saídas estruturadas limpas em chamadas em várias etapas e em paralelo. Se o seu agente vive chamando ferramentas, a liderança no MCP-Atlas pesa mais que a diferença no índice. Se ele vive escrevendo código, o Kimi K3 é a escolha aberta mais forte com base nesses números.
A licença: gratuita, com três condições
A Meta lançou os pesos sob a Muse Model License, que ela descreve como tendo "limited commercial terms". Parece uma licença permissiva com condições anexadas. Você pode usar, copiar, modificar, ajustar, destilar, mesclar, publicar e vender, de graça, sujeito a:
- A política de uso. Uma longa lista de usos proibidos, de armas e infraestrutura crítica a avaliações falsas e afirmar que as saídas foram escritas por humanos. Ela também diz que o modelo não é destinado a menores de 18 anos.
- Atribuição. Você deve exibir de forma destacada ("prominently display") as palavras "Built with Muse Spark Open" na interface do produto, na documentação, no site ou no menu de configurações. Isso vale também para qualquer modelo que você treine ou destile a partir das saídas dele.
- A cláusula de serviço de $20M. Se você vende acesso a modelos de IA como serviço via API e o seu grupo empresarial fatura mais de $20 milhões em um período de 12 meses, deve notificar a Meta e assinar um acordo separado antes.
A terceira cláusula parece assustadora e, na maior parte, não é. Ela exclui explicitamente o uso interno, a pesquisa e o uso do modelo para alimentar funcionalidades do seu próprio produto. Uma empresa de SaaS que roda o Muse Spark Open por trás da caixa de entrada de suporte não deve nada à Meta além da linha de atribuição. A cláusula mira provedores de inferência e grandes plataformas que revendem o modelo.
Mais um obstáculo prático: baixar do Hugging Face exige um formulário com acesso restrito pedindo seu nome legal completo, data de nascimento e o nome completo da organização com identificadores corporativos. A Meta também não reivindica propriedade sobre as saídas, a cláusula que o seu jurídico vai procurar primeiro.
Uso internamente, para pesquisa, ou para alimentar funcionalidades dentro do meu próprio produto
Gratuito. Sem acordo separado, mesmo acima de $20M de faturamento. Você ainda precisa seguir a política de uso e exibir "Built with Muse Spark Open" em algum lugar que os usuários encontrem: a interface, a documentação, o site ou um menu de configurações.
Vendo acesso via API a modelos de IA, e o meu grupo empresarial fatura menos de $20M por ano
Gratuito por enquanto, com as mesmas regras de atribuição e de uso. Acompanhe o faturamento: o teste vale para quaisquer 12 meses consecutivos, somando você e suas afiliadas.
Vendo acesso via API a modelos de IA, e o meu grupo empresarial fatura mais de $20M por ano
Você deve notificar a Meta e assinar um acordo escrito separado antes de oferecer o Muse Spark Open, ou qualquer coisa derivada dele, nesse serviço. Os termos não são públicos.
Ajustei ou destilei um novo modelo a partir dele
Isso conta como um Derivative. A linha de atribuição e a política de uso o acompanham, e a cláusula de serviço de $20M também, se você revender acesso a ele.
Resumido a partir da Muse Model License de 15 de outubro de 2026. Não é aconselhamento jurídico; leia o texto completo no Hugging Face antes de lançar.
Ele é "aberto"? Muitos comentaristas do Hacker News disseram que não, porque a licença não é aprovada pela OSI e só os pesos são entregues, sem dados de treinamento nem código. Eu o chamaria de pesos abertos com um teto comercial, e para a maioria das empresas esse teto está muito acima de qualquer coisa que vão atingir. Se você quer blocos de construção totalmente de código aberto, meu levantamento de agentes de IA de código aberto é um ponto de partida melhor.
Segurança: a parte mais forte do lançamento
Foi aqui que a Meta mais trabalhou, e isso aparece. O model card informa, sem salvaguardas no nível do sistema:
- Uso indevido em cibersegurança: recusou 99,2% dos jailbreaks no benchmark interno da Meta e 94,8% em PolyGuard, RedCode e CyberBench 2024. O Kimi K3 recusou 75,5% e 70,2% na mesma configuração.
- Química e biologia: mais de 98% de recusas no BioTIER da SecureBio, mais de 97% no teste agêntico de biologia em vários turnos da Meta.
- Honestidade: taxa de honestidade de 98,1% no benchmark MASK e 0% de mau comportamento no benchmark Agentic Misalignment.
Há um trade-off escondido na própria tabela da Meta. No teste FORTRESS, o Muse Spark Open tem a menor pontuação de risco adversarial (5,8), mas a maior pontuação de recusa excessiva (17,4) do grupo, ou seja, recusa mais pedidos inofensivos que o GLM 5.3 (3,2) ou o Kimi K3 (2,7). Para um bot voltado ao cliente, algumas respostas extras de "não posso ajudar com isso" são um custo real. Teste com o seu próprio tráfego antes de confiar nos padrões.
Duas ressalvas da própria Meta. O relatório completo de avaliação ainda está "disponível em breve". E o model card avisa que "downstream modifications could degrade safety", então, no momento em que você ajusta o modelo, esses números deixam de ser seus. O conselho da própria Meta é implantá-lo dentro de um sistema com proteções adicionais e "human-in-the-loop confirmation for irreversible actions", que é o mesmo que eu diria a qualquer pessoa que coloque um modelo atrás de uma fila de suporte.
Ajuste fino desde o primeiro dia
Esta é a outra coisa que os pesos abertos realmente destravam. A Meta alinhou suporte de pós-treinamento em toda a linha no lançamento, segundo o post de desenvolvedores:
- PyTorch TorchTitan: pré-treinamento, SFT em vários turnos, LoRA e aprendizado por reforço.
- Hugging Face TRL: LoRA com SFTTrainer sobre o checkpoint liberado.
- Fireworks AI: treinamento LoRA serverless por API, com sequências de até 262.144 tokens. A página do modelo observa que o ajuste fino gerenciado na interface ainda não está disponível para este modelo.
- Together AI: SFT ou aprendizado por reforço GRPO no serviço de pós-treinamento dela, depois servir vários adaptadores LoRA em uma única implantação.
- NVIDIA NeMo AutoModel e o Miles da RadixArk para trabalho com todos os parâmetros.
Para uma equipe de suporte, o ajuste fino parece atraente: ensinar o seu tom, os nomes dos produtos, as regras de reembolso. Na minha experiência, raramente é a primeira correção. A maioria das respostas erradas que vejo vem de uma central de ajuda desatualizada ou contraditória, não de um modelo que precisa ser retreinado, e a recuperação resolve isso mais rápido. Meu texto sobre RAG vs LLM explica por quê. Ajuste o modelo depois que a recuperação estiver sólida e você ainda vir problemas de estilo ou formato.
Quem deve realmente usar o Muse Spark Open?
Assim eu decidiria:
- Você precisa do modelo dentro das suas próprias paredes. Dados regulados, uma revisão de segurança que bloqueia processadores de terceiros, ou um contrato de cliente que diz "sem IA externa". Este é o caso mais forte, e os números de segurança facilitam defendê-lo.
- Você está construindo agentes que usam muitas ferramentas. As lideranças em MCP-Atlas e JobBench são reais. Combine-o com um servidor MCP e veja como ele lida com o seu conjunto de ferramentas.
- Você quer ajustar um modelo multimodal grande. Ele aceita áudio e vídeo nativamente, e a pilha de treinamento estava pronta no dia do lançamento.
- Você quer os tokens mais baratos da Meta. Pule. O preço contributor do Muse Spark 1.3 fechado é muito mais barato, se você aceitar que a Meta treine com esse tráfego.
- Você quer o melhor programador aberto. Olhe primeiro o Kimi K3 ou o Qwen, ou suba para modelos fechados de fronteira como o Claude Opus 5.5 e o mais novo Muse Wonder.
Para suporte ao cliente especificamente, a escolha do modelo é a decisão menor. Meu guia de modelos para suporte explica por que recuperação, escalonamento e testes movem mais a qualidade da resolução do que alguns pontos de índice. Uma diferença de 6 pontos no índice raramente aparece na fila. Uma resposta confiante vinda de um artigo desatualizado aparece todos os dias, com pesos abertos ou não.
Experimente a eesel
O Muse Spark Open é infraestrutura. Você recebe pesos, uma licença e uma conta de hardware, e depois constrói por conta própria a recuperação, as regras de escalonamento, os testes e a trilha de auditoria. A eesel é o funcionário. Nosso colega de helpdesk com IA se conecta ao Zendesk, Freshdesk, Gorgias e aos demais, aprende com seus tickets antigos e sua central de ajuda, e você pode rodá-lo contra centenas dos seus tickets históricos antes que ele responda a um único cliente. Essa repetição é onde você pega a resposta excessivamente confiante antes do cliente, seja qual for o modelo por baixo.
Se você prefere gerenciar pelo terminal, como faria com um modelo hospedado por conta própria, a CLI da eesel dá conta. eesel instructions lê e edita as regras permanentes do colega, eesel approvals lista ações esperando um humano e eesel activity mostra cada execução e por que ela fez o que fez. Todos os comandos imprimem JSON e as escritas aceitam --dry-run, então um agente de programação como o Claude Code pode gerenciar o seu colega de suporte do mesmo jeito que gerencia o seu repositório. Se você escreve conteúdo em vez de responder tickets, o mesmo time tem um redator de blog com IA.

É grátis para começar, com 100 créditos e sem cartão. Experimente a eesel nos tickets do mês passado e veja o que ela teria respondido, antes de orçar um único Mac Studio. Os planos estão na página de preços.