

O que é o Mistral Large 4?
Eu construo agentes de IA para viver na eesel, então todo lançamento de fronteira chega à minha mesa com a mesma pergunta: se os agentes da eesel deveriam rodar nele. Com o Mistral Large 4, a resposta honesta é "ainda não, mas fique de olho", e os motivos são mais interessantes do que o gráfico de benchmarks sugere.
A Mistral o chama de seu "largest and most capable model to date". Segundo o post de lançamento, ele foi treinado em 3,800 GPUs NVIDIA Grace Blackwell nos próprios data centers europeus da Mistral, e é também o primeiro marco do roadmap financiado pela Série D de €3 bilhões da Mistral. Se você precisa relembrar quem é a empresa, minha visão geral da Mistral AI cobre a história, e o apanhado de avaliações da Mistral AI mostra o que os usuários acham dos modelos antigos.
Estas são as especificações que importam, direto da ficha do modelo na documentação:
| Especificação | Mistral Large 4 |
|---|---|
| Lançamento | 6 de outubro de 2026, prévia pública (v26.10) |
| Arquitetura | Mistura de especialistas granular, híbrido de instrução e raciocínio |
| Parâmetros | 1.05T no total, 52B ativos, mais um codificador de visão de 1.6B |
| Janela de contexto | 1M de tokens |
| Entrada | Texto e imagens |
| ID do modelo na API | mistral-large-4 |
| Recursos | Function calling, saídas estruturadas, document QnA, batching, Agents API, ferramentas integradas |
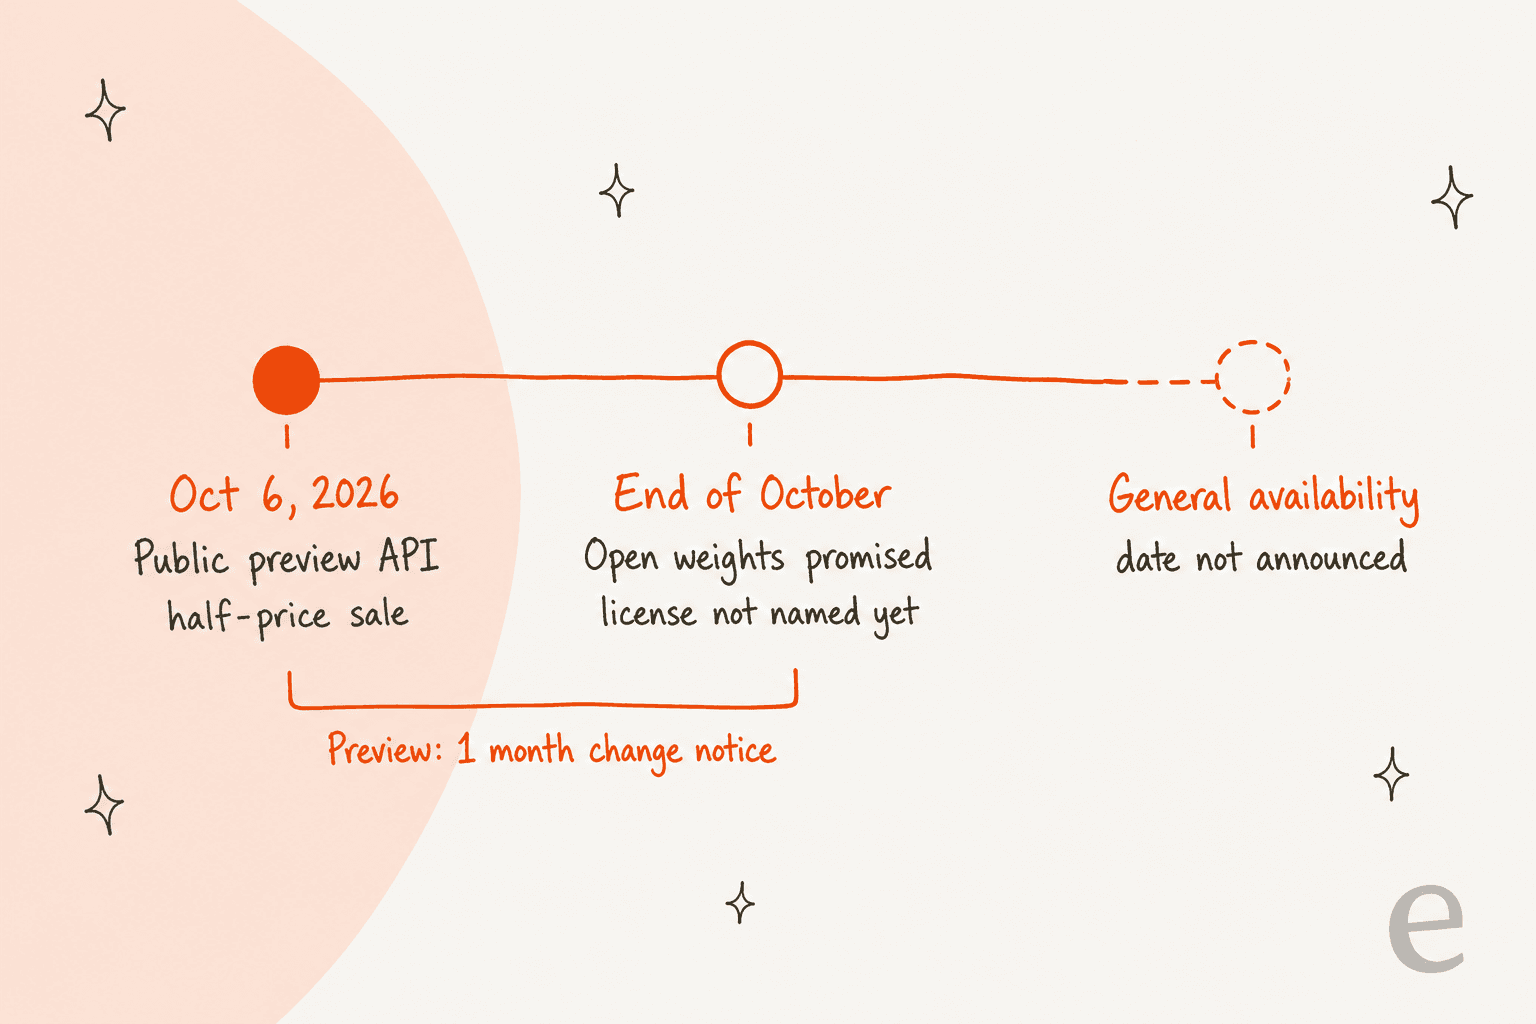
| Pesos | Prometidos até o fim de outubro de 2026, licença ainda não definida |
| Idiomas de treinamento | Mais de 160, incluindo todos os idiomas oficiais da UE |
Há um pequeno detalhe nos números: a ficha da documentação diz 52B de parâmetros ativos, enquanto o próprio post de lançamento no X da Mistral diz 49B. O Artificial Analysis também lista a janela de contexto em 524,288 tokens, metade do 1M da ficha, então eu planejaria com o número menor até a Mistral esclarecer.
Como o Mistral Large 4 funciona por dentro
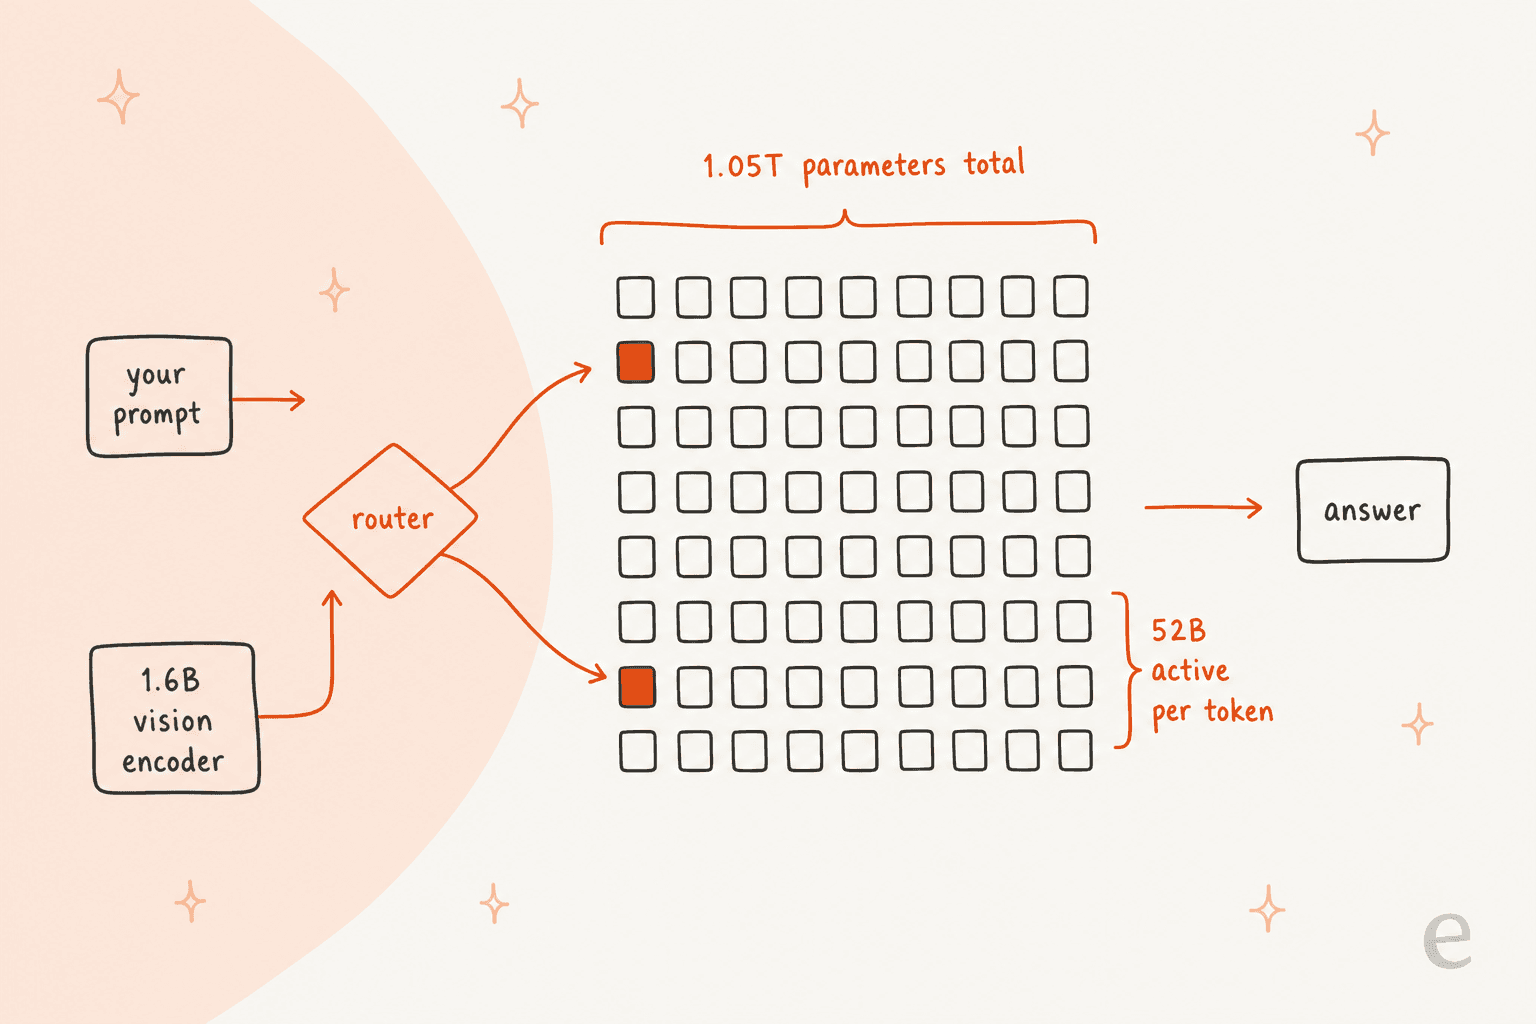
O número de destaque, 1.05T de parâmetros, engana um pouco se visto sozinho. O Mistral Large 4 é um modelo de mistura de especialistas: um roteador escolhe uma pequena fatia da rede para cada token, de modo que só cerca de 5% dos pesos (52B) trabalham em um dado token. É por isso que o modelo pode ser enorme e ainda assim razoavelmente rápido. O Artificial Analysis mediu 116.1 tokens de saída por segundo na API da Mistral, bem acima da mediana de 77.0 de modelos de raciocínio com preço semelhante.
Ele também é um modelo híbrido, então você pode usá-lo como modelo de instrução comum ou ativar o raciocínio com o parâmetro reasoning_effort mostrado no exemplo da documentação. É no raciocínio que custo e latência se escondem (cada passo de pensamento é cobrado como tokens de saída), e voltarei a isso mais adiante, porque é a coisa mais importante a entender antes de colocá-lo diante de clientes.
A outra decisão de design que acho que vale conhecer é que a Mistral o treinou na própria infraestrutura e serve a prévia do mesmo lugar, incluindo "a European deployment that Mistral operates end-to-end". Para equipes sob regras de dados da UE, isso importa mais que qualquer benchmark. Também pesa em revisões de SOC 2 e GDPR, em que uma das primeiras perguntas costuma ser exatamente onde o modelo roda.
Preços do Mistral Large 4
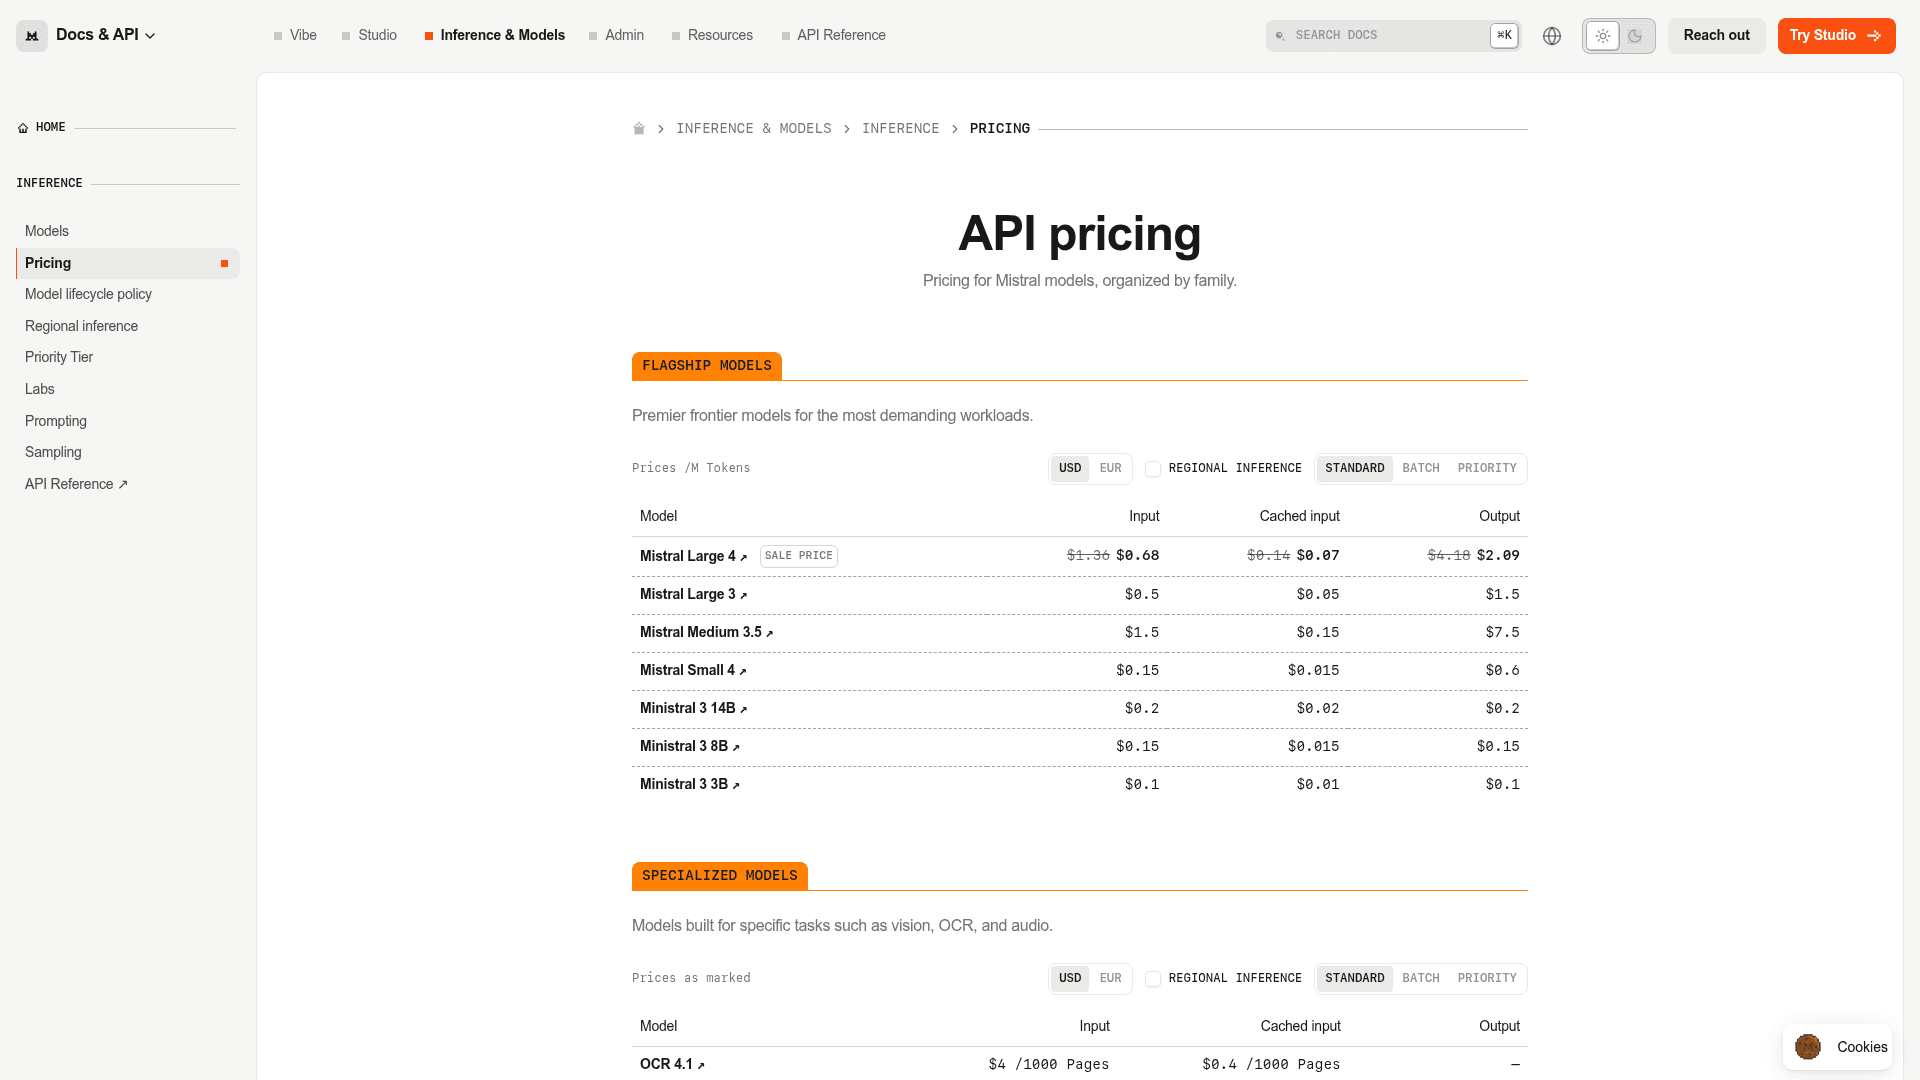
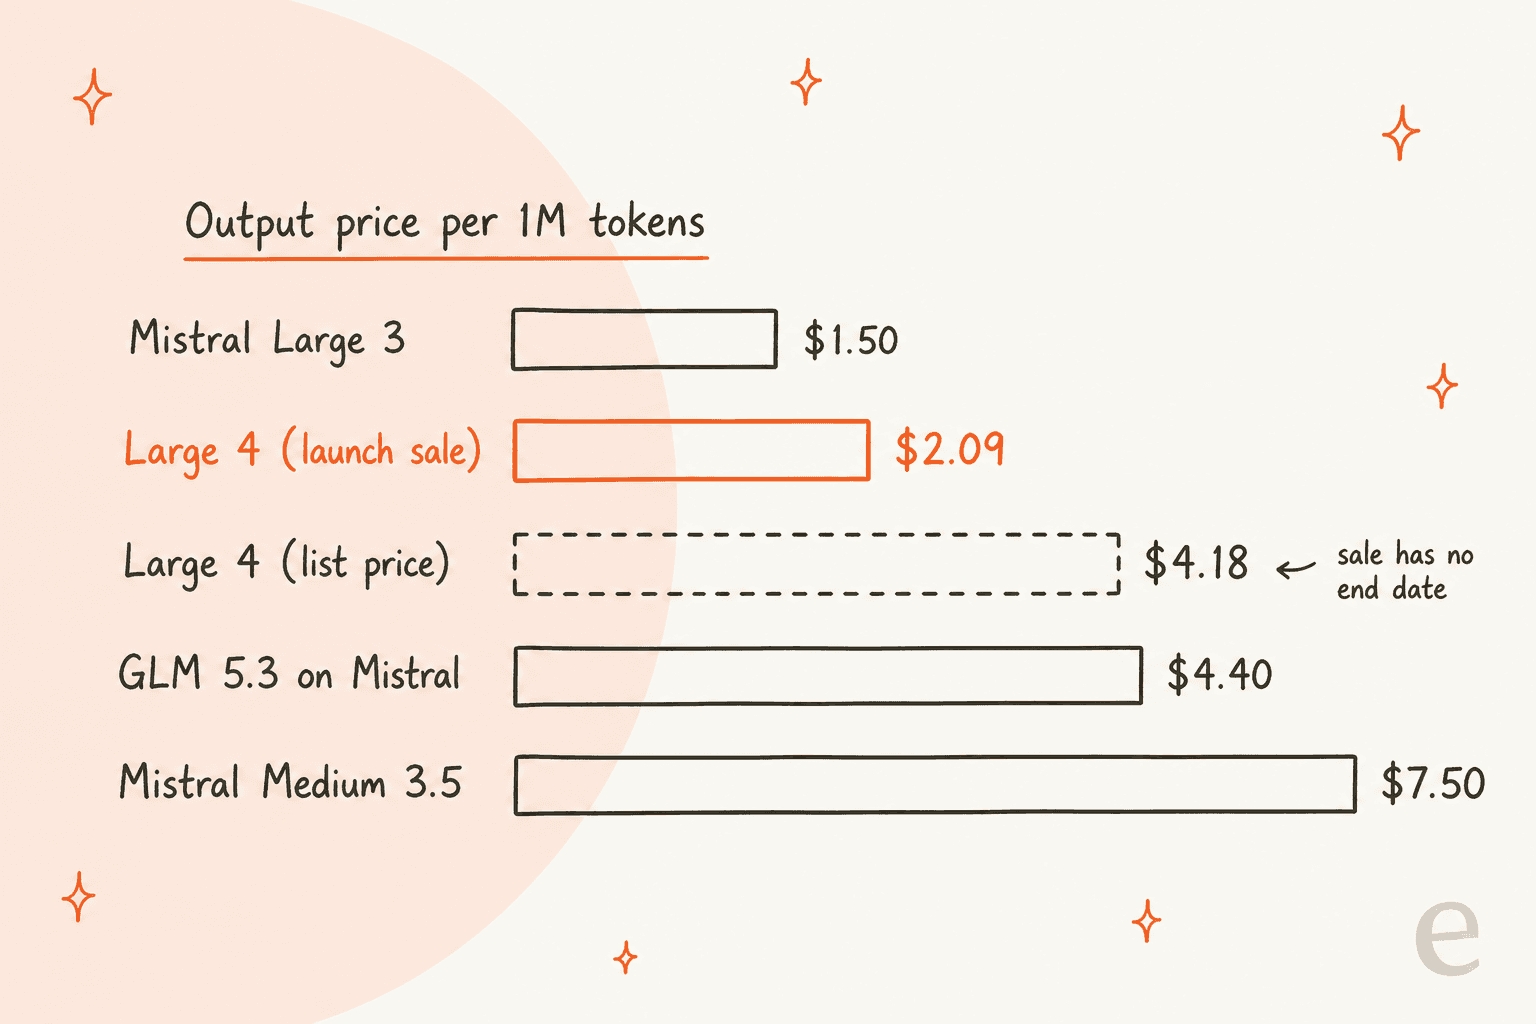
O Mistral Large 4 é cobrado por token pela API, e agora há uma promoção de lançamento, exatamente na metade do preço de tabela. A página de preços da API mostra os dois:
| Modelo (por 1M de tokens) | Entrada | Entrada em cache | Saída |
|---|---|---|---|
| Mistral Large 4 (promoção de lançamento) | $0.68 | $0.07 | $2.09 |
| Mistral Large 4 (preço de tabela) | $1.36 | $0.14 | $4.18 |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 |
| GLM 5.3 (hospedado pela Mistral) | $1.40 | $0.14 | $4.40 |
Três coisas me chamam a atenção:
- A promoção não tem data de término. No preço de tabela, a saída custa 2.8x o que o Large 3 custava. Faça o orçamento com $1.36 / $4.18 e trate a promoção como um bônus.
- Ele fica abaixo do próprio Medium 3.5 da Mistral. Na promoção, a saída do Large 4 custa $2.09 contra $7.50 do Medium 3.5, então há pouco motivo para continuar no Medium em qualquer trabalho novo.
- O batch é ainda mais barato. O FAQ de preços da Mistral diz que requisições batch custam 50% menos e a entrada em cache até 90% menos.
Se você prefere usá-lo como aplicativo de chat em vez de por uma API, ele está dentro do produto para consumidores da Mistral, que agora se chama Vibe (antes Le Chat): Free por $0, Pro por $14.99/mês, Team por $24.99/usuário/mês e Enterprise sob consulta. A página de preços não diz quais planos do Vibe incluem o Large 4, então vale conferir antes de comprar uma licença por causa dele. Meu guia completo de preços da Mistral AI detalha os planos.
Quanto custa uma resposta de suporte no Large 4
Preços por token são mais fáceis de avaliar quando há uma carga de trabalho real associada. Digamos que uma resposta de suporte leia 8,000 tokens de entrada (o histórico do ticket mais alguns artigos da central de ajuda trazidos por RAG) e escreva 3,000 tokens de saída, raciocínio incluído. No preço promocional isso dá cerca de $0.012 por resposta, e no preço de tabela cerca de $0.023.
É barato, e é por isso que eu diria à maioria das equipes de suporte que o preço por token raramente é o item que decide a implantação de um suporte com IA. Respostas erradas e as horas gastas cuidando do bot custam bem mais, que é também o tema do meu detalhamento do custo de um agente de suporte com IA.
Benchmarks do Mistral Large 4: gráficos da Mistral vs. testes independentes
A Mistral publicou muitos gráficos neste lançamento, e vale lê-los com cuidado, porque são honestos de um jeito um pouco incomum. Os próprios gráficos da Mistral mostram concorrentes batendo o Large 4 em quatro dos seis benchmarks que consegui ler.
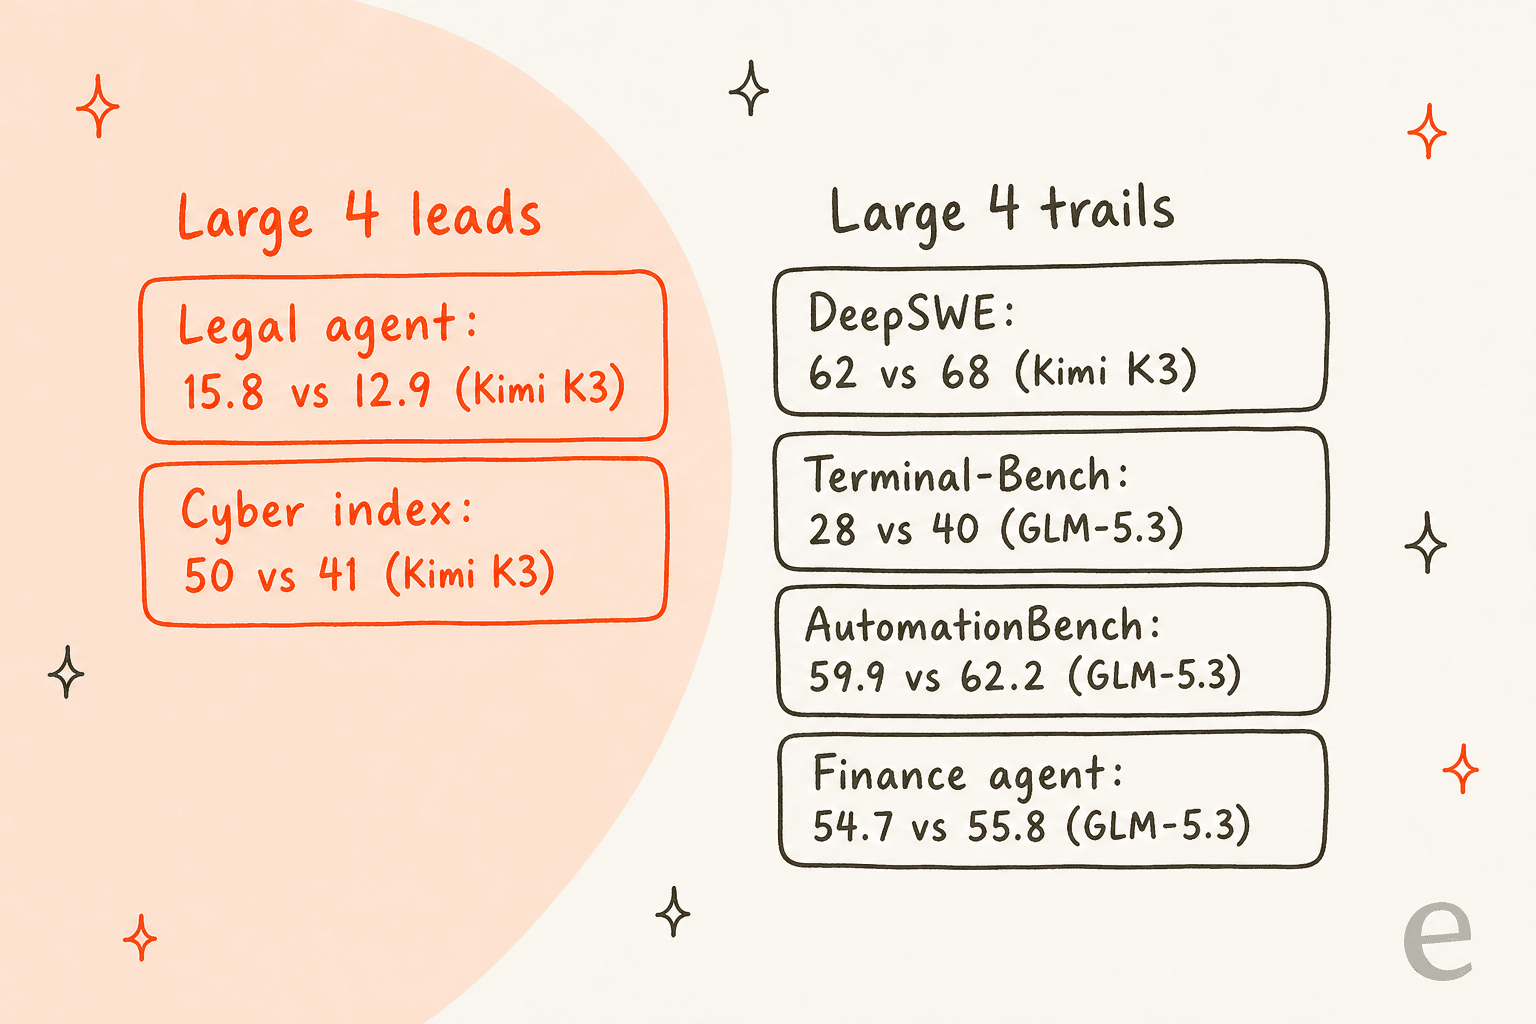
Em programação, ele marca 61.7% no DeepSWE v1.1 e 28.3% no Terminal-Bench 4. O Kimi K3 é superior no DeepSWE (68) e o GLM-5.3 é superior no Terminal-Bench (40), ambos dos próprios gráficos da Mistral.
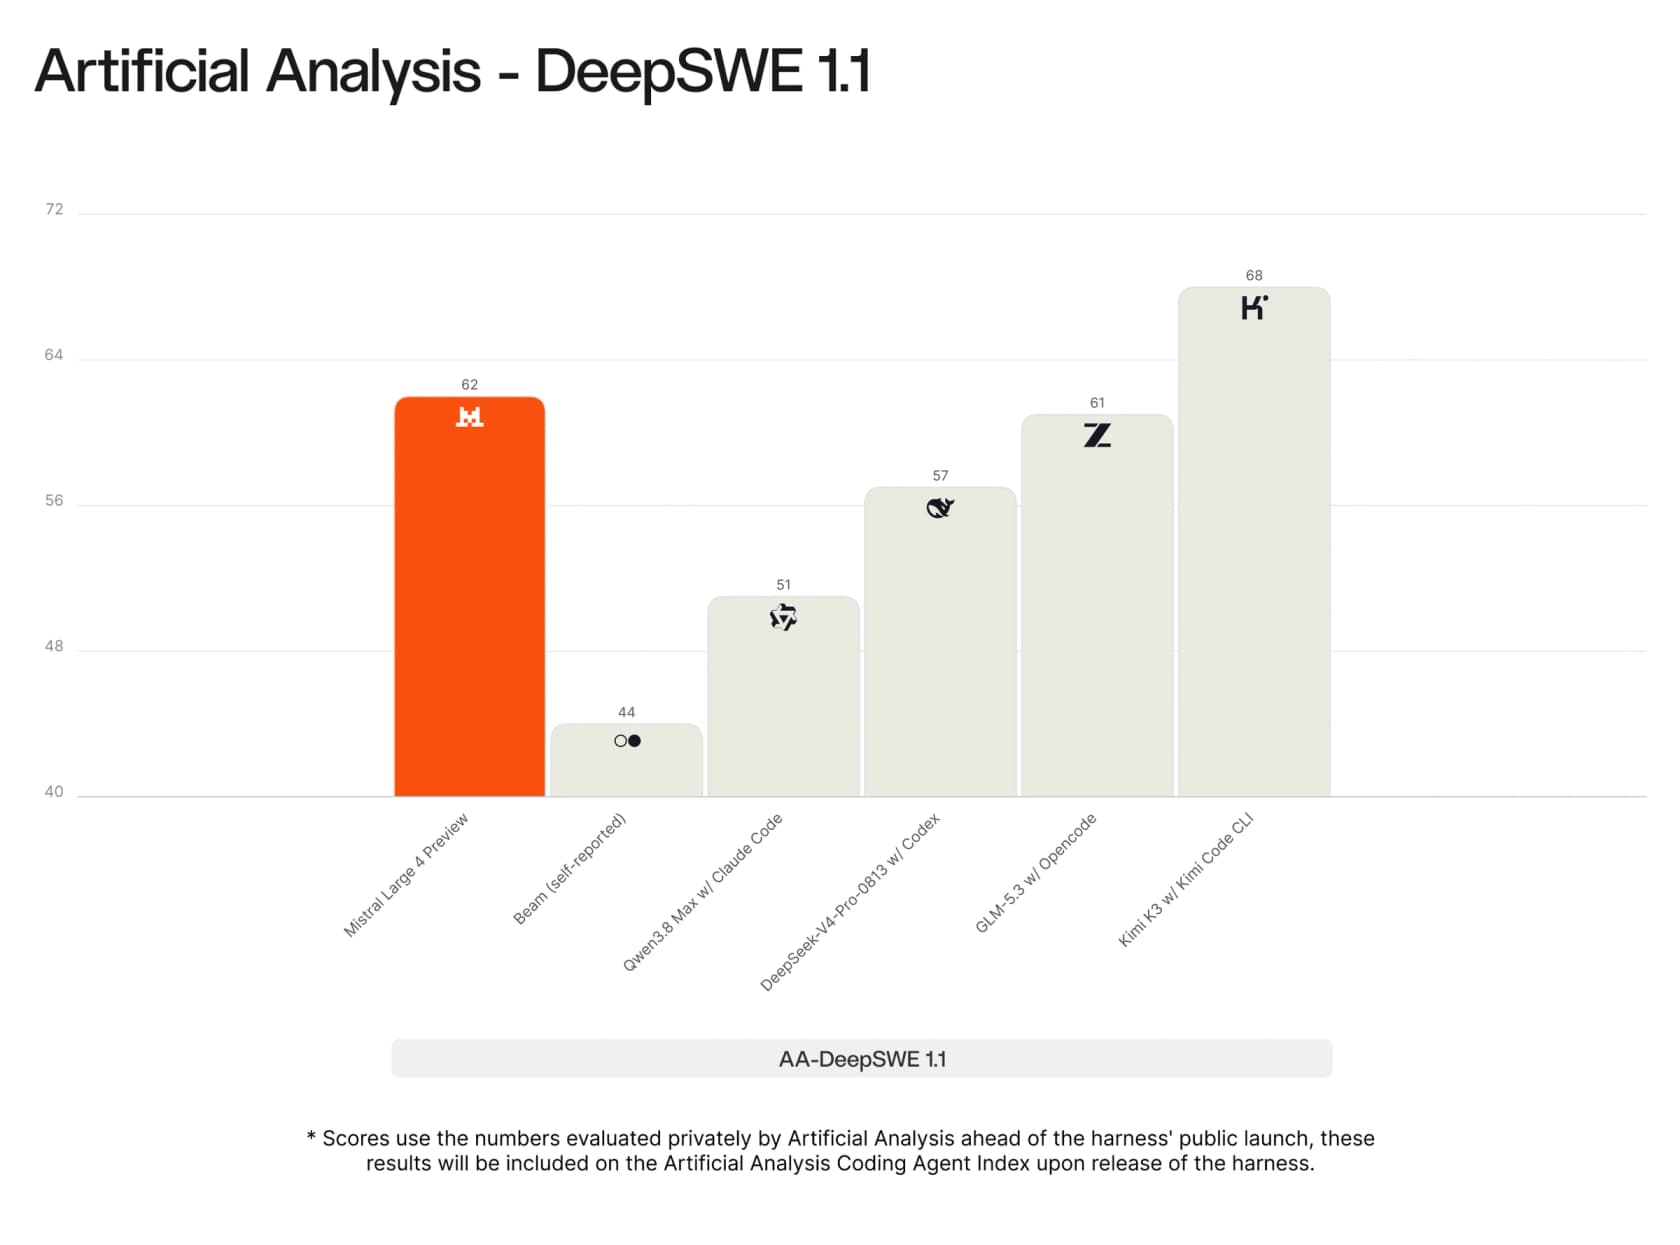
O quadro independente do Artificial Analysis combina com isso. Aqui está onde o Large 4 fica no Intelligence Index deles, com o custo para concluir uma tarefa do benchmark:
| Modelo | AA Intelligence Index | Preço entrada / saída por 1M | Custo por tarefa |
|---|---|---|---|
| Claude Sonnet 5.5 (Max) | 56.0 | $2 / $10 | $5.46 |
| Qwen 3.8 Max | 45.4 | $2 / $6 | $5.41 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.00 |
| Claude Haiku 5.5 (Max) | 43.4 | $0.10 / $0.50 | $0.21 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.24 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.27 |
| Mistral Large 4 Preview | 38.4 | $1.36 / $4.18 | $1.13 |
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.18 |
| DeepSeek V4 Pro (Max) | 36.0 | $1.32 / $3.96 | $0.67 |
| Mistral Large 3 | 9.3 | $0.50 / $1.50 | $0.03 |
Há duas leituras da mesma tabela, e as duas são verdadeiras. Frente ao passado da Mistral, o Large 4 é um salto de geração: 4.1x a pontuação do Large 3. Frente ao cenário de hoje, ele fica atrás do Kimi K3 e do Qwen 3.8 Max, e cai logo abaixo do DeepSeek V4.1 Flash e logo acima do GPT-5.6 Luna, ambos custando uma fração por tarefa.
O motivo é o apetite por tokens. O Artificial Analysis contou 69,330 tokens de saída por tarefa para o Large 4, dos quais 52,011 foram de raciocínio. O Large 3 usou 5,566. Um modelo de raciocínio que pensa tanto transforma um preço moderado por token em um preço alto por tarefa.
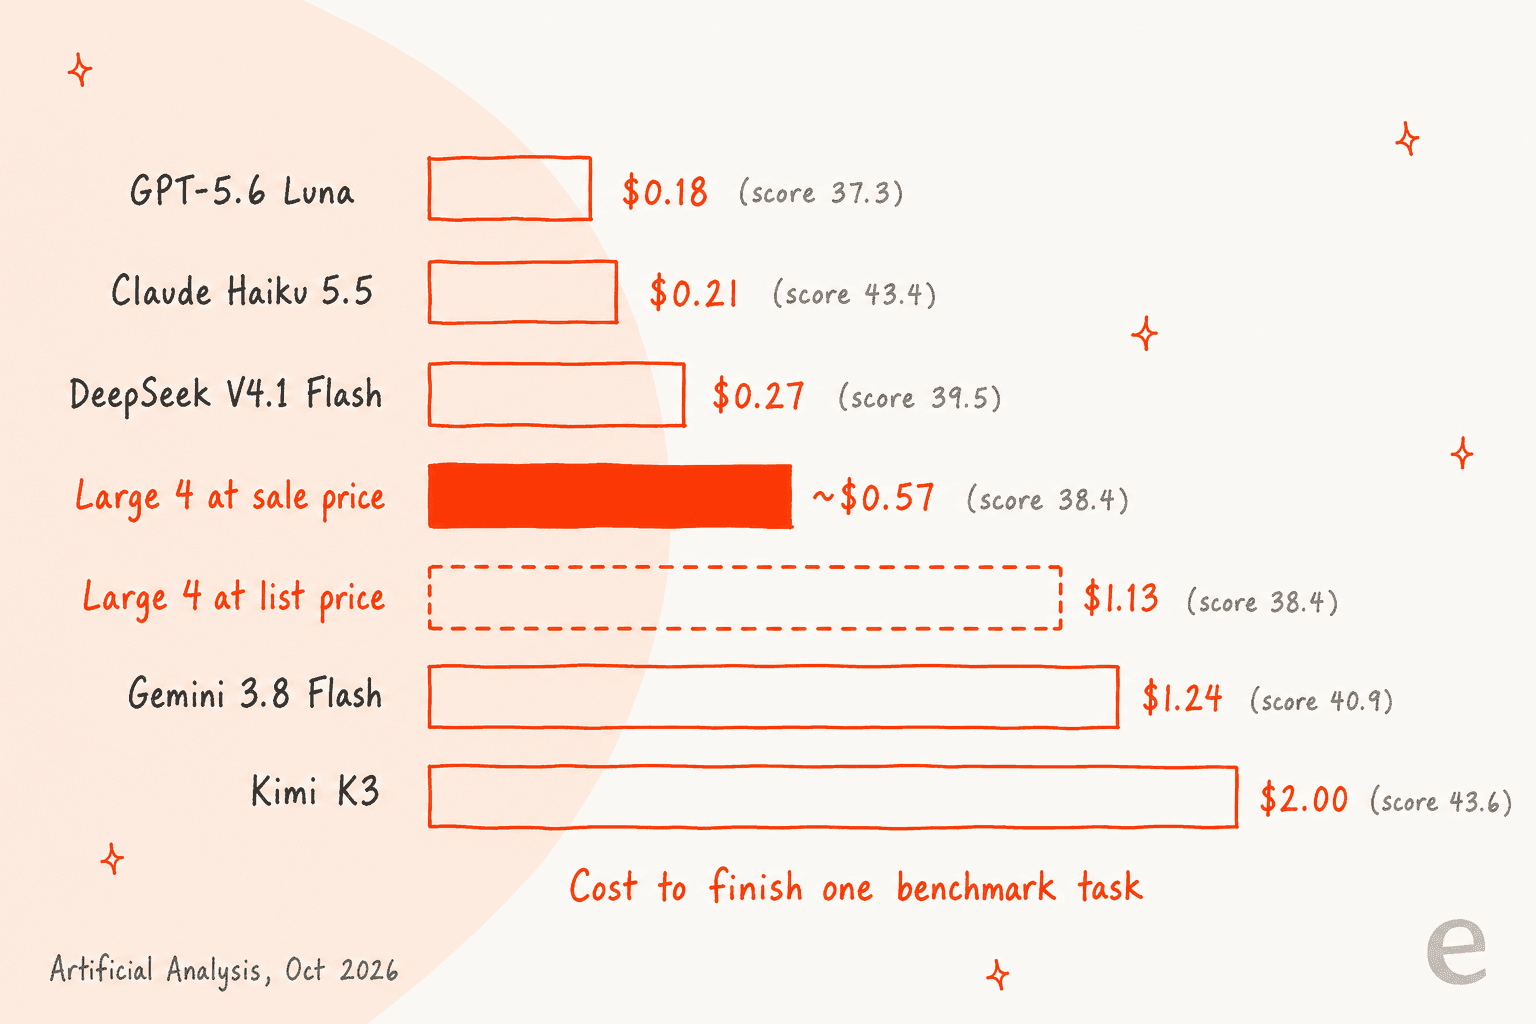
O Artificial Analysis precifica suas execuções pelas tarifas de tabela, e como a promoção reduz todas as tarifas à metade, inclusive a entrada em cache, o preço promocional dá cerca de $0.57 por tarefa. Isso ainda é cerca de 2x o DeepSeek V4.1 Flash para uma pontuação um pouco menor. Se você compara modelos abertos por custo, meus posts sobre os preços do DeepSeek V4 Flash e os preços do Kimi K3 trazem as tabelas completas.
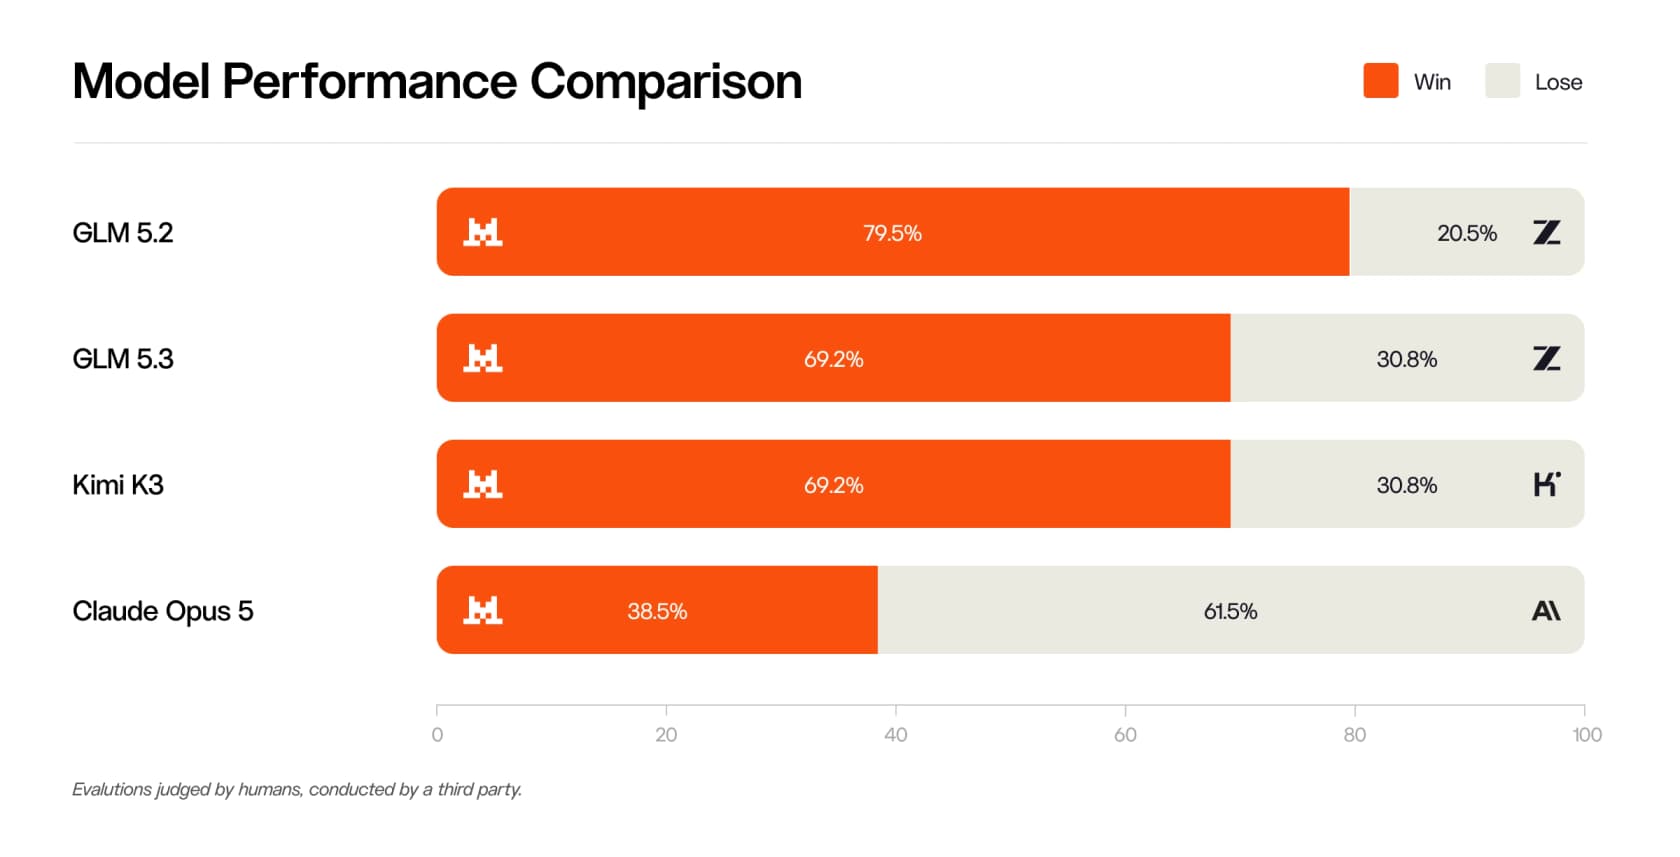
Avaliadores humanos contam uma história mais gentil que o índice. Nas avaliações humanas da Mistral, conduzidas por terceiros, o Large 4 venceu 69.2% dos confrontos diretos tanto contra o GLM-5.3 quanto contra o Kimi K3, e 38.5% contra o Claude Opus 5.
Onde o Mistral Large 4 é mais forte
Tirando o índice geral, surge um formato claro: o Large 4 não é o melhor para tudo, mas lidera em alguns pontos específicos.
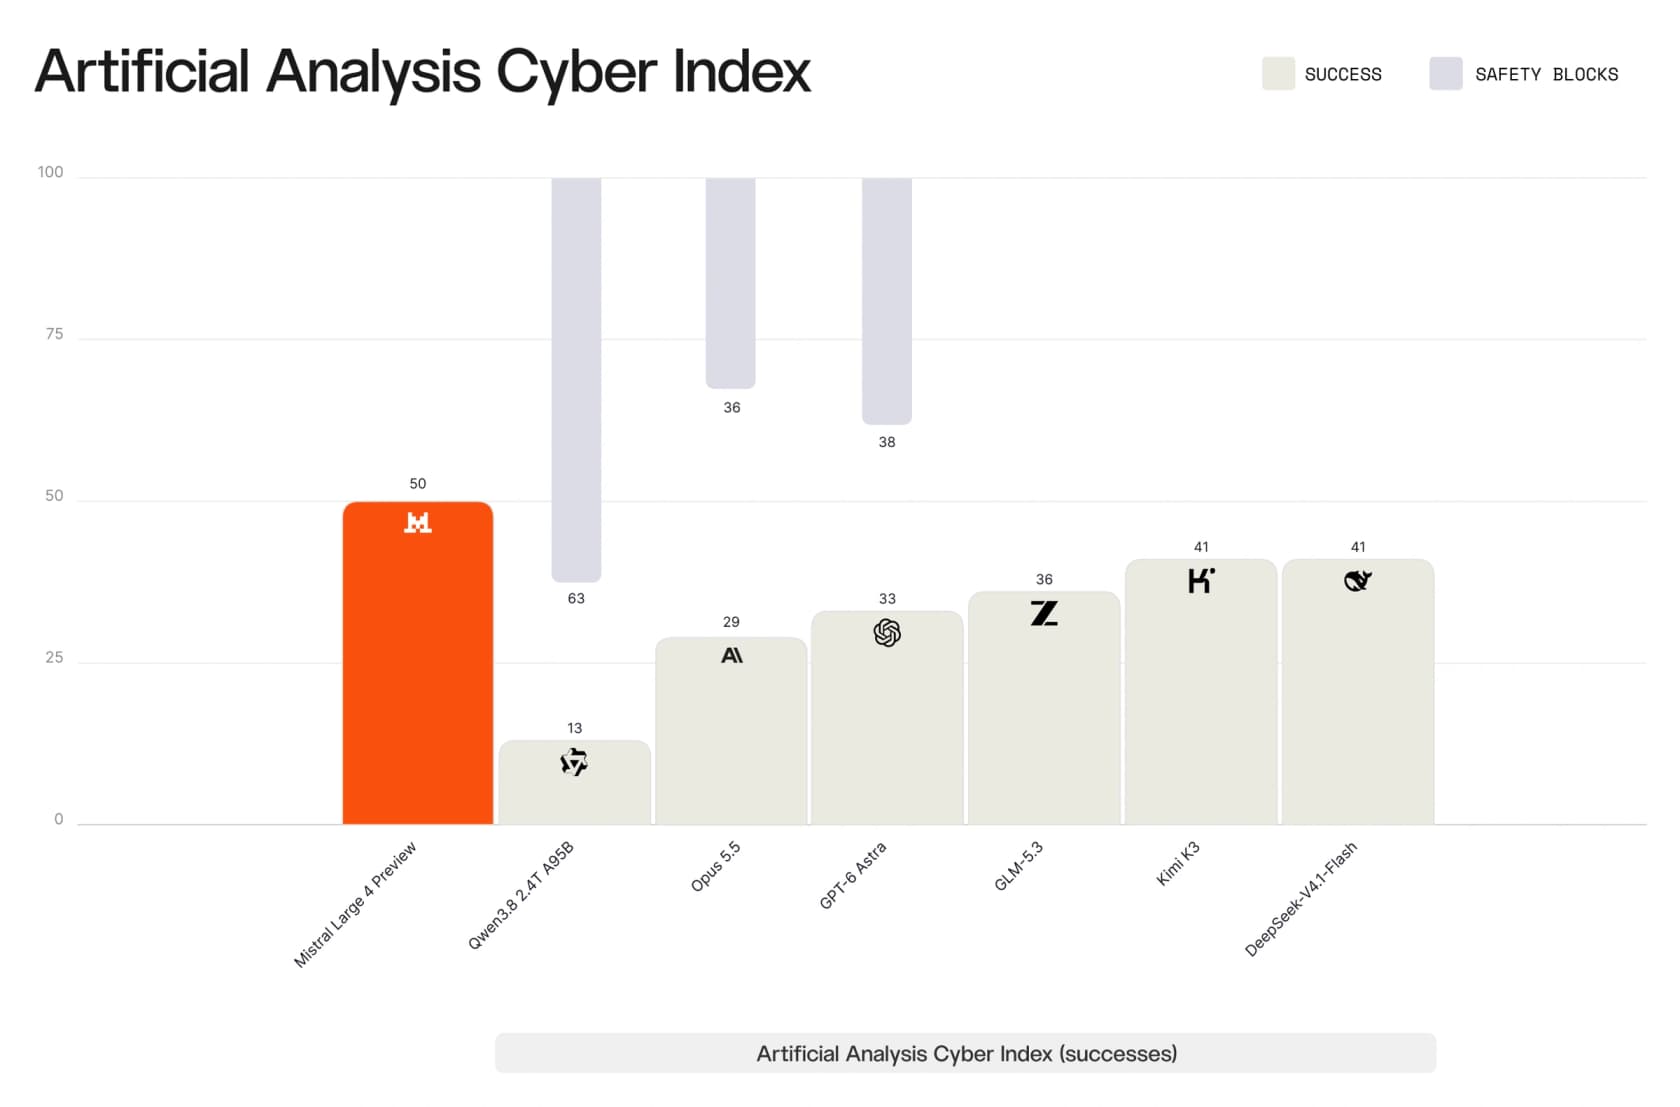
Defesa cibernética. É a afirmação principal, e os números a sustentam. O Large 4 marcou 50 no Artificial Analysis Cyber Index, à frente do Kimi K3 com 41, do GPT-6 Astra com 33 e do Claude Opus 5.5 com 29, segundo o post de lançamento da Mistral. Alcançou 82% em um teste de reproduzir e depois corrigir e 93% no Cybench. Nesse teste de correção, a Mistral observa que os modelos fechados de fronteira "score near zero on the same test because they refuse", então parte da liderança ali é sobre disposição, não habilidade.
O cofundador da Mistral Guillaume Lample defendeu a tese diretamente:
"Open models are the best defense for enterprises today: capable, auditable, self-hosted and governed under enterprise policies -- and more importantly, they do not refuse to help."
Trabalho de agentes jurídicos. No benchmark Harvey Legal Agent da Vals.ai ele marcou 15.8, à frente do Kimi K3 com 12.9 e do GPT-6 Astra com 5.4. Os números absolutos são baixos, mas a liderança é clara.
Documentos longos e gráficos. Marcou 81.3% no teste de raciocínio de contexto longo do Artificial Analysis (AA-LCR) e 42% no Dense 200 visual grounding, superando por pouco os 41% do GPT-6 Astra. A equipe de dados da Plotly viu o mesmo na prática (mais abaixo).
Segurança sob ataque. Resistiu a 93.3% dos ataques no benchmark de segurança de agentes Lakera B3, a maior pontuação que a Mistral reportou entre os concorrentes.
O que a comunidade diz sobre o Mistral Large 4
O tópico de lançamento no Hacker News chegou a 1,990 pontos e 1,144 comentários, e o clima está dividido mais ou menos como a tabela de benchmarks sugere: as pessoas se impressionam com o salto, mas não estão convencidas de que ele supere o restante.
O teste prático mais útil veio de alguém da Plotly que o rodou no benchmark de análise de dados deles:
"It's 10x cheaper than Mistral Medium 3.5 from April and goes from 58% to 74% correct. Definitely a generational shift. It's not on the Pareto curve yet, but it's good enough for data analytics"

O preço apareceu muito nas respostas. Um comentarista o colocou ao lado dos modelos "flash" mais baratos:
"So, I think it would have to be significantly better than GLM 5.3-flash to be worth it. GLM 5.3-flash is already very good."
Para o confronto direto com modelos fechados, minhas comparações Claude vs Mistral e ChatGPT vs Mistral são uma boa próxima leitura.
O Reddit foi mais duro. No r/LocalLLaMA, um usuário que roda seu próprio benchmark de xadrez escreveu:
"Played around with it a bit, for code analysis, image classifications, and chess capability. Feels quite dated and far behind what I usually utilize."

E mesmo assim o argumento da soberania volta sempre, que é o que eu levaria mais a sério para compradores corporativos:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."
A resposta mais curtida ao post de lançamento da Mistral no X foi uma piada que diz muito sobre o enquadramento "open weights": "me with 12 GB of VRAM reading 'open weights, 1.05T parameters'" (An Xuan no X). O que me leva à parte que, por enquanto, ainda é só uma promessa.
Open weights: o que "aberto" significa hoje
A Mistral rotula o Large 4 como open-weight, mas em 8 de outubro de 2026 você não pode baixá-lo. Não há repositório do Mistral Large 4 na página da Mistral no Hugging Face, e nenhuma licença foi definida. Lample diz que a execução de RL "is still in flight" e que uma versão final sai com os pesos antes do fim do mês.
Isso tem duas consequências práticas para você:
- Os benchmarks podem mudar. O modelo que você testa hoje é uma prévia, e a política de ciclo de vida da Mistral dá aos modelos em Public Preview apenas um mês de aviso antes de mudanças, contra seis meses na disponibilidade geral. Rode suas avaliações de novo quando a versão final chegar.
- A licença decide tudo. O Large 3 saiu sob Apache 2.0, enquanto o Medium 3.5 usa uma licença MIT modificada. Até a Mistral definir uma para o Large 4, "aberto" é uma direção, não um contrato.
Mesmo com os pesos, a maioria das equipes não vai rodá-lo por conta própria, já que com 1.05T de parâmetros você está em território de servidores multi-GPU. Os caminhos realistas são a API da Mistral, uma implantação europeia pela Mistral ou um provedor de hospedagem quando eles surgirem. Se você quer algo que possa rodar no seu próprio hardware hoje, minha lista de alternativas à Mistral inclui modelos abertos menores.
Você deve usar o Mistral Large 4 para atendimento ao cliente?
É a pergunta que mais me fazem, então aqui vai minha resposta direta: o Large 4 consegue escrever uma boa resposta de suporte, mas nunca deve responder da própria memória.
No teste de conhecimento do Artificial Analysis (AA-Omniscience), ele acertou 25.8% das perguntas e teve uma taxa de alucinação de 41.9%, ou seja, quando não sabia a resposta, muitas vezes simplesmente chutava. Em um helpdesk, um chute confiante sobre sua política de reembolso ou sobre a compatibilidade do seu produto é a pior resposta possível.
Já vi esse modo de falha de perto. Em uma ligação de vendas da eesel, uma equipe dinamarquesa B2B de telemática veicular usando Zendesk, com cerca de 200 tickets por mês, temia que o bot confirmasse modelos de carro sem suporte, porque a base de conhecimento dizia "we support all models". Um modelo melhor não teria resolvido, porque o modelo lia os documentos corretamente e os documentos estavam errados. É por isso que toda implantação em que trabalho é testada contra tickets históricos antes de entrar no ar, e por isso os guias sobre como impedir alucinações começam pela base de conhecimento, não pelo modelo.
Uma líder de CX de uma marca de suplementos DTC, com cerca de 7,000 tickets, colocou o requisito real melhor do que qualquer benchmark consegue:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
A latência é a segunda coisa que precisa ser verificada. Com o raciocínio ligado, o Artificial Analysis mediu cerca de 18.7 segundos até o primeiro token de resposta em um prompt longo. Isso é aceitável para e-mail e respostas a tickets, mas lento para chat ao vivo, onde você vai querer um reasoning_effort menor ou um modelo mais rápido. Minha comparação do melhor modelo de IA para tickets aprofunda essa troca.
Assim eu resumiria para uma equipe de suporte:
| Caso de uso | Adequação do Large 4 | Por quê |
|---|---|---|
| Rascunhos de respostas para os agentes revisarem | Bom | Boa escrita, barato por resposta, uma pessoa no circuito confere o resultado |
| Respostas autônomas por e-mail ou ticket | Só com proteções | Precisa de embasamento nos seus documentos, uma pontuação de confiança e um plano B humano |
| Chat ao vivo | Fraco com raciocínio ligado | ~18.7 s até o primeiro token de resposta |
| Requisitos de residência de dados na UE | Forte | Construído e servido na Europa pela Mistral |
| Ler capturas de tela e PDFs anexados por clientes | Forte | Entrada de imagens nativa, boas pontuações em documentos e gráficos |
Se você está escolhendo entre modelos para uma stack de suporte, meu guia do melhor LLM para suporte compara as principais opções, e RAG vs fine-tuning explica por que o embasamento supera o treinamento em centrais de ajuda.
O modelo é infraestrutura, a eesel é o funcionário
Esta é a mudança que eu pediria que você fizesse. Um modelo como o Mistral Large 4 é infraestrutura: um motor que prevê texto. O que uma equipe de suporte realmente precisa é de um colega que conheça o produto, trabalhe dentro do helpdesk, saiba quando passar para um humano e possa ser verificado antes de falar com clientes. Escolher o motor é a metade mais fácil do trabalho.
Karel, da GENERAL BYTES, disse com clareza ao explicar por que a equipe dele não construiu a própria solução:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Esse é o trabalho da eesel, uma plataforma de colegas de equipe com IA onde você contrata colegas prontos para trabalhar em funções específicas.
Para suporte, é o colega de equipe de helpdesk com IA: ele se conecta ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda, e roda uma simulação sobre centenas de tickets passados seus para que você veja como ele teria respondido antes de ligá-lo. Para equipes de conteúdo, o redator de blog com IA faz o mesmo para posts longos.
Se você está comparando com a IA nativa do seu helpdesk, comparei eesel vs Zendesk AI separadamente.
Para ser claro sobre os limites: a eesel roda em modelos da OpenAI, Anthropic e Google, segundo a página de segurança, então o Mistral Large 4 não é hoje uma opção que você possa escolher dentro da eesel. Se o seu requisito é especificamente "um modelo Mistral, hospedado na Europa", chamar a API da Mistral diretamente é o caminho mais direto.
Se você chegou ao Large 4 porque quer controle em nível de API, a CLI da eesel oferece isso sobre o próprio colega de equipe. npx @eesel/cli init chat-bubble --site <your-site> cria um balão de chat treinado no seu site sem conta, todo comando retorna JSON para que Claude Code, Cursor ou Codex possam conduzir a configuração, e eesel mcp token transforma seu workspace em um servidor MCP. É o mesmo agente do painel, então tudo que você configura pelo terminal aparece lá também. Meu post sobre CLIs de agentes de IA explica por que isso importa.
Experimente a eesel
Se você está avaliando o Mistral Large 4 porque quer uma IA que responda tickets de suporte, eu começaria um passo acima. O colega de equipe de helpdesk da eesel entra na sua fila do Zendesk, Freshdesk ou Gorgias em minutos, aprende com os tickets que sua equipe já respondeu e mostra uma simulação pontuada nesses tickets passados antes de responder a qualquer pessoa. Você vê as respostas erradas em um relatório, não na caixa de entrada de um cliente.

O plano gratuito inclui 100 créditos sem cartão, e os planos pagos começam em $299/mês para 500 tickets ou chats, segundo os preços da eesel. Experimente a eesel em uma amostra dos tickets do mês passado e veja como ela se sai.
Perguntas frequentes
O que é o Mistral Large 4?
Quanto custa o Mistral Large 4?
O Mistral Large 4 é open source?
O Mistral Large 4 é melhor que o Kimi K3 ou o Qwen 3.8 Max?
O Mistral Large 4 é bom para atendimento ao cliente?
Qual é o nome do modelo Mistral Large 4 na API?
mistral-large-4, e ele aceita o parâmetro reasoning_effort. Suporta function calling, saídas estruturadas, batching e a Agents API. Modelos em prévia têm um mês de aviso antes de mudanças, então fixe seus testes nele antes de construir um agente de IA por cima.