

Preços do Mistral Large 4 em resumo
Eu construo as integrações de API na eesel, e o teammate de helpdesk roda em modelos da OpenAI, Anthropic e Google, então boa parte da minha semana é ler tabelas de tarifas e depois olhar além do número da manchete. A tabela de tarifas da Mistral para o Large 4 é curta, mas esconde mais do que mostra. Aqui está tudo da página de preços da API da Mistral para a família principal, nível Standard, em 8 de outubro de 2026.
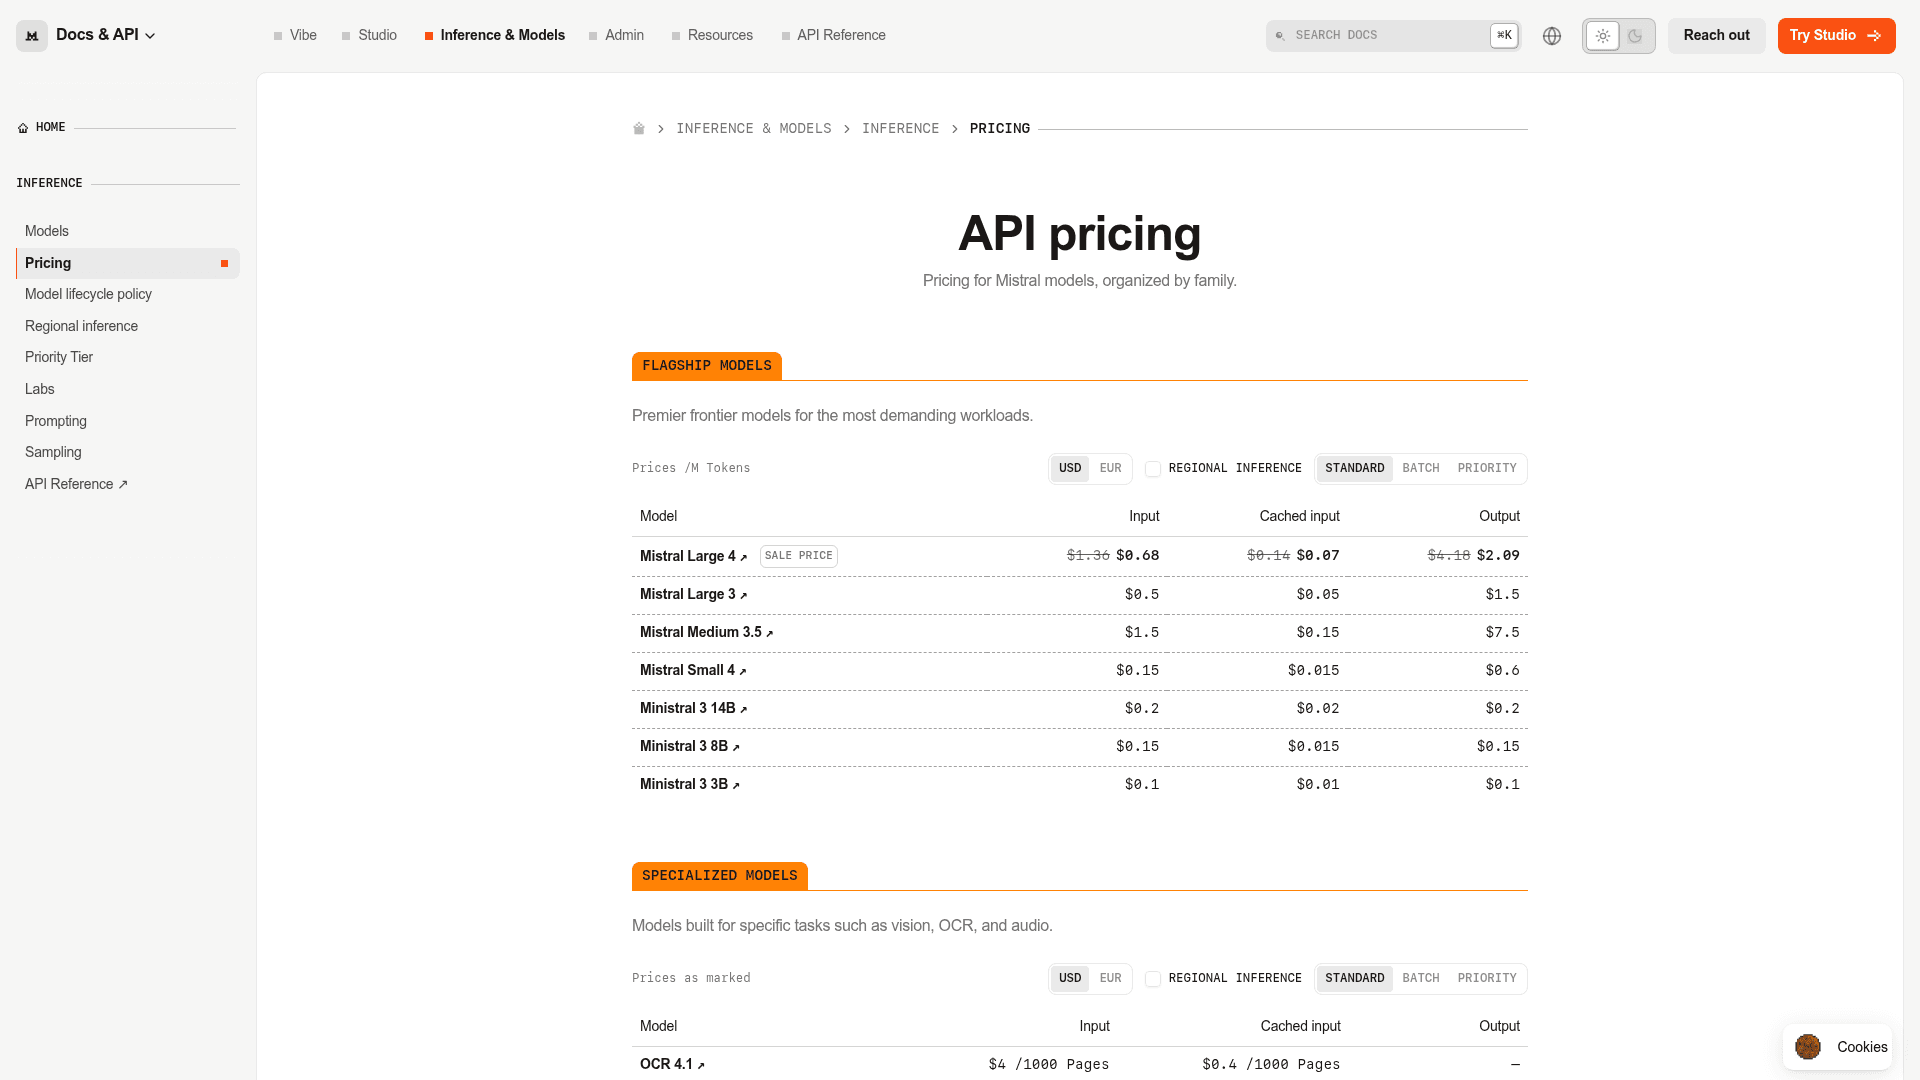
| Modelo | Entrada (por 1M) | Entrada em cache (por 1M) | Saída (por 1M) | Observações |
|---|---|---|---|---|
| Mistral Large 4 (promoção) | $0.68 | $0.07 | $2.09 | Preview pública, contexto de 1M |
| Mistral Large 4 (tabela) | $1.36 | $0.14 | $4.18 | Riscado na página |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 | Carro-chefe anterior, ainda listado |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 | Modelo de raciocínio anterior |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 | Nível econômico |
| Ministral 3 14B | $0.20 | $0.02 | $0.20 | Modelo denso pequeno |
| Z.ai GLM 5.3 (hospedado pela Mistral) | $1.40 | $0.14 | $4.40 | Modelo de terceiros |
Algumas coisas valem ser sabidas antes de colocar esses números em uma planilha:
- A promoção é exatamente 50% de desconto, nos três medidores. A ficha do modelo Large 4 mostra o mesmo padrão riscado e não dá data de término.
- O próprio post de lançamento da Mistral cita o preço de tabela. O anúncio do Mistral Large 4 lista $1.36 / $4.18, então a promoção é uma ação aplicada por cima, não o preço "real".
- A entrada em cache tem 90% de desconto. $0.07 contra $0.68 na promoção. Isso importa mais que o normal para este modelo, e explico o porquê mais abaixo.
- O Large 4 custa mais por token que o Large 3. O preço de tabela passou de $0.50 / $1.50 para $1.36 / $4.18, cerca de 2.7x na entrada e 2.8x na saída. Mesmo em promoção são 36% a mais na entrada e 39% a mais na saída.
Para a história de como a Mistral chegou até aqui, meu resumo dos novos modelos da Mistral cobre os lançamentos do Large 3 e do Medium 3.5.
O que "preço promocional" realmente significa para um modelo em preview
O Large 4 é uma Public Preview na API da Mistral, e esse rótulo muda como você deve ler o preço. A política de ciclo de vida de modelos da Mistral diz três coisas sobre modelos em preview que importam para quem compra:
- Eles têm o mesmo preço dos modelos em General Availability. Então a promoção não é um "desconto de preview" que some no GA por projeto. É uma ação separada.
- Não têm caminho garantido para General Availability, e podem ser desativados antes de chegar lá.
- O aviso de descontinuação de um modelo em preview é de 1 mês, contra 6 meses para um modelo GA. Depois de desativado, as requisições retornam
404.
Somando tudo, o número seguro para planejar é o preço de tabela, mais um plano de migração que você consiga executar em quatro semanas. O cofundador da Mistral, Guillaume Lample no X, já disse que a versão final está chegando:
"The RL run behind this preview is still in flight and shows no sign of saturation -- we will release a final version before the end of the month along with the weights of the model."
O documento de ciclo de vida também observa que modelos em preview não podem usar um alias -latest, e que aliases "may expose you to silent updates in model behavior and pricing." Meu conselho é o mesmo que dou para qualquer modelo em produção: fixe o identificador exato da versão e recalcule o preço quando migrar.
Um token, quatro preços: batch, standard, regional e Priority
A página de preços tem abas Standard, Batch e Priority e também um seletor de inferência regional, enquanto os multiplicadores ficam em páginas de documentação separadas. A maior parte da cobertura dos preços do Mistral Large 4 pula esta parte, e aqui a fatura pode mais que triplicar.
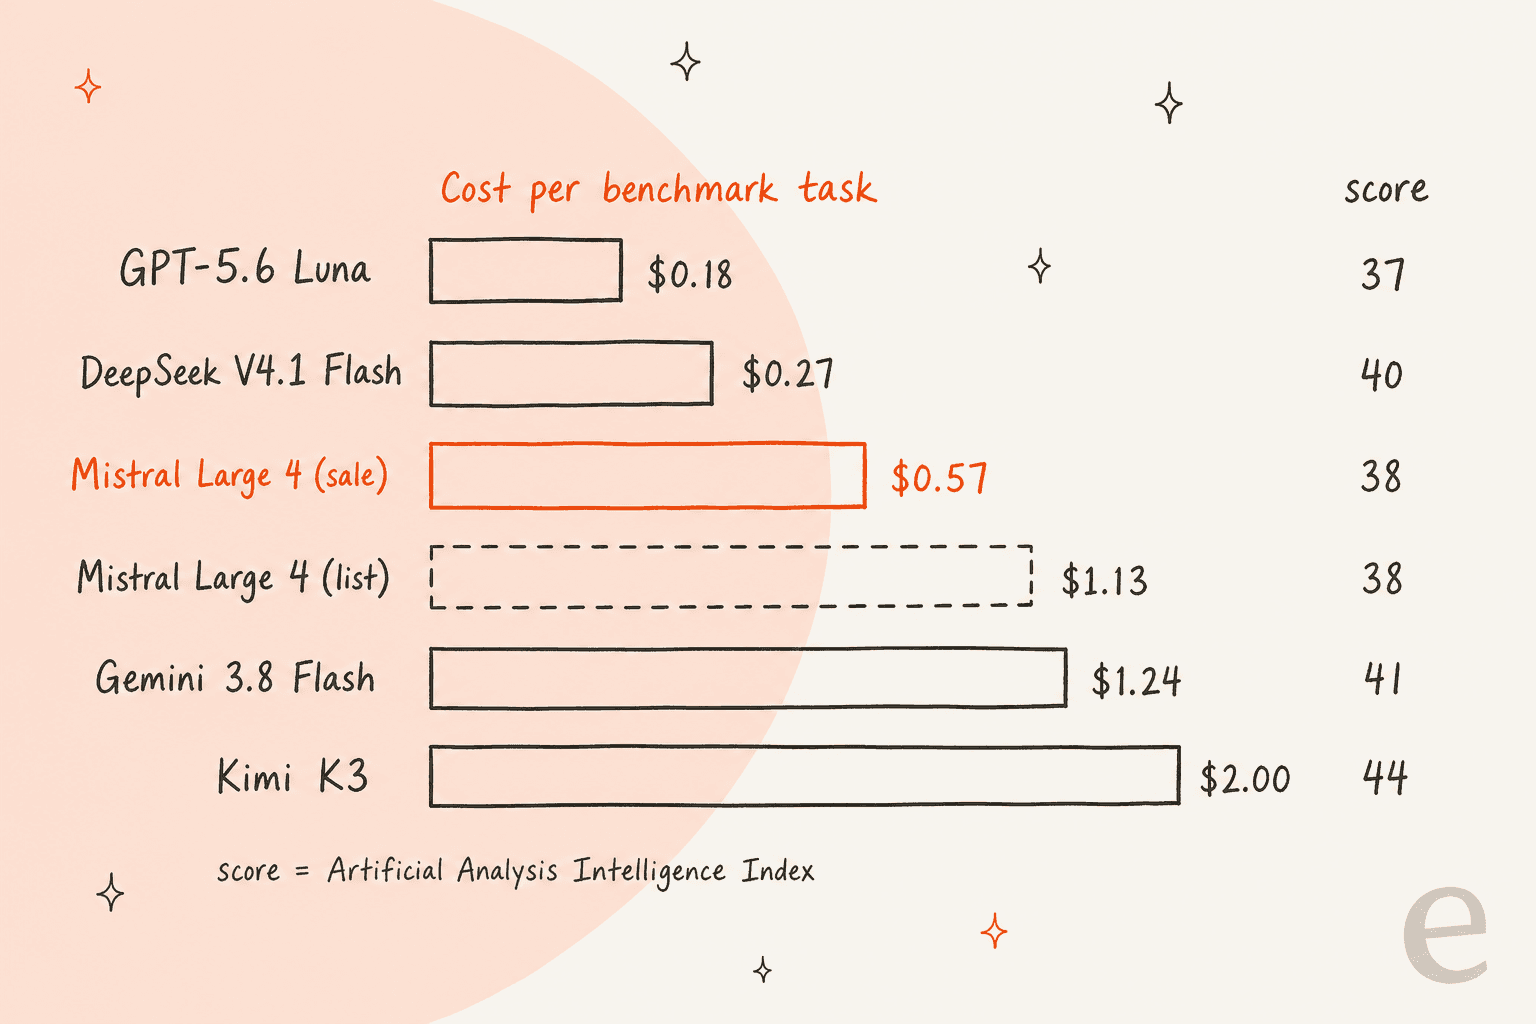
| Nível | Como é precificado | Entrada / cache / saída por 1M | Latência | SLA de uptime |
|---|---|---|---|---|
| Batch | 50% de desconto | $0.34 / $0.035 / $1.045 se acumular com a promoção; $0.68 / $0.07 / $2.09 sobre a tabela | Em fila, até 24 horas | Nenhum |
| Standard (promoção) | Promoção de lançamento | $0.68 / $0.07 / $2.09 | Segundos a minutos | Nenhum |
| Standard (tabela) | Tabela de tarifas | $1.36 / $0.14 / $4.18 | Segundos a minutos | Nenhum |
| Regional (UE ou EUA) | 1.1x a tabela padrão | $1.496 / $0.154 / $4.598 | Segundos a minutos | Nenhum |
| Priority Tier | 1.75x a tabela padrão | $2.38 / $0.245 / $7.315 | Segundos | 99.5% |
As fontes de cada linha:
- Batch. A documentação de processamento batch da Mistral promete "a 50% discount" e até 1 milhão de requisições por lote. A documentação não diz se esse desconto se aplica ao preço promocional ou ao de tabela. Repare que 50% sobre a tabela cai exatamente no preço promocional atual.
- Inferência regional. A página de inferência regional diz que é "billed at 1.1× standard list pricing (a 10% upcharge) for input tokens, output tokens, cached reads, and cache writes." As regiões hoje são a UE e os EUA.
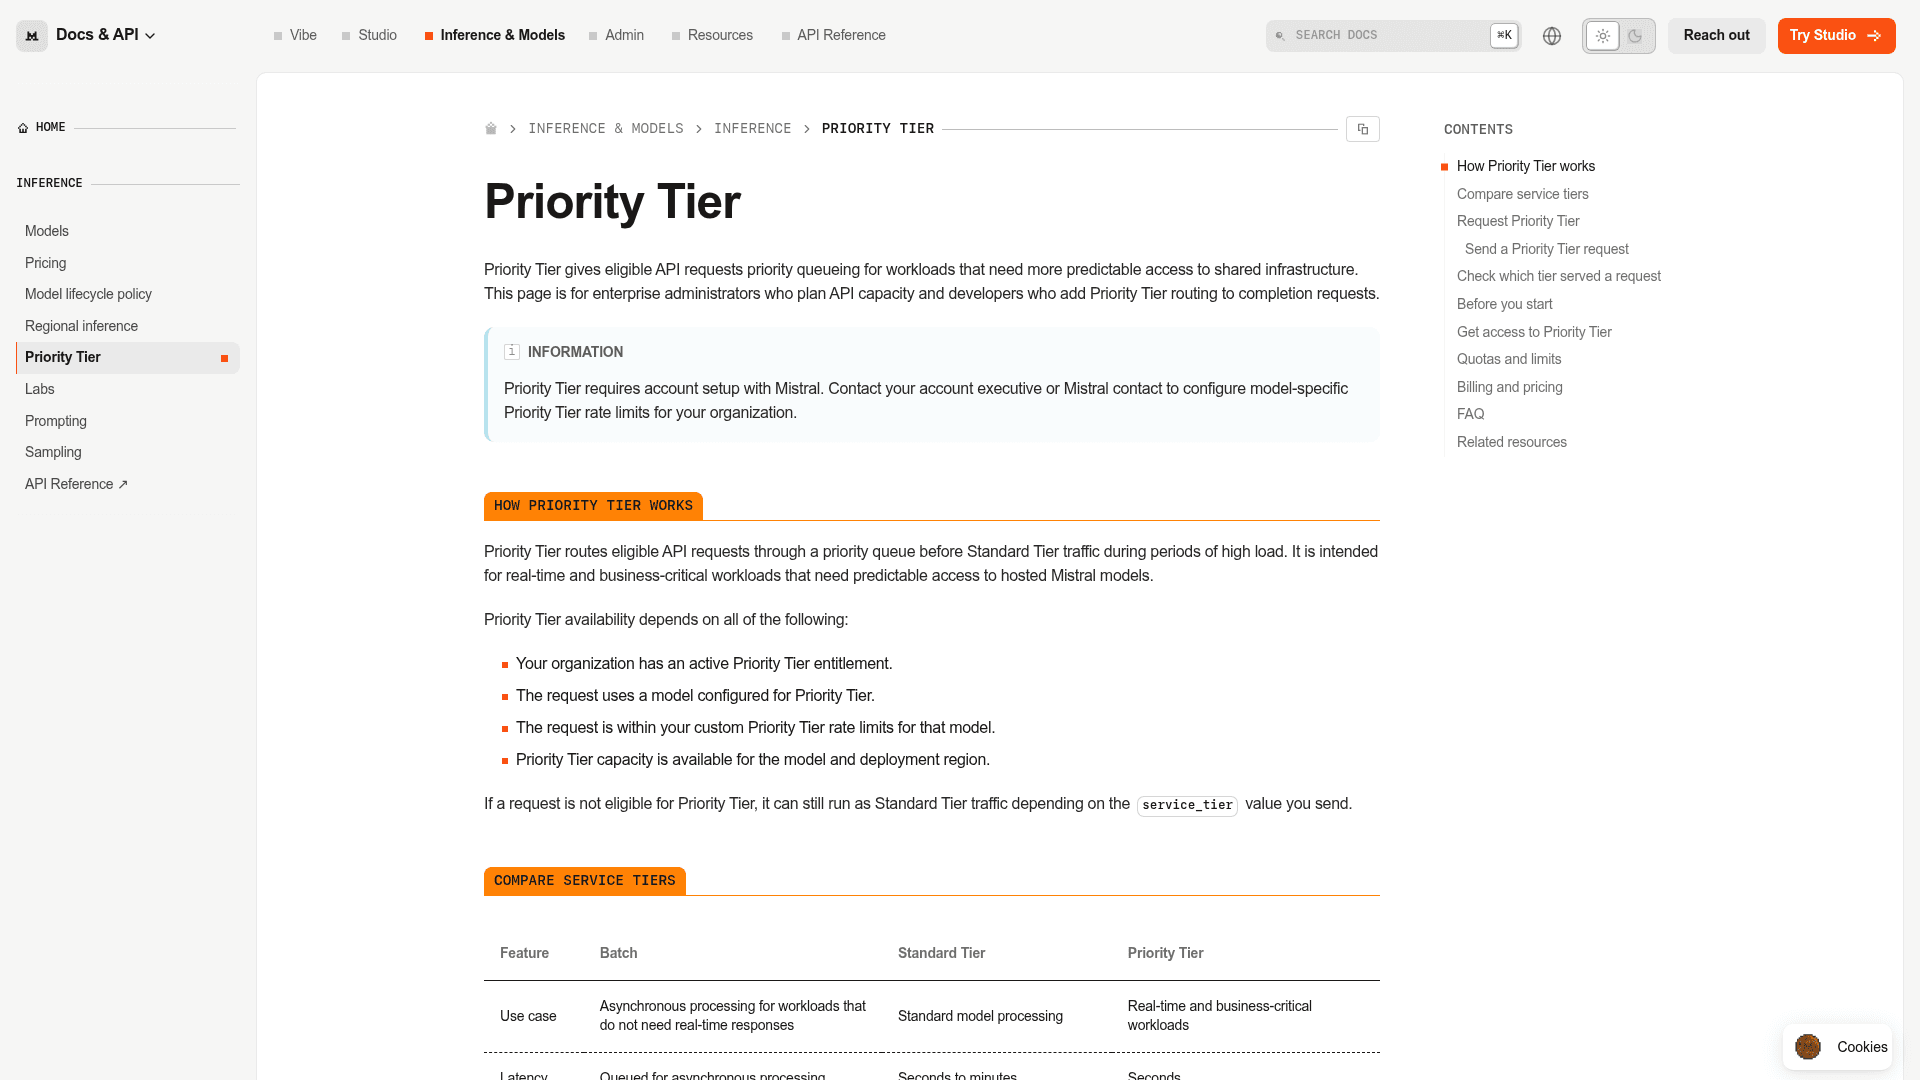
- Priority Tier. A página do Priority Tier diz que o multiplicador "is 1.75x standard list pricing." Exige configuração da conta via vendas, volta para o Standard quando você excede seus limites e é o único nível com SLA de uptime.
Isso importa mais para a Mistral do que para a maioria dos fornecedores. O motivo mais forte que as pessoas dão para escolher a Mistral é que ela é europeia. O próprio post de lançamento da Mistral no X começa por aí:
"Forged in Europe end-to-end and is deployable from Europe via our own Mistral Cloud infrastructure."
Mas o endpoint que garante que a inferência rode dentro da UE é o regional, e seu multiplicador de 1.1x é declarado sobre o preço de tabela. Ambas as páginas de documentação são escritas em termos gerais e não dizem nada sobre a promoção do Large 4, então a Mistral pode aplicar o multiplicador à tarifa com desconto na prática. Eu não orçaria com isso. Se a residência é o motivo da compra, oriente-se por cerca de 2.2x o preço da manchete até que sua fatura diga outra coisa.
A mesma lógica vale para uma equipe de suporte que precisa de SLA. O Priority Tier é a única opção com um, e a 1.75x a tabela são $7.32 por 1M de tokens de saída e $2.38 de entrada. Essa tarifa de entrada é maior que os $2 em que começam os preços do Claude Sonnet 5.5, e a de saída está bem mais perto dos $10 do Sonnet do que dos $2.09 da manchete.
Por que o preço por token subestima a fatura
As tabelas de tarifas comparam modelos por token, mas sua fatura os compara por trabalho. Em modelos de raciocínio, os dois rankings discordam. Um modelo de raciocínio escreve um longo rascunho interno antes de responder, e você paga tarifa de saída por cada palavra dele.
A Artificial Analysis rodou o Intelligence Index completo no Mistral Large 4 Preview e publicou um detalhamento de custos. A preço de tabela, a execução inteira custou $1,601.97, e foi assim que o dinheiro se dividiu:
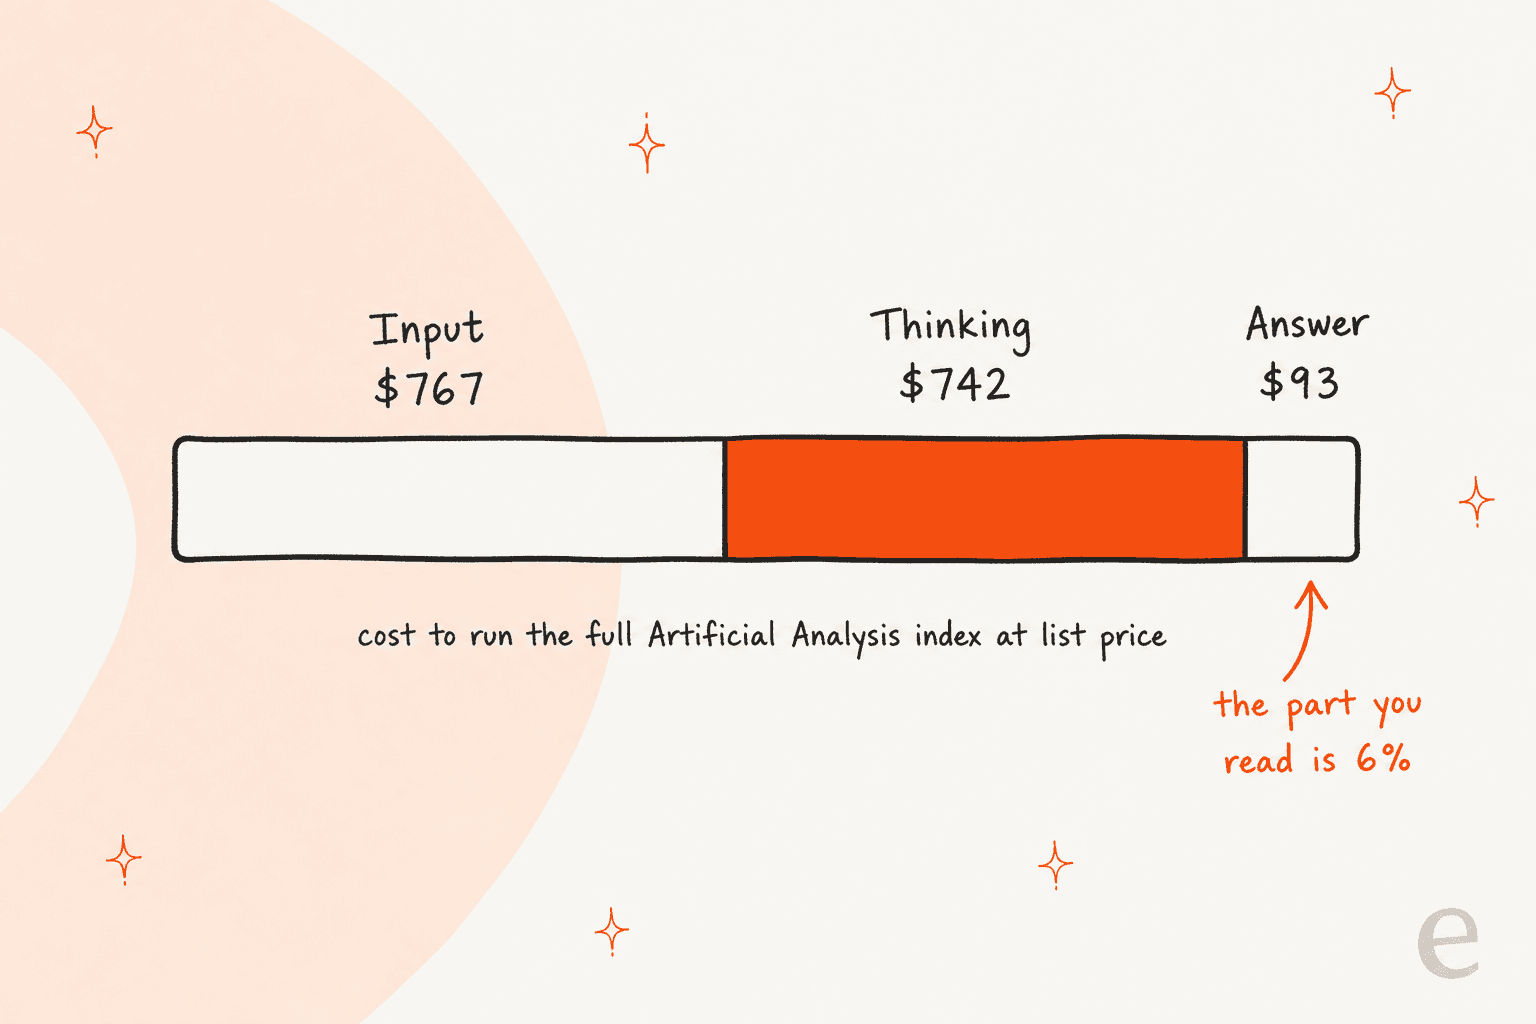
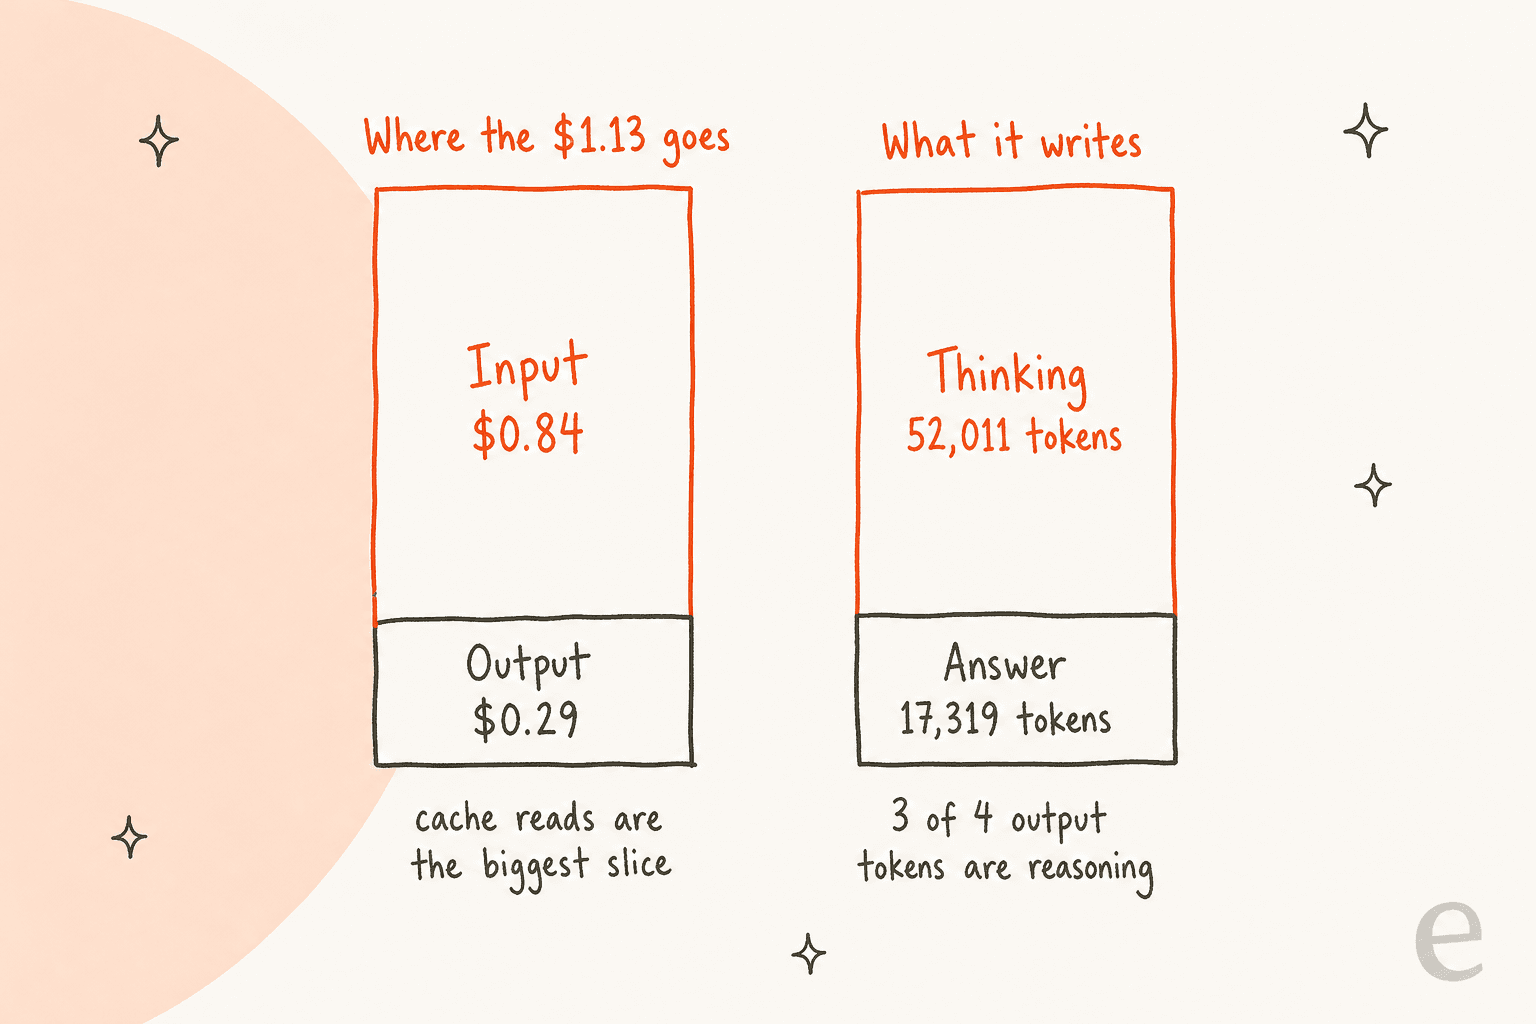
- Saída de raciocínio: $742.45. O Large 4 gerou em média 69,330 tokens de saída por tarefa, e 52,011 deles, 75%, eram raciocínio.
- Entrada: $766.79, dos quais $479.04 foram leituras de cache. Tarefas agênticas longas reenviam o contexto a cada turno, e é por isso que o desconto de 90% do cache vale o esforço de engenharia.
- A resposta que você de fato lê: $92.73. Isso é menos de 6% da fatura.
A unidade útil, então, é o custo por tarefa. A Artificial Analysis coloca o Large 4 em $1.13 por tarefa do índice a preço de tabela, o que dá aproximadamente $0.57 na tarifa promocional se cada medidor cair pela metade. Ao lado, a tabela compara modelos que ficam perto dele no mesmo índice.
| Modelo | Intelligence Index | Preço entrada / saída por 1M | Custo por tarefa do índice | Tokens de saída por tarefa |
|---|---|---|---|---|
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.178 | 41,235 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.265 | 88,574 |
| Mistral Large 4 Preview (promoção, derivado) | 38.4 | $0.68 / $2.09 | ~$0.57 | 69,330 |
| Mistral Large 4 Preview (tabela) | 38.4 | $1.36 / $4.18 | $1.132 | 69,330 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.243 | 71,003 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.000 | 48,455 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.012 | 74,810 |
Todos os números vêm da página da Artificial Analysis de cada modelo, consultadas em 8 de outubro de 2026; a linha com a tarifa promocional é conta minha. Minha leitura é que, mesmo em promoção, o Large 4 custa por tarefa cerca do dobro do DeepSeek V4.1 Flash para uma pontuação a cerca de um ponto de distância (as tarifas do modelo mais antigo estão no meu guia de preços do DeepSeek V4 Flash). Ele é mais barato por tarefa que o Kimi K3, mas o Kimi pontua 5 pontos a mais. O mesmo vale para o Gemini 3.8 Flash, cujas tarifas estão no meu guia de preços do Gemini 3.8 Flash.
Leitores do Hacker News notaram a mesma tensão no dia do lançamento. Um comentarista gostou da tabela de tarifas, mas não se convenceu:
"The pricing ($.68 in/$.07 cached/$2.09 out) makes it much cheaper than Kimi K3, GLM 5.3, and Meta Muse Spark 1.3. That's great! But also much more expensive than GLM 5.3-flash and Spark 1.3 Contributor (the Meta-takes-your-data pricing of Spark 1.3)."

Outro comentarista apontou um benchmark diferente, em que o custo por teste foi na direção oposta mesmo contra um concorrente mais caro por token:
"Otherwise, behind on the broader Pareto frontier, but not by much (Vals Index: 48.05% vs. GLM-5.3's 53.51%; $13.78 vs. $7.25 per test). Many companies will prefer it over Chinease models."
Essa segunda citação é a lição inteira em uma linha: o GLM 5.3 custa mais por token na própria lista de preços da Mistral ($1.40 / $4.40 contra a tabela de $1.36 / $4.18) e ainda assim saiu mais barato por teste nessa execução, porque usou menos tokens para chegar lá.
Calculadora de custos do Mistral Large 4
Coloque seu próprio tráfego. A calculadora usa as tarifas publicadas por 1M acima, aplica os multiplicadores regional e Priority ao preço de tabela como a documentação da Mistral descreve, e trata o batch como 50% sobre a tarifa promocional. Os tokens de saída devem incluir o raciocínio, que no Large 4 tem ficado em cerca de 3 tokens de raciocínio para cada token de resposta na Artificial Analysis.
Exemplos práticos: quanto custariam três cargas de trabalho reais
Números abstratos são fáceis de aceitar sem pensar. Estas são cargas de trabalho que eu esperaria que alguém precificasse, passadas pelas tarifas publicadas.
| Carga de trabalho | Premissas | Promoção | Tabela | Regional | Priority |
|---|---|---|---|---|---|
| Chatbot de suporte | 20,000 conversas/mês, 8,000 tokens de entrada cada (70% em cache), 1,200 tokens de saída | $90.64 | $181.28 | $199.41 | $317.24 |
| Mesmo bot, sem cache | Como acima, 0% em cache | $158.96 | $317.92 | $349.71 | $556.36 |
| Tarefas agênticas | 1,000 tarefas/mês do tamanho do índice da Artificial Analysis | ~$566 | $1,132 | ~$1,245 | ~$1,981 |
| Processamento batch de documentos | 1M de documentos, 3,000 tokens de entrada + 500 de saída cada | $3,085 | $6,170 | n/a | n/a |
Três conclusões dessa tabela:
- O cache vale mais que a promoção. No bot de suporte, ativar o cache a preço de tabela ($181) quase iguala o preço promocional sem cache ($159). Se você estruturar os prompts de forma que o prompt de sistema e os trechos da base de conhecimento fiquem no início e estáveis, você mantém a maior parte dessa economia depois que a promoção acabar.
- A escolha do nível mexe mais na fatura que a escolha do modelo. O mesmo bot vai de $91 a $317 por mês dependendo apenas de qual nível da Mistral o atende.
- O trabalho batch de documentos é onde a promoção do Large 4 brilha. Se o desconto do batch se somar ao preço promocional, esse trabalho de 1M de documentos cai para cerca de $1,542. Se não, fica em $3,085, que ainda é a tarifa promocional.
Planos Vibe: você precisa mesmo da API?
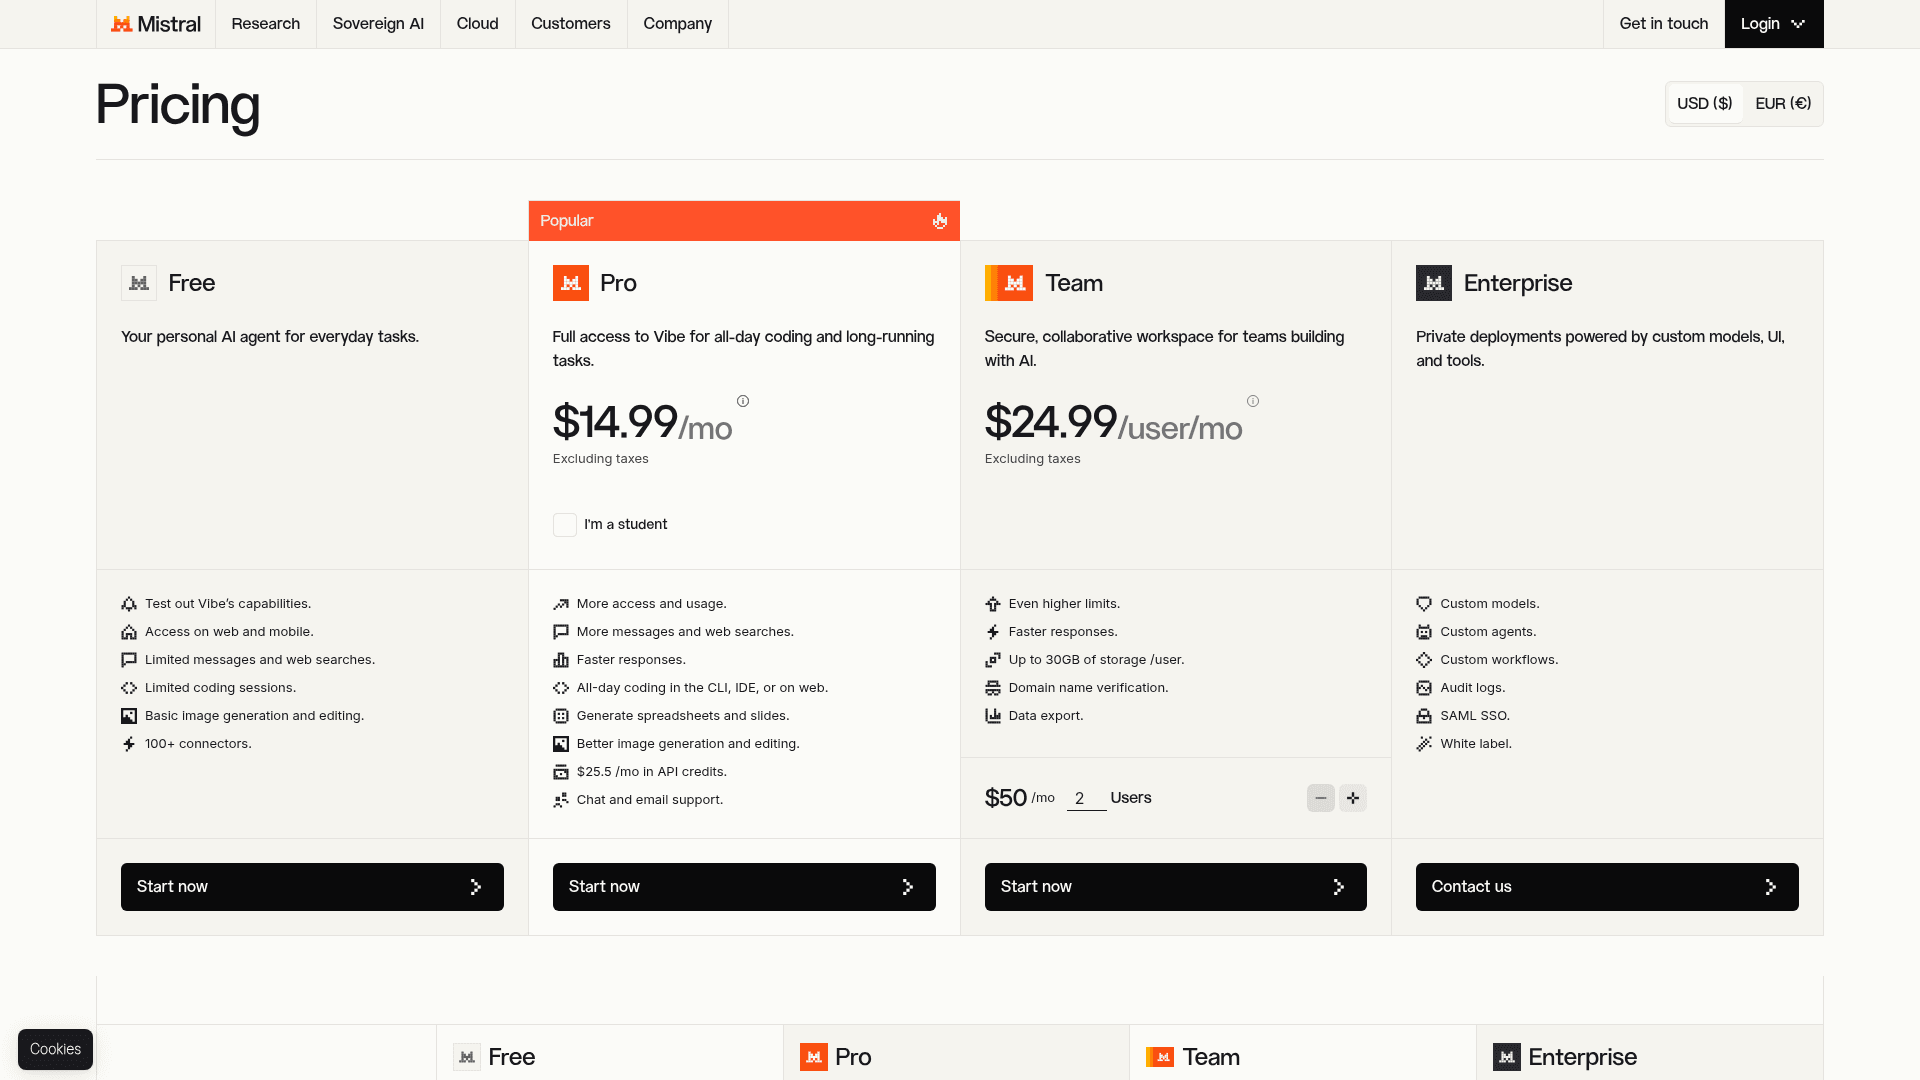
Se você só quer usar os modelos da Mistral no seu trabalho em vez de construir sobre eles, o lado do consumidor é o Vibe (o produto antes conhecido como Le Chat). Preços da página de preços da Mistral:
| Plano | Preço | O que você recebe |
|---|---|---|
| Free | $0 | Mensagens, buscas na web e sessões de programação limitadas, mais de 100 conectores, acesso ao Mistral Studio |
| Pro | $14.99/mês | Mais uso, programação o dia todo no CLI, IDE ou web, $25.50/mês em créditos de API |
| Pro (estudantes) | $5.99/mês | Estudantes verificados; $15/mês em créditos de API |
| Team | $24.99/usuário/mês | Limites maiores, até 30GB de armazenamento por usuário, verificação de domínio, exportação de dados; a calculadora da página começa em 2 usuários ($50/mês) |
| Enterprise | Fale com vendas | Modelos e agentes personalizados, logs de auditoria, SAML SSO, white label |
Um detalhe que vale destacar: o plano Pro inclui $25.50 por mês em créditos de API. Na tarifa promocional, isso dá cerca de 12M de tokens de saída do Large 4, bastante para prototipar antes de se comprometer com a API. O que a página não diz é quais planos Vibe rodam o Large 4 no próprio app de chat, então não presuma que o Free recebe o modelo principal. Meu resumo das avaliações da Mistral AI e a comparação ChatGPT vs Mistral cobrem o Vibe como ambiente de trabalho com mais profundidade.
Self-hosting: o preço depois que os pesos saírem
A Mistral diz que o Large 4 é open-weight, com os pesos previstos para "end of October." Hoje não há licença nomeada nem pesos públicos, então o preço de self-hosting ainda é uma previsão. Dois fatos moldam essa previsão.
Primeiro, o tamanho. A ficha do modelo lista 1.05T de parâmetros no total e 52B ativos, mais um codificador de visão de 1.6B. Rodar um modelo de 1T de parâmetros exige um servidor com várias GPUs, não um notebook. A resposta mais curtida ao tuíte de lançamento da Mistral disse isso melhor do que eu conseguiria:
"me with 12 GB of VRAM reading "open weights, 1.05T parameters""
Segundo, a licença. O FAQ de preços da Mistral diz que seus modelos open-weight são "Apache 2.0 licensed for research/individual use; while commercial deployments require a Mistral license with separate terms." Essa frase foi escrita sobre modelos mais antigos como o Mistral 7B, e a licença do Large 4 não foi publicada, mas é um motivo para não presumir que "open weights" significa "grátis para uso comercial". Se o seu plano é self-hosting, espere o texto da licença antes de precificar as GPUs. Enquanto isso, agentes de IA de código aberto construídos sobre modelos já lançados são a aposta mais segura.
O Mistral Large 4 vale o preço?
A resposta depende de qual ponto forte da Mistral você está pagando, então eu seria específico.
Vale a pena se:
- Você precisa de inferência hospedada na UE por um fornecedor europeu. É o caso mais claro, e mesmo a 1.1x a tabela você paga $4.60 por 1M de tokens de saída, ainda bem abaixo da maioria dos modelos de fronteira dos EUA. Um comentarista do Reddit no r/singularity resumiu a troca:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."

- Seu trabalho combina com seus pontos fortes em benchmarks. Os gráficos da Mistral o mostram liderando em defesa cibernética e no benchmark de agente jurídico da Harvey, e Lample diz que ele pontua 82% em reprodução e correção de vulnerabilidades. Para esses trabalhos, $0.57 por tarefa é bom custo-benefício.
- Você vai rodar grandes jobs batch durante a promoção. Trabalho com documentos de contexto longo a $0.68 de entrada é barato, e a Artificial Analysis pontua seu raciocínio de contexto longo em 81.3%.
Descarte se:
- Você quer o modelo mais barato neste nível de inteligência. O DeepSeek V4.1 Flash e o GPT-5.6 Luna chegam a cerca de um ponto por um terço a metade do custo por tarefa. Minha avaliação do DeepSeek V4 Flash cobre o lado da DeepSeek. Para os níveis da OpenAI, veja os preços do GPT-5.6.
- A precisão factual importa. A Artificial Analysis mediu uma taxa de alucinação de 41.9% em seu teste de conhecimento AA-Omniscience. Para qualquer coisa voltada ao cliente, isso significa ancorar cada resposta nos seus próprios documentos com RAG.
- Você precisa de preços estáveis por um ano. Um modelo em preview com aviso de descontinuação de 1 mês e uma promoção sem data é um alvo em movimento.
Para uma visão mais ampla de como o Large 4 se compara, veja minha visão geral do Mistral Large 4 ou a lista de alternativas à Mistral.
Se você está escolhendo entre fornecedores em vez de modelos, Claude vs Mistral compara os produtos completos. Meu comparativo Gemini vs Mistral também.
O que o preço por token deixa de fora para equipes de suporte
Muita gente que está precificando o Large 4 esta semana o faz para um único trabalho: um bot de suporte. Se é o seu caso, a tabela acima já mostra a parte desconfortável. Mesmo nas tarifas Priority, a conta do modelo para 20,000 conversas é de algumas centenas de dólares. O caro é tudo em volta do modelo: recuperação de informação, fallbacks, testes, a conexão com o helpdesk e também a pessoa que mantém tudo isso.
Foi essa a troca que Karel, da GENERAL BYTES, cliente da eesel, descreveu quando decidiram não construir por conta própria:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
A outra coisa que um modelo mais barato não resolve é um bot que responde quando não deveria. Com uma taxa de alucinação de 41.9% em perguntas de conhecimento, os controles importam mais que a tabela de tarifas: responder só a partir dos seus próprios documentos, passar para uma pessoa em caso de dúvida com um human in the loop e testar com tickets reais do passado antes de entrar no ar. Meu texto sobre alucinações de IA no suporte cobre os modos de falha.
Se você ainda está na fase de escolher o modelo, meus guias sobre o melhor LLM para suporte e como treinar um agente de suporte com IA aprofundam as duas metades do trabalho.
Do meu ponto de vista, o modelo é infraestrutura, e o que uma equipe de suporte quer contratar é o funcionário que o usa. Para uma visão mais ampla dessa categoria, veja o resumo dos melhores softwares de helpdesk com IA.
Experimente a eesel
Se você chegou aqui precificando o Mistral Large 4 para um bot de suporte, há um atalho. O teammate de helpdesk com IA da eesel entra na sua fila existente do Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda e roda uma simulação contra centenas dos seus tickets antigos antes de responder a qualquer cliente. É cobrado por ticket resolvido, a partir de $299 por 500 créditos na página de preços, então se o modelo por baixo pensa 1,000 ou 50,000 tokens é problema da eesel, não da sua fatura. Duas observações honestas: a eesel roda em modelos da OpenAI, Anthropic e Google, não da Mistral, e a residência de dados na UE é um adicional de $500/mês.

Desenvolvedores também podem configurá-lo por um terminal: a CLI da eesel imprime JSON em todo comando, então o Claude Code ou o Cursor podem conectar seu helpdesk, editar instruções e rodar chats de teste por você. O plano gratuito inclui 100 créditos sem cartão. Experimente a eesel.