

O GPT-6.1 Terra custa $1 por milhão de tokens de entrada e $5 por milhão de saída, com a entrada em cache a $0.05, segundo a página de preços da OpenAI. Isso é metade do GPT-6.1 Sol por token e menos da metade do antigo GPT-5.6 Terra.
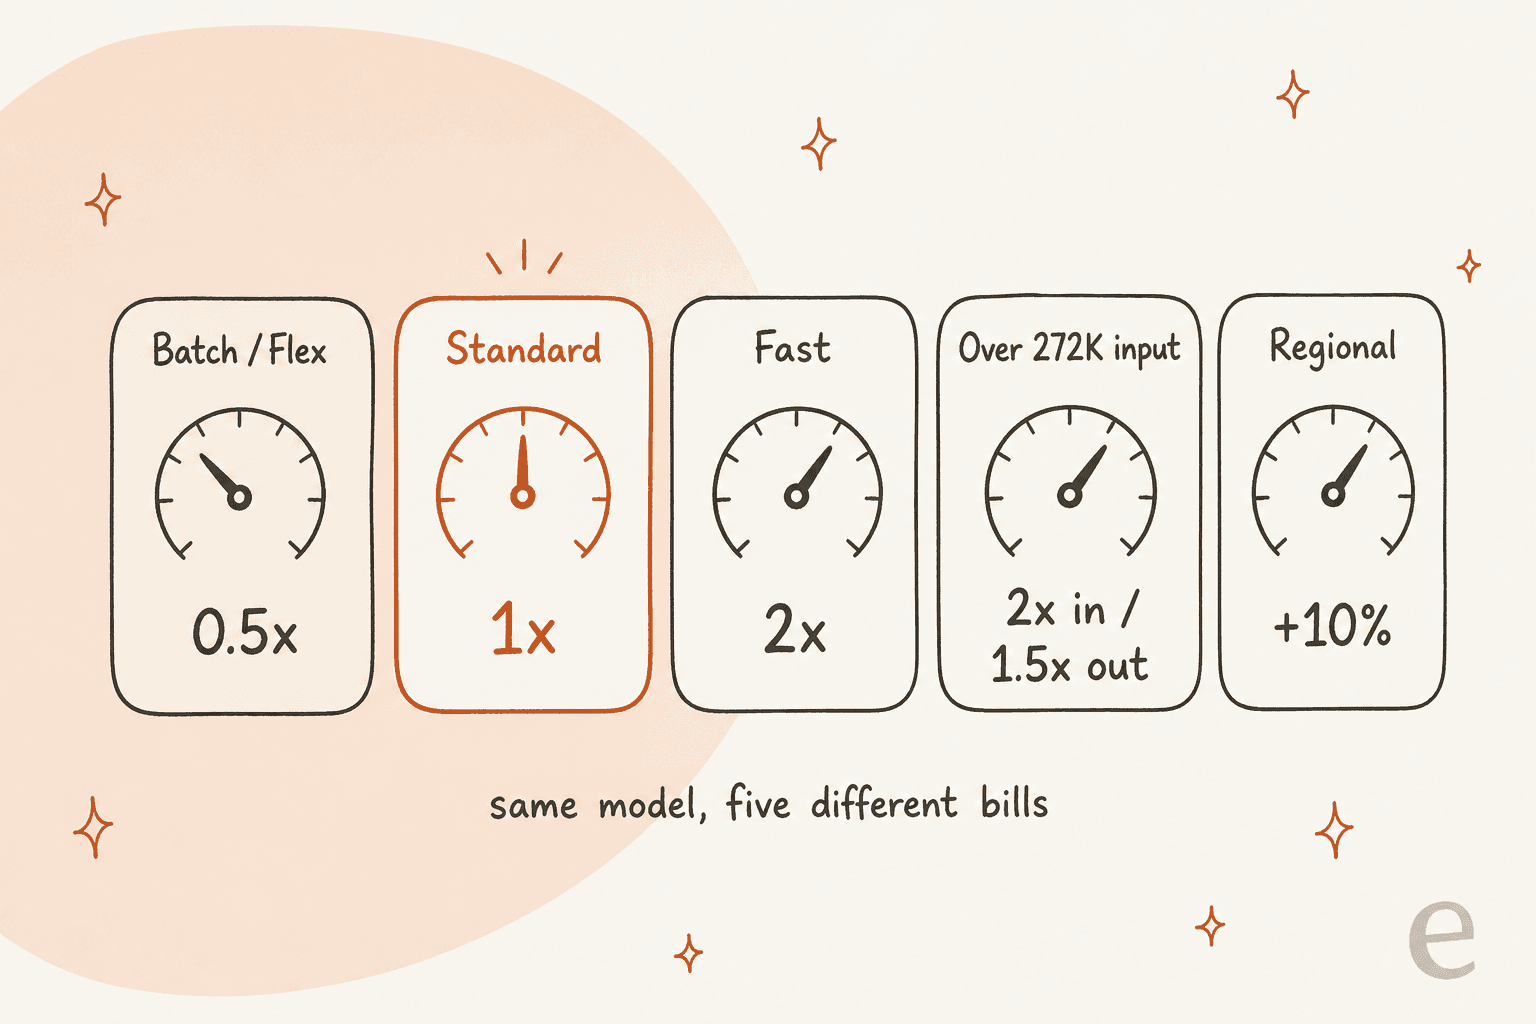
O preço de tabela, porém, não decide a sua conta. Três coisas decidem: o nível de esforço ($0.05 por tarefa em low, $0.40 em max, segundo a Artificial Analysis), a regra de contexto longo de 272K que dobra o preço da requisição inteira, e o cache, que corta a entrada em 95%, mas cobra 1.25x para gravar o cache logo de início.
Minha recomendação: rode o Terra em low ou medium, mantenha os prompts abaixo de 272K e use Batch para tudo que puder esperar. Na análise do GPT-6.1 Terra executei 80 testes com tickets de suporte, e o modelo custou menos de um centavo por ticket. Para uma equipe de suporte, os tokens são a parte barata. A smava tem cerca de 27,000 tickets em alemão por mês classificados e redigidos no Zendesk com a eesel, e o que fez isso funcionar foram 820 macros e artigos, não o preço do modelo.
Quanto custa o GPT-6.1 Terra?
O GPT-6.1 Terra custa $1.00 por milhão de tokens de entrada, $0.05 por milhão de tokens de entrada em cache e $5.00 por milhão de tokens de saída na velocidade Standard. Eu construo o lado de API das integrações da eesel, então leio páginas de preço como leio documentação de API: procurando os multiplicadores escondidos sob o número de destaque. O Terra tem cinco.
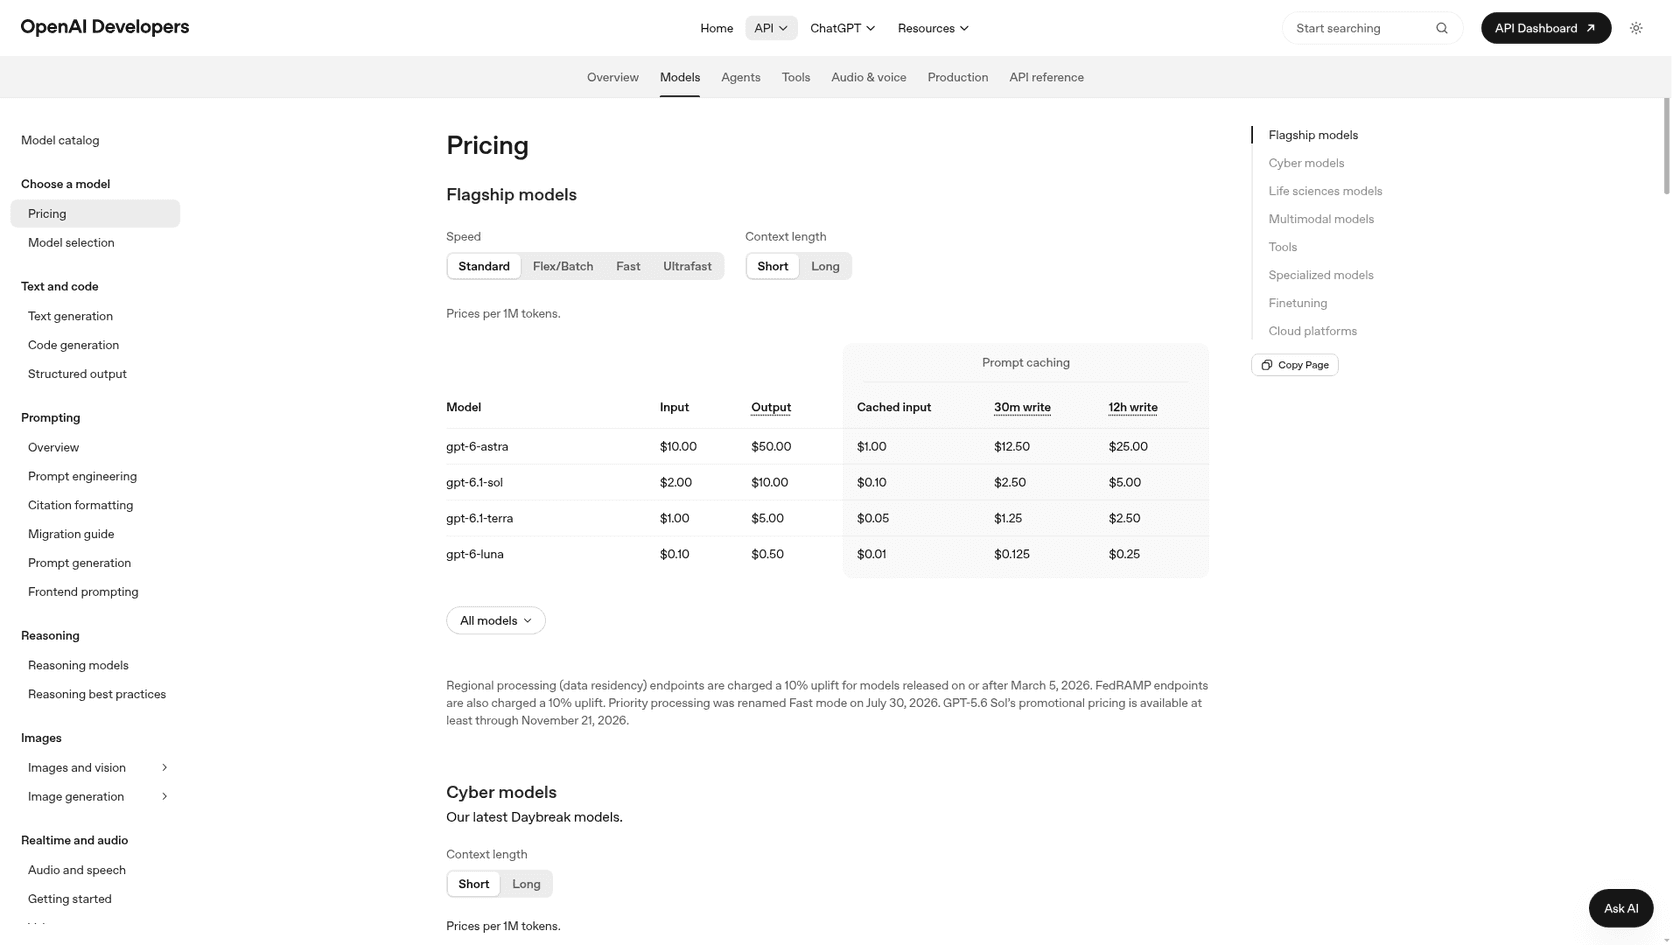
Aqui está a tabela de tarifas completa, por milhão de tokens:
| Nível | Entrada | Entrada em cache | Gravação de cache (30 min) | Gravação de cache (12 h) | Saída |
|---|---|---|---|---|---|
| Standard (até 272K de entrada) | $1.00 | $0.05 | $1.25 | $2.50 | $5.00 |
| Standard (acima de 272K de entrada) | $2.00 | $0.10 | $2.50 | $5.00 | $7.50 |
| Batch / Flex | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Fast | $2.00 | $0.10 | $2.50 | $5.00 | $10.00 |
| Ultrafast | Não oferecido |
Fonte: preços da API da OpenAI e a página do modelo GPT-6.1 Terra. Processamento regional (residência de dados) e endpoints FedRAMP acrescentam 10%. O Ultrafast existe hoje apenas para Sol e Astra.
Vale ler com calma algumas coisas dessa tabela:
- Tokens de raciocínio são cobrados como saída. Todo nível de esforço acima de
noneproduz tokens de raciocínio que você nunca vê, e cada um custa$5por milhão. Por isso o esforço mexe mais na conta do que qualquer outra coisa. - Leituras de cache custam 5% da entrada, gravações custam 125%. A página do modelo diz que a entrada em cache é cobrada a 5% da tarifa sem cache, e que a gravação custa
$1.25para retenção de 30 minutos e$2.50para retenção de 12 horas. - O preço de contexto longo cobre a requisição inteira. A redação da OpenAI é "2x input and cache rates and 1.5x output for the full request." Um token além de 272K e todos os tokens dessa chamada custam mais.
Se você precisa do catálogo inteiro da OpenAI lado a lado, o guia de preços da API da OpenAI traz todos os modelos, e a lista de modelos da OpenAI explica onde cada um se encaixa.
Quanto uma tarefa do GPT-6.1 Terra realmente custa?
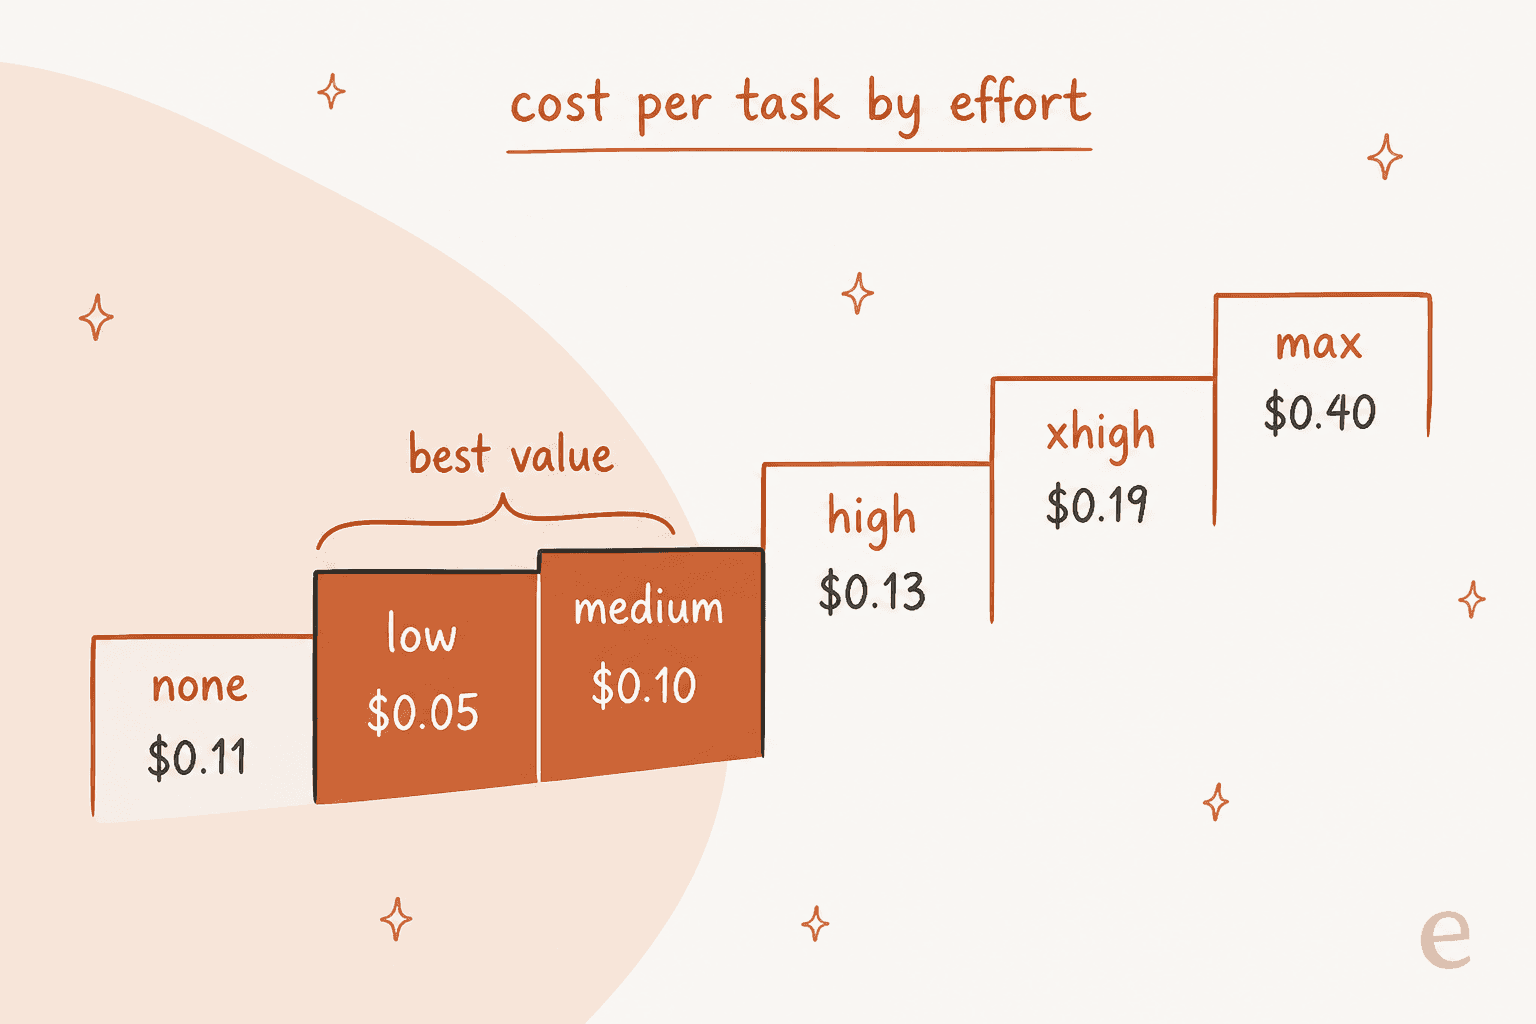
Uma tarefa custa de $0.05 a $0.40 no conjunto de testes da Artificial Analysis, e o ajuste de esforço é toda a diferença. Mesmo modelo, mesmo preço por token, variação de 8x:
| Esforço do Terra | Intelligence Index | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|
none (sem raciocínio) | 33.5 | $0.11 | n/d |
low | 36.2 | $0.05 | 29s |
medium | 41.3 | $0.10 | 63s |
high | 43.9 | $0.13 | 96s |
xhigh | 45.4 | $0.19 | 160s |
max | 48.1 | $0.40 | 384s |
Fonte: páginas de modelo por esforço da Artificial Analysis. A Artificial Analysis chama low e medium de ajustes ótimos de Pareto, ou seja, nenhum modelo que ela acompanha é ao mesmo tempo mais barato e mais inteligente nesses pontos.
Dois detalhes me surpreenderam. Primeiro, none custa mais por tarefa que low nesse conjunto, o oposto do que os nomes sugerem. simonw viu algo parecido em um teste no dia do lançamento no Hacker News: os dois ajustes gastaram zero tokens de raciocínio no prompt dele, e mesmo assim low saiu mais barato. Não presuma que none é o ajuste econômico; meça.
Segundo, o esforço máximo é onde o Terra deixa de ser a opção barata. Ir de medium para max custa 4x mais e leva 6x mais tempo por 7 pontos a mais no índice. Nesse ponto, o GPT-6.1 Sol em medium ($0.21 por tarefa, índice 47.8) entrega mais ou menos a mesma nota por cerca de metade do dinheiro. Os leitores do Hacker News chegaram a essa conta em poucas horas:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."

E de alguém que usa em produção:
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."
Isso bate com o que medi na minha própria análise do Terra. Em 16 tickets de suporte pela Responses API, o Terra em low teve a mesma pontuação que em medium e custou $0.75 por 1,000 tickets em vez de $0.92:
| Configuração | Corretos (de 16) | Custo por 1,000 tickets | Tempo médio |
|---|---|---|---|
Terra, none | 15 (1 falha) | $0.65 | 2.5s |
Terra, low | 15 | $0.75 | 2.7s |
Terra, medium | 15 | $0.92 | 3.1s |
GPT-6.1 Sol, medium | 16 | $1.62 | 3.9s |
GPT-6 Luna, medium | 15 | $0.14 | 4.1s |
O ajuste none foi o mais barato, mas disse a um cliente falante de espanhol que a mudança de endereço dele estava "anotada" quando não tinha ferramenta nenhuma para mudar coisa alguma. São 10 centavos de economia por 1,000 tickets, pagos com uma promessa que sua equipe não pode cumprir. Eu começaria em low.
Por que um prompt longo custa o dobro?
Porque a tarifa de contexto longo vale para a requisição inteira, não só para os tokens além da linha. Abaixo de 272K tokens de entrada você paga $1/$5. Acima, a chamada toda é cobrada a $2/$7.50.
O salto é grande. Uma requisição com 270K de entrada e 2K de saída custa $0.28. Some mais 10K de entrada e ela custa $0.58, mais que o dobro, por 4% a mais de texto.
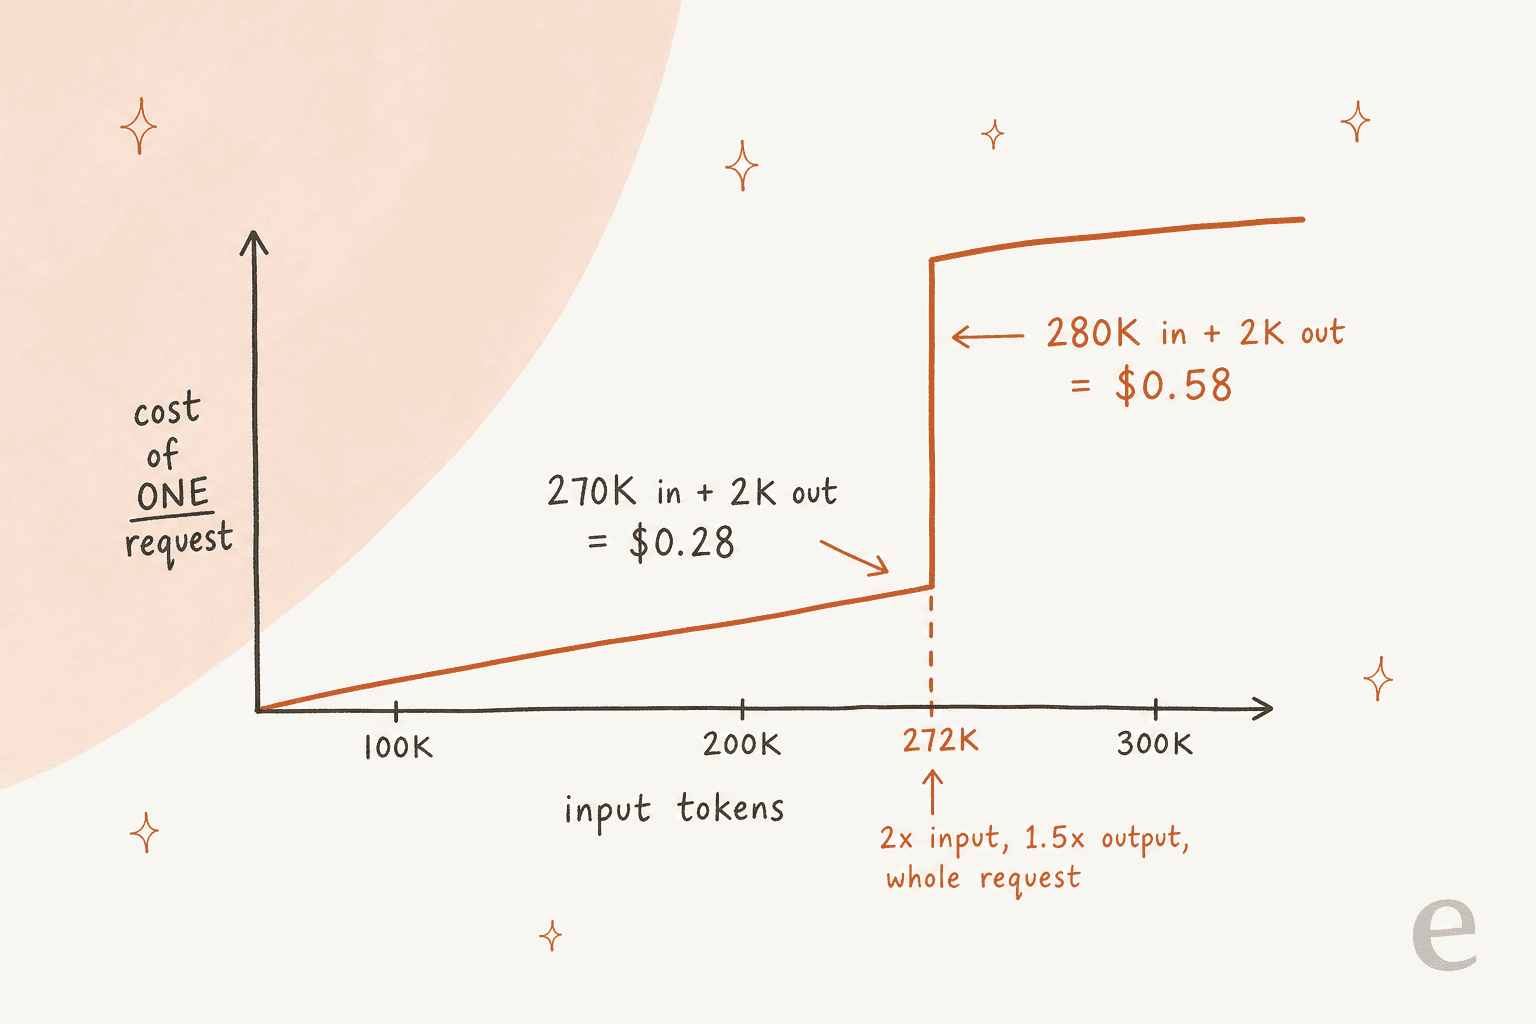
A janela de contexto do Terra é de 1,050,000 tokens, então ele aceita numa boa um contrato ou um despejo de logs de 400K tokens. Veja quanto isso custa, e quanto custa dividir:
| Abordagem | Conta | Custo |
|---|---|---|
| Uma requisição de 400K tokens, 4K de saída | 400K x $2 + 4K x $7.50 | $0.83 |
| Duas requisições de 200K tokens, 4K de saída cada | 2 x (200K x $1 + 4K x $5) | $0.44 |
Dividir economiza 47%, desde que a tarefa sobreviva à divisão. Resumos, extração e revisão por seção geralmente sobrevivem. Uma pergunta que precisa do documento inteiro de uma vez, não, e aí você paga a tarifa de contexto longo.
O jeito silencioso de cruzar a linha é um loop de agente. Cada turno reenvia a conversa, então uma sessão que começa em 50K pode passar de 272K lá pelo turno 20 sem ninguém notar. Se você roda o Terra como agente, registre os tokens de entrada por chamada e corte ou resuma o histórico antes de chegar lá. O guia de function calling da OpenAI mostra como os resultados de ferramentas entram nesse histórico.
O cache de prompts economiza dinheiro no Terra?
Sim, quando o tráfego é constante. A entrada em cache custa $0.05 por milhão, 95% de desconto. A pegadinha é a gravação: guardar um prefixo no cache custa $1.25 por milhão por 30 minutos, ou $2.50 por 12 horas, o que é mais do que enviá-lo sem cache.
Pegue uma resposta de suporte com um prompt de sistema e um bloco de políticas de 4,000 tokens que nunca mudam, 2,000 tokens de ticket e contexto da central de ajuda que mudam, e 400 tokens de saída:
| Cenário | Por ticket | Por 1,000 tickets |
|---|---|---|
| Sem cache | $0.0080 | $8.00 |
| Prefixo em cache e lido (fila cheia) | $0.0042 | $4.20 |
| Prefixo gravado toda vez (um ticket a cada 30 min) | $0.0090 | $9.00 |
Numa fila cheia, o prefixo é gravado uma vez por janela e lido milhares de vezes, então o cache quase reduz a conta pela metade. Numa fila parada, em que cada requisição chega depois de o cache expirar, você paga o acréscimo de gravação toda vez e termina cerca de 12% pior do que sem cache.
O guia de modelos da OpenAI diz para acompanhar cached_tokens e cache_write_tokens para entender o custo líquido, e esse é o hábito certo. A retenção de 12 horas só compensa quando um prefixo é reutilizado ao longo de horas, mas com menos de 30 minutos entre usos, como num job noturno.
Quanto o Terra custa por mês?
Aqui está uma carga de trabalho precificada em todos os níveis: 1 milhão de requisições por mês, cada uma com 2,000 tokens de entrada e 300 de saída.
| Nível | Custo de entrada | Custo de saída | Total mensal |
|---|---|---|---|
| Standard | $2,000 | $1,500 | $3,500 |
| Batch / Flex | $1,000 | $750 | $1,750 |
| Fast | $4,000 | $3,000 | $7,000 |
| Standard + regional | $2,200 | $1,650 | $3,850 |
O Batch é a economia mais fácil. Se os resultados podem chegar dentro da janela de batch (classificação, resumos noturnos, cargas retroativas), você paga metade. O guia da Batch API da OpenAI cobre a configuração. O modo Fast só faz sentido para chamadas voltadas ao usuário em que a latência faz você perder um cliente.
Para precificar a sua própria carga, coloque seus números aqui:
Os valores padrão são um mês de 100,000 tickets com um prompt de 6,000 tokens, o que dá cerca de $800. Coloque o tamanho real do seu prompt, não o do seu protótipo. Trechos recuperados da central de ajuda e o histórico da conversa costumam deixar um prompt de 5x a 10x maior do que você esperava.
Como o preço do Terra se compara ao de outros modelos?
O Terra é o segundo degrau da escada de quatro modelos da OpenAI. Aqui está a mesma carga de 1 milhão de requisições (2,000 de entrada, 300 de saída) na família da OpenAI e nos rivais mais próximos:
| Modelo | Entrada / saída por 1M | Entrada em cache | Custo AA por tarefa | Conta mensal (exemplo) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | n/d | $350 |
| GPT-6.1 Terra | $1.00 / $5.00 | $0.05 | $0.40 (max) | $3,500 |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | $0.21 (medium) | $7,000 |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | $3.26 (max) | $35,000 |
| GPT-5.6 Terra (anterior) | $2.00 / $12.00 | n/d | $1.40 (max) | $7,600 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $0.10 | $0.88 (high) | $7,000 |
| Claude Haiku 5.5 | $0.10 / $0.50 | $0.01 | $0.08 (high) | $350 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fora do horário de pico | $0.003 | $0.26 (max) | $480 |
| Gemini 3.8 Flash | $0.75 / $3.75 até 31 de dez. | $0.075 | $3.49 (high) | $2,625 |
Fontes: preços da API da OpenAI, a página de preços de cada fornecedor em 28 de outubro de 2026, e a Artificial Analysis para o custo por tarefa. O preço do Haiku vale até um prompt de 100K.
Em relação ao antecessor, a queda é real. A thread de lançamento da OpenAI disse isso de forma simples:
"It's a significant step up over GPT‑5.6 Terra, with 50% lower standard API prices."
No nível do token, o Terra fica no meio da tabela: 10x o Luna e o Haiku, metade do Sol e do Sonnet. Por tarefa, está entre os modelos mais baratos com Intelligence Index acima de 45. Se o seu trabalho é marcação e roteamento simples, o Luna a um décimo do preço é a melhor compra. Se é programação difícil, a própria OpenAI aponta para o Sol ou o GPT-6 Astra. O post sobre alternativas ao GPT-6.1 Terra percorre cada opção em detalhe.
Quanto o Terra custa no ChatGPT e no Codex?
Não existe preço separado do Terra no ChatGPT. Ele vem com os planos Plus, Pro, Enterprise e Edu no ChatGPT Work e no Codex, segundo o post de lançamento da OpenAI. A OpenAI diz que sua cota de uso rende mais com o Terra do que com o GPT-5.6 Terra, e muito mais do que com o Sol ou o Astra.
Então, numa assinatura, escolher o Terra não reduz a conta, estica a cota. Se você bate nos limites com o Sol em trabalho de rotina, mover essas tarefas para o Terra é a solução barata. Os guias de preços do ChatGPT Work e de preços do Codex cobrem o que cada plano inclui, e o ChatGPT Enterprise explica o nível de workspace.
Quais são os custos ocultos e os limites?
A maioria é pequena isoladamente e soma no conjunto. Esta é a lista que eu checaria antes de me comprometer:
- Sem nível gratuito de API. A página do modelo lista Free como "Not supported." Você precisa de uma conta paga desde a primeira chamada.
- Os limites de taxa começam baixos. O nível Build dá
5,000requisições e1,000,000tokens por minuto. Com 2,300 tokens por requisição, são cerca de 430 requisições por minuto. O Launch vai a4,000,000TPM e o Grow a40,000,000. O guia de limites de taxa da OpenAI explica como subir. - Chamadas de ferramentas custam à parte. Busca na web e busca de arquivos são cobradas por chamada ou por GB além dos tokens, e os tokens usados por ferramentas integradas são cobrados às tarifas do Terra, segundo a página de preços.
- Processamento regional é +10%. Residência de dados e endpoints FedRAMP carregam o acréscimo para modelos lançados a partir de 5 de março de 2026, o que inclui o Terra.
- Novas tentativas e avaliações. Uma chamada de ferramenta que falha ou uma resposta que você regenera é cobrada por inteiro. Reserve uma margem e rode avaliações de agentes da OpenAI em um conjunto fixo antes de mudar níveis de esforço, para comparar custos com a mesma qualidade.
| Nível de limite de taxa | Requisições por minuto | Tokens por minuto | Limite da fila de Batch |
|---|---|---|---|
| Free | Não compatível | ||
| Build | 5,000 | 1,000,000 | 3,000,000 |
| Launch | 10,000 | 4,000,000 | 200,000,000 |
| Grow | 15,000 | 40,000,000 | 15,000,000,000 |
Fonte: página do modelo GPT-6.1 Terra.
O GPT-6.1 Terra vale a pena para atendimento ao cliente?
Para rascunho e triagem, sim, e a conta de tokens é a menor linha do orçamento. Um ticket de suporte realista, com um prompt de 6,000 tokens, custa cerca de $0.008 no Standard. Um mês de 10,000 tickets são $80 em custos de modelo, ou uns $42 com um prefixo em cache.
O que realmente custa dinheiro a uma equipe de suporte é a resposta errada. No meu teste, o ajuste mais barato disse a um cliente que uma mudança de endereço estava feita quando não estava, e esse único ticket custaria mais em acompanhamento e reembolso do que um ano de economia em tokens. A eesel passou anos colocando agentes de IA em filas de suporte reais e construindo as integrações para eles, e eu continuo reaprendendo a mesma lição: o modelo é a metade menor do trabalho. A metade maior é o que ele lê, o que ele pode fazer e quando passa para uma pessoa. A análise do custo da IA no atendimento ao cliente cobre o quadro completo, e as alucinações de IA no suporte tratam do tipo de falha descrito acima.
O caso da smava mostra como é essa metade. O agente da eesel dela trabalha dentro do IA para Zendesk, cuida de cerca de 27,000 tickets por mês em duas marcas de crédito, preparou 15,300 rascunhos de resposta em um mês e redige a partir das 820 macros e artigos da central de ajuda que a equipe já mantém no Zendesk. Em finanças reguladas, uma resposta que promete algo que a equipe não vai cumprir é dano real, e por isso o texto vem das macros, não da imaginação do modelo. A Dokument 24 usa o mesmo padrão em dinamarquês: 670 rascunhos de resposta por mês ficam como notas internas para a equipe revisar e enviar, um bom encaixe para o atendimento ao cliente multilíngue.
Experimente a eesel
Se você está avaliando o preço do Terra porque quer uma IA que redija ou responda tickets, talvez nem precise montar o pipeline. A eesel é uma plataforma de colegas de IA, e seu agente de IA para helpdesk entra na sua fila atual do Zendesk, Freshdesk ou Gorgias, aprende com seus tickets antigos e sua central de ajuda, e redige ou responde com as regras de escalonamento que você definir. Você pode testá-lo nos seus próprios tickets históricos antes que ele toque num cliente real.
O preço é por ticket, não por token: os planos da eesel começam em $299 por mês por 500 créditos, em que um ticket é um crédito não importa quão longa seja a conversa, com 100 créditos grátis para experimentar. Isso deixa a escolha do modelo, o tamanho do prompt e a regra de 272K do lado da eesel da mesa, em vez do seu. A SamCart roda um agente em tickets do Freshdesk e outro no chat do site, ambos respondendo a partir de 280 artigos da central de ajuda.
Se você prefere controlar por código, a CLI da eesel opera o mesmo colega a partir de um terminal, e todo workspace também é um servidor MCP, então uma sessão do Codex rodando o GPT-6.1 Terra pode chamar seu agente de suporte como ferramenta. Experimente a eesel e veja os rascunhos nos seus próprios tickets.
Perguntas frequentes
Quanto custa o GPT-6.1 Terra?
Quanto custa o GPT-6.1 Terra por tarefa?
O GPT-6.1 Terra é mais barato que o GPT-6.1 Sol?
Qual é o preço de contexto longo do GPT-6.1 Terra?
O GPT-6.1 Terra tem plano gratuito?
gpt-6.1-terra, e os limites de taxa começam em 5,000 requisições e 1 milhão de tokens por minuto no nível Build. O guia de limites de taxa da OpenAI explica como os níveis sobem. No ChatGPT, o Terra vem com os planos Plus, Pro, Enterprise e Edu.