

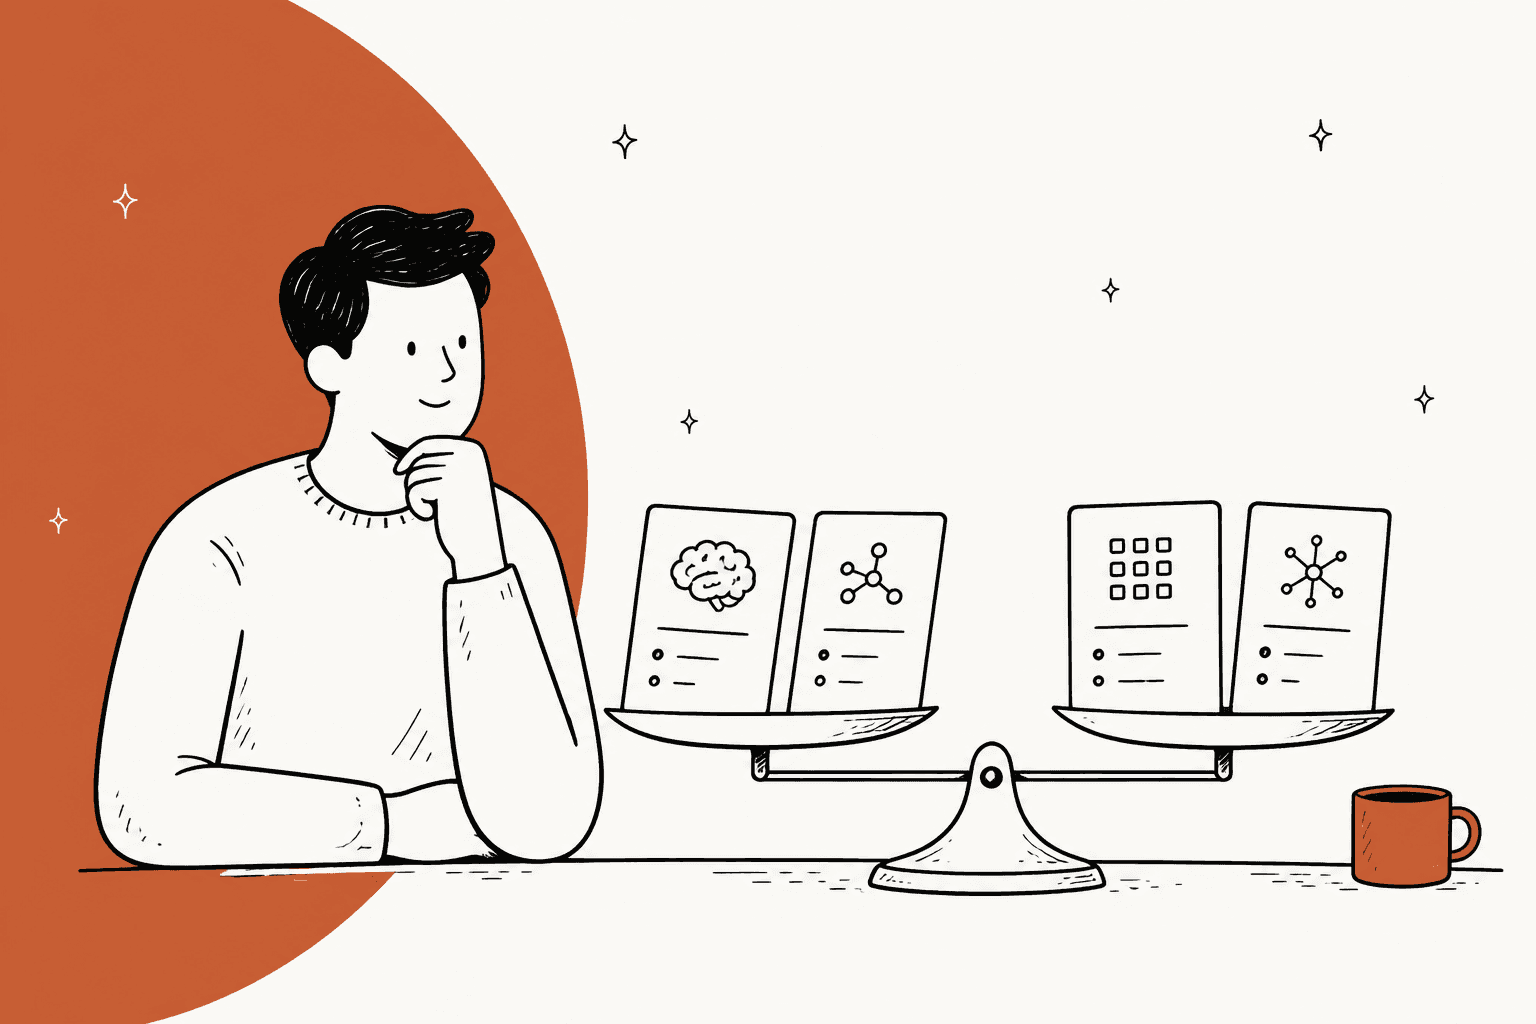
A melhor alternativa ao GPT-6.1 Terra para a maioria das equipes é o GPT-6.1 Sol com esforço médio, o que parece ao contrário porque o Sol custa o dobro por token. Por tarefa, isso se inverte: a Artificial Analysis dá ao Sol medium 47.8 por $0.21 a tarefa, enquanto o Terra em max marca 48.1 por $0.40. Se você ia levar o Terra ao esforço máximo, troque de modelo em vez disso.
Se você quer sair da OpenAI: o Claude Sonnet 5.5 para programação e agentes ($2/$10), o DeepSeek V4.1 Flash para a menor fatura ($0.15/$0.60 fora do pico, pesos abertos) e o Gemini 4 Argon para o raciocínio mais difícil, com um preço promocional que dobra em 1º de dezembro. Num mês de 1 milhão de requisições, a fatura a preço de tabela vai de $480 no DeepSeek a $7,000 no Sol ou no Sonnet, contra $3,500 no Terra.
Se o modelo é para uma fila de suporte, o modelo importa menos do que você pensa. Na minha análise do GPT-6.1 Terra, o Terra acertou 15 de 16 tickets contra 16 do Sol, e o único erro foi uma regra de escalonamento, não falta de inteligência. Essa regra mora na camada que a eesel cuida, do jeito que a Koffer.ch a executa no Freshdesk, com cada resposta como rascunho.
Por que olhar além do GPT-6.1 Terra?
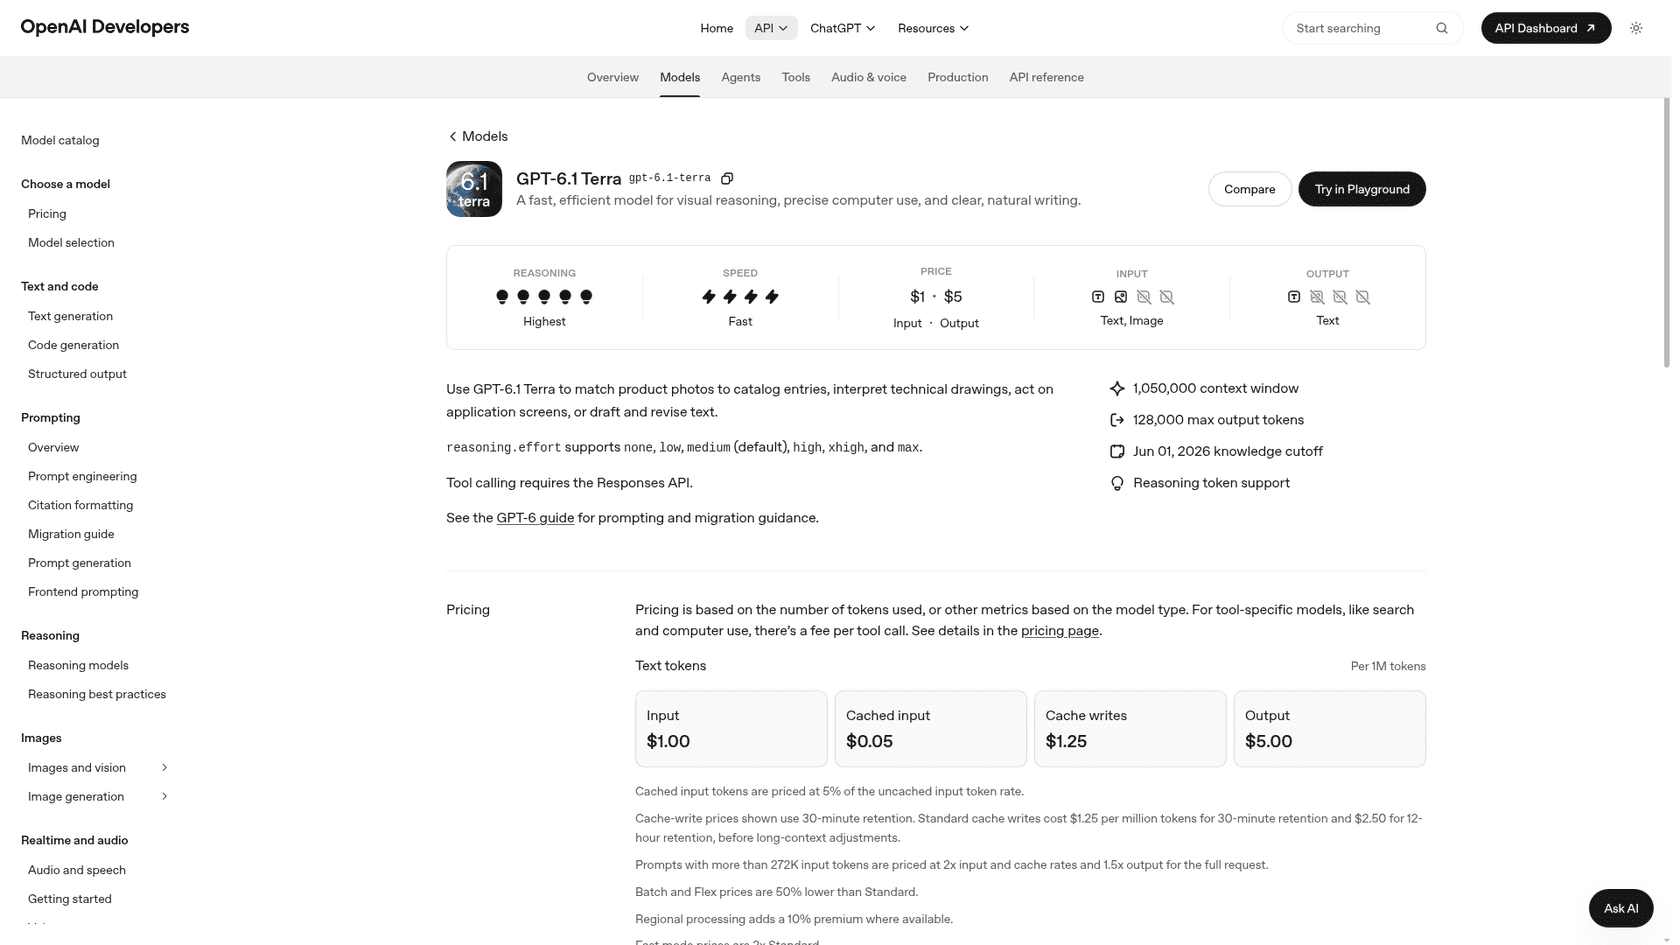
Digo primeiro: o Terra é um bom modelo. O GPT-6.1 Terra foi lançado em 26 de outubro de 2026 a $1 por milhão de tokens de entrada e $5 por milhão de saída. Tem uma janela de contexto de 1,050,000 tokens, além de um nível de raciocínio none que o Sol e o Astra não têm. Nos meus próprios tickets de suporte, foi o modelo mais rápido que testei, de 2.5s a 3.1s cada.
Ainda assim, as pessoas procuram outra coisa, e geralmente se resume a isto:
- Fica caro quando você aumenta. O Intelligence Index do Terra sobe de
36.2com esforço baixo para48.1em max. Já o custo por tarefa vai de$0.05a$0.40, e o tempo por tarefa de29sa384s, segundo a Artificial Analysis. Se você leva ao máximo, paga preço de Sol por algo que não é o Sol. - Programação e trabalho em terminal ficam atrás dos modelos maiores. O Terminal-Bench 4.0 apareceu várias vezes no tópico de lançamento do Hacker News. Um comentarista colocou o Terra em max em 50%, e o Claude Opus 5.5 em 70%.
- Risco de depender de um único fornecedor. Quando todo o seu produto roda em um único modelo da OpenAI, a mudança de preço ou a queda deles também vira sua.
Um comentário cético resume bem o ponto 1:
"Terra XHigh more expensive than Sol Low and still does worse."

E aqui está o que vale ter em mente ao ler cada tabela abaixo:
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."
Como escolhi e precifiquei estas opções
Eu construo os agentes de IA que ficam nos helpdesks dos clientes da eesel, e fui eu quem rodou a avaliação do Terra com 80 tickets para a minha análise. Anos com filas ao vivo me ensinaram que o preço por token é a coisa errada para medir. Metade do preço com o dobro de novas tentativas não economiza nada em produção. Então julguei cada escolha abaixo por estes critérios:
- Preço de tabela por 1M de tokens, levantado em 28 de outubro de 2026 na página de preços de cada fornecedor.
- Custo por tarefa e Intelligence Index da Artificial Analysis. Ela roda a mesma bateria de testes em todos os modelos e registra o que cada um realmente gastou.
- Uma fatura mensal para um comprador de exemplo: imagine um produto que envia 1 milhão de requisições por mês, cada uma com 2.000 tokens de entrada e 300 de saída. Isso soma 2 bilhões de tokens de entrada e 300 milhões de saída, sem contar cache nem tokens de raciocínio.
Também fiz essa pergunta ao ChatGPT do jeito que um comprador faria. A lista curta dele foi Sonnet 5.5, Gemini 3.6 Flash, DeepSeek V4.1 Flash, Gemini 4 Argon e Grok 4.7. A maioria ficou. Troquei o Gemini 3.6 Flash pelo 3.8 Flash (mesmo preço, modelo mais novo) e acrescentei o Sol e o Haiku 5.5, que o ChatGPT deixou de fora.
Alternativas ao GPT-6.1 Terra comparadas
| Modelo | Entrada / saída por 1M | Entrada em cache | Contexto | AA Intelligence Index | AA custo por tarefa | Tempo até o primeiro token | Pesos abertos | Fatura mensal (comprador de exemplo) |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra (referência) | $1 / $5 | $0.05 | 1.05M | 48.1 (max) | $0.40 | 1.3s (low) | Não | $3,500 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | 47.8 (medium) | $0.21 | 4.4s | Não | $7,000 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 46.8 (high) | $0.88 | 3.1s (medium) | Não | $7,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 fora do pico | $0.003 | 1M | 45.1 (max) | $0.26 | 1.2s | Sim | $480 (fora do pico) |
| Gemini 3.8 Flash | $0.75 / $3.75 até 31 dez. | $0.075 | 1M | 40.9 (high) | $3.49 | 28.3s (high) | Não | $2,625 |
| Gemini 4 Argon | $2 / $10 até 30 nov. | $0.10 | 1M | 52.6 (high) | $1.62 | 48.2s | Não | $7,000 |
| Grok 4.7 | $2 / $6 | n/d | 500K | 46.3 (high) | $2.36 | 5.4s (low) | Não | $5,800 |
| Claude Haiku 5.5 | $0.10 / $0.50 até 100K de prompt | $0.01 | 1M | 37.8 (high) | $0.08 | 26.7s (high) | Não | $350 |
Duas coisas se destacam. O DeepSeek V4.1 Flash custa cerca de 7x menos que o Terra na fatura e fica a menos de 3 pontos no índice. Depois há o Gemini 3.8 Flash: barato por token, mas um dos mais caros por tarefa, porque pensa muito antes de responder. O índice, o custo por tarefa e os tempos até o primeiro token vêm todos das páginas de modelos da Artificial Analysis, no esforço mostrado entre parênteses.
1. GPT-6.1 Sol
Melhor para: equipes que já usam a API da OpenAI e precisam de melhor julgamento sem mudar uma linha de código de integração.
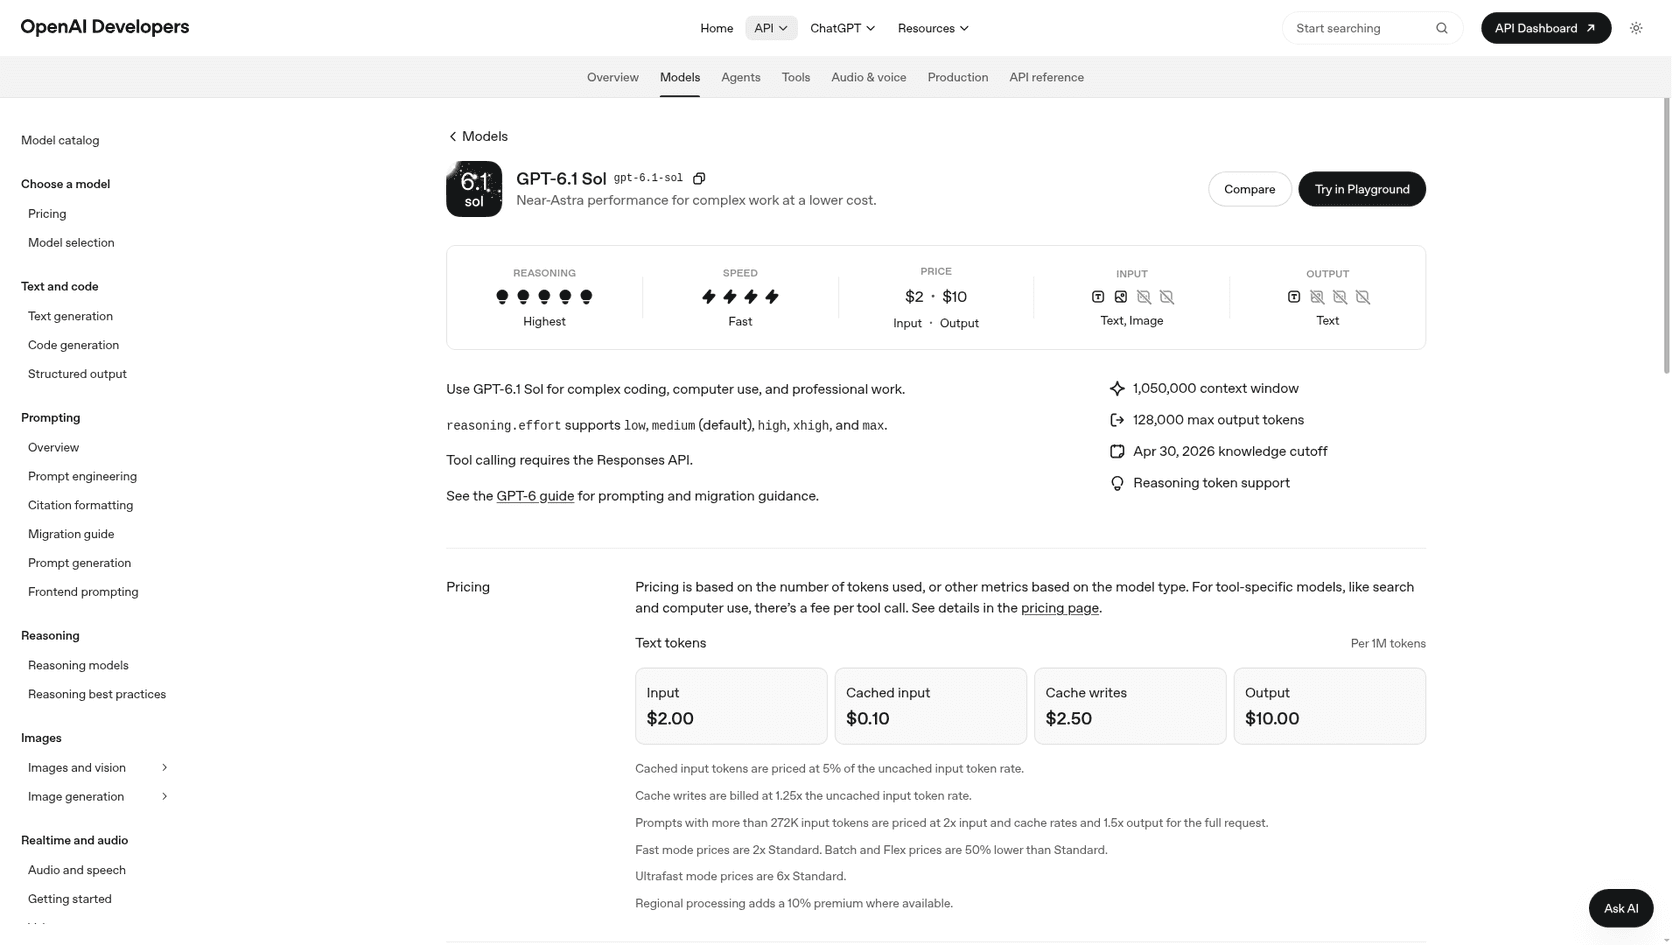
Pense no Sol como o irmão maior do Terra. Ele fica um degrau acima na escada da OpenAI, entre o Terra e o GPT-6 Astra. A API, as ferramentas e a geração gpt-6.1 são as mesmas, então trocar significa apenas mudar o nome do modelo.
Vantagens
- O Sol com esforço médio iguala o Terra em max no índice da Artificial Analysis, por cerca de metade do custo por tarefa (
$0.21vs$0.40). - No meu teste de suporte, o julgamento dele foi o melhor: 16 de 16. Foi também a única configuração que escalou uma mudança de endereço em espanhol que ele não conseguia fazer.
- A AA coloca a taxa de alucinação dele com esforço alto em
49%, contra38%do Terra em max. Então não é o modelo mais cuidadoso com fatos. Onde ele vence é nas decisões de casos extremos.
Desvantagens
- É mais lento. A AA mede cerca de
54tokens de saída por segundo em medium contra91do Terra, e um primeiro token de4.4scontra1.3sdo Terra em low. - Requisições curtas e fáceis custam mais no Sol. Meu teste saiu a
$1.62por 1.000 tickets, comparado com$0.75do Terra em low. - Não há esforço
none, o que significa que não existe um caminho rápido sem raciocínio.
Preços: $2 de entrada, $0.10 em cache, $10 de saída por 1M de tokens na página de preços da OpenAI. O modo em lote reduz pela metade, para $1/$5.
Minha opinião: deixe os 80% fáceis no Terra em low e roteie para o Sol em medium tudo o que precisaria de esforço alto. O caminho de upgrade a partir do Terra não é o Terra em max, é o Sol. Os números completos estão na análise do GPT-6.1 Sol.
2. Claude Sonnet 5.5
Melhor para: ferramentas de programação, agentes de terminal e uso de ferramentas em vários passos.
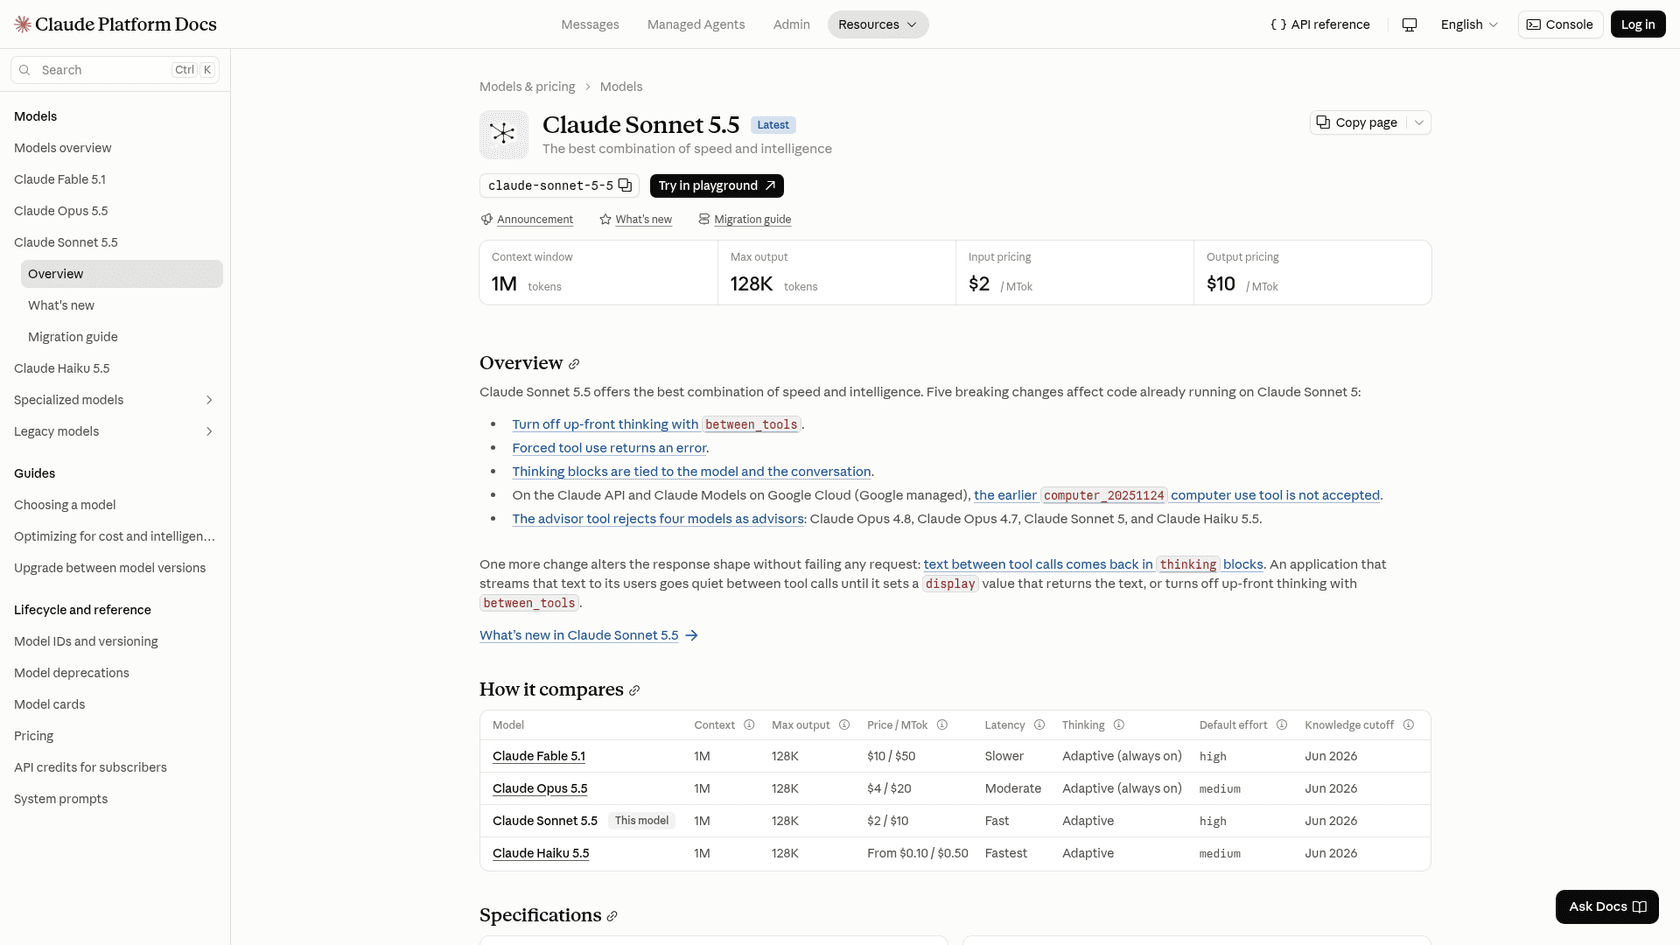
Este é o modelo intermediário da Anthropic, lançado em 28 de setembro de 2026. O ChatGPT o chamou de "best first alternative to test", e para trabalho com agentes eu diria que está certo.
Vantagens
- Os melhores números de programação da sua faixa de preço. A Anthropic reporta
70.6%no Terminal-Bench 4.0, à frente dos66.4%do Opus 5.5, e80.1%no OSWorld 2.1 para uso de computador. - Tem preço igual ao do Sol,
$2/$10, e vem com janela de contexto de 1M e 128K de saída. - Primeiro token rápido com esforço médio (
3.1sna AA) e cerca de107tokens de saída por segundo.
Desvantagens
- Com esforço alto, custa
$0.88por tarefa na AA. É mais de 4x o Sol medium, para uma pontuação de índice menor. - Na AA, a taxa de alucinação dele com esforço alto é de
65%, a mais alta entre os modelos fechados aqui. - Migrar não é indolor:
thinking: disablede umtool_choiceforçado retornam ambos um erro 400 no Sonnet 5.5, então o código feito para modelos Claude mais antigos precisará de mudanças.
Preços: $2 de entrada, $10 de saída, $0.10 para acertos de cache, segundo a página de preços da Claude. O lote é $1/$5.
Minha opinião: se o seu produto escreve ou executa código, ou conduz um navegador por longos períodos, vá de Sonnet 5.5. Tarefas curtas de texto, como rascunho e extração, rendem mais por dólar no Terra ou no Sol. A análise do Claude Sonnet 5.5 e a comparação Sol vs Opus 5.5 aprofundam mais.
3. DeepSeek V4.1 Flash
Melhor para: chat de alto volume, extração e RAG em que a fatura de tokens é a principal restrição, ou em que você quer pesos que possa hospedar.
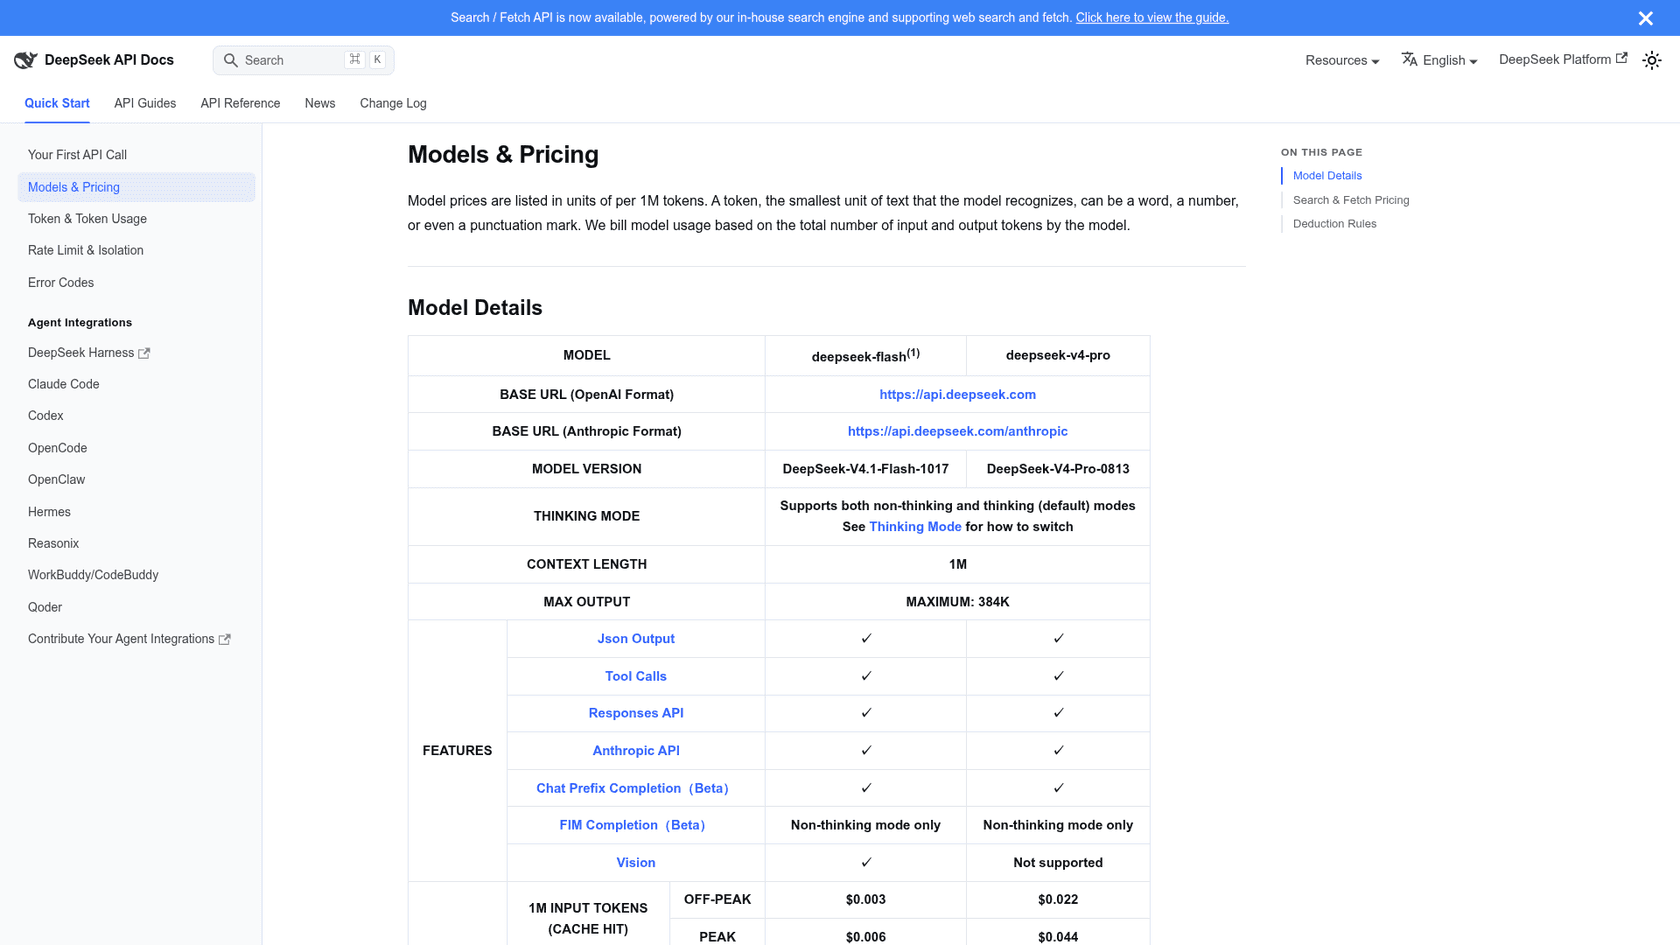
Na API, o nome agora é simplesmente deepseek-flash, e o checkpoint DeepSeek-V4.1-Flash-1017 o atende. Nomes antigos como deepseek-v4-flash continuam funcionando e são cobrados pelo preço do Flash, segundo a documentação de preços do DeepSeek.
Vantagens
- Entre os modelos daqui que pontuam acima de 45, este tem a menor fatura. O comprador de exemplo paga
$480por mês fora do pico, comparado com$3,500no Terra. - Acertos de cache custam
$0.003por 1M de tokens fora do pico, então prompts de sistema repetidos custam quase nada. - Os pesos são abertos, então você pode hospedar por conta própria quando a residência de dados importa. Ele também lê imagens, aceita chamadas de ferramentas e fala os formatos de API da OpenAI e da Anthropic.
- Tem o primeiro token mais rápido daqui,
1.2sna Artificial Analysis.
Desvantagens
- O preço de pico dobra tudo para
$0.30/$1.20. As horas de pico vão de 01:00 a 04:00 e de 06:00 a 10:00 UTC em dias úteis, o que cai bem na manhã de trabalho europeia. - A taxa de alucinação da AA para o checkpoint 1017 em max é de
67%, então mantenha-o ancorado nos seus próprios documentos. - Chamadas de Search e Fetch no lado do servidor começam a ser cobradas a
$0.75por 1.000 requisições em 1º de novembro de 2026.
Preços: $0.15 de entrada (falha de cache), $0.003 por acerto de cache, $0.60 de saída fora do pico; $0.30, $0.006 e $1.20 no pico.
Minha opinião: para tráfego em sua maioria simples, e se outro fornecedor não for problema, o DeepSeek é a troca mais barata que vale levar a sério. Um comentarista do HN resumiu a divisão sem rodeios:
"If all I want is coding at a cheaper price, then deepseek is a good model for that."
A análise do DeepSeek V4.1 Flash 1017 e o guia da API do DeepSeek mostram a configuração.
4. Gemini 3.8 Flash
Melhor para: trabalhos multimodais em lote (PDFs, vídeo, áudio) em que ninguém espera pela resposta.
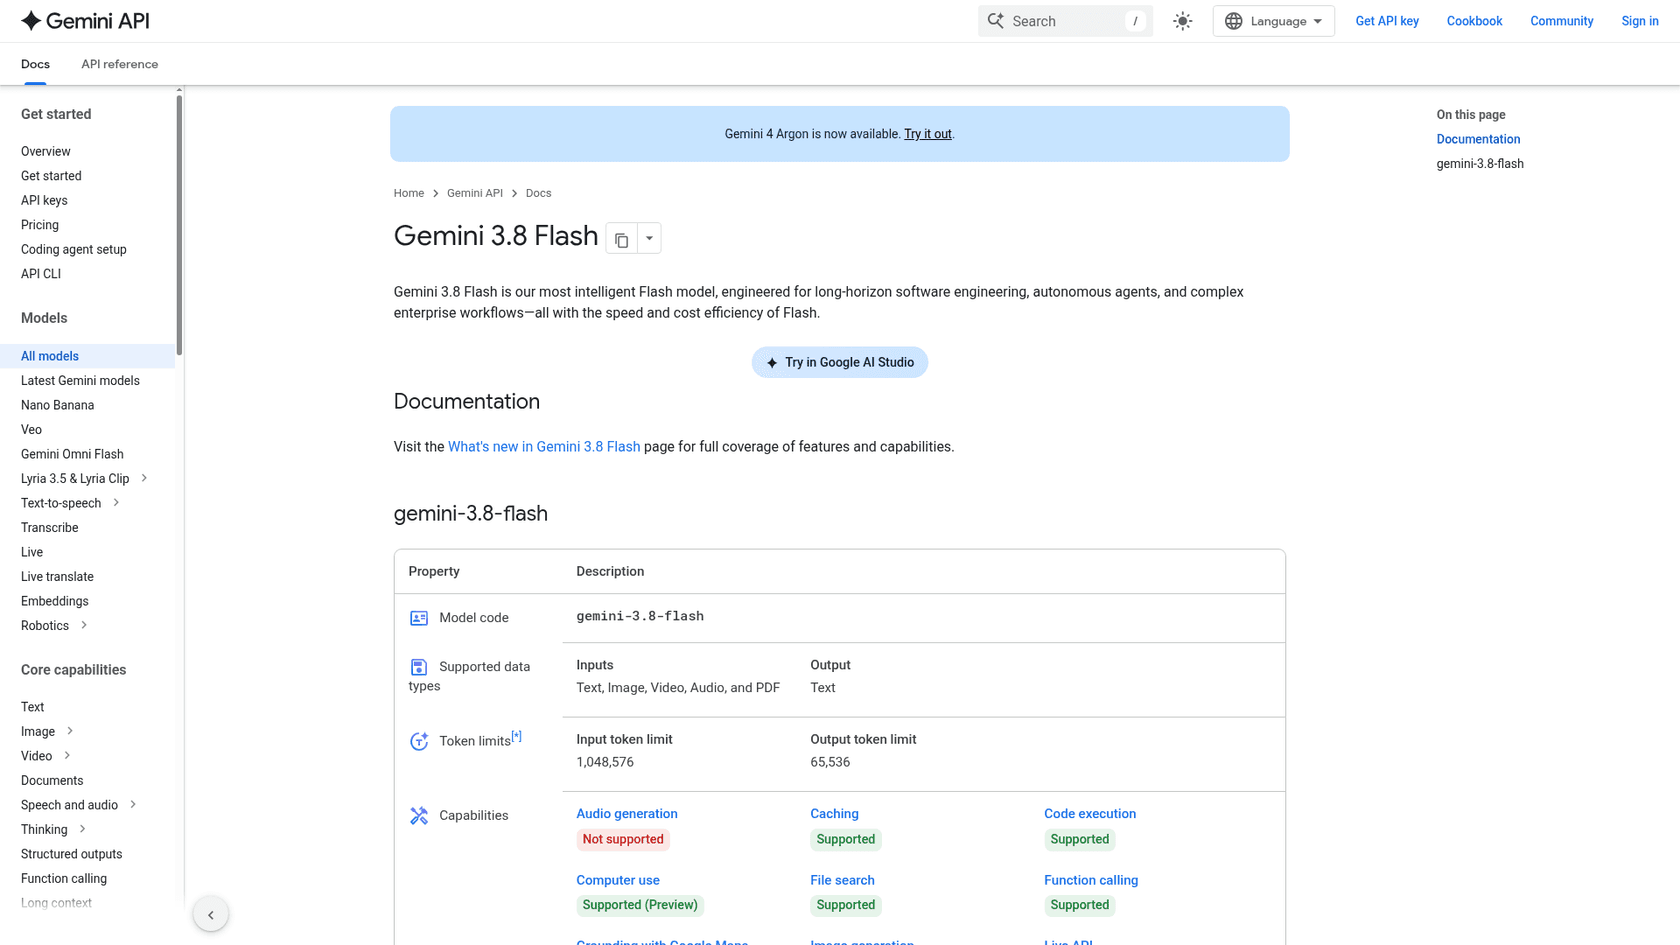
A escolha do ChatGPT para essa vaga foi o Gemini 3.6 Flash. Mas na página de preços do Gemini, o 3.6 Flash e o 3.8 Flash custam exatamente o mesmo, e o Google agora chama o 3.6 de seu "previous generation Flash model". Se você vai testar a faixa Flash do Google, teste o 3.8.
Vantagens
- Mais barato por token que o Terra até o fim de 2026:
$0.75de entrada e$3.75de saída, o que coloca o comprador de exemplo em$2,625. - Aceita entrada de texto, imagem, vídeo, áudio e PDF, mais ampla que qualquer outro modelo daqui.
- Há um plano gratuito para testes, algo que o Terra não oferece.
Desvantagens
- Em 1º de janeiro de 2027 o preço dobra para
$1.50/$7.50, ficando acima do Terra por token. - Ele pensa muito. A AA o coloca em
$3.49por tarefa e28.3saté o primeiro token com esforço alto, o que o torna pouco adequado para uma janela de chat em que alguém está olhando. - As próprias notas de lançamento do Google dizem que o 3.8 Flash pode usar mais tokens para maximizar o desempenho. A análise do Gemini 3.8 Flash traz os detalhes.
Preços: $0.75/$3.75 até 31 de dezembro de 2026, depois $1.50/$7.50. Batch e Flex custam metade.
Minha opinião: funciona bem para processamento de documentos durante a noite, precificado por tokens. Para qualquer coisa interativa, ou que ainda esteja rodando em janeiro, calcule primeiro o custo por tarefa.
5. Gemini 4 Argon
Melhor para: o raciocínio mais difícil, pesquisa e agentes autônomos longos, em que acertar a resposta vale o preço.
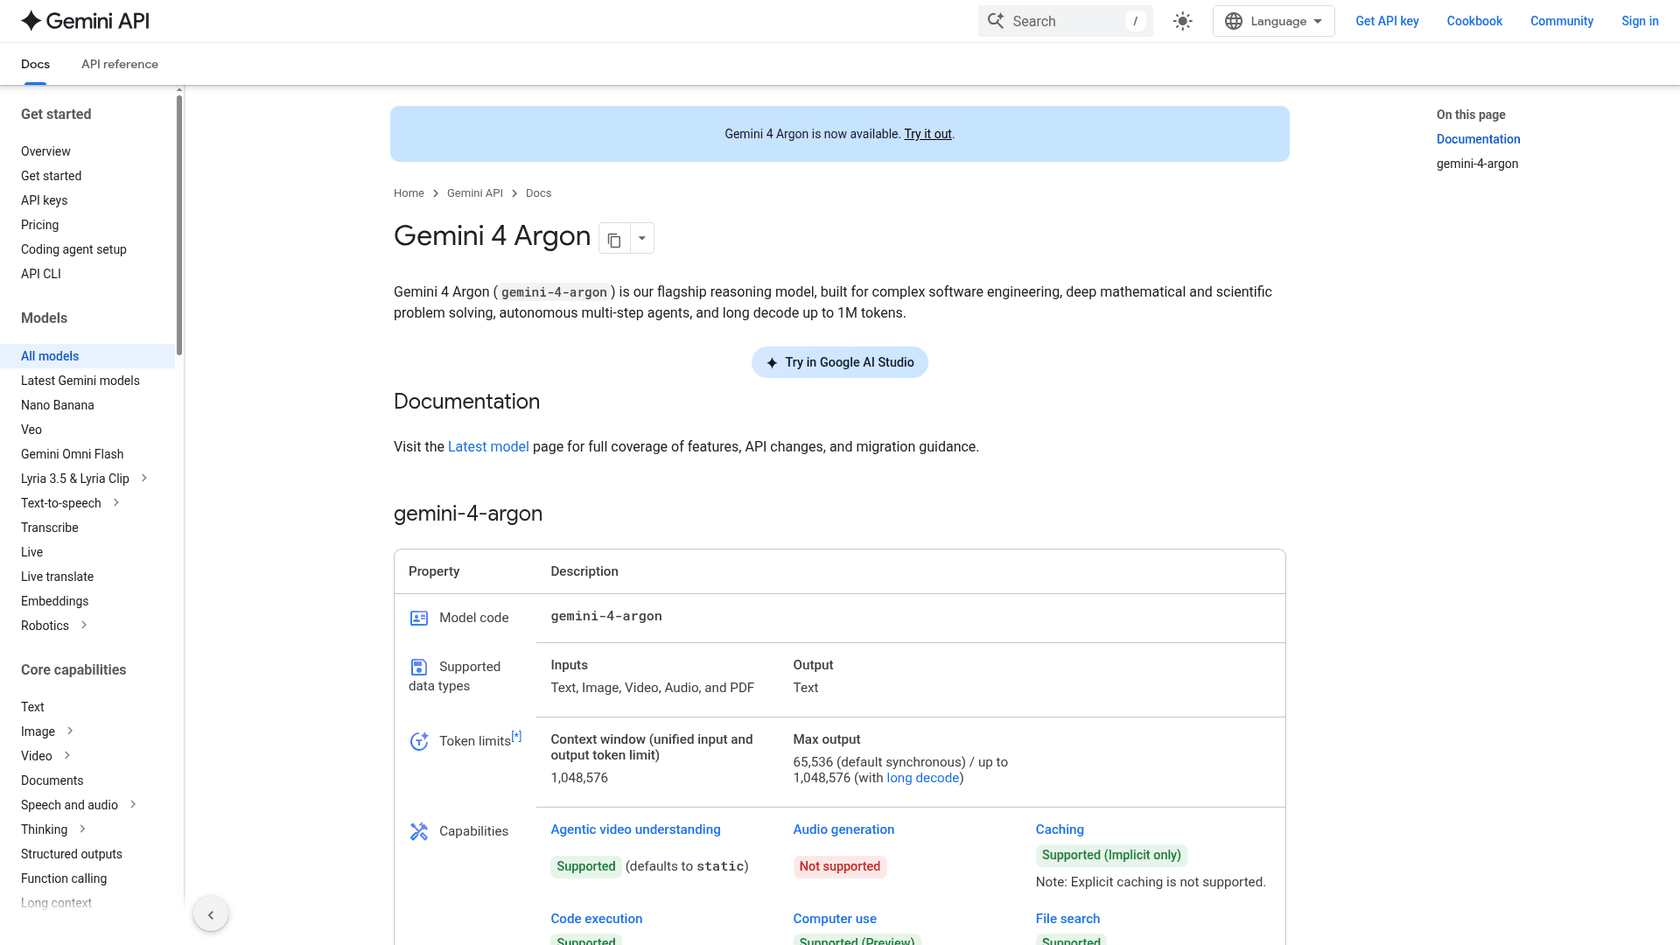
Este é o carro-chefe do Google, lançado em 30 de setembro de 2026, e nada nesta lista pontua mais alto.
Vantagens
- O maior Intelligence Index daqui,
52.6, mais de 4 pontos à frente do Terra em max, na Artificial Analysis. - A taxa de alucinação dele na AA,
15%, é a menor desta lista, contra38%do Terra em max. Se fatos errados são o seu maior risco, o Argon é o modelo mais seguro daqui. - 1M de contexto e saídas longas.
Desvantagens
- Esse preço de
$2/$10é apenas uma tarifa de lançamento, que termina em 30 de novembro. A partir de 1º de dezembro vai para$4/$20, o que dobra a fatura do comprador de exemplo de$7,000para$14,000. - É lento, com
48.2saté o primeiro token e cerca de80tokens por segundo na AA. - Não há plano gratuito, e o cache é apenas implícito.
Preços: $2/$10 até 30 de novembro de 2026, depois $4/$20, segundo a página de preços do Gemini. O guia de preços do Gemini 4 Argon detalha a promoção.
Minha opinião: trate o Argon como o especialista caro para o qual o seu roteador escala, não como um substituto do Terra para o tráfego do dia a dia. E faça o orçamento com o preço de dezembro, não com o promocional. A análise do Gemini 4 Argon tem mais.
6. Grok 4.7
Melhor para: acrescentar um quarto fornecedor independente à sua comparação, especialmente para respostas longas e pesadas em saída.
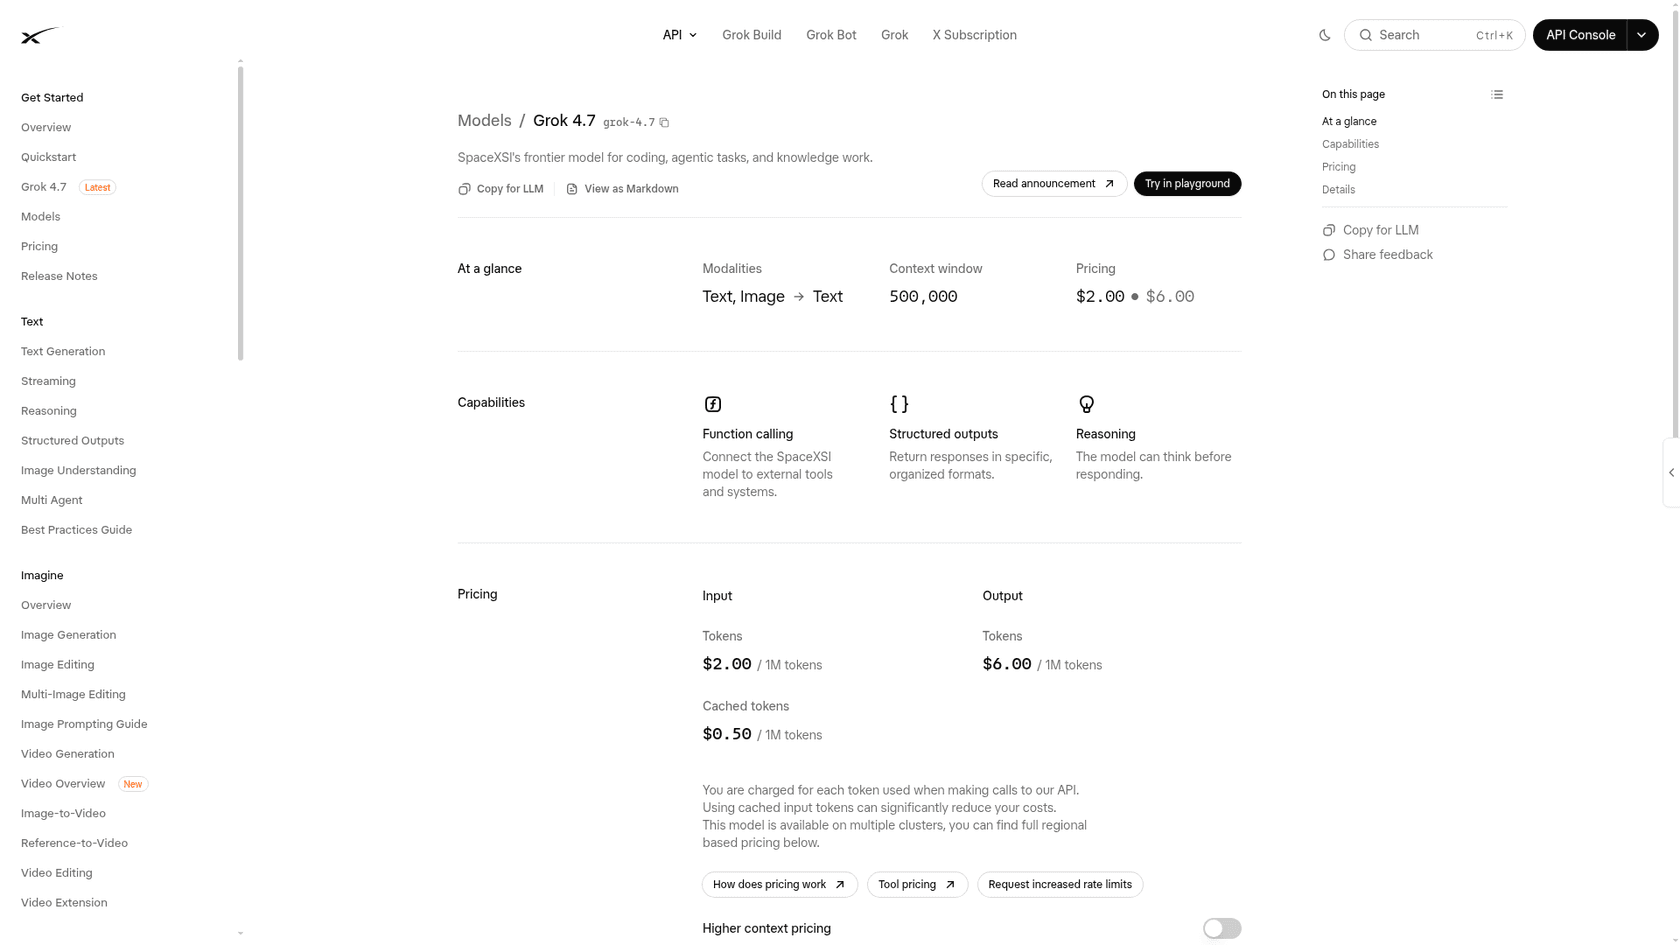
Este é o carro-chefe da xAI, descrito na sua página de modelos como "our flagship model for code and everything else".
Vantagens
- A saída é barata para um modelo de ponta:
$6por 1M contra$10do Sol e do Sonnet, o que leva o comprador de exemplo a$5,800. - A taxa de alucinação da AA com esforço alto é de
32%, menor que a do Terra em max. - O raciocínio é configurável, e há ferramentas de busca web e X no lado do servidor.
Desvantagens
- Com 500K de tokens, tem metade do contexto de tudo o mais daqui.
- É caro por tarefa. A AA o coloca em
$2.36com esforço alto para um índice de46.3, a pior relação desta lista. - O primeiro token leva
45.7scom esforço alto, embora o esforço baixo reduza isso para5.4s.
Preços: $2 de entrada, $6 de saída por 1M na documentação da xAI.
Minha opinião: ele merece uma vaga na comparação para você não depender só dos três grandes. Com esses números, porém, eu não o escolheria no lugar do Sol ou do Sonnet. A análise do Grok 4.7 trata do resto.
7. Claude Haiku 5.5
Melhor para: etiquetagem, roteamento e classificação em volume enorme, em que nada vai direto para um cliente.
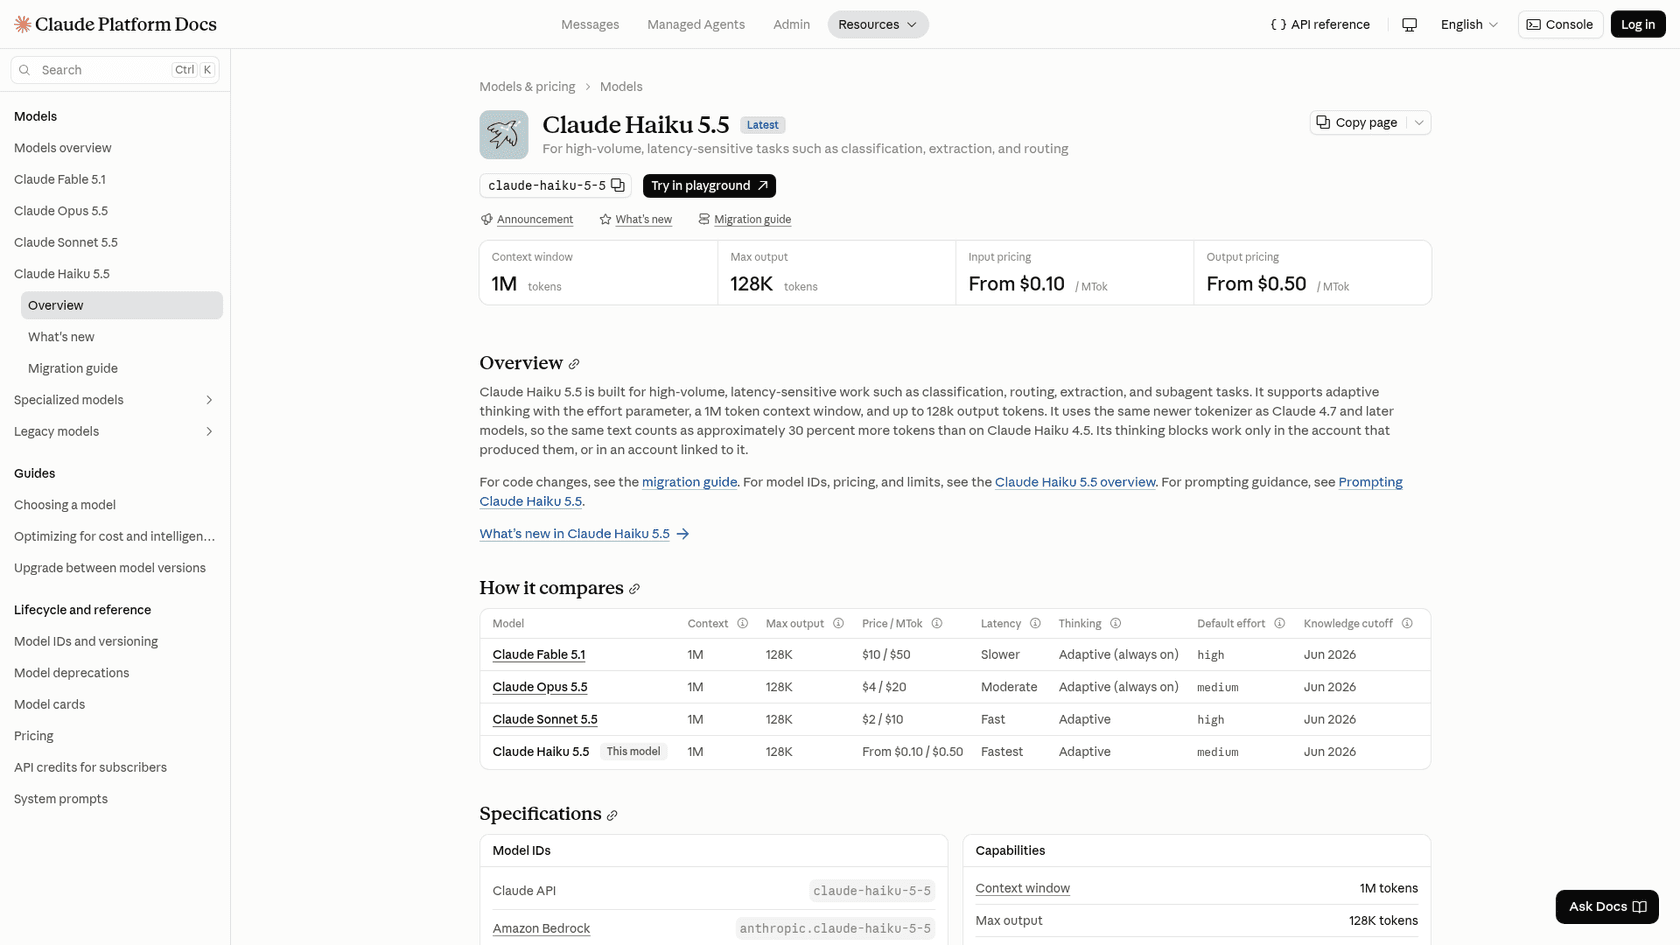
Quando o Terra é mais modelo do que o trabalho precisa, desça um nível em vez de ir para o lado. O Claude Haiku 5.5 é o modelo pequeno da Anthropic, lançado em 7 de outubro de 2026, e fica no mesmo preço de $0.10/$0.50 do GPT-6 Luna.
Vantagens
- O comprador de exemplo paga
$350por mês, um décimo da fatura do Terra. - A AA dá a ele
37.8com esforço alto por$0.08a tarefa, à frente dos32.9do Luna. - Roda a cerca de
185tokens de saída por segundo na AA.
Desvantagens
- Quando um prompt passa de 100.000 tokens, você paga 5x:
$0.50de entrada e$2.50de saída. Um usuário do HN o chamou de modelo "destroyed by Anthropics crazy decision to price it x5 after 100k context" (rockdoe). - Fica
10pontos abaixo do Terra no índice, então trate-o como um nível abaixo, não como uma troca.
Preços: $0.10/$0.50 até prompts de 100K tokens, $0.50/$2.50 acima, segundo a página de preços da Claude.
Minha opinião: o Haiku 5.5 ou o Luna são uma boa primeira passada barata num roteador. Só mantenha os prompts abaixo de 100K. A análise do Claude Haiku 5.5 traz os benchmarks.
Qual alternativa ao GPT-6.1 Terra serve para o seu produto?
Parta do trabalho, não do ranking. Um modelo pode ler bem uma captura de tela e mesmo assim clicar no botão errado. Outro pode ser brilhante em matemática e mesmo assim parecer lento numa janela de chat.
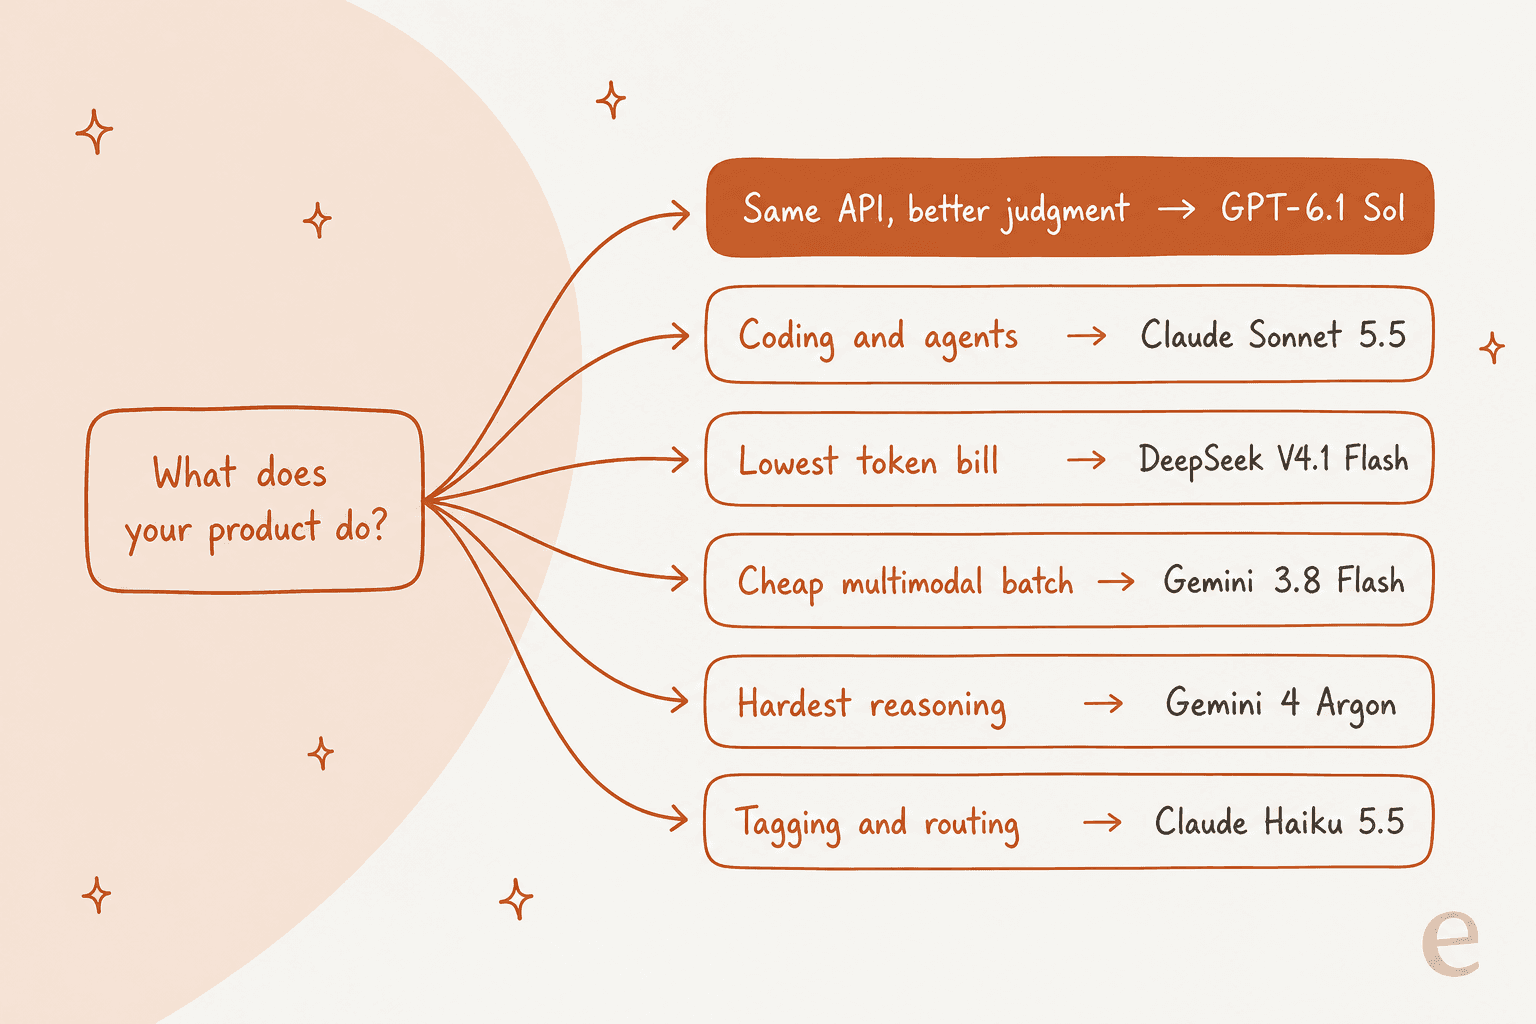
| Se o seu produto faz principalmente... | Teste primeiro | Por quê |
|---|---|---|
| Rascunhos e chat voltados ao cliente | Terra em low, Sol em medium | Primeiro token rápido, boa escrita e Sol para casos extremos |
| Programação ou agentes de terminal | Claude Sonnet 5.5 | 70.6% no Terminal-Bench 4.0 segundo a Anthropic |
| Extração ou RAG de alto volume | DeepSeek V4.1 Flash | $0.15/$0.60 fora do pico e pesos abertos |
| Processamento de PDF, vídeo ou áudio durante a noite | Gemini 3.8 Flash | Tipos de entrada mais amplos, barato até 2027 |
| Pesquisa e o raciocínio mais difícil | Gemini 4 Argon | Maior índice da AA, menor taxa de alucinação |
| Etiquetagem e roteamento | Claude Haiku 5.5 ou GPT-6 Luna | $0.10/$0.50 |
| Hospedagem própria ou preso à residência de dados | DeepSeek V4.1 Flash, ou Qwen 3.8 | Pesos que você mesmo pode rodar |
Se nada aqui servir, vale conhecer mais dois. O Kimi K3.1 Pro marcou 55.1 na AA, mas roda devagar, a cerca de 46 tokens por segundo. O Mistral Large 4 ainda está em pré-visualização.
Como fazer uma comparação de modelos antes de trocar
Um ranking mostra como um modelo se sai no teste de outra pessoa. O que você precisa é de como ele se sai no seu. Este é o processo que eu seguiria, com o mesmo formato da avaliação da minha análise do Terra:
- Pegue de 100 a 500 requisições reais. Anonimize e mantenha as feias: erros de digitação, duas perguntas em uma, timeouts de ferramentas, uma injeção de prompt.
- Escolha três desafiantes. Use o Terra como referência e acrescente as duas ou três linhas da tabela acima que combinam com o seu trabalho.
- Meça o que os usuários sentem. Taxa de sucesso da tarefa, fatos inventados, latência
p50ep95, precisão das chamadas de ferramentas, novas tentativas e custo por tarefa bem-sucedida. - Avalie à mão no começo. Na primeira rodada, leia você mesmo cada saída. Quando confiar na rubrica, automatize; as ferramentas de avaliação de agentes da OpenAI ajudam nisso.
- Teste um roteador, não só modelos isolados. Envie tudo para um modelo barato como padrão e depois escale os casos difíceis ou incertos.
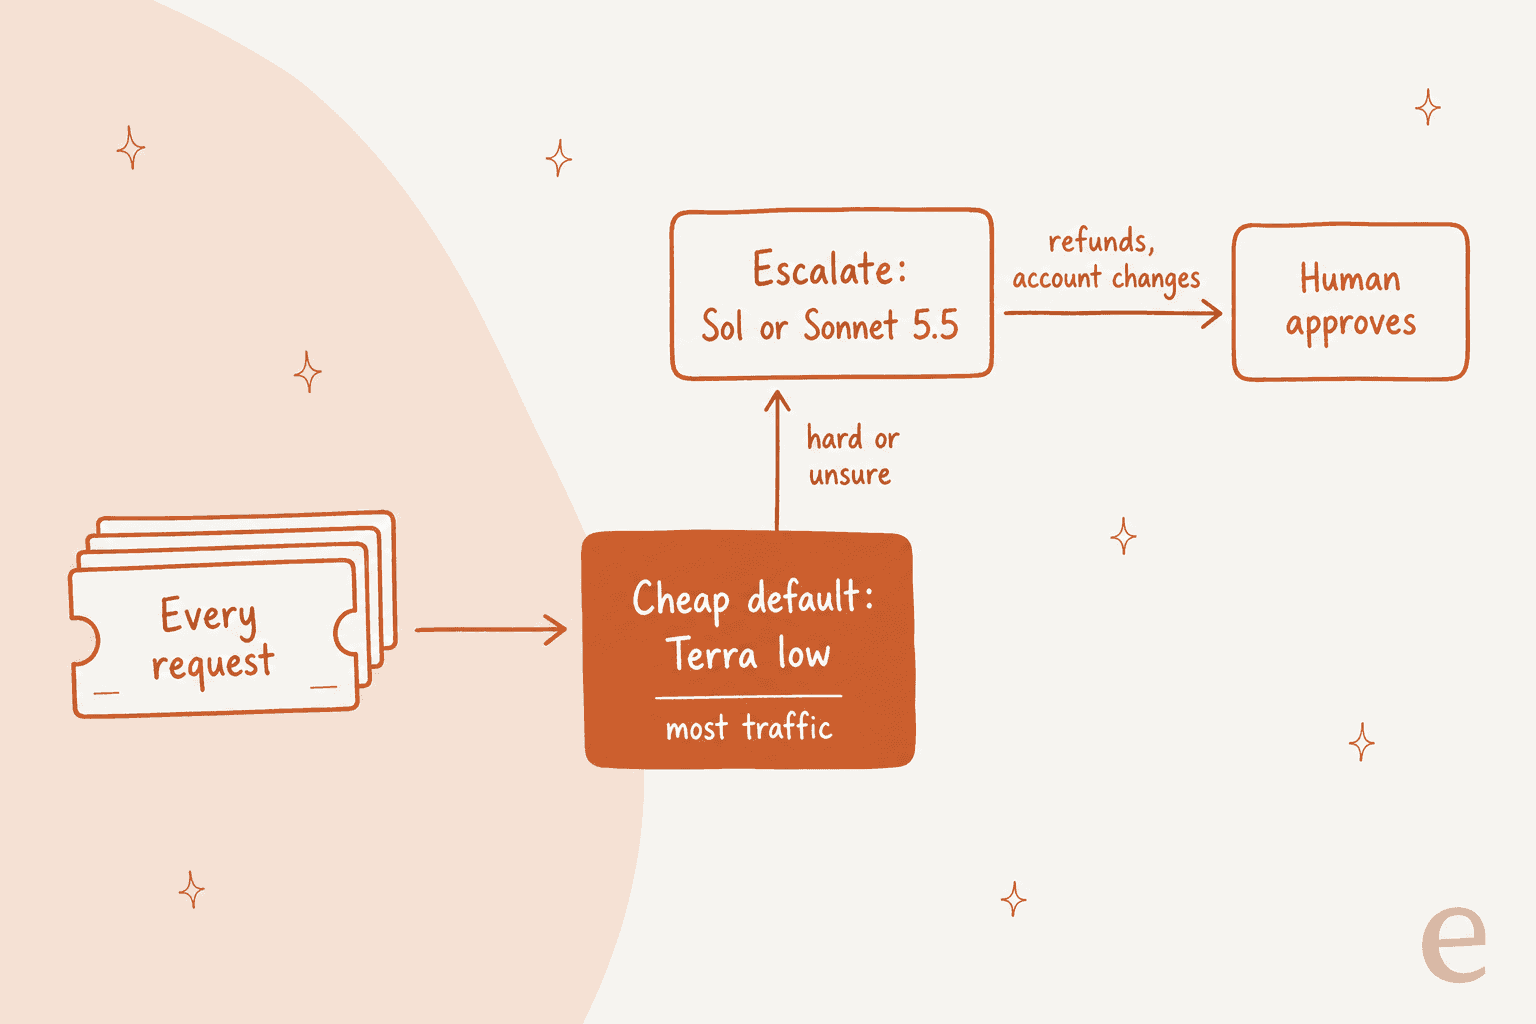
A maior parte da economia vem do roteamento. A OpenAI criou os esforços none e low do Terra para esse caminho rápido, e os usuários do HN voltavam sempre a uma pergunta sobre isso:
"Is a high effort terra above a low effort Sol? Are larger models mostly always better regardless of effort?"
Pelos dados da AA, a resposta muitas vezes é não, e medir é a única forma de saber para a sua própria carga. O cache também ajuda com todas as opções. A entrada em cache do Terra custa $0.05, um desconto de 95%, e o guia de preços da API da OpenAI cobre o Batch e os limites de taxa antes de você escalar.
Se o modelo é para uma fila de suporte
Muitas das equipes que comparam alternativas ao Terra estão, na verdade, construindo um bot de suporte. Há anos coloco agentes de IA em filas de helpdesk ao vivo, e vejo sempre a mesma coisa: o modelo raramente é o ponto fraco; as regras ao redor dele é que são. No meu teste do Terra com 80 execuções, nenhum modelo acertou menos de 15 de 16 tickets. A única falha real foi o Terra em none dizendo a um cliente de língua espanhola "we've noted the new address" quando não tinha como alterá-lo.
Isso é um problema de escalonamento. Você resolve na camada que decide quando passar o caso, não pagando por um modelo maior. O que evita alucinações de IA é ancorar as respostas na sua central de ajuda e nos seus tickets passados, não importa qual modelo escreva as palavras. E ao lado de uma promessa errada feita a um cliente pagante, a fatura de tokens é uma fatia pequena do custo da IA no atendimento ao cliente.
A SamCart mostra como é essa camada na prática. Um agente da eesel cuida dos tickets do Freshdesk e outro do chat do site, ambos respondendo a partir de cerca de 280 artigos da central de ajuda, num plano dimensionado para 8.000 interações por mês. A Koffer.ch, uma loja suíça de malas, mantém cada resposta como rascunho em alemão, francês, inglês ou italiano no Freshdesk. É exatamente o tipo de configuração em que um modelo mais barato faz bem o trabalho.
Prefere conduzir pelo código? A CLI da eesel executa o mesmo colega que você configuraria no painel. Teste uma resposta com eesel chat e veja o que o agente fez com eesel activity; qualquer mudança pode ser pré-visualizada com --dry-run. Todo comando retorna JSON. Cada workspace também é um servidor MCP, de modo que um agente de programação rodando no Terra ou no Sonnet pode chamar o seu colega de suporte como uma ferramenta.
Experimente a eesel
Terra, Sol e Sonnet são motores. Quando o que você está construindo é automação de suporte, a eesel é o colega de IA para helpdesk que já faz esse trabalho por cima deles. Ele entra no helpdesk que você já usa, seja Zendesk, Freshdesk, Gorgias ou outro. Aprende com seus tickets e macros passados, além da central de ajuda, e segue as regras de escalonamento que você define. Antes de responder a qualquer pessoa ao vivo, roda uma simulação nos seus tickets passados reais, para você comparar as respostas dele com o que a sua equipe realmente enviou.

O preço é um plano de créditos mensal fixo, em que um ticket ou chat conta como um crédito. Começa em $299 por mês por 500 créditos, com todos os recursos e assentos ilimitados incluídos. Como não há cobrança por token, a sua fatura fica estável quando um modelo mais barato como o Terra é lançado. Comece no plano gratuito e experimente a eesel numa parte da sua fila.