

A melhor alternativa ao Gemini 4 Carbon para a maioria das equipes é o Gemini 4 Argon, o modelo sobre o qual o Carbon é construído: ele está na API hoje pelo mesmo preço introdutório de $2/$10 e inventou respostas em 4% das vezes contra 11% do Carbon na Artificial Analysis. O próprio Carbon está restrito a defensores de segurança cibernética por meio do Fairwind Program do Google, sem data para todos os outros.
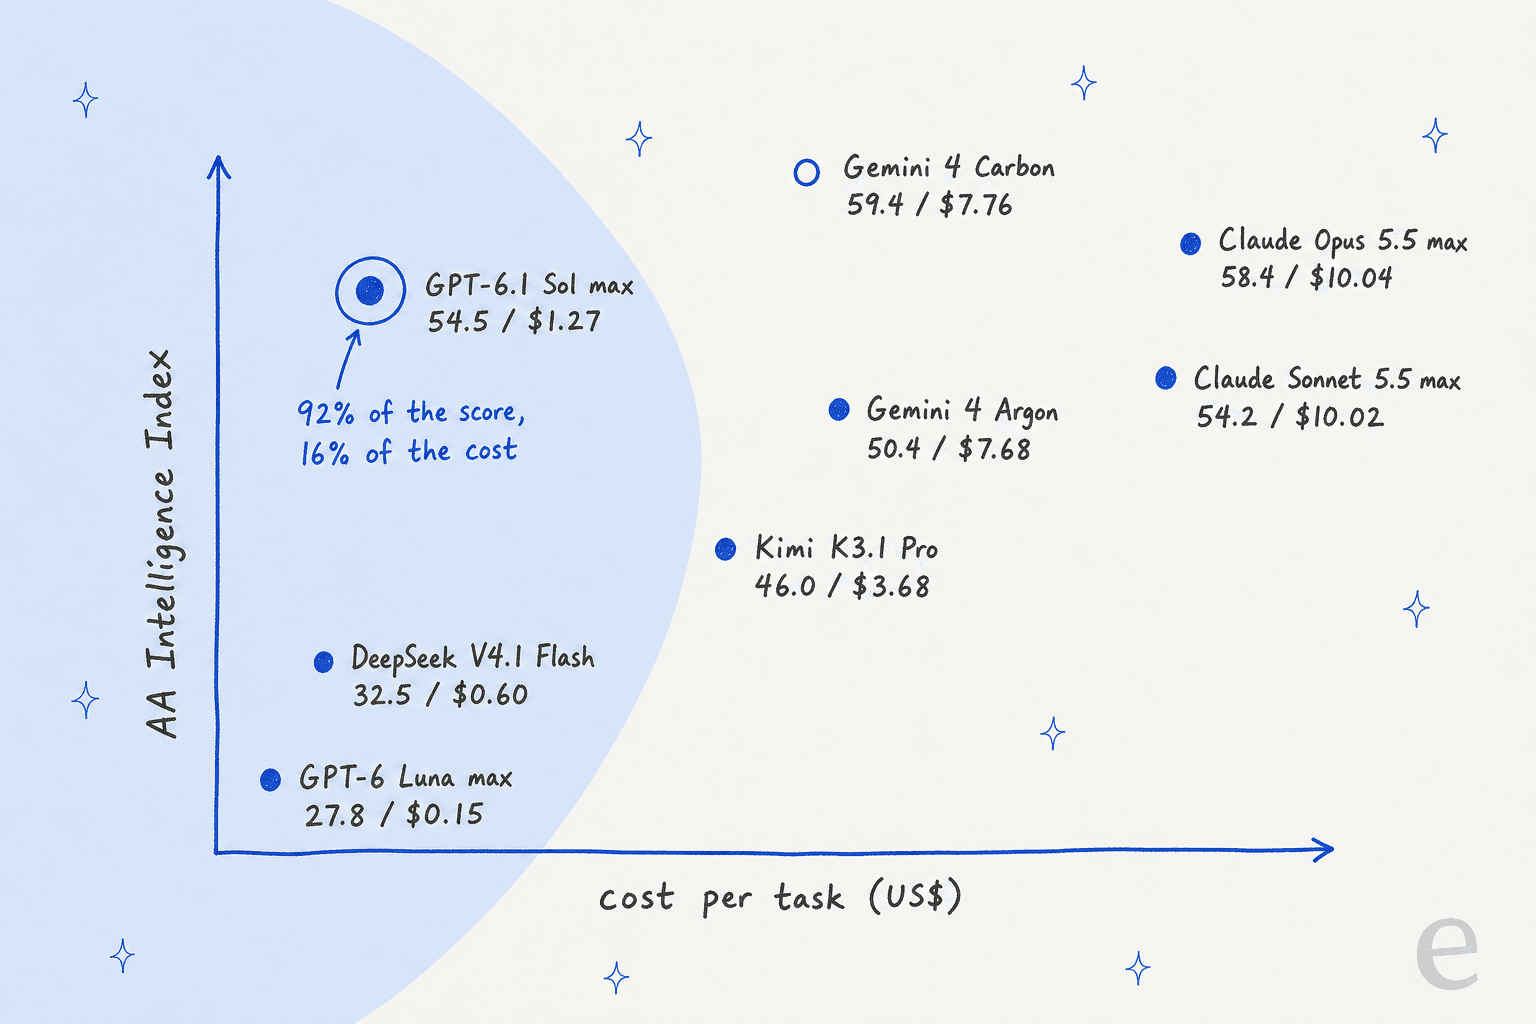
Se você queria o Carbon pela nota, o GPT-6.1 Sol em esforço máximo alcança 92% da nota de índice do Carbon por 16% do custo por tarefa ($1,27 contra $7,76). O Claude Opus 5.5 é o mais próximo em nota bruta (58,4), mas o mais caro por tarefa. Kimi K3.1 Pro, DeepSeek V4.1 Flash e GPT-6 Luna cobrem contexto longo, pesos abertos e triagem barata.
Se você estava de olho no Carbon para um agente de suporte, o modelo importa menos do que aquilo que ele lê. Eu construo as integrações por trás da eesel, onde um colega de helpdesk com IA responde a partir da sua central de ajuda e de tickets anteriores com qualquer um desses modelos; a SamCart roda um agente nos tickets do Freshdesk e outro no chat do site, respondendo a partir de 280 artigos de ajuda.
Por que as pessoas procuram alternativas ao Gemini 4 Carbon?
Porque quase ninguém consegue usá-lo. O Google anunciou o Gemini 4 Carbon em 28 de outubro de 2026 e disse que "starting this week" ele vai para um subconjunto de defensores de segurança cibernética, depois gradualmente para mais parceiros de confiança, com desenvolvedores, empresas e consumidores listados em "coming soon". Não há data para esse último grupo.
O filtro passa pelo Fairwind Program, que o Google descreve como acesso antecipado para defensores de alta prioridade "like governments, healthcare providers, and telecommunications services". Ele trabalha com mais de 650 parceiros e faz verificações de antecedentes das organizações que se candidatam. Se você comanda uma equipe de suporte ou um produto SaaS, não é o seu caso, pelo menos por enquanto.
É uma pena, porque o Carbon é forte. Ele lidera o Artificial Analysis Intelligence Index com 59,4, supera o Argon nas 17 linhas da tabela de benchmarks do próprio Google e será lançado ao preço do Argon: $2 por milhão de tokens de entrada e $10 por milhão de saída, depois $4/$20 após o período introdutório. Passei por tudo na minha explicação do Gemini 4 Carbon.
O tópico do Hacker News sobre o lançamento (735 pontos) captou bem o clima:
"I can't tell if they're withholding access to manufacture some sense of scarcity but the delays are really prolonged."

O precedente do Argon ajuda, um pouco. O Argon foi anunciado em 30 de setembro e lançado em 13 de outubro, cerca de duas semanas depois, como um comentarista do Hacker News apontou. Mas o Argon nunca esteve restrito a um programa de segurança, então eu não planejaria o lançamento de um produto contando que o Carbon siga o mesmo relógio.
Como escolhi estas alternativas
Comecei de onde um comprador começaria. Perguntei ao ChatGPT, em uma conversa nova, as melhores alternativas para um agente de suporte com IA agora que o Carbon é só para segurança cibernética. Ele indicou GPT-6.1 Sol, Gemini 4 Argon, Claude Sonnet 5.5 e GPT-6 Luna, e sugeriu uma configuração com dois modelos, em que um barato faz a triagem e um mais forte pega os casos difíceis. Os quatro entraram nesta lista, e essa ideia de roteamento molda a última seção.
Depois acrescentei os modelos que concorrem com o Carbon nos próprios benchmarks dele e conferi cada preço na página de preços do fornecedor em 29 de outubro de 2026. Os dados de pontuação vêm da Artificial Analysis, que passou Carbon, Argon e os demais pelo mesmo índice a preço de tabela. Peguei três números para cada modelo:
- Intelligence Index v5.0, a nota principal que o Carbon lidera.
- Custo por tarefa, quanto uma tarefa do índice realmente custou a preço de tabela, incluindo todos os tokens de raciocínio. Esse é o número que diz se uma tabela de preços barata é barata na prática.
- Taxa de alucinação no AA-Omniscience: com que frequência o modelo dá uma resposta errada quando deveria ter dito que não sabia. Para qualquer coisa voltada ao cliente, é esta a que mais me importa.
A eesel há anos coloca agentes de IA em filas de suporte reais, e vimos bots com ar confiante darem respostas erradas em silêncio. Por isso toda implantação da eesel agora roda contra os tickets históricos de uma equipe antes de responder a um cliente real, e por isso a coluna de alucinação pesa aqui tanto quanto a nota principal.
Alternativas ao Gemini 4 Carbon num relance
Aqui está a lista inteira em uma tabela. Os preços são tarifas padrão de API por milhão de tokens em 29 de outubro de 2026. Os números da AA são no nível de esforço mais alto de cada modelo, salvo indicação, a preço de tabela.
| Modelo | Dá para usar hoje? | Entrada / saída (por 1M) | Entrada em cache | AA Index v5.0 | Custo AA por tarefa | Taxa de respostas inventadas | Janela de contexto | Pesos abertos | Melhor para |
|---|---|---|---|---|---|---|---|---|---|
| Gemini 4 Carbon (referência) | Só defensores de segurança cibernética | $2 / $10 intro, depois $4 / $20 | 95% de desconto na entrada | 59.4 | $7.76 | 11% | 1M | Não | Segurança e programação, se você conseguir acesso |
| Gemini 4 Argon | Sim, Gemini API | $2 / $10 até 30 nov., depois $4 / $20 | $0.10, depois $0.20 | 50.4 | $7.68 | 4% | 1,048,576 | Não | Menos respostas inventadas |
| GPT-6.1 Sol | Sim, OpenAI API | $2 / $10 | $0.10 | 54.5 | $1.27 | 52% | 1,050,000 | Não | Melhor nota por dólar |
| Claude Opus 5.5 | Sim, Claude API | $4 / $20 | $0.20 | 58.4 | $10.04 | 50% | 1M | Não | Nota bruta mais próxima |
| Claude Sonnet 5.5 | Sim, Claude API | $2 / $10 | $0.10 | 54.2 | $10.02 | 43% | 1M | Não | Qualidade de escrita, uso de ferramentas |
| Kimi K3.1 Pro | Sim, Kimi API | $2 / $10 | $0.20 | 46.0 | $3.68 | 37% | 1,048,576 | Ainda não | Contexto longo, trabalho de agentes |
| DeepSeek V4.1 Flash | Sim, DeepSeek API | $0.15 / $0.60 fora do pico, $0.30 / $1.20 no pico | $0.003 fora do pico | 32.5 | $0.60 | 64% | 1M | Sim | Auto-hospedagem, menor fatura |
| GPT-6 Luna | Sim, OpenAI API | $0.10 / $0.50 | $0.01 | 27.8 | $0.15 | 79% | 1,050,000 | Não | Triagem e roteamento baratos |
Duas coisas chamam a atenção. Primeiro, cinco desses modelos compartilham a tabela de $2/$10 do Carbon, então o preço por token não os separa. O custo por tarefa separa, porque captura quantos tokens cada modelo queima pensando. Segundo, a coluna de respostas inventadas vai de 4% a 79%, uma dispersão muito maior do que a das notas do índice.
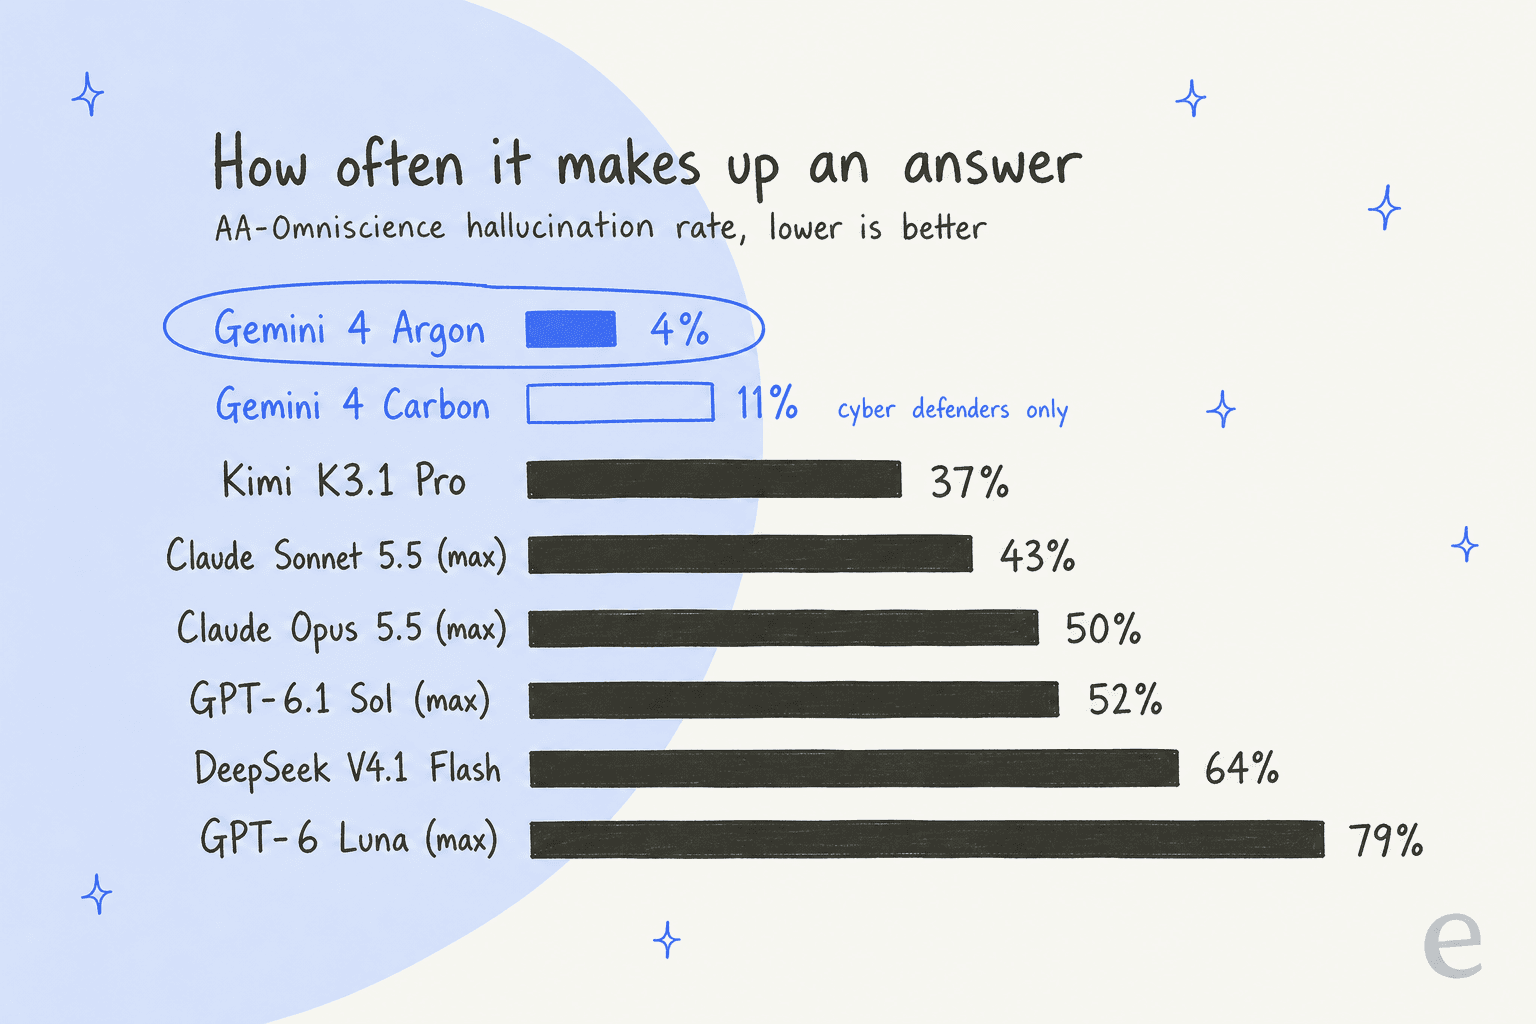
Esse gráfico é a razão de minha primeira escolha não ser o modelo com a nota mais próxima. Se o Carbon atraiu você porque o Google diz que ele é mais honesto sobre o que não sabe, o Argon já está à frente nesse mesmo teste.
1. Gemini 4 Argon
Melhor para: equipes que queriam o Carbon para um agente voltado ao cliente e precisam de menos respostas inventadas mais do que de uma nota maior.
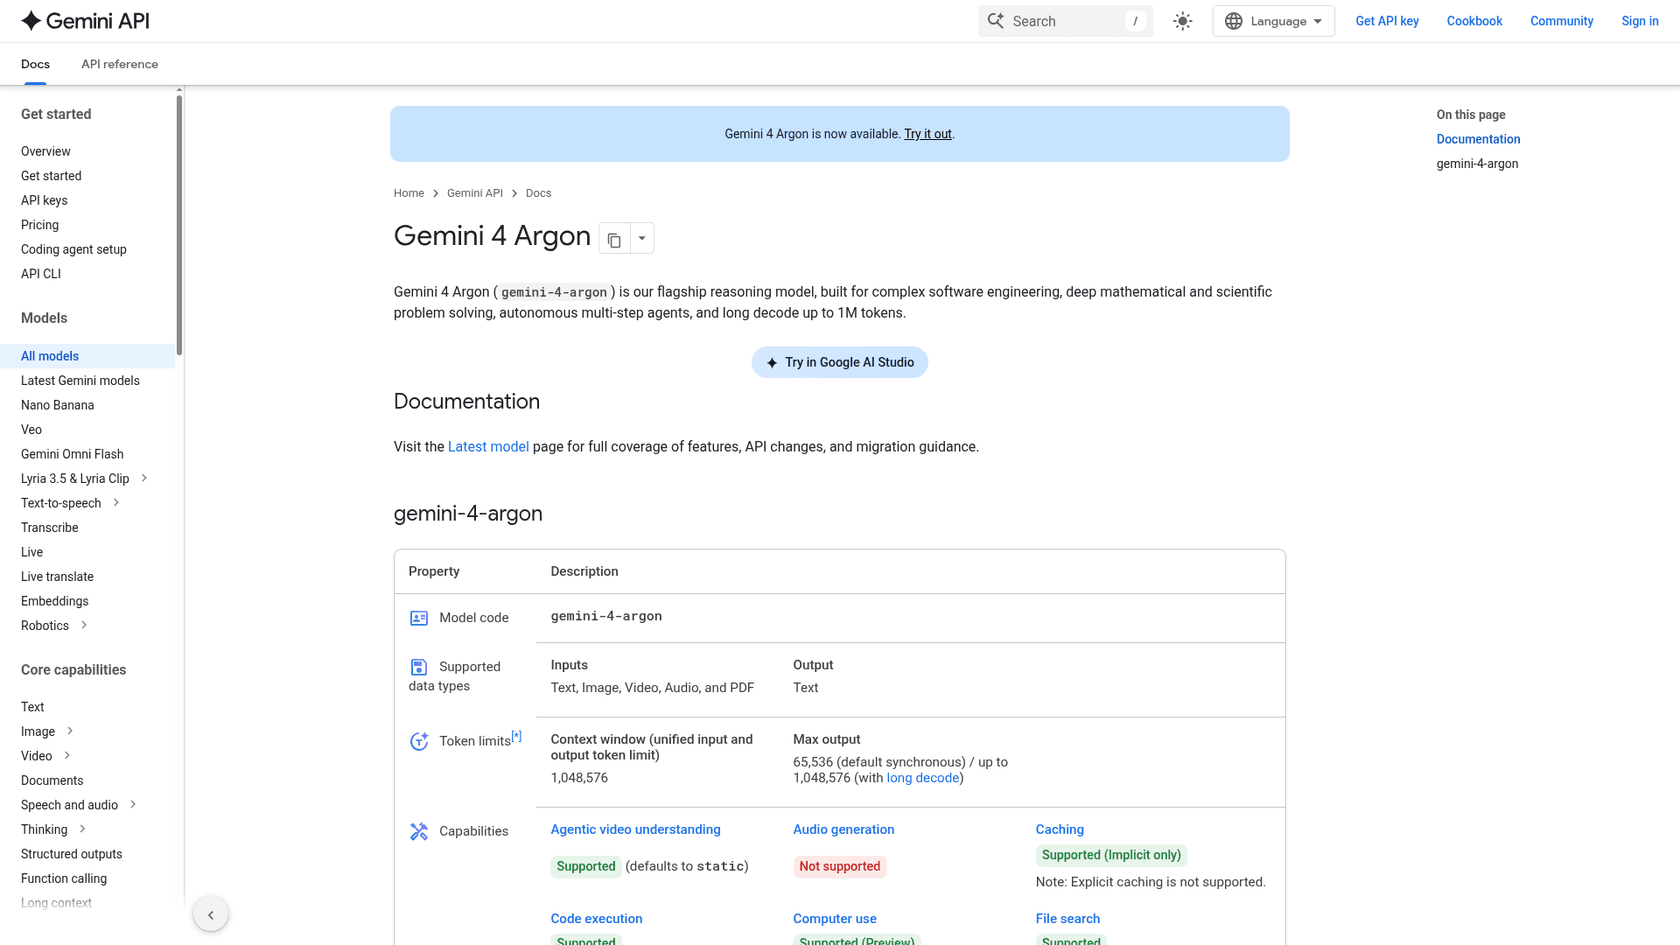
O Argon é o modelo sobre o qual o Carbon é construído, então é a primeira parada óbvia. Ele está disponível de forma geral pela API do Gemini e pelo Google AI Studio, com janela de contexto de 1.048.576 tokens e até 1M de tokens de saída com long decode. Se o seu código já chama o Gemini, migrar para o Carbon depois é só trocar o nome do modelo.
Na Artificial Analysis, o Argon marca 50,4 contra 59,4 do Carbon, então o Carbon é o modelo mais inteligente. Mas a taxa de alucinação do Argon é de 4% contra 11% do Carbon, a mais baixa de todos os modelos que conferi, e no AutomationBench (fluxos de trabalho empresariais de várias etapas) ele marcou 77,5% contra 77,8% do Carbon. O Argon até custou um pouco menos por tarefa do índice ($7,68 contra $7,76). Para um agente de suporte, a diferença que realmente importa é bem pequena.
"For what it's worth: Argon is a pretty good model, and this is coming from someone who just sticks with Opus 5.5 mostly across the board. For the current introductory price, it provides an exceptional value."
Prós
- Mesma tabela de preços do Carbon, então seu modelo de custos não muda quando o Carbon abrir.
- A menor taxa de respostas inventadas desta lista, por larga margem.
- O Google Search grounding inclui 5.000 requisições gratuitas por mês.
Contras
- Pensa muito: 116K tokens de saída por tarefa da AA, então a fatura por tarefa é alta para a nota dele.
- Apenas cache implícito. Você não consegue fixar um cache explicitamente como no Claude.
- Nem todos o valorizam. Um usuário do Hacker News o chamou de "a clear tier below" dos modelos atuais do Claude e do Sol.
Preços
| Nível (por 1M de tokens) | Entrada | Saída | Entrada em cache |
|---|---|---|---|
| Padrão, até 30 nov. 2026 | $2.00 | $10.00 | $0.10 |
| Padrão, a partir de 1º dez. 2026 | $4.00 | $20.00 | $0.20 |
| Batch ou Flex, até 30 nov. | $1.00 | $5.00 | $0.05 |
| Priority, até 30 nov. | $3.60 | $18.00 | $0.18 |
O grounding de busca são 5.000 requisições gratuitas por mês, depois $14 por 1.000, segundo a página de preços do Google. Não há nível gratuito para o Argon. Meu texto sobre os preços do Gemini 4 Argon explica o reajuste de dezembro.
Minha opinião: comece aqui se você está construindo qualquer coisa que responda a clientes. Reserve orçamento para o dobro do preço em 1º de dezembro, e se você precisa mais de velocidade e custo, olhe o Sol. Cobri mais opções no meu levantamento de alternativas ao Gemini 4 Argon.
2. GPT-6.1 Sol
Melhor para: equipes que queriam a inteligência do Carbon mas se importam com a fatura.
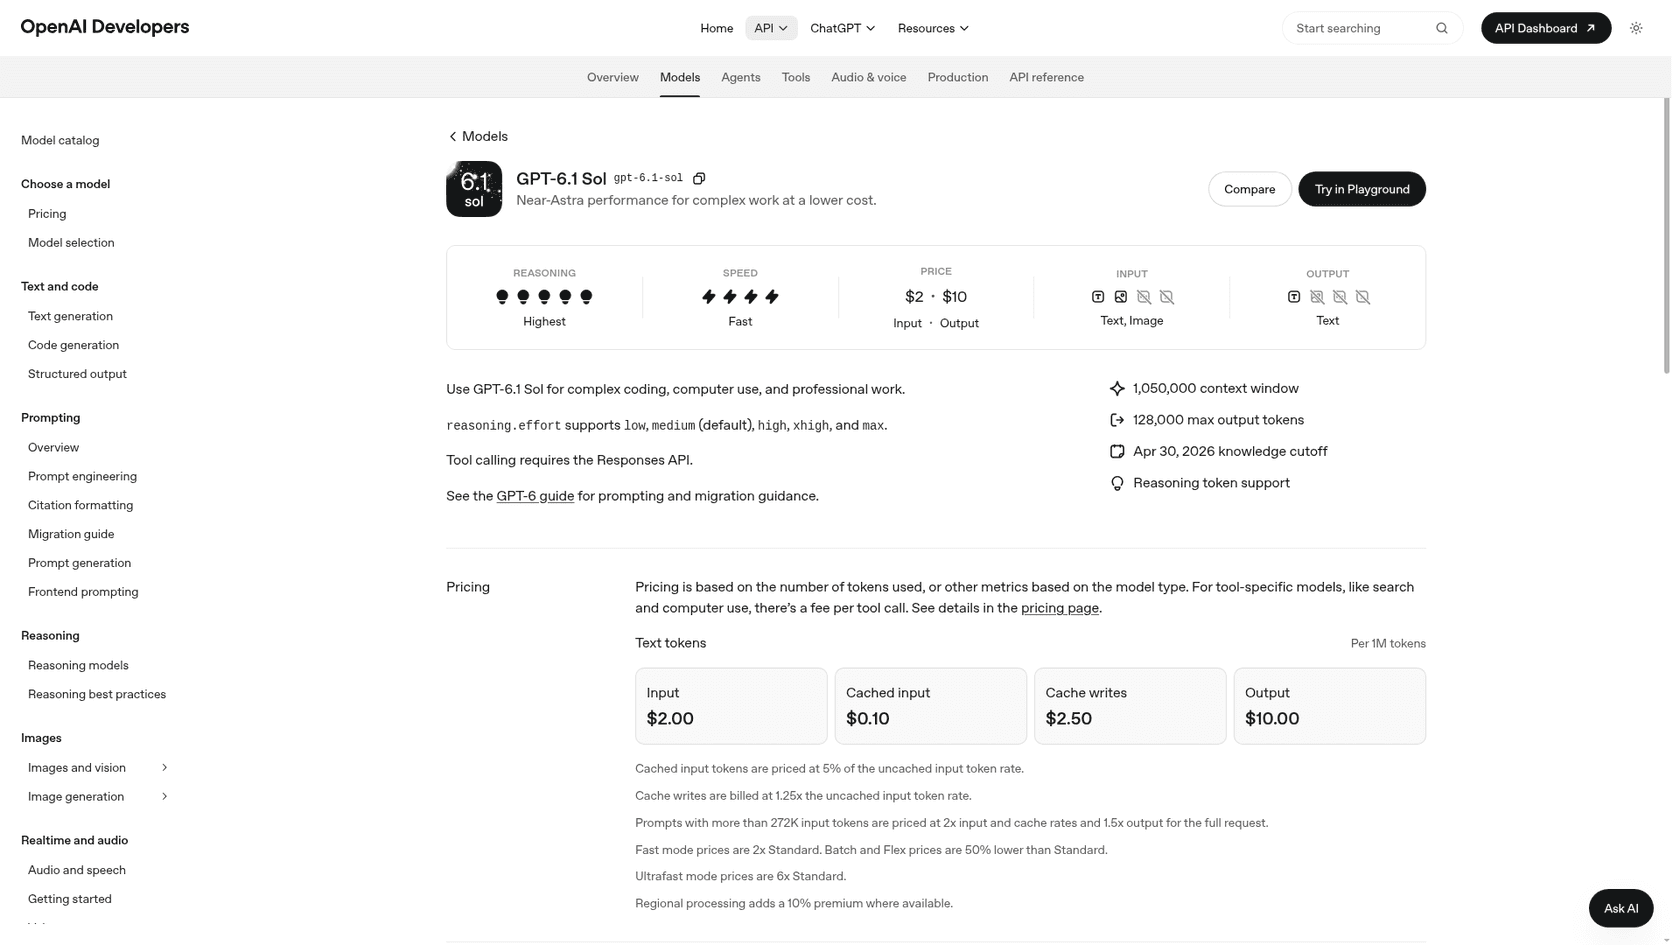
O Sol foi a primeira sugestão do ChatGPT para um agente de suporte, e os números confirmam. A página do modelo da OpenAI o descreve como "Near-Astra performance for complex work at a lower cost", com janela de contexto de 1.050.000 tokens e esforço de raciocínio de low a max.
Em esforço máximo, o Sol marca 54,5 no índice da Artificial Analysis por $1,27 por tarefa, contra $7,76 do Carbon. Isso é 92% da nota do Carbon por 16% do custo. Em xhigh são 52,3 por $0,76, e em medium 46,1 por $0,36, a configuração com a qual eu começaria um agente de suporte.
Prós
- Melhor nota por dólar de tudo nesta lista.
- Cinco níveis de esforço, então um modelo pode cobrir tickets baratos e difíceis.
- O preço batch reduz a fatura pela metade, para $1/$5, em tudo que pode esperar.
Contras
- Inventou respostas em 52% das vezes no AA-Omniscience em esforço máximo. Precisa ser fundamentado no seu próprio conteúdo.
- Tool calling exige a Responses API, então código antigo de Chat Completions precisa de migração.
- Prompts acima de 272K tokens de entrada são cobrados a 2x na entrada e 1,5x na saída.
Preços
| Modo (por 1M de tokens) | Entrada | Saída | Entrada em cache |
|---|---|---|---|
| Padrão | $2.00 | $10.00 | $0.10 |
| Batch / Flex | $1.00 | $5.00 | $0.05 |
| Fast | $4.00 | $20.00 | $0.20 |
| Ultrafast | $12.00 | $60.00 | $0.60 |
Os preços são da página de preços da OpenAI. Meu guia dos preços do GPT-6.1 Sol tem exemplos calculados.
Minha opinião: a escolha padrão se você não tem motivo para ficar com o Google. Só não deixe que ele responda a clientes de memória. Minha análise do GPT-6.1 Sol cobre onde ele escorrega.
3. Claude Opus 5.5
Melhor para: equipes que querem o mais próximo da nota do Carbon e vão pagar por isso.
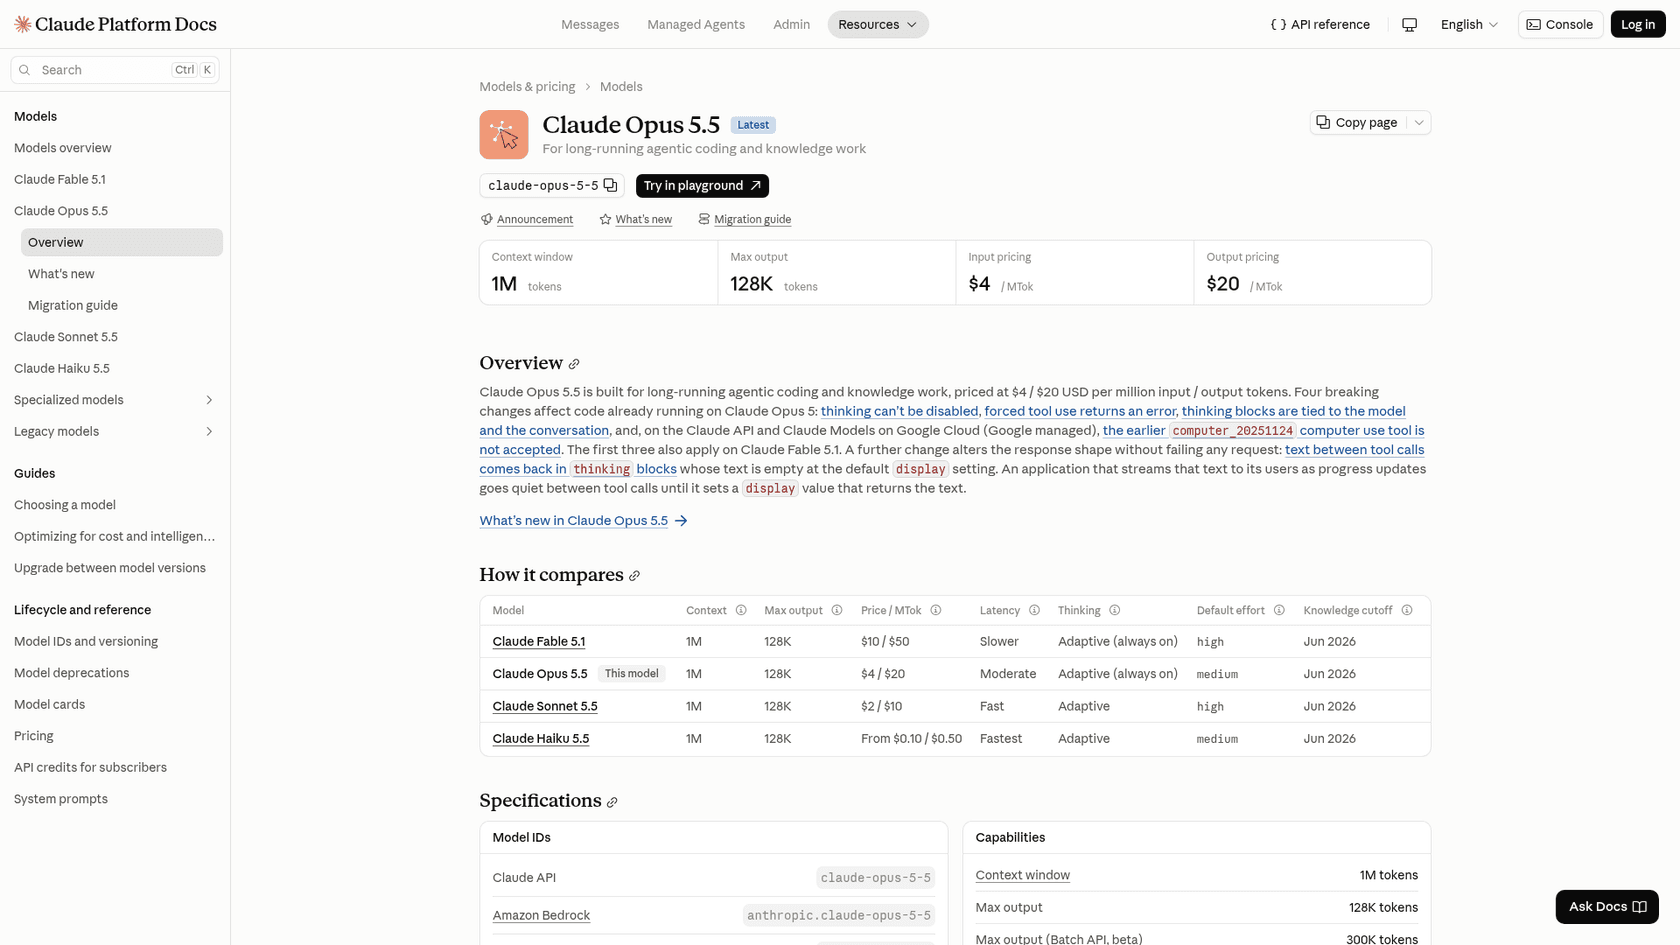
O Opus 5.5 é o modelo que o Carbon só venceu por pouco. Na Artificial Analysis ele marca 58,4 em esforço máximo, um ponto atrás dos 59,4 do Carbon, e na própria tabela do Google ainda lidera o uso de computador OSWorld-2.1 com 87,2% contra 81,5% do Carbon. A Anthropic o posiciona para "long-running agentic coding and knowledge work".
O problema, em termos de dinheiro, é a fatura. Em esforço máximo uma tarefa da AA custou $10,04, o maior valor desta lista. Xhigh é a melhor troca: 57,0 por $6,05, o que ainda supera o Carbon em custo por tarefa. A Anthropic também observa que o Opus 5.5 mudou parte do comportamento da API em relação ao Opus 5 (o thinking não pode ser desativado, o uso forçado de ferramentas retorna erro), então vale conferir o guia de migração antes de trocar.
"I've found its worse in most tasks, especially when ranked on a cost-per-task metric."
Essa resposta era sobre o Claude Fable 5.1 versus o Opus 5.5, e resume bem por que aqui a escolha da Anthropic é o Opus, e não o Fable.
Prós
- A nota bruta mais próxima do Carbon que você pode de fato comprar.
- Acertos de cache de prompt custam 5% da entrada ($0,20 por milhão), mais barato que os 10% de costume.
- Também elegível para o Cyber Verification Program da Anthropic se segurança fizer parte do trabalho.
Contras
- Maior custo por tarefa em esforço máximo ($10,04).
- Inventou respostas em 50% das vezes em esforço máximo no AA-Omniscience.
- O modo Fast custa $8/$40, o dobro do padrão.
Preços
| Modo (por 1M de tokens) | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| Padrão | $4.00 | $20.00 | $0.20 |
| Batch | $2.00 | $10.00 | n/a |
| Modo Fast | $8.00 | $40.00 | n/a |
Da documentação de preços da Anthropic. Mais detalhes no meu texto sobre os preços do Claude Opus 5.5.
Minha opinião: escolha o Opus 5.5 em xhigh se o trabalho for difícil e longo, como programação agêntica ou pesquisa profunda. Para uma fila de suporte, é mais modelo do que a maioria dos tickets precisa. Minha análise do Claude Opus 5.5 tem os detalhes.
4. Claude Sonnet 5.5
Melhor para: escrita voltada ao cliente e uso de ferramentas em que o tom importa.
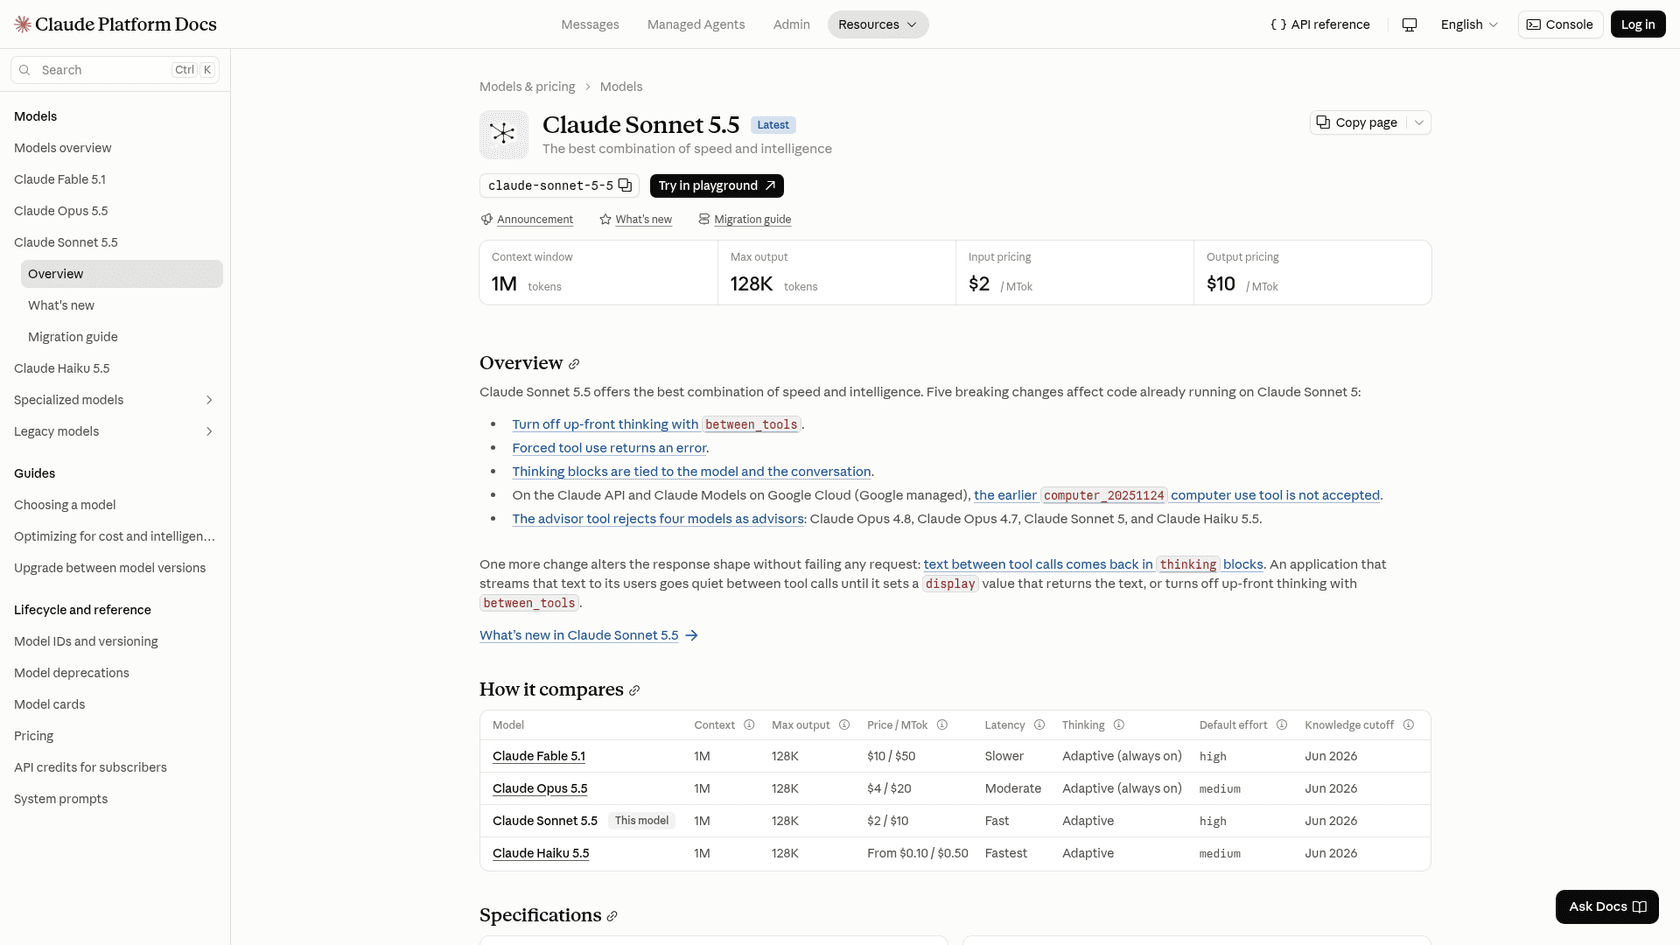
O Sonnet 5.5 é o terceiro modelo que o ChatGPT sugeriu, para "nuanced, high-quality customer conversations". A Anthropic o chama de "the best combination of speed and intelligence" da sua linha, pelos mesmos $2/$10 do preço de lançamento do Carbon.
As notas dependem muito do esforço. Em max, o Sonnet chega a 54,2 na Artificial Analysis, perto do Sol, mas essa execução custou $10,02 por tarefa. Em esforço high cai para 41,1 por $1,64. A taxa de alucinação dele é a melhor entre os modelos de fronteira da Anthropic e da OpenAI aqui em esforço máximo (43%), e a nota dele no AutomationBench em max (71,8%) fica atrás apenas dos dois modelos Gemini 4 e do Kimi.
Prós
- O modelo intermediário da Anthropic: mais rápido que o Opus 5.5 pela metade do preço por token.
- Acertos de cache a $0,10 por milhão, 5% da entrada.
- Mesma API e ferramentas do Opus, então você pode rotear entre eles.
Contras
- O esforço max custa por tarefa tanto quanto o Opus 5.5.
- A queda de nota de max para high é acentuada (54,2 para 41,1).
- Sem pesos abertos, sem auto-hospedagem.
Preços
| Modo (por 1M de tokens) | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| Padrão | $2.00 | $10.00 | $0.10 |
| Batch | $1.00 | $5.00 | n/a |
Da documentação de preços da Anthropic. Meu guia dos preços do Claude Sonnet 5.5 detalha os custos por esforço.
Minha opinião: uma escolha padrão forte para respostas de suporte, rodando em esforço medium ou high com grounding. Pule o esforço max, a menos que a tarefa seja difícil. Veja minha análise do Claude Sonnet 5.5 para mais.
5. Kimi K3.1 Pro
Melhor para: tickets longos, documentos longos e trabalho de ferramentas em várias etapas com uma tabela de preços de modelo de fronteira.
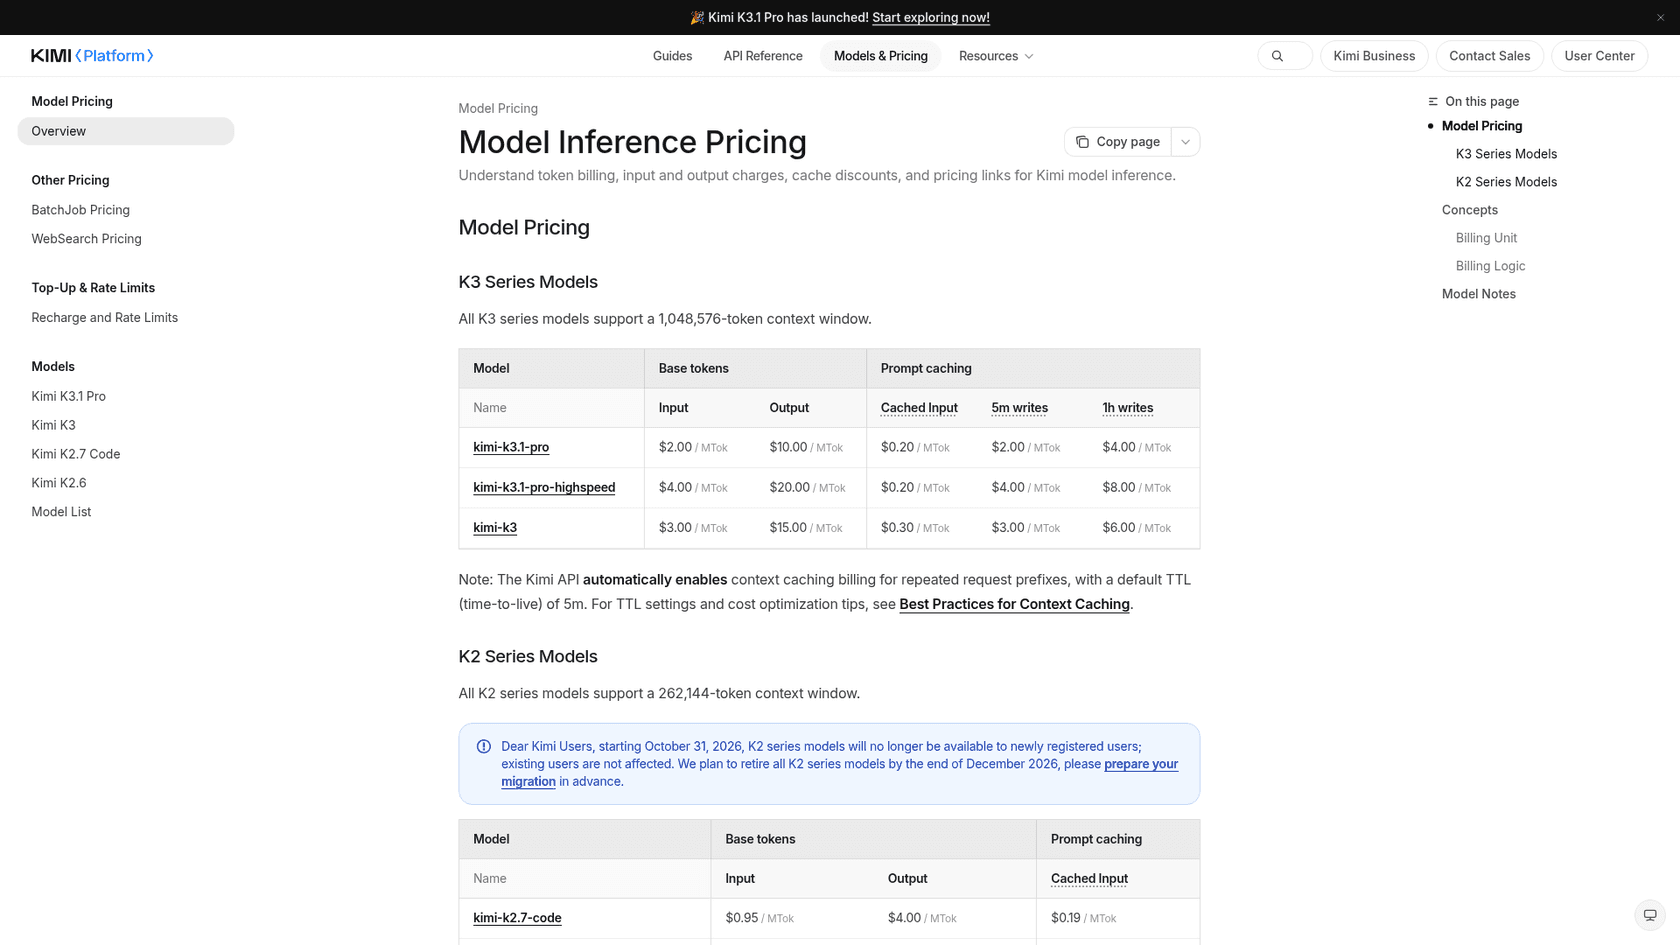
O Kimi K3.1 Pro, da Moonshot, é meio o discreto desta lista. Ele marca 46,0 no índice da Artificial Analysis, abaixo dos outros, mas registra o melhor resultado de raciocínio em contexto longo da minha comparação (86,3% no teste de contexto longo da AA, contra 79,3% do Carbon) e 73,3% no AutomationBench. Sua taxa de alucinação de 37% é a mais baixa fora da família Gemini 4.
Ele custa $3,68 por tarefa da AA, metade do Carbon, e é o modelo mais lento aqui, com cerca de 36 tokens de saída por segundo. Para um agente de suporte redigindo respostas em segundo plano essa velocidade serve, para chat ao vivo não.
Prós
- Melhor nota de contexto longo do grupo.
- Segunda menor taxa de respostas inventadas entre os modelos que você pode comprar.
- Mesma tabela de $2/$10 do preço de lançamento do Carbon.
Contras
- Saída lenta, então não é uma escolha para chat ao vivo.
- Nota principal menor que os modelos de fronteira dos EUA.
- Os pesos abertos ainda não estão disponíveis, então por ora é só por API.
Preços
| Modelo (por 1M de tokens) | Entrada | Saída | Entrada em cache |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
Da página de preços da Kimi Platform. Meu texto sobre os preços do Kimi K3.1 Pro tem as contas por tarefa.
Minha opinião: vale testar se seus tickets são longos e bagunçados, ou se seu agente lê documentos grandes. Use o nível highspeed se a latência importar. Mais na minha análise do Kimi K3.1 Pro.
6. DeepSeek V4.1 Flash
Melhor para: equipes que precisam de pesos abertos, auto-hospedagem ou a menor fatura por token.
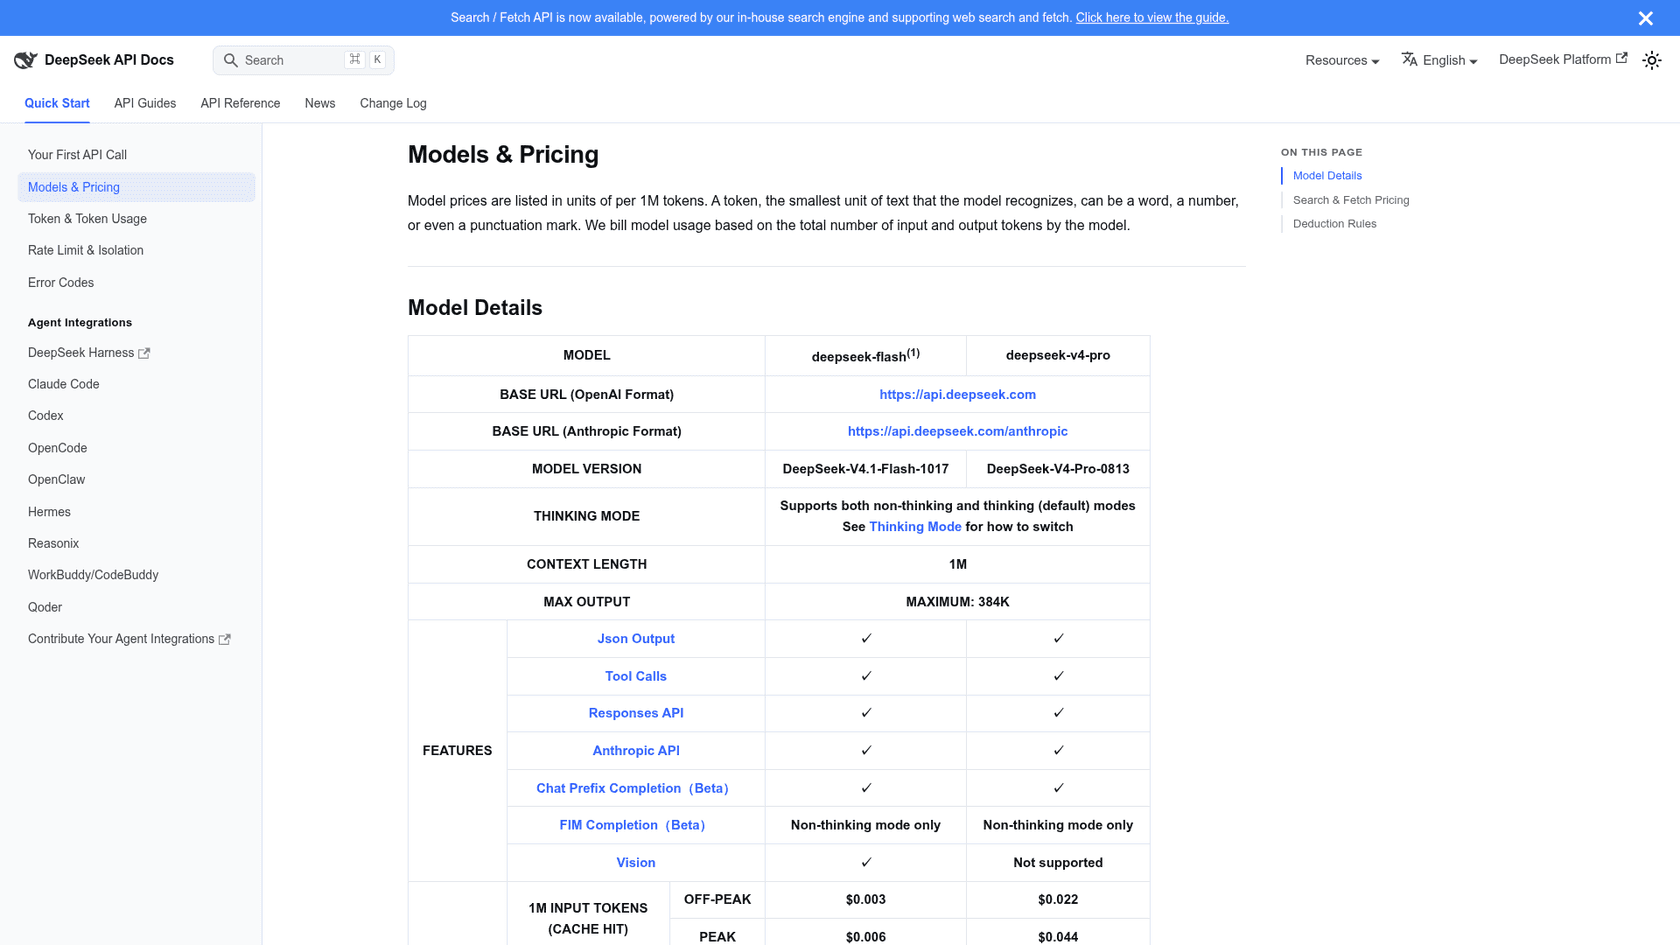
O DeepSeek V4.1 Flash é o único modelo desta lista com pesos abertos, o que importa se seus dados não podem sair dos seus próprios servidores. Na API ele roda a $0,15 de entrada e $0,60 de saída fora do pico, com os horários de pico (01:00 às 04:00 e 06:00 às 10:00 UTC em dias úteis) ao dobro, segundo a página de preços da DeepSeek.
Ele marca 32,5 no índice da Artificial Analysis em esforço máximo por $0,60 por tarefa, e sua taxa de alucinação é de 64%. É um burro de carga capaz e barato, não um modelo da classe do Carbon, e precisa de orientação firme.
"I use DeepSeek too but it's more of a workhorse model, requires a lot more guiding and sometimes struggles to get where I want it."
Prós
- Pesos abertos, então você pode auto-hospedar.
- A fatura de API mais barata desta lista perto da fronteira, com acertos de cache a $0,003 por milhão fora do pico.
- 1M de contexto, 384K de saída máxima, tool calls e visão.
Contras
- Nota muito menor que a do Carbon (32,5 contra 59,4).
- 64% de respostas inventadas, então precisa ser fundamentado.
- O preço de pico dobra o custo nas manhãs de dias úteis na Ásia e na Europa.
Preços
| Por 1M de tokens | Fora do pico | Pico |
|---|---|---|
| Entrada, acerto de cache | $0.003 | $0.006 |
| Entrada, falha de cache | $0.15 | $0.30 |
| Saída | $0.60 | $1.20 |
As APIs Search e Fetch da DeepSeek custam $0,75 por 1.000 requisições, com a cobrança de chamadas de ferramentas no servidor começando em 1º de novembro de 2026. Meu texto sobre os preços do DeepSeek V4.1 Flash cobre o cronograma de pico.
Minha opinião: escolha-o quando auto-hospedagem ou custo por token for a restrição. Não o escolha como substituto do Carbon em qualidade. Veja minha análise do DeepSeek V4.1 Flash.
7. GPT-6 Luna
Melhor para: um modelo barato de primeira passada que separa e responde os tickets fáceis antes que um modelo mais forte veja o resto.
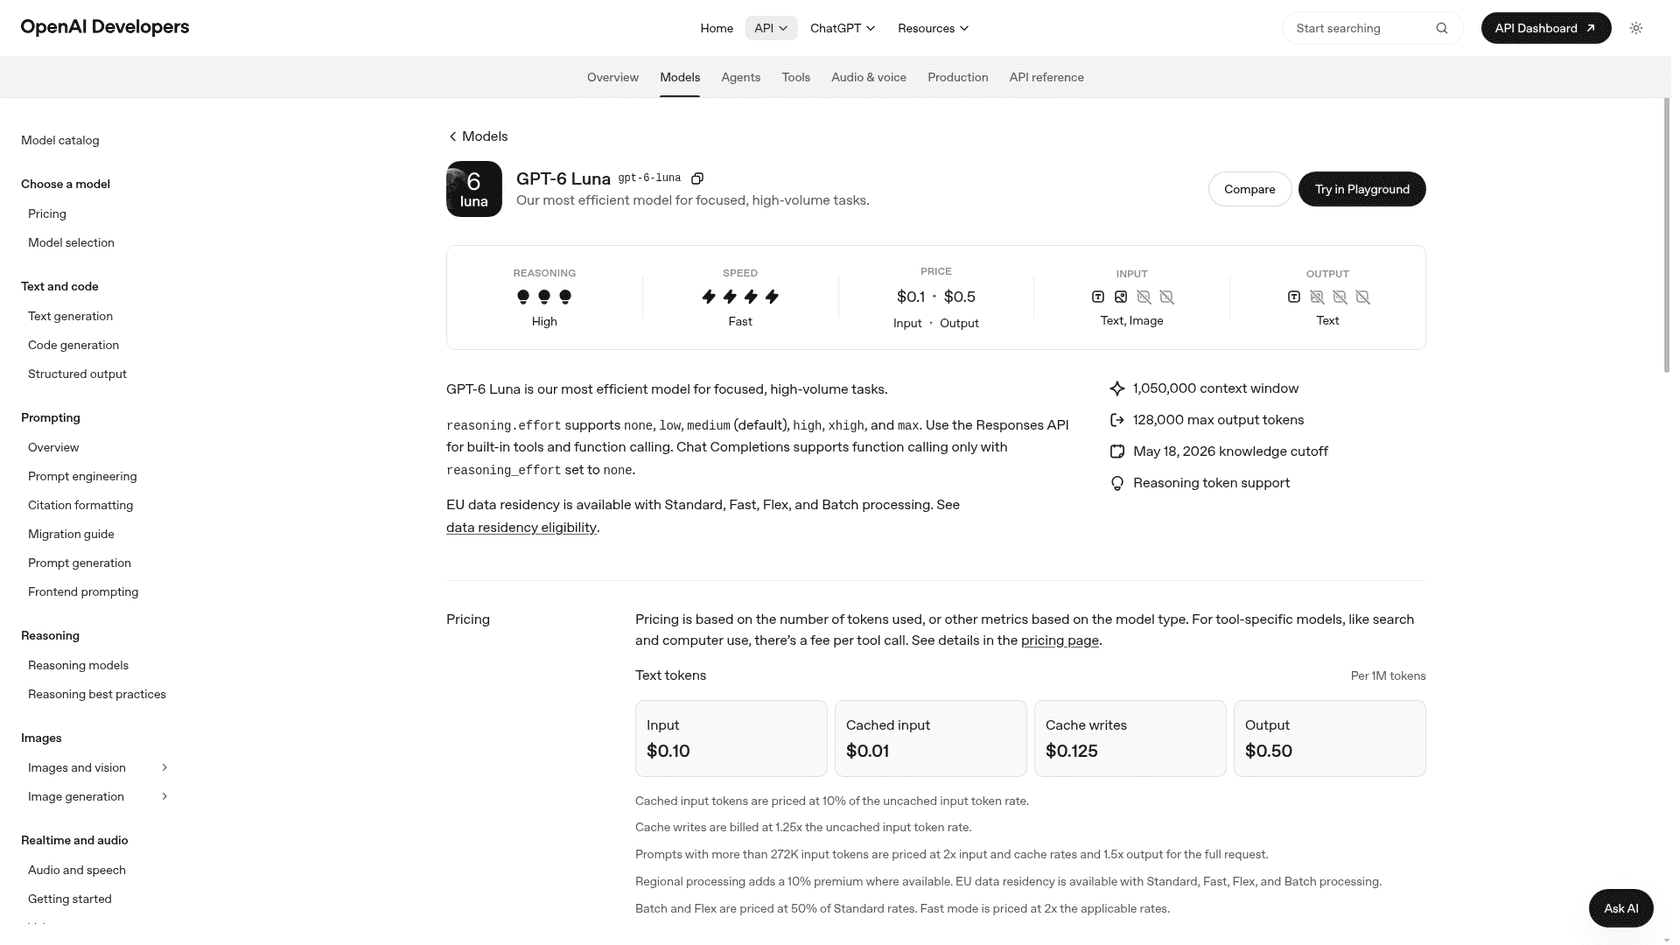
O Luna é a quarta escolha do ChatGPT, para "high-volume, repetitive requests". A OpenAI o chama de seu "most efficient model for focused, high-volume tasks", e a $0,10 de entrada e $0,50 de saída por milhão de tokens ele é 20 vezes mais barato que o preço de lançamento do Carbon.
Sozinho, ele não substitui o Carbon. O Luna marca 27,8 no índice da Artificial Analysis em esforço máximo por $0,15 por tarefa, e inventou respostas em 79% das vezes no AA-Omniscience. O trabalho dele é a triagem: etiquetar o ticket, responder a pergunta sobre status de pedido a partir dos seus dados e repassar todo o resto.
Prós
- O mais barato por tarefa desta lista.
- Rápido, com janela de 1.050.000 tokens.
- Mesma API do Sol, então rotear entre eles é simples.
Contras
- A maior taxa de respostas inventadas aqui (79% em esforço máximo).
- Não serve para nada que exija julgamento.
- Saída apenas em texto.
Preços
| Modo (por 1M de tokens) | Entrada | Saída | Entrada em cache |
|---|---|---|---|
| Padrão | $0.10 | $0.50 | $0.01 |
| Batch / Flex | $0.05 | $0.25 | $0.005 |
| Fast | $0.20 | $1.00 | $0.02 |
Da página de preços da OpenAI. Se você quer um modelo de triagem barato com menos respostas inventadas, o Claude Haiku 5.5 custa os mesmos $0,10/$0,50 para prompts de até 100K tokens e registrou taxa de alucinação de 34% em esforço máximo.
Minha opinião: use o Luna (ou o Haiku 5.5) como primeira camada barata, nunca como único modelo. Mais no meu detalhamento dos preços do GPT-6 Luna.
E se você precisava do Carbon para trabalho real de segurança?
Então não se contente com um modelo geral, candidate-se a um programa restrito, porque modelos gerais bloqueiam de propósito parte do trabalho cibernético. Há três caminhos:
| Caminho | Modelo que você recebe | Como entrar | Custo |
|---|---|---|---|
| Google Fairwind | Gemini 4 Carbon | Formulário de interesse, verificação de antecedentes, 650+ parceiros até agora | $2/$10 de intro do Carbon, depois $4/$20 |
| OpenAI Daybreak | GPT-5.6-Cyber e níveis de acesso do Daybreak | Candidatura; a OpenAI oferece $1 bilhão em créditos do Daybreak para defensores | $12.50 / $75 por 1M para gpt-5.6-cyber na tabela de preços da OpenAI |
| Anthropic Cyber Verification Program | Claude Opus 5.5, Sonnet 5.5 e Mythos 5.1 com menos bloqueios cibernéticos | Uma candidatura por organização; decisão em até sete dias úteis | Preços padrão da API do Claude |
O programa da Anthropic é o mais fácil de entrar entre os três. A atualização de outubro de 2026 acrescentou três níveis de acesso e chama o Opus 5.5 de seu "most capable cyber model yet". Pesquisadores independentes, mantenedores e caçadores de bug bounty podem se candidatar como indivíduos, embora indivíduos por ora só recebam o nível Defense. Meu texto sobre as alternativas ao GPT-5.6-Cyber compara esses programas com mais profundidade.
Nem todos gostam da restrição:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Para tarefas de segurança de rotina, talvez você nem precise de programa algum. A Anthropic diz que seus modelos de disponibilidade geral ainda podem ser usados para revisão segura de código, modelagem de ameaças, correção de problemas conhecidos e triagem de alertas de segurança.
Qual alternativa ao Gemini 4 Carbon você deve escolher?
Parta do motivo pelo qual você queria o Carbon. O mapa abaixo mostra como eu encaminharia a decisão.
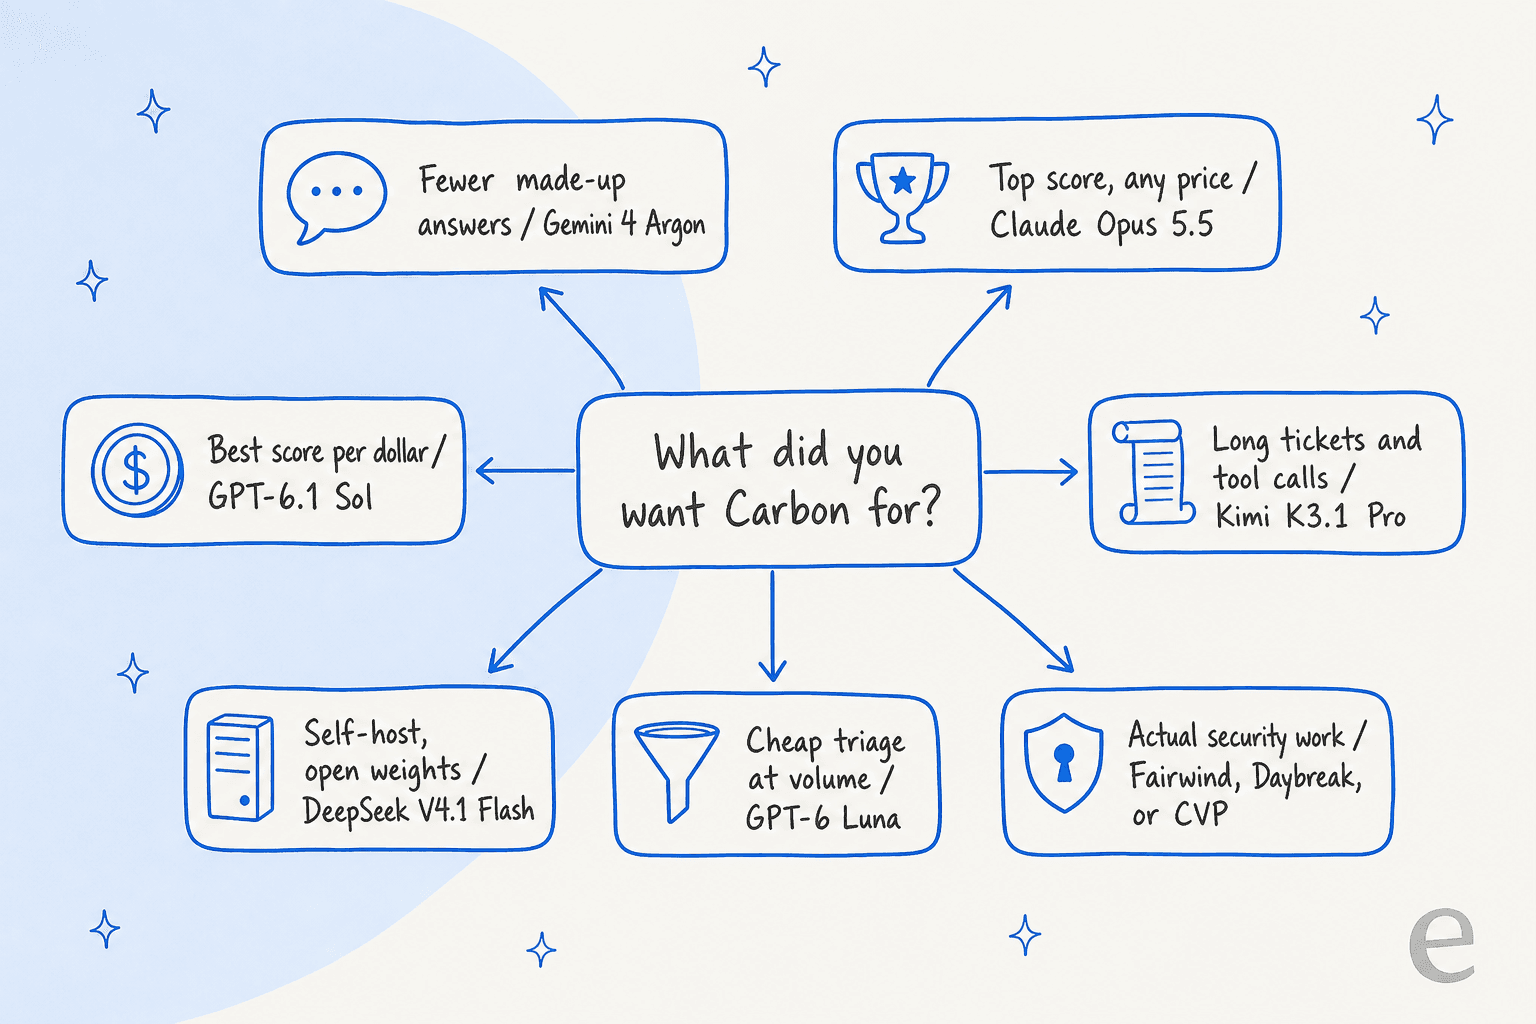
Para a maioria dos leitores a resposta honesta é um par de modelos, não um só. A sugestão de dois modelos do ChatGPT está certa: um modelo barato como o Luna ou o Haiku 5.5 cuida do trabalho fácil e de alto volume, e um mais forte (Argon, Sol ou Sonnet 5.5) pega os casos difíceis. Como cinco desses modelos custam o mesmo por token, a escolha do modelo mais forte se resume a custo por tarefa e taxa de respostas inventadas, não à tabela de preços.
E uma coisa a dizer com clareza: a diferença entre Carbon e Argon em uma fila de suporte é menor do que a diferença entre um agente fundamentado e um sem fundamentação. Todos esses modelos inventam respostas quando alguém pergunta algo que a sua documentação não cobre. A solução é a camada em torno do modelo, que é a parte em que eu realmente trabalho.
Como essa escolha funciona em um agente de suporte real?
Na eesel, o modelo é só uma configuração. O trabalho que decide se os clientes recebem respostas certas é o que o colega de IA lê e o que ele pode fazer. Quando uma equipe conecta seu helpdesk, o agente aprende com os tickets anteriores, a central de ajuda e os documentos internos, segue regras escritas sobre o que passar para uma pessoa e é simulado em tickets históricos antes de responder a alguém ao vivo.
Dois clientes no Freshdesk mostram como isso fica. A Qontro, uma empresa de software ERP, recebe um rascunho de resposta com artigos de ajuda já vinculados em cada ticket do Freshdesk, redigiu 190 tickets em um mês e responde a partir de 9.800 tickets anteriores e artigos de ajuda. A SamCart roda um agente por canal, um nos tickets do Freshdesk e outro no chat do site, com um plano dimensionado para 8.000 interações por mês.
Nenhuma das duas precisou de um modelo de segurança de fronteira. Precisaram de um agente que diga "vou chamar uma pessoa" em vez de chutar. Se você está comparando modelos para uma fila de suporte, meu guia do melhor modelo para tickets de suporte aprofunda essa troca, assim como o texto sobre LLMs para atendimento ao cliente.
Experimente a eesel
Se você chegou aqui porque queria o Carbon dentro de um agente de suporte, a eesel é o caminho mais curto. É um colega de helpdesk com IA que se conecta ao Freshdesk, ao Zendesk e a outros helpdesks, aprende com seus tickets anteriores e sua central de ajuda e é testado no seu próprio histórico de tickets antes de responder a um cliente. A escolha do modelo fica resolvida, e você tem a fundamentação que impede qualquer um desses modelos de inventar coisas.
Você pode ver os planos na página de preços da eesel, ou experimentar a eesel grátis nos seus próprios tickets.