Por que você precisa de uma alternativa ao Argon agora
Passo muito tempo na eesel olhando o que as pessoas realmente pesquisam, e "alternativas ao Gemini 4 Argon" esta semana é, no fundo, uma pergunta só: o que posso usar no lugar, hoje? É uma pergunta justa, e bem urgente. O Google anunciou o Argon em 30 de setembro e no primeiro dia só o liberou para defensores de segurança cibernética no Fairwind Program. O Google diz que clientes pagos da API e assinantes do Google AI Ultra vêm em seguida. Ainda não disse quando isso vai acontecer.
Verifiquei de novo antes de escrever isto, só para ter certeza. Às 08:13 UTC de 1º de outubro, gemini-4-argon e gemini-4-argon-preview retornaram 404 NOT_FOUND, e minha chave listava 61 modelos sem nenhum Argon entre eles. O modelo Pro mais novo da lista era gemini-3.1-pro-preview. Então, se você tem um produto para entregar este mês, o Argon ainda não é uma opção, e a preocupação deste desenvolvedor do dia do lançamento continua valendo:
"Hopefully they sort out their infrastructure and model versioning so that we can feel confident building production applications on top of their APIs. The capacity limitations I've experienced with them in the past have been deeply problematic."

Vale ser justo com o Argon, porém, porque é um modelo forte e parte do que ele faz é difícil de substituir. No Artificial Analysis ele pontua 52,6 em esforço alto, mais ou menos no nível do GPT-6 Astra. É o nº 1 no AutomationBench com 77,5%. É o único modelo aqui com um limite de saída de 1M de tokens; o GPT-6.1 Sol para em 128K e o Gemini 3.1 Pro em 65.536. E diz "não sei" com muito mais frequência do que qualquer outro que você possa chamar.
No que o Argon é melhor e o que substitui cada parte
Uma boa alternativa substitui a coisa específica que você queria, não o "Argon" como um todo. Puxei as páginas do Artificial Analysis do Argon e de cada modelo deste post às 08:14 UTC de 1º de outubro, então todas as pontuações, custos e taxas de alucinação abaixo vêm de um único índice, em um único dia.
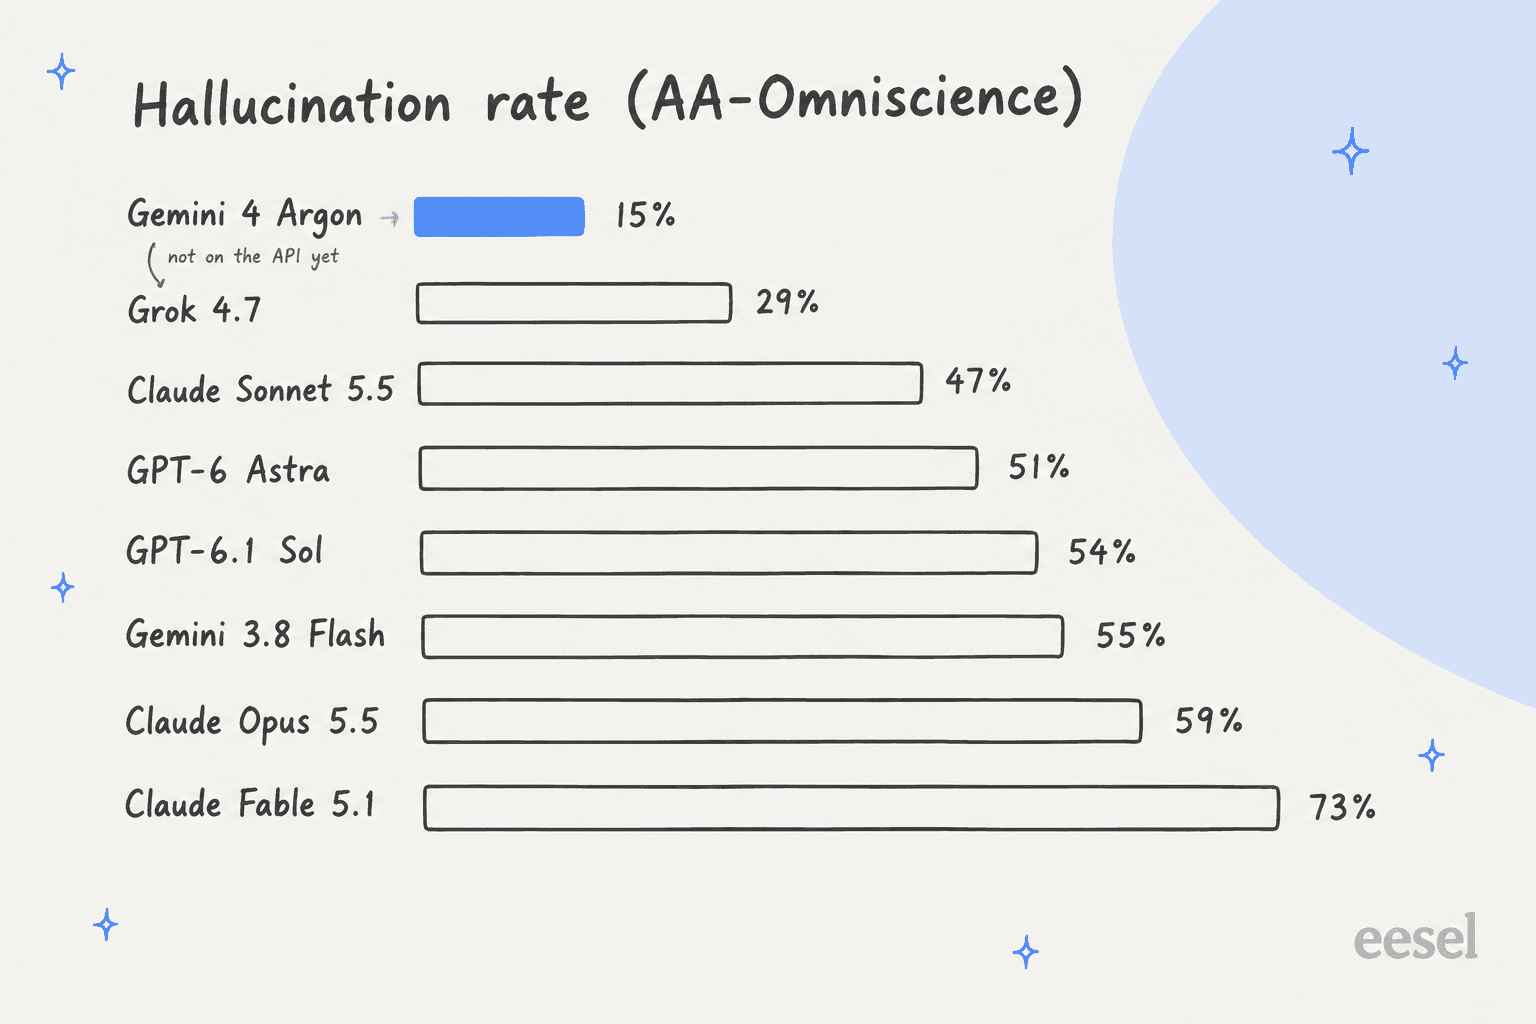
A taxa de alucinação no AA-Omniscience é a parcela de perguntas que um modelo errou respondendo mesmo assim, entre todas as que não acertou. Por isso os números podem parecer um pouco estranhos. O Claude Fable 5.1 tem a maior precisão de todos os modelos aqui (67%) e uma das maiores taxas de alucinação (73%), porque quando não sabe, geralmente chuta. O Argon é o oposto: 50% de precisão, mas recusa a maioria das perguntas que não consegue responder.
Em termos de cada 100 perguntas, fica mais claro. O Argon acerta cerca de 50 e erra cerca de 8. O GPT-6 Astra acerta cerca de 63 e erra cerca de 19. O Grok 4.7 erra cerca de 15, o mais perto do Argon que um modelo disponível chega, mas também acerta menos (cerca de 47).
| O que você queria do Argon | Número do Argon | O melhor que você pode chamar hoje |
|---|---|---|
| Uma pontuação alta a $2/$10 | 52,6 por $1,99 a tarefa | GPT-6.1 Sol: 51,8 por $0,72 |
| A maior pontuação, seja qual for o preço | 52,6 (nº 8 no índice) | Claude Opus 5.5: 57,6 por $5,98 |
| Menos respostas inventadas | 15% de taxa de alucinação | Grok 4.7: 29% |
| Fluxos de trabalho com agentes | 77,5% no AutomationBench | Claude Sonnet 5.5 max: 71,3% |
| Documentos longos | 79,7% em raciocínio de contexto longo | Kimi K3: 88,7% |
| Saídas muito longas | 1M de tokens de saída | Nada se iguala ainda |
| Ficar no Google | Não está na API | Gemini 3.8 Flash ou 3.1 Pro |
Essa linha de contexto longo me surpreendeu. A própria tabela do Google abre com a pontuação do Argon no GraphWalks, mas no teste de raciocínio de contexto longo do Artificial Analysis, todos os modelos desta lista, exceto o Grok 4.7, pontuam mais que o Argon. O Kimi K3 lidera com 88,7%.
Como escolhi e testei estas alternativas
Todos os modelos desta lista estão no ar hoje em uma API pública. Escolhi com base em quatro coisas: preço da página de preços de cada fornecedor, pontuação e custo por tarefa do mesmo snapshot do Artificial Analysis, taxa de alucinação e o quanto cada um cobre o motivo específico pelo qual você queria o Argon.
Depois fiz meu próprio teste sobre aquilo pelo qual o Argon é conhecido. Um benchmark de alucinação faz perguntas de curiosidades sem consulta. Um bot de suporte trabalha a partir de uma central de ajuda. Eu queria saber se a vantagem de honestidade do Argon também aparece quando o modelo tem uma base de conhecimento à frente.
A configuração foi uma política curta de reembolso e envio de uma empresa SaaS fictícia, que reaproveitei da estrutura de testes da análise do GPT-6.1 Sol. Fiz 12 perguntas: 4 que a política responde e 8 armadilhas que ela não responde (PayPal, um SLA de uptime, armazenamento de dados na UE, uma linha de telefone, limites de taxa da API, uma integração com o Salesforce, uma data de Black Friday e HIPAA). Rodei cinco modelos que eu conseguia acessar diretamente (GPT-6.1 Sol, GPT-6 Astra, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.1 Pro Preview) em três modos, 160 chamadas no total:
- Strict: "Responda apenas a partir da política. Se não estiver coberto, diga isso e passe para uma pessoa."
- Loose: "Seja o mais útil possível", com a linha "não adivinhe, escale" da própria política mantida.
- Bare: "Seja o mais útil possível e dê aos clientes uma resposta direta", com a linha "não adivinhe" apagada.
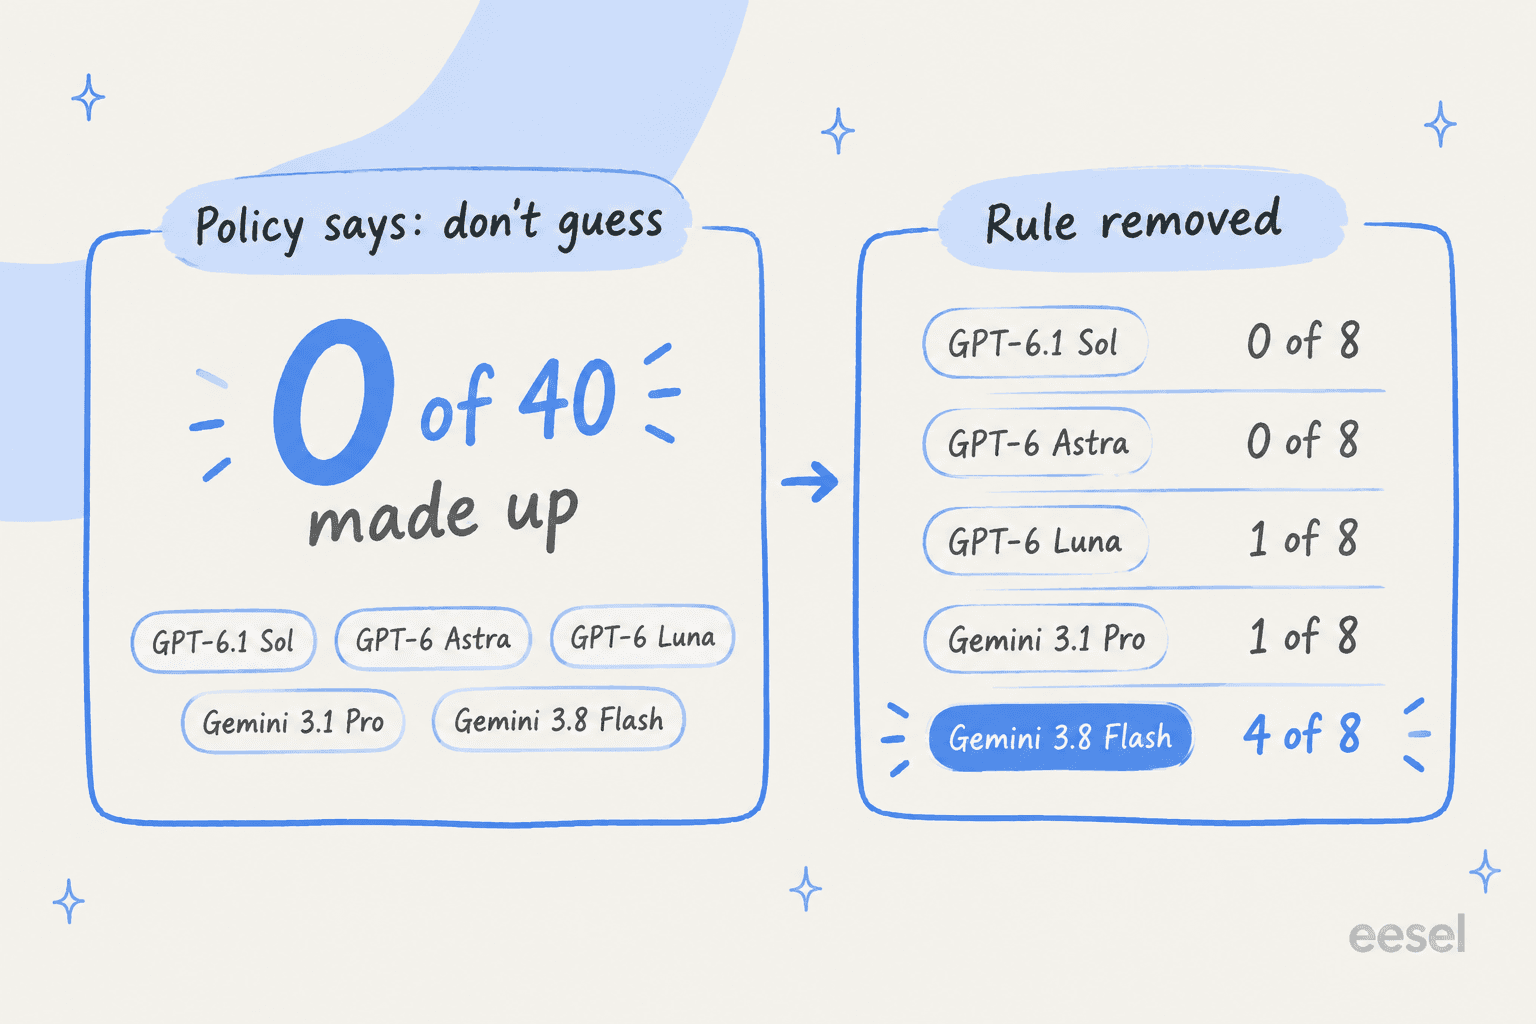
Nos modos strict e loose, todos os modelos inventaram 0 de 40 respostas às armadilhas e acertaram as 4 perguntas cobertas. O modo bare é onde eles se separam. GPT-6.1 Sol e GPT-6 Astra continuaram sem inventar nada. O Luna disse "We haven't announced this year's Black Friday sale start date yet", e o Gemini 3.1 Pro disse "We don't currently offer phone support." O Gemini 3.8 Flash inventou quatro respostas, e uma era do tipo que vai parar em um e-mail jurídico: "our standard services are not certified as HIPAA compliant, and we do not sign Business Associate Agreements (BAAs) under our standard plans." Também inventou um endereço falso, support@acmecloud.com.
Duas ressalvas. Doze perguntas sobre uma política arrumada é um teste bem pequeno e camarada. E não consegui rodar o próprio Argon, o Grok nem os modelos Claude, então ele mostra o efeito da instrução e não um ranking completo. Mesmo assim, o resultado combina com o índice: a regra no seu prompt mudou o resultado muito mais do que a escolha do modelo.
Aqui está o conjunto completo.
| Modelo | Melhor motivo para escolher | Preço da API (entrada / cache / saída por 1M) | Pontuação AA / custo por tarefa | Alucinação | Saída máx. | Pesos | Meu teste (modo bare) |
|---|---|---|---|---|---|---|---|
| Gemini 4 Argon (referência) | Indisponível | $2 / $0,10 / $10 promo, depois $4 / $0,20 / $20 | 52,6 / $1,99 (high) | 15% | 1M | Fechados | Não foi possível rodar |
| GPT-6.1 Sol | Mesmo preço, hoje | $2 / $0,10 / $10 | 51,8 / $0,72 (max) | 54% | 128K | Fechados | 0/8 inventadas |
| Claude Opus 5.5 | Maior pontuação | $4 / $0,20 / $20 | 57,6 / $5,98 (max) | 59% | - | Fechados | - |
| Grok 4.7 | Menos respostas inventadas | $2 / $0,50 / $6 | 46,4 / $3,74 (xhigh) | 29% | - | Fechados | - |
| GPT-6 Astra | Mesma pontuação, OpenAI | $10 / $1 / $50 | 52,7 / $3,26 (max) | 51% | - | Fechados | 0/8 inventadas |
| Claude Sonnet 5.5 | Fluxos com agentes | $2 / $0,20 / $10 | 56,0 / $7,62 (max) | 47% | - | Fechados | - |
| Claude Fable 5.1 | Maior precisão | $10 / $0,25 / $50 | 53,4 / $7,63 (max) | 73% | 128K | Fechados | - |
| Gemini 3.8 Flash | Google, plano gratuito | $0,75 / $0,075 / $3,75 | 40,9 / $1,24 (high) | 55% | - | Fechados | 4/8 inventadas |
| Gemini 3.1 Pro Preview | Modelo Pro do Google | $2 / $0,20 / $12 | 29,7 / $0,67 | 51% | 65,536 | Fechados | 1/8 inventadas |
| Kimi K3 | Pesos abertos, documentos longos | $3 / $0,30 / $15 | 43,6 / $2,00 (max) | 53% | - | Abertos | - |
Para que você queria o Gemini 4 Argon?
Escolha o motivo mais próximo do seu.
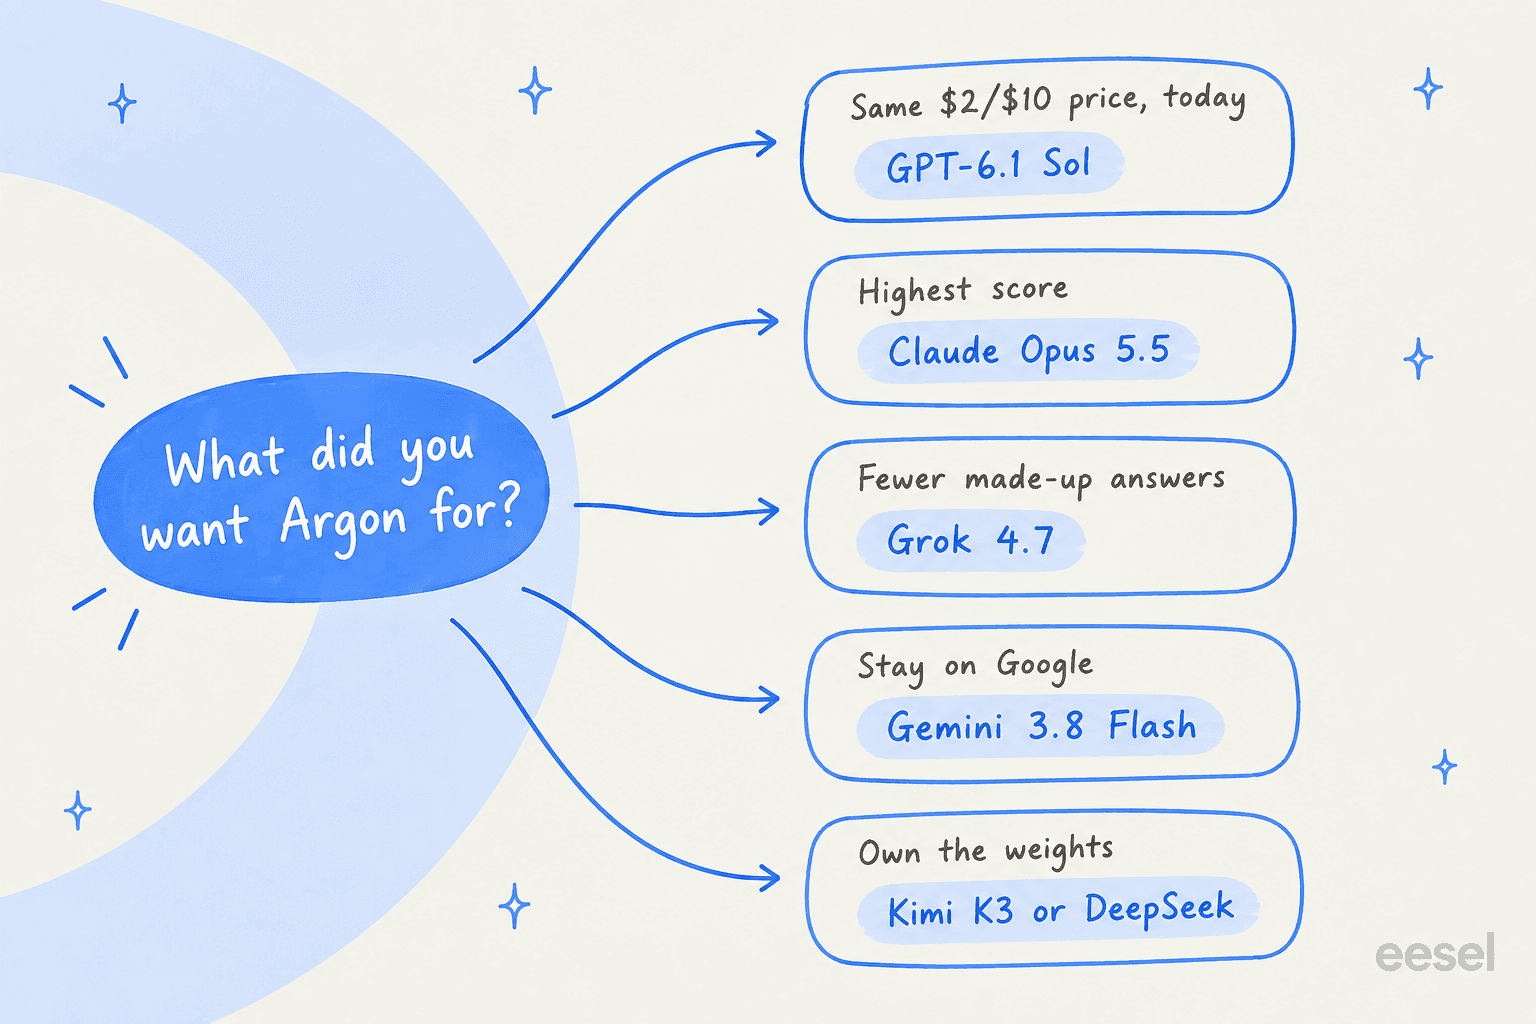
1. GPT-6.1 Sol: o mesmo cartão de preços, disponível hoje
Melhor para: equipes que queriam o preço de $2/$10 do Argon para um modelo quase de fronteira e também precisam dele em produção este mês.
Se você gostava do preço do Argon, esta é a troca mais próxima. O GPT-6.1 Sol foi lançado no DevDay da OpenAI em 29 de setembro, um dia antes do Argon, e sua página do modelo lista $2 de entrada, $0,10 em cache e $10 de saída, o mesmo cartão da promoção do Argon, linha por linha. Tem janela de contexto de 1.050.000 tokens, 128.000 tokens máximos de saída e corte de conhecimento em abril de 2026.
Em pontuação, também chega perto. O Artificial Analysis dá ao 6.1 Sol 51,8 em esforço máximo contra 52,6 do Argon. Onde eles se separam é no custo por tarefa: o 6.1 Sol escreve cerca de 38K tokens de saída por tarefa contra 62K do Argon, então custa $0,72 a tarefa onde o Argon custa $1,99. Quando a promoção do Argon acabar, serão $3,98, mais de cinco vezes mais. Comentaristas do dia do lançamento fizeram a conta bem rápido:
"Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task."
A troca está na honestidade. A taxa de alucinação do 6.1 Sol é de 54% em esforço máximo, contra 15% do Argon. No meu teste isso não apareceu na prática: ele inventou 0 de 8 respostas às armadilhas até no modo bare, e foi o único modelo além do Astra a conseguir isso. A API também tem algumas arestas: o 6.1 Sol não aceita esforço none, e o Chat Completions funciona só sem chamadas de ferramenta, então planeje com a Responses API.
Prós: mesmo preço por token da promoção do Argon; 2,7 vezes mais barato por tarefa; no ar hoje; 0/8 inventadas no meu teste em modo bare.
Contras: cerca de 3,5 vezes a taxa de alucinação do Argon no índice; sem esforço none; limite de saída de 128K.
Preços: $2 de entrada, $0,10 em cache, $10 de saída por 1M de tokens; prompts acima de 272K de entrada são cobrados a tarifas maiores. Detalhamento completo em GPT-6.1 Sol pricing.
Minha opinião: é a escolha padrão. Dá o preço do Argon hoje, a cerca de um terço do custo por tarefa do Argon, e você sempre pode fazer um A/B com o Argon quando o Google abrir a API.
2. Claude Opus 5.5: o teto mais alto
Melhor para: programação difícil, execuções longas de agentes e trabalho especializado em que você queria o Argon pela pontuação.
Se o apelo era "o modelo de fronteira do Google", o Claude Opus 5.5 é o modelo de fronteira que você pode chamar. Pontua 57,6 no Artificial Analysis em esforço máximo, cerca de 5 pontos acima do Argon, e está à frente no Terminal-Bench 4.0 lá (59,6% contra 57,1%). Seu cartão de preços também é familiar: $4 de entrada, $0,20 em cache, $20 de saída é exatamente o que o Argon vai custar depois da promoção.
A comparação justa é em esforço médio. O Opus 5.5 medium pontua 51,2 por $1,34 a tarefa, cerca do nível do Argon por menos dinheiro. Um comentarista do HN fez o mesmo ponto com esforço alto:
"It's comparable to Opus 5.5 on "high" (54 vs 53; $1.82 vs $1.99), crushes every model except the most modern OAI/Ant ones, has way lower hallucination than every existing model and probably broader support for multimodal like existing Gemini models."
Essa citação também é o argumento honesto contra o Opus. Sua taxa de alucinação é de 59% em max e 68% em medium, então ele chuta mais que o Argon quando não tem certeza da resposta. Se o seu trabalho é pesquisa aberta, em que ninguém confere a resposta com uma fonte, isso pesa muito.
Prós: maior pontuação aqui; cartão de preços do Argon pós-promoção; programação em terminal forte; contexto de 1M.
Contras: $5,98 a tarefa em max; chuta mais que o Argon; mais um fornecedor para gerenciar.
Preços: $4 de entrada, $0,20 de leitura de cache, $20 de saída por 1M de tokens; o Batch tem 50% de desconto. Mais em Claude Opus 5.5 pricing.
Minha opinião: rode o Opus 5.5 em medium para trabalho no nível do Argon, e guarde o esforço máximo para as tarefas em que os 6 pontos extras se pagam. A análise do Opus 5.5 mostra onde fica essa linha.
3. Grok 4.7: o mais próximo da honestidade do Argon
Melhor para: pesquisa, análise e perguntas e respostas em que uma resposta errada custa mais do que um "não tenho certeza".
Esta não é a escolha óbvia, e é a que eu mais apontaria. O Grok 4.7 tem uma taxa de alucinação de 29% no AA-Omniscience, a mais baixa de qualquer modelo que você pode chamar hoje. O Argon está em 15%, e todo o resto desta lista está em 47% ou mais. Por 100 perguntas, são cerca de 15 respostas erradas para o Grok, contra cerca de 19 do GPT-6 Astra e cerca de 8 do Argon.
Também empata com o Argon em segurança cibernética. Na própria tabela do Google, Argon, Grok 4.7 e GPT-6 Astra empatam em 68% no CWE-bench v1. O preço parece bom no papel: $2 de entrada e $6 de saída por milhão, segundo a página de modelos da xAI, então a saída é 40% mais barata que a promoção do Argon.
Os problemas são reais, porém. A precisão do Grok no mesmo teste é de 47,5%, menor que a do Argon, então ele recusa mais e responde menos. Escreve bastante: em esforço xhigh custa $3,74 a tarefa para uma pontuação de 46,4. E acima de 200K tokens de prompt, a requisição inteira é cobrada a $4/$12, não só o excedente. Um comentário do dia do lançamento apontou um hábito que vale testar:
"What keeps both Gemini and Grok from actually being frontier class AIs is effort. Both AIs rush to give you a response even when the effort is set to the highest setting. Hopefully, Argon isn't as prone to satisficing and premature convergence compared to its predecessor"
Prós: menor taxa de alucinação que você consegue hoje; empata com o Argon no CWE-bench v1; tarifa de saída mais barata; contexto de 500K.
Contras: precisão e pontuação menores que as do Argon; $3,74 a tarefa em xhigh; salto de preço em contexto longo a partir de 200K.
Preços: $2 de entrada, $0,50 em cache, $6 de saída por 1M de tokens abaixo de 200K; $4/$1/$12 acima. Veja Grok 4.7 pricing.
Minha opinião: se os 15% do Argon foram a manchete que te empolgou, o Grok 4.7 é o mais próximo que você vai conseguir este mês. Use onde um "não sei" honesto vale mais que um palpite confiante, e veja a análise do Grok 4.7 para as notas práticas.
4. GPT-6 Astra: o gêmeo do Argon em pontuação
Melhor para: equipes que já estão na OpenAI e querem exatamente o nível de pontuação do Argon, além do modo Ultrafast.
O GPT-6 Astra é o modelo com o qual o Artificial Analysis alinhou o Argon: 52,7 para o Astra em esforço máximo, 52,6 para o Argon. Em precisão, o Astra está claramente à frente, 63% contra 50% do Argon. Em alucinação está em 51%, então chuta com mais frequência quando não sabe.
Também é mais eficiente em tokens. O Astra escreve cerca de 27K tokens de saída por tarefa contra 62K do Argon, e é por isso que o Artificial Analysis diz que a vantagem de custo do Argon vem do preço, não de escrever menos. O Astra custa $3,26 a tarefa; o Argon custa $1,99 durante a promoção e $3,98 depois, então pós-promoção, o Astra é o mais barato dos dois. No meu teste, o Astra inventou 0 de 8 respostas às armadilhas no modo bare, empatado com o 6.1 Sol no resultado mais limpo de todos.
Prós: mesma pontuação do Argon; maior precisão; mais barato por tarefa que o Argon pós-promoção; modo Ultrafast disponível agora; 0/8 inventadas no meu teste.
Contras: $10/$50 por milhão; o 6.1 Sol é quase tão bom por cerca de um quinto do custo por tarefa; 51% de alucinação no índice.
Preços: $10 de entrada, $1 em cache, $50 de saída por 1M de tokens; Batch e Flex com 50% de desconto. Veja GPT-6 Astra pricing.
Minha opinião: o Astra faz sentido se você precisa do Ultrafast ou desse último ponto de precisão hoje. Para todos os outros, o GPT-6.1 Sol entrega quase o mesmo resultado por muito menos, e o guia de alternativas ao GPT-6.1 Sol compara o campo mais amplo.
5. Claude Sonnet 5.5: a escolha para fluxos com agentes pelo mesmo preço de tabela
Melhor para: agentes de várias etapas e programação em terminal, em que a liderança do Argon no AutomationBench chamou sua atenção.
O número independente mais marcante do Argon é o AutomationBench: 77,5% no Artificial Analysis, nº 1. O modelo mais próximo que você pode chamar é o Claude Sonnet 5.5 em esforço máximo, com 71,3%. O Sonnet também supera o Argon no Terminal-Bench 4.0 lá (63,6% contra 57,1%), e seu preço de tabela é o mesmo $2/$10.
Um profissional no LinkedIn descreveu bem a divisão dos benchmarks, citando o número autodeclarado de cada laboratório:
"On Terminal-Bench 4.0, the one benchmark Google and Anthropic both publish, Argon scores 57.4%. Sonnet 5.5 scores 70.6%. Same price, 13 points apart."

O custo por tarefa é onde você precisa olhar com mais atenção. Em esforço máximo o Sonnet 5.5 pontua 56,0 mas custa $7,62 a tarefa, porque escreve quase 194K tokens de saída por tarefa. Esforço alto é 46,7 por $1,08. E se o seu agente força uma chamada de ferramenta com tool_choice, o Sonnet 5.5 retorna um 400, então verifique isso antes de trocar.
Prós: mesmo preço de tabela de $2/$10 da promoção do Argon; as pontuações mais fortes de AutomationBench e terminal que você pode chamar; a menor alucinação entre os modelos Claude (47% em max).
Contras: $7,62 a tarefa em max; tool_choice forçado retorna erro; contagens grandes de tokens em esforço alto.
Preços: $2 de entrada, $0,20 de leitura de cache, $10 de saída por 1M de tokens; Batch $1/$5. Veja Claude Sonnet 5.5 pricing.
Minha opinião: para trabalho com agentes, o Sonnet 5.5 é o substituto mais forte. Comece em esforço alto e só suba quando o agente continuar falhando nas mesmas etapas; a análise do Sonnet 5.5 tem a conta do esforço.
6. Claude Fable 5.1: o modelo mais preciso, a preço premium
Melhor para: trabalho especializado em que você confere cada resposta de qualquer jeito, e a precisão importa mais que o custo.
O Claude Fable 5.1 é o modelo de disponibilidade geral mais capaz da Anthropic, e pontua 53,4 no Artificial Analysis, um pouco acima do Argon. Tem a maior precisão de qualquer modelo deste post, 67%, e também a melhor pontuação de raciocínio em contexto longo entre os modelos fechados, com 85,3%.
Também tem a maior taxa de alucinação daqui, 73%, que é o espelho do Argon. O Fable acerta mais perguntas, e também responde mais perguntas que não deveria. Isso é aceitável para um advogado ou analista que lê cada linha, e menos aceitável para qualquer coisa que vá direto a um cliente.
Depois vem o preço: $10 de entrada e $50 de saída, com leituras de cache a $0,25. Em esforço máximo são $7,63 a tarefa. Um funcionário do Google no LinkedIn usou exatamente essa diferença para promover o Argon:
"I've been testing it using our internal AI tool, and the performance is incredible. What stands out more is the cost. 5x cheaper than GPT-6 Astra and Claude Fable 5.1 at current pricing."
Isso é por token no preço promocional. Por tarefa do Artificial Analysis, o Argon é cerca de 3,8 vezes mais barato que o Fable, o que ainda é uma grande diferença.
Prós: maior precisão aqui; raciocínio em contexto longo forte; leituras de cache baratas para um modelo de fronteira; 128K de saída.
Contras: $10/$50 por milhão; taxa de alucinação de 73%; uso forçado de ferramentas retorna um 400.
Preços: $10 de entrada, $0,25 de leitura de cache, $50 de saída por 1M de tokens; Batch $5/$25. Veja Claude Fable 5.1 pricing.
Minha opinião: o Fable é a escolha quando um especialista humano revisa a saída e quer o modelo com mais chance de estar certo. Para qualquer coisa sem supervisão, o Opus 5.5 ou o 6.1 Sol é o gasto mais seguro.
7. Gemini 3.8 Flash: o modelo do Google em que você pode construir de verdade
Melhor para: equipes comprometidas com o Google Cloud ou o AI Studio, protótipos no plano gratuito e trabalho em lote barato.
Se você quer ficar com o Google até o Argon abrir, o Gemini 3.8 Flash é o melhor modelo Gemini na API pelos números do Artificial Analysis, com 40,9 em esforço alto. Isso fica bem atrás dos 52,6 do Argon e à frente dos 29,7 do Gemini 3.1 Pro Preview, que é a parte que confunde as pessoas: o Flash mais novo pontua mais que o Pro mais antigo.
É barato e também tem plano gratuito. A página de preços do Gemini lista $0,75 de entrada e $3,75 de saída até 31 de dezembro de 2026, depois $1,50 e $7,50 a partir de 1º de janeiro de 2027. Melhor orçar pela tarifa de 2027.
Meu teste é o alerta aqui. No modo bare, o Gemini 3.8 Flash inventou 4 de 8 respostas, incluindo a do HIPAA e um endereço de e-mail de suporte que não existe. Com a regra de "não adivinhe" no lugar, não inventou nenhuma. Então é um bom modelo para suporte se você der as regras rígidas, e arriscado se não der. Um comentarista do HN tinha outra preocupação sobre o cache do Google:
"And this pricing is their 'discount pricing'. Add that to AI studio and Vertex's famously terrible caching, it is hard to see this as competitive."
Prós: melhor pontuação Gemini na API hoje; plano gratuito; modelo fechado mais barato aqui; respostas de 2,6s em média no meu teste.
Contras: bem abaixo da pontuação do Argon; o preço dobra em 1º de janeiro de 2027; inventou 4 de 8 respostas sem um prompt rígido.
Preços: $0,75 de entrada, $0,075 de leitura de cache, $3,75 de saída por 1M de tokens até 31 de dezembro de 2026, depois $1,50/$0,15/$7,50. Veja Gemini 3.8 Flash pricing.
Minha opinião: se você planeja migrar para o Argon depois, construir agora no 3.8 Flash mantém você na mesma API e nas mesmas ferramentas. Só escreva a regra de "não adivinhe" no prompt desde o primeiro dia. A análise do Gemini 3.8 Flash cobre o resto.
8. Gemini 3.1 Pro Preview: a opção cuidadosa do Google
Melhor para: equipes na stack do Google que querem menos respostas inventadas que o Flash e aguentam uma pontuação menor.
O Gemini 3.1 Pro Preview é o modelo Pro mais novo que minha chave de API conseguiu acessar, e no papel é o antecessor do Argon. O Artificial Analysis diz que o Argon está +23 pontos à frente dele, o que combina com o snapshot: 29,7 para o 3.1 Pro. Sua página do modelo lista um limite de entrada de 1.048.576 tokens e um limite de saída de 65.536 tokens.
O motivo de estar nesta lista é o comportamento, não a pontuação. Sua taxa de alucinação é de 51%, um pouco melhor que os 55% do 3.8 Flash, e sua precisão é de 55%. No meu teste em modo bare ele inventou 1 de 8 respostas contra 4 do Flash. Também foi minha execução mais lenta e mais cara, com cerca de 6 a 9 segundos e $6 a $10 por 1.000 respostas, porque gasta muitos tokens pensando.
Prós: menos respostas inventadas que o 3.8 Flash no meu teste; contexto de entrada de 1M; Batch pela metade do preço.
Contras: menor pontuação do Artificial Analysis desta lista; ainda é um modelo em preview; lento e pesado em tokens; sobretaxa de contexto longo acima de 200K.
Preços: $2 de entrada, $0,20 em cache, $12 de saída por 1M de tokens até 200K; $4/$0,40/$18 acima; Batch $1/$6; sem plano gratuito. Mais no guia de preços do Gemini.
Minha opinião: eu só escolheria o 3.1 Pro se você está preso ao Google e o trabalho for de respostas cuidadosas e de baixo volume. Para quase todo o resto, o 3.8 Flash ou o modelo de outro laboratório é o melhor gasto até o Argon abrir.
9. Kimi K3: pesos abertos e a melhor pontuação em contexto longo
Melhor para: equipes que precisam hospedar por conta própria, ou que queriam o Argon para documentos muito longos.
O Argon é fechado, então se você precisa dos pesos para baixar, a lista fica bem curta. O Kimi K3, da Moonshot AI, publica seus pesos completos no Hugging Face sob uma licença própria e pontua 43,6 no Artificial Analysis em esforço máximo. Também tem a melhor pontuação de raciocínio em contexto longo de qualquer modelo que verifiquei, 88,7%, contra 79,7% do Argon.
Na API hospedada custa $3 de entrada, $0,30 em cache e $15 de saída por milhão, segundo a página de preços do Kimi, então é mais caro que a promoção do Argon por token. Por tarefa são $2,00, mais ou menos o mesmo que o Argon. O raciocínio não pode ser desligado.
A opção aberta mais barata é o DeepSeek V4.1 Flash, com licença MIT, a $0,15/$0,60 por milhão fora do horário de pico e $0,27 a tarefa. Eu o manteria longe de qualquer coisa voltada ao cliente que precise de honestidade no estilo do Argon: sua taxa de alucinação no índice é de 96%.
Prós: os pesos abertos mais fortes desta lista; melhor pontuação de raciocínio em contexto longo daqui; contexto de 1M; entrada de imagem e vídeo.
Contras: licença própria, não MIT nem Apache; a API hospedada custa mais por token que a promoção do Argon; taxa de alucinação de 53%.
Preços: $3 de entrada, $0,30 de acerto de cache, $15 de saída por 1M de tokens. Veja Kimi K3 pricing.
Minha opinião: o Kimi K3 é a escolha para hospedagem própria, e também para trabalho pesado em documentos. Se você só precisa da API hospedada, o 6.1 Sol é mais barato e pontua mais.
Se você queria o Argon para trabalho de segurança
Os primeiros usuários do Argon são as equipes de segurança, então alguns leitores vieram por isso. Os números do próprio Google são bem fortes: 85,8 no seu benchmark de vulnerabilidades do mundo real contra 71,0 do Gemini 3.8 Flash Cyber, e 70,9% contra 58,2% no teste de penetração black-box da Wiz, segundo o post de lançamento.
Todo laboratório de fronteira está restringindo de forma parecida o seu modelo de segurança mais forte. O Claude Mythos 5.1, da Anthropic, fica atrás do Project Glasswing, e o GPT-5.6-Cyber, da OpenAI, atrás de um programa próprio de acesso confiável. Se você não está em nenhum desses programas, o guia de alternativas ao Codex Security Cloud cobre as ferramentas em que você pode se cadastrar hoje. Entre os modelos gerais acima, GPT-6 Astra e Grok 4.7 empatam com o Argon no CWE-bench v1, então são um ponto de partida razoável.
O que meu teste diz sobre alucinação no suporte
O teste mudou a forma como leio o número de destaque do Argon. Uma taxa de alucinação de 15% é um resultado sem consulta: o modelo responde curiosidades sem nada à frente. Um bot de suporte não é sem consulta. Ele tem sua central de ajuda, suas macros e suas políticas, e suas instruções dizem o que fazer quando isso acaba. Nesse cenário, a instrução fez mais trabalho que o modelo: 0 de 40 respostas inventadas com a regra, até 4 de 8 sem ela.
A eesel também viu a falha do modo bare em filas reais. No início deste ano, alguns clientes pagantes da eesel tinham bots que respondiam a clientes reais com conhecimento geral quando a base de conhecimento voltava vazia, e um respondeu uma pergunta de suporte com "Oxygen". Outra equipe, um grupo de suporte técnico B2B no Zendesk, se preocupava por outro motivo: a central de ajuda deles dizia "we support all models", e o bot confirmava alegremente produtos que não suportavam. Em nenhum dos casos o problema era o modelo. Os dois eram de fundamentação em fontes e de fallback, e é por isso que a primeira coisa que eu verificaria em qualquer bot de suporte é uma regra firme de "diga que não sabe e passe para um humano", testada com tickets do passado antes de entrar no ar.
É também o que os compradores pedem. Um líder de CX com cerca de 7.000 tickets por mês disse à equipe da eesel numa ligação de vendas que a IA deveria pegar apenas tickets de que tem confiança e deixar o resto para humanos. Isso é uma regra de passagem. A honestidade do Argon seria um bom reforço, mas você pode definir a regra hoje, em qualquer modelo. Os guias de prevenção de alucinações de IA e de escalonamento com IA explicam como.
Experimente a eesel

Se você estava esperando o Argon para deixar seu bot de suporte mais confiável, não precisa esperar. A eesel é um colega de helpdesk com IA que entra na sua fila existente no Zendesk, no Freshdesk ou no Gorgias, aprende com sua central de ajuda e seus tickets do passado, e só responde o que consegue fundamentar. Antes de responder a qualquer pessoa, roda uma simulação no seu histórico de tickets, para você ver quais perguntas ela responde e quais passa para um humano. Quando o Argon abrir, o modelo pode mudar enquanto suas regras continuam as mesmas.
Se você trabalha pelo terminal, a CLI da eesel controla o mesmo colega e o mesmo workspace do painel. Você pode automatizar uma simulação em um lote de tickets antigos, puxar as respostas para sua própria planilha de revisão e também deixar um agente de programação como Claude Code, Codex ou Cursor configurar tudo por você. Experimente a eesel grátis e rode nos seus próprios tickets antes de escolher o modelo.
Perguntas frequentes
Qual é a melhor alternativa ao Gemini 4 Argon agora?
Já posso usar o Gemini 4 Argon?
gemini-4-argon, e ele não estava entre os 61 modelos que minha chave conseguia listar. O Google diz que clientes pagos da API e assinantes do Google AI Ultra são os próximos, sem data. A visão geral do Gemini 4 Argon acompanha o que se sabe.Qual alternativa ao Gemini 4 Argon alucina menos?
Existe uma alternativa do Google ao Gemini 4 Argon?
O GPT-6.1 Sol é mais barato que o Gemini 4 Argon?
Qual é a melhor alternativa de pesos abertos ao Gemini 4 Argon?
Preciso do Gemini 4 Argon para um bot de atendimento ao cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.