O que o Gemini 3.8 Flash TTS realmente é
O Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) é o atual modelo de texto para voz do Google e, ao contrário de muitos modelos de áudio por aí, é estável em vez de preview. O id não carrega o sufixo -preview, e o Google o lista como o substituto recomendado para o antigo gemini-3.1-flash-tts-preview. Ele recebe texto e produz áudio, nada mais, exatamente o que se espera de um modelo de voz dedicado.
A ficha técnica é generosa. Você tem 30 vozes de estúdio pré-construídas (Zephyr, Puck, Kore, Fenrir e companhia), cada uma com um descritor como Bright ou Firm, além de uma Extended Voice Library com centenas de outras que você pode obter com client.voices.list(). Ele fala 130 idiomas com detecção automática de entrada, e você pode direcionar estilo, sotaque, ritmo e tom com prompts em linguagem natural, ou inserir tags como <laugh> e <sigh> para eventos vocais pontuais. Também vem com design de voz (criar uma persona a partir de uma descrição em texto) e clonagem de voz a partir de um clipe de referência.
O ponto da especificação que mais incomoda em produção: multi-speaker é limitado a dois falantes por requisição. Um podcast de três pessoas ou uma cena em grupo significa sintetizar cada fala separadamente e costurar o áudio você mesmo. A saída padrão é WAV mono em 24 kHz, com mulaw e alaw disponíveis para telefonia. Isso convive com o modelo somente texto Gemini 3.8 Flash, e os dois são cobrados de formas completamente diferentes, que é onde começa a maior parte da confusão.
Preços do Gemini 3.8 Flash TTS: a tabela completa
Aqui estão todos os níveis, em USD por 1M de tokens, nas taxas promocionais de 2026. A taxa de 2027 está entre parênteses porque, como veremos, tudo dobra.
| Nível | Entrada de texto / 1M | Saída de áudio / 1M | Observações |
|---|---|---|---|
| Standard | US$ 0,50 (US$ 1,00) | US$ 9,00 (US$ 18,00) | A taxa padrão |
| Batch | US$ 0,25 (US$ 0,50) | US$ 4,50 (US$ 9,00) | ~50% de desconto, jobs assíncronos |
| Flex | US$ 0,25 (US$ 0,50) | US$ 4,50 (US$ 9,00) | Mesma taxa, cache mais barato |
| Priority | US$ 0,90 (US$ 1,80) | US$ 16,20 (US$ 32,40) | ~1,8x, sensível à latência |
| Free | Grátis | Grátis | Standard/priority via AI Studio |
Tudo isso vem direto da página de preços da API do Gemini do Google. O cache de contexto é suportado e começa em US$ 0,125 por 1M de tokens de cache de entrada no nível standard, mais uma taxa de armazenamento de US$ 0,50 por 1M por hora. O número de saída de áudio é o que importa, porque é ele que escala com a quantidade de fala que você gera. A entrada de texto é quase um erro de arredondamento em comparação.
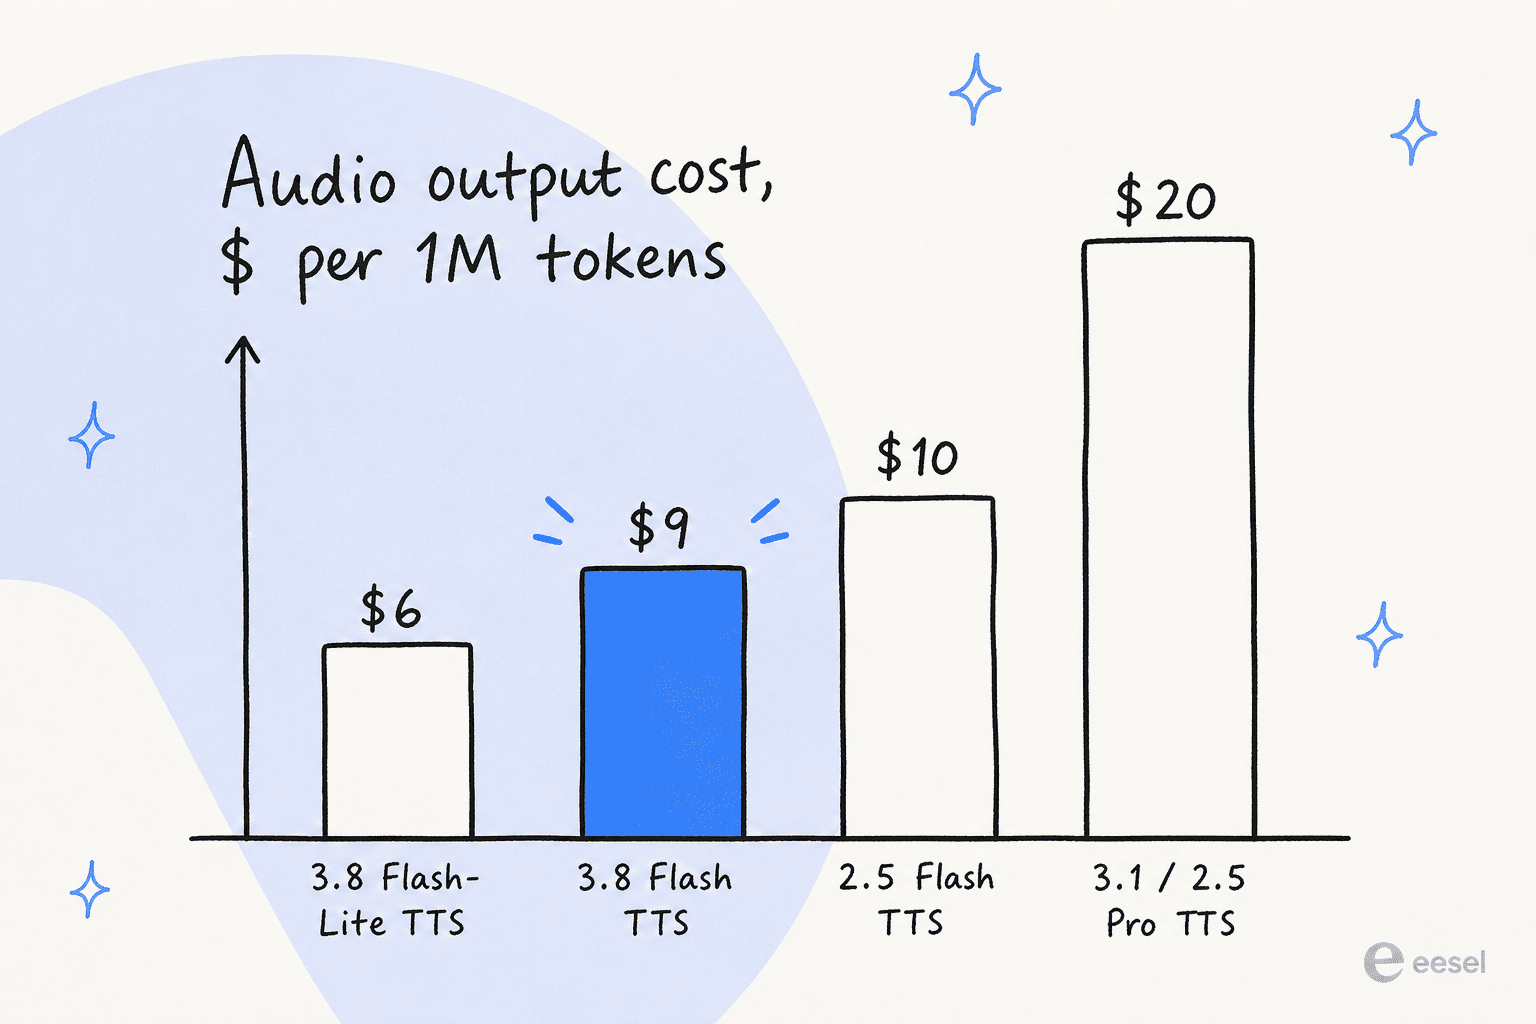
O que é sutilmente interessante é onde os US$ 9,00 ficam na própria linha de produtos do Google. É mais barato que o Gemini 2.5 Flash TTS que ele sucede (US$ 10 de saída de áudio), e menos da metade do preço dos modelos preview 2.5 Pro e 3.1 Flash TTS (US$ 20 de saída de áudio). Também existe um irmão mais barato, o Flash-Lite TTS, a US$ 6 de saída de áudio, se você puder viver com 101 idiomas em vez de 130.
O que isso realmente custa
O preço por token é difícil de sentir, então vamos transformá-lo em dinheiro de verdade. O áudio é cobrado a 25 tokens por segundo, o que dá 1.500 tokens por minuto e 90.000 tokens por hora. Na taxa padrão de 2026 de US$ 9,00 por 1M, uma hora de fala gerada custa cerca de US$ 0,81. Some o texto que você inseriu (uma hora inteira de narração são apenas cerca de 12.000 tokens de entrada) e o acréscimo fica bem abaixo de um centavo.
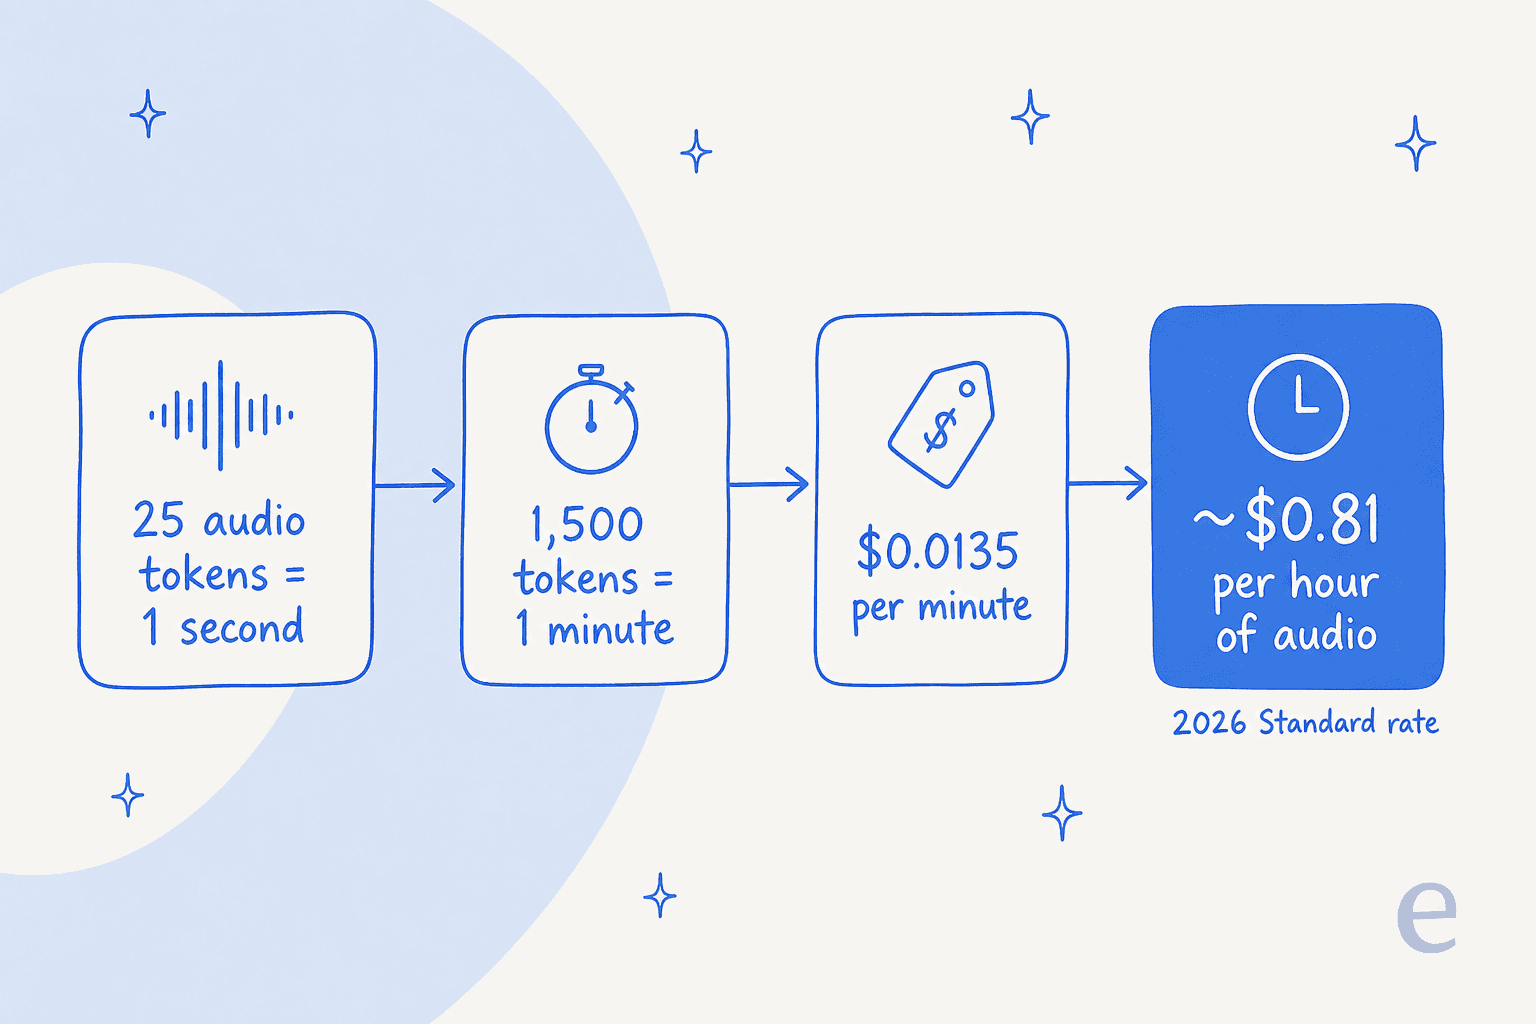
Alguns exemplos calculados na taxa padrão:
- Um episódio de podcast de 30 minutos: cerca de US$ 0,41 em áudio.
- Um audiobook de 8 horas: cerca de US$ 6,48.
- 10.000 mensagens de URA de suporte de 15 segundos cada: 3,75M de tokens de áudio, cerca de US$ 33,75.
Rode qualquer um desses como um job em batch noturno e você reduz pela metade, o que deixa o audiobook mais perto de US$ 3,24. Para geração de alto volume e não interativa, batch é a jogada óbvia. O único lugar onde o preço da etiqueta não conta toda a história é qualquer coisa que um humano espere em tempo real, onde você paga a taxa priority e arca com uma latência que não consegue controlar totalmente.
A pegadinha: os preços dobram em 1º de janeiro de 2027
Esta é a parte para anotar num post-it. Os valores de US$ 0,50 e US$ 9,00 são taxas promocionais introdutórias. Em 1º de janeiro de 2027, a entrada de texto padrão sobe para US$ 1,00 por 1M e a saída de áudio para US$ 18,00 por 1M. Todos os outros níveis dobram no mesmo ritmo: saída de áudio batch e flex para US$ 9,00, saída de áudio priority para US$ 32,40.
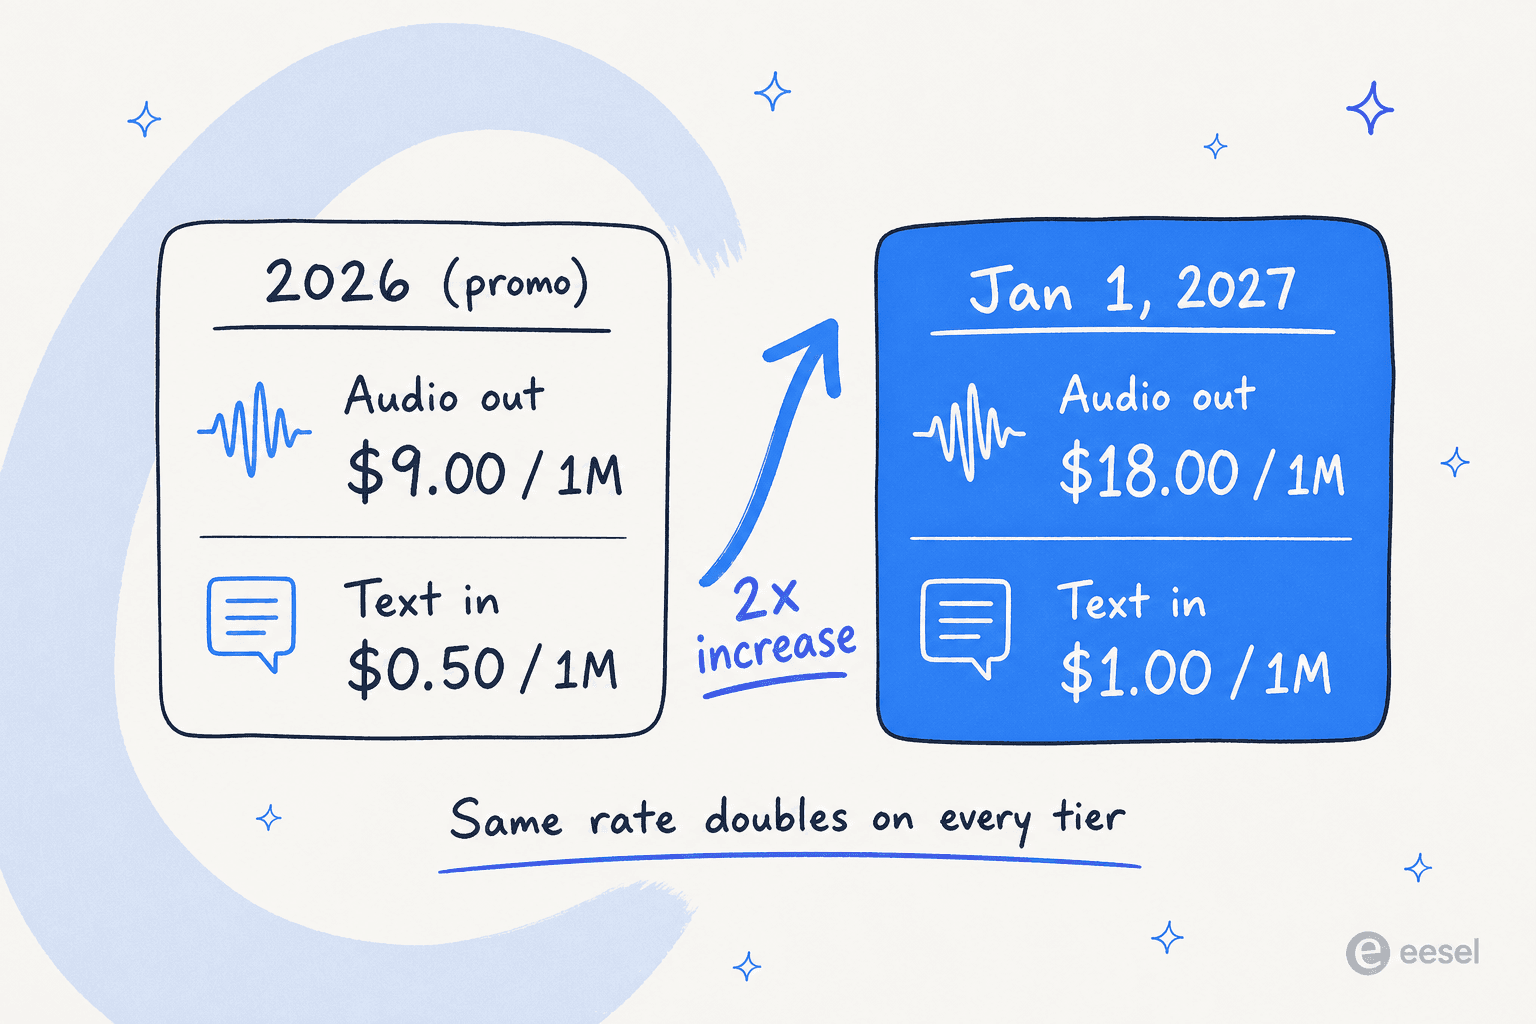
Então aquela hora de áudio de US$ 0,81 vira cerca de US$ 1,62 em 2027, e o audiobook de 8 horas sobe de US$ 6,48 para US$ 12,96. É o mesmo movimento que o Google fez com os modelos de texto, e é justo desde que você o veja chegando. Se você está orçando algo além deste ano, dobre os números deste post e planeje a partir daí. Isso também empurra você a garantir agora toda a economia de cache e batch que puder.
Como ele se compara ao ElevenLabs, OpenAI e o resto
Comparar modelos de voz é realmente complicado, porque os fornecedores não cobram da mesma forma. Amazon, Azure e Deepgram cobram por caractere de texto de entrada. OpenAI e Google cobram por token de saída de áudio, que escala com a duração da fala gerada, não com o roteiro. O ElevenLabs vende créditos de assinatura. Para colocar todos em um mesmo eixo, converti tudo em um custo estimado por hora de fala, usando a própria referência da Amazon de que 1M de caracteres equivale a cerca de 23 horas de áudio. Trate os números por hora como estimativas, não como termos contratuais, porque eles variam conforme o ritmo da fala.
| Fornecedor | Modelo principal | Preço nativo | ~ $/hora de áudio | Nível gratuito |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | gemini-3.8-flash-tts | US$ 9 / 1M tokens de áudio | ~US$ 0,81 | Grátis no AI Studio |
| Amazon Polly (Neural) | Neural | US$ 16 / 1M caracteres | ~US$ 0,70 | 1M caracteres/mês (12 meses) |
| Azure AI Speech | Neural / HD Flash | US$ 15 / 1M caracteres | ~US$ 0,65 | 0,5M caracteres/mês |
| OpenAI | gpt-4o-mini-tts | US$ 12 / 1M tokens de áudio | ~US$ 0,90 | Nenhum |
| Amazon Polly (Generative) | Generative | US$ 30 / 1M caracteres | ~US$ 1,30 | 100k caracteres/mês |
| Deepgram | Aura-2 | US$ 30 / 1M caracteres | ~US$ 1,30 | US$ 200 de crédito |
| ElevenLabs | Eleven v3 / Flash | ~5c/min (Business) | ~US$ 3,00 | 10k créditos/mês |
O que mais me surpreendeu: o Gemini 3.8 Flash TTS tem o preço de uma voz neural genérica, mesmo sendo um dos modelos generativos mais expressivos. As linhas mais baratas da Amazon e da Azure são suas vozes neurais mais antigas; o nível de qualidade generativa delas (Polly Generative) fica em US$ 1,30 por hora, e o modelo principal da Deepgram cai no mesmo patamar. O ElevenLabs, ainda a referência em qualidade de voz, custa cerca de quatro vezes mais por hora. Se o custo por hora é o seu fator decisivo e você ainda quer output expressivo, o Gemini é difícil de superar agora, pelo menos até o reajuste de 2027 elevá-lo para cerca de US$ 1,62.
Para o lado da OpenAI nessa comparação, meus textos sobre a API realtime da OpenAI e os preços do gpt-realtime-mini aprofundam onde a voz cobrada por token faz sentido.
A voz é boa de verdade?
O preço só importa se o resultado for utilizável, e é aqui que as primeiras reações ficam mais divididas. O lançamento gerou certa insatisfação quanto à qualidade. Um desenvolvedor no Hacker News foi direto ao ponto:
"I don't know, I guess their roll out is a bit sloppy. It's a bit of a shame, though, since the voices which are available all sound like generic Gemini voices to me. Nothing stands out."

Essa é a opinião de uma única pessoa, e preferência de voz é subjetiva, mas ela combina com um padrão: o TTS do Google é barato e amplo, enquanto o ElevenLabs ainda vence o teste "essa voz específica soa marcante" para muita gente. Alguns usuários estão ficando com o que já conhecem por enquanto:
"For on the go, I've been using ElevenReader. Technically not free but their free tier has been plenty for me."
Então a leitura honesta é esta. Se você precisa de narração barata, multilíngue e boa o suficiente em escala, o Gemini 3.8 Flash TTS tem um custo-benefício excelente. Se uma voz única, distintiva e que define a marca é o produto, teste-a com cuidado contra o ElevenLabs antes de se comprometer, e não presuma que a diferença de preço significa uma diferença de qualidade a seu favor.
Onde um modelo de voz barato se encaixa, e onde não
Aqui está o reenquadramento que eu gostaria que um comprador levasse consigo. Um modelo de TTS é infraestrutura. É uma forma fantástica e barata de dar voz a um app: um pipeline de audiobook, um narrador dentro do produto, uma camada de acessibilidade, prompts de URA. Para isso, US$ 0,81 por hora é um ótimo negócio de verdade.
Mas no momento em que o caso de uso é atendimento ao cliente, o modelo é os 10% fáceis do problema. A parte difícil é tudo ao redor: extrair a resposta certa da sua base de conhecimento, chamar as ferramentas que de fato resolvem um ticket, e ser testado contra seu histórico real antes de falar com um cliente pela primeira vez. Essa é a diferença entre infraestrutura e um funcionário. O Gemini TTS é a primeira. Ele não vai conhecer sua política de reembolso nem triar um ticket, e montar tudo isso sozinho é um projeto, não uma chamada de API.
Este é o quadro em que trabalhamos todos os dias. Passamos anos colocando IA em filas de suporte ao vivo, e o que separa uma demo de um lançamento real nunca é o modelo, é sempre a canalização e os testes. É por isso que um agente de helpdesk com IA é uma compra muito diferente de um endpoint de voz, mesmo quando ambos dizem "IA" na embalagem. Se você está pesando de forma geral a conta entre humano e automação, nossa análise de custo de agente de IA vs. agente humano é um ponto de partida melhor do que uma taxa por token.
Experimente o eesel
O eesel é uma plataforma de colegas de equipe de IA, e o time atual inclui um agente de helpdesk com IA pronto para trabalhar que entra na sua fila de suporte existente. Enquanto o Gemini TTS é um modelo em torno do qual você precisa construir, o eesel chega já sabendo se conectar ao seu helpdesk, aprender com seus tickets passados e ser simulado contra conversas históricas reais para que você saiba sua taxa de resolução antes de entrar no ar.

Se você gosta de trabalhar no terminal, a CLI do eesel controla o mesmo colega de equipe e workspace de forma programática. Você pode operá-la manualmente, integrá-la a scripts ou deixar um agente de código como Claude Code ou Cursor rodá-la sem interface, de modo que a IA que você compra fica disponível tanto no painel quanto pela API, da mesma forma que você acessaria um modelo como o Gemini TTS. Você pode testar o eesel de graça e simulá-lo primeiro com seus próprios tickets.
Perguntas frequentes
Quanto custa o Gemini 3.8 Flash TTS?
Existe um nível gratuito para o Gemini 3.8 Flash TTS?
Como os preços do Gemini 3.8 Flash TTS se comparam ao ElevenLabs?
Por que o preço do Gemini 3.8 Flash TTS dobra em janeiro de 2027?
O Gemini 3.8 Flash TTS é bom o suficiente para voz de atendimento ao cliente?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.