

O Gemini 3.7 Flash é um modelo muito bom que, sem alarde, deixou de ser barato. Rápido, sim. A Artificial Analysis o mede em 340.1 tokens por segundo, o mais veloz que eles acompanham hoje. Ele foi lançado em disponibilidade geral em 13 de agosto de 2026. O preço no lançamento foi de $0.75 por 1M de tokens de entrada e $3.75 por 1M de saída.
Depois vem a pegadinha, e ela está na tabela de preços, não em nenhum gráfico de benchmark. Esse preço é introdutório. Em 1º de janeiro de 2027 ele dobra, para $1.50 e $7.50. Além disso, o nível de raciocínio minimal sumiu, aquele que tornava os modelos Flash anteriores viáveis para classificação em alto volume, então agora low é o seu piso mais barato. E os tokens de raciocínio são cobrados pela tarifa de saída, mesmo que o que volta para você seja só um resumo deles.
Eu construo integrações e a infraestrutura de modelos na eesel. Nossos agentes rodam em helpdesks reais com volume real, e um cliente passa mais de 100.000 tickets por mês em alemão pelo Zendesk. Esse trabalho me deixou alérgico a escolher modelos olhando uma tabela de benchmarks. Então: para programação, trabalho com agentes e com documentos, o 3.7 é uma melhoria real. Mas se você escolheu o Flash originalmente porque era o nível barato, o 3.7 não é o seu caminho de atualização, e a própria tabela de preços do Google concorda comigo sem dizer.
O que o Gemini 3.7 Flash realmente é
O Gemini 3.7 Flash é o modelo de trabalho mais novo da linha Gemini AI. Ele sai como gemini-3.7-flash e está marcado como GA e não preview. O posicionamento do Google é direto: "our most intelligent workhorse model yet for coding and agents."
Ele tem uma janela de contexto de 1M de tokens com teto de saída de 64k. A entrada pode ser texto, imagem, vídeo, áudio e PDF, mas a saída continua sendo apenas texto. Seis superfícies o têm no ar, incluindo o AI Studio e a Gemini API, e também o Google Antigravity, onde agora é o modelo padrão por trás do agente do Antigravity.
Um pedaço de contexto importa para ler tudo o que vem a seguir. Atualmente não existe um Gemini 3 Pro estável. O gemini-3-pro-preview está marcado como desativado, e o único Pro que sobrou na lista é o 3.1 Pro em preview, o que é uma mudança real em relação ao desenho do lançamento do Gemini 3. Então o Flash carrega mais peso na linha do que um modelo com "Flash" no nome normalmente carregaria, e isso explica muito de como ele foi posicionado e precificado.
A API mudou mais do que o modelo
Esta é a parte que vai realmente custar uma tarde, e quase ninguém a coloca na frente.
Se você está migrando do Gemini 3.5 Flash, do Gemini 3 Flash Preview ou do Gemini 3.1 Pro, a lista de migração do Google manda remover temperature, top_p, top_k e candidate_count, trocar o thinking_budget numérico por uma string thinking_level, remover turnos do modelo pré-preenchidos e mover o histórico de várias interações para um previous_interaction_id do lado do servidor. O Gemini 3.6 Flash já havia eliminado os parâmetros de amostragem, então ir do 3.6 para o 3.7 sai quase de graça. Para todos os outros, a limpeza completa.
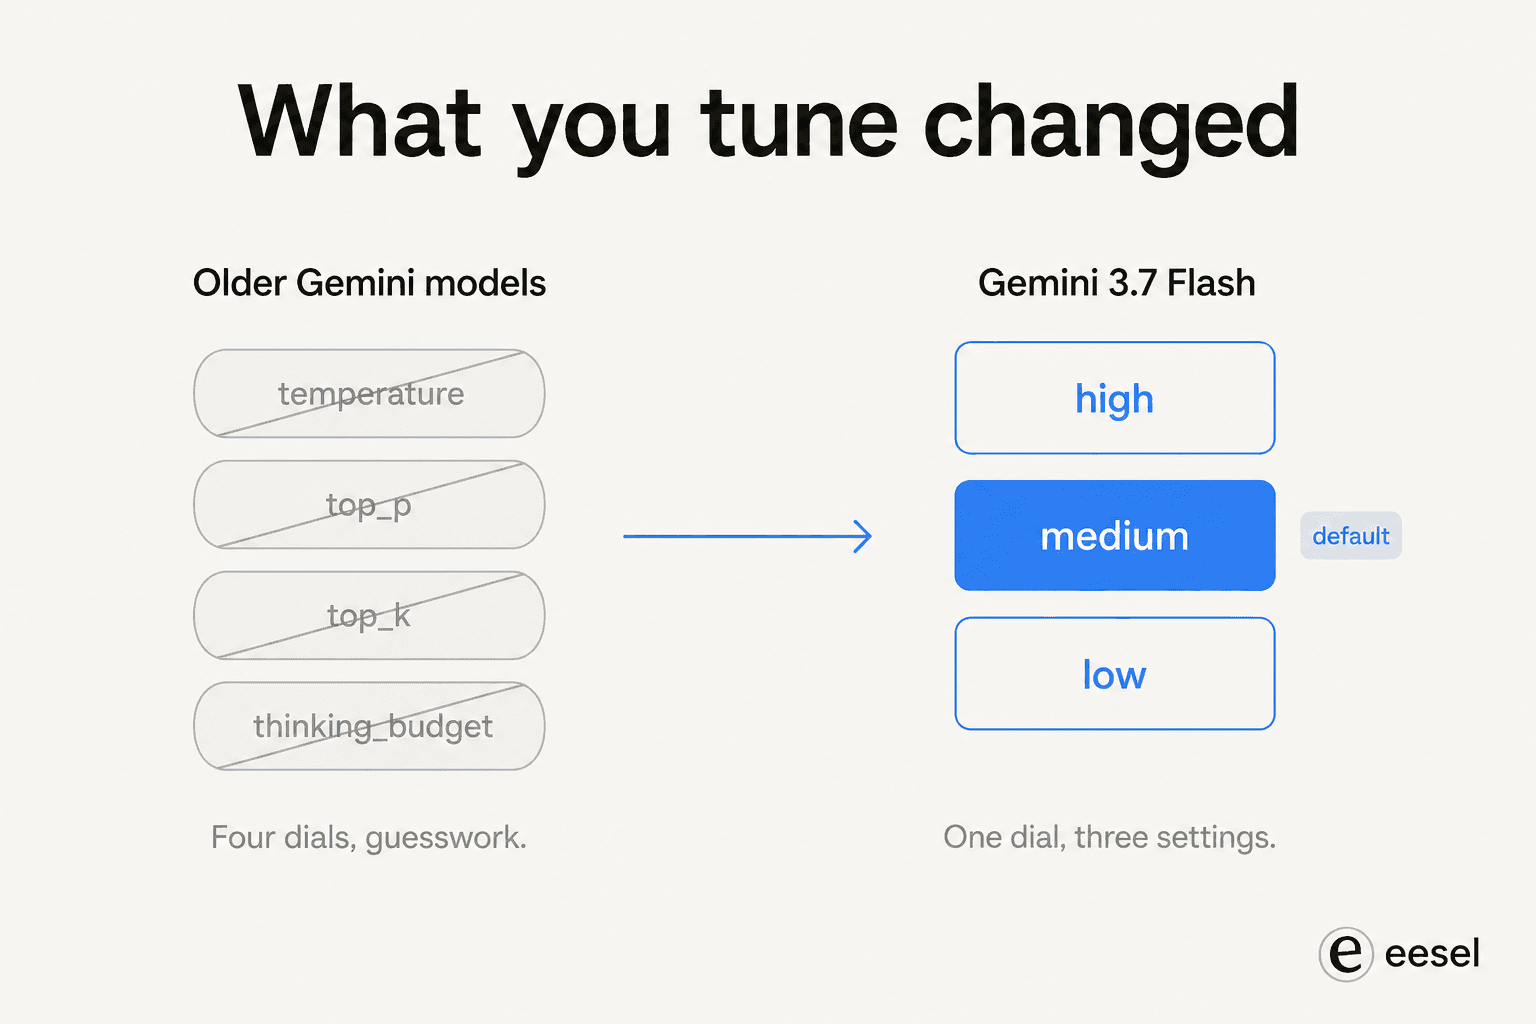
No lugar de quatro botões, você agora tem um, com três ajustes, definido dentro de generation_config:
| Nível | Para que o Google indica | Perfil de custo |
|---|---|---|
low | Trabalho crítico em latência: resposta a incidentes, chat em tempo real, rascunhos, análise rápida de dados | Piso mais barato disponível |
medium (padrão) | Código complexo e uso agêntico, com maior precisão de primeira | Padrão se você não definir nada |
high | Matemática difícil, as tarefas de programação e de agentes mais difíceis, uso estendido de ferramentas | "Higher token consumption and cost" |
Aqui está a regressão que ninguém colocou em um comunicado de imprensa. O Gemini 3.6 Flash, o 3.5 Flash, o 3.5 Flash-Lite e o 3 Flash Preview aceitam todos um quarto nível, minimal. O Gemini 3.7 Flash não. Em um thread de lançamento com 347 comentários, Simon Willison foi a única pessoa a apontar isso:
"The 'introductory pricing' for this 3.7 Flash model is really weird.
It's scheduled to double in price on December 31, 2026, but who would anticipate still using this model five months from now? Especially since 3.6 Flash came out just three weeks ago!"

Perder o minimal importa mais do que parece. Se você usava o Flash para OCR e etiquetagem, ou para classificação de tickets, o minimal era a configuração que fazia a conta fechar. O low é um piso real. Mas não é o mesmo piso.
A outra mudança discreta: todo exemplo de código da página agora usa a Interactions API, que foi para GA junto com o modelo, em vez de generateContent. Vale saber disso antes de copiar um trecho para uma base de código construída sobre o formato antigo.
Quão rápido ele é e como essa velocidade se distribui
Velocidade é onde o 3.7 Flash segue sem rival. A Artificial Analysis o mede em 340.1 tokens de saída por segundo, o primeiro entre os 188 modelos que acompanham, contra uma mediana da classe de 68.6. O Intelligence Index chega a 56, décimo sétimo de 188, bem acima da mediana da classe de 34.
Os números do mundo real são menos lisonjeiros, e mais úteis. O OpenRouter mostra um P50 de 93 tokens por segundo com 1.85 segundo de latência. A divisão por provedor é nítida: o Google AI Studio serve 124 tokens por segundo a 1.74 segundo, enquanto o Vertex consegue 84 a 2.02 segundos.
O tempo até o primeiro token é o ponto fraco, e depende inteiramente do nível de raciocínio escolhido. A Artificial Analysis mede uma mediana de 9.83 segundos até o primeiro token em esforço high, com p95 de 49.5 segundos, contra uma mediana da classe de 2.88. Em low, cai para 0.74 segundo. É a diferença entre uma latência interativa utilizável e uma da qual seus usuários vão reclamar.
O que traz à tona o achado mais prático de todo o conjunto de dados:
| Nível de raciocínio | Intelligence Index | Tempo até o primeiro token | Custo por tarefa de benchmark |
|---|---|---|---|
high | 56.0 | 9.83s | $0.40 |
medium | 53.5 | 4.22s | $0.26 |
low | 50.9 | 0.74s | $0.16 |
Em esforço low ele ainda marca 50.9, a menos de um ponto do Gemini 3.6 Flash em esforço high completo, por 40% do custo por tarefa e cerca de um treze avos da espera. Então, se você migrar do 3.6 Flash e deixar o padrão em medium, provavelmente está pagando por um raciocínio de que não precisava.
O curioso é que 93.1% do tráfego do OpenRouter vai para o Vertex, o endpoint mais lento, porque ele tem um desconto de plataforma de 50%. As pessoas trocam latência por preço, o que diz para que elas realmente compram este modelo.
Há também um forte contra-argumento a toda a história da velocidade, e ele vem com números. A Artificial Analysis mediu que, com raciocínio alto, o 3.7 Flash aumenta o uso de tokens em cerca de 40% sobre o 3.6 Flash, com média de 37k tokens de saída por tarefa. Tokens por segundo e tempo até a resposta não são a mesma coisa:
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens. And that's with Sol high being a substantially better model."
Esse aumento de 40% em tokens é um aumento de preço com crachá de velocidade. A tarifa não mudou. O que mudou é o número de tokens de saída cobráveis por tarefa, e os tokens de raciocínio também entram aí pela tarifa de saída. Tenha isso em mente para a calculadora abaixo.
Os benchmarks, incluindo os que o Google não pôs na frente
O Google publicou uma comparação de 21 linhas contra o Gemini 3.6 Flash, o Claude Sonnet 5, o GPT-5.6 Terra e o Muse Spark 1.2. A seu favor, publicaram também as derrotas. Aqui estão as linhas que mais importam:
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Claude Sonnet 5 | GPT-5.6 Terra | Muse Spark 1.2 |
|---|---|---|---|---|---|
| Preço de entrada, $/1M | $0.75 | $0.75 | $2.00 | $2.00 | $1.25 |
| Preço de saída, $/1M | $3.75 | $3.75 | $10.00 | $12.00 | $4.25 |
| AA Intelligence Index | 56 | 52 | 55 | 57 | 57 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | 42.7% | 41.3% | - |
| DeepSWE v1.1 | 65.3% | 48.6% | 53.8% | 69.6% | 54.9% |
| Code Arena (Elo) | 1588 | 1538 | 1541 | 1523 | 1535 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 80.4% | 87.4% | 82.9% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 14.6% | 20.8% | - |
| AutomationBench (privado) | 30.4% | 17.0% | 10.7% | 23.6% | - |
| GDPVal-AA v2 (Elo) | 1525 | 1422 | 1598 | 1578 | 1628 |
| Harvey LAB-AA (jurídico) | 90.7% | 85.1% | 90.1% | 85.2% | - |
| GDP.pdf (compreensão de PDF) | 34.0% | 22.0% | 28.0% | 24.7% | 16.0% |
| CharXiv Reasoning (sem ferramentas) | 84.5% | 85.2% | 77.0% | 85.9% | - |
| CharXiv Reasoning (com ferramentas) | 88.7% | 89.4% | 88.3% | - | - |
| LVBench (vídeo longo) | 85.4% | 84.2% | 68.5% | 78.9% | - |
| GDM-MRCR v2 @128k | 97.0% | 91.8% | 81.5% | 93.5% | - |
| OSWorld-2.0 (uso do computador) | 47.9% | 33.8% | - | 50.2% | - |
| HLE-Verified | 53.6% | 51.2% | 31.0% | 51.1% | - |
Algumas leituras honestas dessa tabela.
Os saltos em relação ao próprio antecessor são grandes e reais. O DeepSWE indo de 48.6% para 65.3%, e o AutomationBench de 17.0% para 30.4%, não são arredondamento. A própria prosa do Google cita o DeepSWE em 49.0% e não 48.6% para o 3.6 Flash, uma pequena discrepância entre o texto e o gráfico, embora a direção não esteja em dúvida.
O GPT-5.6 Terra ainda é dono do trabalho agêntico de terminal. Terminal-bench 2.1, Terminal-bench 3.0, DeepSWE e OSWorld-2.0 vão todos para o Terra. Se sua carga de trabalho é um agente de programação de longo prazo mastigando um repositório real, são quatro de quatro benchmarks que importam, e é por isso que várias pessoas no Hacker News leram este modelo como concorrente do Terra e não como opção econômica.
Ele perdeu duas linhas para o Gemini 3.6 Flash. Ambas são raciocínio sobre gráficos do CharXiv, 84.5 contra 85.2 sem ferramentas e 88.7 contra 89.4 com elas. Pequeno. Mas significa que "o 3.7 vence o 3.6 em tudo" não é uma afirmação verdadeira, e se gráficos são sua carga de trabalho, você deve conferir isso antes de migrar.
Há mais um número que só aparece nos testes independentes. A Artificial Analysis mede uma taxa de alucinação de 64.5% para o 3.7 Flash contra 55.6% para o 3.6 Flash. A precisão subiu, e a alucinação subiu junto com ela.
Para ser justo com o Google, esse número parece bem diferente dependendo da base de comparação. Um leitor que analisava os mesmos dados no Reddit o colocou em um contexto mais amplo:
"Flash 3 had 93 % hallucination but also very good world knowledge. 3.7 Flash has 65 %. This is a considerable improvement but it still lacks behind 3.1 Pro. […] Both Gemini Flash and GPT Sol are very good at getting the right answer, better than all other models except Claude Fable and Opus. It's just that when they don't get it right hallucination is likely or almost guaranteed."

Então: muito melhor que o Flash 3. Ligeiramente pior que o modelo que ele substitui diretamente, e ainda atrás do 3.1 Pro. Esse último ponto é o que importa, e mais adiante volto ao motivo de ele tirar meu sono.
Duas ressalvas sobre as fontes. A Artificial Analysis não tem pontuação do 3.7 Flash para SWE-Bench Verified, AIME, LiveCodeBench ou MMLU-Pro, então qualquer número que circule para esses é o gráfico do próprio Google e não uma execução independente. Além disso, a janela de contexto diverge entre as fontes: a Artificial Analysis diz 1,000,000 enquanto a ficha do Vertex do Google diz 1,048,576.
Quanto custa e a data em que esse preço acaba
A manchete diz $0.75 por 1M de tokens de entrada e $3.75 por 1M de saída. O asterisco é a história inteira.
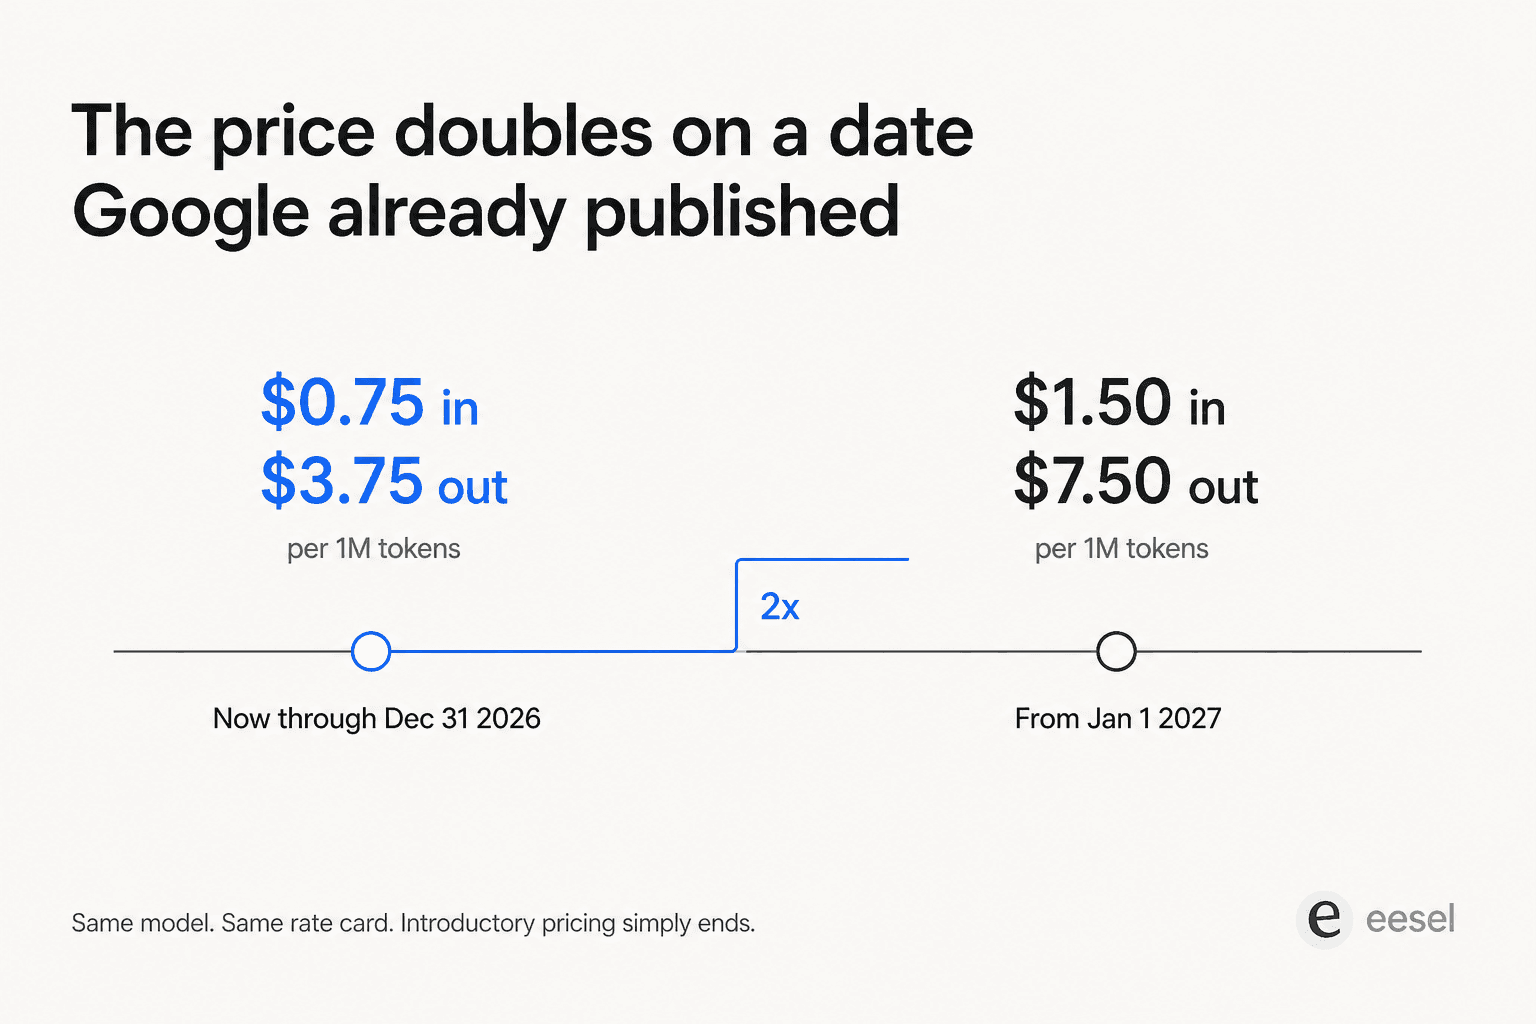
Aqui está a tabela de preços completa, tirada da página de preços do Google:
| Item | Até 31 dez. 2026 | A partir de 1º jan. 2027 |
|---|---|---|
| Entrada, por 1M de tokens | $0.75 | $1.50 |
| Saída (incluindo raciocínio), por 1M | $3.75 | $7.50 |
| Modo batch entrada / saída | $0.375 / $1.875 | $0.75 / $3.75 |
| Modo Flex | Igual ao batch | Igual ao batch |
| Modo Priority | $1.35 / $6.75 | $2.70 / $13.50 |
| Leitura de cache de contexto, por 1M | $0.075 | $0.15 |
| Armazenamento de cache de contexto, por 1M por hora | $0.50 | $1.00 |
| Google Search grounding | 5,000 solicitações grátis por mês em todos os modelos 3.x, depois $14 por 1,000 | Igual |
Algumas coisas merecem destaque. Não há degrau de preço por tamanho de contexto, então um prompt de 900k tokens custa o mesmo por token que um de 900, ao contrário do 3.1 Pro Preview. Também não há sobretaxa por modalidade: entrada de áudio e vídeo é cobrada pela mesma tarifa do texto, enquanto o 3 Flash Preview cobra o dobro pelo áudio. E o grounding ficou bem mais barato ao longo da geração 3.x, caindo de $35 por 1,000 solicitações para $14.
O que soa estranho é que o Gemini 3.6 Flash agora tem preço idêntico ao do 3.7 Flash, a mesma tarifa introdutória e a mesma data de expiração, e o mesmo preço padrão depois também. A prosa do Google descreve o 3.7 Flash como cerca da metade do custo do 3.6 Flash original, verdade em relação ao preço de tabela, não verdade em relação ao que o 3.6 Flash custa hoje. Não há ágio no modelo novo, o que basicamente significa que não há motivo para ficar no 3.6, a menos que o CharXiv ou o minimal sejam essenciais para você. Nossa análise de preços do 3.6 Flash continua valendo, porque agora é a mesma tabela.
Coloque aqui o seu próprio volume:
Você paga por um raciocínio que nunca vê
Este é o item que surpreende as pessoas, e está dito com clareza na documentação de thinking do Google: "When thinking is turned on, response pricing is the sum of output tokens and thinking tokens."
Depois a frase mais afiada, alguns parágrafos abaixo: "Pricing is based on the full thought tokens the model needs to generate, despite only the summary being output from the API."
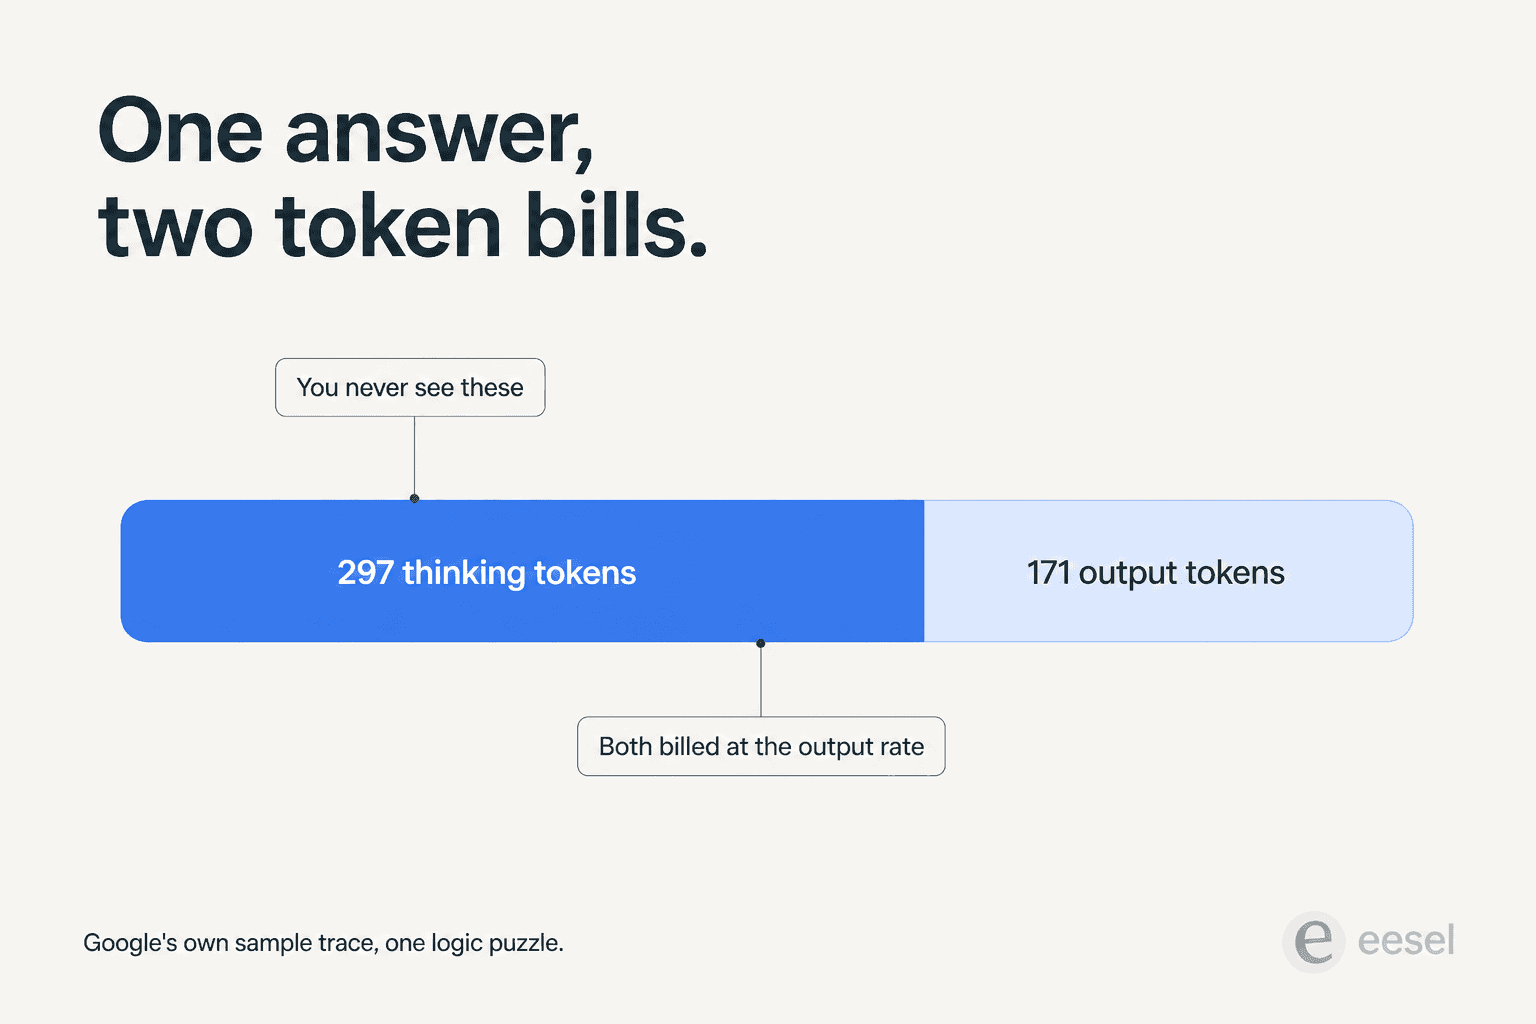
O trace de exemplo do próprio Google, num quebra-cabeça lógico de três pistas, gasta 297 tokens de raciocínio contra 171 tokens de saída. Quase dois terços da conta de saída dessa resposta foram um raciocínio que quem chama nunca recebe, só um resumo dele. A contagem é exposta como usage.total_thought_tokens, então dá para medir, mas é preciso ir atrás. Se você roda vários modelos lado a lado, é exatamente o tipo de coisa que as ferramentas de rastreamento de LLM existem para pegar.
Multiplique isso por uma carga de produção e o medium ser o padrão vira uma decisão real em vez de um dar de ombros. É também o motivo de o controle de sobrecarga de raciocínio da calculadora acima estar em 75% e não em zero.
Alguns desenvolvedores acham a abordagem resumida pior que inútil. Do thread de lançamento:
"I really, really like DSv4 Flash because you see the full, real thinking text. That's been so useful for helping steer the model; as well as seeing its thoughts and correcting any errors, or expanding on it. It's so difficult for me to use closed models with no or summarised thinking now."
O que os desenvolvedores realmente estão dizendo
O thread de lançamento chegou a 621 pontos e 347 comentários em cerca de oito horas, e o formato dele é mais interessante do que a pontuação.
O número mais citado de todo o thread acabou sendo o preço de um concorrente:
"Ever since the insane discount with GPT-5.6 Luna, not much excites me anymore. I mean just look at the benchmarks, even though Gemini 3.7 Flash performs well on the DeepSWE 1.1, Luna (Max) still performs way better.
> Starting January 1, 2027, $1.50/1M input tokens and $7.50/1M output tokens will apply.
Compare this to Luna which is at $0.2/1M input ($0.02 cached) and $1.2/1M output."
A correção de posicionamento veio alguns comentários depois, e é a coisa mais útil de todo o thread:
"They need to release benchmarks against Luna/Terra. Luna is much cheaper which feels like it undercuts the need for Flash.
I've always considered the Flash series of models to be for low-cost, high-volume, mostly text-based use cases (e.g. summarization, parsing, formatting), emphasis on low-cost."
Esse é o reenquadramento. O Flash não compete mais na base do mercado; quem compete ali é o Flash-Lite. Se você amava o Flash por ser barato, o modelo que você realmente quer a seguir fica um nível abaixo, ou totalmente fora da família Google.
Os lugares óbvios para olhar são o Qwen e o Kimi. Se você precisa de um provedor ocidental com orçamento parecido, a Mistral é a comparação mais próxima.
O veredito prático mais afiado saiu de um teste de imagem para HTML rodado no opencode, colocando o 3.7 Flash contra o Claude Opus 5 e o Grok:
"It's not a bad model by any means, but I just don't know what situation I'd reach for 3.7 Flash first for. Google really needs a differentiator, especially given how hard it is to get an API key from them. They can't be high friction and non-pareto."
Essa última cláusula abriu o maior subthread do dia, e o modelo nem era o assunto. O assunto era se dá para comprar do Google. Um comentarista relatou a mensagem de erro "Failed to create project, The request is suspicious. Please try again" numa chave nova; outro relatou o mesmo numa conta de Cloud de dez anos que só passou a funcionar dois dias depois. O mais doloroso operacionalmente:
"There are places where you CAN set a limit. This seems great until you are at the center of a huge traffic spike because of good pr and so you try to change it to a larger number only to be told you need to wait 24 hours for the setting to change.
Biggest traffic day of the decade and our site was down because of google."
Para ser justo, isso é contestado mais abaixo no thread. Um comentarista criou uma chave numa conta nova em dois cliques, sem sair da página, e o Google agora oferece limites de gasto na Gemini API. Então o atrito é real para alguns e irrelevante para outros, o que é um problema à parte. Para contraste, os limites de taxa da OpenAI e os preços da API do GPT-5 Pro são documentados de um jeito que a maioria atravessa sem nenhum ticket de suporte.
Onde o Flash ainda vence de longe
Em visão e em documentos. É o único eixo em que até os críticos do thread concederam o ponto.
Olhe de novo a tabela de benchmarks: GDP.pdf com 34.0% contra 24.7% do Terra, LVBench com 85.4% contra 68.5% do Sonnet 5, depois o teste da agulha de 128k com 97.0%. Isso forma um quadro coerente e não três linhas de sorte. Um comentarista expressou a versão prática melhor do que qualquer benchmark, descrevendo o Gemini diagnosticando corretamente um problema numa planta a partir de uma foto, depois de um modelo voltado a texto ter errado.
"That's been my association as well. I see Flash get brought up a lot in relation to things like OCR and PDF processing frequently, and a lot of other routine multimodal workloads."
Há também um argumento de escala, e ele me surpreendeu:
"did you try to ingest 1M documents per hour with any provider except GCP with Flash? None work at scale. Deepseek, Luna, Mistral all fail. 1 in 3 requests is a fail. I stopped trying. The only thing that works at scale is gemini flash."
Barato por token e confiável em volume são duas coisas diferentes, e é uma distinção que os threads de comparação de preço quase sempre pulam.
Os clientes nomeados pelo Google chegam ao mesmo ponto. O cofundador da Browser Use, Gregor Zunic, relata que o agente ficou "35% cheaper than 3.6 Flash, with a +8% observed prompt-cache hit rate and fewer tool errors." Vale ler isso como gasto total e não como tabela de preços, porque os dois modelos são cobrados de forma idêntica hoje; a economia vem de acertos de cache e de menos chamadas de ferramenta repetidas. Niko Grupen, da Harvey, relata +2.6 pontos all-pass no Legal Agent Bench deles. Kyrill Hux, da Nunu.ai, o chama de equivalente ao GPT-5.6 Terra "at around half the cost." São citações fornecidas pelo fornecedor numa página de lançamento, então pese-as de acordo.
A leitura de terceiros mais útil veio da Cognition, que o colocou dentro do Devin e foi específica sobre onde ele se encaixa:
"On FrontierCode 1.1, it reaches Claude Sonnet 5-level performance at less than half the cost, with the low latency the Flash series is known for. […] Within Devin, Gemini 3.7 Flash performs particularly well on tightly scoped refactors, where it delivers minimal diffs that match repo conventions."
"Tightly scoped refactors" é um limite preciso e honesto, e combina com o que os benchmarks de agentes de terminal dizem sobre a ponta de longo prazo.
Quem deve usar o Gemini 3.7 Flash e quem não deve
Use se você faz extração de documentos, trabalho com PDF e gráficos, recuperação em contexto longo, compreensão de vídeo ou geração de código web e de UI a partir de mockups. Os 1588 Elo do Code Arena são a maior pontuação na tabela do Google, e os benchmarks de documentos não são apertados. É também a escolha certa se você já está no Antigravity, já que lá ele agora é o padrão.
Evite se sua carga de trabalho é um agente de programação de terminal de longo prazo, onde o GPT-5.6 Terra vence esses quatro benchmarks que medem exatamente isso. Evite também se você veio ao Flash pelo piso de preço. Entre perder o minimal, tokens de raciocínio cobrados como saída e uma tarifa que dobra em janeiro, o argumento do nível barato migrou discretamente para o Flash-Lite e para concorrentes uma ordem de grandeza abaixo na saída.
Espere se você está no 3.6 Flash e o raciocínio sobre gráficos no estilo CharXiv é essencial para você. Você pagaria o mesmo dinheiro por duas linhas de benchmark que pioram um pouco.
Se você ainda está pesando o cenário, os resumos que valem seu tempo são alternativas ao Gemini, alternativas ao Gemini 3 e alternativas ao Claude.
Em ferramentas, o modelo importa menos do que o ambiente em que você o roda. A maioria de quem lê isto encontrará o 3.7 Flash por meio de um editor e não de uma chamada de API crua, e nossas notas sobre os melhores assistentes de programação com IA, as CLIs de programação agêntica e os preços do Cursor cobrem essa camada.
O que isso significa se você vai pôr um modelo numa fila de suporte
Agora, de volta ao número de alucinação, porque é aqui que começa o meu trabalho do dia a dia.
A Artificial Analysis mede o Gemini 3.7 Flash alucinando em 64.5%, contra 55.6% do 3.6 Flash. A precisão melhorou, e a alucinação piorou, ao mesmo tempo. Essa combinação não é contradição; é o formato normal de um modelo ajustado para se comprometer com respostas em vez de se proteger. Ótimo para um agente de programação que um compilador pode corrigir. Um risco quando a saída vai direto para um cliente.
Alguém que roda exatamente essa carga em produção traçou o limite melhor do que eu conseguiria:
"Yeah we use it for auto-triage of incidents, attempts to auto-remediate, and escalation to human. But for actual development, it's not a viable option for us."
Triagem, depois tentativa, depois escalonamento. Esse é o formato certo, e note que o humano ali é o último passo e não uma reflexão tardia.
Passamos anos rodando agentes de IA em helpdesks reais com volume real, incluindo uma financeira que passa mais de 100.000 tickets por mês em alemão pelo Zendesk e uma equipe de e-commerce que atende mais de 50.000 por mês no Freshdesk. O que essa experiência ensina é que uma pontuação de benchmark diz quase nada sobre como um modelo se comporta nos seus tickets. Duas equipes com o mesmo modelo, o mesmo helpdesk e o mesmo setor obtêm respostas diferentes, porque suas bases de conhecimento têm formatos diferentes.
Então a escolha do modelo importa menos do que o que está ao redor dele. Uma recuperação que realmente encontre o documento certo, e isso é um problema de RAG e não um problema de modelo. Roteamento por confiança, para que uma resposta de baixa confiança vire rascunho em vez de envio. E depois um ensaio com o seu próprio histórico de tickets, antes de qualquer cliente ver uma palavra, que é o passo que a maioria das implantações de automação de suporte pula.
Repare que nenhum desses é o modelo em si. A maioria dos motivos pelos quais um chatbot de IA responde errado são falhas de conteúdo e de recuperação, e não o modelo ser pouco inteligente, e consertar a base de conhecimento geralmente move o número mais do que trocar para o que foi lançado esta semana.
Esse último ponto é o argumento inteiro. Você não consegue ler uma taxa de alucinação de 64.5% num ranking e prever o que seus clientes vão receber. O que você pode fazer é rodar o agente sobre 500 dos seus tickets fechados e ler as respostas você mesmo. É também a única forma honesta de comparar ferramentas de automação de tickets ou de escolher entre plataformas de helpdesk com IA, porque a demo de cada fornecedor é construída com os dados dele e não com os seus.

Se o motivo de você precificar tokens é um orçamento de suporte, a comparação mais barata para fazer primeiro é custo de agente de IA vs humano, que tende a ofuscar a diferença entre $3.75 e $7.50 por milhão. Colocamos números nisso em economia com IA no suporte.
Experimente a eesel
Se você chegou aqui porque está avaliando o Gemini 3.7 Flash para dar suporte, o conselho honesto é parar de comparar fichas de modelos e começar a testar nos seus próprios tickets. É para isso que a eesel foi feita: ela se conecta em poucos minutos ao Zendesk, Freshdesk, Gorgias, HubSpot, Front ou Slack, aprende com os tickets que você já resolveu e não só com a sua central de ajuda, e então roda uma simulação sobre o seu histórico de tickets, para você ver as respostas exatas que ela teria enviado, por tema, antes de qualquer coisa ir ao ar.
É um preço mensal fixo, a partir de $299/mês por 500 créditos (1 crédito por ticket ou chat) sem taxa por usuário, então a conta se compara com uma fatura de tokens mais facilmente do que a maioria dos fornecedores permite. Um cliente resolveu 73% das solicitações de nível 1 no primeiro mês, e os resultados ficaram visíveis dentro de um teste de sete dias.
Experimente a eesel grátis, rode sobre os suas últimas centenas de tickets e deixe a simulação dizer se o modelo é bom o bastante ou não. Essa resposta vale mais do que qualquer tabela de benchmarks desta página, a minha inclusive.