O que o Gemini 3.8 Flash TTS realmente é
Primeiro os fatos chatos, mas importantes, porque boa parte da confusão online vem de as pessoas misturarem os IDs dos modelos.
O Gemini 3.8 Flash TTS é um modelo de texto para fala: texto entra, áudio sai, nada mais. Ele foi lançado como estável, não em preview, sob o ID gemini-3.8-flash-tts, e o Google o lista como o substituto recomendado para o antigo gemini-3.1-flash-tts-preview. Existe uma irmã mais barata, gemini-3.8-flash-lite-tts, à qual voltarei mais adiante.
Algumas especificações que vale a pena fixar, todas da própria documentação de geração de fala do Google:
- 130 idiomas no Flash TTS, com o idioma de entrada detectado automaticamente.
- 8.192 tokens de entrada e 16.384 tokens de saída por solicitação, então isso foi feito para falas e parágrafos, não romances inteiros em uma única chamada.
- A saída padrão é WAV mono de 24 kHz, com opções mulaw e alaw para telefonia.
- O áudio é cobrado a 25 tokens por segundo, que é o detalhe que faz a conta do preço realmente fechar.
Ele não faz chamadas de função, saída estruturada, raciocínio, grounding de busca ou a Live API. Isto é um mecanismo de renderização, não um agente. Guarde esse enquadramento, porque ele importa mais adiante.
Quão bom ele realmente soa?
Essa é a única pergunta que importa para um modelo de voz, e também é onde o marketing e a realidade divergem um pouco.
O argumento do Google é forte. O post de lançamento afirma #1 no Voice Design Benchmark da Hume AI (71,4) e #1 e #2 no Overall Quality Index da Hume para Flash e Flash-Lite. São números reais. Uma ressalva que eu gostaria de ter em mente antes de confiar totalmente: o fundador da Hume é creditado como autor no próprio anúncio do Google, então o fornecedor e o autor do benchmark não são totalmente independentes aqui. Isso não torna os resultados errados, só faz com que eu os pese um pouco mais leve.
A leitura independente é mais útil. Segundo a Artificial Analysis, o Gemini 3.8 Flash TTS ficou em #1 em Pronunciation Robustness com 89,5% (subindo dos 88,2% do 3.1 Flash TTS), mas apenas #2 na Provider Voice Arena às cegas, com um Elo de cerca de 1.263, atrás do Sonic 3. Então o resumo justo é: o melhor da categoria em pronunciar as palavras corretamente, segundo lugar em soar como a voz que você realmente escolheria.
"O Google lançou o Gemini 3.8 Flash TTS e o Gemini 3.8 Flash-Lite TTS. O Gemini 3.8 Flash TTS estreia em #1 no nosso Pronunciation Robustness Benchmark e #2 no nosso ranking Provider Voice Arena"
Desenvolvedores que realmente testaram foram mais diretos. A observação mais afiada da thread do dia de lançamento no Hacker News:
"As vozes disponíveis soam todas como vozes genéricas do Gemini para mim. Nada se destaca como particularmente interessante ou impressionante nisso."

Isso bate com a diferença nos benchmarks. Pronúncia está resolvida; personalidade não. Se seu trabalho é um narrador claro, correto e neutro, você vai ficar muito satisfeito. Se você precisa de uma voz que o ouvinte lembre, ajuste as expectativas.
O que você realmente pode controlar
O motivo para recorrer ao Gemini em vez de uma voz neural simples é o controle, e essa é a parte que mais gostei. Você não está apenas escolhendo uma voz na prateleira, você está dirigindo ela.
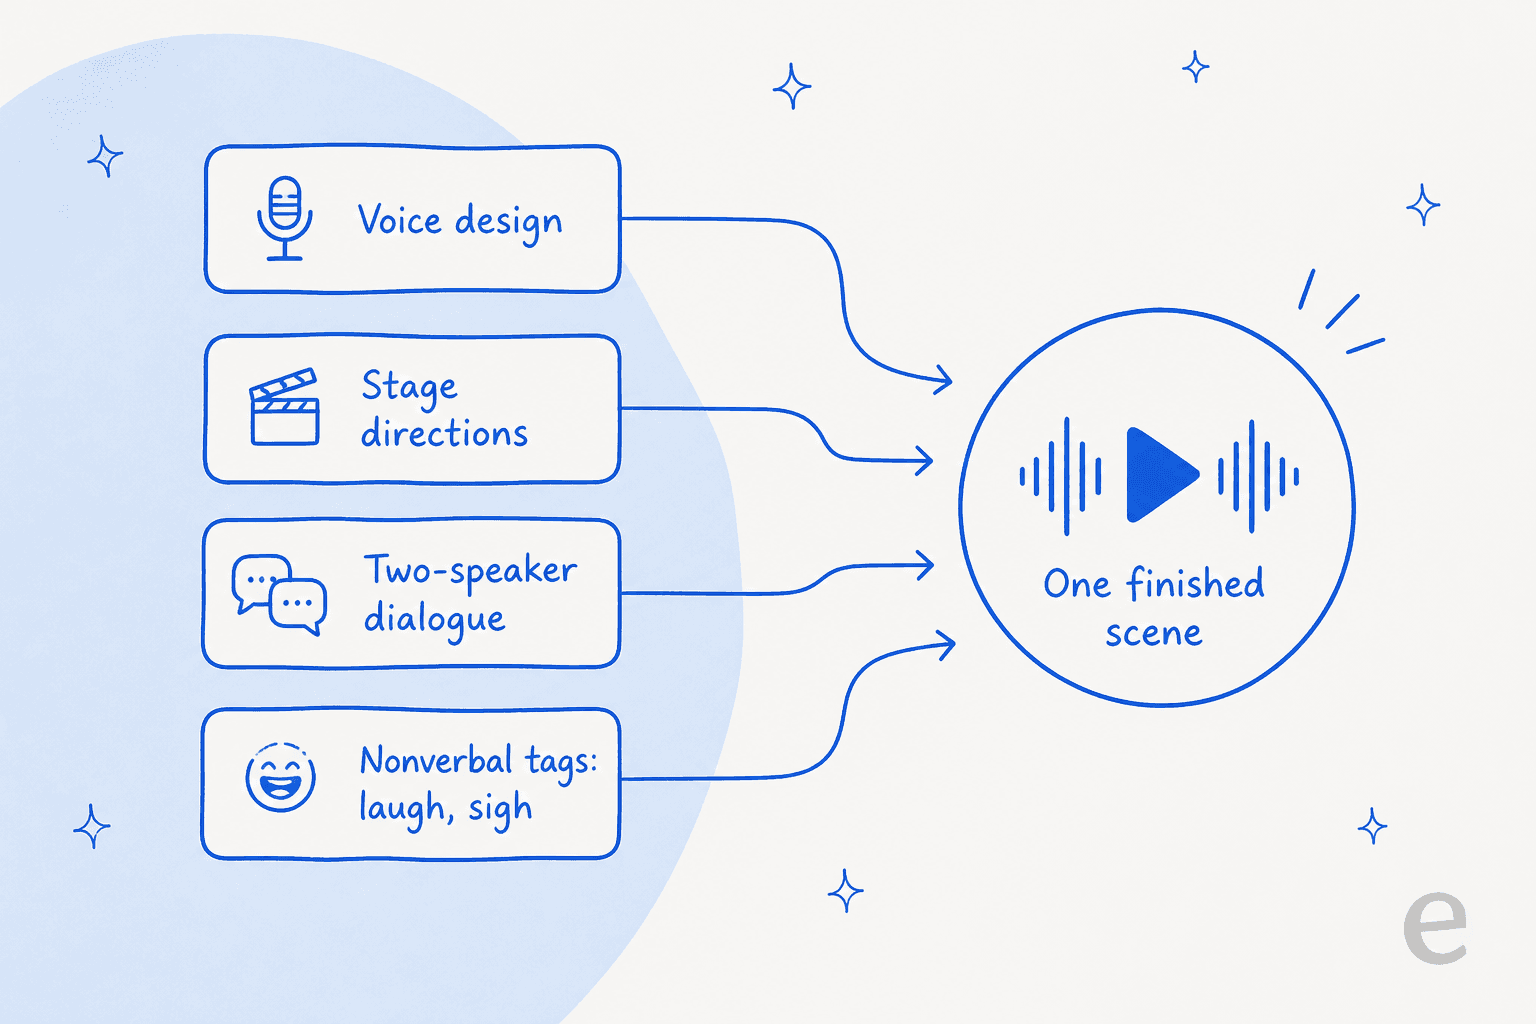
Quatro camadas se combinam:
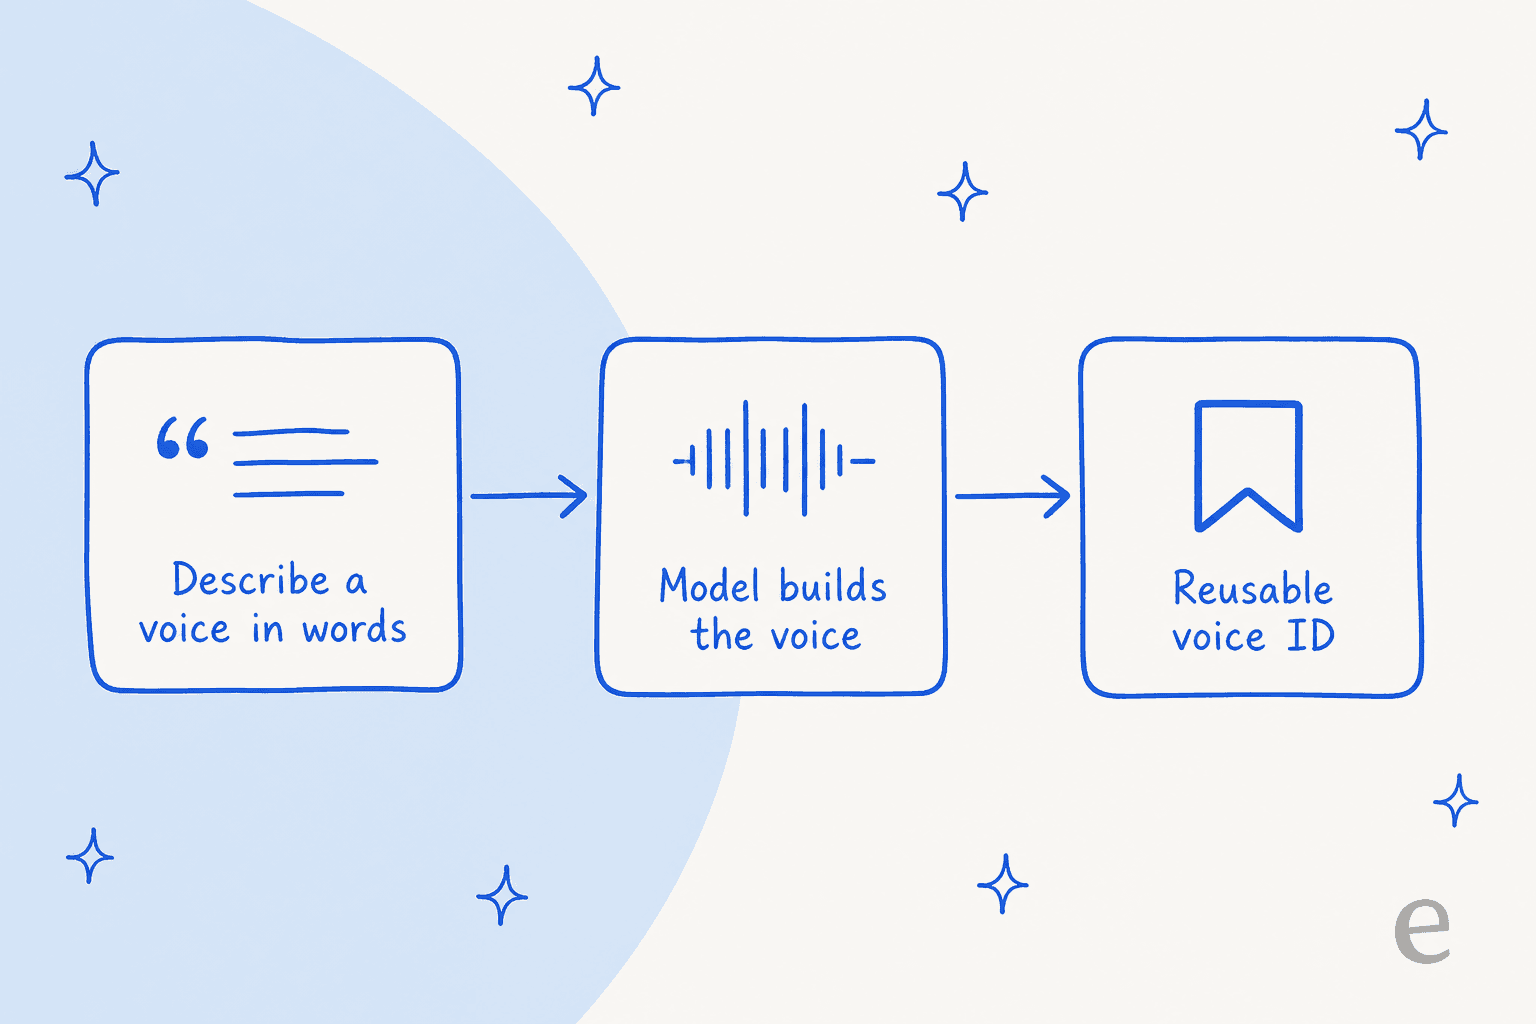
- Design de voz. Descreva uma persona em linguagem simples e o modelo constrói uma voz a partir da descrição, que você pode salvar como um ID reutilizável.
- Instruções de direção. Um campo no estilo
speech_metadatapermite direcionar tom, sotaque e ritmo por fala ("leia isso com calor, um pouco apressado"). - Diálogo de dois falantes. Um modo conversacional lida com até duas vozes prontas em uma única solicitação, o que torna possíveis clipes rápidos estilo podcast.
- Tags não verbais. Marcadores inline como
<laugh>,<sigh>,<breath>e<short pause>colocam eventos vocais exatamente onde você quer.
O fluxo de design de voz é o recurso principal e é genuinamente engenhoso: você vai de uma frase de descrição a uma voz persistente e reutilizável sem nunca gravar nada.
O limite honesto: a controlabilidade é real, mas não perfeitamente confiável. Em um lançamento anterior do Gemini TTS, um desenvolvedor relatou que a direção às vezes era completamente ignorada:
"Não importa o que eu escrevesse no perfil de áudio, o AI Studio nunca seguia, independentemente da cena ou do contexto. Por exemplo, tentei conseguir uma voz masculina e continuava recebendo vozes femininas."
O Google diz que o 3.8 melhora a direção criativa, e pela minha leitura melhora mesmo, mas reserve algumas regenerações para quando uma instrução não acertar de primeira. É um prompt, não uma garantia.
A replicação de voz (clonagem) também foi lançada, algo que por um tempo o Google parecia hesitante em fazer. Como Simon Willison colocou:
"Acho que a clonagem de voz já está disponível de forma bastante ampla em outros provedores para que o Google não hesite mais em lançá-la."
Flash vs Flash-Lite: qual usar
A divisão entre os dois modelos é simples assim que você entende, e escolher errado só custa dinheiro ou qualidade.
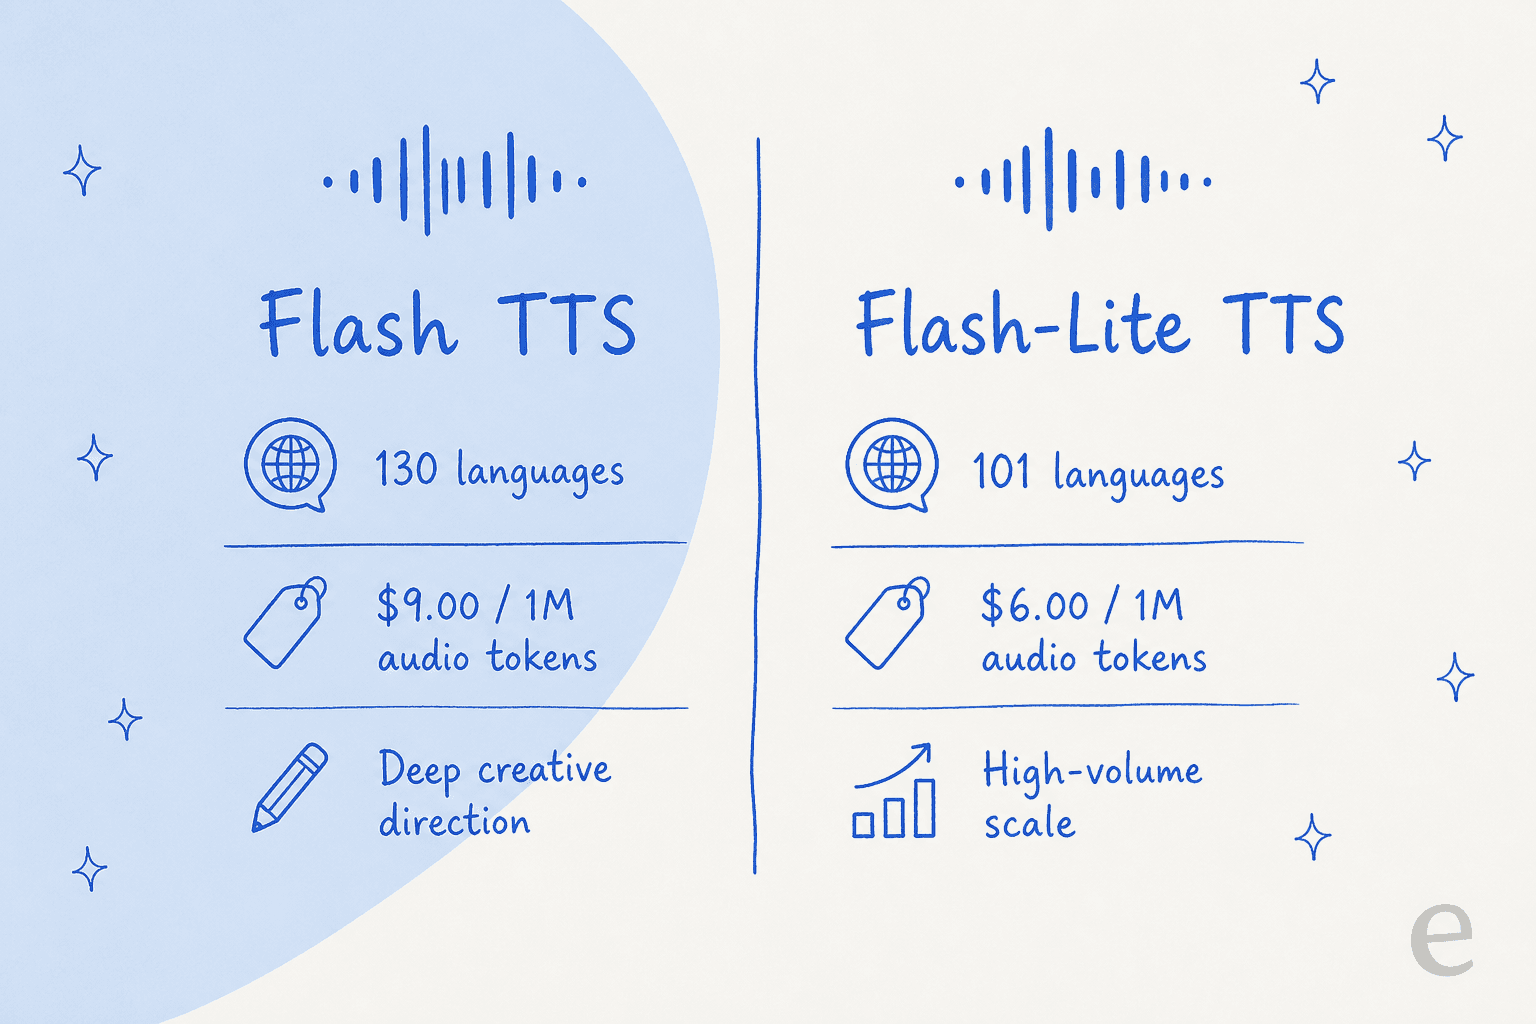
Flash TTS é o expressivo: 130 idiomas, US$ 9,00 por 1M de tokens de áudio, e o kit completo de direção criativa. Recorra a ele quando o áudio é o produto, como um audiobook, um anúncio de marca ou um personagem.
Flash-Lite TTS é o cavalo de batalha: 101 idiomas, US$ 6,00 por 1M de tokens de áudio, ajustado para renderização de alto volume onde "bom e barato" vence "expressivo". Recorra a ele quando você está gerando milhares de clipes e ninguém vai notar uma leitura um pouco mais plana.
Minha regra prática: prototipe no Flash para ouvir o teto de qualidade, depois desça para o Flash-Lite para tudo que você está renderizando em massa. Se nenhum dos dois servir, as alternativas ao Gemini que vale a pena testar são o Sonic 3 da Cartesia e o ElevenLabs.
A realidade do preço (e a pegadinha de 2027)
Eu mantenho os números completos no post de preços do Gemini 3.8 Flash TTS, mas a versão relevante para esta análise é curta.
No nível padrão, o Flash TTS custa US$ 9,00 por 1M de tokens de áudio de saída. Como o áudio é cobrado a 25 tokens por segundo, uma hora de fala são cerca de 90.000 tokens, então cerca de US$ 0,81 por hora de áudio gerado. Batch e Flex têm 50% de desconto sobre isso. Há um nível gratuito real via Google AI Studio.
A pegadinha para planejar: essas são taxas promocionais até 31 de dezembro de 2026, e elas praticamente dobram em 1º de janeiro de 2027 (o Flash vai para US$ 18,00 por 1M de tokens de áudio). Se você está orçando uma carga de trabalho para 2027, orce o número dobrado, não o número de lançamento. Esse é o mesmo padrão em toda a linha de preços do Gemini, então não é surpresa se você acompanha o Gemini de perto.
Sobre custo, o veredito da comunidade foi claro mesmo entre os céticos. Simon Willison, testando o modo conversa:
"O modo conversa é ótimo, e a maioria dos meus experimentos custou menos de um centavo."
Como ele se compara com a concorrência
Os preços de TTS entre fornecedores são uma bagunça porque as unidades de cobrança diferem: Amazon, Azure e Deepgram cobram por caractere, enquanto OpenAI e Google cobram por token de áudio. Para comparar de forma justa, normalizei tudo em dólares por hora de áudio (usando a própria referência da Amazon de cerca de 23 horas de fala por 1M de caracteres). Trate esses números como estimativas, já que a velocidade da fala muda a conta.
| Modelo | Preço anunciado | ~ US$/hora de áudio | Nível gratuito |
|---|---|---|---|
| Gemini 3.8 Flash TTS | US$ 9,00 / 1M tokens de áudio | ~US$ 0,81 | Sim (AI Studio) |
| Gemini 3.8 Flash-Lite TTS | US$ 6,00 / 1M tokens de áudio | ~US$ 0,54 | Sim (AI Studio) |
| Amazon Polly Neural | US$ 16 / 1M caracteres | ~US$ 0,70 | 1M caracteres/mês (12 meses) |
| Azure Neural / HD Flash | US$ 15 / 1M caracteres | ~US$ 0,65 | 0,5M caracteres/mês |
| OpenAI gpt-4o-mini-tts | US$ 12 / 1M tokens de áudio | ~US$ 0,90 | Nenhum (TTS) |
| Deepgram Aura-2 | US$ 30 / 1M caracteres | ~US$ 1,30 | US$ 200 de crédito no cadastro |
| ElevenLabs Business | "a partir de 5 centavos/min" | ~US$ 3,00 | 10 mil créditos/mês |
O ponto principal: o Gemini 3.8 Flash TTS tem preço de uma voz neural genérica, mas se comporta como uma voz expressiva e generativa. Ele fica bem ao lado do Amazon Polly Neural e do Azure em custo, é mais barato que a OpenAI e a Deepgram, e é uma fração do ElevenLabs por hora. Se você se importa com a relação preço-expressividade, essa é a manchete de todo o lançamento.
Uma nuance para ser justo: os preços do ElevenLabs compram uma biblioteca de vozes e um nível de personalidade que a tabela de custos não captura, que é exatamente por que as equipes continuam pagando por ele, como mostram as avaliações do ElevenLabs.
Você deveria usar? Uma decisão rápida
Em vez de mais um parágrafo de "depende", aqui está a decisão que eu tomaria dependendo do caso de uso.
Onde ele fica devendo
Para manter isso justo, os limites reais que eu apontaria antes de você se comprometer:
- As vozes carecem de personalidade. A crítica dos desenvolvedores mais votada foi que tudo soa "genericamente Gemini". Ótimo para utilidade, mais fraco para marca.
- A direção pode ser ignorada. O controle criativo é um prompt, não um contrato, então espere erros ocasionais e regenerações.
- Não é o topo da arena. #1 em pronúncia, mas #2 na preferência humana às cegas atrás do Sonic 3. Se "melhor voz" é sua exigência, isso não está resolvido.
- O custo dobra em 2027. O preço de lançamento é promocional. Uma carga de trabalho que você dimensiona em 2026 fica 2x mais cara em janeiro.
- Modelos locais estão alcançando. Vários desenvolvedores apontaram opções abertas como Fish Audio, Higgs e Qwen3 TTS como boas o suficiente para uma renderização final, especialmente quando custo ou regras de privacidade descartam uma API na nuvem.
Nada disso é desqualificante. É a diferença entre "incrível" e "muito bom e muito barato", que é onde eu fico.
A parte que as pessoas realmente vieram buscar: voz para suporte
Muita gente que busca um modelo de voz está, na verdade, fazendo uma pergunta diferente: posso colocar isso na frente dos meus clientes? Esta é a seção que eu não pularia.
Um modelo TTS é infraestrutura. Ele transforma texto em áudio, e esse é todo o trabalho dele. Ele não conhece sua política de reembolso, não consegue ler seu software de atendimento ao cliente, e não tem ideia se a frase que acabou de falar é realmente verdadeira. Se você colocar um modelo de voz bruto na frente de uma linha de suporte, ele vai ler com confiança uma resposta errada em uma voz linda, o que é pior do que uma simples mensagem de erro. Isso é o oposto da economia de custos que a maioria das equipes está buscando.
Eu trabalho com isso na eesel, e a forma como penso é simples: o modelo é a voz, o colega de equipe é o funcionário. A eesel é uma plataforma de colegas de equipe de IA, e o colega de equipe relevante aqui é o agente de helpdesk com IA. Ele se conecta ao seu helpdesk existente, aprende com seus chamados anteriores e sua central de ajuda, segue as regras que você define, e é simulado contra seu histórico real de chamados antes de responder a um cliente ao vivo. Essa última parte importa: já vimos bots com tom confiante darem respostas erradas silenciosamente, e é exatamente por isso que todo lançamento passa por um teste a seco com chamados históricos primeiro. Um modelo de voz não tem uma rede de segurança equivalente.
Se você trabalha em um terminal ou quer automatizar isso, a CLI da eesel controla o mesmo colega de equipe e espaço de trabalho que o painel. Uma pessoa pode inspecionar as instruções de um colega de equipe pela linha de comando, um script pode automatizar um fluxo de trabalho, e um agente de código como Claude Code, Codex ou Cursor pode operar a eesel de forma programática, imprimir resultados em JSON e propor mudanças limitadas para um responsável aprovar. É a interface amigável a agentes para o mesmo produto, não algo separado. Isso é uma diferença real em relação a conectar você mesmo o Gemini TTS, onde você assume sozinho toda a orquestração, as métricas de suporte, a lógica de escalonamento e a gestão de SLA.
Então: use o Gemini 3.8 Flash TTS para aquilo em que ele é ótimo, que é fala barata, clara e controlável. Para uma voz que realmente resolve problemas de clientes, você precisa de um colega de equipe testado por cima, não do modelo bruto. Se esse é o seu objetivo real, comece com um chatbot de helpdesk com IA de verdade e as ferramentas mais amplas de automação de suporte, e compare as opções do melhor agente de IA para atendimento ao cliente antes de construir qualquer coisa do zero.
Meu veredito
O Gemini 3.8 Flash TTS é um modelo de voz muito bom a um preço genuinamente disruptivo. Ele acerta na pronúncia, dá controle criativo de verdade, traz design de voz e clonagem, e custa uma fração do ElevenLabs por hora. Os asteriscos honestos são que as vozes carecem de personalidade marcante, ele fica em #2 em vez de #1 na preferência às cegas, e o preço dobra em 2027.
Para a maioria dos desenvolvedores renderizando áudio em escala, ele é o novo padrão sensato. Para uma voz de marca assinatura, ElevenLabs e Sonic 3 continuam na disputa. E se você veio aqui querendo uma IA que fale com seus clientes e realmente resolva os problemas deles, lembre-se de que a voz é a parte fácil: as empresas de atendimento ao cliente com IA que valem seu tempo são as que resolvem a parte difícil, e o software de helpdesk com IA que resolve um chamado importa muito mais do que a voz que lê a resposta.

Quer um colega de equipe de IA para sua fila de suporte, não só uma voz bonita? A eesel se conecta ao seu helpdesk em minutos, aprende com seus próprios chamados, e você pode simulá-la no seu histórico real antes de colocá-la em produção. Experimente a eesel gratuitamente, ou agende uma demo para ver com seus próprios dados.
Perguntas frequentes
O Gemini 3.8 Flash TTS é bom?
Sim, com uma ressalva. Tem qualidade de estúdio em clareza e pronúncia, e estreou em #1 no benchmark Pronunciation Robustness da Artificial Analysis. Mas na preferência humana às cegas ficou em #2, atrás do Sonic 3 da Cartesia, e vários desenvolvedores disseram que as vozes prontas soam genéricas. É um ótimo padrão, mas não uma vitória completa.
Quanto custa o Gemini 3.8 Flash TTS?
Custa US$ 0,50 por 1M de tokens de texto de entrada e US$ 9,00 por 1M de tokens de áudio de saída no nível padrão até 31 de dezembro de 2026, o que dá cerca de US$ 0,81 por uma hora de fala. Ambas as taxas dobram em 1º de janeiro de 2027. Os níveis completos estão no meu detalhamento de preços do Gemini 3.8 Flash TTS, e a família mais ampla está no guia de preços do Gemini 3.
Gemini 3.8 Flash TTS vs ElevenLabs: qual é melhor?
O Gemini vence em preço por uma margem ampla, cerca de 4 a 5 vezes mais barato por hora de áudio. O ElevenLabs ainda costuma vencer em vozes marcantes, com personalidade, e em sua biblioteca de vozes. Se custo e escala importam mais, Gemini; se uma voz distinta importa mais, veja também as alternativas ao ElevenLabs.
Qual é a diferença entre Gemini 3.8 Flash TTS e Flash-Lite TTS?
O Flash TTS cobre 130 idiomas a US$ 9,00 por 1M de tokens de áudio e foi feito para áudio expressivo e dirigido. O Flash-Lite TTS cobre 101 idiomas a US$ 6,00 por 1M de tokens de áudio e foi feito para tarefas de alto volume e sensíveis a custo. Escolha o Flash quando a direção criativa importa, e o Flash-Lite quando você está renderizando em escala.
O Gemini 3.8 Flash TTS consegue clonar uma voz?
Sim. Ele suporta design de voz (descrever uma persona em palavras) e replicação de voz (clonagem a partir de um clipe de referência curto mais áudio de consentimento). Vozes clonadas podem ser salvas como um ID de voz reutilizável, limitado a 200 por projeto com validade de um ano, ou como uma chave sem estado válida por 7 dias.
O Gemini 3.8 Flash TTS suporta múltiplos falantes?
Até dois falantes por solicitação usando vozes prontas, com um modo conversacional para diálogo. Para mais de duas vozes, você sintetiza cada fala separadamente e une os áudios.
Um modelo de voz como o Gemini TTS é suficiente para atendimento ao cliente?
Não. Um modelo TTS transforma texto em fala; ele não lê sua central de ajuda, não segue suas políticas nem resolve um chamado. Para suporte, você precisa de um colega de equipe de IA por cima, como um agente de helpdesk com IA conectado ao seu software de atendimento ao cliente e testado primeiro no seu histórico real de chamados.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.