

O MAI-Transcribe-2 é o novo modelo de fala para texto da Microsoft AI, anunciado em 3 de setembro de 2026 e apresentado como "o modelo de reconhecimento de fala mais rápido, preciso e barato do mundo". Pelos números da própria Microsoft, a alegação em boa parte se sustenta: taxa média de erro de palavras de 5,2% em 60 idiomas, cerca de 10 vezes mais rápido que o GPT-Transcribe em áudios longos (segundo os benchmarks próprios da Microsoft) e US$ 0,10 por hora de áudio como preço de lançamento.
Vale conhecer as ressalvas antes de construir em cima dele. Esses US$ 0,10 são uma oferta por tempo limitado até o fim de 2026, e o preço padrão não foi divulgado. É um modelo em lote em prévia pública (sem SLA), os arquivos são limitados a 300 MB e o tempo real exige uma configuração separada do Voice Live. A tabela de benchmarks também é da Microsoft, em um ranking no qual ele fica em segundo lugar no geral.
Se você só precisa transformar áudio em texto limpo e multilíngue por API, é uma das opções mais fortes e baratas hoje. Mas se o seu objetivo é um fluxo de suporte, lembre que a transcrição é o começo, não o fim: alguém ainda precisa ler, encontrar a resposta e resolver o ticket. Esse é o trabalho de um colega de IA como a eesel, e é aí que está o valor real agora.
Eu construo integrações e APIs na eesel, então leio um lançamento como esse como um desenvolvedor: o que a API realmente faz depois da manchete? Passei um tempo com a página do modelo MAI-Transcribe-2, a documentação do Azure Speech, o playground e os primeiros comentários de desenvolvedores. Aqui está o que encontrei.
O que o MAI-Transcribe-2 realmente é
O MAI-Transcribe-2 é um modelo de fala para texto criado internamente pela Microsoft AI, o mesmo grupo por trás dos modelos MAI-Voice e MAI-1. A proposta é refrescantemente restrita: faz uma coisa só, que é transformar áudio em texto, e faz isso em vários idiomas com um único modelo, em vez de obrigar você a escolher um mecanismo por idioma.
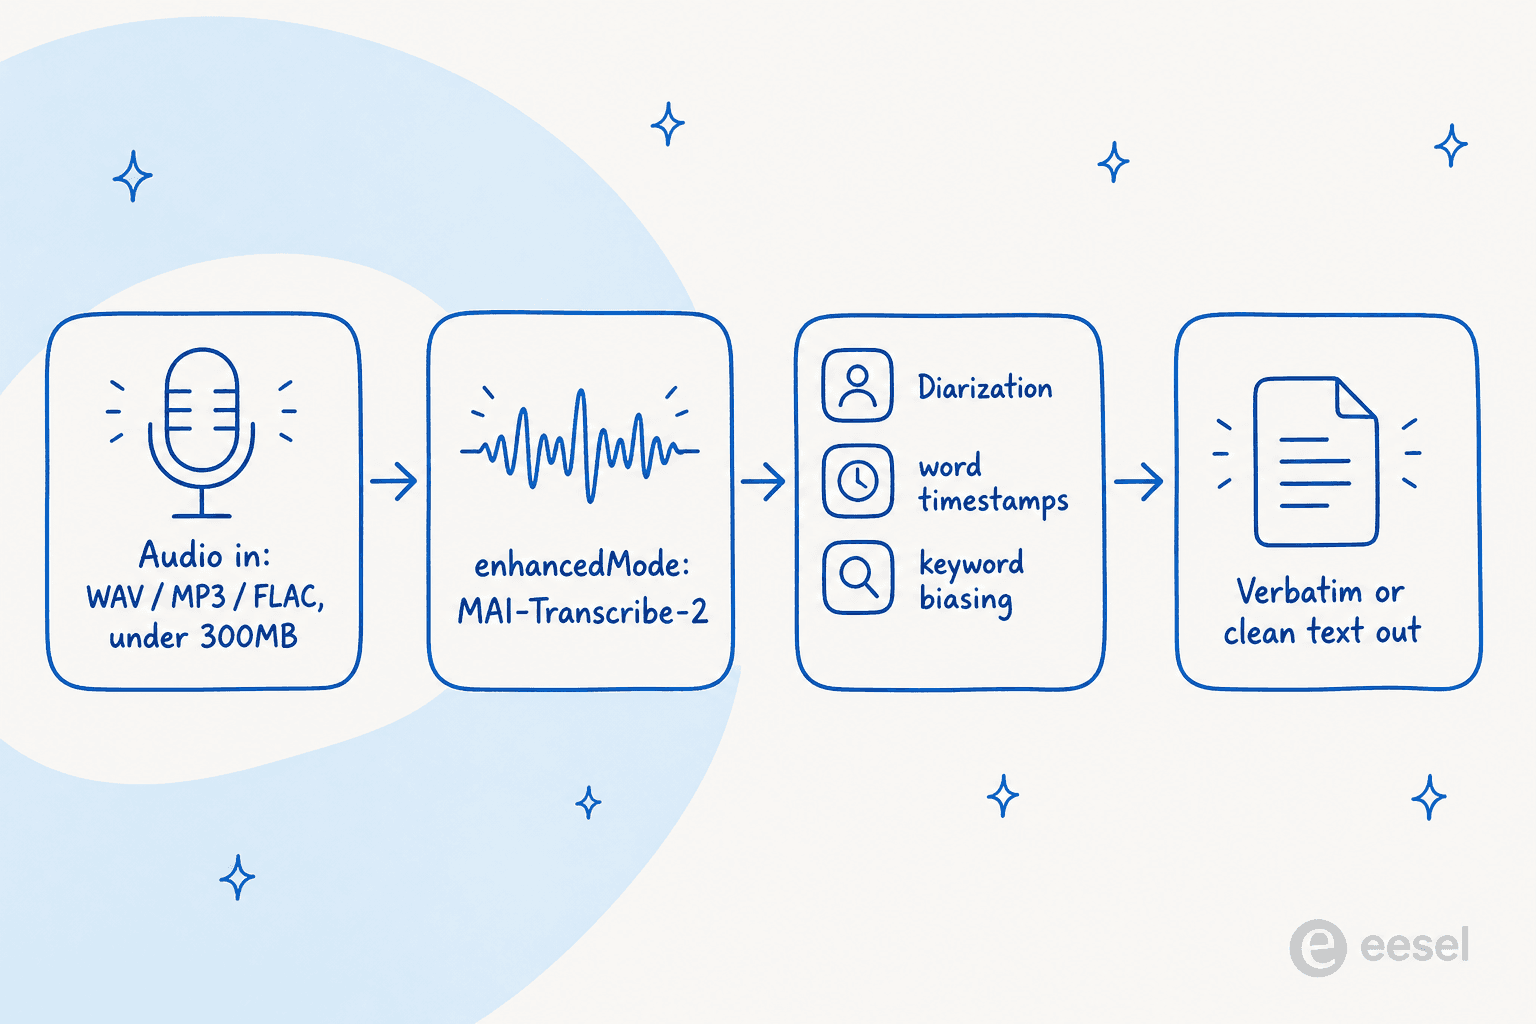
O que você recebe é mais do que uma string bruta. O modelo cuida da diarização de falantes (marcar quem falou quando), carimbos de tempo por palavra, direcionamento por palavras-chave para favorecer nomes de produtos e jargões, e a escolha entre um estilo "verbatim", que mantém cada vício de linguagem e recomeço para trabalhos de conformidade, e um estilo "clean", que formata legendas legíveis. Ele sucede o MAI-Transcribe-1.5 e o MAI-Transcribe-1, que a documentação do Azure Speech marca como descontinuados desde 20 de agosto de 2026.
O enquadramento honesto: é um modelo da Microsoft AI, portanto faz parte do ecossistema Azure Speech e não de um app de consumo independente. Você o acessa por uma API, um playground para desenvolvedores ou roteadores de terceiros, não por um produto polido para o usuário final. Se você esperava um app de reuniões no estilo Otter, isto é a camada por baixo dele, não o app em si.
A manchete: mais rápido, mais preciso e mais barato
A Microsoft não deixou margem para dúvida. A publicação de lançamento chama o MAI-Transcribe-2 de "o modelo de reconhecimento de fala mais rápido, preciso e barato do mundo", o tipo de alegação tripla que costuma desmoronar na segunda parte. Esta se sustenta em grande parte, com alguns asteriscos.
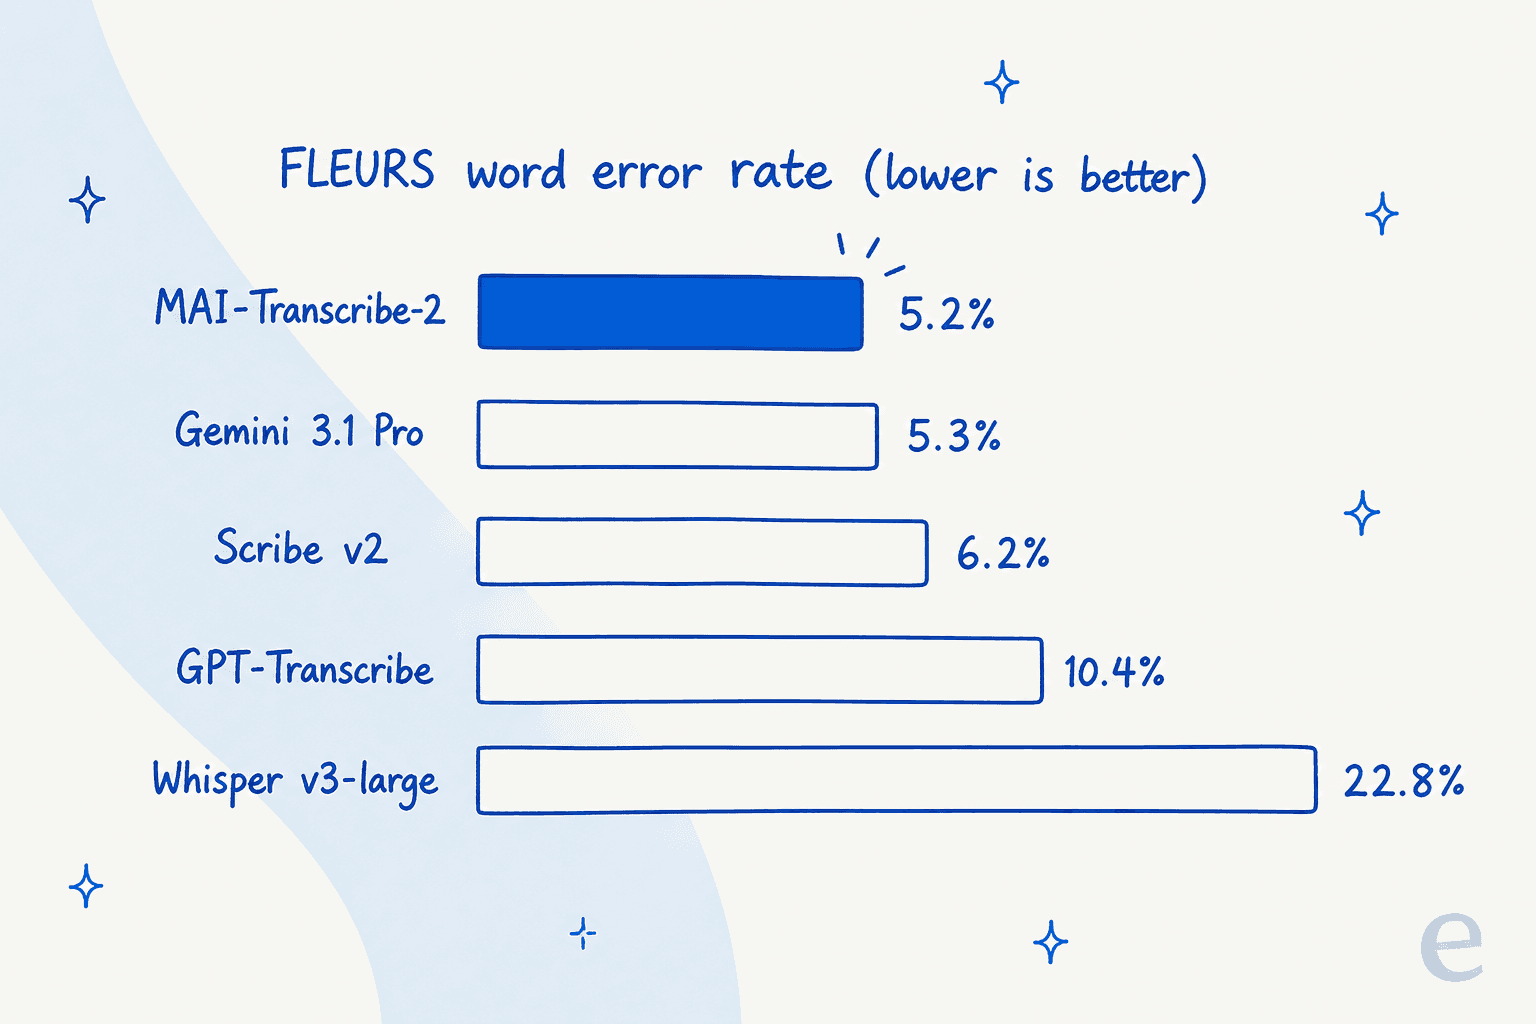
Em precisão, o modelo registra uma taxa média de erro de palavras de 5,2% no benchmark FLEURS em 60 idiomas, que segundo a Microsoft é o 1º lugar no FLEURS e o segundo no ranking de taxa de erro de palavras da Artificial Analysis. Nos 25 principais idiomas do FLEURS, cai para 3,4%. Veja como a página do modelo o compara com os demais (menor é melhor):
| Modelo | WER FLEURS em 60 idiomas (forced) |
|---|---|
| MAI-Transcribe-2 | 5,2% |
| Gemini 3.1 Pro | 5,3% |
| Scribe v2 (ElevenLabs) | 6,2% |
| Gemini 3.5 Transcribe | 5,9% |
| GPT-Transcribe (OpenAI) | 10,4% |
| Whisper v3-large (OpenAI) | 22,8% |
A diferença para o Whisper v3-large, aberto e mais antigo, é enorme, e a vantagem sobre o Gemini 3.5 Transcribe e o GPT-Transcribe é real. Já a margem sobre o Gemini 3.1 Pro é de um décimo de ponto, então "mais preciso" é verdade, mas por muito pouco no topo da tabela.
Em velocidade, os números impressionam de verdade. A Microsoft mede uma hora de áudio em cerca de 10 segundos de inferência do modelo, e seus benchmarks de lançamento o mostram 10 vezes mais rápido que o GPT-Transcribe, 7 vezes mais rápido que o ElevenLabs Scribe v2 e 5 vezes mais rápido que o Gemini 3.5 Transcribe, tudo isso na fronteira de Pareto entre precisão e latência. Um comentarista do HN que o testou resumiu o enquadramento sem rodeios:
"According to Artificial Analysis it is on the pareto frontier."

O que manter em mente ao ler tudo isso: são números de benchmark da própria Microsoft e pontos de comparação escolhidos pela própria Microsoft. Isso não os torna errados, e os primeiros testes independentes seguem a mesma direção. Apenas significa que "o melhor do mundo" é o enquadramento do fornecedor, e ser o segundo no ranking geral da Artificial Analysis é uma leitura mais comedida.
Como usar na prática
Aqui meu lado construtor entrou em ação, e é aqui que o modelo fica mais interessante do que o ranking. O MAI-Transcribe-2 roda pela Fast Transcription API do Azure Speech, e você o ativa com a flag enhancedMode, em vez de um endpoint novo. Uma chamada mínima é assim:
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Content-Type: multipart/form-data' \
--header 'Ocp-Apim-Subscription-Key: <YourSpeechResourceKey>' \
--form 'audio=@"YourAudioFile.wav"' \
--form 'definition={
  "enhancedMode": {
    "enabled": true,
    "model": "MAI-Transcribe-2"
  }
}'
A partir daí, os parâmetros são limpos: diarization.enabled para rótulos de falante, phraseList.phrases para direcionamento por palavras-chave, modelOptions.transcribeStyle para escolher literal ou limpo, e locales se você quiser pular a detecção automática. Os arquivos sobem como WAV, MP3 ou FLAC e têm limite de 300 MB. É um upload em lote direto, o que é bom ou ruim dependendo do que você está construindo.
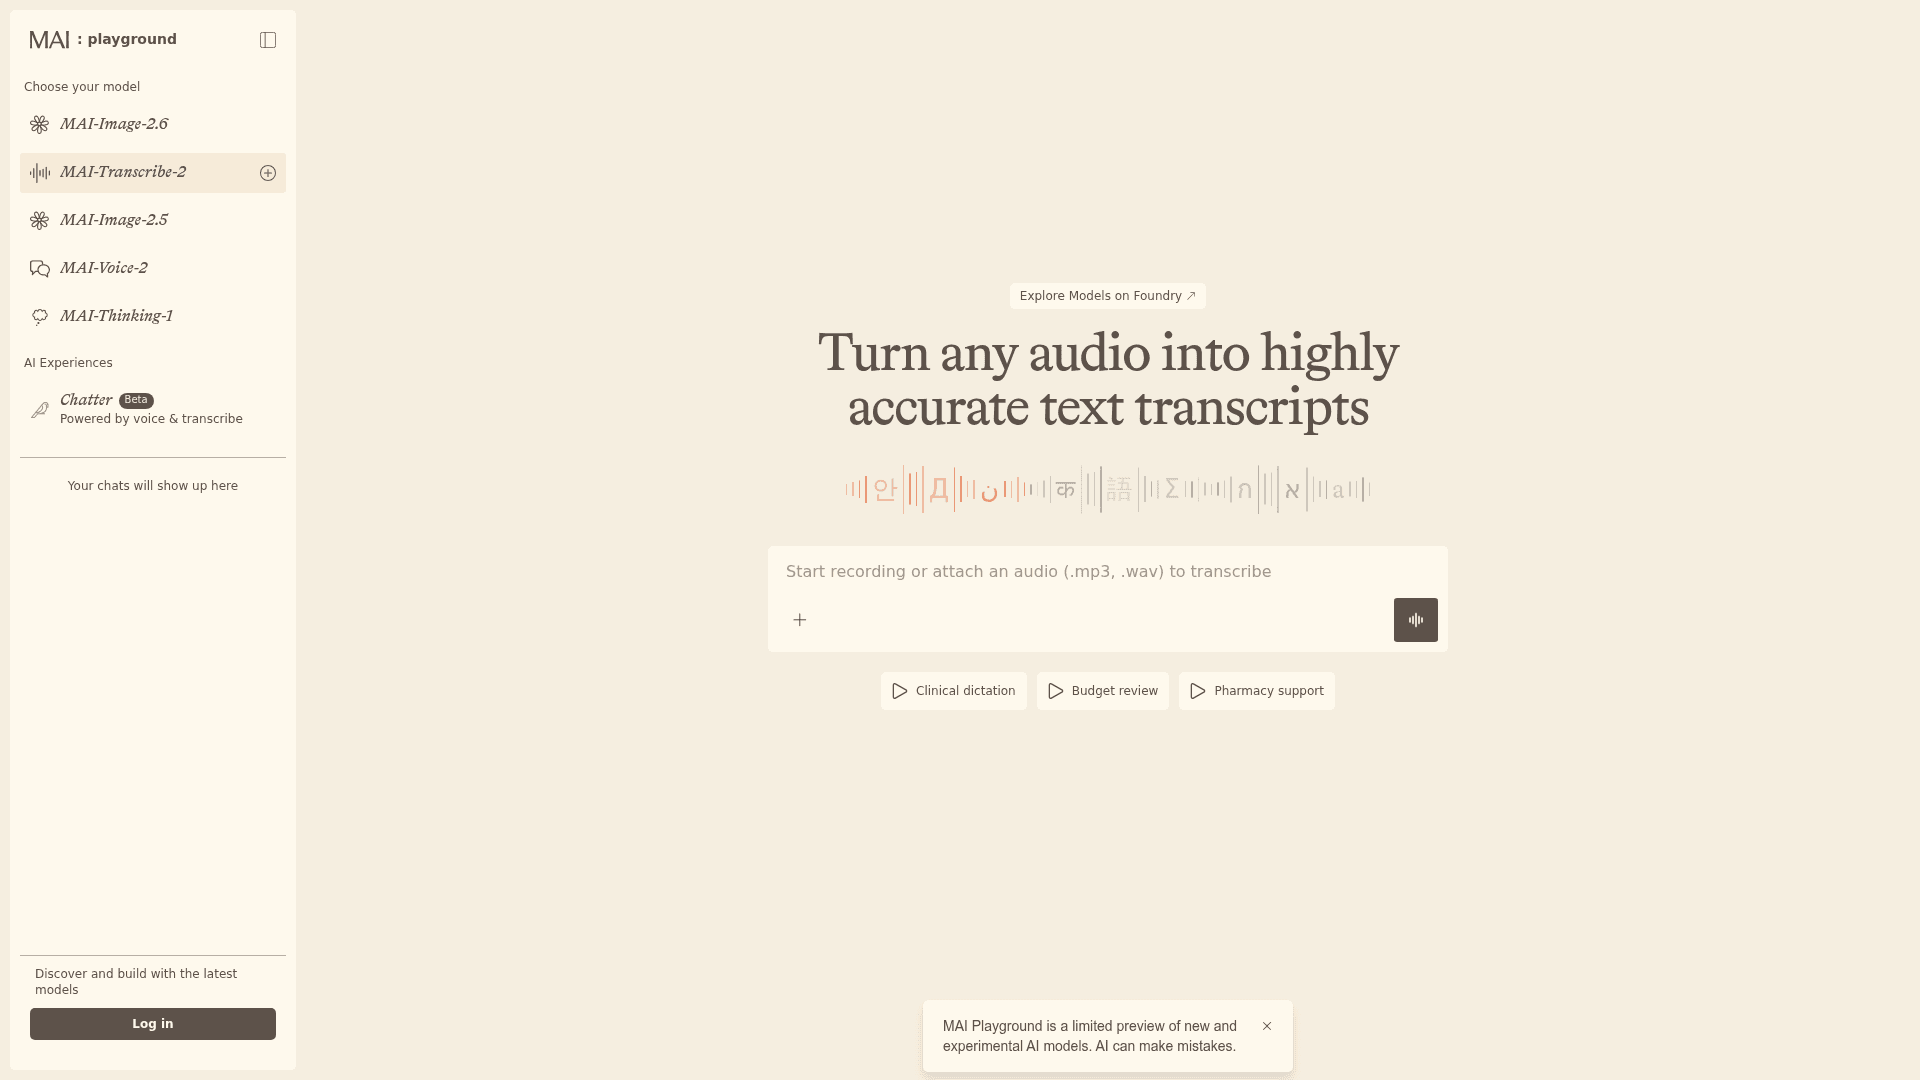
Se você prefere clicar a usar curl, há duas portas mais fáceis. O MAI Playground permite soltar um MP3 ou gravar direto do navegador, com exemplos de ditado clínico e ligações de suporte, e o modelo também está listado no OpenRouter e no catálogo do Azure AI Foundry.
Onde ele é realmente bom e onde estão as ressalvas
Primeiro, vamos dar ao MAI-Transcribe-2 o que ele merece. A reação independente mais forte que encontrei não foi uma republicação da ficha técnica. Vojtech Rinik, o desenvolvedor independente por trás do app Whisper Memos, passou por ele um clipe real difícil:
"I tried running a church homily with lots of echo in Slovak language through this... It did much better than ElevenLabs at 45% of the price."
Áudio ruidoso, com eco e em idioma que não é o inglês é exatamente o caso que derruba modelos mais fracos, então um desenvolvedor que o escolhe em vez de uma ferramenta que já usa em produção diz algo que a tabela de benchmarks não consegue.
Agora as ressalvas, porque elas importam se você for colocar isso em produção. O preço de US$ 0,10 por hora é uma promoção de lançamento que vai "até o fim do ano", e a Microsoft não divulgou o que acontece depois. Como referência, a página do modelo ainda lista o MAI-Transcribe-1.5 a US$ 0,36 por hora, então a tarifa padrão da v2 cair nessa faixa não seria surpresa. Um comentarista do Hacker News fez as duas perguntas que a Microsoft deixou em aberto no lançamento:
"is this usable for streaming or only batch? do they give the price after the launch-discount (till end of year) goes away?"
A parte do streaming tem resposta, e é trabalhosa: a Fast Transcription API é apenas em lote, e para áudio ao vivo você precisa ligar o modelo como modelo de transcrição de entrada na Voice Live API, que é separada. É factível, mas não é a mesma chamada, então planeje. Ele também ainda está em prévia pública e foi lançado sem SLA, algo que a Microsoft sinaliza explicitamente como inadequado para produção.
O formato de integração é a outra coisa a verificar. Por ser um modelo de transcrição puro, ele não se encaixa nas ferramentas de chat completions como um LLM geral. Desenvolvedores no Reddit esbarraram nisso cedo:
"OpenRouter requires a dedicated endpoint (
/api/v1/audio/transcriptions) for pure transcription models like MAI-Transcribe-2."

Nada disso impede o uso. É a textura normal de um modelo em prévia com uma semana de vida, e vale nomear para que você não seja pego de surpresa.
O que o gráfico de benchmarks não mostra
Este é o reenquadramento ao qual eu sempre voltava. A transcrição costumava ser a parte difícil e cara. O MAI-Transcribe-2, junto com o Gemini 3.5 Transcribe e o ElevenLabs Scribe, a transformou discretamente em uma camada rápida, barata e quase resolvida, uma commodity. Isso é ótimo, mas também significa que o valor mudou de lugar. Uma transcrição precisa não é o que alguém realmente queria; é a matéria-prima do que queriam.
Em nenhum lugar isso é mais claro do que no atendimento ao cliente. Um modelo de transcrição pode transformar uma ligação de suporte ou um correio de voz em texto impecável, com falantes separados e carimbos de tempo, em cerca de dez segundos. E depois? O texto ainda precisa ser lido, a resposta ainda precisa ser encontrada nos seus documentos e tickets anteriores, a resposta ainda precisa ser escrita e o ticket resolvido. O modelo dá os ouvidos. Não dá o colega.
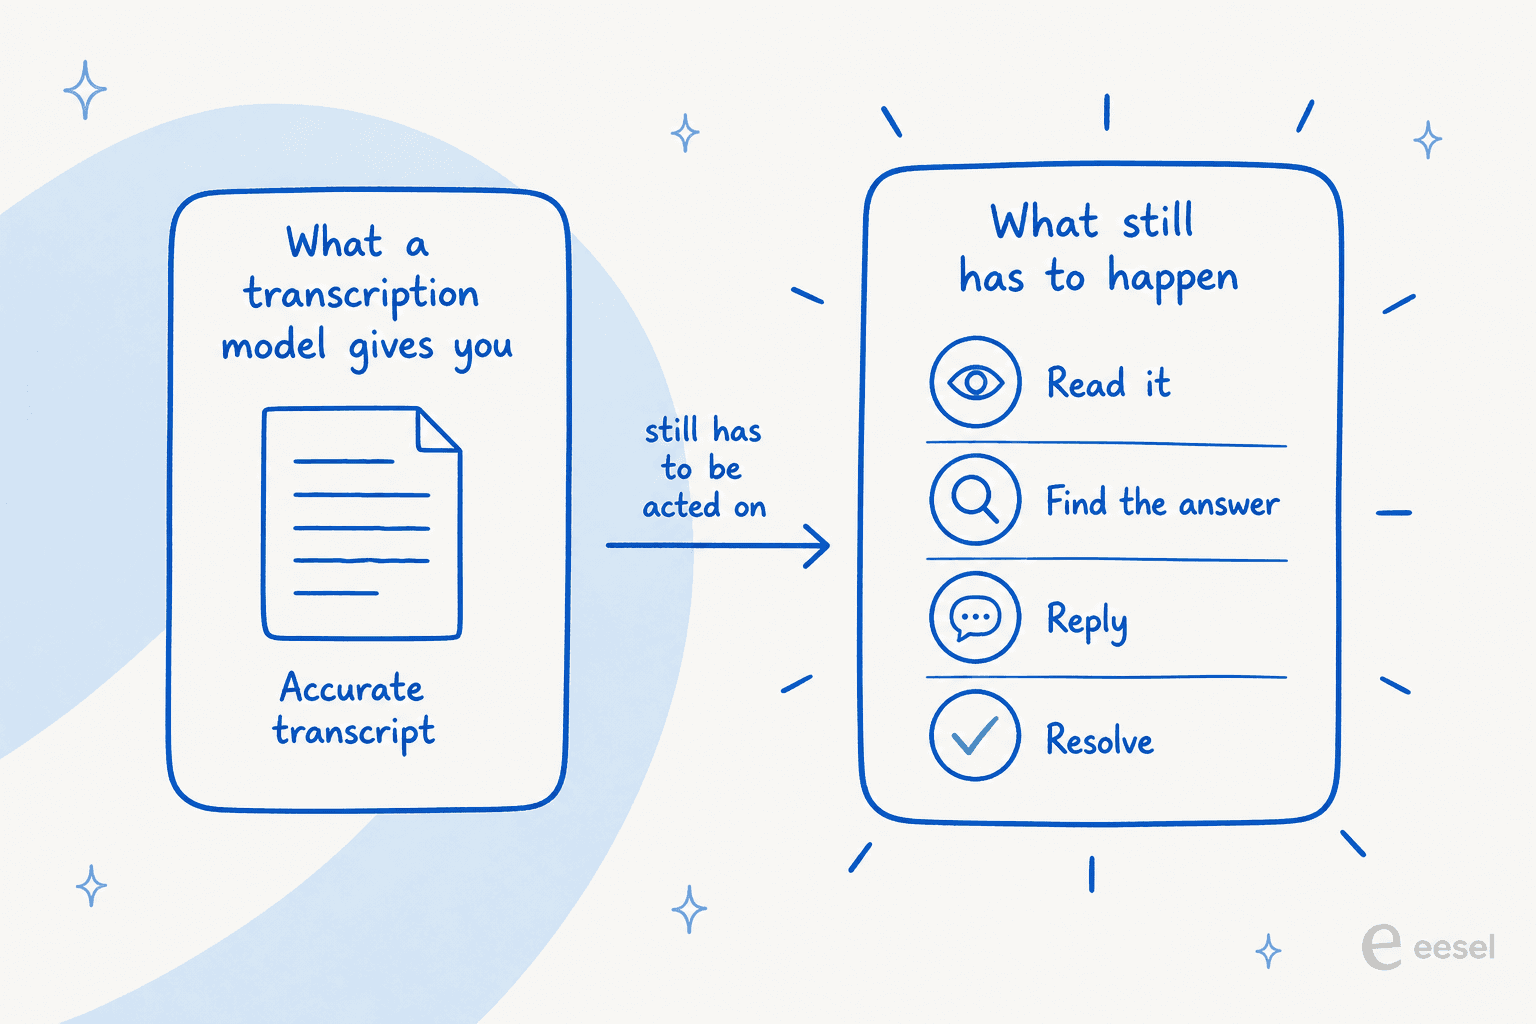
Este é o limite honesto de um modelo como o MAI-Transcribe-2, e não é uma crítica. Ele faz seu trabalho extremamente bem. É apenas um trabalho diferente de resolver a conversa, e se você é uma equipe de suporte, o segundo trabalho é o que realmente move seus números.
Onde a eesel se encaixa
O MAI-Transcribe-2 é infraestrutura. A eesel é o funcionário que trabalha em cima dele. Construímos colegas de IA que você contrata para uma função específica, e o colega de IA para helpdesk é o que assume de onde um modelo de transcrição para: ele lê o texto, busca a resposta na sua central de ajuda e nos tickets anteriores, e redige ou envia a resposta direto no Zendesk, Freshdesk ou Slack. Combine os dois e um ticket de voz transcrito vira um ticket resolvido, não apenas um parágrafo organizado.

E como o MAI-Transcribe-2 é um modelo pensado primeiro para APIs, os desenvolvedores que o escolhem tendem a querer o mesmo controle sobre a automação de suporte. A eesel tem uma CLI pública para isso: ela controla o mesmo colega e workspace a partir de um terminal, de modo que uma pessoa pode executá-la à mão, um script pode automatizá-la e agentes de programação como Claude Code ou Cursor podem operá-la sem interface, sem precisar de painel. Você pode ligar a transcrição no início desse pipeline e a eesel na ponta que resolve. É gratuito para testar, conecta-se ao seu helpdesk em poucos minutos e simula com seus tickets passados reais antes de responder a qualquer cliente, para que você veja como ele teria tratado sua fila antes de liberá-lo.