

O Cohere Parse 5 (parse-v5.0) é um modelo de visão pequeno e focado em custo que transforma páginas de documentos em Markdown limpo para busca, RAG e agentes. Ficou disponível de forma geral em 27 de agosto de 2026.
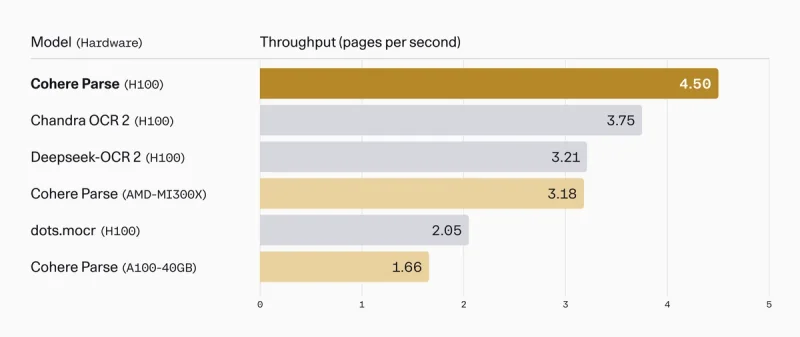
O veredito honesto: o Parse 5 não é o parser mais preciso do mercado, e não tenta ser. No ParseBench da própria Cohere ele marca 79,2, atrás dos LLMs de ponta (GPT-5.5 com 84,4, Opus 4.8 com 84,3, Gemini 3.5 Flash com 81,8), mas à frente da maioria das ferramentas de OCR dedicadas. Ele vence em preço e vazão: US$ 1,50 por 1.000 páginas e 4,5 páginas por segundo, com o Model Vault reduzindo ainda mais o custo por página em escala.
Compre se você analisa centenas de milhares a milhões de páginas para um pipeline de RAG e quer custo previsível. Tenha cuidado se precisa hoje de uma integração rígida (o endpoint em produção recebe imagens, não PDFs), saída JSON estruturada ou pontuações de confiança por campo, porque o Parse 5 não oferece nada disso. E lembre-se: o Parse é só o primeiro passo. Ele entrega texto limpo, não respostas.
O Cohere Parse 5 chegou com uma proposta bem específica. Não "o melhor parser de documentos", mas "o melhor perfil de custo-benefício do mercado". É algo refrescante de admitir em um lançamento, e é também toda a história sobre se este modelo é o certo para você.
Eu construo integrações e a parte de encanamento de APIs para viver, e na eesel passei muito tempo na parte pouco glamorosa desse trabalho: fazer documentos corporativos bagunçados chegarem em uma forma que uma IA consiga realmente usar. A análise é onde um pipeline de recuperação ganha ou perde em silêncio. Um parser que destrói uma tabela de preços ou perde um campo de formulário contamina todas as respostas seguintes, e você raramente percebe até um cliente receber o número errado. Então li a documentação do Parse 5 como leio qualquer parser: não "como é boa a demo", mas "o que quebra em produção".
Eis o que encontrei.
O que o Cohere Parse 5 realmente é
O Parse é a entrada da Cohere na inteligência documental corporativa. A frase do produto é "transforme seus documentos corporativos em dados prontos para IA", e, mecanicamente, isso significa que ele converte arquivos complexos e multimodais (tabelas, formulários, diagramas, imagens incorporadas) em Markdown estruturado e legível por máquina que você pode alimentar em fluxos de indexação, recuperação e agentes.
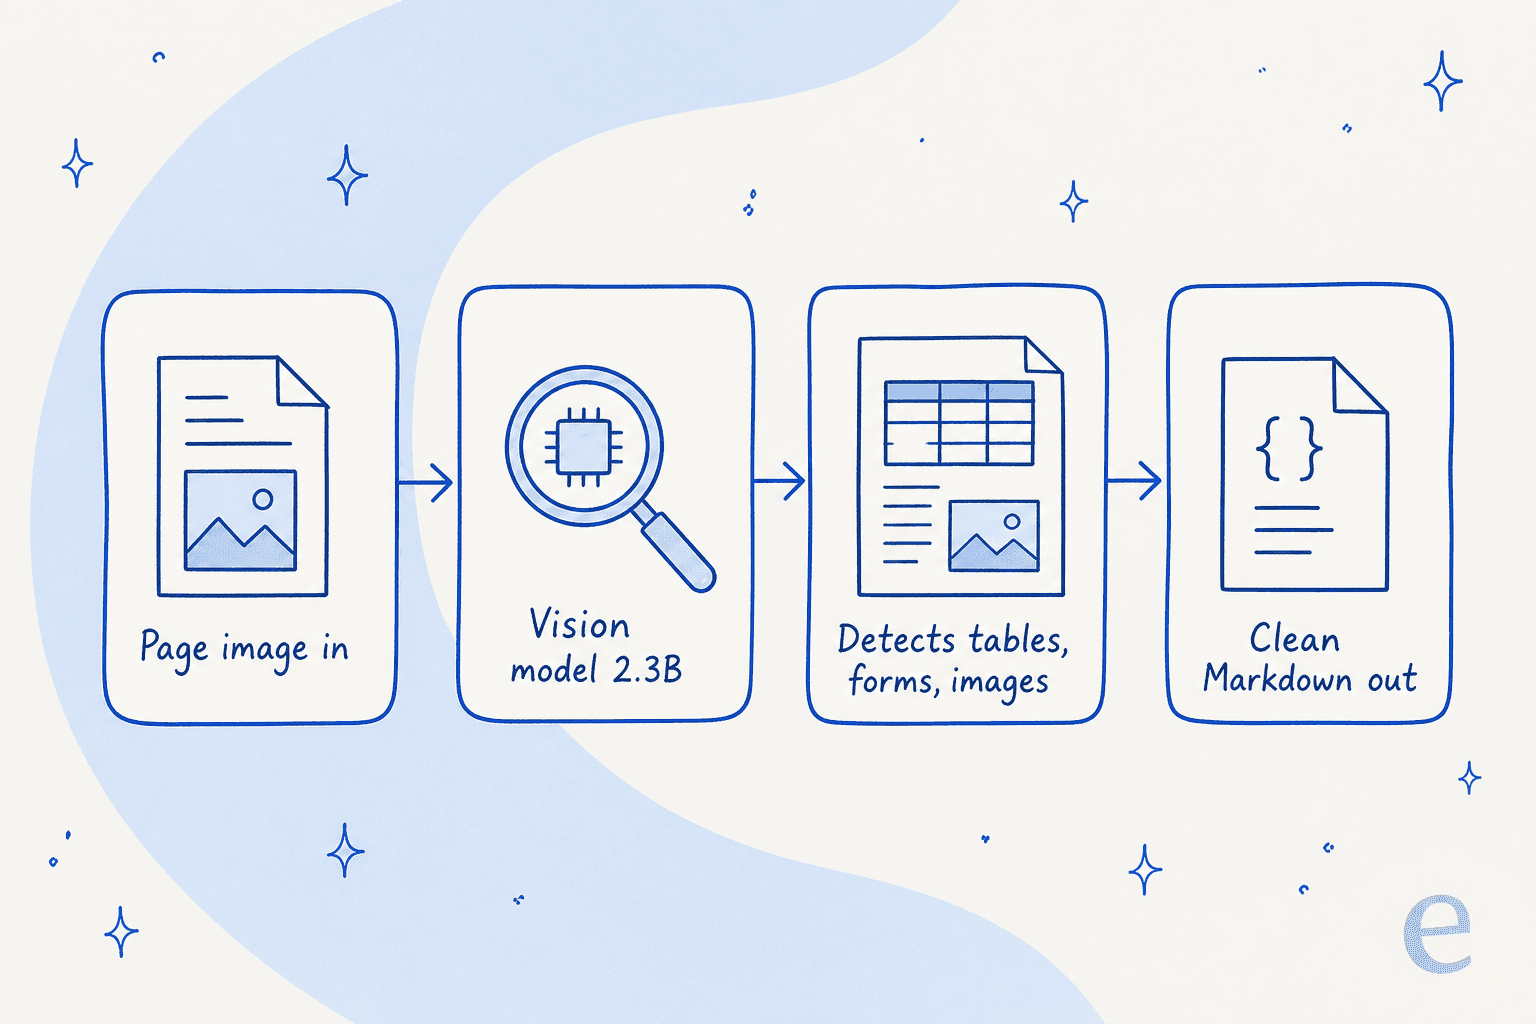
Os detalhes importam, porque "modelo de visão e linguagem para documentos" cobre muita coisa. Segundo a documentação do modelo, o parse-v5.0 é um modelo de 2,3 bilhões de parâmetros, com cerca de 4,6 GB, contexto de 8.192 tokens, construído sobre a arquitetura north-micro-vision-instruct da Cohere. É um modelo deliberadamente pequeno. A Cohere é franca ao dizer que os LLMs de ponta com os quais é comparado são "cada um de uso geral e significativamente maiores que o Parse". Ser pequeno é o ponto: é o que faz o preço e a vazão funcionarem.
O fluxo é simples. Você entrega uma imagem de página, ele detecta a estrutura visual e retorna Markdown limpo, com tabelas embutidas em HTML e caixas delimitadoras para os elementos visuais.
O benchmark: forte, mas não o melhor
A Cohere criou seu próprio benchmark, o ParseBench, para medir o "desempenho de análise adequado a agentes" em três dimensões: extração de tabelas, fidelidade do conteúdo (omissões, alucinações, ordem de leitura quebrada) e formatação semântica (estilos que mudam o significado, como o texto tachado).
O Parse chega a 79,2 na média das três dimensões, e o formato dessa pontuação é interessante. Ele é realmente forte em tabelas (87,0) e fidelidade do conteúdo (86,6), e mais fraco em formatação semântica (64,0). Ou seja, ele lê e estrutura seu conteúdo de forma confiável, mas é menos cuidadoso ao preservar nuances como itálico ou tachado, que ocasionalmente mudam o que o texto significa.
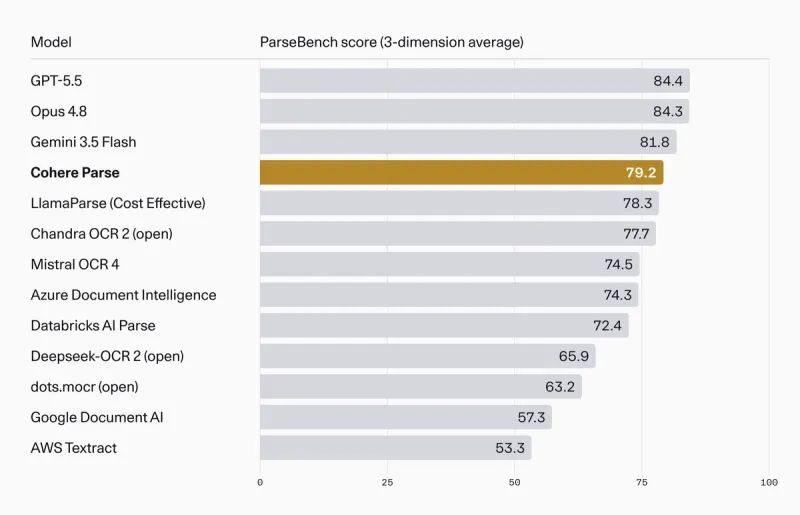
Lendo o gráfico com honestidade, duas coisas são verdadeiras ao mesmo tempo. O Parse é superado pelos três modelos de ponta: GPT-5.5 (84,4), Opus 4.8 (84,3) e Gemini 3.5 Flash (81,8). E o Parse supera todos os parsers dedicados que a Cohere testou, incluindo o nível econômico do LlamaParse (78,3), o Chandra OCR 2 (77,7), o Mistral OCR 4 (74,5) e o Databricks AI Parse (72,4). Diante dos serviços de OCR em nuvem da velha guarda, não há comparação: a Cohere reporta uma melhoria de mais de 20 pontos tanto sobre o AWS Textract (53,3) quanto sobre o Google Document AI (57,3).
Uma ressalva que vale citar: este é o benchmark do próprio fornecedor, e o modelo que ele vende vence no enquadramento ajustado por preço. Isso não torna os números errados, mas é por isso que o gráfico mais útil é o próximo, em que a precisão é comparada ao custo.
Vazão e preço: onde o Parse realmente vence
Este é todo o argumento a favor do Parse, então vale desacelerar aqui.
No preço, a API da Cohere cobra US$ 1,50 por 1.000 páginas. Na vazão, o modelo processa 4,5 páginas por segundo, o que a Cohere reporta como 36 páginas por segundo (2.160 páginas por minuto) em um nó 8×H100, cerca de 1,4 vez a vazão do dots.mocr da RedNote e 2,2 vezes a do Chandra OCR 2 no mesmo hardware, tudo servido com o vLLM.
Coloque precisão e preço nos mesmos eixos e a posição real do Parse salta aos olhos. No gráfico de Pareto do ParseBench, ele fica no quadrante barato e de alta pontuação, enquanto os LLMs de ponta entregam alguns pontos a mais de precisão a 30 a 50 vezes o custo por página.
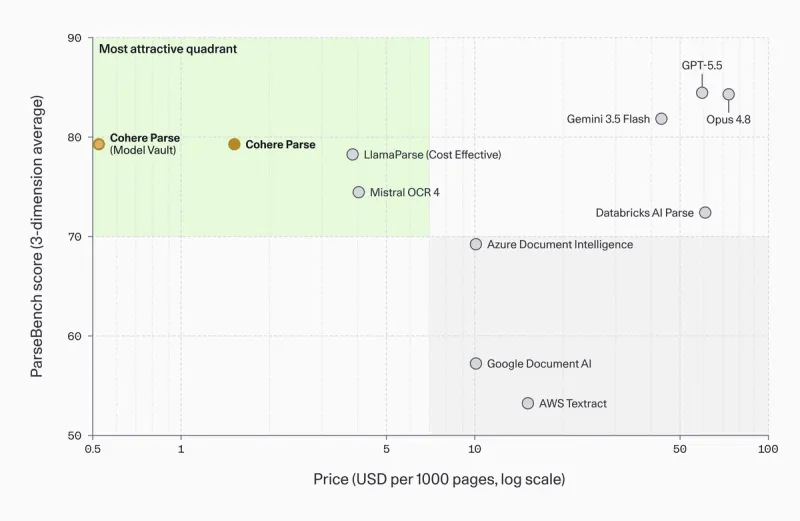
A economia fica mais concreta em volume. O exemplo prático da Cohere: um fluxo de contas a pagar que processa cerca de 13 milhões de páginas por mês no Model Vault em vez da API economiza aproximadamente US$ 12.000 por mês, ou US$ 144.000 por ano. Contra um parser de hiperescalador a US$ 10 por 1.000 páginas, esse mesmo fluxo economizaria cerca de US$ 1,47 milhão por ano. São os números que levam uma decisão de análise ao financeiro, e são o motivo de o Parse existir.
Preços do Cohere Parse 5 em detalhe
O Parse é vendido por várias vias, e a mais barata depende da constância com que você o executa. Aqui está o quadro completo.
| Via de acesso | O que você recebe | Preço |
|---|---|---|
| API da Cohere | Endpoint gerenciado, pagamento por página, sem infraestrutura | US$ 1,50 por 1.000 páginas |
| Model Vault (50% de uso da GPU) | Instância de locatário único cobrada por hora | ~23% abaixo da API |
| Model Vault (uso total) | Instância de locatário único cobrada por hora | até 61% abaixo da API |
| Microsoft Foundry | Modelo Cohere-parse-v5 no Azure | Preço de instância do Azure |
| Amazon SageMaker | Implantação via marketplace | Preço de instância da AWS |
| Hugging Face Space | Demo gratuita para experimentar | Grátis |
Minha leitura: a API é a escolha certa para trabalho irregular ou de baixo volume, porque você paga só pelas páginas que envia. O Model Vault vence quando você tem volume constante e alto para manter as instâncias ocupadas, que é exatamente a carga em escala de contas a pagar para a qual o Parse foi feito. Se o seu volume é irregular, faça as contas antes de se comprometer com uma instância dedicada, porque tempo ocioso de GPU apaga rápido a economia por página.
Para ver como isso se encaixa no catálogo e nos planos mais amplos da Cohere, nosso detalhamento de preços da Cohere AI cobre as tarifas de Command, Embed e Rerank ao lado desta.
O que ele extrai e o que ele ignora
Um parser é definido tanto pelo que deixa de fora quanto pelo que captura, e o Parse tem algumas arestas que você deve conhecer antes de construir sobre ele.
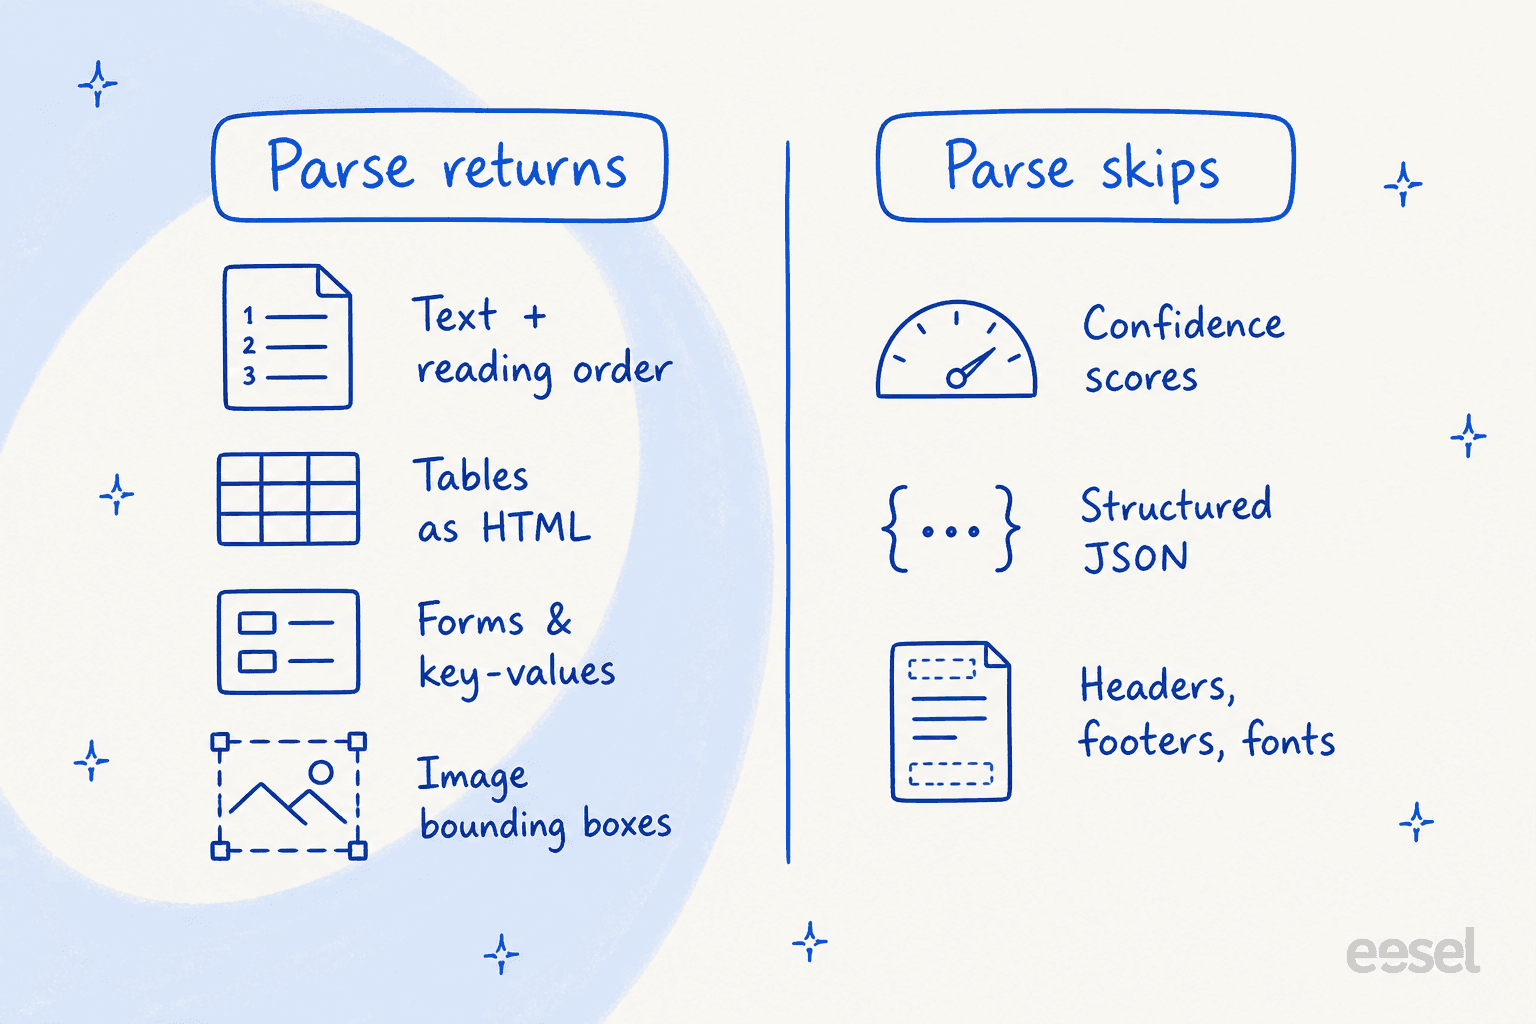
No lado positivo, o Parse retorna texto na ordem de leitura correta, tabelas em HTML, formulários e pares chave-valor, e descrições de imagens com caixas delimitadoras. É um conjunto de recursos sólido para alimentar uma base de conhecimento ou um chatbot de base de conhecimento com IA.
Os limites, direto da documentação, são onde você precisa prestar atenção:
- Sem pontuações de confiança. Você não pode perguntar ao Parse o quão seguro ele está sobre uma extração, o que dificulta o controle de qualidade automatizado. Em um fluxo de contas a pagar ou de sinistros, é uma lacuna real.
- Somente Markdown, sem JSON estruturado. Se o seu pipeline quer campos tipados de saída, você terá de pós-processar o Markdown por conta própria.
- Sem detecção de cabeçalho, rodapé ou hierarquia de fontes. Ele lê o conteúdo, mas não marca elementos acessórios do documento nem níveis de título.
- Caixas delimitadoras apenas para tabelas e imagens. Conforme a nota de rodapé 2 do lançamento, o Parse não emite caixas por elemento para texto. A Cohere apresenta isso como uma escolha intencional de ordem de leitura, não um bug, e para a maioria dos casos de RAG não importa, mas se você precisa de coordenadas em nível de palavra, procure em outro lugar.
Nenhum desses pontos é um impedimento para o caso de ingestão que o Parse mira. Eles são impeditivos se você esperava encaixar o Parse em um produto de extração estruturada de documentos que exija campos tipados e controle de confiança. Combine a ferramenta com o trabalho.
Chamando a API (e a única pegadinha)
A experiência do desenvolvedor é limpa. Você instala o SDK, cria um cliente e chama co.parse na API v2 da Cohere.
A chamada mínima do guia de início rápido é tão simples quanto a análise pode ser:
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")
data_uri = f"data:image/png;base64,{b64}"

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": data_uri},
)

for page in response.pages:
    print(page.markdown.content)
Aqui está a pegadinha, e é grande para quem planeja construir hoje. A documentação lista PDF, PPT e JPEG como tipos suportados, mas a referência da API é explícita: o endpoint atualmente suporta apenas document.type = image_url, ou seja, um data URI ou uma URL de imagem remota. Entradas diretas de PDF e de URL de arquivo ainda não são suportadas. Na prática, você primeiro rasteriza as páginas do PDF em imagens e depois as envia uma a uma. Os limites de imagem são generosos (20 MB de tamanho de arquivo, 50 megapixels), e você pode mudar output_format para blocks quando quiser o array ordenado de regiões de texto, tabela e imagem com suas caixas delimitadoras em vez de Markdown plano.
A cobertura de idiomas é de nove idiomas de entrada estáveis hoje: árabe, inglês, francês, alemão, japonês, coreano, italiano, português e espanhol, com suporte zero-shot para outros com menor precisão.
Onde o Parse se encaixa: é o primeiro passo, não o pipeline inteiro
Esta é a parte que a maior parte da cobertura do lançamento deixa passar. O Parse transforma documentos em texto limpo. Ele não os incorpora, não os recupera e não responde nada. É a porta de entrada de um pipeline de recuperação, não o pipeline.
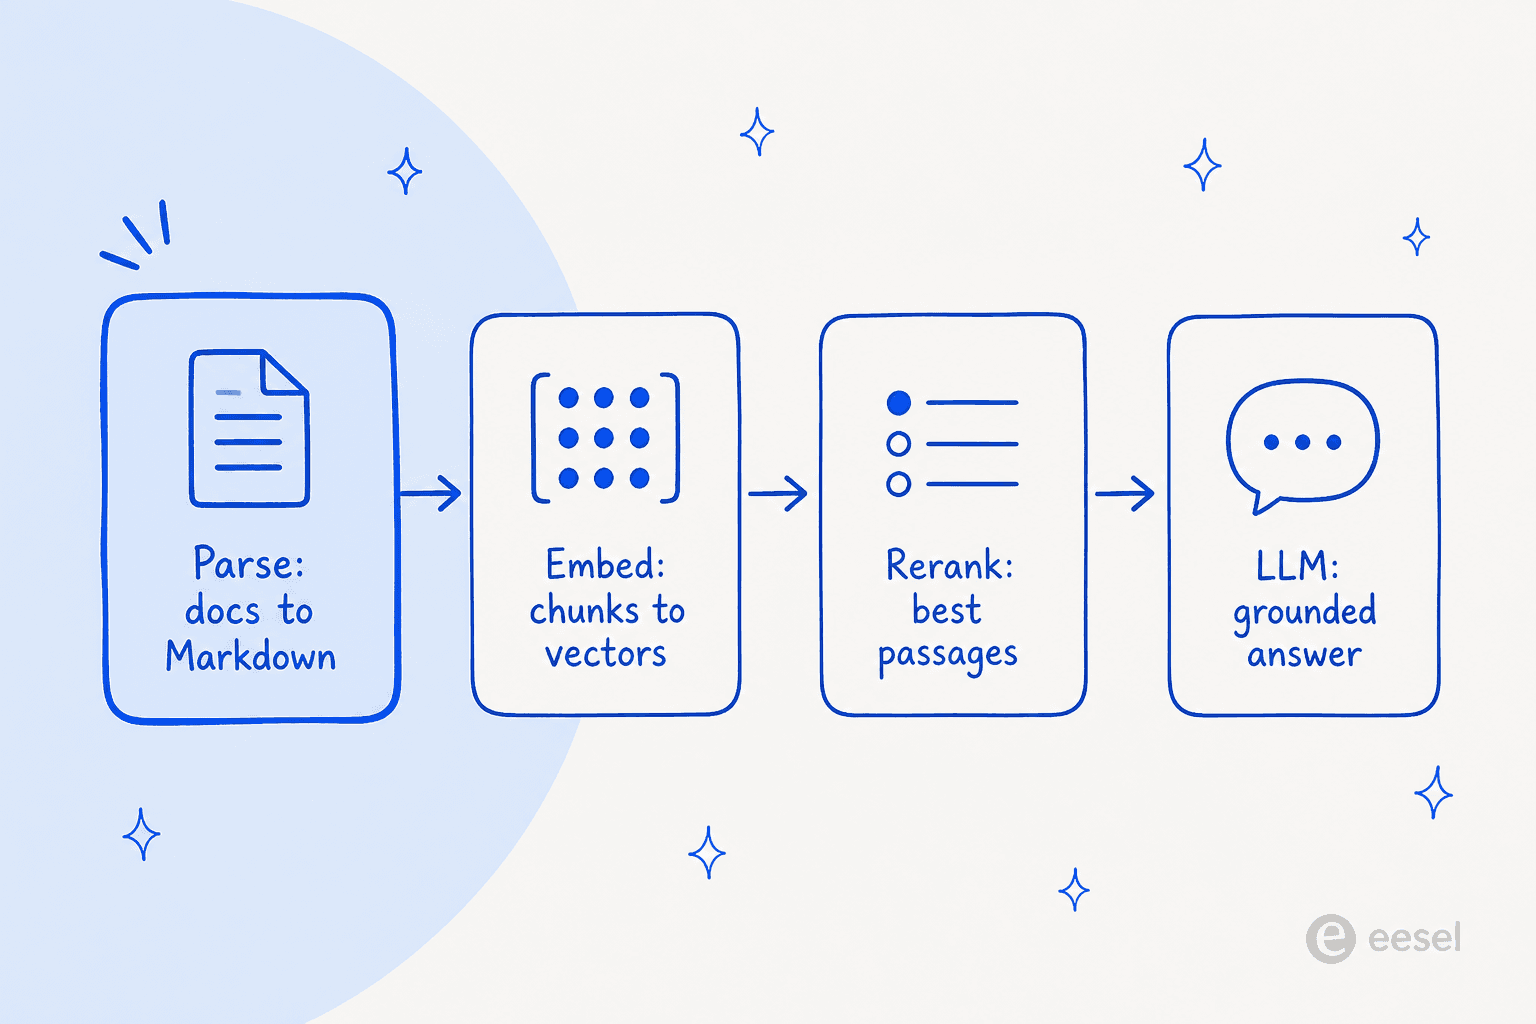
A Cohere sabe disso, e por isso o Parse é entregue como componente do Compass, sua pilha de inteligência documental e busca, ao lado do Embed e do Rerank. Se você já apostou tudo na Cohere, esse caminho integrado é realmente conveniente. Se não, vale pesar alternativas à Cohere antes de padronizar em uma única pilha.
A única voz externa confiável que encontrei sobre o lançamento fez o mesmo apontamento de que analisar é mais difícil do que parece. O jornalista de tecnologia corporativa Sean Kerner disse bem:
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Esse ceticismo é justo. O Parse 5 é um bom lançamento, mas é um parser forte em um campo em constante agitação, e resolve exatamente um elo de uma cadeia com quatro ou cinco. Se o seu objetivo real é responder perguntas a partir dos seus documentos, escolher um parser é o início do projeto, não o fim.
Quem realmente deve usar o Cohere Parse 5
Depois de analisar tudo, é aqui que chego.
Escolha o Parse 5 se você está ingerindo grandes volumes de documentos corporativos (pense em centenas de milhares a milhões de páginas) em um sistema de RAG ou de gestão do conhecimento, se importa com custo previsível por página e "perto da precisão de ponta por uma fração do preço" é a troca que você quer. A opção de Model Vault e on-premises também o torna uma escolha forte para setores regulados que não podem enviar documentos a uma API pública.
Pule, por enquanto, se você precisa hoje de ingestão direta de PDF, saída JSON estruturada, pontuações de confiança por campo ou dos últimos pontos de precisão de formatação que só um modelo de ponta compra. E pule se o que você realmente queria eram respostas, e não texto limpo, porque um parser sozinho não leva você até lá.
eesel: quando você quer respostas, não só texto analisado
Se você chegou ao Parse 5 porque quer que uma IA realmente responda perguntas a partir dos documentos da sua empresa (tickets de suporte, artigos de ajuda, wikis internas), vale nomear o que o parser não faz. O Parse entrega Markdown limpo. Você ainda precisa construir por cima as camadas de embedding, recuperação, ranqueamento e resposta, e depois mantê-las precisas conforme seu conteúdo muda.
A eesel é a versão pronta para trabalhar de todo esse pipeline. Em vez de infraestrutura que você monta, é um colega de helpdesk com IA que você contrata: ela se conecta à sua central de ajuda, a tickets anteriores e a ferramentas como Zendesk ou Confluence, aprende o contexto da sua empresa e responde a perguntas reais de clientes e funcionários. É uma das melhores opções de helpdesk com IA justamente porque todo o pipeline é resolvido para você. O Parse 5 é um bloco de construção; a eesel é o trabalho concluído.

A parte que eu destacaria, porque é o que gostaria que todo pipeline que começa pela análise tivesse: a eesel permite simular um lançamento com seus próprios tickets históricos antes de ela responder a um cliente real, para que você veja a taxa de resolução real e as respostas exatas sobre o seu conteúdo de verdade, não uma demo. Essa é a diferença entre entregar um parser e entregar algo em que você confia. Você pode experimentar a eesel de graça.
Perguntas frequentes
O que é o Cohere Parse 5?
parse-v5.0) é um modelo de visão de 2,3 bilhões de parâmetros que converte páginas de documentos em Markdown limpo e legível por máquina para busca, RAG e agentes de IA. Ficou disponível de forma geral em 27 de agosto de 2026 e se posiciona pela relação custo-benefício, não pela maior precisão da tabela.