

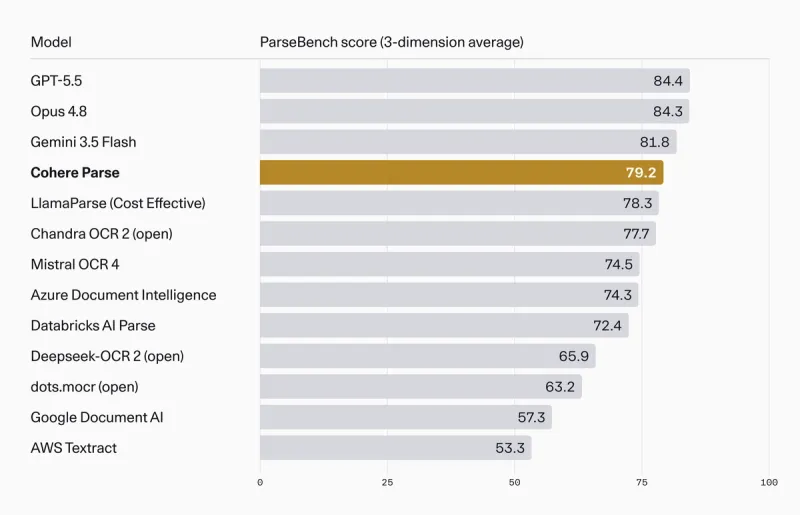
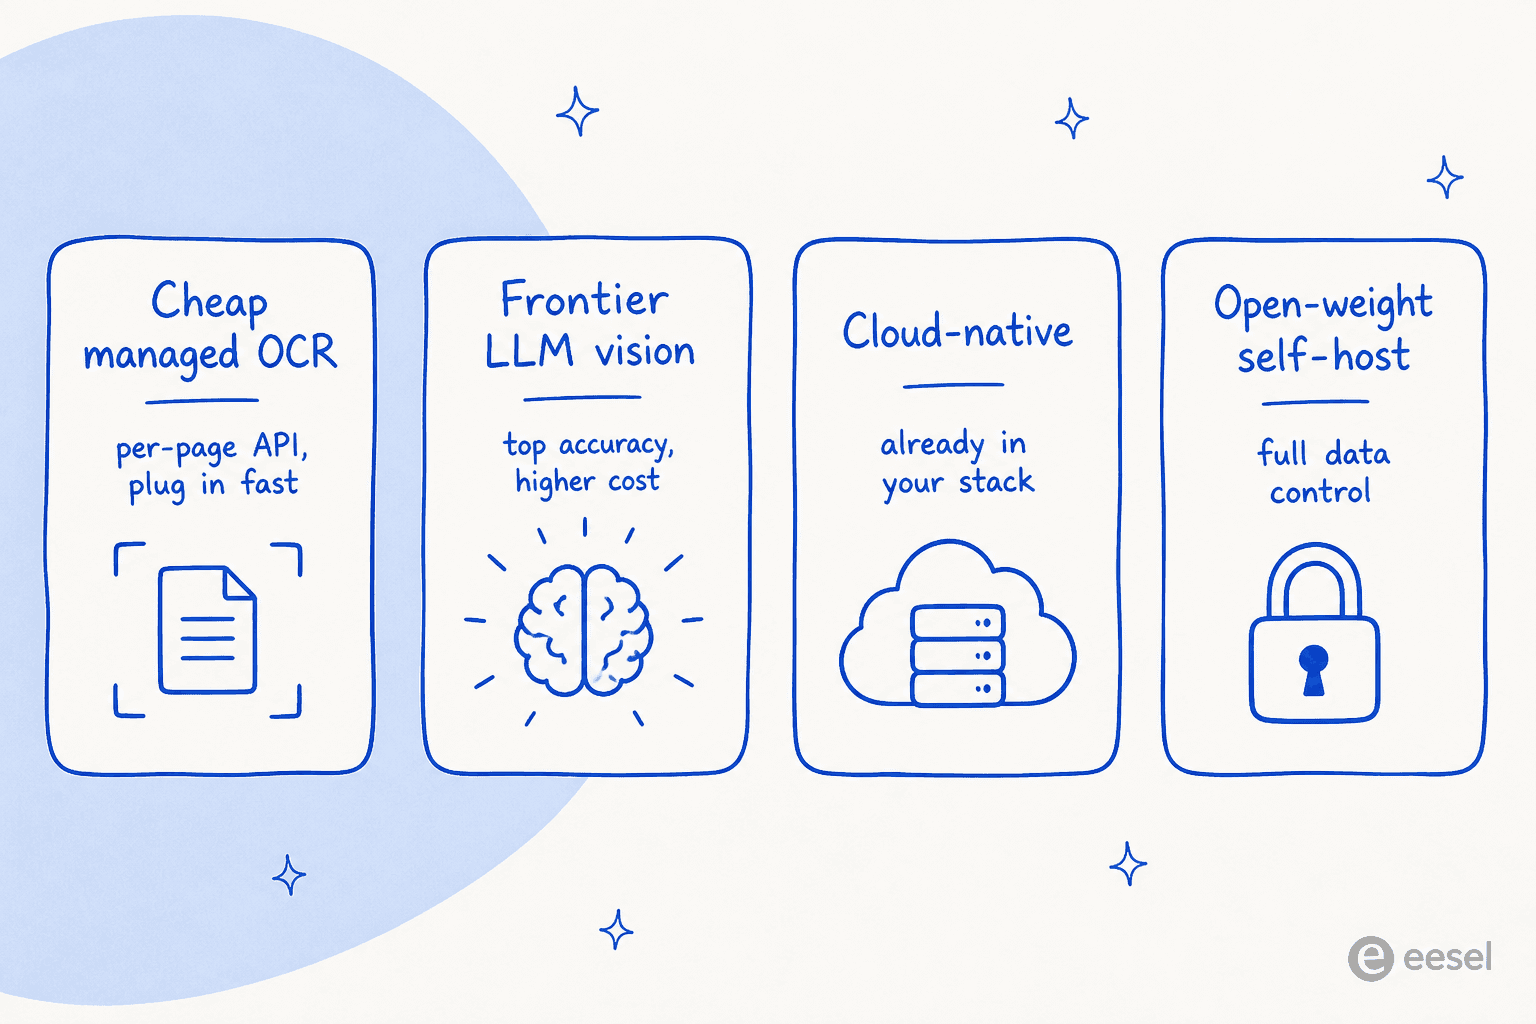
O Cohere Parse 5 (parse-v5.0) é um analisador de documentos forte e barato: transforma páginas em Markdown limpo a US$ 1,50 por 1.000 páginas e marca 79,2 no ParseBench. As pessoas procuram alternativas por três motivos: querem mais precisão, querem uma ferramenta que viva dentro de uma nuvem que já pagam, ou querem hospedar por conta própria para ter controle dos dados.
Aqui vai a versão curta de para onde ir:
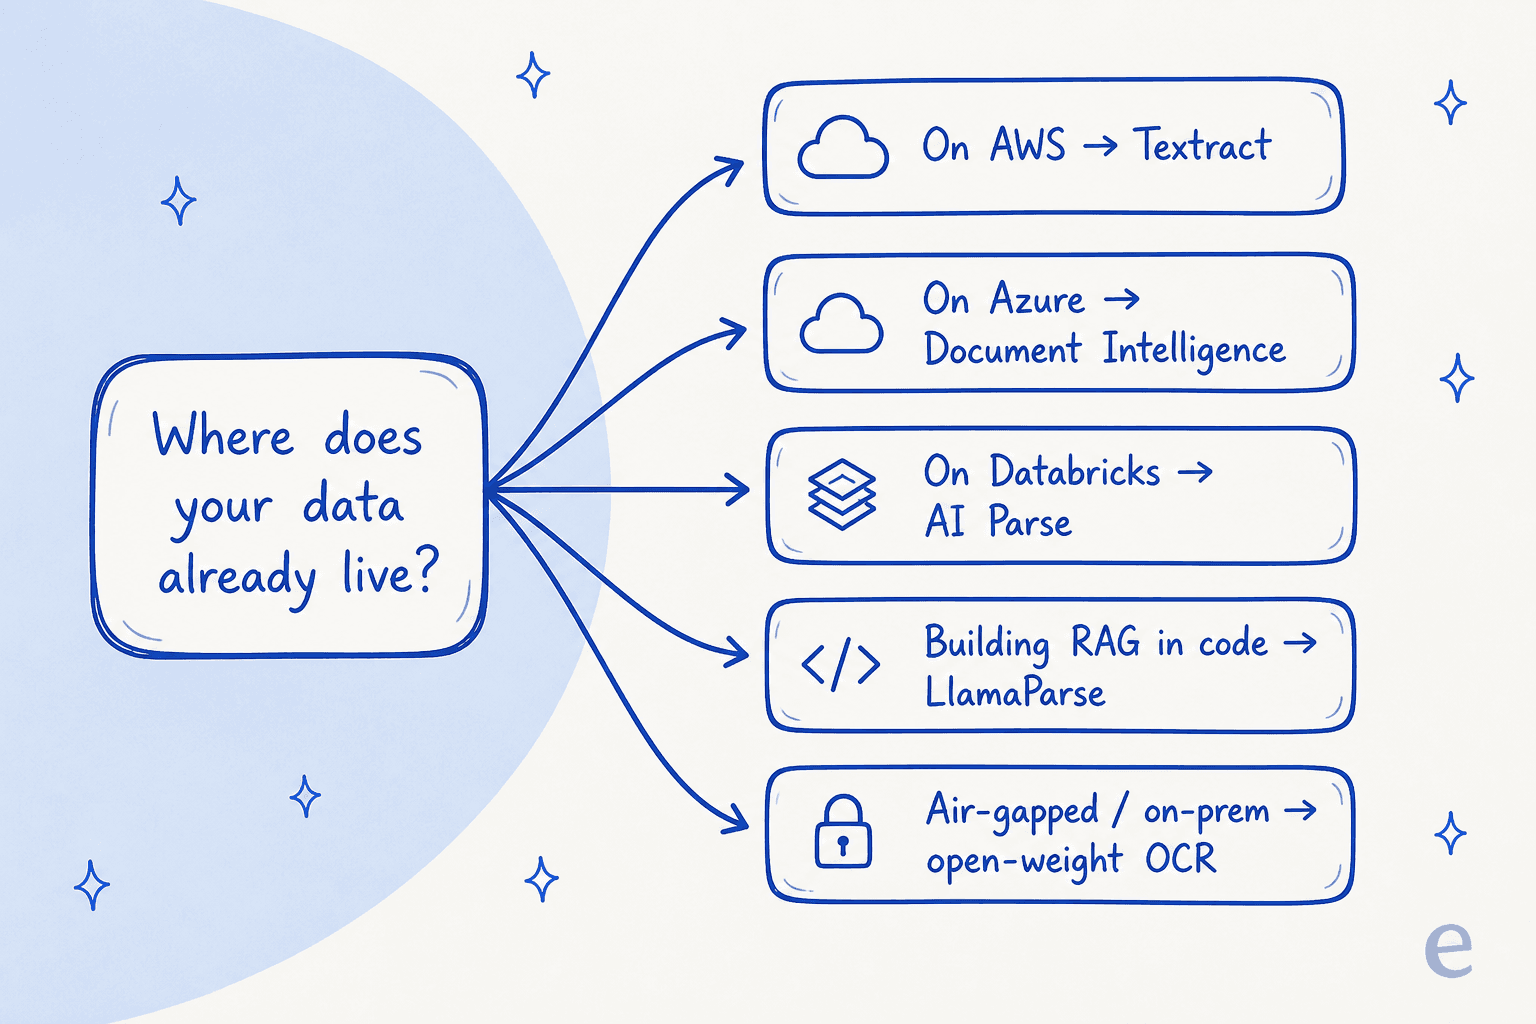
- Quer a melhor precisão, custe o que custar? Um modelo de fronteira, GPT-5.5 (84,4) ou Gemini 3.5 Flash (81,8), lidera a tabela.
- Quer uma API por página como o Parse? O Mistral OCR é a troca mais próxima.
- Construindo RAG em código? O LlamaParse se encaixa no stack do LlamaIndex.
- Já está na AWS, Azure ou Databricks? Use o analisador nativo (Textract, Document Intelligence, AI Parse) e dispense um fornecedor.
- Precisa de controle total dos dados? Hospede um modelo OCR de pesos abertos por conta própria.
Uma coisa que vale dizer logo de início: toda ferramenta desta lista apenas converte documentos em texto. Se o seu objetivo real é responder perguntas a partir desses documentos, analisar é o passo um de quatro. É aí que entra um agente de IA para helpdesk pronto para trabalhar como a eesel, que cuida da cadeia inteira em vez de só do primeiro elo.
Por que olhar além do Cohere Parse 5?
Primeiro, justiça com o Parse, porque é um lançamento realmente bom. A Cohere o lançou em 27 de agosto de 2026 como "um modelo de análise visual de alto throughput com o perfil de preço-desempenho mais forte do mercado", e os números sustentam essa descrição. Ele processa 4,5 páginas por segundo, devolve Markdown limpo que entra direto em um pipeline de RAG e custa uma tarifa fixa de US$ 1,50 por 1.000 páginas. Se você ingere centenas de milhares de páginas por mês, é difícil contestar essa relação preço-desempenho. Aprofundei tudo isso em nossa análise completa do Cohere Parse 5.
Então por que alguém pesquisa outras opções? Três motivos reais aparecem o tempo todo.
Precisão. O Parse é posicionado explicitamente em preço-desempenho, não em ser o analisador mais preciso que dá para comprar. No ParseBench ele marca 79,2 e "só é superado pelos LLMs de fronteira" (GPT-5.5, Opus 4.8, Gemini 3.5 Flash). Se seus documentos são bagunçados, densos ou cheios de tabelas aninhadas, esses pontos extras importam, e você pode pagar feliz mais por página para tê-los.
Encaixe no stack. Se seus dados já estão na AWS, Azure ou Databricks, adicionar a Cohere significa mais um fornecedor, mais uma chave, mais uma fatura e mais um acordo de processamento de dados. O analisador nativo da sua nuvem costuma ser "bom o bastante" e poupa toda essa fricção.
Limites de entrada e controle de dados. O endpoint ao vivo do Parse aceita atualmente só imagens, então os PDFs precisam ser convertidos antes, e é uma API gerenciada. Equipes de setores regulados frequentemente querem tratamento direto de PDF ou um modelo que possam rodar inteiramente no próprio hardware. Algumas alternativas oferecem ambos.
Nada disso é crítica ao Parse. São apenas as costuras em que outra ferramenta se encaixa melhor. Veja como o mercado se divide.
Como escolhi e comparei estas alternativas
Toda ferramenta aqui faz o mesmo trabalho central do Parse: pega páginas de documentos e devolve texto ou Markdown estruturado e legível por máquina. Eu as ordenei por quatro critérios que um comprador realmente valoriza:
- Precisão - onde ficam no ParseBench, o benchmark que a própria Cohere usou, para que a comparação seja justa.
- Modelo de custo - por página, por token ou sua própria computação, e quanto isso dá em volume.
- Implantação - API gerenciada, dentro de uma nuvem que você já usa ou hospedagem própria.
- Tratamento de entrada - só imagens, PDFs diretamente ou uma ampla variedade de tipos de arquivo.
Aqui está o panorama completo num relance. As pontuações do ParseBench vêm direto da tabela publicada pela Cohere.
| Ferramenta | Média ParseBench | Melhor para | Implantação | Entrada | Modelo de custo |
|---|---|---|---|---|---|
| Cohere Parse 5 | 79,2 | Análise barata e em alto volume | API, Model Vault, marketplaces de nuvem | Imagens | US$ 1,50 / 1.000 páginas |
| GPT-5.5 | 84,4 | Documentos mais bagunçados, máxima precisão | API | Imagens, PDFs (via LLM) | Por token |
| Opus 4.8 | 84,3 | Máxima precisão, contexto longo | API | Imagens, PDFs (via LLM) | Por token |
| Gemini 3.5 Flash | 81,8 | Análise barata de nível fronteira | API | Imagens, PDFs (via LLM) | Por token |
| LlamaParse | 78,3 | Pipelines de RAG baseados em código | API / nuvem | PDFs, Office, imagens | Créditos por página |
| Mistral OCR 4 | 74,5 | API por página com hospedagem própria | API, hospedagem própria | Imagens, PDFs | US$ 4 / 1.000 páginas |
| Databricks AI Parse | 72,4 | Equipes no lakehouse | Dentro do Databricks | PDFs, imagens | DBUs |
| Azure Document Intelligence | 69,3 | Formulários estruturados, modelos prontos | Azure | PDFs, imagens | Por 1.000 páginas |
| AWS Textract | 53,3 | Stacks nativos da AWS e regulados | AWS | PDFs, imagens | Por 1.000 páginas |
| Unstructured | Não está no ParseBench | Ingestão aberta, muitos tipos de arquivo | API, código aberto | Mais de 25 tipos de arquivo | Por página / código aberto |
Uma observação rápida sobre como ler a tabela: uma pontuação menor no ParseBench não é automaticamente "pior para você". O Textract fica no fim neste benchmark geral, mas se você só precisa de texto limpo de PDFs padrão dentro de uma empresa AWS, continua sendo uma escolha perfeitamente sensata. Combine a ferramenta com o trabalho, não com o ranking.
1. LlamaParse
Melhor para: equipes que constroem um pipeline de RAG em código e já vivem no ecossistema do LlamaIndex.
O LlamaParse é o serviço de análise do LlamaIndex, o popular framework de código aberto para criar apps de LLM sobre seus próprios dados. Foi feito exatamente para o trabalho que o Parse mira: transformar PDFs complexos, apresentações e planilhas em Markdown limpo e pronto para fragmentação na recuperação. No ParseBench, a oferta Cost Effective marca 78,3, praticamente empatada com os 79,2 do Parse.
Recursos. O LlamaParse aceita PDFs, arquivos Office e imagens diretamente (sem etapa de conversão para imagem), oferece vários modos de análise que equilibram custo e profundidade e se encaixa direto em um pipeline de recuperação do LlamaIndex. Lida com tabelas, imagens incorporadas e layouts de várias colunas, e pode seguir instruções de análise em linguagem natural por documento.
Prós. Se você já escreve Python e usa o LlamaIndex, é a opção de menor atrito da lista. O suporte direto a PDF e Office poupa tempo real de engenharia, e os 10.000 créditos gratuitos mensais facilitam prototipar antes de gastar qualquer coisa.
Contras. É uma ferramenta para desenvolvedores, não um produto de apontar e clicar. O modelo de créditos exige um tempo para entender, já que modos de análise diferentes consomem números diferentes de créditos por página. E você continua montando as camadas de recuperação e resposta por conta própria.
Preços. O LlamaParse cobra em créditos: 1.000 créditos custam US$ 1,25, e a análise básica começa em 1 crédito por página (os modos Agentic, atentos ao layout, custam mais). O plano gratuito inclui 10.000 créditos por mês, e um Auto Mode direciona cada página para o nível mais barato que dê conta do trabalho.
Veredito: a escolha natural se você constrói RAG em código e quer uma análise que se encaixe no resto do seu stack. Se você ainda não está no mundo do LlamaIndex, a dependência do ecossistema é um motivo para procurar em outro lugar.
2. Mistral OCR
Melhor para: equipes que querem a experiência simples de API por página do Parse com outro fornecedor, e um caminho de hospedagem própria.
O Mistral OCR é a correspondência filosófica mais próxima do Cohere Parse: um modelo OCR dedicado e de alto throughput vendido como uma API limpa por página. A Mistral o posiciona como compreensão de documentos que devolve Markdown estruturado com tabelas e imagens preservadas, de um modelo que você também pode rodar por conta própria. No ParseBench, o Mistral OCR 4 marca 74,5, um degrau abaixo do Parse, mas ainda à frente da maioria das opções nativas de nuvem.
Recursos. Lida com imagens e PDFs diretamente, extrai tabelas e figuras incorporadas, suporta uma ampla gama de idiomas e devolve Markdown feito para indexação posterior. A Mistral também oferece implantação com hospedagem própria para equipes que precisam manter os documentos na própria infraestrutura.
Prós. Rápido e muito simples de integrar se você já chamou uma API no estilo OpenAI. A opção de hospedagem própria é um diferencial real frente ao endpoint só gerenciado do Parse, e a história de residência de dados europeia atrai equipes com necessidades de conformidade na UE.
Contras. Fica atrás do Parse e dos modelos de fronteira no ParseBench, principalmente em formatação semântica, e o modelo atual deixou de ser a pechincha que o original era. Nos documentos financeiros ou científicos mais densos, a lacuna de precisão pode aparecer como uma tabela quebrada de vez em quando.
Preços. O atual Mistral OCR 4 custa US$ 4 por 1.000 páginas, caindo para US$ 2 por 1.000 pela API em lote; a camada Document AI sem código custa US$ 5 por 1.000. Isso está acima da tarifa fixa de US$ 1,50 do Parse, então a troca custa um pouco mais por página.
Veredito: se você gostou da ideia do Parse mas quer uma segunda fonte, residência de dados na UE ou um caminho de hospedagem própria, o Mistral OCR é a troca mais direta. Só saiba que você troca alguns pontos de precisão e paga um pouco mais por página.
3. GPT-5.5
Melhor para: os documentos mais bagunçados e valiosos, em que a precisão importa mais que a conta por página.
Você nem precisa usar um analisador feito sob medida. Um modelo multimodal de fronteira como o GPT-5.5 consegue ler a imagem de uma página e devolver texto estruturado, e lidera toda a tabela do ParseBench com 84,4, mais de cinco pontos à frente do Parse. A própria Cohere admite que o Parse "só é superado pelos LLMs de fronteira", e o GPT-5.5 é um deles.
Recursos. Como modelo de uso geral, o GPT-5.5 não só transcreve; ele raciocina sobre uma página. Você pode pedir que extraia campos específicos, siga regras de formatação complexas ou lide com um layout que nunca viu, tudo em uma chamada. Lê imagens e, pela API, PDFs.
Prós. A melhor precisão do benchmark e flexibilidade incomparável. Se um documento tem um layout estranho em que um analisador de esquema fixo trava, um LLM muitas vezes simplesmente resolve. É também provavelmente o mesmo modelo que você já usa em outros lugares, então não há fornecedor novo.
Contras. Custo. Você paga por token, e uma página densa pode ter muitos tokens, então com milhões de páginas fica caro rápido comparado à tarifa fixa por página do Parse. Também é mais lento por página, e modelos gerais podem alucinar conteúdo, algo a que um modelo OCR específico é menos propenso.
Preços. Por token, cobrado em entrada e saída, então o custo escala com a complexidade da página em vez de um valor fixo por página. O atual carro-chefe da OpenAI, o GPT-5.6 Sol, custa US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de saída na tarifa promocional, com irmãos mais baratos (Luna a US$ 0,20 / US$ 1,20) para trabalhos mais leves. Uma página densa queima muitos tokens, então com milhões de páginas isso soma rápido.
Veredito: recorra ao GPT-5.5 quando os documentos forem de alto valor e baixo volume, ou quando os layouts forem variados demais para um analisador fixo. Para páginas previsíveis e de alto volume, a conta por token faz de um analisador dedicado como o Parse a compra mais inteligente.
4. Gemini 3.5 Flash
Melhor para: equipes que querem precisão de análise de nível fronteira sem o preço cheio de um modelo de fronteira.
O Gemini 3.5 Flash é o modelo multimodal rápido e barato do Google, e é o ponto ideal entre os dois extremos desta lista. Marca 81,8 no ParseBench, superando o Parse e todos os analisadores nativos de nuvem, sendo muito mais barato por token do que um carro-chefe como o GPT-5.5 ou o Opus 4.8.
Recursos. Como o GPT-5.5, é um modelo geral que lê imagens de página e PDFs e pode extrair dados estruturados sob instrução. O Flash é ajustado para velocidade e baixo custo, com uma janela de contexto grande que permite alimentá-lo com documentos longos de uma vez.
Prós. Uma combinação rara: precisão maior que a do Parse e a flexibilidade de um LLM, a um preço que continua razoável em escala. Se você já está no Google Cloud ou usa o Vertex AI, a integração é trivial.
Contras. Ainda é por token, portanto menos previsível que um analisador de tarifa fixa por página, e em volume realmente massivo os US$ 1,50 por 1.000 páginas do Parse ainda podem vencer no custo total. Como em qualquer LLM, você carrega um pequeno risco de alucinação que um modelo OCR específico não tem.
Preços. Por token, às tarifas baixas do Flash. O atual Gemini 3.7 Flash custa US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de saída no preço promocional, e há um nível realmente gratuito (com limite de uso) para prototipagem. É uma fração do custo por token de um modelo carro-chefe.
Veredito: minha recomendação padrão para equipes que querem mais precisão que o Parse mas recuam diante dos preços de um modelo carro-chefe. O Flash é a escolha de melhor custo-benefício do grupo de modelos de fronteira.
5. Databricks AI Parse
Melhor para: equipes de dados cujos documentos já vivem no lakehouse do Databricks.
O Databricks AI Parse (ai_parse_document) é análise de documentos embutida diretamente na plataforma Databricks, chamada como função SQL sobre dados que você já tem no lakehouse. Marca 72,4 no ParseBench. O argumento não é precisão máxima, é movimentação zero de dados.
Recursos. Você chama a análise inline em um fluxo de SQL ou notebook, e o texto extraído volta direto para suas tabelas Delta, pronto para a gestão de conhecimento e análises seguintes. Sem serviço separado e sem dados saindo da plataforma.
Prós. Se seu pipeline já está no Databricks, é o caminho de menor resistência: nenhum fornecedor novo, nenhuma saída de dados, e a governança cuidada pelo Unity Catalog. Para unificar a análise de documentos com o resto da sua engenharia de dados, nada é tão fluido.
Contras. Só faz sentido se você é uma empresa Databricks; montar a plataforma só para analisar documentos seria absurdo. E com 72,4 fica atrás do Parse e dos modelos de fronteira na qualidade geral de análise.
Preços. Cobrado em DBUs (Databricks Units) como parte da sua computação normal, em vez de uma tarifa pública por página. Confira a página de preços do Databricks e a tarifa do seu workspace.
Veredito: um sim fácil para equipes que já usam Databricks e valorizam manter os dados no lugar em vez de espremer os últimos pontos de precisão. Irrelevante para todos os demais.
6. Azure AI Document Intelligence
Melhor para: equipes no Azure que precisam de extração estruturada de formulários, faturas e documentos de identidade com modelos prontos.
O Azure AI Document Intelligence (antes Form Recognizer) é o maduro serviço de processamento de documentos da Microsoft. Marca 69,3 no ParseBench, mas essa pontuação geral subestima seu ponto forte real: modelos prontos que extraem campos estruturados de tipos específicos de documento, faturas, recibos, formulários fiscais e documentos de identidade, sem você treinar nada.
Recursos. Além do OCR de texto simples (o modelo Read), traz extratores prontos para documentos comerciais comuns e um fluxo de modelos personalizados para treinar o seu com um punhado de amostras. Aceita PDFs e imagens diretamente e devolve JSON estruturado com pontuações de confiança por campo, algo que o endpoint ao vivo do Parse não emite atualmente.
Prós. Para formulários estruturados, está um nível acima da análise genérica: não só lê a fatura, mas informa o total, o fornecedor e a data de vencimento como campos rotulados com confiança. A integração profunda com o Azure e a conformidade empresarial facilitam a venda em empresas Microsoft.
Contras. Foca mais a extração de campos de formulário do que Markdown limpo para RAG, então na conversão geral de documento em texto fica atrás dos analisadores mais novos. As pontuações de confiança e os modelos prontos trazem configuração extra de que você não precisa se só quer texto.
Preços. Por 1.000 páginas, conforme o tipo de modelo: o modelo Read OCR custa US$ 1,50 por 1.000 páginas (igual ao Parse), enquanto os modelos prontos custam US$ 10 e a extração personalizada US$ 30 por 1.000. Um nível gratuito F0 cobre 500 páginas por mês.
Veredito: a melhor escolha quando seu problema real é a extração estruturada de formulários conhecidos, não análise geral, e você já está no Azure. Para Markdown limpo que alimente um índice de RAG, um analisador mais novo se encaixa melhor.
7. AWS Textract
Melhor para: equipes nativas da AWS e stacks regulados que querem OCR de documentos dentro da nuvem que já usam.
O AWS Textract é o antigo serviço de OCR e análise de documentos da Amazon. Fica no fim da tabela geral do ParseBench com 53,3, e a Cohere relata uma "melhoria de mais de 20 pontos" em relação a ele, então ninguém escolhe o Textract pela qualidade de ponta do Markdown. As pessoas o escolhem porque já está na conta AWS delas.
Recursos. O Textract detecta texto, tabelas e pares chave-valor de formulários, além de APIs especializadas para despesas e documentos de identidade. Aceita PDFs e imagens, integra-se nativamente com S3, Lambda e o resto da AWS, e herda as certificações de conformidade da AWS de fábrica.
Prós. Para uma empresa AWS, a história de integração e governança é imbatível: nenhum fornecedor novo, nenhuma saída de dados, IAM e logs de auditoria em que você já confia. É testado em escala empresarial e sua extração de tabelas e formulários em documentos padrão limpos é confiável.
Contras. No benchmark moderno fica bem atrás do restante, principalmente em formatação semântica (2,8 ali). É um motor de OCR de geração anterior, não um modelo de visão e linguagem, então em layouts bagunçados ou incomuns sofre onde as ferramentas mais novas se saem bem.
Preços. Por 1.000 páginas, com preço separado por API: o Detect Text simples custa US$ 1,50 por 1.000 páginas, enquanto o Analyze Document salta para US$ 15 para tabelas e US$ 50 para formulários, então extrair campos estruturados fica caro rápido. Contas novas têm um nível gratuito de três meses.
Veredito: a escolha segura, sem graça e correta para equipes nativas da AWS que analisam documentos padrão e valorizam ficar na nuvem mais do que pontuações de benchmark. Se a qualidade de análise em layouts difíceis é seu gargalo, olhe mais acima nesta lista.
8. Unstructured
Melhor para: equipes que precisam ingerir uma ampla variedade de tipos de arquivo em um único pipeline limpo, com opção de código aberto.
O Unstructured é menos um modelo OCR único e mais uma camada completa de ingestão: pega mais de 25 tipos de arquivo (PDF, Word, PowerPoint, HTML, e-mail, imagens) e os normaliza em JSON limpo e fragmentado, pronto para embeddings. Não está no ParseBench porque desempenha um papel um pouco diferente, a tubulação que leva tudo ao seu armazenamento vetorial, não só PDFs.
Recursos. Conectores para dezenas de fontes, enorme variedade de formatos de entrada, fragmentação atenta ao layout e uma conhecida biblioteca de código aberto ao lado da API gerenciada. É um padrão comum em stacks de RAG caseiros justamente por tratar a longa cauda de tipos de arquivo que os analisadores de propósito único ignoram, o que importa se sua gestão de conhecimento está espalhada por uma dúzia de apps.
Prós. Abrangência. Se seu conhecimento está em PDFs, exportações do Confluence, e-mails e apresentações, o Unstructured trata tudo em um só pipeline. O núcleo de código aberto permite começar de graça e hospedar por conta própria.
Contras. Sua qualidade de OCR bruta em documentos complexos não é a melhor da categoria, então muitas equipes o combinam com um analisador mais forte para os PDFs difíceis. E rodar a versão de código aberto em escala é trabalho de engenharia de verdade, não uma comodidade gerenciada.
Preços. A biblioteca de código aberto é gratuita para hospedar; a Unstructured Platform gerenciada é cobrada por página. Confira o site deles para os preços atuais da API.
Veredito: a melhor escolha quando seu problema é a variedade de formatos, não a precisão bruta de análise em um único tipo. Muitas equipes usam o Unstructured pela abrangência e um modelo como o Parse ou o Gemini para os documentos complicados.
Uma nota sobre analisadores de pesos abertos
Se o controle dos dados é o seu motor, o canto que mais rápido avança neste espaço são os modelos OCR de pesos abertos que você mesmo hospeda: coisas como dots.ocr, Chandra OCR 2 e DeepSeek-OCR 2 aparecem todos no ParseBench (o Chandra OCR 2 marca um respeitável 77,7). O dots.ocr vem com licença MIT e roda localmente via vLLM, então a troca é direta: nenhuma tarifa por página, nunca, e controle total sobre onde os documentos são processados, em troca de ser dono das GPUs e da operação. Para um ambiente isolado ou muito regulado, essa troca costuma valer a pena. Para todos os outros, uma API gerenciada dá menos trabalho.
O que toda ferramenta desta lista deixa para você construir
Esta é a parte fácil de perder ao comparar analisadores. Toda opção acima, o Parse incluído, faz um só trabalho: transforma documentos em texto limpo. Esse texto não é uma resposta. Para realmente usar seus documentos, você ainda precisa fragmentar e gerar embeddings do texto, armazená-lo, recuperar a passagem certa para uma dada pergunta e gerar uma resposta fundamentada por cima.
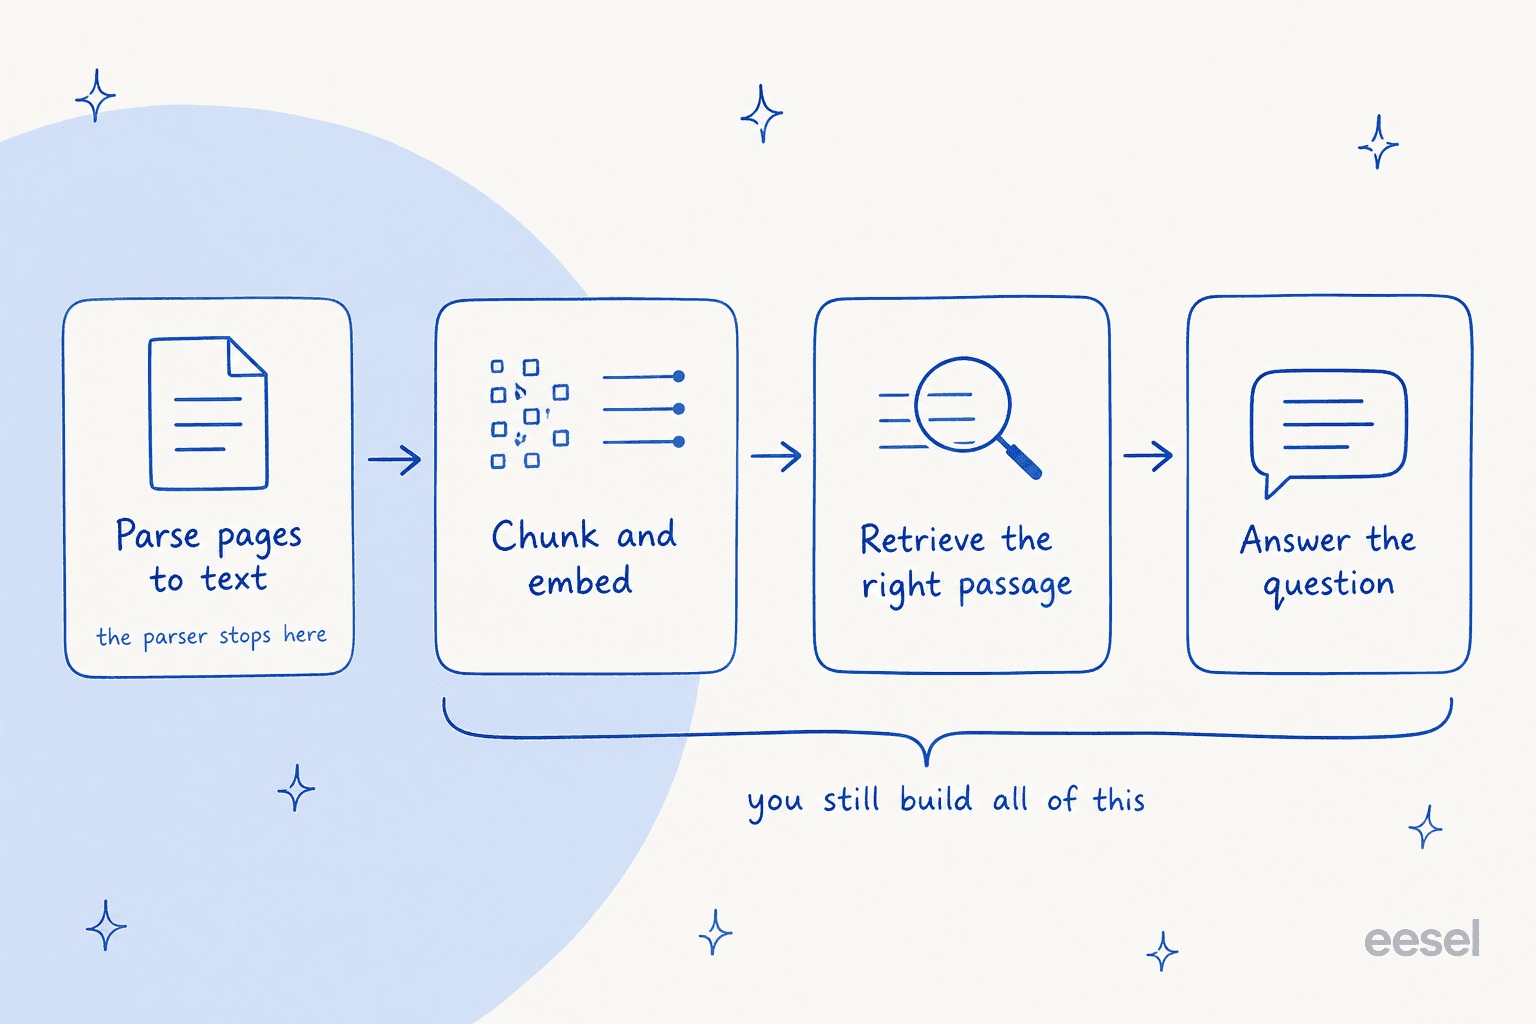
Se você é uma equipe de dados construindo um produto personalizado, conectar essas quatro etapas é exatamente o trabalho que você escolheu, e escolher o analisador certo desta lista é uma decisão real. Mas muitas das pessoas que pesquisam "alternativas ao Cohere Parse" não estão construindo um pipeline de análise por si só. Querem o resultado: respostas a perguntas de clientes ou funcionários, extraídas dos próprios documentos. Para elas, escolher um modelo OCR é um meio para um fim que está três passos adiante na cadeia.
Experimente a eesel
É essa a lacuna que a eesel preenche. A eesel é uma plataforma de colegas de equipe de IA: em vez de um kit de ferramentas que você monta, você contrata um colega pronto para trabalhar numa função específica. O agente de IA para helpdesk é o relevante aqui, e como agente de IA para atendimento ao cliente ele ingere sua central de ajuda, documentos internos e tickets anteriores, cuida da análise, dos embeddings e da recuperação por você, e então realmente responde às perguntas, ao vivo no seu helpdesk.

Então o enquadramento honesto é este: se você está construindo um pipeline de documentos e precisa de um analisador como um componente, escolha entre os oito acima. Se seu objetivo real é responder perguntas a partir do seu conhecimento, você não precisa escolher um modelo OCR, precisa da camada que fica por cima. A eesel é gratuita para testar, conecta em minutos, e você pode apontá-la para seus documentos atuais e vê-la responder antes de se comprometer com qualquer coisa. (Há também um colega de redação de blog com IA no time, para um trabalho bem diferente.)