

O que é o Microsoft-Decision-1?
O Microsoft-Decision-1 é um modelo de pontuação de decisões. Você entrega a ele um texto (a Microsoft e o OpenRouter o chamam de state) e uma ou mais perguntas com um conjunto fixo de respostas. Ele devolve uma probabilidade para cada resposta. Essa é toda a interface.
A Microsoft o anunciou em 9 de outubro de 2026 em uma publicação no blog Command Line, escrita por Achint Srivastava, VP de Engenharia de Software no Office of the CTO. A publicação diz que ele foi criado para «roteamento, classificação, priorização, verificação e controle de fluxos de trabalho» (Microsoft). Satya Nadella postou o lançamento no mesmo dia, dizendo que a Microsoft já o está testando internamente em resposta a incidentes, controle de qualidade e descoberta científica (Satya Nadella no X).
Se a categoria é nova para você, meu explicativo sobre modelos de decisão cobre o contexto. A versão curta: o TypeSafe Jev iniciou a categoria em setembro de 2026, Cloudflare, AWS e OpenAI vieram em poucas semanas, e o Microsoft-Decision-1 é a primeira entrada de um hiperescalar que vende o modelo na própria nuvem.
O que ele não é importa tanto quanto o que é. A ficha do modelo da Microsoft diz que ele «não foi projetado para geração de texto, resposta aberta a perguntas, conversação, tradução ou resumo» (catálogo do Foundry). Ele não consegue escrever uma resposta, um resumo ou uma linha de código. Ele escolhe.
Como funciona o Microsoft-Decision-1?
Passo meus dias construindo o lado de agentes da eesel, então esta foi a parte que procurei primeiro. A mecânica é mais simples do que a publicação de lançamento faz parecer.
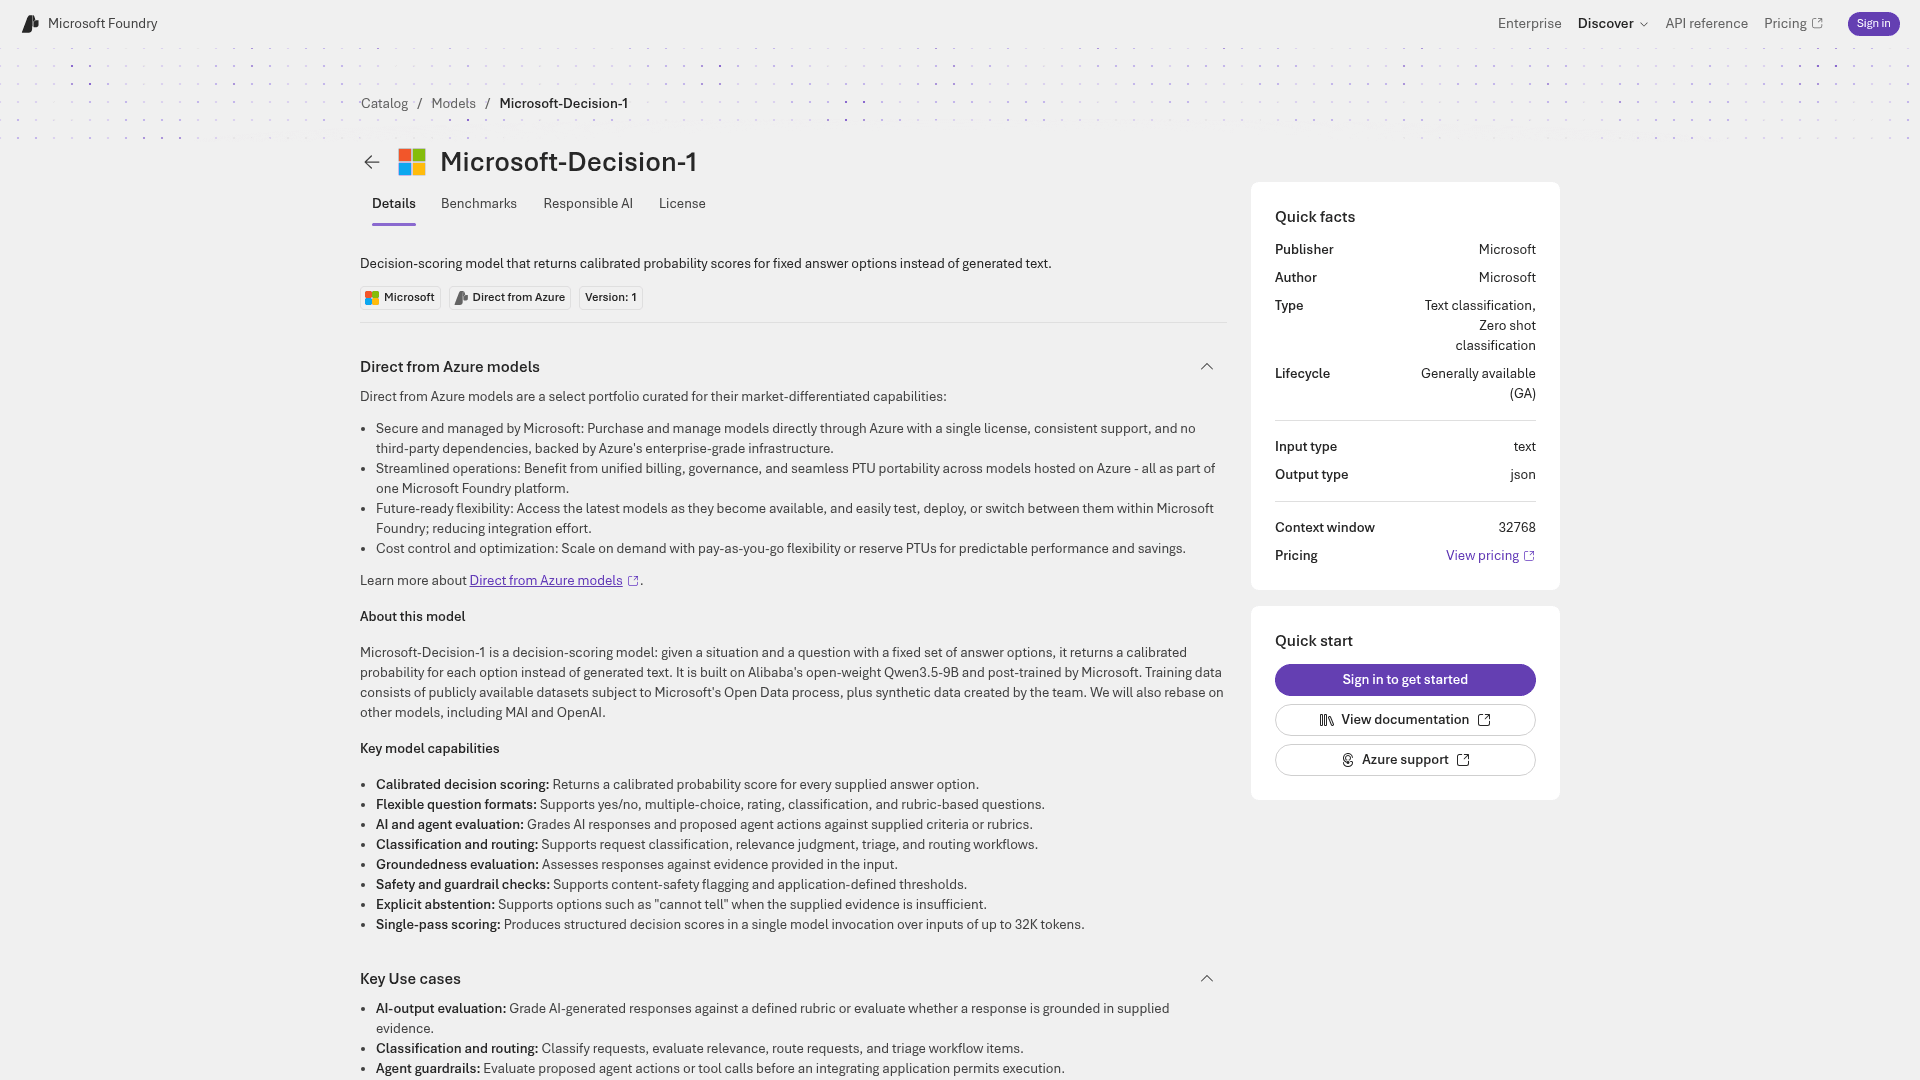
A Microsoft pegou o Qwen3.5-9B, de pesos abertos, da Alibaba e o pós-treinou «para pontuação de decisões rápida, em uma única passagem», e diz que «em breve o migrará para outros modelos, incluindo Microsoft AI (MAI) e OpenAI» (Microsoft). Os dados de treinamento são «conjuntos de dados publicamente disponíveis sujeitos ao processo Open Data da Microsoft, mais dados sintéticos criados pela equipe» (catálogo do Foundry). A base Qwen é a mesma família por trás do Clef-flash da Cloudflare e do Strands Decider da AWS.
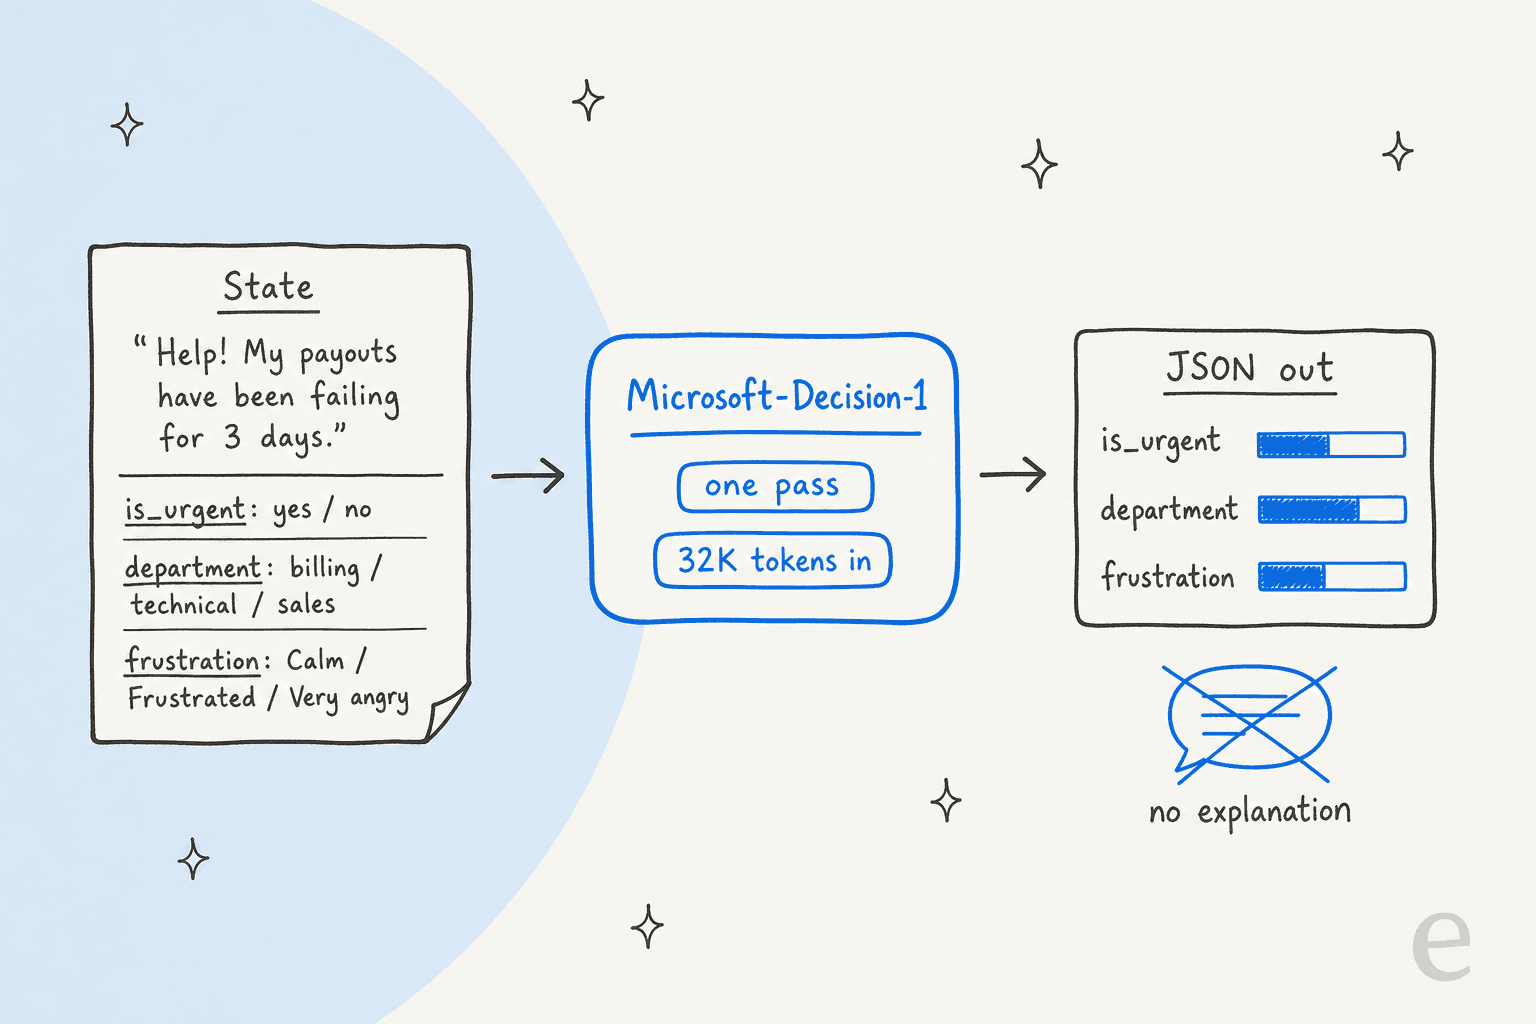
Em termos simples, três coisas acontecem em uma chamada:
- Ele lê o estado e cada pergunta uma vez. Até 32.768 tokens de texto entram. A Microsoft chama isso de «pontuação em passagem única» (catálogo do Foundry).
- Ele pontua cada resposta permitida. Em vez de escrever «billing» letra por letra, ele atribui uma probabilidade a billing, technical e sales ao mesmo tempo.
- Ele devolve JSON e para. Não há justificativa. A ficha diz claramente que o modelo «não gera explicações nem justificativas».
Os tipos de pergunta correspondem ao que os usuários do Jev já conhecem. No OpenRouter, uma requisição pode levar várias perguntas nomeadas sobre o mesmo estado (OpenRouter):
| Tipo de pergunta | O que pergunta | O que volta | Exemplo de suporte |
|---|---|---|---|
noul | Isto é verdade? | Uma probabilidade de 0 (não) a 1 (sim) | «Esta mensagem transmite urgência?» |
choice | Qual opção se encaixa? | A escolha mais uma probabilidade por opção | «Cobrança, técnico ou vendas?» |
score | Onde nesta escala? | Uma posição em uma rubrica ordenada | «Calmo, Frustrado ou Muito bravo?» |
O catálogo da Microsoft lista alguns extras: avaliação baseada em rubricas de respostas de IA e ações de agentes, verificações de fundamentação contra evidências fornecidas, verificações de segurança e «abstenção explícita», ou seja, uma opção como «não é possível dizer» quando a evidência é fraca (catálogo do Foundry). Esse último é subestimado. Um modelo que consegue dizer «não há o bastante aqui para decidir» é muito mais fácil de colocar diante de uma fila real.
Aqui está a requisição de exemplo do OpenRouter, levemente enxuta. É um ticket de suporte, o que mostra quem a Microsoft e o OpenRouter acham que serão os primeiros compradores:
const decision = await openrouter.alpha.decisions.create({
  decisionsRequest: {
    model: "microsoft/microsoft-decision-1",
    state: "Help! My payouts have been failing for 3 days.",
    questions: {
      is_urgent: {
        type: "noul",
        instructions: "Does this message convey urgency?",
        criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" }
      },
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Payments, invoicing, refunds",
          technical: "Bugs, outages, integrations",
          sales: "Pricing, upgrades, new accounts"
        }
      },
      frustration: {
        type: "score",
        instructions: "How frustrated is the customer?",
        criteria: ["Calm", "Frustrated", "Very angry"]
      }
    }
  }
});
Seu código então lê as respostas e decide o que fazer, por exemplo escalar quando is_urgent estiver acima de 0,8 e o departamento for cobrança. Essa lógica de limiares é o ponto central. Compare com o modo JSON de um LLM geral, em que você paga cada token de saída e ainda recebe um rótulo sem uma confiança honesta associada.
Como acessar o Microsoft-Decision-1?
Há duas portas, e elas se comportam de modo diferente.
Microsoft Foundry, «Direct from Azure». O catálogo lista o Microsoft-Decision-1 como Versão 1 com ciclo de vida «Generally available (GA)», texto de entrada, JSON de saída e janela de contexto de 32.768 tokens (catálogo do Foundry). A documentação do Microsoft Learn o coloca entre os modelos vendidos diretamente pelo Azure, que «são cobrados pela sua assinatura do Azure, cobertos pelos acordos de nível de serviço do Azure e têm suporte da Microsoft» (Microsoft Learn). Se você já compra modelos do Azure OpenAI, este é o caminho de compras conhecido.
A Decisions API do OpenRouter. Não é preciso conta no Azure. O ID do modelo é microsoft/microsoft-decision-1, ele roda em POST https://openrouter.ai/api/alpha/decisions, e o OpenRouter avisa que «os SDKs de chat completions não funcionarão com ele» (OpenRouter). O Azure é o único provedor por trás, então toda requisição ainda cai na infraestrutura da Microsoft.
| Microsoft Foundry | OpenRouter | |
|---|---|---|
| Status | GA, Versão 1 | No ar desde 9 de outubro de 2026 |
| Conta | Assinatura do Azure | Chave do OpenRouter |
| Cobrança | Sua fatura do Azure | Créditos do OpenRouter |
| SLA | Aplicam-se os SLAs do Azure | Não é um SLA do Azure |
| Formato da requisição | Ainda não documentado publicamente | Decisions API documentada |
| Atualizações do modelo | Versão 1 no catálogo | «Os pesos são atualizados continuamente enquanto o formato da API permanece o mesmo» |
| Velocidade medida | 85 ms p50, teste da própria Microsoft | 0,19 s p50 do melhor provedor, medição do OpenRouter |
Duas linhas dessa tabela mudariam como eu o colocaria em produção. Primeiro, o Foundry é o lar mais seguro para produção, mas o formato da requisição ainda não é público. Um usuário do Hacker News que o implantou no primeiro dia escreveu:
«Talvez eu só não esteja olhando no lugar certo, mas não consigo achar como é o formato da API. Até implantei este modelo pelo Foundry e ele não diz o que enviar nem o que esperar de volta.»

Quando verifiquei em 11 de outubro, ainda não havia uma página de instruções no Learn para o modelo. Segundo, a observação do OpenRouter de que os pesos são atualizados continuamente significa que um limiar que você ajustou no mês passado pode derivar sem aviso. Se você roteia com confidence > 0.9, reverifique depois das atualizações.
O que os benchmarks da Microsoft afirmam?
A publicação de lançamento da Microsoft abre com uma comparação de 36 benchmarks que cobre 147.137 perguntas «mantidas cegas em relação ao treinamento» (Microsoft). Eis o núcleo da tabela que ela publicou:
| Modelo | Precisão média | Latência mediana | Calibração (100 = perfeita) |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85 ms p50, 125 ms p95 | 92,2 |
| Jev 1.13.0 | 82,3% | 240 ms | 93.7 |
| Quyet-1.0-Large | 81,9% | 380 ms | 93,1 |
| GPT-6 Luna Decisions | 79,4% | 300 ms | 89,9 |
| H2O-Lightning-4B v1.1 | 77,2% | 210 ms | 91,8 |
| Strands-Decider 2B (23 de 36 benchmarks) | 54,8% | Não medida | Sem pontuação |
| GPT-6 Sol (referência) | Sem classificação | 3,01 s | Sem pontuação |
Fonte: anúncio da Microsoft. A Microsoft também informa que o modelo muda sua resposta em 1,3% das perturbações em média, com zero trocas quando as opções são parafraseadas, invertidas ou embaralhadas. Os testes de segurança cobriram 5.250 requisições em 11 benchmarks.
Leia as notas de rodapé antes de citar esses números. A latência de cada concorrente vem da mediana ajustada do JevBench v1.6.1, verificada em 7 de outubro. Os 85 ms do Microsoft-Decision-1 foram «medidos pelo Foundry na mesma região». Não é a mesma corrida. E a Microsoft fica em terceiro em calibração, 1,5 ponto atrás do Jev, o que importa mais do que a vantagem em precisão se você pretende agir automaticamente acima de um limiar de confiança.
O Jev não estava na tabela no início. A resposta mais curtida sob a publicação de lançamento de Nadella, com 335 curtidas, dizia:
«Como o Jev não está classificado? Esse é literalmente o modelo nº 1 com o qual as pessoas vão comparar isto.»
O anúncio agora traz uma nota do editor dizendo que ele «foi atualizado em relação ao original para acrescentar benchmarks do Jev em precisão e calibração». Mérito para a Microsoft por corrigir rápido. Minha análise do Jev traz mais sobre o modelo com o qual ele é comparado.
Os resultados internos são mais magros, mas interessantes. A Microsoft diz que sua equipe do Copilot o achou «competitivo com o GPT5.6 Luna e 100 vezes mais rápido», e que sua equipe de XBOX Research passou mais de 10.000 itens de feedback por ele a «mais de 14 vezes mais rápido e 200 vezes mais barato» que o GPT-6 Sol (Microsoft). São equipes da Microsoft avaliando o modelo da Microsoft, então eu os trataria como sinais de casos de uso, não como prova.
O que foi medido de forma independente?
Ainda não muita coisa, o que é normal dois dias após o lançamento. Isto é tudo que consegui verificar fora da Microsoft.
O OpenRouter publica sua própria latência para cada modelo que serve. Ao longo de três dias, mediu um p50 do melhor provedor de 0,19 segundo, um p50 médio de 0,27 segundo e um p99 de 0,67 segundo, com 99,90% de disponibilidade (OpenRouter).
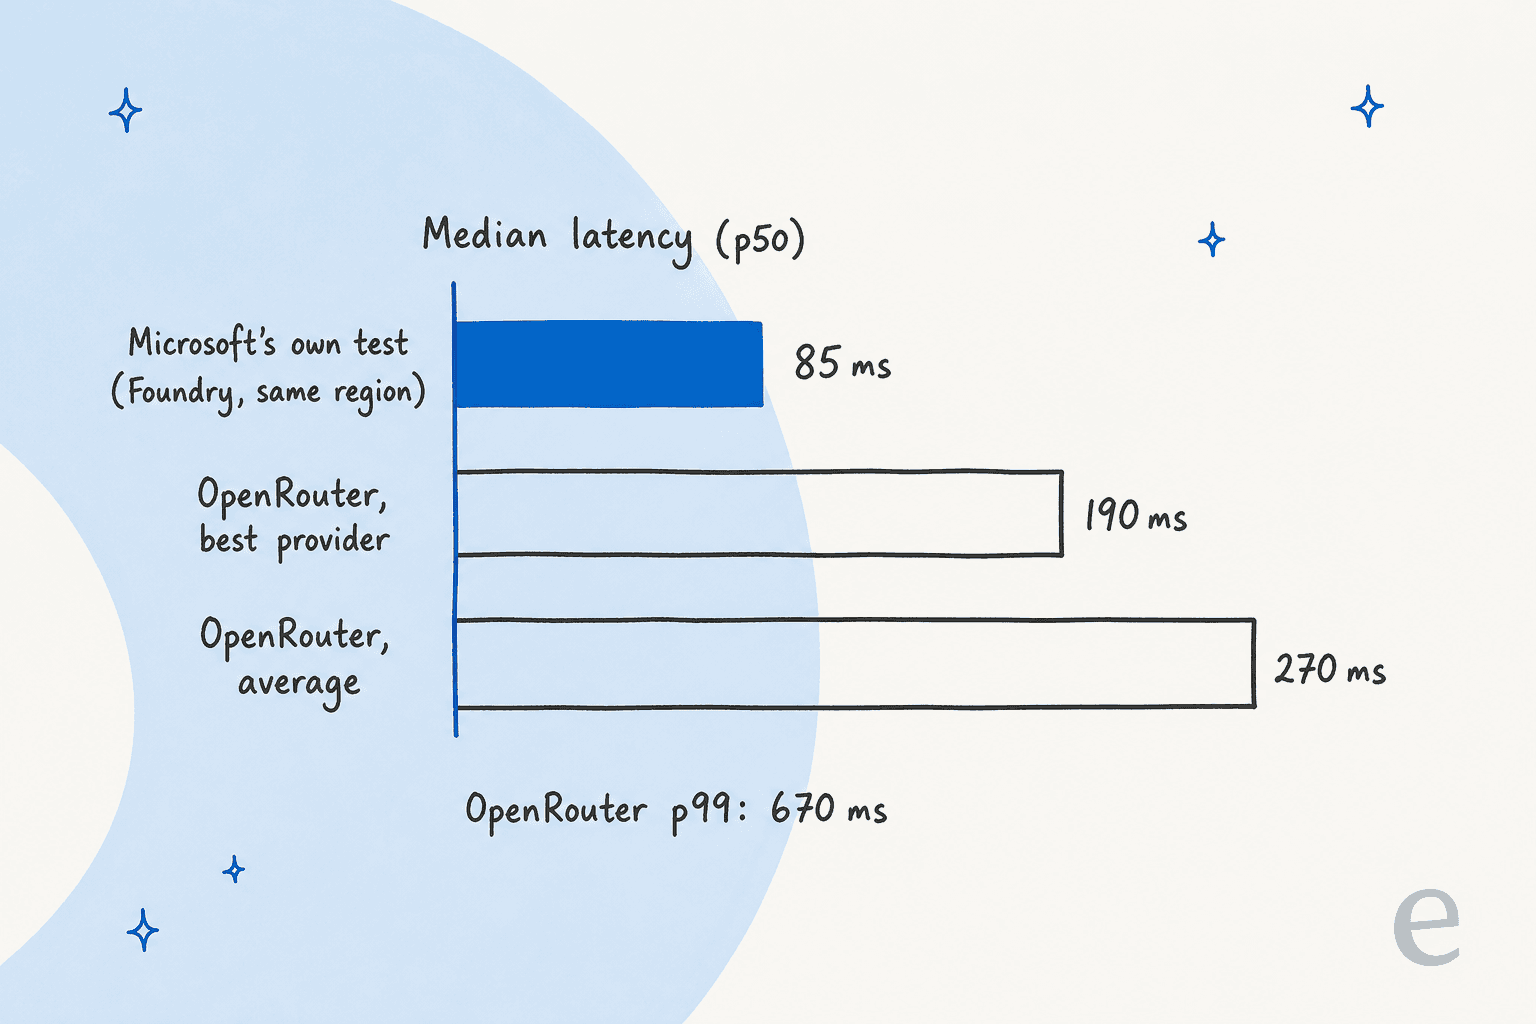
Essa diferença não significa que o número da Microsoft esteja errado. Ele é medido ao lado do modelo, enquanto o do OpenRouter inclui um salto por um roteador. Mas se você o chama pela internet pública, conte com cerca de 200 a 300 ms, não 85. Para uma única chamada de roteamento em um ticket, ainda é instantâneo. Para um agente que encadeia 20 decisões, vale a conta da própria Microsoft: «acrescentar apenas 100 milissegundos a cada uma de 20 decisões sequenciais soma dois segundos ao fluxo de trabalho inteiro».
A única comparação prática que encontrei veio de um comentarista do Hacker News que o executou contra o Jev:
«Na minha suíte mínima ele foi mais barato (por 0,72x), mas com latência maior (283 ms contra 369 ms p50) que o Jev. Os resultados foram muito comparáveis em todos os cenários que meço, o primeiro destes que testei que realmente justifica sua existência como lançamento comercial.»
É a pequena suíte de uma pessoa, mas combina com o formato da história: respostas mais ou menos no nível do Jev, a um preço no nível do Jev.
O que falta: o Jev Decision Index, mantido pela comunidade, foi atualizado para a v0.3.1 em 10 de outubro com 117 entradas, e o Microsoft-Decision-1 não está entre elas. O Jev está em 60,11 na nova pontuação Full desse ranking, então há uma barra clara esperando. O uso também é inicial. Os rankings de decisões do OpenRouter desta semana mostram o Jev 1.13 com 999M de requisições, o GPT-6 Luna Decisions com 11,7M e o Microsoft-Decision-1 fora do top 10.
Quais são os limites e as incógnitas?
Esta é a seção que eu leria duas vezes antes de colocá-lo em produção. Alguns pontos são escolhas deliberadas de escopo e outros são apenas lacunas da documentação da semana de lançamento.
- Sem explicações. Ele devolve pontuações, nunca motivos. Se um líder de suporte perguntar «por que isto foi para cobrança?», o modelo não consegue dizer.
- Apenas texto, contexto de 32K. Sem imagens ou capturas de tela, ao contrário do Clef ou da Decisions API da OpenAI. Uma longa thread de e-mail com histórico citado pode atingir o limite.
- Sem pesos abertos. A URL do Hugging Face retorna 404, então hospedagem própria e ajuste fino não são opções.
- Sem regiões, limites de taxa ou cotas publicados. Ele não aparece na página de disponibilidade regional do Azure, e a aba de licença do catálogo não era exibida para visitantes sem login, então não consegui ler os termos de licença.
- Ainda não está na tabela de preços do Azure. A tarifa de US$ 0,042 está no anúncio e no OpenRouter, mas a página de preços do Foundry Models não tem uma linha para ele. Detalhei o que isso significa na minha publicação sobre os preços do Microsoft-Decision-1.
- Usos fora de escopo. A Microsoft diz que ele «não deve ser usado como única base para decisões envolvendo crédito, emprego, moradia, seguros, educação, saúde, direitos legais» (catálogo do Foundry).
O primeiro ponto rendeu o comentário mais afiado na thread do HN, que chegou a 195 pontos e 65 comentários:
«Usar a saída de um modelo de "decisão" sem visibilidade do raciocínio por trás de uma decisão parece muita confiança.»
Concordo, com uma ressalva. Você não precisa que o modelo se explique se registrar o que ele viu, o que escolheu e com que confiança, e enviar os casos de baixa confiança a uma pessoa. É a mesma disciplina que eu aplicaria para impedir alucinações de IA em um bot de suporte: testar com histórico real, colocar travas nas decisões arriscadas, manter um rastro.
Como o Microsoft-Decision-1 se compara ao Jev, ao Clef e aos demais?
O Microsoft-Decision-1 chega a um campo cheio. A versão rápida de quem é quem, verificada em 11 de outubro de 2026:
| Modelo | Criador | Preço de entrada por 1M | Contexto | Entradas | Pesos abertos | Onde rodar | Jev Decision Index v0.3.1 |
|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 | Microsoft | US$ 0,042, saída gratuita | 32.768 | Texto | Não | Foundry, OpenRouter | Não listado |
| Jev 1.13 | TypeSafe | US$ 0,042, saída gratuita | 64K por requisição | Texto | Não | API da TypeSafe, Workers AI, OpenRouter | 60,11 (2º empatado) |
| Clef | Cloudflare | US$ 0,24 | 65.536 | Texto, JSON, imagens, vídeo | Sim, Apache 2.0 | Workers AI | 53,08 (19º) |
| Clef-flash | Cloudflare | US$ 0,038 | 24.576 | Texto, JSON, imagens, vídeo | Sim, Apache 2.0 | Workers AI | 47,61 (33º) |
| OpenAI Decisions API | OpenAI | US$ 0,10, saída gratuita | 1.050.000 do GPT-6 Luna | Texto, imagens | Não | API da OpenAI, beta pública | Não listado |
| Strands Decider 2B | AWS Strands Labs | Grátis para hospedar | Executado com 3.072 a 4.096 | Texto | Sim, Apache 2.0 | Seu próprio hardware | 21,75 (84º) |
Fontes: a documentação de cada fornecedor (por exemplo, a página do Clef da Cloudflare e o guia de Decisions da OpenAI) e os dados do Decision Index de 10 de outubro.
Algumas coisas chamam a atenção. A Microsoft igualou exatamente o preço do Jev, e só o Clef-flash é mais barato por token. O Clef e a API da OpenAI aceitam imagens, o que a Microsoft não faz. E a OpenAI chama seu tipo sim/não de predicate em vez de noul, então migrar entre eles não é uma simples troca de URL. Cobri os custos dessa API no meu detalhamento dos preços da Decisions API.
A comparação de preços na própria publicação da Microsoft gerou críticas. O gráfico de custos da Microsoft coloca o Microsoft-Decision-1 em cerca de US$ 11 por milhão de textos classificados contra cerca de US$ 2.434 do GPT-6 Sol. Um comentarista do HN apontou o que falta:
«A Microsoft só compara o preço do seu com o GPT Sol(!), não com o GPT Terra nem com o GPT Luna (em que se baseia o imitador do Jev da OpenAI), e certamente não com o Jev (4/10 do custo do Luna).»
Ponto justo. Frente a um modelo geral como o GPT-6 Luna, qualquer modelo de decisão parece barato. Frente aos seus verdadeiros pares, o Microsoft-Decision-1 tem preço igual, não menor. Se você está pesando todo o campo, meu levantamento de alternativas ao Jev vai modelo por modelo.
O Microsoft-Decision-1 é a escolha certa para o seu trabalho?
Escolha a situação mais próxima da sua.
Se a velocidade pura é o seu principal critério, meu texto sobre o Jev Ultrafast cobre o nível de baixa latência da TypeSafe, o rival mais próximo da promessa de velocidade da Microsoft.
O que o Microsoft-Decision-1 significa para equipes de suporte?
Suporte é o caso de uso que todos procuram primeiro, e com razão. A triagem de tickets é um monte de perguntas pequenas e delimitadas com respostas fixas. A classificação de intenção é uma pergunta choice. Urgência e análise de sentimento são pontuações em uma escala fixa. «Um humano deveria ver isto?» é um sim/não, o coração da escalação por IA. O Microsoft-Decision-1 responde tudo isso em uma chamada por uma fração de centavo.
Eis o que eu gostaria que todo líder de suporte soubesse antes de se empolgar: ordenar é a parte que já funciona bem.
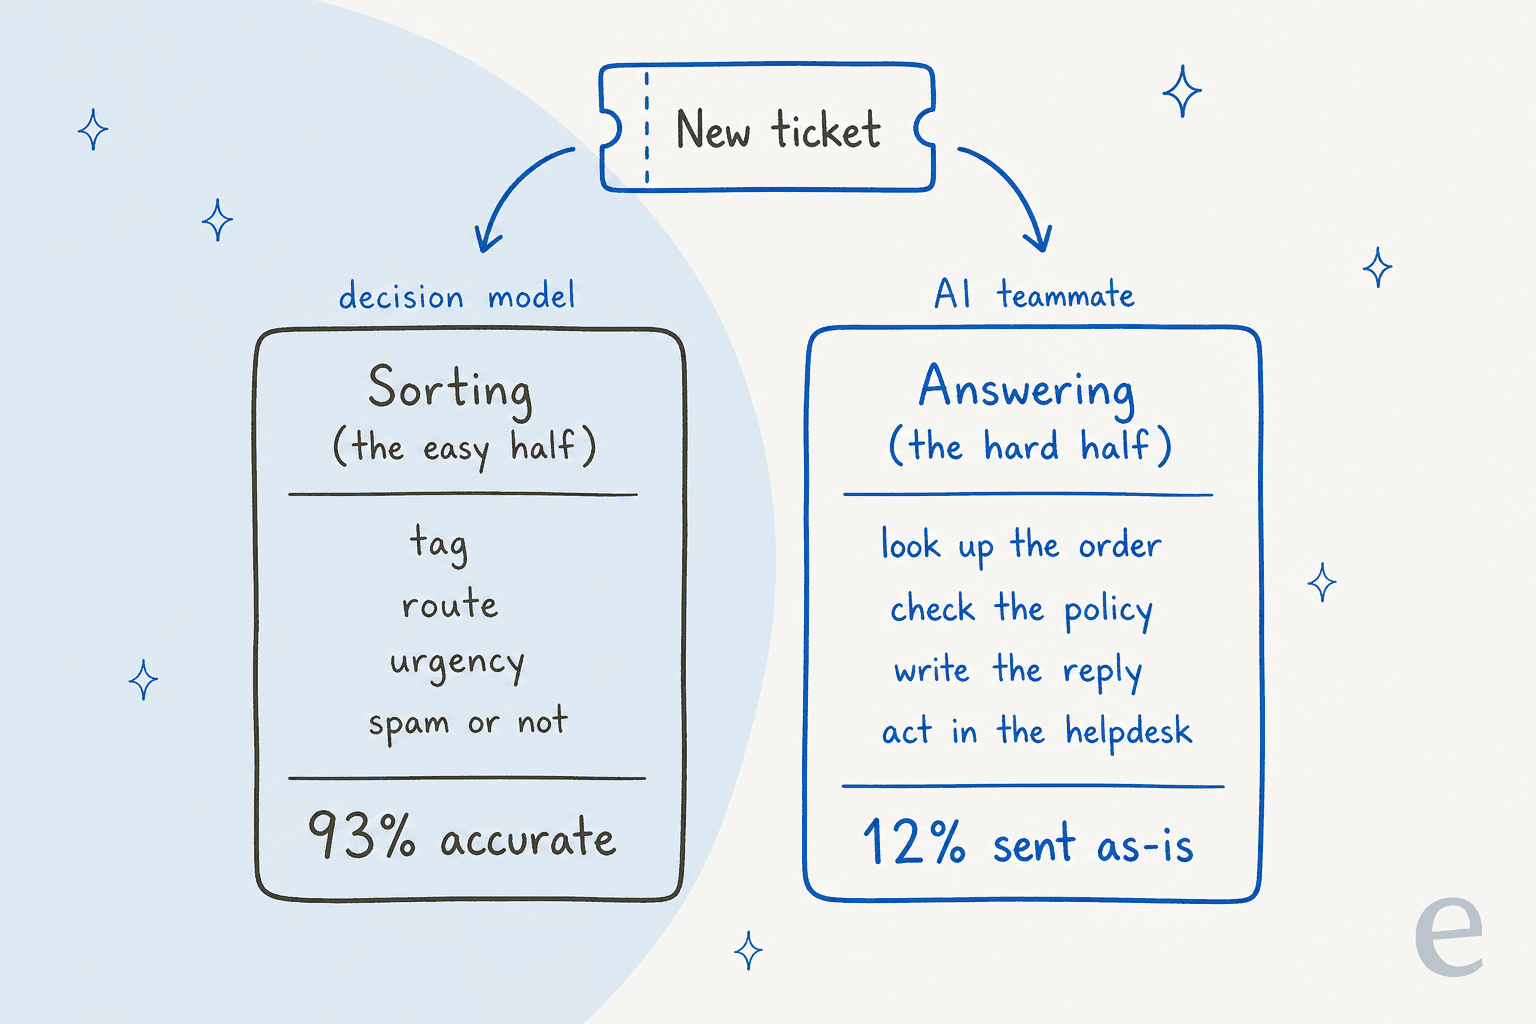
Esses números vêm de um teste com validação cruzada que vi, com tráfego real do Zendesk em uma empresa de e-commerce. A triagem por IA teve 93% de precisão e pegou 100% do spam, que era 22% da caixa de entrada, com zero falsos positivos. As respostas redigidas apontavam na direção certa 88% das vezes. Mas apenas 12% saíram sem edição, e 7% continham um erro factual. O rótulo foi fácil. A resposta era o trabalho.
Isso combina com o que os compradores da eesel dizem querer. Uma líder de CX com 7.000 tickets por mês disse assim em uma ligação:
«A IA nunca vai conseguir responder 100% das perguntas, mas se ela tentar e só responder "desculpe, não sei isso", eu não consigo ir conferir todos os meus 7.000 tickets para ver se a IA realmente deu uma boa resposta.»
O que elas pedem é primeiro uma decisão confiante (esse é um que eu consigo resolver?) e depois uma ação. Um modelo de decisão entrega a primeira parte como um número. Transformar esse número em uma etiqueta no Zendesk, uma reatribuição, um reembolso retido para aprovação e uma resposta na voz da sua marca é tudo o que cerca o modelo. Por isso eu trataria o Microsoft-Decision-1 como um componente para equipes que constroem o próprio roteamento de tickets com IA, não como uma ferramenta de suporte por si só.
Se você mesmo for construir, uma ordem sensata é:
- Comece pelas perguntas que seus triadores já respondem. Equipe, urgência, spam, nível de priorização de tickets. Escreva-as como perguntas
choiceescorecom os mesmos rótulos que seu helpdesk usa. - Reproduza um mês de tickets antigos. Compare as escolhas do modelo com o que sua equipe realmente fez, por rótulo, não como uma única média.
- Defina um limiar por pergunta. Roteie automaticamente acima dele, envie a uma pessoa abaixo, e registre ambos.
- Mantenha regras simples onde funcionam. Se «reembolso» no assunto sempre significa cobrança, as regras de roteamento do Zendesk são gratuitas e nunca derivam.
- Decida quem escreve a resposta. É a parte que um modelo de decisão não faz, e a que seus clientes de fato veem.
Para uma visão mais ampla das opções, meu levantamento de ferramentas de triagem com IA compara o que vem embutido em cada helpdesk hoje, e o guia para automatizar a triagem de tickets percorre a configuração de ponta a ponta.
Experimente a eesel para triagem de tickets e respostas
O Microsoft-Decision-1 é infraestrutura: um jeito rápido e barato de o seu código tomar uma decisão. A eesel é a funcionária que toma a decisão e depois faz o trabalho. O colega de helpdesk com IA entra na sua fila existente pela integração com o Zendesk, Freshdesk ou Gorgias. Ele etiqueta, encaminha e escala, depois escreve a resposta a partir da sua central de ajuda e de tickets antigos.
A divisão a que esta publicação não para de voltar já está embutida. Cada automação tem uma configuração de «Força do modelo», com «um mais leve para tarefas simples como etiquetar ou rotear» e o modelo usual para redigir (documentação da eesel). Cada ação pode ser definida como Automática, Requer aprovação ou Desativada, e os eventos que o agente decide pular são registrados com um motivo. Antes de qualquer coisa entrar no ar, você pode simular o agente com seus próprios tickets antigos e ver onde ele teria coincidido com as respostas da sua equipe.

Se preferir configurar pelo terminal, a CLI da eesel executa o mesmo colega que o painel. Todo comando imprime JSON, então o Claude Code, o Codex ou o Cursor podem conduzir toda a configuração. Um comando como eesel automations enable <platform> <key> --instructions "..." configura uma regra de triagem em palavras simples, eesel approvals lista ações retidas para aprovar ou negar, e --dry-run verifica uma escrita antes que ela aconteça. Escrevi mais sobre por que isso importa no meu texto sobre a CLI de agentes.
Os preços seguem um plano fixo mensal de créditos: um ticket é um crédito, não importa quanto trabalho aconteça dentro dele, a partir de US$ 299 por mês por 500 créditos, e você ganha 100 créditos grátis para testar sem cartão. Conecte seu helpdesk, aponte para os tickets do mês passado e veja como ele os ordena e o que teria respondido. Experimente a eesel.
Perguntas frequentes
O que é o Microsoft-Decision-1?
O Microsoft-Decision-1 é um modelo de decisão que a Microsoft lançou em 9 de outubro de 2026. Você entrega um texto e um conjunto de opções de resposta fixas, e ele devolve uma probabilidade calibrada para cada opção em JSON, em vez de escrever texto. É um de um grupo em rápido crescimento de modelos de decisão criados para chamadas de roteamento, classificação e verificação.
Em que o Microsoft-Decision-1 é baseado?
A Microsoft diz que pós-treinou o Qwen3.5-9B, modelo de pesos abertos da Alibaba, para pontuar decisões em uma única passagem e planeja migrar o modelo depois para modelos da Microsoft AI (MAI) e da OpenAI. A família Qwen também está por trás do Clef-flash da Cloudflare e do Strands Decider da AWS.
Como uso o Microsoft-Decision-1?
Há dois caminhos: implantá-lo pelo catálogo do Microsoft Foundry, onde é vendido diretamente pelo Azure e cobrado na sua assinatura do Azure, ou chamá-lo pela Decisions API do OpenRouter com o ID de modelo microsoft/microsoft-decision-1. Os SDKs de chat completions não funcionam com ele, então planeje uma requisição tipada, como faria com o TypeSafe Jev.
Quanto custa o Microsoft-Decision-1?
O Microsoft-Decision-1 custa US$ 0,042 por milhão de tokens de entrada e os tokens de saída são gratuitos, a mesma tarifa de destaque do Jev. A página de preços do Foundry no Azure ainda não tem uma linha para ele. Para a conta de custos do concorrente, veja meu detalhamento dos preços do Jev.
O Microsoft-Decision-1 é melhor que o Jev?
Na própria tabela de 36 benchmarks da Microsoft, o Microsoft-Decision-1 tem em média 83,5% de precisão contra 82,3% do Jev 1.13.0, enquanto o Jev pontua mais alto em calibração (93,7 contra 92,2). Nenhum ranking independente pontuou o Microsoft-Decision-1 ainda, então trate a vantagem como uma alegação. Minha análise do Jev cobre o que o Jev faz bem.
O Microsoft-Decision-1 consegue triar tickets de suporte?
Sim. Decisões de urgência, equipe e sentimento são exatamente as perguntas de opções fixas para as quais ele foi criado, e a própria requisição de exemplo do OpenRouter é uma mensagem de suporte. Você ainda precisa de algo que aplique a etiqueta, mova o ticket e escreva a resposta, que é o trabalho de um colega de helpdesk com IA. Veja como automatizar a triagem de tickets para o fluxo completo.
O Microsoft-Decision-1 explica suas decisões?
Não. A ficha do modelo da Microsoft diz que ele é apenas de texto e não gera explicações nem justificativas. Se você precisa de um motivo para cada decisão, para uma trilha de auditoria ou uma escalação para um humano, precisa registrar você mesmo as entradas e as opções ou usar um LLM para essa etapa.
Os pesos do Microsoft-Decision-1 são abertos?
Não. Não há repositório no Hugging Face para o Microsoft-Decision-1, e a Microsoft não publicou licença nem opção de hospedagem própria. Se você precisa de pesos abertos, o Clef da Cloudflare e o Strands Decider da AWS são Apache 2.0.