

Vale a pena testar a Gemini Decisions API se o seu código faz a mesma checagem de conjunto fechado milhares de vezes por dia: rotear este ticket, esta foto mostra um dano, esta resposta quebra uma política. O Gemini Decision 1 responde a até 1.000 perguntas de sim/não, escolha e rubrica em uma única passagem e retorna probabilidades, não texto, a 0,10 $ por milhão de tokens de entrada com zero tokens de saída cobrados. A vantagem dela sobre os outros modelos de decisão é o input: ela lê áudio, vídeo e PDF nativamente. As lacunas são a falta de caching, de batch, e ainda não ter Vertex AI. Ela classifica tickets mas não consegue responder a eles, e é exatamente essa a tarefa que o colega de equipe de IA para helpdesk da eesel faz dentro do seu helpdesk. Com o eesel CLI, um agente de código pode subir suas regras de triagem e artigos de ajuda, e depois rodar tickets de teste antes de qualquer coisa ir ao ar.
O que é a Gemini Decisions API?
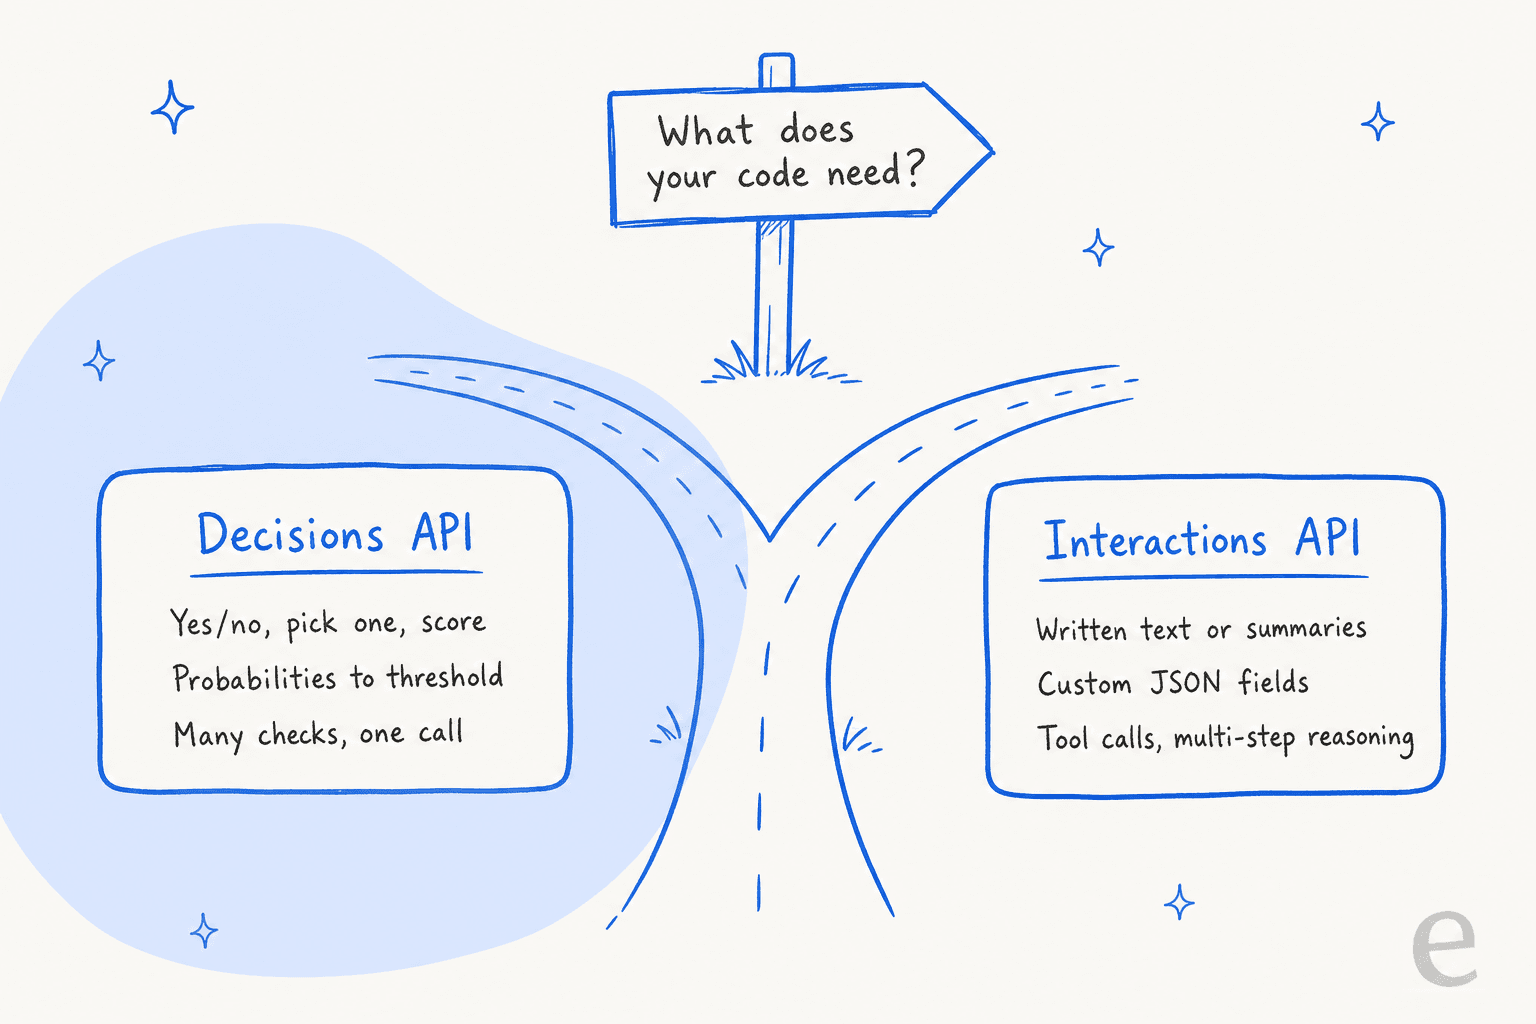
A Gemini Decisions API é um novo endpoint da API Gemini para decisões rápidas de conjunto fechado. O Google a lançou em 11 de novembro de 2026, junto com um novo modelo chamado Gemini Decision 1 (gemini-decision-1). Você envia um input compartilhado e uma lista de perguntas tipadas, e ela devolve uma resposta por pergunta com uma probabilidade calibrada e um confidence score.
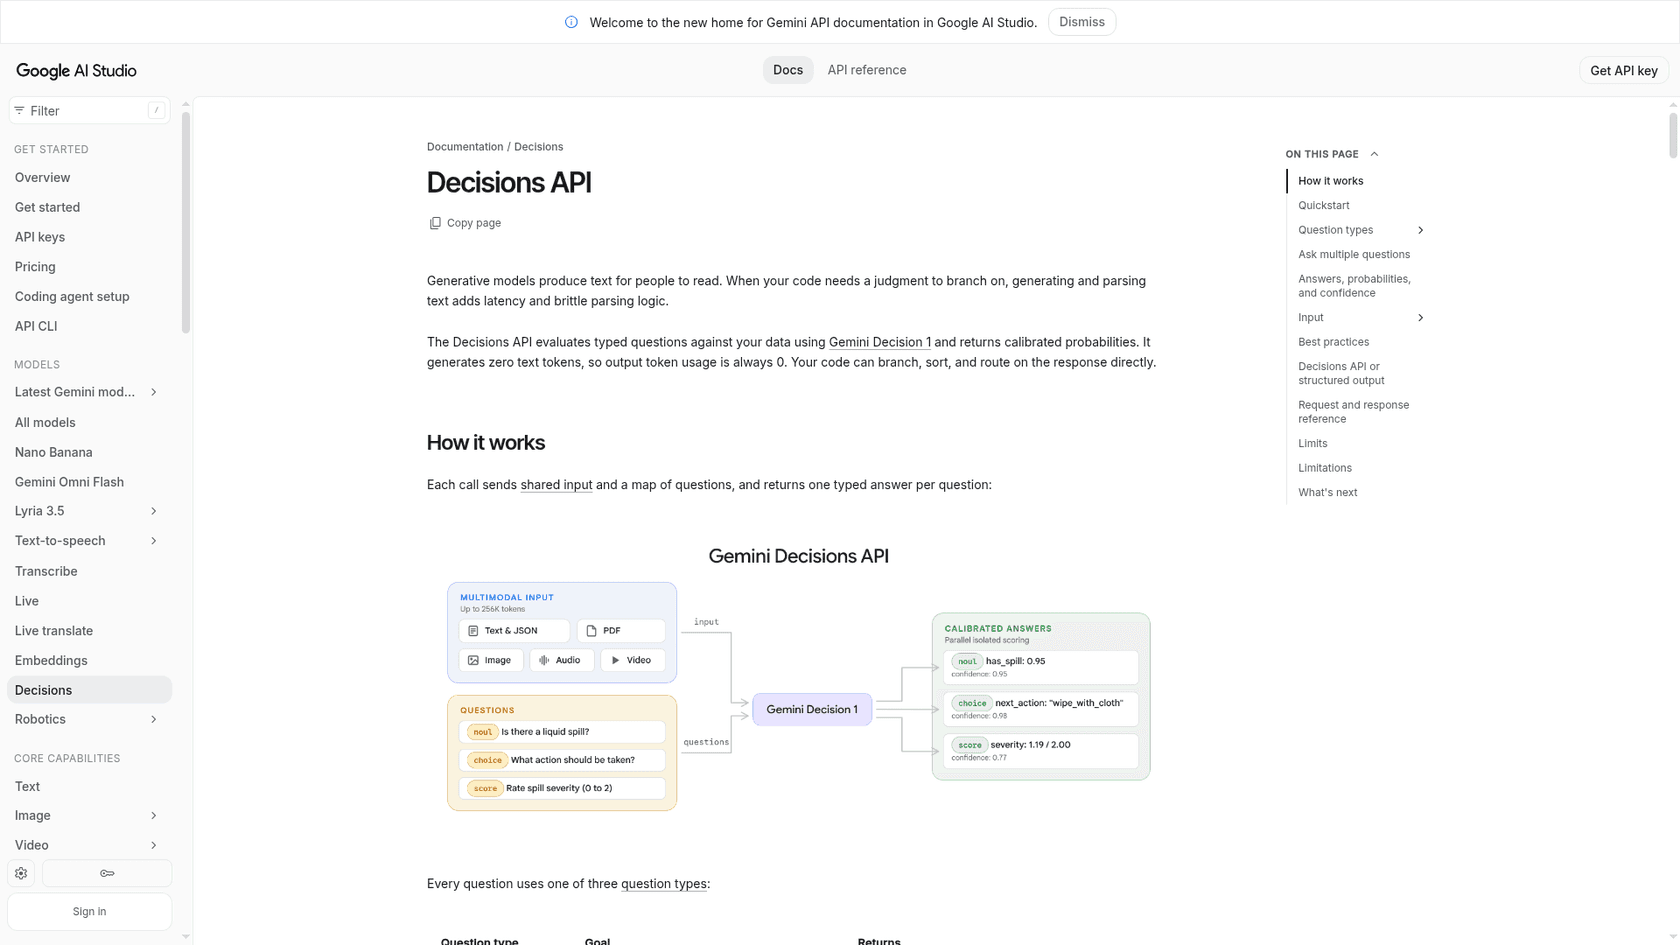
A frase-chave nos docs da Decisions API é que ela "generates zero text tokens, so output token usage is always 0." Seu código se ramifica em um número, em vez de interpretar uma frase.
Eu construo integrações e APIs na eesel, e a parte desse trabalho que eu adoraria nunca mais escrever é a cola em volta de um LLM que deveria devolver só uma palavra. Você pergunta por "billing" ou "shipping", recebe "Billing." com ponto final, ou um parágrafo educado, e escreve um parser mais um retry. Um endpoint de decisão remove essa camada toda. Essa é a verdadeira proposta aqui, mais do que a velocidade.
Veja o que o Google confirmou no lançamento:
| Especificação | Gemini Decision 1 |
|---|---|
| ID do modelo | gemini-decision-1 |
| Entradas | Texto, imagens, áudio, vídeo e PDF, misturados em uma só requisição |
| Saída | Probabilidades e confidence scores, 0 tokens de saída |
| Tipos de pergunta | Sim/não (noul), escolha, pontuação |
| Perguntas por requisição | 1 a 1.000 |
| Janela de contexto | 262.144 tokens, input compartilhado mais todas as perguntas |
| Latência (número do Google) | 150 a 250 ms de ponta a ponta |
| Preço | 0,10 $ por 1M de tokens de entrada, nível gratuito no AI Studio |
| Onde roda | Gemini Developer API (v1beta), OpenRouter. Google Cloud "em breve" |
| Não suportado | Geração de texto, thinking, function calling, caching, Batch API, Flex e Priority |
O Google chega atrasado nessa categoria, e admite isso abertamente. O TypeSafe Jev começou em setembro, e a OpenAI Decisions API foi para beta pública no início de outubro. Um comentarista do Hacker News resumiu o timing sem rodeios:
"It took OpenAI 2 weeks after Jev to release a decision end point, and now google does it 2 months later."

Como funciona o Gemini Decision 1?
O Gemini Decision 1 lê seu input uma única vez e pontua cada resposta permitida em uma única passagem direta, em vez de gerar uma resposta token por token. É por isso que a saída é gratuita e a latência fica estável conforme você adiciona perguntas. O Google diz que o cômputo mediano do modelo é de 50 a 100 ms, quase constante de 1 a 100 perguntas por requisição, para inputs de até 16.000 tokens.
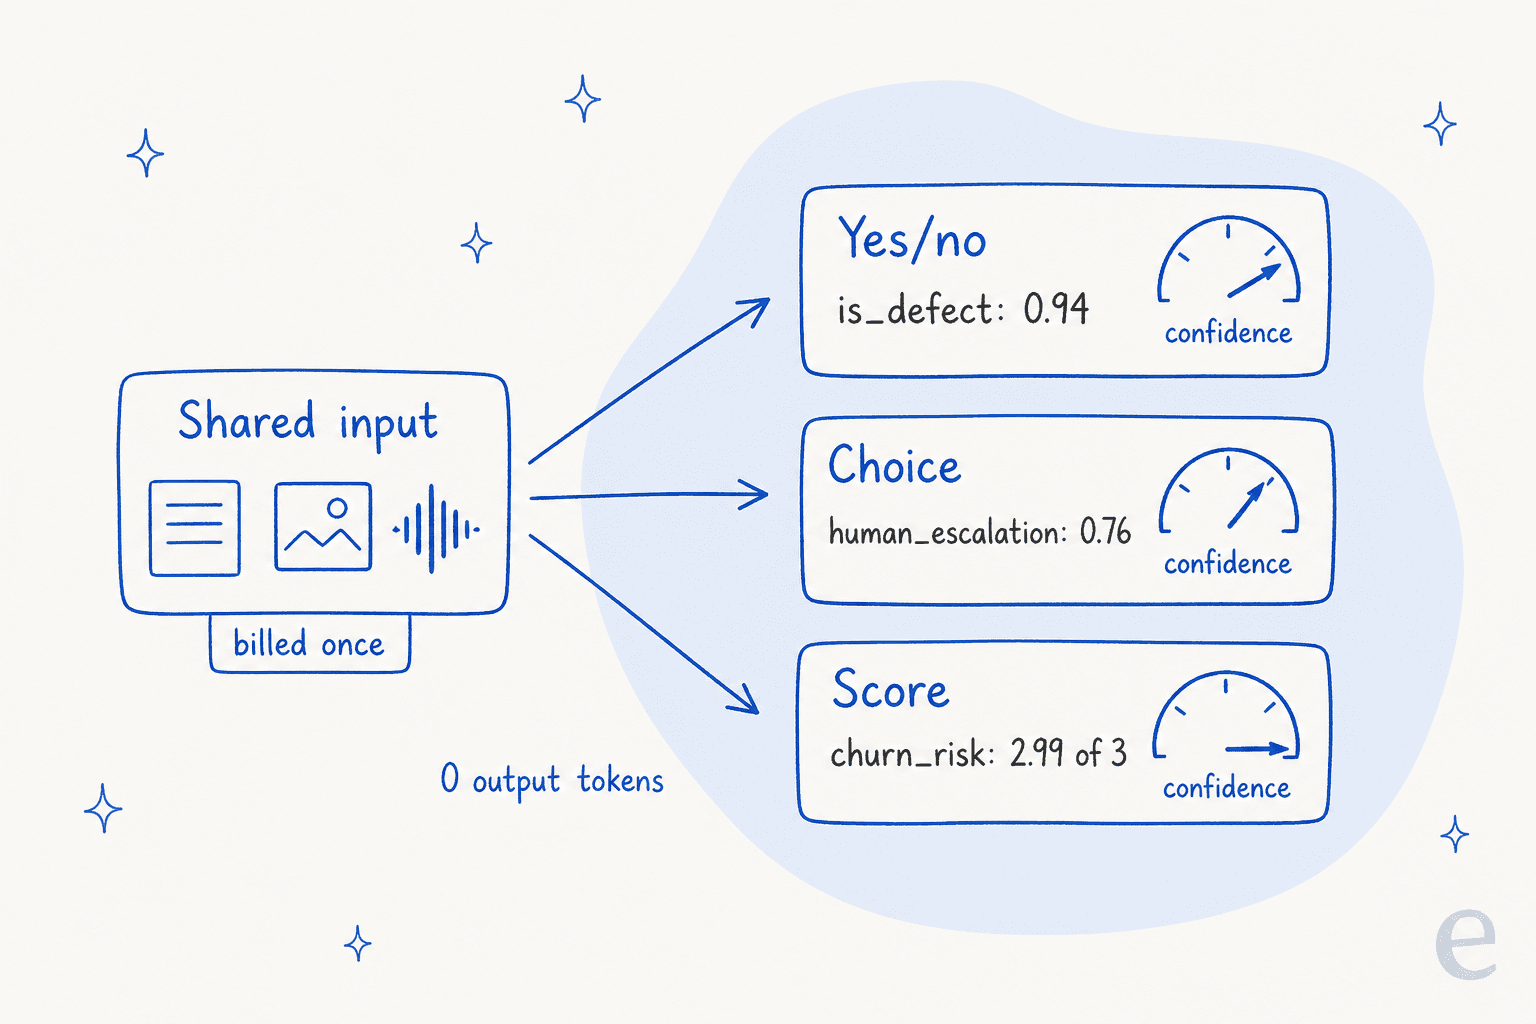
Os números desse diagrama saem direto do próprio exemplo de ticket de suporte do Google nos docs, que vale a pena percorrer.
Os três tipos de pergunta
Cada pergunta é de um dos três tipos, e você pode misturá-los em uma só chamada:
- Sim/não (
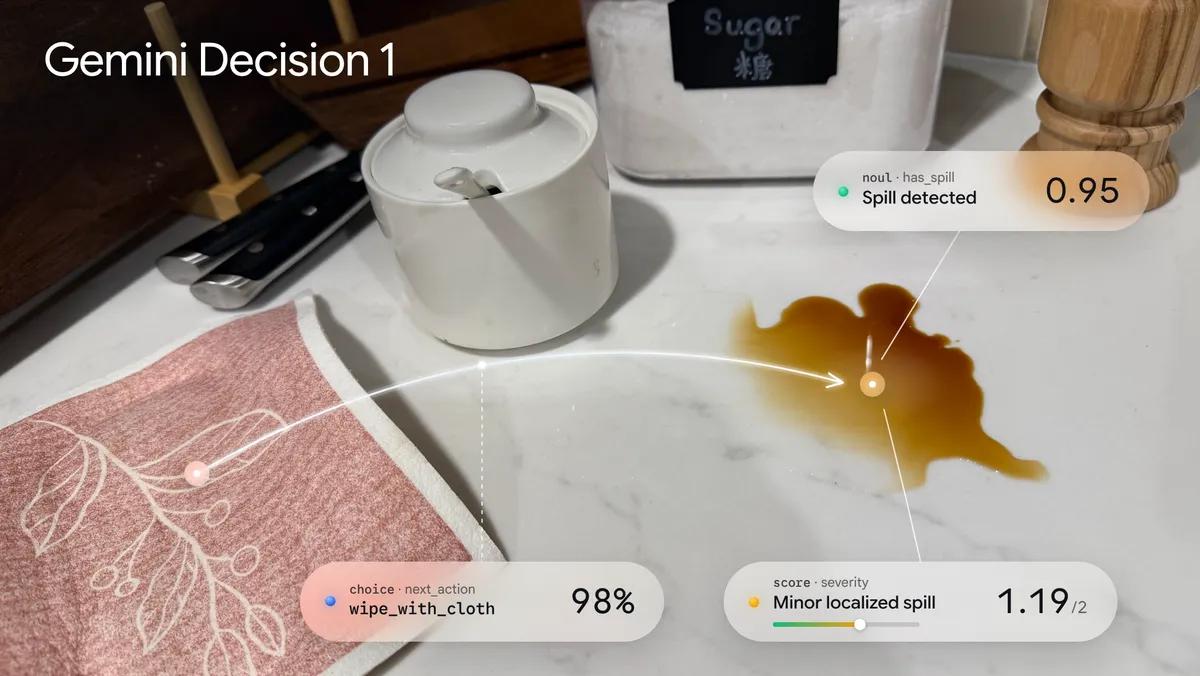
noul) retorna a probabilidade de uma afirmação ser verdadeira, de 0,01 a 0,99. Você pode adicionar umatrue_descriptione umafalse_descriptionquando "sim" for ambíguo. O nome estranho segue a API do Jev (comentaristas do HN acham que vem de "Bernoulli"), enquanto a OpenAI chama a mesma coisa depredicate. - Escolha seleciona uma opção entre 2 e 255 e retorna a vencedora mais uma probabilidade para cada opção, que somam 1.
- Pontuação avalia o input segundo uma rubrica ordenada de 2 a 255 níveis (o Google recomenda 2 a 10) e retorna uma média ponderada por probabilidade. Uma pontuação de 1,12 significa "majoritariamente nível 1, um pouco de nível 2".
Um exemplo de suporte tirado dos docs do Google
O próprio exemplo multi-pergunta do Google é um ticket de suporte. O input são dados do pedido (fones de ouvido, 240 $, nível Gold) mais a mensagem "Audio cuts out on the left earcup. Fix it today or I cancel my membership." Três perguntas são executadas sobre isso:
| Pergunta | Tipo | Resposta | Confiança |
|---|---|---|---|
| É um defeito de hardware? | Sim/não | 0,94 | 0,94 |
| Qual resolução se encaixa? | Escolha | human_escalation (0,76), replacement 0,18 | 0,76 |
| Qual a probabilidade de churn? | Pontuação, 0 a 3 | 2,99 ("ameaça cancelar") | 0,99 |
O conjunto usou 324 tokens de entrada e 0 tokens de saída. Depois o código faz a composição: se a probabilidade de defeito passar de 0,9 e a confiança da escolha passar de 0,6, a ação é tomada, caso contrário vai para uma pessoa. O Google chama isso de "atomic checks, composed in code", e é a forma correta de usar esses modelos. Cada pergunta não consegue ver as outras, então adicionar uma nunca muda o resto.
É assim também que um bom roteamento de tickets funciona em um helpdesk. Você não quer um único prompt gigante decidindo tudo. Você quer checagens pequenas e testáveis (intenção, urgência, sentimento) e uma regra clara para quando uma pessoa assume. Cobri o lado do helpdesk nos meus guias sobre classificação de tickets com IA e tickets com detecção de intenção.
Armadilhas que os docs apontam
Os docs têm algumas regras que vão te pegar se você só passar os olhos:
- As chaves das opções são ordenadas alfabeticamente antes de pontuar. Um catch-all chamado
none_of_the_abovecai antes deshipping, então chame-o deother. - A escolha sempre distribui probabilidade entre suas opções, mesmo quando nenhuma se encaixa. Verifique a confiança, ou adicione uma checagem de escopo sim/não separada, como "Esta mensagem é sobre um pedido?"
- O modelo nunca vê as chaves das suas perguntas. Coloque a pergunta completa em
instructions. - Faça as contas no código. Compare datas, valores e durações você mesmo, e então passe o resultado.
- Trate o input como não confiável. O Google avisa que o texto do usuário "can argue for its own classification", então mantenha uma pessoa ou uma segunda checagem em pagamentos e reembolsos. É a mesma lógica atrás dos guardrails de IA em qualquer configuração de suporte.
O que a diferencia do Jev e da OpenAI?
Os tipos de input. O Gemini Decision 1 lê texto, imagens, áudio, vídeo e PDF em uma só requisição, com uma janela de 262K. A maioria dos concorrentes é só texto, ou texto mais imagens, com 24K a 65K tokens.
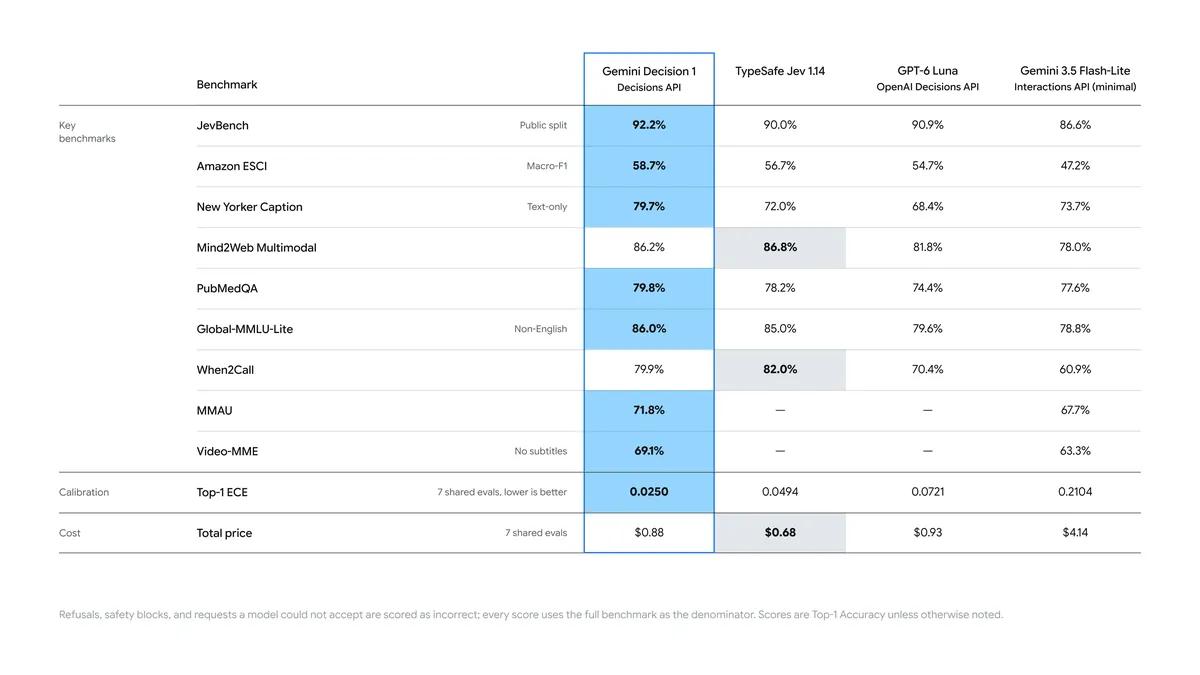
O post de lançamento do Google diz que o Decision 1 "leads across the suite, with the lowest calibration error." Trate isso como o Google corrigindo a própria tarefa de casa, até que um comitê externo verifique. Veja como a categoria aparece na página de cada fornecedor:
| Modelo | Preço de entrada por 1M | Saída | Contexto | Lê |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | Gratuito | 262.144 | Texto, imagens, áudio, vídeo, PDF |
| OpenAI Decisions API (GPT-6 Luna) | 0,10 $ | Gratuito | Janela do Luna, 2x input após 272K | Texto, imagens incorporadas |
| TypeSafe Jev | 0,042 $ | Gratuito | 32.000 | Texto |
| Microsoft-Decision-1 | 0,042 $ | Gratuito | 32.768 | Não informado |
| Cloudflare Clef | 0,24 $ | Sem preço de saída | 65.536 | Texto, JSON, imagens, vídeo |
| Cloudflare Clef-flash | 0,038 $ | Sem preço de saída | 24.576 | Texto, JSON, imagens, vídeo |
| Strands Decider 2B | Gratuito (self-host) | Gratuito | Janelas de execução de 3K a 4K | Texto |
Números do Gemini checados em 12 de novembro de 2026. Números dos concorrentes conforme a página de cada fornecedor, checados por último em 11 de outubro de 2026.
Três coisas se destacam:
- O Gemini iguala exatamente o preço da OpenAI e custa cerca de 2,4x o do Jev por token. Você está pagando pelo input multimodal e pela janela grande.
- Áudio e PDF são novos para essa categoria. Os próprios exemplos do Google combinam "a call recording with account metadata or a scanned PDF claim with damage photos." Sem cobrança separada de transcrição ou OCR.
- A hospedagem é mais restrita do que parece. Sem pesos abertos, sem self-hosting, e ainda sem Vertex AI. O Jev roda no Cloudflare, o modelo da Microsoft no Azure, e o Strands roda em qualquer lugar.
O tópico de lançamento no Hacker News chegou à mesma conclusão sobre preço versus input:
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."
Se seus inputs são tickets em texto puro, o Jev ou o Clef-flash vão custar menos por decisão. Se seus inputs são mensagens de voz, gravações de chamadas, fotos de produtos quebrados ou faturas em PDF, o Gemini é o único modelo de decisão hospedado que eu conheço que aceita todos eles nativamente. Para um olhar mais amplo sobre as opções só de texto, veja meu resumo de alternativas ao Jev.
Quanto custa a Gemini Decisions API?
O Gemini Decision 1 custa 0,10 $ por milhão de tokens de entrada no nível pago, e a saída é sempre gratuita porque não existe. O nível gratuito é "Free of charge" para prototipagem, e o Google pode usar esses dados para melhorar seus produtos (no nível pago, não).
Dois detalhes de cobrança importam mais do que a tarifa:
- O input compartilhado é cobrado uma vez por requisição, independente de quantas perguntas você faça. Cada pergunta só adiciona seus próprios tokens de instrução e critérios. Então dez perguntas sobre um ticket custam muito menos que dez chamadas.
- Nada tem desconto. Não há context caching, Batch API nem nível Flex, então o mesmo contexto de sistema enviado em cada requisição é cobrado por completo todas as vezes. Com uma configuração de Gemini 3.5 Flash-Lite você teria ao menos input em cache a 0,03 $.
O Google afirma que o Decision 1 é "nearly 5x cheaper" que o Flash-Lite na sua suíte de referência. Meu próprio cálculo aproximado concorda. Pegue 10.000 tickets por mês, 600 tokens cada, três perguntas de cerca de 60 tokens cada:
- Decision 1: 7,8M tokens de entrada x 0,10 $ = cerca de 0,78 $ por mês.
- Flash-Lite com structured output: 7,8M x 0,30 $ = 2,34 $, mais cerca de 600K tokens de saída x 2,50 $ = 1,50 $, então cerca de 3,84 $, antes de qualquer token de thinking.
De qualquer forma, a conta do modelo para a triagem é dinheiro de bolso perto do custo de ter uma pessoa lendo cada ticket. Coloque seus próprios números aqui:
O que você pode construir com ela?
O Google lista quatro usos: rotear uma solicitação para um modelo, fila, agente ou ferramenta; checar inputs e outputs contra muitas regras de política de uma vez; decidir quais ferramentas um agente precisa, ou se deve compactar, escalar ou parar; e filtrar ou ranquear candidatos contra uma rubrica. As próprias equipes do Google já usam isso em produção:
- Gemini Notebook roteia cada consulta para o nível de modelo e de thinking certo, o que o Google diz que atende consultas do dia a dia com até 40% menos latência.
- Google Search usa isso como camada de segurança para ferramentas MCP, capturando conteúdo adversarial dentro do seu orçamento de latência.
- CC do Google Labs escolhe uma reação de emoji entre mais de 200 opções em uma fração de segundo.
- Stitch usa isso em um experimento rápido de canvas que constrói wireframes jogáveis em segundos.
Para equipes de suporte, os usos são óbvios, e os próprios exemplos dos docs do Google são majoritariamente tickets de suporte. É aqui que eu usaria:
- Triagem e roteamento. Departamento, prioridade e idioma em uma só chamada, antes que uma pessoa ou um agente veja o ticket. Isso é auto-triagem clássica.
- Checagens de escalonamento. "O cliente está ameaçando cancelar?" e "Isso é uma questão legal ou de segurança?" como perguntas sim/não com um limiar fixo, alimentando uma regra de escalonamento.
- QA de respostas. Passar um rascunho de resposta por dez regras de política (sem reembolsos prometidos, sem nomes de concorrentes, tom correto) antes de enviar. Esse é o substituto barato para fazer um LLM julgar cada rascunho.
- Entrada de voicemail e fotos. Pontuar a intenção de uma gravação de chamada, ou o dano visível na foto de um cliente, sem uma etapa de transcrição.
- Pontuação de sentimento e churn segundo uma rubrica, para que um "2,99 de 3" possa subir um ticket na fila.
O que ela não faz é escrever a resposta. Cada um desses usos termina com "e então algo responde ao cliente". Quando alguém no tópico de lançamento perguntou onde esses modelos são úteis, uma resposta resumiu isso como "Routing, classification, replacement for LLM-as-judge." Esse é o alcance honesto.
O que isso significa para uma equipe de suporte?
Para a maioria das equipes de suporte, a Gemini Decisions API é uma peça, não um produto. Se você tem engenheiros e quer conectar a triagem à sua própria stack, é uma forma barata e rápida de fazer isso, e o confidence score te dá um ponto claro para passar o caso para uma pessoa. Se não tem, você teria que construir sozinho as regras de roteamento, os limiares, a infraestrutura de testes e as escritas no helpdesk, e nada disso vem incluído.
Essa camada ao redor é exatamente o que é o colega de IA para helpdesk da eesel. Ele entra na sua fila existente no Zendesk, Freshdesk ou HubSpot, toma as mesmas decisões de categorizar, rotear e escalar, e então faz a parte que um modelo de decisão não consegue: redige ou envia a resposta a partir dos seus próprios macros e central de ajuda. Antes de tocar em um ticket real, ele é simulado contra suas conversas históricas, porque um rótulo errado e confiante continua errado.
Dois clientes da eesel mostram como isso é:
- A smava, um site alemão de comparação de empréstimos no Zendesk, se aproxima de um caso de livro-texto para um modelo de decisão. Em um mês, a eesel tratou 27.000 tickets em duas marcas, categorizou 14.600 deles (idioma, elegibilidade de resposta e categoria escritos em campos do Zendesk) e preparou 15.300 rascunhos de resposta a partir de 820 macros e artigos sincronizados.
- A MentorShow, uma plataforma francesa de aprendizado online no HubSpot, faz com que todo ticket seja analisado com um rascunho de resposta anexado. Em um mês, foram 1.200 conversas e tickets lidos e 432 rascunhos escritos em francês, inglês ou espanhol.
Em ambos os casos, os rótulos só são úteis porque algo age sobre eles. Essa é a lacuna entre uma decision API e um colega de equipe.
Você deveria usar a Gemini Decisions API?
Use-a se você já escreve código em torno de chamadas de LLM que devolvem uma palavra, e especialmente se seus inputs são áudio, imagens ou PDF. O modelo de passagem única com muitas perguntas é uma melhoria real em relação a interpretar JSON de um modelo generativo, e 0,10 $ por milhão de tokens com saída gratuita é difícil de contestar.
Escolha-a se você precisa de decisões multimodais, mais de 32K de contexto, ou dezenas de checagens sobre o mesmo input, e está confortável com a Developer API do Google. Escolha outra coisa se seus inputs são texto puro (Jev e Clef-flash são mais baratos por token), você precisa de Vertex AI ou self-hosting hoje, ou depende de input em cache ou em lote para manter os custos baixos.
E se o que você realmente quer é que os tickets sejam classificados e respondidos, pule a parte da fiação. Para uma visão mais ampla, meu resumo de IA para triagem de tickets compara as ferramentas que fazem as duas coisas.
Teste a eesel para uma triagem que termina em resposta
Um modelo de decisão pode te dizer que um ticket é um defeito de faturamento com 0,94 de confiança. A eesel pega esse ticket no Zendesk, Freshdesk ou HubSpot, rotula, roteia, e redige a resposta que sua equipe teria escrito, testada primeiro nos seus próprios tickets passados. A smava usa isso para classificar e redigir 27.000 tickets alemães do Zendesk por mês. Veja os preços, ou experimente a eesel gratuitamente.
Perguntas frequentes
O que é a Gemini Decisions API?
A Gemini Decisions API é um endpoint do Google, lançado em 11 de novembro de 2026, que responde a perguntas de conjunto fechado (sim/não, escolher uma opção, ou pontuar segundo uma rubrica) sobre um input e retorna probabilidades calibradas em vez de texto gerado. Ela roda sobre o modelo Gemini Decision 1 e pertence à mesma categoria de modelos de decisão que o TypeSafe Jev.
Quanto custa a Gemini Decisions API?
O Gemini Decision 1 custa 0,10 $ por milhão de tokens de entrada no nível pago, com zero tokens de saída cobrados, e o nível gratuito é sem custo para prototipagem. O input compartilhado é cobrado uma vez por chamada, independente de quantas perguntas você faça. Para comparação, os preços do Gemini 3.5 Flash-Lite são 0,30 $ de entrada e 2,50 $ de saída por milhão de tokens.
Qual modelo a Gemini Decisions API usa?
Ela usa o gemini-decision-1, um modelo multimodal especializado que pontua as opções em uma única passagem de prefill. Tem um limite de entrada de 262.144 tokens e um limite de saída de zero. Não consegue gerar texto, chamar ferramentas nem raciocinar, então complementa modelos como o Gemini 4 Carbon em vez de substituí-los.
Em que a Gemini Decisions API difere do structured output?
O structured output faz um modelo generativo escrever JSON que se encaixa no seu esquema, e você paga por cada token de saída. A Gemini Decisions API nunca escreve texto: ela retorna uma probabilidade para cada resposta permitida, que você pode filtrar com um limiar. O Google diz para usar structured output quando você precisa de valores extraídos ou objetos personalizados, a mesma troca entre o modo JSON da OpenAI e um endpoint de decisão.
A Gemini Decisions API é melhor que a OpenAI Decisions API?
Custam o mesmo, 0,10 $ por milhão de tokens de entrada com saída gratuita. O Gemini lê áudio, vídeo e PDF além de texto e imagens, enquanto a OpenAI Decisions API aceita texto e imagens incorporadas. O gráfico de referência do Google coloca o Decision 1 na frente, mas esse é o próprio teste do Google e ainda não foi reproduzido de forma independente.
Posso usar a Gemini Decisions API para triagem de tickets de suporte?
Sim. A própria documentação do Google usa exemplos de suporte: rotear um ticket para faturamento ou envio, verificar um defeito de produto e pontuar o risco de churn em uma única chamada. Ela se encaixa muito bem para triagem de tickets, mas apenas toma a decisão. Você ainda precisa de um sistema que escreva a resposta, e é aí que entra um agente de helpdesk.
A Gemini Decisions API está disponível no Vertex AI?
Ainda não. Em 12 de novembro de 2026, ela roda apenas na Gemini Developer API (v1beta) via Google AI Studio, e o Google diz que o suporte ao Gemini no Google Cloud chega em breve. Ela também está no OpenRouter. Se você precisa dela no Vertex hoje, veja as alternativas ao Gemini ou espere.
Quais são os limites da Gemini Decisions API?
Uma chamada aceita de 1 a 1.000 perguntas, de 2 a 255 opções por pergunta de escolha, e de 2 a 255 níveis por pergunta de pontuação, tudo dentro de uma janela de 262.144 tokens. Não há context caching, Batch API nem níveis Flex ou Priority, então um input repetido é cobrado por completo todas as vezes. As instruções das perguntas são apenas texto, e inputs que acionam os filtros de segurança retornam um HTTP 400 em vez de respostas, então planeje um caminho de escalonamento.