

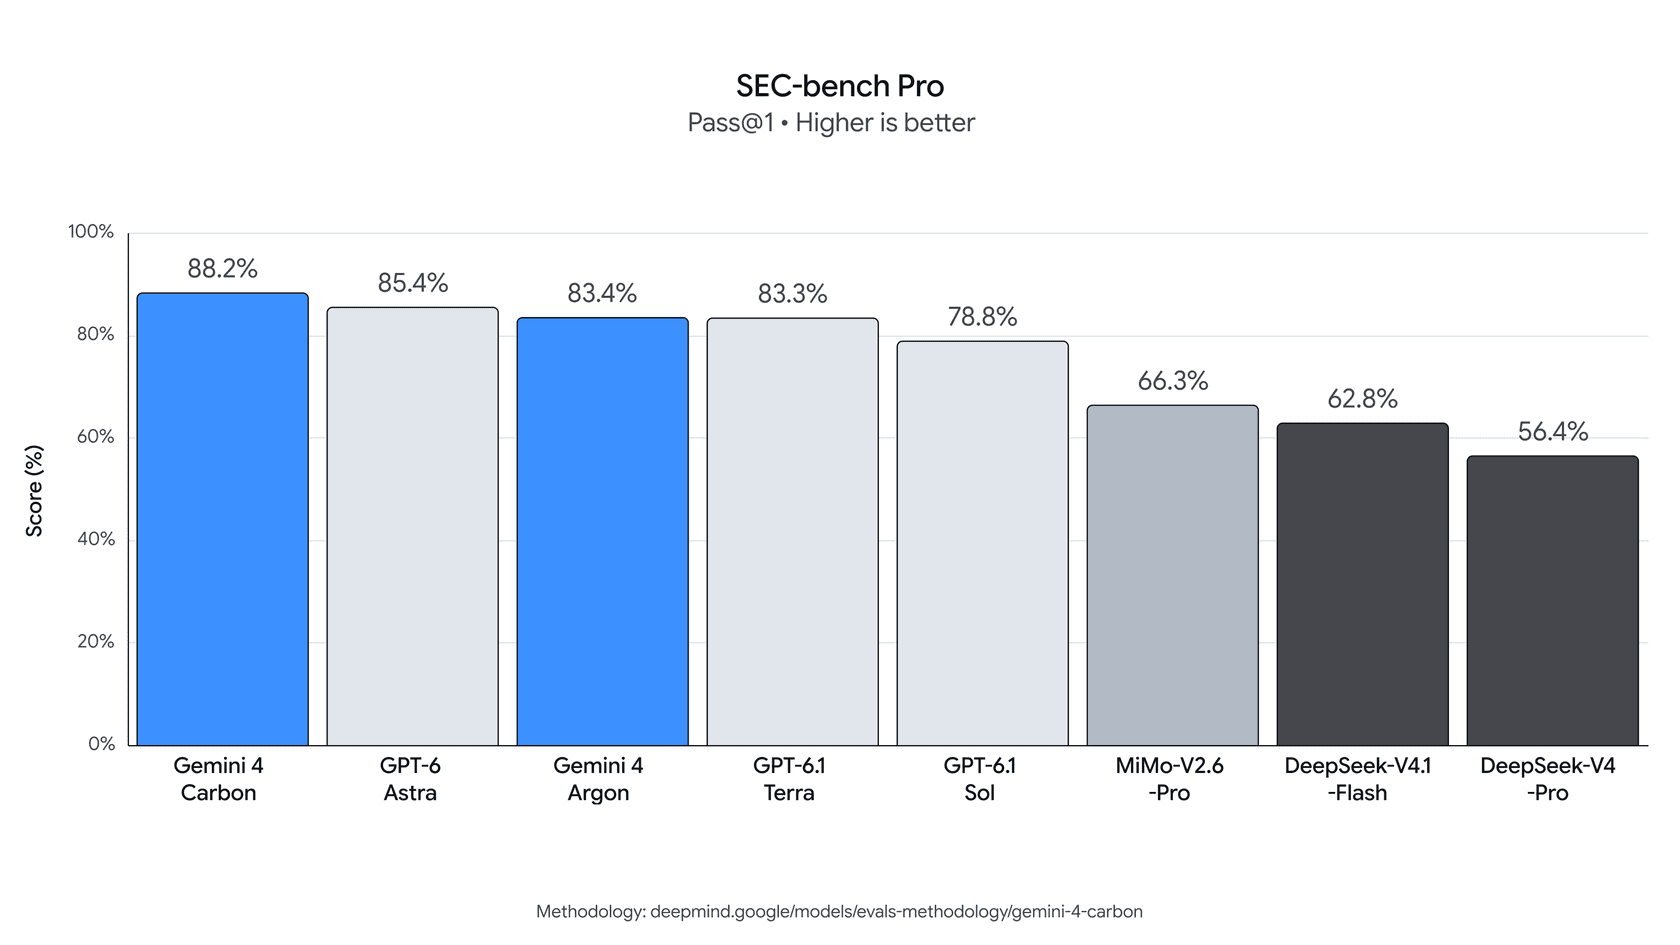
O Gemini 4 Carbon é o novo modelo de fronteira do Google, e é o modelo mais forte do Artificial Analysis Intelligence Index, com 59, nove pontos acima do Gemini 4 Argon, lançado apenas duas semanas antes. Ele supera o Argon nos 17 benchmarks que o Google publicou, lidera o campo em testes de segurança cibernética como o SEC-bench Pro (88,2%) e custa exatamente o mesmo: $2/$10 por milhão de tokens no lançamento, $4/$20 depois.
O problema é o acesso. Hoje, apenas um subconjunto de defensores de segurança cibernética pode usar o Carbon, por meio do Fairwind Program do Google. Desenvolvedores, empresas e consumidores o recebem "o mais rápido possível", sem data. O Argon foi do anúncio à API em cerca de duas semanas, então essa é a melhor estimativa para o Carbon também.
Minha leitura: o Carbon não é um nível acima do Argon, é a substituição dele. Se você já usa o Argon, planeje trocar o nome do modelo quando ele chegar. Se está avaliando para tickets de suporte, a manchete que importa é a afirmação do Google de que o Carbon faz cerca de metade das afirmações sem respaldo. É o mesmo problema que a eesel resolve no nível do agente de helpdesk: rascunhos embasados na sua central de ajuda e em tickets anteriores, e um repasse quando não há nada em que embasá-los.
O que é o Gemini 4 Carbon?
O Gemini 4 Carbon é um modelo de linguagem grande do Google DeepMind, anunciado em 28 de outubro de 2026 por Koray Kavukcuoglu, Chief AI Architect do Google. O Google o chama de "our strongest model with state-of-the-art cybersecurity and long horizon capabilities", e ele é construído "building on" o Argon, não como uma classe de tamanho separada.
A versão curta do que o Google afirma:
| O quê | Gemini 4 Carbon |
|---|---|
| Anunciado | 28 de outubro de 2026 |
| Baseado em | Gemini 4 Argon (lançado duas semanas antes) |
| Artificial Analysis Intelligence Index v5.0 | 59,4, nº 1 no lançamento |
| Feito para | Programação agêntica de longa duração, defesa em segurança cibernética |
| Janela de contexto | 1M de tokens, segundo a Artificial Analysis |
| Preço de lançamento | $2 entrada / $10 saída por 1M de tokens, entrada em cache com 95% de desconto |
| Preço após a promoção | $4 entrada / $20 saída |
| Quem pode usar hoje | Um subconjunto de defensores de segurança cibernética via Fairwind Program |
O Google diz que suas próprias equipes viram o Carbon "run for days to persist through dead ends" em trabalhos de engenharia como encontrar a causa raiz de bugs sutis em grandes bases de código. É esse o trabalho em torno do qual ele foi projetado, e é por isso que a maior parte da publicação de lançamento fala de programação e segurança e não tanto de chat.
Como o Carbon é diferente do Argon?
O Carbon é um Argon melhor pelo mesmo preço. O Google não diz se é um novo treinamento ou um checkpoint posterior, mas tudo no lançamento (mesma tabela de preços, mesmo caminho de implantação, "building on Gemini 4 Argon") aponta para um sucessor e não para um irmão. Veja como os dois se comparam nos números que mais mudaram:
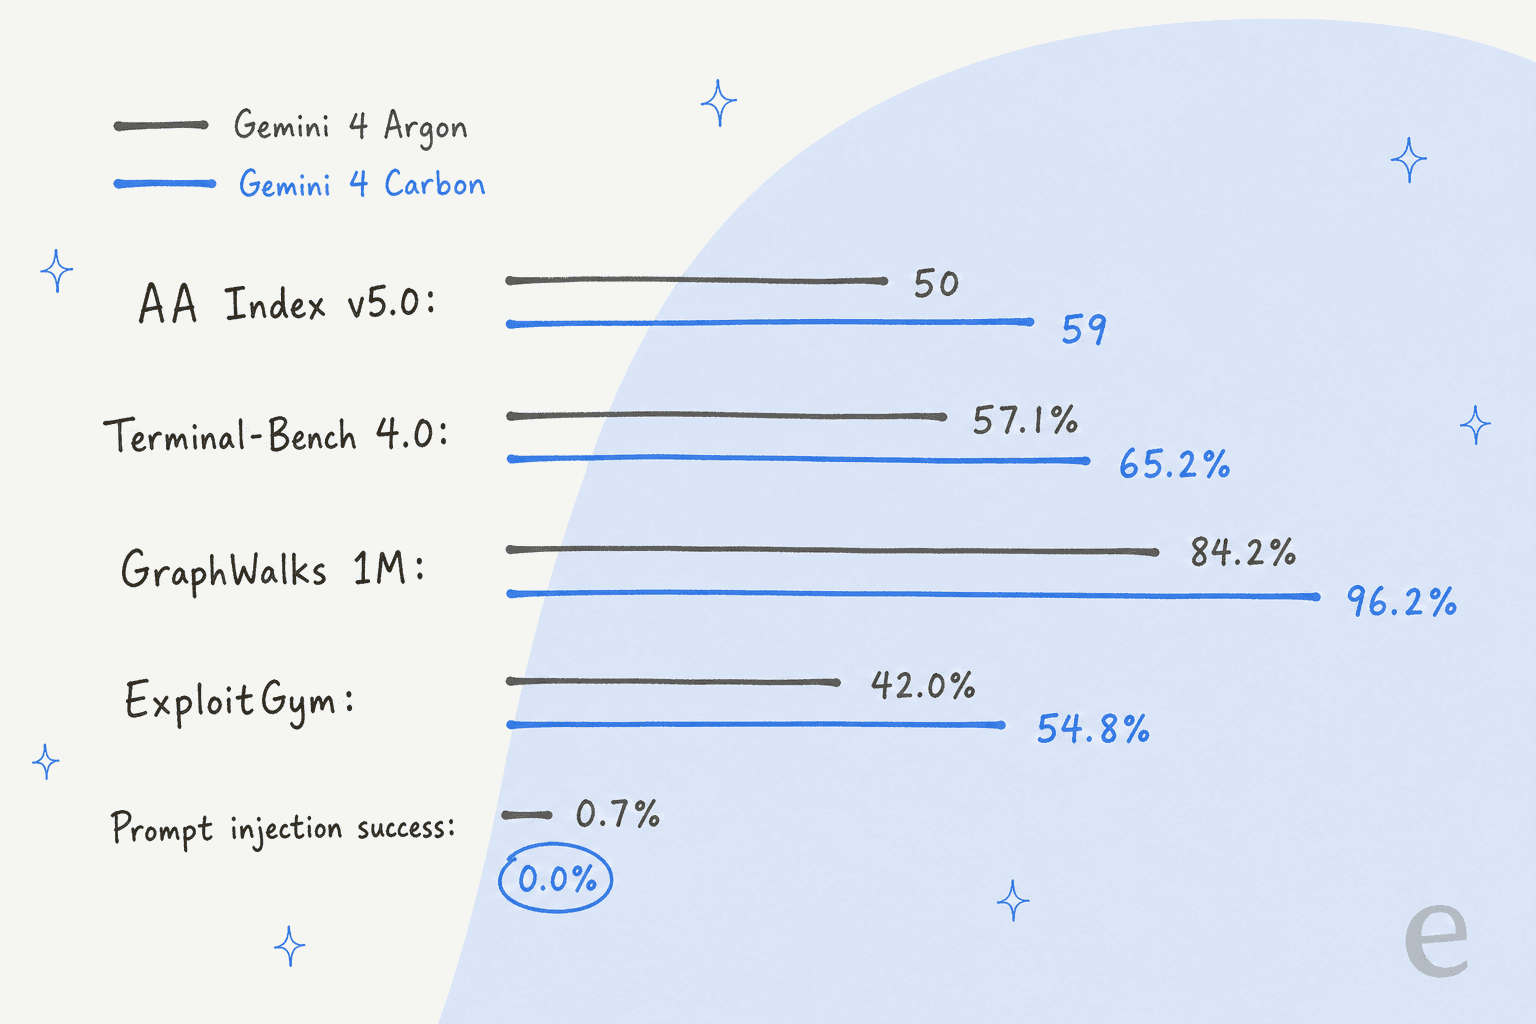
Os maiores saltos estão no contexto longo e na segurança. O GraphWalks, que testa raciocínio entre 256K e 1M de tokens, vai de 84,2% para 96,2%, e o benchmark de exploração ExploitGym sobe quase 13 pontos. Os ganhos em programação geral são menores, mas reais: o Terminal-Bench 4.0 ganha oito pontos e, no WebDev Arena, o Carbon sobe 89 Elo até o 4º lugar.
Os nomes confundiram quase todo mundo. Laboratórios como OpenAI e Anthropic usam nomes que indicam a ordem de tamanho (Astra, Sol, Terra; Opus, Sonnet, Haiku). Os nomes de elementos do Google não fazem isso, e o tópico do Hacker News gastou centenas de comentários só nisso:
"Confusingly, Carbon is another model in the same size class as Argon. Every other lab would have just called it Gemini 4.1 Argon."

Acho que esse é o modelo mental certo. Se você tratar o Carbon como "Argon, próxima versão", o resto do lançamento também faz sentido.
Como o Gemini 4 Carbon pontua nos benchmarks?
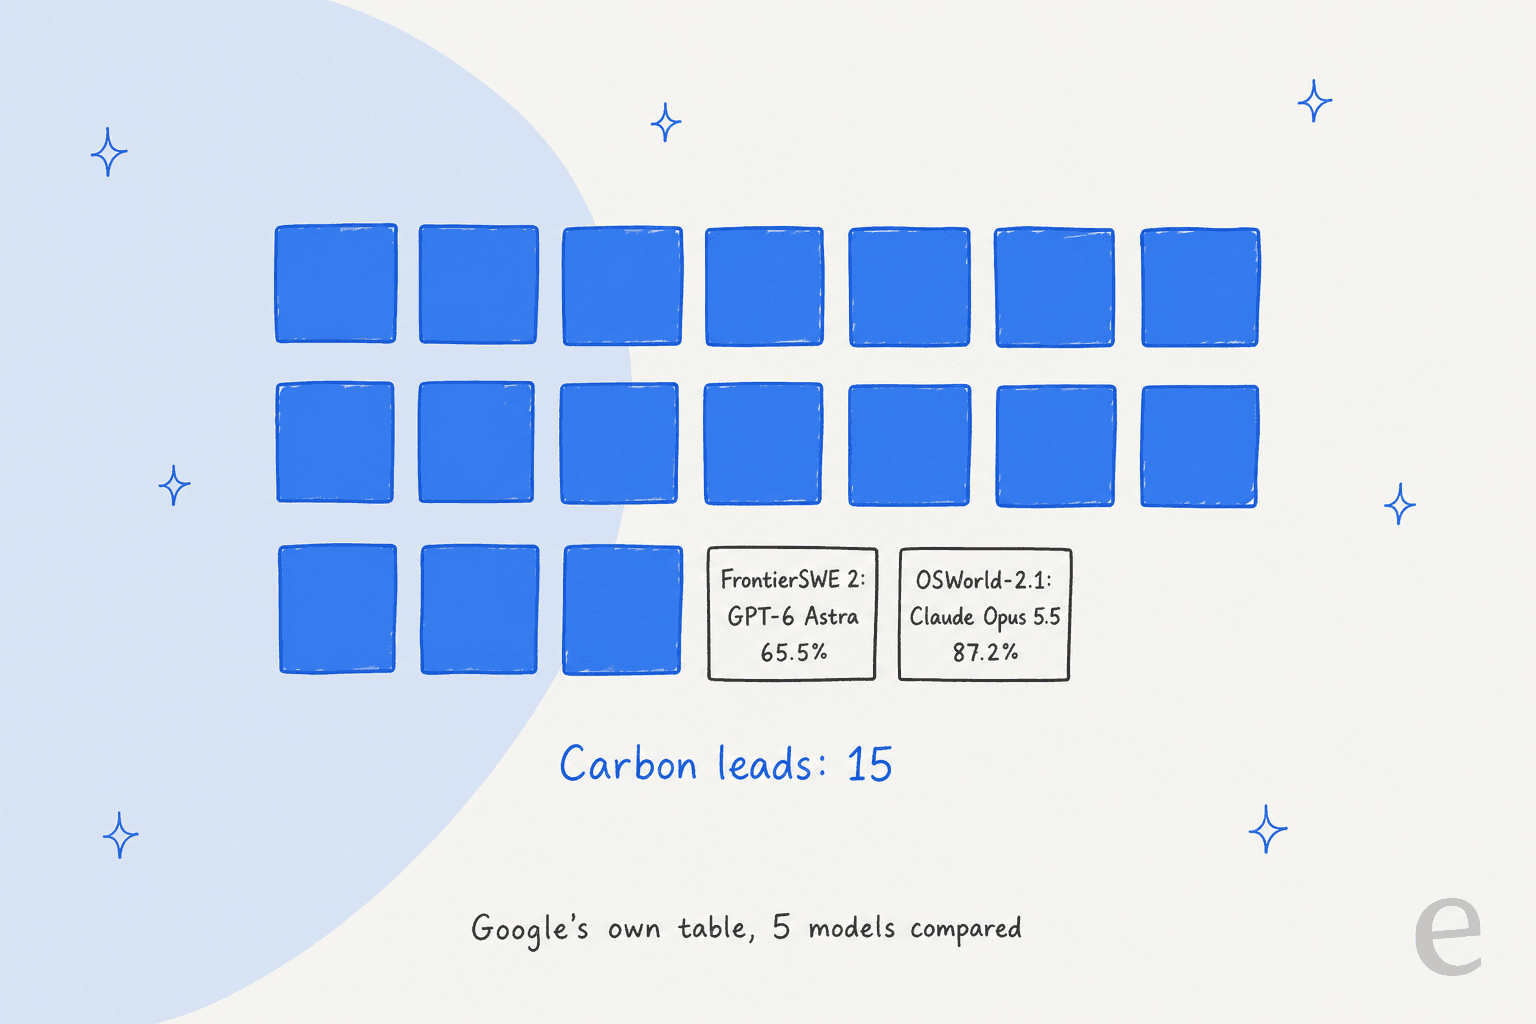
O Carbon lidera 15 das 17 linhas da tabela do próprio Google, contra o Argon, o GPT-6 Astra, o Claude Opus 5.5 e o Claude Fable 5.1. Aqui está a tabela completa como o Google a publicou:
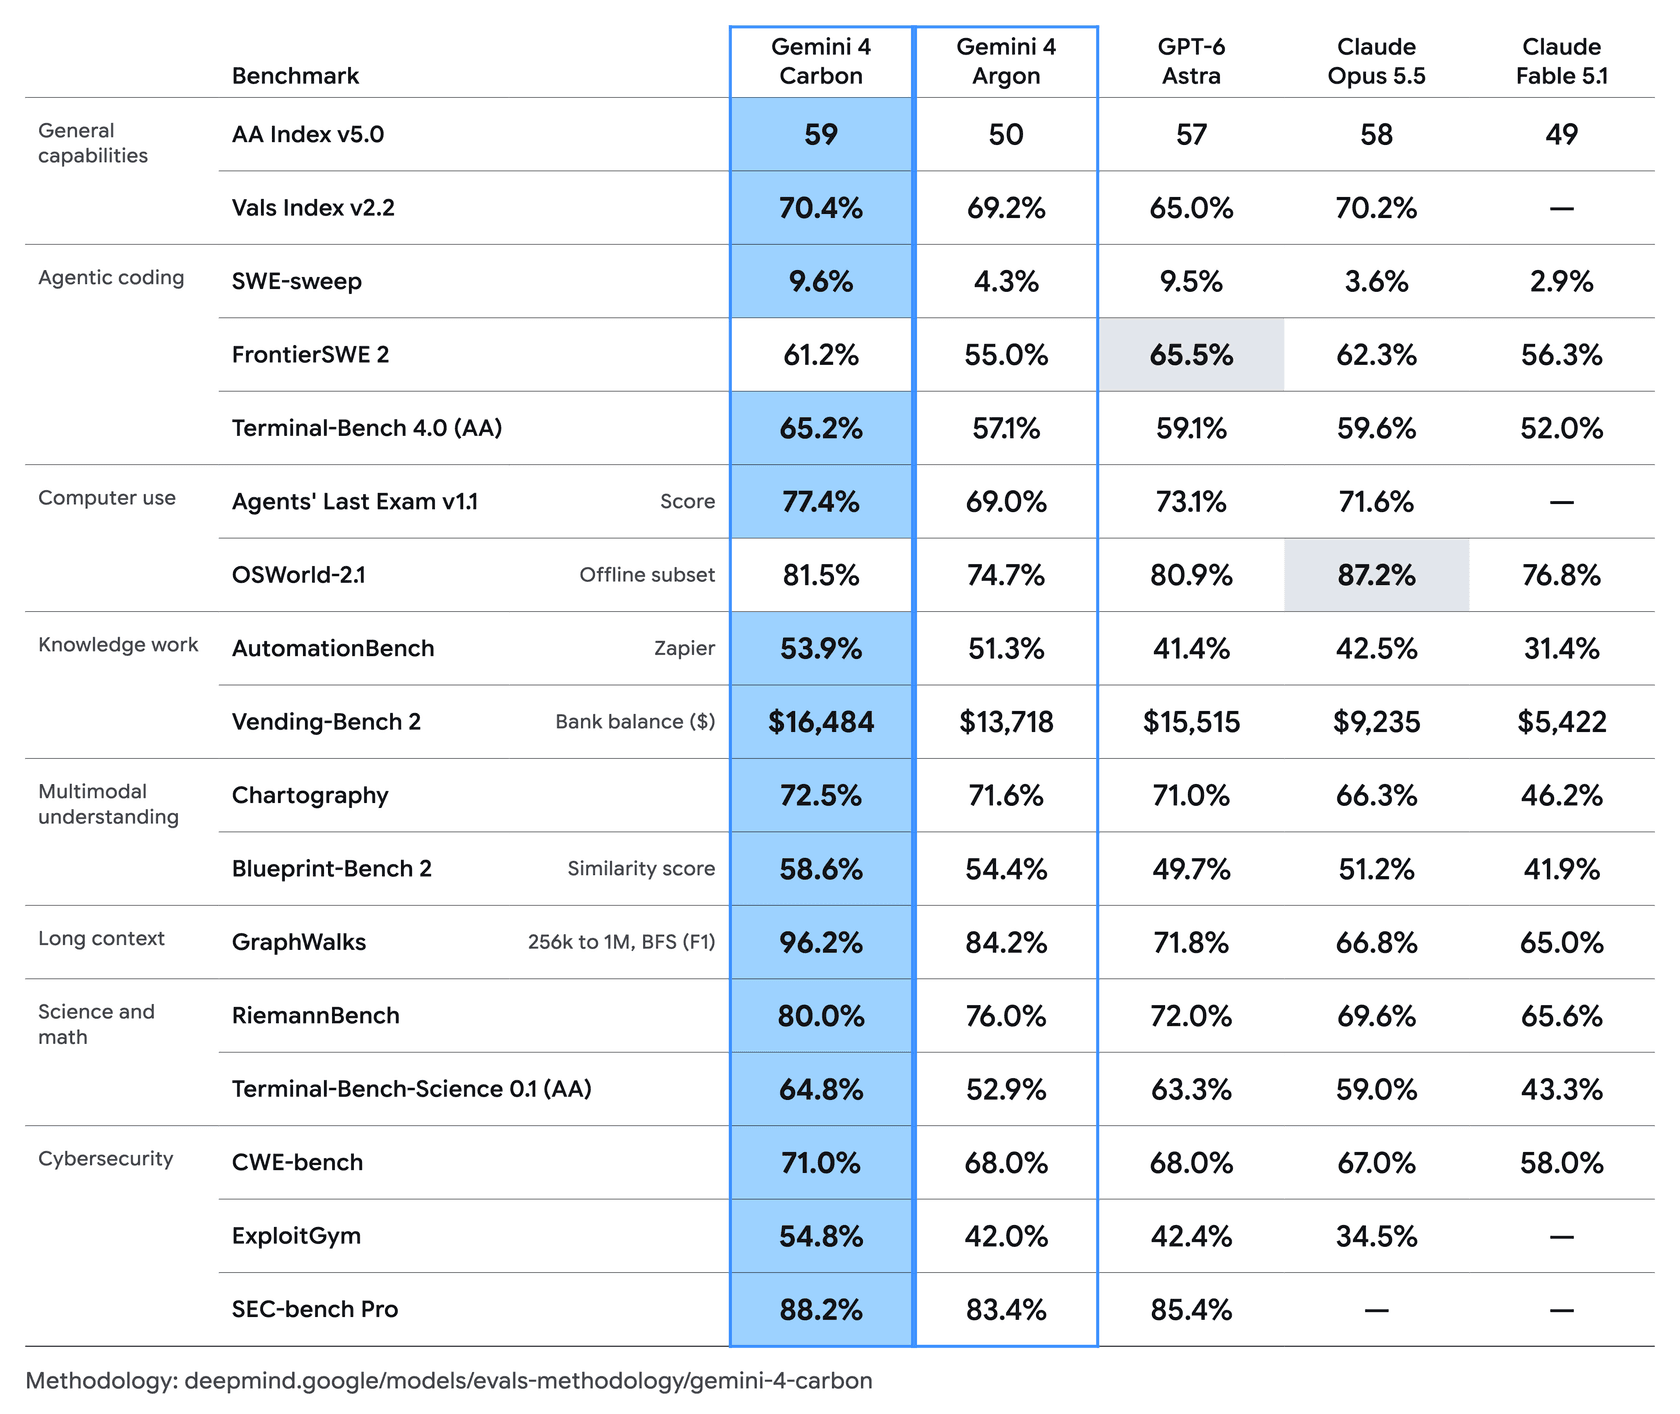
As duas linhas em que o Carbon não vence merecem atenção, pois são as que um comprador de programação ou uso de computador olharia primeiro:
Estas são as linhas às quais eu prestaria mais atenção, retiradas da página do modelo no DeepMind:
| Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| Terminal-Bench 4.0 (programação agêntica) | 65.2% | 57.1% | 59.1% | 59.6% |
| FrontierSWE 2 (engenharia de software) | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 (uso de computador) | 81.5% | 74.7% | 80.9% | 87.2% |
| AutomationBench (tarefas do Zapier) | 53.9% | 51.3% | 41.4% | 42.5% |
| GraphWalks (256K a 1M de tokens) | 96.2% | 84.2% | 71.8% | 66.8% |
| SEC-bench Pro (encontrar vulnerabilidades) | 88.2% | 83.4% | 85.4% | n/a |
Duas coisas chamam minha atenção. Primeiro, a vantagem em contexto longo é grande, não marginal: 96,2% no GraphWalks contra 66,8% do Opus 5.5. Se o seu trabalho é ler bases de código inteiras ou contratos longos, essa é a linha que importa. Segundo, o número do AutomationBench (o teste da Zapier para fluxos de trabalho empresariais reais) coloca o Carbon mais de 11 pontos à frente do Astra e do Opus, e para trabalho com agentes isso é um sinal mais forte do que qualquer pontuação isolada de programação.
Uma ressalva justa: são números do fornecedor. A verificação independente até agora é a Artificial Analysis, que coloca o Carbon em 59,4, primeiro no geral, a $7,76 por tarefa no preço de tabela. E o histórico do Argon é um motivo para esperar o uso real antes de confiar na tabela. O Argon também parecia forte no papel, e boa parte do tópico do Hacker News sobre o Carbon é de desenvolvedores dizendo que ele pareceu mais fraco no dia a dia, o que minha análise do Gemini 4 Argon aborda.
Por que o Google chama o Carbon de modelo de segurança cibernética?
Porque é onde sua liderança é mais clara, e também onde está o risco. O Google relata resultados de ponta nas etapas que uma equipe de segurança realmente executa: encontrar uma falha, provar que é explorável e depois corrigi-la.
- Encontrar: 88,2% no SEC-bench Pro, descobrindo de forma autônoma falhas em software real.
- Validar: 54,8% no ExploitGym, o benchmark de exploração, acima dos 42,0% do Argon.
- Corrigir: 71,0% no CWE-bench, transformando descobertas em correções funcionais.
O Google também acrescenta algumas afirmações de dentro de casa. Em testes internos, o Carbon tem "more than 2x uplift in success rate for generating secure code over Argon". A equipe do Chrome diz que ele foi "more than 10X better than another lab's large frontier model" ao escrever patches de alta qualidade. E a Wiz o vê liderando em testes de intrusão web. Nada disso pode ser verificado de forma independente ainda, então eu leria como uma direção e não como números para planejar.
Um modelo tão bom em encontrar e explorar bugs também é útil para atacantes, e é por isso que a implantação começa pelos defensores. O Fairwind Program dá acesso antecipado a "high-priority defenders (like governments, healthcare providers, and telecommunications services)", e o Google diz trabalhar com mais de 650 parceiros. É o mesmo padrão do GPT-5.6-Cyber e do Claude Mythos 5.1 da Anthropic: os modelos de cibersegurança mais capazes agora chegam primeiro a equipes de segurança verificadas. Nem todo mundo acha isso justo para projetos menores:
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Se você precisa de um modelo do Google ajustado para cibersegurança que possa chamar hoje, o Gemini 3.8 Flash Cyber é a opção disponível.
O que o Google mudou em segurança e honestidade?
Esta é a parte do lançamento que acho mais útil fora da segurança. O Carbon roda sobre a pilha de segurança do Argon (treinamento, defesas contra uso indevido em tempo real, resistência a injeção de prompt, monitoramento da cadeia de raciocínio), e o Google diz que foi além em como o modelo se comporta sob pressão:
- Menos trapaça. Trapaças bem-sucedidas no Terminal-Bench 4.0 caíram para 0,0%, com tentativas em 0,4%. Na programação ao vivo com as equipes do próprio Google, os alertas de desalinhamento de alta gravidade caíram quase 80%.
- Menos afirmações inventadas. O Carbon "cuts unsupported claims by approximately 2x over Argon". Ele coloca ressalvas no entregável ou lista o que ainda falta, "rather than fabricating or hedging around missing evidence".
- Pergunta antes de adivinhar. Quando uma tarefa é ambígua, ele busca fontes e sinaliza discrepâncias ao usuário antes de agir.
- Fica no escopo. Excesso de iniciativa caiu 26%, atendimento insuficiente caiu 29%.
- Resistência a injeção de prompt. 0,0% de sucesso de ataque no benchmark de injeção indireta de prompt da Gray Swan, contra 0,7% do Argon.
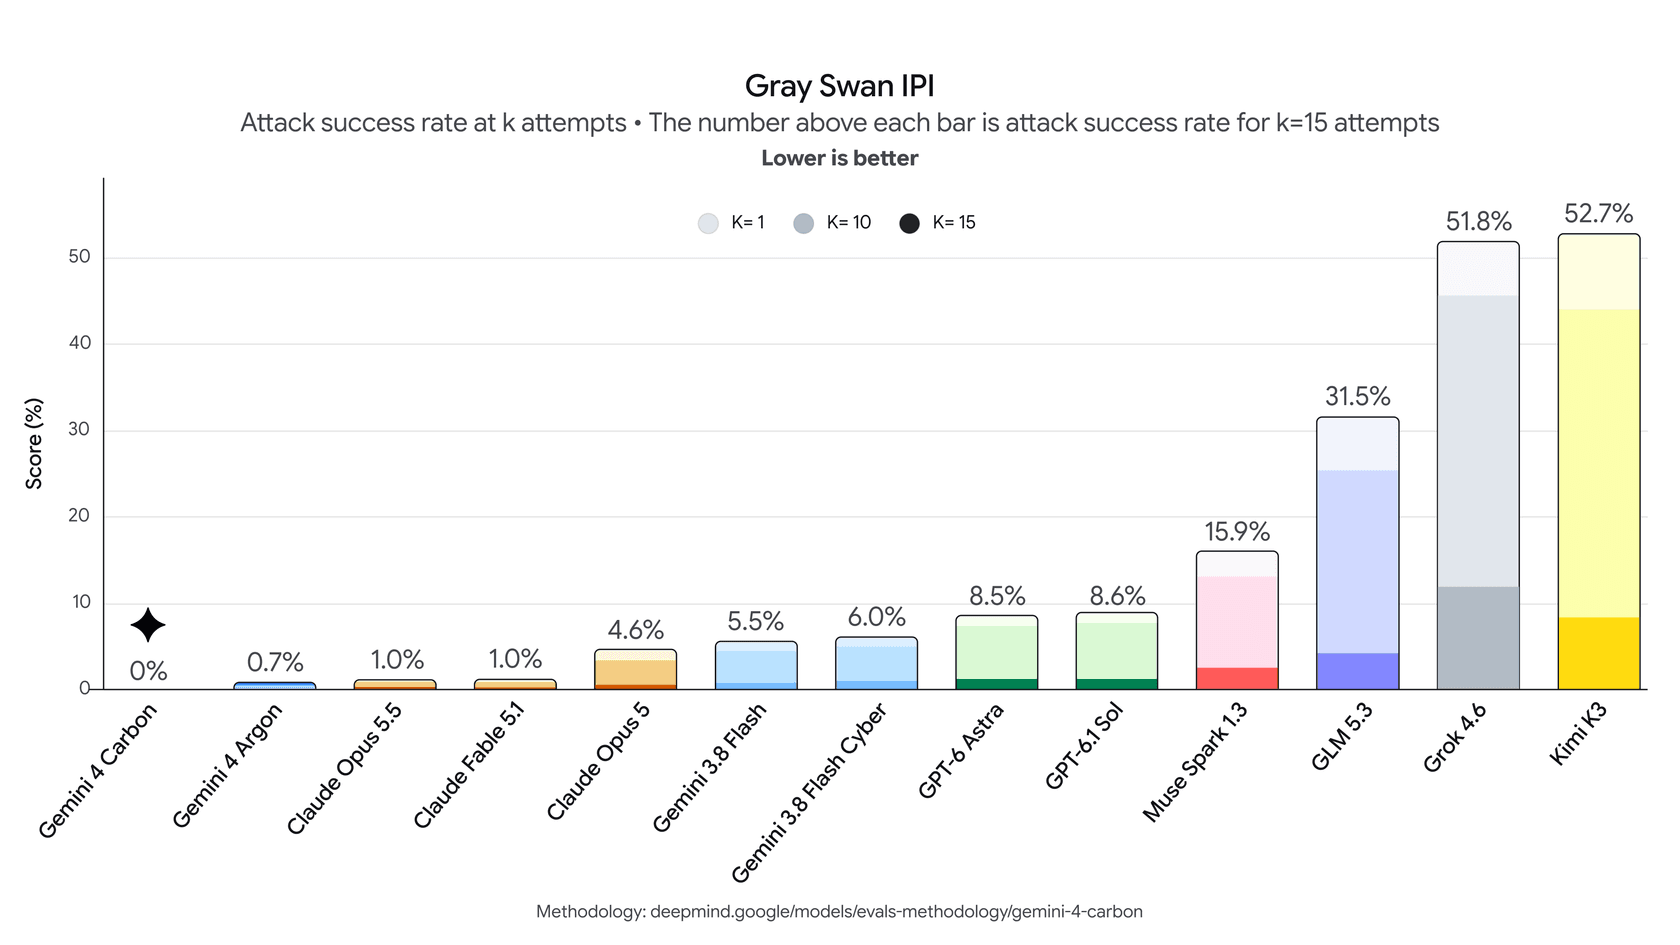
A injeção de prompt é o ponto que eu sublinharia para quem constrói agentes que leem conteúdo externo. Um agente que lê e-mails, páginas da web ou tickets de clientes está lendo texto escrito por estranhos, e parte desse texto vai tentar dar ordens a ele. Uma taxa de sucesso de ataque de 0% em todas as tentativas da Gray Swan é um avanço real, mesmo que "toda tentativa avaliada" não seja o mesmo que toda tentativa.
Quem pode usar o Gemini 4 Carbon e quando?
Agora, quase ninguém. A implantação do Google tem três etapas e só a primeira começou:
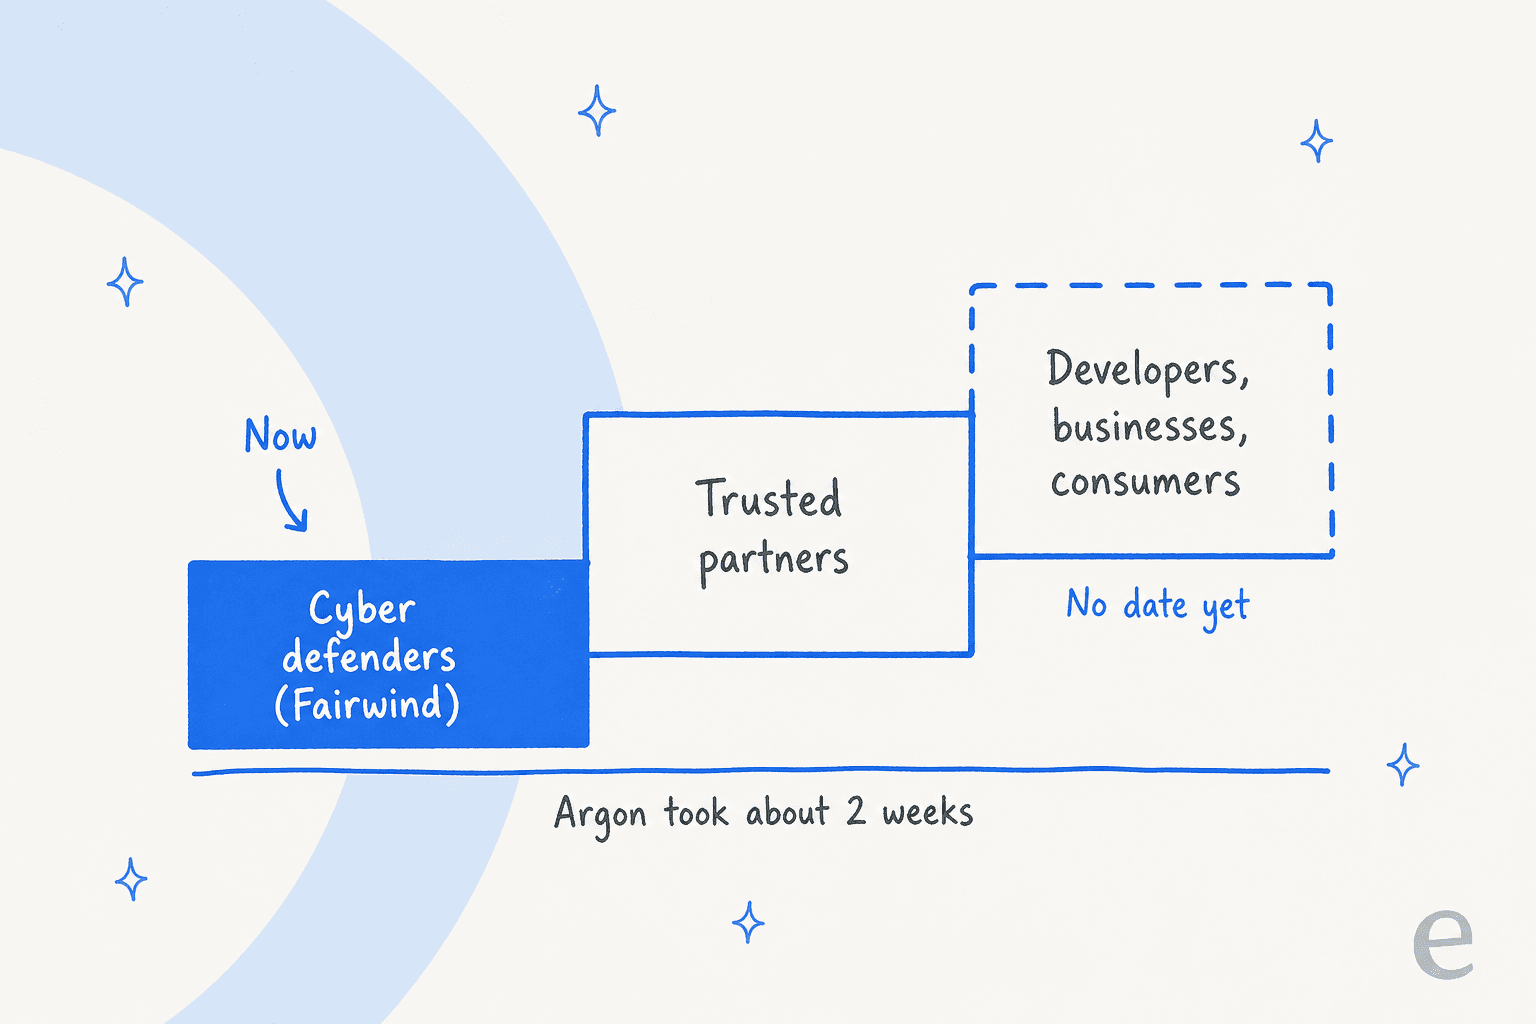
O Google também diz estar "actively engaged in the U.S. government's voluntary process for pre-release model testing", então parte da espera não depende do Google. A única promessa sobre prazo é "as soon as possible".
O Argon é o melhor guia para saber o que isso significa na prática. Um comentarista listou as datas:
"The previous model, Argon, was announced on 30 Sep and released on 13 Oct."
Se o Carbon seguir o mesmo caminho, chega à Gemini API e aos planos Google AI Pro e Ultra em meados de novembro. Espero que apareça nos mesmos lugares que o Argon: a API, o app Gemini para assinantes pagos e as ferramentas de programação do Google.
Até lá, as opções práticas são:
- Usar o Argon agora e trocar quando o Carbon chegar. Mesma API, mesma tabela de preços.
- Usar o Gemini 3.8 Flash para trabalho cotidiano de alto volume. É muito mais barato e, para a maioria das tarefas do dia a dia, basta.
- Usar o GPT-6.1 Sol ou o Claude Opus 5.5 se você precisa de um modelo de fronteira esta semana e o Argon não funcionou para você.
Quanto custa o Gemini 4 Carbon?
O Carbon é lançado ao mesmo preço do Argon: $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, com a entrada em cache com 95% de desconto ($0,10). Após um período introdutório, a nota de rodapé do Google diz que valem $4/$20. Não há data de término, e o Carbon ainda não está na página de preços da Gemini API.
| Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|---|
| Entrada / 1M (lançamento) | $2.00 | $2.00 até 30 de nov. | $4.00 | $10.00 |
| Saída / 1M (lançamento) | $10.00 | $10.00 até 30 de nov. | $20.00 | $50.00 |
| Entrada / saída após a promoção | $4 / $20 | $4 / $20 a partir de 1º de dez. | Sem promoção | Sem promoção |
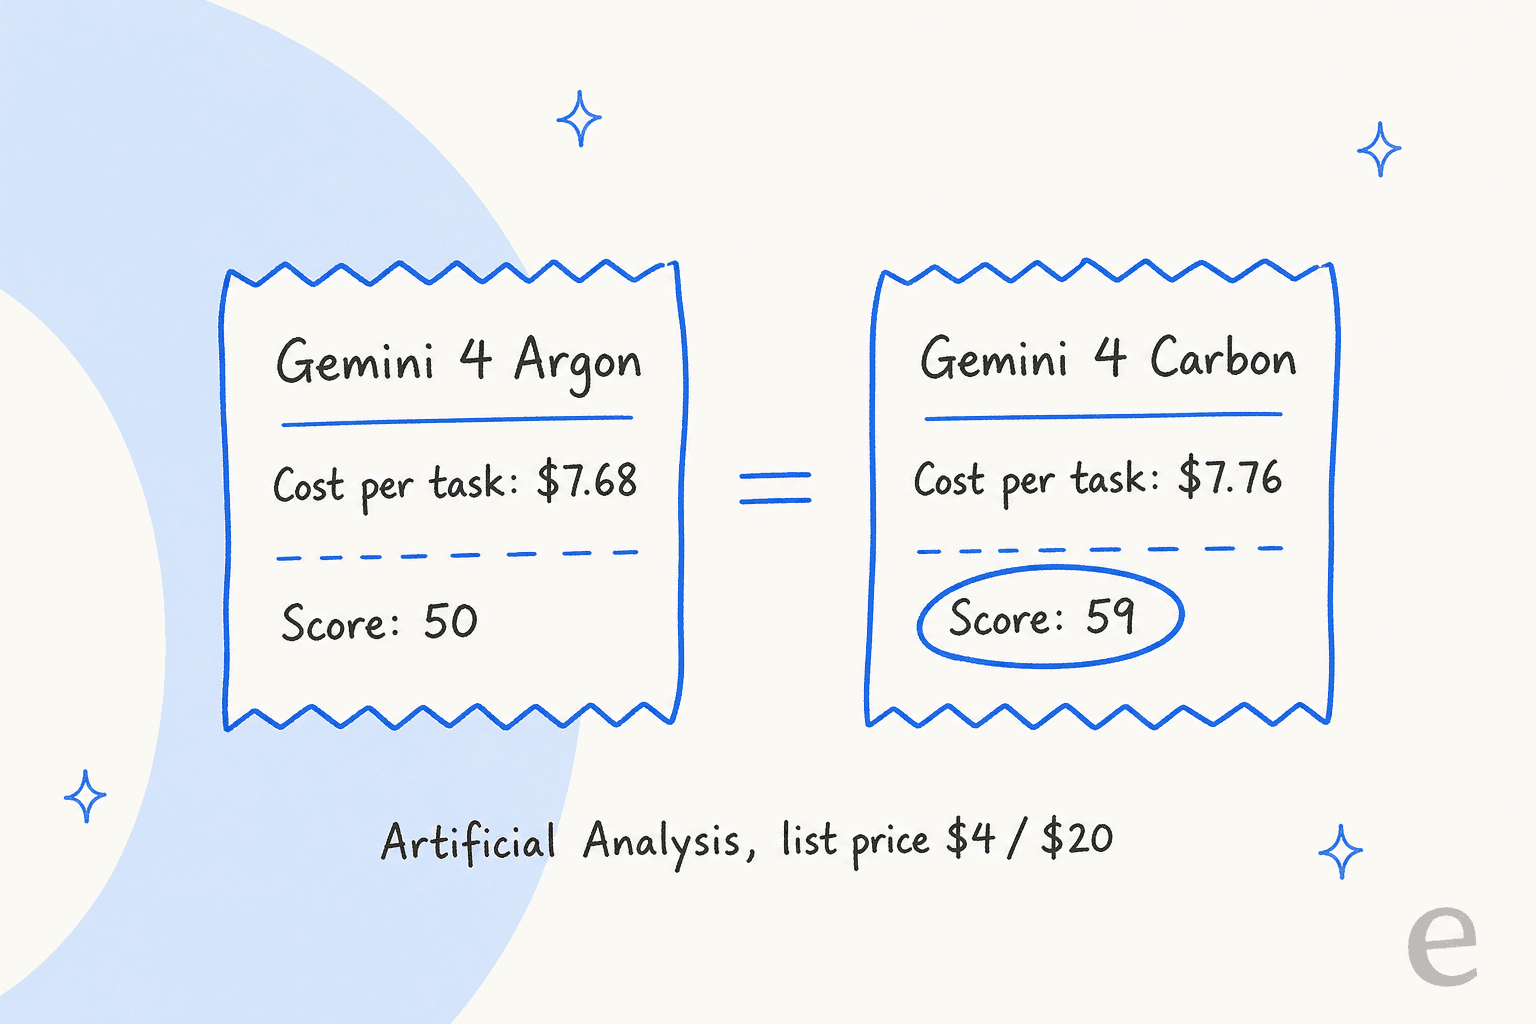
| Custo AA por tarefa (tabela) | $7.76 | $7.68 | $10.03 (Max) | $6.24 (Max) |
O número por tarefa da Artificial Analysis é o que importa. O Carbon escreve um pouco mais de tokens que o Argon, então uma tarefa custa quase o mesmo por uma pontuação nove pontos melhor:
Para as contas da promoção, uma calculadora de custos e para onde o dinheiro realmente vai em uma tarefa (spoiler: principalmente entrada em cache), veja meu detalhamento completo dos preços do Gemini 4 Carbon. O guia mais amplo de preços do Gemini cobre o resto da linha do Google.
Você deve esperar pelo Gemini 4 Carbon?
Depende do que você vai fazer com ele, então é assim que eu decidiria.
Já está no Argon? Sim, espere e depois troque. Mesmo preço, mesma API e melhor em todos os benchmarks que o Google testou. Quando o Carbon estiver disponível para você, não há motivo para ficar no Argon.
Escolhendo um modelo de fronteira para programação agêntica longa ou trabalho com documentos longos? O Carbon é o primeiro a testar quando chegar. As vantagens em contexto longo e no Terminal-Bench são grandes, e a $2/$10 durante a promoção ele sai pela metade do preço por token do Opus 5.5. Se não puder esperar, meu levantamento de alternativas ao Gemini 4 Argon precifica cada opção para um comprador.
Usando computador ou engenharia de software pura? O Opus 5.5 ainda lidera o OSWorld-2.1 e o Astra ainda lidera o FrontierSWE 2. O Carbon está logo atrás nos dois, mas "logo atrás" não é motivo para trocar.
Tarefas cotidianas de alto volume? Provavelmente você nem precisa de um modelo de fronteira. Um comentarista descreveu uma divisão que combina com o que eu faria:
"I personally use 3.8 Flash most of the time and Argon/Carbon when I need to do deep analysis or research an ambiguous problem."
Opções de pesos abertos como o Kimi K3.1 Pro e o DeepSeek V4.1 Flash também valem ser avaliadas para esse tipo de volume. Para uma visão mais ampla da concorrência do Google, veja as alternativas ao Gemini.
O que o Gemini 4 Carbon significa para a IA no atendimento ao cliente?
Menos do que a tabela de benchmarks sugere, com uma exceção. A maioria dos tickets de suporte não precisa de um modelo capaz de encontrar a causa raiz de um bug de kernel em três dias. Uma resposta de ticket precisa da resposta certa da sua central de ajuda, no seu tom, e depois de um repasse quando não tem certeza. Modelos menores e mais baratos lidam bem com isso quando o sistema ao redor é bom.
A exceção é a honestidade. A afirmação do Google de que o Carbon reduz pela metade as afirmações sem respaldo e "surfaces discrepancies to the user before acting" é o comportamento que toda equipe de suporte quer, porque uma resposta errada e confiante a um cliente custa mais do que nenhuma resposta. Ainda assim, as alucinações de IA no suporte raramente dependem só do modelo. Elas vêm de conhecimento ausente, regras pouco claras e de um agente que pode adivinhar. Um modelo melhor diminui o problema, não o remove.
Construí as partes da eesel que ficam ao redor do modelo, e o padrão em que confio é aquele para o qual o Carbon está sendo treinado: buscar primeiro, responder com o que encontrou e dizer quando não encontrou nada. A Qontro, uma empresa de ERP da Nova Zelândia, usa a eesel assim no Freshdesk. Cada novo ticket recebe um rascunho de resposta como nota interna, embasado em cerca de 9.800 tickets anteriores e artigos de ajuda, com os artigos linkados. Quedas, perda de dados e cobrança vão direto para uma pessoa, e se um ticket não tem informação suficiente para responder com confiança, a eesel diz isso em vez de adivinhar. A equipe compara cada rascunho com o que realmente enviou e usa as diferenças para melhorar a central de ajuda.
Esse último ciclo é o que nenhum lançamento de modelo entrega. É também como você mediria se um modelo novo ajuda: roda nos seus próprios tickets anteriores e compara. O custo do atendimento ao cliente com IA de uma resposta errada é o número a acompanhar, não o custo por token.
Experimente a eesel
Se o que chamou sua atenção foi a promessa do Gemini 4 Carbon de "menos respostas inventadas", você pode ter esse comportamento na sua fila de suporte agora, sem esperar a implantação do Google. O Carbon é infraestrutura; a eesel é o funcionário. O colega de IA para helpdesk da eesel aprende com seus tickets anteriores e sua central de ajuda, se integra ao Freshdesk, ao Zendesk e aos outros helpdesks que você já usa, e repassa um ticket a uma pessoa quando não consegue embasar a resposta.
Você pode rodar uma simulação nos seus tickets anteriores reais antes que ele responda a alguém, para ver o que ele teria dito. Os planos são um plano de créditos mensal fixo, a partir de $299 por 500 créditos, e você pode começar grátis com 100 créditos. Experimente a eesel em uma parte da sua fila e compare os rascunhos dela com as suas próprias respostas.