

O que é o EmbeddingGemma 2?
O EmbeddingGemma 2 é um modelo de embeddings aberto do Google DeepMind, anunciado em 6 de outubro de 2026.
Um modelo de embeddings faz uma única coisa: transforma uma entrada em uma lista de números (um vetor) para que coisas parecidas fiquem próximas. Esse é o motor por baixo da busca semântica, do clustering e da metade de recuperação do RAG.
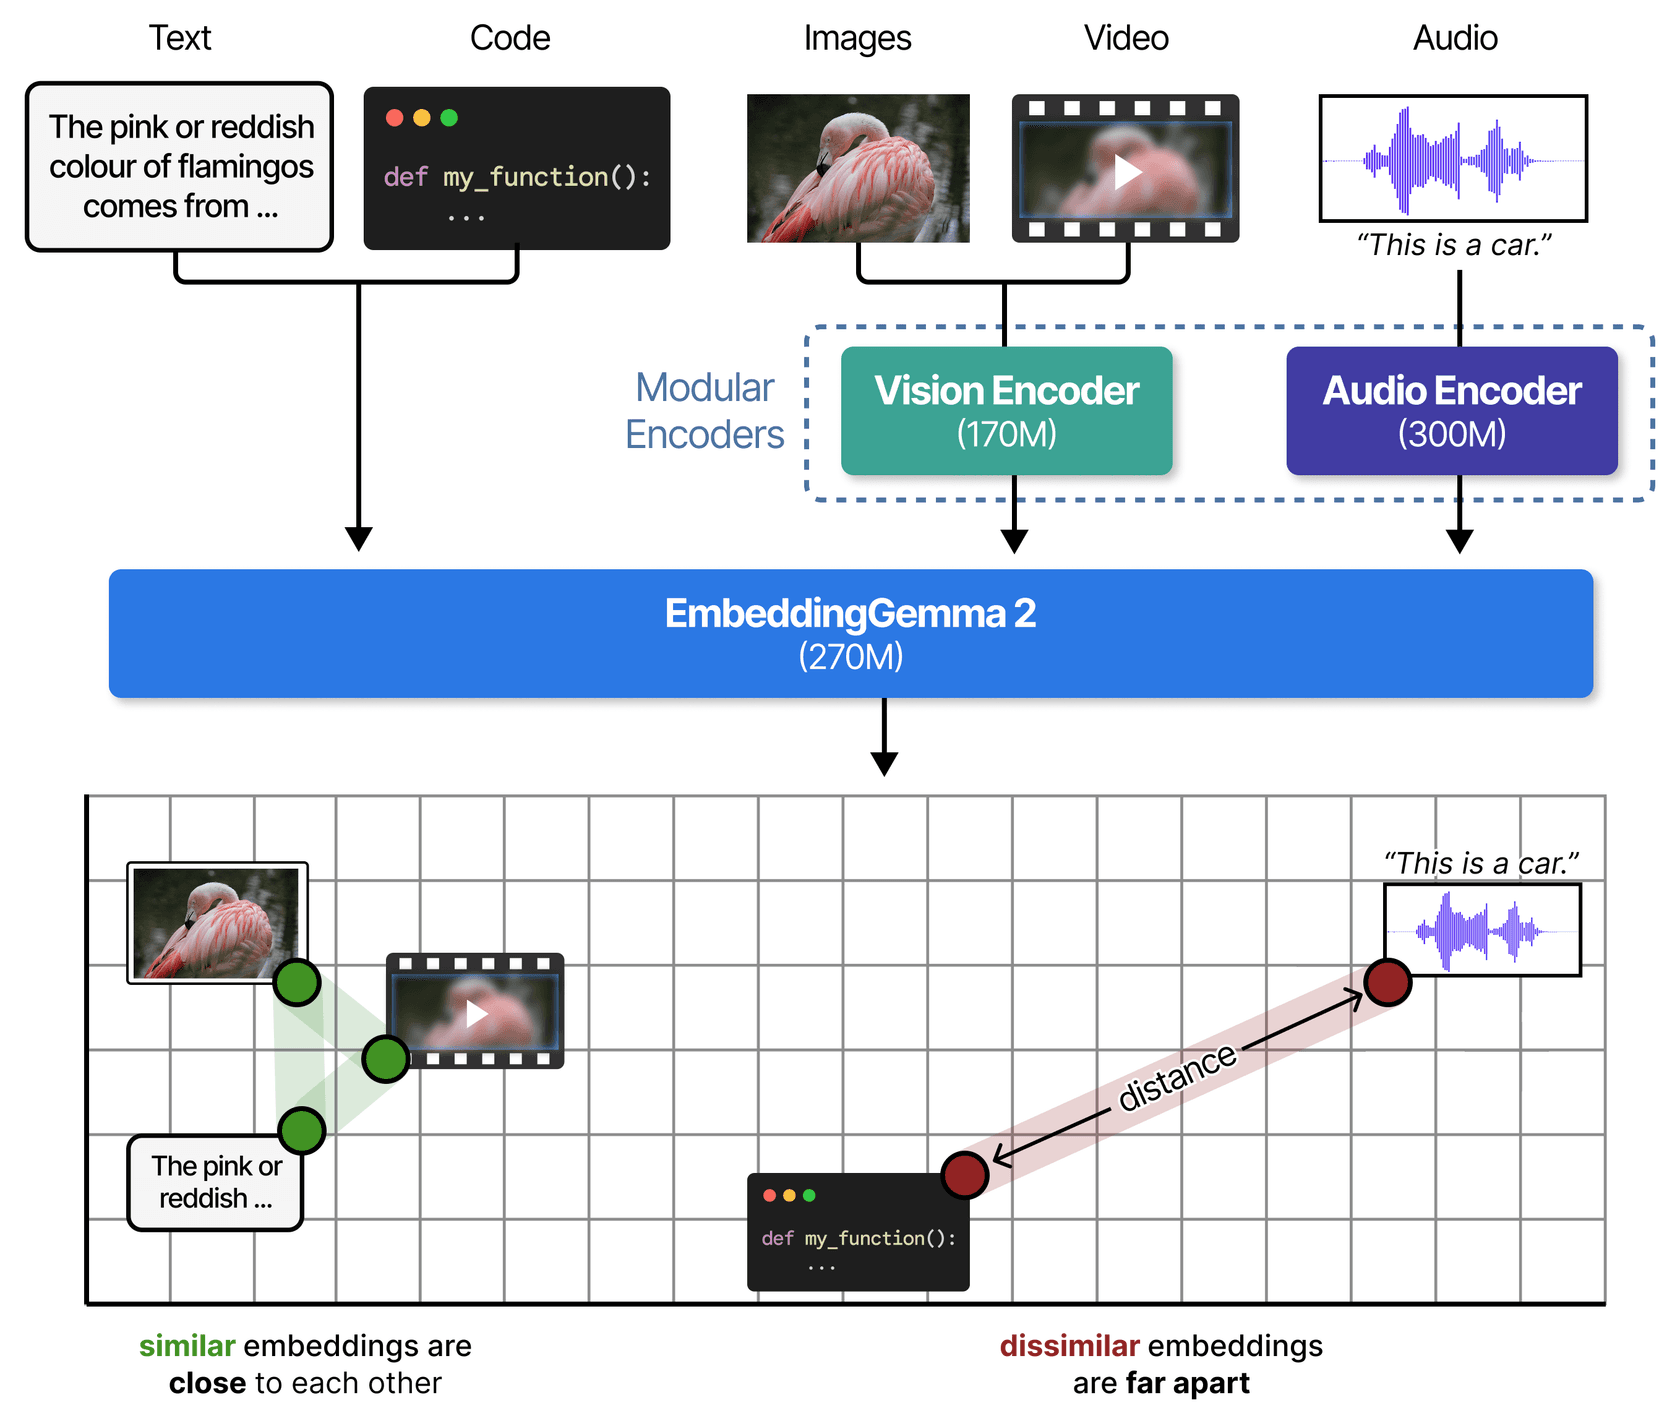
O primeiro EmbeddingGemma, um modelo de 308M só de texto, saiu em 2025 e passou de 20 milhões de downloads, segundo o Google. A versão 2 mantém a ideia de um modelo pequeno que roda em qualquer lugar e o torna multimodal com mais quatro tipos de entrada. Segundo a model card, ele mapeia texto (incluindo código), imagens, vídeo e áudio, ou qualquer mistura deles, em um único espaço de 768 dimensões.
Uma observação rápida sobre de onde falo. Sou engenheiro de software na eesel e construo os agentes de IA que pesquisam a central de ajuda de um cliente antes de responder a um ticket. Então, quando leio o lançamento de um modelo de embeddings, me interesso menos pelo ranking e mais por três perguntas: o que ele encontra que o anterior não encontrava, quanto custa rodar e o que quebra. Não coloquei este modelo em produção. Minha leitura vem da model card e da documentação do Google, do guia para desenvolvedores e dos três primeiros dias de relatos práticos no Hacker News.
EmbeddingGemma 2 em resumo
| Spec | EmbeddingGemma 2 | Fonte |
|---|---|---|
| Lançamento | 6 de outubro de 2026 | Google blog |
| Parâmetros | 740M no total: 270M texto, 170M visão, 300M áudio | Model card |
| Entradas | Texto, código, imagens, vídeo, áudio e misturas intercaladas | Model card |
| Saída | 768 dimensões, truncável para 512, 256, 128 | Developer guide |
| Janela de contexto | 8,192 tokens (v1: 2,048) | Model card |
| Idiomas | Mais de 100 | Gemma docs |
| RAM, quantizado, Pixel 11 Pro | ~191MB só texto, ~567MB completo | Google AI Edge |
| Licença | Apache 2.0 | Gemma docs |
| Preço | Pesos gratuitos; você paga pelo processamento | n/a |
| Base | Arquitetura de decodificador do Gemma 4 | Gemma docs |
Como o EmbeddingGemma 2 funciona?
Por dentro, é um modelo de texto pequeno com dois complementos opcionais acoplados na frente. O núcleo é um modelo de 270M de parâmetros (um transformer de 130M mais um embedder de 140M) adaptado do decodificador do Gemma 4. Um codificador de visão de 170M cuida de imagens, quadros de vídeo e documentos visuais como PDFs e slides. Um codificador de áudio de 300M recebe fala e som brutos. Tudo passa pela mesma base e sai como um único vetor de 768 números.
O mais esperto é que os complementos são opcionais na hora de carregar. Você define vision_config ou audio_config como None e esse codificador nunca é carregado, economizando disco e memória. Segundo o guia para desenvolvedores do Google, as quatro configurações carregam do mesmo checkpoint e compartilham um espaço vetorial. Uma consulta gerada com a configuração só de texto de 270M pode corresponder a documentos gerados com o modelo completo.
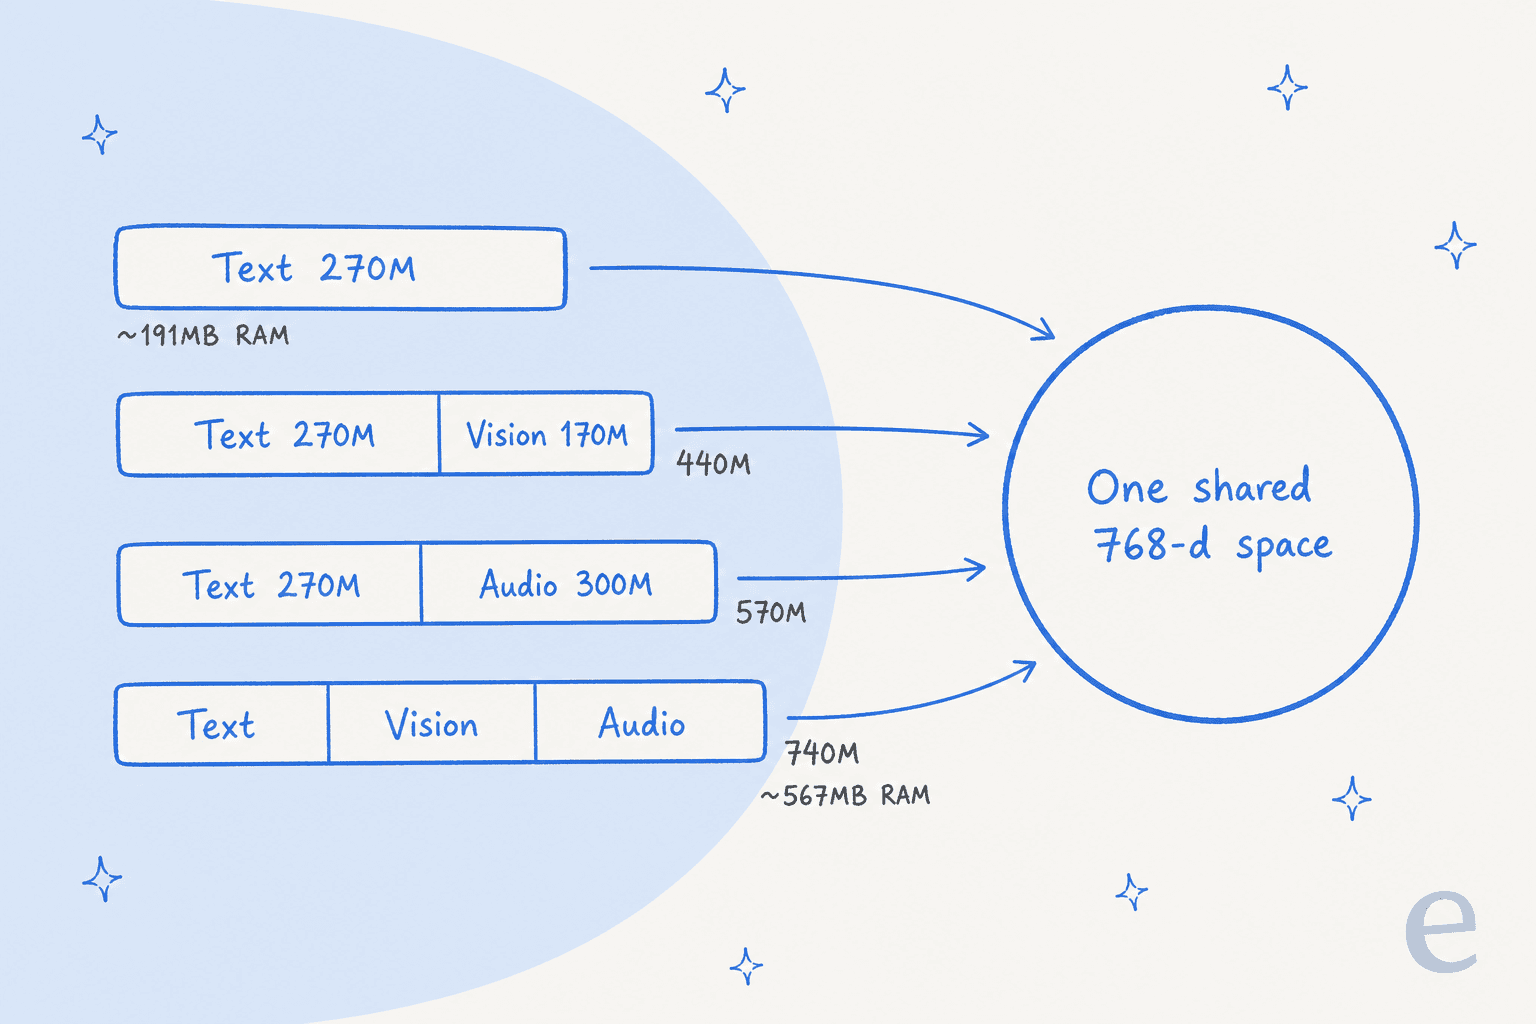
Isso tem uma vantagem prática de que gosto muito. Você pode começar só com texto e adicionar imagens depois sem recalcular um único vetor que já tem, diz o guia. Se você já gerou de novo os embeddings de um milhão de documentos porque trocou de modelo, sabe o quanto isso vale.
As entradas dividem a janela de contexto de 8,192 tokens em taxas fixas, contadas em tokens. Uma imagem custa 280 tokens por padrão, um quadro de vídeo custa 140 e um segundo de áudio custa 25. Assim, uma única chamada comporta cerca de 29 imagens, 58 quadros de vídeo ou 327 segundos de áudio, segundo a model card.
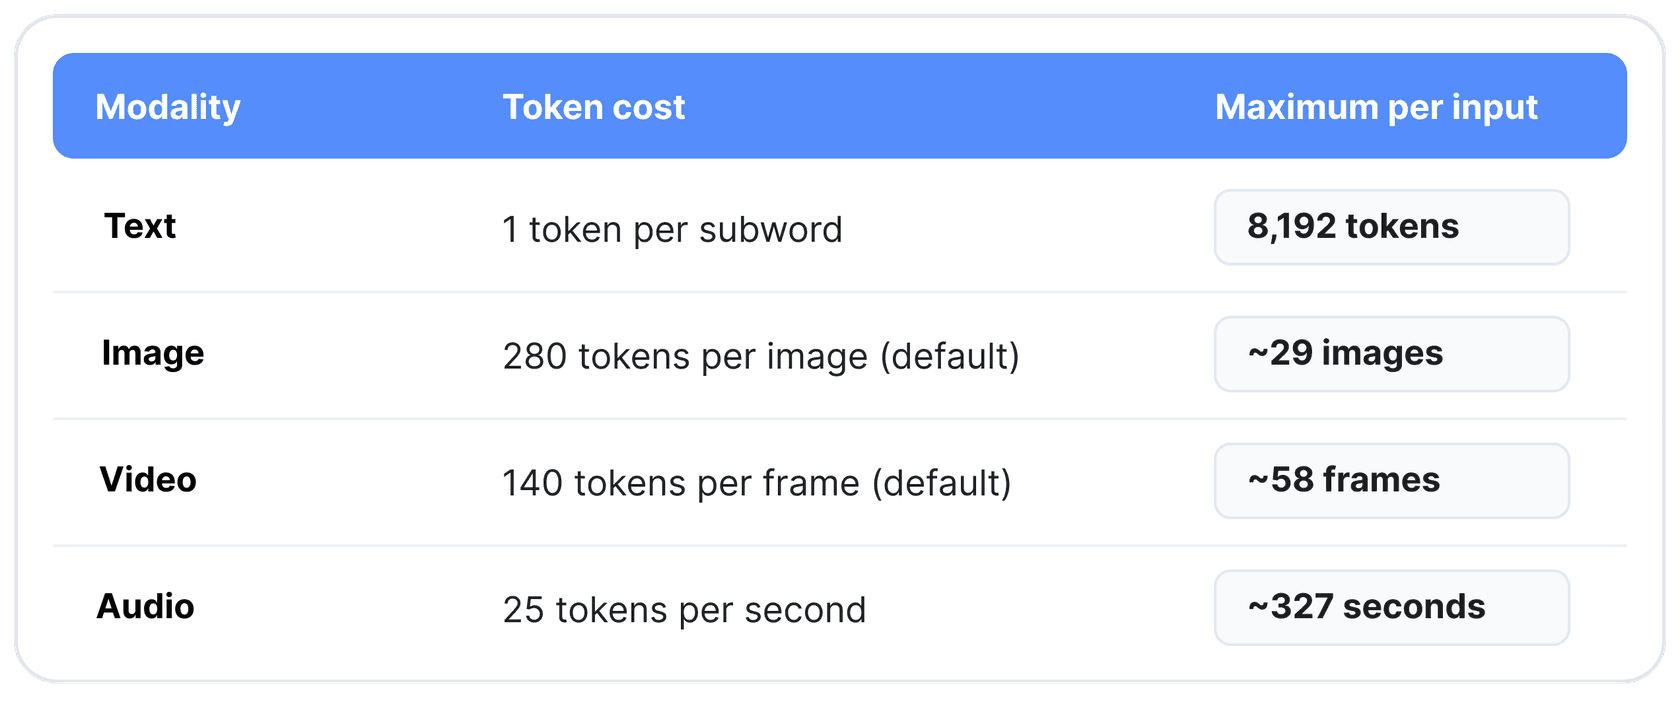
Algumas mecânicas que vale conhecer antes de escrever código:
- O vídeo é amostrado a 1 quadro por segundo por padrão, e o áudio precisa ser mono a 16 kHz.
- O detalhe da imagem é um controle. A documentação multimodal lista cinco orçamentos por imagem: 70, 140, 280, 560 ou 1,120 tokens. Mais tokens significam mais detalhe e execuções mais lentas.
- Você pode intercalar. Uma entrada pode misturar texto com marcadores
<|image|>,<|video|>e<|audio|>, como uma página de produto com uma foto e um clipe de demonstração, e ainda assim sai como um único vetor. - O texto recebe um prefixo de tarefa, a mídia não. As consultas ficam como
task: search result | query: ...e os documentos comotitle: ... | text: .... Pular o prefixo funciona, mas custa precisão.
O que mudou em relação ao EmbeddingGemma 1?
Aqui eu iria mais devagar, porque o discurso do lançamento e os números contam histórias um pouco diferentes. O anúncio do Google diz que a v2 iguala o desempenho de texto multilíngue da v1 e dá um salto em código. Isso é verdade. Mas a model card também traz o MTEB em inglês, e nele a v2 fica um pouco atrás.
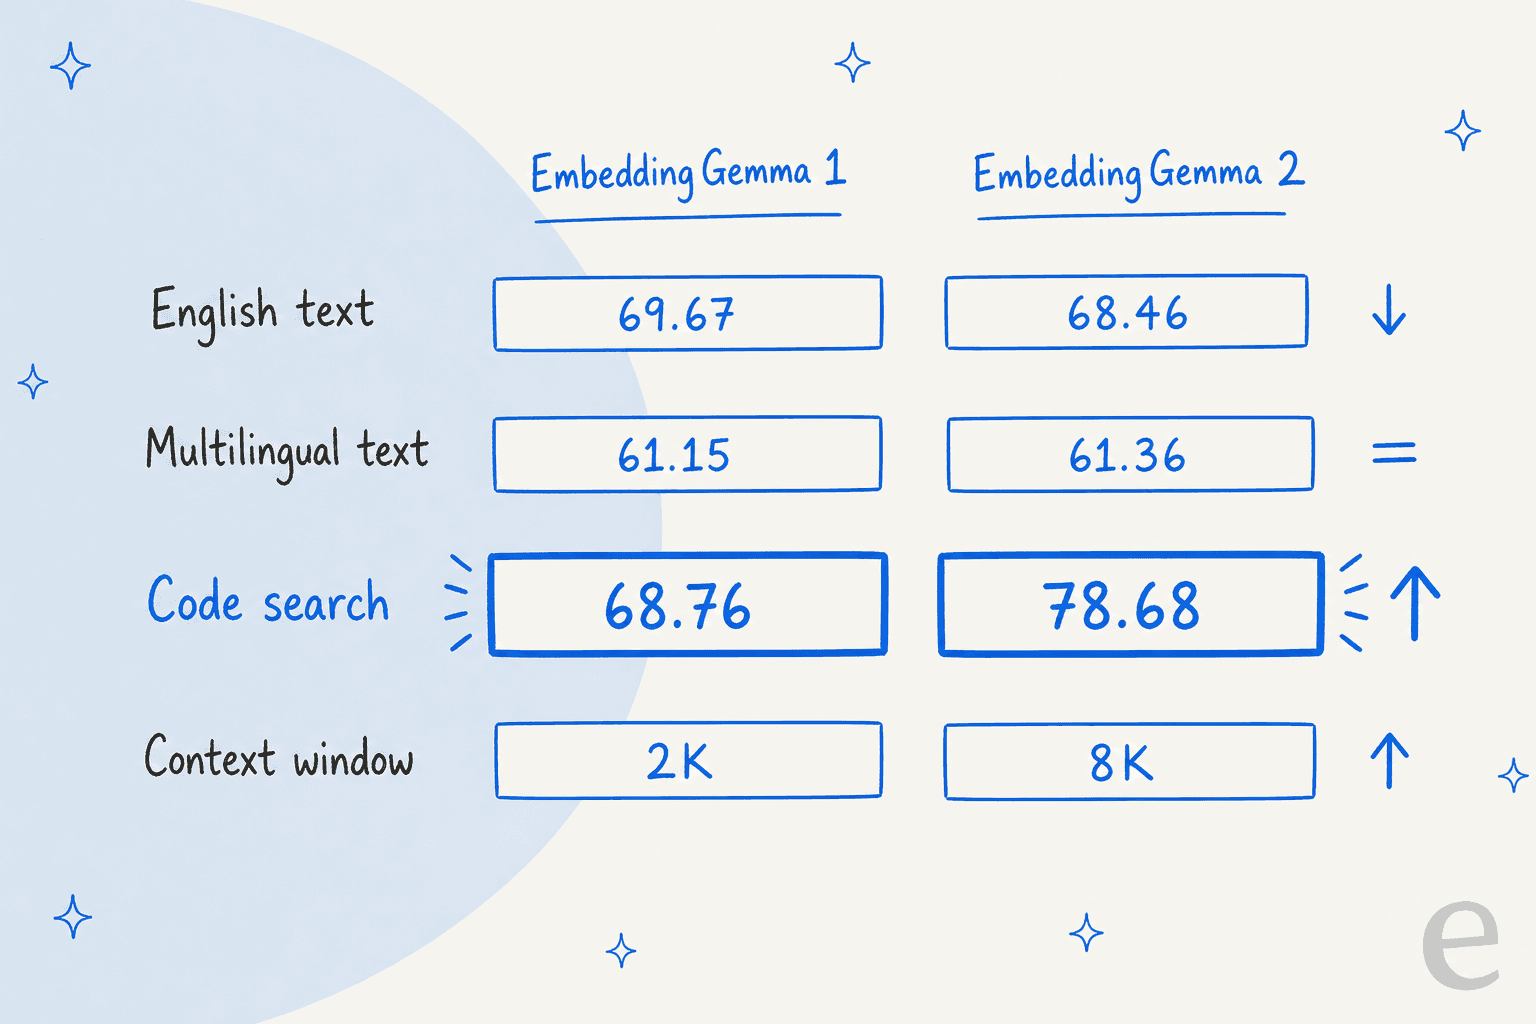
| Benchmark (768 dim.) | EmbeddingGemma 1 | EmbeddingGemma 2 | Mudança |
|---|---|---|---|
| MTEB English v2 | 69.67 | 68.46 | -1.21 |
| MTEB Multilingual v2 | 61.15 | 61.36 | +0.21 |
| MTEB Code v1 | 68.76 | 78.68 | +9.92 |
| Janela de contexto | 2,048 tokens | 8,192 tokens | 4x |
| Entradas | Texto | Texto, código, imagem, vídeo, áudio | +4 |
| Licença | Termos do Gemma, download restrito | Apache 2.0 | Aberta |
Os números da v1 vêm da card do EmbeddingGemma 300M e os da v2 da card da v2. Os primeiros testadores chegaram ao mesmo ponto:
"for text, benchmarks are identical to the first EmbeddingGemma. but you can use this new one and enable/disable what you don't need. can keep only text for ex."

Minha leitura é simples. Se você só busca texto em inglês, a v2 é um movimento lateral, e a atualização só vale a pena se o contexto 4 vezes maior ajudar (menos trechos, porém maiores) ou se a licença Apache destravar um produto. Se você busca código, ou qualquer coisa que não seja texto, é um grande passo. Para uma central de ajuda que é na maior parte artigos, minha visão sobre RAG vs. fine-tuning importa mais do que esta atualização.
O que dizem os novos benchmarks
Para os novos tipos de entrada não há v1 para comparar, então as pontuações da model card valem por si. O Google o chama de "best-in-class" entre os modelos de embeddings multimodais abaixo de 1B no MTEB Code e no MAEB, o benchmark de áudio. É uma afirmação do fabricante sem tabela comparativa direta na card, então trate-a como ponto de partida.
| Entrada | Benchmark | Pontuação |
|---|---|---|
| Imagem | MIEB lite | 64.64 |
| Imagem | MMEB v2 Image (Hit@1) | 57.28 |
| Documentos visuais | MMEB v2 VisDoc (NDCG@5) | 67.84 |
| Vídeo | MMEB v2 Video (Hit@1) | 50.67 |
| Áudio | MSEB Retrieval (MRR@10) | 69.54 |
| Áudio | MAEB | 49.39 |
Duas coisas que eu destacaria do tópico do HN. Um comentarista perguntou por que não há comparação com o SigLIP 2, o modelo de imagem e texto do próprio Google. Outro o rodou localmente e descobriu que o exemplo de classificação zero-shot da própria demo do Google errou:
"I got this running locally, and funnily enough the exact example they have for classifying "Cancel my flight and refund my credit card immediately." failed. It said the request does not involve a payment, charge, or refund, with a p(true) of 0.22 (where true means it is financial)."
Isso incomoda um pouco para quem pensa em usá-lo no roteamento de tickets, já que "reembolso ou não" é exatamente o tipo de rótulo que uma equipe de suporte quer. Um dado não é um veredito, mas é um bom motivo para testar com seus próprios tickets antes de ligá-lo a qualquer coisa.
Há também uma pegadinha mais discreta na documentação multimodal: as pontuações de similaridade não são calibradas entre modalidades. Uma pintura sem relação obteve 0,585 contra uma foto da Golden Gate, mais do que prompts de texto sem relação. Compare a posição dentro de uma busca, não as pontuações brutas entre imagens e texto.
Qual é, de fato, a velocidade e o tamanho?
É aqui que o EmbeddingGemma 2 merece o rótulo "on-device". A equipe de AI Edge do Google publicou números por dispositivo para gerar o embedding de uma imagem com orçamento de 70 tokens:
| Dispositivo | Chip | Latência por imagem | Imagens/s |
|---|---|---|---|
| iPhone 18 Pro | CPU | 191 ms | 5.2 |
| iPhone 18 Pro | GPU | 69.8 ms | 14.3 |
| Pixel 11 Pro XL | NPU | 48.9 ms | 20.6 |
| MacBook M5 Pro | GPU | 37.3 ms | 26.9 |
| Dell XPS 16 | NPU | 49.8 ms | 20.1 |
| Raspberry Pi 5 | CPU | 1,761 ms | 0.6 |
Os números reais de um notebook são parecidos. Um comentarista do HN compartilhou o desempenho em um M3 Pro:
"Text: 78 embeddings/second on small texts - Image: 4 embeddings/second - Audio: 6 embeddings/second for 30 second chunks (which is how the encoder works) - Video: 0.2 embeddings/second per minute of video"
Repare na diferença. Vídeo a 0,2 por minuto de gravação significa que uma hora de vídeo leva cerca de cinco minutos para ser indexada nesse notebook. Bom para uma biblioteca de demos de produto. Lento demais para vídeo ao vivo e em grande volume.
O armazenamento é a outra alavanca. O modelo usa treinamento Matryoshka, então você pode cortar os vetores de 768 números para 512, 256 ou 128 e manter a maior parte da qualidade. Segundo o guia para desenvolvedores, um milhão de vetores de 768 dimensões ocupam cerca de 1,5GB em bfloat16, e cerca de 250MB com 128 dimensões.
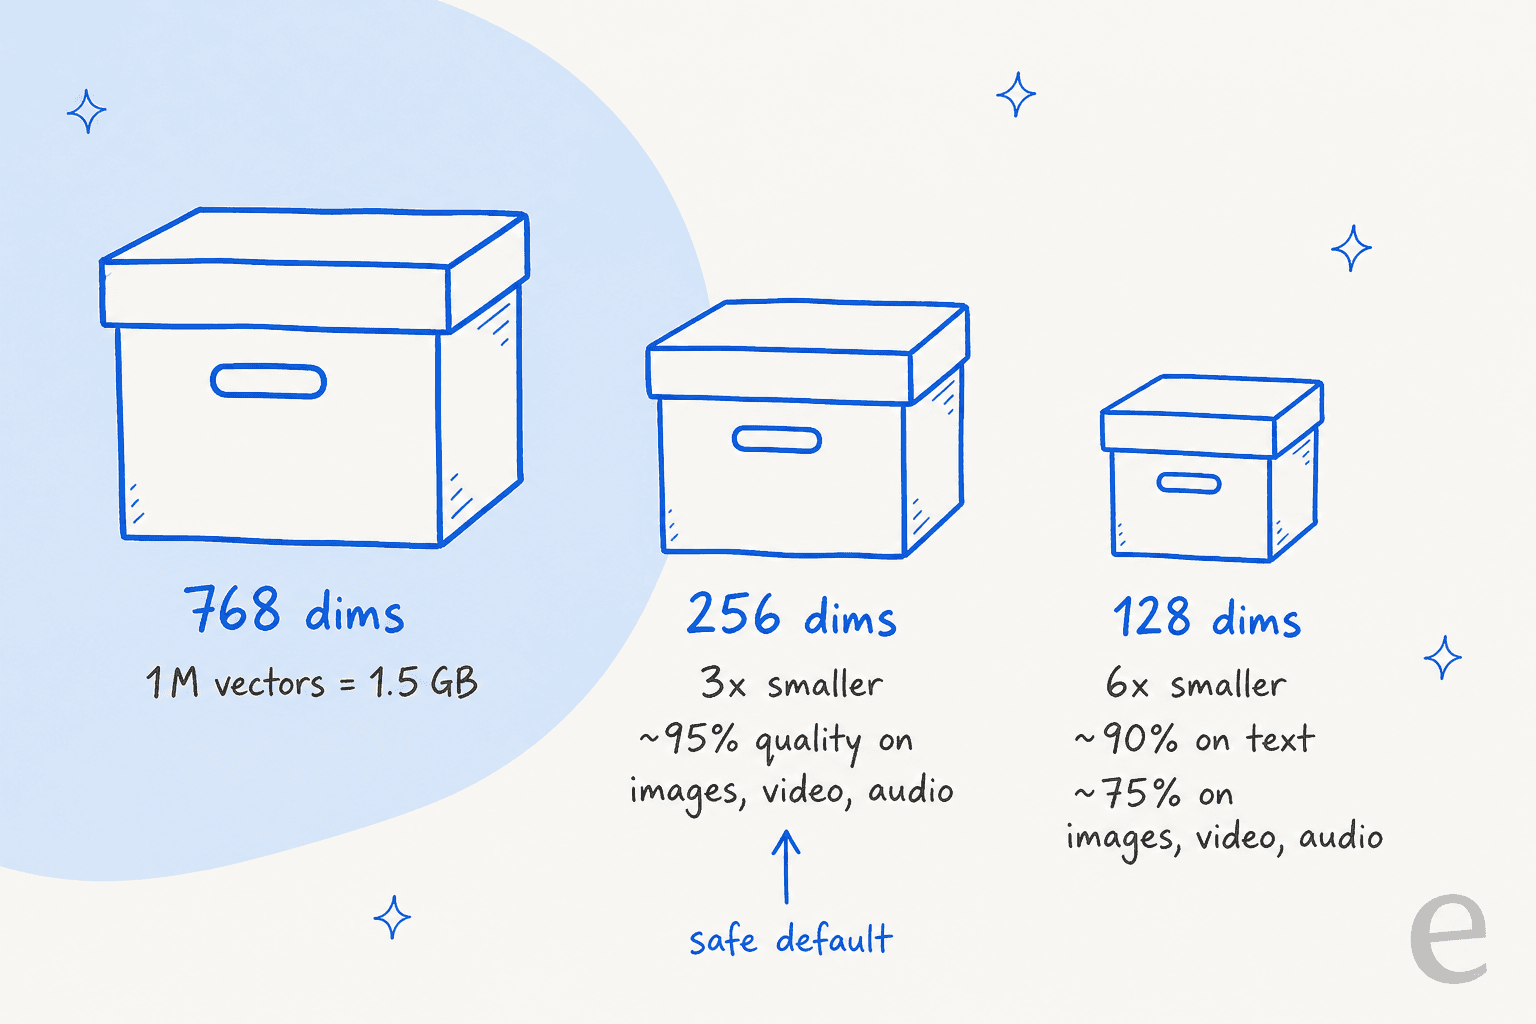
O problema é que a mídia se degrada mais rápido que o texto ao comprimir. Na model card, o MMEB v2 cai de 59,01 com 768 dimensões para 45,65 com 128. Para um índice misto, eu pararia em 256 dimensões e só iria a 128 para listas curtas só de texto que você reordena depois. Duas regras da card que vão pegar você se ignorá-las: normalize os vetores de novo depois de truncar e nunca o execute em float16. As ativações estouram e você obtém NaNs ou vetores silenciosamente piores, sem nenhum erro.
Qual configuração do EmbeddingGemma 2 você deve carregar?
Como você só paga memória pelos codificadores que carrega, a primeira decisão é o que seu índice realmente contém. Escolha a opção mais próxima:
O que entra no seu índice de busca?
Toque em uma opção para ver a configuração com a qual eu começaria.
vision_config=None, audio_config=None. Nota honesta: para busca só em inglês, a v1 pontuou um pouco mais (69,67 contra 68,46). Troque se precisar do contexto de 8K ou do Apache 2.0, não por precisão. 256 dimensões é um corte de armazenamento seguro.CodeRetrieval nas consultas e coloque o nome do arquivo no título do documento. Fique em 512 ou 768 dimensões; o código perde qualidade mais rápido ao truncar.audio_config=None. A visão cobre imagens, PDFs, slides e gráficos (MMEB v2 VisDoc 67,84). Aumente o orçamento de imagem para 560 ou 1,120 tokens se suas capturas tiverem texto pequeno. Mantenha 256 dimensões ou mais.vision_config=None. Reamostre o áudio para mono a 16 kHz e divida em trechos; uma chamada comporta cerca de 327 segundos. Ele corresponde ao conteúdo da fala, não apenas a "isto é fala", mas teste primeiro com suas próprias chamadas.Como executar o EmbeddingGemma 2?
Os pesos estão no Hugging Face e no Kaggle (novo na plataforma? comece pela minha explicação sobre o Hugging Face), e o suporte desde o primeiro dia é amplo: sentence-transformers (v6.1.0 ou posterior), Transformers, vLLM, SGLang, MLX, llama.cpp GGUF, Ollama, LM Studio e o LiteRT do próprio Google para celulares. O caminho mais curto, direto da model card:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
Se você prefere não mexer com Python, a versão do Ollama se encaixa na maioria das stacks de RAG locais, e frameworks como LangChain e LlamaIndex vão tratá-lo como qualquer outro gerador de embeddings.
Para um exemplo prático de suporte, veja meu passo a passo do pipeline de RAG para suporte ou este guia de busca semântica no Zendesk. Você ainda precisa de um lugar para guardar os vetores; a Qdrant publicou um guia no dia do lançamento, e meu texto sobre RAG vs. bancos de dados vetoriais explica como escolher.
Em celulares, o Google vai levá-lo ao Android como um serviço gerenciado do ML Kit "nas próximas semanas", com aceleração por NPU. Até lá, o app AI Edge Gallery é a forma mais fácil de experimentar. Sua demo Instant Media Search pesquisa o rolo da câmera enquanto você digita, offline, e o Video Moments Finder salta para marcações de tempo em consultas como "cachorro pegando um frisbee" sem transcrição.
Hospedar por conta própria ou usar o Gemini Embedding 2?
Este é o segundo reenquadramento que eu ofereceria. O EmbeddingGemma 2 é gratuito para baixar, e as pessoas costumam presumir que isso o torna a opção barata. Para a maioria das equipes, não é muito mais barato, porque o irmão hospedado do Google já é baratíssimo.
O Gemini Embedding 2 é a API paga de embeddings multimodais do Google, e é o único modelo de embeddings na lista de preços atual da API do Gemini. (Se você está comparando a API do Google de forma mais ampla, veja API da OpenAI vs. API do Gemini.) Meu texto sobre os preços do Gemini cobre o restante; aqui estão as tarifas de embeddings:
| Entrada | Padrão (por 1M de tokens) | Lote | Por unidade (padrão) |
|---|---|---|---|
| Texto | $0.20 | $0.10 | n/a |
| Imagem | $0.45 | $0.225 | $0.00012 por imagem |
| Áudio | $6.50 | $3.25 | $0.00016 por segundo |
| Vídeo | $12.00 | $6.00 | $0.00079 por quadro |
Agora um exemplo prático para uma equipe de suporte de médio porte. Digamos 2,000 artigos de ajuda com cerca de 800 tokens cada (1,6M de tokens), 10,000 capturas de tela de produto e 100 horas de chamadas gravadas:
- Artigos: 1,6M de tokens x $0.20 = $0.32
- Capturas de tela: 10,000 x $0.00012 = $1.20
- Chamadas: 360,000 segundos x $0.00016 = $57.60
Isso dá menos de $60 para gerar os embeddings de toda a biblioteca uma vez nas tarifas padrão, e metade disso em lote. Uma GPU alugada pelos $1 a $2 por hora que um comentarista do HN citou ficaria ligada mais tempo do que isso só para começar. Então eu enquadraria a escolha assim:
- Use o Gemini Embedding 2 se seus dados podem ir para a API do Google e você quer zero configuração. Só observe que os dados do plano gratuito podem ser usados para melhorar os produtos do Google; os do plano pago não.
- Use o EmbeddingGemma 2 se os dados não podem sair do dispositivo ou dos seus próprios servidores (saúde, jurídico, suporte interno), se você precisa dele offline ou se gera embeddings de consultas em um celular e não quer ida e volta. Esses são motivos reais. Custo sozinho normalmente não é.
Simon Willison defendeu bem o caso dos modelos de embeddings abertos:
"I really appreciate that EmbeddingGemma 2 is under the Apache 2.0 license. For embedding models in particular, I don't think it makes sense to use a closed, proprietary, hosted-only model."
O ponto dele é mais sobre dependência de fornecedor do que sobre preço. Cada vetor do seu índice está preso ao modelo que o gerou. Se um modelo hospedado for descontinuado, você precisa gerar tudo de novo. Com pesos abertos, o modelo com o qual você indexou continua disponível enquanto você guardar uma cópia.
Por que as equipes de suporte deveriam se importar com a parte multimodal
Este é o ângulo que não vi na cobertura do lançamento. A maior parte do que se escreve sobre RAG para atendimento ao cliente assume que o conhecimento é texto. Na prática, muito dele não é, e isso aparece o tempo todo nas chamadas de vendas da eesel.
Uma marca DTC de suplementos com cerca de 7,000 tickets por mês disse que suas respostas estavam em SOPs do ClickUp, vídeos do Loom sem transcrição e macros antigas. Uma empresa de TI do setor público que atende cerca de 3,000 tickets complexos por mês roda no Freshdesk com documentação técnica cheia de imagens. Equipes de produtos técnicos pedem sempre uma IA que consiga ler os diagramas dentro dos PDFs e as fotos que os clientes anexam aos tickets. Modelos de embeddings só de texto não enxergam nada disso a menos que alguém transcreva ou legende antes, e é por isso que tantas ferramentas de base de conhecimento para suporte ainda tratam mídia como anexo, não como resposta.
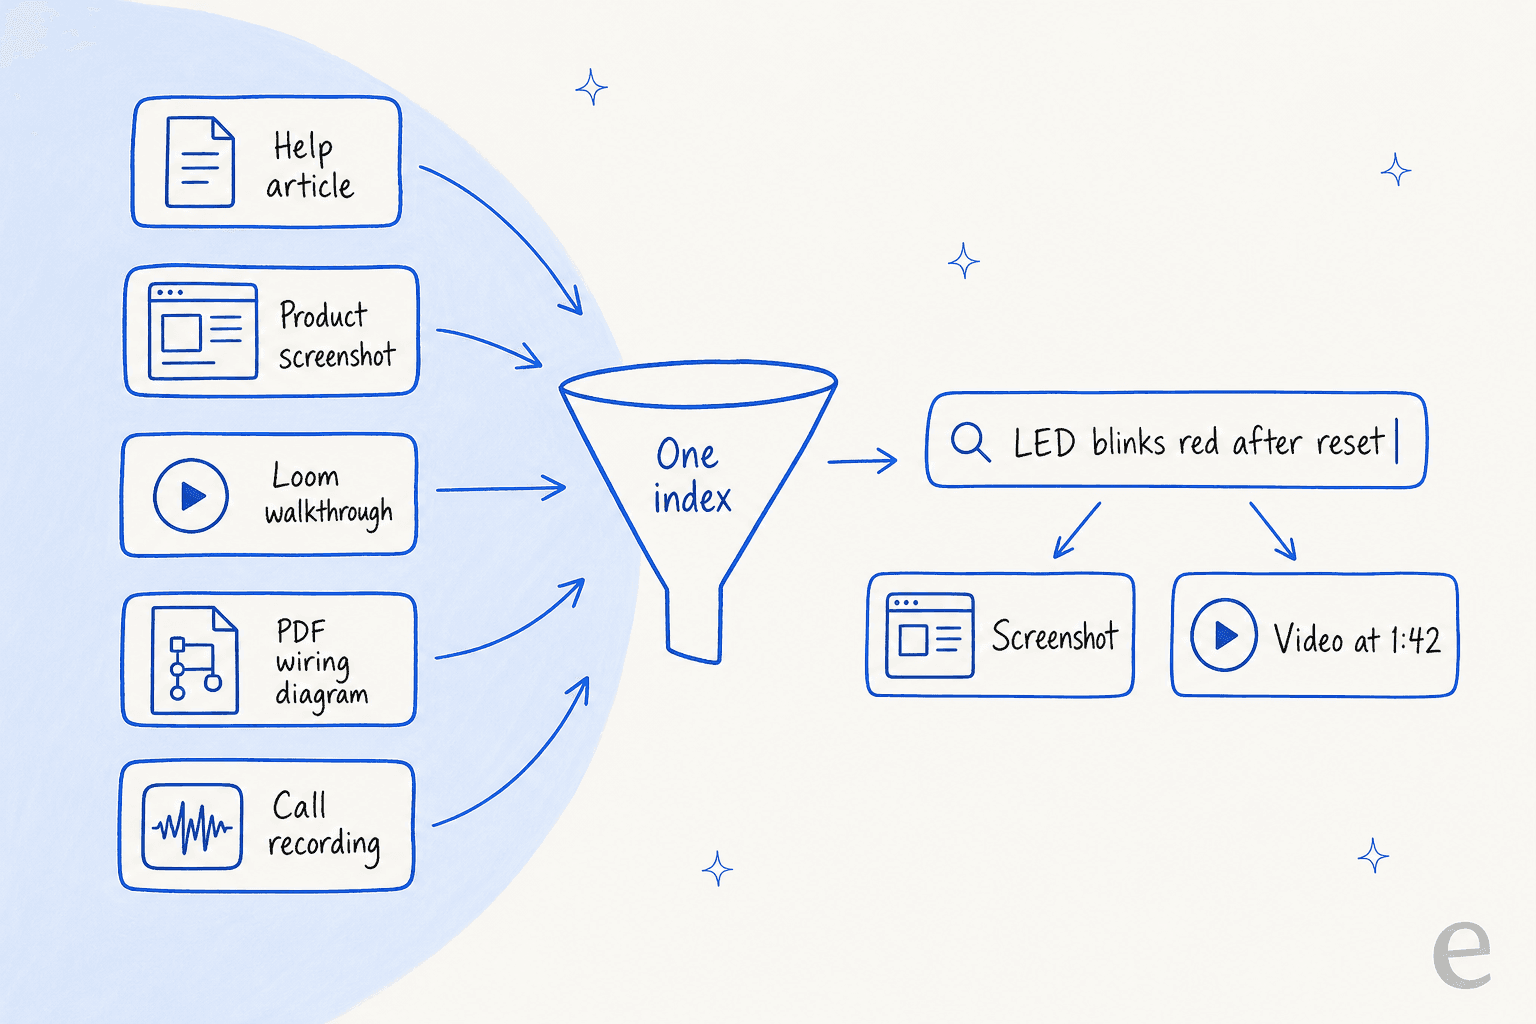
Um espaço compartilhado é a solução. Indexe a captura de tela, o tutorial e o artigo juntos, e uma consulta de texto como "LED pisca vermelho após reiniciar" pode trazer de volta o quadro certo do vídeo certo. Um leitor do HN, advogado, descreveu a mesma ideia para processos judiciais:
"I could imagine using it to search a case file for "undamaged roof before Hurricane Katrina" and "damaged roof after Hurricane Katrina" and being able to locate both deposition testimony and pertinent photographs in the body of evidence."
Mas a recuperação é só metade de um bot de suporte, e na minha experiência não é a metade que dói. No início deste ano, alguns clientes pagantes da eesel, incluindo um fornecedor dinamarquês de energia solar, viram o bot inventar respostas quando a busca na base de conhecimento voltava vazia. Ele preencheu a lacuna com os dados de treinamento do modelo, um caso clássico de alucinação de IA, e enviou detalhes de assinatura inventados a clientes reais.
Um gerador de embeddings melhor não teria resolvido isso. Uma regra rígida de "sem correspondência, passa para uma pessoa" resolveu, além de simular o bot contra tickets anteriores antes de entrar no ar. Se você construir sobre o EmbeddingGemma 2, planeje essa camada desde o primeiro dia; meu guia sobre como impedir alucinações de IA cobre os padrões.
Quem deve usar o EmbeddingGemma 2?
| Você é | Minha opinião |
|---|---|
| Constrói busca sobre uma base de código ou memória para agentes de programação | Use. +9,92 pontos no MTEB Code é o ganho mais claro do lançamento. |
| Busca em fotos, capturas de tela, PDFs, áudio ou vídeo | Use, com 256 dimensões ou mais, e teste com seus próprios arquivos. |
| Lança busca no dispositivo ou offline em um app | Use. 191MB para texto é pequeno o bastante para um celular, e o suporte do ML Kit no Android está a caminho. |
| Já usa o EmbeddingGemma 1 só para texto em inglês | Fique onde está, a menos que precise de contexto de 8K ou da licença Apache. |
| Roda busca de suporte na nuvem sem limites de dados | O Gemini Embedding 2 dá menos trabalho pelo mesmo dinheiro. |
| Quer um bot de suporte funcionando, não um pipeline | Pule a construção. O modelo é uma peça de cinco. |
Para comparações com outras opções, meus textos sobre o Cohere Embed 5 e a API de embeddings da OpenAI cobrem as principais alternativas hospedadas, e modelos de linguagem pequenos aprofunda a tendência on-device a que este modelo pertence.
Para o cenário mais amplo, meu resumo de ferramentas de recuperação de conhecimento compara os produtos prontos.
O veredito
O EmbeddingGemma 2 é um lançamento bom e honesto. O design modular é inteligente, a licença Apache remove um bloqueio real, e a busca de código e a multimodal dão um passo claro à frente em um pacote pequeno o bastante para um celular. Se seus dados não são só texto, é o primeiro modelo aberto que eu testaria.
Só leia além da manchete. Para texto em inglês, ele fica no mesmo nível do modelo que substitui, as afirmações de "best-in-class" são do próprio Google, e para a maioria das equipes na nuvem a API hospedada custa quase o mesmo que rodar por conta própria. Escolha-o por privacidade, uso offline, código ou mídia, e você ficará satisfeito. Escolha-o esperando um grande salto na busca de texto puro, e não verá um.
Experimente a eesel
Se você chegou aqui porque está pensando em construir um bot de suporte sobre um modelo de embeddings novo, aqui vai o atalho: o gerador de embeddings encontra trechos, mas alguém ainda precisa lê-los, escrever a resposta e saber quando ficar em silêncio. O colega de helpdesk com IA da eesel faz esse trabalho dentro do Zendesk, Freshdesk ou Gorgias. Ele aprende com sua central de ajuda, com sua documentação em lugares como Confluence e Google Docs e com seus tickets anteriores, e depois roda uma simulação sobre centenas dos seus tickets reais para que você veja as respostas antes de um cliente. Quando a busca volta vazia, ele passa o ticket para uma pessoa em vez de adivinhar.

Há um plano gratuito com 100 créditos e sem cartão, e os planos pagos estão na página de preços. Experimente a eesel e reproduza os tickets do mês passado antes de construir qualquer coisa.