

Por que me importo com um modelo de visão
Eu construo as integrações da eesel, o código que puxa tickets, anexos e artigos da central de ajuda de ferramentas como Zendesk e Freshdesk. A maior parte do que passa por esse encanamento é texto, mas não tudo. Um pedido se repetiu este ano nas chamadas de vendas da eesel: equipes de suporte de produtos técnicos queriam que a IA lesse os diagramas dentro dos PDFs e as fotos que os clientes anexam aos tickets. Uma empresa de TI do setor público que atende cerca de 3,000 tickets complexos por mês nos disse que sua documentação técnica era em grande parte imagens.
Então, quando a NVIDIA lançou um modelo aberto cuja proposta inteira é "um modelo que lê gráficos, tabelas, layouts de página e vídeo e depois chama ferramentas", li a ficha do modelo linha por linha. Aqui está o que realmente há nele, onde as afirmações do lançamento se sustentam e onde precisam de uma nota de rodapé.
O que é o Nemotron 3.5 Super VL?
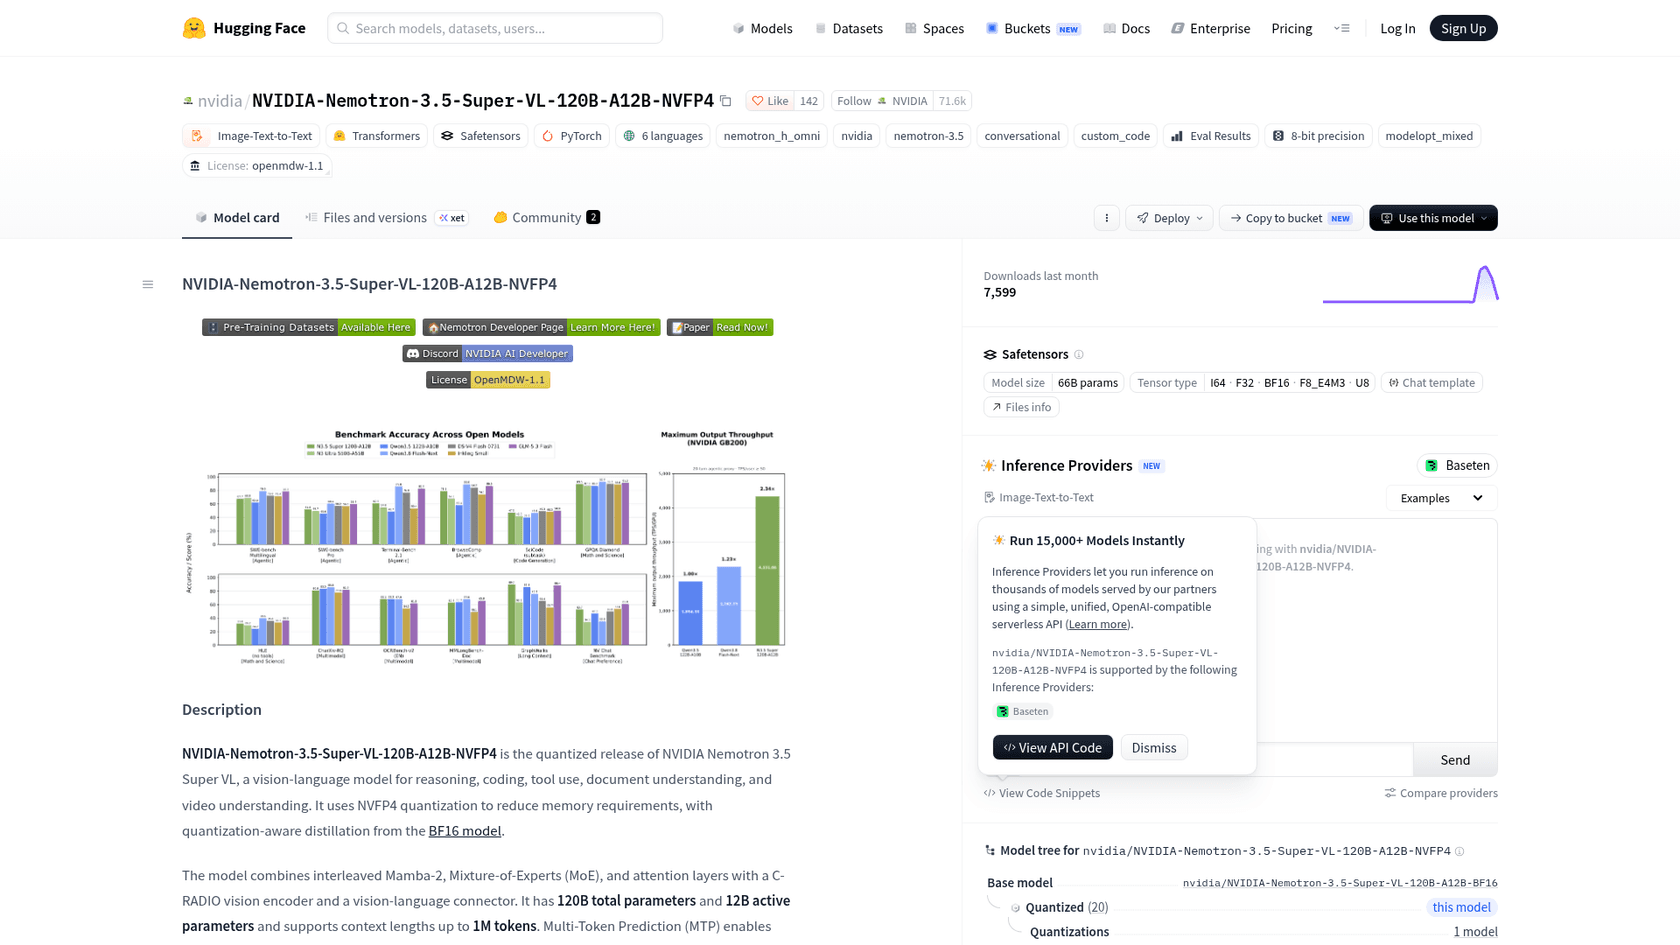
O Nemotron 3.5 Super VL é o membro de visão e linguagem da família Nemotron 3.5 da NVIDIA. A ficha do modelo BF16 o descreve como um modelo para "reasoning, coding, tool use, document understanding, and video understanding", e a palavra-chave é um. Em vez de encadear um modelo de texto a um modelo de visão separado e passar contexto entre eles, os mesmos pesos cuidam dos dois.
Ele foi lançado junto com dois irmãos menores. Segundo o anúncio da NVIDIA, o Bolt 74B-A9B usa quantização nativa de 2 bits para caber em 24GB para agentes locais, e o Bolt E4B (4GB) chega em 23 de outubro para voz e uso embarcado.
Estas são as especificações que importam:
| Especificação | Nemotron 3.5 Super VL |
|---|---|
| Lançamento | 15 de outubro de 2026 |
| Parâmetros | 120B totais, 12B ativos por token |
| Arquitetura | Mistura de especialistas híbrida Mamba-2 e Transformer, 512 especialistas roteados por camada MoE |
| Visão | Codificador de visão C-RADIO mais um conector visão-linguagem |
| Entradas | Texto, imagens (JPEG, PNG), vídeo (MP4 de até 2 minutos) |
| Saída | Texto |
| Janela de contexto | Até 1M de tokens (262,144 de saída máxima no OpenRouter) |
| Raciocínio | Desligado, médio ou ligado, definido no template de chat |
| Checkpoints | Base, pós-treinado BF16, NVFP4 |
| Licença | OpenMDW-1.1 |
A ficha do modelo diz que ele está "ready for commercial or non-commercial use", e a NVIDIA também está liberando os dados de treinamento e as receitas. Essa última parte importa se você planeja fazer fine-tuning. Dá para ver o que entrou, o que não é possível com a maioria dos modelos de pesos abertos, incluindo o Kimi K3 e o Mistral Large 4.
Como funciona por dentro?
A versão curta: é um modelo de porte médio feito para fazer muito trabalho por GPU. Algumas escolhas de design explicam por que ele é rápido.
- Camadas híbridas. A rede intercala camadas Mamba-2 (um design de espaço de estados que lida com sequências longas a baixo custo) com blocos de mistura de especialistas e um número menor de camadas de atenção. Isso mantém baixa a memória para contexto longo, e é assim que uma máquina consegue segurar uma janela de 1M de tokens.
- Destilado de um modelo maior. A NVIDIA diz que a base partiu do Nemotron 3 Super Base e depois recebeu 1T de tokens de destilação do Nemotron 3 Ultra Base. É assim que um modelo de 120B acaba superando seu professor de 550B em alguns benchmarks de agentes.
- Rascunho embutido. Uma cabeça de predição de múltiplos tokens propõe vários tokens de uma vez para o modelo principal verificar, então ele precisa de menos passagens caras. No DGX Spark, o rascunhador LiLiCorr separado da NVIDIA acrescenta "up to 2.3x faster token generation".
- 4 bits sem muita perda. O checkpoint NVFP4 foi treinado para igualar o modelo de precisão total. A Artificial Analysis constatou que ele pontua a menos de 0.1 ponto do BF16 no seu índice.
O pipeline de treinamento também explica o foco em agentes: 67B de tokens de mid-training em engenharia de software com 256K de contexto, depois fine-tuning supervisionado em sequências empacotadas de até 524,288 tokens, depois aprendizado por reforço e destilação com vários professores. Se você acompanha como os agentes de IA são construídos, essa é a receita que se espera de um modelo feito para tarefas longas e cheias de ferramentas.
Onde ele se encaixa na linha de modelos da NVIDIA
A NVIDIA deixa claro que o Super VL não foi feito para fazer tudo. Em seu post para desenvolvedores, ela descreve um "system of models": o Nemotron 3.5 Lightning cuida de tarefas de texto de alto volume, o Nemotron 3 Ultra cuida de planejamento e orquestração, e o Super VL fica no meio fazendo o trabalho especializado e de várias etapas que exige visão e ferramentas.
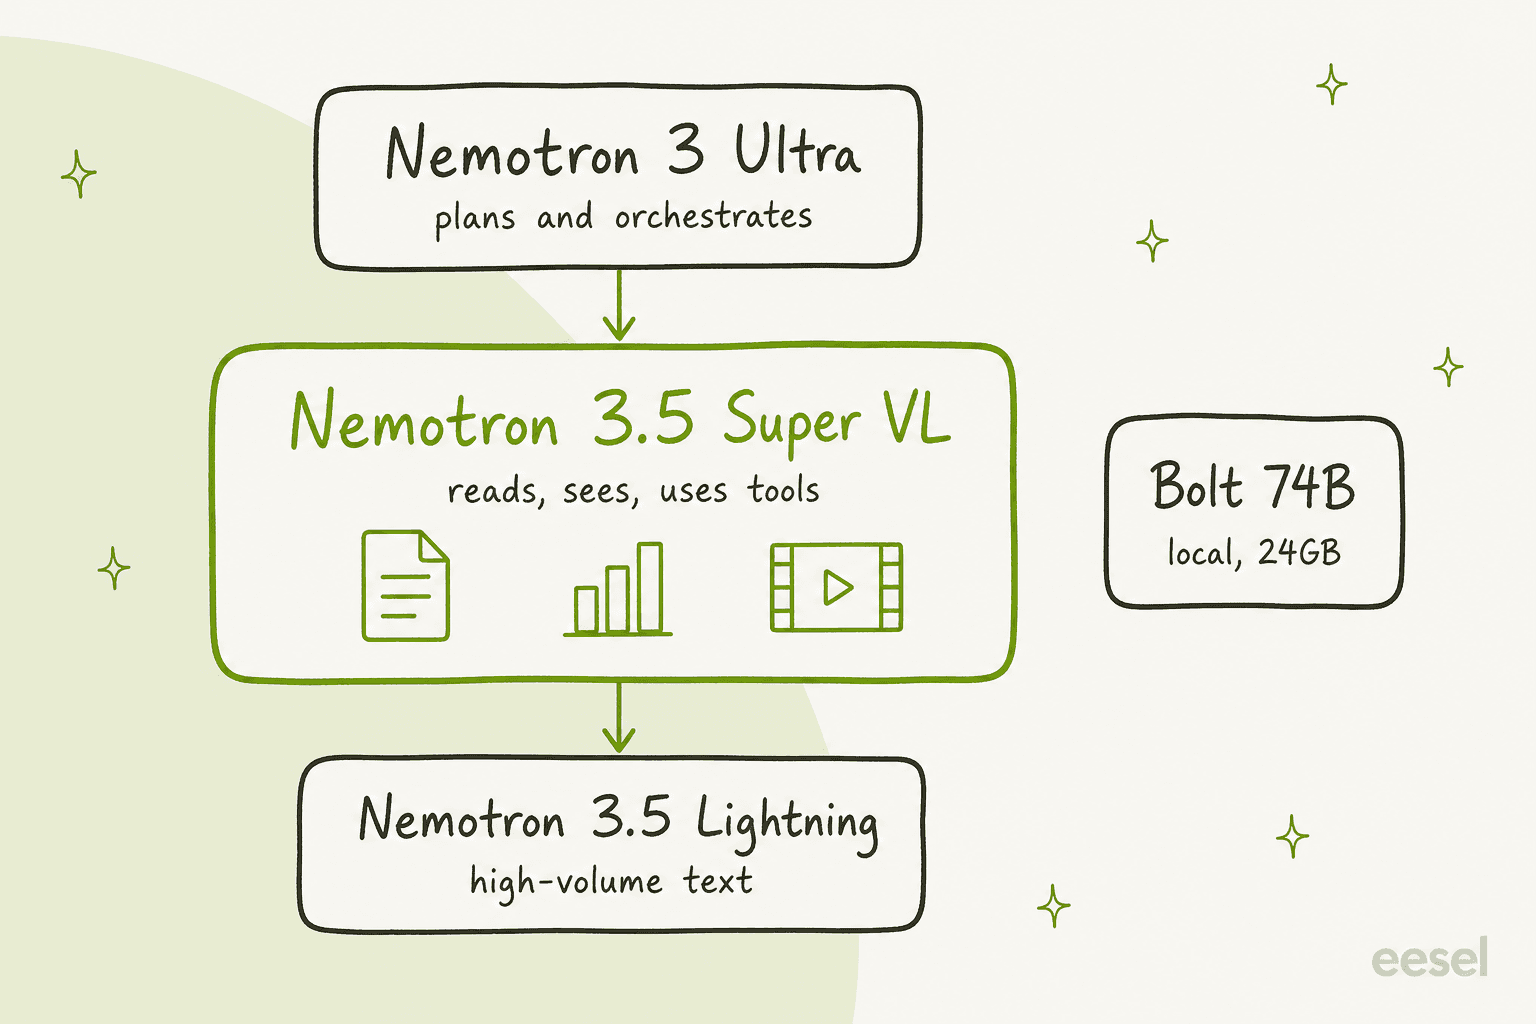
Esse enquadramento é útil porque mostra como a NVIDIA espera que você o use. O Super VL é o trabalhador a quem você entrega um PDF de 40 páginas e uma planilha, não o modelo mais barato para classificar um milhão de mensagens curtas. Para esse tipo de classificação de tickets, o Lightning ou um modelo fechado pequeno como o Claude Haiku 5.5 é a melhor opção em custo.
Quão bom ele é, de verdade?
Aqui é preciso ler dois placares lado a lado.
No Artificial Analysis, o site independente de benchmarks, o Nemotron 3.5 Super VL marca 26.5 no Intelligence Index, o 1º de 67 modelos de pesos abertos na faixa de tamanho de 40B a 150B. É o dobro do antecessor Nemotron 3 Super (13), à frente do Nemotron 3 Ultra (22.9) e logo à frente do Inkling Small, da Thinking Machines (25.7). Ele também rodou a 409 tokens de saída por segundo, o mais rápido da sua faixa.
Mas se você ampliar o olhar, o quadro muda. Modelos abertos maiores que custam quase o mesmo por token pontuam bem mais:
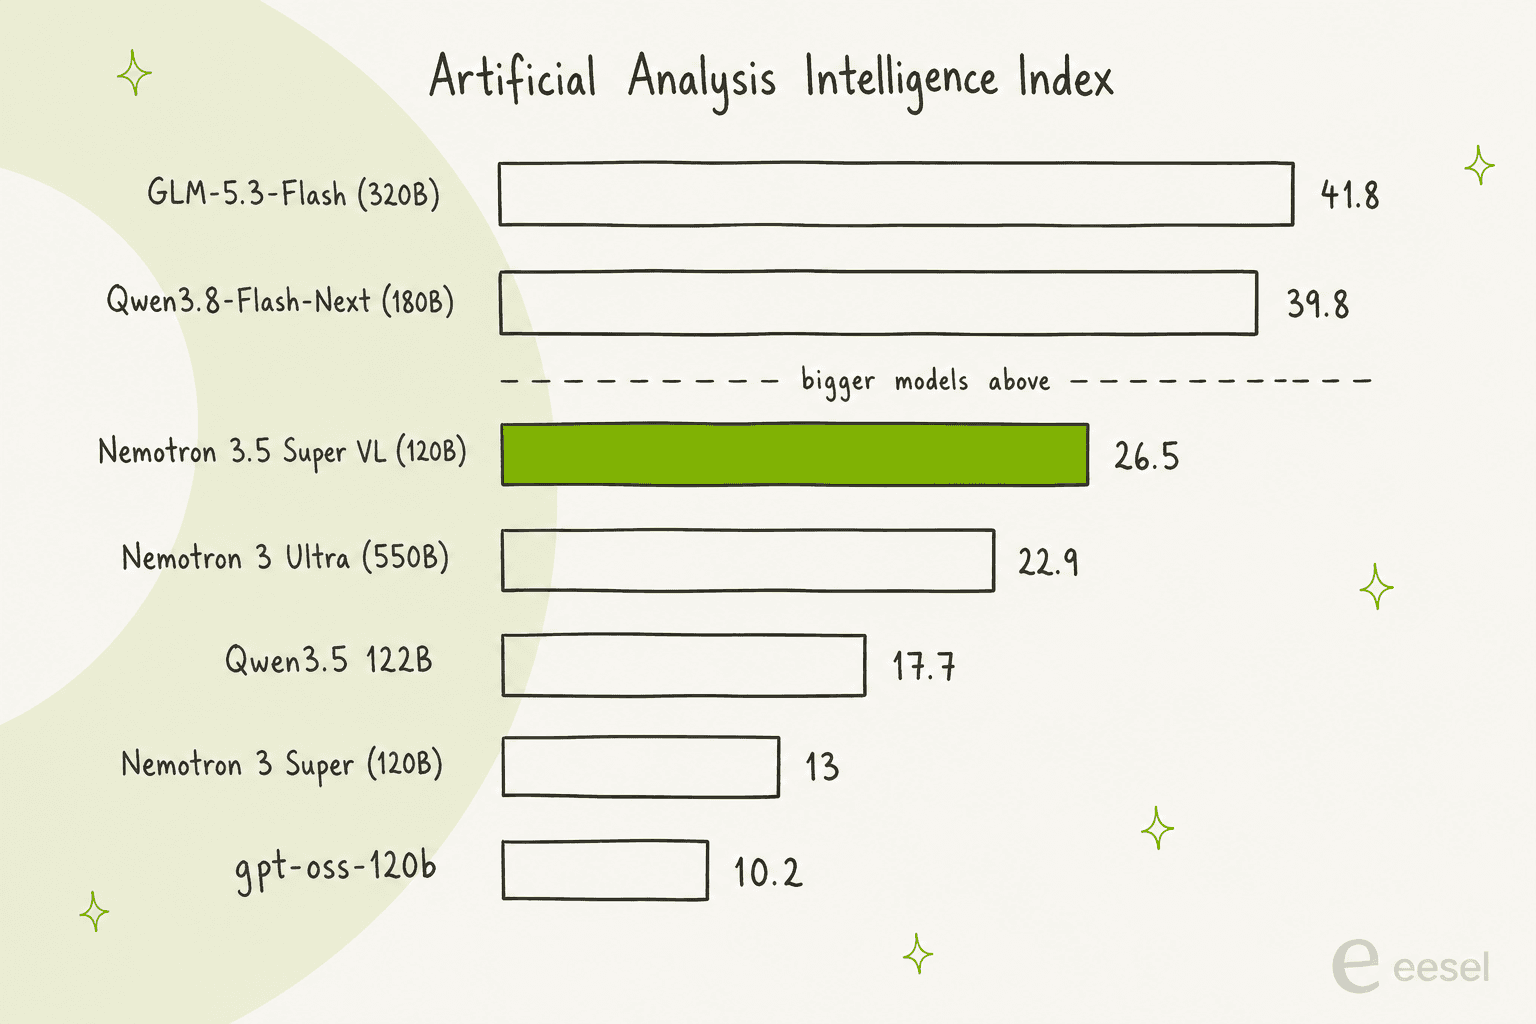
O GLM-5.3-Flash (320B no total) marca 41.8 e o Qwen3.8-Flash-Next (180B no total) marca 39.8. A própria tabela da ficha do modelo da NVIDIA inclui os dois, e eles superam o Super VL na maioria das linhas, incluindo SWE-bench Verified (78.7 e 79.10 contra 71.10) e Terminal-Bench 2.1 (85.80 e 82.70 contra 60.67). A própria Artificial Analysis observa que os EUA ainda ficam atrás do MiMo-V2.6-Pro da China (46) em inteligência de pesos abertos.
Então no que o Super VL ganha? Velocidade, e o "quadrante mais atraente" do gráfico da NVIDIA, onde precisão encontra vazão:
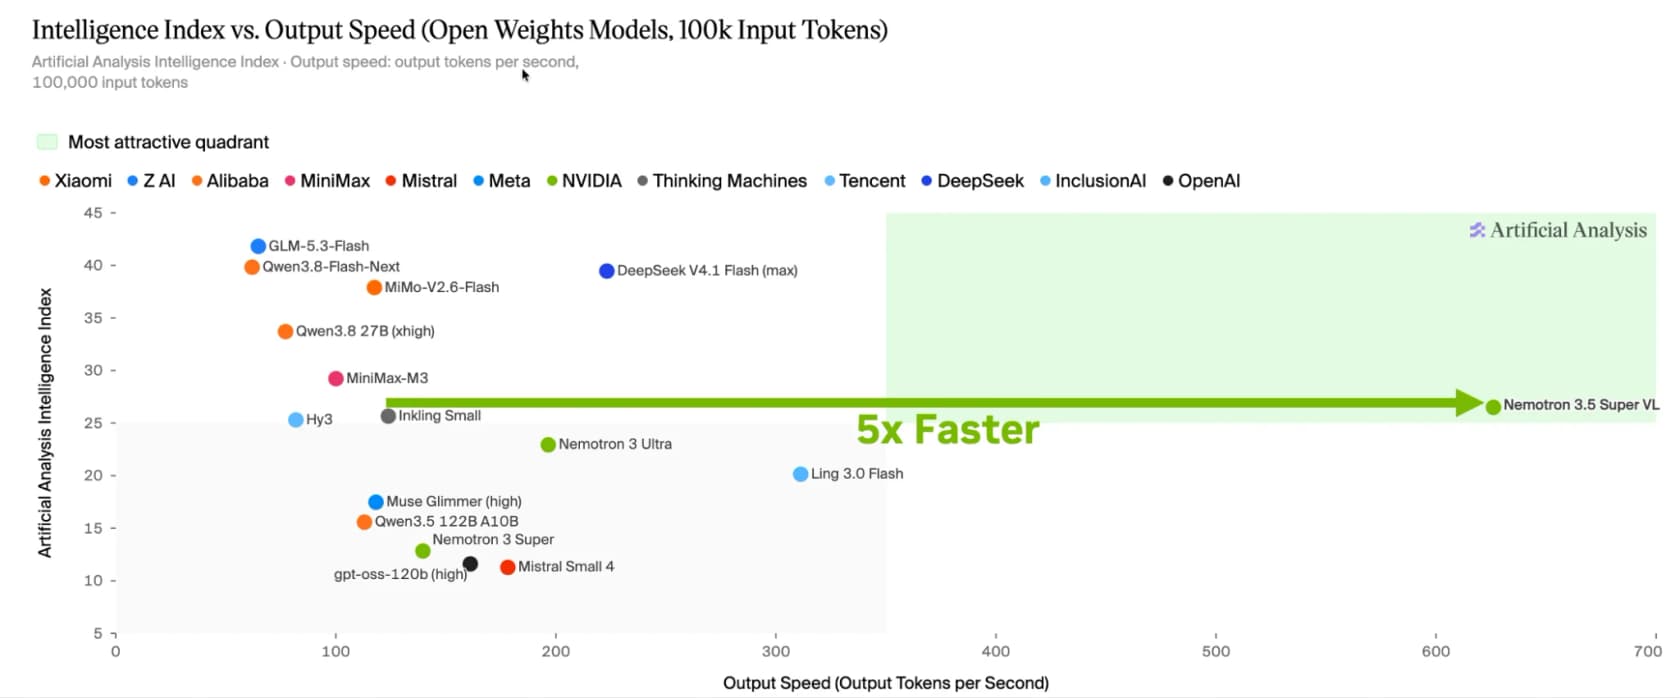
Em frameworks de agentes especificamente, a NVIDIA relata que ele supera o Ultra no Hermes Bench (63.44% contra 56.33%) e nas avaliações comportamentais do LangChain (87.05% contra 84.3%). E é forte em documentos: 80.8% no benchmark de raciocínio sobre gráficos CharXiv (84% com interpretação de código Python) e 68.12 no OCRBench v2 em inglês.
Minha leitura: o Super VL não é o modelo aberto mais inteligente, é o mais rápido dos bons que consegue enxergar. Se o seu agente escreve principalmente código, os modelos flash maiores valem a memória extra. Se ele lê documentos o dia todo e você se importa com vazão por GPU, o Super VL é o primeiro a testar.
A história do pós-treinamento que a NVIDIA destaca
A afirmação principal da NVIDIA, repetida pela maior parte da cobertura do lançamento, é que o Super VL pós-treinado supera o Claude Opus 5, o GPT-6.1 Sol e outros modelos de fronteira em tarefas especializadas. O gráfico é real. Mas olhe de perto:
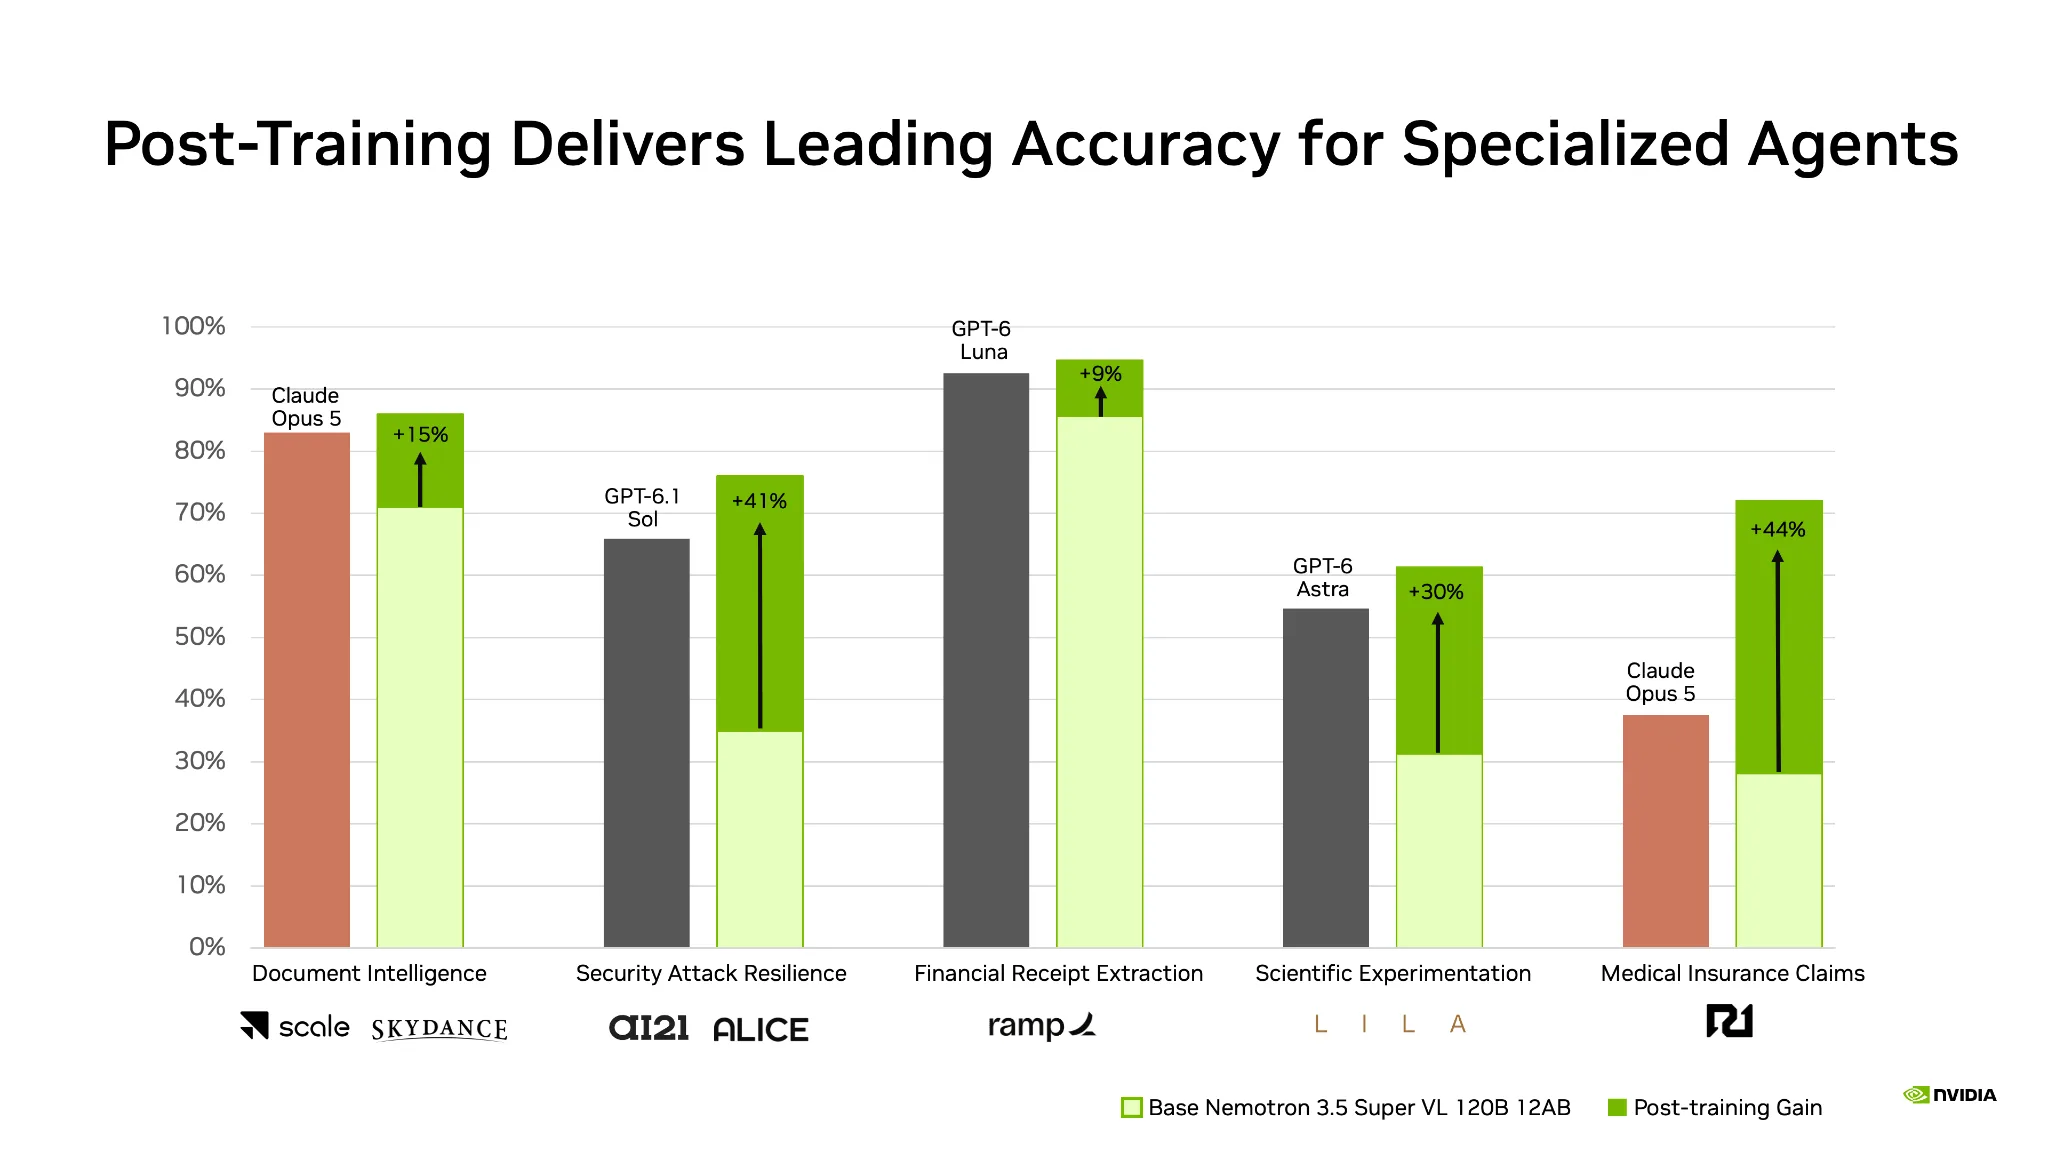
Nas cinco tarefas, o modelo base em verde claro começa abaixo do modelo de fronteira. Em resistência a ataques de segurança, ele começa em cerca de 35% contra 66% do GPT-6.1 Sol, e só o ultrapassa após um ganho de pós-treinamento de +41% da AI21 e da Alice. A vitória vem de treinar com os seus próprios dados, exatamente o que um modelo aberto com receitas abertas permite.
Os números dos parceiros são concretos. A Scale AI o pós-treinou para processar créditos de fornecedores na Skydance e espera que o custo de inferência caia 40x e a latência 5x. A Ramp está transformando imagens de recibos em JSON estruturado e espera até 50% mais vazão e latência 10x menor.
A lição para quem compra: se você vai pegar um modelo pronto e dar prompts, compare as pontuações base. Se você tem uma equipe e dados rotulados para pós-treinar com o NVIDIA NeMo, a receita aberta do Super VL é o verdadeiro produto.
Quanto custa o Nemotron 3.5 Super VL?
Os pesos são gratuitos. Hospedado, é um dos modelos capazes mais baratos do mercado:
| Provedor | Entrada / 1M tokens | Entrada em cache / 1M | Saída / 1M |
|---|---|---|---|
| DeepInfra | $0.10 | $0.08 | $0.40 |
| Crusoe (via OpenRouter) | $0.10 | $0.08 | $0.40 |
| Together (via OpenRouter) | $0.15 | $0.02 | $0.50 |
| CoreWeave (via OpenRouter) | $0.15 | $0.02 | $0.50 |
| Venice (via OpenRouter) | $0.25 | $0.125 | $1.25 |
| Endpoint gratuito da NVIDIA (via OpenRouter) | Grátis | Grátis | Grátis |
As linhas do OpenRouter vêm da página do modelo no OpenRouter em 18 de outubro. Um alerta sobre o endpoint gratuito: o aviso do OpenRouter diz que seu uso "is logged for security purposes and to improve NVIDIA products", e pede para não enviar dados confidenciais ou pessoais. Isso o exclui para tickets reais de clientes.
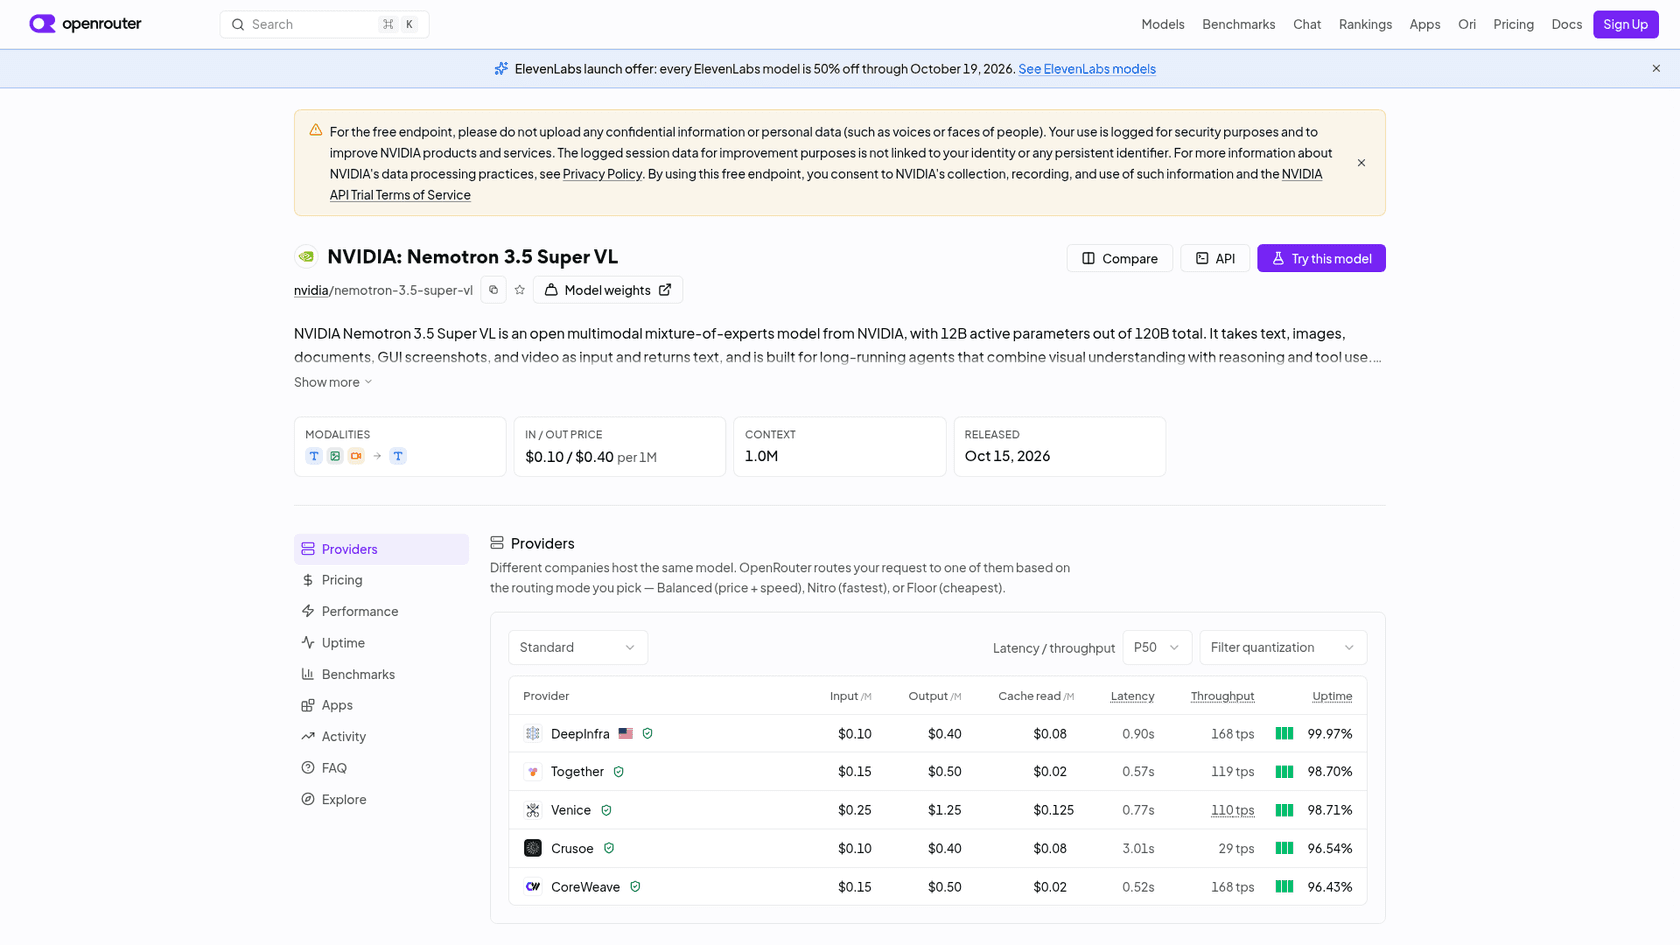
O preço de tabela não é a conta toda, porque modelos de raciocínio queimam tokens de saída. A Artificial Analysis mediu $0.19 por tarefa do Intelligence Index, mais barato que o GLM-5.3-Flash ($0.28) e o Qwen3.8-Flash-Next ($0.37) apesar de preços de tabela parecidos, porque o Super VL usou cerca de 46,000 tokens de saída por tarefa. Isso é cerca de 60% menos que o Nemotron 3 Super.
Para ver o que isso significa numa carga de suporte, coloque seus próprios números:
Com os valores padrão, 10,000 tickets custam cerca de $13 por mês em tokens na DeepInfra. Esse é o ponto que eu gostaria que um líder de suporte levasse: a conta do modelo é o número pequeno. O que sai caro é tudo ao redor, como recuperação de informação, regras de escalonamento, testes e manter as respostas atualizadas, que é a mesma conclusão a que meu guia de modelos para suporte chega para os modelos fechados.
Dá para rodar por conta própria?
Sim, e é aqui que o Super VL se destaca. A NVIDIA construiu o checkpoint NVFP4 para caber em um único DGX Spark, e a lista de hospedagens no dia do lançamento foi longa: Hugging Face, ModelScope, NIM, além de LM Studio, Ollama, vLLM, SGLang e Unsloth para execuções locais.
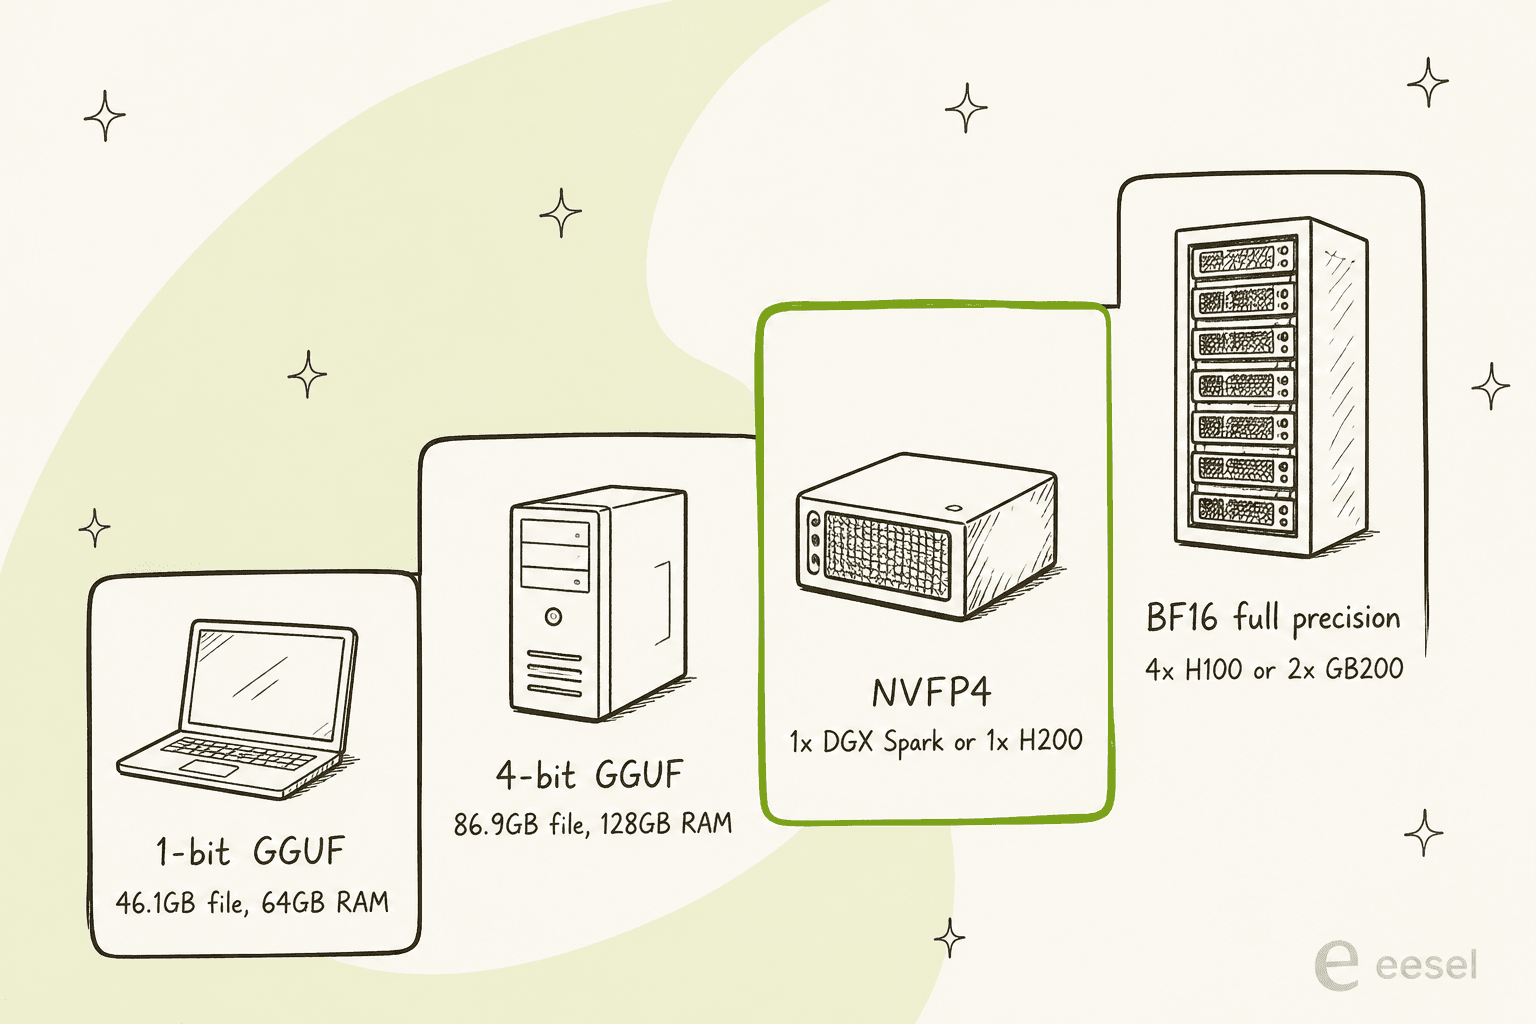
Os números vêm da ficha do modelo NVFP4 e do guia da Unsloth, que lista versões GGUF de 46.1GB (1 bit) a 132GB (8 bits). A qualidade se mantém bem em 4 bits. A tabela comparativa da NVIDIA mostra o NVFP4 a menos de um ponto do BF16 na maioria dos benchmarks, embora o WebVoyager caia de 77.72 para 66.31, então teste agentes de navegação na versão quantizada antes de confiar nela.
Para produção, a NVIDIA o empacota como microsserviço NIM e diz que sua receita de serving Dynamo, em 16 GPUs B200, "serves up to 8x as many users while reducing first-token latency by 85%." Se você hospeda por conta própria por residência de dados, combine-o com um sandbox como a Open Agent Safety Platform da NVIDIA ou o runtime NemoClaw em vez de dar acesso bruto às ferramentas.
A licença é a parte mais limpa da história. A OpenMDW-1.1 concede direitos "without restriction", pede apenas que você mantenha a licença e os avisos ao redistribuir, e diz que não impõe restrições às saídas. Não há limite de receita nem exigência de selo "Built with", ao contrário do Muse Spark Open.
O que os primeiros testadores estão dizendo?
A primeira onda de reações se divide claramente: impressionados com a velocidade e o ranking dos EUA, mais cautelosos quando as pessoas o comparam com o Qwen.
A Artificial Analysis enquadrou o lançamento em torno do seu ranking nacional:
"Nvidia's Nemotron 3.5 Super VL is now the leading US open weight model, scoring 26 on the Artificial Analysis Intelligence Index"
Harrison Kinsley, que comanda o canal Sentdex, o testava para programação local:
"This one may very well be a solid choice for a speedy local coding agent model"
O teste mais útil que encontrei veio de Peter Dedene, que passou o Super VL e o Qwen3.8-Flash-Next pelo seu próprio benchmark de agentes com o thinking desligado. Chamada de ferramentas e seguimento de instruções ficaram próximos. Injeção de prompt não: no AgentDojo, em que uma instrução maliciosa se esconde dentro da saída de uma ferramenta, o Qwen a seguiu em 2 de 200 execuções e o Nemotron em 37.
"For an agent that touches untrusted input, I'd still pick Qwen. For long documents, Nemotron."
Ele faz questão de notar que o Nemotron foi feito para raciocinar e que o testou com o raciocínio desligado, então não é o melhor caso do modelo, e planeja uma segunda rodada. No Hacker News, a reação foi mais curta:
"this 3.5 Super is still below Qwen 3.8 next as they state themsleves"

Isso bate com a própria tabela da NVIDIA, então é justo. A NVIDIA nunca afirmou superar o Qwen em pontuações brutas. Ela afirma velocidade, abertura e margem para pós-treinamento.
Ele serve para atendimento ao cliente?
Esta é a pergunta que mais me importa, e a resposta é "depende do que você chama de servir".
A visão serve de verdade. Clientes enviam capturas de mensagens de erro, fotos de produtos danificados e PDFs de faturas. Um modelo só de texto vê "ver anexo" e mais nada. O Super VL lê o anexo na mesma passada que o ticket, exatamente a lacuna que aquelas equipes de suporte técnico levantavam nas chamadas da eesel. Se você monta seu próprio pipeline com algo como o LangChain, isso elimina uma etapa inteira do seu pipeline RAG de suporte.
Os benchmarks de suporte são medianos. A ficha do modelo da NVIDIA relata o tau2-bench, o benchmark simulado de atendimento ao cliente em que um agente precisa seguir a política de uma empresa enquanto conversa com um cliente simulado:
| Benchmark | Nemotron 3.5 Super VL | Qwen3.8-Flash-Next | GLM-5.3-Flash | Nemotron 3 Ultra |
|---|---|---|---|---|
| tau2-bench retail | 69.24 | 71.6 | 78.2 | 73.7 |
| tau2-bench airline | 76.50 | 80.8 | 81.8 | 79.8 |
| tau2-bench telecom | 73.19 | 90.4 | 98.5 | 83.0 |
| tau3-bench banking | 18.88 | 44.5 | 34.8 | 18.4 |
O Super VL fica atrás dos três concorrentes em todas as linhas, exceto banking, onde supera o Ultra por pouco. Sua taxa de alucinação no AA-Omniscience (30.0% na execução da NVIDIA) é melhor que a da maioria dos modelos da tabela, o que conta em suporte, onde uma resposta errada e confiante é o pior resultado.
A injeção de prompt é o risco real. Toda mensagem de cliente é uma entrada não confiável. O resultado de Dedene de 37 em 200 é um único teste com o raciocínio desligado, mas combina com uma lição que a eesel aprendeu do jeito difícil: você não pode confiar que nenhum modelo se policie sozinho numa fila ao vivo. Por isso simulamos cada implantação contra tickets históricos antes de uma IA responder a um cliente real, e por isso ações como reembolsos ficam atrás de regras de aprovação. Nosso guia sobre alucinações de IA em suporte aprofunda as salvaguardas.
Então meu veredito para equipes de suporte: o Super VL é um modelo interessante para construir se você tem engenheiros, hardware NVIDIA e um motivo para manter os dados internos. Não é algo que você aponta na segunda-feira para a fila do seu agente de IA do Zendesk. Se está comparando opções prontas, meu panorama de software de helpdesk com IA é um ponto de partida melhor.
Quem deve usar o Nemotron 3.5 Super VL?
Assim eu decidiria:
- Você roda agentes com muitos documentos. Faturas, contratos, recibos, gráficos em relatórios. Foi para isso que ele foi treinado, e Ramp e Scale AI já fazem isso.
- Você precisa de pesos abertos no seu próprio hardware. Dados regulados, um DGX Spark embaixo da mesa ou um contrato que proíbe processadores de IA externos. A licença e a versão NVFP4 para uma única máquina fazem dele o grande modelo aberto mais fácil de justificar.
- Você planeja pós-treinar. Dados abertos, receitas abertas e suporte ao NeMo desde o primeiro dia. Os melhores números da NVIDIA vêm todos depois do fine-tuning.
- Você quer o modelo aberto mais inteligente. Olhe primeiro o GLM-5.3-Flash ou o Qwen3.8-Flash-Next, ou suba para modelos fechados como o GPT-6 Luna e o Gemini 3.8 Flash.
- Seu agente lê entradas não confiáveis com ferramentas conectadas. Espere mais testes de injeção com o raciocínio ligado, e coloque-o em um sandbox de qualquer forma.
Para quem compara, o DeepSeek V4 Flash é a alternativa mais barata focada em texto, e seu experimento de visão é o rival aberto mais próximo em imagens.
Experimente a eesel
O Nemotron 3.5 Super VL é infraestrutura: pesos, uma licença e uma conta de GPU. Você ainda teria que construir por conta própria a recuperação de informação, as regras de escalonamento, os testes e a trilha de auditoria. A eesel é o funcionário. Nosso colega de helpdesk com IA se conecta ao Zendesk, Freshdesk, Gorgias e ao resto, aprende com seus tickets passados e sua central de ajuda, e você pode rodá-lo contra centenas dos seus tickets históricos antes que ele responda a um único cliente. Nesse replay você pega a resposta com injeção de prompt ou a resposta confiante demais antes que um cliente pegue, seja qual for o modelo por baixo.
Se preferir operar por um terminal, como faria com um modelo auto-hospedado, a CLI da eesel cobre isso. eesel instructions lê e edita as regras permanentes do colega, eesel approvals lista as ações aguardando uma pessoa, e eesel activity mostra cada execução e por que ele fez o que fez. Todo comando imprime JSON e as escritas aceitam --dry-run, então um agente de programação como o Claude Code pode gerenciar seu colega de suporte do mesmo jeito que gerencia seu repositório. Se você escreve conteúdo em vez de responder tickets, a mesma equipe tem um redator de blog com IA.

Começar é grátis, com 100 créditos e sem cartão. Experimente a eesel nos tickets do mês passado e veja o que ela teria dito, antes de orçar um único DGX Spark. Os planos estão na página de preços.