

Resumo
Nemotron 3.5 Bolt é a nova família de modelos abertos da NVIDIA feita para rodar na sua própria máquina, e são dois modelos, não um. O Bolt 74B-A9B acomoda um modelo de 74B parâmetros em 24GB com pesos de 2 bits, para que agentes locais possam rodar em uma única GPU de consumo. O Bolt E4B é um modelo de 4GB para assistentes de voz, personagens de jogos e dispositivos.
O modelo de 74B marca 21 no Artificial Analysis Intelligence Index, ficando em quarto lugar entre os modelos com menos de 100B parâmetros e a menos de 2 pontos do Nemotron 3 Ultra de 550B da NVIDIA. Os pesos são gratuitos sob a licença OpenMDW-1.1, e ainda não há uma API paga para nenhum dos Bolt, então sua conta é o hardware.
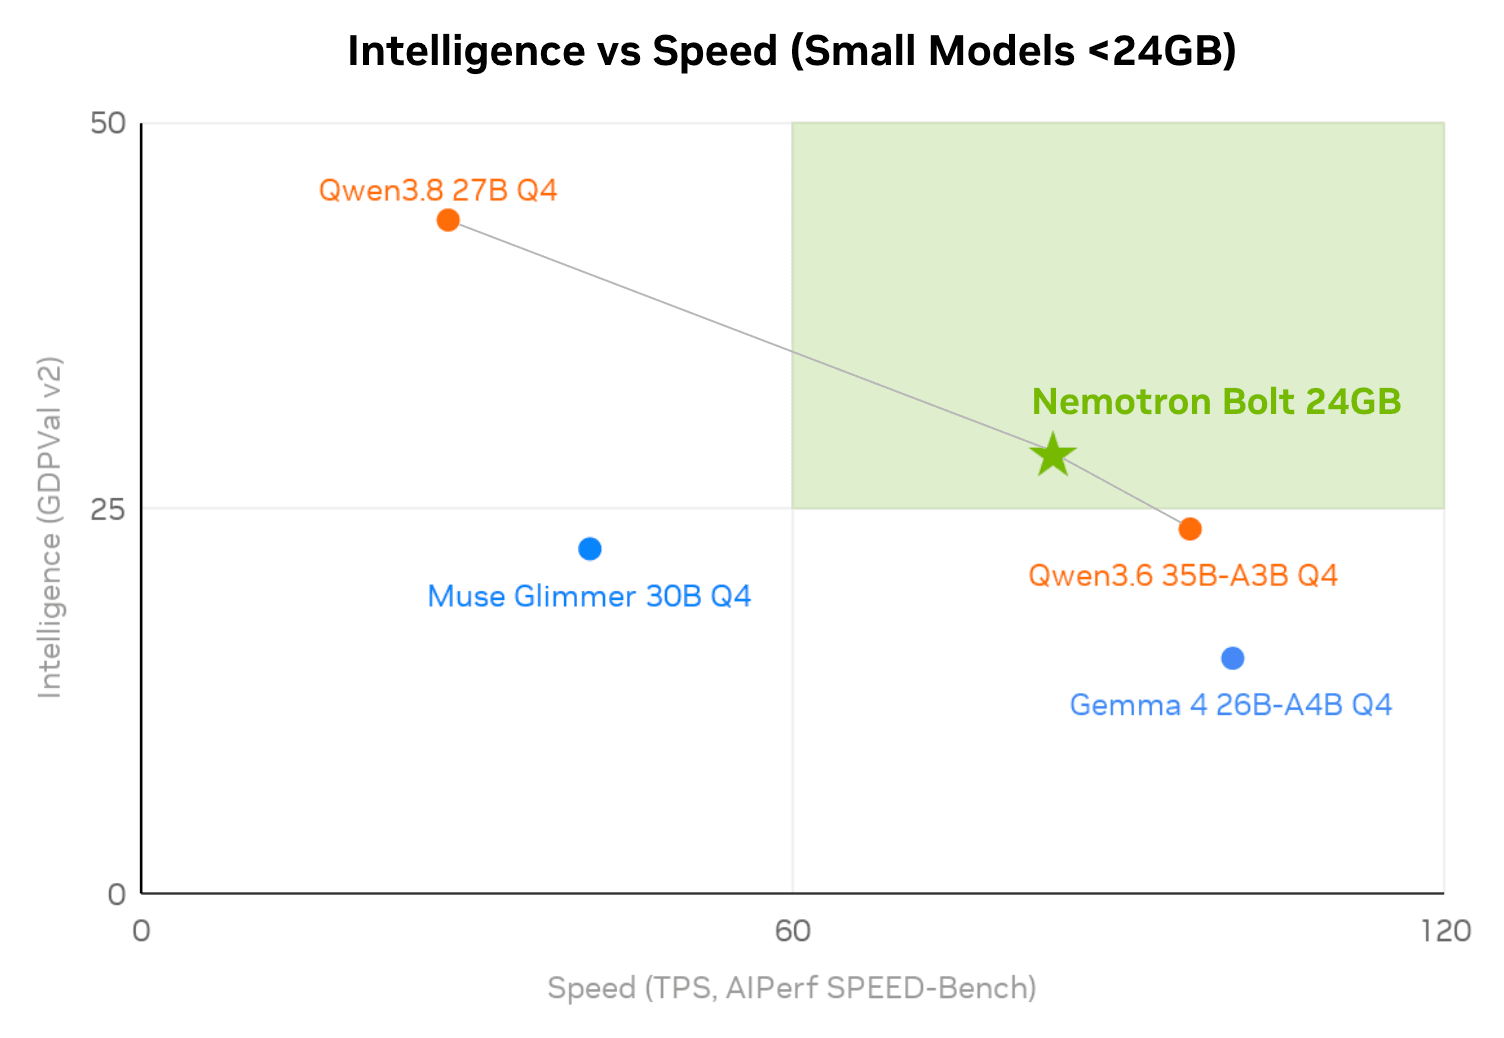
O porém: o Qwen3.8 27B denso ainda é mais inteligente (44.5 contra 28.5 no próprio gráfico GDPVal v2 da NVIDIA), o Bolt é prolixo, e uma pessoa que o testou viu o modelo falhar em 6 de 21 testes de jailbreak. Para equipes de suporte, ele é um motor promissor para trabalho privado, no próprio dispositivo, não uma solução de resposta a tickets que você simplesmente liga. Se é isso que você quer hoje, o colega de equipe de helpdesk com IA da eesel responde apenas com base na sua própria documentação e é testado nos seus tickets anteriores antes de responder a qualquer pessoa.
Por que li o relatório técnico do Bolt
Eu desenvolvo recursos e agentes de IA na eesel, então passo a maior parte da semana na parte intermediária e sem graça de um agente: o que entra no contexto, qual ferramenta ele chama e o que acontece quando o modelo erra. A pergunta que mais ouço de compradores técnicos não é "quão inteligente ele é?". É "para onde vão os nossos dados?". Em uma chamada de vendas neste ano, um avaliador de uma empresa de hardware perguntou se a IA recorreria a "some kind of other ChatGPT" quando não soubesse uma resposta, e se o conhecimento deles ficaria restrito à organização.
Um modelo que você pode rodar em um computador debaixo da sua própria mesa é uma resposta honesta a essa pergunta. Então, quando a NVIDIA lançou um modelo cuja proposta inteira é "fit a big model in 24GB", li o card do modelo, o relatório técnico e todos os testes de usuários que consegui encontrar. Aqui está o que se sustenta e o que precisa de uma nota de rodapé.
O que é o Nemotron 3.5 Bolt?
Nemotron 3.5 Bolt é a linha de "edge" da NVIDIA dentro da família Nemotron 3.5. A NVIDIA o anunciou em 15 de outubro de 2026 junto com o Nemotron 3.5 Super VL, e descreve a família assim: Lightning cuida de cargas de trabalho de alta vazão, Ultra cuida do raciocínio mais difícil, e "Bolt brings intelligence to the edge."
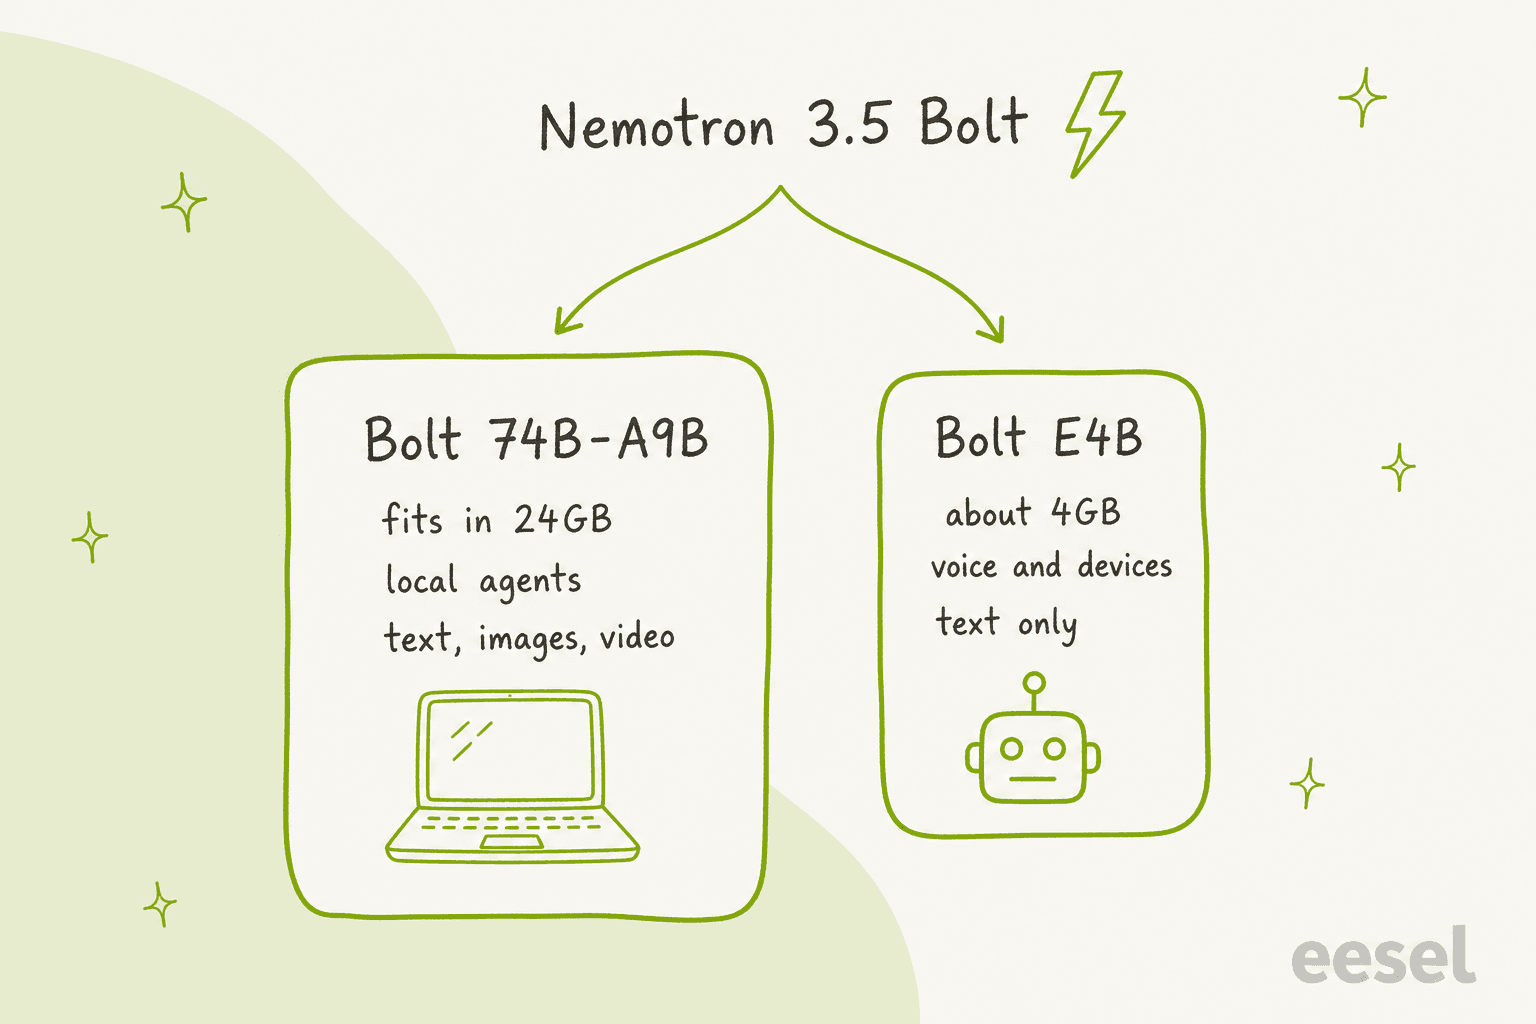
O nome abrange dois modelos bem diferentes, o que confunde boa parte da cobertura inicial:
- Bolt 74B-A9B 24GB é o modelo de destaque. Ele é "designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory", segundo a NVIDIA.
- Bolt E4B 4GB chegou em 23 de outubro. É um modelo de 8B com 4B parâmetros efetivos, construído sobre o Gemma 4 E4B do Google com pós-treinamento Nemotron, para "fast local voice assistants, interactive characters and embedded interfaces."
Aqui estão as especificações lado a lado:
| Especificação | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Lançamento | 15 de outubro de 2026 | 23 de outubro de 2026 |
| Parâmetros | 74B no total, 9B ativos por token | 8B no total, 4B efetivos |
| Construído a partir de | Nemotron 3.5 Super VL (120B), comprimido | Gemma 4 E4B, com pós-treinamento |
| Arquitetura | Mistura de especialistas híbrida de Mamba-2 e Transformer | Gemma 4 E4B |
| Formato dos pesos | Especialistas de 2 bits (IQ2_XXS), 22.1GB | 4 bits (Q4_K_M) |
| Entradas | Texto, imagens, vídeo (MP4 de até 2 minutos) | Texto |
| Janela de contexto | Até 256K tokens | 64K tokens |
| Hardware-alvo | RTX Spark, DGX Spark, GeForce RTX, RTX PRO | GeForce RTX, Jetson, RTX/DGX Spark |
| Licença | OpenMDW-1.1 | OpenMDW-1.1, mais Apache 2.0 para a base Gemma |
Ambos têm raciocínio que você pode ativar ou desativar, e o modelo de 74B oferece suporte a chamadas de ferramentas e saída JSON. Se você vem acompanhando lançamentos abertos como Meta Muse Spark Open ou Kimi K3, a diferença aqui é o alvo: o Bolt foi feito para uma máquina, não para um data center.
Como a NVIDIA faz um modelo de 74B caber em 24GB?
A versão curta: comece grande, corte partes e depois reduza cada número. A página de pesquisa da NVIDIA declara o objetivo sem rodeios: "fit into 24GB of memory and achieve a decoding speed of at least 80 TPS, while maximizing intelligence." Quatro etapas levam até lá.
- Comprimir um modelo maior. O Bolt começa como Super VL, que tem 120B parâmetros e escolhe 22 especialistas por token. O método Star Elastic da NVIDIA faz a poda até 74B e fixa a quantidade de especialistas em 9. Por si só, isso custa 2.85 pontos de acurácia média, 4,94% em relação ao modelo original, segundo o relatório técnico.
- Recuperá-lo com treinamento. O Bolt recebe então 120B tokens de treinamento de recuperação, visão reconectada, ajuste fino supervisionado e aprendizado por reforço. A parte de visão é a que mais precisa disso: a compressão derrubou a pontuação no WebArena de 57.4 para 1.35, e o treinamento a trouxe de volta para cerca de 50.
- Quantizar os especialistas para 2 bits. Os pesos dos especialistas são armazenados com 2.0625 bits cada, usando destilação consciente de quantização para que o modelo pequeno aprenda a reproduzir o grande nessa precisão. As camadas Mamba usam NVFP4 de 4 bits, e a atenção e os embeddings permanecem em 8 bits. Isso leva o modelo de 148GB para 22.1GB, "an 85.1% reduction in size. This quantization is lossy by design", diz a NVIDIA.
- Adicionar um modelo de rascunho para ganhar velocidade. Um modelo separado de 1.13B parâmetros chamado LiLiCorr prevê vários tokens à frente, e o modelo principal os verifica. É assim que a NVIDIA chega a 84 tokens por segundo no RTX Spark.
A aposta da NVIDIA é que um modelo grande reduzido para 2 bits supera um modelo pequeno treinado em 4 bits. Isso é o oposto de como a maioria dos modelos locais é construída, e é a ideia nova deste lançamento.
Uma nota de rodapé sobre o "24GB" no nome. A tabela de memória do relatório técnico soma 23.83GB apenas para texto. O codificador de visão precisa de mais 1.68GB além disso.
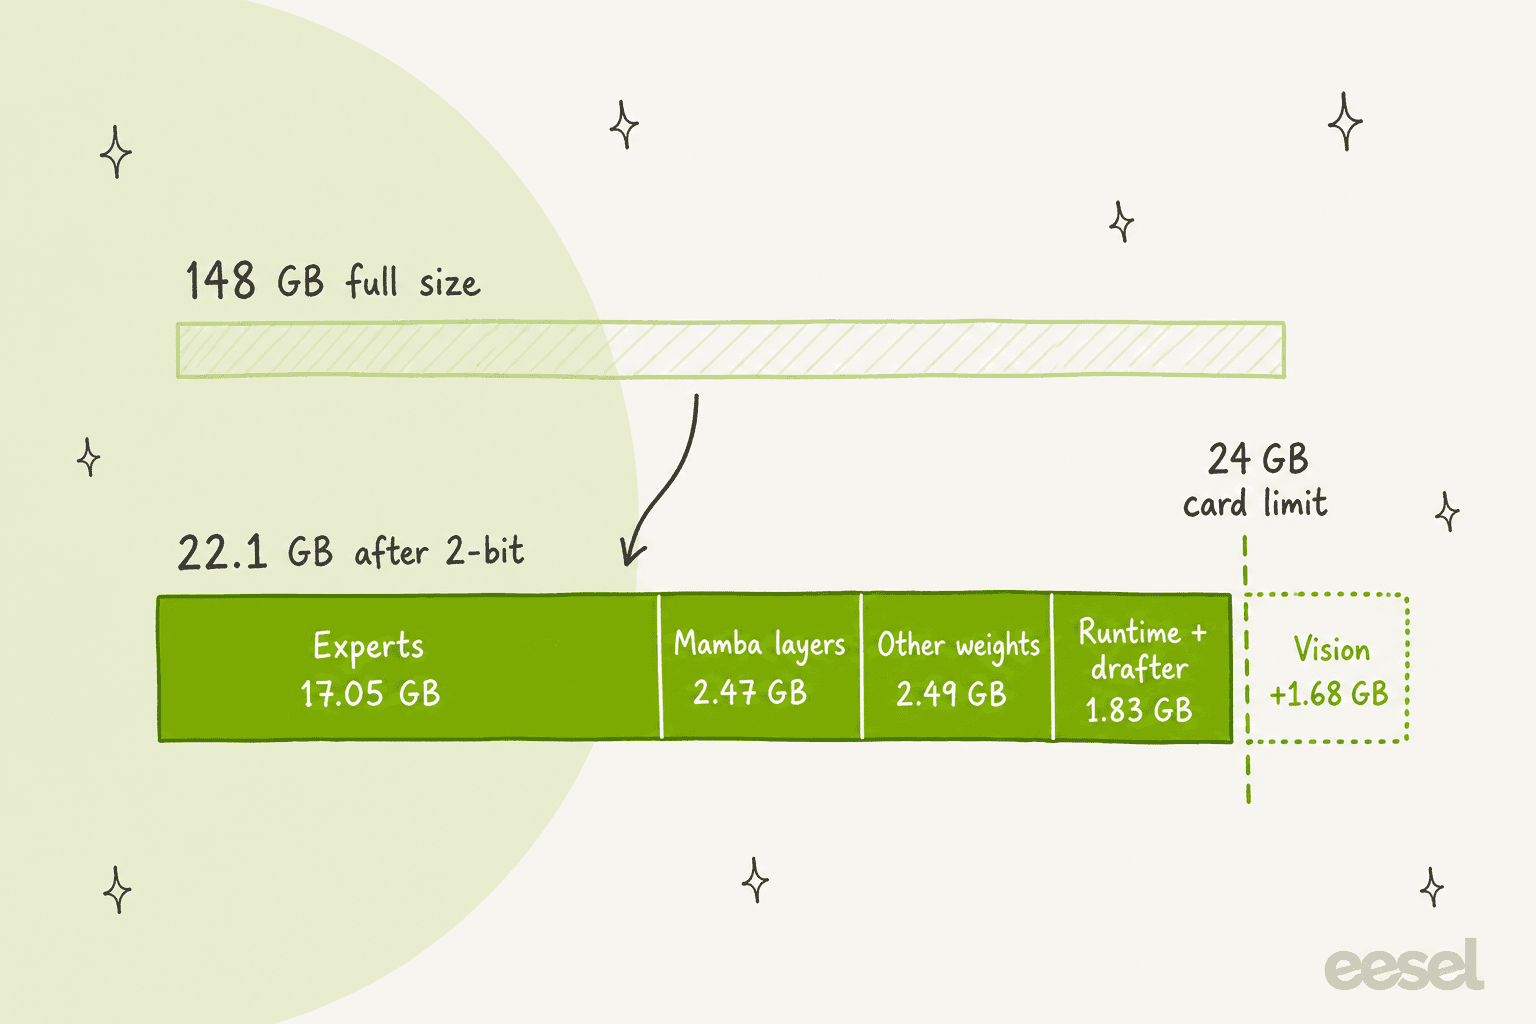
Então, em uma placa de 24GB, você está rodando agentes de texto. Se também quiser as capacidades de imagem e vídeo, planeje um pouco mais de folga. De qualquer forma, o guia local da Unsloth sugere de 24 a 32GB de memória.
O Nemotron 3.5 Bolt é bom mesmo?
Leia dois placares: o independente e o da própria NVIDIA.
A pontuação independente. A Artificial Analysis coloca o Bolt 74B em 21.4 no seu Intelligence Index, "placing 4th among models under 100B parameters and first among US models in that class." Isso fica a menos de 2 pontos do Nemotron 3 Ultra (23), um modelo com cerca de sete vezes mais parâmetros. O Bolt chega a superar o Ultra no AutomationBench-AA (15,5% contra 3,0%).
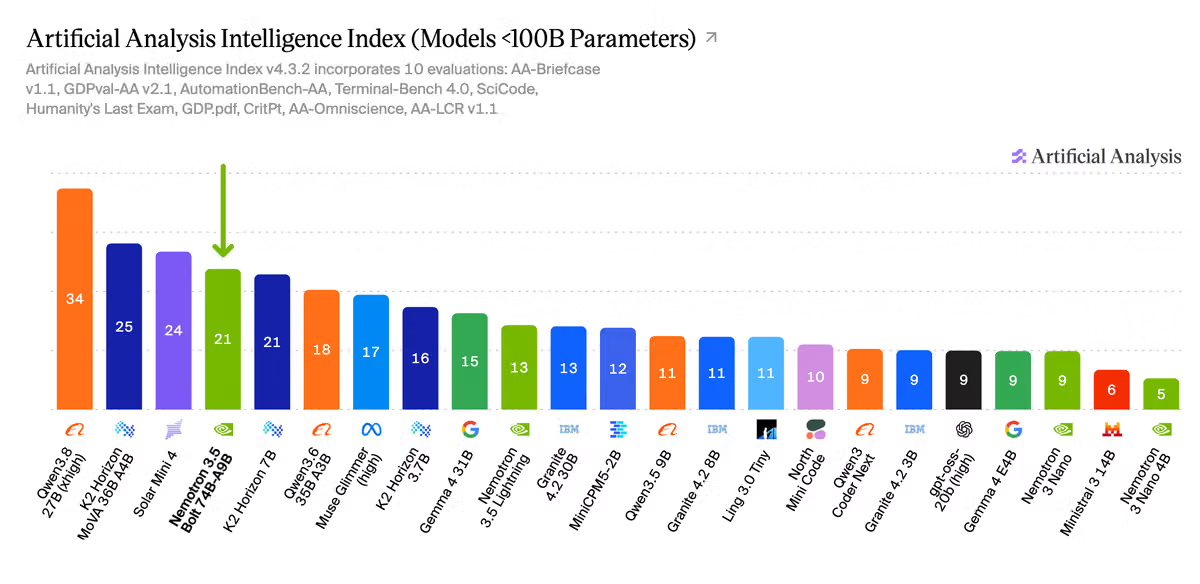
Mas olhe para a esquerda desse gráfico. O Qwen3.8 27B marca 34. O Bolt é o melhor modelo dos EUA na sua categoria, não o melhor modelo da categoria.
A tabela da própria NVIDIA. O card do modelo compara o Bolt de 2 bits com três pares de mistura de especialistas em precisão total:
| Benchmark | Bolt 74B 24GB (2 bits) | Qwen3.6 35B-A3B | Gemma 4 26B-A4B | Nemotron 3.5 Lightning |
|---|---|---|---|---|
| GDPVal-AA-V2 (tarefas reais de trabalho) | 28.47 | 25.75 | 15.33 | 18.26 |
| Terminal-Bench 2.1 | 50.98 | 44.38 | 37.22 | 23.46 |
| Tau3 Banking (atendimento ao cliente) | 17.01 | 10.52 | 14.02 | 9.48 |
| GPQA Diamond | 86.43 | 83.40 | 79.61 | 75.57 |
| BrowseComp | 66.75 | 48.74 | 26.30 | 36.81 |
| PinchBench | 87.82 | 88.07 | 74.70 | 83.43 |
| Acurácia no AA-Omniscience | 16.90 | 19.47 | 22.17 | 16.63 |
| IFBench (seguimento de instruções) | 66.17 | 63.71 | 77.25 | 72.88 |
Contra esses três, o Bolt vence na maioria das linhas, e fazer isso em 2 bits é impressionante. Mas a tabela deixa de fora o Qwen3.8 27B denso. O próprio relatório técnico da NVIDIA o coloca em 44.5 no GDPVal v2 contra 28.5 do Bolt, com aproximadamente um terço da velocidade. É uma troca justa a oferecer, mas você precisa ler o PDF para vê-la.
Mais dois custos que você precisa conhecer:
- 2 bits têm um custo. Em comparação com os próprios pesos do Bolt em precisão total, o GDPVal cai de 31.13 para 28.47 e a acurácia no Omniscience de 21.80 para 16.90, segundo o relatório técnico.
- Ele fala muito. A Artificial Analysis contou 82k tokens de saída por tarefa do Index, 1.8x o Super VL e 2.9x o Ultra. Localmente, isso custa tempo em vez de dinheiro, mas é tempo.
Qual é a velocidade dele em hardware real?
A tabela de velocidade da própria NVIDIA é mais modesta que as publicações de lançamento. No RTX Spark com llama.cpp, o Bolt roda a 83.99 tokens por segundo, contra 96.63 do Qwen3.6 35B-A3B, 100.56 do Gemma 4 26B-A4B e 28.26 do Qwen3.8 27B, segundo a página de pesquisa. Então ele é mais lento que os modelos pequenos de mistura de especialistas que supera em acurácia, e cerca de 3x mais rápido que o modelo denso que o supera.
Usuários com placas maiores conseguem muito mais:
"343 tok/s median with the LiLiCorr drafter (DFlash, n_max 6, about 55% of drafted tokens accepted), 166 tok/s without it. 25.0 GiB at 32K with the drafter and the projector, 22.7 GiB without the drafter."

Isso é em uma RTX 5090, e repare no valor de 25GB depois que a visão e o modelo de rascunho são carregados. Em uma placa de 16GB, um usuário relatou cerca de 45 tokens por segundo transferindo parte do modelo para a memória do sistema. Para usuários de Mac, a situação está pior por enquanto:
"Nemotron Bolt appears to be really quite good but unfortunately it is quite slow on macOS/Metal in llama.cpp at the moment because of lack of support for a tensor type (or something… not sure I understand)."

Quanto custa o Nemotron 3.5 Bolt?
Os pesos são gratuitos, e essa é toda a lista de preços. Até 27 de outubro de 2026, nenhum dos modelos Bolt tem uma API hospedada paga. Ele não está listado no OpenRouter nem na DeepInfra, a página build.nvidia.com da NVIDIA para o modelo de 74B retorna um erro 404, e a Artificial Analysis informa "No publicly available API."
| Opção | Bolt 74B-A9B 24GB | Bolt E4B 4GB |
|---|---|---|
| Pesos abertos | Gratuito, OpenMDW-1.1 | Gratuito, OpenMDW-1.1 |
| Hospedado pela NVIDIA | Não disponível | Endpoint de teste gratuito sob os Termos de Teste da API da NVIDIA |
| OpenRouter, DeepInfra | Não listado | Não listado |
| Download local | 22GB (GGUF de 2 bits) | 6.18GB (GGUF de 4 bits, Unsloth) |
| Memória para rodar | 24 a 32GB | Cerca de 4GB de memória de vídeo |
Se você preferir pagar por token, os modelos irmãos dele têm hospedagem. No OpenRouter, o Super VL está listado a US$ 0,15 por milhão de tokens de entrada e US$ 0,50 de saída, e o Lightning a US$ 0,07 e US$ 0,20. Se o plano é usar hospedagem, meu guia do melhor modelo de IA para tickets de suporte também compara as opções fechadas, como Claude Haiku 5.5 e Gemini 3.8 Flash.
A licença é a outra metade da história dos custos, e é uma boa metade. A OpenMDW-1.1 concede uso "without restriction", não impõe limites às saídas e não tem limite de usuários nem política de uso aceitável. Você mantém os avisos ao redistribuir, e seus direitos terminam se você entrar com uma ação alegando que o modelo infringe uma patente ou direitos autorais. Um comentarista no Reddit a chamou de "an Apache styled license", o que é uma descrição bem adequada.
Como você roda o modelo?
Você tem mais opções do que na maioria dos lançamentos no primeiro dia. A NVIDIA e seus parceiros disponibilizaram:
- Ollama:
ollama run nemotron-3.5-boltbaixa a versão de 25GB com contexto de 256K e entrada de imagem. O Ollama também lista comandos de inicialização de uma linha para Claude Code, OpenCode, Hermes Agent e OpenClaw. - llama.cpp: o GGUF da própria NVIDIA mais um arquivo separado do modelo de rascunho. A NVIDIA diz que a versão é "optimized for use on RTX Spark with llama.cpp and DGX Spark with vLLM."
- vLLM: precisa de uma versão nightly e, por enquanto, só oferece suporte a GPUs da geração Blackwell.
- LM Studio, Unsloth e um snap da Canonical completam as opções.
A estrutura para execução de agentes locais é o verdadeiro caso de uso. A NVIDIA propõe entregar ao Bolt projetos "from researching the web to writing to debugging code", sem enviar o trabalho para a nuvem. Os usuários que mais gostam dele dão a ele uma tarefa bem delimitada, com um ponto de chegada claro:
"I really don't hate this model. I was expecting to, it's a 2 bit quant for fucks sakes, but it seems to do really well when it's got some tools, a defined goal and a success condition such as 'compile works and tests pass'."
O que dizem os primeiros usuários que testaram?
A reação no r/LocalLLaMA é positiva, com um limite claro. Quatro temas apareceram repetidamente.
O truque dos 2 bits funciona melhor do que o esperado. Um comentarista chamou "74GB QAT coming in at 24GB on disk" de "pretty incredible" e disse que ele "has a decent chance of retiring Qwen3.6-35B for some people." Outro o usa em uma tarefa de ingestão de fax no trabalho, na qual ele superou o modelo de visão anterior em uma comparação direta.
Ele fica abaixo do Qwen 3.8 27B denso no trabalho real. O teste mais cuidadoso que encontrei executou 33 tarefas de infraestrutura em uma RTX 5090:
"26 of 33 passed, with the LiLiCorr drafter on. On the same tasks the same day qwen3.8:27b passed 32, qwen3.6:27b 31, gemma4:31b and glm-4.7-flash 29, qwen3.6:35b and gemma4:12b 27."
Uma segunda pessoa executou 36 tarefas às cegas contra o Gemma 31B e achou o Bolt "about 3.5 times faster, but it made up more problems that weren't there."
Ele explora muito. A mesma pessoa que fez o teste de 33 tarefas descobriu que 54% das chamadas de ferramentas eram sondagens e diagnósticos, e resumiu isso como "Careful, and expensive in turns." Outro usuário viu o modelo ignorar a instrução sobre Docker no seu arquivo AGENTS.md.
A segurança é uma verdadeira incógnita. Este é o ponto mais importante para qualquer coisa voltada ao cliente:
"It is not safe for an agent; it failed 6/21 jailbreak tests. Qwen3.8 Flash and 27 B failed none."
É o teste de uma pessoa, e uma resposta na mesma discussão trouxe um contraponto justo: "If you're relying on model weights to protect you from hostile content, you're doing it wrong." As duas coisas são verdadeiras.
E o Bolt E4B?
O Bolt E4B é o modelo para acompanhar se você desenvolve produtos de voz ou dispositivos. A página do E4B da NVIDIA afirma "~40% higher average quality" que seu modelo anterior de 4B e "up to ~80% fewer tokens vs peers", e lista "customer service" entre seus usos como assistente de voz. Ele tem um modo de conversa que mantém as respostas curtas o suficiente para serem faladas, e oferece suporte a 35 idiomas.
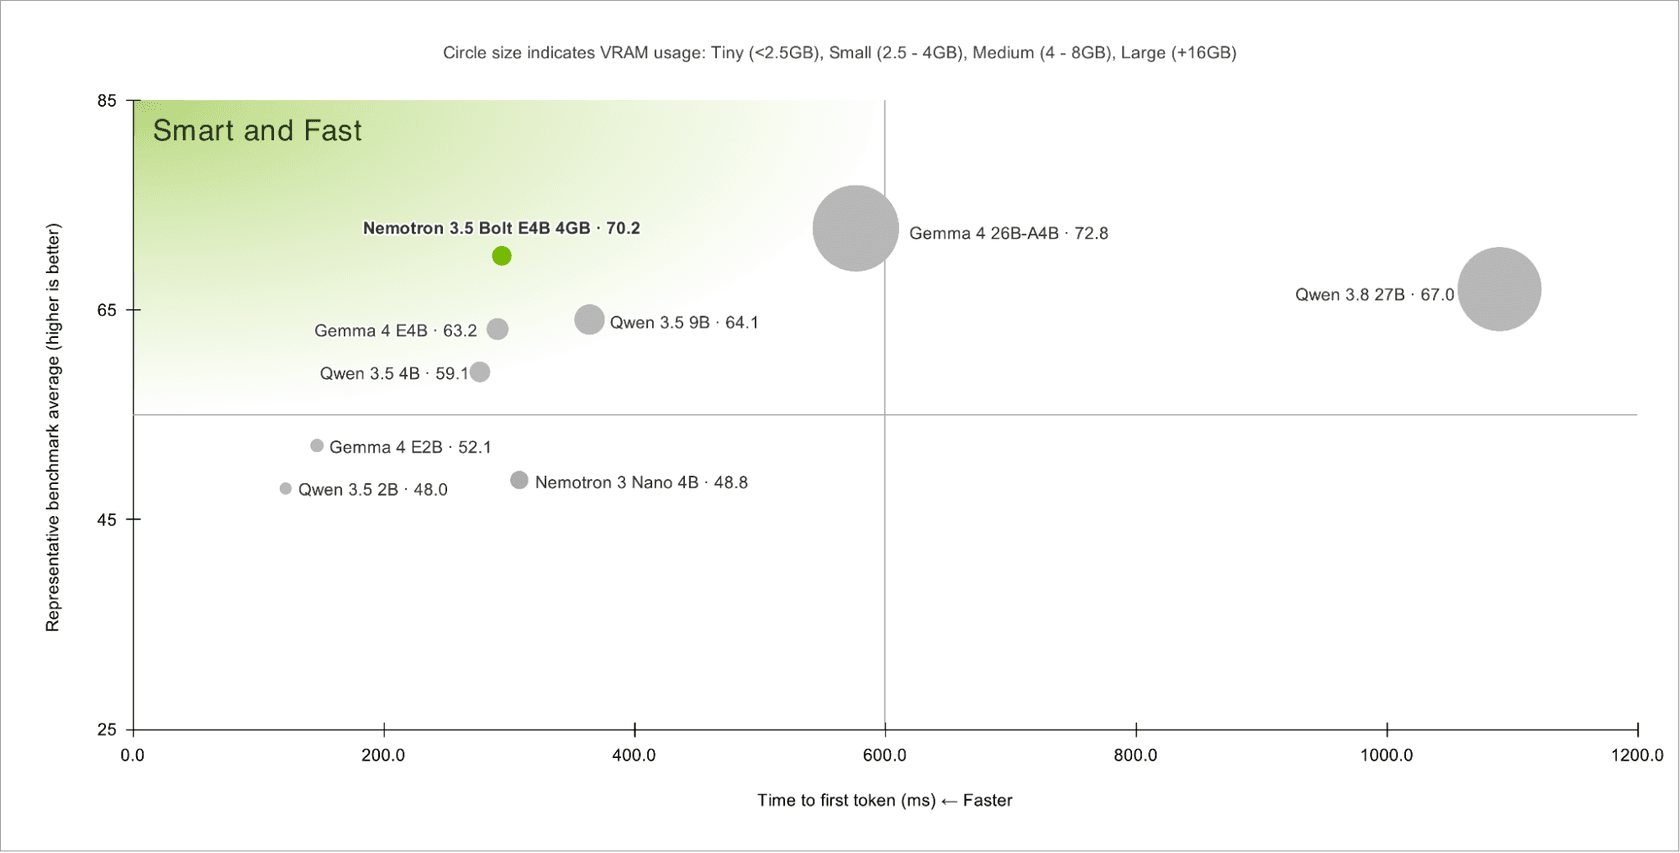
Ele é rápido. Em uma RTX 5070, retorna o primeiro token em 548 milissegundos e roda a 133.4 tokens por segundo, usando 3.5GB de memória de vídeo. Até um Jetson Orin Nano consegue 15.5 tokens por segundo.
A tabela de benchmarks é, na maior parte, uma vitória, com uma linha à qual as equipes de suporte devem prestar atenção:
| Benchmark | Bolt E4B | Qwen 3.5 4B | Gemma 4 E4B |
|---|---|---|---|
| IHEval (hierarquia de instruções) | 84.8 | 60.6 | 67.0 |
| RoleMRC | 80.6 | 65.8 | 74.6 |
| RAGTruth F1 | 77.6 | 75.6 | 77.0 |
| BFCL-v3 (chamadas de ferramentas) | 68.5 | 70.9 | 66.4 |
| Tau2-Bench (tarefas de clientes) | 55.1 | 75.1 | 38.5 |
O Qwen 3.5 4B o supera por 20 pontos no Tau2-Bench, o benchmark que simula um agente lidando com solicitações de clientes de acordo com uma política da empresa. Se você está desenvolvendo um agente de voz para suporte ao cliente, teste os dois.
O Nemotron 3.5 Bolt é uma boa opção para suporte ao cliente?
Ele é uma boa opção para uma parte do suporte, e uma opção arriscada para a parte à qual as pessoas geralmente se referem.
A parte boa: manter os dados dentro de casa. Um modelo que roda em uma máquina com uma licença permissiva responde claramente à pergunta "para onde vão os nossos dados?". Para trabalho interno, como resumir tickets, classificá-los ou elaborar respostas que um atendente revisa, um Bolt local é um motor razoável, e sua pontuação no Tau3 Banking (17.01) supera todos os pares na tabela da NVIDIA.
A parte arriscada: responder diretamente aos clientes. 17% em um benchmark de atendimento ao cliente bancário ainda é baixo em termos absolutos. Some a isso uma taxa relatada de falha em jailbreak de 6 em 21 e o hábito de explorar com chamadas extras de ferramentas, e você tem um modelo que precisa de muita estrutura de apoio antes de falar com um cliente. Toda mensagem de cliente é uma entrada não confiável.
O que essa estrutura de apoio precisa fazer é a parte com a qual passo meus dias trabalhando. A eesel aprendeu cedo que um detalhe errado é pior do que nenhuma resposta, e é por isso que toda implantação é simulada com tickets históricos antes que uma IA responda a um cliente real. Um dos nossos clientes com caso publicado, uma empresa de automação industrial, opera um chat que responde aos seus engenheiros apenas com base nos seus documentos técnicos e informa de onde veio cada resposta. Não encontrar uma resposta é um resultado aceitável ali. Essa é uma propriedade do sistema ao redor do modelo, não dos pesos. Nosso guia para prevenir alucinações de IA no suporte aborda as proteções em mais profundidade.
Então, meu veredito: se você tem engenheiros, uma GPU NVIDIA de 24GB+ e um motivo para manter os dados localmente, vale dedicar um fim de semana ao Bolt. Ele não é algo que você conecta à sua fila do Zendesk AI na segunda-feira. Se você está comparando ferramentas prontas, comece pela minha seleção de softwares de helpdesk com IA.
Quem deve usar o Nemotron 3.5 Bolt?
Veja como eu decidiria:
- Você roda agentes locais de programação ou pesquisa em uma GPU. É exatamente para isso que o Bolt 74B foi feito. Dê a ele ferramentas e uma condição clara de sucesso.
- Você precisa manter os dados fora da nuvem. Dados regulamentados, um contrato que proíbe processadores externos de IA ou um notebook em um avião. A licença e o uso de 24GB facilitam justificar essa escolha.
- Você desenvolve produtos de voz, jogos ou dispositivos. O Bolt E4B é rápido, pequeno e de poucas palavras por projeto.
- Você quer o modelo mais inteligente que cabe em 24GB. Olhe primeiro para o Qwen3.8 27B e aceite que ele é cerca de 3x mais lento. Ou opte por hospedagem com Qwen3.8 Flash-Next ou DeepSeek V4 Flash.
- Você precisa de uma API hospedada nesta semana. O Bolt não tem uma. Use o Nemotron 3.5 Super VL, que está no OpenRouter.
Experimente a eesel
O Nemotron 3.5 Bolt é infraestrutura: pesos gratuitos, uma GPU e um fim de semana de configuração. Você ainda teria que construir a recuperação de informações, as regras de escalonamento, os testes e a trilha de auditoria. A eesel é o funcionário. Nosso colega de equipe de helpdesk com IA se conecta ao Zendesk, Freshdesk, Gorgias e aos demais, aprende com seus tickets anteriores e sua central de ajuda, e responde apenas com base no seu próprio conhecimento. Antes de responder a um único cliente, você pode testá-lo com centenas dos seus tickets históricos e ver o que ele teria dito.
É assim que a Dokument 24 o usa no Zendesk: em um mês, o colega de equipe preparou 680 tickets para a equipe e deixou 670 rascunhos de respostas em dinamarquês como notas internas, prontos para enviar ou editar.

Se você gosta de comandar agentes por um terminal da mesma forma que comandaria um modelo local, a eesel CLI opera o mesmo colega de equipe. Você pode ler e editar suas instruções permanentes, listar ações aguardando aprovação humana e verificar o registro de atividade de cada execução, com saída JSON e simulações nas operações de escrita, para que um agente de programação como o Claude Code possa gerenciar seu colega de suporte junto com seu repositório. Se você escreve conteúdo em vez de responder a tickets, o mesmo elenco tem um redator de blog com IA.
É grátis para começar. Experimente a eesel nos tickets do mês passado antes de comprar uma placa de 24GB para isso, e veja os planos na página de preços.