

O que é o Reflection AI Beam?
O Beam é o primeiro modelo da Reflection AI, um laboratório que dois ex-pesquisadores do Google DeepMind fundaram em 2024. Por dentro, é um modelo de mistura de especialistas (MoE) esparso, com 501 bilhões de parâmetros no total, 23 bilhões ativos em cada token. O alvo do treinamento foi trabalho de programação e raciocínio, com cargas de trabalho de agentes por cima.
Isso o coloca também na mesma faixa do Kimi K3, do Qwen3.8 Max e do DeepSeek V4 Flash.
Ele também fica ao lado da outra aposta open-weight americana deste ano, o Inkling.
Eu construo agentes de IA para viver, então costumo ler um post de lançamento como a ficha técnica de um carro antes do test drive: os números que importam são os que acabam na sua fatura e nos seus logs de latência. No caso do Beam, o que torna os números interessantes é principalmente como foram obtidos:
- Pré-treinamento:
23.8Ttokens, executado de ponta a ponta em menos de quatro semanas em6,144GPUs NVIDIA GB300, segundo o post de lançamento da Reflection. - Aprendizado por reforço:
10.5KGPUs GB300 por quatro semanas, gerando mais de100 millionde rollouts em quase um milhão de ambientes de treinamento. - Arquitetura:
52camadas, atenção local e global intercaladas e especialistas roteados de granularidade fina com utilização quase uniforme (o especialista mais ocupado roda com apenas1.04xda carga média). - Entrada: apenas texto. Entradas de imagem, áudio e arquivo não são suportadas na API, segundo a documentação de compatibilidade com a OpenAI.
- Licença: Apache 2.0, prometida para "este mês", junto com versões quantizadas FP8 e NVFP4, segundo o thread de lançamento da Reflection.
O lançamento recebeu muita atenção. O post oficial no X passou de 8,492 curtidas, enquanto o tópico do Hacker News chegou a 549 pontos e 174 comentários nos primeiros dias.
O que dá para usar hoje versus o que foi anunciado
A maior parte da cobertura do lançamento pula esta parte, o que é uma pena, porque ela decide se o Beam entra ou não nos seus planos deste mês. O anúncio descreve o modelo que a Reflection treinou, e a documentação para desenvolvedores descreve o modelo que você de fato pode chamar. Por enquanto, os dois não são a mesma coisa.
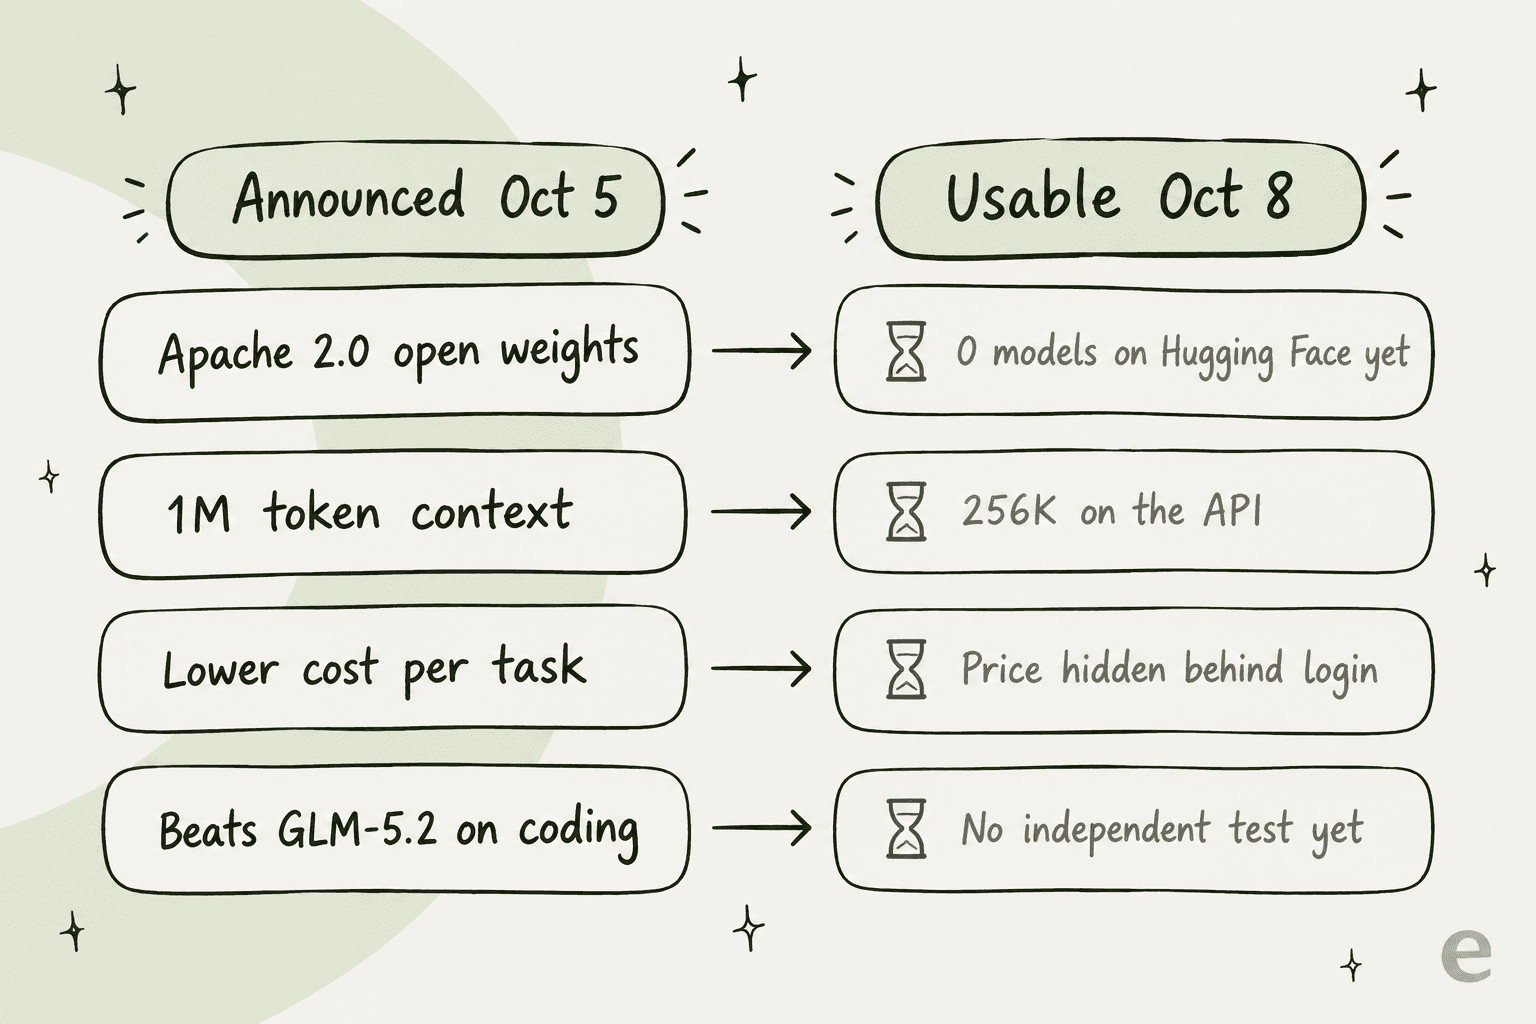
| O que o lançamento diz | O que a API e a documentação dizem (8 out. 2026) | |
|---|---|---|
| Pesos | Apache 2.0 "este mês" | A organização da Reflection no Hugging Face tem 0 modelos |
| Janela de contexto | Contexto efetivo estendido para 1M tokens | 256K de contexto, 128K de saída máxima, "may change during beta" (Models) |
| Acesso | Acesso antecipado para "a select group of users" | Lista de espera; chaves só quando o acesso é habilitado (Authentication) |
| Preço | "Lower cost" por eficiência | Sem tarifa pública; a página de preços fica atrás do login |
| Limites de uso | Não mencionados | Limites por organização e uma cota diária de tokens, sem números publicados (Rate limits) |
| Raciocínio | Esforço controlável | Sempre ligado, cinco níveis de low a max, padrão medium (Reasoning) |
| Data de corte do conhecimento | Não informada | 30 de junho de 2026 |
A janela de contexto é a lacuna que eu mais destacaria. Se o seu plano é um fluxo com documentos longos ou repositórios inteiros construído em torno de "1M tokens", a API beta hoje limita você a um quarto disso. Eu não chamaria de promessa quebrada, já que capacidade de treinamento e limites de serviço são coisas diferentes, mas isso muda o que você consegue construir em outubro.
O usuário do Hacker News adrian_b explicou o prazo em termos simples:
"They claim that they will release the model as open weights later this month. That means that they have the 31th of October as the deadline to make true their claims."

Como o Beam funciona: 23B trabalhando, 501B armazenados
O design MoE é praticamente toda a história do Beam, então vale gastar um minuto em linguagem simples nele. Um modelo de mistura de especialistas divide seus pesos em muitas redes pequenas de "especialistas", e para cada token um roteador escolhe um punhado delas, e só esses especialistas fazem cálculo. É por isso que um modelo de 501B pode custar por token mais ou menos o mesmo que um modelo denso de 23B.
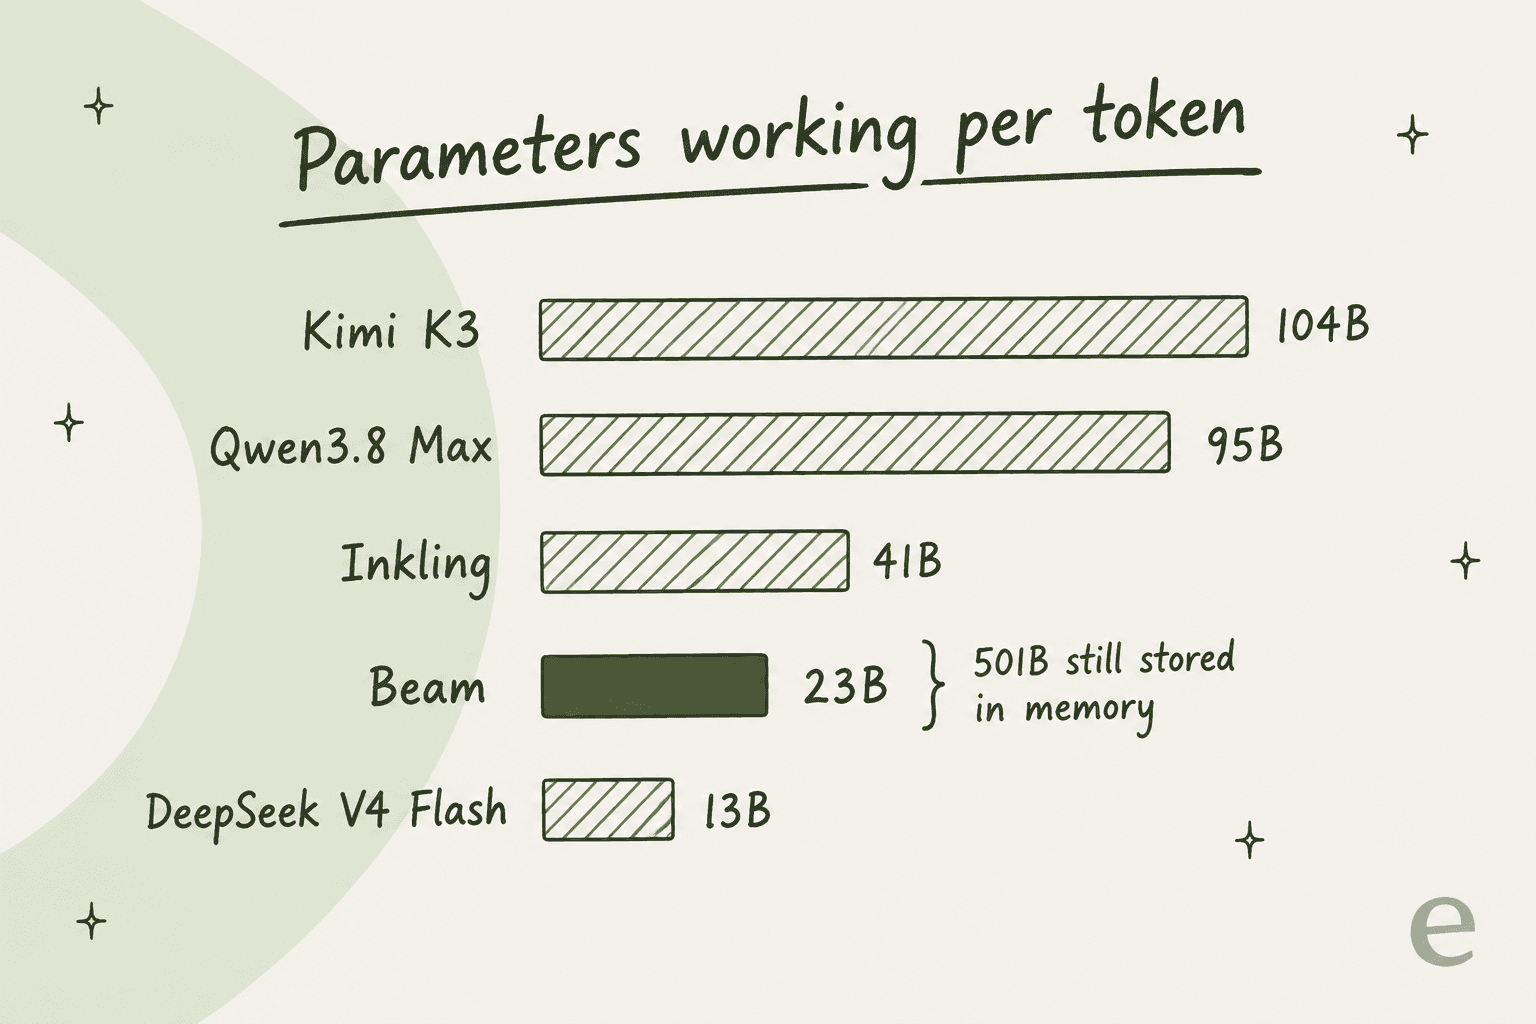
A pegadinha que muita gente deixa passar é esta: parâmetros ativos definem sua conta de computação, parâmetros totais definem sua conta de hardware. Todos os 501B precisam estar na memória, porque no próximo token o roteador pode escolher qualquer especialista. Então, por token, o Beam é barato de executar, mas não é pequeno para hospedar. Ao lado do Kimi K3, com 2.8T totais e 104B ativos, o Beam é mais leve nos dois aspectos, e ao lado do DeepSeek V4 Flash, que ativa só 13B, ele faz mais trabalho por token.
O comprimento do raciocínio é a outra alavanca. A Reflection treinou o Beam com uma penalidade de comprimento que premia respostas corretas e desencoraja tokens desnecessários, e depois expôs esse equilíbrio pelo parâmetro reasoning_effort. Nos gráficos de eficiência deles, a pontuação é plotada contra quantos tokens cada modelo gasta:
Sob o gráfico, a Reflection declara uma ressalva honesta: as estimativas de computação deixam de fora o prefill do prompt, os custos de atenção e a sobrecarga de serviço, então "represent an approximate compute comparison rather than measured inference cost." Em outras palavras, o que você vê é o formato da eficiência, e não uma fatura.
Benchmarks do Beam: onde ele realmente fica
A Reflection publicou uma tabela de benchmarks ampla e, a seu favor, ela inclui modelos que superam o Beam. Abaixo estão as linhas que eu olharia para trabalho com agentes e programação, e cada número vem da tabela da própria Reflection. "NR" significa not reported (não reportado).
| Benchmark | Beam | GLM-5.2 | Kimi K3 | Qwen3.8 Max | DeepSeek V4.1 Flash | Inkling |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | NR | NR | NR | NR | 77.6 |
| SWE-bench Pro v1 | 65.5 | 62.1 | NR | 67.7 | NR | 54.3 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 88.3 | 86.6 | 90.6 | 63.8 |
| DeepSWE v1.1 | 44.4 | 44.0 | 68.0 | 51.0 | 74.2 | NR |
| MCP Atlas | 78.7 | 77.8 | 82.3 | 84.5 | NR | 76.0 |
| tau3 banking | 38.0 | 37.1 | 37.1 | 55.2 | NR | 25.0 |
| HLE (no tools) | 36.2 | 40.5 | 46.9 | 43.6 | 39.1 | 29.7 |
| GPQA Diamond | 90.5 | 91.2 | 93.5 | 92.6 | 90.9 | 87.2 |
Lendo as linhas lado a lado, o quadro é bem claro: o Beam troca golpes com o GLM-5.2 e supera com folga o Inkling, mas fica atrás do Kimi K3, do Qwen3.8 Max e do DeepSeek V4.1 Flash onde esses reportaram resultado. O enquadramento da própria Reflection está alinhado a isso, ao dizer que o Beam é "competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks," enquanto "frontier open models like Kimi K3 remain ahead on raw capability."
O 80.9 de destaque no SWE-bench Verified precisa de uma nota de rodapé, e um usuário do X chamado LuChai a escreveu bem:
"The 80.9 on SWE Bench Verified is the standout, but worth flagging that GLM-5.2 and Qwen 3.8 Max are both NR there"
Também não há até agora um árbitro independente. Em 8 de outubro, o Beam não está listado no Artificial Analysis (a lista de 696 modelos não tem entrada do Beam) e também não aparece no ranking do tau-bench da Sierra. Para contexto, o Artificial Analysis atualmente pontua o Qwen3.8 Max com 45.4, o Kimi K3 com 43.6 e o GLM-5.2 com 33.7 no seu Intelligence Index. Se o Beam realmente fica perto do GLM-5.2, eu esperaria vê-lo em algum ponto dos 30 depois de testado, e o Mistral Large 4, outro lançamento ocidental recente, é uma régua útil para isso.
Outra coisa de que gostei é que a Reflection mostra que sua execução de RL continuou melhorando sem estagnar, um bom sinal para o próximo modelo da série.
Quanto vai custar o Reflection AI Beam?
Resposta curta: ninguém fora da lista de espera sabe ainda. Tanto a plataforma da Reflection quanto a página /pricing mostram apenas uma tela de login. Segundo os termos comerciais, as taxas estão "set forth in the pricing documentation" na plataforma, e essa documentação fica atrás do mesmo login.
A documentação de erros e cobrança revela uma coisa, que é o formato da cobrança:
- Um saldo de créditos ou pré-pago (
402 insufficient_credits,prepaid_balance_exhausted) - Um cartão verificado antes de algumas organizações poderem criar chaves de API (
403 payment_method_required) - Faixas de cobrança e uma cota diária de tokens definidas pelo seu plano
Como não há preço do Beam para citar, aqui está a faixa em que o Beam precisaria cair para que sua história de eficiência importe. Abaixo estão as tarifas de API dos próprios fabricantes para os modelos da tabela de comparação da Reflection, por 1M de tokens:
| Modelo | Entrada | Entrada em cache | Saída | Fonte |
|---|---|---|---|---|
| Kimi K3 | $3.00 | $0.30 | $15.00 | Kimi platform |
| Qwen3.8 Max | $2.00 | $0.25 | $6.00 | Qwen Cloud |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.ai pricing |
| DeepSeek V4.1 Flash | $0.30 | $0.006 | $1.20 (peak) | DeepSeek pricing |
| Reflection Beam | Não publicado | Não publicado | Não publicado | Apenas lista de espera |
Digamos que o Beam fique perto do GLM-5.2 em qualidade. Então o argumento de eficiência só compensa se ele custar igual ou menos que os $1.40 / $4.40 do GLM-5.2, e ainda precisa se justificar diante do DeepSeek V4.1 Flash, que pontua mais alto na maioria das linhas da própria Reflection por uma fração dessas tarifas. Para ver como esses números se comportam por tarefa, veja minhas análises mais detalhadas dos preços do GLM e dos preços do Qwen3.8 Max.
Hospedar por conta própria muda a conta, mas não a fatura de hardware. Uma resposta no X a um post de "run it on your desk" fez o contraponto em termos diretos:
"m5 studio 512GB is like $20 grand... this is realistically a $40k investment, to use 6 month old AI."
Termos de dados para ler antes de enviar dados reais
Os termos da Reflection dividem o serviço em dois tipos. Nos Standard Services pagos, você licencia seu conteúdo à Reflection "solely to operate and provide the Services." Nos serviços gratuitos ou Discounted Services, a licença é muito mais ampla e inclui o direito de "create derivative works of, and otherwise exploit" seu conteúdo. Nos dois casos, o conteúdo é mantido por 30 dias por segurança e conformidade, e o conteúdo sinalizado por até 12 meses. Se você está testando o Beam com conversas de clientes em um plano de acesso antecipado com desconto, essa é a cláusula que eu leria duas vezes.
Como usar o Beam agora
Quando você sair da lista de espera, a API é fácil de encaixar. A Reflection mantém um endpoint compatível com a OpenAI em https://api.reflection.ai/openai/v1, o que significa que código construído com os SDKs da OpenAI funciona depois de trocar a URL base e a chave. O ID do modelo é Beam-501B-A23B.
Há algumas pegadinhas na documentação que vale conhecer antes de construir:
- Só Chat Completions e Models são suportados. Sem Responses API, embeddings, batch, files ou assistants.
- Sequências
stopsão aceitas, mas ignoradas. A geração não para nelas, então não conte com isso para parsing. - O raciocínio não pode ser desligado. Escolha
lowpara velocidade,maxpara tarefas difíceis. O texto de raciocínio volta em um campo separado,reasoning_content. né fixo em 1 e os logprobs estão desligados. Se o seu harness de avaliação amostra várias completions por chamada, ele precisa de um loop.- Tool calling e saídas estruturadas funcionam, incluindo
parallel_tool_callsejson_schema.
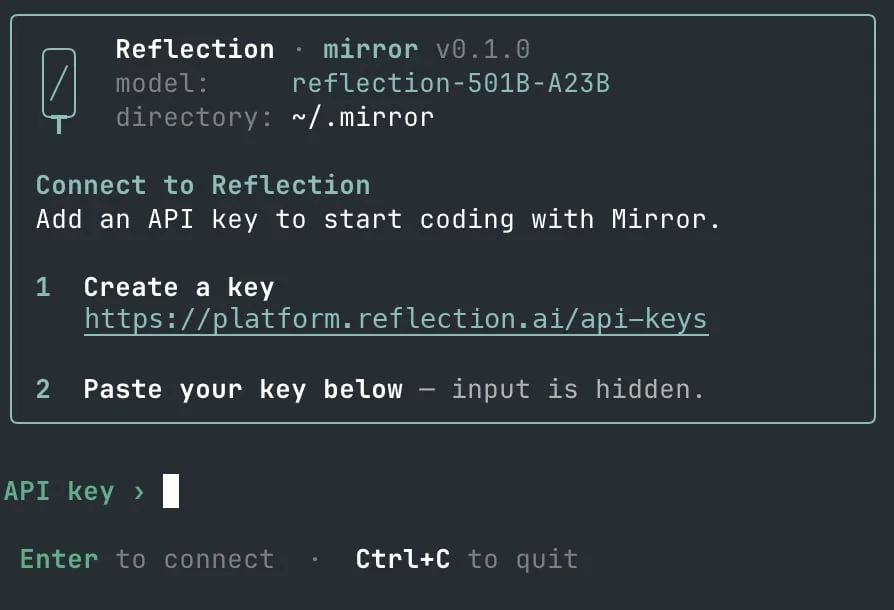
Para trabalho de programação, a Reflection entrega seu próprio agente de terminal, a Mirror CLI, com o Beam como modelo padrão. Ainda está em beta inicial e suporta worktrees paralelos e instruções AGENTS.md, além de conexões MCP com ferramentas como Linear e Notion. O guia rápido da Reflection também mostra como ligar o Beam ao Pi, ao OpenCode e ao Hermes Agent, o que é útil se você já vive em um deles.
Se você ainda está escolhendo um harness, esse lado é coberto nos meus posts sobre o agente de programação Pi e a CLI de programação agêntica.
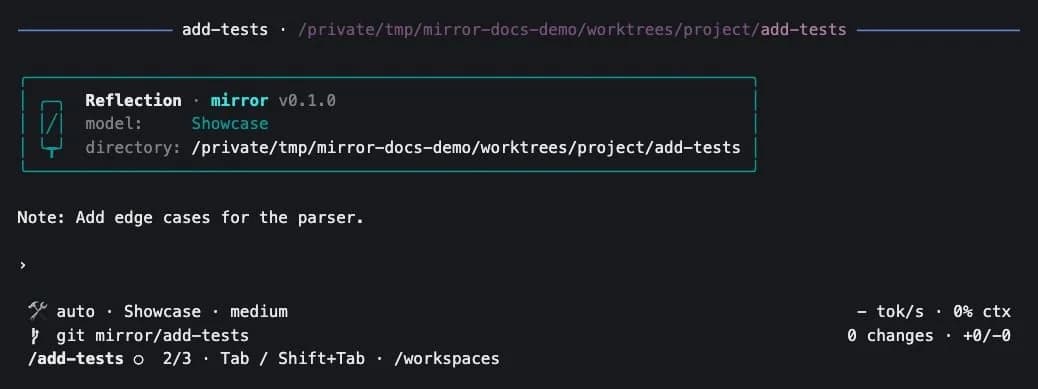
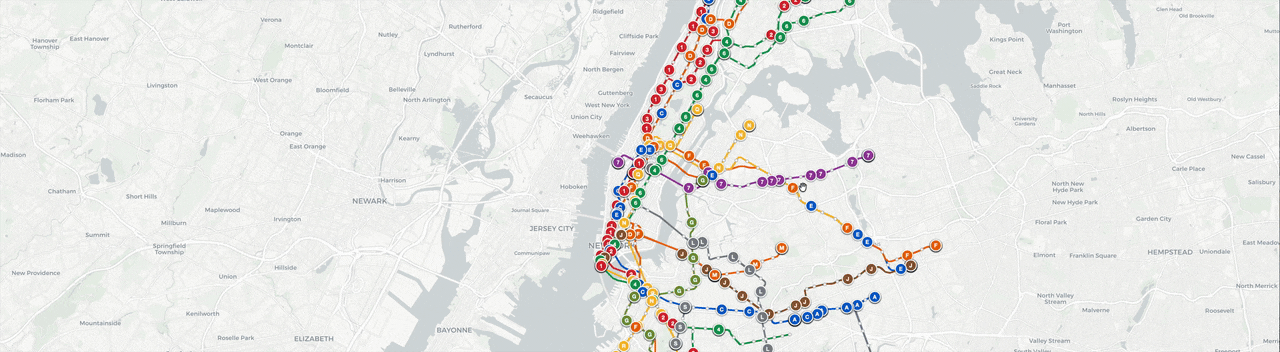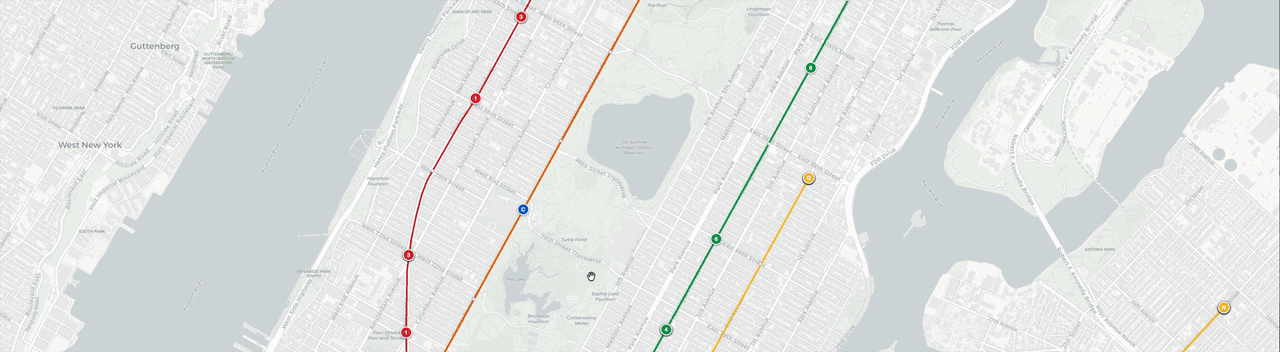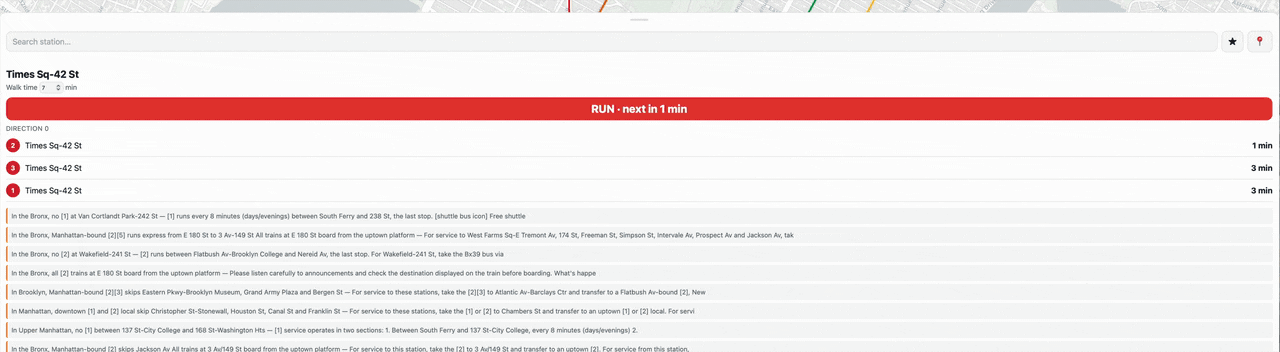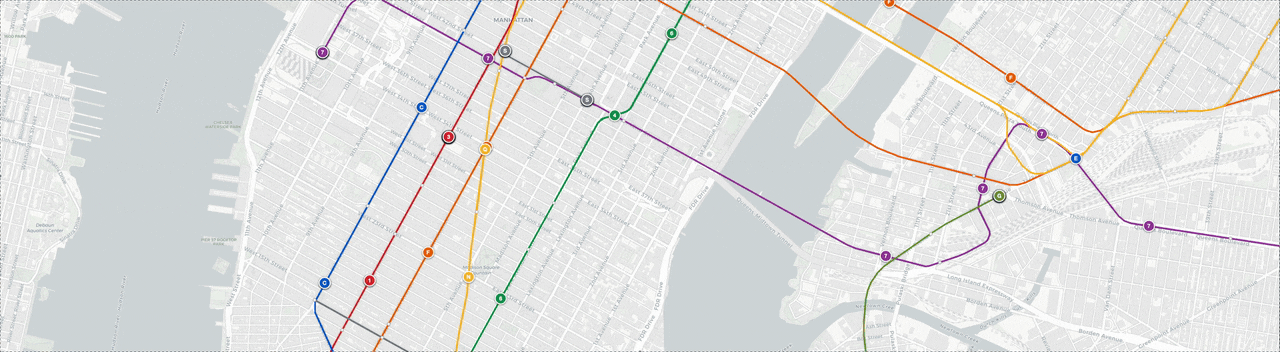
As próprias demos da Reflection apostam forte nesse ângulo de agentes. Minha favorita é o mapa ao vivo do metrô de Nova York, em que o Beam pesquisou a documentação da MTA e resolveu a autenticação, depois encontrou a geometria do metrô e construiu tanto o frontend quanto o backend:
Uma demo precisou de correção depois do lançamento. A demo "Land or Water" da Reflection afirmou primeiro que o quebra-cabeça tinha apenas alguns dias, então não poderia estar nos dados de treinamento. Depois que um usuário do HN apontou que ele era mais antigo, um membro da equipe da Reflection respondeu que a legenda havia sido alterada. É algo pequeno e foi tratado de forma aberta, mas vale ter em mente ao ler as demos.
O que os desenvolvedores estão dizendo sobre o Beam
Passei pelo tópico do Hacker News e pelo r/LocalLLaMA, além de X e LinkedIn, e os mesmos três temas voltavam o tempo todo.
"Show me the weights." Até os pesos serem lançados, muita gente simplesmente não vai contar o Beam como aberto. Os moderadores do r/LocalLLaMA removeram o tópico do lançamento exatamente por esse motivo:
"Until such time that weights become available, this is off-topic for LocalLLaMA."

"It's a generation behind, but it's American." A maioria dos comentaristas coloca o Beam em torno do GLM-5.2, que é um modelo de junho. A empolgação tem mais a ver com onde ele foi construído, e para equipes que não podem usar modelos de origem chinesa, essa é a decisão inteira:
"I'm in a similar situation to you where we can't use Chinese AI models but we want to host on-prem due to data sovereignty concerns. ... I'm also keeping an eye on Reflection Beam"
"Nice efficiency claim, now let someone check it." Até as opiniões positivas vêm com essa ressalva. Tyler Folkman, Chief AI Officer da JobNimbus, resumiu como os profissionais vão dimensioná-lo:
"Nobody outside Reflection has verified any of this yet. ... When Beam's weights ship, I'm sizing them for my boxes by active parameters and quantized footprint, not the leaderboard."

A Reflection também ganhou algum crédito pela franqueza. Um comentarista do HN elogiou a Reflection por admitir que o Kimi K3 está à frente "instead of making false claims." Concordo, já que um post de lançamento que cita os modelos que o superam é mais raro do que deveria.
O Beam é um bom modelo para atendimento ao cliente?
Esta é a pergunta que mais me importa, já que meus dias são dedicados à IA que responde tickets de suporte. A boa notícia é que a Reflection reportou uma pontuação em um benchmark que realmente se parece com trabalho de suporte.
O tau3 banking vem do tau-bench da Sierra. Ele coloca o modelo em um helpdesk bancário simulado com 698 documentos de políticas e pede que resolva solicitações de clientes por meio de ferramentas. Uma tarefa só passa quando a conta do cliente termina no estado correto, ou seja, uma resposta educada mas errada vale zero. Cada tarefa exige cerca de 18.6 documentos e 9.5 chamadas de ferramentas.
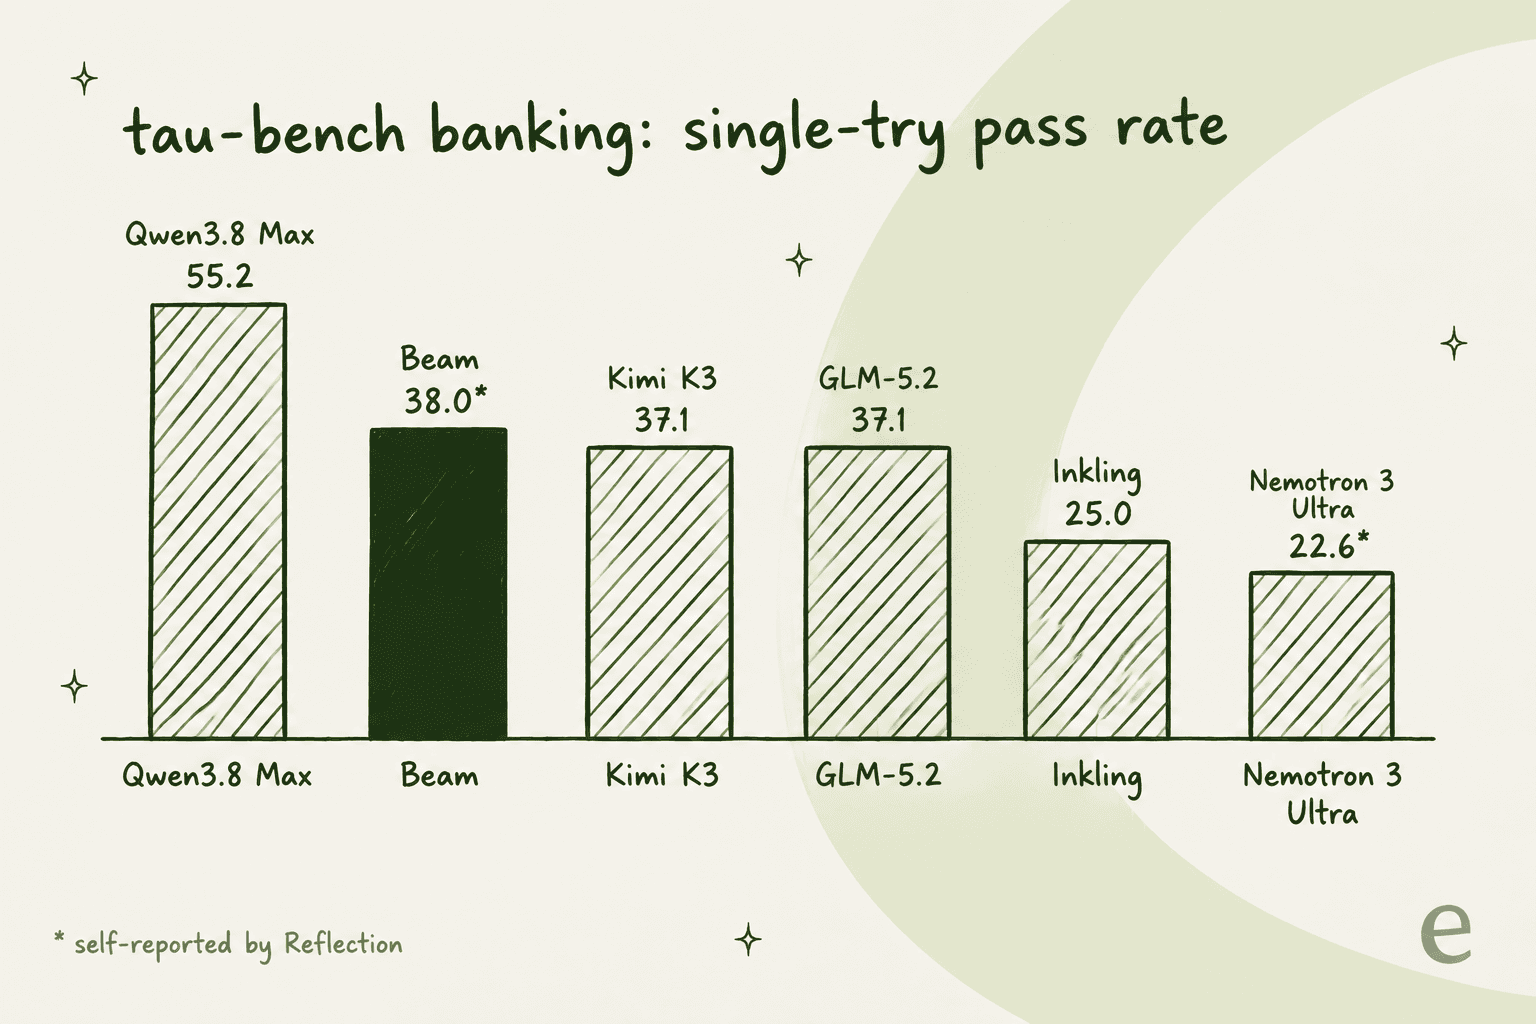
Os 38.0 do Beam ficam mais ou menos no nível do Kimi K3 e do GLM-5.2 (ambos 37.1 no ranking da Sierra) e bem atrás do Qwen3.8 Max, com 55.2. A Reflection não diz qual configuração de teste gerou seus 38.0, então eu trataria como próximo, não exato. O campo todo também cai quando se exige consistência: no ranking da Sierra, o Qwen3.8 Max cai de 55.2 para 35.1 quando uma tarefa precisa passar nas quatro tentativas.
Esse último número é a verdadeira lição para equipes de suporte, e eu a cobri em profundidade na minha análise do melhor modelo de IA para tickets de suporte: mesmo o melhor modelo acerta um ticket cheio de políticas todas as vezes em apenas cerca de um terço dos casos. Trocar por um modelo novo não resolve isso.
O que resolve é a camada ao redor do modelo, ou seja, basear as respostas na sua base de conhecimento real e em tickets passados e escalar para um humano as respostas de baixa confiança, além de testar no seu próprio histórico antes de qualquer coisa ir ao ar. Meu guia de implementação percorre essa ordem de lançamento.
Já vi essa falha acontecer em filas reais. Uma equipe de telemática veicular no Zendesk tinha um bot dizendo com confiança aos clientes "yes, we support your car model" para marcas que não estavam no banco de dados, tudo porque um artigo de ajuda dizia "we support all models." Nenhuma pontuação de benchmark teria pegado isso, mas uma simulação com os próprios tickets passados teria.
Então, para suporte especificamente, o Beam é um candidato razoável a motor quando tiver preço e os pesos estiverem disponíveis, mais ainda se sua empresa descarta modelos de origem chinesa. Sozinho, porém, não é um agente de suporte. Para essa parte você precisa de um agente de helpdesk com IA que conheça sua fila, e meu resumo de helpdesks com IA compara os que fazem isso.
Quem é a Reflection AI?
A Reflection foi cofundada em 2024 por Misha Laskin (CEO) e Ioannis Antonoglou, ambos ex-pesquisadores do Google DeepMind. No post de lançamento, Laskin atribui sua própria mudança da física para a IA ao AlphaGo, em 2016.
Há muito dinheiro por trás. O post da própria Reflection anunciou uma captação de $2 billion em 2025 com investidores como NVIDIA, Sequoia, Lightspeed, DST, CRV e Eric Schmidt, e sua sala de imprensa lista uma avaliação pre-money de $25 billion para a rodada de abril de 2026. No post de lançamento, Laskin também defende por que escolheram o caminho aberto:
"Open also means safer. The best defence is a distributed one."
Antonoglou acrescentou no X que a equipe já está "already training the next, larger model." O Beam, em outras palavras, é explicitamente o primeiro de uma série.
Um esclarecimento também surgiu no HN: esta Reflection não tem relação com o modelo "Reflection 70B" de 2024. Um comentarista corrigiu a confusão no tópico do lançamento, e a pessoa que a levantou retirou o que disse.
Então, você deve esperar pelo Beam?
Aqui é onde eu chegaria, dependendo do leitor:
| Se você é... | Minha recomendação |
|---|---|
| Uma equipe que precisa de um modelo aberto feito nos EUA (governo, setores regulados, política de "sem origem chinesa") | Entre já na lista de espera e planeje uma avaliação para o início de novembro |
| Quem constrói hoje agentes de programação com orçamento enxuto | Use agora o DeepSeek V4 Flash ou o GLM, e teste o Beam de novo quando ele estiver no Artificial Analysis |
| Quem busca o modelo aberto mais forte | Kimi K3 ou Qwen3.8 Max, segundo a própria tabela da Reflection |
| Quem planeja hospedar por conta própria | Espere pelos pesos FP8 e NVFP4, depois dimensione pela memória para 501B, não pela computação para 23B |
| Quem escolhe um modelo para uma fila de suporte | Escolha primeiro o agente, depois o modelo; veja abaixo |
eesel para equipes de suporte que acompanham a corrida de modelos
Se você chegou aqui porque está escolhendo um modelo para responder a clientes, o atalho é que você não precisa apostar sua fila em um único lançamento. O colega de helpdesk com IA da eesel se conecta ao Zendesk, Freshdesk ou Gorgias e aprende com seus tickets anteriores e sua central de ajuda, e depois executa uma simulação no seu histórico real de tickets antes de responder a qualquer pessoa. Quando um modelo melhor ou mais barato é lançado, o colega melhora e você não precisa reconstruir nada.

Ele também funciona para o público de terminal que lê um post sobre o Beam. Com a CLI da eesel você pode rodar o mesmo colega a partir de um shell, para coisas como conectar um helpdesk, editar suas instruções permanentes, aprovar ou negar ações pendentes e ler seu registro de atividade. Todo comando retorna JSON, e uma flag --dry-run mostra a chamada exata antes de ela ser enviada. Além disso, cada workspace é um servidor MCP, então um agente de programação como o Claude Code pode controlá-lo diretamente.
Os resultados costumam vir rápido quando o agente se baseia nos seus próprios dados. Foi assim que a Gridwise descreveu depois do teste:
"In the first month, eesel is resolving 73% of our tier 1 requests."

Experimente a eesel grátis com 100 créditos, sem cartão, ou veja os planos pagos na página de preços.