

O ERNIE 5.5 Flash é um modelo base aberto de 280B de parâmetros da Baidu, com 14B ativos por token, lançado em 5 de novembro de 2026. Na própria tabela da Baidu, ele supera o DeepSeek V4 Flash Base em 26 de 30 testes. Mas é um checkpoint de pré-treinamento: não há versão de chat ou de uso de ferramentas, nenhum preço de API hospedada, e a licença exclui a UE, o Reino Unido e a Coreia do Sul. Para um agente de helpdesk, vale esperar o modelo pós-treinado. Isto é o modelo; a eesel é o colega de equipe.
O que é o ERNIE 5.5 Flash?
O ERNIE 5.5 Flash é um modelo transformer mixture-of-experts esparso da Baidu. O que a Baidu lançou em 5 de novembro de 2026 é o ERNIE-5.5-Flash-Base, o checkpoint "ao final do pré-treinamento, antes de qualquer treinamento intermediário ou pós-treinamento". A Baidu diz que isso é deliberado: os desenvolvedores podem pegar os pesos e escolher para onde treiná-los a seguir.
Trabalho nos agentes de IA da eesel, então a primeira coisa que verifico em qualquer lançamento de modelo é em que etapa de treinamento os pesos estão. Aqui a resposta é a etapa mais precoce que se pode usar, e isso muda quase tudo sobre como ler o restante deste artigo.
A ficha técnica, da model card da Baidu:
| Especificação | ERNIE-5.5-Flash-Base |
|---|---|
| Parâmetros totais / ativos | 280B / 14B por token |
| Camadas | 43 (1 densa, 42 mixture-of-experts) |
| Especialistas | 512 roteados (top 10 por token) mais 1 compartilhado |
| Dados de pré-treinamento | 33.5T tokens |
| Contexto | 128K no treinamento, 1M para fine-tuning e inferência |
| Modalidade | Apenas texto |
| Pesos | Safetensors FP8 e BF16 |
| Vocabulário | 201,216 tokens |
| Licença | ERNIE 5.5 Flash Base Model License v1.0 |
Apenas cerca de 5% dos parâmetros trabalham em um token qualquer, e é assim que um modelo de 280B consegue rodar como um de 14B. É a mesma troca que o DeepSeek V4 Flash faz com 284B totais e 13B ativos.
O que há de novo no design?
O blog técnico da Baidu fala principalmente sobre custo: quanta memória um contexto longo consome, e quão barato é continuar treinando. Quatro escolhas se destacam.
- Atenção econômica. Uma em cada sete camadas mantém a atenção de contexto completo. O restante usa "Heavily Compressed Attention", que armazena uma única entrada de cache a cada 128 tokens, de modo que a janela de contexto custa muito menos memória.
- Vários roteadores por camada. Em vez de um único roteador escolher os especialistas, cada camada mixture-of-experts usa vários roteadores independentes, com o argumento de que a pontuação de um único roteador é um indicador fraco de qual especialista ajuda.
- Decodificação especulativa integrada. A última camada do modelo também funciona como modelo de rascunho, um design que a Baidu chama de ECHO, de modo que gerar mais rápido não exige um modelo auxiliar separado.
- Código e documentos longos nos dados. O pré-treinamento se apoia bastante em código em escala de repositório e dados de contexto longo, incluindo commits, pull requests e revisões de código.
Nada disso diz se o modelo é agradável para conversar. Diz que o modelo foi construído para ser barato de fazer fine-tuning e de servir, que é para o que serve um lançamento de modelo base.
O ERNIE 5.5 Flash é um modelo de chat?
Não, e esse é o fato mais importante sobre ele. Os pesos são o checkpoint de pré-treinamento, e a Baidu diz que o ERNIE 5.5 Flash pós-treinado virá a seguir. Nenhuma data foi informada. A model card diz que ele é servido pelo endpoint de completions, o que significa que você envia texto e ele o continua, sem formato de chat.
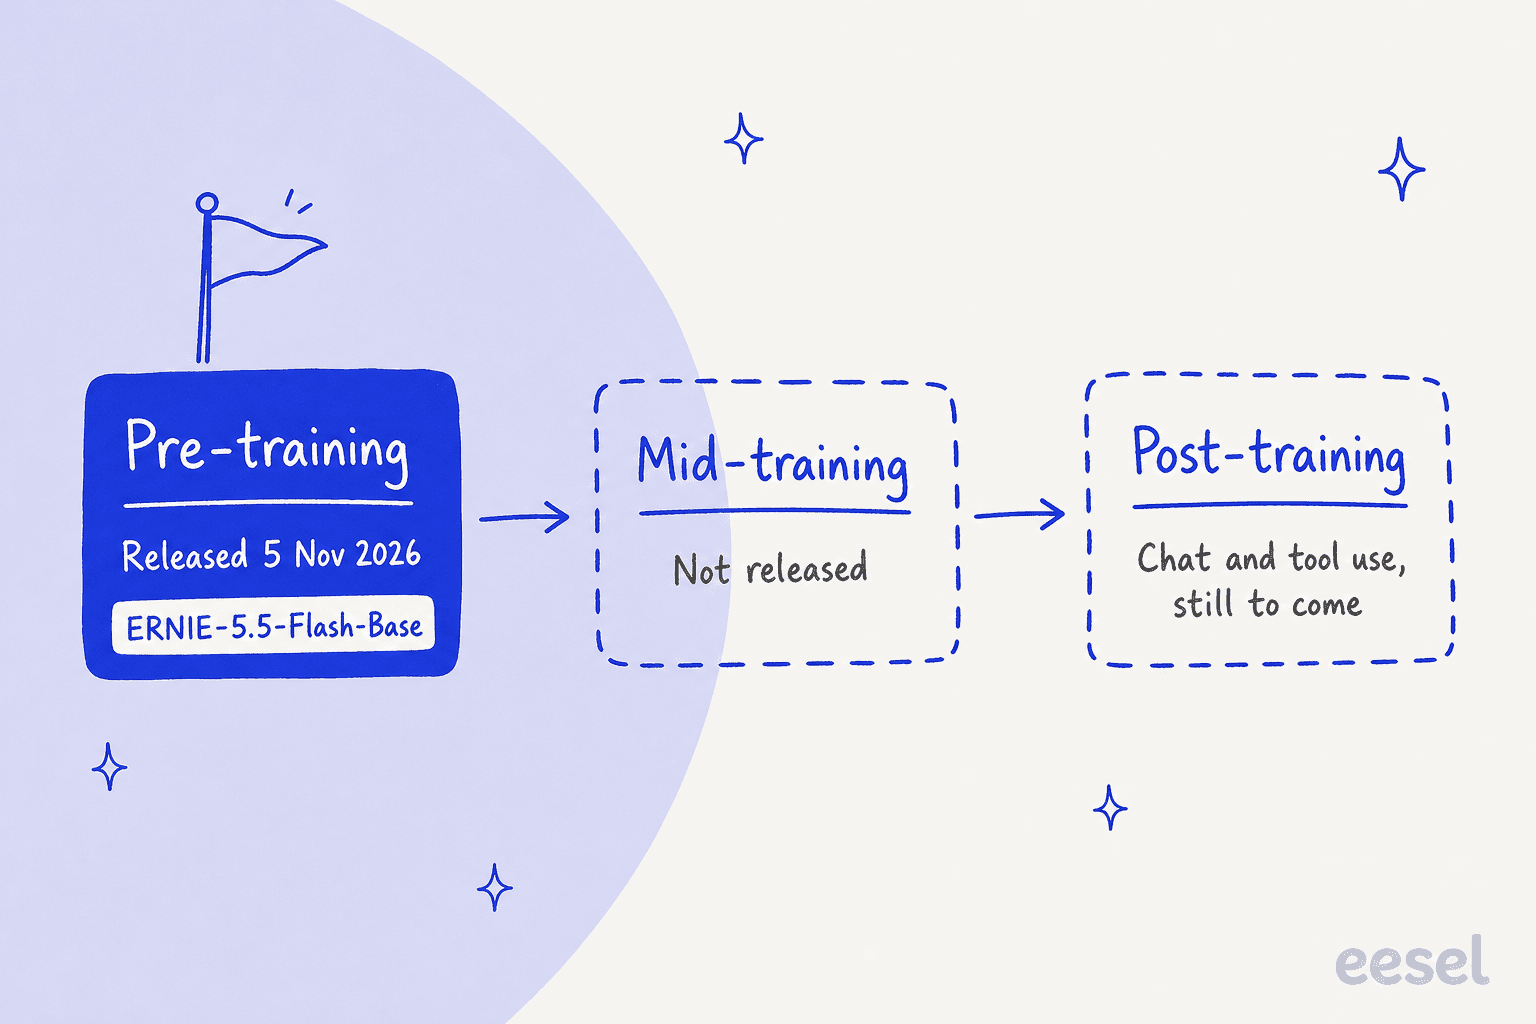
Um modelo pós-treinado é aquele que segue instruções, mantém uma persona, chama ferramentas e sabe dizer não. A linha principal da Baidu é separada: o lançamento do ERNIE 5.1 é datado de 9 de maio de 2026, e o ERNIE 5.0 é um modelo multimodal de 2,4 trilhões de parâmetros. O ERNIE 5.5 Flash é uma linha diferente, focada em eficiência, e por agora só seus ingredientes brutos são públicos.
Um comentarista do Hacker News resumiu o significado prático com clareza na thread de lançamento, que chegou a 162 pontos:
"It's not instruction finetuned, so no, it's not good to use for anything like coding agents."

O que dizem os benchmarks do ERNIE 5.5 Flash?
Na tabela da Baidu, o modelo base vence a maioria das linhas. A Baidu o comparou com três outros modelos base, DeepSeek-V4-Flash-Base (284B totais, 13B ativos), Hy3-preview-Base (295B, 21B) e MiMo-V2.5-Base (310B, 15B), "todos avaliados com o mesmo pipeline, os mesmos prompts e as mesmas configurações de few-shot". Contra o DeepSeek, o ERNIE pontua mais alto em 26 de 30 linhas.
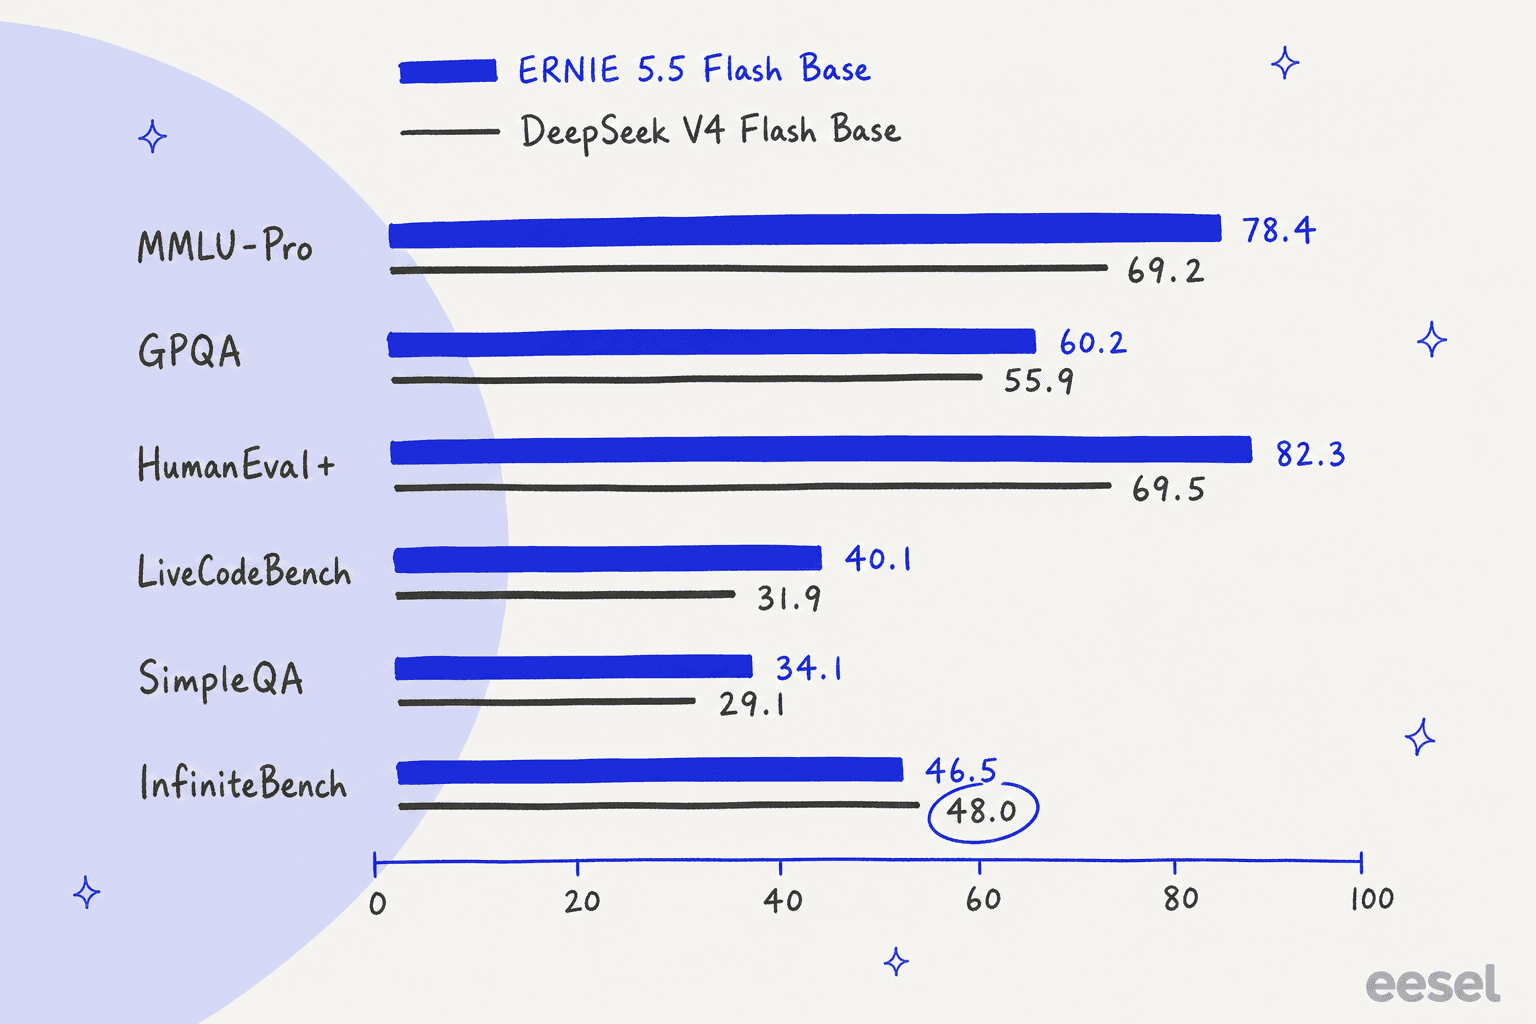
Aqui está um recorte da tabela completa, incluindo toda linha em que o ERNIE perdeu para o DeepSeek:
| Benchmark | ERNIE 5.5 Flash Base | DeepSeek V4 Flash Base |
|---|---|---|
| MMLU-Pro | 78.4 | 69.2 |
| GPQA | 60.2 | 55.9 |
| HumanEval+ | 82.3 | 69.5 |
| LiveCodeBench | 40.1 | 31.9 |
| RepoQA (contexto longo) | 91.7 | 81.0 |
| SimpleQA | 34.1 | 29.1 |
| ChineseSimpleQA | 73.0 | 75.3 |
| INCLUDE-lite (multilíngue) | 79.5 | 79.8 |
| HELMET-Rerank (contexto longo) | 56.2 | 60.0 |
| InfiniteBench (contexto longo) | 46.5 | 48.0 |
Três razões para tratar esses números com cautela:
- São testes da própria Baidu. Não consegui encontrar uma avaliação independente. A Artificial Analysis ainda não tem uma página para o ERNIE 5.5.
- São testes de modelo base. Benchmarks de conhecimento few-shot e de código medem o que o pré-treinamento construiu. Não medem se o modelo segue um system prompt ou completa uma tarefa de várias etapas.
- O rival não é o mais novo. Um comentarista do Hacker News observou que a Baidu comparou com a base V4 Flash mais antiga, basicamente duas versões atrás da versão mais recente do DeepSeek Flash.
"They're comparing it to Deepseek-v4-Flash, not 4.1 and not the 4.1 1017 update, so essentially two versions behind the latest version of Deepseek Flash."
A leitura justa é que o pré-treinamento parece forte, especialmente em código e conhecimento, e que as linhas de contexto longo são mistas. Se isso sobrevive ao pós-treinamento é a pergunta que fica aberta.
Quanto custa o ERNIE 5.5 Flash?
Os pesos não custam nada para baixar, e não há preço de API da Baidu a citar. A página do Hugging Face dizia, quando eu a capturei, que o modelo "isn't deployed by any Inference Provider", e também não encontrei nenhuma listagem no OpenRouter.
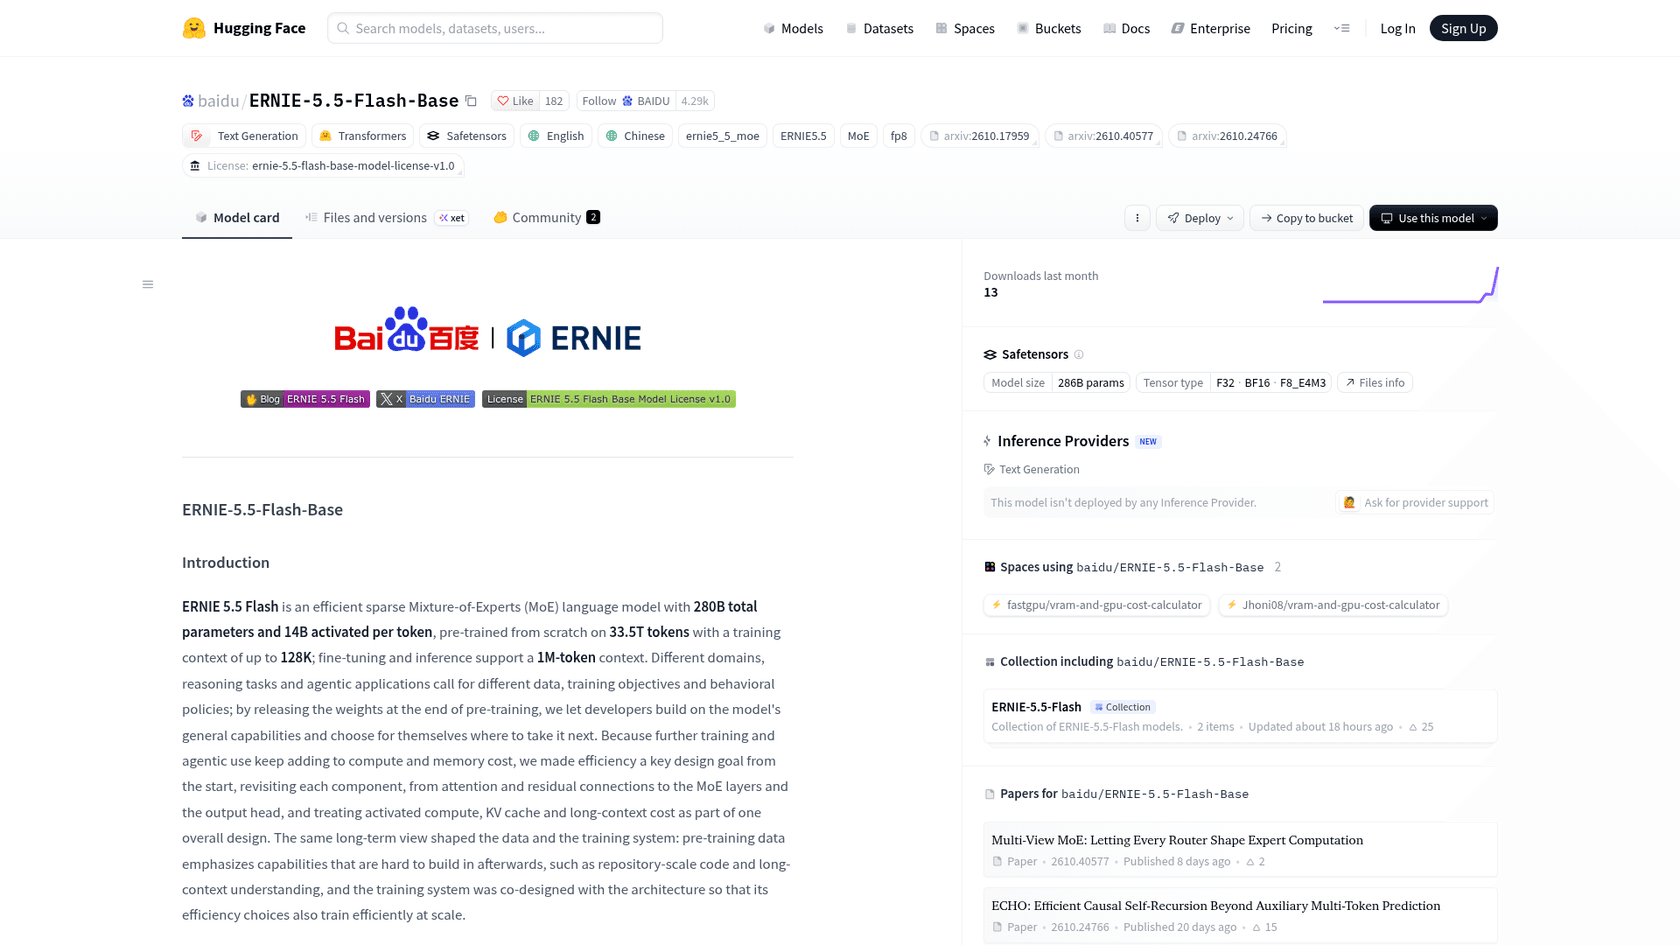
Então o custo real é hardware e engenharia. O Hugging Face lista 286B de parâmetros, e os pesos FP8 ocupam cerca de um byte cada, então, pelas minhas contas, são necessários aproximadamente 286 GB só para manter o modelo, antes de contar qualquer cache KV. Os próprios comandos de lançamento da Baidu são configurados para paralelismo de quatro vias: --tp 4 para o SGLang e --data-parallel-size 4 para o vLLM.
Para ver como isso se compara a opções hospedadas, aqui está uma carga de trabalho hipotética: 10,000 conversas de suporte por mês, 3,000 tokens de entrada e 500 de saída cada, ou seja, 30M de entrada e 5M de saída, sem cache e sem tokens de raciocínio. Os preços vêm da página de cada fornecedor.
| Modelo | Entrada / saída por 1M de tokens | Fatura mensal para essa carga |
|---|---|---|
| ERNIE 5.5 Flash | Nenhum preço hospedado publicado | Suas próprias GPUs |
| Claude Haiku 5.5 (prompts até 100K) | $0.10 / $0.50 | $5.50 |
| GPT-6 Luna | $0.10 / $0.50 | $5.50 |
| Qwen3.8-Flash (internacional) | $0.15 / $0.47 | $6.85 |
| DeepSeek V4.1 Flash (fora de pico) | $0.15 / $0.60 | $7.50 |
| DeepSeek V4.1 Flash (horário de pico) | $0.30 / $1.20 | $15.00 |
| Gemini 3.8 Flash (até 31 de dez. de 2026) | $0.75 / $3.75 | $41.25 |
São faturas minúsculas. Nesse volume, tokens hospedados quase certamente vão custar menos do que manter um servidor multi-GPU funcionando o dia todo, embora eu não tenha colocado preço no hardware. Hospedar você mesmo um modelo aberto compensa por outros motivos, como manter os dados na sua própria rede ou treinar um modelo no estilo da sua empresa, e é exatamente para isso que serve um modelo base: um fine-tune. Há artigos de preços mais detalhados em preços do DeepSeek V4.1 Flash e preços do Claude Haiku 5.5.
Quem pode usar o ERNIE 5.5 Flash?
Menos gente do que a palavra "aberto" sugere. A licença do ERNIE 5.5 Flash é um acordo próprio da Baidu, e quatro cláusulas importam na prática.
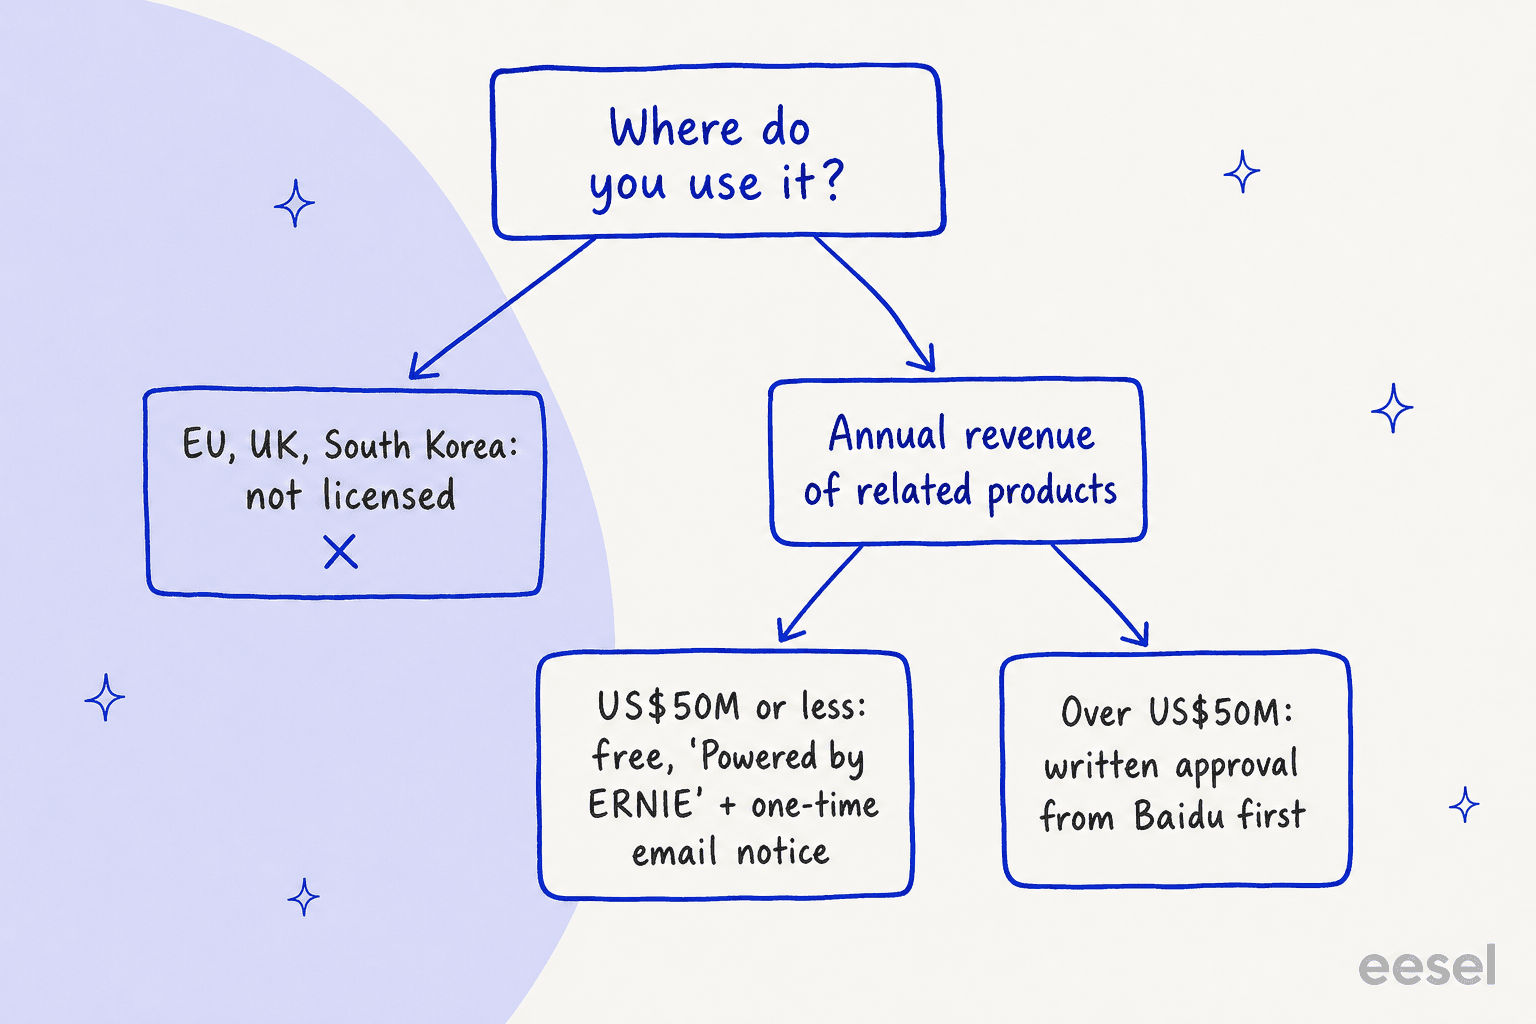
- Território. A concessão cobre todo lugar "exceto a União Europeia, o Reino Unido e a Coreia do Sul". A seção 5.3 também proíbe usar as saídas do modelo fora desse território.
- Receita. O uso comercial é livre de taxas de licença até 50 milhões de dólares de receita anual do produto relacionado, somando todas as afiliadas. Acima disso, você precisa da autorização por escrito da Baidu antes de começar.
- Atribuição. Um produto comercial deve exibir as palavras exatas "Powered by ERNIE" em sua interface, site ou documentação, e você envia à Baidu um aviso único por e-mail.
- Sem destilação. A seção 5.5 proíbe usar o modelo ou suas saídas para melhorar qualquer outro modelo de IA, exceto derivados do próprio modelo.
Os desenvolvedores notaram isso. No Hacker News, a licença foi a principal reclamação:
"The license seems really restrictive for something intended to be built on. Entire countries are forbidden to use it at all (European Union, the United Kingdom and South Korea), and you are responsible for making sure no one in those places uses your derivative."
Um comentarista teve uma leitura mais relaxada, argumentando que a exclusão é uma forma de evitar risco regulatório, e não algo que a Baidu pretenda fiscalizar. De todo modo, se seus clientes estão na Europa, resolver isso é problema seu, e o guia do AI Act da UE e o guia de residência de dados mostram quanto peso isso tem no suporte.
Os fãs de modelos base também encontraram bastante para gostar:
"Absolutely glad to see the release of a base model, I think the trend away from that has been an issue for the field."
Como executar o ERNIE 5.5 Flash fora da China?
Você baixa os pesos e os serve você mesmo, se a sua localização estiver dentro do território da licença. Os pesos estão no Hugging Face e no ModelScope em FP8, com uma cópia em BF16 também.
- SGLang: a imagem pré-construída é
lmsysorg/sglang:dev-ernie-55-flash, iniciada com--tp 4 --attn-dp-size 4. - vLLM: versão 0.32.0 mais o plugin vLLM-ERNIE da Baidu, com
--data-parallel-size 4. - Contexto: ambos os servidores aceitam até 1,048,576 tokens, e o contexto de treinamento foi 128K.
- Fine-tuning: a Baidu indica um exemplo de Megatron Bridge da NVIDIA.
Ainda não há um atalho hospedado. Se você só quer um modelo de nível Flash barato e hospedado hoje, a tabela acima é sua lista de compras, e a análise do Qwen 3.8 Flash cobre um deles em detalhe.
O ERNIE 5.5 Flash serve para um agente de IA de helpdesk?
Hoje não. Eu não colocaria esse checkpoint perto de uma fila de clientes, por quatro razões.
- Ainda não segue instruções. Um agente de suporte precisa obedecer a um system prompt, usar guardrails e saber quando escalar. Esses são comportamentos de pós-treinamento, e são exatamente a parte que falta.
- Não há nada para chamar. Sem endpoint hospedado, o custo de servir, a disponibilidade e a revisão de segurança ficam todos com você.
- A licença bloqueia clientes europeus. Uma equipe de suporte em Copenhague ou Londres não pode usar as saídas sob a concessão como está escrita.
- Ninguém mediu isso em trabalho de suporte. A tabela da Baidu não tem nenhum teste de seguimento de políticas no estilo τ-bench, nenhum teste de uso de ferramentas e nenhuma taxa de alucinação.
O modelo também é só a metade menor do trabalho. Mesmo uma versão pós-treinada perfeita ainda precisaria de uma base de conhecimento, regras de transferência, retrieval e uma forma de revisar as respostas antes que os clientes as vejam. Esse é o custo real por trás de construir versus comprar, e a razão pela qual um modelo isolado nunca se torna um agente de suporte. Minha regra curta: isto é o modelo; a eesel é o colega de equipe.
A eesel é uma plataforma de colegas de IA, e o colega de IA de helpdesk dela entra na fila que você já administra no Zendesk, Freshdesk, Gorgias e outros. A eesel vem colocando IA em filas de suporte reais há anos, por isso cada implantação é simulada primeiro contra seus tickets históricos. Você lê o que o colega de equipe teria dito antes de ele responder a alguém.
A Timengo, uma empresa dinamarquesa de e-mail seguro, usa a eesel no Freshdesk. O colega de equipe redige respostas em dinamarquês a partir de cerca de 5,300 tickets anteriores e artigos da central de ajuda, preparou 300 tickets em um mês e escreveu 180 rascunhos de resposta. Um engenheiro de suporte revisa e envia cada um, e a eesel nunca envia por conta própria. A SamCart roda um agente nos tickets do Freshdesk e outro no chat do site, ambos respondendo a partir de cerca de 280 artigos da central de ajuda. O agente de tickets só responde enquanto nenhuma pessoa está designada, e recua assim que um colega de equipe assume o ticket.
Esse comportamento de "recuar" é exatamente o tipo de coisa que um modelo base ainda não aprendeu. É também por isso que eu esperaria pelo ERNIE 5.5 Flash pós-treinado em vez de julgar este lançamento como um agente. Quando ele chegar, nosso guia para escolher um LLM para suporte e o melhor modelo para tickets de suporte mostram o que testar primeiro, e a prevenção de alucinação é a parte que mais pesa.
Se você gosta de trabalhar a partir de um terminal, a CLI da eesel vale a pena olhar. Com ela, um agente de IA de código pode enviar conhecimento aprovado, como artigos de ajuda exportados e macros, editar as instruções do colega de equipe e fazer perguntas de teste para verificar as respostas antes que algo vá ao ar. Conectar o próprio helpdesk ainda exige alguém com acesso de administrador para aprovar. Há mais em gerenciar agentes de IA pelo terminal.
Quem deveria usar o ERNIE 5.5 Flash?
Aqui está minha avaliação depois de ler por completo o blog, a model card e a licença da Baidu:
- Experimente se você é uma equipe de pesquisa ou uma empresa fora da UE, do Reino Unido e da Coreia do Sul que quer uma base forte e eficiente para fazer fine-tuning. Um modelo mixture-of-experts com 14B ativos e contexto de 1M é um bom ponto de partida, e um checkpoint base é exatamente o que você quer para o fine-tuning.
- Espere se você quer um modelo de chat ou de agente. A Baidu prometeu um sem data, e testes externos vão dizer mais do que uma tabela do fornecedor.
- Pule se você atende clientes europeus, ou se só precisa de tokens hospedados baratos. O DeepSeek V4.1 Flash, o Claude Haiku 5.5 e o GPT-6 Luna estão prontos hoje.
- Compare com outros modelos abertos se estiver pesquisando opções: Kimi K3, GLM 5.3 Flash e Ripple-65B fazem cada um uma troca diferente entre tamanho, preço e licença.
O resumo que eu daria a um colega: o ERNIE 5.5 Flash é um ingrediente promissor. Os números de pré-treinamento são fortes na própria tabela da Baidu e o design de economia de custo é real, mas o modelo de chat está faltando, e a licença tem limites geográficos.
Experimentar a eesel
Se você veio até o ERNIE esperando que um novo modelo aberto tirasse tickets da sua equipe, pode poupar o trabalho de construir a camada de suporte você mesmo. O colega de IA de helpdesk da eesel se conecta ao Zendesk, Freshdesk, Gorgias e mais em minutos, aprende com seus tickets anteriores e mostra como teria respondido antes de ir ao ar. Os planos começam em $299 por mês, e há um nível grátis para testar.

Experimente a eesel de graça.