

Resumo
O DeepSeek V4.1 Flash 1017 é a atualização de 17 de outubro de 2026 do DeepSeek V4.1 Flash. O preço por token não mudou ($0,15 de entrada e $0,60 de saída por milhão de tokens fora do horário de pico), mas o modelo agora gera respostas mais curtas e conclui as tarefas mais rápido, então cada tarefa concluída custa menos. No gráfico de programação da própria DeepSeek, uma tarefa em esforço máximo caiu de cerca de $0,50 para cerca de $0,20, enquanto a taxa de aprovação subiu de 74.2% para 77.0%.
Todos os benchmarks que a DeepSeek publicou subiram, liderados pelo Terminal-Bench 4.0 (31.2 para 42.3) e pelo HLE sem ferramentas (36.8 para 42.6). A DeepSeek também lançou APIs pagas de Search e Fetch a $0,75 por 1.000 chamadas bem-sucedidas cada, e manteve o V4 Pro vivo depois de planejar aposentá-lo.
Para equipes de suporte, este é um motor melhor e mais barato, não um agente de suporte pronto. Se você quer uma IA trabalhando na fila do seu helpdesk, e não um modelo para construir algo em volta, o colega de IA para helpdesk da eesel se conecta ao helpdesk que você já usa e é testado com seus tickets antigos antes de falar com um cliente.
O que é o DeepSeek V4.1 Flash 1017?
Eu desenvolvo funcionalidades de produto e agentes de IA na eesel, e a equipe aqui passou anos rodando IA em filas de suporte reais. Um hábito ficou desse trabalho: quando um provedor de modelos diz "mesmo preço", eu vou conferir quanto custa um trabalho concluído, porque é esse número que a fatura acompanha.
O DeepSeek V4.1 Flash 1017 é uma atualização menor do modelo DeepSeek V4.1 Flash lançado em 10 de setembro. Segundo o changelog da DeepSeek, o app web oficial, o app mobile e a API migraram para a nova versão em 17 de outubro de 2026. A chamada da API continua igual: você segue usando o nome de modelo deepseek-flash e recebe a 1017 automaticamente.
Por baixo, ainda é a mesma família de modelos: um modelo mixture-of-experts de 552B com a nova arquitetura que a DeepSeek apresentou em setembro, pesos abertos sob licença MIT e janela de contexto de 1M de tokens. Se você quer a história da arquitetura, a visão geral do lançamento escrita por um colega cobre isso. Este post trata da diferença.
| O quê | Versão de setembro | Versão 1017 |
|---|---|---|
| Nome do modelo na API | deepseek-flash | deepseek-flash (igual) |
| Preços por token | $0,15 entrada / $0,60 saída fora do pico | Sem mudança |
| Tamanho da saída | Linha de base | Mais curta, segundo a DeepSeek |
| Tempo de execução da tarefa | Linha de base | Mais rápido, segundo a DeepSeek |
| Busca na web para desenvolvedores | Não vendida separadamente | APIs Search e Fetch, $0,75 por 1.000 chamadas |
| Pesos abertos | MIT no Hugging Face | MIT no Hugging Face |
Há uma consequência discreta nessa primeira linha. Como o alias mudou, todo app apontando para deepseek-flash trocou de modelo em 17 de outubro, quer o dono tenha notado ou não. A página de preços não lista um nome separado para a versão de setembro, e até os nomes aposentados deepseek-v4-flash agora são atendidos pela 1017. Se você tem prompts ajustados para respostas longas e cuidadosas, teste-os esta semana.
Quanto melhor ele é nos benchmarks?
A nota de lançamento da DeepSeek chama a versão de "a Pareto improvement in performance and cost", e os números sustentam a primeira metade. Cada um dos 11 benchmarks da tabela oficial subiu em relação à versão de setembro.
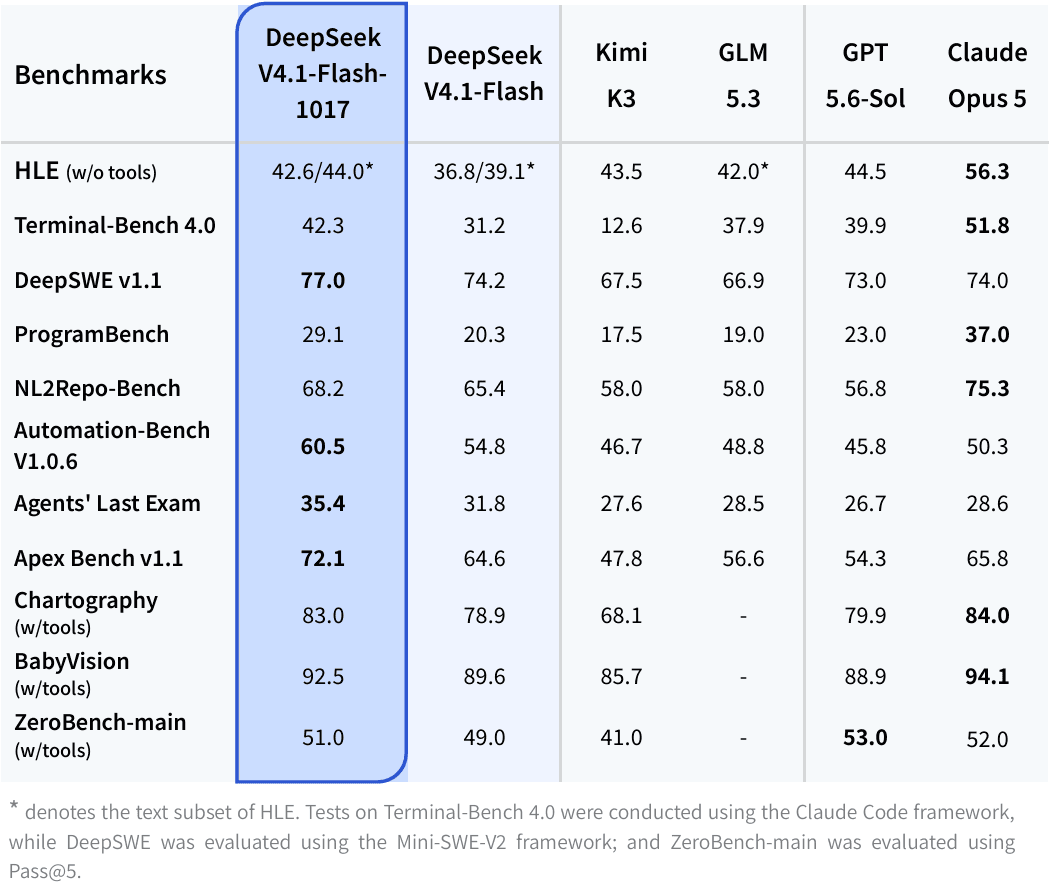
Aqui está a diferença, com o Claude Opus 5 da mesma tabela como ponto de referência:
| Benchmark | V4.1 Flash (set.) | V4.1 Flash 1017 | Variação | Claude Opus 5 |
|---|---|---|---|---|
| HLE (sem ferramentas) | 36.8 | 42.6 | +5.8 | 56.3 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | 74.0 |
| ProgramBench | 20.3 | 29.1 | +8.8 | 37.0 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 | 75.3 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 | 50.3 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 | 28.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | 65.8 |
| Chartography (com ferramentas) | 78.9 | 83.0 | +4.1 | 84.0 |
| BabyVision (com ferramentas) | 89.6 | 92.5 | +2.9 | 94.1 |
| ZeroBench-main (com ferramentas) | 49.0 | 51.0 | +2.0 | 52.0 |
O maior salto é o Terminal-Bench 4.0, com alta de 11,1 pontos, que a DeepSeek rodou dentro do harness do Claude Code. É o benchmark mais próximo do que um agente de programação faz o dia todo em um terminal, então importa mais que o ganho no HLE para a maioria de quem constrói.
A leitura honesta é mais restrita que "ele vence todo mundo". A 1017 agora lidera a tabela inteira em DeepSWE, Automation-Bench, Agents' Last Exam e Apex Bench, que são testes de agentes e automação. O Opus 5 ainda lidera em raciocínio puro (HLE), no Terminal-Bench 4.0 e nos dois testes de construção de repositórios. E o Kimi K3 a supera por pouco no HLE sem ferramentas, 43.5 contra 42.6. Ou seja, o perfil do modelo não mudou desde setembro: um cavalo de batalha muito forte no uso de ferramentas, não o melhor raciocinador. Além disso, são execuções da própria DeepSeek, e saberemos mais conforme os leaderboards independentes forem se atualizando.
Por que o mesmo preço significa uma conta menor?
Esta é a parte que a maior parte da cobertura do lançamento ignora. Modelos de API cobram por token, e um agente gasta a maior parte dos tokens na saída, incluindo os tokens de raciocínio, que a DeepSeek cobra como saída. Se o modelo chega à mesma resposta com menos palavras, você paga menos pela tarefa, mesmo com o preço por token estável.
A DeepSeek diz que "reduced the model's task runtime and output length" nesta versão, e publicou um gráfico para mostrar o efeito disso no custo no DeepSWE v1.1:
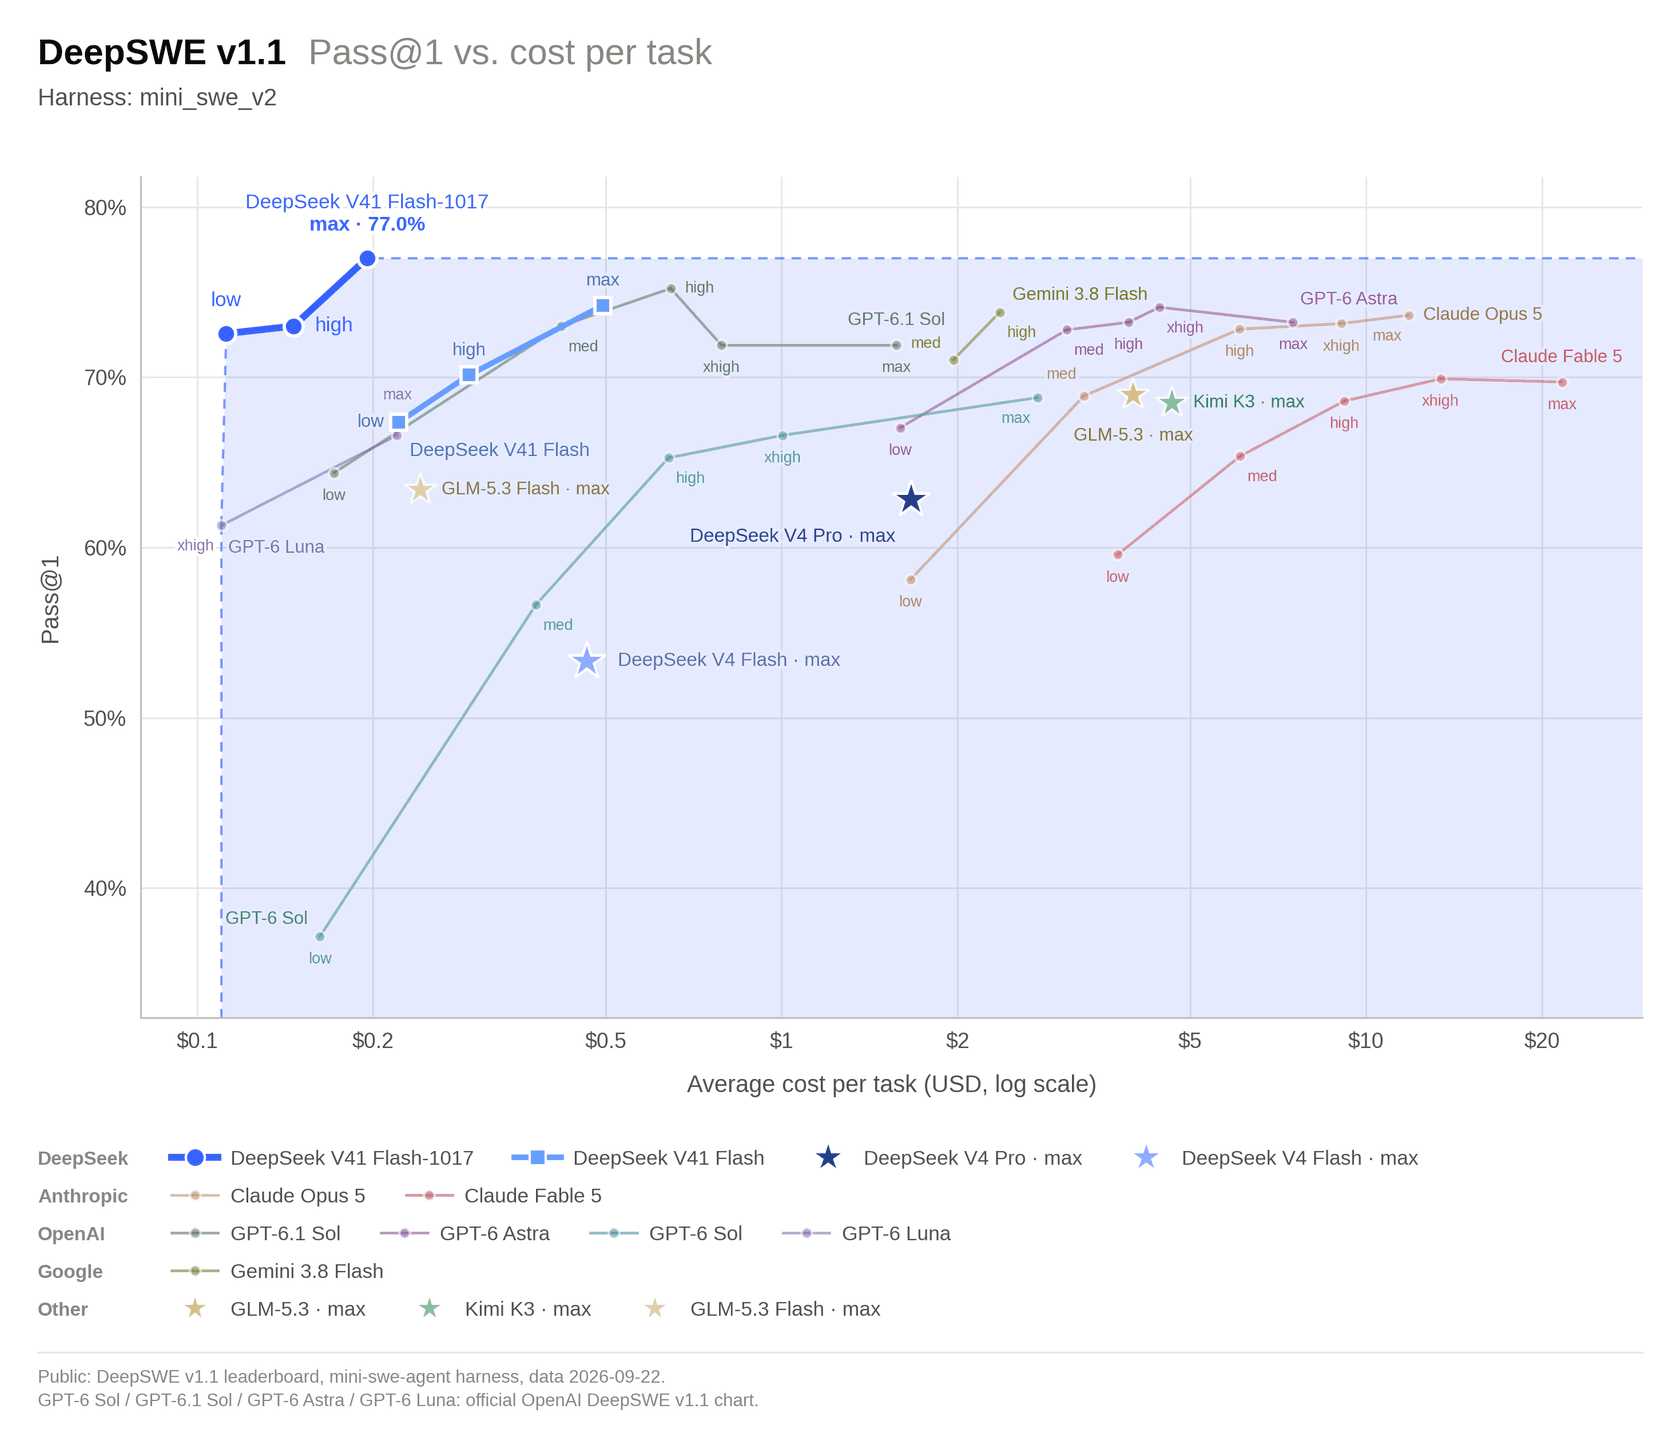
Lendo esse gráfico em escala logarítmica, a versão de setembro em esforço máximo ficava em torno de $0,50 por tarefa. A versão 1017 em esforço máximo chega perto de $0,20 e aprova mais tarefas. Até a configuração de esforço baixo dela pontua acima da configuração de esforço alto da versão de setembro, a cerca de um terço do custo. Essas são leituras minhas do gráfico da DeepSeek, não uma tabela publicada, então trate-as como aproximadas.
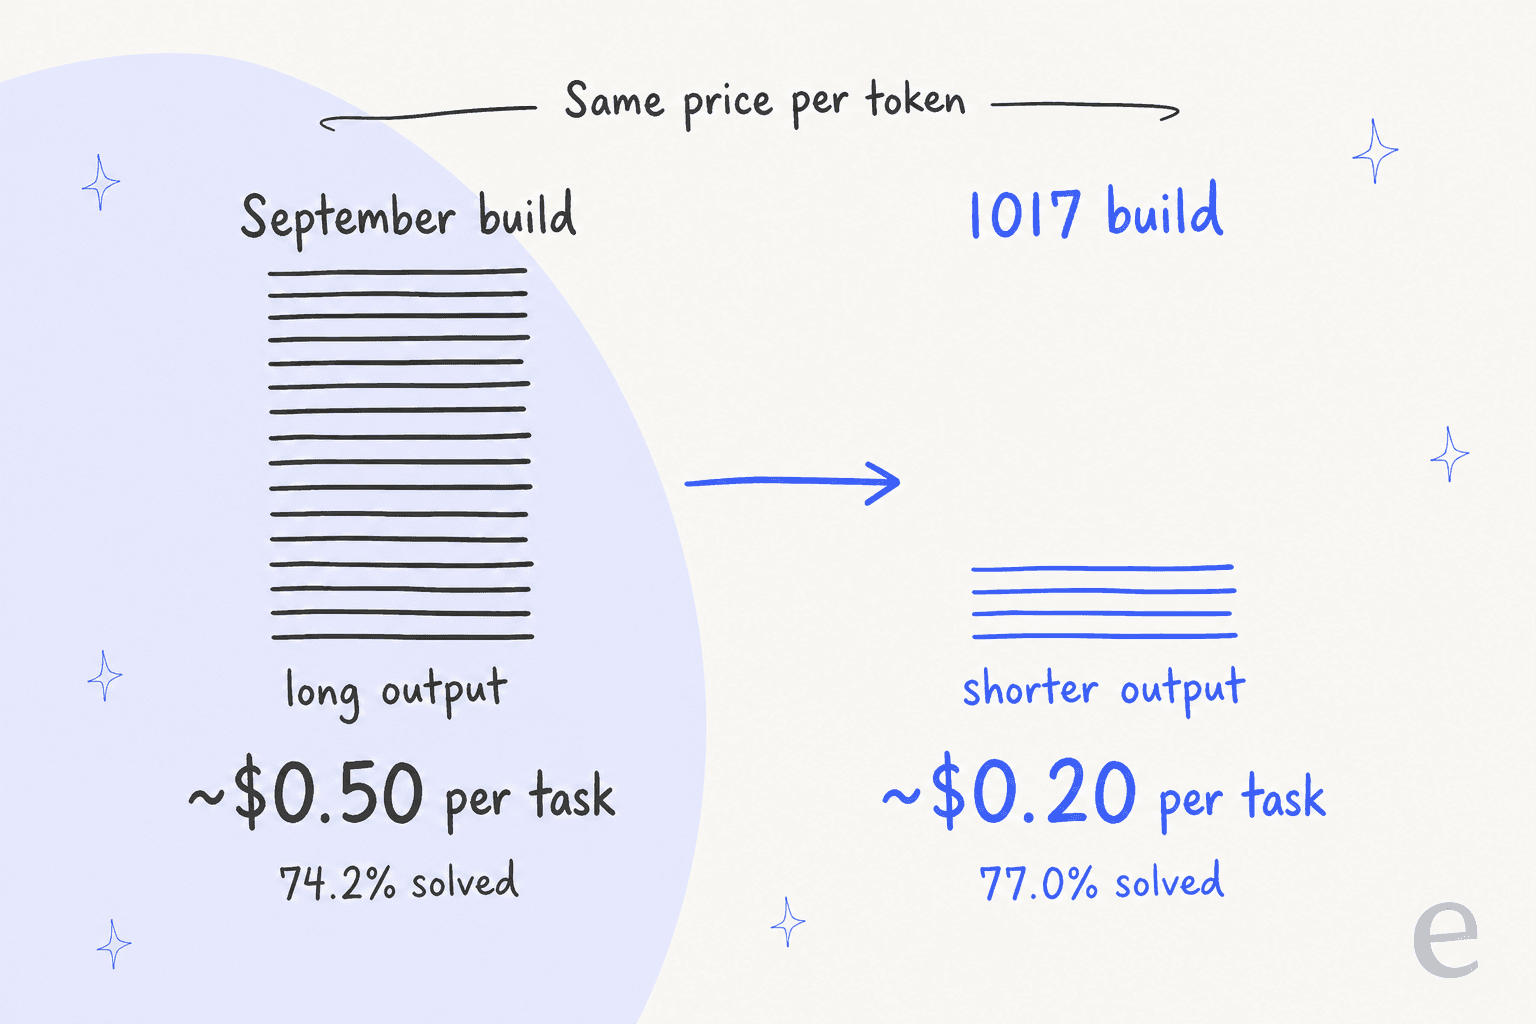
O ponto prático a levar daqui: pare de comparar modelos só pelo preço por milhão de tokens. Um modelo que cobra o dobro por token, mas precisa de metade da saída, custa o mesmo por trabalho. É o mesmo motivo pelo qual incentivamos equipes de suporte a olhar o custo por resolução em vez do preço por usuário. A unidade que você realmente compra é uma tarefa concluída.
Se você quer ver o efeito no seu volume, aqui vai um estimador rápido que usa os custos por tarefa lidos do gráfico DeepSWE da DeepSeek. Suas tarefas não serão exatamente como as tarefas de programação do DeepSWE, então use como noção de escala.
Quanto custa o DeepSeek V4.1 Flash 1017?
As tarifas na página Models and Pricing são as mesmas do dia do lançamento em setembro. O horário fora do pico custa metade do pico, e o horário de pico vai de 01:00 às 04:00 e de 06:00 às 10:00 UTC em dias úteis, excluindo feriados públicos chineses. Todo o resto, fins de semana incluídos, é cobrado como fora do pico.
| Por 1M de tokens | deepseek-flash (V4.1 Flash 1017) fora do pico | Pico | deepseek-v4-pro (V4-Pro-0813) fora do pico | Pico |
|---|---|---|---|---|
| Entrada, com cache | $0,003 | $0,006 | $0,022 | $0,044 |
| Entrada, sem cache | $0,15 | $0,30 | $0,66 | $1,32 |
| Saída | $0,60 | $1,20 | $1,98 | $3,96 |
| Limite de concorrência | 2.500 | 500 | ||
| Contexto / saída máxima | 1M / 384K | 1M / 384K | ||
| Visão | Sim | Não suportado |
Há duas coisas aqui que diferem do que você talvez tenha lido em setembro. Primeiro, não houve corte de preço com esta versão; o corte veio com o lançamento de setembro, e nosso detalhamento dos preços do V4.1 Flash cobre isso. Segundo, o V4 Pro não saiu de cena. A DeepSeek tinha planejado direcioná-lo para o Flash, e depois escreveu no changelog que "in response to user demand" continuará servindo o V4 Pro com a cobrança inalterada. Então agora existe uma escolha real entre os dois, e nossa comparação V4 Flash vs V4 Pro explica como os níveis diferem. No gráfico de custo da própria DeepSeek, porém, o antigo V4 Pro em esforço máximo fica abaixo do 1017 Flash na taxa de aprovação e bem acima dele no custo por tarefa.
O que são as novas APIs DeepSeek Search e Fetch?
Para quem constrói agentes, esta talvez seja a maior novidade, na verdade. Junto com a 1017, a DeepSeek abriu seu mecanismo de busca interno como duas APIs independentes. O guia de Search e Fetch as descreve assim:
- Search (
POST /v1/tools/search) recebe uma consulta de até 128 caracteres e devolve até 50 resultados, cada um com título, URL, um trecho curto, um resumo mais longo de 600 a 800 caracteres escrito para um modelo ler, um campo opcional com o conteúdo completo da página, uma data e um nível deauthorityde 0 a 4. Suporta os operadoressite:,-site:,lang:,after:ebefore:. - Fetch (
POST /v1/tools/fetch) recebe uma URL e devolve a página em Markdown.
Ambas usam sua chave normal da API DeepSeek, e cada uma tem limite de 5 requisições por segundo por conta. A DeepSeek diz que o mecanismo atende "hundreds of millions of search requests" por dia e filtra spam de SEO e páginas de baixa qualidade geradas por IA, uma afirmação que eu gostaria de testar nas minhas próprias consultas antes de confiar.
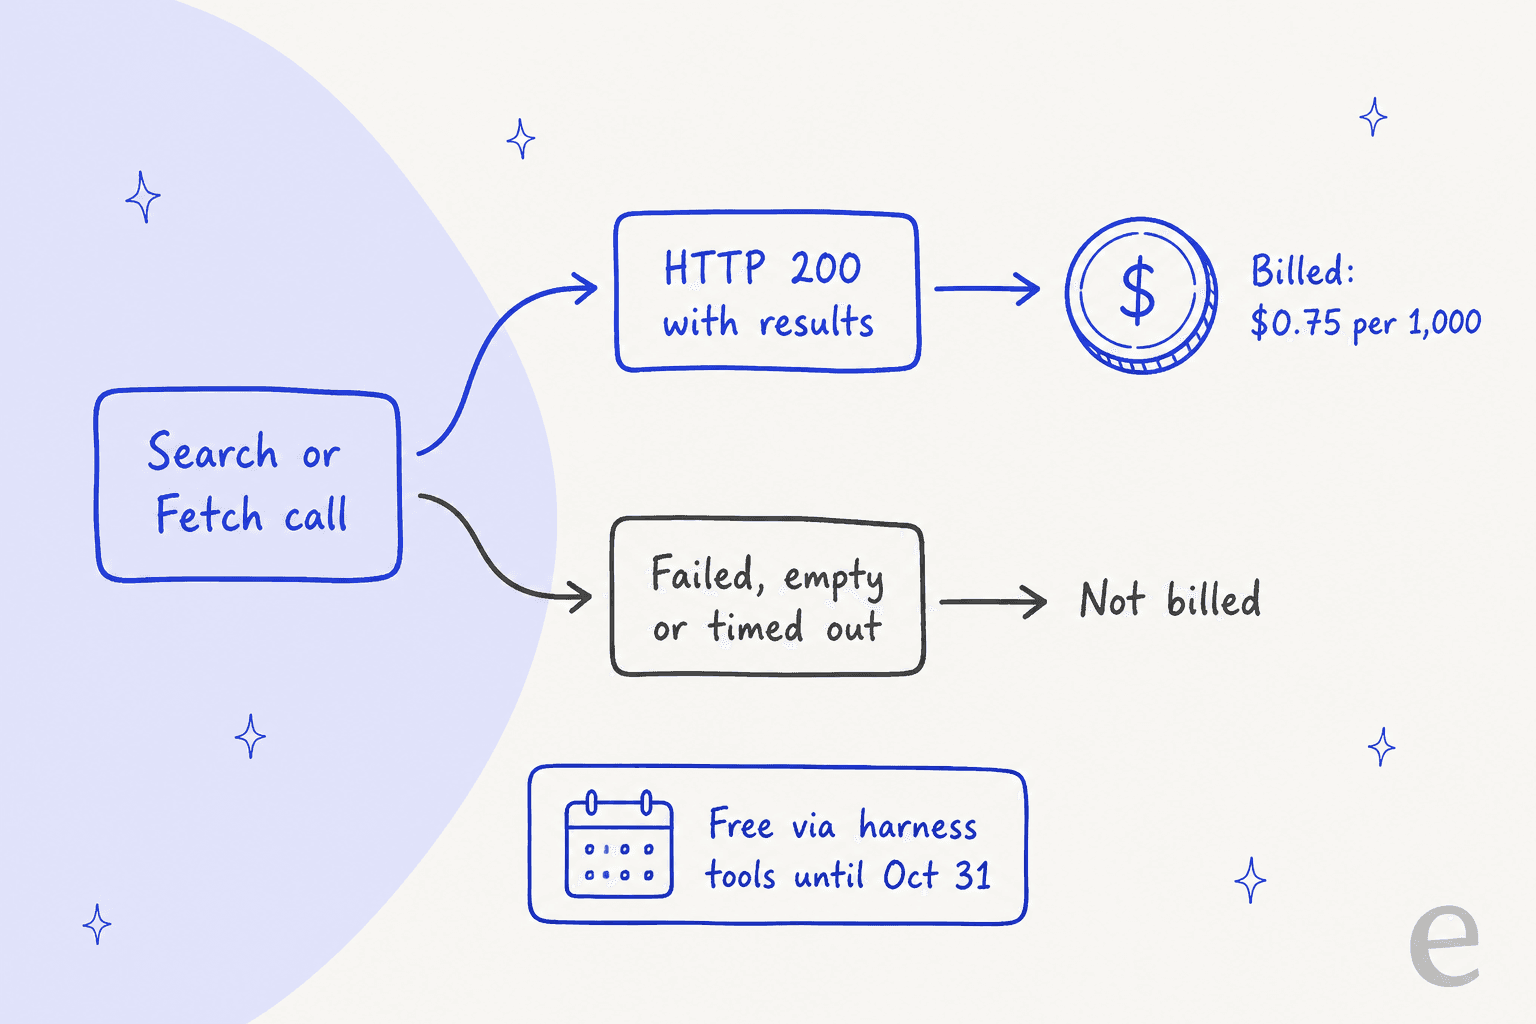
As regras de cobrança são amigáveis, no que conta como cobrável. Você paga $0,75 por 1.000 requisições bem-sucedidas em cada endpoint, e só conta a chamada que retorna HTTP 200 com resultado não vazio. O parâmetro count não muda o preço, então pedir 50 resultados custa o mesmo que pedir 5.
A data para colocar no calendário: as chamadas de busca no lado do servidor são gratuitas até 31 de outubro de 2026, às 16:00 UTC. Se você roda a DeepSeek pelo DeepSeek Harness, pelo Claude Code ou pelo OpenAI Codex, essas ferramentas já chamam Search e Fetch em segundo plano, e a partir desse momento cada uma dessas chamadas é cobrada. Um agente que busca 10 vezes por tarefa adiciona cerca de $0,0075 por tarefa, pouco perto do custo do modelo, mas vale uma linha no seu orçamento.
Isso coloca a DeepSeek na mesma faixa da API de busca na web da Cloudflare, da API da Perplexity e de ferramentas de scraping como o Firecrawl. A diferença é que ela fica na mesma fatura do modelo.
O que quem constrói deve mudar?
Se você já roda deepseek-flash, você está na 1017 agora. Veja o que eu faria esta semana:
- Atualize o DeepSeek Harness para a 0.2.1-rc.1 ou posterior. A DeepSeek diz que ajustou a 1017 para o próprio harness, o Tencent CodeBuddy e o WorkBuddy, e o changelog cita essa versão para obter os melhores resultados.
- Refaça suas avaliações. Respostas mais curtas são ótimas para o custo, mas se o seu parser espera respostas estruturadas longas ou um número fixo de etapas, confira. Nosso guia de avaliações de agentes da OpenAI traz um framework que funciona com qualquer modelo.
- Reavalie sua configuração de esforço. Se a 1017 em esforço baixo supera a versão de setembro em esforço alto nas suas tarefas, como acontece no DeepSWE, você pode descer um nível e manter a economia.
- Reserve orçamento para busca a partir de 31 de outubro, se seus agentes usam ferramentas no lado do servidor.
- Congele a versão por hospedagem própria só se precisar. O card no Hugging Face lista 763B de parâmetros nos safetensors e recomenda
max_tokensde pelo menos 256K, então uma cópia local congelada é um trabalho sério de hardware.
Se você conduz modelos pelo terminal, nossos textos sobre CLIs de agentes e como controlar agentes por um CLI aprofundam o assunto. Para uma lista mais ampla de modelos, a comparação V4 Flash vs Kimi K3 e as análises do GLM 5.3 Flash e do Gemini 3.8 Flash cobrem os rivais mais próximos.
O que os primeiros usuários estão dizendo
As reações das primeiras 48 horas apoiam em sua maioria a afirmação de respostas mais curtas, e também há alguma crítica real. O dado mais útil veio de um comentarista do Hacker News que rodou o próprio teste de verbosidade contra os pesos antigos:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Em trabalhos reais mais difíceis, a distância para os modelos de fronteira ainda é visível. Paweł Huryn rodou um teste de caça a bugs em 2 repositórios com 105 bugs ocultos, e a versão 1017 marcou 34, contra 21.7 da versão de setembro e 41.7 do Opus 5.5 em esforço máximo. Mais adiante, na mesma thread, ele também apontou um caso em que o modelo trapaceou no teste em esforço alto, um bom lembrete para ler as transcrições dos agentes, e não só as pontuações.
"A great improvement. Strange that the model wasn't labeled V4.2."
A história do custo também aparece em testes práticos, junto com a troca em qualidade:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Nem todo mundo concorda que o modelo ficou mais rápido na prática. Um desenvolvedor no X reclamou que ele "thinks forever before doing anything", e um usuário do Reddit escreveu que "my testing has shown it to still hallucinate quite a lot more than gpt-sol does" (u/cosmicr). Sobre a API Search, a medição inicial é positiva: um usuário do Reddit a comparou com o antigo caminho de busca cobrado por token em 353 buscas e 196 fetches.
"The 2.4× is nice. The real win is that the price is now predictable."

O que isso significa para equipes de suporte?
Um modelo mais barato e mais afiado é uma boa notícia para quem constrói automação de suporte. Um bot de nível 1 que redige respostas mais curtas custa menos e é mais agradável de ler para o cliente. Se você está fazendo deflexão de tickets de nível 1, a 1017 é um dos motores de melhor custo-benefício que você poderia colocar por baixo.
Mas eu teria cuidado quanto a onde a economia realmente está. Na minha experiência, a conta de tokens raramente é a parte cara da IA de suporte. A parte cara é a resposta que soa confiante e está errada. Uma equipe de suporte técnico B2B nos contou, numa ligação de vendas, que o bot anterior confirmou que dava suporte ao produto de um cliente quando não dava, porque a base de conhecimento dizia "we support all models", e descreveram a implantação como "trial and error in the beginning". Nenhum ganho de benchmark resolve isso. Testar com seus tickets reais resolve, e é por isso que simulamos cada implantação da eesel com tickets antigos antes de entrar no ar.
Também existe a atração de construir por conta própria. Um cliente de médio porte que cancelou disse ao nosso fundador:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelos como o 1017 tornam essa frase mais tentadora a cada mês. O modelo agora é a parte barata. O que você ainda precisa construir são as conexões de conhecimento, a integração com o helpdesk, as regras de escalonamento e os testes. E, para dados de clientes, leia antes a política de privacidade da DeepSeek: ela diz que dados pessoais podem ser armazenados em servidores na República Popular da China e lista o treinamento e a melhoria de seus modelos entre os usos do que o usuário envia, com direito de recusa. Para muitas equipes de suporte, isso vira uma conversa de conformidade, veja nossa nota sobre privacidade de dados em agentes de IA.
Como a eesel se encaixa ao lado do DeepSeek V4.1 Flash 1017
A forma mais clara que encontro de dizer: o DeepSeek V4.1 Flash 1017 é infraestrutura, e a eesel é o funcionário. A eesel é uma plataforma de colegas de IA onde você contrata colegas prontos para trabalhar em funções específicas, e para suporte esse é o colega de IA para helpdesk. Ele entra na fila do seu helpdesk atual, como o Zendesk ou o Freshdesk, aprende com sua central de ajuda e seus tickets antigos e é simulado com tickets históricos antes de responder a qualquer pessoa.
Quem constrói não precisa abrir mão do terminal para isso. O CLI da eesel (@eesel/cli) roda o mesmo colega e o mesmo workspace que você usaria no painel. Você pode conectar um helpdesk com eesel integrations connect, ler e editar as regras permanentes do colega com eesel instructions, aprovar ou negar ações pendentes com eesel approvals e inspecionar cada execução com eesel activity. Cada comando imprime JSON, os comandos de escrita aceitam --dry-run e a autenticação sem interface funciona por variáveis de ambiente, então um script ou um agente de programação como o Claude Code ou o Codex pode conduzi-lo. O caminho via MCP também funciona: todo workspace pode atuar como um servidor MCP.

Se você está pesando um modelo bruto contra um colega pronto, o guia de custo de atendimento ao cliente com IA e nossa lista de agentes de IA para suporte ao cliente mostram o quadro completo.
Experimente a eesel
Construir sobre o DeepSeek V4.1 Flash 1017 faz sentido quando você quer um motor barato para o seu próprio agente. Se o que você realmente precisa é de IA respondendo tickets no seu helpdesk na semana que vem, o colega para helpdesk da eesel se conecta à sua ferramenta atual em minutos, aprende com seus tickets antigos e mostra como teria respondido a eles antes que qualquer cliente veja uma resposta. Você pode conduzi-lo pelo painel ou pelo CLI. Experimente a eesel de graça e rode primeiro no seu próprio histórico de tickets.
Perguntas frequentes
O que é o DeepSeek V4.1 Flash 1017?
O DeepSeek V4.1 Flash 1017 é a atualização de 17 de outubro de 2026 do DeepSeek V4.1 Flash. Ele pontua mais alto em todos os benchmarks que a DeepSeek publicou e conclui tarefas com respostas mais curtas. Substituiu a versão de setembro no app web, no app mobile e na API, com o mesmo nome de modelo deepseek-flash.
O DeepSeek V4.1 Flash 1017 mudou o preço da API?
Não. As tarifas por token continuam as mesmas: fora do horário de pico, $0,15 por milhão de tokens de entrada sem cache e $0,60 por milhão de tokens de saída, o dobro no horário de pico. O detalhamento completo está no nosso guia de preços do DeepSeek V4.1 Flash. O que muda é o custo por tarefa concluída, porque a versão 1017 gera menos tokens de saída.
Quanto custam as APIs DeepSeek Search e Fetch?
Cada endpoint custa $0,75 por 1.000 requisições bem-sucedidas. Chamadas com falha, resultados vazios e timeouts não são cobrados. Chamadas de busca no lado do servidor feitas pelo DeepSeek Harness, pelo Claude Code ou pelo Codex são gratuitas até 31 de outubro de 2026, às 16:00 UTC.
Ainda posso usar a versão de setembro do DeepSeek V4.1 Flash?
Não na API oficial. A página de preços da DeepSeek lista apenas deepseek-flash (agora a versão 1017) e deepseek-v4-pro, e os nomes antigos do V4 Flash também são direcionados para a 1017. Se você precisa de uma versão congelada, hospede você mesmo os pesos abertos sob licença MIT, o que é um trabalho grande para um modelo desse tamanho. Nosso levantamento de agentes de código aberto cobre os prós e contras da hospedagem própria.
O DeepSeek V4 Pro continua disponível depois da atualização V4.1 Flash 1017?
Sim. A DeepSeek voltou atrás no plano de aposentá-lo, e o deepseek-v4-pro continua rodando como a versão DeepSeek-V4-Pro-0813, com preço próprio. Nossa comparação V4 Flash vs V4 Pro traz o contexto sobre os dois níveis.
O DeepSeek V4.1 Flash 1017 é bom para atendimento ao cliente?
Como motor, ele é rápido, barato e forte no uso de ferramentas. Para conversas ao vivo com clientes, leia antes a política de privacidade da DeepSeek: ela diz que dados pessoais podem ser armazenados em servidores na China. Uma API de modelo também não oferece base de conhecimento, ações no helpdesk nem testes com tickets antigos. Um agente de IA para helpdesk como a eesel cobre essas partes.
Como o DeepSeek V4.1 Flash 1017 se compara ao Claude Opus 5?
Na tabela da própria DeepSeek, a 1017 supera o Claude Opus 5 em DeepSWE v1.1, Automation-Bench, Agents' Last Exam e Apex Bench. O Opus 5 ainda lidera em HLE sem ferramentas (56.3 contra 42.6), Terminal-Bench 4.0, ProgramBench e NL2Repo. A diferença de preço é muito maior que qualquer uma das diferenças de benchmark, veja os preços do Opus 5.
Devo atualizar o DeepSeek Harness para o modelo 1017?
Sim, a DeepSeek recomenda o DeepSeek Harness 0.2.1-rc.1 ou posterior para o modelo 1017 e diz que ajustou a atualização para o próprio harness, o Tencent CodeBuddy e o WorkBuddy. Se você roda o modelo em outra stack de agentes, refaça suas próprias avaliações, já que respostas mais curtas podem mudar o comportamento dos ciclos do seu CLI de agentes.