

A DeepSeek lançou um modelo que enxerga. 21 de agosto de 2026. O deepseek-v4-flash-vision-exp custa exatamente o mesmo que o V4-Flash normal, a janela de contexto de 1M continua, e as imagens são cobradas como tokens de entrada comuns.
O anúncio, porém, enterra a parte interessante. A própria DeepSeek diz que o build de visão "matches" o V4-Flash em texto. A tabela de benchmarks dela diz mais: a variante de visão supera o modelo só de texto em seis de sete benchmarks de agentes de texto. Quase cinco pontos no DeepSWE. Cinco e meio no Toolathlon-Verified. Então a pergunta que vale a pena nem é sobre imagens, e sim se você vai mover seu tráfego de texto para um build experimental.
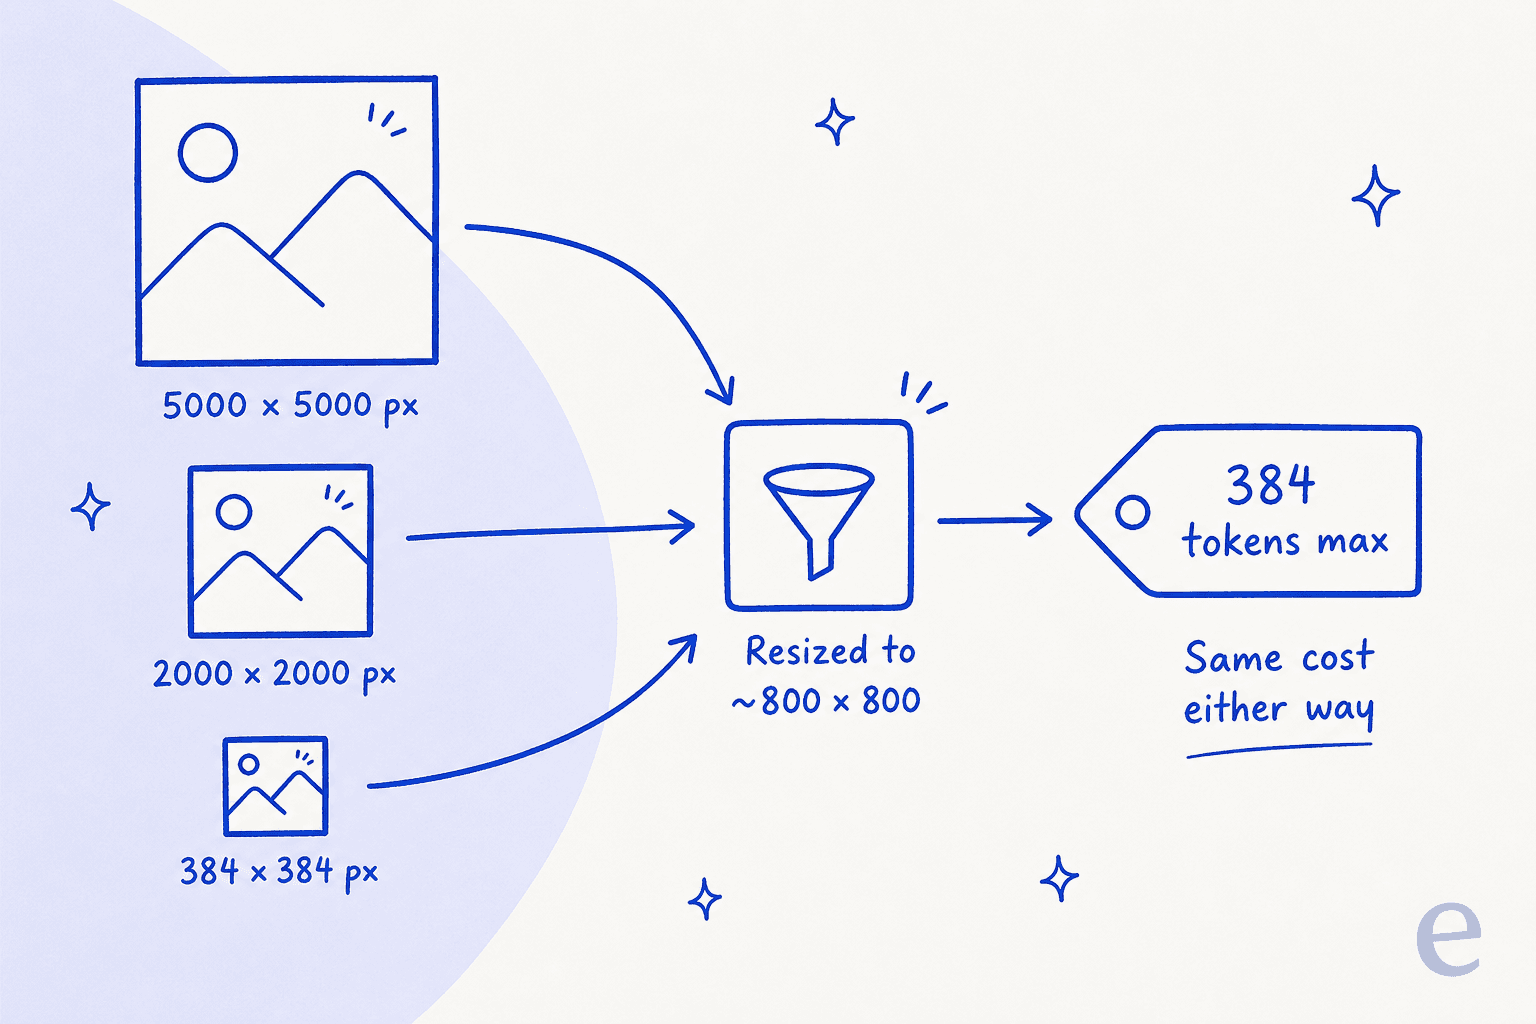
Depois, a pegadinha. Toda imagem é espremida para cerca de 800 por 800 pixels antes de o modelo olhar para ela, com limite de 384 tokens. Uma captura de 5000 pixels e uma miniatura custam o mesmo, porque depois do redimensionamento elas são a mesma coisa. O que significa que o preço fixo não é generosidade. É o teto de resolução, escrito como tabela de preços.
Eu cuido das integrações e da parte de API na eesel, e leio notas de lançamento como se lê um diff: o que mudou, o que silenciosamente não mudou, o que vai me acordar às 2 da manhã. Aqui, as linhas interessantes são duas funcionalidades que sumiram sem alarde. A completação FIM sumiu, e a string do modelo não tem data de build, então o que você testou na segunda não é necessariamente o que atende o tráfego na sexta.
E se você vai apontar isso para uma fila de suporte, deixe claro o que isso resolve. Ler a captura de tela de um cliente é a metade fácil. A metade difícil é saber que a resposta está correta antes de chegar a esse cliente, o que é um problema de fundamentação e de testes, não de modelo maior. Essa é toda a razão pela qual a eesel reproduz um agente sobre seus tickets reais do passado antes de ele responder um ao vivo.
O que a DeepSeek realmente lançou
O lançamento são três coisas ao mesmo tempo, e só uma delas rendeu manchetes.
Um modelo de visão. O deepseek-v4-flash-vision-exp recebe imagens na mesma requisição que o seu texto, via Chat Completions, o endpoint /messages compatível com a Anthropic ou a Responses API. Os formatos suportados são JPEG, PNG, GIF e WebP, e segundo o guia de visão o formato é detectado pelo conteúdo do arquivo, não pelo nome nem pelo tipo MIME declarado.
Uma Files API gratuita. Você envia uma imagem uma vez e depois a referencia por file_id em várias requisições. Ela também eleva o limite por imagem de 32 MiB para 64 MiB, o que importa mais do que parece.
Um lançamento de harness. O DeepSeek Harness 0.1.1 saiu no mesmo dia, com suporte já embutido.
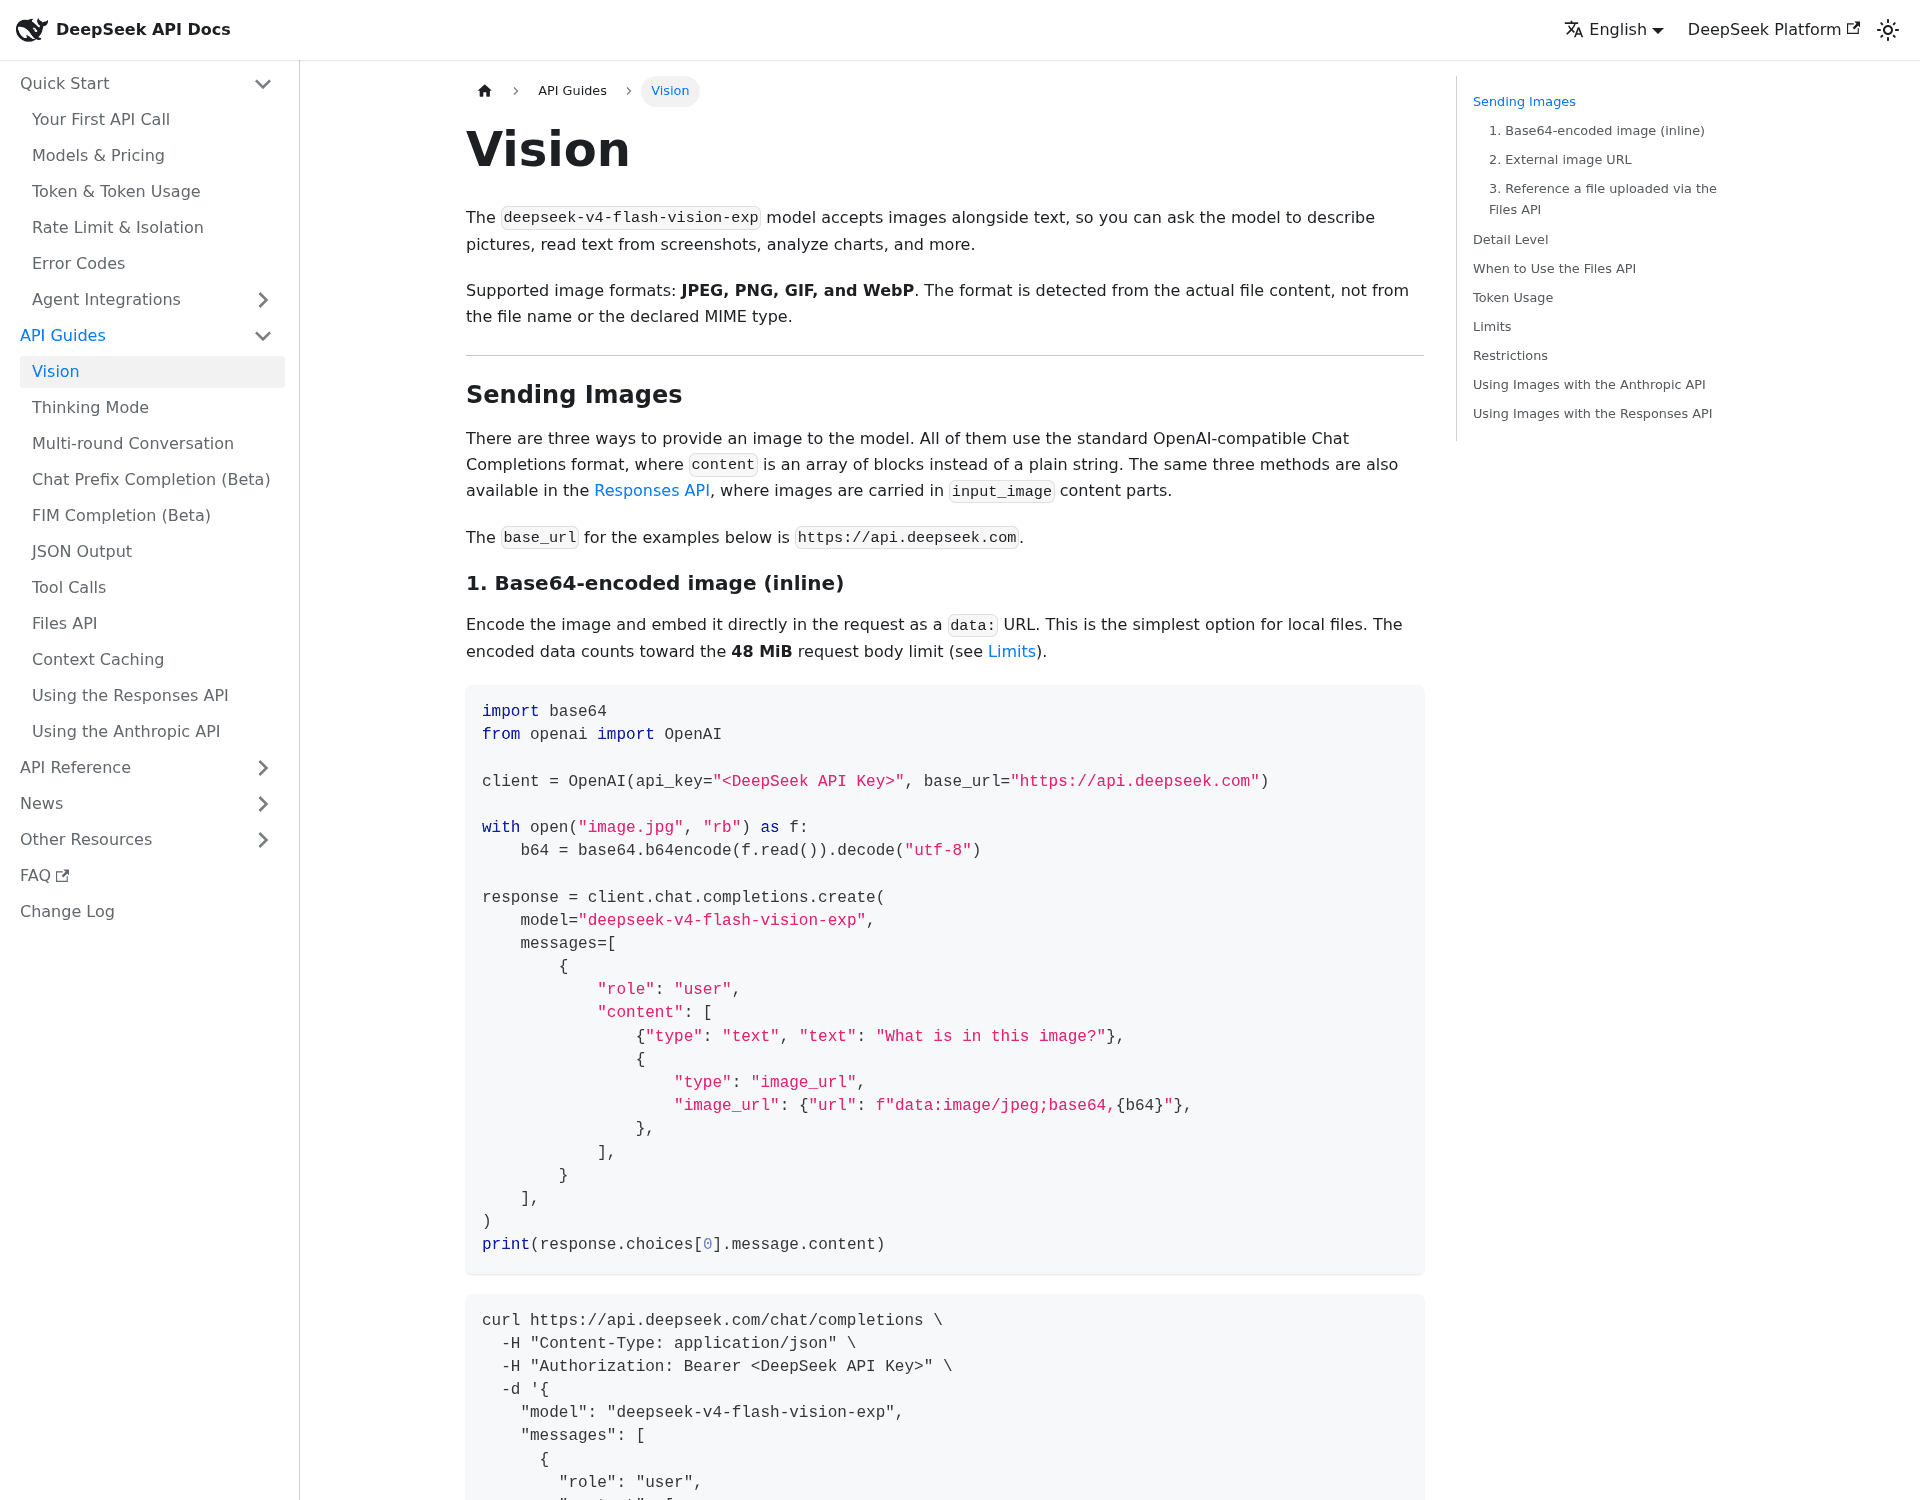
Em arquitetura, nada mudou em relação ao modelo de que deriva: uma mistura de especialistas esparsa com 13B de parâmetros ativos de 284B no total, segundo a página do modelo no OpenRouter. O contexto continua em 1M de tokens, a saída máxima em 384K e a concorrência em 2.500. Se você já construiu sobre o DeepSeek V4 Flash, trocar a string do modelo é toda a migração.
Um detalhe que parece nota de rodapé mas não é: imagens são aceitas apenas em mensagens user. Coloque uma em uma mensagem system ou assistant e você recebe um 400. Se o seu loop de agente enfia a saída de ferramentas em um turno de assistente, isso é uma reescrita para você, não uma mudança de configuração.
O limite de 384 tokens é todo o design
Esta é a parte que vale entender antes de planejar qualquer coisa em torno do modelo.
Antes da inferência, a DeepSeek redimensiona toda imagem que chega. Qualquer coisa abaixo de cerca de 384 por 384 pixels é ampliada, preservando a proporção. Qualquer coisa maior é reduzida, de novo preservando a proporção, até que o total de pixels fique mais ou menos no de uma imagem de 800 por 800. O resultado é um teto rígido de 384 tokens por imagem, e a documentação diz a consequência com todas as letras: uma imagem de 2000 por 2000 e uma de 5000 por 5000 consomem o mesmo número de tokens.
Então as imagens saem quase de graça. Na tarifa fora de pico de $0,22 por milhão de tokens de entrada, 384 tokens custam cerca de $0,00008. Um comentarista no Hacker News fez a conta e chegou mais ou menos ao mesmo lugar:
"400 tokens per image results in 2,500 images per dollar, if I'm not mistaken."

Ele estava certo, e vale ficar um segundo com esse número. Nessa tarifa, o custo de olhar se arredonda para nada dentro de quase qualquer orçamento de agente.
Mas o preço e a resolução aqui são uma única decisão, não duas. É barato porque olha com menos atenção. A reação mais afiada de todo aquele tópico tinha poucas palavras:
"Oof 800 by 800 kills a lot of use cases"
É justo, e o tópico passou muito tempo discutindo o quanto isso realmente importa. O contorno em que as pessoas se firmaram é uma ferramenta de recorte e zoom: você dá ao modelo a capacidade de pedir uma subregião de uma imagem de alta resolução, de modo que ele lê um recorte de 600 por 600 com detalhe nativo em vez da imagem inteira borrada. Várias pessoas relataram que isso funcionou bem. Outras apontaram o limite óbvio: costurar nove recortes de volta em um único entendimento espacial é um problema difícil por si só, e contar coisas ou rastrear relações em um esquema é exatamente onde quebra.
Os dois lados têm razão, só que para cargas de trabalho diferentes. Verificar se um botão foi renderizado no lugar certo sobrevive facilmente a uma redução para 800 por 800. Ler texto de 8 pt em um recibo, não.
Também há um parâmetro detail, que vale conhecer principalmente pelo que ele não faz. low reduz para 512 por 512 por velocidade. high, original e auto hoje significam todos a mesma coisa: manter o original e aplicar o redimensionamento padrão mesmo assim. Não existe um modo de alta resolução a que recorrer.
A tabela de benchmarks diz mais que o anúncio
A nota de lançamento da DeepSeek descreve o lado de texto do modelo de visão com uma palavra: ele "matches" o V4-Flash. A tabela que publicaram junto não diz bem isso.
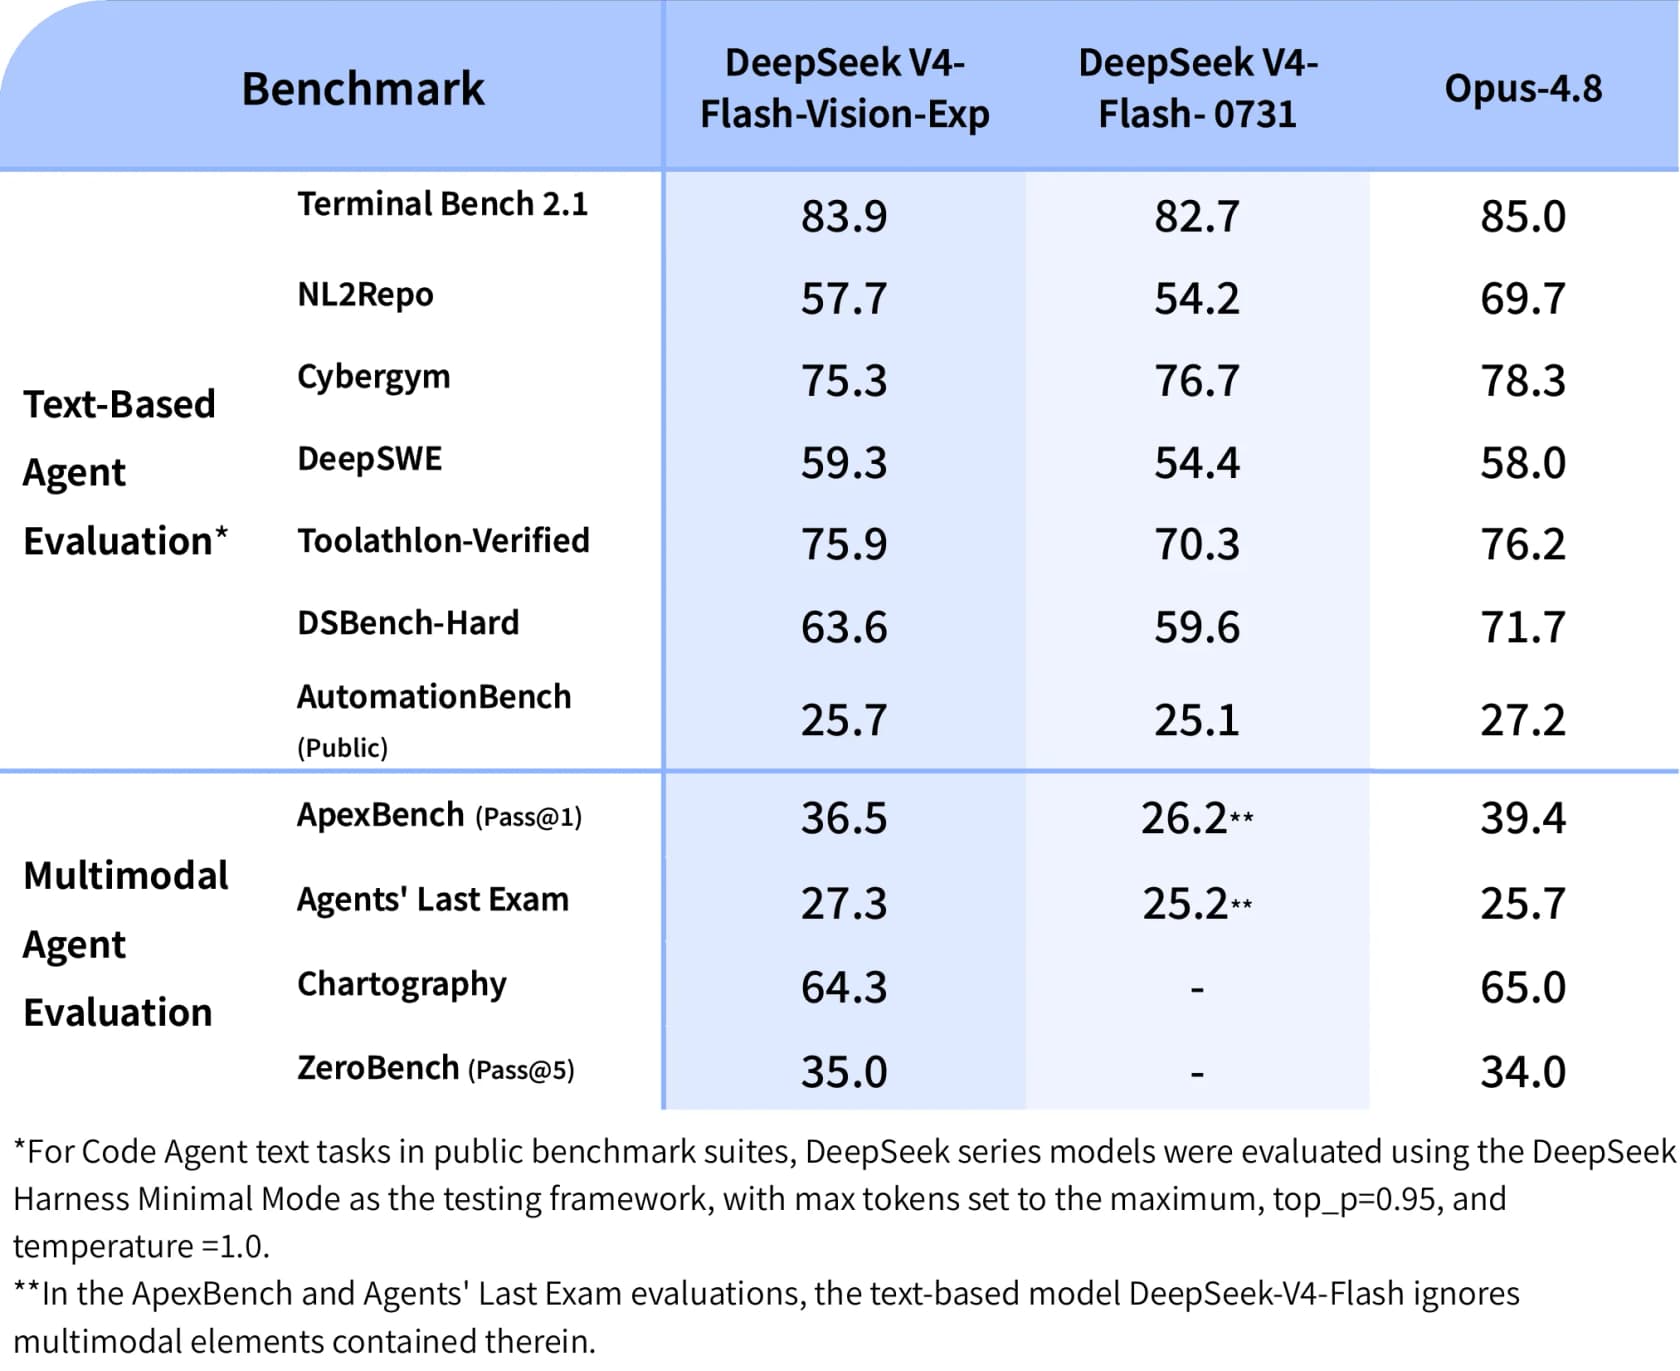
Alinhando as linhas de agentes baseados em texto, o build de visão leva seis de sete:
| Benchmark de agente de texto | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
O DeepSWE se move 4,9 pontos e o Toolathlon-Verified 5,6. Não são erros de arredondamento. No DeepSWE, a variante de visão também passa à frente do Opus-4.8, 59,3 contra 58,0. "Matches on text" subestima o que o próprio harness da DeepSeek mediu aqui, e se você está escolhendo um modelo de código ou de uso de ferramentas a partir dessas linhas, o build de visão é a melhor escolha mesmo que você nunca envie uma única imagem a ele.
Agora a metade multimodal, em que o enquadramento merece um segundo olhar:
| Benchmark multimodal | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | – | 65.0 |
| ZeroBench (Pass@5) | 35.0 | – | 34.0 |
*Nota de rodapé da própria DeepSeek: no ApexBench e no Agents' Last Exam, o V4-Flash baseado em texto ignora os elementos multimodais da tarefa.
Essa nota de rodapé faz muito trabalho. O "grande salto sobre o V4-Flash" nos benchmarks multimodais de agentes é em parte apenas medir que um modelo enxerga e o outro não, o que é verdade, mas não é o mesmo que um ganho de capacidade. A comparação honesta está na coluna do Opus-4.8, e ali o quadro é apertado: a DeepSeek fica 2,9 atrás no ApexBench e 0,7 no Chartography, depois passa à frente por pouco no Agents' Last Exam e no ZeroBench. "Perto do Opus-4.8" é uma afirmação justa, e para um modelo a uma fração dos preços da API da Anthropic essa é de fato a manchete.
Duas ressalvas para manter a leitura correta. Todos os números da série DeepSeek vêm do Minimal Mode do DeepSeek Harness com top_p=0.95 e temperature=1.0, que é o andaime do próprio fornecedor. Além disso, são números do dia do lançamento, do fornecedor, e não uma replicação independente. Trate-os como trataria qualquer tabela de primeira mão, inclusive as nossas.
Quanto custa de verdade
A tabela de preços é idêntica à do V4-Flash normal, o que provavelmente é o fato mais útil de todo o lançamento. Fora do pico, por milhão de tokens: $0,007 em cache hit, $0,22 em cache miss e $0,66 de saída. No pico, as três dobram. O horário de pico vai de 01:00 a 04:00 e de 06:00 a 10:00 UTC, de segunda a sexta, o que significa que uma carga dos EUA ou da UE é cobrada na maior parte pela tarifa mais barata por puro acaso geográfico.
O preço de tabela também não é o que a maioria realmente paga. A própria telemetria do OpenRouter coloca o preço de entrada efetivo em $0,03073 por milhão contra $0,22 de tabela, porque a taxa de cache hit observada está em 88,9%. A saída quase não se mexe, $0,6595 efetivos contra os $0,66 de tabela. Assim, no que diz respeito a para onde vai o dinheiro, o cache faz quase todo o trabalho na entrada e nenhum na saída, o que faz da sua fatura uma fatura de tokens de saída com um erro de arredondamento anexado.
Coloque seus próprios números:
Passe um agente realista guiado por capturas de tela por isso e o formato se mantém: as imagens mal aparecem, a fatura é de tokens de saída. O que traz um número que vale destacar. Nos três primeiros dias no OpenRouter, o modelo queimou 25B de tokens de prompt, 69,6M de tokens de completação e 139M de tokens de raciocínio, então o raciocínio roda em aproximadamente o dobro da completação. O modo de raciocínio vem ligado por padrão e os tokens de raciocínio são cobrados pela tarifa de saída. Portanto, se o seu modelo de custos trata a saída como "o tamanho da resposta", ele erra por algo como 3x. A mesma armadilha aparece na nossa análise dos preços do DeepSeek V4 Flash, e explica boa parte de por que comparar tabelas de preços brutas entre fornecedores engana tanto. Quem comparou a API da OpenAI com uma ferramenta de suporte cobrada por resolução já encontrou o mesmo problema vindo da outra direção.
Os limites que realmente vão te atingir
A maioria é generosa. Dois não.
| Limite | Valor |
|---|---|
| Formatos suportados | JPEG, PNG, GIF, WebP |
| Máx. de imagens por requisição | 600 |
| Tamanho do corpo da requisição | 48 MiB |
| Máx. por imagem (base64 / URL) | 32 MiB |
| Máx. por imagem (Files API) | 64 MiB |
| Máx. tamanho total de imagens por requisição | 64 MiB, ou 200 MiB usando file_id |
| Dimensão máx. da imagem | 8192 px por lado |
| Dimensão máx. com 15+ imagens | 4096 px por lado |
| Comprimento da URL externa | 8192 caracteres |
| Tempo limite de download de imagem externa | 60 segundos |
Seiscentas imagens em uma requisição é muita folga. Mas repare como a regra de dimensão cai silenciosamente pela metade quando uma requisição leva quinze ou mais imagens, que é exatamente o formato de um trabalho em lote de processamento de documentos. E aquela janela de 60 segundos de download em URLs externas é o tipo de coisa que funciona perfeitamente nos testes e começa a gerar falhas intermitentes na primeira vez que você a aponta para algum CDN lento de cliente. Se imagens importam para o seu pipeline, a Files API é o padrão mais seguro e não a otimização que você deixa para depois.
Do que você abre mão
Duas coisas, e nenhuma está na lista de tópicos do anúncio.
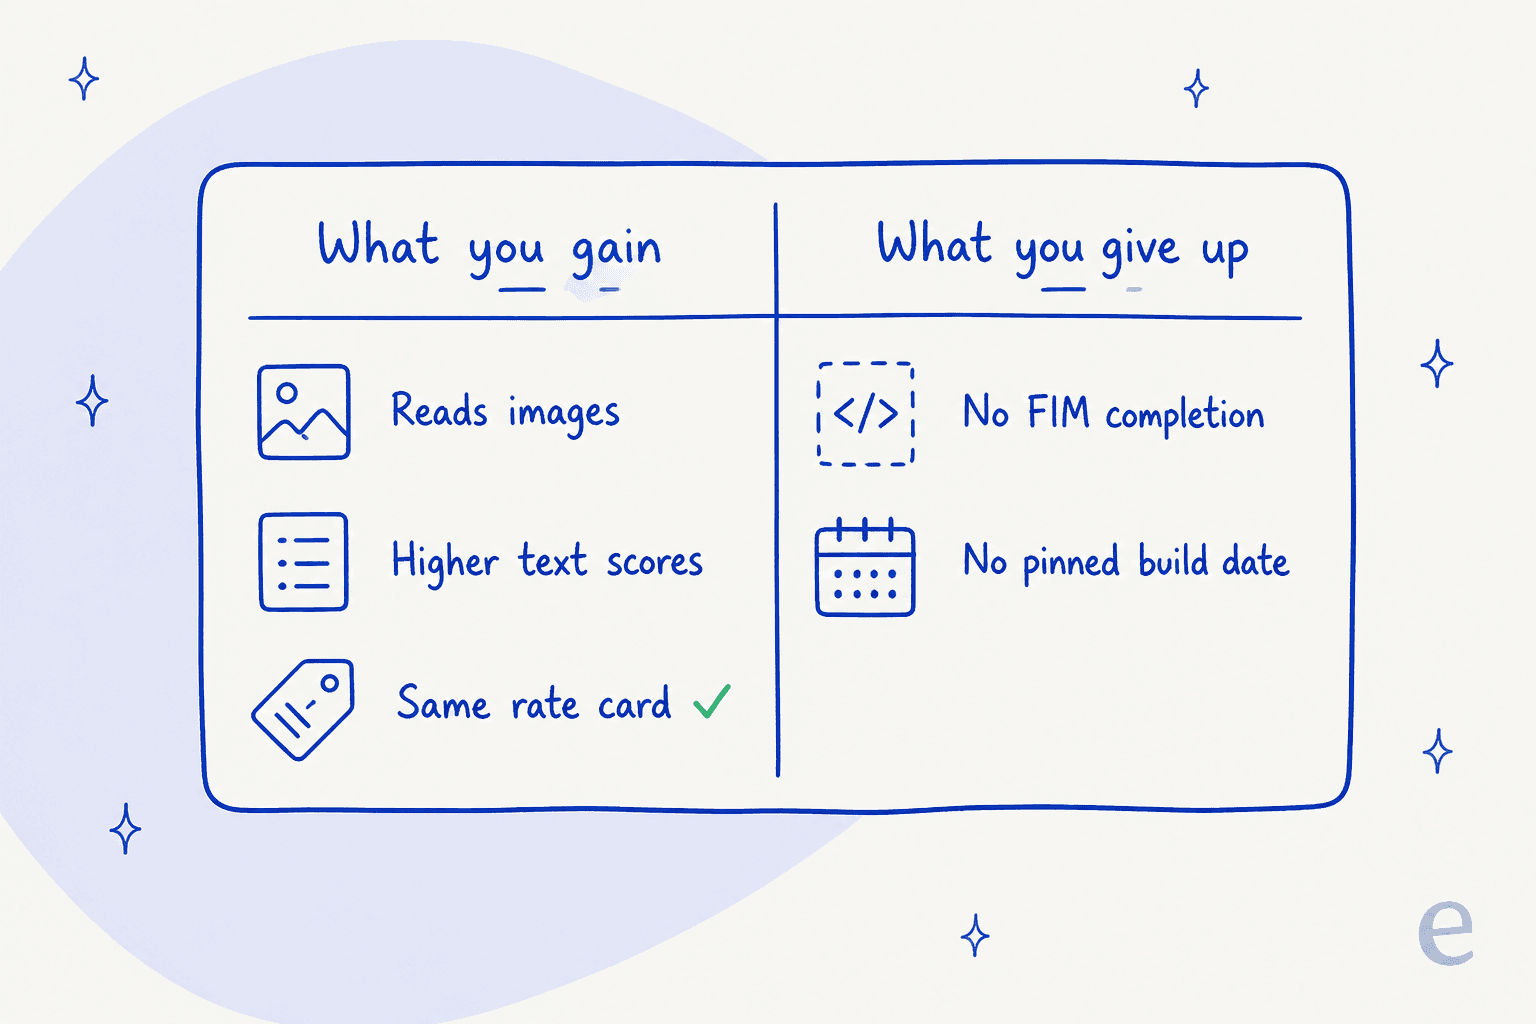
A completação FIM não é suportada. O V4-Flash normal e o V4-Pro oferecem fill-in-the-middle no modo sem raciocínio, enquanto a página de preços o marca como "Not supported" para o build de visão. Então, se você usa FIM para completar código inline, este modelo não pode ser um substituto direto, e esse é o único bloqueio duro do lançamento.
Não há data de build. Isso é mais sutil, e é o motivo pelo qual eu ainda não moveria tráfego de produção. Veja como a tabela de preços nomeia suas versões: o Flash normal é DeepSeek-V4-Flash-0731, o Pro é DeepSeek-V4-Pro-0813, e o build de visão é apenas DeepSeek-V4-Flash-Vision-Exp. Um build datado é um build sobre o qual se pode raciocinar. Um rótulo exp sem carimbo é um alvo móvel, e um comentarista do Hacker News leu o roteiro da mesma forma:
"most likely a preview. they often release the preview via API, get more training data, post train some more then release the weight. i would expect to see it perform better in a few weeks or a month."
Se for isso, os números deste post têm prazo de validade, e também qualquer avaliação que você rodar esta semana. É um custo normal de usar endpoints experimentais. Só vira problema se você esquecer que aceitou isso.
O que as primeiras 72 horas de tráfego real mostram
Benchmarks de fornecedor são uma coisa. Aqui está o que a própria camada de roteamento mediu, segundo o OpenRouter, nos três primeiros dias do modelo.
- 85 tokens/segundo de vazão P50, com latência P50 de 1,11 segundo.
- 1,27% de taxa de erro em chamadas de ferramentas. Para um modelo cujo argumento inteiro é trabalho multimodal de agentes, este é o número que eu checaria primeiro, e está bom.
- 100% de uptime, 99,93% de disponibilidade, com um único provedor. A DeepSeek o serve diretamente, então não há failover para onde rotear.
- 90,4% de taxa de cache hit, que é o que puxa o preço de entrada efetivo para cerca de um sétimo da tabela.
A cauda merece uma olhada, porém. A latência P99 chega a 18,34 segundos e a ponta a ponta P99 a 99,94 segundos. É uma distribuição boa para um trabalho em lote e dura para qualquer coisa em que uma pessoa fica esperando, o mesmo equilíbrio que se pesa com qualquer agente de IA colocado diante de um cliente.
A composição do tráfego é a parte mais interessante. Os maiores consumidores são todos harnesses de programação: Claude Code com 9,58B de tokens, pi com 4,56B, Hermes Agent com 3,3B, além do próprio harness de ponte multimodal da DeepSeek com 3,12B. Ninguém usa isso como modelo de chat. Eles apontam para bases de código e para telas, o que combina bem com essas vitórias em seis de sete benchmarks de texto.
Mais um pedaço de contexto sobre por que um modelo de visão barato pegou tão forte aqui. O V4-Flash normal aparentemente passou meses fingindo que enxergava:
"It tried to recreate vision by analyzing pixels on 3 separate projects I had it working on."
Outro comentarista descreveu como teve de dizer ao 0731 para parar de abrir capturas de tela, porque as tentativas ficavam quebrando as sessões. Diante dessa base, um modelo que simplesmente olha para a imagem é um upgrade real, mesmo que borrado.
Quem deve usar e quem deve esperar
Use agora se você roda loops de agentes sobre telas e bases de código, já estava no V4-Flash e não depende de FIM. Os benchmarks de texto sozinhos justificam a troca da string do modelo, e a visão é lucro extra. Trabalho em lote com documentos também serve, desde que você tenha conferido seus próprios documentos contra o redimensionamento.
Espere se você precisa de um build fixado, ou precisa de FIM, ou suas imagens dependem de detalhe fino. Mostradores analógicos, esquemas densos, letras miúdas em recibos: teste tudo isso antes de planejar em torno disso. A discussão sobre leitura de relógios que correu pelo tópico do Hacker News ilustra bem como são ruidosos os julgamentos de visão em uma única tentativa, já que a falha de um comentarista virou 9 acertos em 10 quando outra pessoa rodou dez vezes, o que gerou uma frase que todos deveríamos colar no monitor:
"Lesson learned to double check what I read on the internet."
Pense melhor se você vai apontar isso para uma fila de suporte. Capturas de tela de clientes estão entre as entradas de maior valor no suporte e também são o pior encaixe possível para um teto de 800 por 800, porque a razão de um cliente enviar uma captura é o texto pequeno dentro dela. Leia nossas notas sobre como escolher um modelo para suporte e sobre qual LLM serve ao suporte antes de ligar um modelo cru a qualquer fila ao vivo.
eesel para filas de suporte cheias de capturas de tela
Quero ser preciso sobre o que este modelo resolve para uma equipe de suporte, porque temos o sinal de demanda registrado. Um cliente, uma terceirizada de suporte para aluguéis de temporada que usa a eesel como copiloto no Zendesk, nos disse claramente o que o impedia de ser totalmente autônomo:
"Eesel is currently unable to analyze images, and our customers frequently share screenshots. Our agents are currently required to read these images and manually transfer the knowledge to Eesel."
Essa é uma necessidade real não atendida, e um modelo como este é o que acabará suprindo-a. Mas vale deixar claro qual metade um modelo de visão de fato resolve. Ler os pixels é a metade fácil. Produzir uma resposta correta e dentro da política a partir deles é a metade difícil, e é também a metade que queimou todo mundo que já lançou suporte com IA.
Já vimos um bot de tom confiante dizer silenciosamente a clientes que dávamos suporte a modelos de carro que não suportávamos, porque a base de conhecimento dizia "we support all models" e o bot levou isso ao pé da letra. Era uma equipe de telemática no Zendesk, com cerca de 200 tickets por mês. Nada em um codificador de visão corrige essa falha em particular. O que corrige é fundamentar o agente no seu histórico real e comprovar o comportamento antes que qualquer cliente o encontre, por isso todo rollout da eesel é reproduzido primeiro sobre tickets passados e restrito a um tipo de ticket por vez.

Então, se você está avaliando o modelo de visão da DeepSeek porque sua fila está cheia de capturas de tela, faça os dois testes na ordem certa. Primeiro, se o modelo consegue ler suas imagens reais depois de redimensionadas. Segundo, e este importa mais, se a resposta que ele devolve é uma que você mesmo teria enviado. A eesel resolve esse segundo teste simulando sobre o seu histórico de tickets antes de entrar no ar, cobrando por ticket em vez de por usuário e encaminhando para um humano tudo que fique abaixo do seu nível de confiança. Experimente a eesel de graça, ou agende uma demonstração com os seus próprios tickets.
Onde isso se encaixa na linha da DeepSeek
Se você está mapeando a família, a versão curta é esta: o deepseek-v4-flash-vision-exp é um fork do build Flash 0731, com um codificador de visão acoplado e o FIM retirado. Não é um modelo de nível Pro e não substitui nada.
- O DeepSeek V4 Flash é a base de texto e continua sendo o build fixado para produção.
- Flash contra Pro trata da situação estranha em que a camada mais barata hoje supera a cara.
- Flash contra Kimi K3 e Flash contra GPT-5.6 cuidam das comparações entre fornecedores.
- Qwen 3.8 Max contra Flash é a disputa de pesos abertos mais próxima, e o Kimi K3 é o outro para acompanhar.
- O DeepSeek V3.2 é a geração anterior, se você ainda o roda.
- Nossa análise do V4-Flash e o resumo de alternativas cobrem o quadro mais amplo.
E se você chegou aqui pelo ângulo da automação de suporte e não da escolha de modelo, a leitura mais útil está mais abaixo na pilha:
- Onde um modelo realmente se encaixa: tickets com IA e agentes de helpdesk com IA.
- A questão da recuperação, que costuma importar mais que o modelo: RAG contra um LLM.
- Como é o trabalho da fila: desvio de tickets e classificação de tickets.
- Ordem e volume de triagem: priorização de tickets, automação da primeira resposta e redução de tickets.
- O padrão com humano no circuito: copilotos de IA para suporte.
- Terminologia, se os discursos dos fornecedores se confundirem: agentes contra chatbots.
- As duas comparações que decidem orçamentos: custo por resolução e custo de agente de IA contra agente humano, tendo como base o custo do atendimento ao cliente com IA.
Conclusão
A DeepSeek lançou um modelo que lê imagens por praticamente nada e, no caminho, lançou um modelo de texto melhor do que aquele de que derivou. As duas coisas são reais, e as duas são baratas.
As duas coisas a ponderar são as que o anúncio não coloca na frente. Toda imagem é achatada para cerca de 800 por 800 antes de o modelo olhar, então a visão aqui é uma olhada e não uma inspeção. E o build não tem data, então tudo que você medir esta semana é uma medição feita sobre um alvo móvel.
Para loops de agentes sobre telas e sobre código, é um bom negócio a $0,22 de entrada e $0,66 de saída. Para uma fila de suporte em que a captura de tela é o ticket, teste o redimensionamento antes de planejar em torno dele, e lembre que ler a imagem nunca foi a parte que ia dar errado.
Perguntas frequentes
O que é o DeepSeek V4 Flash Vision Exp?
model='deepseek-v4-flash-vision-exp' e ele aceita imagens junto com texto na mesma requisição. É uma variante do DeepSeek V4 Flash, com a mesma arquitetura de mistura de especialistas (284B no total, 13B ativos) e a mesma janela de contexto de 1M.Quanto custa o DeepSeek V4 Flash Vision Exp?
Como a DeepSeek cobra as imagens?
O DeepSeek V4 Flash Vision Exp é melhor que o V4-Flash?
Qual é a pegadinha do DeepSeek V4 Flash Vision Exp?
DeepSeek-V4-Flash-Vision-Exp, não com um carimbo fixo no estilo 0731, então um build experimental pode mudar debaixo de você entre o dia do teste e o dia do lançamento.O DeepSeek V4 Flash Vision Exp consegue ler capturas de tela de clientes para suporte?
Como envio uma imagem para a API da DeepSeek?
file_id da nova Files API, que é de uso gratuito. O caminho pela Files API também eleva o limite por imagem de 32 MiB para 64 MiB. Nosso passo a passo da API da DeepSeek cobre a autenticação e a URL base compatível com a OpenAI.