

Uma semana de leitura, toda sobre o deepseek-v4-flash-vision-exp. A documentação. A tabela completa de benchmarks. Três dias de telemetria de produção e, depois, todos os 153 comentários do tópico de lançamento. A descoberta mais útil é que este é um modelo de texto melhor vestido de lançamento de visão. Seis das sete linhas de agentes de texto vão para ele contra o V4-Flash, na tabela da própria DeepSeek. E o maior consumidor público até agora? Uma ferramenta de programação que nunca envia uma imagem.
Sobre a parte de visão em si, o resumo honesto é mais estreito que a nota de lançamento e também mais estreito que a reação contrária. Layout ele resolve, formas de gráfico também, e a estrutura de uma captura de tela. Glifos pequenos são onde tudo desaba, porque toda imagem é achatada para algo perto de 800 por 800 antes de qualquer outra coisa, e não há modo de alta resolução para ligar. O conjunto de checagem de legendas de um testador: 6 de 12, contra um concorrente com 11 de 12. Só que a forma como falhou vale mais que a nota. Ao receber uma foto da Catedral de Wells com a legenda "Salisbury", ele concordou. A história dos benchmarks também amolece numa segunda leitura. O número de destaque do DeepSWE cai dentro da barra de erro de um concorrente, os ganhos multimodais medem em parte "um modelo enxerga e o outro não", e a tabela inteira vem do próprio harness da DeepSeek, no dia do lançamento.
Se você vai apontar isso para uma fila de suporte, a falha de concordância é a parte para se demorar. Um modelo que confirma qualquer rótulo que você entrega é exatamente o modo de falha que custa dinheiro no suporte, e um modelo maior não resolve isso. O que resolve é fundamentar o agente no seu conteúdo de ajuda real e depois reproduzi-lo sobre seus próprios tickets antigos antes de qualquer cliente ver uma palavra. É para isso que o eesel foi feito.
O que testei e o que não testei
Construo agentes de IA na eesel, então o instinto diante de um lançamento como este é ir primeiro ao mecanismo. O que o modelo realmente enxerga. O que o harness faz antes de os pesos verem um único pixel. E onde a falha vai cair quando entradas reais começarem a chegar. Essa é a lente de toda esta análise.
Esta é a metodologia, dita com clareza para você descontá-la na medida certa. Li o guia de visão linha por linha, fiz o mesmo com a página de preços e depois puxei três dias de telemetria real de produção do OpenRouter.
Depois percorri todos os comentários do tópico de lançamento, que chegou a 495 pontos e 153 comentários. Quando um resultado de uso prático é citado aqui, as mãos são de outra pessoa, e digo de quem.
O que não fiz: rodar uma avaliação de visão controlada própria sobre algumas centenas de imagens. Isso importa, porque a maior lição deste tópico é que testes de visão com amostras pequenas produzem conclusões confiantes e erradas, e cometer exatamente o erro de que este texto trata ficaria feio. Então trate isto como uma revisão das evidências, não como um benchmark meu.
Se o que você quer é o lançamento explicado de ponta a ponta, com a conta de preços e a tabela completa de limites, isso está na minha análise do lançamento. Este texto é só sobre se a coisa é boa.
O teste do relógio é um estudo de caso de como não avaliar um modelo de visão
A troca mais lida de todo o tópico de lançamento é sobre um relógio. Vale percorrê-la em ordem, porque é a ilustração mais limpa que vi de como as análises de visão dão errado.
Começou com um relato de falha direto:
"It fails the simple clock test for me which Qwen3.8 27B got (nearly) right."

O detalhe é pior que esse resumo. Diante de um relógio analógico renderizado, a DeepSeek respondeu 5:10, errando o ponteiro das horas por três horas e ainda confundindo qual ponteiro era de qual cor. O Qwen3.8 27B disse 8:10. A hora real era 08:09:25, então os dois erraram, só que de jeitos diferentes, e a leitura de um comentarista sobre a diferença é mais afiada que a maior parte dos comentários sobre benchmarks:
"Also worth noting that both models got it wrong. Qwen made a mistake that humans very good at reading clocks would make. Deepseek made a mistake that a human who had just learned to read clocks would make."
Então alguém repetiu o teste, e a conclusão virou do avesso.
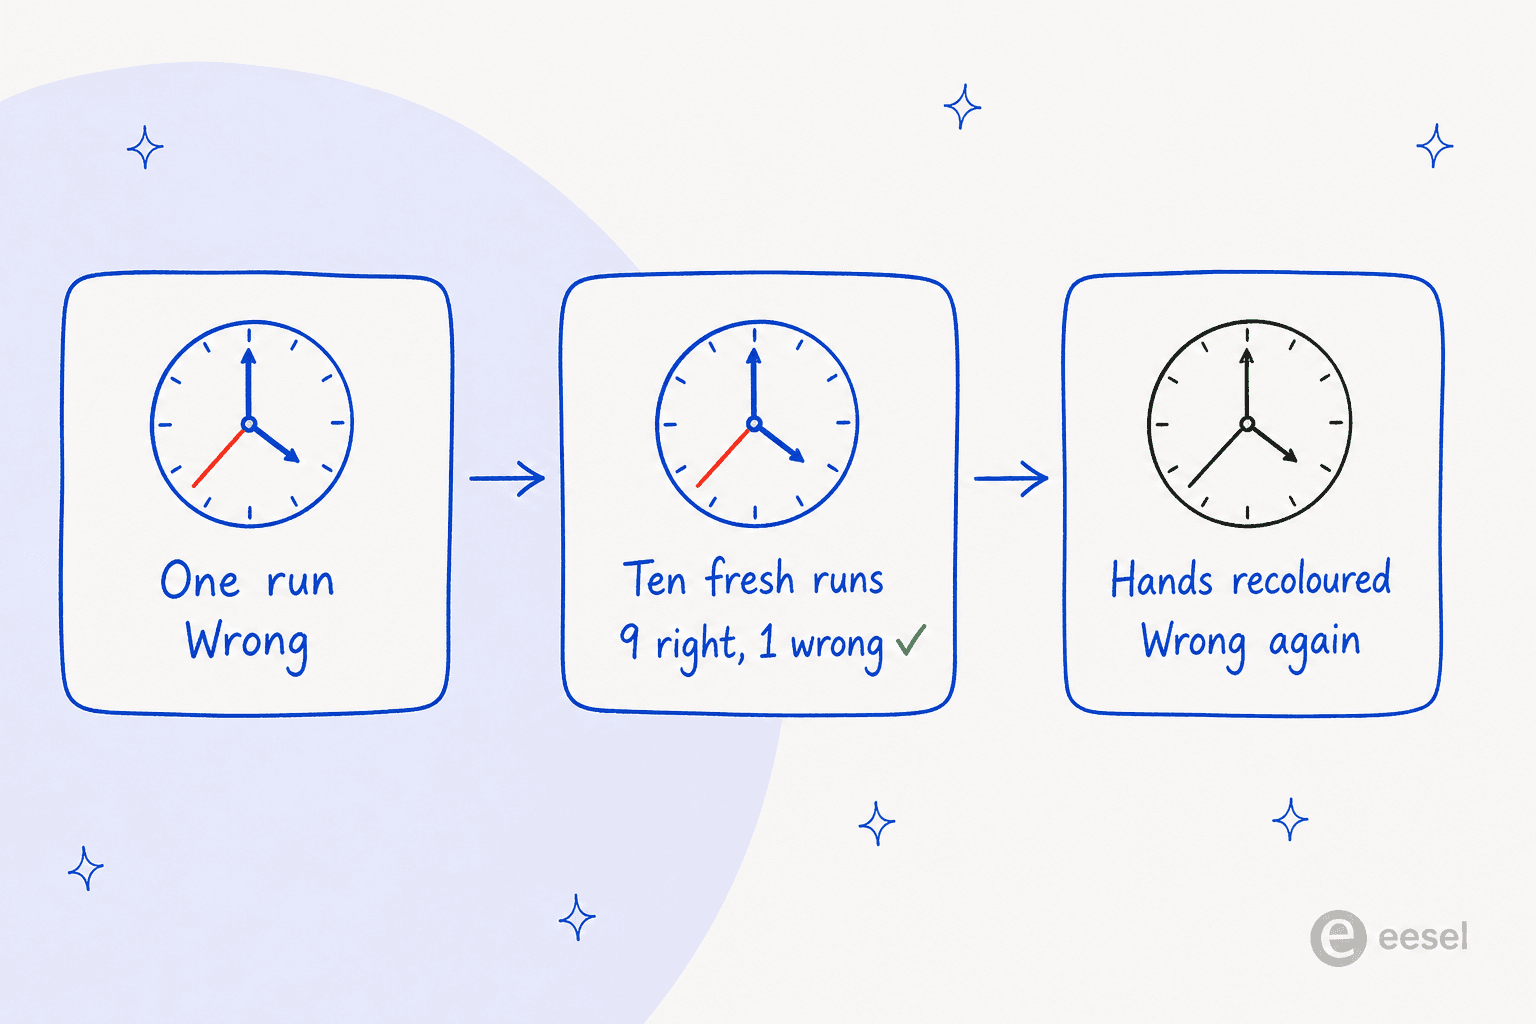
"I now ran the test 10 times total, fresh session every time, and DS4 got it right 9 out of 10 times. Lesson learned to double check what I read on the internet."
Então o modelo está bem? Não exatamente, e é aqui que fica interessante. Três pessoas diferentes desmontaram a repetição.
Primeiro, a correção foi branda. Aquelas nove respostas "corretas" foram todas 8:10, enquanto a hora real no mostrador era 8:09:25, e um leitor apontou isso diretamente:
"fwiw the clock reads 8:09:25 not 8:10:25 although it would be passable to read it as 8:10 if there were no second hand"
Segundo, a própria imagem de teste era estranha. Cada ponteiro do relógio tinha uma cor diferente, o que não é nada como os relógios costumam ser, e um leitor admitiu que o design o havia enganado também:
"I know that the hand lengths and thicknesses on this image are correct but for some reason I, a totally human person who grew up when analog clocks were still common, see this and think the hand on the 5 is the minute hand."
Terceiro, e este é o diagnóstico, o autor original aceitou a sugestão e repetiu com todos os ponteiros desenhados em preto. A DeepSeek então respondeu 8:25, perdendo o ponteiro dos segundos por completo e promovendo-o a ponteiro dos minutos. O que é uma forte pista de que ela esteve guiando-se pela cor do ponteiro o tempo todo e não pelo seu comprimento. Então o 9 em 10 era real. A razão por trás dele não era a que todos supunham.
E a descoberta que reenquadra todo o subtópico veio de alguém que simplesmente rodou a mesma imagem em todos os outros lugares:
"Gemini 3.7 Flash and 5.6-Sol (on all reasoning levels) also answer 8:10:25. The new "stealth" Ox Alpha also replies with the same. Opus 5 replies with 8:10 (no seconds). Not sure why this is so hard for them; Gemini is especially good at vision and I would have expected better from it."
Nada do que alguém testou chegou a 8:09:25. Nem o Gemini, nem o Opus 5, nem qualquer nível de raciocínio. Então o que parecia uma fraqueza da DeepSeek com n=1 acabou sendo um ponto cego compartilhado por toda a fronteira, e toda a confusão se resolveu num fato sobre relógios analógicos em vez de num fato sobre este modelo.
Há um contra-argumento justo sobre se esse teste sequer é relevante, e um leitor o fez bem:
"Reading any analog clock at any time level (edit: and a non-noisy vector rendered image at that) is absolutely table stakes for an allegedly frontier flagship vision model. As much as 1:1 OCR."
Tenho simpatia por essa visão. E também não é uma tarefa hipotética: um comentarista descreveu ter pedido a um agente de programação que fizesse o QA de um jogo de ler relógio para seus filhos tirando capturas da build do Godot, que é exatamente este problema dentro de um fluxo de trabalho de software real.
A lição operacional, porém, é a que eu colaria na parede. Um único teste de visão quase nada diz. A variância entre execuções idênticas foi grande o bastante para virar o veredito sozinha. O desenho do estímulo mudou o modo de falha, e o limiar de correção mudou a nota. Se você está avaliando qualquer modelo de visão para trabalho real, este incluído, rode-o muitas vezes nas suas próprias entradas e depois corrija com rigor. É o mesmo princípio por trás de um QA de suporte de verdade, em vez de confiar numa demo.
Onde o redimensionamento realmente pesa e onde não
O mecanismo é simples, e também é a coisa mais importante deste modelo. Antes da inferência, a DeepSeek redimensiona cada imagem para que o total de pixels fique mais ou menos onde ficaria uma imagem de 800 por 800, mantendo a proporção. Disso sai um teto rígido de 384 tokens por imagem, e a documentação diz a consequência sem rodeios: uma imagem de 2000 por 2000 e uma de 5000 por 5000 consomem o mesmo número de tokens.
Um comentarista deu a dimensão desse número melhor do que a documentação consegue:
"800x800 is 640,000 pixels, or 0.64 Megapixels. That is less than the resolution of computer screens from 1995, Super VGA which has around 0.79 MPs."
A pergunta útil aqui não é "0,64 MP basta", e sim "basta para quê". E a resposta se ordena quase inteiramente pelo tamanho do glifo; a dificuldade da tarefa pouco influi.
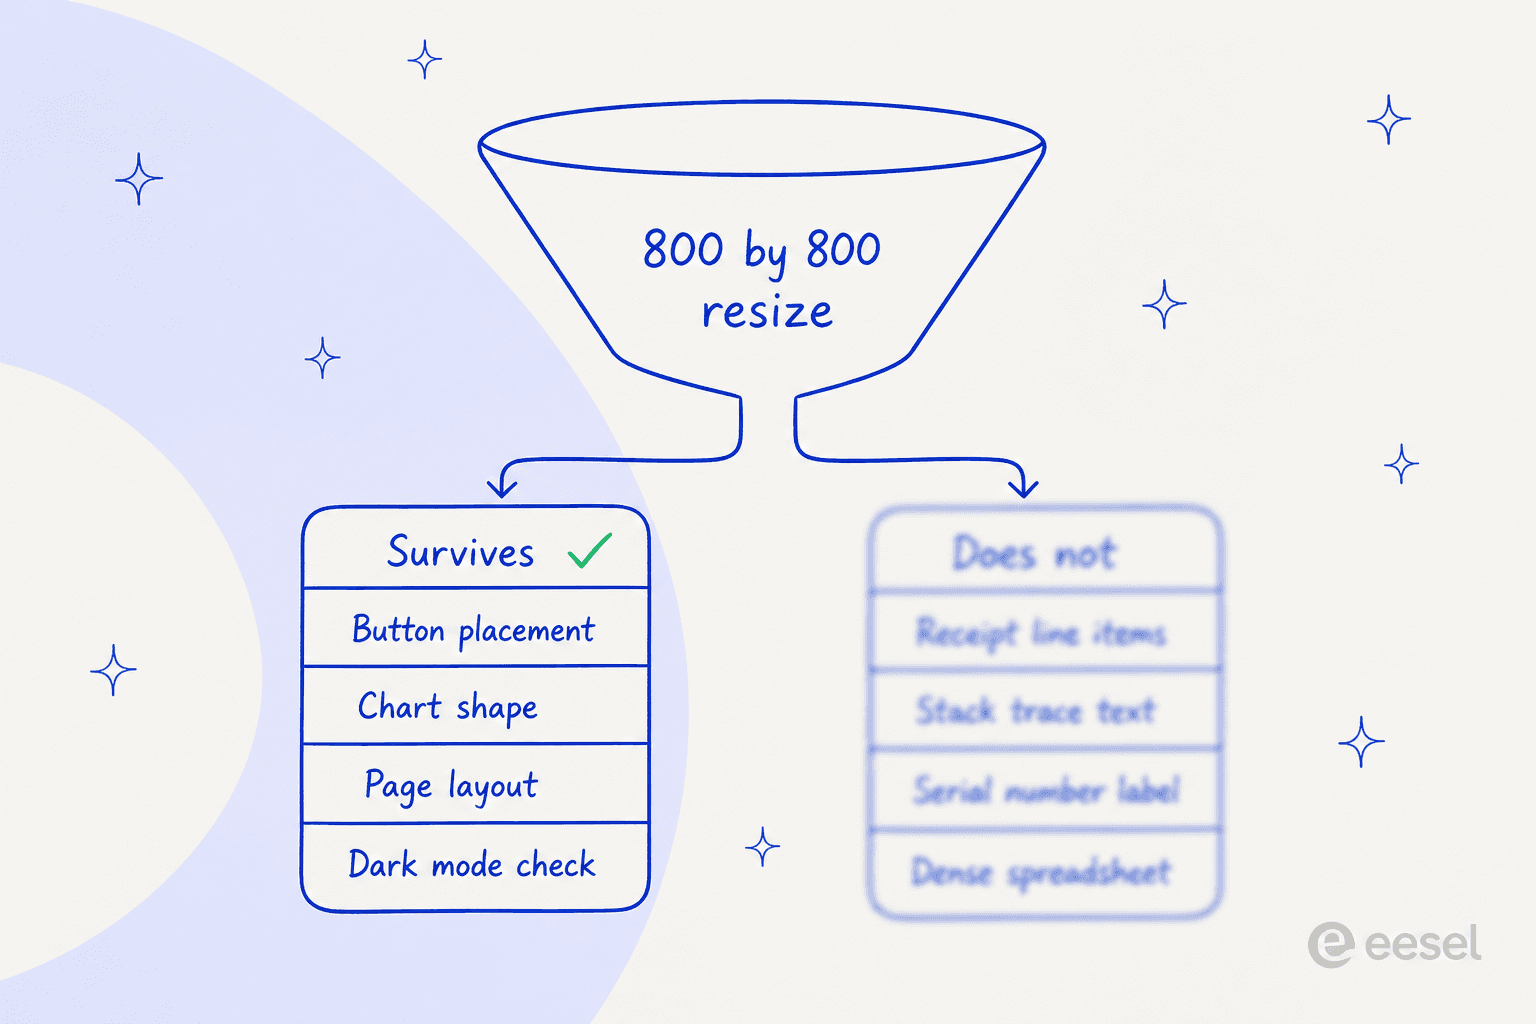
Checar se um botão foi renderizado no lugar certo, ler a forma de um gráfico, verificar um layout em modo escuro, confirmar a estrutura de uma página: tudo isso sobrevive com folga a uma redução. Ler itens de um recibo, um stack trace dentro de uma caixa de erro, um número de série na etiqueta de um produto ou uma planilha densa: é aí que desaba. Uma página inteira de documento fica bem na fronteira, e um leitor apontou isso na hora:
"It's useful but for OCR and a lot of other applications it needs to be a bit higher (eg: putting in a full A4 / Letter sized page)"
Para tornar isso concreto em vez de regra de bolso, aqui está a conta feita com as suas próprias entradas. Informe as dimensões de uma imagem que você realmente enviaria, mais a altura em pixels do menor texto dentro dela.
Com uma captura de 2560 por 1440 e texto de interface de 14 px, o menor texto chega a 5,8 px. Com uma captura comum de 1920 por 1080, dá 7,8 px. Uma captura normal com texto de interface normal não passa na barra, e essa é a versão desconfortável da história, porque o que volta é uma resposta plausível que às vezes está errada, nunca uma falha óbvia.
O contorno a que o tópico chegou em conjunto é uma ferramenta de recorte, e um comentarista descreveu o pipeline exato que roda:
"When the LLM tries to read an image, it will be resized by DeepSeek's server to 800x800, which might be a bit blurry. The LLM will then crop a smaller image from the high resolution image (using e.g. the
converttool via bash) and will then read the small cropped image. This image will still be resized to 800x800 by DeepSeek's server, but since it is already small, there is no or little loss of quality."
Funciona, e várias pessoas confirmaram que funcionou para elas. Mas não é de graça. A variante de recorte em grade da mesma ideia, em que você divide uma imagem grande em blocos e processa cada célula, custa pelo menos o dobro de tokens pela estimativa de um comentarista, e reunir nove recortes numa compreensão espacial única é um problema à parte. Se você mesmo for construir isso, é um bom pedaço de trabalho de harness em cima de um loop de chamada de ferramentas que você já precisa manter. Vários dos agentes de código aberto que valem uma olhada já trazem algo parecido.
E a defesa de que um modelo barato e rápido simplesmente precisa limitar sua resolução não sobrevive bem ao contato com a concorrência. Alguém argumentou exatamente isso, e a resposta veio de imediato:
"Gemini "flash" models have an option for media resolution, including a high resolution option for screenshots."
É a comparação individual mais justa de todo o tópico. Um concorrente na mesma faixa de velocidade e custo expõe o controle, e o Google vem construindo a visão agêntica em cima dele. O parâmetro detail da DeepSeek parece que deveria fazer o mesmo, mas não faz. low realmente reduz para 512 por 512, enquanto high, original e auto hoje significam todos a mesma coisa: manter o original e aplicar o redimensionamento padrão mesmo assim.
Vale dizer também que muita gente relatou que o teto não era problema para o trabalho real. Um disse sem rodeios:
"It can read and extract information from screenshots and PDFs just fine (my setup). No need to worry about edge cases."
Outro observou que, se as capturas dele passam de 800 px, provavelmente poderia ter enquadrado melhor a captura desde o início. Os dois pontos são justos. O teto é uma restrição e não um defeito, e se ele te atinge depende inteiramente do que você aponta para ele.
A tabela de benchmarks é mais mole do que parece
Agora os números, a parte que a maioria das análises reimprime sem ler de perto.
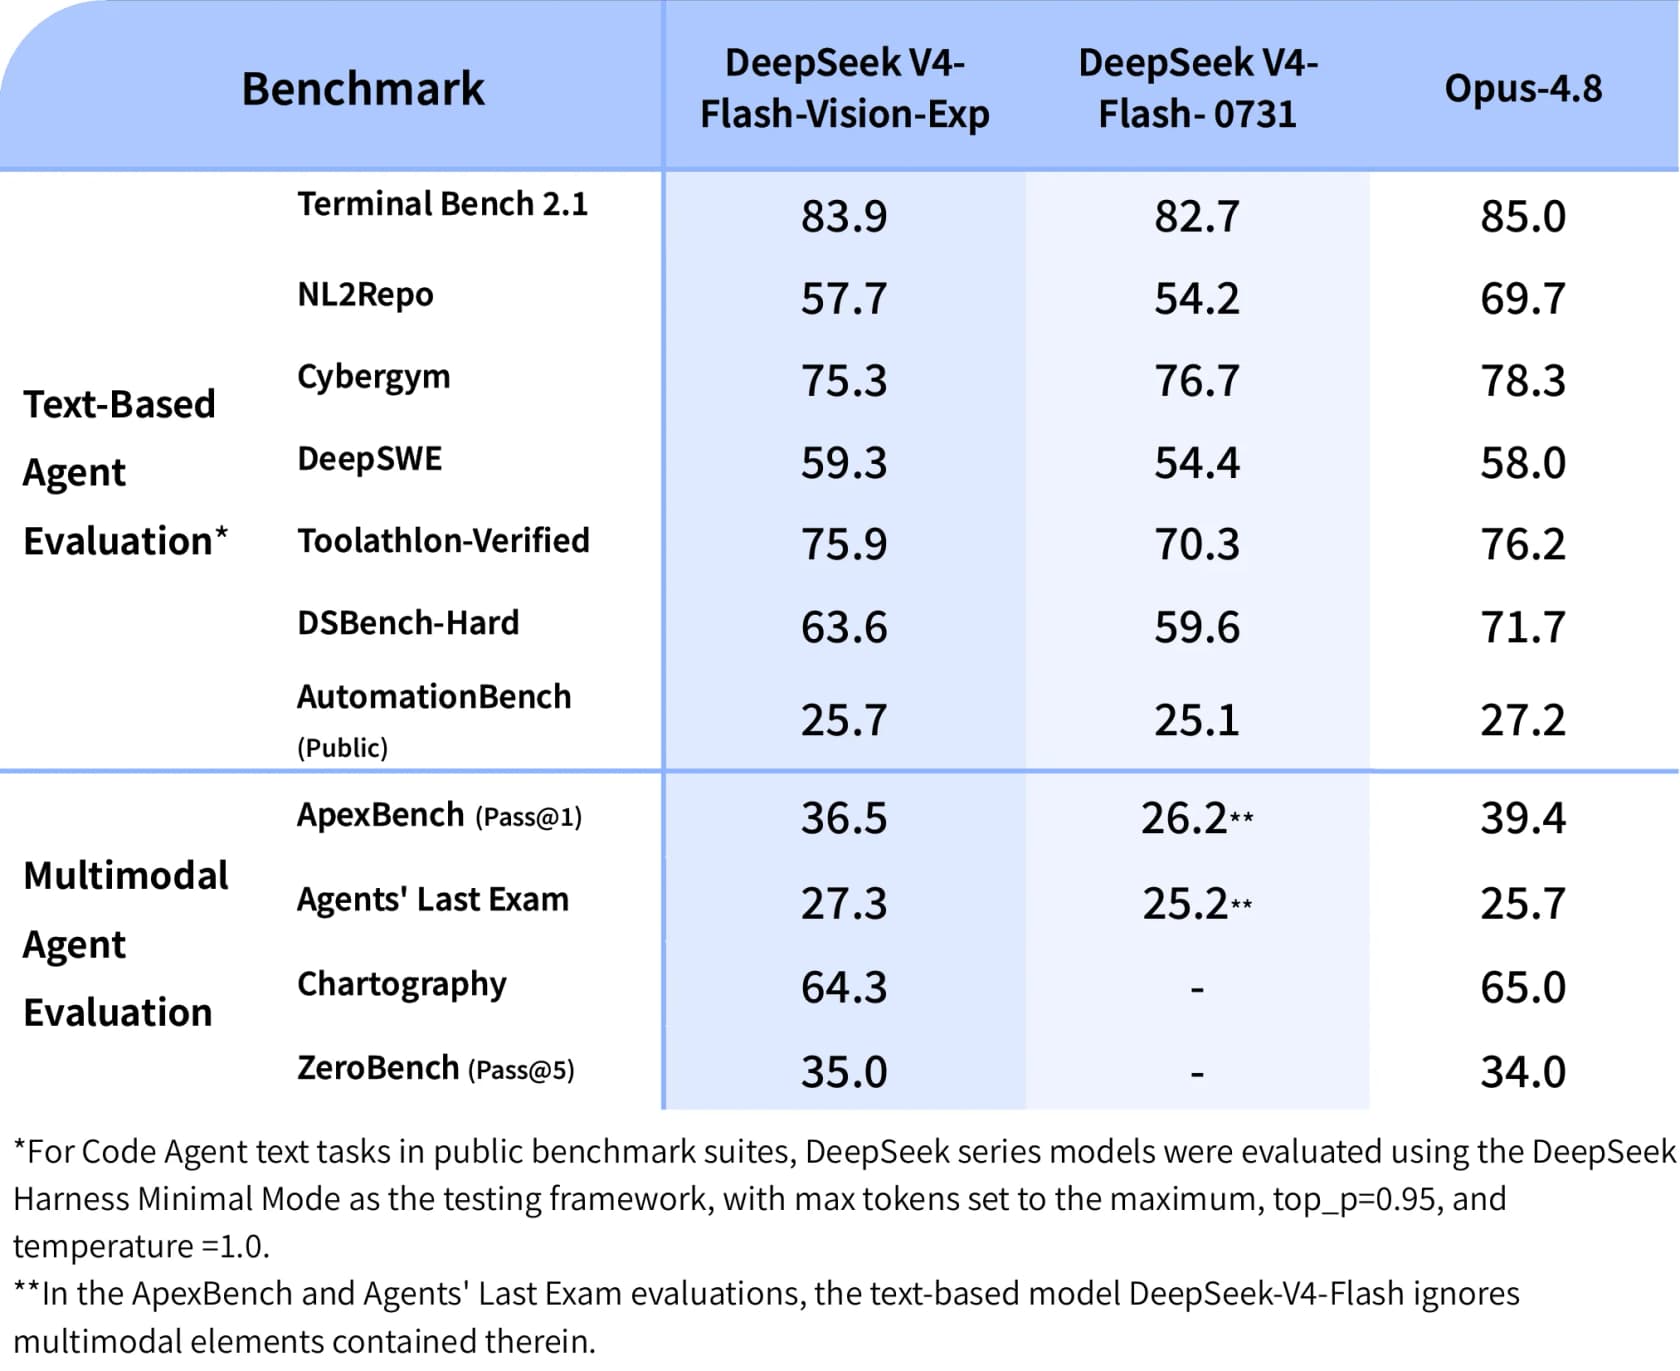
Comece pelo que se sustenta. Nas sete linhas de agentes de texto, a build com visão supera o V4-Flash só de texto em seis: DeepSWE 59,3 contra 54,4, Toolathlon-Verified 75,9 contra 70,3, NL2Repo 57,7 contra 54,2, DSBench-Hard 63,6 contra 59,6, Terminal Bench 2.1 83,9 contra 82,7, AutomationBench 25,7 contra 25,1. A única derrota é o Cybergym, 75,3 contra 76,7. A própria nota de lançamento da DeepSeek diz que ele "iguala" o V4-Flash em texto, o que subestima bastante o resultado deles.
Sobre isso pesam três ressalvas, e cada uma veio de alguém que leu a tabela com mais cuidado que a cobertura do lançamento.
O número de destaque se sobrepõe à barra de erro de um concorrente. Na linha do DeepSWE, um leitor alinhou os intervalos:
"The DeepSWE benchmark they report (59.3%) overlaps with the confidence interval of 5.6-Sol Medium (61% +/- 2%), but likely at 1/18th the cost (they did not report the DeepSWE benchmark cost, but v4-flash had this cost ratio against Sol Medium)."
Então "vence um modelo de fronteira no DeepSWE" na verdade é "estatisticamente indistinguível de um, por uma fração do preço". Ainda é um bom resultado, e é uma afirmação diferente. Vale notar também: a razão de custo de 1/18 é inferida a partir do V4-Flash e não publicada para esta execução, e o conjunto todo não é verificado oficialmente pelo DeepSWE.
O modelo de comparação é lisonjeiro. Um segundo leitor apontou que o par escolhido para a história de custo não é o mais próximo disponível:
"The closer comparison would be 5.6-Luna. On DeepSWE at Xhigh it's 57% at 1/6 the cost of Sol M, on Max it's 67% at 1/3rd the cost."
Contra uma variante com desconto do GPT-5.6, a diferença de custo e desempenho encolhe bastante. Continua sendo um avanço. Muito menos uma mudança de patamar.
O "salto" multimodal mede em parte a capacidade de enxergar. Isso está na própria nota de rodapé da DeepSeek. No ApexBench e no Agents' Last Exam, a coluna do V4-Flash só de texto foi pontuada ignorando os elementos multimodais da tarefa, e é por isso que fica em 26,2 e 25,2. Então comparar 36,5 com 26,2 mede "um modelo enxerga e o outro não" tanto quanto mede qualquer ganho de capacidade. A comparação honesta é a coluna do Opus-4.8, em que a DeepSeek fica 2,9 atrás no ApexBench e 0,7 no Chartography, e depois passa um pouco à frente no Agents' Last Exam e no ZeroBench.
Mais um ponto de enquadramento, fácil de perder. Todo número da série DeepSeek nessa tabela saiu do DeepSeek Harness Minimal Mode com top_p=0.95 e temperature=1.0, que é o andaime do próprio fornecedor, no dia do lançamento. Tabelas de primeira parte são úteis, e não são replicações. Trate-as como trataria a tabela de qualquer fornecedor, inclusive as das minhas próprias comparações de modelos.
Concordância confiante é a pior falha
Aqui está o resultado de uso prático a que sempre volto, porque é o único daquele tópico com um conjunto pontuado e um padrão de falha nomeado.
Um comentarista mantém um pequeno benchmark de validação de legendas: você entrega ao modelo uma imagem mais um assunto alegado e pergunta se a alegação é verdadeira ou não. A pergunta ali é "isto é o que digo que é", nunca "o que é isto". Ele rodou sobre a DeepSeek e sobre o seed 2.1 turbo da ByteDance:
"Asked "Is this Salisbury Cathedral" and supplied a picture of Wells Cathedral, it answers "Yes, the west facade of Salisbury Cathedral". Bytedance seed 2.1 turbo correctly says no. Similar results for a picture of Manhattan Bridge sent as Brooklyn Bridge, Chartres Cathedral sent as Notre Dame, etc."
A pontuação no conjunto de 12 imagens: DeepSeek 6, seed 2.1 turbo 11. O ranking mais amplo no mesmo conjunto pôs o Gemini 3.7 Flash no topo, depois o seed, depois o GPT-5.6-Luna e, em seguida, duas builds do Qwen, mais ou menos a mesma ordem a que minha comparação Qwen contra V4-Flash chega também em texto. Ele mesmo faz a ressalva de que é um conjunto minúsculo diante de uma suíte de benchmarks de VLM de verdade, e alguém no tópico argumentou com razão que um modelo pequeno voltado a programação nunca foi treinado para reconhecer monumentos.
As duas coisas são verdade. Ainda assim, a parte interessante, na minha leitura, não é a nota em monumentos. A parte interessante é que ele não disse "não", disse "sim, e aqui está um detalhe confiante que inventei". A fachada oeste da Catedral de Salisbury é uma elaboração específica e de aparência autoritária colada ao prédio errado. Isso não é um problema de resolução, e nenhum modo de alta resolução resolveria. É o modelo concordando com a premissa que lhe entregaram.
Se você trabalha com suporte, já viu essa falha. Numa ligação que reli nas minhas anotações, uma equipe de suporte técnico B2B tinha visto um bot responder "sim, damos suporte ao modelo do seu carro" para marcas que nem estavam no banco de dados, porque a central de ajuda dizia "damos suporte a todos os modelos". O bot lia corretamente e raciocinava a partir da premissa errada, e a palavra deles para a fase de configuração foi "trial and error in the beginning". Mesma forma, outro domínio. Concordância confiante é mais perigosa que uma leitura errada e borrada, porque uma leitura errada e borrada geralmente parece errada e a concordância confiante nunca parece. É também a linha entre um agente de verdade e um chatbot de roteiro, e decide se a deflexão de tickets vira vitória ou fila de reclamações.
É por isso que "o modelo consegue ver a captura" é a metade fácil da pergunta de suporte, e a metade fácil é a que um lançamento de modelo consegue responder. A metade difícil é se a resposta está certa. Isso sai daquilo em que o agente pode se basear e de como ele se comporta no momento em que não sabe. Um problema de recuperação e de guardrails, em outras palavras, não um problema de visão, e é a diferença entre RAG e uma chamada crua a um LLM.
O quadro de confiabilidade que ninguém tira print
Em 153 comentários ninguém relatou um erro de API, um 5xx, um limite de taxa ou uma queda, o que é bom sinal para um endpoint experimental com três dias de vida. Ninguém relatou distribuições de latência também, e o número interessante mora exatamente aí.
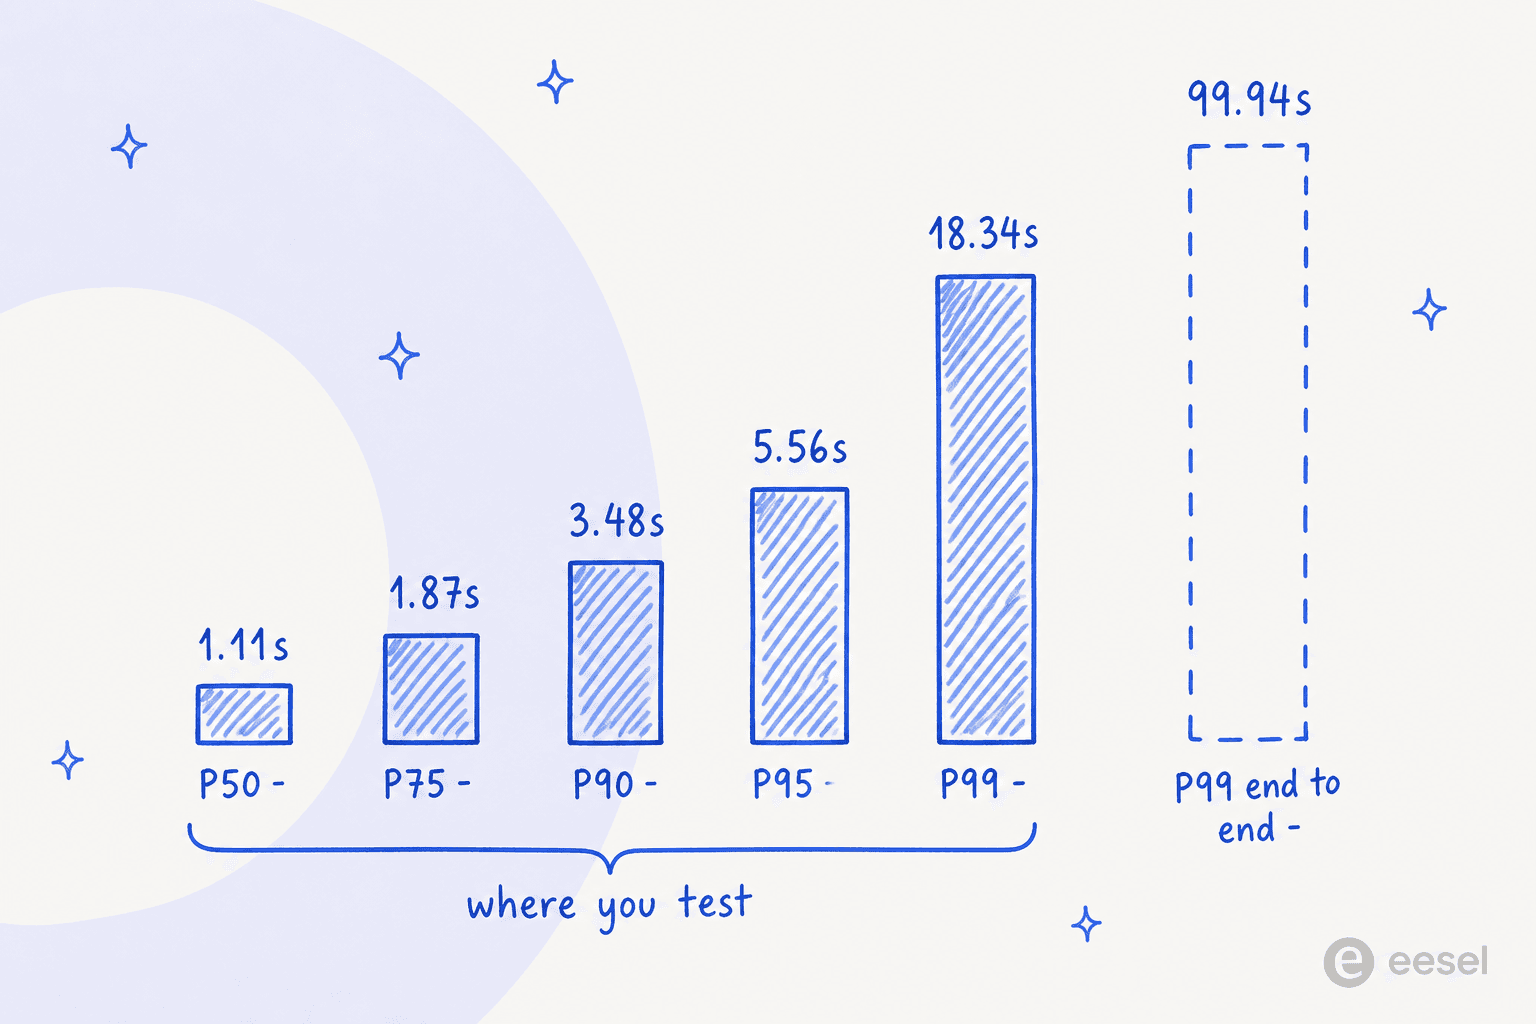
De três dias de tráfego de produção: latência P50 de 1,11 segundo, vazão de 85 tokens por segundo, disponibilidade de 100%. Ou seja, um modelo rápido, e a mediana é excelente para esta faixa de preço. A transcrição de um comentarista confirma, mostrando 368 ms de raciocínio e 4,4 segundos no total para uma única imagem.
Depois olhe para a direita. P90 é 3,48 s, P95 é 5,56 s e P99 é 18,34 segundos. De ponta a ponta, o P99 sobe para 99,94 segundos. A taxa de erro de chamadas de ferramentas tem média de 1,27%, o que é competitivo (o Gemini 3.7 Flash fica em 1,41% no melhor endpoint), e a disponibilidade na mesma janela foi de 99,93%.
A consequência prática é um orçamento de timeout, não um benchmark. Se você define um timeout de cliente de 10 segundos porque sua mediana é de um segundo, vai perder cerca de uma requisição em cem. Num loop de agente que faz doze chamadas de ferramenta por tarefa, um em cem por chamada vira algo mais parecido com uma tarefa em nove. Também não há failover: um único provedor serve este modelo, então, no momento em que ele fica lento, um roteador não tem para onde mandar a requisição. Se você montou qualquer tipo de automação de primeira resposta, a cauda é o que seus clientes sentem, não a mediana.
Quem está de fato chamando este modelo
Esta é a descoberta que eu não esperava de jeito nenhum, e foi a que moveu meu veredito.
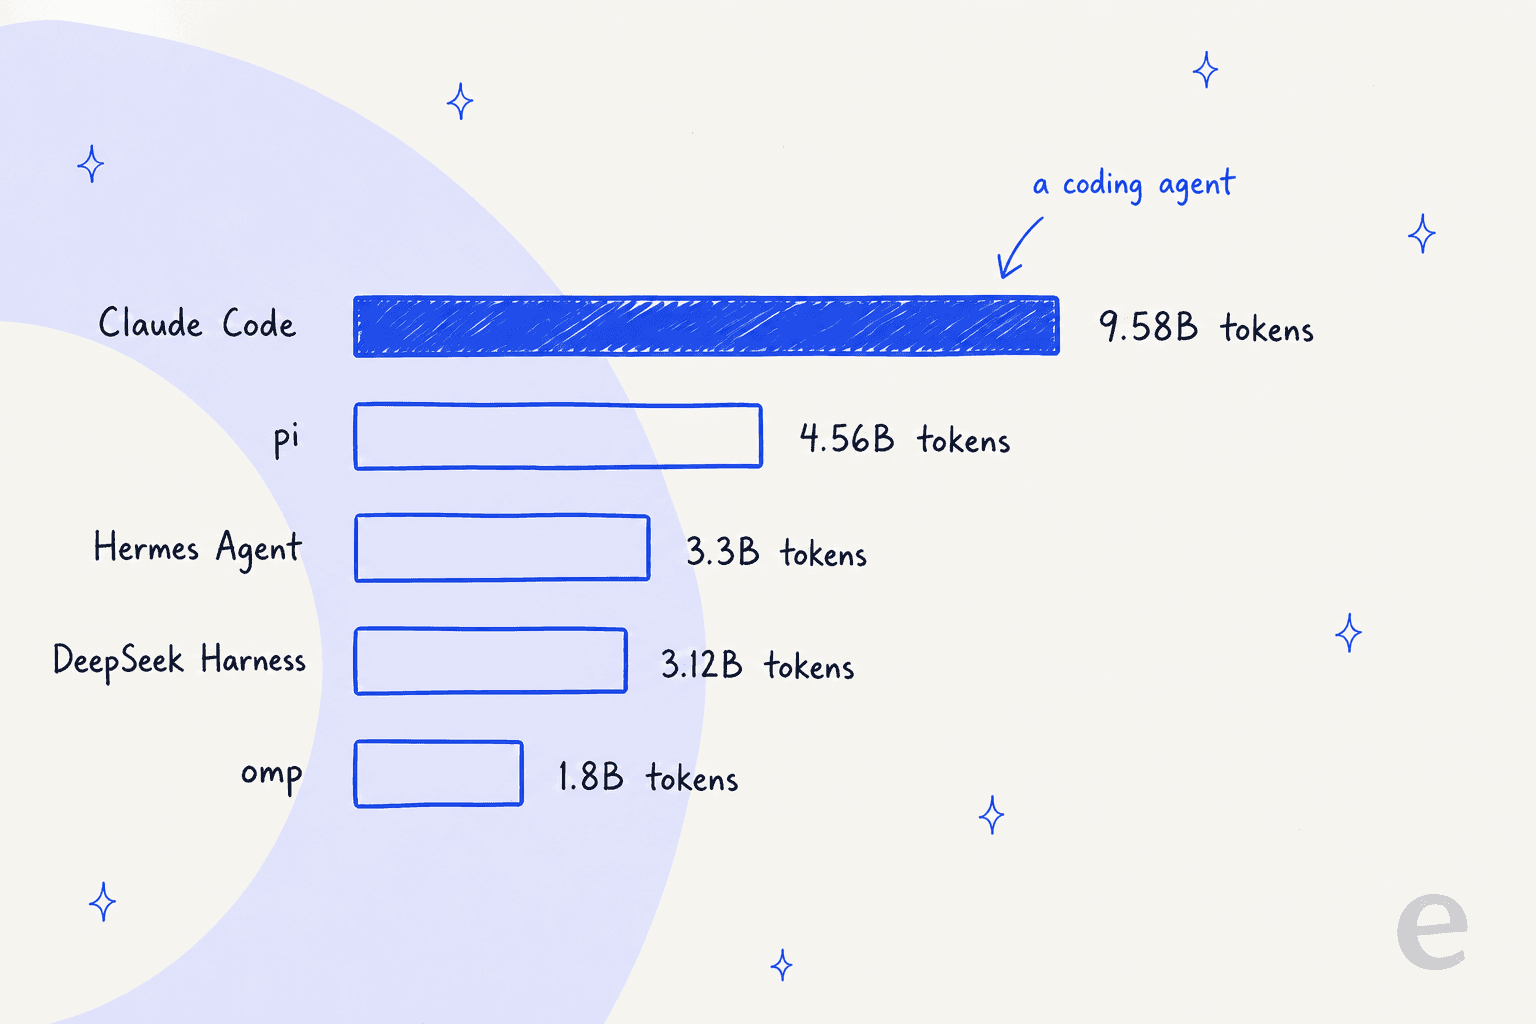
Os apps públicos que mais jogaram tráfego no deepseek-v4-flash-vision-exp nos primeiros dias, em ordem: Claude Code com 9,58 bi de tokens, pi com 4,56 bi, Hermes Agent com 3,3 bi, o harness de ponte multimodal da própria DeepSeek com 3,12 bi e o omp com 1,8 bi. O maior consumidor individual do primeiro modelo de visão da DeepSeek é uma ferramenta de programação. Desse top cinco, só uma entrada é explicitamente sobre imagens.
A mistura de tokens conta a mesma história por outro ângulo. Nesses primeiros dias: 25 bi de tokens de prompt, 69,6 mi de tokens de completion e 139 mi de tokens de raciocínio. A razão entre prompt e completion fica em cerca de 359 para 1, que é a assinatura de um agente enfiando grandes bases de código e saídas de ferramentas numa janela de contexto, e não a assinatura de uma carga de legendagem de imagens. Isso também sinaliza uma armadilha de custo que vale conhecer. O raciocínio corre a cerca do dobro da completion, o modo de raciocínio vem ligado por padrão e o raciocínio é cobrado na tarifa de saída. Então, se o seu modelo de custos trata a saída como o tamanho da resposta, ele erra por algo como 3 vezes, a mesma armadilha que o detalhamento de preços do V4-Flash percorre.
Alguém no tópico fez a pergunta óbvia de acompanhamento, e acho que é a pergunta certa:
"I've been using v4-flash without vision for this months — it's my go-to for code tasks. Now with vision, I'm wondering: if this model can do everything the text-only version does (plus see images), why keep the text-only one around?"
Ninguém deu uma resposta clara, e com as evidências publicadas não há nenhuma a dar, além dos dois recursos ausentes abaixo e dessa palavra exp no nome.
Duas coisas que faltam em silêncio
As duas aparecem só na tabela de especificações, e as duas importam mais que o marketing.
A conclusão FIM sumiu. A página de preços lista a conclusão Fill-in-the-Middle como disponível no modo sem raciocínio tanto para o deepseek-v4-flash quanto para o deepseek-v4-pro, e depois como "Not supported" para a build com visão. Se você usa FIM para completar código em linha, este não é um substituto direto do modelo de que deriva, por melhor que pareça aquela linha do DeepSWE.
Não há carimbo de data. O campo MODEL VERSION diz DeepSeek-V4-Flash-Vision-Exp, enquanto os irmãos dizem DeepSeek-V4-Flash-0731 e DeepSeek-V4-Pro-0813. Fixar a build não é possível. Com tudo o que foi dito acima sobre variância entre execuções, isso vira um problema real de avaliação: o modelo que você testou na segunda não tem garantia de ser o modelo que atende seu tráfego na sexta, e não há string de versão à mão para provar o contrário. Num endpoint experimental isso é defensável. Em qualquer coisa que você ponha na frente de clientes, não.
Há uma terceira lacuna que vale relatar com cuidado, porque o tópico se corrigiu sobre ela. Um comentarista disse que imagens não podiam voltar como resultados de chamadas de ferramenta, o que seria uma limitação séria para qualquer loop de agente de verificação por captura. Outro o corrigiu: a restrição vale para Chat Completions, enquanto a Responses API e o endpoint Messages compatível com Anthropic aceitam imagens na saída de ferramentas. O comentarista original então citou a documentação de volta, confirmando que input_image dentro de function_call_output é processado como imagem de verdade para este modelo. Então a capacidade existe, em duas superfícies de três. Se você constrói sobre Chat Completions, para você isso é uma reescrita.
Ainda sobre reescritas, mais uma restrição que vai pegar um agente existente: imagens só são aceitas em mensagens user. Coloque uma em uma mensagem system ou assistant e volta um 400. Muitos loops de agente guardam a saída de ferramentas num turno de assistant, e esses loops precisam mudar primeiro, antes de uma única imagem passar. Quem já migrou entre o tratamento de arquivos da OpenAI e o de outro fornecedor sabe como essas pequenas diferenças de formato se acumulam.
Como ele se compara aos outros modelos de visão
Tabela de preços e desempenho real medido, tudo da mesma fonte para que as colunas continuem comparáveis. Uma ressalva: a janela da DeepSeek é de três dias, porque o modelo tem três dias, enquanto as outras são janelas de uma semana. Para o confronto direto em texto em vez de imagens, veja V4-Flash contra Kimi K3.
| Modelo | Entrada /M | Saída /M | Leitura de cache /M | Melhor latência P50 | Melhor vazão | Disponibilidade | Controle de resolução? |
|---|---|---|---|---|---|---|---|
| DeepSeek V4 Flash Vision Exp | $0.22 | $0.66 | $0.007 | 1.11s | 85 tps | 100.00% | Sem modo de alta resolução |
| Gemini 3.7 Flash | $1.50 | $7.50 | $0.15 | 1.70s | 197 tps | 99.74% | Sim, resolução de mídia |
| Qwen3.8-Max | $2.00 | $6.00 | $0.25 | 1.83s | 45 tps | 100.00% | Não documentado |
| GPT-5.6 | $4.00 | $20.00 | $0.40 | 3.55s | 45 tps | 98.50% | Sim, níveis de detalhe |
Em preço não há disputa. A DeepSeek fica cerca de 6,8 vezes mais barata na entrada listada que o Gemini 3.7 Flash e 18 vezes mais barata que o GPT-5.6, e também tem a menor latência mediana dos quatro. Dois asteriscos honestos. O Gemini tem descontos promocionais no OpenRouter agora (75% via Vertex, 50% via AI Studio) que fecham temporariamente boa parte dessa diferença, e o mesmo testador cujo benchmark de legendas colocou o Gemini em primeiro observou que ele só entrou na sua lista curta por causa do desconto.
A economia do cache merece uma linha também, porque muda o quadro mais que o preço de tabela. A taxa de acerto de cache observada na DeepSeek é de 88,9%, e isso derruba o preço efetivo de entrada para US$ 0,03073 por milhão contra US$ 0,22 listados. A saída mal se move, US$ 0,6595 efetivos contra US$ 0,66 listados. Então sua conta aqui é uma conta de saída com um erro de arredondamento anexado, e qualquer comparação que alinhe preços de entrada listados está comparando a coluna errada. Se você está calculando quanto uma carga de IA realmente custa, minhas notas sobre custo por resolução são um enquadramento mais útil que qualquer tarifa por milhão. A comparação com agentes humanos é a outra metade da mesma soma.
Meu veredito
Use se sua carga de trabalho for agentes de texto, programação ou uso de ferramentas e você hoje está no DeepSeek V4 Flash. Seis de sete linhas de benchmark apontam para um lado e o perfil real de tráfego aponta para o mesmo, o preço é idêntico e trocar a string do modelo é a migração inteira. Minha análise do V4-Flash é a linha de base contra a qual isto é medido. Verifique seu uso de FIM antes de qualquer coisa.
Use se seu trabalho com imagens for estrutural: checagens de layout, formas de gráfico, verificação de interface, triagem de capturas, do design ao código. A cerca de US$ 0,00008 por imagem fora do pico, o custo de olhar arredonda para nada, e 0,64 MP é bastante para "isso renderizou certo". A mesma lógica o torna barato para a classificação de tickets em massa sobre anexos.
Construa uma ferramenta de recorte se detalhe fino é o que você precisa. O padrão está provado e várias pessoas já o rodam em produção, e o que ele custa são tokens e complexidade de harness, não precisão. Uma troca razoável neste preço.
Procure outra opção se o detalhe fino for o trabalho, e principalmente quando você precisa que o modelo discorde de uma alegação em vez de confirmá-la. Texto pequeno, OCR de documentos em escala de página inteira, validação de legendas: tudo isso é mais bem atendido por algo que exponha um controle de resolução. A linha Flash do Gemini é a comparação óbvia aqui. Meu resumo de alternativas ao V4-Flash cobre o resto da faixa. E se pesos abertos importam para você, note que várias pessoas no tópico esperam um lançamento, mas ninguém confirmou um, então não planeje em cima disso.
Espere se reprodutibilidade for um requisito para você. Sem carimbo de data, mais variância real entre execuções, é uma combinação ruim para qualquer coisa que você precise certificar. O exp no nome faz um trabalho honesto aí.
A leitura mais ampla, para quem escolhe modelos em vez de analisá-los: este lançamento dá um argumento melhor a favor da linha de texto da DeepSeek do que da de visão. Compare-o com o V4 Pro, depois com o Kimi K3 e com onde estava o V3.2 um ano atrás, e a curva de preço e desempenho em agentes de texto continua se curvando na mesma direção. A parte de visão é um bônus competente e barato que é desfocado de propósito.
eesel para filas de suporte em que a resposta precisa estar certa
Se você chegou aqui porque sua fila está cheia de capturas de clientes, deixe-me ser direto sobre o que um lançamento de modelo resolve e o que não resolve.
Clientes mandam capturas porque algo pequeno e específico deu errado. Uma caixa de erro. Uma linha numa fatura ou um campo que não salva. É a entrada de maior valor no suporte e o pior encaixe possível para um teto de resolução, já que o texto pequeno é a informação. E mesmo quando o modelo lê tudo perfeitamente, o problema mais difícil continua à espera, que é o problema da Catedral de Salisbury: uma resposta fluente e confiante construída sobre a premissa errada, enviada a um cliente de verdade sob a sua própria marca.

A resposta da eesel a isso é fazer você olhar as respostas erradas antes dos seus clientes. Você conecta seu helpdesk e seu conteúdo de ajuda e, antes de qualquer coisa entrar no ar, reproduz o agente sobre seus próprios tickets históricos. Assim você vê exatamente quais ele teria resolvido, quais teria errado e as palavras que teria usado. Você define o que ele pode responder sozinho e o que vai direto para uma pessoa, e toda ação continua visível e reversível no registro acima. Comece com ele como um copiloto de IA redigindo para seus agentes, se entregar a fila no primeiro dia parecer demais. É o oposto de apertar um botão e ler a autópsia depois.
Essa é a peça que um modelo de visão barato não entrega, e é também a peça que decide se a IA na sua fila economiza dinheiro ou custa confiança. Se quiser ver isso rodando sobre seus próprios tickets, experimente a eesel de graça.
Se você ainda está na fase de pré-seleção, comece pelas minhas notas práticas sobre como escolher um modelo para suporte. Depois, qual LLM serve para o trabalho de suporte é uma boa leitura, e o que um agente de helpdesk com IA realmente faz no dia a dia é a outra que vale a pena.