

Meu veredito sobre o MiniMax M3.1 Flash é 3,5/5: um burro de carga para agentes, barato e rápido, que não supera a DeepSeek em código. A MiniMax o lançou em 19 de outubro de 2026 com preço fixo de $0.15 de entrada e $0.60 de saída por milhão de tokens na sua página de preços, sem sobretaxa de contexto longo na janela de 1M. Ele lidera a tabela da própria MiniMax no Automation-Bench (62.8) e empata com o Claude Opus 5 no BankerToolBench (76.2).
O problema está nessa mesma tabela. Contra o DeepSeek V4.1 Flash 1017, que custa o mesmo fora do pico, o M3.1 Flash vence um de seis benchmarks compartilhados e fica atrás no DeepSWE (73.7 contra 77.0), no Terminal-Bench 4.0 e no NL2Repo. Seu gráfico de custo por tarefa precifica o DeepSeek em tarifas de pico, o que favorece a MiniMax. Os pesos estão prometidos para 23 de outubro.
Então eu o usaria em ciclos de agentes estilo escritório, chamadas de ferramentas e trabalho com documentos longos, e escolheria o DeepSeek para trabalho pesado em repositórios. Para equipes de suporte, o modelo é a menor parte do trabalho: o colega de IA para helpdesk da eesel traz a conexão com o helpdesk, o conhecimento e uma reprodução dos seus tickets antigos, que é como a smava processa cerca de 27,000 tickets por mês com ele.
Qual é o meu veredito sobre o MiniMax M3.1 Flash?
Passo a maior parte da semana olhando o que as pessoas pesquisam antes de comprar, e as buscas em torno deste lançamento são diretas: "is M3.1 Flash better than DeepSeek", "is it open source", "what does it cost". Esta análise responde a elas, nessa ordem. Se você quer a ficha técnica simples dos dias da prévia, a visão geral do M3.1 Flash do meu colega ainda cobre o seletor de esforço e o contexto de 1M.
Também faço parte de uma equipe que roda IA em filas de suporte reais há anos, e esse histórico molda como pontuo um modelo. Um modelo mais barato faz "vamos construir nós mesmos" parecer fácil. Um cliente de médio porte que cancelou nos disse exatamente isso na saída:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelos como o M3.1 Flash são o motivo de essa frase soar verdadeira. Se ela é verdadeira depende de tudo ao redor do modelo, então pontuo tanto o motor quanto até onde ele leva você.
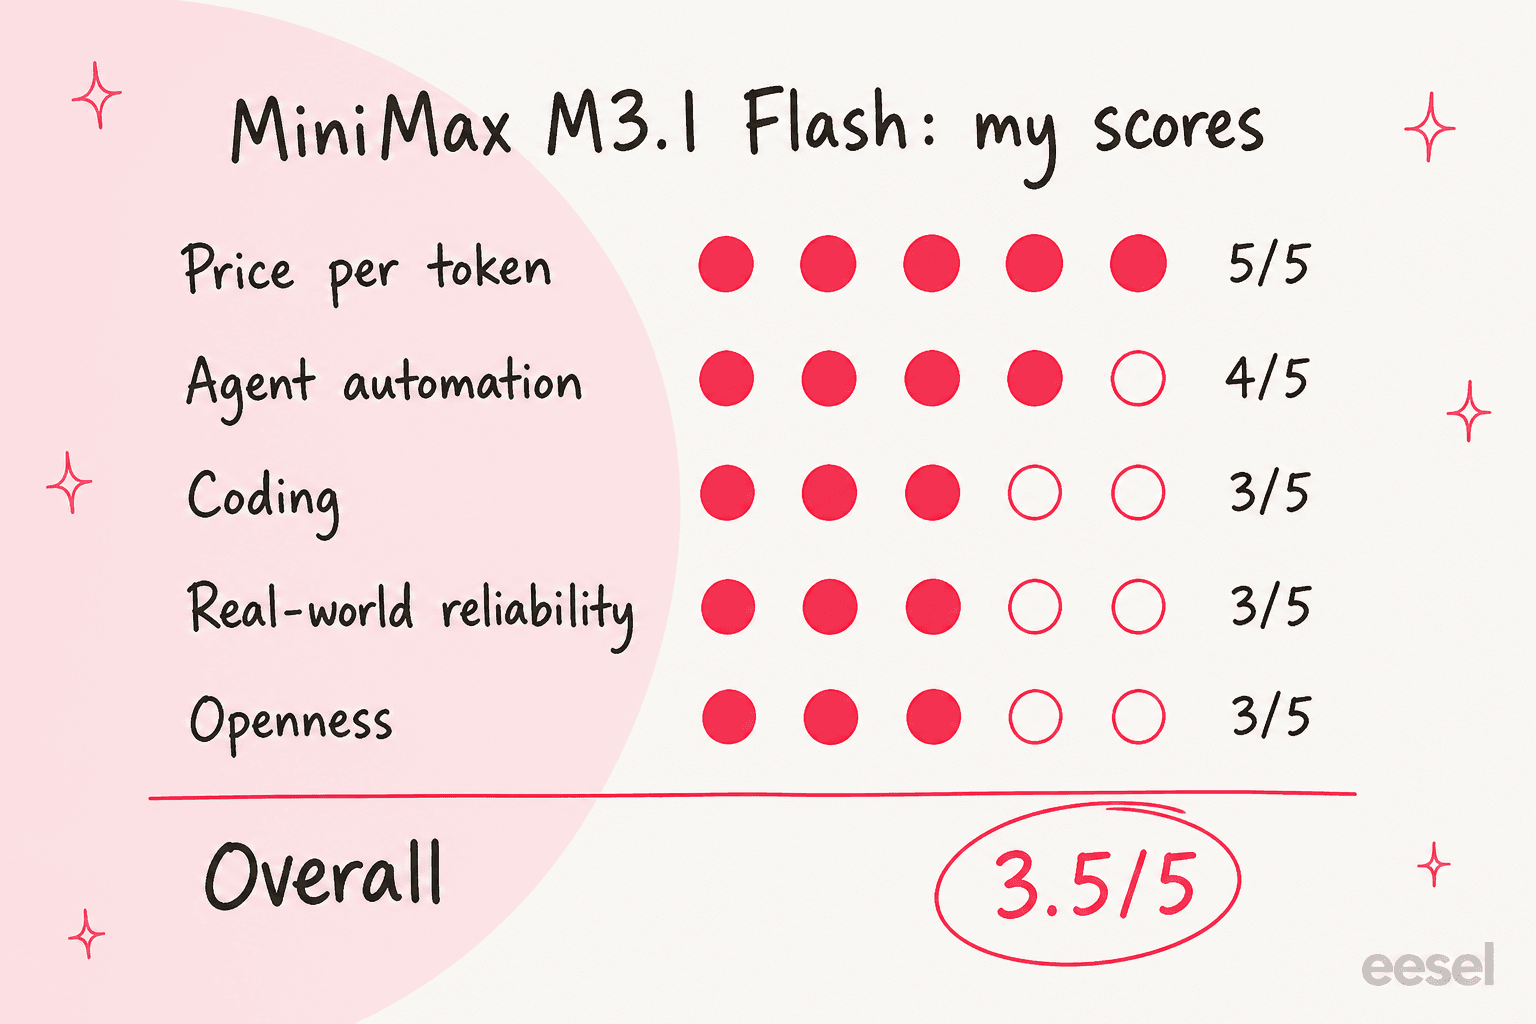
| Área | Nota | Por quê |
|---|---|---|
| Preço por token | 5/5 | $0.15/$0.60 fixo em 1M de tokens, metade da tarifa de contexto curto do MiniMax M3 |
| Automação de agentes | 4/5 | Melhor no Automation-Bench na tabela da MiniMax, empata com o Opus 5 no BankerToolBench |
| Programação | 3/5 | Fica atrás do DeepSeek V4.1 Flash 1017 no DeepSWE, Terminal-Bench 4.0 e NL2Repo |
| Confiabilidade no mundo real | 3/5 | Os primeiros testadores relatam preguiça e divagação com esforço alto |
| Abertura | 3/5 | Pesos prometidos para 23 de outubro, ainda não liberados |
| Geral | 3,5/5 | Um bom motor barato para ciclos de agentes, não o rei barato da programação |
Essas notas são minhas. Vêm da publicação de lançamento da MiniMax, das suas páginas de documentação e preços, das páginas de preços dos rivais e do que os desenvolvedores publicaram nas primeiras 24 horas.
O que realmente foi lançado em 19 de outubro?
A prévia sobre a qual escrevi em setembro sumiu. A documentação da MiniMax agora lista o MiniMax-M3.1-Flash como o modelo mais recente da série M, e a documentação do M Plan diz que o antigo nome MiniMax-M3.1-Flash-Preview foi aposentado, com as requisições agora atendidas pelo novo modelo. Também confirmou o boato do período furtivo: o "Space Bunny", o modelo anônimo que processou mais de 200 trilhões de tokens, era uma versão inicial.
Veja o que mudou entre a prévia e o lançamento geral:
| Prévia (27 set.) | Lançamento geral (19 out.) | |
|---|---|---|
| ID do modelo | MiniMax-M3.1-Flash-Preview | MiniMax-M3.1-Flash |
| Onde | Apenas MiniMax Code e Token Plan | API, M Plan e MiniMax Code |
| Preço por token | Nenhum publicado | $0.15 entrada / $0.60 saída / $0.015 em cache |
| Afirmação de velocidade | Nenhuma | 200+ tokens por segundo, P50 170+ |
| Benchmarks | Nenhum | Tabela de 15 linhas contra seis rivais |
| Pesos | Nenhum | Prometidos para 23 de outubro |
Três coisas continuaram iguais e ainda definem como usá-lo. A janela de contexto é de 1.000.000 de tokens. A entrada pode ser texto, imagens ou vídeo. E o raciocínio está sempre ligado: você define effort de low a max (padrão max), e enviar effort: "none" retorna um erro 400, segundo a documentação de geração de texto.
Mais um detalhe importa para quem planeja hospedar por conta própria. O nome "Flash" não significa pequeno. A página do Code da MiniMax lista uma arquitetura de mistura de especialistas com 428B de parâmetros no total e cerca de 23B ativos, a mesma classe de tamanho do MiniMax M3. Um comentarista do Reddit resumiu bem:
"yeah fair point, the "flash" name is kinda misleading. same 428b / 23b active as m3, so if you could run m3 you can run this."

Onde ele vence?
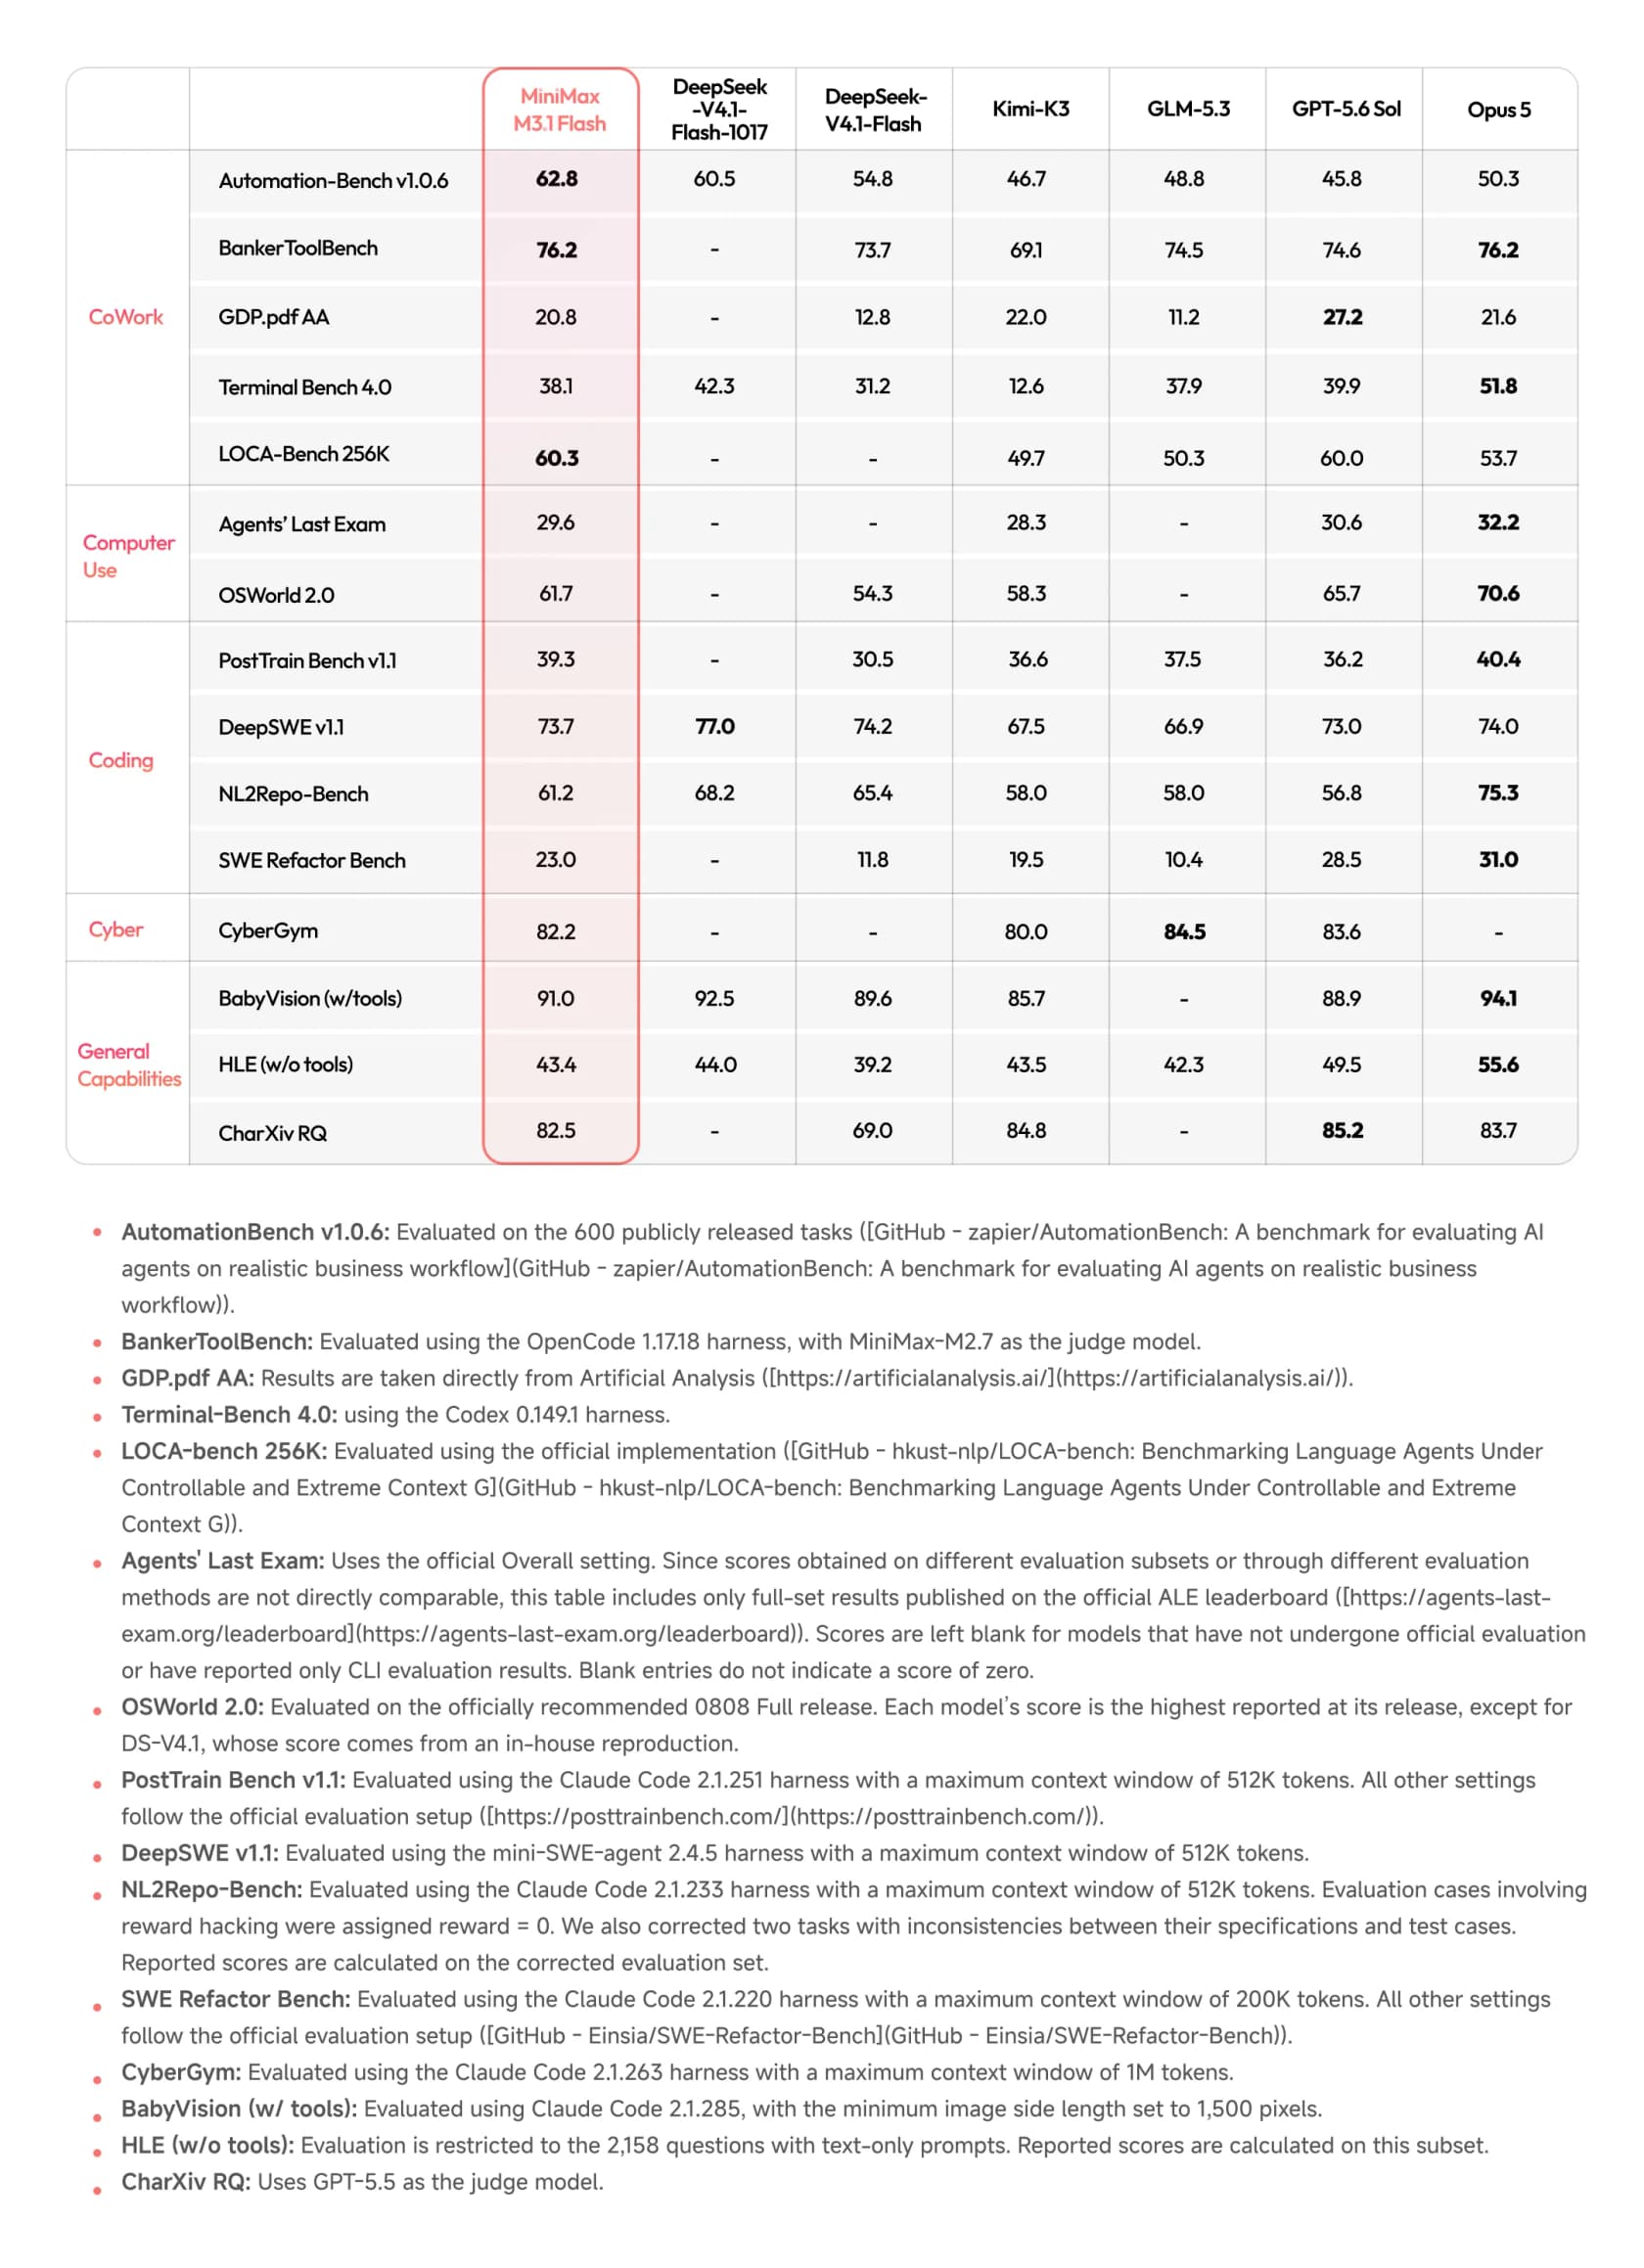
As vitórias se concentram em trabalho de agentes estilo escritório: tarefas de várias etapas em software de negócios, chamadas de ferramentas encadeadas e documentos longos. A tabela da própria MiniMax é a fonte aqui, então leia essas pontuações como relatadas pelo fornecedor.
- Automation-Bench
62.8, a maior pontuação da tabela, à frente do DeepSeek 1017 (60.5), do Claude Opus 5 (50.3) e do GPT-5.6 Sol (45.8). A MiniMax o descreve como fluxos de trabalho reais em vendas, marketing, operações, atendimento ao cliente, finanças e RH. - BankerToolBench
76.2, empate com o Opus 5 e à frente do Kimi K3 (69.1). - LOCA-Bench 256K
60.3, a melhor pontuação de agente de contexto longo da tabela. - CyberGym
82.2, atrás apenas do GLM-5.3 (84.5) e do GPT-5.6 Sol (83.6).
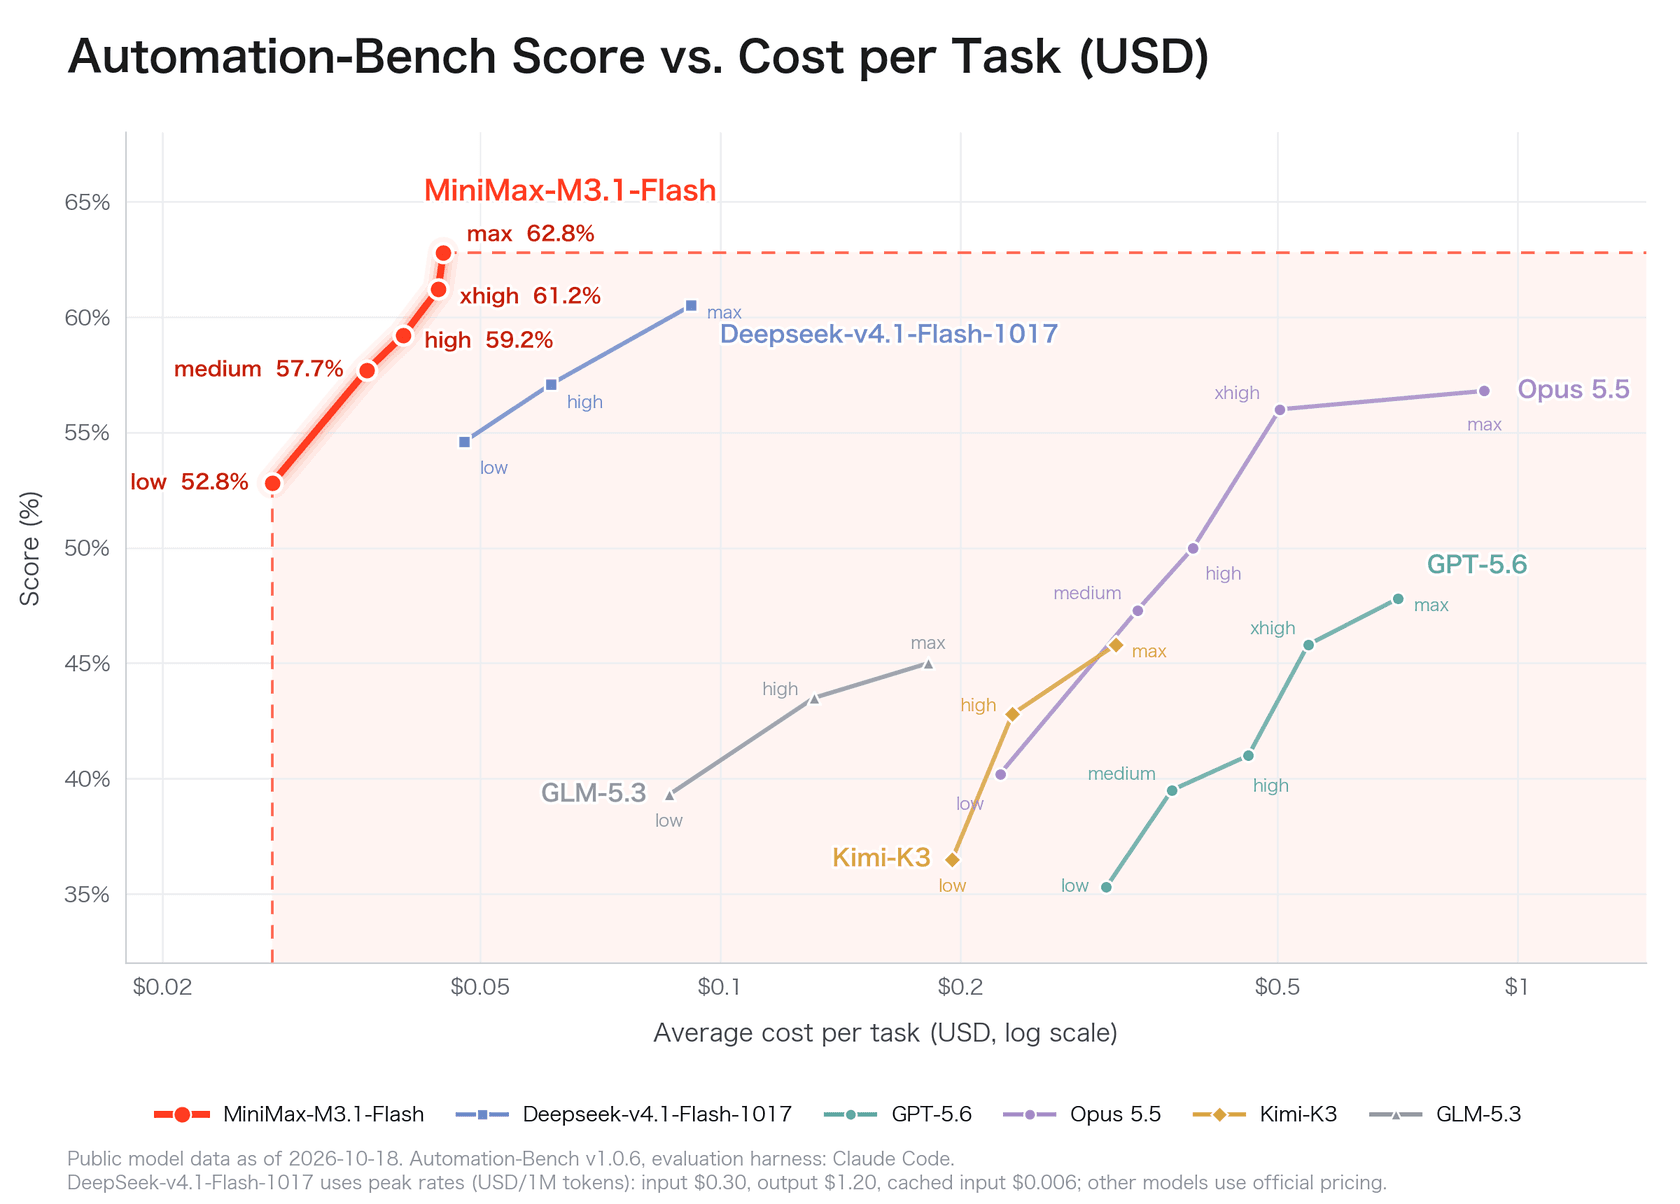
Os gráficos de custo são onde o M3.1 Flash aparece melhor. No gráfico de Automation-Bench da MiniMax, o M3.1 Flash com esforço max chega a 62.8% por cerca de $0.045 por tarefa, e até o esforço low marca 52.8%, acima de GPT-5.6, Kimi K3 e GLM-5.3 nas suas melhores configurações. No gráfico do Agents' Last Exam, atinge 29.6% por $111 no total, o ponto mais barato da fronteira.
A velocidade é a outra vitória. A MiniMax diz que a saída chega a 200+ tokens por segundo, com mediana de 170+, quase três vezes mais rápido que o M3. Os primeiros usuários confirmaram a sensação, se não o número exato:
"first impression of minimax m3.1 flash been using model for the last few hours and it's a huge step up from m3. pretty good for flash model"
Onde ele fica atrás do DeepSeek V4.1 Flash 1017?
Esta é a seção que a maior parte da cobertura do lançamento pulou. O DeepSeek V4.1 Flash 1017 tem pontuação em seis das linhas da MiniMax e vence o M3.1 Flash em cinco delas:
| Benchmark (tabela da MiniMax) | M3.1 Flash | DeepSeek V4.1 Flash 1017 | Vencedor |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | M3.1 Flash |
| Terminal-Bench 4.0 | 38.1 | 42.3 | DeepSeek |
| DeepSWE v1.1 | 73.7 | 77.0 | DeepSeek |
| NL2Repo-Bench | 61.2 | 68.2 | DeepSeek |
| BabyVision (with tools) | 91.0 | 92.5 | DeepSeek |
| HLE (no tools) | 43.4 | 44.0 | DeepSeek |
Três dessas derrotas são testes de programação, e por isso dou 3 em código. No gráfico de custo do DeepSWE da própria MiniMax, a linha do DeepSeek 1017 fica mais alta e mais à esquerda: cerca de 77% por aproximadamente $0.20 por tarefa em max, contra 73.7% por aproximadamente $0.27 do M3.1 Flash. A visão geral do DeepSeek 1017 explica por que esse modelo ficou tão barato por tarefa.
Depois há a nota de rodapé. O gráfico de Automation-Bench precifica o DeepSeek 1017 em tarifas de pico, $0.30 de entrada e $1.20 de saída. A página de preços do DeepSeek cobra isso apenas em dias úteis, das 01:00 às 04:00 e das 06:00 às 10:00 UTC. Todas as outras horas são fora de pico, a metade do preço, $0.15/$0.60, exatamente a mesma tarifa do M3.1 Flash. Minha conta: com tarifas fora de pico, o ponto de esforço máximo do DeepSeek passa de cerca de $0.09 para cerca de $0.045 por tarefa, bem onde está o M3.1 Flash, com pontuação apenas 2,3 pontos menor.
Leitores do Hacker News notaram o padrão em poucas horas:
"Not as strong as DeepSeek V4.1 Flash 1017 on deepswe so it's already dead to me."

É mais duro do que eu seria. O M3.1 Flash ainda vence em automação de agentes e cobra menos sem tirar nada. Mas não é a história limpa de "mais barato e melhor" que a publicação de lançamento conta.
Quanto ele realmente custa?
O preço é simples, o que eu aprecio. O M3.1 Flash tem uma única tarifa em toda a janela de 1M, enquanto o MiniMax M3 dobra acima de 512K tokens de entrada.
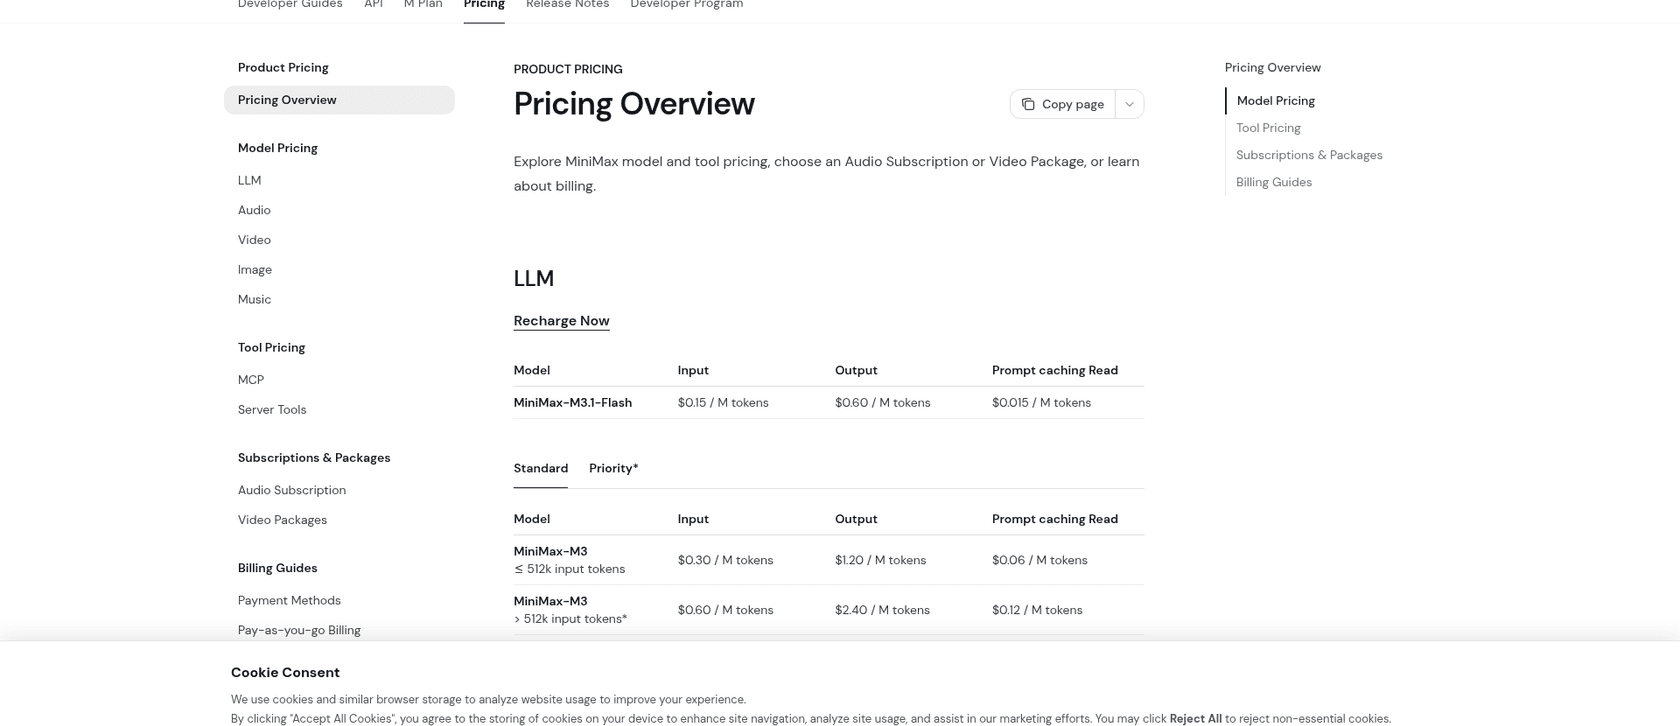
| Modelo (por 1M de tokens) | Entrada | Entrada em cache | Saída | Fonte |
|---|---|---|---|---|
| MiniMax M3.1 Flash | $0.15 | $0.015 | $0.60 | MiniMax |
| MiniMax M3 (até 512K) | $0.30 | $0.06 | $1.20 | MiniMax |
| MiniMax M3 (acima de 512K) | $0.60 | $0.12 | $2.40 | MiniMax |
| DeepSeek V4.1 Flash, fora de pico | $0.15 | $0.003 | $0.60 | DeepSeek |
| DeepSeek V4.1 Flash, pico | $0.30 | $0.006 | $1.20 | DeepSeek |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI |
| Gemini 3.8 Flash (até 31 dez. 2026) | $0.75 | $0.075 | $3.75 |
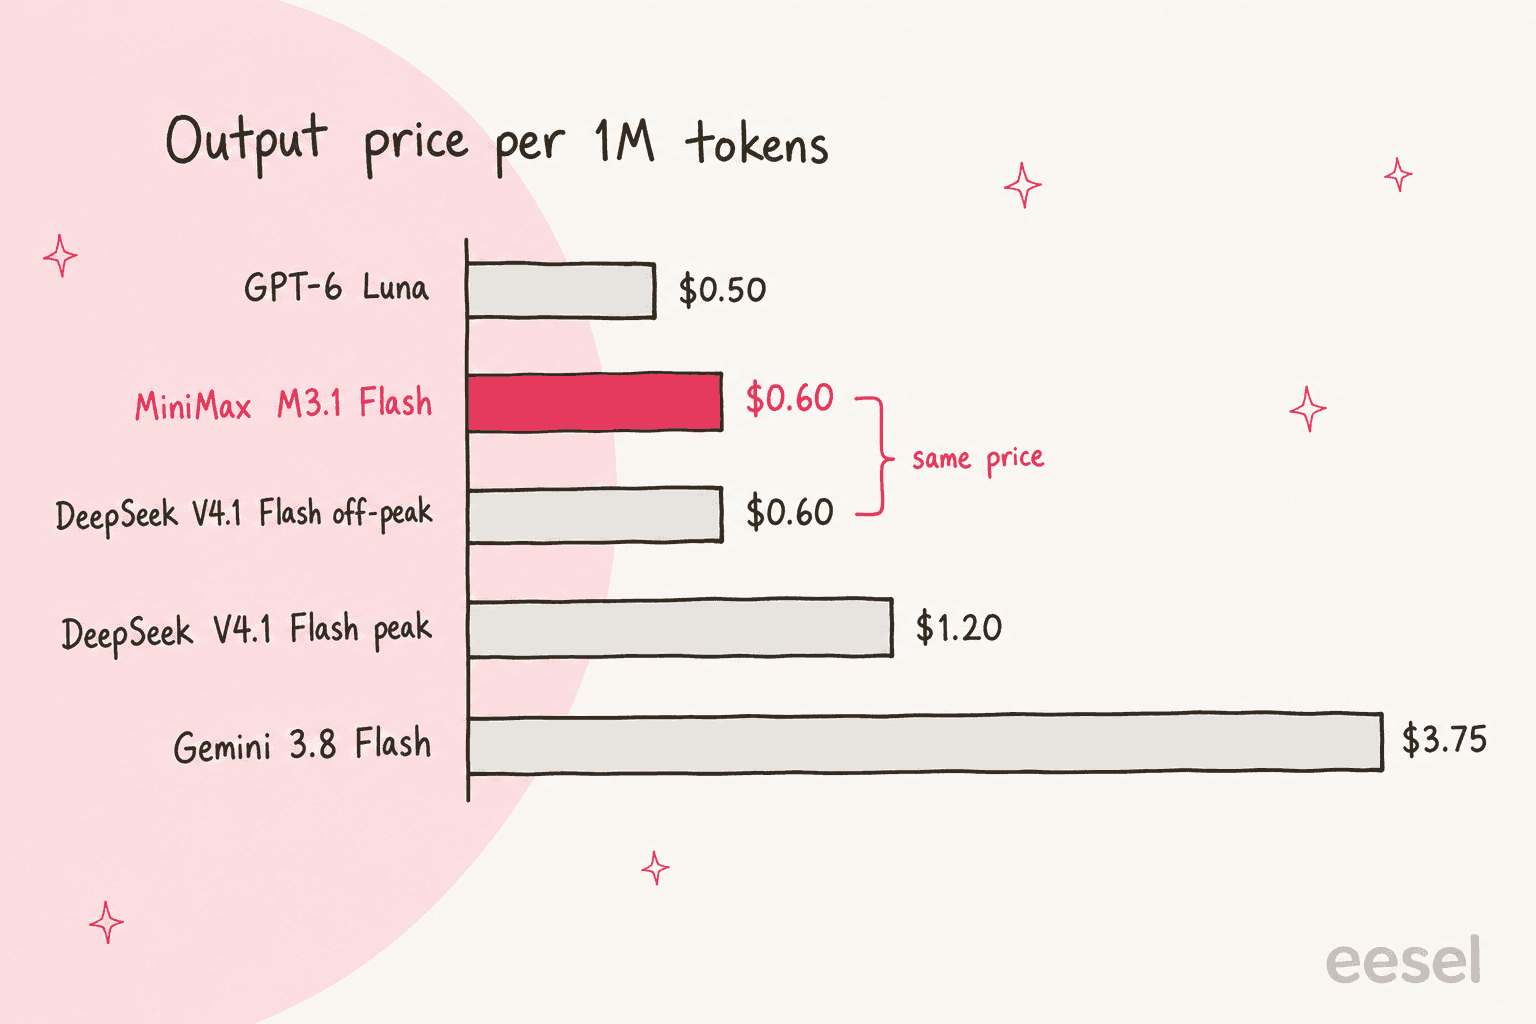
Duas coisas se destacam. Primeiro, a entrada em cache é onde o DeepSeek ainda ganha: $0.003 fora de pico contra os $0.015 do M3.1 Flash, cinco vezes mais barato. Ciclos de agentes relêem o mesmo contexto várias vezes, então uma carga que usa muito cache pode inclinar a conta para o DeepSeek mesmo com o mesmo preço de tabela. Segundo, o GPT-6 Luna é mais barato por token do que ambos, e o detalhamento de preços do Luna mostra também a sua tarifa de cache. No gráfico do Agents' Last Exam da MiniMax, porém, os $111 no total do M3.1 Flash ficam bem abaixo do ponto do GPT-5.6 Luna, então o preço por token sozinho não decide.
Se você prefere pagar uma assinatura, o M Plan reúne o M3.1 Flash com o MiniMax Code e outros modelos. A cobrança anual é de $220, $550 ou $1,320 por ano nos níveis Go, Explore e Build, que dão 1x, 3x e 7,5x o uso do Go, reiniciados em janelas de 5 horas e semanais. O próprio FAQ do M Plan da MiniMax diz que o plano é projetado para uso individual e interativo e recomenda pagamento por uso para produção. Leve isso a sério: a assinatura é para suas próprias sessões de programação, não para um produto que atende clientes.
O que usuários reais dizem depois de um dia?
As primeiras reações se dividem com clareza. Os benchmarks impressionaram. Os testadores na prática foram mais mistos, e a reclamação mais comum é sobre o comportamento em esforço alto, que é o padrão.
"I might get downvoted for this, but this model was WAY too lazy, even at Max effort"
O mesmo tema veio de um testador no X que, fora isso, gostou:
"hallucinates alot on xhigh or max and starts doing stuff i didn't ask for, and cuz of that model ends up being slow despite giving 100+ tok/s"
No Hacker News, um usuário que havia testado a versão furtiva apontou uma diferença entre as pontuações e os resultados do dia a dia:
"The deepswe and terminalbench4.0 scores don't seem to jive with what many opencode users' experience has been of this model while it was being tested as "space bunny"."
A MiniMax diz que o Space Bunny era um checkpoint anterior, então parte disso pode já estar corrigida. Nem todo relato foi negativo. Um desenvolvedor que usou a prévia dentro do MiniMax Code gostou de como ela lidava com a incerteza:
"it found the real bug instead of patching around it, refused to pad weak results, wrote its own tests and got to 12/12 green, and said UNVERIFIED when it couldn't confirm something"
O comentário mais justo que li foi sobre tempo, não sobre tokens. Modelos baratos que levam o dobro do tempo são difíceis de vender no trabalho:
"For a hobby project I do not mind that a cheaper model takes twice as long but at work it's hard to justify using a "cheaper" model if the time per task is so much higher than the frontier models."
Quais são os prós e os contras?
Prós
- Preço fixo de
$0.15/$0.60em 1M de tokens, sem faixa de contexto longo. - Melhor pontuação de Automation-Bench na tabela da MiniMax e empate com o Opus 5 no BankerToolBench.
- 200+ tokens por segundo declarados, cerca de três vezes o M3.
- Funciona com clientes no estilo Anthropic e OpenAI, então Claude Code, Codex, Cursor e OpenClaw podem apontar para ele.
- Pesos abertos prometidos para 23 de outubro.
Contras
- Fica atrás do DeepSeek V4.1 Flash 1017 em cinco de seis benchmarks compartilhados, incluindo todos os testes de programação.
- A entrada em cache custa cinco vezes a tarifa fora de pico do DeepSeek.
- O raciocínio não pode ser desligado, e o padrão é
max, onde os testadores relatam preguiça e desvio. - 428B de parâmetros no total, então o uso local exige uma máquina grande.
- O M Plan é para uso pessoal, então o tráfego de produção vai em chaves de pagamento por uso.
Qual modelo barato combina com o seu trabalho?
Escolha o trabalho que você quer executar. O widget mostra o modelo com o qual eu começaria e por quê.
Quem deve usá-lo e quem deve deixar passar?
Use-o se você roda ciclos de agentes sobre ferramentas de negócios, planilhas ou documentos longos e se importa com o custo por tarefa. Os resultados de Automation-Bench e BankerToolBench apontam direto para esse trabalho, e o preço fixo torna os contextos longos indolores. Também serve para desenvolvedores que já estão no MiniMax Code e querem um modelo padrão rápido.
Deixe passar, por enquanto, se o seu trabalho principal é programação pesada em repositórios. O DeepSeek V4.1 Flash 1017 pontua mais alto em todas as linhas de programação da tabela pelo mesmo preço fora de pico, e o Qwen 3.8 Flash Next aparece com frequência entre quem hospeda por conta própria.
Se você quer um modelo de fronteira e pode pagar por ele, o GPT-6 Sol e o Claude Opus 5.5 ainda estão um nível acima.
Espere se você quer rodá-lo por conta própria. Os pesos saem em 23 de outubro, e o tamanho exige uma máquina grande com várias GPUs ou um computador com muita memória unificada.
O que isso significa para uma equipe de suporte?
O AutomationBench lista o atendimento ao cliente entre seus fluxos de trabalho, então é tentador ler uma pontuação alta como "pronto para a minha fila". Eu não leria. Um benchmark verifica se o modelo concluiu uma tarefa roteirizada. Sua fila pergunta se a resposta estava certa para este cliente, sob a sua política, com as suas regras de reembolso, e se o modelo soube deixar um ticket em paz.
Se você construir seu próprio fluxo de suporte sobre o M3.1 Flash, isto é o que continua com você:
- O pipeline de conhecimento que o alimenta com sua central de ajuda e tickets antigos.
- A conexão com o helpdesk que lê tickets e escreve respostas.
- As regras de quando repassar, o núcleo da deflexão de nível 1.
- Testes com histórico real, que é como você pega alucinações no suporte.
Nada disso é um problema do modelo, e por isso um modelo mais barato reduz uma linha da conta, não o projeto. O guia do custo de IA no atendimento ao cliente cobre o resto, e o comparativo custo de agente de IA contra humano o coloca em contexto.
Como a eesel se encaixa ao lado do M3.1 Flash?
O MiniMax M3.1 Flash é infraestrutura. A eesel é o funcionário. A eesel é uma plataforma de colegas de IA em que você contrata colegas prontos para trabalhar em tarefas específicas, e no suporte esse é o colega de IA para helpdesk. Ele entra na fila que você já opera, como Zendesk ou Freshdesk, aprende com sua central de ajuda e tickets antigos e reproduz tickets históricos para que você veja as respostas antes de um cliente.
Veja como isso funciona em escala. A smava, uma plataforma berlinense de comparação de empréstimos, roda três agentes da eesel em um único Zendesk para duas marcas: um categoriza cada ticket, um redige a resposta a partir de cerca de 820 macros e artigos da central de ajuda, e um por marca prepara a resposta pronta para o cliente. Entre 8 de agosto e 8 de setembro de 2026, foram cerca de 27,000 tickets, com pessoas aprovando os rascunhos. A SE Ranking roda um agente separado para cada um dos seus três produtos no chat ao vivo do Zendesk, cerca de 4,650 conversas em um mês, com reembolsos e casos de nível 2 repassados à equipe com os dados do cliente anexados.

Se você é do tipo que lê uma análise de modelo, provavelmente vai querer o terminal. A CLI da eesel (@eesel/cli) controla o mesmo colega que você vê no painel. eesel integrations connect zendesk conecta um helpdesk, eesel files upload adiciona conhecimento, eesel instructions edita as regras permanentes, eesel approvals lista as ações aguardando uma pessoa e eesel activity mostra o que o agente fez. Todo comando imprime JSON, então o Claude Code ou o Cursor podem executar a configuração para você, e cada workspace também funciona como servidor MCP. O guia da CLI de agentes mostra o padrão.
Para comparar opções de suporte lado a lado, comece pela lista dos melhores agentes de atendimento ao cliente ou pelo argumento mais amplo a favor dos colegas de IA.
Experimente a eesel
Use o M3.1 Flash onde ele brilha: ciclos de agentes baratos e rápidos que você pode conferir. Se o que você precisa é de IA respondendo tickets no seu helpdesk na semana que vem, o colega de IA para helpdesk da eesel se conecta à ferramenta que você já usa, aprende com seus tickets antigos e mostra como teria respondido a eles antes que qualquer cliente veja uma resposta. É assim que a smava consegue 15,300 rascunhos por mês sem abrir mão do controle. Experimente a eesel grátis e rode primeiro no seu próprio histórico de tickets, ou veja os preços da eesel antes de começar.