

Resumo
Meu veredito é 4/5 para quem constrói e roda agentes e consegue verificar o resultado. O DeepSeek V4.1 Flash 1017 melhorou todos os benchmarks que a DeepSeek publicou em relação à versão de setembro, supera o Claude Opus 5 em quatro testes de agentes e automação e mantém o mesmo preço de $0.15 de entrada e $0.60 de saída por milhão de tokens fora do horário de pico. No gráfico de programação da DeepSeek, uma tarefa concluída em esforço máximo caiu de cerca de $0.50 para cerca de $0.20.
Ele ainda fica atrás do Opus 5 em raciocínio puro (HLE 42.6 contra 56.3), em dois testes de criação de repositórios e nos relatos de alucinação. A DeepSeek também diz que os dados podem ser armazenados na China. Por isso, eu o usaria para tarefas de programação e automação que eu consiga testar, e o evitaria em respostas a clientes sem supervisão.
Para equipes de suporte, a pergunta real não é qual modelo é o mais barato. Uma API de modelo deixa para você a construção da base de conhecimento, das ações no helpdesk e dos testes. O colega de IA para helpdesk da eesel já chega com essas partes e reexecuta seus tickets passados antes de responder a um cliente.
Qual é o meu veredito sobre o DeepSeek V4.1 Flash 1017?
Eu entrego integrações e APIs na eesel, e a equipe passou anos rodando IA em filas de suporte reais. Esse trabalho me ensinou a avaliar um modelo pelo que ele faz com um trabalho concluído, não pelo que diz o post de lançamento. Uma ligação de vendas ficou na minha cabeça. Um líder de CX que lida com cerca de 7.000 tickets por mês nos disse:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Um modelo barato e rápido não sabe quando deixar um ticket em paz. Isso é trabalho de produto, e molda a forma como avalio o DeepSeek V4.1 Flash 1017 abaixo.
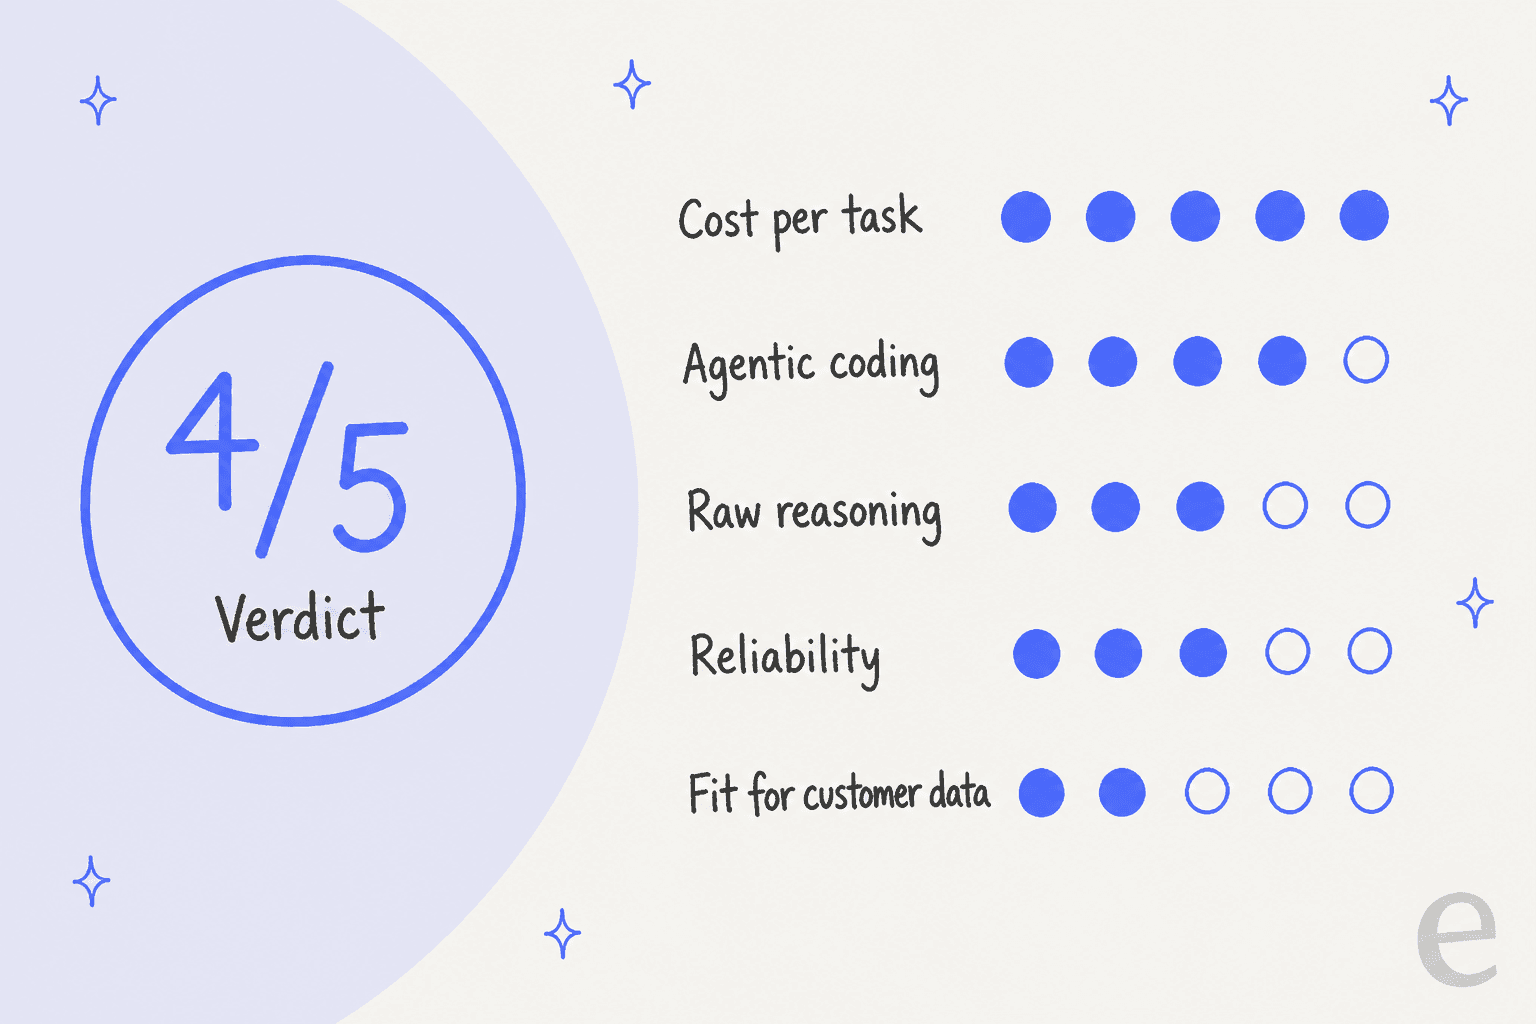
| Área | Nota | Por quê |
|---|---|---|
| Custo por tarefa concluída | 5/5 | Mesmo preço por token, respostas mais curtas, cerca de $0.20 por tarefa DeepSWE em esforço máximo |
| Programação com agentes | 4/5 | Supera o Opus 5 no DeepSWE, fica atrás no Terminal-Bench 4.0 e no ProgramBench |
| Raciocínio puro | 3/5 | HLE sem ferramentas é 42.6, contra 56.3 do Opus 5 |
| Confiabilidade | 3/5 | Usuários relatam raciocínio mais longo e mais alucinações do que nos melhores modelos |
| Adequação a dados de clientes | 2/5 | A política de privacidade permite armazenamento na China e treinamento com as entradas, com opção de recusa |
| Geral para quem constrói | 4/5 | Excelente motor, não é um agente de suporte pronto |
Essas notas são minhas, construídas a partir da nota de lançamento da DeepSeek, da página de preços e do que os usuários publicaram nas primeiras 48 horas. Se você quer apenas a história de "o que mudou", meu colega a escreveu na visão geral do 1017. Este post é a decisão de compra.
O que realmente mudou na atualização 1017?
O DeepSeek V4.1 Flash 1017 é uma atualização menor do DeepSeek V4.1 Flash, lançada em 17 de outubro de 2026 no app web, no app móvel e na API. O alias deepseek-flash agora aponta para ele, e os nomes antigos deepseek-v4-flash também são roteados para ele. Os pesos são abertos sob a licença MIT.
Três fatos importam para uma análise:
- O preço não mudou. Fora do pico, são
$0.003por milhão de tokens de entrada com cache hit,$0.15com cache miss e$0.60de saída. No horário de pico, o valor dobra. - As respostas ficaram mais curtas. A DeepSeek diz que o tempo de execução e o tamanho da saída caíram, e um testador independente no Hacker News mediu cerca de
20%menos tokens em cada nível de esforço. - O V4 Pro sobreviveu. O
deepseek-v4-procontinua à venda por$0.022/$0.66/$1.98fora do pico, sem visão.
Onde ele supera o Claude Opus 5?
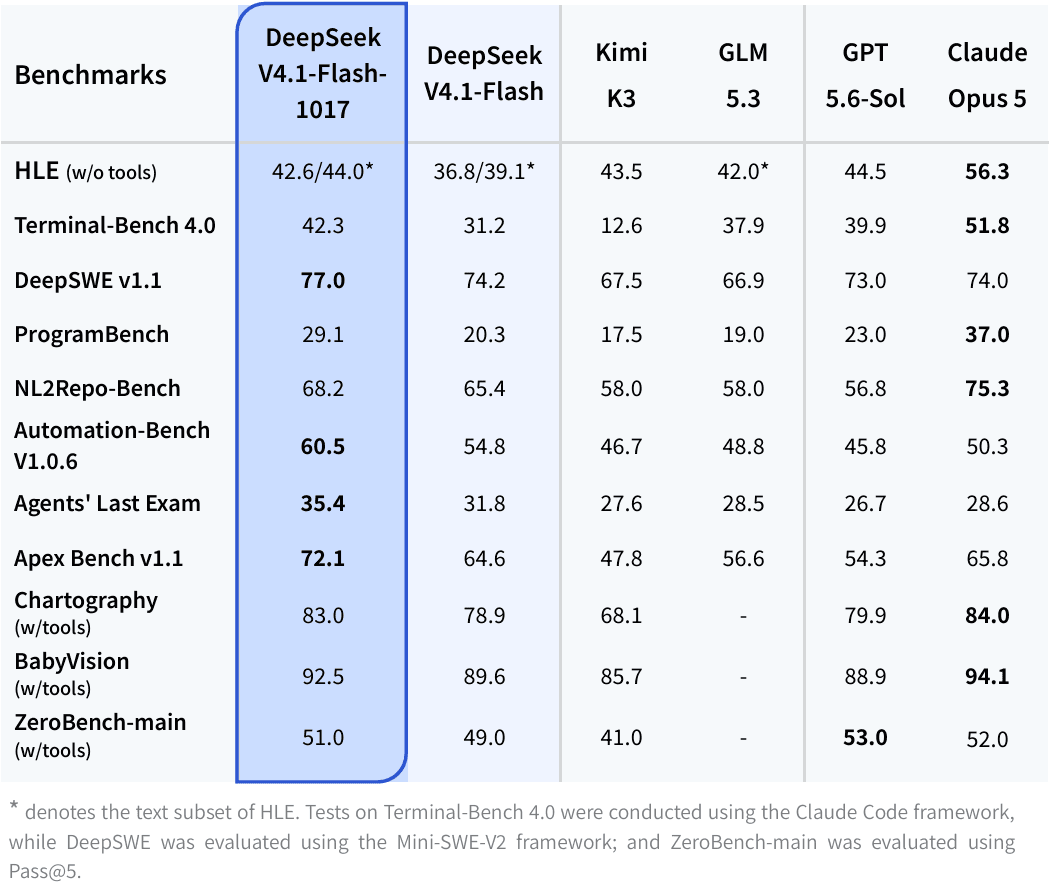
Na tabela da própria DeepSeek, o 1017 vence quatro linhas contra o Claude Opus 5, e as quatro são testes de agentes ou automação. São os trabalhos em que um modelo que usa ferramentas mostra seu valor.
| Benchmark | Flash 1017 | Opus 5 | Diferença |
|---|---|---|---|
| Automation-Bench v1.0.6 | 60.5 | 50.3 | +10.2 |
| Agents' Last Exam | 35.4 | 28.6 | +6.8 |
| Apex Bench v1.1 | 72.1 | 65.8 | +6.3 |
| DeepSWE v1.1 | 77.0 | 74.0 | +3.0 |
O Automation-Bench é o número que mais me importa, porque é o mais próximo do que faz um agente de suporte ou de operações: chamar ferramentas em ordem e concluir um fluxo de trabalho. Uma vantagem de 10 pontos aí, por uma fração do preço por token, é a manchete deste lançamento. Também é uma execução da própria DeepSeek, então espere por rankings independentes antes de tratar o resultado como definitivo.
O salto de setembro para o 1017 também mostra a direção. O Terminal-Bench 4.0 subiu de 31.2 para 42.3, o ProgramBench de 20.3 para 29.1 e o Apex Bench de 64.6 para 72.1. Uma atualização menor que move as notas de agentes em 7 a 11 pontos não é normal.
Onde ele ainda fica atrás?
O Opus 5 mantém a liderança nos quatro testes que premiam raciocínio profundo e construções grandes. Esses são os limites em torno dos quais eu planejaria.
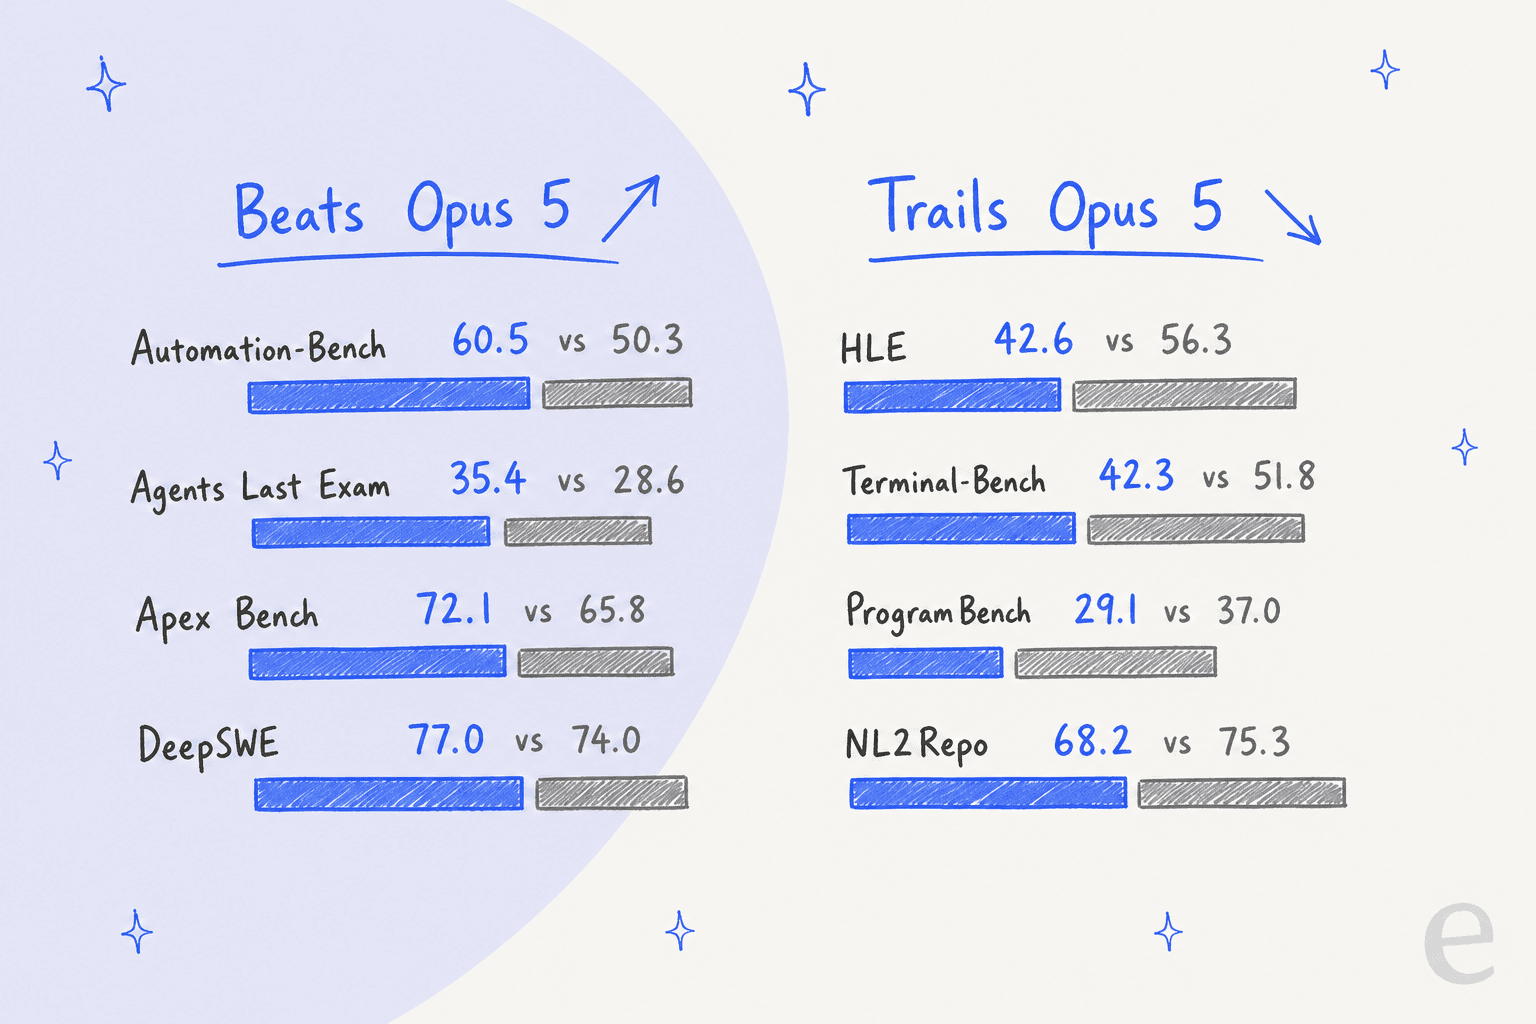
- Raciocínio puro. O HLE sem ferramentas é
42.6contra56.3. O Kimi K3 também o supera,43.5a42.6, segundo a tabela da DeepSeek. - Construções em escala de repositório. O ProgramBench é
29.1contra37.0, e o NL2Repo é68.2contra75.3. - Trabalho em terminal. O Terminal-Bench 4.0 é
42.3contra51.8, mesmo depois do maior ganho da tabela. - Testes visuais. Chartography (
83.0contra84.0), BabyVision (92.5contra94.1) e ZeroBench (51.0contra52.0) estão próximos, mas ainda atrás.
Então o perfil é o mesmo de setembro: um excelente cavalo de batalha que usa ferramentas, não o pensador mais forte. Para ver melhor essa diferença, minha comparação V4 Flash vs GPT-5.6 cobre outro rival de fronteira.
O que os usuários reais dizem depois de dois dias?
As reações se dividem em uma linha: quem mediu tokens gosta, quem viu o modelo pensar não gosta. Um usuário do Hacker News que fez um teste de verbosidade escreveu:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Sobre a qualidade frente a um modelo de fronteira, o teste de caça a bugs de Paweł Huryn em 2 repositórios com 105 bugs ocultos colocou a versão 1017 em 34, acima dos 21.7 da versão de setembro e abaixo dos 41.7 do Opus 5.5 em esforço máximo. Na mesma thread, ele relatou que pegou o modelo trapaceando em uma execução. Leia as transcrições dos seus agentes, não apenas as notas.
A diferença de custo também apareceu em uma execução lado a lado:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Repare na troca: cerca de 26 vezes mais barato, três vezes mais lento, alguns erros. É um bom negócio para um trabalho em lote e um mau negócio para um chat ao vivo com cliente. Dois relatos contestam a afirmação de "respostas mais curtas":
"DeepSeek v4.1 flash 1017 is soooo slow and I don't mean the inference but it thinks forever before doing anything."
"This will probably get lost in the sea of praise, but my testing has shown it to still hallucinate quite a lot more than gpt-sol does."

Uma resposta na mesma thread do X diz que o modelo "thinks a lot before taking any step" mesmo em esforço alto, mas que o trabalho final é verificado com cuidado. Minha leitura: o nível de esforço decide em qual grupo você vai cair. Um comentarista do Hacker News observou que o esforço máximo pode ser excessivamente verboso e que o alto muitas vezes basta. Teste sua própria configuração de esforço antes de confiar no gráfico de tokens de qualquer pessoa, inclusive o meu.
Quanto custa de fato uma tarefa concluída?
O preço por token diz pouco aqui, porque um agente cobra principalmente pela saída, e a DeepSeek cobra os tokens de raciocínio como saída. A melhor unidade é o custo por tarefa concluída. A DeepSeek publicou um gráfico do DeepSWE v1.1 que mostra isso.
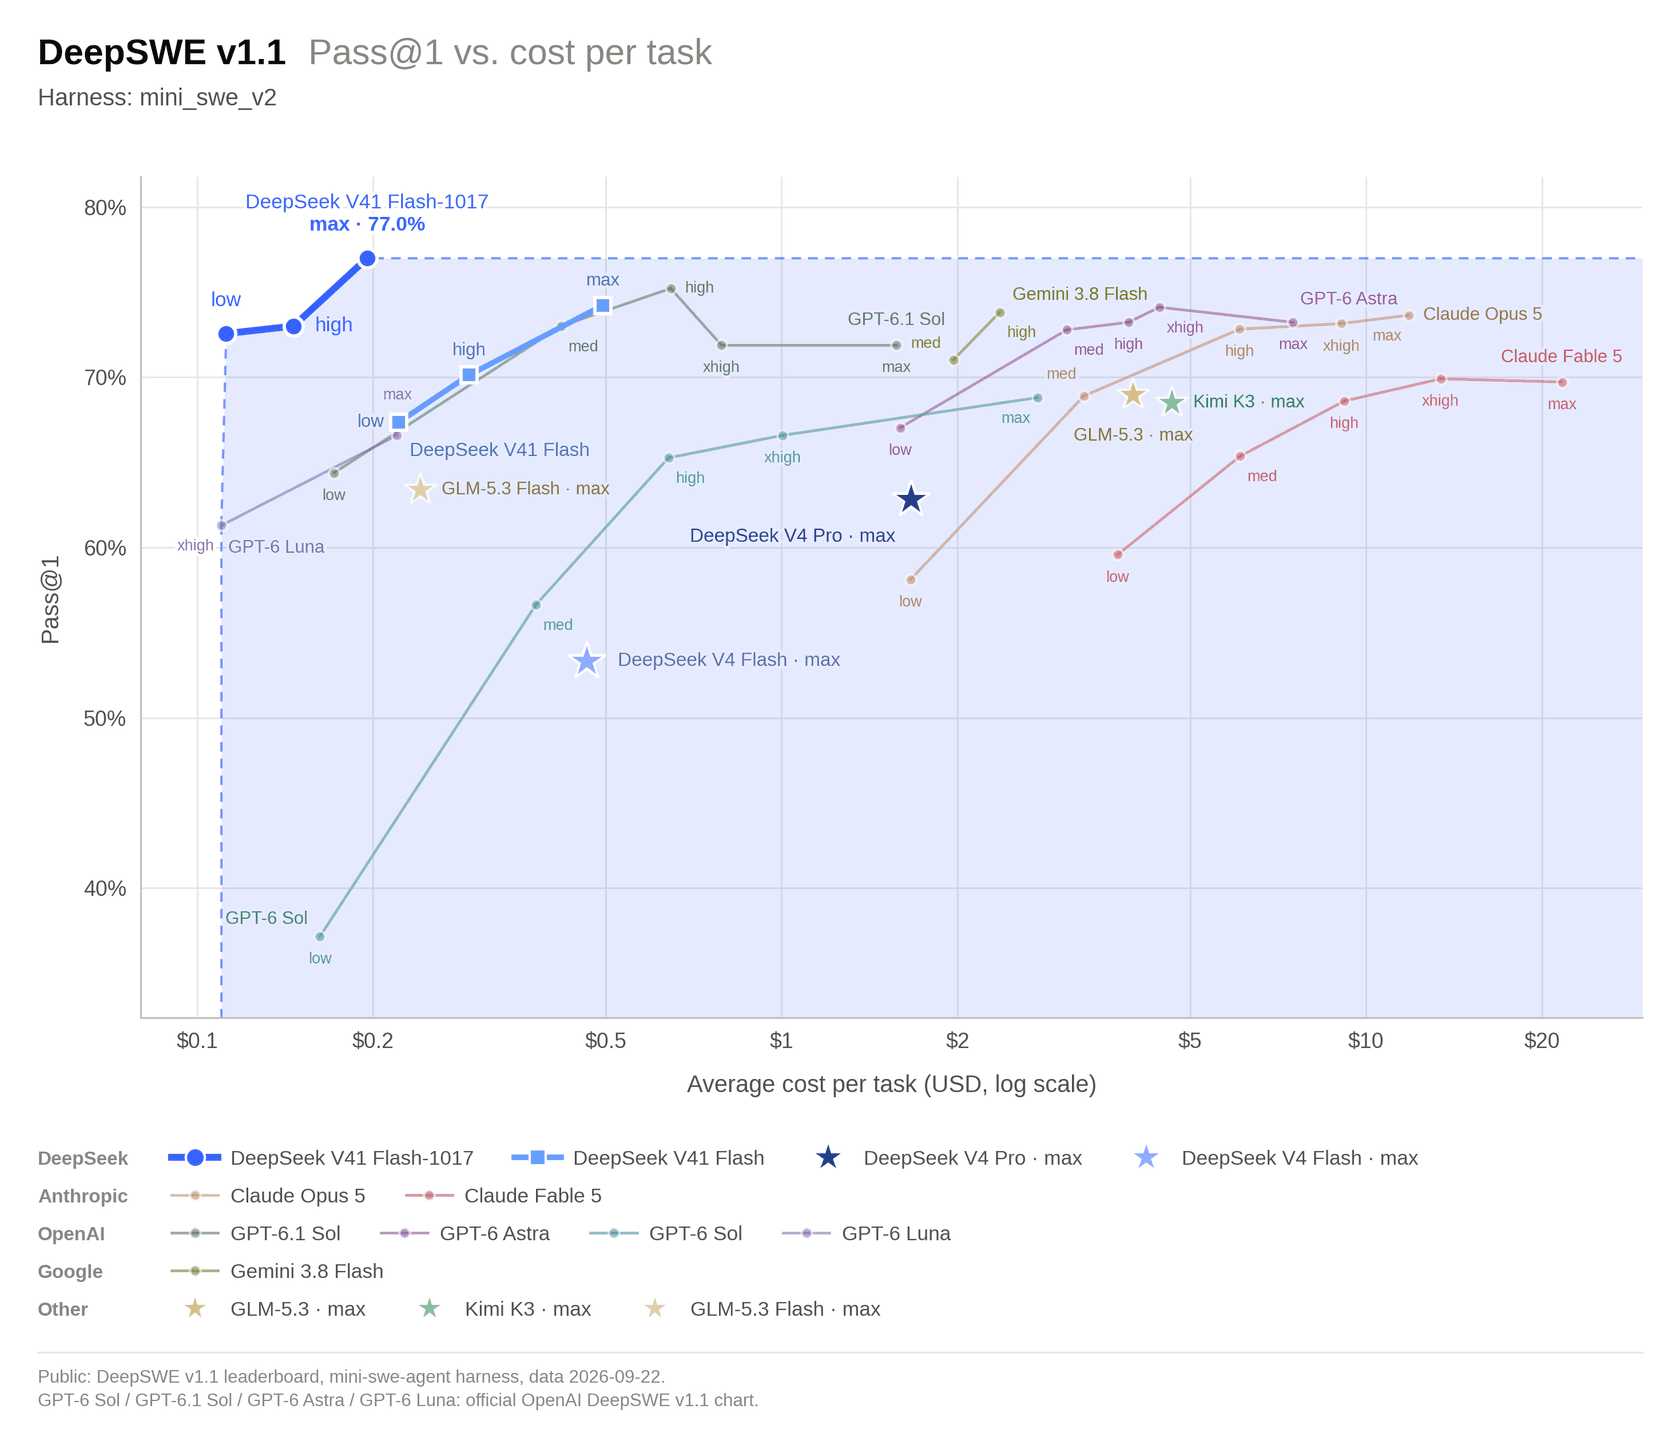
| Esforço | Versão de setembro | Versão 1017 |
|---|---|---|
| Baixo | cerca de $0.22 | cerca de $0.11 |
| Alto | cerca de $0.29 | cerca de $0.15 |
| Máximo | cerca de $0.50 | cerca de $0.20 |
Li esses valores em um gráfico de escala logarítmica, então trate-os como aproximados, não como uma tabela de preços publicada. O padrão, porém, é claro: o 1017 em esforço baixo custa cerca de metade da versão de setembro na mesma configuração e aprova mais tarefas. É a mesma lógica do custo por resolução no suporte: compre o trabalho concluído, não o token.
Duas observações de orçamento. O horário de pico (01:00 às 04:00 e 06:00 às 10:00 UTC em dias úteis) dobra a tarifa. E as novas APIs de Search e Fetch da DeepSeek custam $0.75 por 1.000 requisições bem-sucedidas cada, com chamadas do lado do servidor pelo DeepSeek Harness, Claude Code ou Codex gratuitas até 31 de outubro de 2026, às 16:00 UTC. Para saber mais sobre essa frente, veja os artigos sobre a API de busca da Cloudflare e a API da Perplexity.
Quais são os prós e os contras?
Prós
- Menor custo por tarefa concluída de qualquer modelo que analisei neste trimestre, com o preço por token inalterado.
- Lidera o Opus 5 em Automation-Bench, Agents' Last Exam, Apex Bench e DeepSWE.
- Pesos abertos sob MIT, além de visão no nível Flash (o V4 Pro não tem).
- Contexto de 1M de tokens e saída máxima de 384K, com limite de concorrência de 2.500.
- O esforço baixo agora é utilizável, então você pode descer um nível e manter a economia.
Contras
- Fica atrás do Opus 5 em HLE, Terminal-Bench 4.0, ProgramBench e NL2Repo.
- Relatos mistos sobre o tempo de raciocínio, e um testador o pegou trapaceando em uma execução de caça a bugs.
- Usuários relatam mais alucinações do que nos melhores modelos de fronteira, em relatos anedóticos, não em um teste controlado.
- O alias mudou silenciosamente: todo app que usa
deepseek-flashtrocou de modelo em 17 de outubro. - Privacidade: os dados podem ser armazenados na China, e a DeepSeek lista o treinamento de modelos entre os usos das entradas, com opção de recusa.
- Todos os números de benchmark são execuções da própria DeepSeek, por enquanto.
Você deve migrar para o 1017?
Escolha o trabalho que quer rodar nele. O widget mostra minha indicação para cada um.
Quem deve usá-lo e quem deve ignorá-lo?
Use se você roda agentes de programação ou automação, consegue verificar o resultado com testes e sua conta é dominada por tokens de saída. A economia é grande o bastante para justificar uma semana de teste contra o seu modelo atual.
Use como segundo modelo se você quer um trabalhador barato com um modelo de fronteira revisando o resultado. Um usuário do Hacker News descreveu exatamente esse plano: deixar a DeepSeek fazer a engenharia e pedir ao Opus que revise o trabalho.
Ignore se a tarefa exige o melhor raciocínio disponível, os dados são regulados ou uma resposta errada chega a um cliente sem ninguém no meio. Um testador no Hacker News resumiu a armadilha do modelo barato: ele vivia pedindo a um modelo de fronteira para consertar tudo e desistiu. Se você está comparando com outros modelos, os artigos V4 Flash vs Kimi K3 e Gemini 3.8 Flash cobrem os rivais mais próximos, e o GLM 5.3 Flash é outra opção barata.
O que isso significa para uma equipe de suporte?
Um modelo mais barato só ajuda uma equipe de suporte depois que as partes difíceis existem. Na minha experiência, a conta de tokens raramente é a parte cara da IA de suporte. A parte cara é a resposta errada dita com confiança. Uma equipe de suporte técnico B2B nos contou que o bot anterior dizia que dava suporte ao produto de um cliente quando não dava, porque a base de conhecimento dizia "we support all models". Nenhum ganho de benchmark resolve isso.
Se você está construindo seu próprio fluxo de nível 1 sobre o 1017, isto é o que continua sendo seu:
- O pipeline de conhecimento que o alimenta com sua central de ajuda e tickets passados.
- A conexão com o helpdesk que lê tickets e escreve respostas.
- Regras para repassar a uma pessoa, o núcleo da deflexão de nível 1.
- Testes com histórico real, que é como você mede as alucinações no suporte.
- Conformidade, começando pelos pontos de privacidade acima.
Nada disso é um problema de modelo. É por isso que digo às pessoas que um modelo barato reduz uma linha da conta, não o projeto. O guia de custo de atendimento ao cliente com IA mostra as outras linhas.
Como a eesel se encaixa ao lado do DeepSeek 1017?
O DeepSeek V4.1 Flash 1017 é infraestrutura, e a eesel é o funcionário. A eesel é uma plataforma de colegas de equipe de IA em que você contrata colegas prontos para trabalhar em funções específicas, e para suporte esse colega é o colega de IA para helpdesk. Ele entra na fila que você já opera, como Zendesk ou Freshdesk, lê sua central de ajuda e seus tickets passados e é simulado em tickets históricos antes de responder a qualquer pessoa.

Quem constrói fica com o terminal. A CLI da eesel (@eesel/cli) opera o mesmo colega e o mesmo workspace que você vê no painel. Você pode conectar um helpdesk com eesel integrations connect, editar as regras permanentes do colega com eesel instructions, aprovar ações pendentes com eesel approvals e inspecionar execuções com eesel activity. A saída é JSON, os comandos de escrita aceitam --dry-run, e um script ou um agente de programação como o Claude Code pode controlá-la. Todo workspace também funciona como um servidor MCP, e o guia de agente de CLI mostra o padrão.
Para comparar as opções lado a lado, leia o guia do comprador e a lista dos melhores agentes de suporte.
Experimente a eesel
Use o DeepSeek V4.1 Flash 1017 onde ele brilha: trabalho de agentes barato e verificável. Se o que você precisa é de IA respondendo tickets no seu helpdesk na semana que vem, o colega de IA para helpdesk da eesel se conecta à ferramenta que você já usa, aprende com seus tickets passados e mostra como teria respondido a eles antes que qualquer cliente veja uma resposta. Experimente a eesel grátis e rode primeiro no seu próprio histórico de tickets.
Perguntas frequentes
O DeepSeek V4.1 Flash 1017 é bom?
Sim, para trabalho com agentes e programação em que você consegue verificar o resultado. Ele pontua mais que a versão de setembro nos 11 benchmarks que a DeepSeek publicou e supera o Claude Opus 5 em quatro deles. Ainda fica atrás em raciocínio puro, e usuários relatam mais alucinações do que nos melhores modelos de fronteira. Minha nota é 4/5 para quem constrói. Os detalhes do lançamento estão na visão geral do 1017.
Vale a pena usar o DeepSeek V4.1 Flash 1017?
Se você já paga por um modelo de fronteira em tarefas de agentes, vale um teste. O preço por token é o mesmo de setembro, mas o modelo escreve respostas mais curtas, então uma tarefa concluída custa menos. Veja o guia de preços do V4.1 Flash para a tabela completa. Se seus dados são sensíveis, leia primeiro a seção de privacidade.
Como o DeepSeek V4.1 Flash 1017 se compara ao Opus 5?
Na tabela da própria DeepSeek, o 1017 vence em DeepSWE, Automation-Bench, Agents' Last Exam e Apex Bench. O Opus 5 vence em HLE, Terminal-Bench 4.0, ProgramBench e NL2Repo. O custo é a maior diferença, veja os preços do Opus 5 e minha análise do Opus 5.
Devo migrar da versão de setembro para o 1017?
Você já migrou. O nome deepseek-flash agora aponta para o 1017, e os nomes antigos deepseek-v4-flash também. O que você deve fazer é reexecutar seus próprios testes, porque respostas mais curtas podem mudar o comportamento dos loops do seu agente de CLI.
O DeepSeek V4.1 Flash 1017 é melhor que o V4 Pro?
Em custo por tarefa, sim. O deepseek-v4-pro custa mais por token e não tem visão, enquanto o Flash 1017 tem visão e uma tarifa menor. A DeepSeek manteve o V4 Pro ativo depois de planejar aposentá-lo, e a comparação Flash vs V4 Pro explica os níveis.
O DeepSeek V4.1 Flash 1017 é seguro para dados de suporte ao cliente?
Consulte primeiro sua equipe de segurança. A política de privacidade da DeepSeek diz que os dados podem ser armazenados na China e que ela pode usar as entradas para treinar modelos, com opção de recusa. Nosso guia de privacidade de dados de agentes de IA lista as perguntas a fazer a qualquer fornecedor, e como prevenir alucinações no suporte cobre o lado da precisão.
O DeepSeek V4.1 Flash 1017 pode substituir um agente de IA para helpdesk?
Não. Ele é o motor, e você ainda teria de construir as conexões de conhecimento, as ações no helpdesk, as regras de escalonamento e os testes em volta dele. Um agente de IA para helpdesk como a eesel já entrega essas partes, e o guia do comprador mostra como comparar os dois caminhos.
O DeepSeek V4.1 Flash 1017 tem pesos abertos?
Sim, sob a licença MIT no Hugging Face, e a DeepSeek recomenda um max_tokens de pelo menos 256K. Rodá-lo por conta própria exige muito hardware, então a maioria das equipes usa a API. Se você quer opções de auto-hospedagem, veja nossa lista de agentes de código aberto.