

O Ripple-65B Preview é um modelo denso de 65B sob Apache 2.0 que se equipara, em programação com agentes, a modelos de pesos abertos de oito a quinze vezes o seu tamanho, a $0.20 / $0.60 por milhão de tokens hospedado. A vantagem, porém, é estreita. A própria tabela da Ricursive o coloca em primeiro em 2 de 22 benchmarks, e o Terminal-Bench 2.1 é uma vitória de 0,4 ponto sobre o Reflection Beam. O motivo real para se importar é que ele cabe em um único DGX Spark. Experimente se quiser um modelo de código que você possa hospedar; espere testes independentes se precisar de provas. Para equipes de suporte, o modelo é a parte fácil, e o eesel é o colega de equipe construído em cima.
O que é o Ripple-65B?
O Ripple-65B Preview é o primeiro modelo público da Ricursive Intelligence, um laboratório de Palo Alto cofundado por Anna Goldie e Azalia Mirhoseini que desenvolve IA para projeto de chips. Foi lançado em 4 de novembro de 2026. A Ricursive o chama de "a general-purpose variant of the proprietary model that powers our AI chip design platform."
A ficha técnica, em resumo:
- Tamanho: 64,8B parâmetros, todos ativos em cada token. Isso o torna um modelo transformer denso, não uma mistura de especialistas.
- Treinamento: pré-treinado do zero com 12 trilhões de tokens de texto e código, principalmente em inglês. Sem imagens, sem áudio.
- Contexto: até 1M de tokens suportados, com 2M de posições permitidas na configuração.
- Licença: Apache 2.0 em todos os checkpoints, então o uso comercial é permitido.
- Foco: a Ricursive diz que o Preview teve "relatively light posttraining, with a focus on agentic coding."
Ele sai em quatro repositórios do Hugging Face: o modelo BF16 ajustado por instruções (cerca de 130 GB), uma versão NVFP4 rotulada como "Experimental" (cerca de 57 GB), um modelo base sem pós-treinamento e um modelo rascunho "DFlash2" de 4B que acelera a geração por decodificação especulativa.
Eu construo integrações e recursos de API na eesel, então, quando um modelo como este chega, a primeira coisa que leio não é o gráfico de lançamento. É o arquivo de configuração, o template de chat e os scripts de serviço, porque é ali que se descobre o que dá para usar de fato na segunda-feira. Tudo abaixo vem desses arquivos, da ficha do modelo e das páginas dos provedores, conferidos em 5 de novembro de 2026.
O que há de novo no Ripple-65B?
Três coisas o distinguem dos outros lançamentos de pesos abertos dos EUA neste ano.
Ele é denso quando todos os outros foram para MoE. Reflection Beam, Meta Muse Spark Open, Inkling e Nemotron 3 Ultra usam arquiteturas de mistura de especialistas, em que só uma fatia do modelo roda por token. O Ripple roda os 65B inteiros todas as vezes. O argumento da Ricursive, na ficha do modelo, é que um modelo denso "reduce[s] pretraining and posttraining infrastructure complexity", o que permitiu que uma equipe que cresceu de 1 para 5 pessoas o treinasse com "simple sharding, no custom kernels, and no quantization." O formato também é incomum: fino e profundo, com uma camada oculta estreita de 5.120 de largura empilhada em 80 camadas, e quatro camadas de atenção de janela curta para cada uma completa.
Afirma ser barato de fazer. A Ricursive diz que gastou $32M em todo o projeto, e o blog deixa claro que é "our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging" e as execuções finais, não apenas um treinamento. A comparação de "um décimo do custo" é mais frágil do que parece. A nota de rodapé se apoia em uma reportagem do TechCrunch de que a Reflection se comprometeu com $150M por mês em computação, mais a declaração da Reflection de que o Beam levou cerca de oito semanas. Ou seja, é a estimativa da Ricursive para o gasto de um concorrente, não um número publicado pela Reflection.
Precisou de menos execuções de aprendizado por reforço. A Ricursive diz que chegou à sua pontuação no Terminal-Bench com 1,4M de rollouts, "roughly 70x fewer rollouts than Reflection Beam." Também diz que não comprou dados de pós-treinamento e construiu seus próprios pipelines de dados sintéticos.
O que dizem os benchmarks do Ripple-65B?
O Ripple-65B marca 80,5 no Terminal-Bench 2.1, o número de destaque, que testa se um modelo consegue concluir tarefas reais dentro de um terminal. Isso supera por pouco o Reflection Beam, com 80,1, e vence o Muse Spark Open (76,4), o Inkling (63,8) e o Nemotron 3 Ultra (56,4), segundo as pontuações autorrelatadas de cada laboratório.
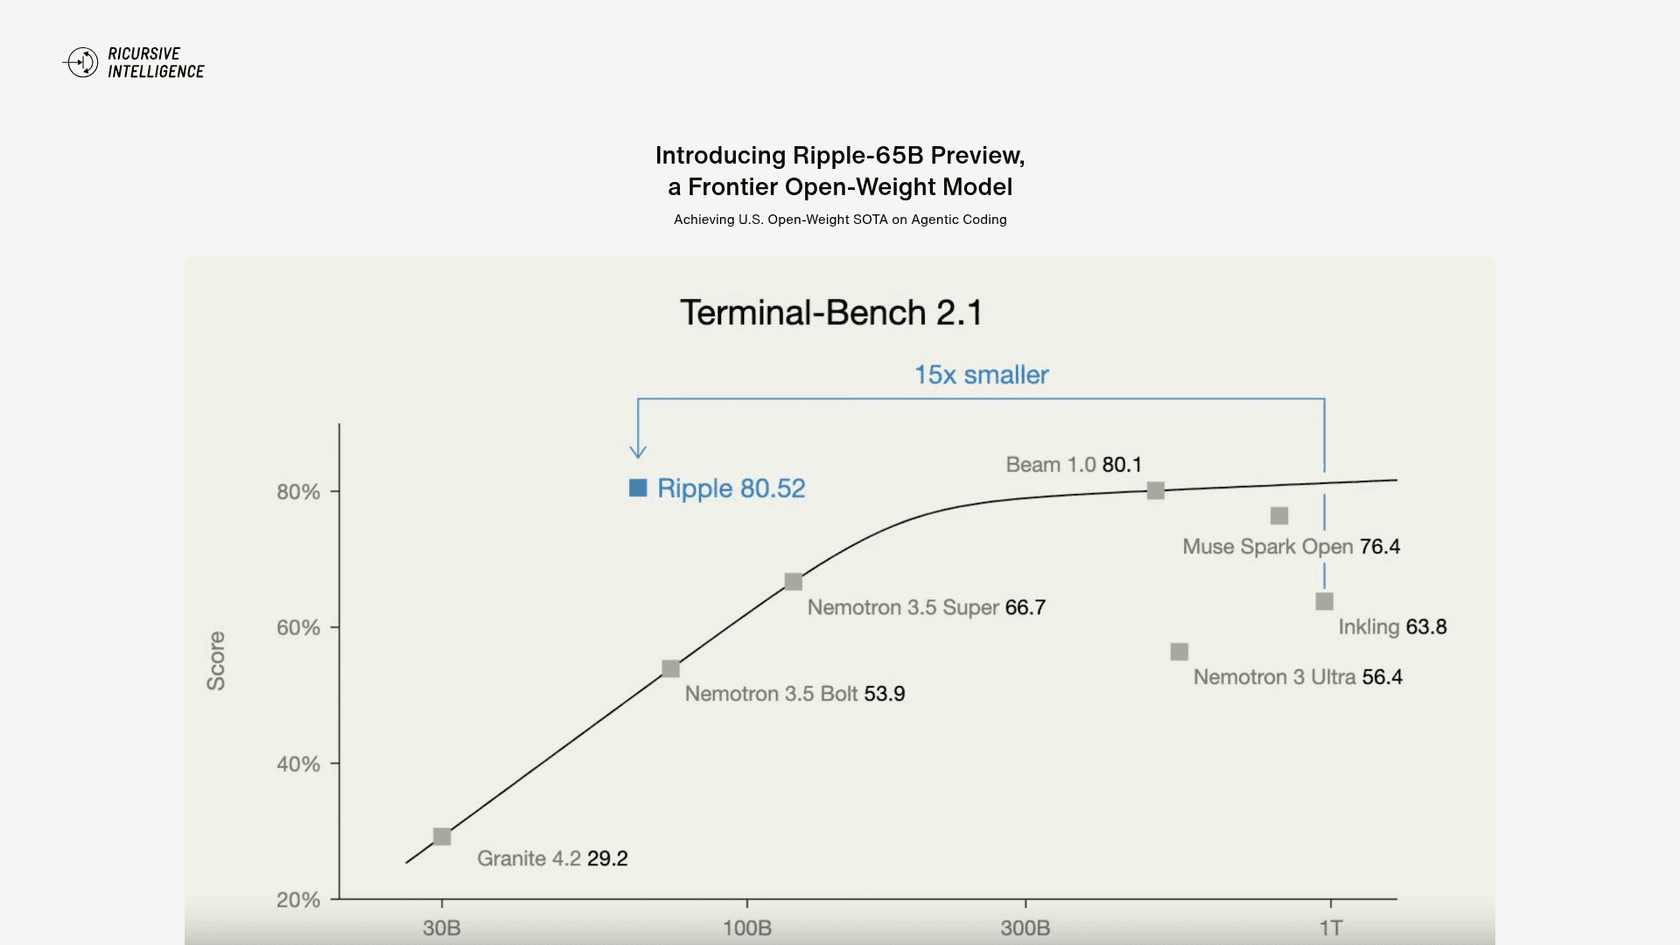
Esse gráfico é todo o argumento: pontuação contra tamanho, com o Ripple bem à esquerda da curva. Ele também coloca modelos americanos menores, como o Nemotron 3.5 Bolt (53,9) e o Nemotron 3.5 Super (66,7), na mesma linha. Ajustado por tamanho em programação, o Ripple está claramente à frente.
A tabela completa na ficha do modelo conta uma história mais mista. Estas são as linhas que importam para agentes de código, com os números da própria Ricursive:
| Benchmark | Ripple-65B | Reflection Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Parâmetros ativos | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1 (autorrelatado) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminal-Bench 2.1 (reexecução da Ricursive) | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
| GPQA Diamond | 85.2 | 90.6 | 89.0 | 87.2 | 87.0 |
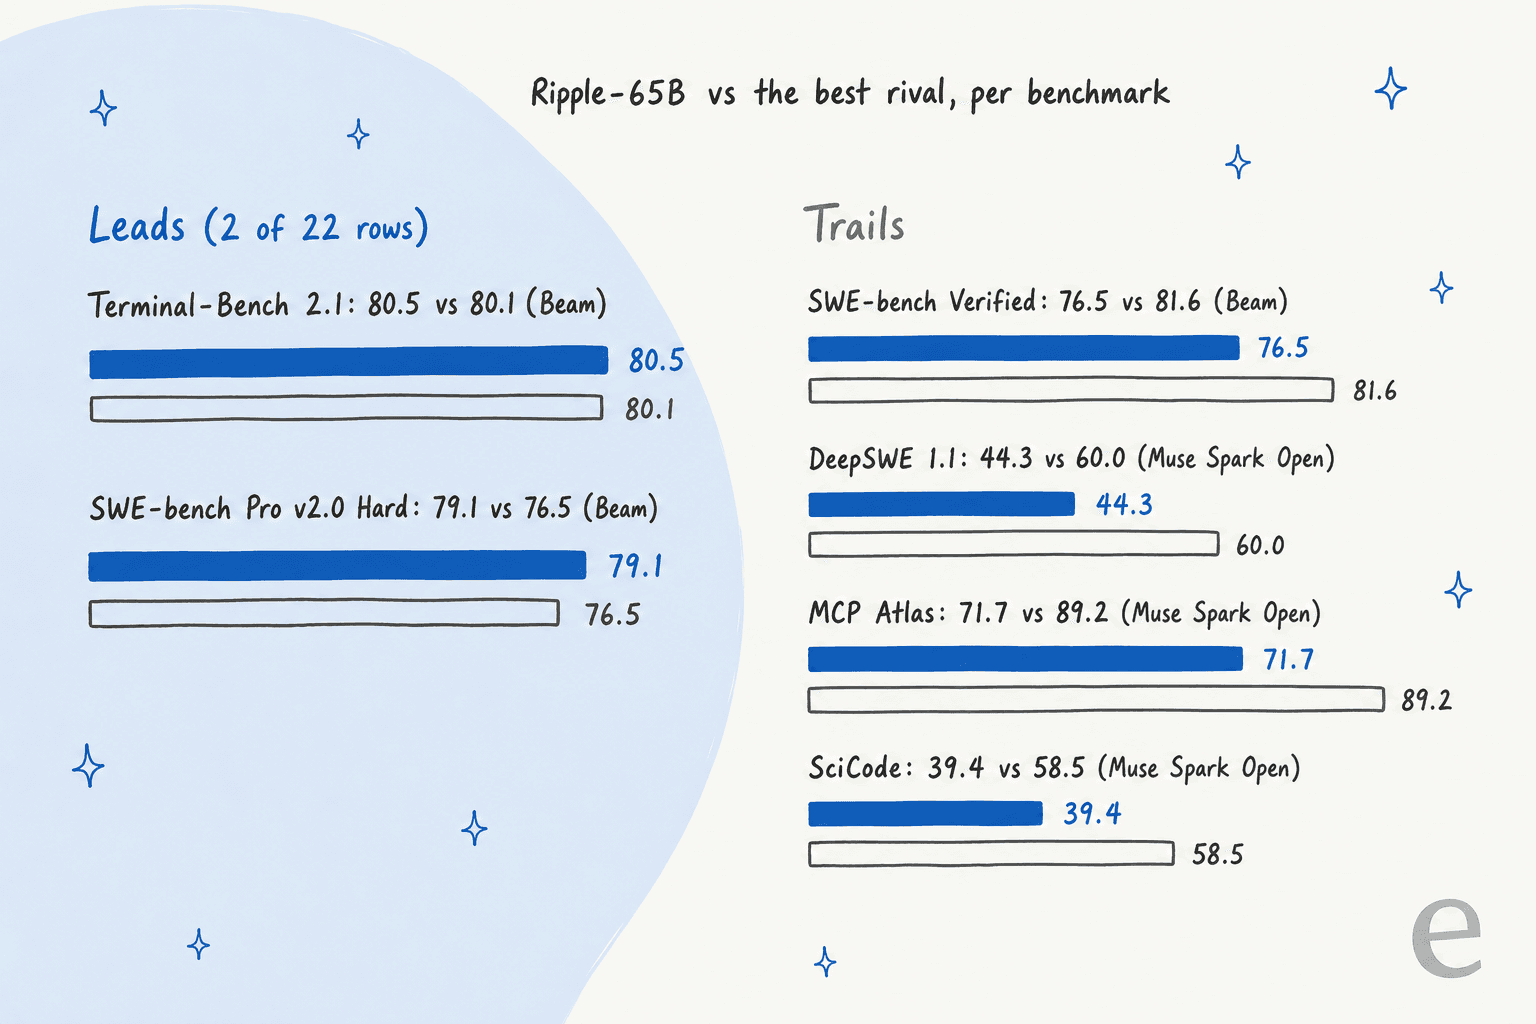
Quatro coisas se destacam quando se lê a tabela com atenção.
- Ele lidera em 2 de 22 linhas. Terminal-Bench 2.1 e SWE-bench Pro v2.0 Hard. No SWE-bench Verified e no Pro v1.0, o Reflection Beam está à frente. No DeepSWE, MCP Atlas e SciCode, é o Muse Spark Open.
- A reexecução ajuda mais o Ripple. Quando a Ricursive reexecutou o Terminal-Bench 2.1 no harness oficial Terminus 2, o Beam caiu de 80,1 para 70,8 enquanto o Muse Spark Open subiu para 78,7. A ficha diz que as pontuações "were universally lower" nesse harness, exceto a do Muse, e chama seus resultados de "a best-effort attempt at a fair comparison." Isso é honesto, e também significa que a diferença maior vem das próprias execuções de teste da Ricursive.
- Várias pontuações dos rivais são execuções da Ricursive, não dos rivais. A ficha marca em itálico os resultados internos, e eles cobrem a maioria dos números baixos, como o 2,0 do Inkling no SWE-bench Pro v2.0 Hard. O blog de lançamento da Ricursive mostra valores diferentes para algumas dessas mesmas células (39,6 para o Inkling, 72,4 para o Muse), então trate essas linhas com cuidado até o relatório técnico sair.
- Modelos de pesos abertos chineses ficaram de fora. A comparação é enquadrada como "U.S. open-weight", então não há DeepSeek, Qwen ou Kimi na tabela de instruct. Se sua lista inclui o DeepSeek V4.1 Flash ou o Qwen 3.8 Flash Next, você terá de fazer sua própria comparação.
Nenhum desses benchmarks foi verificado por um laboratório externo ainda. Até alguém reexecutá-los, a leitura segura é "um modelo denso de 65B que compete com os melhores modelos de pesos abertos dos EUA em programação", e não "o melhor modelo de código de pesos abertos".
Quanto custa o Ripple-65B?
Os pesos são gratuitos sob Apache 2.0. Hospedado, o Ripple-65B custa $0.20 por milhão de tokens de entrada e $0.60 por milhão de tokens de saída, com entrada em cache a $0.05. É igual diretamente na GMI Cloud e no OpenRouter, onde a GMI Cloud é o único provedor.
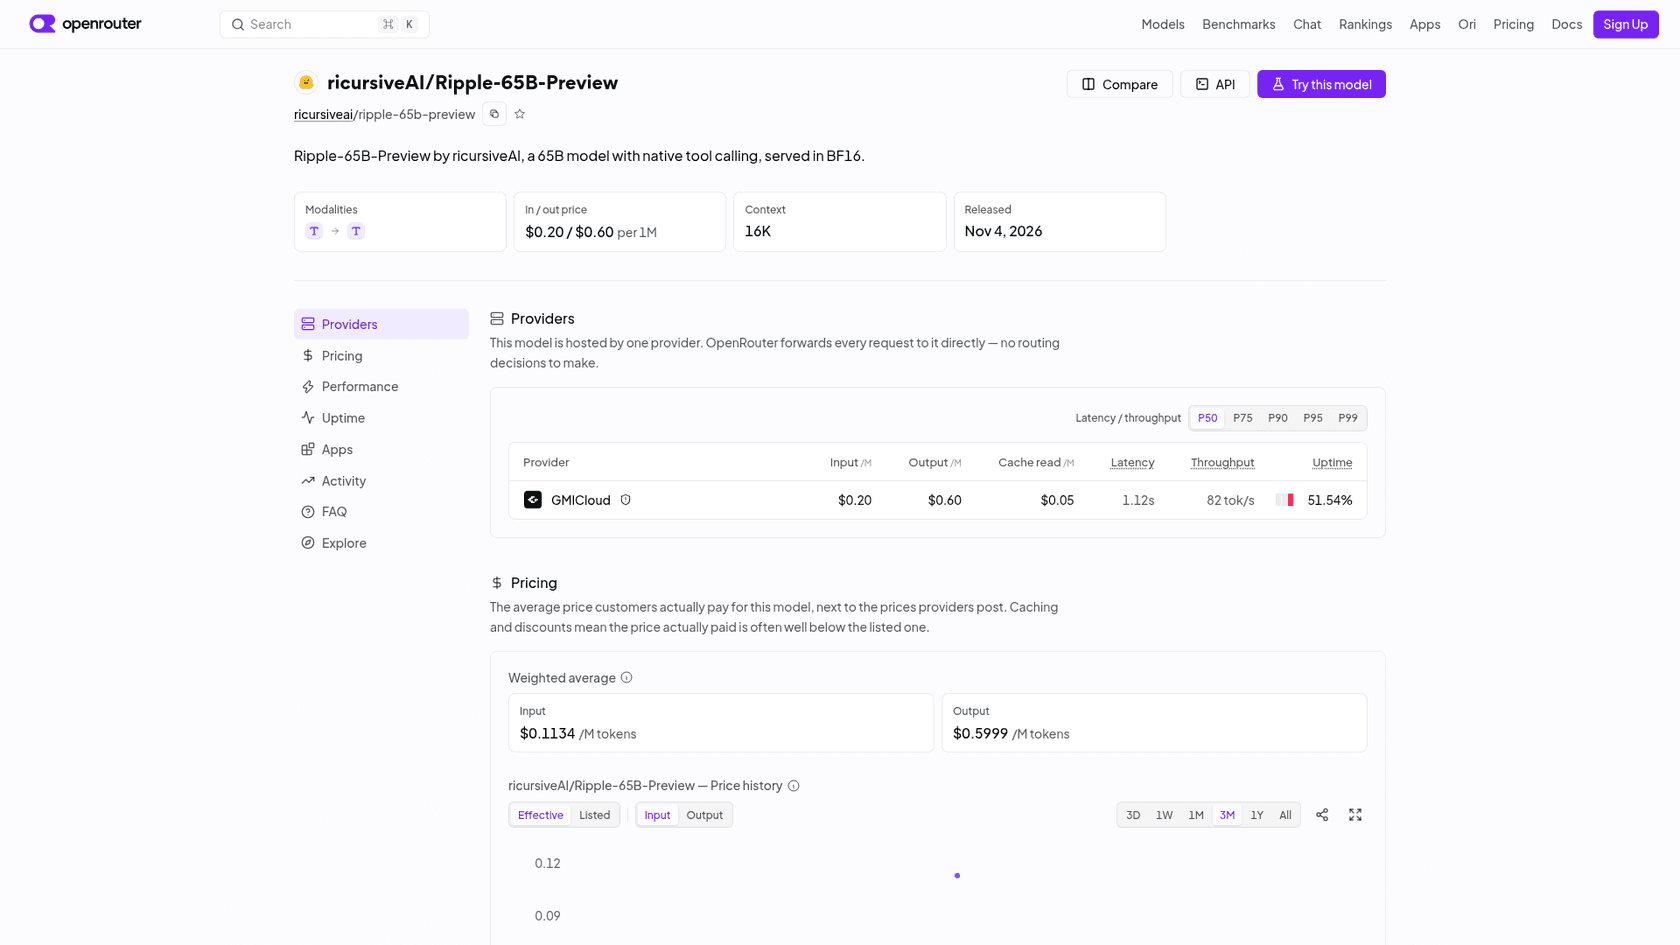
Veja como isso se compara a modelos próximos, usando os preços de lista do OpenRouter em 5 de novembro de 2026:
| Modelo | Entrada / 1M | Saída / 1M | Entrada em cache / 1M | Contexto no OpenRouter |
|---|---|---|---|---|
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | 16,384 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | 1,048,576 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | 1,048,576 |
| Inkling | $1.00 | $4.05 | $0.17 | 524,288 |
| Inkling Small | $0.45 | $1.20 | $0.10 | 524,288 |
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | 1,048,576 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | 1,050,000 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1,000,000 |
O Ripple é a opção de pesos abertos americana mais barata na saída nessa tabela. Duas coisas na listagem importam mais que o preço, porém.
- O contexto hospedado é de 16K. O OpenRouter o limita a 16.384 tokens com um teto de saída de 14.745, embora a ficha do modelo e a própria página da GMI digam 1M. Um agente de código trabalhando em um repositório real consome 16K rápido, então confira isso antes de ligar o Ripple a qualquer coisa.
- Um único provedor significa capacidade curta. Com a GMI Cloud como único host, o painel de disponibilidade do OpenRouter mostrava cerca de 51% no dia anterior quando verifiquei. A Ricursive também disse que o Ripple chegaria à Together AI e à Fireworks. Em 5 de novembro, a página da Together ainda dizia "This model is coming soon to Together's Serverless API."
Dá para rodar o Ripple-65B localmente?
Sim, em hardware NVIDIA, e esta é a parte mais interessante do lançamento. A Ricursive distribui duas configurações documentadas, e a janela de contexto que você obtém depende de qual escolher.
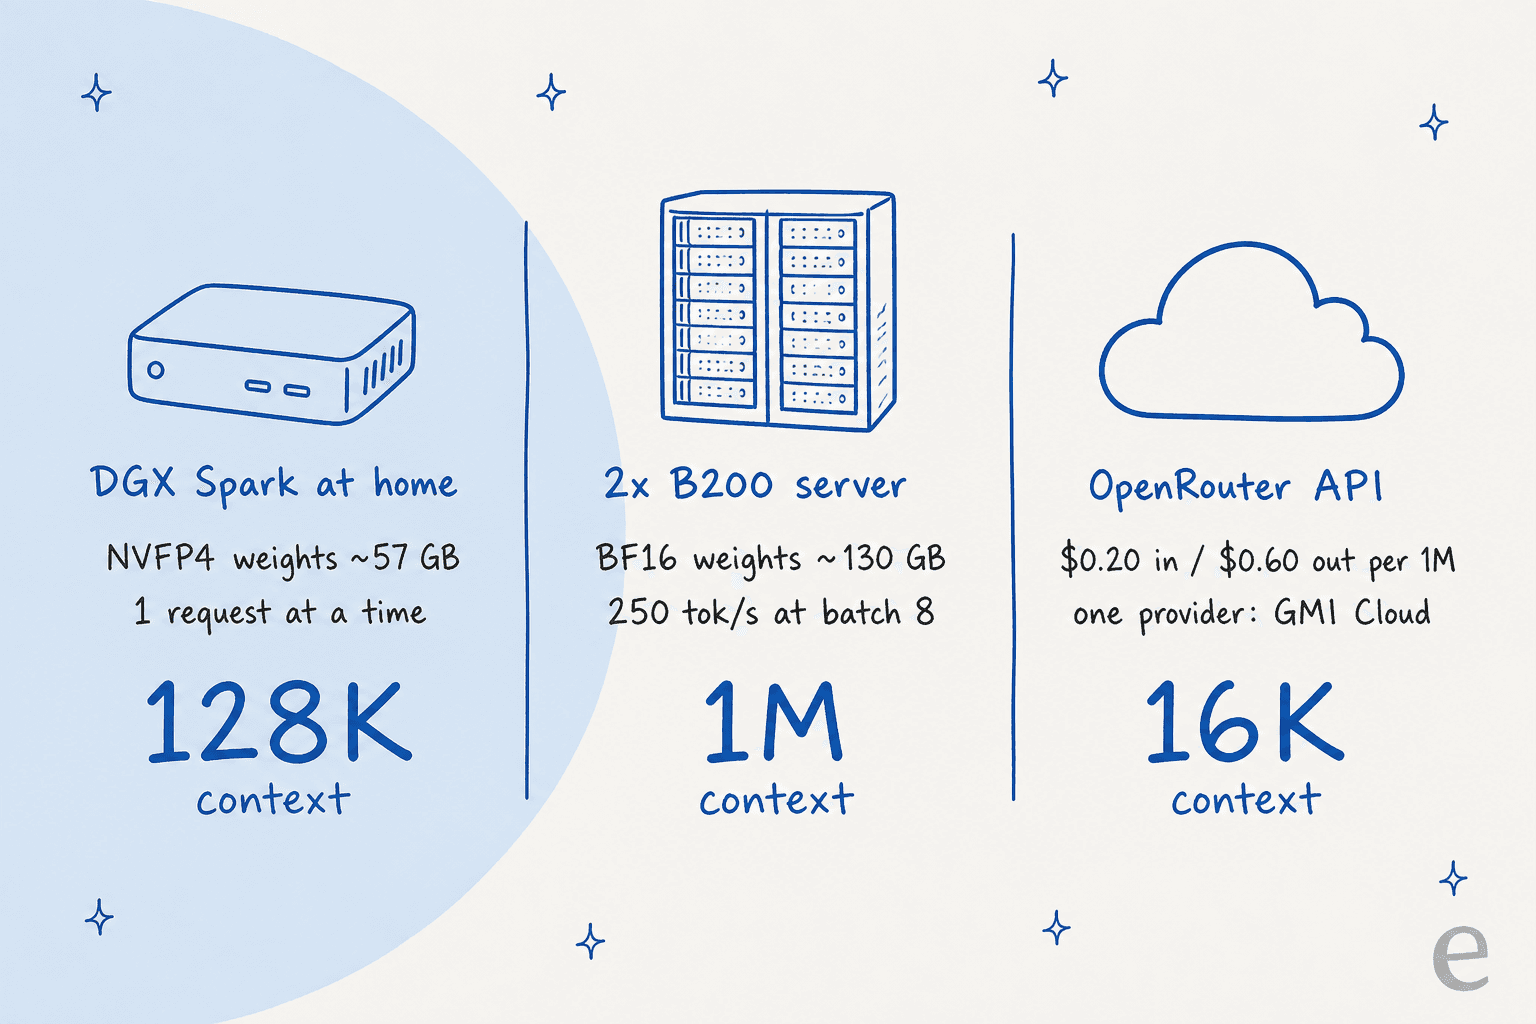
Em um DGX Spark. O repositório NVFP4 inclui um notebook e um script spark.py para a caixa de IA de mesa da NVIDIA. Ele carrega os pesos NVFP4 (4 bits para as camadas feed-forward, BF16 para a atenção) mais o modelo rascunho DFlash2, e atende uma requisição por vez com 128K de contexto. O script se recusa a rodar em qualquer coisa que não seja um chip GB10. A Ricursive não publica um número de tokens por segundo para o Spark.
Em duas GPUs B200. O repositório BF16 traz uma configuração de servidor com SGLang 0.5.19 que atende o contexto completo de 1M, com a Ricursive citando "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels." Com quatro GPUs você obtém duas cópias independentes.
Em um Mac ou qualquer outra coisa. Não há caminho oficial. A publicação de lançamento do cofundador dizia "You can run Ripple-65B locally and efficiently on a MacBook Pro", mas nenhuma instrução para MacBook, MLX ou llama.cpp aparece no blog nem em qualquer uma das quatro fichas de modelo. Conversões GGUF da comunidade apareceram no Hugging Face em um dia; a Ricursive não as testou.
A velocidade é a questão em aberto. Um modelo denso lê todos os pesos para cada token, então depende muito da largura de banda de memória, o ponto fraco do Spark. Isso foi levantado poucas horas depois do lançamento:
"What tok/s are you getting on the Spark? 65B dense on ~273GB/s of memory bandwidth has to crawl in an agent loop."
O modelo rascunho é a resposta da Ricursive a isso, já que a decodificação especulativa deixa o modelo pequeno adivinhar vários tokens que o grande verifica em uma única passada. Se isso leva os loops de agente a uma velocidade utilizável em um Spark, ninguém havia medido publicamente até 5 de novembro.
Como chamar o Ripple-65B pelo código?
Tanto a GMI Cloud quanto o OpenRouter expõem um endpoint de chat compatível com OpenAI, então qualquer SDK ou framework de agentes que fale esse formato funciona. No OpenRouter, o ID do modelo é ricursiveai/ripple-65b-preview:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ricursiveai/ripple-65b-preview",
    "messages": [{"role": "user", "content": "Write a bash one-liner that finds the 10 largest files in a repo."}],
    "temperature": 0
  }'
Alguns detalhes do template de chat que vale conhecer antes de construir em cima dele:
- A chamada de ferramentas é nativa. As ferramentas vão no prompt do sistema e as chamadas voltam como JSON dentro de tags
<tool_call>, que o parserrippledo SGLang converte emtool_callspadrão. Se você forçar uma chamada comtool_choice: "required", definastrict: true, porque a Ricursive descobriu que "non-strict required calls produced extra argument fields." - O raciocínio está sempre ligado. O template envolve o raciocínio em tags
<think>e "does not implement a thinking on/off switch or reasoning-effort levels." Você paga tokens de saída por esse raciocínio em toda chamada. - Sem valores de amostragem padrão. A Ricursive não publica uma temperatura recomendada; seus próprios exemplos usam 0.
Se você pretende usar o Ripple a partir de um agente de código como o Claude Code ou uma CLI de programação com agentes, o contexto hospedado de 16K é o limite que você vai atingir primeiro. Hospedar por conta própria é hoje o caminho para contorná-lo.
O que os desenvolvedores estão dizendo sobre o Ripple-65B?
O principal tópico do Hacker News chegou a 181 pontos e 61 comentários no dia do lançamento. Dois temas dominaram: o enquadramento dos benchmarks e se um modelo denso de 65B é prático em casa.
Sobre o enquadramento, a reclamação mais comum foi que a comparação para nos modelos dos EUA:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"

Outros apontaram o tamanho da própria vantagem:
"Still they score 0.42 percentage points higher than the second-best model on their chosen benchmark, so it's hardly a meaningful lead."
O contraponto veio de pessoas para quem "feito nos EUA" é um requisito real, não um rótulo de marketing:
"US Gov won't let Chinese models be hosted on any internal infra ... So there is absolutely a market for US-made or non-Chinese models there."
Sobre rodá-lo em casa, as opiniões se dividiram. Um comentarista esperava que "inference will be prohibitively slow on consumer grade hardware" e leu o lançamento como voltado a equipes de projeto de chips em ambientes isolados, o que combina com o próprio negócio da Ricursive. Donos de Mac Studio com muita memória foram mais otimistas, já que 130 GB de pesos ficam bem abaixo do que seus clusters comportam. Ninguém havia postado velocidades medidas até a manhã de 5 de novembro.
A alegação de custo teve a recepção mais calorosa. swyx chamou o lançamento de "the avengers of open model SOTA" e citou a nota de rodapé de que os $32M cobrem todo o esforço de P&D, o detalhe que mais gente achou marcante.
Você deve usar o Ripple-65B para atendimento ao cliente?
Provavelmente não como o cérebro de um bot de suporte, e o motivo é adequação, não qualidade. O Ripple-65B é um modelo de código com pós-treinamento leve. As linhas da própria tabela da Ricursive mais próximas do trabalho de suporte são medianas: 31,27 no τ³-bench banking, que testa conversas de cumprimento de políticas com um cliente (o Beam marca 36,1), e 71,67 no MCP Atlas, que testa uso de ferramentas (o Muse Spark Open marca 89,2). O único caso forte é o controle de dados: se os dados dos clientes nunca podem sair da sua rede, um modelo Apache 2.0 no seu próprio hardware é uma opção real, e o Ripple é um dos menores entre os fortes.
Mesmo assim, o modelo é a parte fácil. Para responder bem a tickets você também precisa de conexões com a base de conhecimento, regras de escalonamento, proteções contra respostas inventadas e uma forma de conferir as respostas antes que os clientes as vejam. Esse é o dilema de construir ou comprar IA para suporte, e é a maior parte do trabalho.
Essa lacuna é o que a eesel preenche. A eesel é uma plataforma de colegas de equipe de IA, e seu colega de IA para helpdesk entra no seu helpdesk atual, aprende com sua central de ajuda e tickets passados e trabalha na sua fila. Já vi bots que soam confiantes darem respostas erradas em filas reais, por isso toda implantação da eesel roda primeiro contra tickets históricos, para que você leia o que ele teria dito antes de tocar em um cliente.
A Timengo é um bom exemplo no extremo técnico. Ela vende software de e-mail seguro e Digital Post na Dinamarca, e a eesel redige suas respostas de suporte técnico em dinamarquês a partir de cerca de 5.300 tickets passados e artigos da central de ajuda, preparando cerca de 300 tickets do Freshdesk em um mês. A SE Ranking roda três produtos no Zendesk com um agente da eesel cada, que cuidaram de 4.650 conversas em um mês.
E se você olhou para o Ripple porque gosta de trabalhar no terminal, a CLI da eesel combina com esse hábito. Um agente de código pode usá-la para enviar conhecimento aprovado, como artigos de ajuda e macros exportados, editar as instruções do colega de equipe e fazer perguntas de teste para conferir as respostas antes de qualquer coisa ir ao ar. Conectar o próprio helpdesk ainda exige que alguém com acesso de administrador aprove. Há mais sobre esse fluxo em gerenciar agentes pelo terminal.
Quem deve usar o Ripple-65B?
Esta é a minha opinião depois de ler todos os arquivos que a Ricursive publicou:
- Experimente se quiser um modelo de código que seja totalmente seu. Apache 2.0, um caminho local em uma única máquina e $0.60 por milhão de tokens de saída hospedado tornam barato testá-lo no seu próprio repositório, e ele é um candidato natural para equipes que só podem rodar modelos feitos nos EUA.
- Hospede por conta própria se precisar de contexto longo. O limite hospedado de 16K descarta trabalho sério com agentes hoje; o contexto de 1M só vem com suas próprias GPUs.
- Espere se precisar de provas. Ainda não há relatório técnico, as fontes dos benchmarks divergem em algumas células e nenhum laboratório externo reexecutou os números. Algumas semanas de testes independentes vão esclarecer muita coisa.
- Procure em outro lugar se o preço for toda a decisão. O DeepSeek V4.1 Flash é mais barato na entrada e na saída, e o Kimi K3.1 Pro foi testado de forma mais ampla. Para uma lista mais ampla, veja as melhores ferramentas de assistente de programação com IA.
O resumo justo: o Ripple-65B Preview mostra que uma equipe pequena com um modelo denso de 65B pode chegar à mesma faixa de modelos de pesos abertos dos EUA de oito a quinze vezes seu tamanho em programação, por $32M reportados. É um resultado real. "Estado da arte" só vale dentro de uma categoria estreita, e a forma de descobrir se vale para o seu trabalho é rodá-lo nas suas próprias tarefas.
Experimente a eesel
Se você chegou ao Ripple-65B esperando que um modelo aberto pudesse tirar tickets da sua equipe, pode pular a construção da camada de suporte. O colega de IA para helpdesk da eesel se conecta em minutos ao Zendesk, Freshdesk, Gorgias e mais, aprende com seus tickets passados e mostra como os teria respondido antes de ir ao ar. Os planos começam em $299 por mês, e há um nível gratuito para testar.

Experimente a eesel de graça.