

Resumo rápido
Vale a pena testar o LongCat 2.5 se você quer um agente de programação barato que também consiga ler capturas de tela e vídeos. É o modelo de 1.6T de parâmetros da Meituan com entrada nativa de imagens e vídeos, ao preço de US$ 0,30 de entrada e US$ 1,20 de saída por milhão de tokens, o mesmo do DeepSeek V4.1 Flash no horário de pico. A ressalva está na própria tabela de benchmarks da Meituan: o DeepSeek V4.1 Flash vence na maioria das linhas de programação pelo mesmo preço, e os pesos do LongCat 2.5 ainda estão como "coming soon". Use-o para tarefas com agentes que dependam bastante de visão e mantenha os dados dos clientes de fora até a Meituan publicar uma política de dados. Para suporte, um colega de equipe de helpdesk como o eesel, que você testa em tickets anteriores, é mais seguro.
O que é o LongCat 2.5?
O LongCat 2.5 é o modelo mais recente da equipe LongCat da Meituan. Ele entrou em disponibilidade geral na LongCat API Platform em 2 de novembro de 2026, cinco semanas depois de uma versão de prévia chegar em 25 de setembro. O registro de alterações da Meituan destaca três recursos principais: "Native Multimodality, Beyond Text", "Long-Horizon Agents for Complex Engineering" e "Works Across Agent Harnesses".
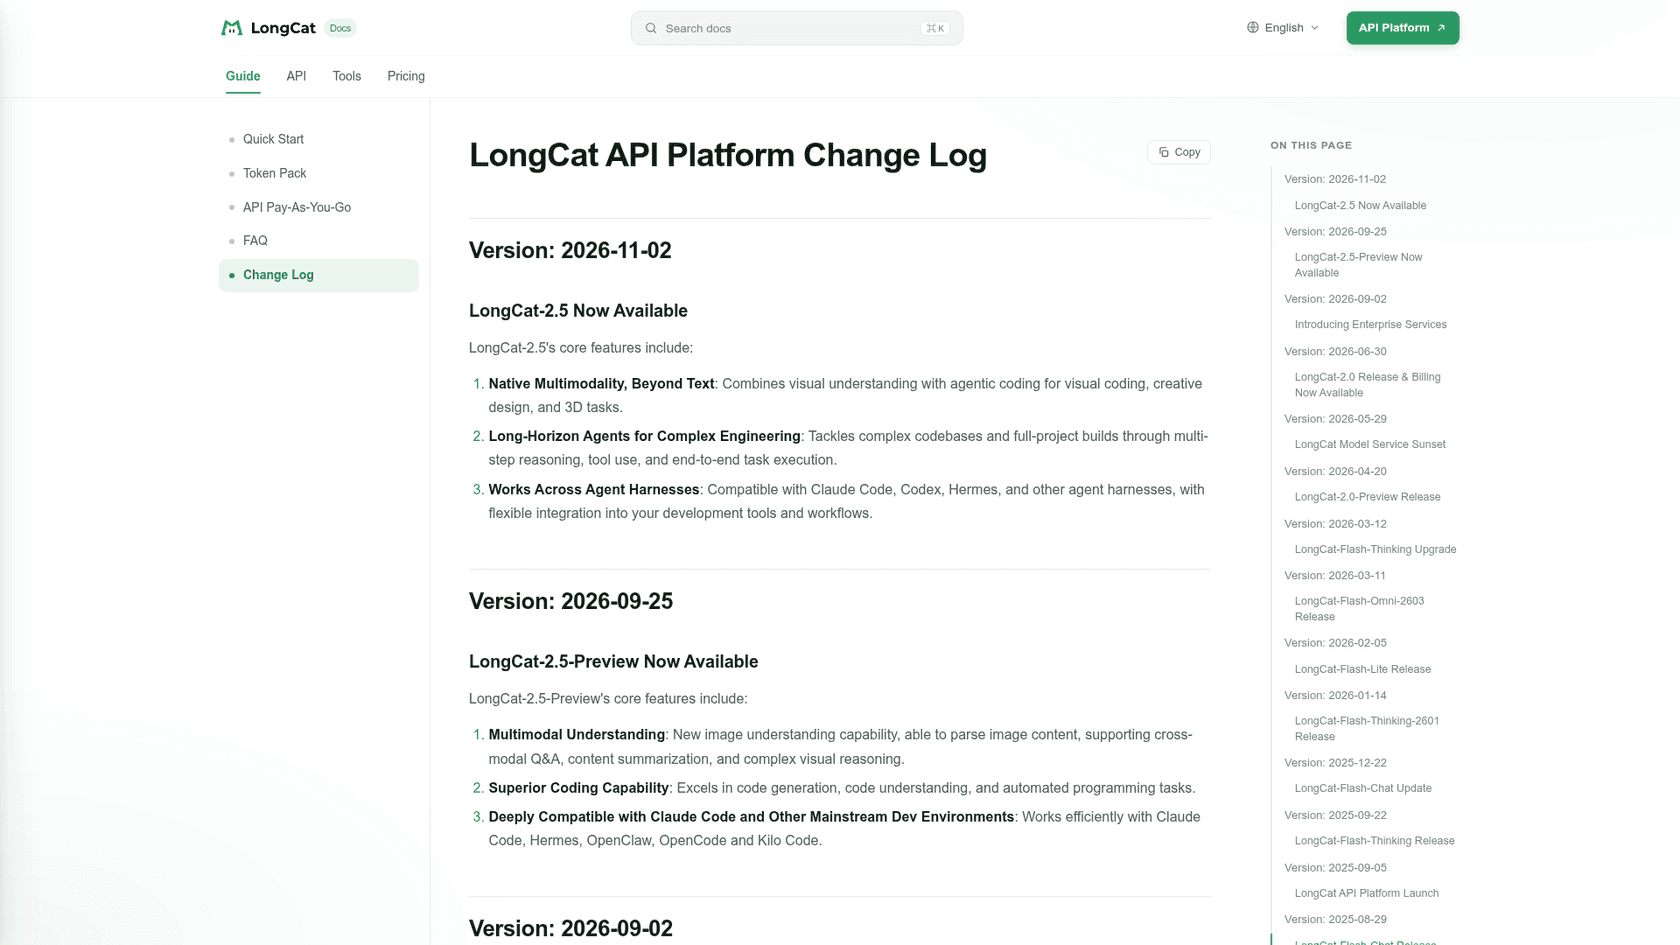
Se você perdeu a rodada anterior: o LongCat 2.0 era um modelo fundacional com mistura de especialistas de 1.6 trilhão de parâmetros, com cerca de 48B de parâmetros ativos por token, lançado sob uma licença MIT com pesos no Hugging Face. Era um modelo exclusivamente de texto, criado para tarefas de programação com agentes.
Sou engenheiro de software na equipe que desenvolve os agentes de IA do eesel, então leio os lançamentos de modelos com uma pergunta em mente: o que eu precisaria mudar para realmente colocar isso para rodar? Este post foi elaborado a partir do blog técnico do LongCat 2.5 da Meituan, da documentação e do registro de alterações da plataforma, do post de lançamento no X e dos relatos de desenvolvedores que usaram a prévia gratuita.
O que mudou em relação ao LongCat 2.0?
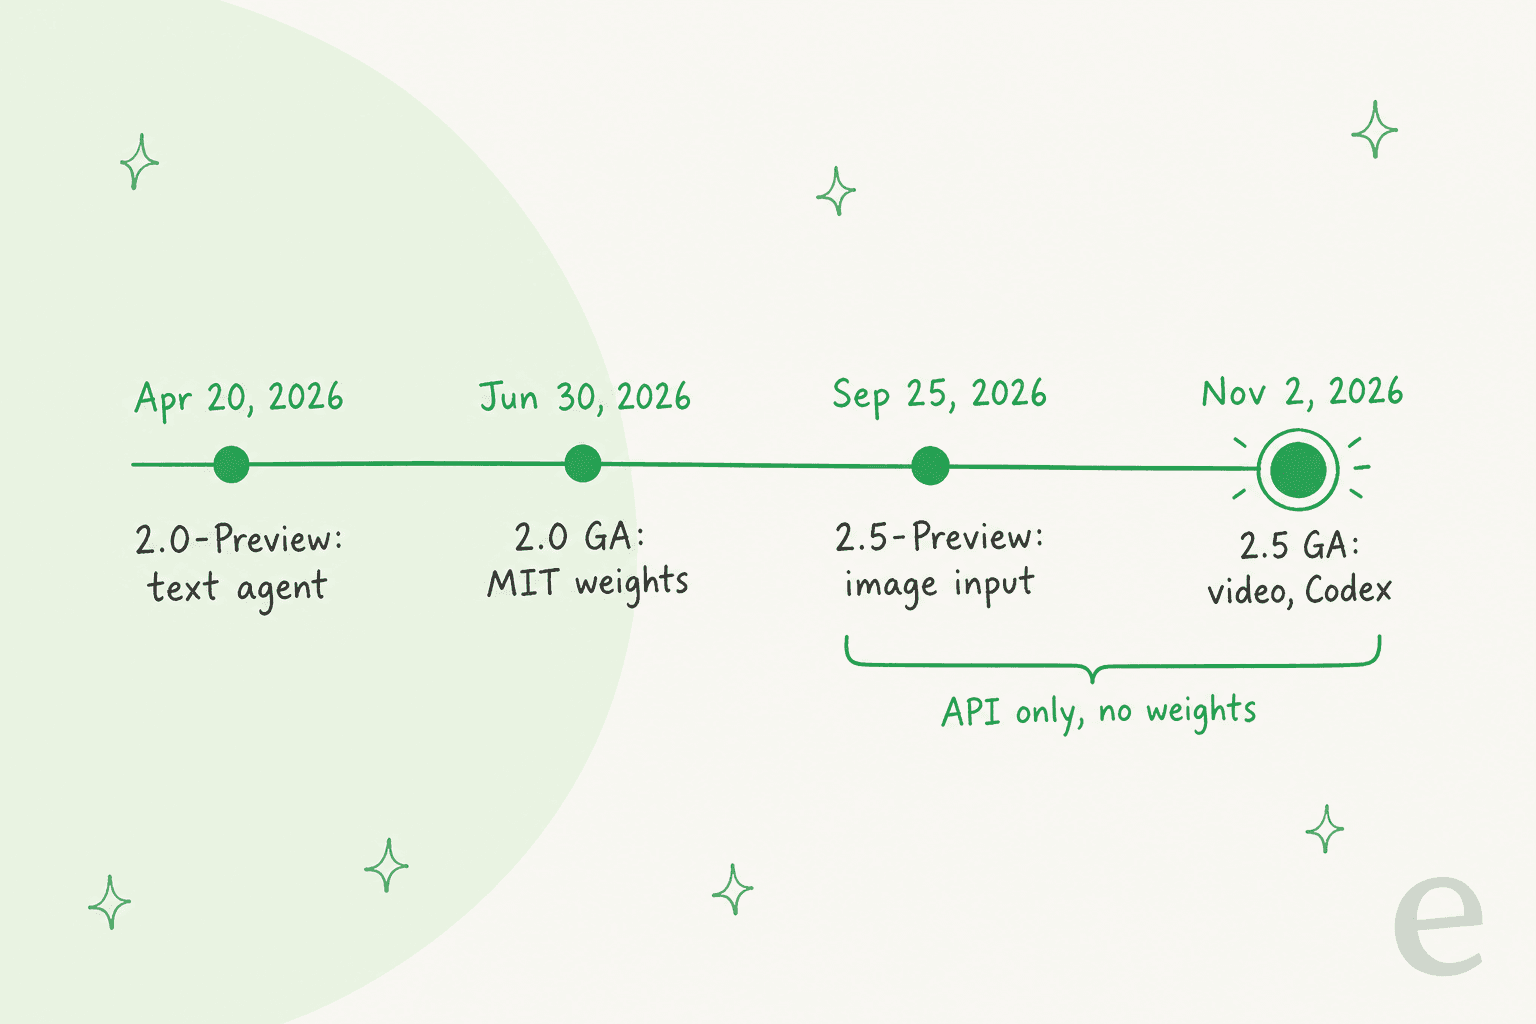
Mesmo corpo, novos sentidos. O blog técnico da Meituan diz que o 2.5 tem "1.6 trillion total parameters and approximately 48 billion activated per token" e "builds on LongCat-2.0". Portanto, este não é um modelo novo e maior. É a arquitetura de mistura de especialistas do 2.0 com visão adicionada e muito mais treinamento de agentes por cima. Aqui está a linha do tempo.
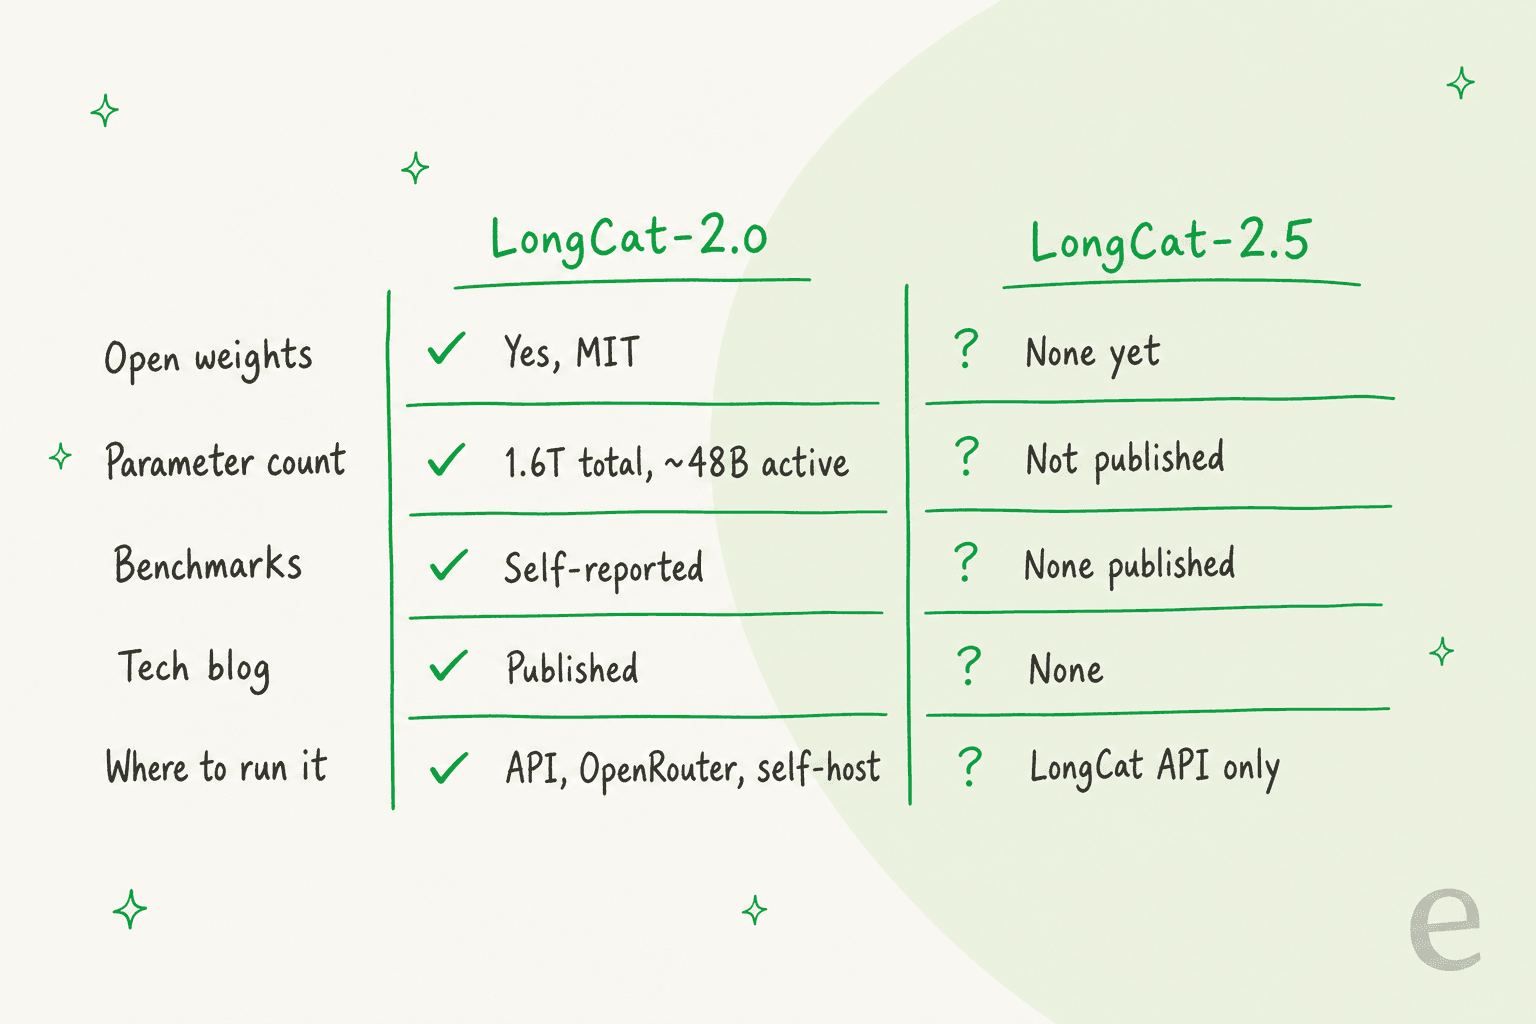
O 2.0 passou da prévia aos pesos MIT em cerca de dez semanas. O 2.5 está disponível há cinco semanas, contando a prévia e a disponibilidade geral. Seu blog técnico mostra "GitHub Coming soon" e "HuggingFace Coming soon", e nada apareceu ainda no Hugging Face ou no GitHub. "Coming soon" é um rótulo, não uma data, e a Meituan não deu nenhum prazo.
Entrada de imagens e vídeos
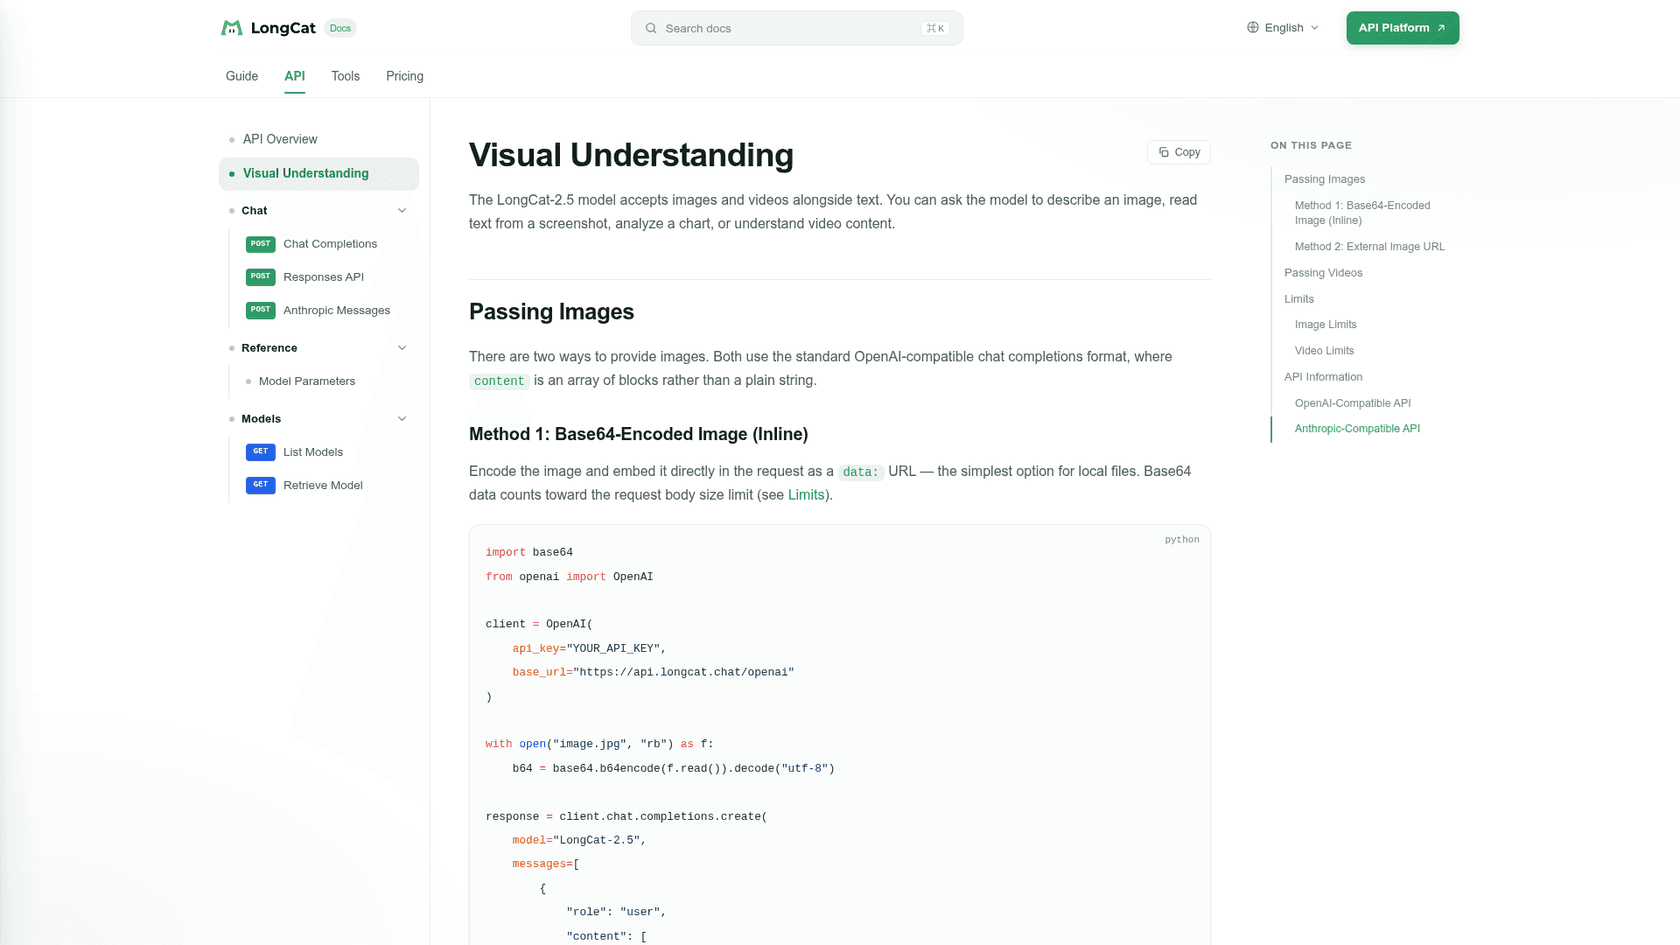
Este é o principal recurso. A documentação de compreensão visual diz "The LongCat-2.5 model accepts images and videos alongside text", e os limites são generosos:
| Entrada | Formatos | Limite de tamanho | Por solicitação | Como enviar |
|---|---|---|---|---|
| Imagens | PNG, JPG, JPEG, WebP, GIF | 10 MB cada | Até 50 | URL de dados Base64 ou URL pública |
| Vídeo | Não informados | 100 MB cada, menos de 3.600 segundos | Até 10 | Apenas URL pública |
A prévia anunciava apenas compreensão de imagens. O vídeo chegou com a versão de disponibilidade geral. A saída continua sendo apenas texto, então este é um modelo que lê capturas e gravações de tela, não um que cria imagens. Arquivos SVG e HEIC não são compatíveis, e uma imagem com proporção superior a 200:1 gera um erro. Também não há uma linha de preço separada para imagens ou vídeos na página de preços; você paga pelos tokens em que eles são convertidos.
Por que isso importa para programação: o registro de alterações o apresenta para "visual coding, creative design, and 3D tasks". Em termos simples, você pode colar uma captura de tela de um layout quebrado e pedir ao agente para corrigir o CSS. É a mesma direção que o DeepSeek V4 Flash Vision seguiu, e era uma lacuna real do 2.0.
Como funciona a parte de visão
A maioria dos modelos de visão acopla um codificador de imagens a um modelo de texto. O LongCat 2.5 transforma imagens no mesmo tipo de tokens que as palavras. O blog técnico diz que ele "represents visual signals as multi-level discrete tokens", então a estrutura central lê um único fluxo misto de tokens de texto e imagem. Um tokenizador fixo significa que os tokens de imagem podem ser calculados uma vez e armazenados em cache offline, e é por isso que a Meituan pôde remover completamente o codificador de visão do treinamento.
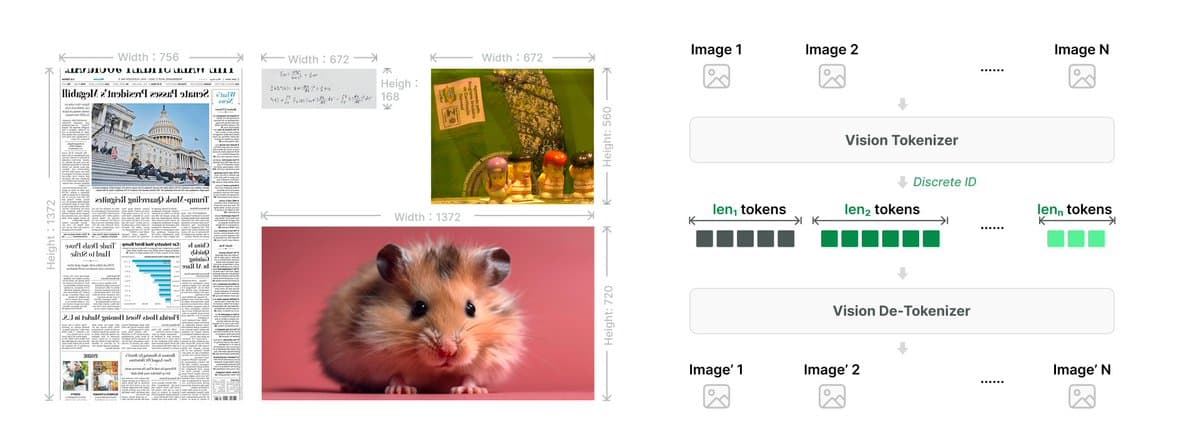
O resultado prático é a resolução nativa: uma captura de tela alta vira mais tokens, em vez de uma miniatura achatada. Do lado dos agentes, a Meituan descreve "large-scale long-horizon reinforcement learning" em tarefas criadas a partir de pull requests filtrados do GitHub, com penalidades para "repetitive reasoning and repeated tool calls". Guarde essa última frase para a seção da comunidade.
Codex entra na lista de ambientes de execução
A prévia citava Claude Code, Hermes, OpenClaw, OpenCode e Kilo Code. A versão de disponibilidade geral adiciona o Codex, e a documentação agora traz um novo endpoint Responses no formato OpenAI (POST /openai/v1/responses), necessário para o Codex. Esse endpoint traz níveis de esforço de none a xhigh, chamadas paralelas de ferramentas ativadas por padrão e saída com esquema JSON. A barra lateral de ferramentas lista 13 guias de configuração no total, do Cline ao Hermes Agent.
Um contexto real de 1M, no papel
O marketing do 2.0 dizia contexto de 1M, enquanto a configuração entregue tinha um limite de 256K. Para o 2.5, não há configuração para verificar, apenas a API, e a página de parâmetros do modelo define a janela de contexto como 1.048.576 tokens de entrada mais saída por solicitação. É na saída que a documentação se contradiz:
- A página de parâmetros do modelo permite
max_tokensde até 262.144. - Tanto o guia de início rápido quanto as perguntas frequentes dizem que a saída máxima é de 128K.
- A própria configuração de Claude Code da Meituan define a saída como
131072, que equivale a 128K.
Eu planejaria com base em 128K de saída e trataria qualquer coisa acima disso como um bônus a testar.
O que dizem os benchmarks do LongCat 2.5?
Os números da Meituan mostram um grande salto em relação ao 2.0 e um modelo que fica próximo da fronteira de 2025-2026 em tarefas com agentes. A própria tabela conta uma história menos favorável na sua faixa de preço. Todos os números abaixo vêm da tabela de avaliação do blog técnico, executada pela Meituan com o raciocínio ativado.
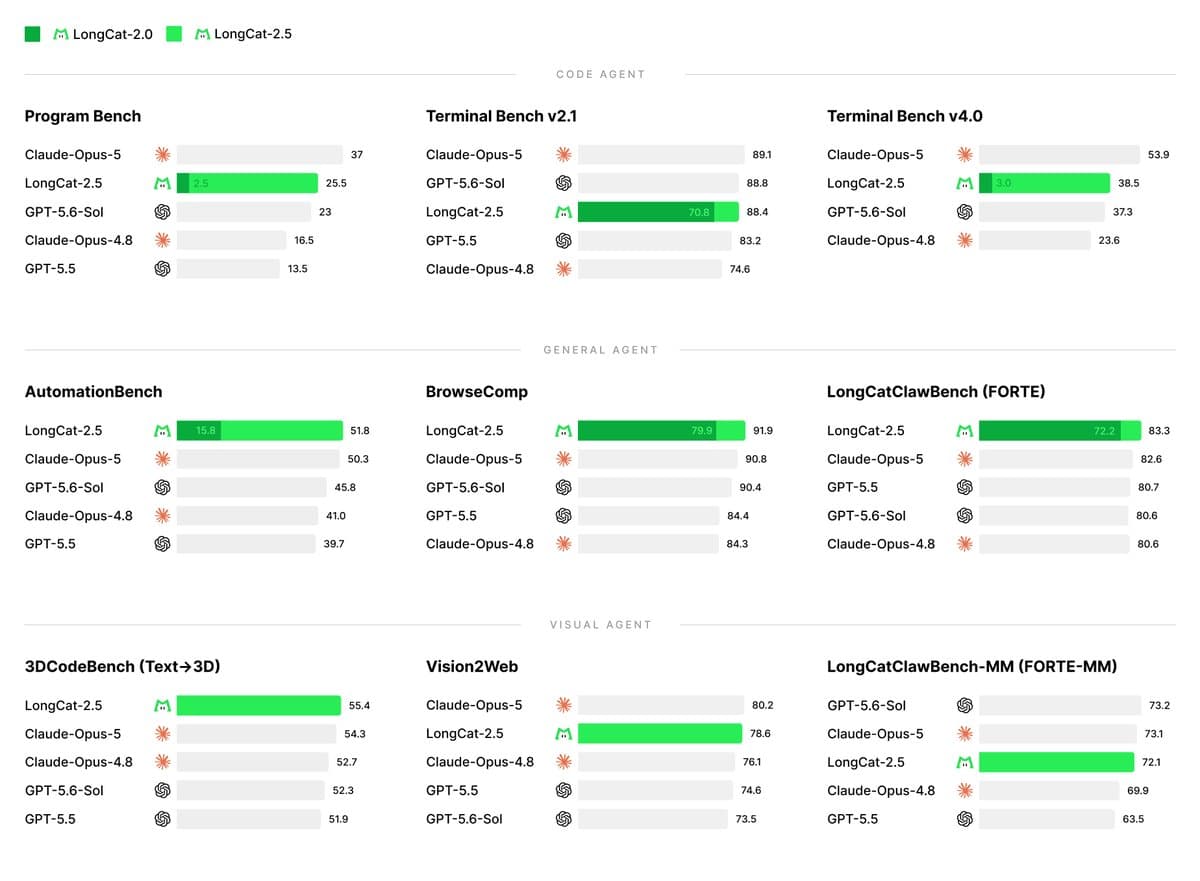
O salto do 2.0 para o 2.5 é real no papel. O Terminal Bench 4.0 vai de 3.0 para 38.5, o AutomationBench de 15.8 para 51.8 e o DeepSWE v1.1 de 9.7 para 64.6. É isso que meses de treinamento de agentes para tarefas de longa duração proporcionam.
A ressalva está no conjunto de comparação. Os gráficos principais comparam com GPT-5.5, GPT-5.6-Sol, Claude Opus 4.8 e Claude Opus 5. Não há Claude Opus 5.5, nem GPT-6.1 Sol, nem Kimi K3.1 Pro. A tabela completa mais abaixo na página adiciona GLM-5.3, Kimi K3 e DeepSeek V4.1 Flash, e essa última coluna é a que eu leria primeiro, porque é o modelo com exatamente o mesmo preço.
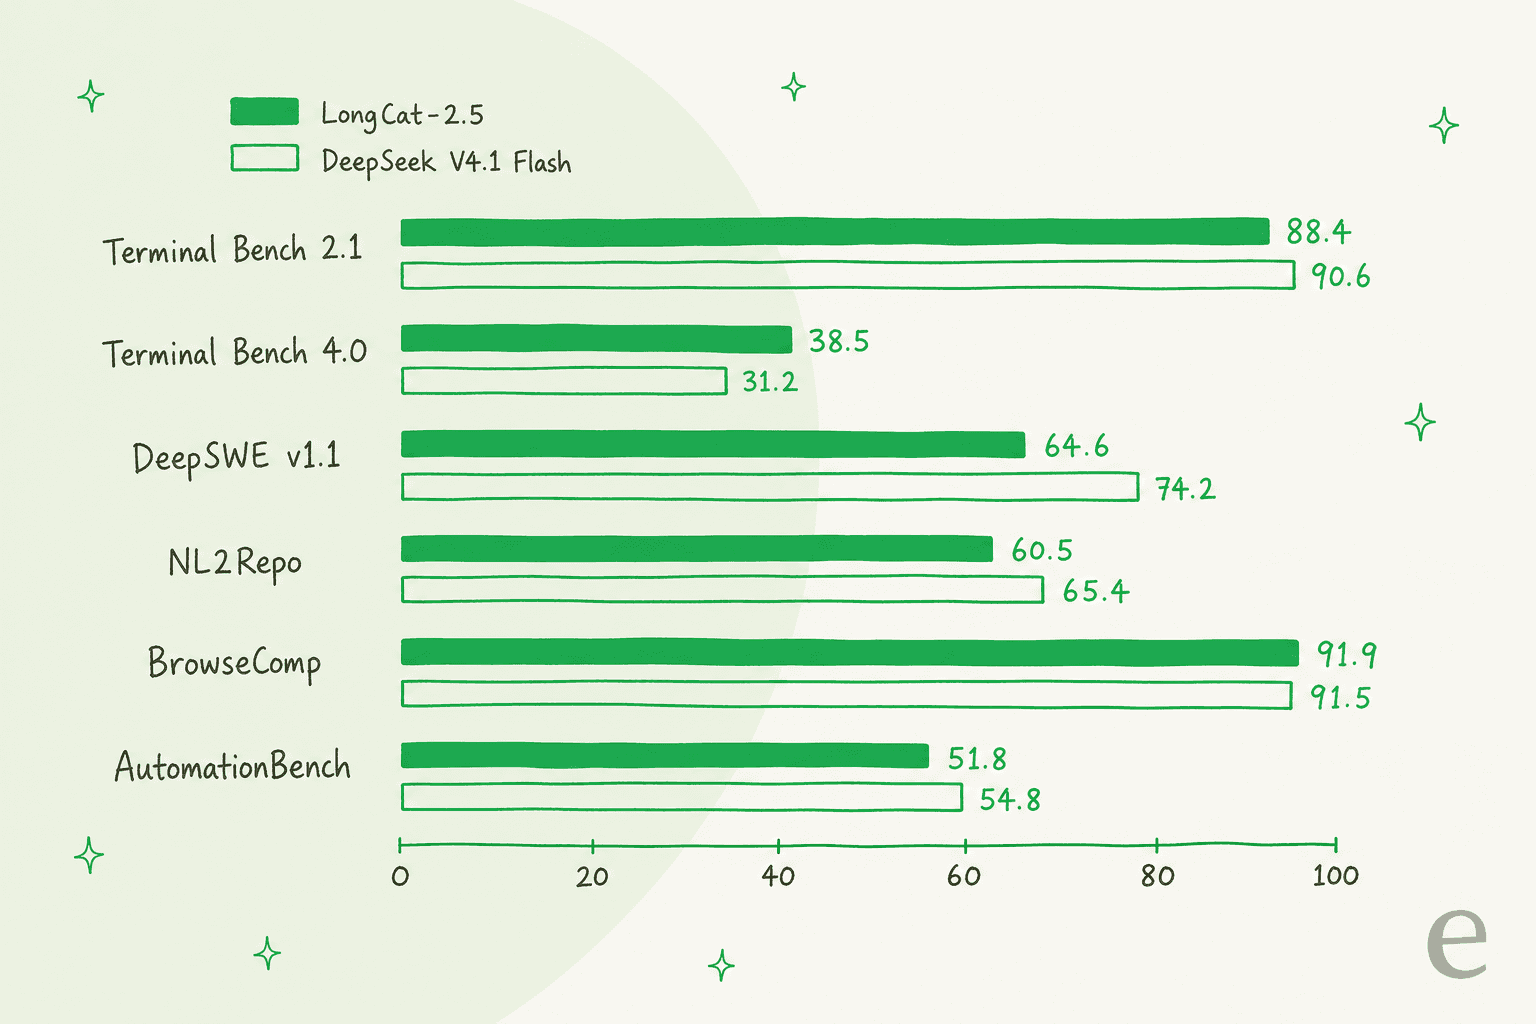
| Benchmark (tabela da Meituan) | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| VideoMME | 85.2 | - | - | 90.0 | - |
Fonte: blog técnico do LongCat-2.5. As pontuações de outros modelos misturam números que a Meituan extraiu de relatórios públicos com os de suas próprias execuções, que, segundo o blog, "are indicative only".
Lendo de forma direta: nas próprias linhas de programação da Meituan, o DeepSeek V4.1 Flash ganha mais do que perde. O LongCat 2.5 lidera em Terminal Bench 4.0, Program Bench, perguntas e respostas sobre bases de código do SWE Atlas e BrowseComp, e é o único dos dois com pontuações publicadas de vídeo. Nas tarefas de programação de longa duração que são o foco do lançamento, o modelo da DeepSeek, mais barato fora do horário de pico, está à frente.
Nenhuma avaliação independente chegou lá ainda. A Artificial Analysis lista apenas LongCat 2.0 e LongCat Flash Lite, e a API de modelos do OpenRouter retorna um modelo da Meituan, meituan/longcat-2.0. Uma comparação útil para identificar a diferença: a Artificial Analysis mediu o LongCat 2.0 em 50,2% no Terminal-Bench 2.1, enquanto a tabela da Meituan dá ao 2.0 uma pontuação de 70.8. Os ambientes de execução são diferentes, mas uma diferença de 20 pontos é motivo para fazer seu próprio teste em vez de confiar em qualquer uma das colunas.
Quanto custa o LongCat 2.5?
O LongCat 2.5 custa US$ 0,30 por milhão de tokens de entrada e US$ 1,20 por milhão de tokens de saída, com entrada em cache a US$ 0,006. Todos os números da página têm o rótulo "Discounted Price (limited-time)".
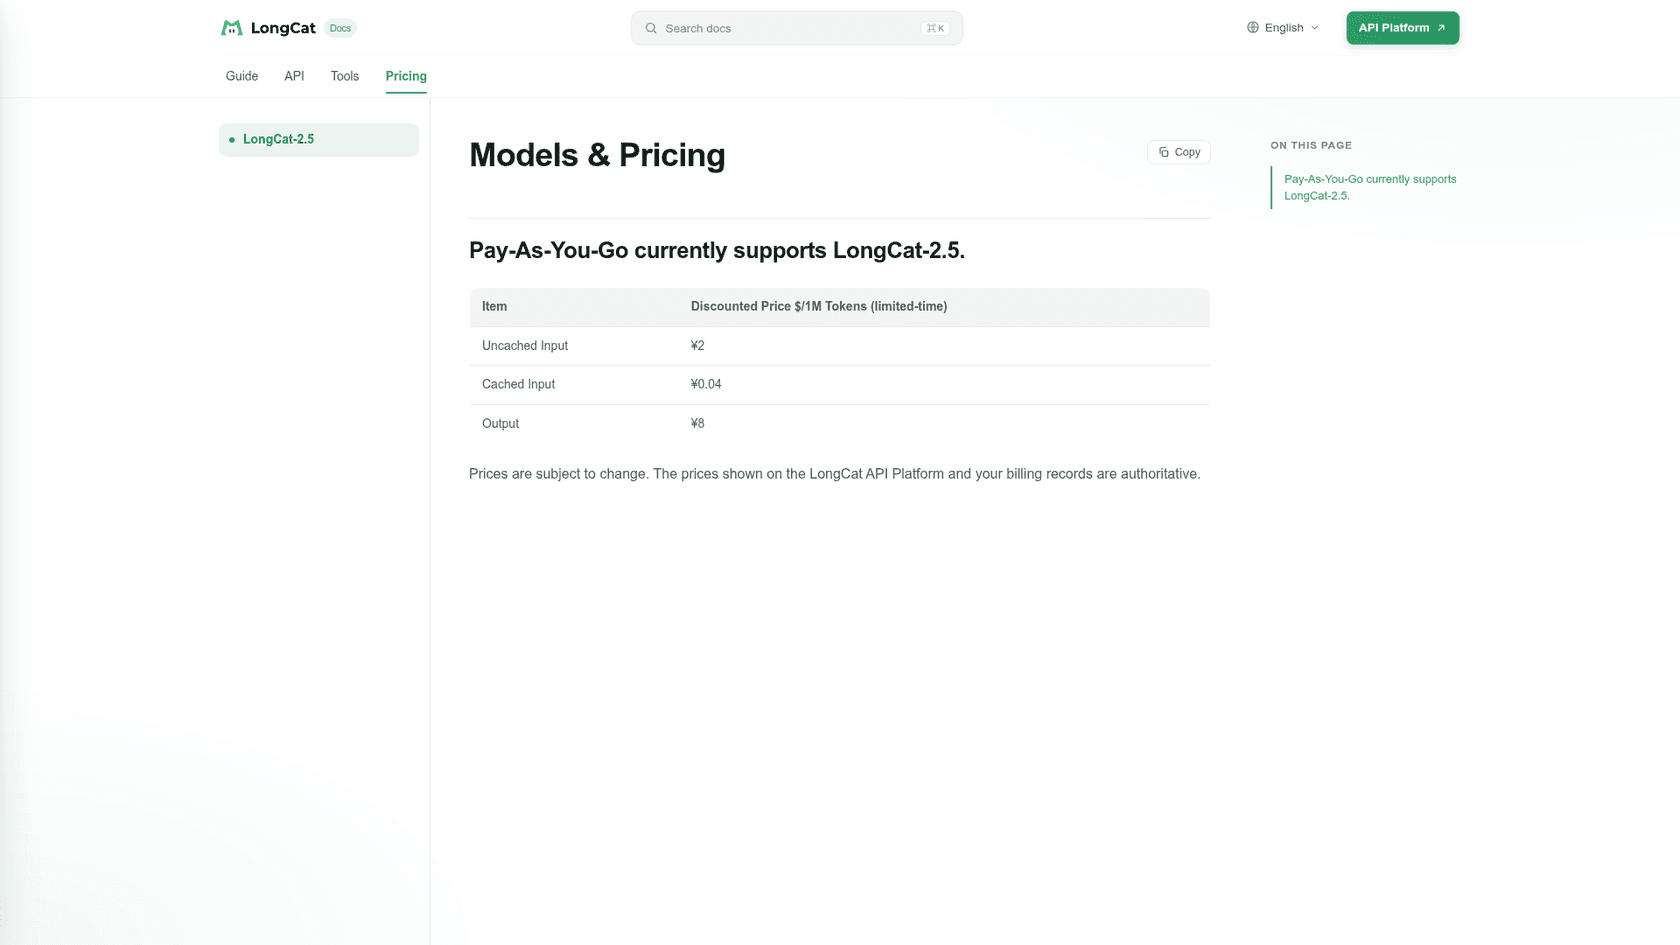
| Item | USD por 1M de tokens | CNY por 1M de tokens |
|---|---|---|
| Entrada sem cache | US$ 0,30 | ¥2 |
| Entrada em cache | US$ 0,006 | ¥0.04 |
| Saída | US$ 1,20 | ¥8 |
| Sobretaxa por tamanho do contexto | Nenhuma | Nenhuma |
| Sobretaxa por imagem ou vídeo | Nenhuma informada | Nenhuma informada |
Fonte: preços do LongCat-2.5 e API Pay-As-You-Go.
Duas coisas chamam a atenção. A entrada em cache custa 2% do preço sem cache, o que faz uma grande diferença para agentes de programação que reenviam os mesmos arquivos a cada turno. E não há faixas por tamanho, então uma solicitação de 900K tokens custa o mesmo por token que uma de 9K.
O exemplo calculado pela própria Meituan: uma solicitação com 600.000 tokens de entrada sem cache, 400.000 tokens de entrada em cache e 500.000 tokens de saída custa US$ 0,7824. Apenas chamadas bem-sucedidas (HTTP 200) são cobradas, o saldo pré-pago nunca expira e não há compromisso mínimo.
O que acontece quando o desconto acabar?
Ninguém sabe, e esse é o verdadeiro risco de preço. A página do 2.5 mostra apenas a coluna com desconto. Uma página antiga de preços do LongCat 2.0, sem links apontando para ela, ainda mostra o preço de tabela do 2.0 ao lado do mesmo desconto: US$ 0,75 de entrada, US$ 0,015 em cache e US$ 2,95 de saída. Se o 2.5 acabar adotando o preço de tabela do 2.0, o custo de saída sobe cerca de 2.5x. A Meituan não disse que isso vai acontecer, nem disse que não vai.
Como ele se compara em preço
| Modelo | Entrada / 1M | Em cache / 1M | Saída / 1M | Contexto / saída máxima | Página de preços do fornecedor |
|---|---|---|---|---|---|
| LongCat 2.5 (promocional) | US$ 0,30 | US$ 0,006 | US$ 1,20 | 1M / 128K | LongCat |
| DeepSeek V4.1 Flash (horário de pico) | US$ 0,30 | US$ 0,006 | US$ 1,20 | 1M / 384K | DeepSeek |
| DeepSeek V4.1 Flash (fora do horário de pico) | US$ 0,15 | US$ 0,003 | US$ 0,60 | 1M / 384K | DeepSeek |
| Qwen 3.8 Max | US$ 2,00 | US$ 0,25 | US$ 6,00 | 1M / 131K | QwenCloud |
| Kimi K3.1 Pro | US$ 2,00 | US$ 0,20 | US$ 10,00 | 1M | Kimi |
| Kimi K3 | US$ 3,00 | US$ 0,30 | US$ 15,00 | 1M | Kimi |
A linha interessante é a do DeepSeek. A tarifa promocional do LongCat 2.5 é idêntica, centavo por centavo, à tarifa de pico do DeepSeek V4.1 Flash, e o DeepSeek a reduz pela metade fora do horário de pico. Então o 2.5 não é barato de uma forma que nenhum outro seja. Ele é barato na mesma faixa do modelo econômico mais usado da categoria, que tem pontuações independentes, saída máxima maior e um guia de API publicado. A vantagem do LongCat sobre ele precisa vir da entrada de vídeo e da qualidade de programação que você mesmo medir.
Pagar por ele ficou mais fácil
As recargas do 2.0 aceitavam apenas Alipay e WeChat Pay, o que deixava de fora a maioria das equipes ocidentais. A página Pay-As-You-Go agora lista cartões de crédito e débito e Google Pay para o site em USD, e fora da China continental você pode se cadastrar por e-mail sem verificação de identidade. Os Token Packs (uma cota fixa válida por 30 dias, vendida em ofertas relâmpago às 10:00, 16:00, 21:00 e 23:00 no horário de Pequim) ainda existem, mas seus tamanhos e preços ficam no console, acessível após o login.
Empresas verificadas também recebem descontos por volume nos gastos com Pay-As-You-Go:
| Gasto mensal (site em USD) | Gasto mensal (site em CNY) | Desconto |
|---|---|---|
| US$ 75 ou mais | ¥500 ou mais | 10% de desconto |
| US$ 300 ou mais | ¥2.000 ou mais | 20% de desconto |
| US$ 1.200 ou mais | ¥8.000 ou mais | 30% de desconto |
| US$ 6.000 ou mais | ¥40.000 ou mais | 40% de desconto |
Fonte: perguntas frequentes do LongCat.
Como rodar o LongCat 2.5 no Claude Code ou no Codex?
Você aponta o ambiente de execução para o endpoint do LongCat no formato Anthropic ou OpenAI e define o nome do modelo como LongCat-2.5. O guia do Claude Code coloca isso em ~/.claude/settings.json:
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_longcat_api_key",
    "ANTHROPIC_BASE_URL": "https://api.longcat.chat/anthropic",
    "ANTHROPIC_MODEL": "LongCat-2.5",
    "ANTHROPIC_SMALL_FAST_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "LongCat-2.5",
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "131072",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}
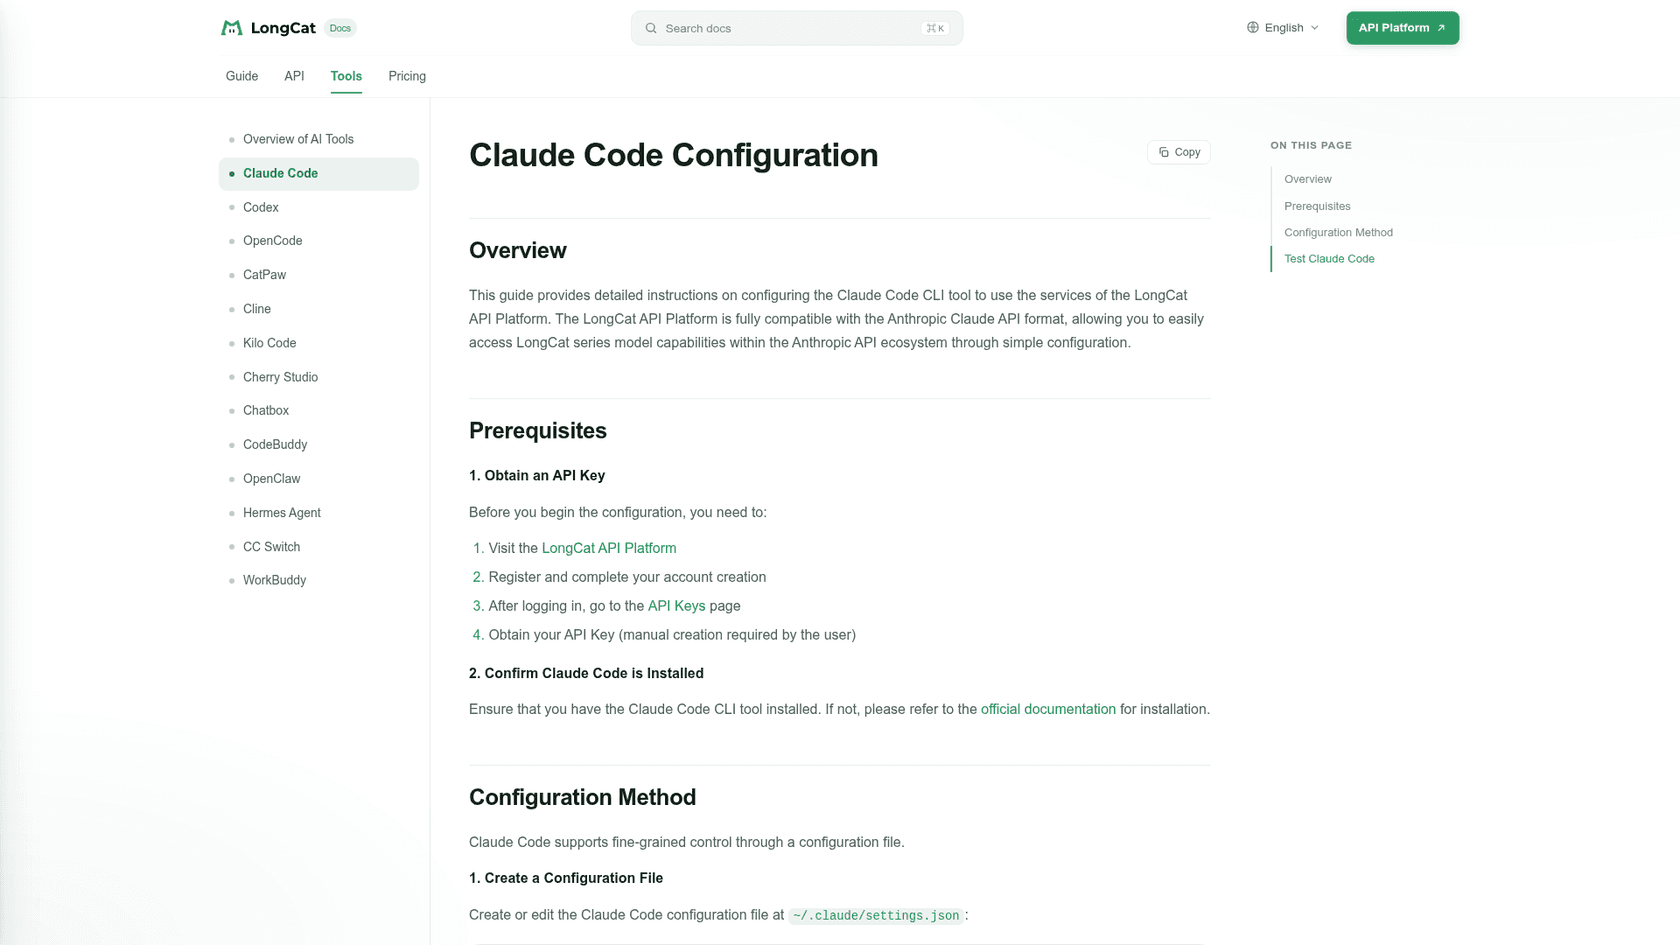
Observe que todos os campos de modelo apontam para o mesmo modelo, incluindo o "small fast" que o Claude Code normalmente usa para chamadas baratas em segundo plano. Isso não é um problema com saída a US$ 1,20, mas significa que você perde a diferença de velocidade que teria com um modelo realmente pequeno.
Para o Codex, você define model = "LongCat-2.5", model_reasoning_effort = "high", a URL base https://api.longcat.chat/openai/v1 e wire_api = "responses" em ~/.codex/config.toml, com a chave em ~/.codex/auth.json.
Três particularidades que eu procuraria conhecer antes da primeira execução:
- A temperatura é fixa. Ela é 1.0 com o raciocínio ativado e 0.7 com o raciocínio desativado, e outros valores são sobrescritos silenciosamente em vez de rejeitados (parâmetros do modelo). Se o seu ambiente de avaliação testa uma faixa de temperaturas, ele não está fazendo o que você pensa.
- Os limites de taxa não são publicados. Os limites são por chave de API e retornam um 429 com
retry_after: 60, mas nenhum valor de solicitações por minuto ou tokens por minuto aparece na visão geral da API. - IDs antigos de modelos podem desaparecer. LongCat 2.0 e 2.5-Preview saíram de todas as tabelas de modelos compatíveis sem um aviso de descontinuação com data. Se você fixou
LongCat-2.0, teste-o hoje.
Se você quer uma visão mais ampla dos agentes de programação no terminal antes de escolher um, o comparativo de CLIs de programação com agentes os compara lado a lado.
O que os desenvolvedores estão dizendo sobre o LongCat 2.5?
A prévia ficou gratuita no OpenCode por duas semanas, então há mais relatos de uso prático do que o normal para um modelo lançado há um dia. O tema mais recorrente é ficar preso em loops em tarefas longas.
"Longcat is fantastic until it get stuck in loops. I think around 200k tokens of context it loses it. I have been compacting and continuing."

Isso é coerente com a Meituan adicionar penalidades para "repetitive reasoning and repeated tool calls" no treinamento. Se a versão de disponibilidade geral corrigiu isso é a primeira coisa que eu testaria. O contraponto justo é que quem o manteve em uma função restrita gostou:
"Longcat is ok as cheap vision agent, tiny tasks, commit. But definitely not as planner, creative writing."
Um desenvolvedor rodou por conta própria a prévia gratuita no Terminal-Bench 2.1 e obteve 48,7% de pass@1, a maior eficiência no uso de tokens entre os quatro modelos que testou, com cerca de 0.54M de tokens por tentativa (r/opencode). Isso é uma prévia, com ambiente de execução e configuração diferentes dos usados para chegar aos 88.4 da Meituan, então encare como uma verificação de plausibilidade, não como um veredito.
No Hacker News, a discussão do lançamento se concentrou no preço e na escolha dos concorrentes:
"Same price as DS4.1F ... On benchmarks they seem comparable. The wild cards are the cache hit rate and speed."

"LongCat-2.5's chart skips Opus 5.5 and every current frontier model. This always happens, and people defend it because they say it's not fair to compare them. But it absolutely is!"
E um lembrete de que o chat para consumidores é menos refinado que a API: um comentarista do HN encontrou o link do chat do longcat.ai redirecionando para uma página de login em outro domínio, com respostas em mandarim por padrão. Se você testar apenas pelo aplicativo de chat, não estará testando o que a API entrega.
Você deve usar o LongCat 2.5 para suporte ao cliente?
Não como o modelo por trás de uma fila de suporte, pelo menos por enquanto. O motivo não é preço nem qualidade. São os dados. As perguntas frequentes e as páginas de cobrança do LongCat não dizem nada sobre por quanto tempo os prompts são mantidos ou se o tráfego da API é usado para treinamento. Quando um prompt contém o nome, o pedido e o endereço de um cliente, esse silêncio decide a questão, o mesmo impedimento que apontei na análise do 2.0.
Há um ponto maior também. Um modelo é infraestrutura. Para responder bem aos tickets, você também precisa das conexões com a base de conhecimento, das regras de escalonamento, do tom e de uma forma de verificar as respostas antes de os clientes vê-las. Isso exige muita construção em cima de uma API, que é a escolha discutida em desenvolver ou comprar para suporte com IA.
É essa lacuna que o eesel preenche. O eesel é uma plataforma de colegas de equipe de IA, e seu colega de equipe de helpdesk com IA se integra ao seu helpdesk existente, aprende com sua central de ajuda e seus tickets anteriores e responde na sua fila. Antes de entrar em operação, ele é testado nos seus tickets históricos para que você possa ler o que teria respondido. Já vi bots que pareciam confiantes darem respostas erradas em filas reais, e é exatamente por isso que toda implantação do eesel é simulada em tickets anteriores antes de tocar em um ticket em andamento.
A SE Ranking é um bom exemplo de como isso funciona na prática. Ela opera três produtos no Zendesk, com um agente eesel para cada um, e em um mês esses agentes atenderam 4.650 conversas, incluindo 2.100 chats ao vivo respondidos primeiro pelo eesel, usando cerca de 16.800 páginas de conhecimento. A SamCart usa um agente nos tickets do Freshdesk e outro no chat do site, respondendo com base em 280 artigos da central de ajuda.
E se você estava olhando para o LongCat 2.5 porque gosta de trabalhar pelo Claude Code ou pelo Codex, o eesel também está lá. A CLI do eesel (@eesel/cli) permite conectar um helpdesk, ler e editar as instruções permanentes do agente, aprovar ou negar ações e ler o que o agente fez em cada execução, tudo pelo terminal. Todo comando imprime JSON e as operações de escrita aceitam --dry-run, então um agente de programação pode operá-la com segurança, e cada workspace também é um servidor MCP que você pode adicionar ao Claude Code. O agente de programação configura o colega de equipe de suporte; ele não precisa se tornar um.
Quem deve usar o LongCat 2.5?
Minha opinião, depois de ler cada página que a Meituan publicou:
- Experimente se você usa agentes de programação com orçamento limitado e quer um que consiga ler capturas ou gravações de tela. A US$ 0,30 / US$ 1,20, com entrada em cache a 2%, uma tarde de testes no seu próprio repositório custa poucos dólares. Compare-o diretamente com o DeepSeek V4.1 Flash pelo mesmo preço.
- Espere se você precisa de pesos abertos, uma licença ou hospedagem própria. A Meituan diz que os pesos estão "coming soon", e mesmo assim um modelo de 1.6T precisa de um nó com várias GPUs. Hoje, o LongCat 2.0 é o único dos dois que você pode baixar.
- Deixe de lado por enquanto se seus prompts contêm dados de clientes ou dados sujeitos a regulamentação. Sem uma política publicada de retenção ou treinamento, não há sinal verde, seja qual for o preço.
- Escolha o DeepSeek no lugar se a tarefa inteira for programação de longa duração. Pelo mesmo preço, a própria tabela da Meituan coloca o DeepSeek V4.1 Flash à frente em DeepSWE, NL2Repo e Terminal Bench 2.1, e ele é mais barato fora do horário de pico. Se você precisa de pontuações medidas de forma independente, o Kimi K3.1 Pro e o Qwen 3.8 Max custam mais, mas já foram testados.
O resumo justo: o LongCat 2.5 é uma evolução real em relação ao 2.0, com visão integrada em vez de acoplada, a um preço que não mudou. Ele só não é a escolha óbvia na sua faixa de preço para programação pura, e a própria tabela de benchmarks é onde você pode ver isso.
Experimente o eesel
Se você chegou ao LongCat 2.5 esperando que um modelo barato tirasse tickets da sua equipe, pule a montagem da infraestrutura. O colega de equipe de helpdesk com IA do eesel se conecta ao Zendesk, Freshdesk, Gorgias e outros em minutos, aprende com seus tickets anteriores e mostra como teria respondido a eles antes de entrar em operação. Os planos começam em US$ 299 por mês, com uma opção gratuita para testar.

Experimente o eesel gratuitamente.