

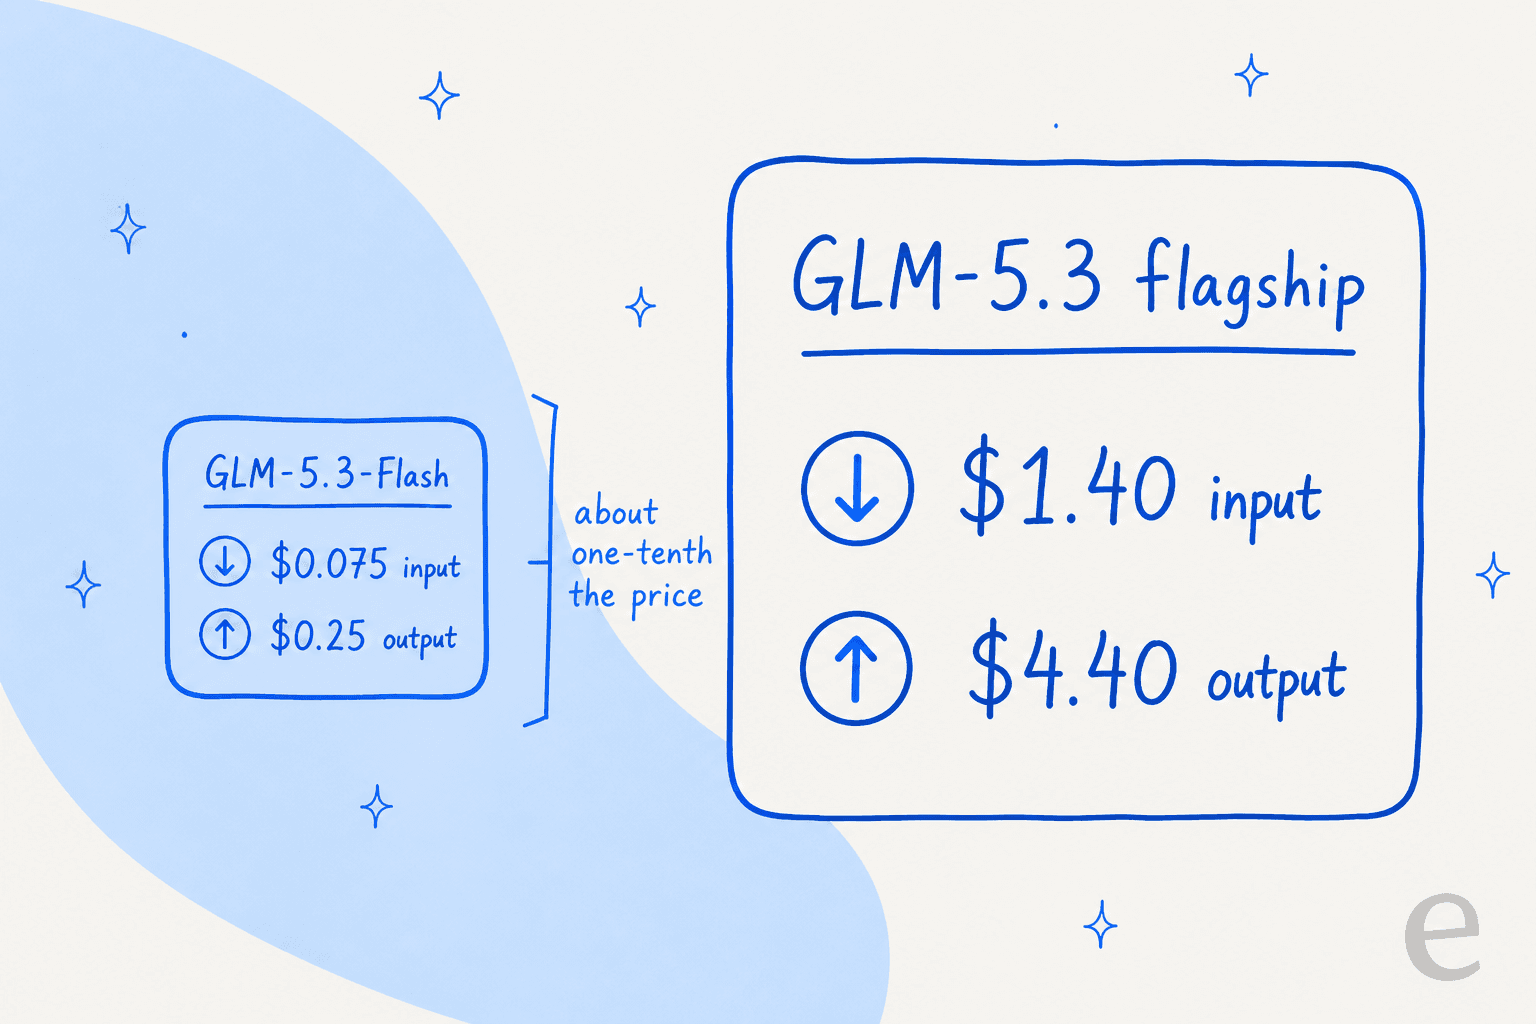
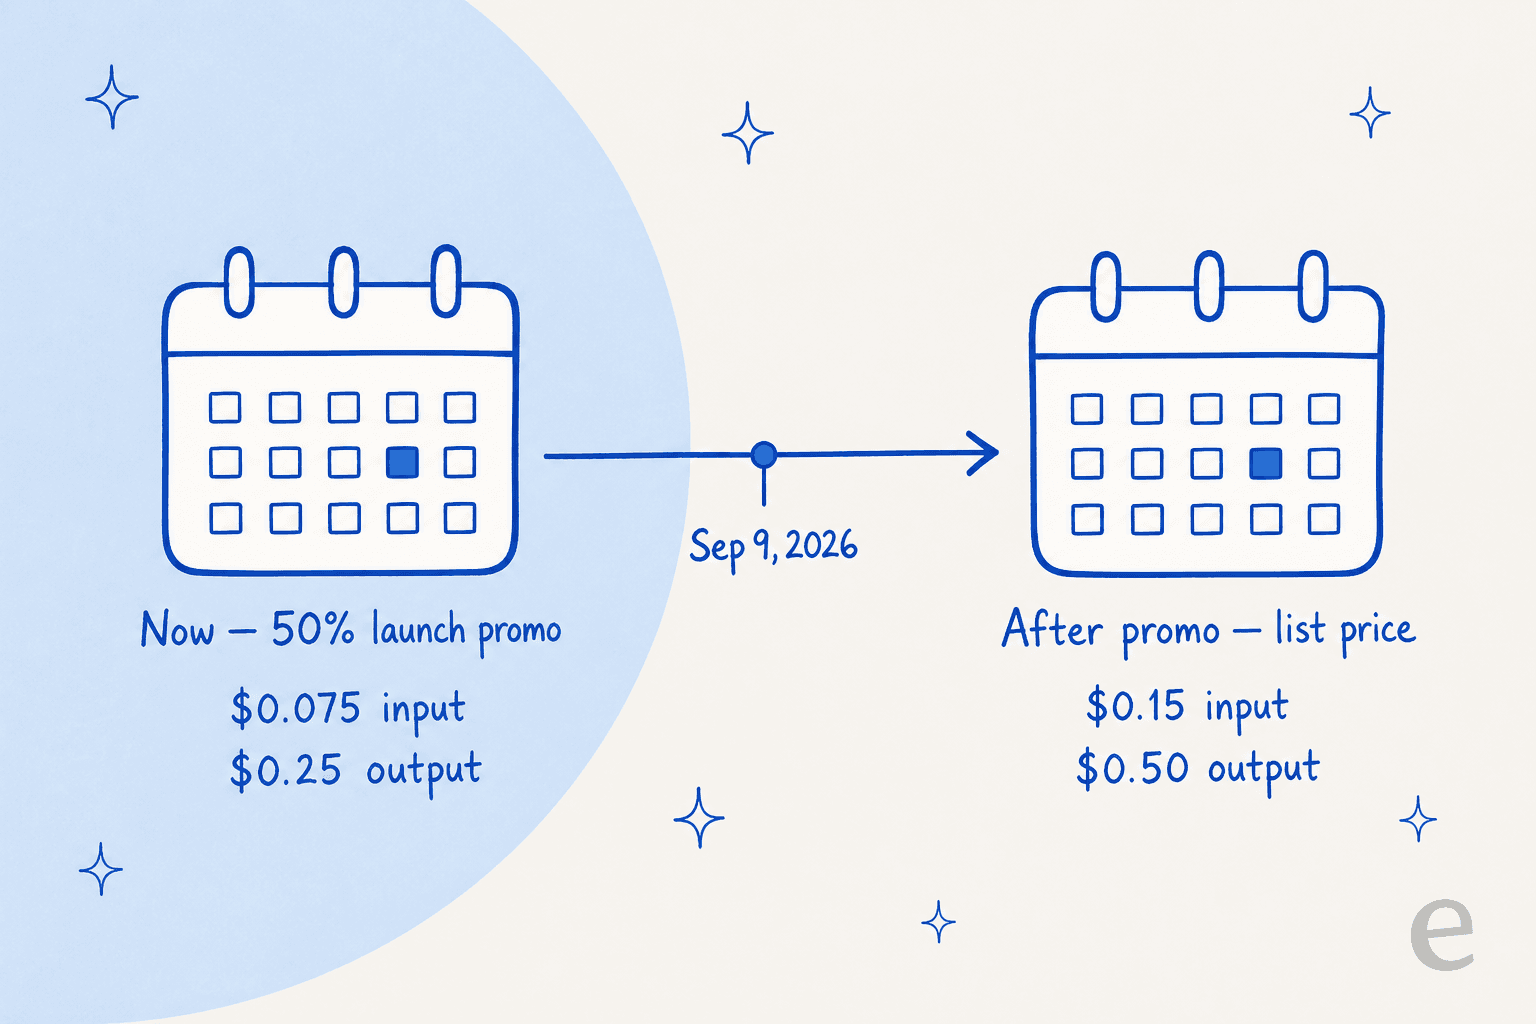
O GLM-5.3-Flash é o modelo GLM-5 mais barato da Z.ai, e o preço é a manchete. Com 50% de desconto de lançamento, ele custa $0.075 por milhão de tokens de entrada e $0.25 por milhão de tokens de saída, com entrada em cache a $0.015. A unidade cobrada são tokens simples, então não há surpresas por resolução nem por usuário. Duas coisas confundem as pessoas: a promoção termina em 9 de setembro de 2026, e depois disso todas as tarifas dobram para a tabela de $0.15/$0.50, e o GLM-5.3-Flash não é o modelo principal. O GLM-5.3 apenas de texto é outro modelo, a $1.40/$4.40, cerca de dez vezes o preço.
Se você prefere assinar a medir tokens, o GLM Coding Plan começa em $18/mês (Lite) e vai até $168/mês (Max) para uso dentro do Claude Code, do Cursor e de ferramentas parecidas.
Um detalhe que não está na etiqueta: na API da própria Z.ai o modelo é lento (~49 tokens/s). Provedores externos como a Databricks servem os mesmos pesos a 273 tokens/s, então onde você o executa muda o seu custo real tanto quanto a tabela de preços. E lembre-se de que uma tabela de preços compra tokens, não um sistema que funciona. Se você quer uma IA que realmente responda tickets ou escreva posts dentro das suas próprias ferramentas, essa é a camada de colega de equipe da eesel, que fica acima de modelos como este.
O resto deste post percorre a tabela completa, o penhasco da promoção, os planos de programação e alguns exemplos práticos para você ver quanto custa uma carga de trabalho real.
O GLM-5.3-Flash chegou em agosto de 2026 como o primeiro modelo nativamente multimodal da linha GLM-5 da Z.ai (Zhipu AI), e a reação online girou principalmente em torno de uma coisa: incredulidade diante do custo. A Artificial Analysis o estimou em cerca de $0.045 por tarefa, e threads do Reddit o comparavam favoravelmente a modelos várias vezes mais caros. Então vamos fazer o que os posts de lançamento não fizeram: mostrar exatamente o que você paga, onde estão as armadilhas e o que esse número realmente compra.
Aqui está a tabela real, como aparece na documentação de preços da Z.ai.
Preços do GLM-5.3-Flash num relance
O modelo é cobrado por uso, por milhão de tokens, dividido em entrada, entrada em cache e saída. Aqui está o quadro completo, com as tarifas promocionais primeiro e os preços de tabela ao lado.
| Item | Tarifa promocional | Tarifa de tabela | Observações |
|---|---|---|---|
| Entrada | $0.075 / M | $0.15 / M | Tokens de prompt padrão |
| Entrada em cache | $0.015 / M | $0.03 / M | ~80% menos que a entrada padrão |
| Armazenamento da entrada em cache | Grátis | Grátis | "Limited-time free" |
| Saída | $0.25 / M | $0.50 / M | Inclui tokens de raciocínio |
| Busca na web | $0.01 / uso | $0.01 / uso | Ferramenta integrada como complemento |
Fonte: a documentação de preços da API da Z.ai.
Alguns pontos merecem destaque. Os tokens de saída custam cerca de 3,3 vezes mais que os de entrada, e como o GLM-5.3-Flash é um modelo que só pensa (não dá para desligar o raciocínio), cada requisição gasta tokens de saída no raciocínio interno antes de responder. Isso é normal em um modelo de raciocínio, mas significa que a sua fatura mora na saída. Faça o orçamento pela tarifa de saída, não pela de entrada da manchete.
O outro detalhe é o que o GLM-5.3-Flash é: um modelo de mistura de especialistas com 320B de parâmetros totais e 18B ativos, uma janela de contexto de 1M de tokens e visão nativa. Para um modelo que lê imagens e guarda um milhão de tokens de contexto, um quarto de dólar por milhão de tokens de saída é surpreendentemente baixo.
Flash não é o modelo principal (e a diferença de preço é enorme)
Esta é a confusão mais comum, então vale ser direto. O GLM-5.3 e o GLM-5.3-Flash são dois modelos diferentes que por acaso dividem o número da versão.
- GLM-5.3-Flash é o irmão barato, multimodal e de alto desempenho. É o de $0.075/$0.25.
- GLM-5.3 (o modelo principal) é um modelo apenas de texto para programação e cibersegurança, e custa $1.40 de entrada / $4.40 de saída por milhão.
É uma diferença de aproximadamente dez vezes. Se você copia o preço de "GLM-5.3" de um lugar e uma estimativa de tokens de outro, pode errar por uma ordem de grandeza. A descrição da Cloudflare sobre o Flash é o melhor resumo: ele "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price."
Então, ao precificar uma carga de trabalho, a primeira pergunta não é "quantos tokens?", e sim "qual GLM-5.3 eu estou realmente chamando?". Para a maioria das tarefas que não são de programação (chat, extração, visão, resumo), o Flash é o que você quer, e o assunto deste post. Se você faz programação de ponta ou pesquisa de segurança, o modelo principal existe, mas você paga tarifas de modelo principal.
O penhasco da promoção: os preços dobram em 9 de setembro
Os números $0.075/$0.25 são um desconto de lançamento de 50%, não o preço permanente. Segundo a documentação de preços da Z.ai, a promoção termina às 24:00 de 9 de setembro de 2026 (UTC+8, horário de Singapura). Depois disso, a tabela volta aos $0.15 de entrada / $0.50 de saída.
Mesmo dobrado, o GLM-5.3-Flash continua barato por qualquer critério razoável, então não é motivo de pânico. Mas se você está montando um modelo de custos para um produto que lança depois de setembro, use os preços de tabela, não os promocionais. Um orçamento baseado em $0.075 que silenciosamente precisa de $0.15 parece ótimo na planilha e dói na primeira fatura pós-promoção.
Entrada em cache e o complemento de busca na web
Duas alavancas menores mudam a sua tarifa efetiva.
A entrada em cache é a grande. Se os seus prompts compartilham um prefixo grande e estável (um prompt de sistema, uma base de conhecimento, um documento longo sobre o qual você faz muitas perguntas), a parte repetida é cobrada pela tarifa de cache de $0.015/M durante a promoção, cerca de 80% abaixo da tarifa de entrada padrão. Em cargas com muita reutilização de prompt, é a diferença entre uma boa fatura e uma ótima. O armazenamento da entrada em cache também é gratuito por enquanto.
A busca na web é uma ferramenta integrada cobrada à parte, a $0.01 por uso. É barata, mas é medida por chamada, então um agente que pesquisa a cada turno soma de um jeito que as tarifas por token não mostram. Vale ficar de olho se você a colocar em um loop.
O GLM Coding Plan: uma assinatura em vez de medir tokens
Se você usa o GLM principalmente dentro de uma ferramenta de programação, a Z.ai vende uma assinatura fixa que evita totalmente a medição de tokens. O GLM Coding Plan executa o GLM-5.3 e o GLM-5.3-Flash dentro do Claude Code, Cline, OpenCode, Cursor, Roo Code, Kilo Code e mais de 20 outras ferramentas de agentes.
Aqui estão os níveis individuais, com a tarifa mensal efetiva se você pagar anualmente.
| Plano | Mensal | Anual (efetivo /mês) | Créditos semanais | Uso relativo |
|---|---|---|---|---|
| Lite | $18/mês | $12.60/mês | 10,000 | 1x |
| Pro | $80/mês | $56.00/mês | ~60,000 | 6x Lite |
| Max | $168/mês | $117.60/mês | ~140,000 | 14x Lite |
Também há dois níveis para equipes: um Standard Seat a $88/assento/mês (66,000 créditos semanais) e um Premium Seat a $188/assento/mês (155,000 créditos semanais, mais acesso antecipado a modelos), segundo a página de assinatura da Z.ai.
A mecânica recompensa a paciência. Os créditos são gastos por um multiplicador por modelo (o GLM-5.3-Flash custa muito menos por token que o modelo principal), e o uso fora do horário de pico é cobrado a 50% da taxa padrão de créditos. O pico é apenas de segunda a sexta, das 14:00 às 18:00 no horário de Singapura, então a maior parte da semana é fora de pico. A Z.ai afirma que apoiar-se no horário fora de pico pode economizar até 92% em relação a chamadas de API do modelo principal pagas por uso. É um número do fornecedor, então trate-o como um teto, não como uma promessa, mas a direção é real: a assinatura mira diretamente o uso intenso e diário de programação.
Os planos de programação são o que a maioria imagina ao pensar no GLM em ação: um modelo triturando refatorações e migrações dentro de um agente.
O custo oculto: qual provedor você escolhe
Aqui está a parte que a tabela de preços não conta. O GLM-5.3-Flash tem pesos abertos, então você pode executá-lo em muitos lugares, e o desempenho varia muito entre eles. Na API própria da Z.ai, a saída roda a cerca de 49 tokens por segundo, o que um thread do Reddit chamou de "one of the slowest models AA has ever" avaliado. Os provedores externos são outra história.
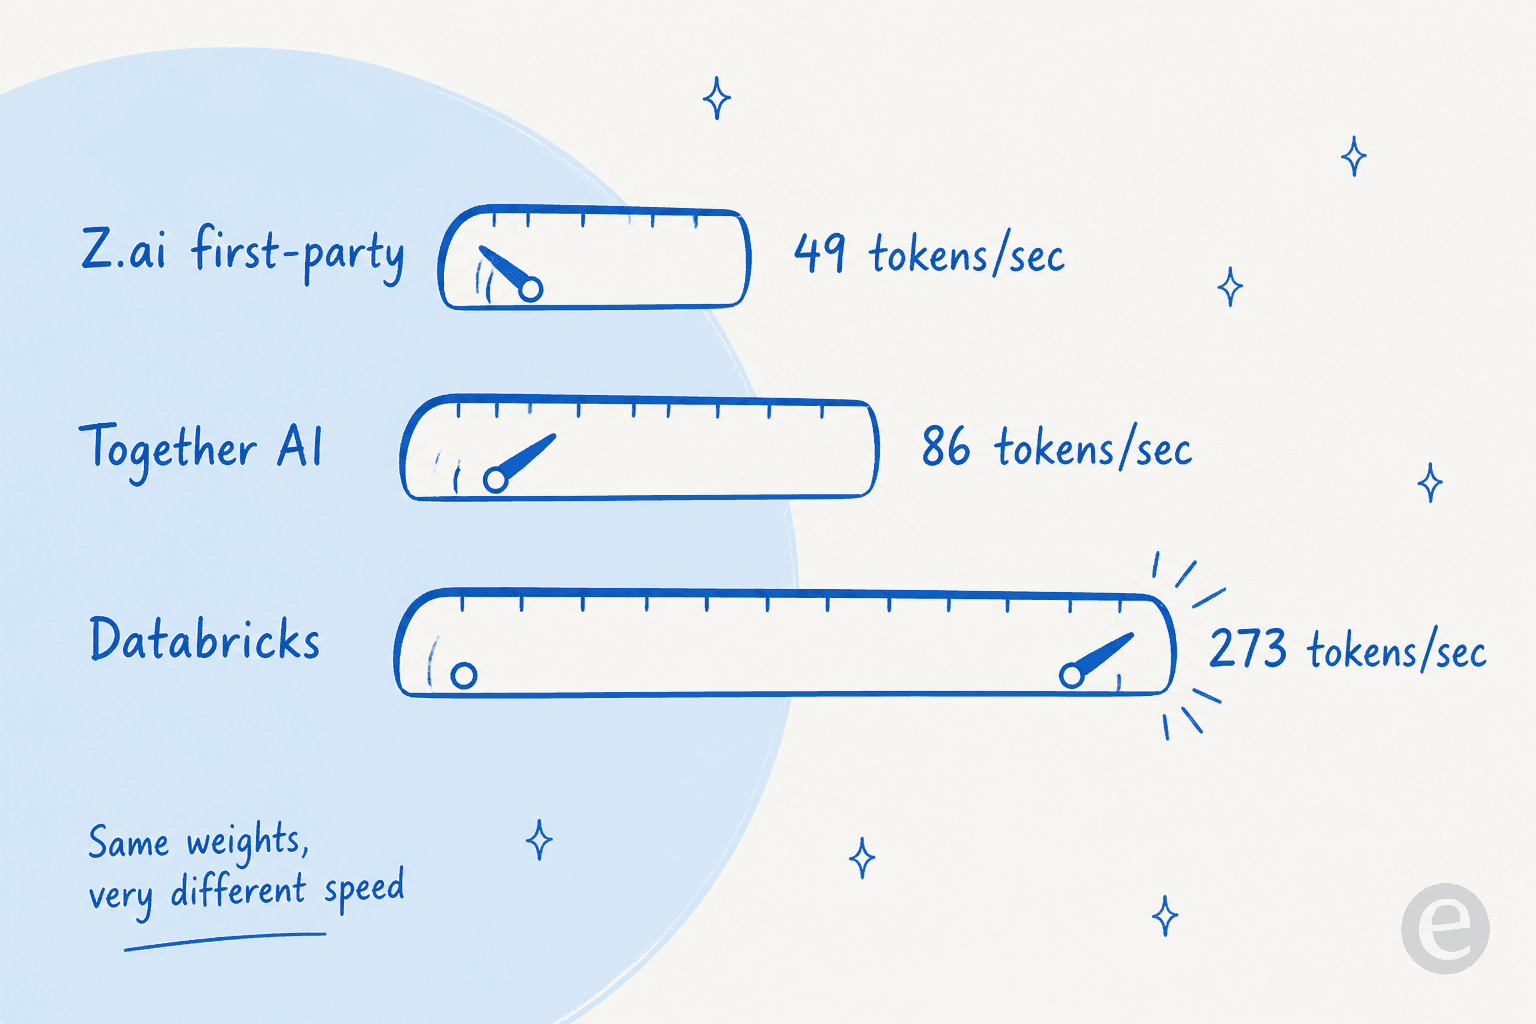
Segundo a Artificial Analysis, entre onze provedores de API, a Databricks serve o GLM-5.3-Flash a 272.9 tokens/s com a menor latência (8 segundos até o primeiro token), enquanto os menores preços de tabela vêm da GMI e da Bitdeer, em torno de $0.05. O ponto não é que um provedor seja o melhor. É que "os preços do GLM-5.3-Flash" são, na verdade, uma matriz de preço e velocidade, e para qualquer coisa voltada ao usuário, o desempenho também é um custo. Um modelo que custa metade, mas é cinco vezes mais lento, pode acabar mais caro quando você conta a latência que seus usuários (ou seus agentes) enfrentam.
Se você quer o piso de preço puro, o provedor próprio ou a GMI. Se quer velocidade a uma tarifa razoável, um provedor como a Databricks. Escolha o provedor conforme o seu gargalo seja dólares ou segundos.
O que o preço baixo realmente compra
Barato só é bom se o resultado for utilizável, então vale ancorar o número no que o modelo consegue fazer. No Artificial Analysis Intelligence Index, o GLM-5.3-Flash marca 57, contra 60 do GLM-5.3 completo, o que o coloca bem na fronteira de preço e inteligência. Os testadores confirmaram isso em casos específicos.
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Sobre a nova capacidade de visão, um testador rodou 1,500 amostras e relatou 81% de precisão, chamando-a de razoável para um primeiro lançamento multimodal. E a reação ao preço frente aos concorrentes foi o tema mais forte de todos.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Para uma leitura mais completa das capacidades, nossa visão geral do GLM-5.3-Flash aprofunda a arquitetura e os benchmarks, e se você está fazendo uma lista curta por custo, vale lê-la ao lado das nossas análises de preços do DeepSeek e preços do Kimi K2.5. Mas, para fins de preço, a conclusão é simples: o modelo não é barato por ser fraco. É barato porque a Z.ai precificou de forma agressiva um MoE de 18B ativos e ainda subsidia o lançamento.
Um exemplo prático: quanto custa uma carga de trabalho real
Tarifas por milhão de tokens são difíceis de sentir, então insira os seus próprios números. Esta calculadora usa as tarifas promocionais ($0.075 de entrada, $0.25 de saída); use o seletor para ver o preço de tabela pós-setembro.
Para dar contexto aos valores padrão: um assistente de porte médio que processa 500M de tokens de entrada e 150M de saída por mês fica perto de $75/mês nas tarifas promocionais, ou cerca de $150/mês quando o preço de tabela entra em vigor. Mesmo na tabela, isso é um erro de arredondamento perto das ferramentas de IA cobradas por usuário, e é exatamente por isso que o modelo fez barulho. O ponto a internalizar é que o seu volume de saída, aumentado pelo raciocínio de um modelo que só pensa, é o botão que realmente move o número. Se o seu objetivo é conteúdo e não tokens brutos, nossa análise do melhor LLM para escrever blogs pesa qualidade e custo da mesma forma.
Experimente a eesel: o modelo é o motor, a eesel é o colega de equipe
Aqui vai o enquadramento honesto. O GLM-5.3-Flash é uma infraestrutura fantástica. Mas uma tarifa de $0.075 por milhão de tokens não é a resposta a um ticket de suporte nem um post pronto, assim como um barril de petróleo não é uma viagem de carro. Acesso bruto ao modelo ainda deixa você construir a recuperação de informação, as proteções, as integrações, os testes e a engrenagem do "o que acontece quando ele erra".
A eesel fica uma camada acima. Em vez de tokens, você contrata colegas de equipe de IA prontos para trabalhar: um colega de IA para o helpdesk que entra na sua fila existente do Zendesk, Freshdesk ou Gorgias e redige ou envia respostas, e um redator de blog com IA que pesquisa e escreve posts de SEO de ponta a ponta. Cada um já chega conhecendo a sua central de ajuda e os tickets anteriores, e entra no ar em minutos, não num sprint de código de ligação.
O diferencial que mais importa para quem tem receio de entregar tickets a uma IA: a eesel permite simular um colega de equipe com os seus tickets históricos reais antes que ele toque em um cliente ao vivo, então você vê a taxa de resolução e as respostas de antemão, em vez de virar uma chave e torcer. Modelos como o GLM-5.3-Flash tornam os tokens baratos; a eesel é o que os transforma em um colega de equipe em quem você pode realmente confiar na fila. É grátis para testar, sem cartão de crédito e sem ligação de vendas para começar.