

O Mercury 3 custa $0.10 por milhão de tokens de entrada e $0.35 por milhão de saída no lançamento, com a entrada em cache a $0.01. São 50% de desconto sobre o preço de tabela real de $0.20 / $0.70 / $0.02, e a Inception não disse quando ele termina. Contas novas recebem 100 milhões de tokens gratuitos.
No preço de lançamento, é o modelo mais barato da sua classe em todas as tarefas que precifiquei. No preço de tabela, custa cerca de 1,6 a 1,8 vez o que custam o GPT-6 Luna e o Claude Haiku 5.5 em prompts curtos, porque a saída é $0.70 contra os $0.50 deles. Na tabela, ele só ganha em prompts longos: supera o Haiku 5.5 depois de 100K tokens e praticamente empata com o Luna depois de 272K, porque o Mercury 3 cobra a mesma tarifa até 1M. Faça o orçamento pela tabela e trate o desconto como bônus.
Se você está precificando o Mercury 3 para um bot de suporte, lembre-se de que os tokens são a linha pequena. Um mês de 10.000 tickets no Mercury 3 custa bem menos de $100 em tokens e semanas de engenharia em tudo o que está em volta. É essa a lacuna que o teammate de helpdesk com IA da eesel preenche, por um preço mensal fixo por ticket, com a integração e os testes já prontos.
Por que precifiquei por tarefa, e não por token
Eu construo integrações e APIs para viver, e a primeira coisa que faço com qualquer modelo novo é ler o objeto usage que ele devolve. Uma tarifa por milhão de tokens é só a etiqueta. O que você realmente paga depende de quantos tokens uma tarefa consome, quantos deles estão em cache e quantos são tokens de raciocínio que você nunca vê. Então, para este artigo, precifiquei o Mercury 3 do jeito que faria antes de ligá-lo a qualquer coisa: por tarefa, no lançamento e na tabela, contra os modelos que ele persegue.
Há um segundo motivo para olhar assim. A eesel há anos roda modelos de IA em filas de suporte reais, e a conta por token nunca foi a parte cara dessas implantações. O caro é tudo o que cerca o modelo. Voltarei a isso no final, com números reais de um dos nossos clientes.
Se você quer primeiro a história de velocidade e benchmarks, minha visão geral do Mercury 3 explica o que é o modelo e quão rápido ele roda. Este artigo trata só do dinheiro.
Quanto custa o Mercury 3?
Esta é a tabela de preços da própria Inception, da página de modelos e da documentação dos modelos, conferida em 20 de outubro de 2026.
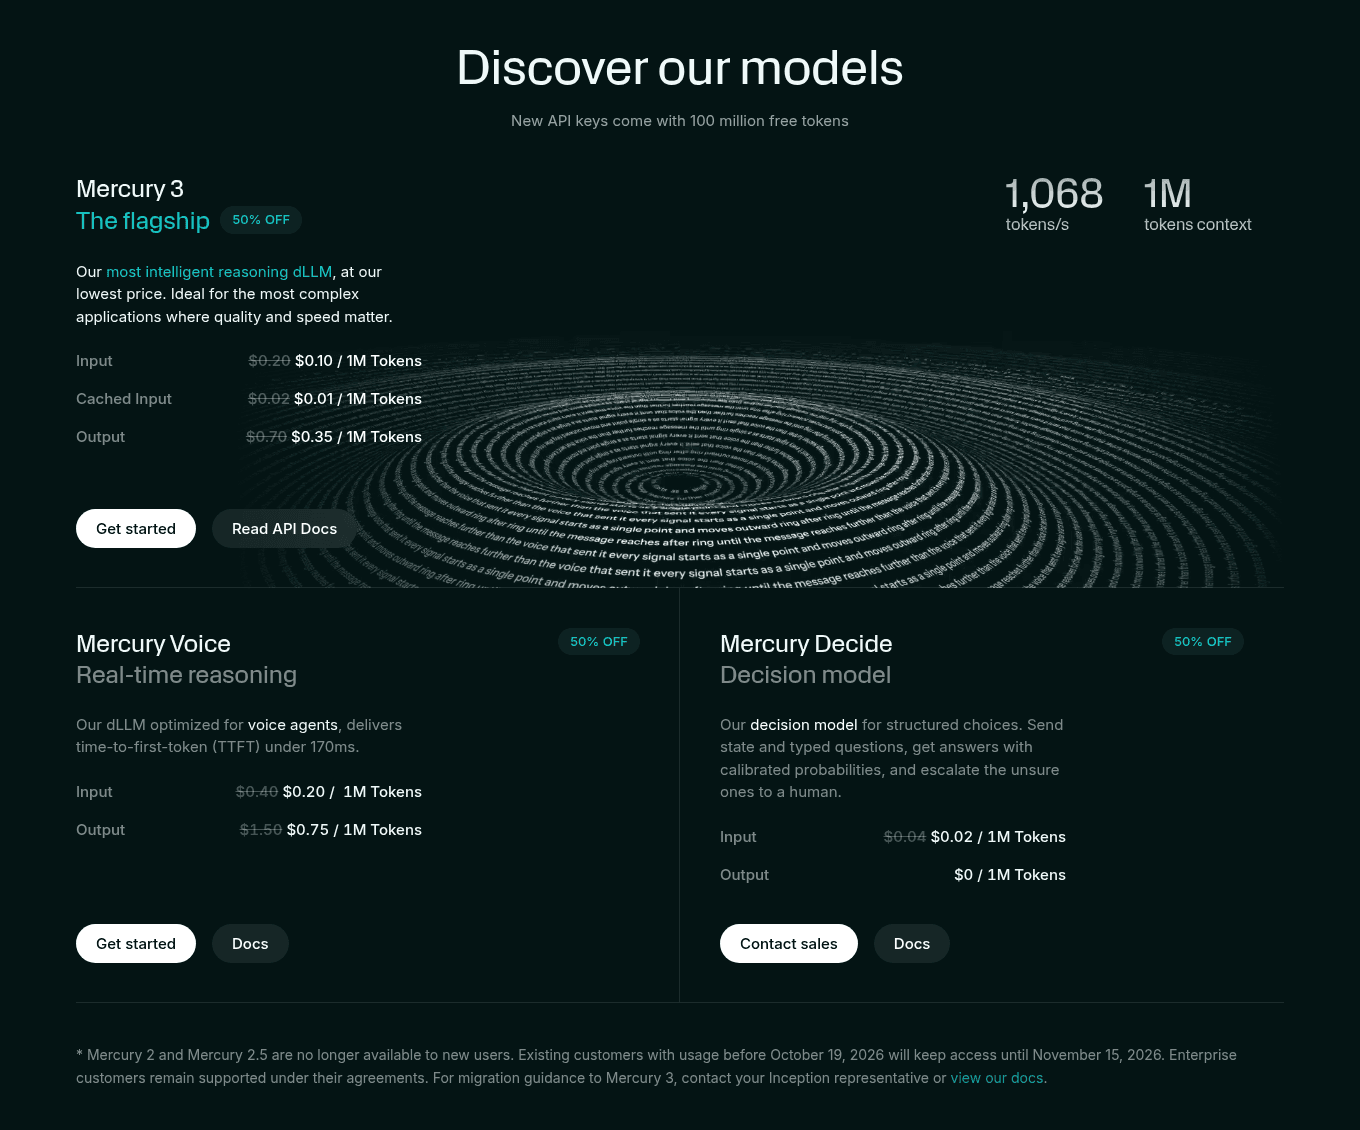
| Modelo | Entrada (tabela → lançamento) | Entrada em cache | Saída (tabela → lançamento) | Contexto | Saída máx. |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | 131,072 |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | 50,000 |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (não cobrado) | n/d | n/d |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | 8,192 |
| Mercury 2.5 (sendo encerrado) | $0.20 | $0.02 | $0.75 | 260K | 65,536 |
| Mercury 2 (sendo encerrado) | $0.25 | $0.025 | $0.75 | 128K | 50,000 |
Todos os preços são por milhão de tokens. Algumas coisas que a tabela não diz sozinha:
- A unidade cobrada é o token simples. A FAQ da Inception diz que os tokens de raciocínio são contados dentro dos tokens de completion e cobrados pela tarifa de saída, e que os tokens em cache são um subconjunto dos tokens do prompt cobrados pela tarifa de cache. Não há taxa por requisição.
- O esforço de raciocínio é definido por requisição. O Mercury 3 aceita
instant,low,mediumouhigh, e segundo a documentação de raciocínio ele usalowpor padrão se você não definir. Os benchmarks da própria Inception rodaram todos em medium, então, se você copiar as configurações deles, espere mais tokens de saída do que no padrão. - O Mercury Voice é só para enterprise via API, segundo a documentação, e o Mercury Decide é um endpoint separado de classificação que cobra apenas a entrada.
Os três planos de acesso
Além dos preços por token, a Inception vende o acesso em três planos. Eles mudam seus limites de taxa e o suporte, não o preço do token.
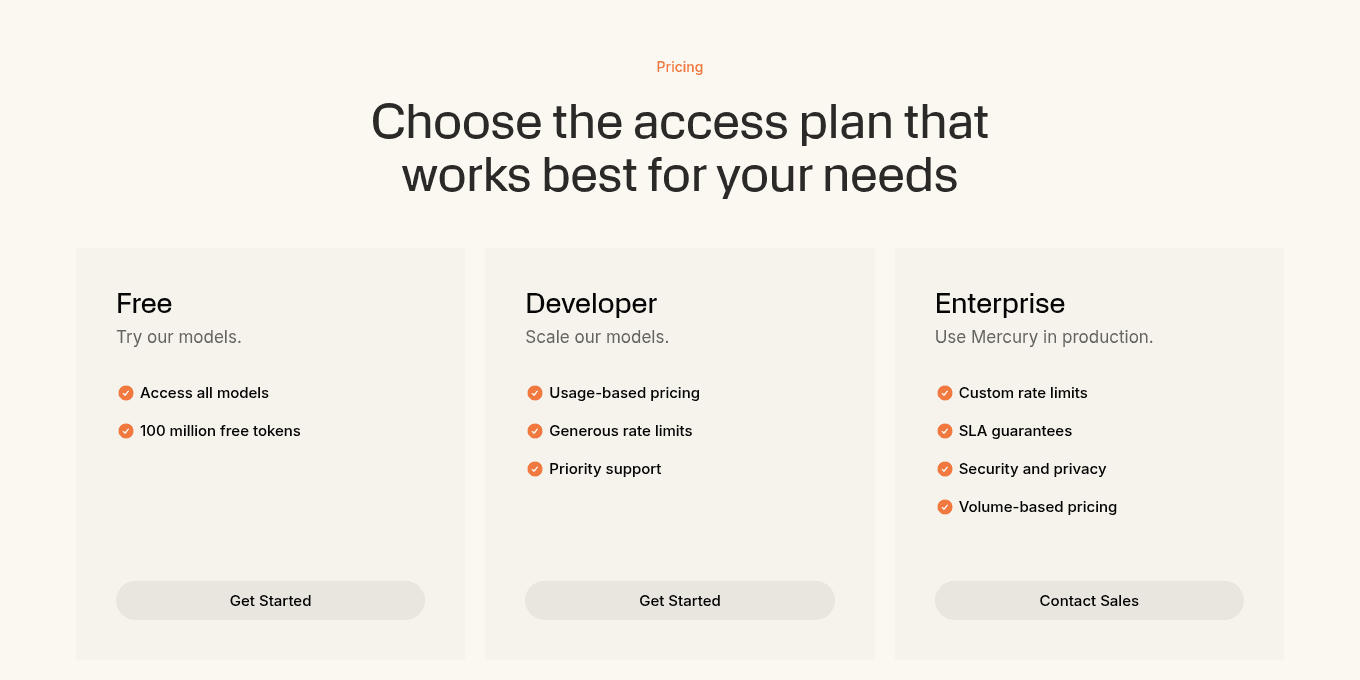
| Plano | O que você paga | Requisições por minuto | Tokens de entrada por minuto | Tokens de saída por minuto |
|---|---|---|---|---|
| Free | 100M de tokens gratuitos, uma única vez | 1,000 | 1,000,000 | 100,000 |
| Developer (pague pelo uso) | Por uso, tabela de preços acima | 3,000 | 3,000,000 | 300,000 |
| Enterprise | Preços por volume | Personalizado | Personalizado | Personalizado |
Os limites vêm da página de limites de taxa da Inception. O crédito gratuito é uma concessão única compartilhada entre todos os modelos, não uma franquia mensal, segundo a FAQ. Quando ele acaba, você adiciona um cartão em cobrança e segue com as tarifas por uso.
O que o desconto de lançamento de 50% realmente significa
O desconto é o fato de preço mais importante sobre o Mercury 3, e o menos especificado. Tanto a página de modelos quanto a documentação dizem que o Mercury 3 está com "50% off at launch". Nenhuma das duas dá data de término, limite de tokens ou prazo de aviso.
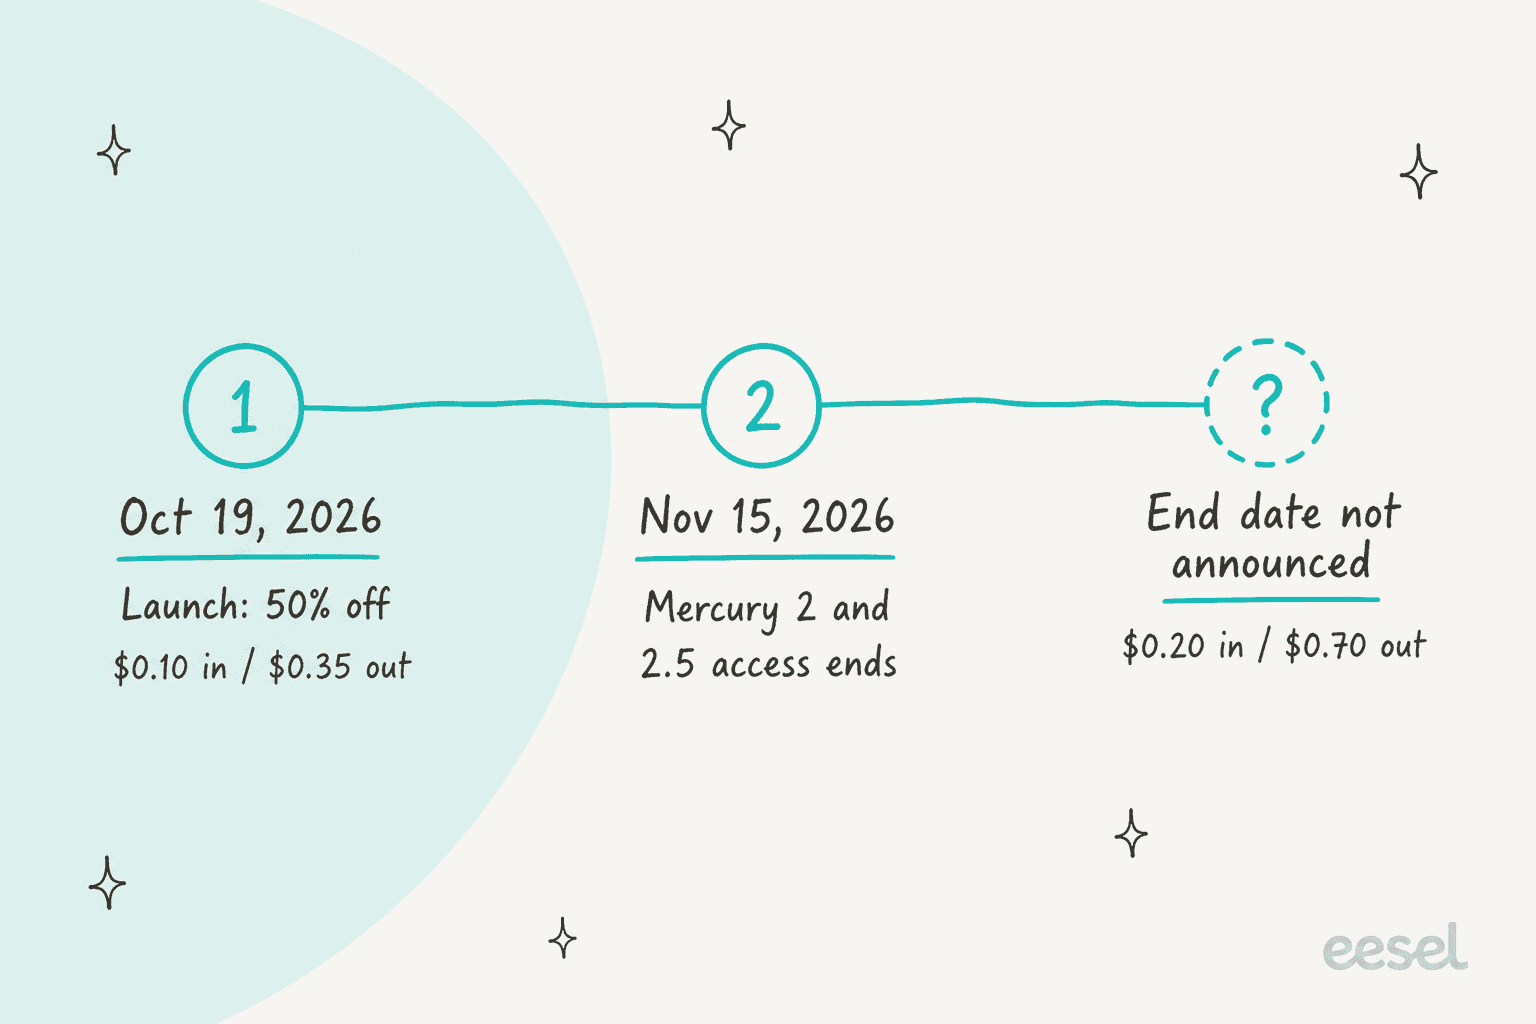
Isso é incomum para esta faixa. A página de preços do Gemini do Google também tem uma promoção no Gemini 3.8 Flash, mas data as duas pontas: $0.75 de entrada e $3.75 de saída até 31 de dezembro de 2026, e depois $1.50 e $7.50 a partir de 1º de janeiro de 2027. Com o Mercury 3 você conhece o preço depois, mas não a data, então qualquer orçamento montado sobre $0.35 de saída tem um buraco. Os primeiros usuários notaram:
"I'm going to start using this instead of Haiku/GPT-Luna for tasks that require speed. I'm wondering if it'll still be useful once the discount is lifted?"

Duas boas notícias vêm junto. Primeiro, o cofundador da Inception disse no mesmo tópico que o modelo "runs in our API at reasonable costs", que é a explicação dele para os preços de lançamento. Outro comentarista rebateu que o preço "can always be set at a loss", e não há dados públicos nem num sentido nem noutro.
Segundo, se você já é cliente do Mercury, o preço de tabela ainda é uma pequena economia. O Mercury 2.5 custa hoje $0.20 de entrada e $0.75 de saída, então o Mercury 3 na tarifa cheia de saída de $0.70 é mais barato que o modelo que ele substitui, com quase quatro vezes mais contexto. Usuários do Mercury 2 economizam também na entrada. Clientes atuais mantêm o acesso ao Mercury 2 e 2.5 até 15 de novembro de 2026, então essa migração tem prazo, mesmo que o desconto não tenha.
Mercury 3 vs. GPT-6 Luna, Haiku 5.5, DeepSeek e Gemini Flash
A Inception posiciona o Mercury 3 contra o GPT-6 Luna e o Claude Haiku 5.5. Acrescentei o DeepSeek V4.1 Flash, com o qual os testadores do Hacker News o compararam, e o Gemini 3.8 Flash como a opção do Google. Todos os preços abaixo vêm da própria página de cada fornecedor.
| Modelo | Entrada | Entrada em cache | Saída | Regra para prompts longos | Fonte |
|---|---|---|---|---|---|
| Mercury 3 (lançamento) | $0.10 | $0.01 | $0.35 | Fixo até 1M | Inception |
| Mercury 3 (tabela) | $0.20 | $0.02 | $0.70 | Fixo até 1M | Inception |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Acima de 272K: 2x entrada, 1,5x saída | OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | Acima de 100K: $0.50 / $2.50 | Anthropic |
| DeepSeek V4.1 Flash | $0.15 | $0.003 | $0.60 | Fixo até 1M; horário de pico 2x | DeepSeek |
| Gemini 3.8 Flash | $0.75 | $0.075 | $3.75 | Promoção até 31 dez. 2026, depois 2x |
Por milhão de tokens, nível padrão. Os números do DeepSeek são fora do pico; no horário de pico (01:00 às 04:00 e 06:00 às 10:00 UTC em dias úteis) custa o dobro.
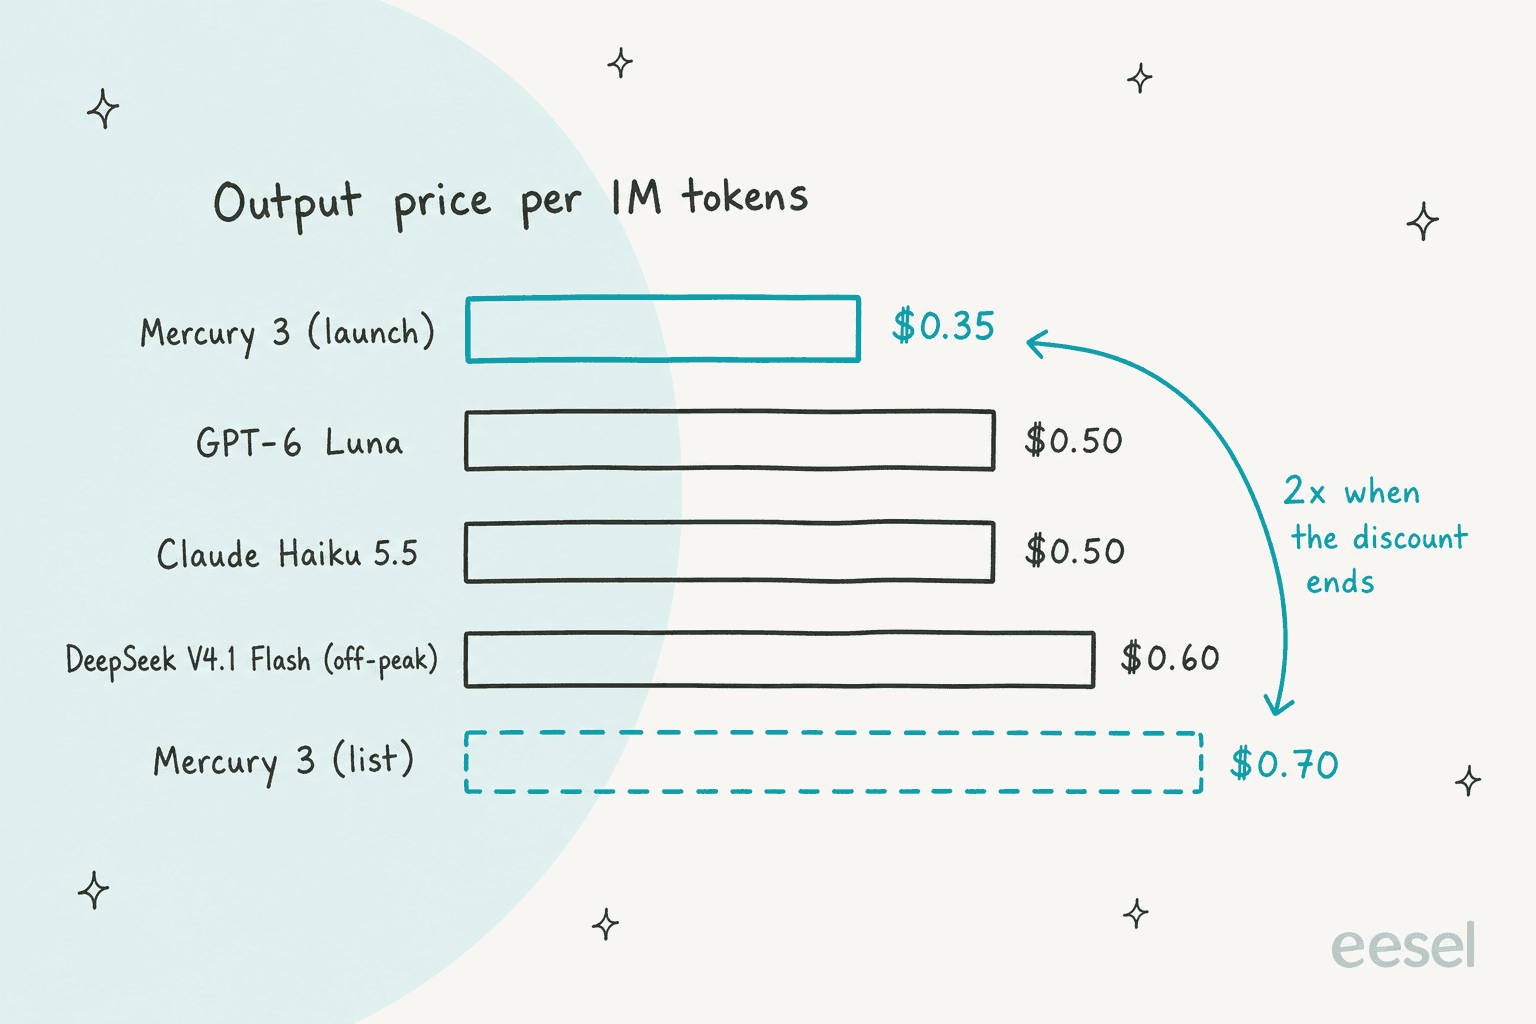
Leia a coluna de saída e a história é simples. No lançamento, o Mercury 3 tem o token de saída mais barato deste grupo. No preço de tabela, tem a saída mais cara dos quatro modelos econômicos, e o Gemini 3.8 Flash fica numa classe de preço mais alta.
Na entrada há empate com o Luna e o Haiku a $0.10 durante o lançamento, e depois o dobro deles na tabela. Na entrada em cache, o DeepSeek joga em outra liga a $0.003, mais de três vezes mais barato que a tarifa em cache de qualquer outro.
A coluna que a maioria das comparações pula é a regra para prompts longos. O Haiku 5.5 cobra a requisição inteira a $0.50 de entrada e $2.50 de saída quando o prompt passa de 100.000 tokens, leituras de cache incluídas. O Luna passa a 2x de entrada e 1,5x de saída depois de 272K. O Mercury 3 cobra a mesma tarifa em toda a janela de 1M, o que um testador inicial percebeu na hora:
"If these benchmarks hold up it is a no-brainer against Haiku 5.5 and GPT-6 Luna, especially considering that Haiku 5.5 becomes 5x more expensive past 100k context, and this model goes up to 1M for the same price. (Note: the price increases 2x after a period post launch but is still way lower than Haiku is priced for >100k requests)"
Minhas análises dos preços do GPT-6 Luna e dos preços do Haiku 5.5 cobrem esses limiares em detalhe, e o artigo sobre os preços do V4.1 Flash explica as regras de horário de pico do DeepSeek.
Calculadora de custo do Mercury 3
Tarifas por milhão de tokens são difíceis de sentir. Escolha uma tarefa abaixo, ou digite suas próprias contagens de tokens, e a calculadora precifica um mês em cada modelo pela tarifa padrão do fornecedor. Alterne o DeepSeek entre fora do pico e pico para ver quanto o relógio pesa ali.
Escolha uma tarefa ou digite suas próprias contagens de tokens para comparar um mês de Mercury 3 no preço de lançamento e de tabela com GPT-6 Luna, Claude Haiku 5.5, DeepSeek V4.1 Flash e Gemini 3.8 Flash.
Quanto custa uma tarefa real no Mercury 3
Aqui estão os quatro presets da calculadora em forma de tabela, para você ver o padrão sem clicar. Cada um assume tarifas padrão, DeepSeek fora do pico e nenhum crédito gratuito.
| Tarefa (por mês) | Formato de uma tarefa | Mercury 3 lançamento | Mercury 3 tabela | GPT-6 Luna | Haiku 5.5 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|
| 20,000 respostas de suporte | 1 chamada, 6,000 de entrada (70% em cache), 400 de saída | $7.24 | $14.48 | $8.44 | $8.44 | $10.45 | $63.30 |
| 10,000 tarefas de agente | 12 chamadas, 8,000 de entrada (85% em cache), 600 de saída | $47.76 | $95.52 | $58.56 | $58.56 | $67.25 | $439.20 |
| 1,000 documentos longos | 1 chamada, 200,000 de entrada, 2,000 de saída | $20.70 | $41.40 | $21.00 | $105.00 | $31.20 | $157.50 |
| 500,000 classificações | 1 chamada, 1,500 de entrada, 150 de saída | $101.25 | $202.50 | $112.50 | $112.50 | $157.50 | $843.75 |
Três coisas saltam aos olhos.
Primeiro, todo número é pequeno. Dez mil tarefas de agente de 12 passos custam menos de $100 por mês no Mercury 3 mesmo no preço de tabela. Para a maioria das equipes que leem isto, a conta do modelo não é a decisão. Velocidade, qualidade e o trabalho em volta do modelo são.
Segundo, o preço de tabela muda o ranking. No lançamento o Mercury 3 vence todas as linhas. Na tabela, perde para o Luna e o Haiku 5.5 em respostas de suporte, tarefas de agente e classificação, por aproximadamente 1,6 a 1,8 vez. Em documentos longos supera o Haiku 5.5, cuja tarifa acima de 100K entra em vigor ($41.40 contra $105), mas ainda custa cerca do dobro dos $21 do Luna. Se o prompt passar de 272K, a tarifa de contexto longo do Luna fecha essa diferença até o empate.
Terceiro, a saída é a maior parte da conta quando o cache funciona. Na linha de tarefas de agente no preço de tabela, é assim que o dinheiro se distribui:
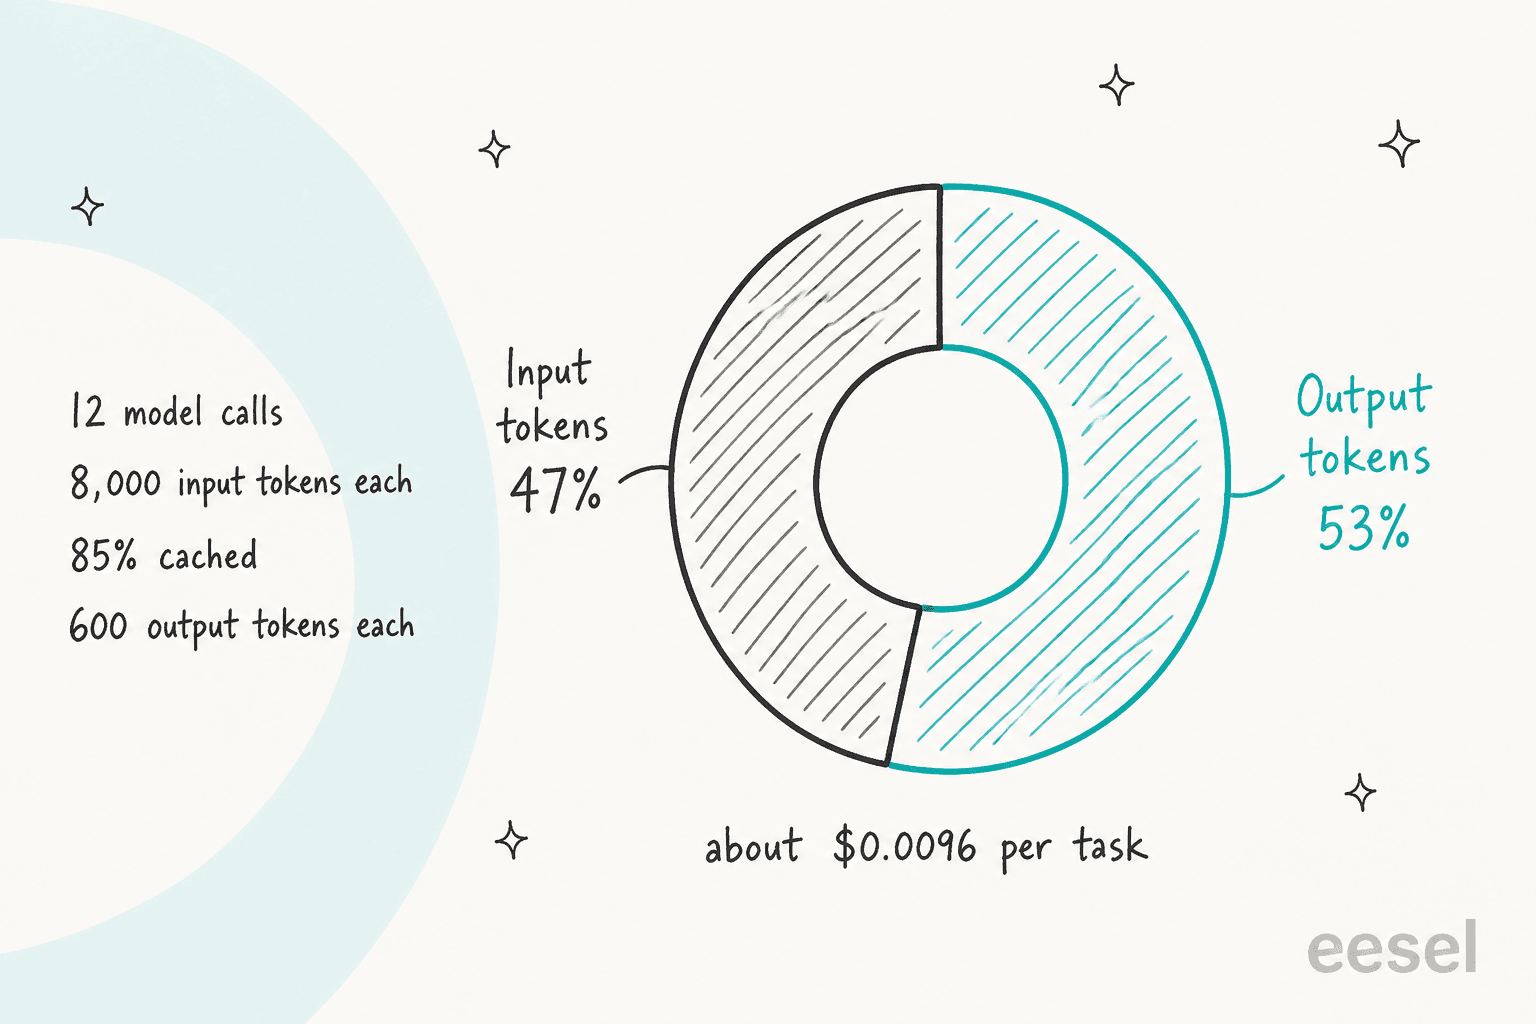
Com 85% da entrada em cache a um décimo do preço, os 600 tokens de saída por chamada pesam mais que 8.000 tokens de entrada. Como os tokens de raciocínio são cobrados como saída, o esforço de raciocínio que você escolhe é o principal controle de custo. Passar do padrão low para medium ou high adiciona tokens de raciocínio a cada chamada. Teste se instant ou low mantêm a qualidade na sua tarefa antes de pagar por mais.
Mais uma linha dessa tabela merece uma nota própria. Se a sua tarefa é classificação, o Mercury 3 é o modelo errado da Inception para precificar. O Mercury Decide cobra apenas a entrada, a $0.02 por milhão no lançamento e $0.04 na tabela, e não cobra a saída. As mesmas 500.000 classificações custariam cerca de $15 no lançamento, contra $101.25 no Mercury 3. Meu guia de classificação de tickets com IA mostra quando um classificador vence um modelo de chat nessa tarefa.
Os detalhes de cobrança que mexem na sua conta
Além da tabela de preços, cinco detalhes mudam o que você realmente paga. Nenhum está escondido, mas estão espalhados por quatro páginas diferentes.
O cache é automático, sem taxa de escrita
A Inception guarda em cache prefixos de prompt repetidos por conta própria, sem parâmetro na requisição. Tokens em cache são cobrados a um décimo do preço de entrada, e a tabela não tem acréscimo por escrita em cache. É mais simples que as tabelas da OpenAI e da Anthropic, que listam uma tarifa de escrita em cache separada ($0.125 por milhão para o Luna e para as escritas de 5 minutos do Haiku 5.5). A contrapartida é o controle: a FAQ diz que a Inception não documenta quanto tempo um prefixo fica em cache, e você não pode fixar nem inspecionar as entradas.
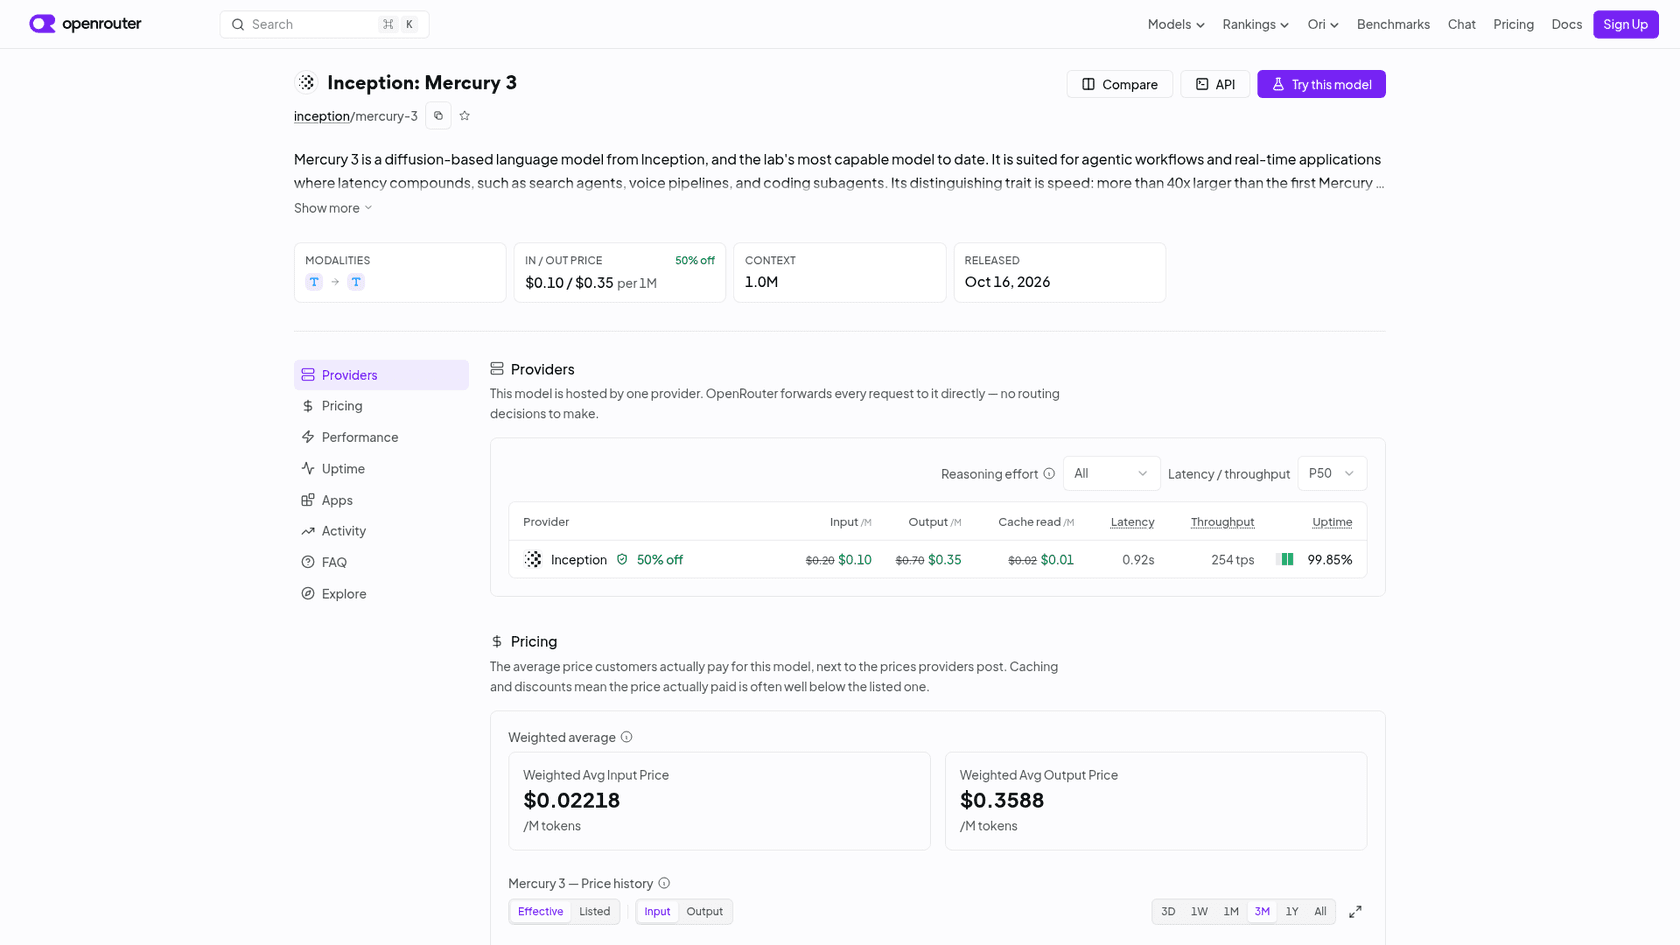
O efeito na prática é grande. O OpenRouter publica o que os usuários do Mercury 3 realmente pagam, e em 20 de outubro de 2026 o preço médio ponderado de entrada foi $0.0222 por milhão, contra $0.10 listados, com 86,6% de acerto de cache em todo o seu tráfego. Se o seu app reutiliza um prompt de sistema longo, oriente o orçamento de entrada mais perto da tarifa em cache do que da tarifa de vitrine.
O OpenRouter custa o mesmo
A página do Mercury 3 no OpenRouter lista um provedor, a Inception, com os mesmos preços de lançamento de $0.10 / $0.35 / $0.01. Então passar pelo OpenRouter não economiza nem custa nada na tarifa por token. A Inception também cita a Baseten e a Vercel como parceiras de lançamento, mas nenhuma publica preço do Mercury 3; a Baseten pede que você entre em contato. Se você já compra modelos abertos pela Together AI ou pela Fireworks, lembre que o Mercury 3 não tem pesos públicos, então só é vendido pela Inception e pelos parceiros que ela nomeia.
Os tokens gratuitos rendem mais do que parece
100 milhões de tokens é muita coisa nesse tamanho. No formato de resposta de suporte acima, cerca de 6.400 tokens por resposta, isso dá aproximadamente 15.600 respostas se cada token contar contra a concessão. No formato de tarefa de agente de 12 chamadas, cerca de 103.000 tokens por tarefa, são menos de 1.000 tarefas. É suficiente para fazer uma avaliação real com o seu próprio tráfego, que é exatamente como eu gastaria.
Limites de taxa podem pegar antes do preço
O nível gratuito permite 100.000 tokens de saída por minuto. Uma única requisição em streaming aos 1.068 tokens por segundo citados pela Inception produz cerca de 64.000 tokens por minuto, então dois streams em velocidade máxima podem atingir o teto de saída do nível gratuito. O pague pelo uso triplica isso para 300.000. Na prática, o OpenRouter mediu uma média de uma semana de 203 tokens por segundo, então você tem mais folga, mas se está planejando uma frota de agentes em paralelo, confira a tabela de limites antes da tabela de preços.
Não há desconto para lotes
A OpenAI e a Anthropic oferecem processamento em lote pela metade do preço no Luna e no Haiku 5.5, e o Google tem níveis Batch e Flex. A tabela da Inception não tem nível de lote. Para tarefas noturnas em que a latência não importa, o Luna em lote a $0.05 de entrada e $0.25 de saída supera até o preço de lançamento do Mercury 3, então cargas adequadas a lote são o único caso em que eu pularia o Mercury 3 só por custo. Meu guia de preços da API da OpenAI explica como funciona o nível de lote.
A velocidade vale o preço de tabela?
Essa é a pergunta real por trás do desconto. Se o Mercury 3 fosse apenas barato, o fim da promoção acabaria com o argumento a favor dele. O argumento que sobrevive ao preço de tabela é a velocidade.
A Inception cita 1.068 tokens por segundo; a média medida pelo OpenRouter em uma semana foi 203, contra cerca de 130 que a Inception lista para o Luna. A diferença importa mais em loops de agente, onde as chamadas rodam uma atrás da outra e cada segundo de geração se acumula. Minha visão geral do Mercury 3 tem uma calculadora para esse tempo de espera. Para precificação, o enquadramento útil é este: na tabela, você paga cerca de 1,6 a 1,8 vez a conta de tokens do Luna para reduzir o tempo de geração em cadeias longas. Para subagentes do Claude Code, agentes de navegador e pipelines de voz, isso muitas vezes compensa. Para uma tarefa em segundo plano que ninguém espera, não.
Se velocidade é o motivo de você estar aqui, vale também comparar o caminho do hardware. A Groq vende inferência rápida em modelos abertos, coberta no meu artigo sobre o Groq 3 LPX. E se você quer entender por que os modelos de difusão são rápidos, minha explicação sobre modelos de IA baseados em difusão mostra o passo a passo.
Quando o Mercury 3 é a escolha barata e quando não é
Assim eu decidiria, com o preço de tabela em mente.
- Prompts longos, a partir de 100K tokens. O Mercury 3 na tabela vence o Haiku 5.5 com folga aqui. Contra o Luna, custa cerca do dobro entre 100K e 272K, depois praticamente empata acima de 272K. Se as suas chamadas carregam várias centenas de milhares de tokens de documentos ou histórico, é uma escolha forte nos dois preços.
- Loops de agente em que a velocidade importa. Pague o prêmio na tabela. Antes, rode de novo a calculadora com suas contagens reais de tokens.
- Chamadas curtas, de alto volume e tolerantes à latência. Na tabela, o Luna e o Haiku 5.5 são mais baratos, e o DeepSeek V4.1 Flash fora do pico fica perto. Aproveite o preço de lançamento enquanto durar, mas monte o orçamento sobre as alternativas.
- Tarefas em lote ou noturnas. Use um provedor com nível de lote. O Luna em lote custa metade da tarifa padrão do Luna.
- Classificação e roteamento. Precifique o Mercury Decide, não o Mercury 3, ou um modelo pequeno. Meu panorama de modelos de linguagem pequenos cobre opções que você mesmo pode hospedar.
- Qualquer coisa que precise de visão ou pesos abertos. O Mercury 3 é só texto com pesos fechados. O DeepSeek V4.1 Flash suporta visão e o Gemini 3.8 Flash também aceita imagens. Se você quer um modelo de difusão aberto, veja o DiffusionGemma.
Se você está comparando mais modelos da faixa econômica, minhas análises dos preços do Gemini 3.8 Flash, dos preços do Gemini 3.5 Flash-Lite e dos preços do Kimi K3 usam o mesmo método por tarefa.
A conta de tokens vs. o custo total de um agente de IA
A maior parte do custo de pôr um modelo para trabalhar num caso real fica fora da tabela de preços, e o suporte é onde eu vejo isso com mais clareza. Um mês de 10.000 tickets são menos de $100 de tokens do Mercury 3, mesmo no preço de tabela. Mas, para que esses tokens respondam tickets, você constrói a conexão com o helpdesk, a recuperação sobre a sua central de ajuda e tickets passados, regras de quando transferir, uma forma de testar contra conversas reais e o monitoramento para pegar uma resposta ruim. São semanas de engenharia, mais manutenção toda vez que o seu helpdesk ou as suas políticas mudam.
Esse dilema nos é familiar das nossas próprias chamadas de vendas. Um líder de engenharia de uma empresa de hardware cripto, com uma base de conhecimento no Confluence de mais de 300 artigos, resumiu bem ao escolher comprar em vez de construir:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Veja o que um dos nossos clientes opera para entender a escala. A smava, uma plataforma berlinense de comparação de empréstimos, lida com cerca de 27.000 tickets do Zendesk por mês em duas marcas com três agentes da eesel: um categoriza cada ticket, outro redige a resposta a partir de cerca de 820 macros e artigos da central de ajuda, e um por marca prepara respostas prontas para o cliente nos tickets sem consultor atribuído. Os agentes aprovam cada rascunho, e um ticket com anexos vai para uma pessoa com uma nota. Cada uma dessas regras é trabalho que uma conta por token não inclui.
A SE Ranking é outra forma do mesmo argumento: cerca de 4.650 conversas por mês em três produtos, com um agente da eesel por produto, respondendo a partir de cerca de 16.800 páginas de conhecimento. Nenhuma das equipes precisou pensar em tokens, cache ou esforço de raciocínio. Meus guias sobre o custo de agentes de IA vs. humanos e o custo de um chatbot fazem as contas completas dos dois caminhos.
Experimente a eesel
O Mercury 3 é infraestrutura, e no lançamento é infraestrutura de ótimo custo-benefício. A eesel é o funcionário. Se você está precificando um modelo porque quer que uma IA responda tickets de suporte, o teammate de helpdesk com IA entra na fila que você já opera, no Zendesk e nos outros grandes helpdesks, aprende com seus tickets e documentos passados e se reproduz contra suas conversas históricas antes de responder a um único cliente.

O preço funciona como pensa um líder de suporte: os planos começam em $299 por mês por 500 créditos, um ticket ou um chat é um crédito, não importa quanto dure, e o teste gratuito dá 100 créditos sem cartão. Compare isso com uma solução própria por token na página de preços.
Se você prefere operá-lo como operaria uma API de modelo, a CLI da eesel opera o mesmo teammate a partir de um terminal, e cada comando devolve JSON que um script ou um agente de código como o Claude Code consegue ler. Meu guia da CLI de agentes de IA mostra como isso funciona. Experimente a eesel nos tickets do mês passado e veja você mesmo o custo por ticket respondido. E se você está aqui porque escreve conteúdo, e não tickets, o time também tem um redator de blog com IA.