

Quanto custa o Elorian Glimpse?
Sou a Alicia e desenvolvo recursos e agentes de IA na eesel. Boa parte da minha semana vai para a diferença entre o que um modelo custa por token e o que ele custa por trabalho concluído, porque é nessa diferença que os orçamentos de IA saem do controle. Então, antes de fazer qualquer conta com o Glimpse, li linha por linha a publicação de lançamento da Elorian, os termos da plataforma e as páginas dos provedores. Visão também é uma questão em aberto no meu trabalho: nas chamadas de vendas da eesel neste ano, equipes de suporte de produtos técnicos pediam sem parar uma IA capaz de ler os diagramas dos PDFs e as fotos que os clientes anexam aos tickets. Eu queria o custo real de um modelo feito justamente para esse tipo de olhar.
O Glimpse foi lançado em 16 de outubro de 2026 como o primeiro modelo da Elorian, uma startup fundada por Andrew Dai, que antes co-liderou o trabalho de dados do Gemini no Google DeepMind. A Elorian o chama de modelo de "pensamento visual": ele recebe imagens e vídeo, dá zoom em regiões, revê trechos curtos em taxa de quadros maior e só então responde em texto. É uma prévia de pesquisa, pós-treinada sobre um modelo base de pesos abertos.
Aqui está tudo o que dá para comprar hoje e quanto custa:
| Como acessar | Entrada (por 1M de tokens) | Entrada em cache (por 1M) | Saída (por 1M de tokens) | Observações |
|---|---|---|---|---|
| API da Elorian | $0.60 | Não publicado | $3.00 | Cadastro na plataforma da Elorian |
| OpenRouter | $0.60 | $0.06 | $3.00 | Toda requisição vai para a Together AI |
| Together AI dedicado | Falar com vendas | Falar com vendas | Falar com vendas | GPUs de locatário único, cobradas por hora |
| Interface de chat da Elorian | Grátis | Grátis | Grátis | Chat na web, não é API |
Nas especificações, o OpenRouter lista uma janela de contexto de 262,144 tokens e até 256,000 tokens de saída. As entradas são texto, imagens e vídeo. A saída é só texto.
Faltam duas coisas nos materiais da própria Elorian, e elas importam. Não há preço de cache publicado na API da Elorian em si, e não há desconto para processamento em lote em lugar nenhum. Se você quer o cache documentado hoje, a listagem do OpenRouter é a única fonte pública.
Como os preços do Glimpse se comparam ao Astra, Sol, Opus 5.5 e Gemini?
A publicação de lançamento da Elorian compara o Glimpse com quatro modelos de fronteira, e as linhas de preço são a primeira coisa na tabela de resultados. Esta é a tabela, direto da página de lançamento:
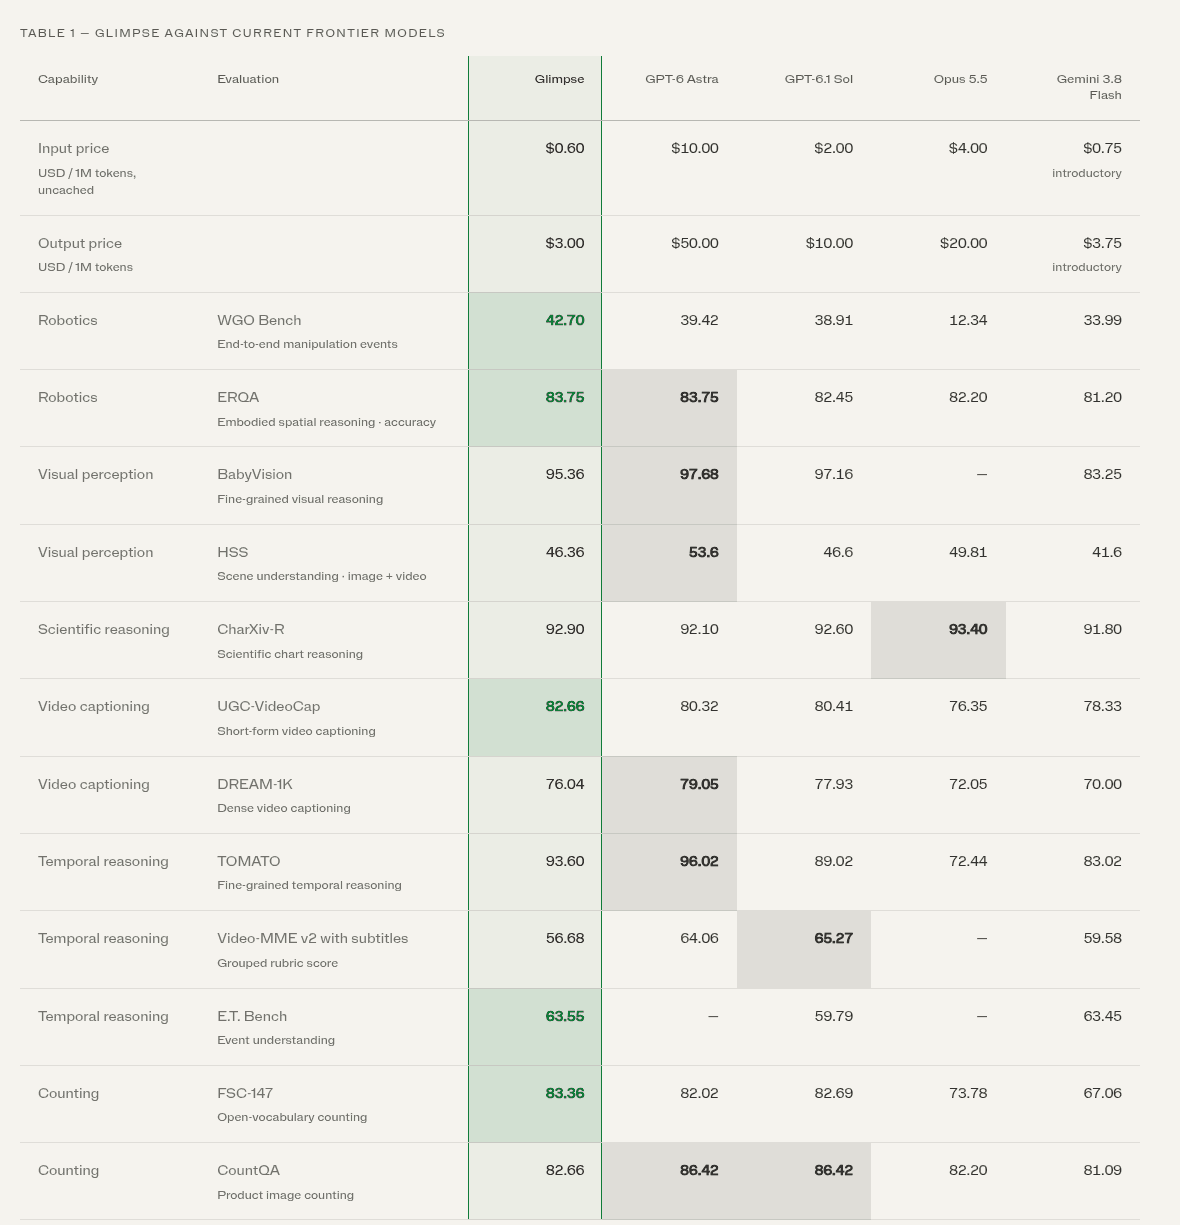
Conferi o preço de cada concorrente na página do próprio fornecedor e acrescentei as tarifas de cache, já que o cache muda o quadro em trabalhos com muitas imagens, em que os mesmos quadros de referência são enviados repetidamente:
| Modelo | Entrada (por 1M) | Entrada em cache (por 1M) | Saída (por 1M) | Economia do Glimpse na saída |
|---|---|---|---|---|
| Elorian Glimpse | $0.60 | $0.06 (OpenRouter) | $3.00 | - |
| Gemini 3.8 Flash (até 31 dez. 2026) | $0.75 | $0.075 | $3.75 | 20% |
| Gemini 3.8 Flash (a partir de 1º jan. 2027) | $1.50 | $0.15 | $7.50 | 60% |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | 70% |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | 85% |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 94% |
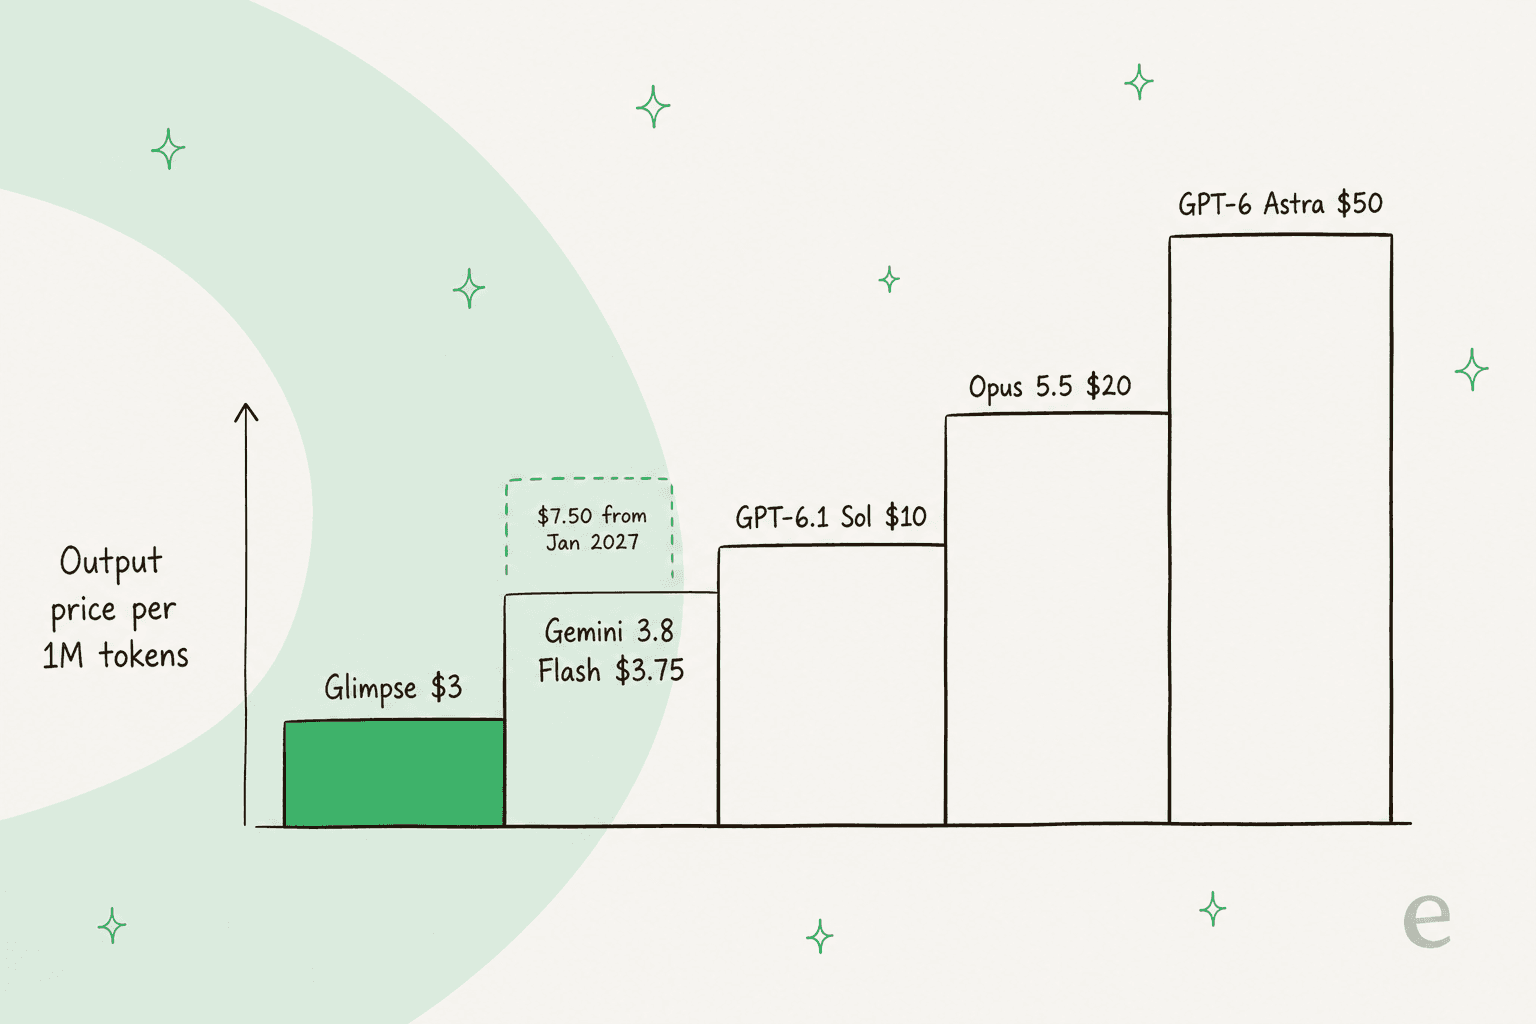
A linha que merece mais atenção é a do Gemini. A Elorian tem o cuidado de escrever "introductory" ao lado do preço do Flash, e essa palavra pesa: o Gemini 3.8 Flash passa de $0.75 e $3.75 para $1.50 e $7.50 em 1º de janeiro de 2027. Hoje o Glimpse fica 20% abaixo do Flash. Em dez semanas, fica 60% abaixo. Se você está escolhendo entre os dois para um projeto que vai até 2027, calcule com a coluna de 2027, não com a de outubro.
No outro extremo, a comparação com o Astra é a manchete com que a Elorian abre, e ela se sustenta na tabela de preços. O GPT-6.1 Sol fica no meio, com $2 e $10, e o Opus 5.5 com $4 e $20.
Entre as alternativas abertas e baratas com visão, a prévia do DeepSeek V4 Flash Vision e o Nemotron 3.5 Super VL são ambos ainda mais baratos por token, embora nenhum seja pensado para rever vídeo como o Glimpse.
Para as tabelas completas de cada fabricante, veja os guias de preços da API da OpenAI, preços do Gemini e preços da API da Anthropic.
Por que a economia real é menor que 94%?
Porque o Glimpse foi projetado para olhar duas vezes, e olhar custa tokens. A própria Elorian diz isso na publicação de lançamento: "Looking that closely takes time, and tokens. Token efficiency is our next highest focus."
A prova mais clara é a demo de robôs da própria Elorian. O Glimpse e o GPT-6 Astra atuaram como planejadores da mesma política de robô (π0.5 da Physical Intelligence) na mesma tarefa: colocar o cream cheese na tigela e depois colocar a tigela sobre o armário. Os dois concluíram. Segundo a publicação de lançamento, o planejamento do Glimpse custou $0.035 por episódio e o do Astra, $0.249.
É uma diferença de 7,1 vezes. A diferença na tabela de preços é de 16,7 vezes. A diferença tem de vir da contagem de tokens e, nessa tarefa, implica que o Glimpse usou cerca de 2,3 vezes mais tokens que o Astra para chegar ao mesmo resultado. Esse é um cálculo meu a partir dos dois números da Elorian, não um dado publicado pela Elorian, e vem de uma única demo. Mas é o tipo certo de alerta para quem orça com base na manchete dos 94%.
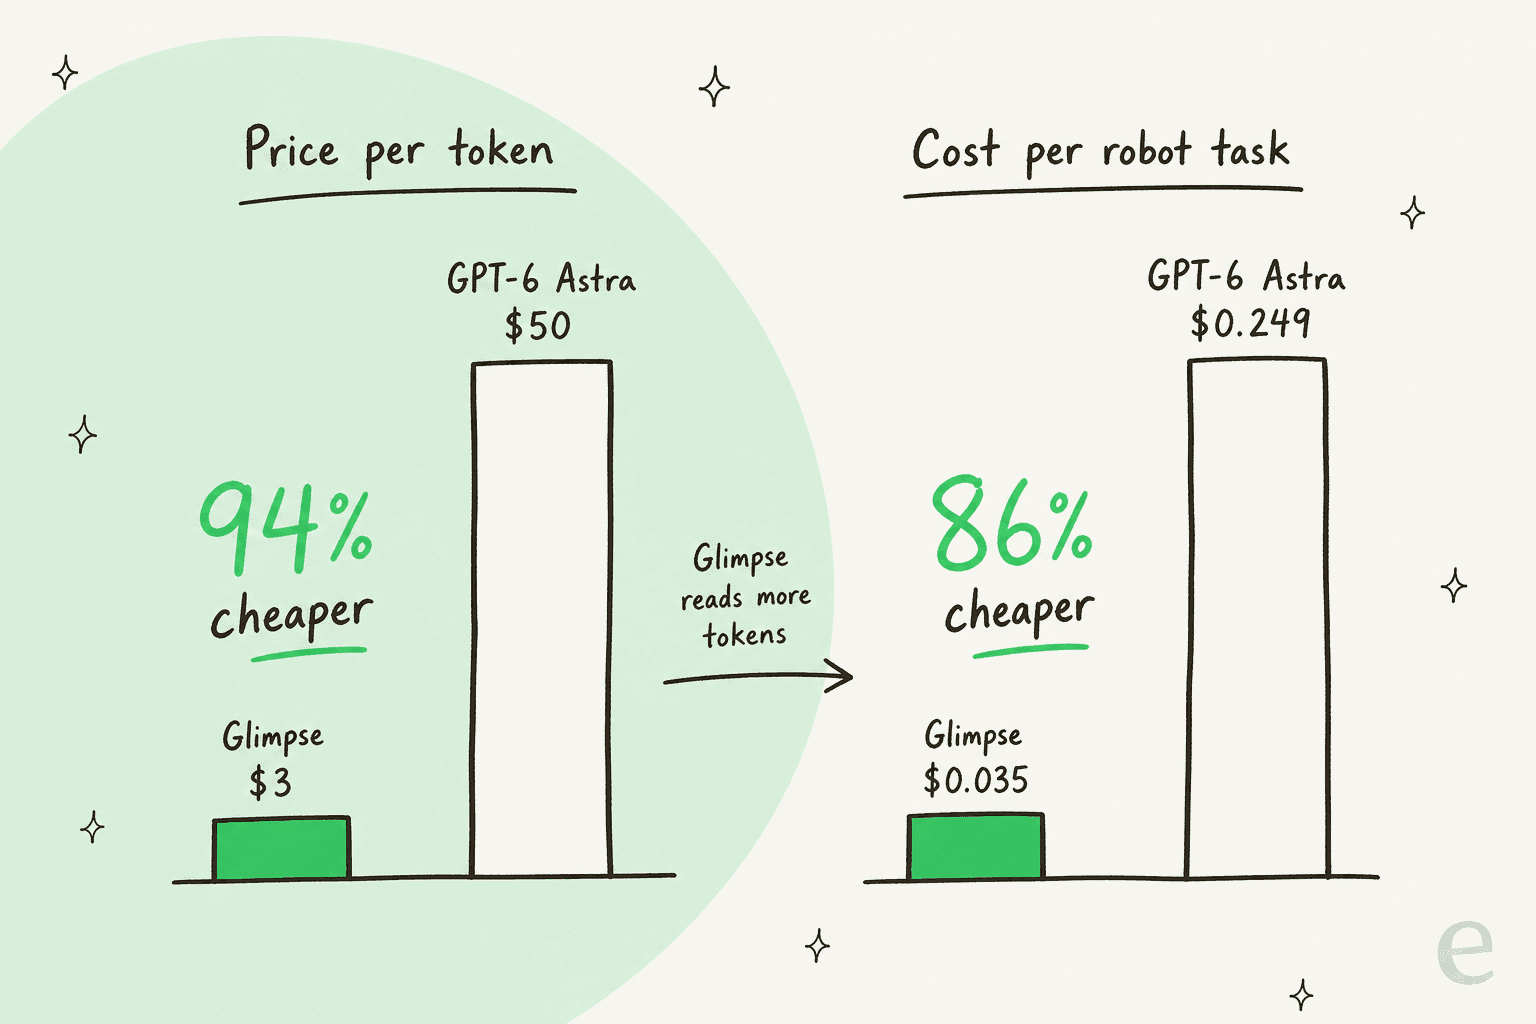
Uma economia de 86% continua sendo um ótimo negócio e, na robótica, muda o que é viável financeiramente. Brian Zhan, investidor da Elorian, fez a conta por hora justamente sobre essa demo:
"A check every 2s is 1,800 calls per robot-hour. Glimpse is 7x cheaper than GPT-6 Astra and ~1s faster per call. The same budget on Astra buys one check every 14s."
Repare no "7x", não "16x". Até os apoiadores da própria Elorian citam o número por tarefa quando fazem contas reais. O olhar extra também aparece na forma como os primeiros testadores descrevem o modelo:
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
Quatro recortes e um zoom dão uma resposta melhor. São também tokens de quatro recortes e um zoom.
Para onde a conta do Glimpse realmente vai?
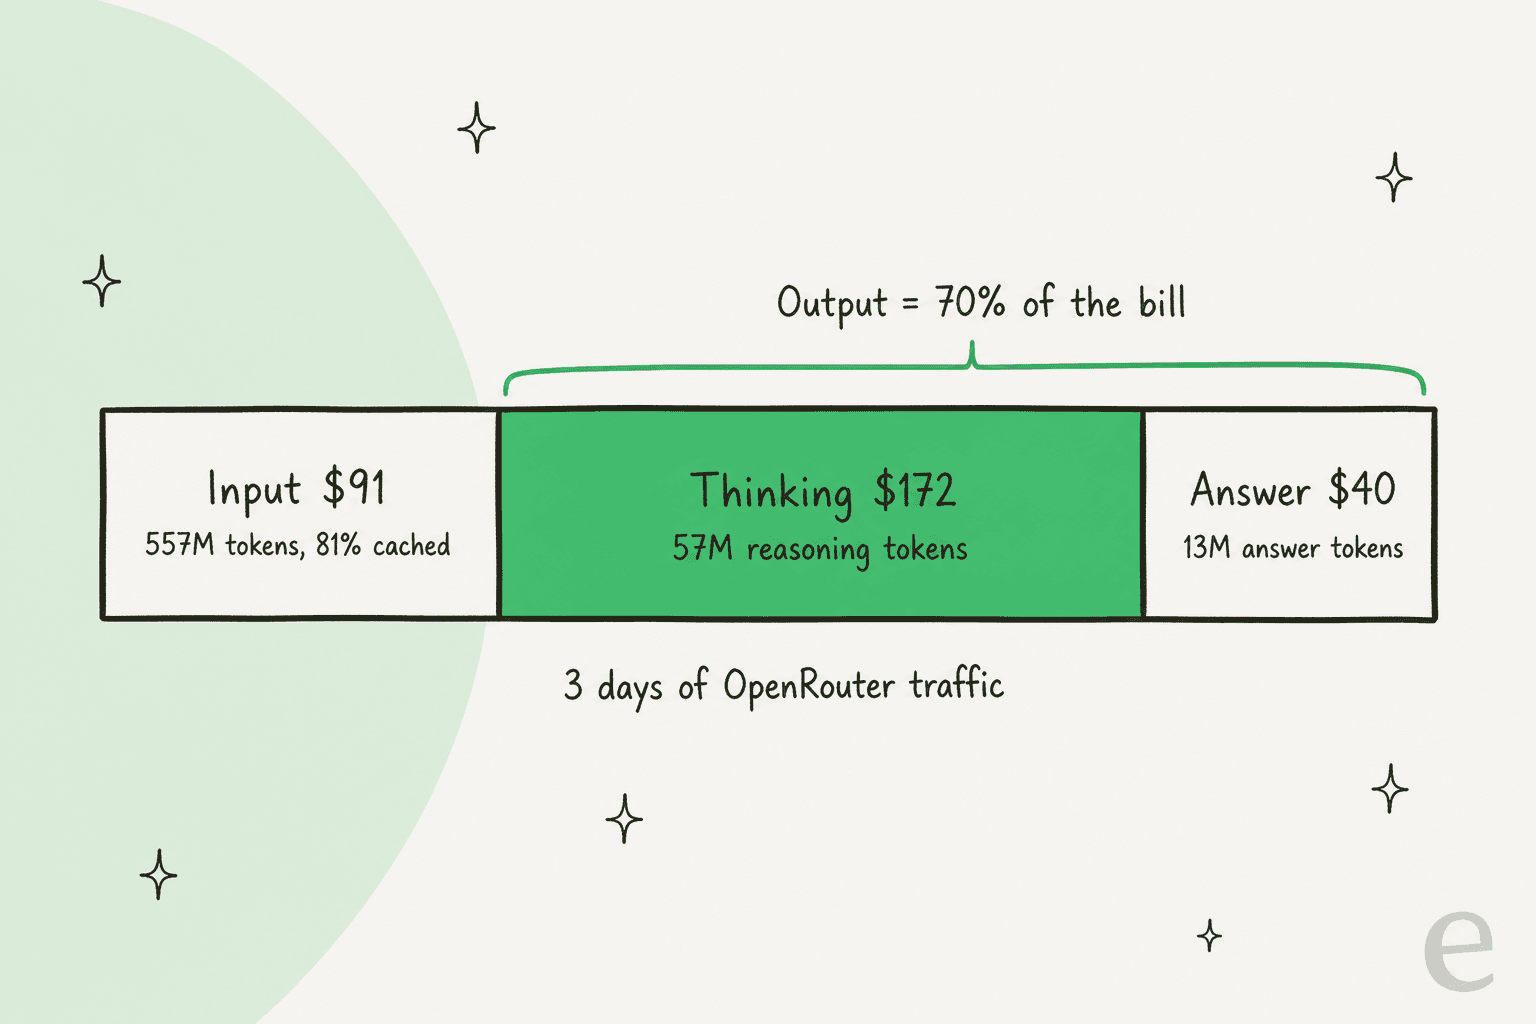
O OpenRouter publica o tráfego ao vivo de cada modelo que hospeda, o que dá uma visão rara de como cargas de trabalho reais gastam dinheiro com o Glimpse. Nos três primeiros dias, a página do OpenRouter mostrou 557M tokens de prompt, 57.2M tokens de raciocínio e 13.2M tokens de resposta.
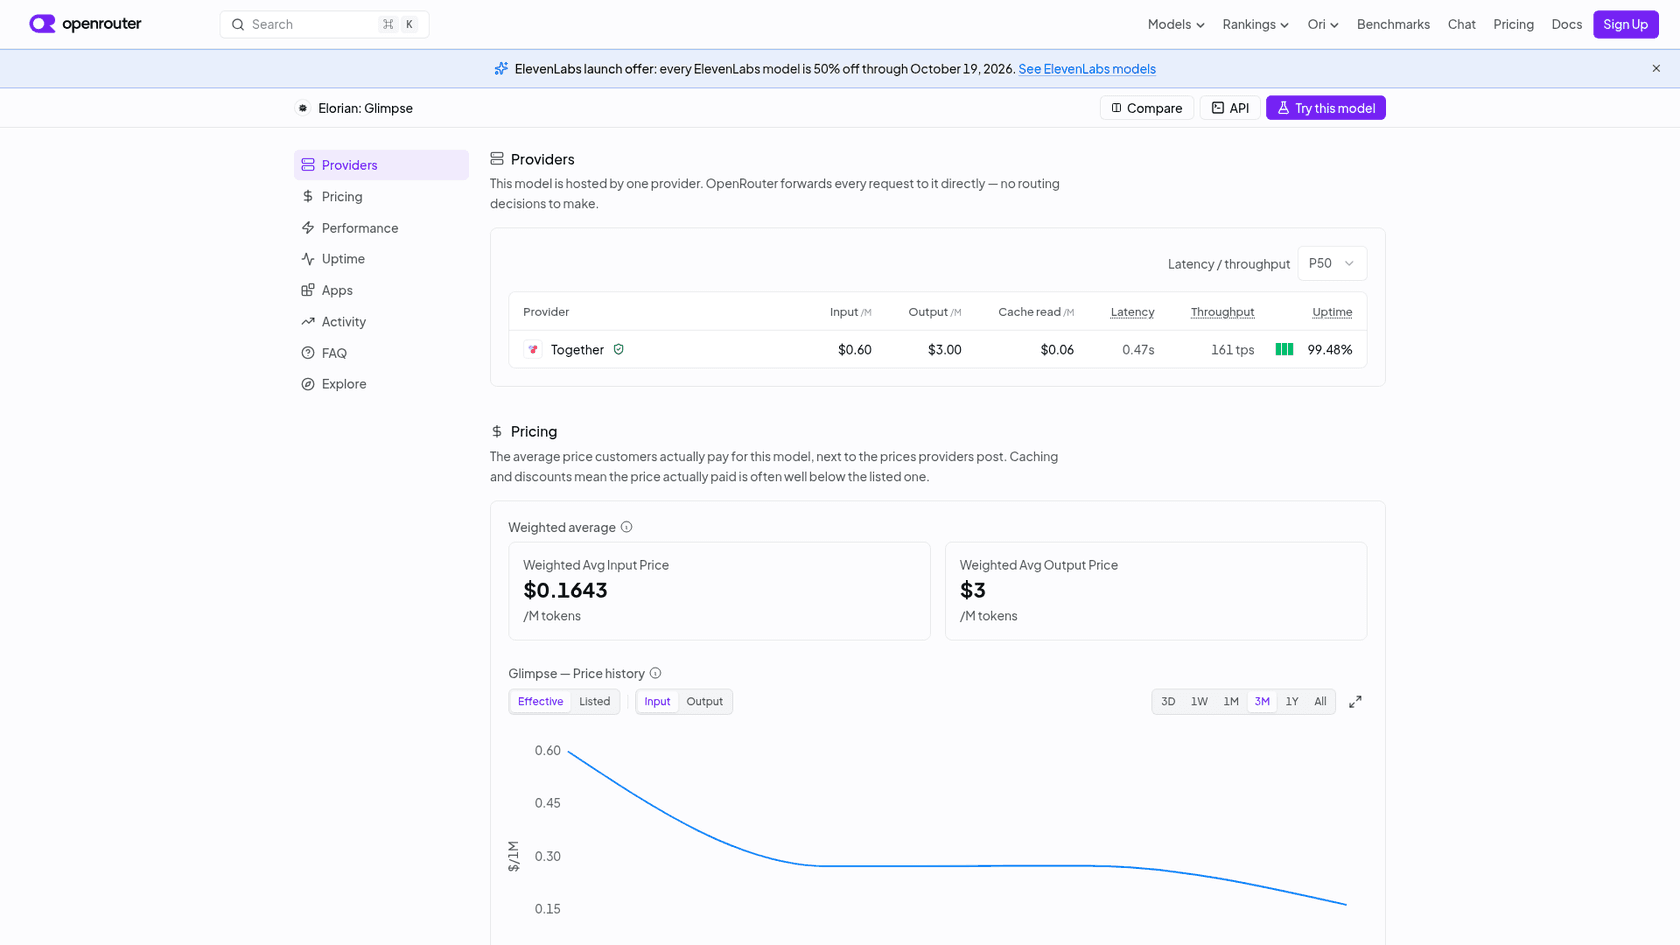
Dois números dessa página explicam a maior parte da conta:
- Taxa de acerto de cache de 80,7%. A maior parte da entrada foi servida do cache a
$0.06, o que reduz o preço médio de entrada pago para$0.1643por milhão, cerca de 73% abaixo do preço de tabela de$0.60. - O raciocínio é 81% da saída. Dos
70.4Mtokens de saída,57.2Mforam pensamento e só13.2Mforam a resposta visível. No OpenRouter, os tokens de raciocínio são cobrados como saída pela tarifa cheia de$3.
Junte os dois e o dinheiro se inverte. A entrada é 89% dos tokens, mas só cerca de $91 dos aproximadamente $303 gastos. A saída são cerca de $211, ou 70%, e só o pensamento custa mais do que toda a entrada somada.
Isso é uma mistura de tráfego, não a sua. Os principais aplicativos que enviaram tráfego ao Glimpse nesses primeiros dias foram agentes de programação e o Hermes Agent, que reenviam prompts longos e estáveis e aproveitam bem o cache. Um pipeline que envia um videoclipe novo a cada chamada usará bem menos o cache, e a entrada terá uma fatia maior. Mas a lição vale do mesmo jeito: no Glimpse, a alavanca é o raciocínio, não a imagem. O parâmetro reasoning do OpenRouter permite definir o esforço ou um orçamento máximo de raciocínio, e esse é o primeiro botão que eu giraria numa revisão de custos.
Estime a sua própria conta do Glimpse
Insira o seu volume de requisições e os tamanhos de tokens. O "multiplicador de tokens do Glimpse" existe por causa do exemplo do robô acima: use 1.0 se supor que o Glimpse usa os mesmos tokens que os outros modelos, ou cerca de 2.3 para acompanhar o que a demo da própria Elorian indica.
Com os valores padrão (10.000 requisições, 20.000 tokens de entrada e 3.000 de saída cada, sem cache), o Glimpse sai a $210 por mês, contra $262.50 do Gemini 3.8 Flash, $700 do Sol, $1,400 do Opus 5.5 e $3,500 do Astra. Agora deslize o multiplicador para 2.3 e o Glimpse sobe para $483, mais do que o Gemini 3.8 Flash custa hoje. Ative os preços de 2027 e o Flash sobe para $525, e o Glimpse volta a ganhar. Essa oscilação é toda a decisão de compra em um controle deslizante.
A interface de chat do Glimpse é gratuita?
Sim. O fundador Andrew Dai disse isso na thread de lançamento:
"Free on the chat interface at https://platform.elorian.ai with an API available too."
A publicação de lançamento da Elorian repete isso com um botão "Try Glimpse free on the Elorian platform". O cadastro é por Google ou e-mail, e há um contato separado para contas corporativas.
Não encontrei limites de uso publicados para o chat gratuito. Os termos da plataforma, atualizados pela última vez em 12 de outubro de 2026, descrevem como funciona o uso pago depois que você passa desse ponto:
- As tarifas são em dólares americanos e não são reembolsáveis, exceto quando a lei exige; pedidos de reembolso são analisados caso a caso.
- A cobrança pode ser feita com créditos pré-pagos ou com uma assinatura contínua.
- Se você ativar o pagamento automático, a Elorian cobra periodicamente o seu cartão pelo uso, e você cancela entrando em contato com a Elorian antes da próxima data de cobrança.
- Testes gratuitos e ofertas beta não têm garantia e podem acabar.
O chat gratuito é o lugar certo para começar. Ele até mostra o "visual scratch space" do modelo enquanto dá zoom e reve, que é o jeito mais rápido de ter uma noção de quantos passos o seu tipo de imagem exige e, portanto, de quantos tokens a API vai cobrar.
Quais são os custos escondidos e as armadilhas?
A tabela de preços é curta, então as surpresas reais estão no comportamento do modelo. Elas vêm das métricas ao vivo do OpenRouter e das próprias notas da Elorian:
| Armadilha | O que os números dizem | Por que isso custa dinheiro |
|---|---|---|
| Erros em chamadas de ferramentas | 9.20% de taxa de erro no OpenRouter | Chamadas com falha costumam ser repetidas, e as repetições são cobradas de novo |
| Erros em saída estruturada | 10.38% de taxa de erro | Pipelines com esquema rígido vão repetir cerca de 1 em cada 10 chamadas |
| Latência de cauda longa | P50 de ponta a ponta 12.48s, P90 76.17s | Bom para rotulagem em lote, lento para qualquer coisa que uma pessoa espera |
| Um único provedor | A Together é o único host, 99.48% de disponibilidade | Sem provedor de reserva se a Together tiver uma hora ruim |
| Prévia de pesquisa | Rótulo da própria Elorian | Preços e comportamento podem mudar, e ainda não há faixa de lote |
As taxas de erro são as que eu observaria com mais atenção. Com 10% de repetição, o seu preço efetivo fica cerca de 10% acima do que a calculadora mostra e, em chamadas com muito raciocínio, uma nova tentativa repete a parte cara. Se você extrai dados estruturados de imagens, valide cedo e limite as tentativas.
Sobre os "pesos abertos": o Glimpse é pós-treinado sobre um modelo base de pesos abertos, mas os pesos do próprio Glimpse não são públicos. A página da Elorian no Hugging Face não lista nenhum modelo. Hospedar por conta própria não é uma opção hoje. O mais próximo é uma implantação dedicada na Together, cuja página de preços lista H100 dedicadas a $5.49 por GPU por hora sob demanda. Isso só compensa com volume alto e constante, e você combinaria com a equipe de vendas da Together.
Quanto o Glimpse custa em cargas de trabalho reais?
Aqui vão três exemplos calculados com as tarifas da Elorian. Onde precisei supor tamanhos de tokens, eu aviso.
1. Planejamento de robôs, com o custo por episódio da própria Elorian. A $0.035 por episódio, 1.000 episódios de planejamento custam $35 com o Glimpse contra $249 com o GPT-6 Astra. É o único exemplo com contagem de tokens medida pela Elorian em vez de suposta, então é o mais confiável. É também o caso de uso de que a Elorian e seus investidores mais falam, ao lado do Gemini Robotics 2 e do Gemini 4 Argon.
2. Rotulagem de vídeo com 10.000 clipes por mês. Suponha 20.000 tokens de entrada por clipe e 3.000 de saída, sem cache porque cada clipe é novo. São $210 por mês com o Glimpse e $262.50 com o Gemini 3.8 Flash aos preços de hoje. Se o Glimpse precisar de 2,3 vezes os tokens para rever trechos difíceis, vai para $483, e o Flash sai mais barato até janeiro.
3. Um leitor de capturas de tela para tickets de suporte. Suponha 5.000 tickets por mês com uma captura cada, cerca de 3.000 tokens de entrada e 800 de saída por ticket. Com o Glimpse são cerca de $21 por mês. Com o Claude Opus 5.5 são $140. Nesse tamanho, a conta do modelo é um erro de arredondamento perto do tempo de engenharia para integrá-lo ao seu helpdesk, que é o custo real que explico no guia de custo do atendimento ao cliente com IA.
O padrão nos três: o Glimpse é mais barato quando o trabalho exige o olhar cuidadoso dele, e a economia diminui quando a tarefa é simples o bastante para um leitor mais barato chegar lá em menos passos.
Quem deve pagar pelo Glimpse?
O Glimpse vale a pena quando o raciocínio visual é o produto. Rotular gravações de robôs, contar objetos em uma câmera em movimento, verificar se uma etapa de um vídeo realmente aconteceu: são as tarefas em que a própria tabela da Elorian mostra que ele iguala ou supera modelos que custam de 6x a 16x mais. Um testador resumiu bem a questão em aberto:
"Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing."
Se esse é o seu problema, o preço é fácil de justificar, e o chat gratuito permite conferir com as suas próprias gravações antes de gastar qualquer coisa.
Eu descartaria, ou pelo menos faria um benchmark rigoroso antes, em três casos. Primeiro, leitura simples de imagens, como OCR ou "que produto aparece nesta foto", em que o Gemini 3.8 Flash ou um modelo econômico da DeepSeek responderão com menos tokens. Segundo, qualquer coisa que um cliente espera em tempo real, dada a latência de cauda longa. Terceiro, pipelines com esquema rígido, até que a taxa de erro de 10% em saída estruturada caia.
Para todo o resto, trate os $0.60 e $3 como um teto do preço por token, não como uma previsão da sua conta, e defina um orçamento de raciocínio desde o primeiro dia. O guia de otimização de LLM cobre os outros botões que valem a pena girar.
Onde a eesel entra
O Glimpse é infraestrutura: um par de olhos muito capaz que você chama do seu próprio código. Se você está avaliando modelos de visão, ou uma API de atendimento ao cliente crua, porque os clientes não param de enviar capturas de tela e fotos para a sua fila de suporte, o modelo é a menor parte do que você precisa. Você ainda precisa da conexão com o helpdesk, do conhecimento, das proteções e de uma forma de saber que ele responde corretamente antes de falar com um cliente.
Essa é a parte que a eesel resolve. O colega de IA da eesel para helpdesk entra no seu helpdesk atual, como o Zendesk ou o Freshdesk, aprende com seus tickets anteriores e com a central de ajuda, e é simulado nos seus tickets históricos antes de entrar no ar, para que você veja as respostas antes dos seus clientes. Se você está comparando modelos especificamente para suporte, o panorama dos melhores modelos para tickets de suporte é uma boa próxima leitura.
Experimente a eesel grátis e veja o que ela responderia aos seus próprios tickets.
Perguntas frequentes
Quanto custa o Elorian Glimpse?
$0.60 por milhão de tokens de entrada e $3.00 por milhão de tokens de saída na API. No OpenRouter, as leituras de entrada em cache custam $0.06 por milhão, e por isso o preço médio de entrada pago lá é de cerca de $0.16. Compare com os preços do Gemini 3.8 Flash, de $0.75 e $3.75.O Elorian Glimpse é gratuito?
O Glimpse é mesmo 94% mais barato que o GPT-6 Astra?
$0.60 e $3 contra $10 e $50 do Astra. Por tarefa, a diferença é menor. No exemplo de planejamento de robôs da própria Elorian, o Glimpse custou $0.035 contra $0.249 do Astra, ou seja, 86% a menos, porque o Glimpse lê mais antes de responder. O detalhamento dos preços do GPT-6 Astra traz a tabela completa do Astra.O Glimpse cobra por tokens de raciocínio?
$3 por milhão. No tráfego público do OpenRouter para o Glimpse, o raciocínio representou cerca de 81% de todos os tokens de saída, então limitar o raciocínio é a maior alavanca na sua conta. A mesma regra vale para a maioria dos modelos que pensam, incluindo o Claude Opus 5.5.Onde posso comprar acesso à API do Glimpse?
$0.60 e $3, nos dois primeiros. Uma implantação dedicada é cobrada por hora de GPU, como outras opções desta comparação de APIs.