Preços do Cohere Embed 5 num relance
A Cohere lançou a família Embed 5 em 30 de setembro de 2026, em dois níveis, e ambos compartilham 128K de contexto e mais de 100 idiomas, além de entradas que podem ser texto, imagem ou a combinação fundida de texto e imagem. Passei por todos os preços publicados e os reuni em uma tabela, tirados diretamente da página de preços da Cohere, do post de lançamento e das listagens dos marketplaces de nuvem:
| Opção | Preço | Cobrança por | Ideal para |
|---|---|---|---|
| Chave de teste | Grátis, 1.000 chamadas/mês | n/d (sem uso em produção) | Testes |
| Embed 5 Pro, texto | US$ 0,12 / 1M de tokens | Tokens de entrada | Indexar documentos |
| Embed 5 Fast, texto | US$ 0,08 / 1M de tokens | Tokens de entrada | Consultas, loops de agentes |
| Embed 5 Pro ou Fast, imagens | US$ 0,40 / 1M de tokens | Tokens de imagem | Imagens de páginas, slides |
| Model Vault Small (Pro ou Fast) | US$ 3,00/h ou US$ 2.000/mês | Instância dedicada | Volume alto e constante |
| Model Vault Medium (Pro ou Fast) | US$ 5,00/h ou US$ 3.250/mês | Instância dedicada | Volume muito alto |
| Amazon SageMaker | US$ 2,39 a US$ 8,48/host/h de taxa de software + instância | Hora | Equipes que já usam AWS |
| Microsoft Foundry | Listado em preview, ainda sem preço | n/d | Equipes no Azure |
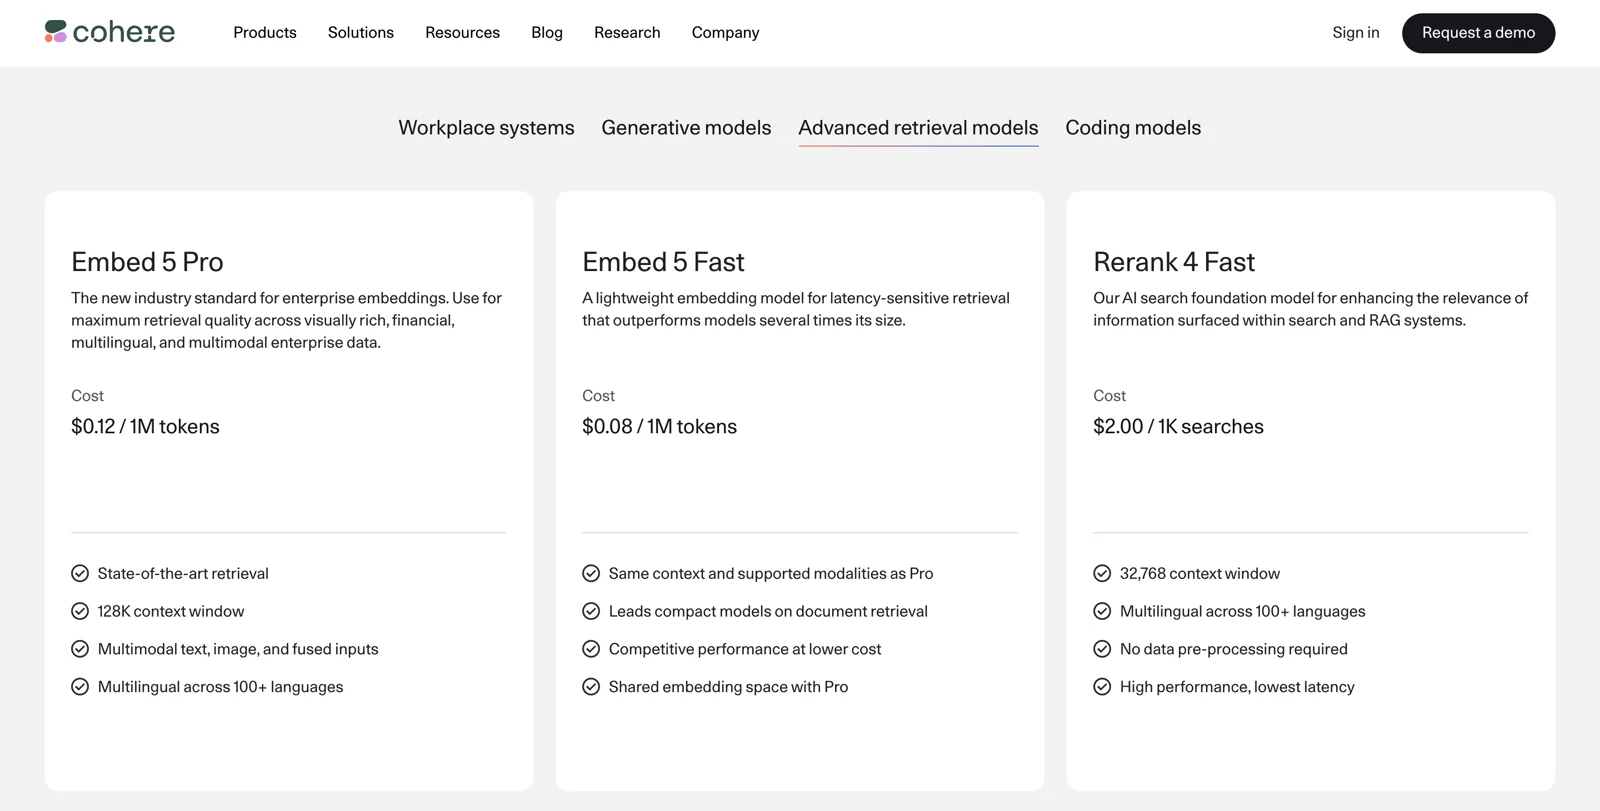
A mesma aba também lista o Parse 5 a US$ 1,50 por 1.000 páginas e o Rerank 4 a partir de US$ 2,00 por 1.000 buscas, e juntos com o Embed 5 formam todo o stack de recuperação que a Cohere vende. Lendo os cartões, duas coisas me chamaram atenção. A primeira: o Model Vault cobra a mesma taxa para Pro e Fast, o que significa que numa instância dedicada toda a lógica de "o Fast é mais barato" desaparece, e o único motivo para escolher o Fast ali é a velocidade. A segunda: o Embed 4 sumiu por completo da página de preços, embora a documentação de modelos ainda o liste sem aviso de descontinuação. Se você está no Embed 4 hoje, nada quebra, mas o sinal sobre onde a Cohere quer que você esteja é bem claro. (Minha análise da Cohere AI cobre o resto da linha.)
Eu construo integrações na eesel, e a parte da eesel que transforma uma central de ajuda e alguns anos de tickets em algo que uma IA consegue pesquisar é exatamente esta camada. Então, quando leio cartões de preços de embeddings, leio como um encanador lê um orçamento de tubulação. O preço por unidade importa, claro, mas o que você realmente está precificando é tudo aquilo a que as tubulações se conectam.
O que mudou em relação ao Embed 4
A versão curta: a Cohere manteve o preço e mexeu em praticamente todo o resto. Aqui está a comparação lado a lado, usando as taxas do Embed 4 dos preços da Cohere no Azure e do snapshot de preços da Cohere de agosto:
| Embed 4 | Embed 5 Pro | Embed 5 Fast | |
|---|---|---|---|
| Texto, por 1M de tokens | US$ 0,12 | US$ 0,12 | US$ 0,08 |
| Imagens, por 1M de tokens | US$ 0,47 | US$ 0,40 | US$ 0,40 |
| Model Vault Small | US$ 4,00/h, US$ 2.500/mês | US$ 3,00/h, US$ 2.000/mês | US$ 3,00/h, US$ 2.000/mês |
| Dimensões padrão | 1536 | 2048 | 2048 |
| Pontuação ViDoRe V3 (Cohere) | 77,0 | 85,8 | 84,5 |
Ou seja, um salto de qualidade de 8,8 pontos pelo mesmo preço de texto, imagens 15% mais baratas e uma instância dedicada US$ 500 por mês mais barata. O Fast, por outro lado, simplesmente não existia antes.
A linha que eu circularia é a das dimensões padrão. O preço por token é o mesmo, mas cada vetor sai um terço maior por padrão. Se você trocar de modelo e mantiver as configurações padrão, sua conta de embeddings fica igual e a do banco de dados vetorial sobe. Chego à solução mais adiante, já que é simples e economiza dinheiro de verdade.
O que conta como token cobrável
A documentação de cobrança da Cohere diz que o embed é precificado com base no número de tokens embutidos, e os tokens que a Cohere adiciona nos bastidores não são cobrados. Você paga apenas pela entrada. Não há nenhuma cobrança por tokens de saída, já que o que uma chamada de embedding retorna é uma lista de números e não texto.
Há alguns detalhes que vale conhecer, pois moldam a conta real:
- Batching não muda o preço. Cada chamada de embed aceita até 96 textos ou entradas, o que é bom para throughput, mas o custo por token continua igual.
- Imagens são cobradas por token, mas a conversão não é publicada. A documentação explica o redimensionamento (imagens acima de 2.458.624 pixels são reduzidas), mas não dá uma fórmula de tokens por imagem. Vale rodar uma pequena amostra antes de fixar um orçamento para um grande arquivo de PDFs.
- Não há desconto em lote declarado. O post de lançamento diz que o embedding em lote está disponível, mas o guia de Embed Jobs ainda diz que só funciona com modelos v3.0. Não planeje contar com uma taxa de lote de 50% como a que você teria no Google.
- As chaves de teste são restritas. O embedding de texto roda a 2.000 entradas por minuto tanto no teste quanto na produção, mas o de imagens é de 5 entradas por minuto no teste contra 400 na produção.
O resto é aritmética simples: tokens de entrada vezes a taxa. É o mesmo modelo de cobrança da API da OpenAI e da maioria dos outros serviços de embeddings hospedados.
O truque de indexar com Pro e consultar com Fast
Para mim, é a coisa mais útil de todo o lançamento, e na verdade é um recurso de preço disfarçado de técnico. Pro e Fast compartilham um espaço de embeddings, então uma consulta que o Fast embutiu consegue pesquisar um índice construído pelo Pro, sem você reconstruir nada.
"For many customers, we recommend the following deployment pattern: index with Pro, query with Fast."
A Cohere testou todas as combinações em 40 conjuntos de dados de desenvolvimento. Com uma configuração toda Pro pontuada como 100, um índice Pro consultado pelo Fast ficou em 98,4, um índice Fast consultado pelo Pro em 97,3 e tudo Fast em 96,6. Há uma pegadinha escondida nas notas de rodapé: os dois lados precisam usar a mesma dimensão de saída.
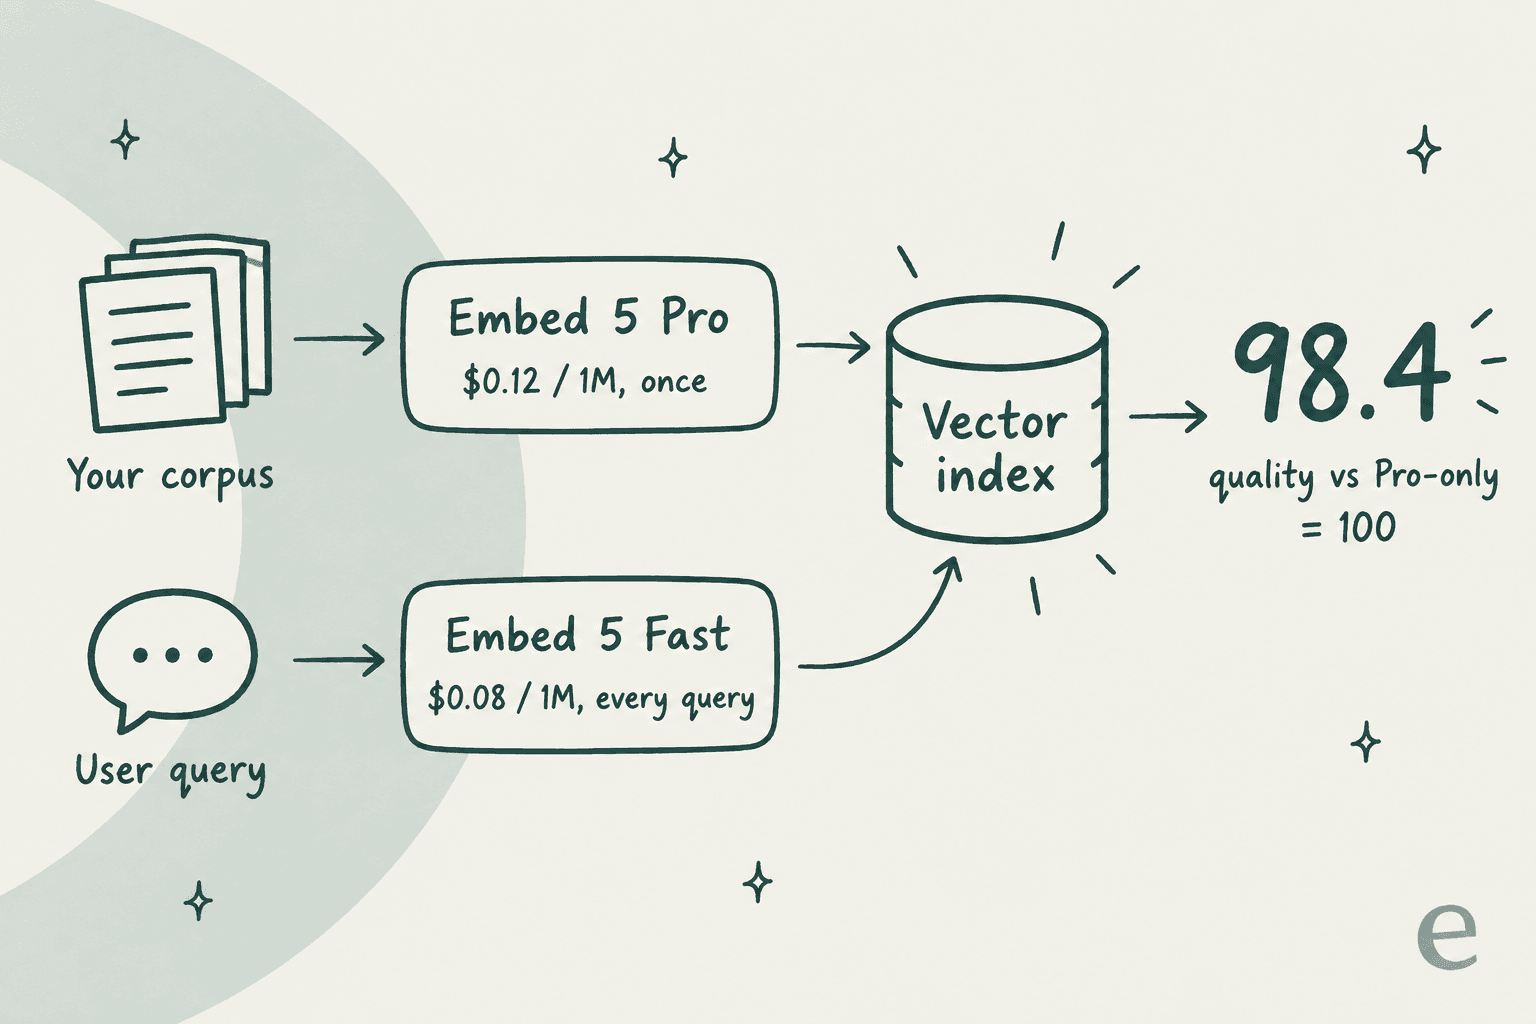
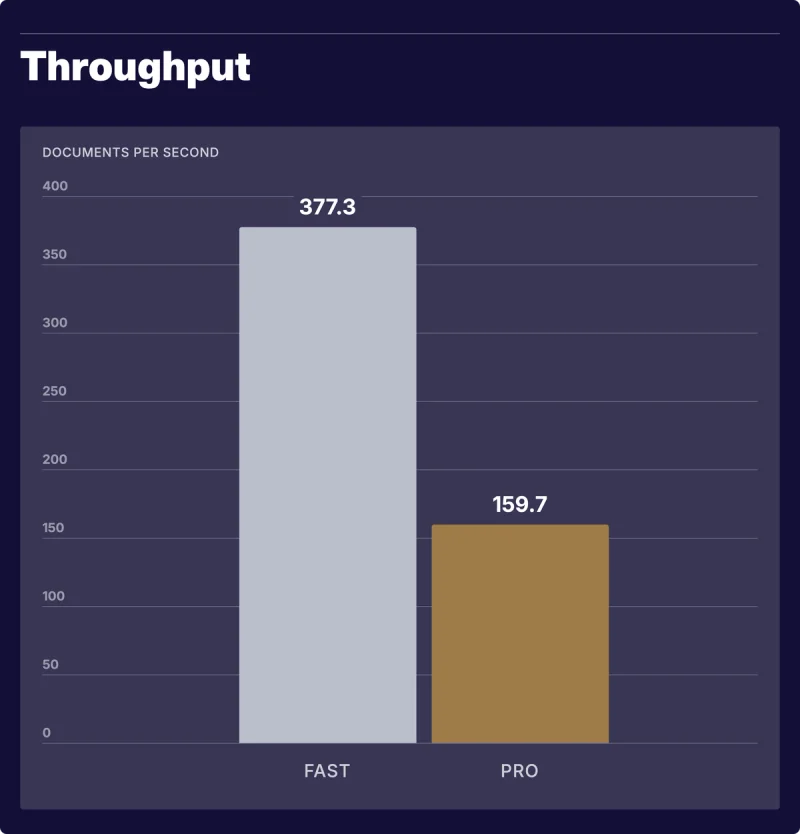
Por que isso importa para o custo? Porque na maioria dos sistemas de busca e RAG (aqui está um pipeline de RAG para suporte se você quiser ver o formato completo), a indexação acontece uma vez (mais as atualizações), enquanto as consultas acontecem para sempre. Assim você paga a taxa Pro na parte que faz raramente e a taxa Fast na parte que faz a cada segundo. O Fast ainda processou 377,3 documentos por segundo contra 159,7 do Pro no teste de throughput da Cohere, então as consultas ficam mais rápidas além de mais baratas.
Aqui eu discordaria um pouco da leitura comum, porque para a maioria das equipes o lado das consultas é minúsculo. Um bot de suporte que atende 30.000 perguntas por mês com cerca de 100 tokens cada envia 3 milhões de tokens de consulta: são US$ 0,36 no Pro ou US$ 0,24 no Fast. A manchete de que "o Fast economiza dinheiro" é real na escala de loops de agentes, em que um modelo dispara dezenas de buscas por tarefa. Para uma central de ajuda normal, escolha o Fast pela latência e pare de se preocupar com o custo dele.
O custo que a página de preços não mostra: armazenamento vetorial
Cada vetor que você cria precisa morar em algum lugar, normalmente um banco de dados vetorial, e esse lugar cobra de você todo mês. De todo o orçamento de embeddings, esta é a parte que vejo mais subestimada, porque a API de embeddings é um custo único por documento, enquanto o banco de dados é aluguel.
O Embed 5 permite escolher o tamanho de saída (256, 512, 768, 1024, 1536 ou 2048 dimensões) e o formato (float, int8, binary e algumas variantes). O exemplo da própria Cohere: 100 milhões de chunks no padrão de 2048 dimensões float ocupam 819 GB, enquanto 256 dimensões binary ocupam 3,2 GB, ou seja, 256 vezes menos.
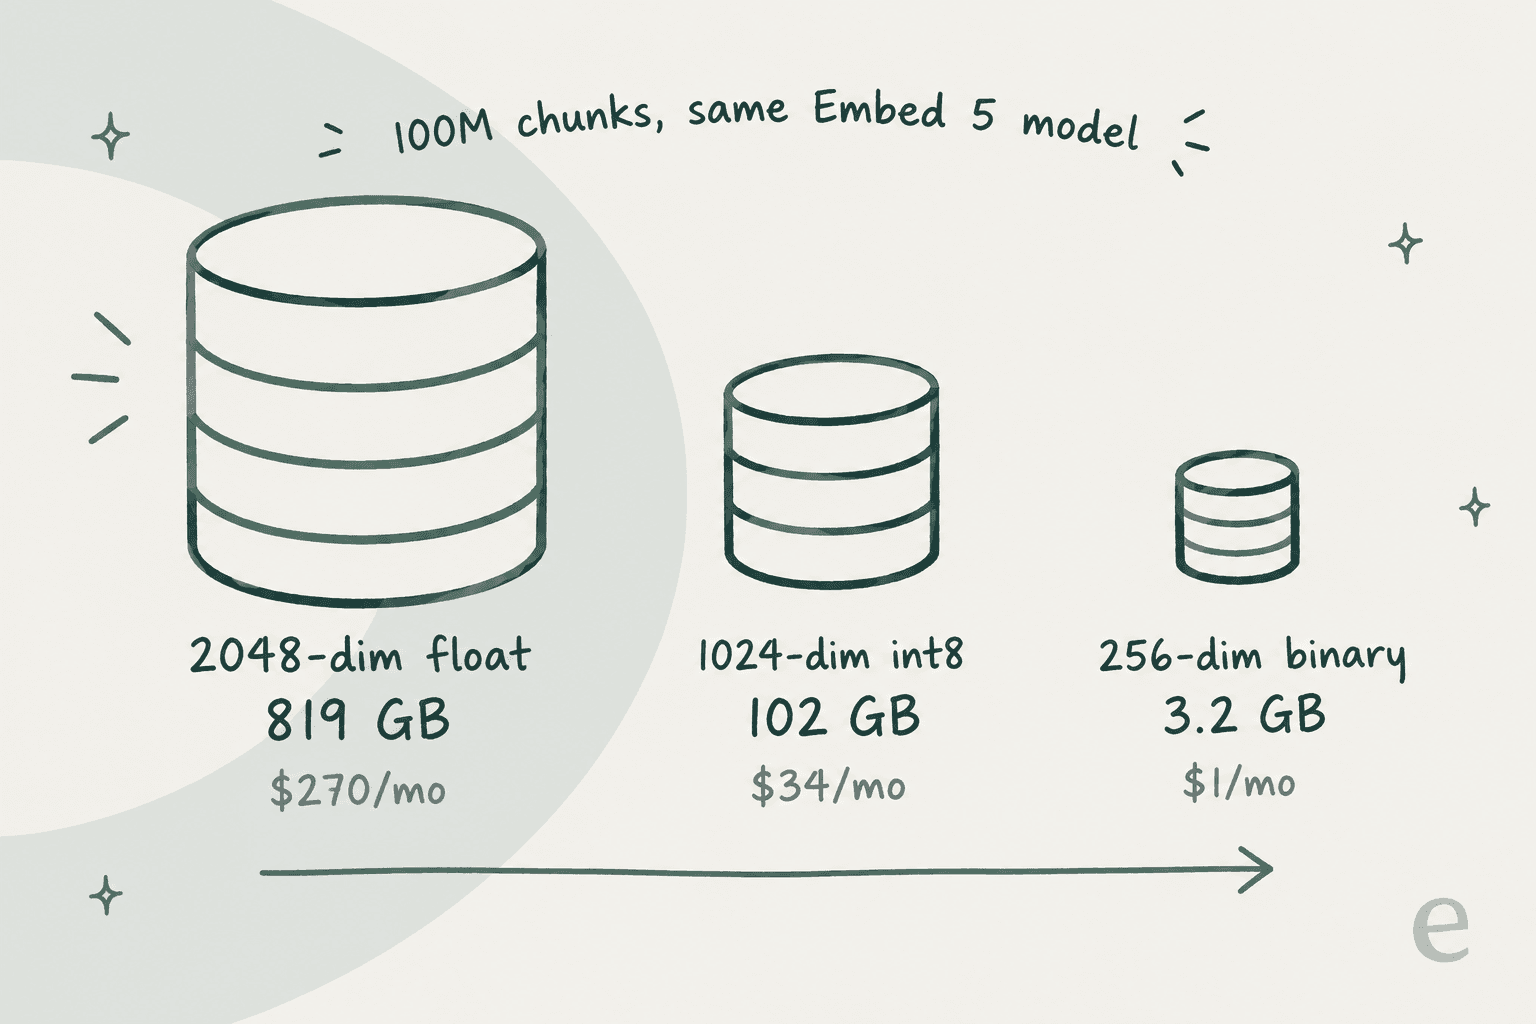
Precifiquei esses três tamanhos no plano serverless da Pinecone a US$ 0,33 por GB por mês (apenas bytes brutos de vetor, antes da sobrecarga do índice e dos metadados). Isso coloca a diferença em US$ 270 por mês contra US$ 34 contra cerca de US$ 1. Em dois anos, a configuração float padrão custa aproximadamente US$ 6.500 só em armazenamento, mais do que os US$ 6.000 que custa embutir 50 bilhões de tokens com o Pro logo de início.
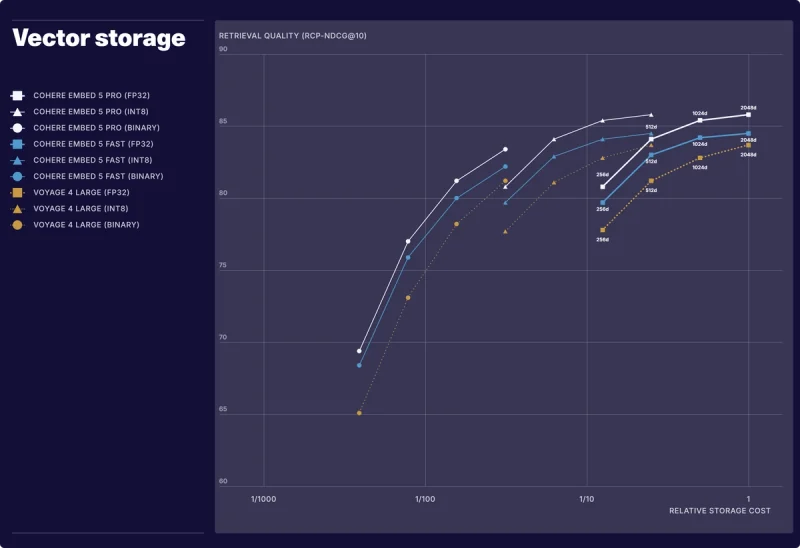
O que você perde em qualidade ao reduzir é menor do que se imagina. O gráfico da Cohere traça a qualidade de recuperação contra o custo relativo de armazenamento, e as linhas int8 ficam quase em cima das linhas float. A recomendação da própria Cohere é int8 de 1024 dimensões, e é também a configuração com a qual eu começaria.
Outros bancos de dados precificam de forma diferente, e o formato da conta muda junto. O Weaviate Cloud cobra por milhão de dimensões vetoriais armazenadas (a partir de US$ 0,00465 no Flex), então 2048 dimensões custam literalmente o dobro de 1024. A Pinecone também cobra de US$ 16 a US$ 18 por milhão de unidades de leitura no Standard, com mínimo mensal de US$ 50, e para índices pequenos isso pesa mais do que o armazenamento. Comparei as opções de bancos de dados com mais profundidade no meu detalhamento dos preços do Weaviate e no apanhado de alternativas ao Weaviate.
Se você prefere não operar um banco de dados, a opção hospedada da OpenAI é abordada no meu guia de vector stores, embora ela prenda você aos modelos de embeddings da própria OpenAI.
Estime sua conta do Embed 5
Insira aqui seu próprio corpus e seu próprio tráfego. A calculadora usa as taxas publicadas da API e a taxa de armazenamento da Pinecone de US$ 0,33/GB, então a linha de armazenamento é melhor tratada como um piso.
Experimente trocar de int8 de 1024 dimensões para float de 2048 dimensões, que são os padrões do Embed 5. Com um milhão de chunks, a conta de indexação não se mexe, enquanto a linha de armazenamento salta 8 vezes.
API vs Model Vault vs marketplaces de nuvem
O Model Vault troca o medidor por token por um aluguel fixo de uma instância dedicada e single-tenant. A conta do ponto de equilíbrio é bem simples:
| Instância | Mensal | Equilíbrio no Pro | Equilíbrio no Fast |
|---|---|---|---|
| Small | US$ 2.000 | ~16,7 bi de tokens/mês | ~25 bi de tokens/mês |
| Medium | US$ 3.250 | ~27,1 bi de tokens/mês | ~40,6 bi de tokens/mês |
Dezesseis bilhões de tokens por mês são cerca de 550 milhões por dia. Pouquíssimas equipes embutem tanto, então para quase todo mundo a API continua sendo a opção mais barata. A Cohere também não publica quantos tokens uma instância Small consegue processar por mês, então confirme o throughput com vendas antes de presumir que uma instância cobrirá seu pico.
Mesmo assim as pessoas compram o Model Vault, e o motivo é mais controle do que preço. Não há multitenancy compartilhada e o throughput é garantido, o que também dá um argumento mais limpo para revisões de segurança. Isso combina com todo o discurso da Cohere sobre implantação corporativa. Se você precisa que tudo fique dentro da sua própria rede, os dois modelos podem ser hospedados por conta própria no vLLM por meio de uma implantação privada, com preço definido por vendas.
Os marketplaces são um terceiro caminho. No Amazon SageMaker, o Embed 5 é cobrado como uma taxa de software por hora e por host (US$ 2,39 em uma ml.g5.xlarge, até US$ 8,48 na maior instância Pro) mais a própria instância do SageMaker. O Microsoft Foundry lista os dois modelos em preview, ainda sem preço. O Amazon Bedrock e o Oracle OCI ainda só trazem o Embed 4 em 1º de outubro, a US$ 0,12 por 1M de tokens no Bedrock. Se sua empresa tem gasto em nuvem já comprometido, o caminho do marketplace ainda pode fazer sentido mesmo quando a taxa bruta é pior.
Exemplos práticos: o que uma equipe real paga
Abaixo estão três cenários, usando as taxas publicadas e armazenamento int8 de 1024 dimensões, salvo indicação em contrário.
A central de ajuda e o histórico de tickets de uma equipe de suporte. 2.000 artigos de ajuda de cerca de 800 tokens e 50.000 tickets anteriores de cerca de 400 tokens somam 21,6 milhões de tokens. Indexar com o Pro custa US$ 2,59, uma única vez. Consultas a 30.000 por mês no Fast custam US$ 0,24 por mês. Os vetores cabem no nível gratuito de 2 GB da Pinecone. A conta de embeddings, neste caso, é um erro de arredondamento. O custo real está na engenharia para construir chunking e sincronização, além de permissões e a camada de LLM por cima, o mesmo trade-off que percorro em busca semântica sobre o Zendesk Guide.
Um arquivo de documentos para uma ferramenta de busca interna. 20 milhões de chunks de 500 tokens são 10 bilhões de tokens. Indexar com o Pro custa US$ 1.200; com o Fast seriam US$ 800. O armazenamento em float de 2048 dimensões é de cerca de 164 GB, ou US$ 54 por mês na Pinecone. Com int8 de 1024 são cerca de 20 GB, ou US$ 6,76 por mês. Quando o próximo modelo sair, uma reindexação custa de novo os US$ 1.200 inteiros, e se os PDFs precisarem ser processados antes, o Parse 5 soma sua própria conta por página.
Um agente de alto volume que busca a cada passo. 500 milhões de tokens de consulta por dia são 15 bilhões por mês. No Fast são US$ 1.200 por mês; no Pro, US$ 1.800. Nenhum dos dois cruza a linha de US$ 2.000 do Model Vault, então a API continua ganhando, a menos que você precise de capacidade dedicada.
A lição dos três: a API de embeddings quase nunca é a parte cara. O armazenamento e a reindexação são, e também as pessoas que mantêm o pipeline.
Como os preços do Embed 5 se comparam
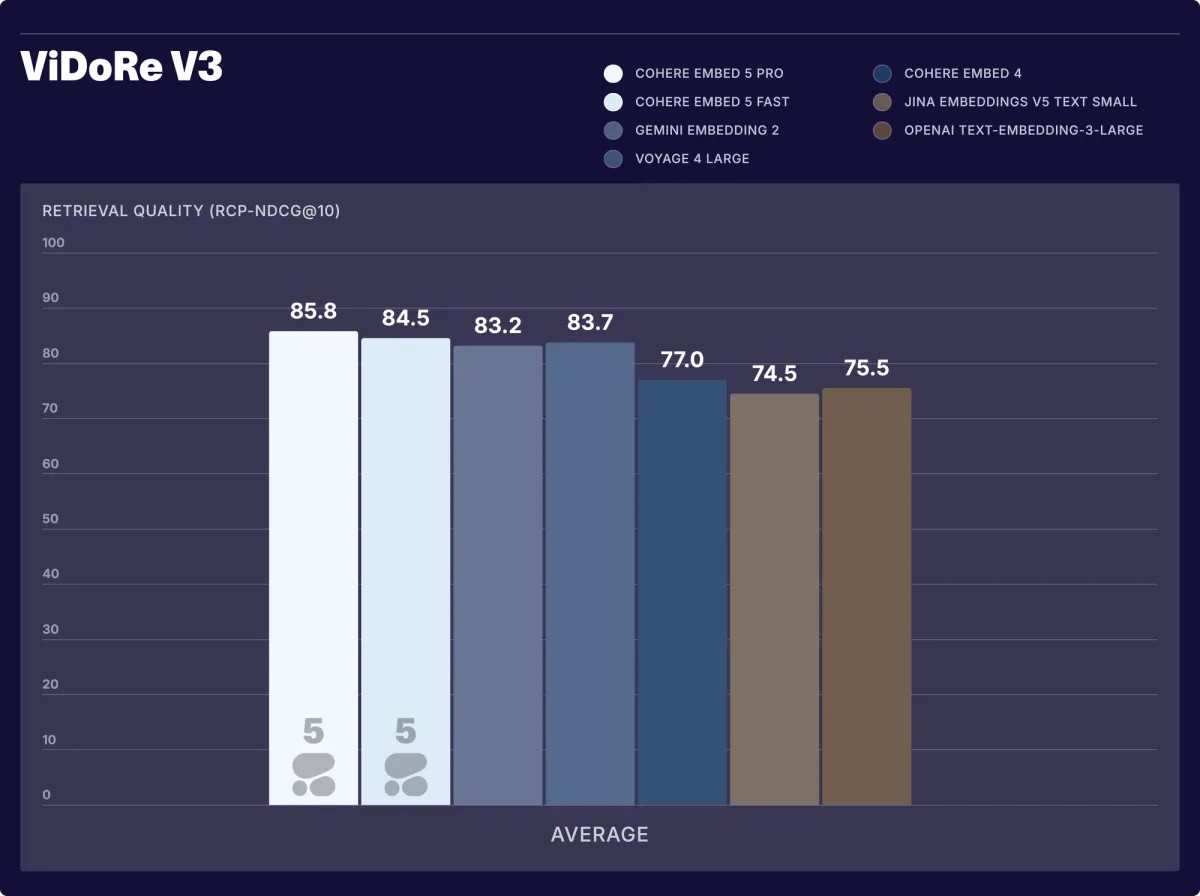
Alinhei o Embed 5 com os outros modelos de embeddings principais, cada preço tirado da página de preços do próprio fornecedor. As pontuações são os números ViDoRe V3 da Cohere do post de lançamento, então leia-os como o teste da própria Cohere e não como um independente.
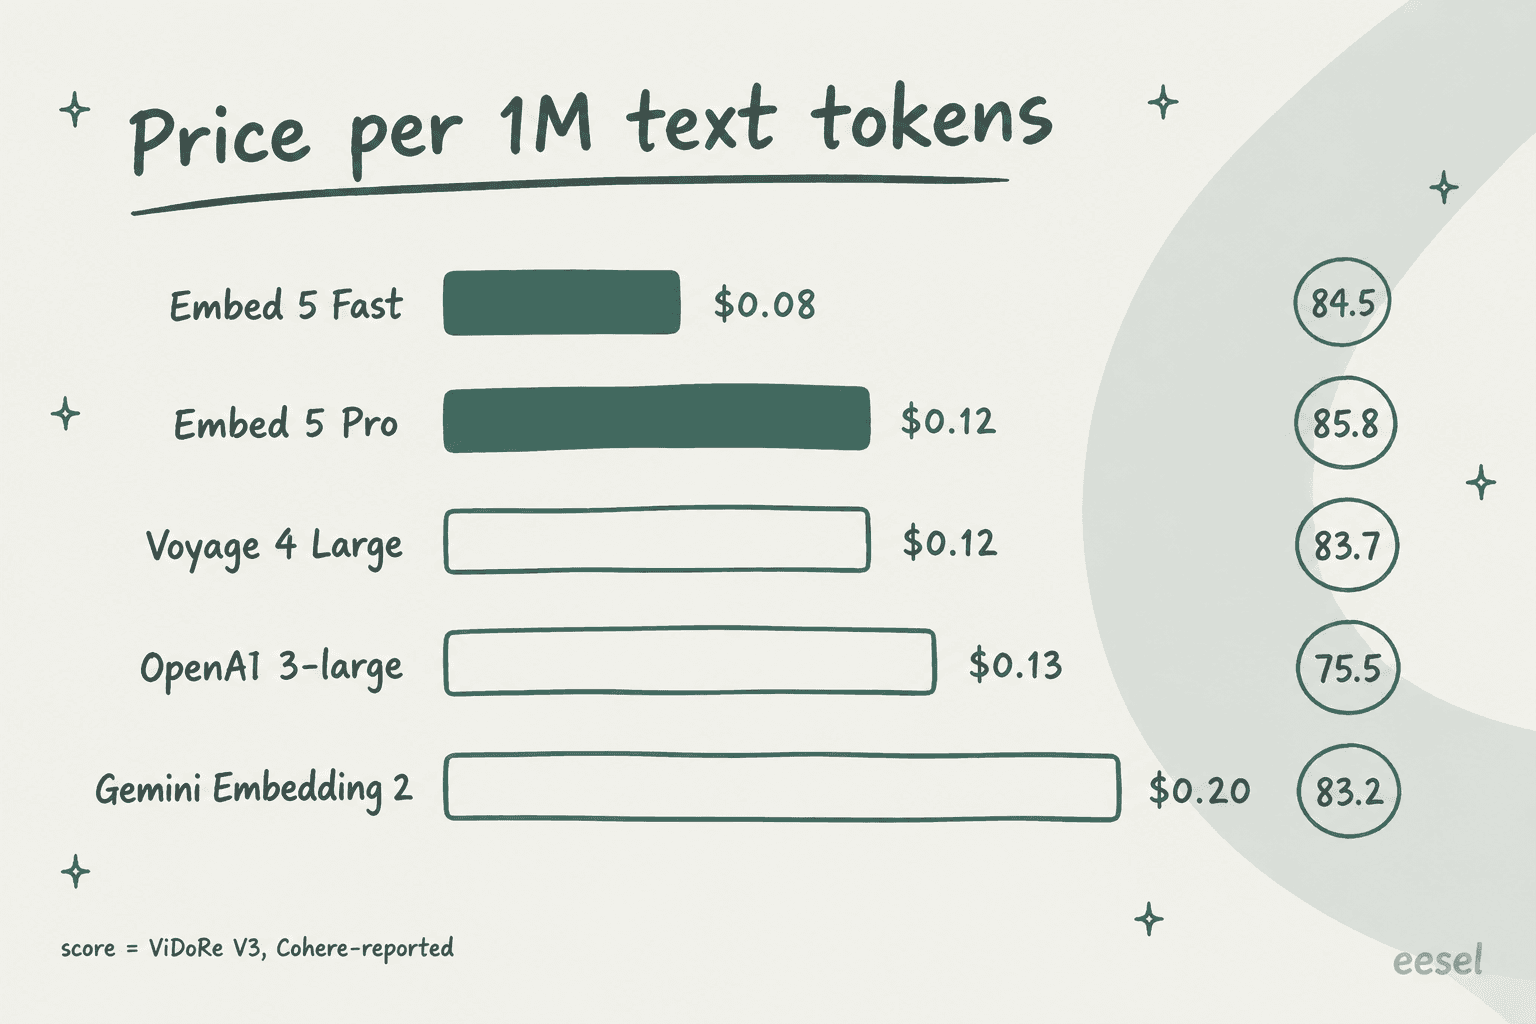
| Modelo | Texto / 1M de tokens | Lote | Plano gratuito | ViDoRe V3 (Cohere) |
|---|---|---|---|---|
| Cohere Embed 5 Pro | US$ 0,12 | Não declarado | Teste de 1.000 chamadas/mês | 85,8 |
| Cohere Embed 5 Fast | US$ 0,08 | Não declarado | Teste de 1.000 chamadas/mês | 84,5 |
| Voyage 4 Large | US$ 0,12 | 33% de desconto | 200M de tokens | 83,7 |
| Gemini Embedding 2 | US$ 0,20 | US$ 0,10 | Sim | 83,2 |
| OpenAI text-embedding-3-large | US$ 0,13 | n/d | Nenhum | 75,5 |
| OpenAI text-embedding-3-small | US$ 0,02 | n/d | Nenhum | n/d |
| Jina Embeddings v5 | US$ 0,045 a US$ 0,05 | n/d | 10M de tokens, não comercial | 74,5 (v5 Small) |
| Mistral embed | US$ 0,10 | n/d | n/d | n/d |
O Embed 5 Fast é o modelo mais barato do grupo de maior pontuação, e o Pro iguala o Voyage 4 Large no preço enquanto o supera ligeiramente no teste da Cohere. O Gemini Embedding 2 custa 2,5 vezes o que o Fast custa na taxa cheia, embora o preço em lote de US$ 0,10 reduza muito essa diferença na indexação offline (taxas completas no meu guia de preços do Gemini). A API de embeddings da OpenAI custa um centavo a mais que o Pro por uma pontuação muito menor neste benchmark.
Há duas ressalvas honestas a fazer. Se o preço puro por token é seu único objetivo, o 3-small da OpenAI e o Voyage 4 Lite estão ambos a US$ 0,02, um quarto do Fast. E a própria tabela multilíngue da Cohere mostra o Gemini Embedding 2 à frente do Pro em 9 dos 10 idiomas asiáticos e do Oriente Médio testados, com o telugu como a maior diferença (91 vs 80). Se seu corpus é majoritariamente em hindi, japonês ou árabe, vale testar o Gemini antes de se comprometer. O modelo embed da Mistral a US$ 0,10 é outra opção para dados europeus; veja minhas notas sobre os preços da Mistral AI. Para uma lista mais ampla, meu post de alternativas à Cohere AI compara os fornecedores além dos embeddings.
O que os desenvolvedores estão dizendo
O Embed 5 tem um dia de vida enquanto escrevo isto, então ainda não há avaliações reais de usuários. O que existe é um histórico estável dos embeddings da Cohere em geral, e o tema que continua aparecendo é a confiabilidade:
"It has the most crisp, steady P50 of any external service I've used in a long time."

As críticas costumam ser sobre custo em alto volume e sobre depender de uma API fechada, o que vale para qualquer modelo de embeddings hospedado:
"The API can also become expensive when you start using it more frequently."

"Voyage for embeddings + rerank is totally defensible - Cohere is popular partly because it's been the default in a lot of examples, not because it's always better."

Acho a última justa, e os números do Embed 5 sustentam os dois lados: o Pro vence o benchmark da própria Cohere, mas por 2,1 pontos sobre o Voyage 4 Large ao mesmo preço. Se você já opera bem o Voyage, não há urgência para migrar. Se você está no Embed 4, passar para o Embed 5 não custa nada a mais por token e é quase uma vitória pura. A integração da Cohere com o LangChain transforma a troca em uma mudança de uma linha no modelo, embora você ainda precise reembutir o corpus.
Qual caminho de preços do Embed 5 serve para você
Aqui estão minhas recomendações, por situação:
- Você está prototipando. Use a chave de teste e depois uma chave de produção pay-as-you-go. Não pense no Model Vault ainda.
- Você está construindo busca ou RAG sobre um corpus fixo. Indexe com o Pro, consulte com o Fast, armazene em int8 de 1024 dimensões. É a configuração de alta qualidade mais barata que a Cohere oferece.
- Você roda agentes que buscam o tempo todo. Fast dos dois lados se precisar do throughput 2,4 vezes maior; índice Pro mais consultas Fast se a qualidade importar mais.
- Você embute dezenas de bilhões de tokens por mês ou precisa de isolamento. Precifique o Model Vault e peça a vendas o throughput por instância antes de assinar. Na AWS, compare com o SageMaker e com os preços de agentes do Bedrock que você talvez já pague.
- Você embute principalmente conteúdo em idiomas asiáticos. Faça primeiro um benchmark do Gemini Embedding 2 contra o Pro com seus próprios dados.
- Você só quer um bot de suporte que responda a partir da sua documentação. Pule totalmente a decisão sobre embeddings e olhe uma base de conhecimento com IA ou um colega de helpdesk que cuide da recuperação para você.
Experimente a eesel quando o objetivo for respostas de suporte
A maioria das pessoas que estão precificando modelos de embeddings não está construindo um mecanismo de busca por si só. Muitas vezes estão escolhendo entre RAG e fine-tuning para uma central de ajuda. O que querem no fim é um bot que responda aos clientes a partir de uma central de ajuda e de tickets anteriores. É nesse ponto que eu pararia e perguntaria se você realmente precisa ser dono do stack.
Na eesel, já vi equipes tomarem essa decisão pelos dois lados. Uma empresa holandesa de hospedagem web no Zendesk, gastando cerca de US$ 1.700 por mês, saiu da eesel para construir sua própria IA internamente. A avaliação da equipe depois não teve nada a ver com custos de modelo:
"A lot of their friction came from setup complexity (handovers, Zendesk integration, business hours logic) and a lack of clear guidance on how to configure things correctly."
Essa é a parte que as páginas de preços de embeddings nunca mostram. Os vetores são baratos. O trabalho de verdade está nas transferências e integrações, além das regras ao redor delas.

A eesel é um colega de helpdesk com IA que entra na sua fila existente no Zendesk, no Freshdesk e em outros helpdesks, aprende com sua base de conhecimento e tickets anteriores, e deixa você reproduzir tickets reais por ele antes de falar com um cliente. Não há modelo de embeddings para escolher nem número de dimensões para ajustar, e você também não recebe uma conta de banco de dados vetorial.
O preço são planos fixos de créditos a partir de US$ 299 por 500 créditos por mês, em que um ticket ou chat atendido equivale a um crédito.
Se você é desenvolvedor, seguir esse caminho não significa perder controle, o que abordo com mais profundidade no meu guia da API de agente de suporte ao cliente. A CLI da eesel permite conectar integrações, editar as instruções do colega, aprovar ou negar ações pendentes e ler seu registro de atividade a partir de um terminal, com saída JSON e uma flag --dry-run para scripts. Agentes de programação como o Claude Code também conseguem operá-la via MCP.
Escrevi mais sobre esse fluxo de trabalho em gerenciando agentes pelo terminal e no passo a passo da CLI para suporte.
Experimente a eesel grátis e veja como sua central de ajuda fica como um colega de suporte em funcionamento, sem escrever uma única chamada de embedding.
Perguntas frequentes
Quanto custa o Cohere Embed 5?
Qual é a diferença de preço entre o Embed 5 Pro e o Embed 5 Fast?
O Cohere Embed 5 é mais caro que o Embed 4?
Existe um plano gratuito para o Cohere Embed 5?
Quando o Cohere Model Vault fica mais barato que a API do Embed 5?
Como os preços do Cohere Embed 5 se comparam aos embeddings da OpenAI?
Preciso do Cohere Embed 5 para criar um agente de suporte com IA?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.