O que o Cohere Embed 5 realmente é
A Cohere é a empresa de IA corporativa por trás dos modelos Command, do Rerank e do analisador de documentos Parse 5. Um modelo de embeddings é a parte discreta de qualquer sistema de busca ou RAG: a peça que transforma um trecho de texto (ou uma imagem) em uma lista de números, e trechos com significado parecido acabam próximos uns dos outros. Quando um usuário pergunta algo, essa pergunta também vira números, e o sistema busca os trechos mais próximos.
Quando o modelo de embeddings é fraco, a resposta certa simplesmente nunca é recuperada, e um prompt engenhoso não vai resolver isso. É a mesma camada que alimenta a busca corporativa com IA.
O Embed 5 assume o lugar do Embed 4 como carro-chefe da Cohere e vem em dois níveis: Pro, "optimized for maximum quality across multimodal, multilingual, financial, code, and parsed-document retrieval", e Fast, que "brings highly competitive performance to latency- and cost-sensitive workloads".
Eu construo agentes de IA para viver na eesel, e a recuperação é a camada onde vai a maior parte do meu tempo de depuração, então essas especificações foram as primeiras que fui procurar. Aqui estão lado a lado, tiradas da documentação do modelo da Cohere e do post de lançamento:
| Embed 5 Pro | Embed 5 Fast | Embed 4 (anterior) | |
|---|---|---|---|
| ID do modelo na API | embed-v5.0-pro | embed-v5.0-fast | embed-v4.0 |
| Preço do texto (por 1M de tokens) | US$ 0,12 | US$ 0,08 | US$ 0,12 |
| Preço da imagem (por 1M de tokens) | US$ 0,40 | US$ 0,40 | US$ 0,47 |
| Tamanho do contexto | 128K tokens | 128K tokens | 128K tokens |
| Entradas | Texto, imagens, texto + imagem fundidos | Texto, imagens, texto + imagem fundidos | Texto, imagens, misto |
| Dimensões de saída | 256 a 2048 (padrão 2048) | 256 a 2048 (padrão 2048) | 256 a 1536 (padrão 1536) |
| Formatos | float, int8, binary | float, int8, binary | float, int8, binary |
| Idiomas | 100+ | 100+ | Multilíngue |
| Melhor para | Indexação offline, busca em que a qualidade é crítica | Consultas ao vivo, loops de agentes, alto volume |
As tarifas do Embed 4 vêm dos preços da Cohere no Microsoft Foundry, já que a página de preços da própria Cohere não lista mais o Embed 4. Se você vem da série 3 da OpenAI, note que os preços de API dela ainda chegam no máximo a US$ 0,13 para o text-embedding-3-large. Na tabela da Cohere há dois pequenos detalhes que as pessoas costumam perder. A saída padrão subiu de 1536 para 2048 dimensões, o que importa para o armazenamento (mais sobre isso abaixo), e a entrada de imagens também ficou mais barata, de US$ 0,47 para US$ 0,40 por 1M de tokens.
Como o Embed 5 funciona: indexe com o Pro, consulte com o Fast
Este é o recurso em torno do qual eu construiria, e é o que tem menos alarde. A maioria das famílias de embeddings, incluindo a API de embeddings da OpenAI, obriga você a escolher um modelo e conviver com ele, porque vetores de dois modelos diferentes não são comparáveis. A Cohere treinou Pro e Fast em um único espaço compartilhado, de modo que uma consulta convertida com o Fast pode ser comparada diretamente com documentos convertidos com o Pro.
Isso importa porque indexar e consultar pedem coisas opostas. A indexação acontece uma vez (ou a cada atualização de documento) e ninguém fica esperando por ela, então aqui você quer a melhor qualidade que o dinheiro pode comprar. A consulta é outra história: acontece a cada requisição do usuário e dentro do seu orçamento de latência, o que significa que o que conta é a velocidade. Ter um espaço compartilhado permite escolher cada lado separadamente.
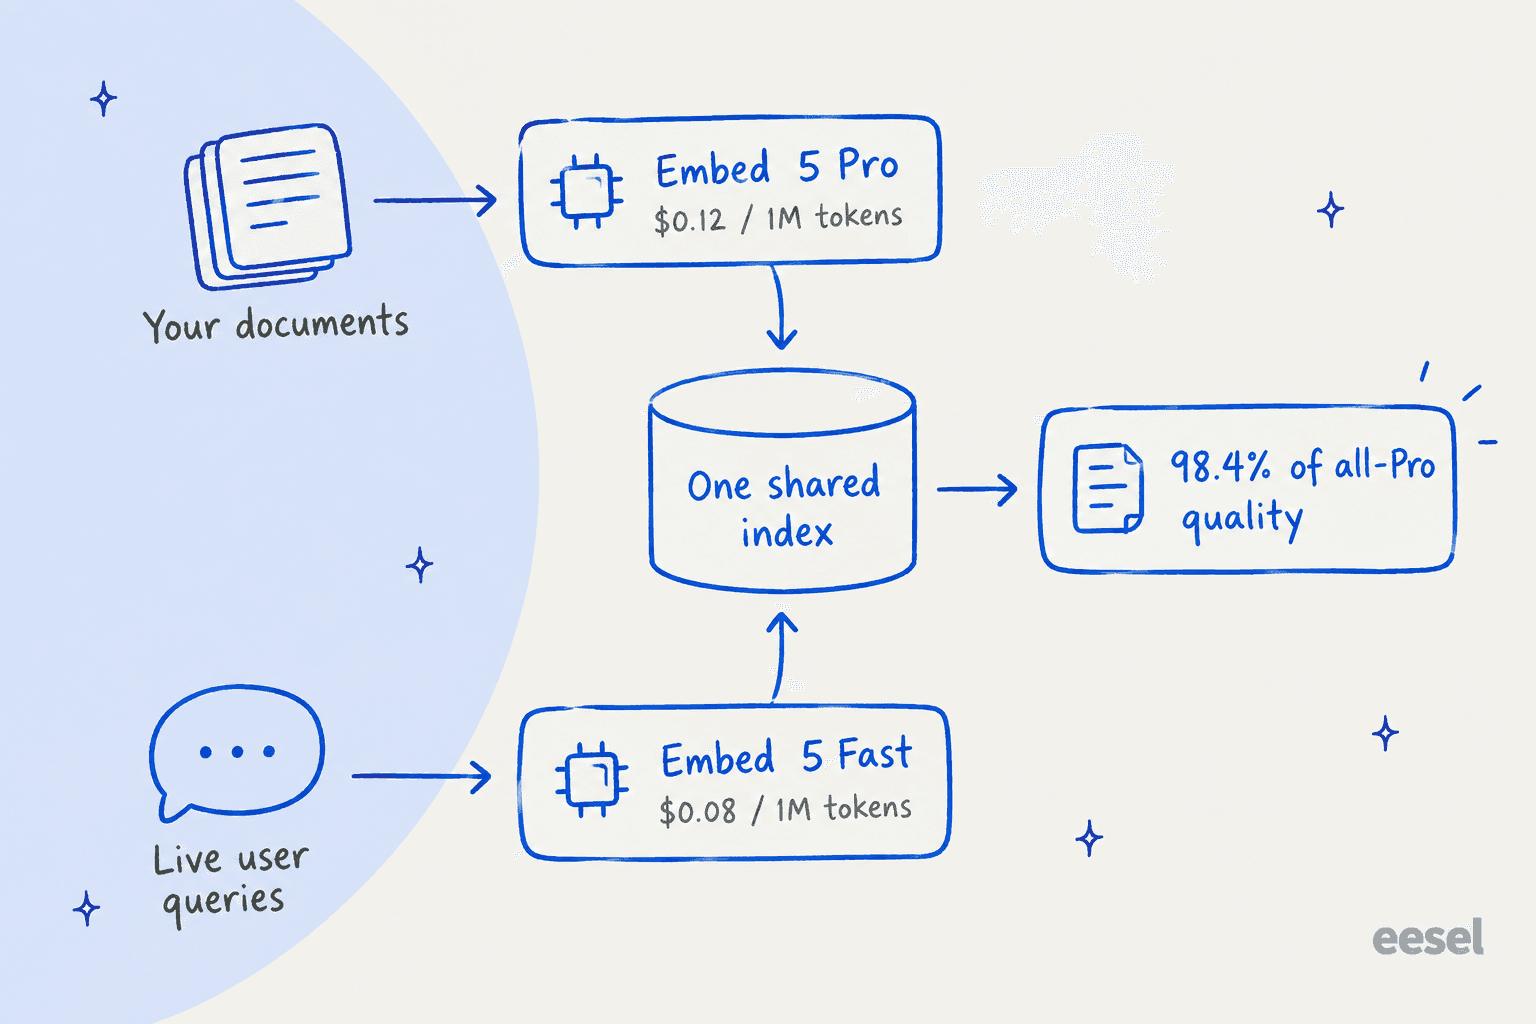
A Cohere testou todas as combinações em 40 conjuntos de dados de desenvolvimento e depois normalizou as pontuações de modo que documentos do Pro mais consultas do Pro seja igual a 100:
| Qualidade média de recuperação | Documentos indexados com o Fast | Documentos indexados com o Pro |
|---|---|---|
| Consultas com o Fast | 96.6 | 98.4 |
| Consultas com o Pro | 97.3 | 100 |
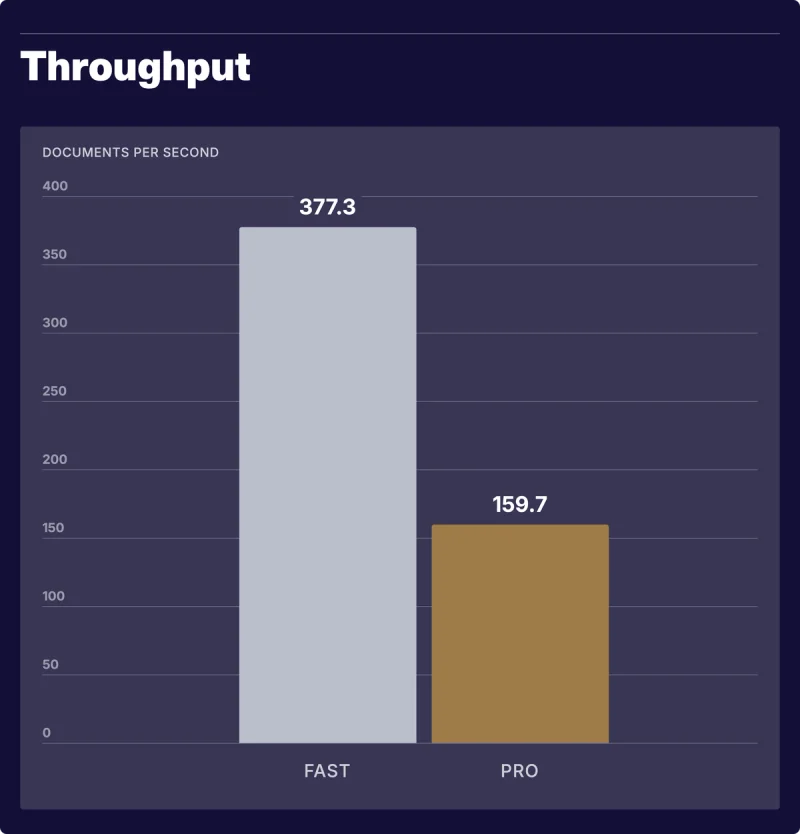
Então índice do Pro mais consultas do Fast chega a 98,4, uma perda de 1,6%, enquanto o Fast faz o trabalho na hora da consulta com cerca de 2,4 vezes o throughput do Pro (377,3 contra 159,7 documentos por segundo no teste da Cohere). A própria Cohere recomenda exatamente esse padrão, e na nota de rodapé está a pegadinha que vale conhecer: os dois lados precisam usar a mesma dimensão de saída. O emparelhamento continua valendo ao adicionar truncamento Matryoshka e quantização int8, então um índice comprimido também funciona.
Alguns detalhes da API, da referência do Embed, que moldam como você a chama:
input_typeé obrigatório. Usesearch_documentao indexar esearch_queryna hora da consulta. Há também os modosclassificationeclustering.- 96 entradas por chamada. Cada entrada pode misturar partes de texto e imagem, com limite de 20 MB de carga total.
- O truncamento padrão é
END. Com contexto de 128K é raro atingi-lo, mas se você prefere receber um erro a perder em silêncio o final de um documento longo, definatruncatecomoNONE. - Os limites de taxa são por entrada, não por requisição: 2.000 entradas de texto por minuto tanto em chaves de teste quanto de produção, e 5 contra 400 entradas de imagem por minuto, segundo a página de limites de taxa. As chaves de teste são gratuitas, mas limitadas a 1.000 chamadas por mês e não permitidas em produção.
Os benchmarks: fortes, mas leia as letras miúdas
Os números que a Cohere publicou são bons. Abaixo está a principal tabela do ViDoRe V3, que cobre documentos corporativos de oito domínios:
| Modelo | Média ViDoRe V3 | Preço do texto por 1M de tokens |
|---|---|---|
| Cohere Embed 5 Pro | 85.8 | US$ 0,12 |
| Cohere Embed 5 Fast | 84.5 | US$ 0,08 |
| Voyage 4 Large | 83.7 | US$ 0,12 |
| Gemini Embedding 2 | 83.2 | US$ 0,20 |
| Cohere Embed 4 | 77.0 | US$ 0,12 |
| OpenAI text-embedding-3-large | 75.5 | US$ 0,13 |
| Jina Embeddings v5 Text Small | 74.5 | US$ 0,05 |
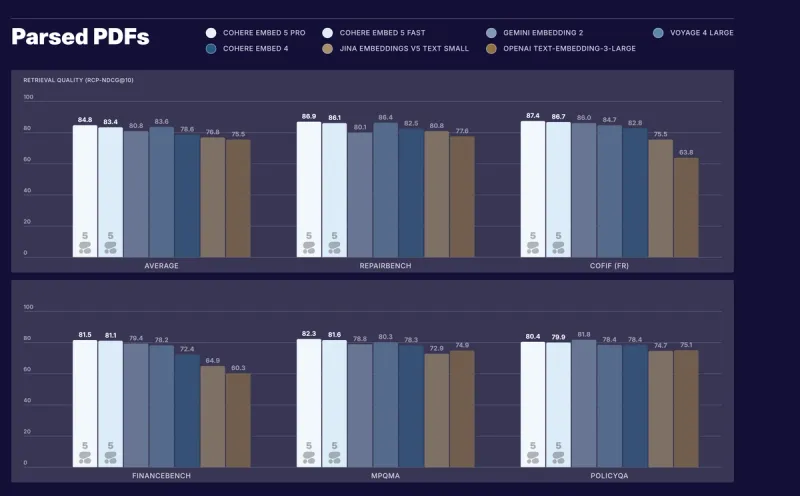
No mesmo teste o Pro ganha 8,8 pontos sobre o Embed 4, e os maiores saltos estão em RH (+11,4) e em documentos industriais (+10,3). Ele também lidera a suíte de PDFs analisados da Cohere, com 84,8. Em recuperação financeira fica em primeiro no FinanceBench (80,1) e no FinQA (90,0), além do ViDoRe V3 Finance (85,0), com o Fast em segundo em todos.
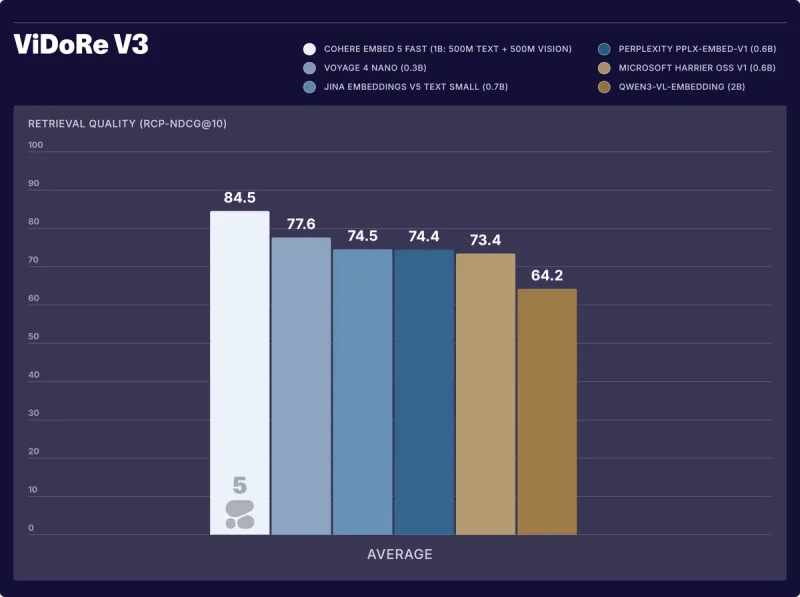
Para mim, o resultado mais impressionante é na verdade o do Fast. Contra outros modelos compactos no ViDoRe V3 ele marca 84,5, onde o Voyage 4 Nano tem 77,6 e o Qwen3-VL-Embedding tem 64,2. A legenda do gráfico da própria Cohere (abaixo) lista o Fast com cerca de 1B de parâmetros, 500M de texto mais 500M de visão, e o post de lançamento diz que ele supera o Qwen3-VL-Embedding-2B em cerca de 20 pontos apesar de ter aproximadamente metade do tamanho.
Agora as letras miúdas, porque uma leitura justa precisa delas.
É uma métrica nova, executada pelo fornecedor. O Embed 5 é a primeira família de modelos pontuada com RCP-nDCG@10, um método que a Cohere publicou no mesmo dia. A própria nota de rodapé da Cohere diz que avalia os modelos reordenando um conjunto fixo de candidatos, então "scores therefore reflect reranking quality rather than first-stage retrieval performance." É uma forma razoável de medir, e o código é público, mas não é o mesmo número que você obteria rodando uma busca top-10 simples sobre todo o seu índice. Além disso, alguns dos conjuntos de dados são internos, como o "High Finance", que a Cohere anotou por conta própria.
O Gemini Embedding 2 vence na maioria dos idiomas não europeus. O Pro lidera o conjunto europeu (média 77 entre alemão, francês, espanhol, italiano e russo). Mas na tabela de dez idiomas da própria Cohere, o Gemini Embedding 2 vence o Pro em 9 dos 10: japonês, coreano, árabe, persa, hindi, bengali, telugu, indonésio e tailandês. O Pro só leva vantagem apertada no chinês (82 contra 81). O telugu é a maior diferença, 91 contra 80.
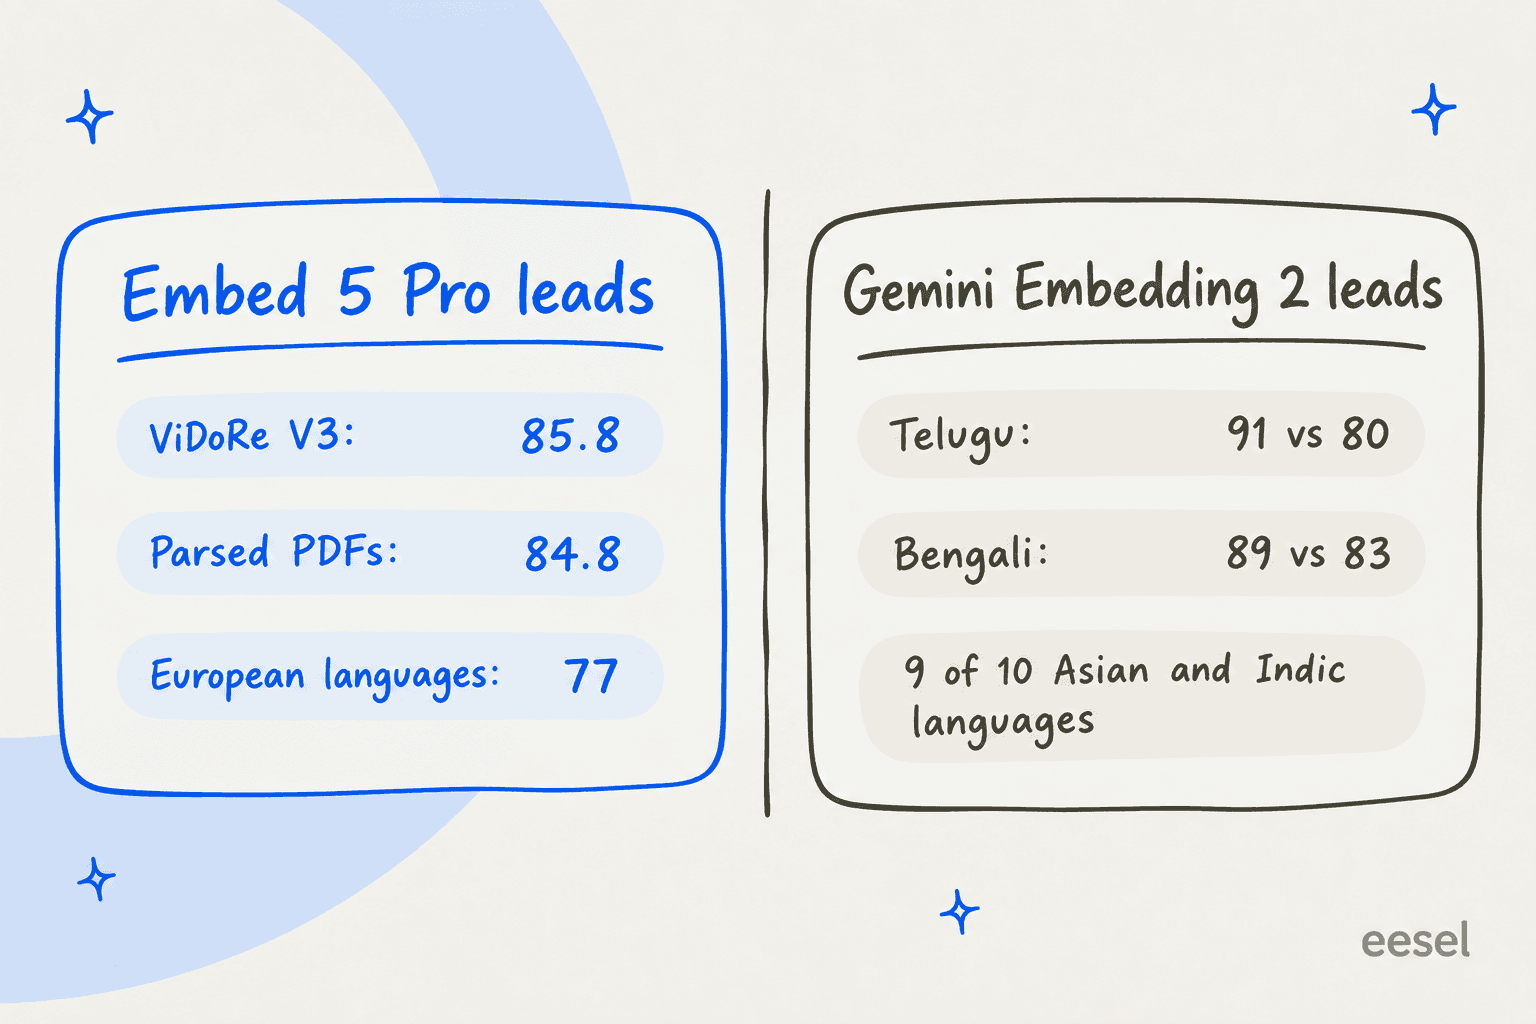
Se a sua fila de suporte ou sua base de documentos depende muito de hindi, tailandês ou bengali, essa tabela é a coisa mais útil de todo o lançamento, e vale dar crédito à Cohere por tê-la publicado. Para uma equipe que atende uma base de conhecimento multilíngue na Europa e em inglês, o Pro é a escolha mais forte segundo esses números.
A reação da comunidade ainda é inicial e escassa, o que é de se esperar um dia depois de um lançamento. A voz mais útil de um praticante que encontrei é mais antiga e fala dos embeddings da Cohere em geral, não do Embed 5 em si:
"My experience with Cohere and interacting with their sales engineers has been boring, I say that is the most flattering way possible. Embeddings are a core service at this point like VMs and DBs. They just need to work and work well and thats what they're selling."

Isso combina bastante bem com a proposta. O Embed 5 não tenta ser empolgante, ele tenta ser a camada chata e confiável que fica por baixo da sua busca.
Preços do Cohere Embed 5
A cobrança do Embed 5 é por token de entrada, e não há cobrança pela saída. Aqui está tudo o que a Cohere publica, da página de preços e do post de lançamento:
| Opção | Embed 5 Pro | Embed 5 Fast | Unidade de cobrança |
|---|---|---|---|
| API da Cohere, texto | US$ 0,12 por 1M de tokens | US$ 0,08 por 1M de tokens | Tokens de entrada |
| API da Cohere, imagens | US$ 0,40 por 1M de tokens | US$ 0,40 por 1M de tokens | Tokens de imagem |
| Chave de teste | Grátis, 1.000 chamadas por mês | Grátis, 1.000 chamadas por mês | Não é para uso em produção |
| Model Vault Small | US$ 3,00/hora ou US$ 2.000/mês | US$ 3,00/hora ou US$ 2.000/mês | Por instância dedicada |
| Model Vault Medium | US$ 5,00/hora ou US$ 3.250/mês | US$ 5,00/hora ou US$ 3.250/mês | Por instância dedicada |
| Amazon SageMaker | US$ 2,39 a US$ 8,48 por hora de host | US$ 2,39 a US$ 3,36 por hora de host | Taxa de software mais custo da instância AWS |
| Microsoft Foundry | Ainda não publicado (prévia) | Ainda não publicado (prévia) |
As tarifas do SageMaker vêm das listagens do AWS Marketplace para o Embed 5 Pro, com uma listagem equivalente para o Fast. A Cohere cobra no fim de cada mês, ou antes, assim que você atinge US$ 250 em aberto. Para o resto do catálogo (Rerank, Parse, Command), veja meu guia completo de preços da Cohere. Se você também analisa PDFs, o detalhamento dos preços do Parse 5 cobre esse medidor.
Três observações de cobrança que eu gostaria de saber antes de definir um orçamento:
- A contagem de tokens de imagem não está documentada. O preço é por 1M de tokens de imagem, mas a Cohere não publica uma fórmula de tokens por imagem. A resposta da API informa as imagens como uma contagem (
"images": 1), então rode um pequeno lote de teste e leia a fatura antes de gerar embeddings de um milhão de imagens de páginas. - O Model Vault só compensa em volume muito alto. Uma instância Small a US$ 2.000 por mês equivale a cerca de 16,7 bilhões de tokens do Pro, ou 25 bilhões do Fast, a tarifas de API. Abaixo disso, a API sai mais barata. Se você escolher o Vault, os motivos reais são isolamento e capacidade garantida, não o preço.
- Ainda não está no Bedrock. O Amazon Bedrock ainda lista o Embed 4 a US$ 0,12 por 1M de tokens, sem SKU do Embed 5. O OpenRouter não traz nenhum modelo de embeddings da Cohere.
Por que o preço por token é o número menos importante aqui
Vou fazer a conta de uma configuração de suporte realista, já que esse é o mundo em que passo meus dias de trabalho. Digamos que você tenha 2.000 artigos da central de ajuda (cerca de 1.500 tokens cada) e 200.000 tickets passados (cerca de 600 tokens cada), aproximadamente 123 milhões de tokens no total. Gerar embeddings de tudo uma vez com o Pro custa cerca de US$ 14,76. Com o Fast, cerca de US$ 9,84. Cinquenta mil perguntas de clientes por mês com 30 tokens cada são 1,5 milhão de tokens, cerca de 12 centavos no Fast. Em outras palavras, a conta de embeddings é basicamente um erro de arredondamento.
O que não some no arredondamento é o armazenamento, que escala com dimensões e precisão. O exemplo da própria Cohere: um vetor float32 de 2048 dimensões tem 8 KB, um vetor int8 de 1024 dimensões tem 1 KB e um vetor binário de 256 dimensões tem 32 bytes.
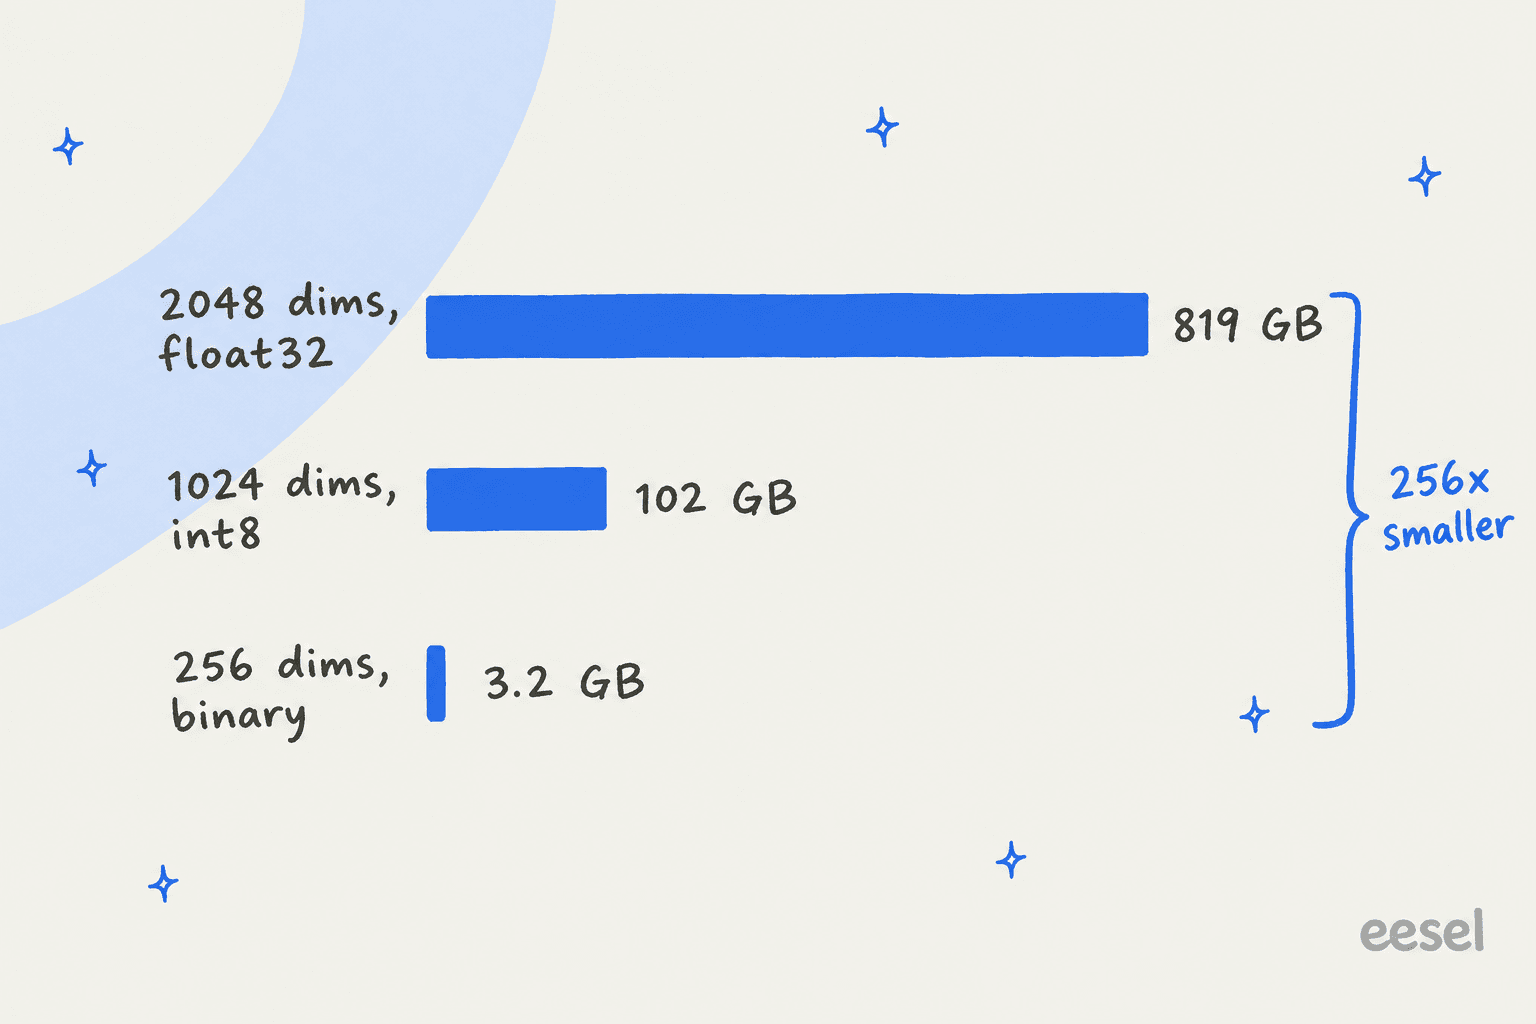
Com 100 milhões de trechos, a saída float32 padrão dá cerca de 819 GB de vetores brutos. No plano Standard da Pinecone (ou em um armazenamento de vetores hospedado) a US$ 0,33 por GB ao mês, isso dá cerca de US$ 270 por mês antes da sobrecarga do índice, todo mês. Os mesmos trechos em int8 de 1024 dimensões dão cerca de 102 GB, aproximadamente US$ 34 por mês. Gerar os embeddings desses 100 milhões de trechos uma vez (com cerca de 500 tokens cada) custa cerca de US$ 6.000 no Pro, uma cobrança única. Escolha suas dimensões e precisão antes de indexar, porque mudar depois significa gerar tudo de novo do zero.
A recomendação da Cohere bate com isso: "For most deployments, we recommend 1,024-dimensional int8 vectors as the ideal performance-efficiency point," e o int8 "retains near-full-precision retrieval quality." O binário é o menor deles, perde um pouco de precisão e funciona bem como uma primeira passada rápida antes de um reranker.
Migrando do Embed 4: o que planejar
Se você usa o Embed 4 hoje, a migração é mais do que trocar o nome do modelo. Coisas a planejar:
- Reindexe tudo. A Cohere diz que Pro e Fast compartilham um espaço entre si. Ela não diz nada sobre os vetores do Embed 4 serem comparáveis aos do Embed 5, então assuma que não são e reserve orçamento para uma geração completa de novo. Com os preços acima, isso costuma ser barato em dólares, embora caro em tempo de engenharia.
- Fique de olho na dimensão padrão. O Embed 4 usava 1536 por padrão, o Embed 5 usa 2048. Se o índice do seu banco de dados vetorial está fixo em 1536, passe
output_dimension=1536(o Embed 5 suporta) ou reconstrua o índice. - Verifique sua nuvem. Se você chama a Cohere pelo Bedrock ou pelo Oracle OCI, o Embed 5 ainda não está lá. Os canais de lançamento são a API da Cohere, o Model Vault, o Microsoft Foundry e o SageMaker.
- Jobs em lote. A Cohere diz que o embedding em lote está disponível para ingestão em grande escala, mas a tabela da documentação lista apenas o endpoint padrão do Embed para os modelos v5, então confirme o suporte a Embed Jobs para o seu modelo antes de projetar um pipeline em massa em torno disso.
Antes de culpar (ou elogiar) o modelo, verifique primeiro o resto do pipeline. Esta resposta em uma thread do r/Rag sobre ajuste fino de embeddings é o conselho mais prático sobre trocas de modelo que já encontrei:
"more than I expected. but only after chunking was already clean. dirty chunks make every embedding model look bad."

Isso combina com a minha própria experiência. Se você quer um exemplo prático, o guia de busca semântica sobre o Zendesk Guide percorre o lado da divisão em trechos. Um modelo de embeddings melhor ajuda mais quando a divisão em trechos já está sólida e você tem busca híbrida e um reranker no lugar.
Onde o Embed 5 se encaixa e onde não
O Embed 5 é uma ótima escolha se você é uma equipe de plataforma construindo seu próprio stack de busca ou RAG, especialmente sobre documentos longos, visualmente ricos ou financeiros. O contexto de 128K significa menos cortes desajeitados de trechos, e a entrada fundida de texto mais imagem dá conta de apresentações e páginas digitalizadas. Além disso, a divisão Pro/Fast oferece um controle limpo entre velocidade e qualidade. Combine com o Parse 5 para transformar PDFs em Markdown e com o Rerank para ordenar os resultados, e você tem todo o stack de recuperação da Cohere. A Cohere também anunciou que sua plataforma de busca gerenciada, o Compass Cloud, está agora em beta privado.
"Cohere seems to be doing a lot on the search side this year with their parsing model, Compass Cloud announcement, and now Embed 5... exciting stuff"
É o nível errado do stack se o seu objetivo real é uma ferramenta do dia a dia, como uma base de conhecimento com IA para sua equipe ou uma IA que responde perguntas de clientes a partir da sua central de ajuda e tickets passados. Um modelo de embeddings entrega vetores. Você ainda precisa de divisão em trechos, um banco de dados vetorial, um reranker, um modelo de geração como o GPT-6.1 Sol, salvaguardas e uma forma de levar as respostas ao seu helpdesk.
Se quiser os trade-offs com mais profundidade, comece por RAG versus LLMs puros. Para centrais de ajuda em particular, há um guia separado sobre RAG versus ajuste fino.
A lição mais dura que tirei de rodar IA em filas de suporte ao vivo não tem nada a ver com a qualidade da recuperação, e sim com o que acontece quando a recuperação volta vazia. Já vi bots de clientes pagantes responderem a clientes reais com afirmações confiantes e inventadas porque a base de conhecimento não tinha nada relevante e o modelo preencheu a lacuna com seus dados de treinamento. Um modelo de embeddings melhor torna isso mais raro, mas não impossível. A solução está na camada de cima: um fallback rígido quando nada relevante é encontrado e testes com tickets reais antes do lançamento.
Experimente a eesel se você quer as respostas, não o pipeline
Se você está lendo sobre modelos de embeddings por causa de um problema de suporte, a eesel é o atalho. A eesel é uma plataforma de colegas de IA, e seu colega de IA para o helpdesk é todo o stack de recuperação, já montado: ele se conecta à sua central de ajuda, à sua documentação e aos seus tickets passados, e redige ou envia respostas dentro do seu helpdesk, do Slack ou de um link compartilhável. Sem vetores para dimensionar, sem índice para reconstruir quando sai um modelo novo.
Ele se integra aos helpdesks que a maioria das equipes de suporte já usa. No Zendesk ele responde a partir de macros e tickets resolvidos; no Freshdesk e no Gorgias ele trabalha a mesma fila que os seus agentes.

Antes de tocar em um cliente ao vivo, a eesel simula a implantação nos seus tickets históricos, para que você veja de antemão as respostas que ela teria enviado e a taxa de resolução. É assim que eu gostaria que qualquer resolução automatizada de tickets conquistasse seu lugar em uma fila ao vivo.
E se você chegou aqui porque gosta de trabalhar no terminal, a CLI da eesel permite rodar o mesmo colega pela linha de comando: conecte uma integração com eesel integrations connect, edite suas instruções permanentes, aprove ou negue ações pendentes e leia cada execução com eesel activity. Todo comando retorna JSON e aceita --dry-run, então scripts e agentes de programação como o Claude Code também podem operá-lo. Há um passo a passo completo sobre gerenciar agentes pelo terminal e um texto mais curto sobre a CLI para atendimento ao cliente.
Experimente a eesel grátis nos seus próprios tickets.
Perguntas frequentes
O que é o Cohere Embed 5?
embed-v5.0-pro) e Embed 5 Fast (embed-v5.0-fast), ambos com janela de contexto de 128K tokens e mais de 100 idiomas.Quanto custa o Cohere Embed 5?
US$ 0,12 por 1M de tokens de texto e o Embed 5 Fast custa US$ 0,08. A entrada de imagens custa US$ 0,40 por 1M de tokens de imagem nos dois. As instâncias dedicadas do Model Vault começam em US$ 3,00 por hora (US$ 2.000 por mês). Para a lista de preços completa da Cohere, veja este detalhamento de preços da Cohere.Qual é a diferença entre o Embed 5 Pro e o Embed 5 Fast?
O Cohere Embed 5 é melhor que os embeddings da OpenAI?
Preciso gerar os embeddings dos meus dados de novo para migrar do Embed 4 para o Embed 5?
output_dimension explicitamente se o esquema do seu índice for fixo.O Cohere Embed 5 está disponível no Amazon Bedrock?
Posso usar o Cohere Embed 5 para busca no atendimento ao cliente?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.