

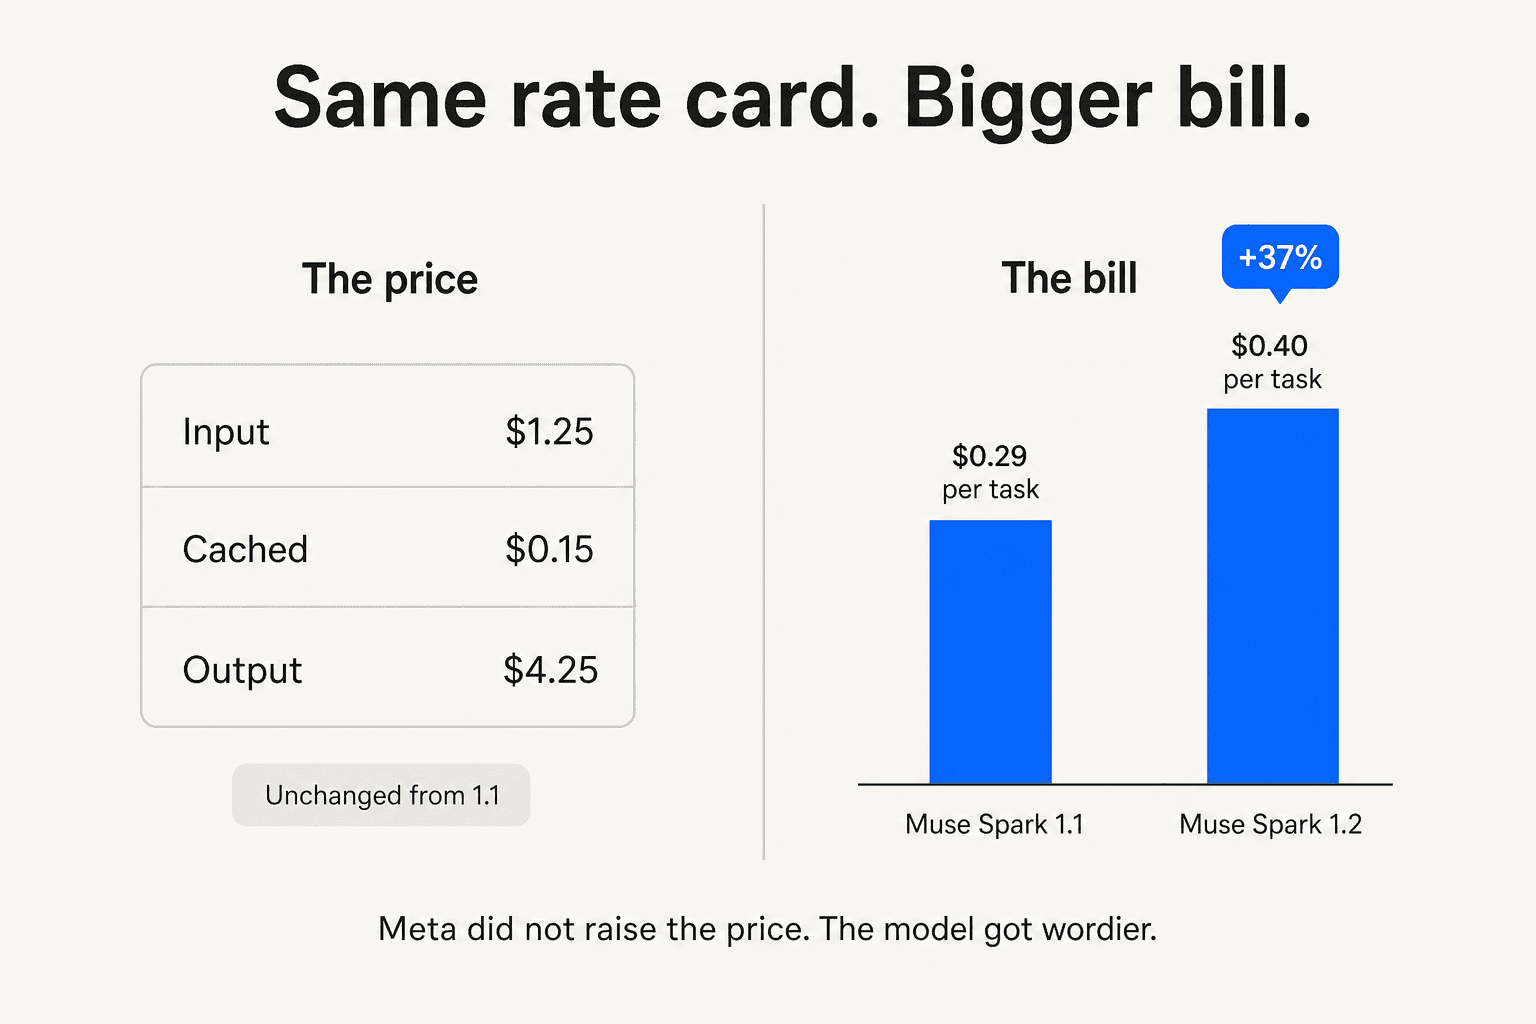
A Meta não mudou um único número da tabela do Muse Spark, e o modelo continua custando 37% mais para rodar. O nível padrão custa $1.25 por milhão de tokens de entrada, $0.15 em cache, $4.25 de saída, exatamente o que o 1.1 custava. O nível contributor custa $0.10 / $0.002 / $0.20 se você deixar a Meta treinar com o seu tráfego. Mas a Artificial Analysis mediu que o custo por tarefa de benchmark subiu de $0.2923 no 1.1 para $0.3992 no 1.2, e o motivo não é o que todo mundo supôs.
O raciocínio ficou mais barato. O dinheiro extra foi para leituras de cache e para a própria resposta, que ficou 78% mais longa por tarefa. Então o número que vale acompanhar é quantos tokens o modelo decide gastar em seu nome, algo sobre o qual a tabela da Meta não diz nada.
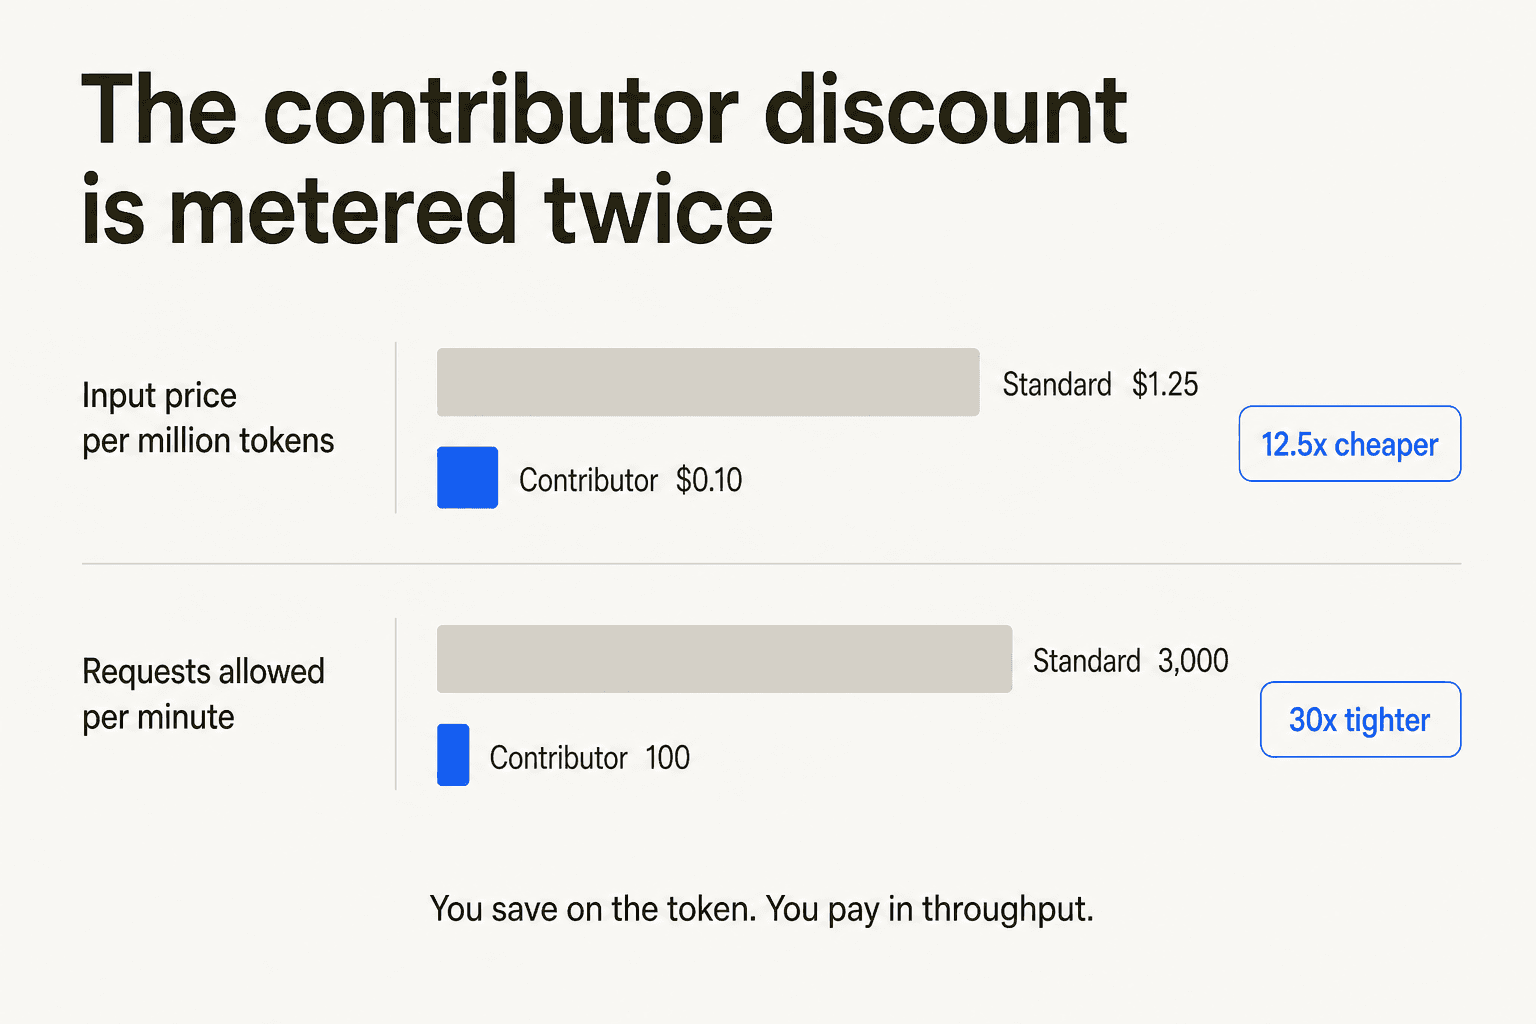
Duas coisas para checar antes de escolher um nível. O desconto do contributor é medido duas vezes: entrada 12.5 vezes mais barata e um teto 30 vezes mais apertado, de 100 requisições por minuto contra 3,000. E ficar no 1.1 não economiza nada, porque a Meta cobra o mesmo preço pelos dois checkpoints.
Se você está calculando isso para uma fila de suporte e não para um projeto paralelo, a resposta honesta é que nenhuma tabela por token consegue prever essa fatura. Um ticket resolvido são várias chamadas, recuperação e novas tentativas. É por isso que a eesel cobra 1 crédito por ticket, não importa a duração, e deixa você simular o custo com o seu próprio histórico de tickets antes de qualquer coisa entrar no ar.
Preços do Meta Muse Spark 1.2, a tabela completa
Aqui está cada número publicado, conferido nas páginas da própria Meta em 17 de agosto de 2026. Todos os preços são em dólares americanos por milhão de tokens.
| ID do modelo | Nível | Contexto | Entrada | Entrada em cache | Saída | Texto da política de dados da Meta |
|---|---|---|---|---|---|---|
muse-spark-1.2-contributor | Contributor | 1,048,576 | $0.10 | $0.002 | $0.20 | "Used to improve our products." |
muse-spark-1.2 | Padrão | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
muse-spark-1.1 | Padrão | 1,048,576 | $1.25 | $0.15 | $4.25 | "Not used to improve our products." |
Essa terceira linha é a que a maioria das coberturas perde. A página da Model API da Meta lista o checkpoint anterior exatamente pelo mesmo preço, e o documento de preços confirma que os dois checkpoints compartilham o preço padrão. Não existe um nível legado barato para onde recuar. Se o comportamento do 1.2 custa mais para você, voltar de versão não devolve o dinheiro, o que muda em relação a como os preços do Muse Spark 1.1 eram lidos no lançamento, quando ele era o único checkpoint da tabela.
Algumas coisas aqui merecem ser ditas com clareza antes de eu entrar no que a tabela esconde.
Não há prêmio por contexto longo. A Meta diz isso de forma explícita na página de preços e limites: você paga o mesmo com a janela quase vazia ou quase cheia. Vários fornecedores elevam o preço acima de um limite de contexto, e se você coloca um prefixo grande e estável em cada chamada, essa diferença se acumula rápido.
O prompt caching é automático e gratuito. O prefix caching da Meta tem "no flag or key to manage", não há taxa de escrita de cache na tabela e os tokens em cache são um subconjunto com desconto da entrada, não uma sobretaxa. Você pode pedir retenção estendida com prompt_cache_retention: "24h", embora a Meta chame isso de uma dica e não de uma garantia.
E a estrutura de apoio da própria Meta é gratuita. A documentação observa que a Meta injeta uma pequena quantidade de contexto de direcionamento em cada prompt, e que esses tokens "are not billed and are excluded from the token counts reported in your usage." É uma gentileza pequena, mas é o tipo de coisa que aparece em silêncio em outras faturas.
A tabela não se mexeu. A fatura subiu 37%.
Isso é o que torna estranho escrever sobre os preços do Muse Spark 1.2. A Meta lançou um modelo novo em 5 de agosto, manteve o preço, e o custo de fazer o mesmo trabalho subiu mais de um terço.
A Artificial Analysis roda a mesma bateria de nove avaliações contra todo modelo de fronteira, então a comparação entre versões é o mais controlada que dados públicos conseguem ser. Ela publica duas medidas de custo separadas, e vale mantê-las distintas porque não se movem juntas.
O custo ponderado por tarefa foi de $0.2923 no 1.1 para $0.3992 no 1.2, uma alta de 36.6%. O total para rodar a bateria inteira uma vez foi de $547.32 para $639.27, uma alta de $91.96 ou 16.8%. A primeira é o número que prevê o que um determinado trabalho custa para você, e é com ela que abro. A segunda diz para onde o dinheiro foi, e eu a detalho na próxima seção.
Quero ser cuidadoso sobre o que esses 37% são e não são. É uma carga de benchmark, não a sua carga. Mas é o mesmo benchmark nas duas versões, precificado pela mesma tabela, o que dá uma leitura limpa de uma pergunta: quanto mais este modelo gasta por unidade de trabalho? Mais de um terço, de graça, sem que ninguém anuncie uma mudança de preço.
Esse é o modo de falha em que vejo equipes caírem repetidamente, e não tem nada a ver com a Meta em particular. Um prospect já ficou numa ligação comigo fazendo suas próprias contas, chegou a cerca de $30,000 por mês para uma empresa crescendo rumo a 150,000 tickets, e toda a confusão vinha da distância entre a unidade que ele contava e a unidade pela qual era cobrado. Outro recebeu uma cota mensal de 3,000 interações enquanto lidava com cerca de 500 tickets por dia, com quatro trocas cada, o que esgota a cota em um dia e meio. Nenhum dos dois era ruim de aritmética. Nos dois casos o multiplicador entre "o que eu conto" e "o que você cobra" ficou invisível até a fatura chegar. A tabela do Muse Spark tem exatamente esse formato.
Para onde os $92 extras realmente foram
Quase todo mundo, incluindo uma versão anterior da minha própria análise do Muse Spark 1.2, supôs que o salto de custo vinha de pensar mais. Modelos de raciocínio ficam mais caros raciocinando com mais força, e o 1.2 foi apresentado como o checkpoint mais inteligente. É um palpite razoável.
Também está errado, e o detalhamento de custos publicado diz isso.
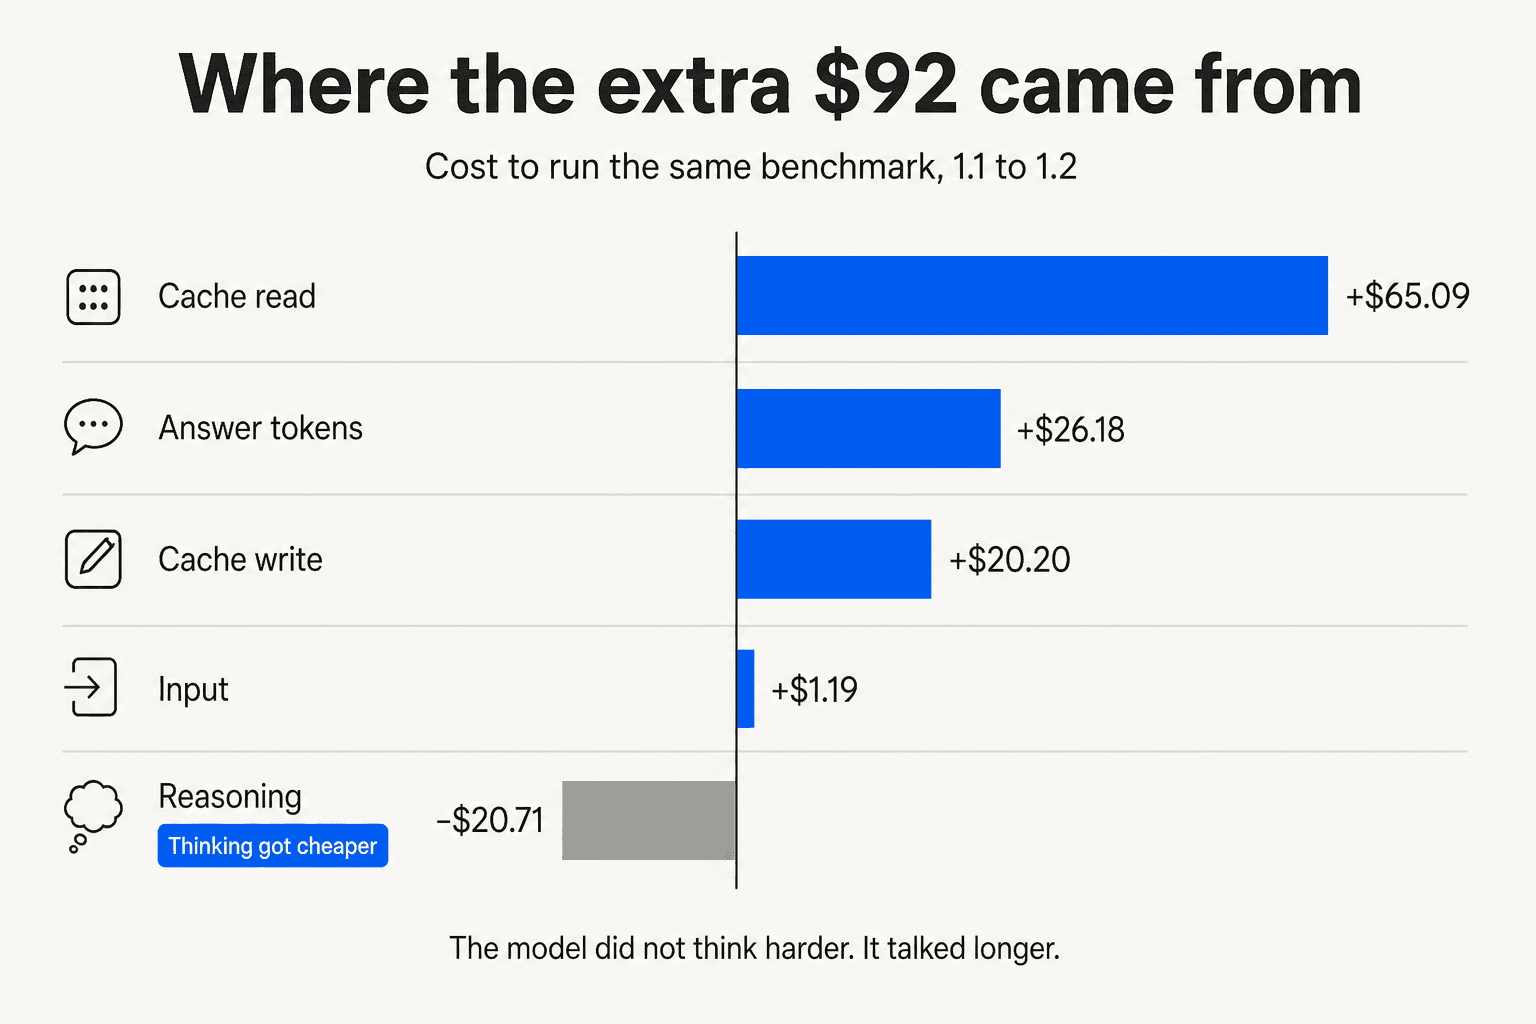
| Tipo de token | Muse Spark 1.2 | Muse Spark 1.1 | Variação |
|---|---|---|---|
| Raciocínio | $339.82 | $360.53 | -$20.71 |
| Leitura de cache | $136.85 | $71.76 | +$65.09 |
| Escrita de cache | $82.21 | $62.01 | +$20.20 |
| Resposta (saída) | $63.61 | $37.42 | +$26.18 |
| Entrada sem cache | $16.78 | $15.59 | +$1.19 |
| Total | $639.27 | $547.32 | +$91.96 |
O raciocínio é a única linha que ficou mais barata. O 1.2 gastou $20.71 a menos em tokens de pensamento oculto do que o 1.1. O aumento veio de todo o resto, e a leitura de cache é o maior fator, quase o dobro.
As contagens de tokens por tarefa explicam o porquê. Os tokens de resposta por tarefa foram de 7,237 para 12,874, um salto de 78%. Os tokens de raciocínio por tarefa subiram só 16%, de 15,158 para 17,557. Enquanto isso, o índice inteiro rodou com aproximadamente o mesmo orçamento total de saída nos dois casos, 95M de tokens contra 94M.
A tradução prática é esta: o Muse Spark 1.2 não pensa com mais força que o 1.1, ele escreve mais longo. Se a sua carga roda agentes de IA em vários turnos, respostas mais verbosas voltam direto para o contexto da chamada seguinte, que é exatamente o mecanismo que dobrou a linha de leitura de cache. A verbosidade se acumula de um jeito que o pensamento puro não faz.
Esse é um botão que você pode de fato girar. Peça respostas mais curtas, limite os tokens de saída e enxugue as partes da sua cadeia de prompts que carregam respostas anteriores adiante. É otimização de LLM comum, a mesma disciplina que mantém os preços da API da Anthropic previsíveis, e o mesmo motivo pelo qual a API da OpenAI surpreende quem nunca olha o tamanho da saída.
O nível contributor é 12.5 vezes mais barato e 30 vezes mais apertado
A estrutura de dois preços é o que todo mundo cita sobre o Muse Spark, e geralmente cita errado, porque o desconto é diferente na entrada e na saída. A entrada cai 12.5 vezes. A saída cai 21.25 vezes. A entrada em cache cai 75 vezes.
O enquadramento da Meta é incomumente direto. A documentação descreve o contributor como "heavily discounted token pricing in exchange for permission" para treinar modelos futuros com seus prompts e respostas, voltado a "prototyping, testing integrations, and scaling experiments where training on your data is acceptable." E o nível não é uma configuração de conta que você liga ou desliga. Nas palavras da Meta, "Tier is a model attribute". Você sai do treinamento chamando outro ID de modelo.
O thread do Hacker News no dia do lançamento foi quase todo sobre se essa troca é justa, e a divisão foi nítida.
"What are you talking about? This is one of the most honest offers ever made by a corporation. "We'll use your data, and we'll compensate you for it." Where is the problem?"

Nem todos concordaram que a promessa do nível padrão vale o prêmio. Quando um comentarista argumentou que a Meta treina com tudo independentemente da fatura, Simon Willison rebateu com um relato sarcástico do que essa acusação realmente implica, que é uma empresa imprimir duas políticas de dados e violar uma delas conscientemente. A diferença contratual é o produto.
Mas o argumento que ninguém estava fazendo é o que mais importa para um orçamento de produção. Estes são os limites publicados:
| Nível | Requisições por minuto | Tokens por minuto |
|---|---|---|
| Padrão | 3,000 | 4,000,000 |
| Contributor | 100 | 3,000,000 |
O nível contributor custa 12.5 vezes menos por token de entrada e permite 30 vezes menos requisições por minuto. O teto de tokens cai apenas 25%, então a limitação é desigual de propósito. A Meta apertou especificamente o caminho das requisições. O contributor tem preço de volume e barreira de prototipagem, uma decisão de produto coerente e uma péssima surpresa se você a descobre depois de construir em cima dele.
Um usuário do X esbarrou nisso diretamente e resumiu em cinco palavras: as requisições por minuto "seem to be severely limited". É o único relato concreto de limite que consegui encontrar em uma plataforma verificável, o que mostra quão poucas pessoas levaram o contributor além de uma carga de hobby.
Mais duas mecânicas que vale conhecer antes de planejar com esses números. Os limites são agrupados por equipe, não por chave de API, então adicionar chaves não aumenta a folga. E as respostas em segundo plano têm um teto separado de 600 envios por minuto por equipe, além de RPM e TPM.
Descubra qual nível você realmente consegue usar
O preço é a segunda pergunta. A vazão é a primeira, porque nenhum desconto ajuda se o teto está abaixo do seu piso. Defina seus números aqui e a resposta aparece.
Os medidores ao lado do medidor de tokens
As taxas de tokens são a manchete, e não são a fatura inteira. Outras quatro coisas cobram ou limitam você.
O grounding com busca na web é medido separadamente a $2.50 por 1,000 consultas de busca, cobrado além dos tokens da requisição. Se o seu agente fundamenta cada resposta com busca, é um segundo medidor rodando em paralelo ao primeiro, e é o mais provável de faltar numa planilha montada a partir da página do modelo.
Não há API em lote nem desconto em lote. A navegação da documentação não lista nenhuma superfície de lote. O único caminho assíncrono são as respostas em segundo plano, que são um modo de envio com seu próprio teto e não um nível com desconto. Se você vinha planejando com os descontos em lote que outros fornecedores publicam, essa economia não existe aqui.
Não há oferta de fine-tuning para o Muse Spark. O documento de modelos lista três IDs de modelo de inferência e nada mais. O fine-tuning no site de desenvolvedores da Meta é território dos pesos do Llama, um produto diferente com outra estrutura de custos.
Não há teto rígido de gastos, e essa é a reclamação que de fato impediu pessoas de se cadastrar. Dois usuários diferentes do Hacker News disseram a mesma coisa no mesmo dia.
"Unfortunately I find this too high risk, I entered my credit card, but can not set a limit. The best I can do is get an email alert. I feel like I am one oopsie away from getting a 100 dollar bill."
É uma lacuna de UX de cobrança e não de preço, e dá para corrigir numa tarde, mas vale saber que, num modelo cuja proposta inteira é token barato, o que bloqueia a conversão é a ausência de um teto.
Como os preços do Muse Spark 1.2 se comparam
Preços de tabela lisonjeiam e enganam nos dois sentidos, então a coluna que importa é o custo medido por tarefa num benchmark fixo. Aqui está o Muse Spark contra os modelos com que ele realmente compete, usando os números do ranking da Artificial Analysis.
| Modelo | Intelligence Index | Custo por tarefa | $/Mtok combinado | Entrada | Saída |
|---|---|---|---|---|---|
| Claude Opus 5 (max) | 63.05 | $2.34 | $3.85 | $5.00 | $25.00 |
| GPT-5.6 Sol (max) | 60.93 | $1.23 | $4.35 | n/a | n/a |
| Kimi K3 (max) | 59.70 | $0.84 | $2.31 | $3.00 | $15.00 |
| Qwen3.8 Max | 58.08 | $1.13 | $1.18 | $2.00 | $6.00 |
| Muse Spark 1.2 (xhigh) | 56.76 | $0.40 | $0.78 | $1.25 | $4.25 |
| GPT-5.6 Terra (max) | 56.58 | $0.51 | $1.74 | n/a | n/a |
| Gemini 3.7 Flash (high) | 56.03 | $0.40 | $0.58 | $0.75 | $3.75 |
| GPT-5.6 Luna (max) | 52.32 | $0.05 | $0.17 | n/a | n/a |
| DeepSeek V4 Flash (max) | 51.77 | $0.11 | $0.23 | $0.44 | $1.32 |
A leitura do lado do comprador é direta, e é uma boa notícia para a Meta. O Muse Spark 1.2 é o modelo mais barato dessa tabela com pontuação acima de 56. Tudo que é mais inteligente custa pelo menos 2.8 vezes mais por tarefa. O Opus 5 custa 5.9 vezes mais. A comparação mais direta é o GPT-5.6 Terra, que pontua praticamente igual e custa $0.51 contra $0.40 do Muse Spark, então a Meta é 22% mais barata com a mesma inteligência.
Uma correção que vale sinalizar, porque atrapalha comparações entre publicações. A Artificial Analysis combina na proporção 7:2:1 de acerto de cache, entrada e saída nessas páginas, e não na proporção 3:1 de entrada para saída, mais antiga e muito difundida. A conta fecha: (0.7 × $0.15) + (0.2 × $1.25) + (0.1 × $4.25) = $0.78. Se você vir um valor combinado calculado com a premissa 3:1, ele não é comparável com esta tabela.
E o GPT-5.6 Luna é a linha que desmonta qualquer história simples de que barato significa fraco: $0.05 por tarefa, oito vezes mais barato que o Muse Spark, com 52.3 no índice. Meu texto sobre o GPT-5.6 Luna detalha o que ele abre mão para chegar lá.
Para as linhas imediatamente acima do Muse Spark, os preços do Kimi K3 trazem a tabela completa. A opção de pesos abertos na ponta barata do ranking está na minha análise do DeepSeek V4 Flash.
O que a tabela de preços deixa de fora
Um texto sobre preços deve ser tão claro sobre as lacunas quanto sobre os números, porque é nas lacunas que um orçamento dá errado.
Velocidade e latência não estão publicadas para o 1.2. A Artificial Analysis não tem medição de velocidade de saída, tempo até o primeiro token nem resposta de ponta a ponta para este checkpoint, e o ranking mostra um traço nas três colunas. O Muse Spark 1.1 tem esses dados, com 225.9 tokens por segundo e 1.38 segundo até o primeiro token, mas eles pertencem ao checkpoint antigo e não devem ser atribuídos ao 1.2. Se o tempo de resposta faz parte do seu caso de custo, você está esperando dados que ainda não existem.
Não há programa de retenção zero de dados. Verifiquei toda a navegação da documentação e não encontrei nenhuma página de retenção de dados, privacidade ou ZDR, nem de autoatendimento nem com venda assistida. O controle mais próximo é um sinalizador de armazenamento de respostas: store: false na Responses API impede que GET /v1/responses/{id} devolva sua resposta, e a Meta deixa claro que "does not disable caching." O nível é a única alavanca de dados que existe.
A API ainda está em prévia pública. A página de produto da Meta agora abre com "Public preview. Now available with expanded global access", o que é melhor do que o enquadramento com restrição geográfica do lançamento, mas prévia é prévia. Preços e limites em uma superfície de prévia estão sujeitos a mudança de um jeito que uma tabela em disponibilidade geral não está.
E um ponto menor que importa se você está testando o nível barato: o acesso pode ser retirado. Um desenvolvedor postou um 403 no meio do trabalho, sem aviso prévio, com o texto "Your access has been restricted due to repeated policy violations". O contributor tem preço de promoção e barreiras de promoção.
O que um desenvolvedor realmente pagou
Tudo acima são preços de tabela e execuções de benchmark. O dado mais útil que encontrei é alguém relatando o custo real da própria sessão, o que é mais raro do que deveria ser.
"even with this subsidized pricing, less than an hour of usage resulted in slightly over $1 of cost (fig. 1). if i do this all month it'll be more expensive than the highest Anthropic/OpenAI subscription"
Isso foi no nível contributor, o barato, aquele que as pessoas chamavam de absurdamente subprecificado no dia do lançamento. Uma hora de trabalho de programação com agentes saiu por mais de um dólar a $0.10 por milhão de tokens de entrada.
O mesmo ponto apareceu com um profissional no LinkedIn dentro de um dia do lançamento, apresentado como alerta e não como recibo.
"But token price isn't the full picture. What matters is cost per task. Different models burn different amounts of tokens to solve the same problem. We don't have that data yet for Muse Spark 1.2. Cheap tokens mean nothing if the model takes twice as many shots to get there."

Ele escreveu isso antes de existirem os dados de custo por tarefa. Os dados chegaram e deram razão a ele, numa direção que ninguém previu: o 1.2 queima mais tokens que o antecessor ao responder mais longo, enquanto o raciocínio ficou um pouco mais barato.
Por que tokens são a unidade errada para uma fila de suporte
Passei três anos na eesel vendo a IA trabalhar em filas de suporte ao vivo, e em todo esse tempo nunca vi uma equipe prever com sucesso uma fatura de suporte a partir de uma tabela por token. A aritmética é fácil o bastante. A unidade simplesmente não sobrevive ao contato com um ticket real.
Um ticket resolvido não é um prompt. É recuperação numa central de ajuda e numa biblioteca de macros, uma passagem de classificação de tickets, uma passagem de redação, geralmente uma nova tentativa quando o primeiro rascunho está errado, às vezes uma chamada de ferramenta para consultar um pedido, e depois a conversa inteira carregada como contexto quando o cliente responde. Cada um desses passos multiplica. Uma taxa baixa por token multiplicada por um número desconhecido de passos não é um orçamento, é uma esperança. Qual modelo você escolhe importa muito menos que essa estrutura, como argumentei ao escolher o melhor modelo para tickets de suporte.
E dá para ver isso dar errado em números reais. Equipes de suporte rotineiramente subestimam por um fator, e as que mais se queimam são as de maior volume, justamente porque o multiplicador se acumula. É a mesma armadilha estrutural da história do Muse Spark 1.2: a taxa ficou parada e o consumo se mexeu. Minha análise do custo do atendimento ao cliente com IA tem o quadro mais completo do que as equipes acabam pagando.
É por isso que a eesel cobra 1 crédito por ticket, não importa a duração, em vez de por token ou por licença, e é a primeira coisa que digo a quem chega segurando uma tabela por token. Uma resolução é a unidade que o negócio já conta, corresponde a algo que um líder de suporte consegue defender numa reunião de orçamento e não se reprecifica em silêncio quando um modelo começa a escrever respostas mais longas. O mesmo argumento está por trás do meu enfoque de custo por resolução.
É também o motivo de o medidor pertencer ao sistema de tickets e não ao modelo, e de a comparação honesta para um líder de suporte ser com uma pessoa e não com uma API. Eu desenvolvi isso no custo de IA versus agente humano.
A outra metade é conhecer o número antes de se comprometer com ele. Eu simulo cada implantação primeiro com os tickets históricos do próprio cliente, o que dá uma taxa de resolução e um custo com tráfego real, e não com um benchmark. Esse hábito veio de ver bots de aparência confiante darem respostas erradas em silêncio em produção, uma disciplina própria coberta em prevenir alucinações de IA, e que por acaso resolve também o problema de previsão. Há mais sobre isso no guia de construir ou comprar, que é a decisão que a maioria dos leitores de uma tabela de preços está realmente tomando.
Experimente a eesel
Se você está calculando o Muse Spark 1.2 porque planeja construir automação de suporte sobre uma API de modelo bruta, a taxa por token é o número menos interessante do projeto. A eesel fica sobre o seu helpdesk, lê a sua base de conhecimento existente e os tickets passados, e começa a resolver conversas de linha de frente em minutos, a 1 crédito por ticket, de modo que a fatura acompanha o trabalho feito e não os tokens gastos.
O que vale experimentar primeiro é a simulação. Aponte-a para o seu histórico de tickets e, antes de qualquer coisa chegar perto de um cliente, você obtém uma taxa de resolução e um custo projetado com o seu próprio tráfego, que é a previsão que uma tabela por token estruturalmente não consegue dar.

Um líder de engenharia que passou exatamente por essa decisão explicou o raciocínio com clareza. De forma anônima, ele dirige uma empresa de hardware de caixas eletrônicos de Bitcoin com uma base de conhecimento de mais de 300 artigos no Confluence e no Telegram:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Grátis para experimentar, e você vê os números simulados antes de decidir qualquer coisa.
O veredito sobre os preços do Muse Spark 1.2
Com $1.25 de entrada e $4.25 de saída, o Muse Spark 1.2 é o melhor custo-benefício da tabela de fronteira acima de 56 no índice de inteligência, e a Meta merece crédito por não reprecificar na atualização, por não cobrar nada extra por contexto longo e por tornar o caching automático em vez de um exercício de configuração.
O que você precisa considerar no planejamento é que o modelo ficou 37% mais caro de rodar sem que o preço mudasse, porque responde 78% mais longo que o 1.1. Limite seus tokens de saída, observe o que sua cadeia de prompts carrega adiante e confira seu pico de requisições por minuto antes de presumir que o nível contributor está disponível para você.
E se a carga é uma fila de suporte, precifique em resoluções. É a única unidade que já sobreviveu a uma fatura real.