

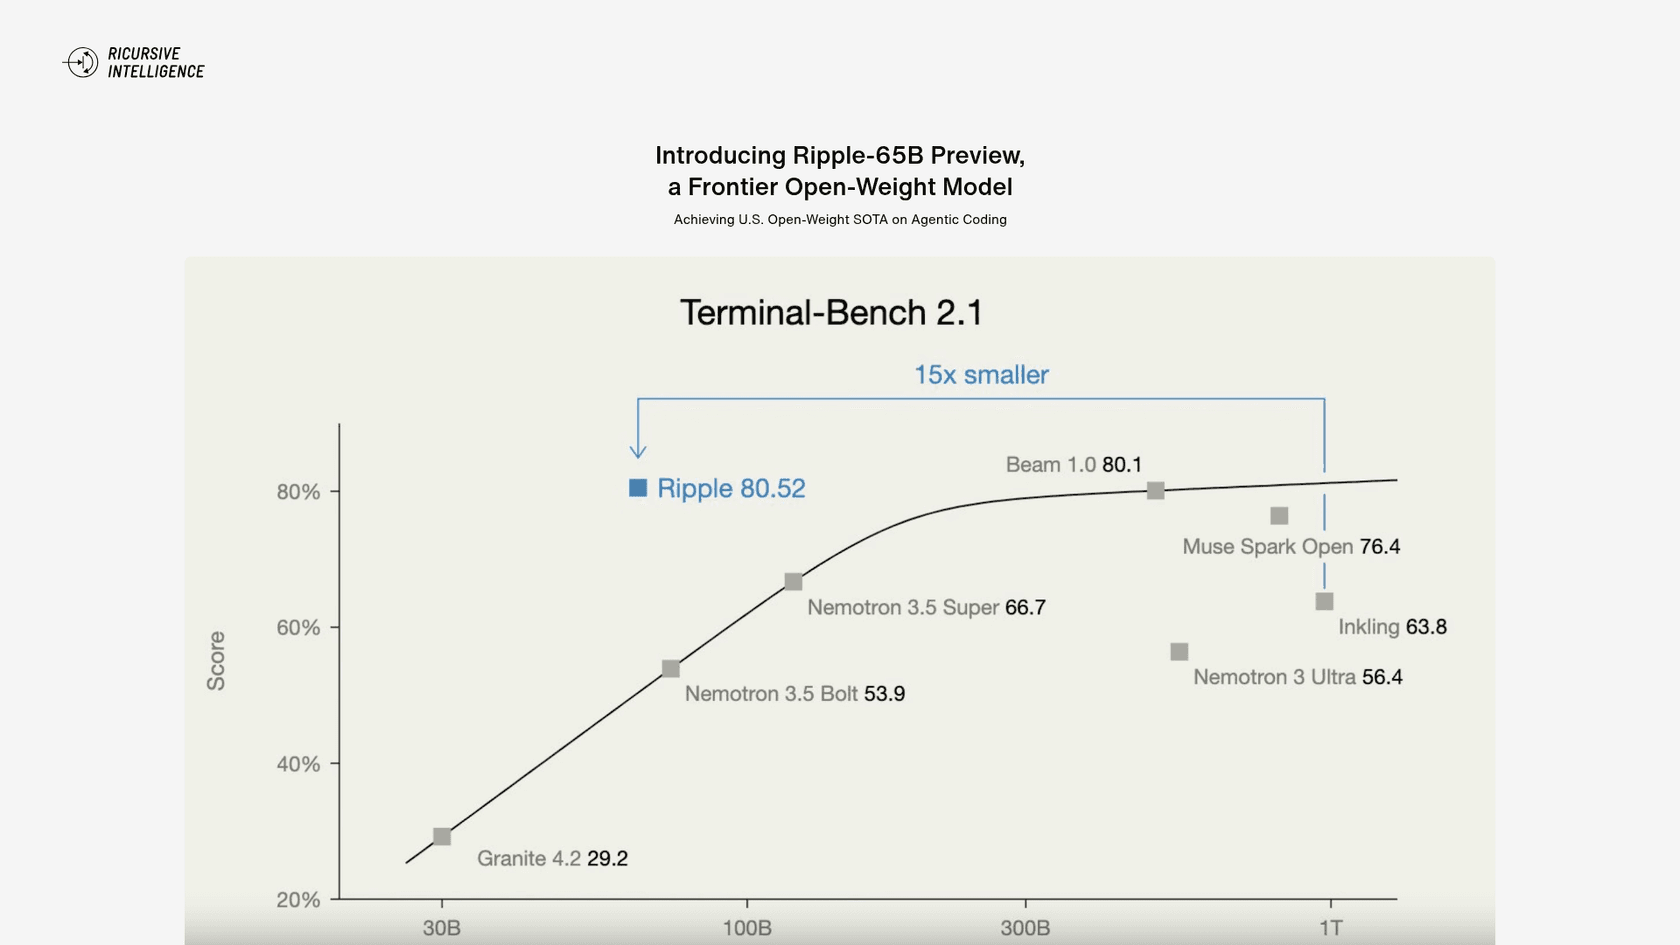
O Ripple-65B é o melhor modelo aberto feito nos EUA que você consegue rodar em uma única máquina, mas não é o melhor modelo aberto de programação no geral. Ele marca 80.5 no Terminal-Bench 2.1, um fio acima do Beam da Reflection (80.1), um modelo quase oito vezes maior. Fora dessa linha, o Beam lidera em cinco testes de programação e de agentes, e a API dele oferece 1M de tokens de contexto onde a do Ripple oferece 16,384.
Meu veredito: 3.5/5. Escolha o Ripple se quer pesos americanos sob Apache 2.0 que cabem em um DGX Spark; chame o Beam se só quer uma API. Para um agente de suporte, um colega pronto como o eesel dispensa a escolha do modelo, e a CLI dele permite que um agente de programação carregue seus documentos de ajuda e teste respostas antes de entrar no ar.
O que é o Ripple-65B, em um minuto?
O Ripple-65B Preview é um modelo de linguagem de pesos abertos lançado em 4 de novembro de 2026 pela Ricursive Intelligence, um laboratório que cria IA para projeto de chips. A Ricursive o treinou do zero e o chama de "a general-purpose variant of the proprietary model that powers our AI chip design platform." Se você quer o passo a passo completo das especificações, o explicativo do Ripple-65B do meu colega cobre isso; este post é o veredito.
A ficha técnica, do model card:
| Especificação | Ripple-65B Preview |
|---|---|
| Parâmetros | 65B no total, todos ativos (denso, não mistura de especialistas) |
| Camadas | 80, com 4 camadas de janela deslizante para cada 1 camada global |
| Dados de treinamento | 12T tokens, somente texto, principalmente inglês e código |
| Contexto (declarado) | Até 1M de tokens |
| Licença | Apache 2.0 |
| Checkpoints | BF16 instruct, NVFP4 instruct (experimental), base, modelo rascunho DFlash2 |
| Raciocínio | Sempre pensa em tags <think>, sem botão liga/desliga nem níveis de esforço |
| Custo total de P&D | $32M, segundo a Ricursive |
Essa última linha é a que todo mundo está comentando. A Ricursive diz que $32M cobrem todo o custo de pesquisa e desenvolvimento do zero, e chama isso de "one-tenth the cost of the previous open-weight SOTA on agentic coding." A nota de rodapé mostra que esse "one-tenth" é a estimativa da própria Ricursive para a conta de computação do Beam, montada a partir de uma reportagem e do cronograma de treinamento da Reflection, então trate como uma comparação aproximada, não auditada.
Como eu fiz a análise?
Eu construo as integrações por trás dos agentes de IA do eesel, então leio um model card como leria uma especificação de API antes de ligá-la à produção: quais são os números, de onde vieram e o que quebra quando você de fato a chama. Algo que os anos do eesel colocando agentes em helpdesks reais me mostraram é que um ranking não diz o que um modelo faz nos seus próprios tickets, por isso todo lançamento do eesel é simulado com tickets passados antes de entrar no ar.
Para o Ripple, eu não tinha acesso à API para rodar meu próprio conjunto de testes no dia do lançamento, então esta análise se baseia apenas em fontes primárias:
- O post de lançamento da Ricursive, mais o model card no Hugging Face com os scripts de inferência.
- As listagens ao vivo no OpenRouter, no GMI Cloud e na Together AI, conferidas em 5 de novembro de 2026.
- O primeiro dia de reação de desenvolvedores no Hacker News e no X.
O Ripple ainda não está no Artificial Analysis, então todo benchmark abaixo é número da própria Ricursive. Vou dizer de qual página veio cada um porque, como você verá, as duas páginas nem sempre concordam.
Como o Ripple-65B pontua contra o Beam e os outros modelos abertos dos EUA?
Nas duas linhas que a Ricursive destaca, o Ripple vence. Na maioria das outras, não. Esta é a tabela instruct do model card, reduzida às linhas de programação e de agentes que importam a quem compra um modelo de programação:
| Benchmark | Ripple-65B | Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 (autodeclarado) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| τ³-bench banking | 31.27 | 36.1 | 14.4 | 23.7 | 22.6 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
Duas coisas saltam aos olhos. Primeiro, a vantagem no Terminal-Bench sobre o Beam é de 0.4 ponto, o que é um empate em qualquer leitura honesta. Segundo, o Beam supera o Ripple em cinco linhas de programação e de agentes, e o Muse Spark Open, que cobri na minha análise do Muse Spark Open, leva DeepSWE, MCP Atlas e SciCode.
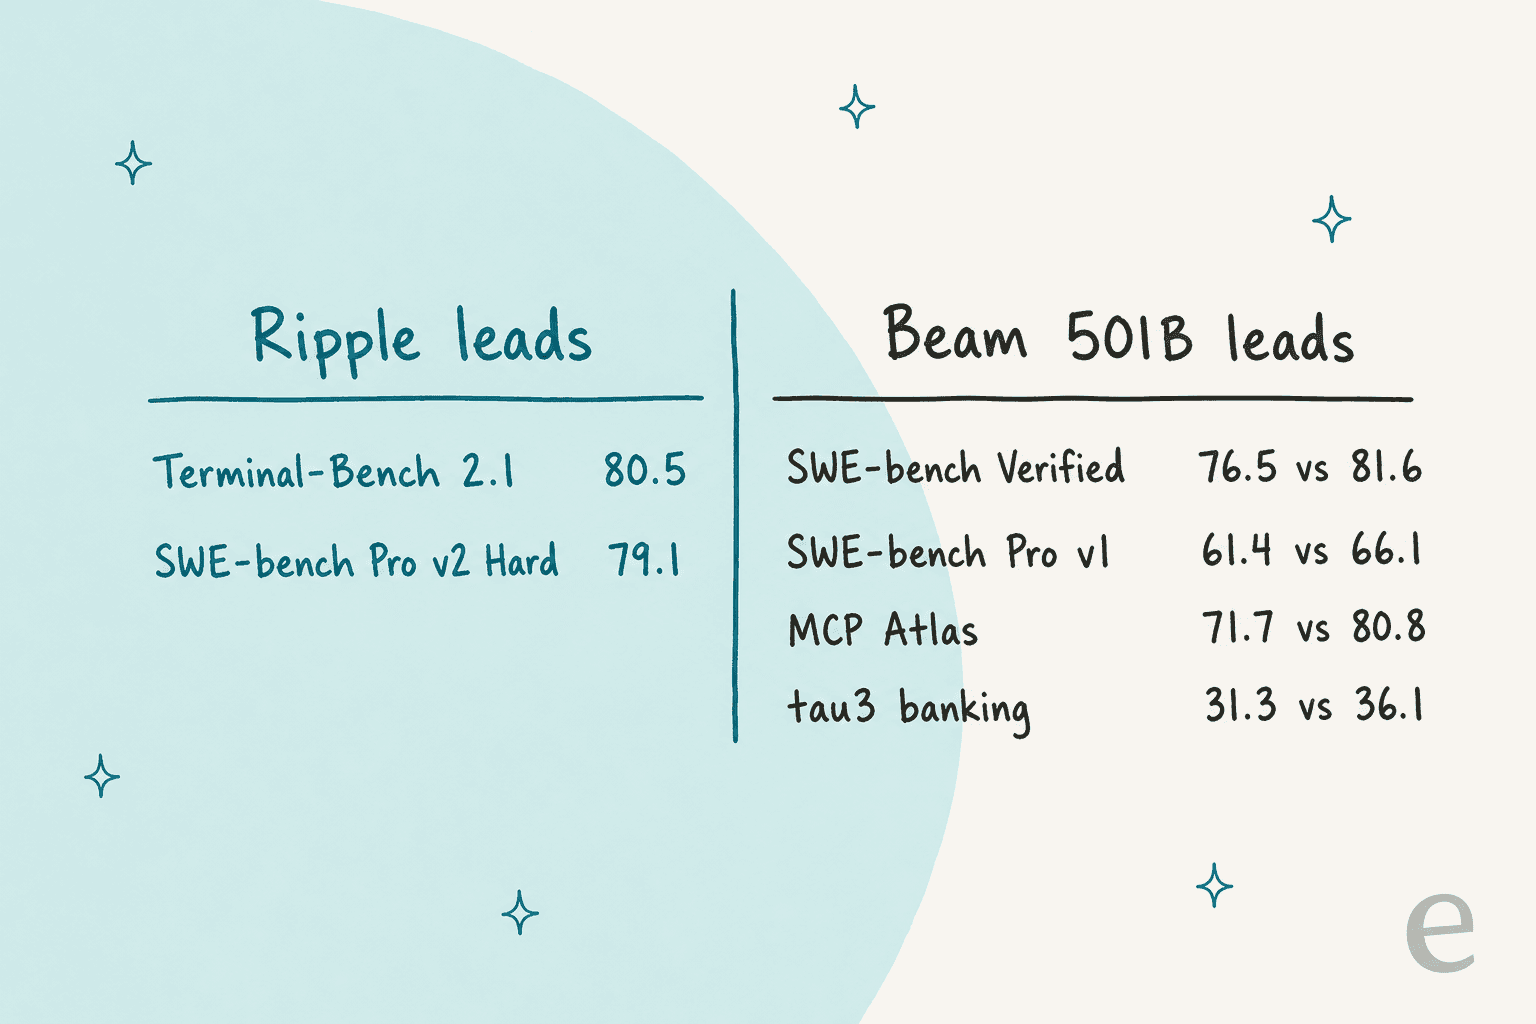
Dito isso, um modelo de 65B igualar um de 501B na sua melhor linha ainda é um resultado real. O Beam tem 23B de parâmetros ativos por token e o Ripple tem todos os 65B ativos, então a comparação é menos desigual do que "8x menor" sugere, mas em termos de memória o Ripple é muito mais fácil de hospedar.
Em quais números confiar?
A Ricursive é franca sobre a bagunça. O model card diz que as pontuações dos concorrentes são "official model card scores where available", e o resto são execuções internas próprias. Também observa que as pontuações do Terminal-Bench 2.1 saíram "universally lower (with the exception of Muse Spark Open)" no harness oficial Terminus 2, por isso reporta ambas.
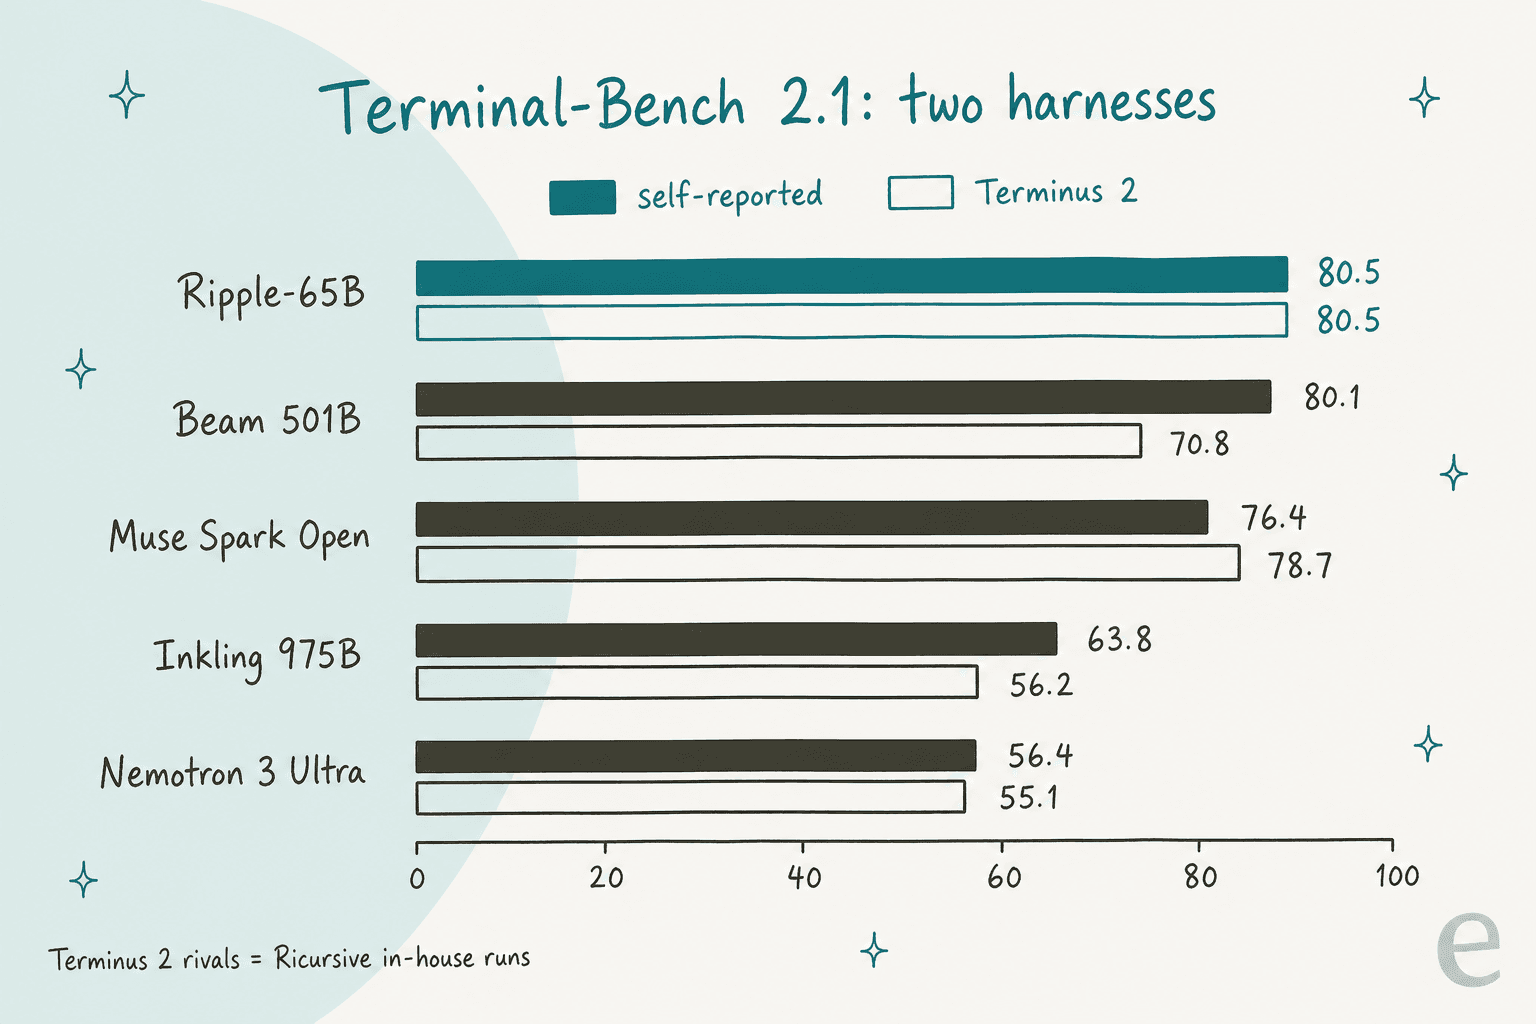
No mesmo harness Terminus 2, a vantagem do Ripple sobre o Beam cresce para quase 10 pontos (80.5 contra 70.8). É o número mais interessante do lançamento e também o que eu verificaria primeiro, porque o número do Beam ali é uma execução da Ricursive, não da Reflection.
A outra ruga: o gráfico de lançamento e o model card discordam em algumas pontuações de concorrentes. No SWE-bench Pro v2.0 Hard, o post de lançamento mostra o Muse Spark Open em 72.4 e o Inkling em 39.6, enquanto o model card traz 52.3 e 2.0. Os números do próprio Ripple batem nas duas páginas. É um lançamento em prévia e isso provavelmente será conciliado, mas até lá eu trataria as colunas dos concorrentes como aproximadas.
Quanto custa o Ripple-65B?
O Ripple é barato de chamar, com uma grande ressalva. Os preços abaixo são a listagem de cada provedor, conferidos em 5 de novembro de 2026:
| Rota | Entrada / 1M | Saída / 1M | Leitura em cache / 1M | Contexto |
|---|---|---|---|---|
| GMI Cloud | $0.20 | $0.60 | $0.05 | 1,000,000 listado |
| OpenRouter (servido pela GMI) | $0.20 | $0.60 | $0.05 | 16,384, saída máx. 14,745 |
| Together AI | Em breve | Em breve | n/a | 1M listado |
| Pesos no Hugging Face | Grátis (Apache 2.0) | Seu hardware | n/a | Até 1M em 2x B200 |
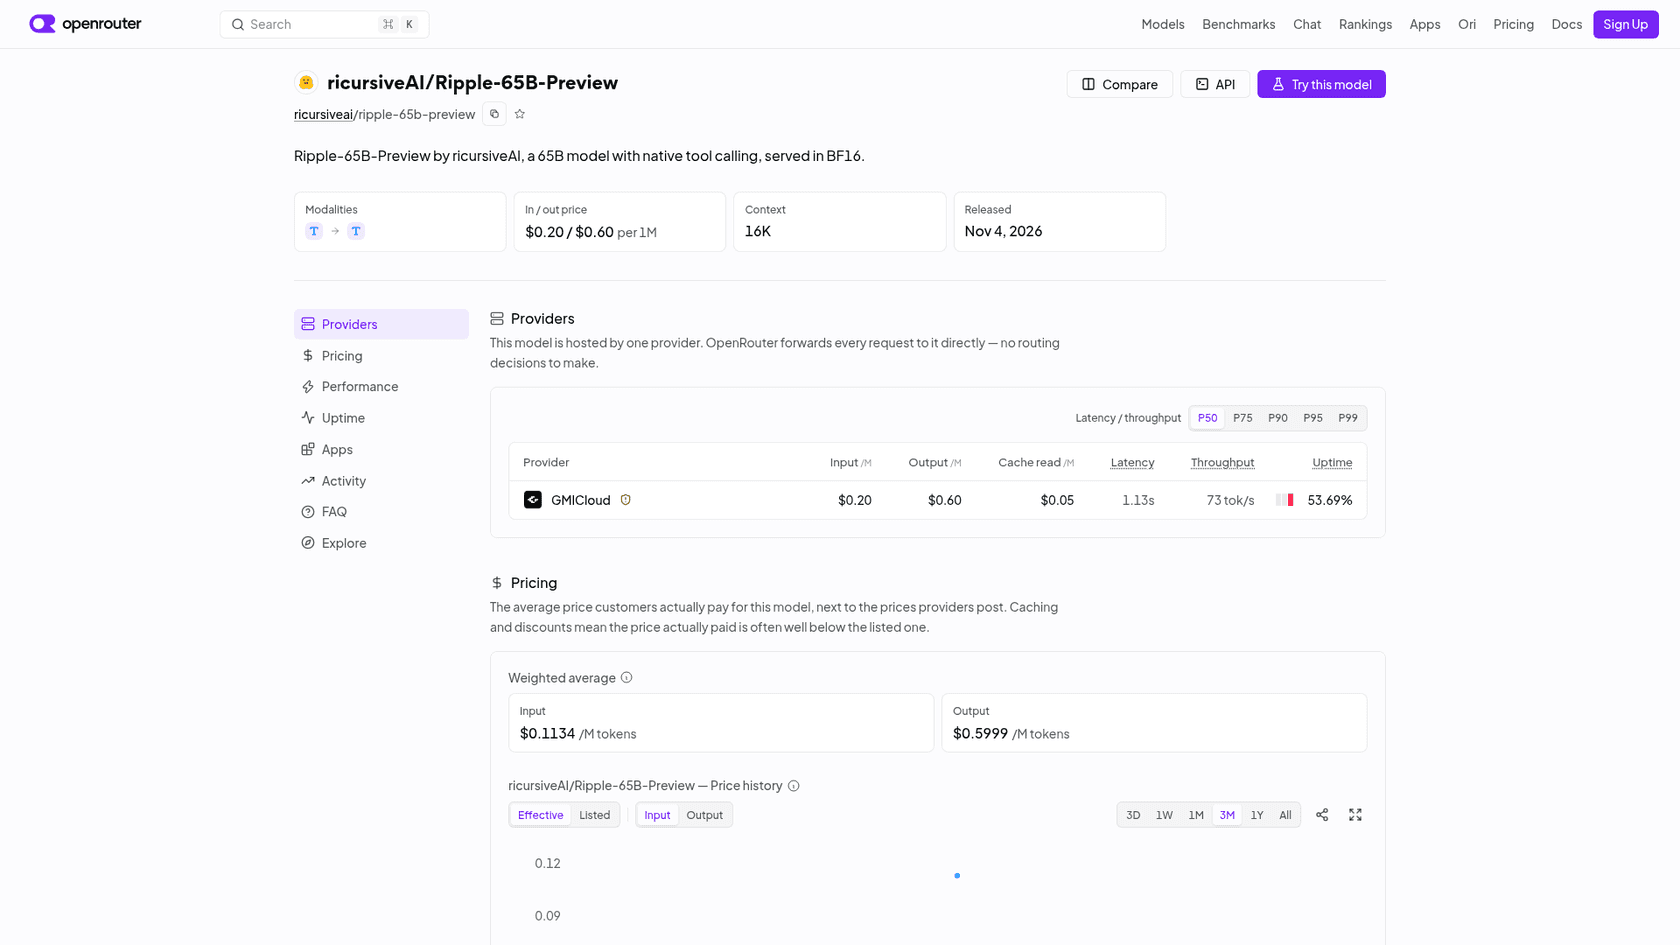
A ressalva é essa janela de 16K. Um agente de programação como o Claude Code ou as ferramentas do meu guia de programação com IA no terminal pode estourar 16,384 tokens antes de terminar de ler o repositório. Pelo OpenRouter hoje, o Ripple tem vista curta demais para a programação com agentes para a qual foi criado. Quando capturei a página, ela também mostrava um único provedor com 53.69% de disponibilidade e 73 tokens por segundo, o que é normal no segundo dia, mas não é algo para pôr em produção ainda.
Veja como uma sessão de 10M de tokens de entrada e 1M de saída se sai contra os rivais abertos, usando os preços de tabela do OpenRouter:
| Modelo | Entrada / saída por 1M | Custo para 10M entrada + 1M saída | Contexto no OpenRouter |
|---|---|---|---|
| Ripple-65B Preview | $0.20 / $0.60 | $2.60 | 16,384 |
| Beam 1.0 501B | $0.25 / $1.00 | $3.50 | 1,048,576 |
| Qwen3.8 27B | $0.15 / $1.875 | $3.38 | 1,024,000 |
| DeepSeek V4.1 Flash | $0.045 / $0.50 | $0.95 | 1,048,576 |
| Inkling | $1.00 / $4.05 | $14.05 | 524,288 |
| Muse Spark Open | $1.25 / $4.25 | $16.75 | 1,048,576 |
Ou seja, o Ripple é $0.90 mais barato que o Beam nessa sessão, com 64 vezes menos contexto. Para a maioria dos compradores de API, essa troca não compensa. O DeepSeek V4 Flash continua sendo a escolha econômica, e o Qwen 3.8 é a comparação óbvia não americana que a Ricursive deixou de fora do gráfico. Assim como o Kimi K3.
Dá para rodar de verdade no seu próprio hardware?
Sim, e é aqui que o Ripple conquista seu lugar. Um modelo denso de 65B é pequeno o bastante para caber em uma máquina, e a Ricursive entrega os scripts para isso. O que o marketing do dia do lançamento deixa de lado é quanto cada rota exige de você:
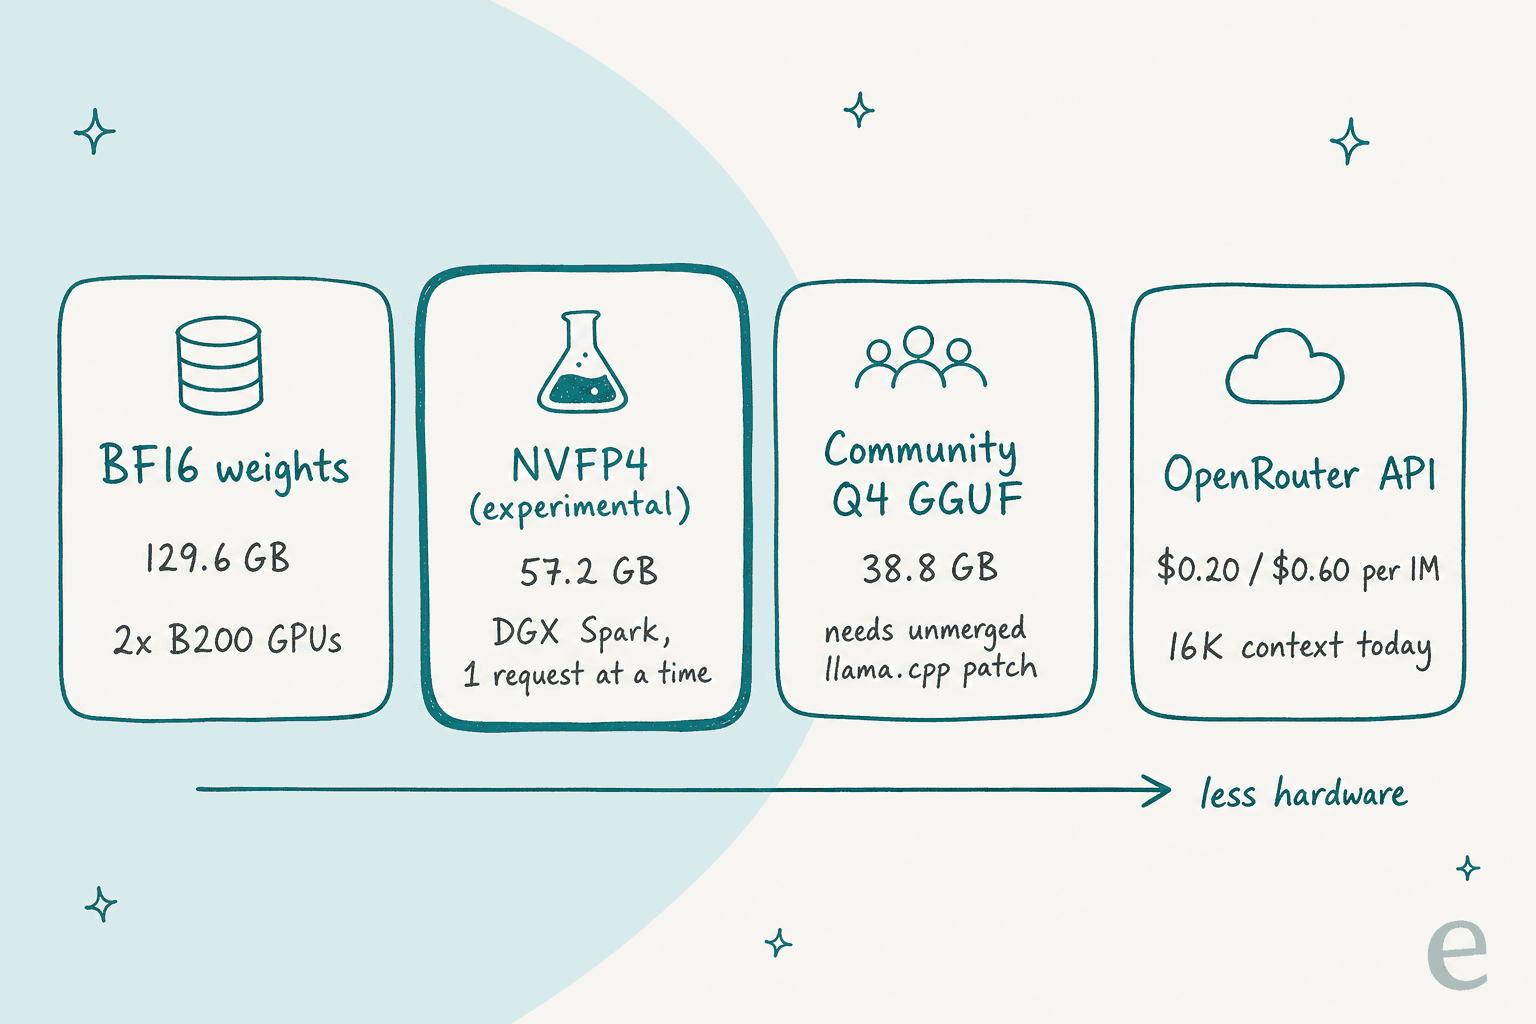
- BF16 em 2x B200. O README do servidor usa SGLang 0.5.19 com o modelo rascunho DFlash2 e 1M de contexto como padrão. O card cita
250tokens por segundo com lote 8. - NVFP4 em um DGX Spark. O checkpoint NVFP4 é rotulado como experimental, mantém a atenção em BF16, e o script local atende uma requisição por vez com 128K de contexto.
- GGUF da comunidade. A quantização da AtomicChat tem
38.8 GBem Q4_K_M, mas o llama.cpp, o Ollama e o LM Studio padrão não conseguem carregá-la até que um patch do llama.cpp seja incorporado. - Sem build MLX. O cofundador da Ricursive postou que dá para rodar "on a MacBook Pro", mas nenhum guia oficial cobre Apple Silicon ainda.
Um comentarista do Hacker News resumiu bem o dilema dos modelos densos:
"it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware"

E o outro lado, de alguém com o hardware certo:
"Speaking as someone who has High-Memory Mac Studios, it is great that there is finally a model that will run at usable speeds with high quality."
Duas ressalvas menores para quem for ligá-lo a um agente. O template de chat "does not implement a thinking on/off switch or reasoning-effort levels", então toda resposta paga uma passada de raciocínio. E forçar uma chamada de ferramenta exige esquemas estritos: o card avisa que "Non-strict required calls produced extra argument fields." O endpoint do OpenRouter só aceita tool_choice como none ou auto por enquanto.
O que os desenvolvedores estão dizendo?
A reação do primeiro dia se divide claramente. O custo de treinamento é elogiado por quase todos, e o enquadramento de "estado da arte" recebe contestação. Do lado do X:
"this is like the avengers of open model SOTA"
Isso foi o swyx reagindo ao número de $32M de P&D total. No Hacker News, onde a discussão chegou a 182 pontos, a reclamação mais respondida foi a categoria estreita:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"
Vários comentaristas apontaram que o gráfico compara apenas modelos abertos dos EUA e deixa o Qwen de fora. Um deles colocou o número do Ripple no Terminal-Bench ao lado do da Alibaba:
"This model scores 80.5 on Terminal Bench 2.1 For reference Qwen 3.8 Flash Next (which is bigger than this model but probably cheaper to run due to MoE) scores 84.3, and Qwen 3.8-27B scores 73.0."
E o comentário que, para mim, explica para quem esse modelo realmente serve:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States."
Esse é o mercado de verdade. Se sua equipe de segurança descartou pesos de laboratórios chineses, as alternativas desse tamanho eram escassas, e o Ripple agora é o modelo aberto americano mais forte que cabe em uma única estação de trabalho.
Você deve usar o Ripple-65B para um agente de suporte?
Eu não o faria minha primeira escolha, e o motivo está na própria tabela da Ricursive. O τ³-bench banking é o que mais se aproxima, no card, de um teste de atendimento ao cliente: um agente seguindo políticas e chamando ferramentas para um cliente de banco. O Ripple marca 31.27 ali, atrás dos 36.1 do Beam. Some o raciocínio sempre ligado (primeiras respostas mais lentas), o pós-treinamento leve "with a focus on agentic coding" e o contexto hospedado de 16K, e ele foi feito para outro trabalho. Meu guia do melhor LLM para suporte aprofunda o que importa nesse caso.
O ponto maior é que um modelo é infraestrutura. Para uma equipe de suporte, o difícil é tudo ao redor: ler o helpdesk, aprender com tickets passados, saber quando passar para um humano. É para isso que serve o eesel. É um colega de IA que você contrata para uma função, como o colega de IA para helpdesk, em vez de um modelo que você hospeda. Três clientes mostram como isso funciona:
- A SE Ranking roda um agente eesel por produto no Zendesk e atendeu
4,650conversas em um mês, passando reembolsos, extensões de teste e dúvidas de nível 2 para a equipe. - A Timengo o usa no Freshdesk para rascunhar respostas a tickets técnicos a partir de cerca de
5,300tickets passados e artigos de ajuda, e o eesel nunca responde sozinho a um cliente ali. - A SamCart roda agentes separados no Freshdesk e no chat do site, respondendo a partir de cerca de
280artigos da central de ajuda.
Se você gosta de conduzir ferramentas pelo terminal, a CLI do eesel permite que um agente de programação como Claude Code, Codex ou Cursor envie conhecimento aprovado, como artigos de ajuda e políticas exportados, depois faça perguntas de teste ao agente com eesel chat e confira as respostas antes de qualquer coisa entrar no ar. Conectar o próprio helpdesk ainda exige alguém com acesso de administrador para aprovar. Mais sobre esse padrão no guia da CLI de agentes de IA, e o explicativo do servidor MCP cobre o outro caminho de entrada.
As ressalvas antes de trocar
- O contexto hospedado é de 16K. Serve para um chat, pequeno demais para trabalho de agente em escala de repositório até que GMI ou Together o ampliem.
- Os benchmarks ainda não são independentes. Sem entrada no Artificial Analysis, e o gráfico de lançamento e o model card discordam em algumas pontuações de concorrentes.
- A instalação local prioriza a NVIDIA. Os caminhos oficiais exigem B200 ou um DGX Spark; usuários de Mac esperam builds da comunidade.
- Ele sempre pensa. Não há como desligar o raciocínio para respostas rápidas e simples.
- É uma prévia. A Ricursive chama o pós-treinamento de "relatively light", e o build NVFP4 é experimental.
Veredito: quem deve rodar o Ripple-65B?
Minha nota: 3.5/5. O Ripple é um primeiro modelo impressionante de uma equipe de treinamento de cinco pessoas, e o número de $32M de custo total importa para o rumo dos modelos abertos. Mas a vitória de destaque é um empate de 0,4 ponto, e quem compara modelos pelos próprios méritos vai achar o Beam à frente em mais linhas.
- Rode se você precisa de pesos Apache 2.0 de um laboratório americano, tem um DGX Spark ou um par de B200, e seu agente vive em um terminal. Esse é um nicho real, e o Ripple é dono dele.
- Pule se você chama uma API. O Beam 1.0 custa
$0.25/$1.00com janela de 1M, e o DeepSeek V4 Flash é bem mais barato se a origem do laboratório não importa para você. - Espere um mês se você usa Mac. Quando o suporte do llama.cpp for incorporado e alguém publicar números reais de tokens por segundo, o caso local fica bem mais claro.
Para o panorama mais amplo, minha análise do Inkling cobre o maior modelo aberto dos EUA. A análise do GLM-5.3 Flash cobre uma opção chinesa mais barata.
O levantamento de alternativas ao Kimi K3 classifica os modelos abertos lado a lado. Do lado fechado, o Claude Sonnet 5.5 continua sendo o modelo padrão da maioria dos agentes de programação, com o GPT-5.6 logo atrás.
Experimente o eesel
Se você chegou aqui porque está escolhendo um modelo para alimentar um agente de suporte, pode pular essa etapa. O eesel é um colega de IA que se conecta ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets passados e sua central de ajuda, e é testado em suas conversas reais antes de responder a qualquer pessoa. A SE Ranking foi da configuração a 4,650 conversas por mês em três produtos. Os planos começam em $299/month por 500 créditos na página de preços, com teste gratuito. Experimente o eesel e rode-o primeiro contra a sua própria fila.
