

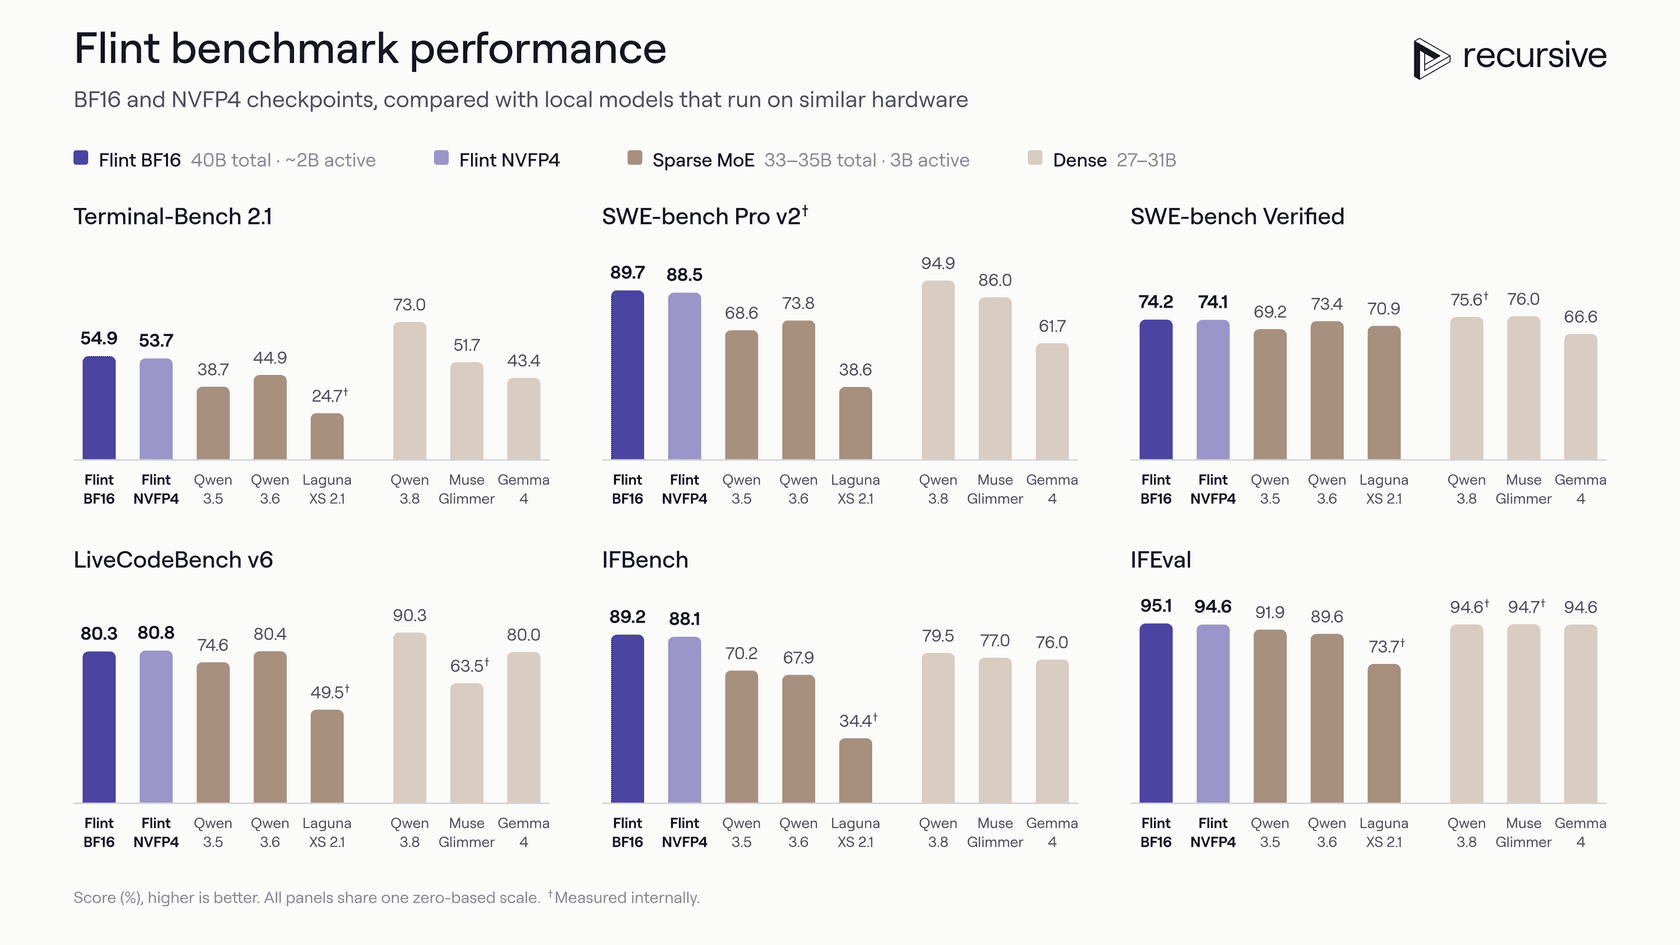
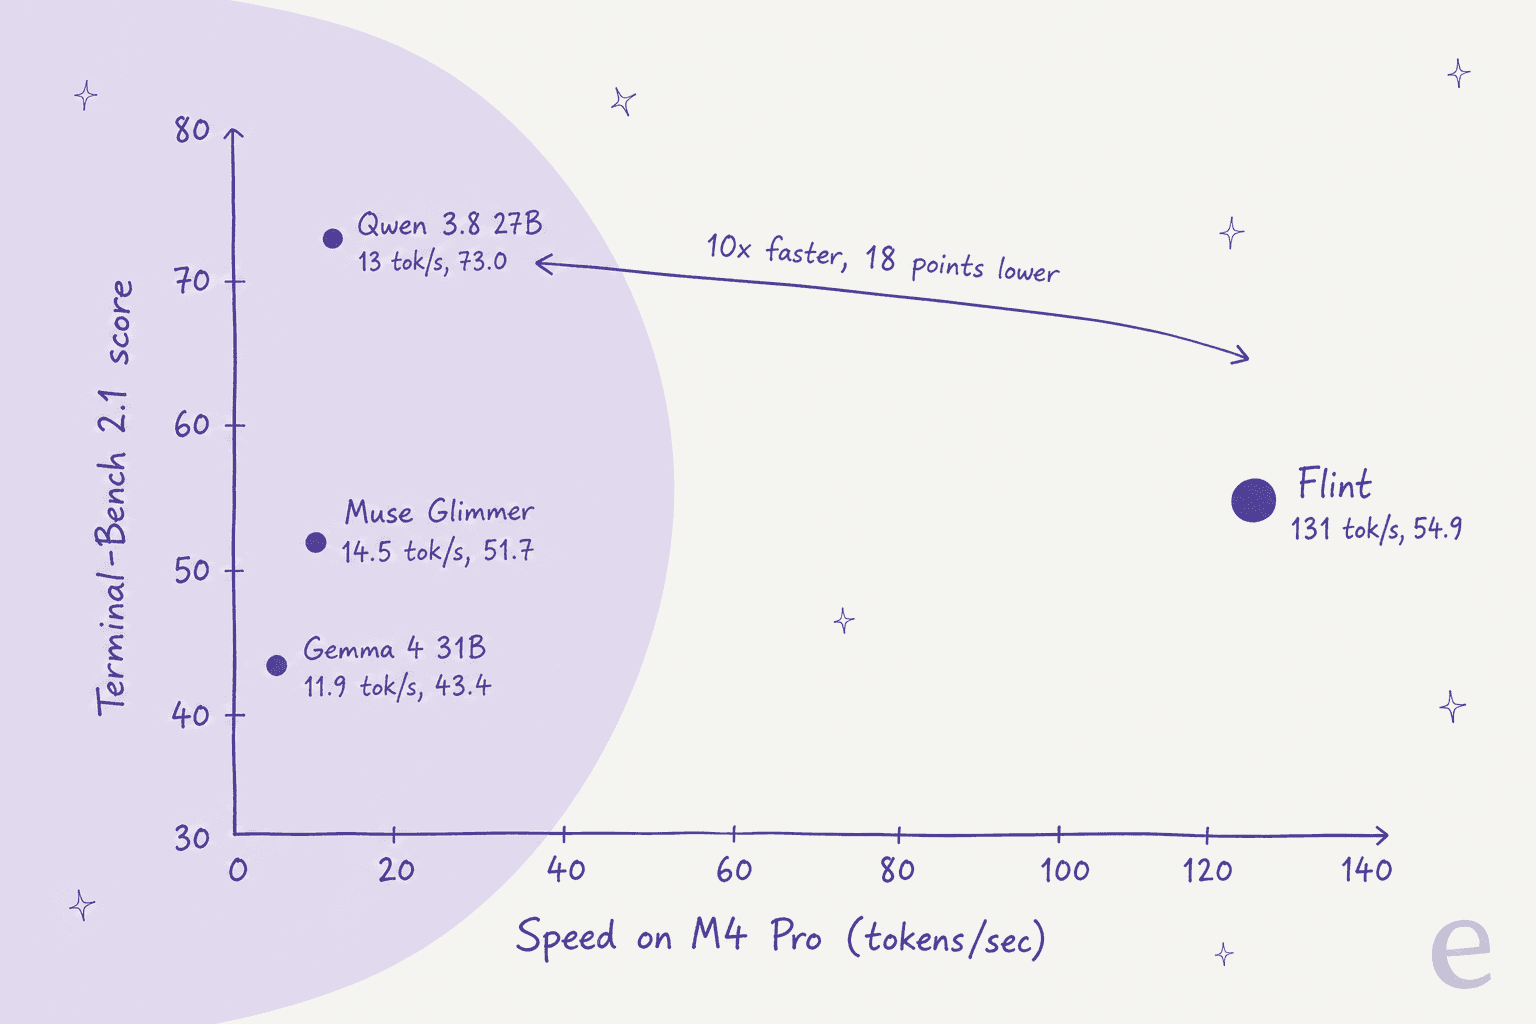
O Recursive Flint é o modelo de programação mais rápido que você pode rodar hoje em um laptop, e é gratuito, mas não é o melhor. Em um MacBook M4 Pro ele gera 131 tokens por segundo, aproximadamente 10x o Qwen 3.8 27B denso, enquanto o Qwen 3.8 ainda o supera em quatro de seis benchmarks de código no gráfico da própria Recursive, incluindo o Terminal-Bench 2.1 por 18 pontos.
Minha nota é 3,5/5. Escolha o Flint se você quer um agente de programação offline, sob Apache 2.0, que acompanhe o seu ritmo, e está disposto a quebrar o trabalho em passos pequenos e explícitos. Pule se precisa do modelo local mais forte por resposta, ou de um ciclo de ferramentas que nunca tropece: no endpoint gratuito do OpenRouter, 17,74% das chamadas de ferramenta dão erro atualmente.
Se o que você realmente precisa é de um agente que trabalhe uma fila de suporte em vez de uma base de código, um modelo bruto é a camada errada. O colega de helpdesk com IA da eesel é o funcionário que fica acima de modelos como este, e seu agente de programação pode controlá-lo pelo terminal com a CLI da eesel.
O que é o Recursive Flint?
O Recursive Flint é um modelo de programação de mistura de especialistas com 40B de parâmetros que ativa cerca de 2,5B de parâmetros por token, lançado em 21 de outubro de 2026 pela Recursive. Entra texto, sai texto, com raciocínio sempre ativo e chamadas de ferramenta, e foi construído para um único trabalho: rodar um agente de programação que lê um repositório, edita arquivos e executa testes. Pense nele como o motor sob uma CLI de programação agêntica, não como um app de chat.
A Recursive é o laboratório comandado por Richard Socher, que também é CEO da You.com. Seu objetivo declarado é uma «superinteligência que se autoaprimora de forma recursiva», e o Flint é o primeiro teste público do sistema pensado para chegar lá: a Eureka Machine, um ciclo de pesquisa automatizado que propõe ideias, implementa, testa e escolhe o que tentar em seguida. A Recursive diz que uma pequena equipe de pessoas e agentes construiu o Flint do zero em menos de quatro meses, com a Eureka Machine trabalhando nos dados, nas receitas de treinamento, na quantização e nos kernels.
Eu construo as integrações e as APIs por trás dos agentes da eesel, o que significa que passo a maior parte da semana ligando modelos a ciclos de ferramentas e vendo onde eles quebram. Essa é a lente desta análise. Li o model card, a documentação da Recursive, o repositório do motor rec e as estatísticas ao vivo do OpenRouter, e avaliei o Flint pelo que um modelo de programação realmente precisa fazer: concluir uma tarefa de vários passos sem você precisar vigiá-lo.
Estas são as especificações que importam, direto do model card:
| Especificação | Recursive Flint |
|---|---|
| Parâmetros totais | 39,8B |
| Ativos por token | ~2,5B (cerca de 2,2B sem a cabeça de saída) |
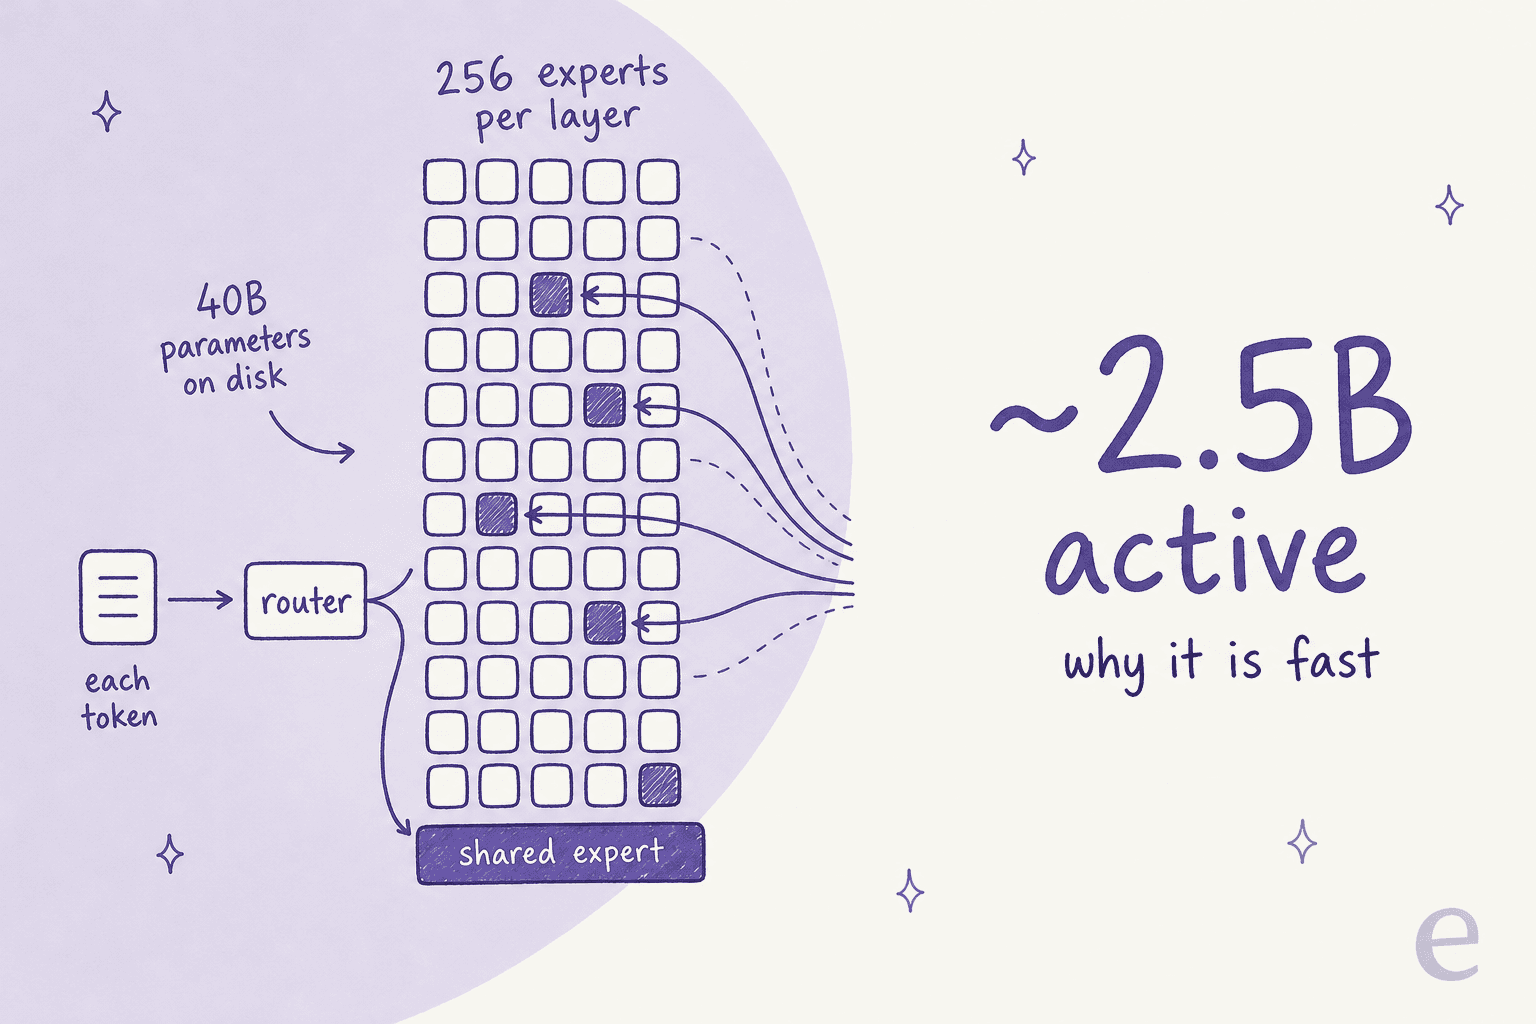
| Especialistas | 256 por camada MoE, 6 roteados por token, mais 1 compartilhado |
| Camadas | 49 (2 densas, 47 MoE; 35 de janela deslizante, 14 de atenção completa) |
| Contexto | 262.144 tokens documentados; até 512k suportados, 256k recomendados |
| Saída máxima (hospedado) | 65.536 tokens |
| Corte de conhecimento | Junho de 2026 |
| Licença | Apache 2.0 |
| Entrada / saída | Texto / texto |
Como um modelo de 40B roda tão rápido em um laptop?
Ele roda rápido porque quase tudo nele fica ocioso. Cada token passa por um roteador que escolhe 6 dos 256 especialistas em cada camada, mais um especialista compartilhado que sempre dispara, então o chip só lê o equivalente a cerca de 2,5B de parâmetros em pesos por token. Um modelo denso de 27B lê todos os 27B a cada token.
O interessante é que a Recursive não parou na arquitetura. Segundo o post de lançamento, a Eureka Machine também buscou receitas de quantização e, contra a prática comum, comprimiu a camada de saída para 4 bits. Com apenas 2,5B de parâmetros ativos, essa camada de saída é uma grande parte dos pesos lidos por token, então encolhê-la compra velocidade real. O modelo NVFP4 final fica a 0,7 ponto do de 16 bits nos benchmarks da Recursive, e a página do LM Studio mostra a diferença por teste: 53,7 contra 54,9 no Terminal-Bench, 74,1 contra 74,2 no SWE-bench Verified.
Depois ele escreveu kernels próprios, incluindo um «megakernel» de Metal que funde todo o passo de decodificação em chips M4 e M5. Por isso a Recursive distribui o próprio motor, o rec, em vez de apenas apontar você para o llama.cpp. Mais sobre isso adiante.
Quão rápido é o Recursive Flint na prática?
Muito. No gráfico da própria Recursive para um Apple M4 Pro com 48 GB, o Flint roda a 131,22 tokens/s via MLX com contexto de 1K tokens, e 87,98 via llama.cpp. Os pares esparsos mais próximos são o Laguna XS 2.1 com 68,84 e o Qwen 3.6 35B-A3B com 65,55. Os modelos densos com pontuações de código comparáveis mal se mexem: Muse Glimmer com 14,54, Qwen 3.8 27B com 13,01, Gemma 4 31B com 11,92.

Os números de contexto longo é que me convencem de que isso não é um truque de prompt curto. Na média de contextos de até 128K, o Flint mantém 68,89 tokens/s no M4 Pro, enquanto o Qwen 3.8 27B cai para 10,11. Um agente de programação passa a maior parte da vida no fundo de um contexto longo (conteúdo de arquivos, saída de testes, seu próprio raciocínio anterior), então a média importa mais do que o número de manchete. Na RTX Spark da NVIDIA, a versão NVFP4 chega a 155,82 tokens/s em contexto curto e 101,95 na média.
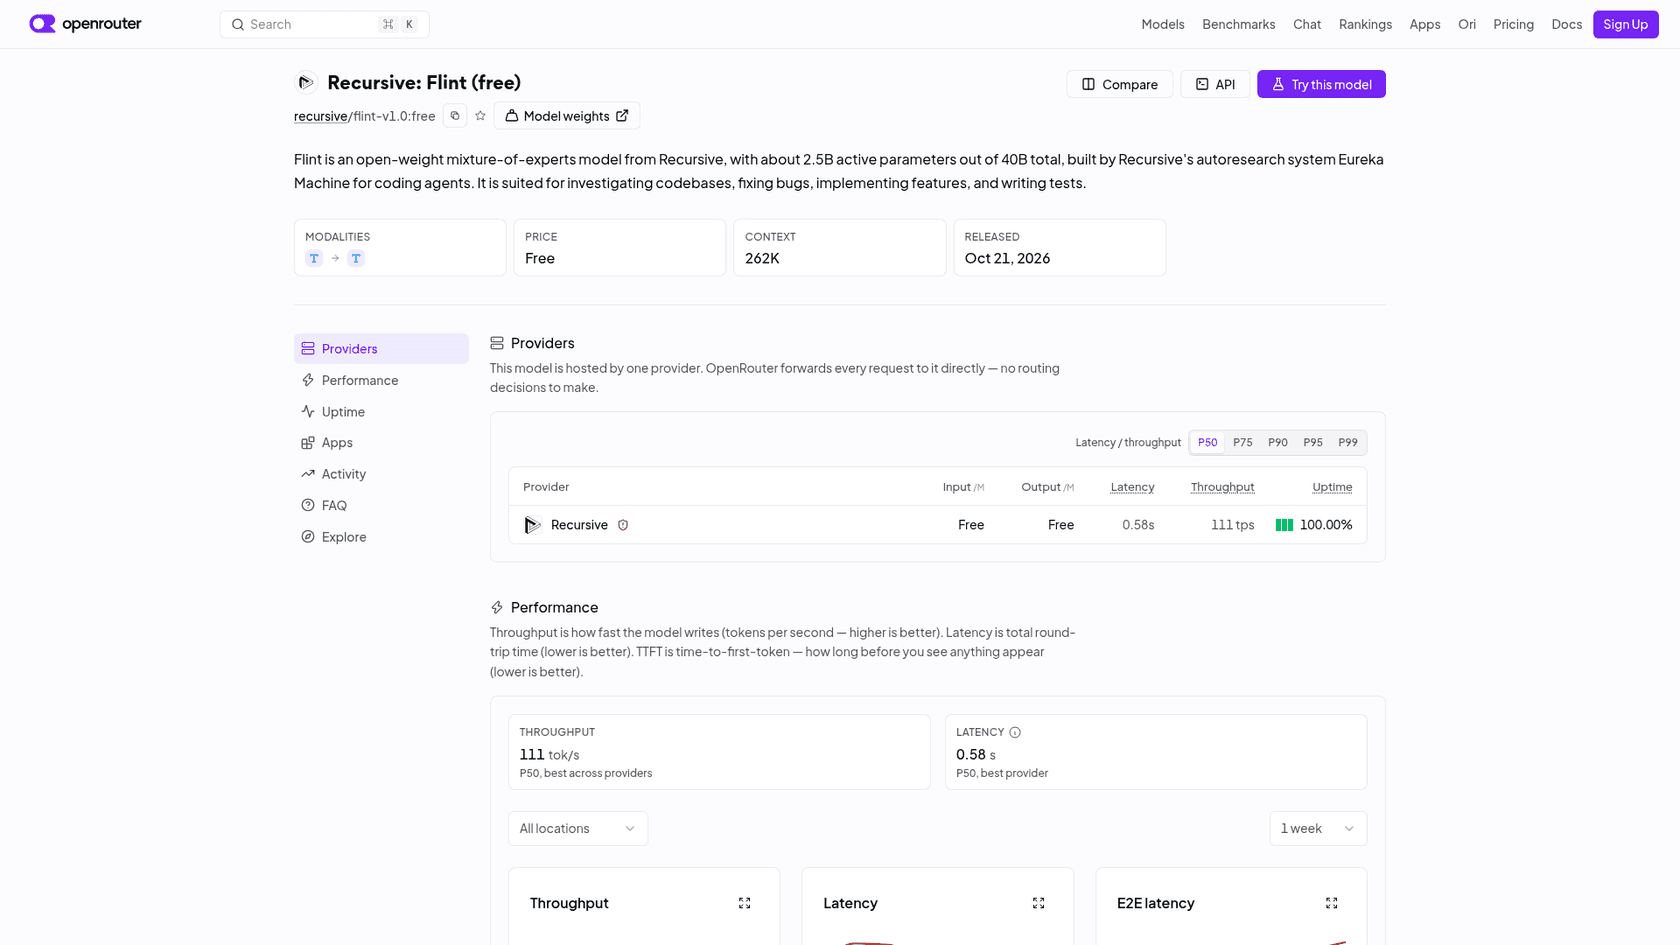
Hospedado, também é rápido. As estatísticas ao vivo do OpenRouter mostram uma vazão P50 de 111 tokens/s e 0,58 s de latência a partir do único endpoint de provedor da Recursive.
Duas ressalvas. Essas são medições da Recursive, com o prefill excluído, então o tempo até o primeiro token com um prompt grande vai parecer mais lento do que as barras sugerem. E a velocidade só aparece se você usar um runtime que suporte o Flint direito; a página de solução de problemas dedica uma entrada inteira a offload para CPU e troca de memória.
Como o Flint se sai contra Qwen 3.8, Gemma 4 e Muse Glimmer?
É aqui que o texto de lançamento e o gráfico se separam. A Recursive diz que o Flint «rivaliza com o desempenho de programação de modelos densos de 25 a 40 bilhões de parâmetros». No próprio gráfico, ele fica atrás do mais forte deles, o Qwen 3.8 27B, na maioria dos testes que importam para programação agêntica.
| Benchmark | Flint BF16 | Qwen 3.8 27B (denso) | Muse Glimmer (denso) | Gemma 4 (denso) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 51.7 | 43.4 | 44.9 |
| SWE-bench Pro v2 | 89.7 | 94.9 | 86.0 | 61.7 | 73.8 |
| SWE-bench Verified | 74.2 | 75.6 | 76.0 | 66.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 63.5 | 80.0 | 80.4 |
| IFBench | 89.2 | 79.5 | 77.0 | 76.0 | 67.9 |
| IFEval | 95.1 | 94.6 | 94.7 | 94.6 | 89.6 |
Lendo com honestidade, três coisas se destacam:
- Contra outros modelos MoE do seu tamanho, o Flint vence com clareza. Ele supera o Qwen 3.6 35B-A3B em cinco de seis linhas (o LiveCodeBench é um empate de 0,1 ponto), e por
10pontos no Terminal-Bench. É a alegação com que a Recursive abre, e ela se sustenta. - Contra o Qwen 3.8 27B, perde quatro de seis. A diferença de
18,1pontos no Terminal-Bench 2.1 é a que eu mais pesaria, já que esse teste é o mais próximo de «conduza um shell até a tarefa terminar». - O destaque dele é seguir instruções. O
89,2no IFBench fica quase10pontos à frente de todo modelo denso do gráfico, o que combina com o conselho da documentação de dar a ele instruções explícitas, passo a passo.
A Recursive é transparente sobre a metodologia, e eu valorizo isso. Segundo o model card, a execução do Terminal-Bench conta como falhas as soluções encontradas por recuperação na web, e o card observa que as pontuações de outros modelos relatadas pelos desenvolvedores podem não aplicar o mesmo ajuste. Então parte dessa diferença pode ser um avaliador mais rigoroso. Parte, porém, é simplesmente um modelo denso de 27B pensando mais por token.
Essa é a troca real. O Flint é 10x mais rápido para uma resposta um pouco pior. Para um ciclo de programação interativo, em que você lê cada diff de qualquer jeito, eu muitas vezes aceitaria esse acordo. Para um agente sem supervisão durante a noite, não.
Onde o Flint fica devendo?
Os limites são, em sua maioria, os que a própria Recursive documenta, o que é um bom sinal sobre o laboratório, se não sobre o modelo.
Ele precisa de uma rédea mais curta que os modelos de fronteira. O post de lançamento diz claramente: «ele pode precisar de mais orientação do que os modelos de programação fechados maiores a que você está acostumado», e recomenda dividir o trabalho em subtarefas menores com instruções explícitas. Se você está acostumado a entregar ao Claude Code ou ao Cursor um ticket vago e sair andando, espere mais idas e vindas.
As chamadas de ferramenta tropeçam mais do que você gostaria. O OpenRouter reporta uma taxa de erro de 17,74% nas chamadas de ferramenta para o endpoint gratuito. Em um ciclo de agente de 30 passos, são várias chamadas quebradas por tarefa para o seu harness absorver. A documentação aponta templates de chat e parsers incompatíveis como causa usual, e o model card pede que você preserve o reasoning_content no histórico, então parte disso dá para corrigir do seu lado. Ainda assim, é o primeiro número que eu acompanharia.
O raciocínio longo come o orçamento. O raciocínio está sempre ligado. O model card recomenda pelo menos 32.768 tokens de saída para problemas difíceis, e o guia do OpenCode sugere 65.536. Se o seu harness limita a saída a menos, as respostas terminam com finish_reason: length no meio do raciocínio, o mesmo problema de orçamento que explico na janela de contexto do Claude Code.
O caminho rápido é só para Mac, e não qualquer Mac. O rec precisa de um M4 Pro, M4 Max, M5 Pro ou M5 Max com pelo menos 48 GB de memória unificada, segundo o README. Uma máquina de 24 GB consegue carregar o menor GGUF pelo LM Studio, mas a própria página do LM Studio avisa que o contexto completo de 262K não está garantido.
Ainda não há API paga com SLA. O acesso direto à API da Recursive é «limitado a parceiros selecionados», segundo a página de versões. Os planos gratuitos do OpenRouter e do OpenCode estão sujeitos a capacidade e limites de taxa. Serve para um teste, não para algo que você cobre de um cliente.
A reação da comunidade combina com o gráfico. O tópico de lançamento no Hacker News ficou impressionado com a velocidade de um modelo treinado do zero, com uma dose de «mostre-me»:
"Pretty amazing for being trained from scratch, to have ~Qwen 3.8 27b quality with such an increase in tok/s performance. Excited to try it out and see how snappy it is."

"not as good as qwen3.8 yet, even the chart says good numbers"
Os dois têm razão. Eu o colocaria entre os dois: perto o bastante do Qwen 3.8 para que a velocidade decida no trabalho interativo, mas não tão perto a ponto de decidir tudo.
Como rodar o Recursive Flint?
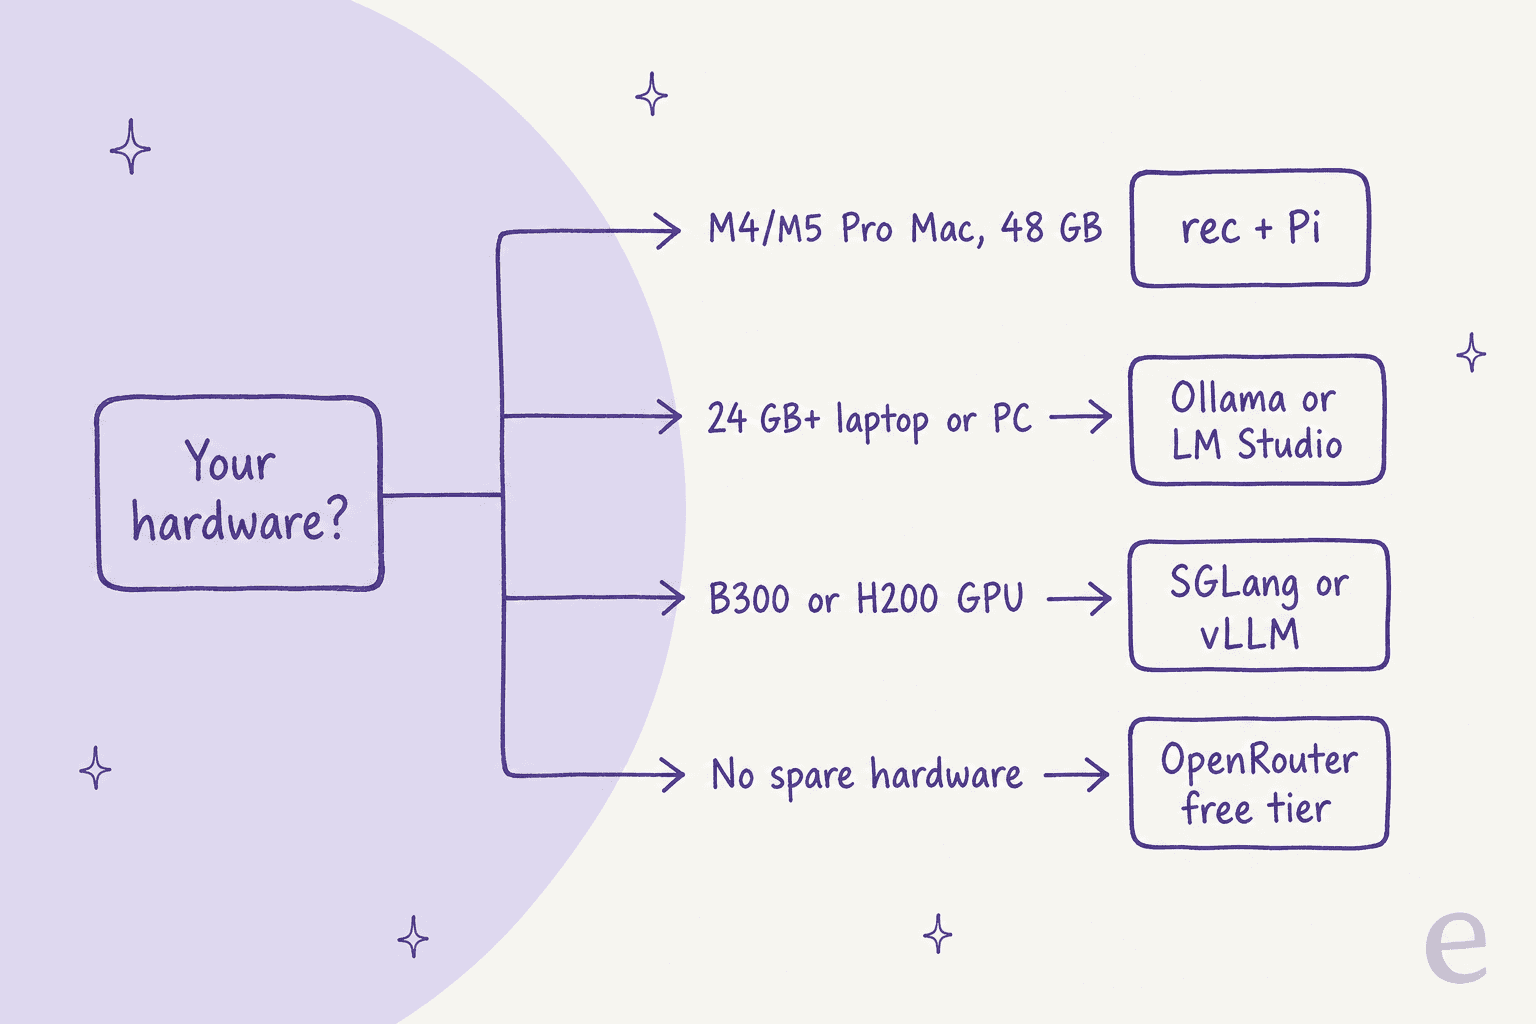
Você tem quatro caminhos, e seu hardware escolhe um por você.
1. Um Mac compatível: use o rec. Este é o motor da própria Recursive, e seu README afirma de 1,4 a 2,6x a vazão do llama.cpp em um M4 Pro. Instale com um único comando curl e depois execute rec launch pi na pasta do seu projeto. Ele baixa o modelo (cerca de 30 GB de disco) e o harness Pi, e inicia um servidor local que fala tanto APIs compatíveis com OpenAI quanto com Anthropic. A Recursive diz que o Flint rende melhor em par com o Pi; rec launch opencode é a alternativa. Um senão: o rec foi feito para uma única sessão, então rodar vários agentes ao mesmo tempo exige outro runtime.
2. Qualquer laptop ou PC razoável: Ollama ou LM Studio. ollama run flint:40b-a2b-qat-int4 baixa a versão empacotada de 4 bits da Recursive, e ollama launch opencode, pi, codex ou vscode a conecta a um harness, segundo o guia do Ollama. O LM Studio tem um GGUF de 24,20 GB com mínimo de 24 GB de RAM. Espere velocidades mais próximas das barras do llama.cpp do que das do MLX.
3. Um servidor com GPU: SGLang ou vLLM. O repositório do Hugging Face traz o checkpoint BF16 de cerca de 80 GB mais um kit de serviço SGLang que roda uma réplica em uma única B300 ou H200. O repositório já reuniu 93 quantizações da comunidade e 14 finetunes, então há muito por onde escolher se as versões da própria Recursive não couberem na sua stack.
4. Sem hardware sobrando: os planos gratuitos hospedados. O OpenRouter lista recursive/flint-v1.0:free a custo zero, e o seletor de modelos do OpenCode tem o Flint-40B no plano gratuito. Os apps mais ativos na página do OpenRouter são agentes de programação: o Kilo Code passou 32,9B tokens por ele em uma semana, o Cline 12,2B. Se você só quer ver se o estilo do Flint combina com você, este é o teste de cinco minutos.
Seja qual for o caminho, a primeira tarefa sugerida pela Recursive é boa: abra um repositório pequeno que você conheça, peça ao Flint para explicar uma função, adicione um teste e depois corrija o que o teste expuser. Confira o diff após cada passo.
Quanto custa o Recursive Flint?
Nada, em termos de licença. Os pesos são Apache 2.0, gratuitos para uso comercial, e as duas rotas hospedadas são gratuitas hoje. O custo real é hardware e eletricidade, e é aí que o Flint economiza dinheiro sem alarde: um modelo que precisa de um Mac de 48 GB em vez de um rack de GPUs, e que roda a 10x a velocidade de seus pares densos nesse Mac, faz mais trabalho por hora de uma máquina que você já possui.
| Rota | Preço | Limites |
|---|---|---|
| Pesos no Hugging Face | Grátis (Apache 2.0) | ~80 GB BF16; versões quantizadas para Mac e NVIDIA |
| rec em um Mac | Grátis | M4/M5 Pro ou Max, 48 GB+, sessão única |
| Ollama / LM Studio | Grátis | 24 GB de RAM mínimo para o menor GGUF |
OpenRouter flint-v1.0:free | $0 entrada, $0 saída | Um provedor, valem limites de capacidade e de taxa |
| Plano gratuito do OpenCode | $0 | Valem limites de capacidade e de taxa |
| API direta da Recursive | Não pública | Apenas parceiros selecionados |
Compare isso com modelos de fronteira hospedados, em que uma sessão longa de programação agêntica pode chegar a dólares por tarefa. Meu detalhamento dos preços do Kimi K3.1 Pro coloca o custo por tarefa em cerca de $2,11. Se você roda dezenas de tarefas pequenas e bem delimitadas por dia, um modelo local gratuito que seja bom o bastante muda a conta rápido.
Quem deve usar o Recursive Flint e quem deve pular?
Aqui está meu veredito, e o fator decisivo é quanto do raciocínio você aceita fazer por conta própria.
Use o Flint se:
- Você quer um agente de programação que funcione offline e mantenha seu código na sua máquina, e tem um Mac M4 ou M5 Pro/Max de 48 GB.
- Você trabalha de forma interativa, lendo cada diff, e valoriza um modelo que responde em segundos mais do que um que responde um pouco melhor em um minuto.
- Você está construindo sobre pesos abertos e precisa de uma licença comercialmente permissiva para finetuning ou redistribuição, o mesmo motivo pelo qual equipes recorrem a agentes de IA de código aberto.
Pule, por enquanto, se:
- Você quer o modelo local mais forte por resposta. O Qwen 3.8 de 27B denso ainda vence na maioria dos testes de código, a um décimo da velocidade; minha lista de alternativas ao Qwen cobre o resto dos rivais dessa família.
- Você roda agentes longos e sem supervisão, em que uma chamada de ferramenta quebrada custa uma execução inteira.
- Você precisa de uma API paga e com suporte e SLA. Isso ainda não existe, então uma ferramenta hospedada como o GitHub Copilot ou o Windsurf é a compra mais segura.
Se você está comparando o Flint com opções hospedadas, minha análise do Kimi K3.1 Pro e minha análise do DeepSeek V4 Flash cobrem as alternativas próximas, e as ferramentas de assistentes de programação com IA cobrem os harnesses em que você as rodaria.
Para outros modelos abertos que valem uma olhada neste mês, veja Nemotron 3.5 Bolt, LFM3 e Nanbeige 4.3.
A história maior é o laboratório, não o modelo. Um modelo de 40B construído do zero em menos de quatro meses, com um sistema automatizado fazendo boa parte da pesquisa, é a alegação a acompanhar. A aposta da Recursive é que cada modelo torna a Eureka Machine uma pesquisadora melhor. Se o Flint 2 fechar a diferença para o Qwen na mesma velocidade, esta análise fica bem mais positiva.
O que o Flint significa se você comanda uma equipe de suporte
O Flint é infraestrutura: um modelo sobre o qual roda um agente de programação. Até escolher um modelo para suporte é uma pergunta à parte, que cubro no meu guia de LLMs para atendimento ao cliente. Se o seu problema é uma fila de suporte e não uma base de código, o modelo nunca foi a parte difícil. O difícil é tudo ao redor: conectar ao Zendesk ou Freshdesk, aprender com seus tickets anteriores, saber quando passar para um humano e provar que ele não dará uma resposta errada com toda a confiança antes de um cliente ver. A eesel passou anos colocando agentes de IA em filas de suporte reais, e a lição que mais vejo ser reaprendida é que todo lançamento precisa ser simulado com tickets históricos antes de entrar no ar.
É isso que são os colegas de IA da eesel, e por isso eu indicaria um líder de suporte a eles antes de qualquer kit de agentes de IA: funcionários prontos para trabalhar em uma função definida, não um modelo em torno do qual você monta um produto. O colega de helpdesk com IA é o indicado para suporte.
A SE Ranking, por exemplo, roda três agentes da eesel em três conexões do Zendesk, uma por produto, e atendeu 4.650 conversas em um mês, incluindo cerca de 2.100 chats ao vivo respondidos primeiro pela eesel. A SamCart roda um agente nos tickets do Freshdesk e outro no chat do site, respondendo a partir de 280 artigos da central de ajuda.
E é aqui que os dois mundos se encontram. A eesel tem uma CLI, então o mesmo agente de programação que você rodaria no Flint, no Claude Code ou no Codex pode operar seu colega de suporte pelo terminal: eesel activity para ler o que o agente fez em cada ticket, eesel instructions para mudar suas regras permanentes, eesel approvals para aprovar ações que ele está aguardando. Todo comando imprime JSON, e --dry-run mostra a chamada exata que uma escrita faria antes de enviá-la. A documentação chega a dizer aos agentes de IA para usarem a CLI em vez de clicar pelo painel. Se você tem curiosidade sobre como isso se compara a montar por conta própria, escrevi separadamente sobre as CLIs de agentes de IA e o caminho do servidor MCP.
Experimente a eesel
Quer uma IA para o seu helpdesk sem construí-la sobre um modelo bruto? O colega de helpdesk da eesel se conecta em minutos ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda, e é testado neles antes de responder a qualquer pessoa. Cada ação aparece em um registro de atividade que você pode ler no painel ou puxar pela CLI. Começar é grátis, sem cartão.
