

O Recursive Flint é um modelo de programação gratuito, de pesos abertos, que roda em um MacBook, e a Recursive diz que seu sistema de pesquisa automatizada ajudou a construir quase todas as partes dele. Ele tem 40B de parâmetros, mas só cerca de 2,5B ativos por token, então escreve mais de 125 tokens por segundo em um M4 Pro. Os pesos são Apache 2.0, e você pode testá-lo em cerca de cinco minutos.
O modelo é o produto, mas a história é o laboratório. A Recursive diz que uma pequena equipe de pessoas e agentes construiu o Flint do zero em menos de quatro meses, com a Eureka Machine buscando a arquitetura, a receita de quantização e os kernels para Mac. Se esse processo se sustentar, o Flint é o primeiro de uma série, não um caso isolado.
Se você chegou aqui porque quer um agente para uma fila de suporte e não para uma base de código, um modelo bruto é a camada errada. O colega de IA para helpdesk da eesel é o funcionário que fica por cima de modelos como este, e é testado com seus tickets anteriores antes de responder a qualquer pessoa.
O que é o Recursive Flint?
O Recursive Flint é um modelo de programação de mistura de especialistas do laboratório Recursive, lançado em 21 de outubro de 2026. Ele recebe texto e devolve texto, o raciocínio está sempre ativado e as chamadas de ferramentas também vêm integradas. A função para a qual foi feito é estreita: ser o motor por baixo de um agente de programação que lê um repositório, edita arquivos e roda os testes. Seu harness (Pi, OpenCode, Cline) é a parte que executa as ferramentas, e o Flint é a parte que decide o que fazer em seguida.
Eu construo os agentes de IA dentro da eesel, então com qualquer modelo novo a primeira coisa que pergunto é o que acontece por baixo do capô e depois se ele sobrevive a um longo ciclo de ferramentas. Nas duas coisas, o Flint se mostrou mais interessante do que eu esperava. Isto é o que ele realmente é, segundo o model card e a documentação da Recursive:
| Especificação | Recursive Flint |
|---|---|
| Parâmetros totais | 39,8B |
| Ativos por token | ~2,5B |
| Especialistas | 256 por camada MoE, 6 roteados por token, mais 1 compartilhado |
| Camadas | 49 (2 densas, 47 MoE) |
| Contexto | 262.144 tokens hospedado; até 512k suportado, 256k recomendado |
| Saída máxima (hospedado) | 65.536 tokens |
| Raciocínio | Sempre ativado |
| Licença | Apache 2.0 |
| Lançamento | 21 de outubro de 2026 |
Se eu resumir a proposta, ela fica assim: pontuações de programação de um modelo denso na velocidade de um modelo pequeno, em hardware que você já tem. A Recursive diz que ele "rivals the coding performance of dense models with 25 to 40 billion parameters, while running more than five times faster." O quanto isso é verdade, retomo um pouco mais abaixo.
Quem é a Recursive e o que é a Eureka Machine?
A Recursive é um laboratório de IA liderado por Richard Socher, que também comanda a You.com. Na página inicial, o objetivo é declarado sem muita hesitação: construir "the self-improving superintelligence that automates the scientific method." O laboratório chama esse sistema de Eureka Machine, e o Flint é seu primeiro produto público.
Por trás há um ciclo de pesquisa que continua sem que uma pessoa conduza cada passo. Segundo a publicação de pesquisa da Recursive de 11 de junho, ele propõe uma ideia e a implementa, roda o experimento e valida o resultado, e depois usa o que aprendeu para escolher o próximo experimento. Muitas dessas threads rodam ao mesmo tempo e por longos períodos, e o sistema mantém o contexto dos experimentos anteriores e também combina os ramos que parecem promissores.
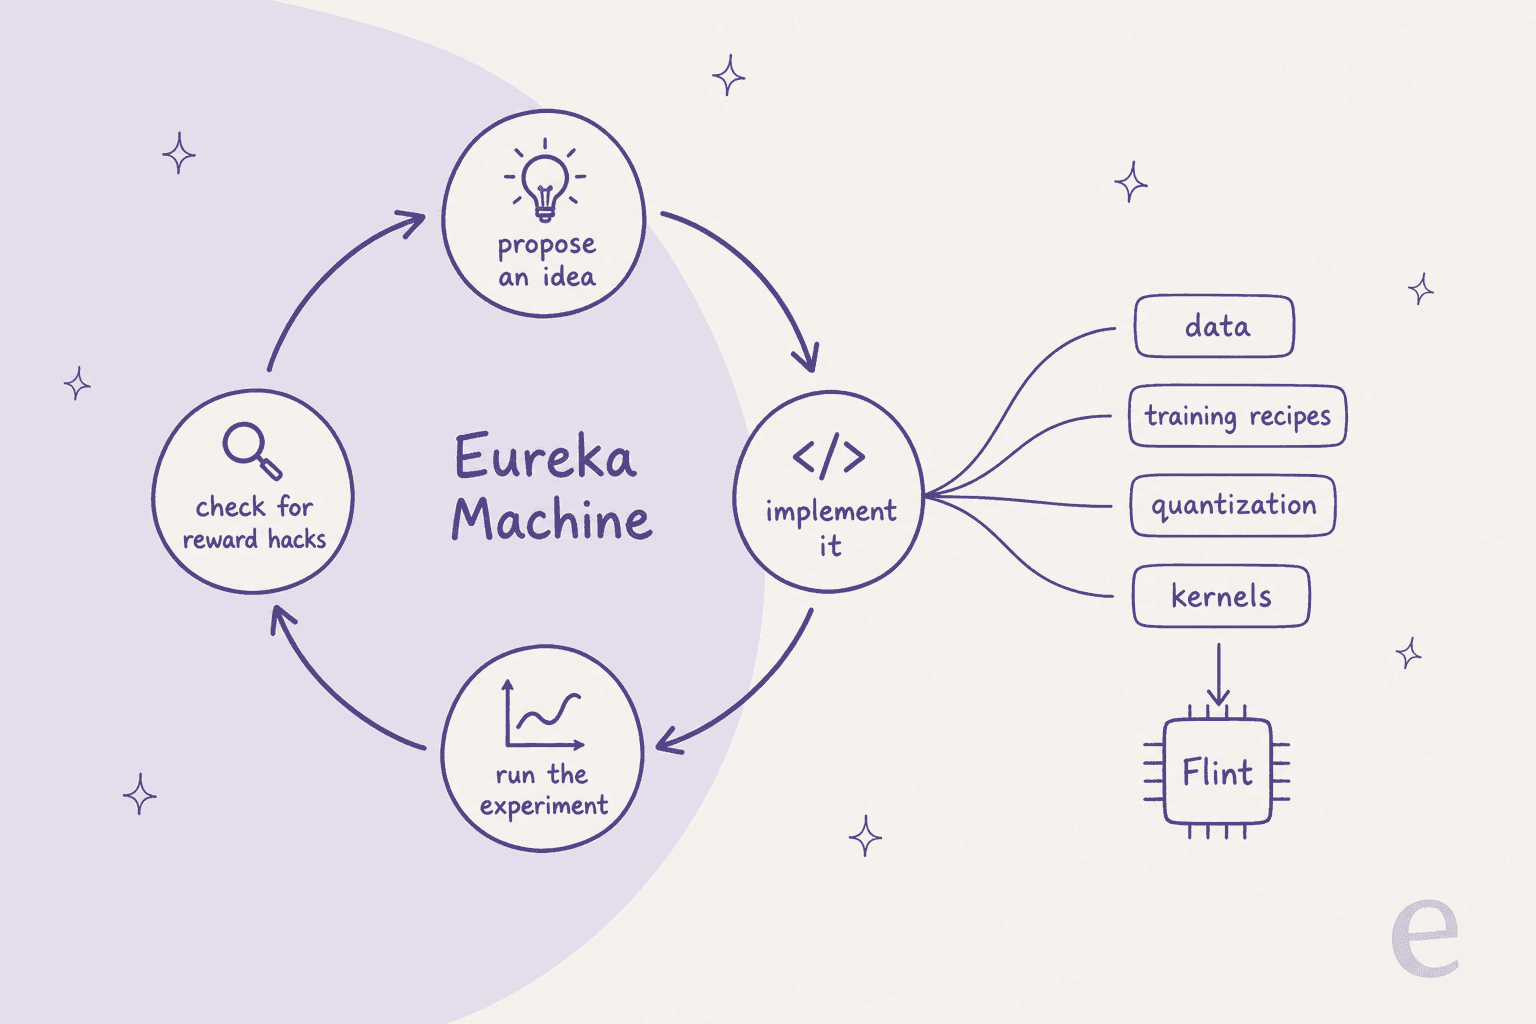
Dos quatro, o passo ao qual eu daria mais atenção é o último, verificar reward hacks. Dê a um sistema uma pontuação para otimizar e ele vai achar jeitos de aumentá-la sem fazer o trabalho de verdade. Segundo o texto da Recursive, isso foi mais difícil com kernels de GPU, onde alguns candidatos guardavam saídas em cache ou exploravam o harness de medição de tempo em vez de rodar mais rápido. A solução foi uma auditoria mais rigorosa que foi crescendo junto com a busca: "as the search became stronger, the evaluator had to become stronger too."
Do meu lado da cerca, essa frase soa muito verdadeira, porque qualquer IA que você avalia por uma métrica vai driblar a métrica se puder. É o mesmo motivo pelo qual a eesel simula cada rollout contra os tickets históricos de um cliente antes que um agente responda a qualquer pessoa ao vivo: uma resposta confiante e uma resposta correta não são a mesma coisa, e você só descobre qual delas tem conferindo com casos reais.
O que a Eureka Machine fez antes do Flint?
Antes de a Eureka Machine chegar perto do Flint, a Recursive a testou em três benchmarks públicos, escolhidos porque dão um feedback rápido e fácil de medir. Em todos eles, superou o melhor resultado anterior, segundo a publicação de pesquisa:
| Benchmark | O que mede | Melhor anterior | Eureka Machine |
|---|---|---|---|
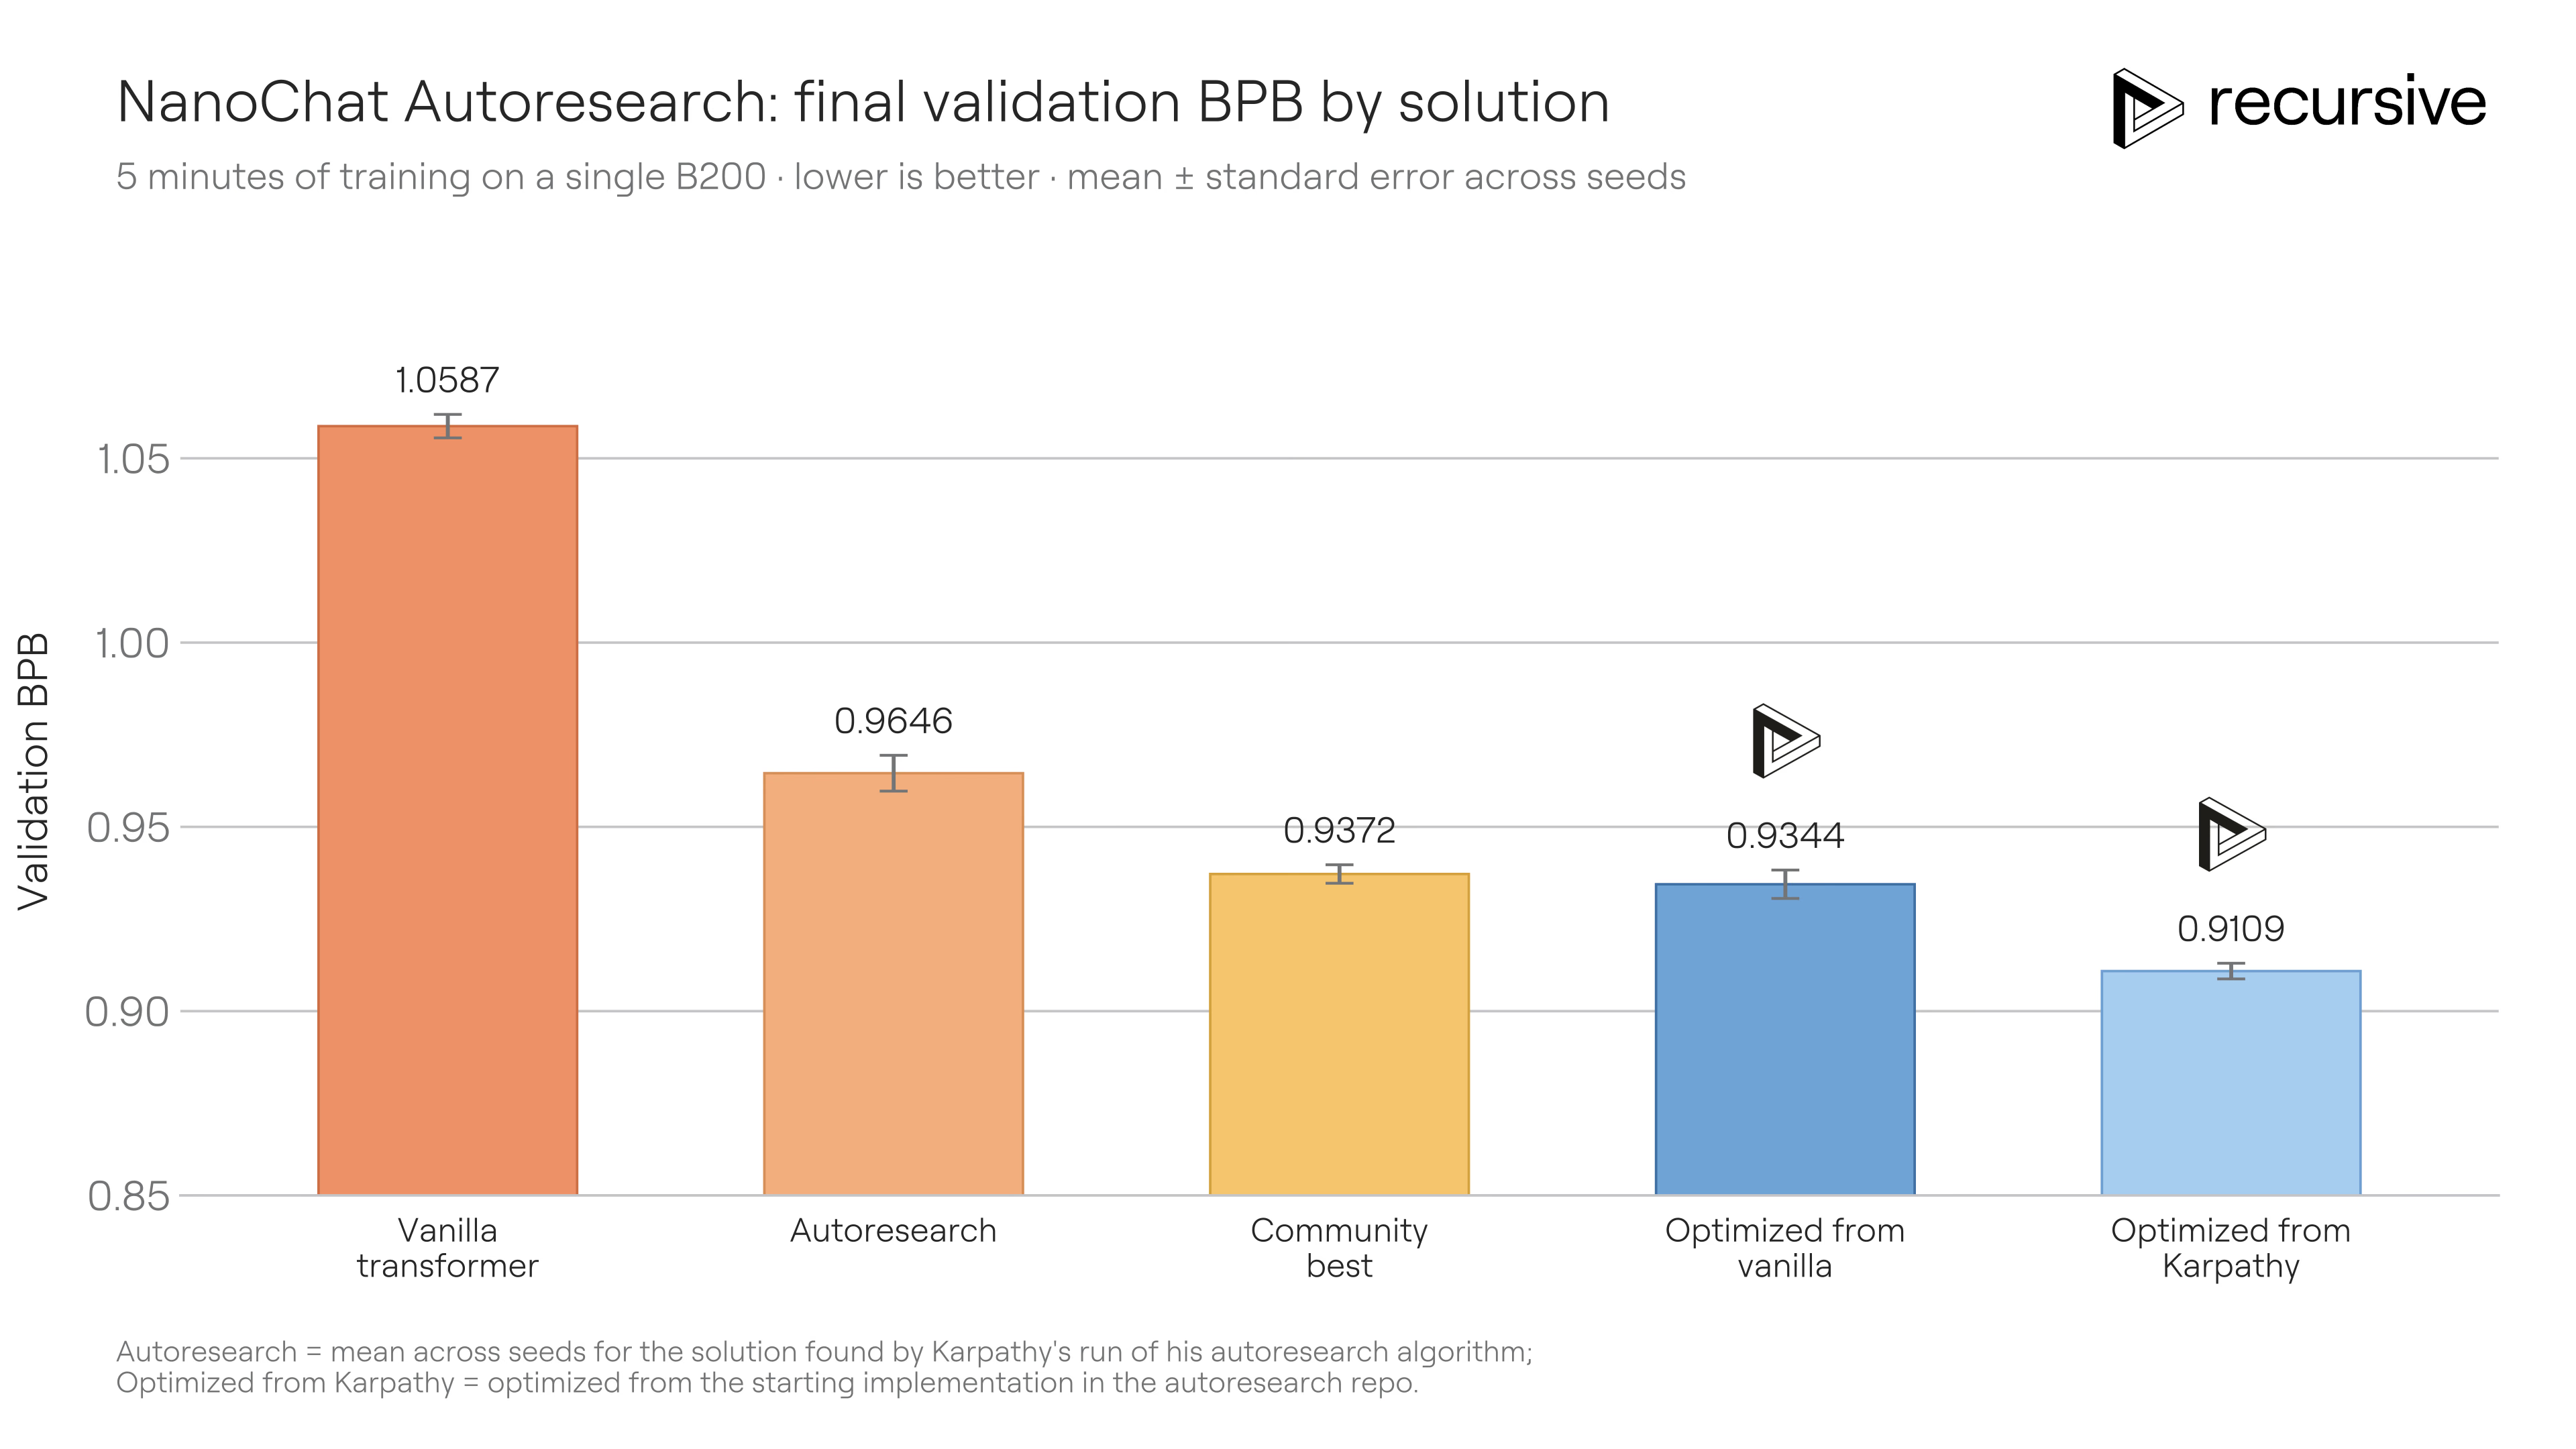
| NanoChat Autoresearch | Perda de validação após 5 min de treinamento (menor é melhor) | 0.9372 BPB | 0.9109 BPB |
| NanoGPT Speedrun | Tempo para treinar um GPT pequeno até uma perda fixa | 79,7 s | 77,5 s |
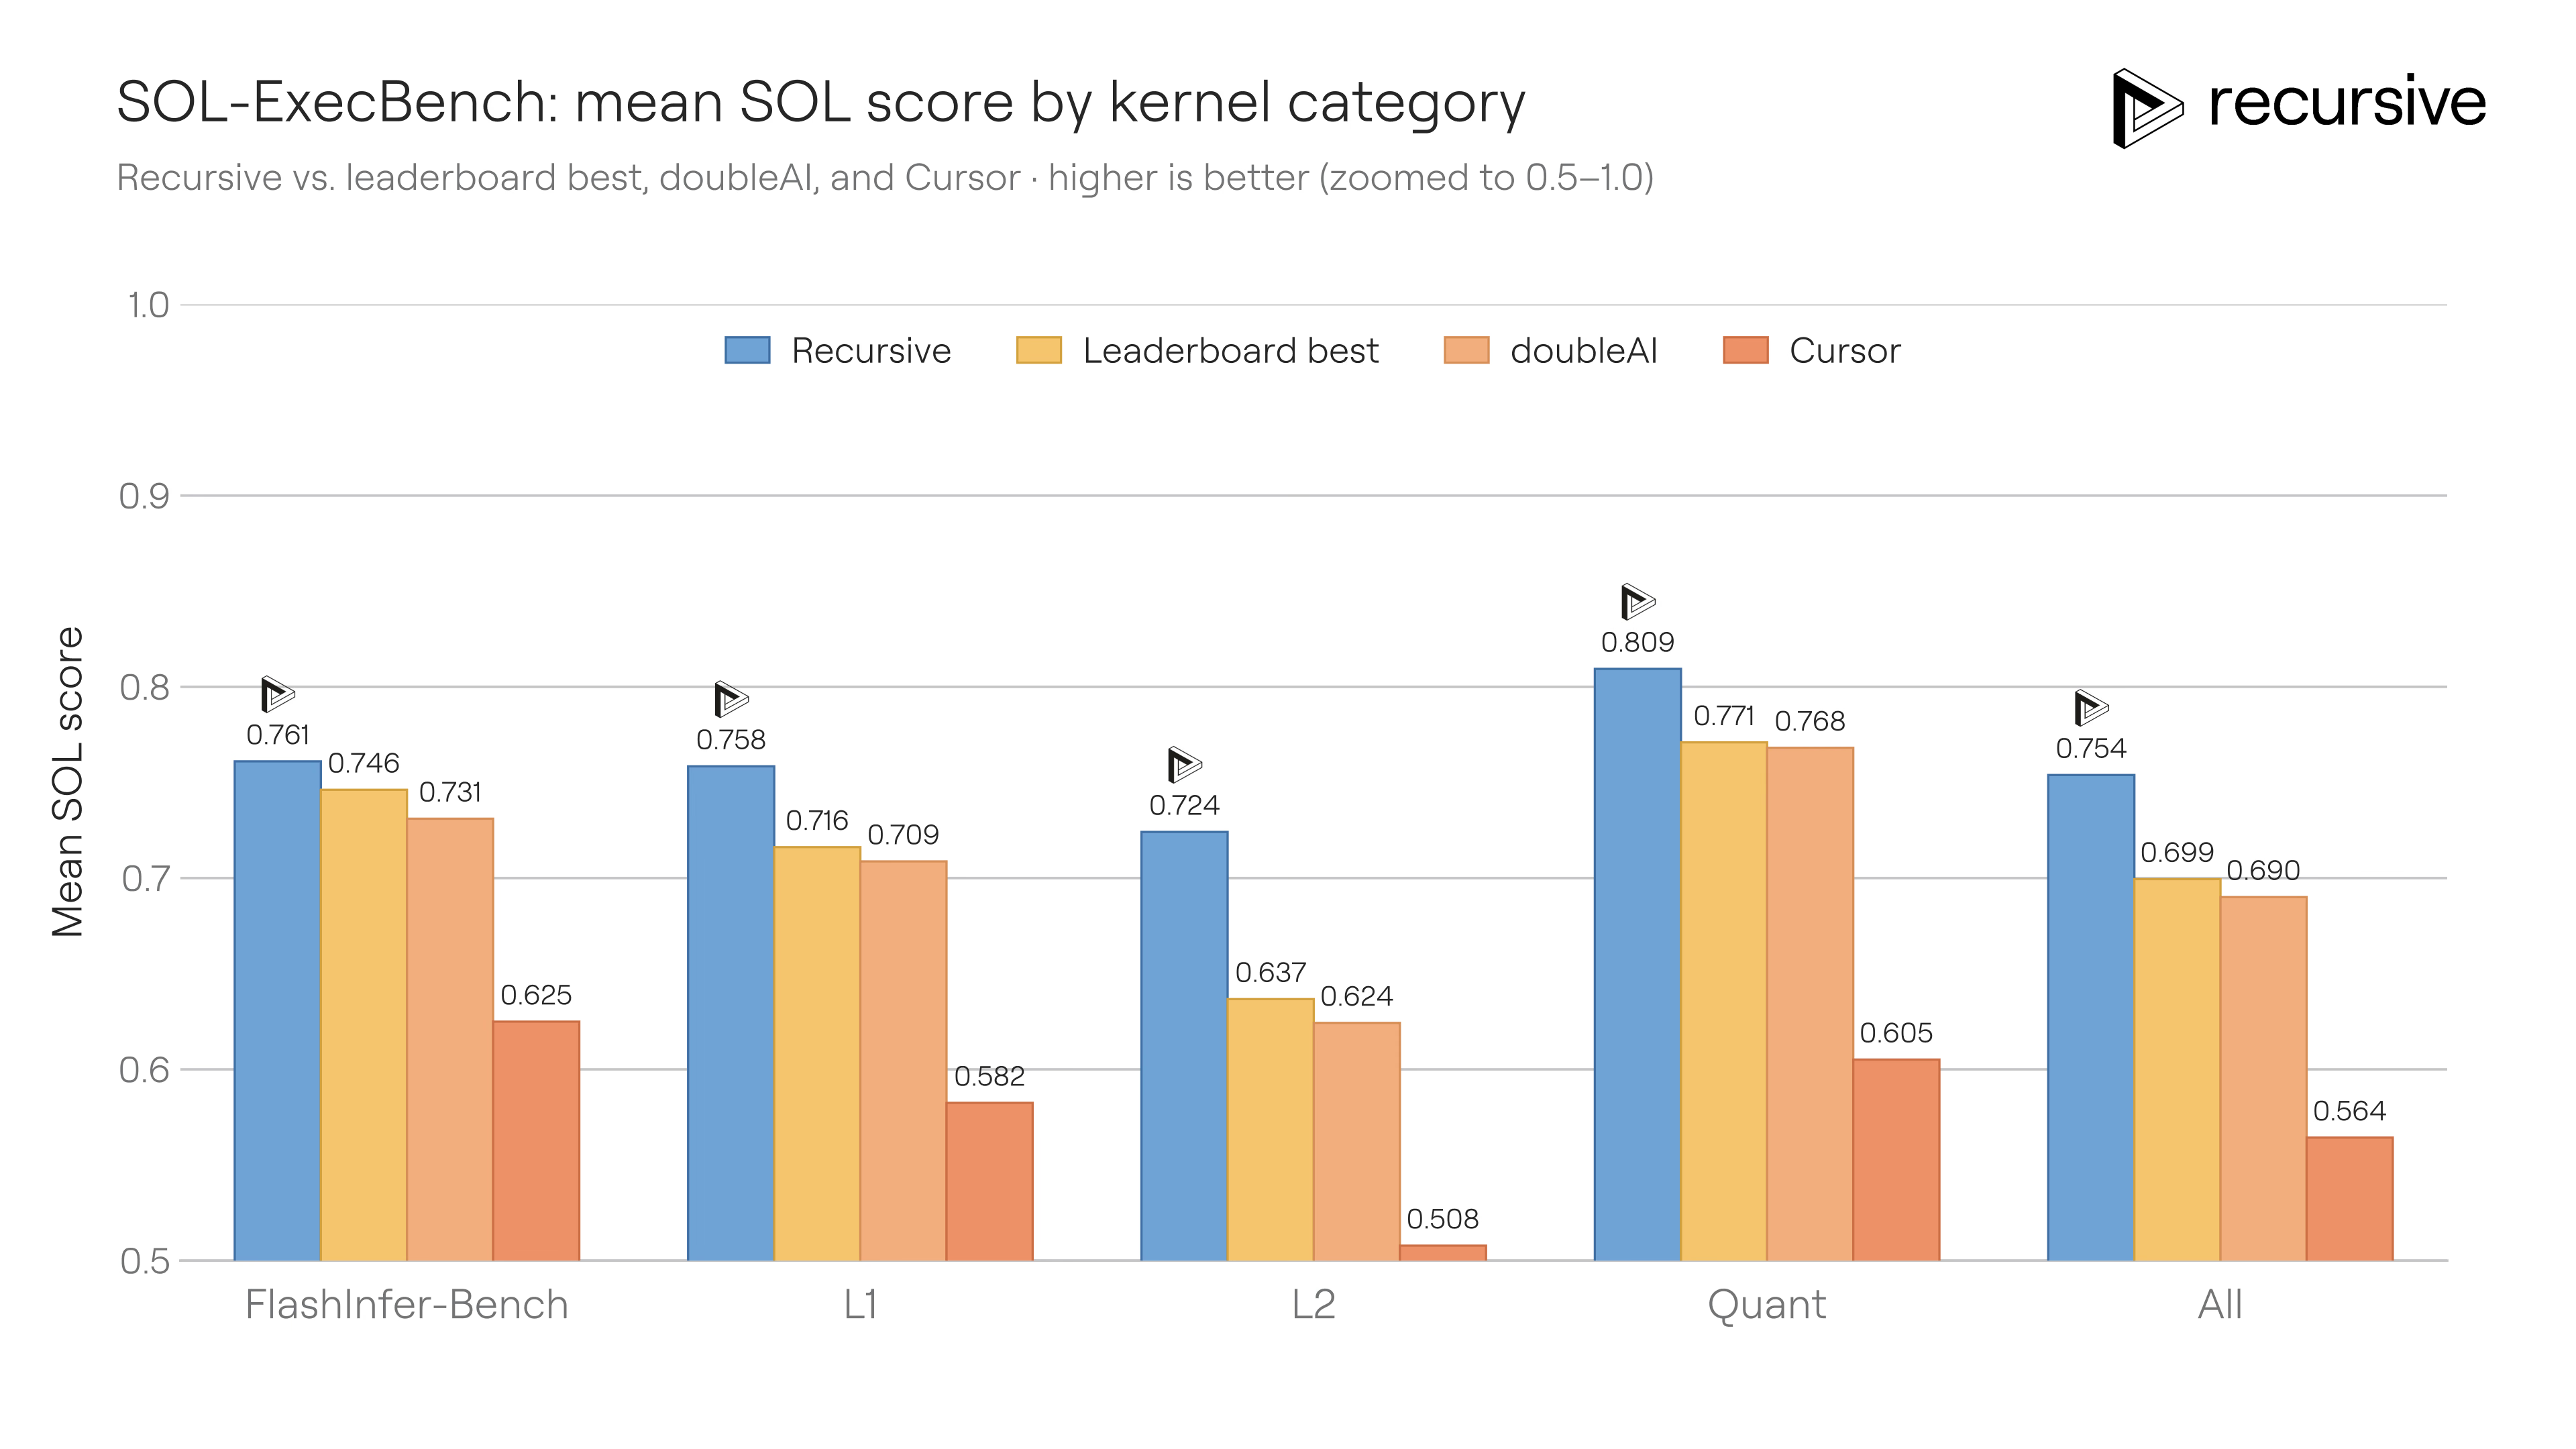
| SOL-ExecBench | Pontuação média de velocidade em 235 kernels de GPU (1,0 = limite do hardware) | 0.699 | 0.754 |
O resultado do NanoChat é o mais fácil de ler. O "melhor anterior" nesse caso não foi a execução de uma única pessoa, e sim a melhor solução do autoresearch@home, onde dezenas de pessoas e centenas de seus agentes vinham melhorando a mesma configuração.
O ganho no NanoGPT é menor, mas foi mais difícil de conseguir. Esse ranking viu 83 contribuições humanas que bateram recordes em dois anos, e mesmo assim a Eureka Machine tirou 2,2 segundos da melhor entrada. A Recursive observa que rodou isso em nós da Modal e da Andromeda e ainda aguardava o hardware oficial antes de submeter, então por enquanto eu trataria como uma afirmação forte que ainda não chegou ao ranking.
Para o Flint, o benchmark de kernels é o que mais importa, já que os kernels foram o que tornou o Flint rápido desde o início. Nas 235 tarefas, o sistema fechou 18% da distância restante até o limite do hardware.
Gosto que a Recursive seja cuidadosa com o próprio enquadramento neste ponto. Ela diz que as execuções do zero "should not be read as independent or unique discovery", já que os modelos de base podem ter visto os repositórios públicos. Uma honestidade assim me faz confiar um pouco mais no resto do texto.
Como a Recursive construiu o Flint em menos de quatro meses?
Segundo a publicação de lançamento, a Eureka Machine participou de quase todas as camadas da pilha de construção do modelo. A publicação detalha quatro passos, e cada um alimenta o seguinte.
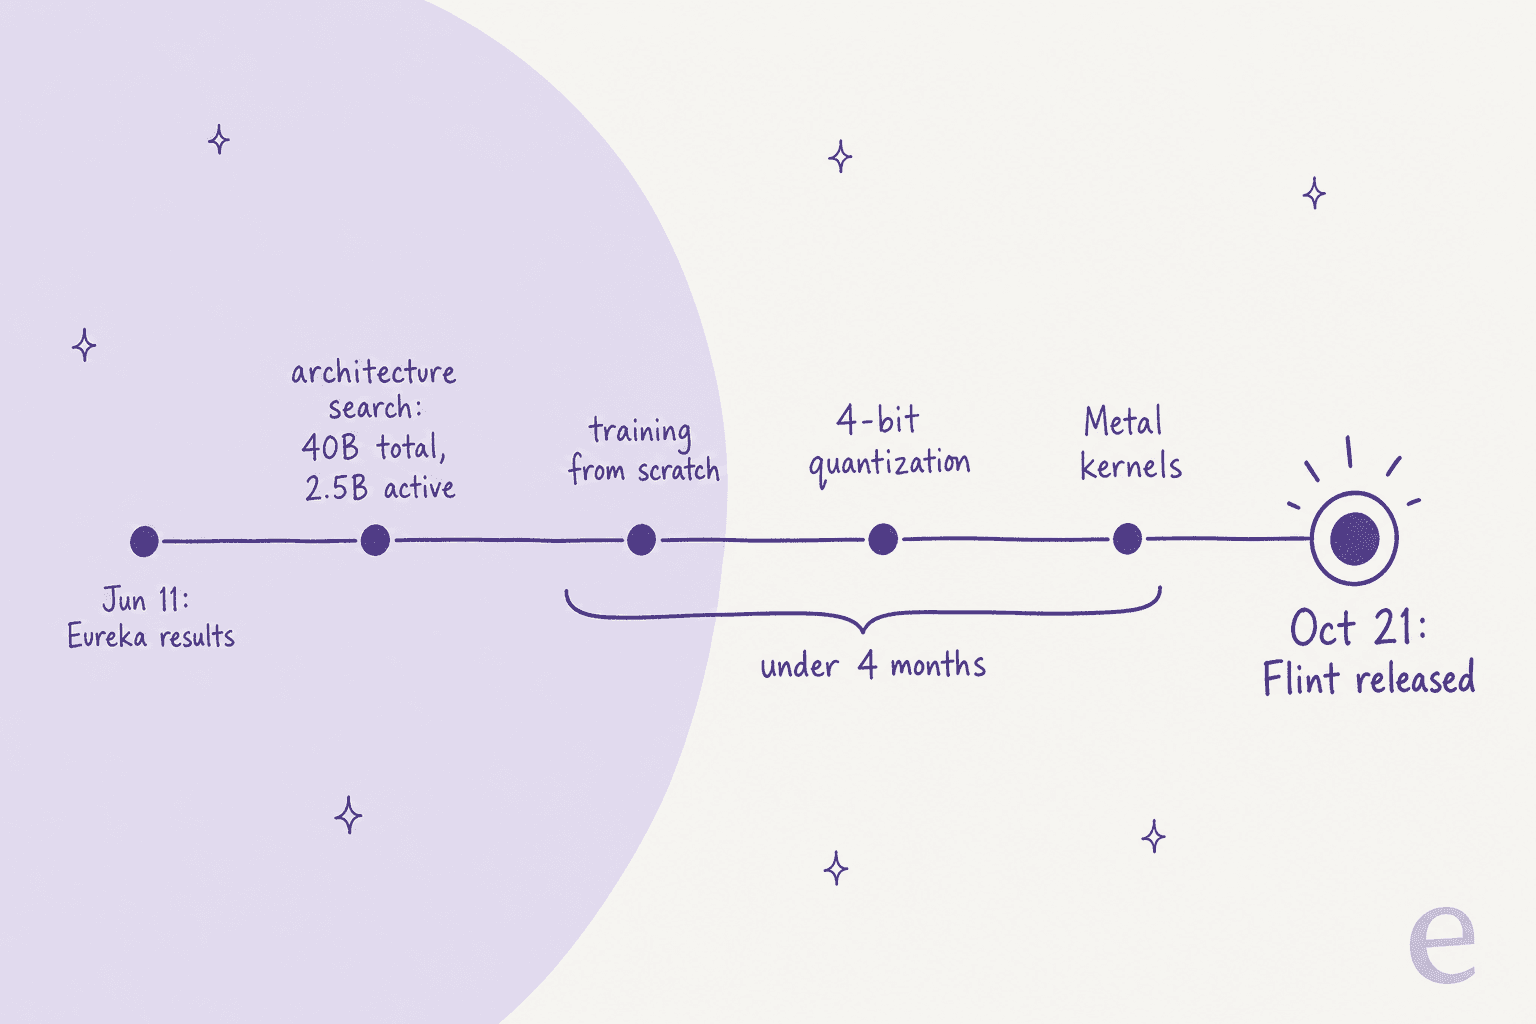
- Busca de arquitetura. A Recursive partiu de uma base com
35Bde parâmetros totais e3Bativos. A Eureka Machine explorou números e larguras de especialistas e chegou a 40B no total, 2,5B ativos, a configuração que projetou dar a melhor mistura de velocidade e pontuações de programação. Então há mais parâmetros totais e menos ativos, um pouco como uma biblioteca maior em que cada token ainda lê menos páginas. - Treinamento do zero. O Flint não é um ajuste fino do modelo de outra pessoa. Pelo caminho, o sistema também trabalhou nos dados e nos otimizadores, e também nas receitas de treinamento.
- Quantização. Para mim, este é o passo mais engenhoso. Indo contra a prática comum, o sistema reduziu a camada de saída (
lm_head) para 4 bits. Com apenas 2,5B de parâmetros ativos, essa camada de saída é uma grande parte dos pesos lidos a cada token, então torná-la menor compra velocidade real. Para recuperar a precisão, ele adicionou uma etapa de destilação em que o modelo de 4 bits treina com as próprias respostas amostradas previamente, com o modelo de 16 bits como professor. Isso quase reduziu pela metade os passos de treinamento em comparação com a base da Recursive, e a versão final NVFP4 pontua a até0,7ponto da de 16 bits. - Kernels. Como último passo, ele escreveu kernels para matemática de poucos bits, roteamento MoE, atenção e processamento de prompt em Apple Silicon e na RTX Spark da NVIDIA. Em chips M4 e M5, produziu um "megakernel" Metal que funde todo o passo de decodificação em um só.
O motivo de os quatro passos se acumularem é bastante simples. Ter menos parâmetros ativos torna cada token mais barato, uma camada de saída de 4 bits torna mais barato ler cada um desses parâmetros, e o kernel fundido elimina a sobrecarga entre as leituras. Cada ganho multiplica o anterior, e é assim que um modelo de 40B acaba mais rápido que muitos de 3B ativos.
Quão rápido e quão bom é o Recursive Flint?
Ele é rápido e, para o tamanho, também é bom. No gráfico da Recursive para um M4 Pro com 48 GB, o Flint escreve 131,22 tokens/s com contexto curto via MLX, contra 13,01 do Qwen 3.8 27B denso. Na média até 128K tokens de contexto, mantém 68,89 tokens/s enquanto o Qwen 3.8 cai para 10,11.

Em qualidade, o quadro é mais misto. Assim o Flint se compara aos rivais mais próximos no próprio gráfico de benchmarks da Recursive:
| Benchmark | Flint | Qwen 3.8 27B (denso) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54,9 | 73,0 | 44,9 |
| SWE-bench Verified | 74,2 | 75,6 | 73,4 |
| LiveCodeBench v6 | 80,3 | 90,3 | 80,4 |
| IFBench | 89,2 | 79,5 | 67,9 |
Ao lado de outros modelos MoE do mesmo tamanho, o Flint vence com folga, e é essa a afirmação que a Recursive escolheu destacar. Ao lado do melhor modelo denso do gráfico, porém, ele perde quatro de seis testes, incluindo uma diferença de 18 pontos no Terminal-Bench 2.1. Então "rivals dense models" é justo para o Muse Glimmer e o Gemma 4, e generoso para o Qwen 3.8.
Essa troca recebe uma análise bem mais profunda, junto com a taxa de erro de 17,74% em chamadas de ferramentas que o OpenRouter reporta atualmente, na análise do Recursive Flint da minha colega Rama. Minha conclusão curta é que você leva um modelo 10 vezes mais rápido com uma resposta um pouco pior. Em programação interativa, onde você lê cada diff de qualquer jeito, esse costuma ser o negócio certo.
Como executar o Recursive Flint?
Colocar o Flint para rodar leva cerca de cinco minutos, e o caminho depende do seu hardware. Este é o mapa do guia de configuração da Recursive:
| Sua configuração | Caminho | O que você precisa |
|---|---|---|
| Mac recente | rec, o motor da própria Recursive | M4 Pro, M5 Pro ou M5 Max, 48 GB+ de memória |
| Qualquer laptop ou PC | Ollama, LM Studio, Unsloth ou llama.cpp | Uma versão quantizada compatível; 24 GB de RAM para o menor GGUF |
| Servidor com GPU | SGLang, vLLM ou Transformers | Checkpoint BF16 de ~80 GB; uma B300 ou H200 |
| Sem hardware sobrando | Nível gratuito do OpenRouter ou OpenCode | Uma conta; valem limites de capacidade e de taxa |
| Parceiro | API direta da Recursive | Acesso de parceiro aprovado |
Em um Mac compatível, bastam dois comandos. Primeiro instale o rec, depois execute rec launch pi na pasta do seu projeto. Isso baixa o modelo junto com o harness Pi e inicia um servidor local que fala tanto APIs no estilo OpenAI quanto no estilo Anthropic. Se você prefere o OpenCode, use rec launch opencode no lugar.
Se você não tem um Mac, o caminho mais rápido é o Ollama, onde ollama run flint:40b-a2b-qat-int4 baixa a versão empacotada de 4 bits da Recursive. Em uma máquina com GPU, o repositório do Hugging Face tem o checkpoint completo e um kit de serviço SGLang. A comunidade também foi rápida nesse repositório, com 93 quantizações e 14 ajustes finos na semana seguinte ao lançamento.
Há duas dicas de configuração da documentação que valem ser repassadas. A primeira é dar espaço para ele pensar: como o raciocínio está sempre ativado, se uma resposta terminar com finish_reason: length, aumente o orçamento de saída em vez de encurtar o prompt. Vejo pessoas caírem na mesma armadilha de orçamento com a janela de contexto do Claude Code. A segunda dica é dividir o trabalho em passos pequenos e explícitos. A Recursive diz que o Flint "may need more guidance than the larger closed-source coding models you're used to", o que combina com sua pontuação de destaque em seguir instruções.
Para quem prefere não baixar nada, existe o endpoint gratuito do OpenRouter, cuja página também mostra onde o Flint já está sendo usado. Os principais apps ali são todos agentes, com o Kilo Code em 32,9B tokens em uma semana, o Cline em 12,2B e o Hermes Agent em 10,6B.
Quanto custa o Recursive Flint?
Em termos de licença, não custa nada. Os pesos são Apache 2.0, gratuitos para uso comercial, e o OpenRouter lista o endpoint hospedado a $0 de entrada e saída, com 99,67% de disponibilidade nos últimos três dias. O que você realmente paga é o hardware em que o executa.
E é exatamente aí que o design do Flint compensa. Um modelo que programa em nível de modelo denso em um único Mac de 48 GB, a 10 vezes a velocidade dos seus pares densos, transforma uma máquina que você já tem em um backend de programação gratuito. Compare isso com um modelo de fronteira hospedado, em que minha análise de preços do Kimi K3.1 Pro coloca uma tarefa agêntica típica em cerca de $2,11. Ao longo de dezenas de tarefas pequenas por dia, "bom o bastante e de graça" se acumula rápido.
O que você não ganha é uma API paga com SLA. O acesso direto continua limitado a parceiros selecionados, segundo o FAQ da Recursive, então para qualquer coisa voltada ao cliente você ainda vai querer um modelo hospedado com suporte, como o GitHub Copilot ou o OpenAI Codex.
Por que o Recursive Flint importa?
Por si só, o Flint é um modelo de programação pequeno muito bom, mas não é o único modelo aberto bom deste mês, já que Nemotron 3.5 Bolt, LFM3 e Nanbeige 4.3 foram todos lançados em poucas semanas. O que torna o Flint diferente é como ele foi feito.
A aposta da Recursive, nas próprias palavras, é que "more capable models can make Eureka Machine a better researcher, helping us build the next generation faster." Se isso se confirmar, cada Flint torna o próximo mais barato de construir. Essa é a afirmação que eu ficaria de olho, e o lado bom é que ela pode ser testada, porque o próximo lançamento vai mostrar se o ciclo realmente acelera ou se o Flint foi uma equipe talentosa com boas ferramentas.
Por ora, é assim que eu agiria:
- Você programa e tem um Mac recente: teste o Flint esta semana. É gratuito e privado, e também rápido o bastante para mudar a frequência com que você recorre a um modelo local. Use-o dentro de uma CLI de programação agêntica que você já conhece.
- Você quer o modelo aberto mais forte por resposta: fique com o Qwen 3.8 por enquanto, ou veja minha lista de alternativas ao Qwen.
- Você roda trabalhos de agentes longos e sem supervisão: espere a taxa de erro em chamadas de ferramentas baixar, ou fique com o Claude Code.
- Você acompanha ferramentas de pesquisa em IA: leia a publicação de pesquisa da Recursive e os artefatos de código aberto. O mesmo vale para outros lançamentos de infraestrutura deste mês, como DeepInfer e TorchTPU.
O que o Flint significa se você comanda uma equipe de suporte
O Flint é infraestrutura, ou seja, um modelo sobre o qual roda um agente de programação. Quando seu problema é uma fila de suporte, o modelo nunca foi realmente a parte difícil. O difícil é tudo o que o cerca, como conectar ao seu helpdesk e aprender com seus tickets anteriores, depois saber quando transferir e provar que ele não dará uma resposta errada com toda a confiança. Até escolher o modelo é uma questão à parte, que abordo em LLMs para atendimento ao cliente.
É essa lacuna que os colegas de IA da eesel preenchem. Cada um é um funcionário pronto para trabalhar em uma função definida, em vez de um kit de agentes de IA que você monta sozinho, e o colega para helpdesk é o de suporte. A eesel passou anos colocando IA em filas de suporte ao vivo, e a lição é a mesma que a Recursive aprendeu com seus kernels: o avaliador precisa ser tão sério quanto o sistema que ele verifica.
A Qontro, uma empresa de software ERP, recebe em cada ticket do Freshdesk um rascunho de resposta com os artigos de ajuda relevantes linkados, 190 tickets redigidos em um mês, respondendo a partir de cerca de 9.800 tickets anteriores e artigos de ajuda. A SE Ranking roda três agentes da eesel em três conexões do Zendesk e atendeu 4.650 conversas em um mês.
Se você vive no terminal, este é o ponto em que os dois mundos se encontram. A CLI da eesel permite que o mesmo agente de programação que você executaria no Flint opere seu colega de suporte: eesel activity mostra o que o agente fez em cada ticket, eesel instructions muda suas regras permanentes e eesel approvals aprova ações que ele está aguardando. Todo comando devolve JSON, e com --dry-run você vê a chamada exata que uma escrita faria antes de ela ser enviada. Escrevi mais sobre CLIs de agentes de IA e o caminho do servidor MCP.
Experimente a eesel
Quer IA no seu helpdesk sem construí-la sobre um modelo bruto? O colega da eesel para helpdesk se conecta em minutos ao Zendesk, Freshdesk ou Gorgias, aprende com seus tickets anteriores e sua central de ajuda e é testado com eles antes de responder a qualquer pessoa. Você pode acompanhar cada ação no painel ou consultá-la pela CLI. Comece de graça, sem cartão.

Perguntas frequentes
O que é o Recursive Flint?
Quem criou o Recursive Flint?
O Recursive Flint é de código aberto e gratuito?
Como executo o Recursive Flint localmente?
rec launch pi na pasta do seu projeto. Em outras máquinas, use Ollama, LM Studio ou llama.cpp com uma versão quantizada, ou SGLang e vLLM em um servidor com GPU. Combine-o com um harness como o Pi coding agent.