

Resumo
LFM3 é a nova família da Liquid AI com seis modelos abertos de cerca de 2B parâmetros cada, lançada em 27 de outubro de 2026, e o modelo de texto, LFM3-1.7B, atinge uma média de 49.37 na tabela de 29 benchmarks da Liquid, contra 47.24 do Qwen3.5-9B, um modelo cinco vezes maior. Ele foi desenvolvido para agentes locais: decodifica 43.6 tokens por segundo em um iPhone 17 Pro usando 1.90 GB de memória, cerca de 2.8x mais rápido que o segundo modelo mais rápido testado pela Liquid.
A família abrange texto, visão, áudio, um modelo "omni" que vê, ouve e fala, e dois modelos de decisão (d1-2B e d1-Omni-2B) que respondem a perguntas sobre um ticket ou documento em milissegundos, em vez de redigir uma resposta. Os pesos são gratuitos no Hugging Face, mas apenas para empresas com receita anual abaixo de US$ 10 milhões, e ainda não há um preço de API publicado para o LFM3.
O porém: a própria ficha do modelo da Liquid diz para não usar o LFM3-1.7B em programação com agentes ou raciocínio complexo de várias etapas, e todos os números acima foram divulgados pelo fornecedor. Para equipes de suporte, a parte interessante é o d1-2B, que pode encaminhar e aplicar tags a um ticket em uma única passagem. Um modelo ainda precisa de um helpdesk ao seu redor, por isso equipes como a Dokument 24 usam um colega de equipe de IA para helpdesk pronto para usar, que aplica tags e prepara rascunhos para cada novo ticket do Zendesk, em vez de integrar um modelo por conta própria.
O que é o LFM3?
LFM3 é a terceira geração dos Liquid Foundation Models da Liquid AI, a empresa por trás de modelos pequenos feitos para rodar em celulares, notebooks e carros, em vez de em um data center. A Liquid anunciou o LFM3 em 27 de outubro de 2026 como "every modality for specialized intelligence," e o primeiro lançamento abrange modelos "in the 2B parameter range."
Eu abordo novos modelos pelo lado das buscas (o que as pessoas estão realmente perguntando sobre ele?), com uma pergunta de quem desenvolve por trás: o que seria necessário para colocar isso para rodar por trás de um produto real? No caso do LFM3, a resposta é mais interessante do que na maioria dos lançamentos, porque ele não é um único modelo, é uma família.
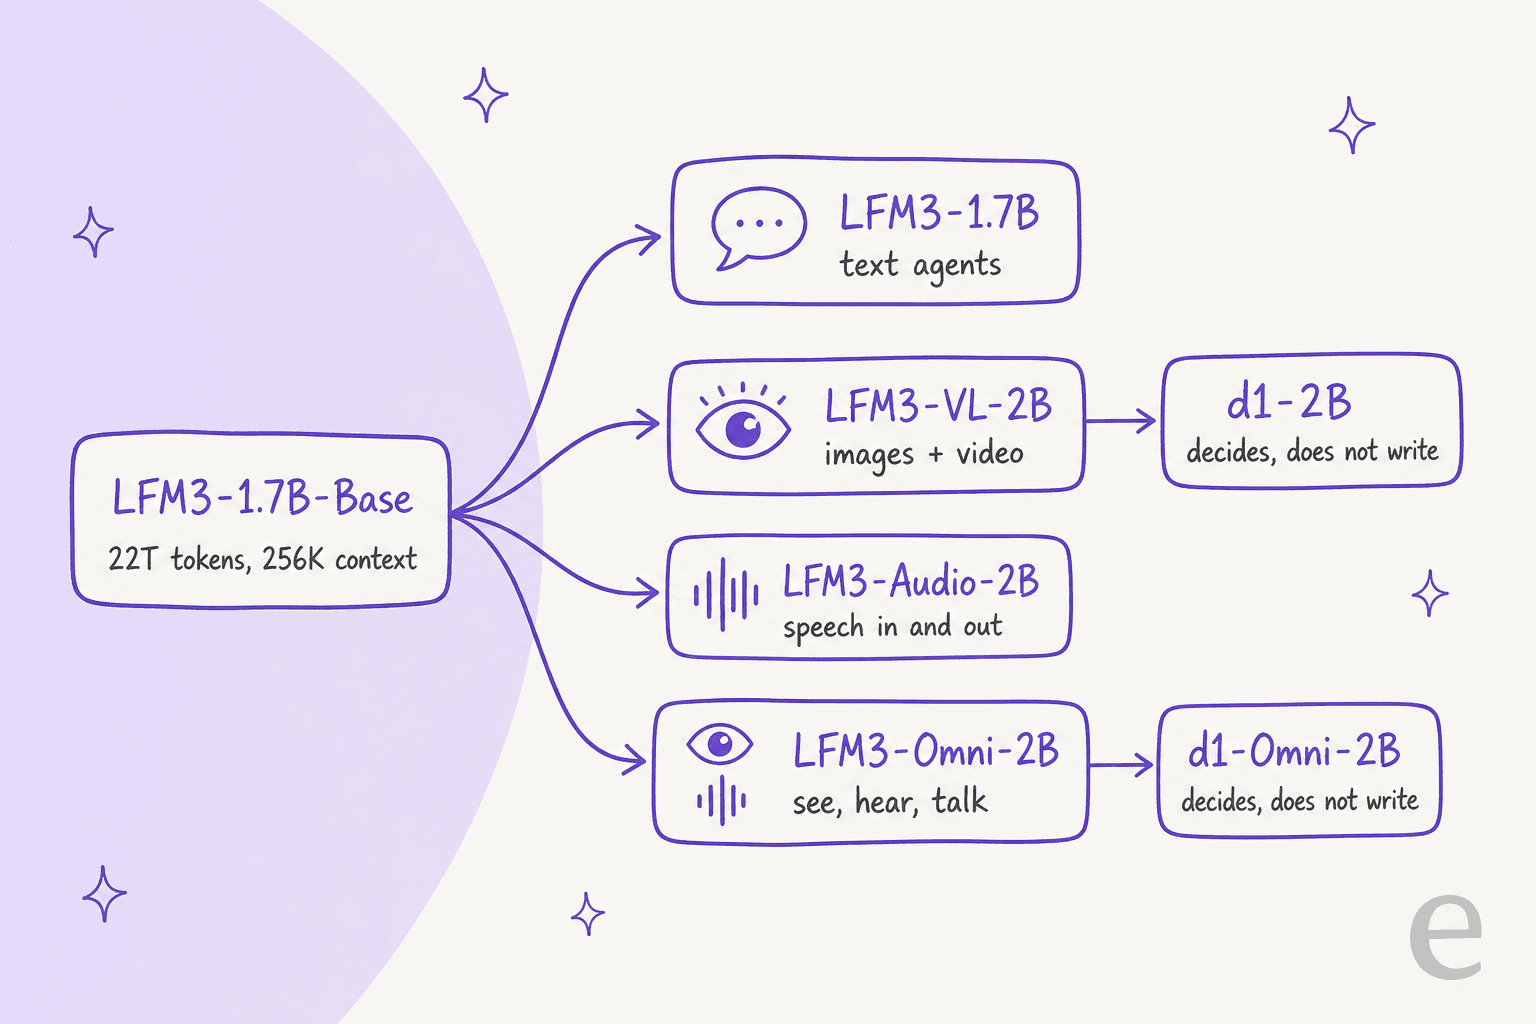
Todos os seis modelos pós-treinados derivam de uma única base, o LFM3-1.7B-Base, que foi pré-treinado com 22 trilhões de tokens e tem uma janela de contexto de 256K tokens. Em vez de um grande modelo geral, a proposta da Liquid é que você escolha o modelo pequeno adequado à tarefa, faça o ajuste fino com seus próprios dados e o execute no dispositivo.
Os modelos LFM3 em resumo
Aqui está o primeiro lançamento completo, com os números de cada ficha de modelo no Hugging Face:
| Modelo | O que faz | Parâmetros | Contexto |
|---|---|---|---|
| LFM3-1.7B | Texto, chamadas de ferramentas, agentes locais | 1.73B | 256K |
| LFM3-VL-2B | Recebe imagens e vídeos, gera texto, com raciocínio passo a passo | 1.92B | 128K |
| LFM3-Audio-2B | Reconhecimento de fala, saída de fala, tradução de fala | 2B | 32K |
| LFM3-Omni-2B | Recebe texto, imagem, vídeo e áudio; gera texto e fala | 2.17B | 32K |
| d1-2B | Decisões sobre texto e imagens, sem gerar texto | 1.92B | 128K |
| d1-Omni-2B | Decisões sobre texto, imagens e áudio | 2B | Não informado |
O modelo de texto entende 16 idiomas, incluindo inglês, árabe, chinês, japonês, hindi e polonês, segundo sua ficha de modelo, algo que importa quando você oferece suporte multilíngue. O modelo omni fala em 19 idiomas e variantes regionais.
O que mudou na arquitetura do LFM3?
O LFM2 provou que uma combinação de convoluções curtas e atenção poderia rodar rapidamente em um celular. O LFM3 mantém essa ideia e acrescenta um terceiro ingrediente. Das suas 24 camadas, o que vale destacar aqui é que 13 são convoluções curtas com gating, enquanto 5 são de atenção com janela deslizante de 256 tokens e 6 são de atenção global. A Liquid chama isso de "tri-hybrid."
O ponto principal da reformulação é o contexto longo. A publicação de lançamento diz que o LFM3-1.7B se iguala ao LFM2-1.2B em prompts curtos em dispositivos de borda, por parâmetro, e é cerca de 25% mais rápido com 8K tokens no contexto. A Liquid chegou ao projeto por meio de uma busca com hardware no ciclo, abrangendo 14 combinações de dispositivo e backend, desde um Samsung Galaxy S26 Ultra e um Raspberry Pi 5 até notebooks Apple M4 Max e a NPU Qualcomm Hexagon.
Desta vez, o treinamento deu mais peso ao trabalho de agentes. Os últimos 3.5 trilhões de tokens de pré-treinamento eram dados selecionados com "a larger share of agentic traces and diverse tool calls," e o modelo de texto passou então por quatro etapas de pós-treinamento: ajuste fino supervisionado com 1.75 trilhão de tokens, aprendizado por reforço misto, destilação a partir de seis modelos professores especializados e aprendizado por reforço para agentes dentro de ambientes reais de execução de agentes, como OpenClaw e Hermes Agent.
Como o LFM3-1.7B se sai nos benchmarks?
Na tabela da própria Liquid AI, o LFM3-1.7B supera modelos muito maiores em tarefas de agentes e de cumprimento de instruções, mas perde em programação e conhecimento. Sua média em 29 benchmarks é 49.37, contra 47.24 do Qwen3.5-9B, 39.27 do Qwen3.5-4B, 39.19 do MiniCPM5 2B e 31.74 do Gemma 4 E4B.
Aqui está um recorte dos resultados publicados:
| Benchmark | LFM3-1.7B | MiniCPM5 2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| AutomationBench (público) | 41.29 | 4.71 | 1.92 | 8.67 | 15.10 |
| WebArena-Verified | 38.42 | 9.11 | 17.06 | 21.92 | 28.94 |
| BFCL V4 (chamadas de ferramentas) | 71.39 | 62.65 | 48.25 | 55.12 | 62.83 |
| τ³-bench | 68.01 | 69.44 | 33.53 | 65.98 | 67.11 |
| IFBench | 73.03 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified (OpenCode) | 43.40 | 34.80 | 0.50 | 41.20 | 51.20 |
| GPQA Diamond | 63.37 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 37.96 | 18.82 | 84.63 | 87.11 |
| Média (29 benchmarks) | 49.37 | 39.19 | 31.74 | 39.27 | 47.24 |
A linha do τ³-bench é a primeira que eu olharia se você trabalha com suporte, porque o τ-bench simula um agente ajudando clientes em conversas de várias interações, com ferramentas e políticas. O LFM3-1.7B marca 68.01, praticamente no mesmo nível dos 67.11 do Qwen3.5-9B e logo atrás dos 69.44 do MiniCPM5 2B. É um resultado forte para seu tamanho, o que é bom, mas não é a vantagem disparada que você vê no AutomationBench. (Para comparar modelos hospedados maiores no trabalho de suporte, mantenho uma seleção atualizada do melhor modelo de IA para tickets de suporte.)
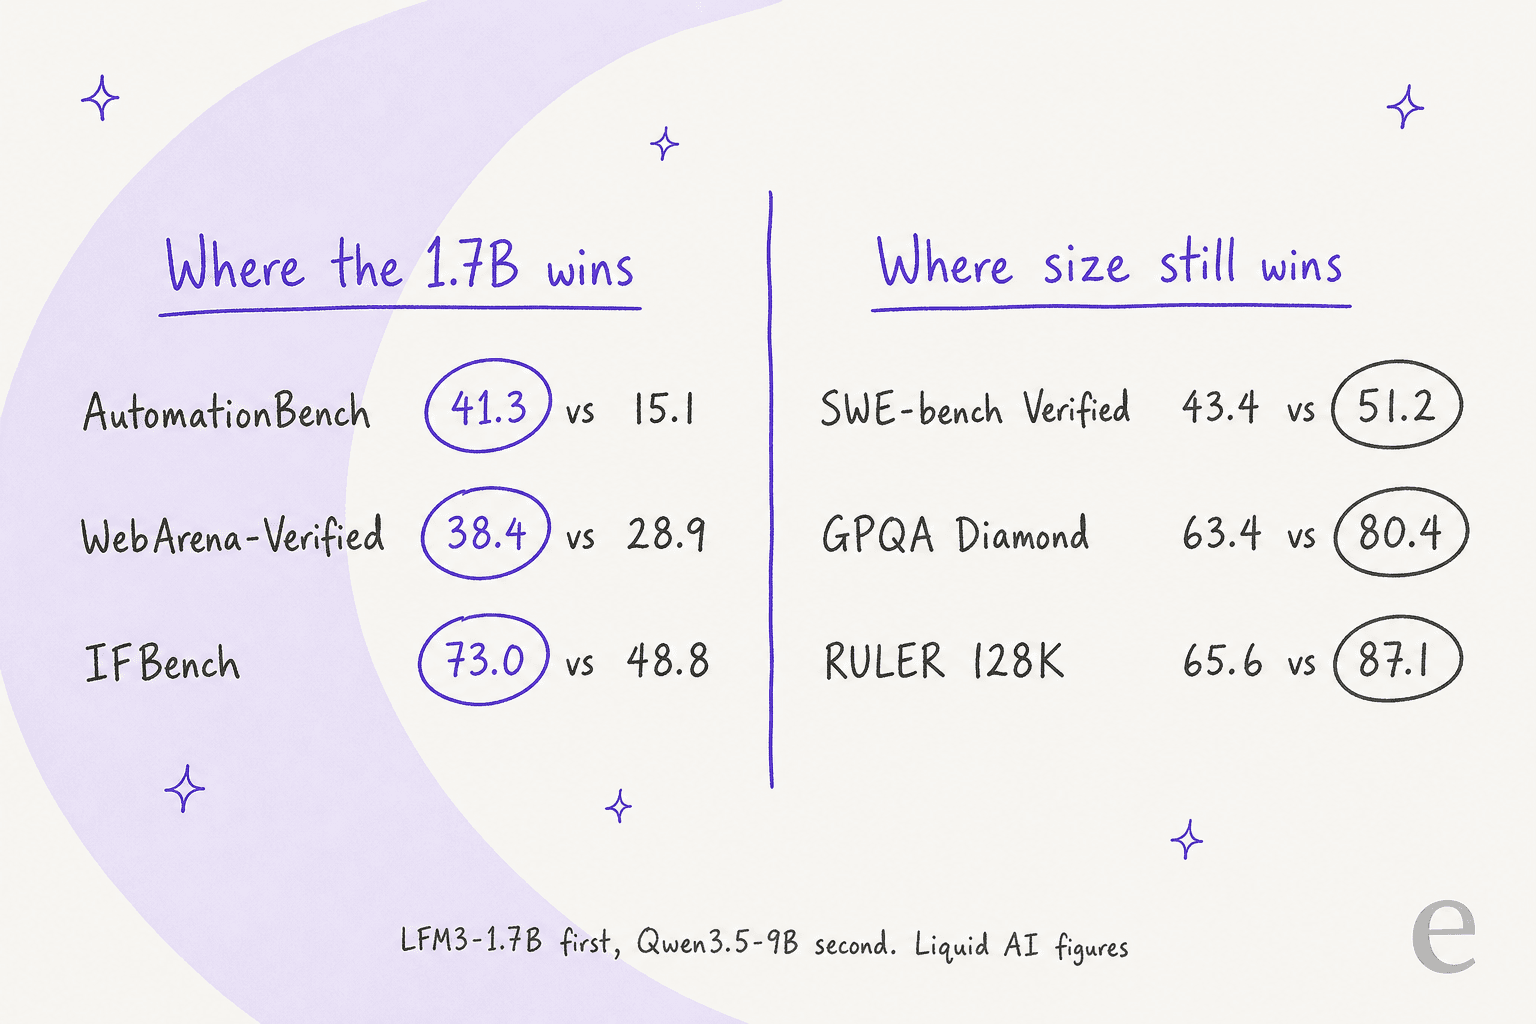
Essa diferença é o ponto principal. O LFM3-1.7B é bom em seguir instruções e chamar ferramentas, mas fraco quando o conhecimento puro ou a recuperação de informações em contextos longos determina a pontuação. A Liquid diz o mesmo: a busca "helps close the knowledge gap," quase dobrando sua pontuação no Humanity's Last Exam de 7.17 para 13.90 quando ferramentas são permitidas. Um leitor na discussão de lançamento resumiu a tabela assim:
"Agentic coding numbers on par with Qwen3.5-4B, the rest of the numbers on par with Qwen3.5-9B. Most impressive for a 1.7B model!"

Mais um número que vale conhecer: no AA-Omniscience, um teste que recompensa dizer "não sei" em vez de adivinhar, o LFM3-1.7B marcou 92.93 em não alucinação, contra 13.64 do Qwen3.5-4B. Sua precisão no mesmo teste foi de apenas 7.07, então ele chega a esse resultado principalmente por se recusar a responder. Para um modelo que já foi feito para consultar uma busca ou uma base de conhecimento, esse é o instinto certo, e é o mesmo hábito que você quer ao evitar alucinações de IA no suporte.
Qual é a velocidade do LFM3 em um celular ou notebook?
Muito alta para sua categoria. A Liquid testou com llama.cpp em Q4_0 e um contexto de 32K tokens, e o LFM3-1.7B foi o modelo mais rápido nos três dispositivos, decodificando de 1.8 a 2.8 vezes mais rápido que o segundo colocado, além de usar menos memória.
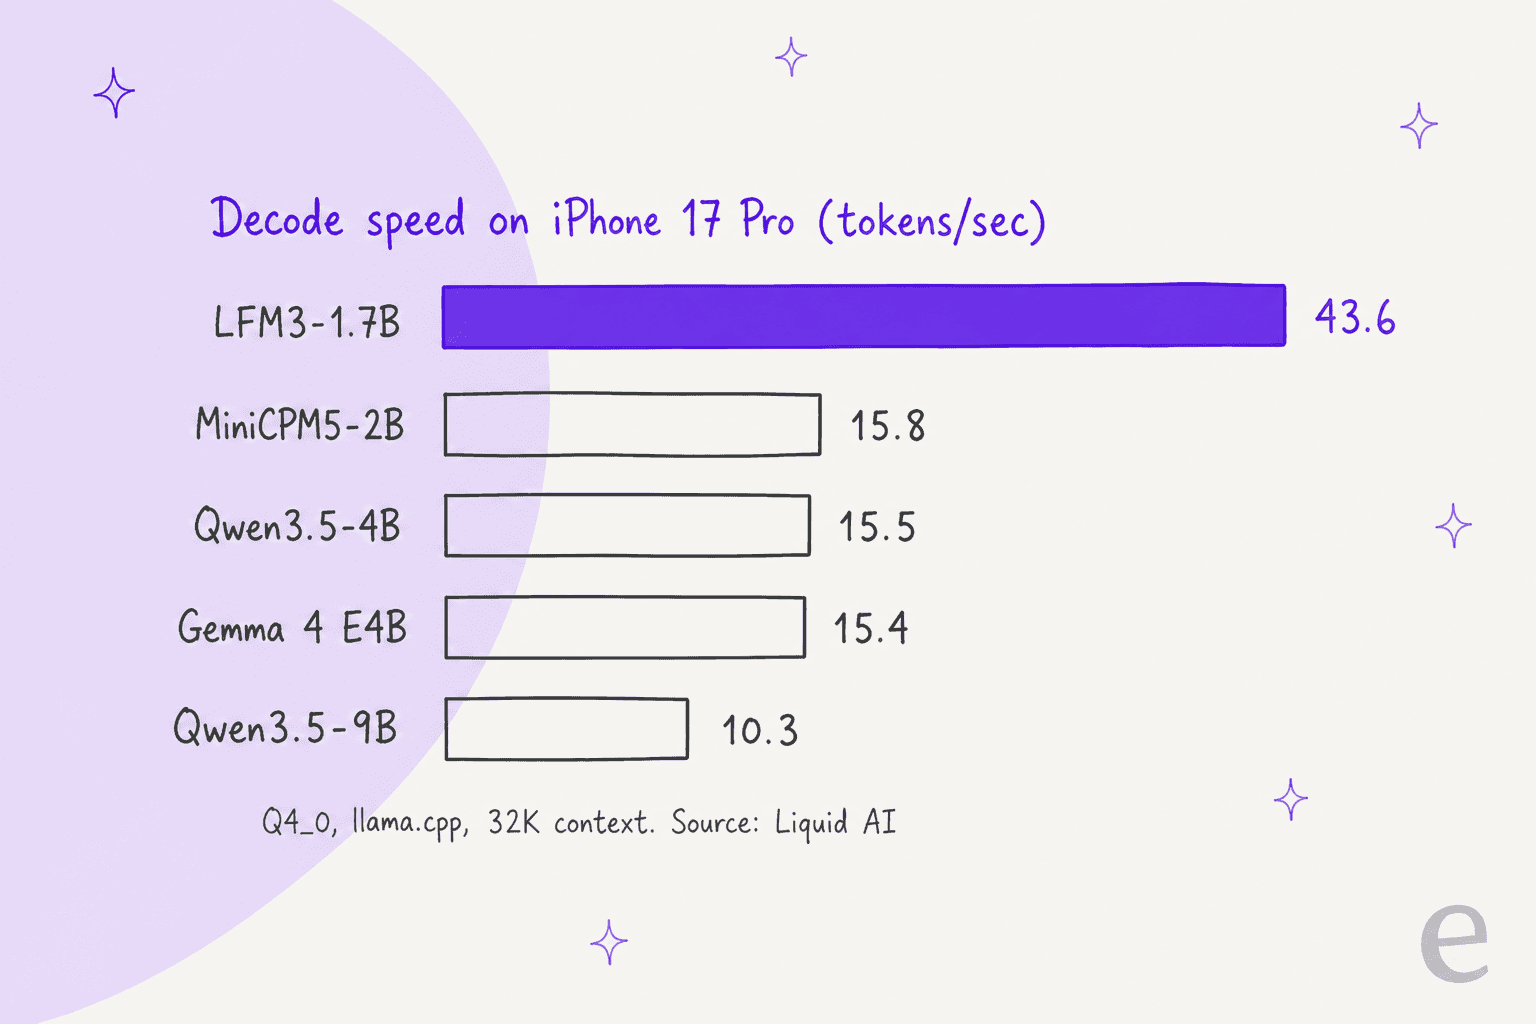
| Dispositivo | Decodificação do LFM3-1.7B | Segundo mais rápido | Memória do LFM3-1.7B |
|---|---|---|---|
| iPhone 17 Pro | 43.6 tok/s | 15.8 (MiniCPM5-2B) | 1.90 GB |
| Apple M5 Max | 237.1 tok/s | 106.0 (MiniCPM5-2B) | 2.25 GB |
| AMD Ryzen AI Max+ 395 | 129.6 tok/s | 70.1 (MiniCPM5-2B) | 2.75 GB |
O contexto longo também continua econômico. Um contexto completo de 128K tokens precisa de 1.6 GB de cache KV, a memória que um modelo usa para armazenar a conversa até aquele momento, contra 4.3 GB do Qwen3.5-4B e 5.6 GB do MiniCPM5-2B. Compare isso com um modelo denso de porte médio como o Nanbeige 4.3, que precisa de cerca de 28 GB de cache para o mesmo tamanho de contexto.
Nos servidores, os números ficam um pouco absurdos. Em uma NVIDIA B300 com 1.024 solicitações simultâneas, o LFM3-1.7B produziu 41,710 tokens de saída por segundo, o que a Liquid arredonda para 3,6 bilhões de tokens por dia. Para demonstrar isso, a Liquid executou mais de 300.000 agentes LFM3-1.7B em paralelo sobre o arquivo de e-mails da Enron. Em sua própria infraestrutura de inferência de baixa latência, a latência p95 para uma solicitação curta se manteve em 150 ms, mesmo com 500 solicitações por segundo em uma B200.
O que os modelos de visão, áudio e omni podem fazer?
Os outros modelos da família são onde o LFM3 se torna incomum para um lançamento de 2B. Cada um é pequeno o suficiente para rodar em um celular, e cada um atende a uma tarefa que normalmente exige um modelo maior na nuvem.
LFM3-VL-2B é o primeiro modelo de visão da Liquid que aceita vídeo e raciocina passo a passo antes de responder. Em 62 benchmarks de visão, sua média é 71.4, à frente do Gemini 3.5 Flash Lite (70.0) e no mesmo nível do Gemma 4 12B (71.7), um modelo mais de seis vezes maior. Ele fica a dois pontos do GPT-5.6 Luna (73.4). Suas maiores pontuações são em leitura de documentos, OCR e gráficos (83.9) e compreensão de interfaces gráficas (83.1).
LFM3-Audio-2B transcreve, fala e traduz fala, com um novo codificador de áudio em streaming que começa a processar enquanto você ainda está falando. A Liquid diz que o tempo até o primeiro token pode ser de apenas 50 ms.
LFM3-Omni-2B é o primeiro modelo da Liquid que vê, ouve e fala em um só: você pode fazer uma pergunta falada sobre uma imagem e receber uma resposta falada, ou perguntar sobre um vídeo com som. Ele também pode transformar uma solicitação falada junto com o que está na tela diretamente em uma chamada estruturada de ferramenta. Na demonstração da Liquid, ele reserva um voo por voz em um notebook. Se você está avaliando ferramentas de voz para uma linha de suporte, minha seleção dos melhores agentes de voz de IA cobre as opções hospedadas, e este guia de agente de voz de IA para suporte explica a configuração.
Para que servem os modelos de decisão d1?
Esta é a parte do LFM3 à qual eu prestaria mais atenção se você gerencia uma equipe de suporte. O d1-2B e o d1-Omni-2B não escrevem nada. Você fornece uma entrada e uma lista de perguntas, e eles respondem a todas em uma única passagem de inferência, cada uma com uma probabilidade calibrada. A Liquid lista "a support ticket, an invoice, an app screen, a photo, a voice note" como entradas típicas.
A ficha do modelo d1-2B usa um ticket de suporte como exemplo principal: um cliente cobrado duas vezes cuja encomenda nunca chegou. Em uma única passagem, o modelo escolhe uma equipe (cobrança, entrega ou técnica) e diz se cabe um reembolso, depois também lista os assuntos e atribui uma pontuação de urgência. A Liquid informa 5.7 ms por decisão em uma H100. Esse é exatamente o formato do trabalho de triagem de tickets, por isso acho que este é o modelo mais prático do lançamento para equipes de helpdesk. Abordei a categoria mais ampla no meu artigo explicativo sobre modelos de decisão.
A novidade nesta geração são as respostas tipadas. Além de sim/não, múltipla escolha e pontuações, os modelos d1 podem:
- Apontar: desenhar uma caixa ao redor de algo que você descreve ou contar todas as ocorrências.
- Ler: extrair texto, números e datas de um documento com o trecho exato ou dizer "não encontrado".
- Estimar: fornecer um número com um intervalo provável.
- Selecionar: selecionar todas as opções aplicáveis, cada uma com sua própria probabilidade.
O d1-2B substitui o antigo d1-3B com um terço a menos de parâmetros. No teste "Typed Decisions (customer service cases)" da Liquid, o d1-Omni-2B marcou 50.5 com entrada escrita e 48.0 quando as mesmas perguntas foram faladas, além de 83.4 no DecisionBench, um teste de encaminhamento e triagem empresarial. Esses são benchmarks da própria Liquid, então trate-os como um ponto de partida para seus próprios testes. Se você quiser primeiro a versão manual do mesmo trabalho, veja como automatizar a triagem de tickets com regras. Um engenheiro da Liquid na discussão de lançamento explicou de forma direta o argumento sobre hardware:
"If you want to do local classification/image processing, I think the d1-2B is amazing, it can run on 1GB of unified RAM."
A ficha também é honesta sobre os limites: perguntas que exigem muito conhecimento favorecem modelos maiores, e as respostas ficam menos confiáveis acima de cerca de 64K tokens de entrada.
Quanto custa o LFM3?
Os pesos são gratuitos para a maioria das empresas, e ainda não há um preço de API publicado. Veja o que consta na página de preços da Liquid e em sua licença em 28 de outubro de 2026:
| Opção | Preço | Observações |
|---|---|---|
| Pesos abertos, empresa com receita abaixo de US$ 10 milhões | Gratuito | LFM Open License v1.0, baseada na Apache 2.0 |
| Pesos abertos, empresa com receita de US$ 10 milhões+ | Licença paga, somente sob consulta | Entre em contato com o setor de vendas da Liquid; a receita considera todo o grupo empresarial |
| Pesquisa e organizações sem fins lucrativos qualificadas | Gratuito | Sem limite de receita |
| Liquid API, modelos LFM3 | Não publicado | Ainda não consta na página de preços |
| Liquid API, d1 | US$ 0,02 por 1M de tokens de entrada, US$ 0 de saída | d1 antigo, não o d1-2B baseado no LFM3 |
| Liquid API, LFM2.5-24B-A2B | US$ 0,05 de entrada / US$ 0,70 de saída por 1M de tokens | Modelo hospedado maior da Liquid |
| Nova conta no Liquid Console | US$ 2 de crédito grátis | Por organização |
Dois detalhes importam mais do que os preços. Primeiro, o limite de receita de US$ 10 milhões considera todo o seu grupo empresarial, não o produto, e o número de usuários não importa. Segundo, a licença não tem copyleft, então você pode manter uma versão com ajuste fino privada, desde que inclua a atribuição e uma cópia da licença ao redistribuí-la.
O OpenRouter é citado como parceiro desde o dia 0 do lançamento, mas em 28 de outubro sua página da Liquid listava apenas modelos antigos da Liquid e o d1.1, ainda sem nenhum modelo LFM3. Se você quer um modelo hospedado com uma tabela pública de preços hoje, a comparação é com os preços do GPT-6 Luna. O Gemini 3.5 Flash Lite é a outra opção barata.
Como executar o LFM3?
Você baixa o modelo do Hugging Face e o executa localmente, ou primeiro experimenta no playground da Liquid pelo navegador. A coleção LFM3 tem cada modelo em BF16, GGUF, MLX de 4 bits e ONNX, com versões FP8 e NVFP4 para servidores.
O caminho local mais rápido é o llama.cpp. A documentação do LFM3-1.7B fornece este comando, com as configurações recomendadas pela Liquid:
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF --temp 0.1 --top-k 50 --repeat-penalty 1.1
Algumas coisas para saber antes de começar:
- Você precisa de uma versão recente. A ficha GGUF diz que você precisa de uma versão do llama.cpp compatível com LFM3. O arquivo Q4_0 tem
1.05 GBe o Q8_0 tem1.85 GB. - vLLM e SGLang funcionam para servir o modelo. Os benchmarks de GPU da própria Liquid usaram SGLang 0.5.22 com suporte ao LFM3.
- O raciocínio vem ativado por padrão. O template de chat abre um bloco
<think>, e a ficha alerta que desativá-lo pode gerar inconsistências. - As chamadas de ferramentas mudaram de formato. O LFM3 usa um formato XML que é um superconjunto do formato do Qwen3-Coder, não o formato personalizado do LFM2, então os parsers antigos precisam de atualização.
- O ajuste fino é barato. A Liquid tem notebooks TRL para SFT, DPO e GRPO no LFM3-1.7B. Sua demonstração de inspeção de turbinas eólicas fez o ajuste fino do LFM3-VL-2B com cerca de 3.000 fotos em algumas horas em uma A100. (Para conteúdo de suporte, RAG vs. ajuste fino é a dúvida mais comum.)
Se você preferir experimentar antes de baixar, o Liquid Playground tem LFM3-1.7B, LFM3-VL-2B, LFM3 Omni 2B e LFM3 Audio 2B em um seletor de modelos.
O que os primeiros usuários estão dizendo sobre o LFM3?
Ele tem apenas um dia, então os relatos de uso prático são escassos e vêm principalmente da discussão de lançamento no Hacker News, que chegou a 101 pontos e 36 comentários. As primeiras observações são uma checagem de realidade útil para a tabela de benchmarks.
Um leitor percebeu um erro factual básico no playground e atribuiu o problema à quantização:
"when asked “what does a cow say?”, LFM3-1.7B said that a cow can say “Oink”... I assume this is lower quant problem, though: Q8 versions I’ve played with through llama both give the correct “moo” answer."
Outro percebeu o treinamento intenso de uso de ferramentas aparecendo onde não havia sido solicitado, em uma pergunta de conhecimentos gerais sem prompt de sistema:
"I am seeing the following in the reasoning trace: > However, the instructions say I must use available tools when answering questions."
As ferramentas também apresentavam dificuldades em alguns pontos no primeiro dia. Um leitor não conseguiu carregar as versões MLX no LM Studio nem em outros dois executores MLX. O comentário mais relevante para o trabalho de suporte veio de alguém que usa a geração anterior para fazer a triagem de mensagens recebidas:
"The LFM annotations are basically triage... Right now LFM 2.6 gets trustworthy annotations on just over 40% of data points."
Esse é um retrato realista de um modelo pequeno em produção: ele cuida da etapa fácil, e um modelo maior ou uma pessoa cuida do restante. É a mesma divisão que eu usaria para classificação de tickets com IA.
Onde o LFM3 deixa a desejar?
Os limites, apresentados com franqueza, estão principalmente nas letras miúdas da própria Liquid:
- Não é indicado para programação com agentes ou raciocínio difícil. A ficha do LFM3-1.7B diz que ele é "not recommended for agentic coding or complex multi-step reasoning," e sugere recuperação de informações ou busca para tarefas que exigem muito conhecimento. A ficha do modelo de visão acrescenta conversas de várias interações a essa lista.
- Todos os números são divulgados pelo fornecedor. A Artificial Analysis ainda não havia listado o LFM3 em 28 de outubro, então ainda não há uma pontuação independente.
- A licença não é Apache 2.0. É parecida, mas o limite de receita de US$ 10 milhões significa que empresas maiores precisam de um acordo pago antes de disponibilizá-lo.
- Contexto curto nos modelos de voz. O LFM3-Audio-2B e o LFM3-Omni-2B têm janelas de 32K tokens, um oitavo da janela do modelo de texto.
- As ferramentas ainda estão se adaptando. A ficha de visão lista o suporte ao llama.cpp como em revisão, sem vídeo, e o suporte ao vLLM como em andamento.
Você deve usar o LFM3?
Depende do que você está desenvolvendo:
- Assistentes no dispositivo e agentes locais: sim, experimente primeiro o LFM3-1.7B. Nenhum outro modelo comparado pela Liquid roda tão rápido usando tão pouca memória, e ele foi treinado em ambientes reais de execução de agentes. Ele merece estar em qualquer lista de agentes de IA de código aberto para testar.
- Classificação, encaminhamento e extração em escala: veja o d1-2B. Uma passagem, muitas perguntas, milissegundos por decisão e cerca de 1 GB de RAM. Ele se encaixa naturalmente no encaminhamento de tickets e na aplicação de tags.
- Aplicativos de voz e câmera: o LFM3-Omni-2B é um raro modelo pequeno que ouve e fala. Fique atento ao contexto de 32K.
- Agentes de programação: não. A própria Liquid diz isso, e modelos como o Nanbeige 4.3 ou a dupla Nemotron 3.5 Bolt são pontos de partida melhores.
- Um agente de atendimento ao cliente: o LFM3 é um motor potente para partes do trabalho, especialmente a triagem, mas não é um agente por si só. A próxima seção trata do que falta.
Executando modelos pequenos em uma fila real de suporte
Um modelo como o d1-2B pode dizer que um ticket é sobre cobrança e é urgente. Para realmente ajudar, algo ainda precisa estar dentro do seu helpdesk, ler o ticket quando ele chega, consultar sua central de ajuda e tickets anteriores, registrar a tag no ticket, preparar o rascunho da resposta e saber quais tickets uma pessoa deve assumir. Esse é o trabalho para o qual o colega de equipe de IA para helpdesk da eesel foi criado, um dos colegas de equipe de IA prontos para trabalhar que você contrata para uma função específica, em vez de um modelo que precisa integrar.

A Dokument 24, uma empresa dinamarquesa de documentos jurídicos online, é um bom exemplo de triagem na prática. Entre 8 de agosto e 8 de setembro de 2026, a eesel preparou cerca de 680 tickets do Zendesk, aplicou tags a cerca de 430 deles por produto (testamento, acordo pré-nupcial, procuração futura ou constituição de empresa) e deixou cerca de 670 rascunhos de respostas em dinamarquês como notas internas para a equipe enviar. Ela responde com base em cerca de 2.600 páginas da web e itens do Zendesk. A Qontro, uma empresa de software ERP em Auckland, gera um rascunho para cada ticket do Freshdesk, mas indisponibilidades, perda de dados, migrações e cobrança vão direto para uma pessoa. Essas regras de encaminhamento são a parte que um benchmark nunca testa, e também são o que determina o custo por ticket real.
Antes de entrar em operação, a eesel testa sua configuração com seus tickets anteriores para que você veja as respostas antes que um cliente as veja. Escrevi separadamente sobre como esses testes funcionam. E, se você gosta de trabalhar pelo terminal como faria com um modelo local, a eesel CLI permite que você, um script ou um agente de programação como o Claude Code conecte integrações, edite as instruções permanentes do agente, aprove ou negue suas ações pendentes e leia seu registro de atividades, tudo em JSON.
Experimente a eesel
O LFM3 é um motor rápido e barato para agentes no dispositivo e decisões em uma única passagem, como encaminhar um ticket. Se o que você precisa é de tickets com tags, encaminhamento e rascunhos na sua configuração do Zendesk AI ou do Freshdesk ainda nesta semana, o colega de equipe de IA para helpdesk da eesel entra no seu helpdesk em minutos, aprende com seus tickets anteriores e sua central de ajuda e trabalha dentro das regras que você define. Você pode começar gratuitamente com 100 créditos e sem cartão, para testar em tickets reais antes de decidir. Experimente a eesel.
Perguntas frequentes
O que é LFM3?
LFM3 é a terceira geração dos Liquid Foundation Models da Liquid AI, lançada em 27 de outubro de 2026. O primeiro lançamento traz seis modelos de pesos abertos com cerca de 2B parâmetros cada, todos construídos sobre uma única base chamada LFM3-1.7B-Base: um modelo de texto, um modelo de visão, um modelo de áudio, um modelo omni e dois modelos de decisão. Eles fazem parte do mesmo grupo de modelos de linguagem pequenos que o MiniCPM5 2B e as versões menores do Gemma 4.
O LFM3 é gratuito?
Os pesos podem ser baixados gratuitamente no Hugging Face sob a LFM Open License v1.0, que se baseia na Apache 2.0. O uso comercial só é gratuito enquanto seu grupo empresarial tiver receita anual inferior a US$ 10 milhões; acima disso, você precisa de uma licença paga da Liquid AI. O uso em pesquisa e por organizações sem fins lucrativos qualificadas não tem limite de receita. Compare isso com modelos totalmente sob Apache 2.0, como o Nanbeige 4.3.
Quanto custa a API do LFM3?
A Liquid AI ainda não publicou um preço por token para nenhum modelo LFM3. Sua página de preços lista apenas d1 (US$ 0,02 por milhão de tokens de entrada, US$ 0 de saída), d1-ultra (US$ 0,042 / US$ 0) e LFM2.5-24B-A2B (US$ 0,05 / US$ 0,70), e novas organizações recebem US$ 2 de crédito gratuito. O LFM3 também ainda não está no OpenRouter. Para ter uma referência dos preços de modelos hospedados, veja os preços do GPT-6 Luna.
De quanta memória o LFM3-1.7B precisa?
Cerca de 1 GB em 4 bits. O arquivo GGUF Q4_0 tem 1.05 GB e o Q8_0 tem 1.85 GB. Nos testes da Liquid AI, ele usou 1.90 GB em um iPhone 17 Pro com contexto de 32K, e um contexto completo de 128K precisa de 1.6 GB de cache KV, contra 4.3 GB do Qwen3.5-4B. Por isso, ele é um dos poucos modelos pequenos que rodam em um celular com contexto longo.
O LFM3-1.7B é melhor que o Qwen3.5?
Na tabela da própria Liquid AI, o LFM3-1.7B tem média de 49.37 em 29 benchmarks, contra 47.24 do Qwen3.5-9B, um modelo cerca de cinco vezes maior. Ele vence com folga em automação empresarial e tarefas no navegador (AutomationBench 41.29 contra 15.10) e perde em programação e conhecimento (GPQA Diamond 63.37 contra 80.40). Esses números são do fornecedor, não de testes independentes. Veja a visão geral do Qwen para conhecer o outro lado.
O LFM3 pode ser usado para triagem de tickets de suporte ao cliente?
O modelo de decisão d1-2B é o mais adequado. A ficha do modelo mostra como ele encaminha um ticket para cobrança, envio ou suporte técnico, sinaliza reembolsos e atribui uma pontuação de urgência em uma única passagem. Você ainda precisaria conectá-lo ao seu helpdesk e testá-lo com seus próprios tickets. Para opções prontas, veja as melhores IAs para triagem de tickets de suporte.
O que são os modelos de decisão LFM3 d1?
d1-2B e d1-Omni-2B são modelos que não escrevem texto. Você fornece uma entrada, como um ticket, uma fatura, uma foto ou uma mensagem de voz, junto com uma lista de perguntas, e eles respondem a todas em uma única passagem, com uma probabilidade para cada resposta. O d1-2B lida com texto e imagens, e o d1-Omni-2B acrescenta áudio. Leia mais sobre modelos de decisão.