

O que é um modelo de decisão?
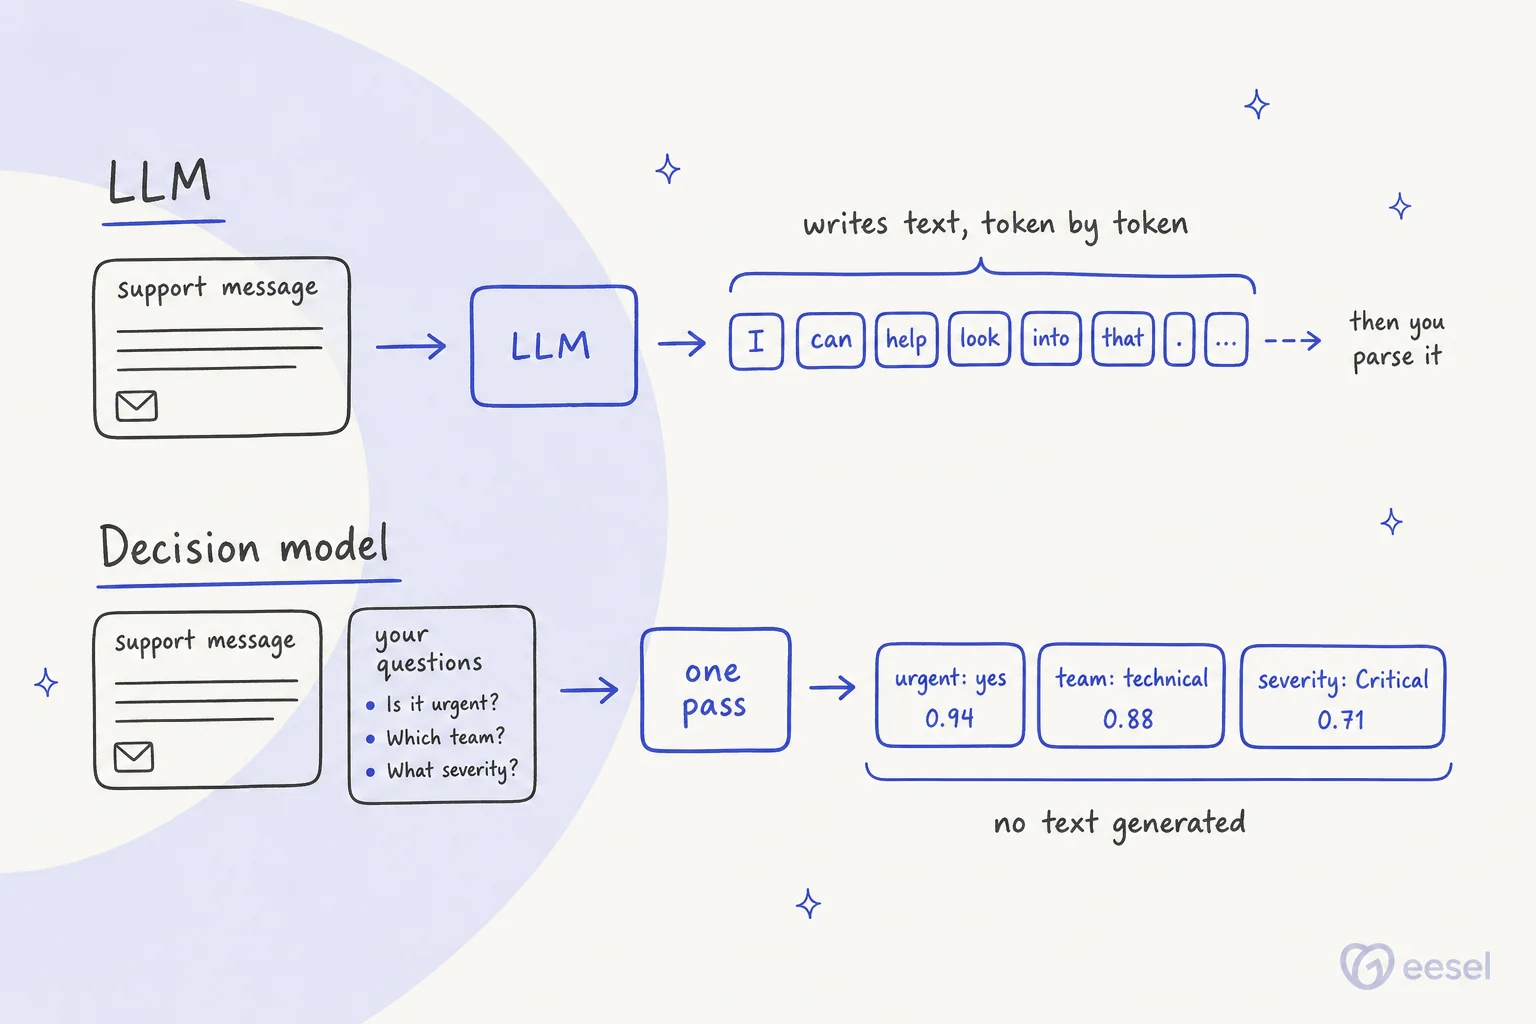
Um modelo de decisão recebe duas coisas: um estado (a entrada bruta, como um e-mail de suporte, um bloco JSON ou uma captura de tela) e um conjunto de perguntas tipadas sobre esse estado. Ele devolve uma resposta tipada por pergunta, cada uma com uma probabilidade. Sem parágrafo, sem JSON para interpretar, sem "Claro! Aqui está a minha análise."
A documentação da TypeSafe descreve bem o problema que resolve: quando você pede a um LLM um julgamento que seu código vai consumir, "você está forçando um sistema de geração de texto a produzir decisões estruturadas e depois interpretando os resultados de volta". Um modelo de decisão dispensa o texto por completo.
Quase todos os modelos da categoria adotaram os mesmos três tipos de pergunta, que a TypeSafe chama de primitivas:
| Tipo de pergunta | O que pergunta | O que volta | Exemplo no suporte |
|---|---|---|---|
| Noul | Esta afirmação é verdadeira? | Uma probabilidade, de 0 a 1 | "Esta solicitação é urgente?" |
| Choice | Qual opção se encaixa? | A escolha, uma probabilidade por opção, uma confiança | "Faturamento, técnico ou vendas?" |
| Score | Onde fica nesta escala? | Um nível, uma probabilidade por nível, uma confiança | "Sem impacto, menor, maior ou crítico?" |
Você pode misturar os três em uma única solicitação, e cada pergunta é avaliada em paralelo sobre o mesmo estado. A TypeSafe diz que "adicionar perguntas quase não muda o tempo de resposta", e o README do Strands Decider diz o mesmo: o texto é lido uma vez e "cada pergunta acrescenta apenas os seus próprios tokens".
Veja como isso funciona na prática, com o exemplo de lançamento da própria Cloudflare. Uma chamada faz três perguntas sobre uma única mensagem de suporte:
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/run/@cf/cloudflare/clef \
  -X POST \
  -H "Authorization: Bearer $CLOUDFLARE_AUTH_TOKEN" \
  -d '{
    "model": "clef",
    "state": "Checkout has been failing for every customer for the last hour.",
    "questions": {
      "urgent": { "type": "noul", "instructions": "Is this support request urgent?" },
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds",
          "technical": "Outages, errors, and configuration",
          "sales": "Plans and upgrades"
        }
      },
      "severity": {
        "type": "score",
        "instructions": "How severe is the customer impact?",
        "criteria": ["No impact", "Minor", "Major", "Critical"]
      }
    }
  }'
Se você já fez triagem de tickets manualmente, essa solicitação vai parecer familiar. São urgência, equipe e gravidade, os mesmos três campos que um triador humano preenche, e a mesma divisão por trás de urgência e impacto na maioria dos helpdesks.
Como um modelo de decisão funciona por dentro?
Esta é a parte que acho mais interessante, porque o truque é mais simples do que o marketing sugere.
A maioria dos modelos de decisão abertos parte de um LLM aberto comum (geralmente uma base Qwen ou Gemma) e muda a forma como ele responde. O post de lançamento da Cloudflare descreve o Clef executando "uma passada apenas de prefill e depois pontuando em paralelo as opções válidas do esquema". A Strands removeu completamente a cabeça do modelo de linguagem, então o Strands Decider 2B fisicamente não consegue gerar texto, e seu blog de lançamento diz que a cabeça de pontuação que ela adicionou tem "pouco mais de um milhão de parâmetros no total".
Em termos simples, acontecem três coisas:
- O modelo lê o estado e as perguntas uma vez. É a etapa de "prefill" que todo LLM faz antes de escrever. Os modelos de decisão param aí.
- Uma cabeça pequena pontua cada resposta permitida. Em vez de gerar "technical" letra por letra, ela pontua faturamento, técnico e vendas em relação ao que acabou de ler, tudo de uma vez.
- As pontuações são treinadas para serem honestas. A TypeSafe chama seu método de treinamento de Reinforcement Learning for Calibrated Decisions (RLCD). A Cloudflare criou sua própria versão do RLCD para o Clef e a combina com uma perda de Brier, uma penalidade padrão para probabilidades excessivamente confiantes (Cloudflare).
Essa terceira etapa é o produto de verdade. Uma confiança de 0.9 só é útil se as respostas em 0.9 estiverem certas cerca de 90% das vezes. A Strands relata que, em tarefas curtas de classificação inéditas, "respostas com confiança de 0.9 ou mais estão certas cerca de 95% das vezes". É por isso que os modelos de decisão são apresentados como adequados para a priorização de tickets e outras decisões em que você quer um limite seguro. Essa é a propriedade que permite escrever if confidence > 0.9: auto-route, else: send to a human.
Como nada é gerado, o custo de saída cai para zero ou quase. Compare com a chamada de funções em um LLM, em que cada chave e cada aspas é um token de saída cobrado. O mesmo vale para o modo JSON. O Jev não cobra nada pela saída, e o Clef não lista nenhum preço de saída. É por isso que a página inicial do Jev insiste tanto no enfoque "mais parecido com código": uma solicitação, uma resposta tipada, sempre.
Modelos de decisão vs LLMs vs classificadores clássicos
A crítica mais barulhenta no Hacker News é que isso é só um classificador com uma nova marca. Um comentarista resumiu como "modelo de decisão = classificador". Eles não estão errados quanto à matemática. Onde erram é no que mudou para quem coloca isso em produção.
"LLM as judges - generalized, but too slow. ... traditional classifiers, very specific 1 trick pony, super fast and cheap once built. ... decision models/jev - are generic, you can throw them at most generic classification problems, and they are good enough."

Essa é a versão honesta. Veja como as três opções se comparam em uma tarefa típica de roteamento de tickets com IA:
| LLM com esquema estrito | Modelo de decisão | Classificador clássico treinado | |
|---|---|---|---|
| Novos rótulos | Mude o prompt | Mude a solicitação | Coletar dados, retreinar |
| Saída | Texto que você interpreta | Resposta tipada + probabilidade | Rótulo + probabilidade |
| Latência típica | 1 a 3 segundos (meu teste com o Luna: 1.3 a 2.6 s) | 39 a 524 ms de mediana | Menos de 10 ms |
| Custo de tokens de saída | Cobrado (Luna: $0.50/M) | Gratuito ou não cobrado | Nenhum (hospedagem própria) |
| Confiança calibrada | Fraca após o pós-treinamento | O recurso principal | Possível, difícil de acertar |
| Consegue escrever uma resposta | Sim | Não | Não |
| Melhor para | Trabalho aberto, respostas, raciocínio | Muitas pequenas chamadas zero-shot | Uma tarefa fixa de alto volume |
Os números de latência do Luna vêm de um teste que fiz com o GPT-6 Luna com o raciocínio desligado para meu artigo sobre os preços da Decisions API. A faixa dos modelos de decisão é a do benchmark da Cloudflare abaixo, sem o Laya. A linha do classificador reflete o Laya, um codificador de 421M que se comporta quase como um classificador clássico e que a Cloudflare mediu em 5.8 ms.
A coluna em que eu me concentraria é "Novos rótulos". Outro comentarista expôs o argumento prático melhor do que qualquer fornecedor: "Poder resolver qualquer problema de classificação arbitrário em minutos em vez de em uma semana é muito importante". Se sua equipe de suporte adiciona uma nova linha de produto e uma nova categoria de roteamento a cada trimestre, retreinar um classificador a cada trimestre é o custo oculto que um modelo de decisão elimina.
Quais modelos de decisão você pode usar hoje?
A categoria avançou de forma absurdamente rápida. O Jev Decision Index, mantido pela comunidade, foi lançado em 22 de setembro com 31 participantes abertos e listava 70 modelos abertos na atualização de 28 de setembro. A maioria são reproduções de entusiastas. Aqui estão os que têm um fornecedor real ou uma pontuação relevante por trás:
| Modelo | Criador | Tamanho | Pesos abertos | Hospedado | Preço | Entradas | Decision Index |
|---|---|---|---|---|---|---|---|
| Jev | TypeSafe | Não divulgado | Não | API da TypeSafe, Workers AI | $0.042/M entrada, saída gratuita | Texto | 57.9 |
| Clef | Cloudflare | 27B | Sim, Apache 2.0 | Workers AI | $0.24/M entrada | Texto, JSON, imagens, vídeo | 61.2 (autodeclarado) |
| Clef-flash | Cloudflare | 9B | Sim, Apache 2.0 | Workers AI | $0.09/M entrada | Texto, JSON, imagens, vídeo | 57.1 (autodeclarado) |
| pplx-decider-v1-27b | Perplexity | 26B | Sim | Não verificado | Hospedagem própria | Texto, imagens | 56.4 |
| Strands Decider 2B | AWS Strands Labs | 1.9B | Sim, Apache 2.0 | Não | Gratuito (hospedagem própria) | Texto (imagens experimental) | Fora do quadro |
| Bespoke-Nimble-9B-v2 | Bespoke Labs | Adaptador 9B | Sim | Não | Hospedagem própria | Texto | 39.6 |
| Kev 9B | Jared Palmer | Adaptador 9B | Sim, Apache 2.0 | Não | Hospedagem própria | Texto | 38.5 |
| Tev1-4B | Together AI | 4B | Sim, licença não final | Together serverless | Não registrado | Texto | 29.0 |
| Laya | Convai Innovations | 421M | Sim, Apache 2.0 | Não | Hospedagem própria | Texto, mais de 100 idiomas | 6.0 |
| Decisions API | OpenAI | Baseado no GPT-6 Luna | Não | Prévia limitada | Não publicado | Texto, imagens | Fora do quadro |
Fontes: o Decision Index, o quadro autodeclarado da Cloudflare e a página de cada modelo, vinculada nas seções abaixo. O Index é corrigido para o acaso em 38 benchmarks, então 0 significa chute aleatório.
Os quatro que eu veria primeiro estão abaixo.
TypeSafe Jev
O Jev é o original e continua sendo a referência contra a qual todos se comparam. É um modelo fechado da TypeSafe AI, uma equipe de São Francisco liderada por Diogo Almeida, que coinventou os métodos RLHF e InstructGPT por trás do ChatGPT. Em 27 de setembro, a TypeSafe eliminou a lista de espera, então agora qualquer pessoa pode criar uma conta.
O preço de destaque no post de lançamento é $0.042 por milhão de tokens de entrada com saída gratuita, e a TypeSafe afirma tempos de resposta de ponta a ponta de 70 a 500 ms. É somente texto, com 32K de contexto. Duas coisas para saber antes de se comprometer: a arquitetura e os pesos do Jev não são públicos, e a própria TypeSafe diz que "não pode provar que não é subsidiado".
Para as contas no seu volume, veja meu detalhamento dos preços do Jev. Se quiser a visão prática, cobri na minha análise do Jev. Há também um nível separado de menor latência, que descrevi como Jev Ultrafast.
Cloudflare Clef e Clef-flash
O Clef é o modelo aberto que afirma superar o Jev. A Cloudflare o construiu sobre o Qwen3.8-27B (o Clef-flash sobre o Qwen3.5-9B), lançou ambos sob Apache 2.0 e os tornou totalmente compatíveis com a API do Jev, então trocar é basicamente mudar uma URL.
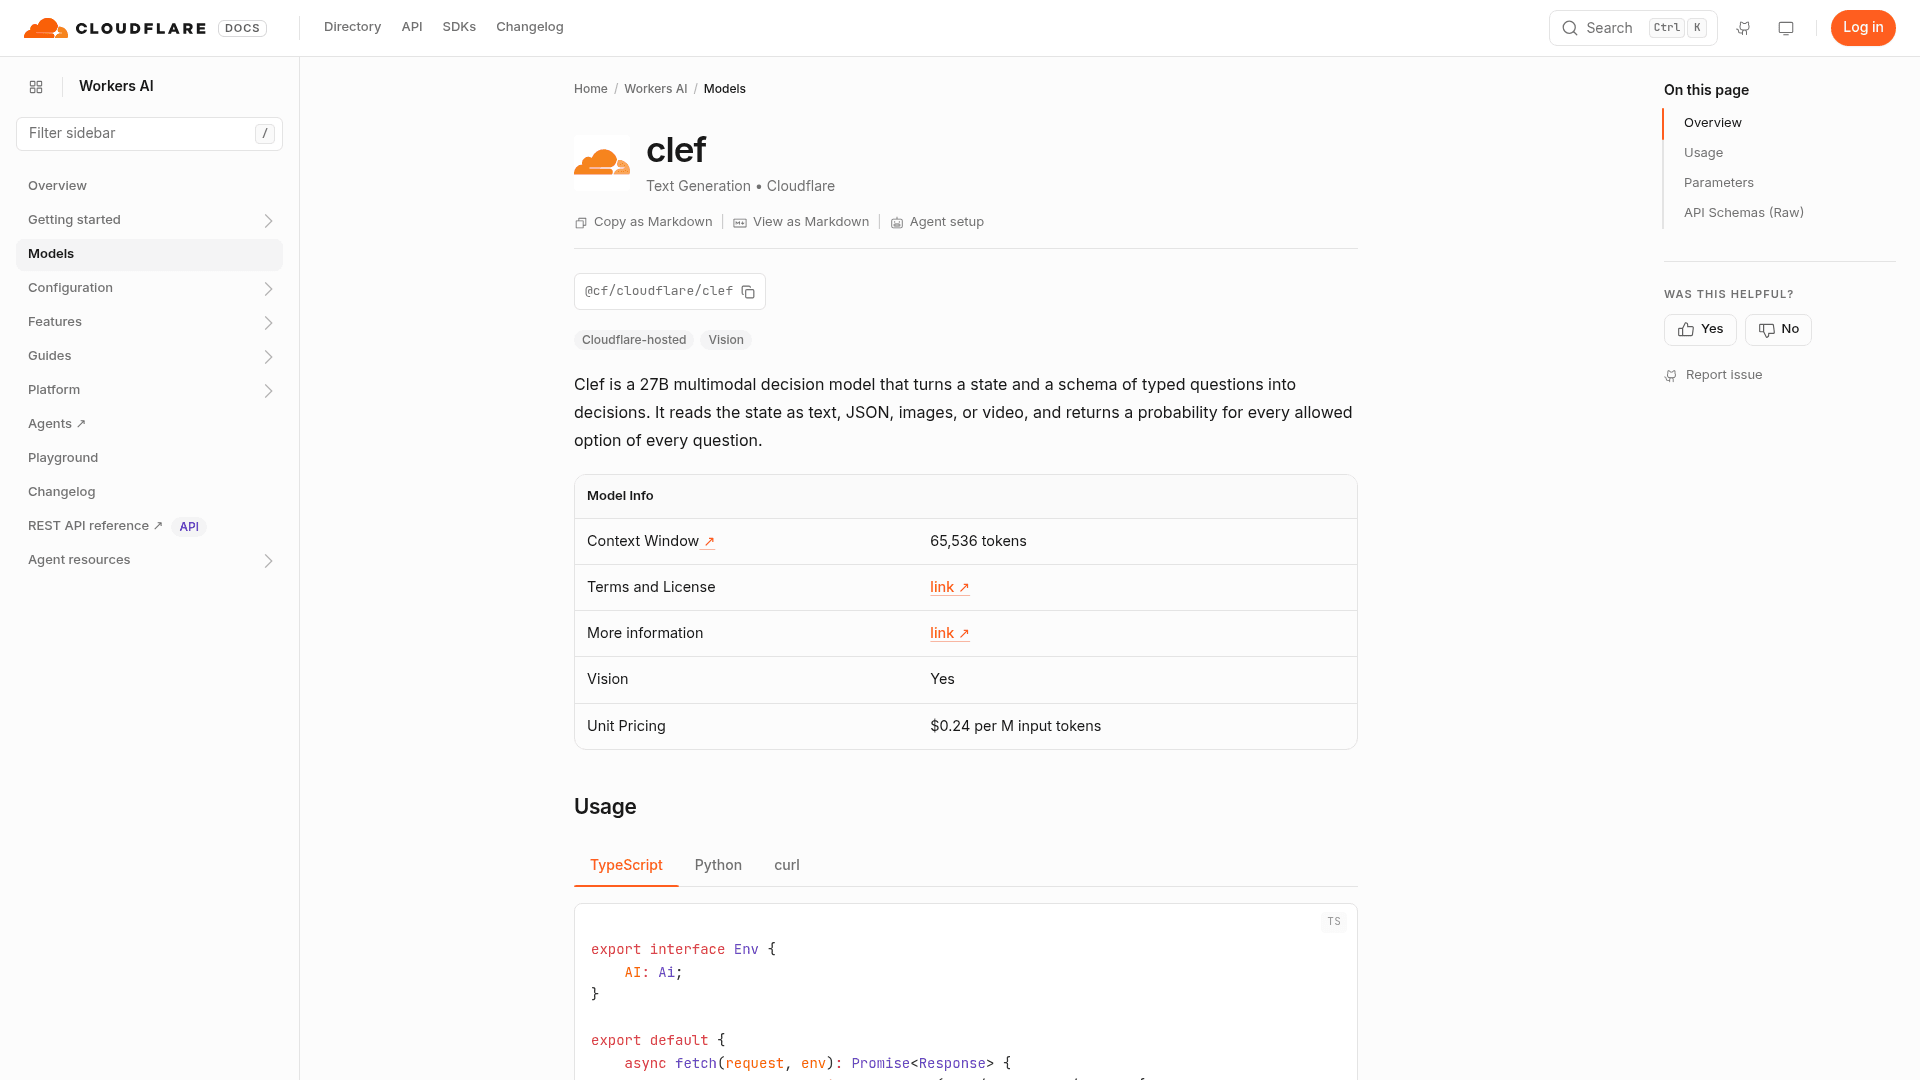
As duas vantagens reais do Clef sobre o Jev são a visão (lê imagens e vídeo) e um contexto de 64K. Pelos números da Cloudflare, ele também vence 3 das 4 avaliações de fluxo de trabalho da própria TypeSafe, incluindo atendimento ao cliente, em que os três modelos ficam a um ponto uns dos outros (Clef 76.3, Clef-flash 77, Jev 76.0). A ressalva é que ambas as pontuações do Clef são a Cloudflare corrigindo a própria lição de casa: não foram reproduzidas no quadro original, e a Cloudflare pulou dois benchmarks. Ele também custa cerca de 5.7 vezes o preço por token do Jev. Fiz as contas por decisão no meu artigo sobre os preços do Cloudflare Clef.
Strands Decider 2B
O Strands Decider 2B é a proposta da AWS Strands Labs, escrita por Marc Brooker, Mike Chambers e Fabio Nonato de Paula. É a opção pequena que roda no seu notebook: 1.9B de parâmetros sobre uma base Qwen3.5-2B, com pesos, dados de treinamento e scripts de treinamento todos publicados.
Roda em CPU, GPUs NVIDIA ou Apple silicon, com mediana de 115 ms em uma RTX 3090 e 153 ms em um M3 Pro para prompts curtos, segundo o repositório no GitHub. No JevBench, marca 0.762 na versão mais recente. Gosto de como o post de lançamento é franco: diz que o design de passada única o torna "significativamente pior em resolver problemas complexos do que os modelos de raciocínio" e inadequado para chatbots ou resumos. Duas observações práticas: não há versão hospedada (o Hugging Face não mostra nenhum provedor de inferência), e o servidor local não tem autenticação, então serve para experimentos, não para tráfego de produção. Se você já constrói sobre o harness da Strands, ele se encaixa em um hook de chamada de ferramenta como portão de prosseguir/negar.
OpenAI Decisions API
A OpenAI anunciou a Decisions API no DevDay de 29 de setembro, e o resumo do DevDay a descreve como "concentrar a inteligência do Luna em um conjunto específico de perguntas definidas pelo usuário com respostas finitas e predefinidas". Sete dias depois, ainda não encontro página de documentação, esquema de referência, linha de preço nem entrada de changelog. O endpoint /v1/decisions existe, mas uma chave padrão recebe um HTTP 403 dizendo que a API não está habilitada para este usuário.
Então, por ora, o único número verificável da OpenAI é a tarifa de tokens do GPT-6 Luna: $0.10 por milhão de entrada e $0.50 por milhão de saída. Se você está na OpenAI hoje, uma chamada ao Luna com um esquema enum estrito faz o mesmo trabalho; meu artigo sobre a Decisions API da OpenAI explica essa alternativa.
Qual é a velocidade dos modelos de decisão?
A velocidade é onde a categoria faz jus ao nome. A Cloudflare mediu a latência mediana em 43 benchmarks para seis modelos de decisão na sua própria infraestrutura:
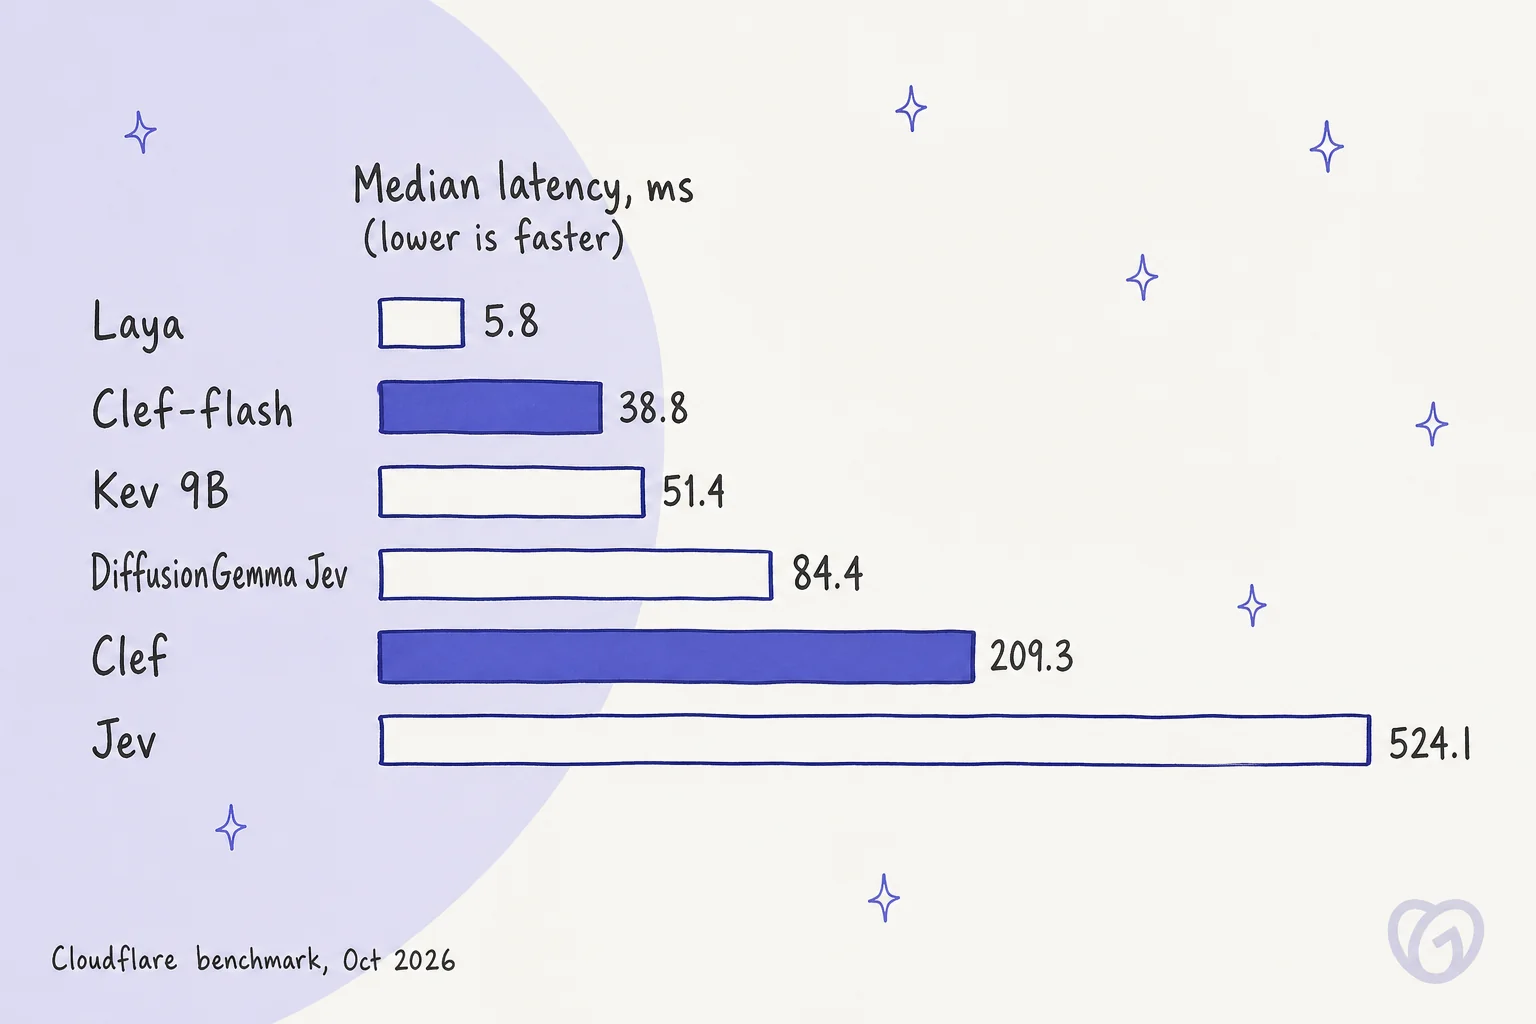
Duas ressalvas honestas sobre esse gráfico. Primeiro, os 524 ms do Jev são uma viagem de ida e volta hospedada pela internet, enquanto os modelos abertos foram medidos nas GPUs da própria Cloudflare, então não é uma corrida em igualdade de condições. Segundo, o Laya é ultrarrápido, mas marca 6.0 no Decision Index; velocidade sem precisão é só uma resposta errada rápida.
Para comparar, um LLM fazendo o mesmo trabalho é medido em segundos. Um desenvolvedor que trocou a camada de proteção de um agente de suporte simulado de um LLM para o Jev relatou "194ms vs 5,825ms. $125 vs $5,894 por milhão de revisões" em um pequeno teste de 51 casos. Essa diferença é todo o argumento para colocar um modelo de decisão na frente de um agente de IA para helpdesk como proteção.
Os modelos de decisão são precisos?
Aqui é onde eu contestaria o entusiasmo. Os modelos de decisão são bons o bastante para muitas tarefas, mas não são a opção mais precisa da mesa.
No JevBench, as notas de avaliação da Strands descrevem o topo do quadro como "modelos de raciocínio (GPT-6 Luna 0.996), depois reconstruções do Jev sobre troncos maiores, em sua maioria de 12B para cima (0.83-0.93)". Um LLM de raciocínio como o Luna ou o Claude Sonnet 5.5 ainda vence em precisão. Os modelos de decisão vencem em custo, velocidade e calibração, e você troca alguns pontos de precisão por isso.
A precisão também cai à medida que o número de rótulos aumenta. A ficha do próprio Laya mostra 0.425 no BANKING77 (77 rótulos) contra 0.870 do Jev (Laya). Se seu helpdesk tem 60 categorias de roteamento, teste com as 60, não com uma demo arrumada de quatro.
E as pontuações de confiança, o grande argumento de venda, ainda não são ciência consolidada:
"for production routing, you almost always want to threshold on confidence ('auto-handle above 0.9, route to a human below'), and that only works if the probabilities mean what they say. A 96% model with overconfident outputs is operationally worse than a 94% model with honest ones."
Um testador pediu ao Jev o resultado de uma jogada de dado justo e recebeu cerca de 80% de confiança no "1" (wat10000). Outro mostrou uma cópia aberta do Jev mudando para "100% legítimo" quando o próprio e-mail dizia que era legítimo (FooBarWidget). Os modelos de decisão não conseguem alucinar um parágrafo, mas podem muito bem estar confiantemente errados ou ser convencidos de uma resposta.
A ficha do modelo da Strands dá a orientação certa: "meça com seu próprio tráfego antes de confiar em um limite". É a mesma lição por trás de evitar alucinações da IA no suporte: teste com tickets reais, não com demos.
Qual modelo de decisão serve para o seu caso?
Escolha a situação mais próxima da sua.
Essa última aba não é brincadeira. Um comentarista do Reddit disse com perfeição: "metade do roteamento que escrevi acabou sendo um if fantasiado". Regras simples de roteamento do Zendesk ainda cobrem muita coisa.
Onde os modelos de decisão se encaixam no atendimento ao cliente?
O suporte é o caso de uso a que todo fornecedor recorre primeiro, e com razão. A triagem automática é, em grande parte, uma pilha de decisões pequenas e delimitadas. O exemplo de lançamento da Cloudflare é um ticket de suporte. As próprias avaliações de fluxo de trabalho da TypeSafe incluem um conjunto de atendimento ao cliente com 5,330 linhas.
A classificação de intenção é uma pergunta de tipo choice. A detecção de spam também. A urgência é um score, e "isso deve ir para uma pessoa?" é um sim/não, o coração da escalada com IA. Até a análise de sentimento é um score em uma escala fixa. São todas perguntas delimitadas com um conjunto fixo de respostas. Esse é exatamente o formato para o qual um modelo de decisão foi feito.
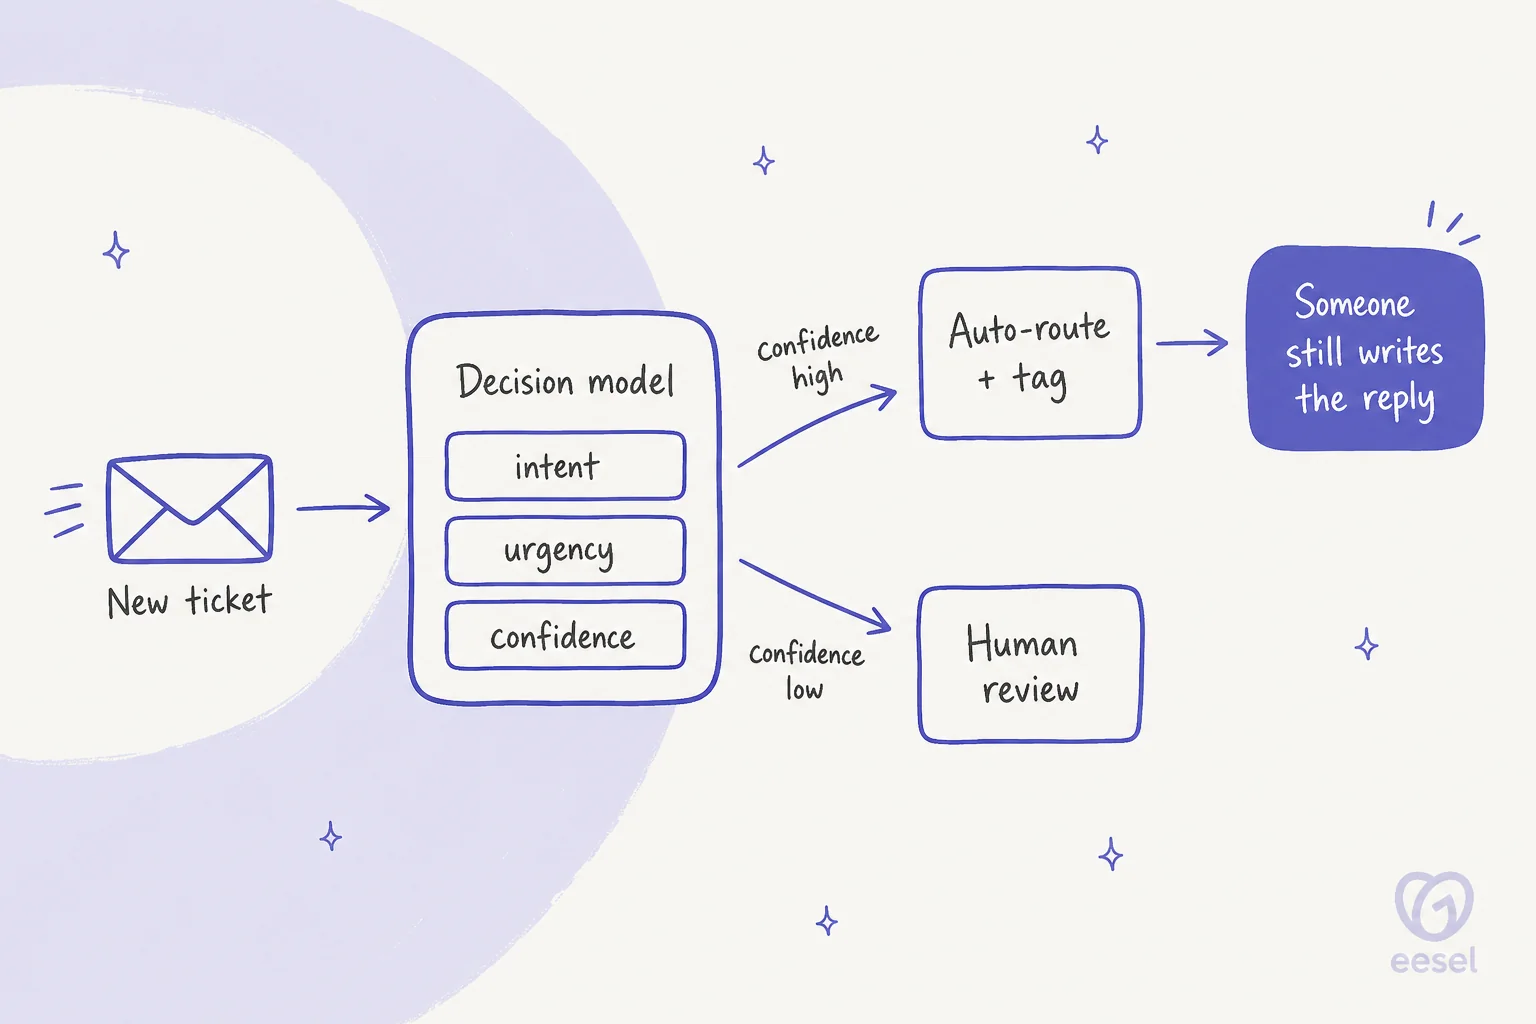
Eis o que aprendi em anos colocando IA em filas de suporte reais na eesel: classificar é a metade fácil. Em um teste com validação cruzada na caixa de entrada real do Zendesk de uma empresa de e-commerce, a triagem com IA atingiu 93% de precisão e pegou 100% do spam, que representava 22% da caixa. No mesmo teste, apenas 12% das respostas redigidas por IA foram enviadas como estavam, e 7% tinham um erro factual. A classificação de tickets estava quase resolvida. O trabalho estava na resposta.
A pontuação de confiança é a peça que os compradores sempre pediram. Um líder de CX que lida com 7,000 tickets por mês disse à equipe da eesel em uma chamada de vendas:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Essa é a ideia central de um modelo de decisão em uma frase. É também o motivo pelo qual a eesel simula cada implantação com os tickets históricos de uma equipe antes de qualquer coisa entrar em produção: uma resposta confiantemente errada é pior do que nenhuma resposta, e a única forma de saber onde fica o seu limite é testar com tráfego real.
Um ponto prático de um dono de MSP vale a pena ser ouvido antes de você reconstruir sua stack em torno da velocidade. Em um tópico do r/SmallMSP, ele disse que o modelo não era o gargalo: "Suspeito que o Autotask seja meu elo fraco quando se trata de velocidade". Tirar 2 segundos de uma chamada de roteamento importa pouco se o ticket depois fica 40 minutos em uma fila.
Então, onde um modelo de decisão se encaixa? Dentro de um fluxo de trabalho que você mesmo constrói, como a primeira passada barata. Se você escreve código e processa milhões de eventos, um modelo de decisão é um ótimo bloco de construção para roteamento, moderação ou proteções, e meu levantamento de alternativas ao Jev cobre as opções de construir por conta própria. Se você é uma equipe de suporte que quer tickets etiquetados, encaminhados, escalados e respondidos no seu helpdesk atual, um modelo bruto é o começo de um projeto, não o fim. Você ainda teria que construir a etiquetagem, o processo de escalonamento, a consulta de conhecimento e a resposta.
Para o caminho completo de fazer você mesmo, comece pelo meu guia para automatizar a triagem de tickets. Se preferir comprar a construir, meu levantamento de ferramentas de triagem com IA compara as opções prontas.
Experimente a eesel para triagem e respostas
O colega de IA para helpdesk da eesel faz as duas metades do trabalho, das quais os modelos de decisão fazem só uma. Ele entra na sua fila atual (há uma integração com o Zendesk, além de Freshdesk e Gorgias), etiqueta e encaminha tickets, escala o que não deve tocar e escreve a resposta a partir da sua central de ajuda e de tickets antigos. Cada automação ainda tem uma configuração de "Model strength", com um modelo mais leve "para tarefas simples como etiquetar ou encaminhar" (documentação de automações) e o mais forte para redigir, então a decisão barata e a resposta difícil já rodam em modelos diferentes.

A ideia de confiança também continua. Cada ação (uma etiqueta, uma resposta, um reembolso) é configurada como automática, que exige aprovação ou desativada, e eventos que suas instruções não cobrem são ignorados e registrados com um motivo. Você pode rodar uma simulação nos seus próprios tickets antigos antes de qualquer coisa entrar em produção.
Se você chegou aqui como desenvolvedor, a CLI da eesel é a ponte. Execute npx @eesel/cli e você pode conectar um helpdesk, configurar uma automação com instruções de roteamento em linguagem natural via eesel automations e aprovar ou negar ações retidas com eesel approvals, tudo a partir de um terminal. Cada comando devolve JSON, então o Claude Code, o Cursor ou o Codex podem conduzir toda a configuração, e --dry-run verifica uma escrita antes que ela aconteça. Você obtém a lógica de roteamento que teria construído em torno de um modelo de decisão, mais a parte que responde ao cliente, sem escrever o código de ligação.
Os planos começam em $299 por mês por 500 créditos nos preços da eesel, em que um crédito é um ticket, sem cobrança por usuário, e há um nível gratuito com 100 créditos. Experimente a eesel nos seus próprios tickets e veja onde realmente fica a sua linha de confiança.
Perguntas frequentes
O que é um modelo de decisão em IA?
Um modelo de decisão é um modelo de IA pequeno que responde perguntas tipadas (sim/não, escolher uma opção ou pontuar em uma escala) sobre uma entrada e devolve cada resposta com uma probabilidade, em vez de escrever texto. O TypeSafe Jev iniciou a categoria em setembro de 2026, e os modelos de decisão já são usados em tarefas como a triagem de tickets. Separar um ticket por assunto, também chamado de classificação de intenção, é uma tarefa típica.
Como os modelos de decisão se diferenciam dos LLMs?
Um LLM gera texto token por token, então você precisa interpretar a resposta dele. Um modelo de decisão lê a entrada uma vez e pontua as respostas permitidas em uma única passada, então não há texto para gerar e a saída é praticamente gratuita. A contrapartida é que os modelos de decisão não conseguem escrever respostas, código ou resumos, e é por isso que uma equipe de suporte ainda precisa de um agente de IA para helpdesk ou de uma pessoa para a resposta.
Os modelos de decisão são apenas classificadores?
Matematicamente são parecidos: escolhem entre rótulos e devolvem probabilidades. O novo é que funcionam em zero-shot com rótulos que você define na hora da solicitação, então não é preciso coletar dados e treinar um modelo para cada novo problema de classificação de tickets.
Quanto custam os modelos de decisão?
O Jev custa $0.042 por milhão de tokens de entrada com saída gratuita, o Cloudflare Clef custa $0.24 e o Clef-flash $0.09 por milhão de tokens de entrada, e o Strands Decider 2B é gratuito se você mesmo o executar. A OpenAI não publicou um preço para a sua Decisions API. Meu artigo sobre os preços do Jev traz as contas completas. Para o Clef, veja o detalhamento dos preços do Clef.
Qual é o melhor modelo de decisão?
No Decision Index da comunidade, o Jev marca 57.9 e nenhum modelo aberto testado de forma independente o supera até agora. A Cloudflare informa 61.2 para o Clef na sua própria cópia do quadro, mas essa pontuação é autodeclarada. Para imagens, Clef; para uso offline ou em CPU, Strands Decider 2B; para as decisões de texto hospedadas mais baratas, Jev.
Posso usar um modelo de decisão para encaminhar tickets?
Sim. O roteamento de tickets, a urgência e as decisões de escalonamento são o caso de uso de manual, e o próprio exemplo de lançamento da Cloudflare encaminha uma mensagem de suporte por equipe e gravidade. Você ainda precisa de código ou de uma ferramenta de helpdesk para agir sobre o rótulo, e é isso que um colega de IA para helpdesk cuida de ponta a ponta.
A Decisions API da OpenAI está disponível?
A OpenAI anunciou a Decisions API no DevDay 2026 em prévia limitada. Em 6 de outubro de 2026, não há documentação pública, esquema nem preço, e o endpoint retorna um erro de não habilitado para chaves de API padrão. Meu artigo sobre a Decisions API da OpenAI acompanha o que se sabe.
Os modelos de decisão substituem um agente de suporte com IA?
Não. Um modelo de decisão toma uma decisão delimitada, como qual equipe deve cuidar ou qual a urgência. Ele não consulta um pedido, não aplica uma política de reembolso nem escreve uma resposta. Os modelos de decisão são um bloco de construção para automatizar a triagem de tickets, não um substituto para o colega que resolve o ticket.