

Resumo
O Strands Decider 2B é um modelo de decisão de 1,9B gratuito e aberto do AWS Strands Labs, lançado em 1º de outubro de 2026. Você dá a ele um texto mais perguntas tipadas ("qual equipe?", "é urgente?") e ele devolve um rótulo com pontuação de confiança em uma única passada. Ele marca 0,762 no JevBench, perto do topo da sua classe de tamanho, e roda em cerca de 115 ms em uma GPU gamer.
O que a maior parte da cobertura do lançamento deixa de lado: os pesos são a parte menos interessante da caixa. Não há API hospedada, o servidor local não tem autenticação, e em um servidor comum só com CPU uma pergunta leva cerca de 1,6 segundo, não 115 ms. O que a AWS realmente entregou é um kit aberto, com os dados de treinamento, a receita e um registro de pesquisa, para que você possa retreiná-lo com as suas próprias perguntas em cerca de 11 horas em uma única RTX 3090.
Para equipes de suporte, classificar o ticket é a metade fácil. Em um teste da eesel com tráfego real, a triagem por IA atingiu 93% de precisão, enquanto apenas 12% das respostas redigidas saíram sem edição. Se você quer triagem, roteamento e resposta resolvidos juntos dentro do Zendesk ou do Freshdesk, o colega de IA para helpdesk da eesel faz isso sem que você precise hospedar um modelo.
O que é o Strands Decider?
O Strands Decider 2B é um pequeno modelo de decisão do Strands Labs, o braço experimental do projeto de código aberto Strands Agents da AWS. O post de lançamento lista Marc Brooker, Mike Chambers e Fabio Nonato de Paula como autores, e tudo é lançado sob Apache-2.0.
Um modelo de decisão não escreve texto. Pense nele como um modelo de linguagem pequeno sem a fala. Ele responde a perguntas que você define, entre opções que você define, e dá uma probabilidade para cada uma. A categoria decolou depois que o TypeSafe Jev foi lançado em setembro, e a equipe do Strands diz isso com todas as letras: é "a type of model that has been gaining a lot of attention since TypeSafe AI's launch of Jev."
Eu construo as integrações da eesel e a superfície da API de helpdesk, e a chamada de triagem (qual equipe, qual urgência, se é spam) é a etapa que mais conectei em helpdesks. Então li este lançamento como leria uma peça que poderia encaixar em um pipeline: o que ele devolve, a que velocidade, onde quebra e o que sobra para eu construir.
Aqui está a ficha técnica resumida:
| Especificação | Strands Decider 2B |
|---|---|
| Lançamento | 1º de outubro de 2026 |
| Parâmetros | 1,9 bilhão |
| Modelo base | Qwen3.5-2B-Base, LoRA de rank 16 + cabeça de ponteiros |
| Modelo de referência atual | strands-decider-2B-hobson-v21 (o v19 continua publicado) |
| Tipos de pergunta | noul (sim/não), choice (uma de N), score (escala ordenada) |
| Saída | Uma resposta por pergunta, com probabilidade calibrada |
| Contexto | 4.096 tokens por padrão |
| Licença | Apache-2.0 (pesos, código, dados, receita) |
| Opção hospedada | Nenhuma |
| Hardware | CUDA, Apple MPS ou MLX, CPU |
Cada linha vem do README no GitHub do projeto e do seu cartão de modelo no Hugging Face.
Como o Strands Decider funciona?
O truque é a subtração. O Strands pega um modelo de linguagem normal, mantém o seu "tronco" (as camadas que entendem texto) e descarta a cabeça que normalmente geraria palavras. No lugar dela fica uma minúscula cabeça de ponteiros, com pouco mais de um milhão de parâmetros, que pontua cada opção de resposta. O README resume assim: "One forward pass, no generation, no decoding loop."
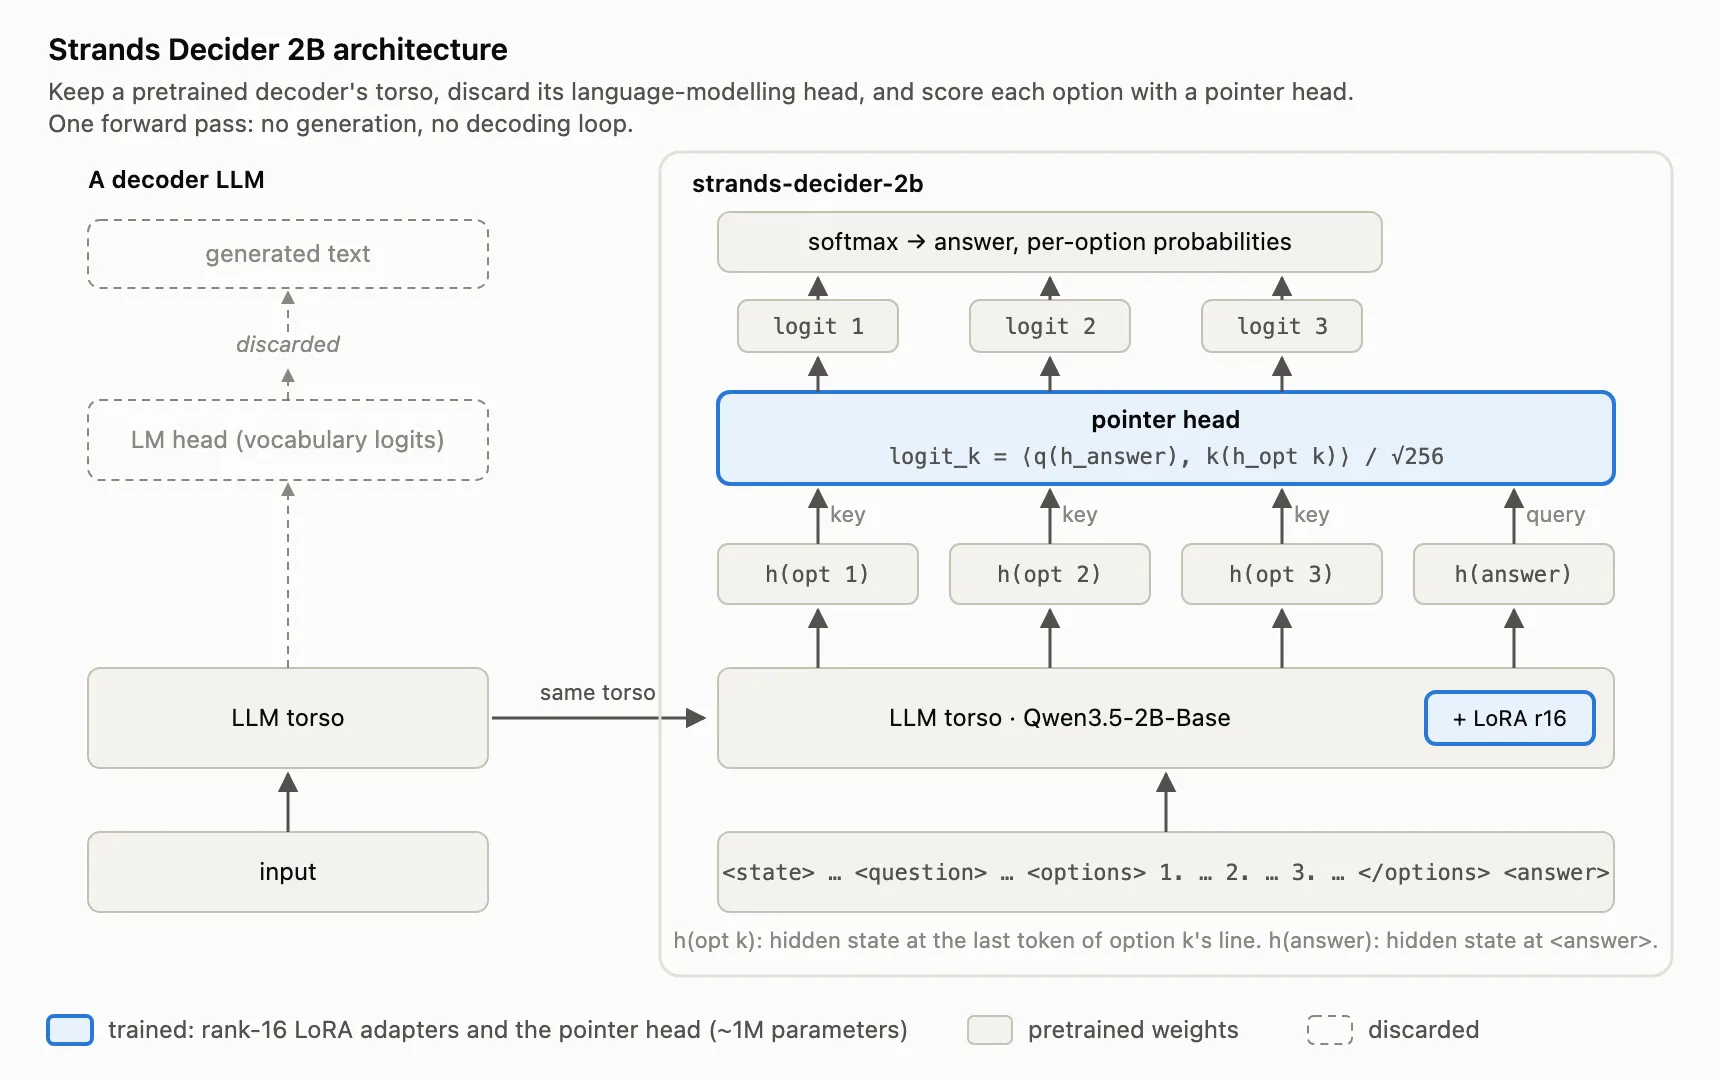
Como nunca gera, ele não consegue sair do formato. Se você pedir uma entre billing, sales ou retail, recebe uma dessas três, sempre. É a mesma promessa da chamada de funções em um LLM grande (ou do modo JSON, seu primo mais frouxo), mas mais barata, porque não há loop token a token nem JSON para interpretar.
Isso também significa que perguntas extras custam muito pouco. O modelo lê o seu texto uma vez, e "each question adds only its own tokens." Então perguntar "qual equipe?", "é urgente?" e "quão frustrado está quem escreveu?" em uma só chamada custa quase o mesmo que fazer uma.
A demonstração do cartão do Hugging Face é um ticket de suporte, o que mostra exatamente quem a AWS acha que são os compradores:
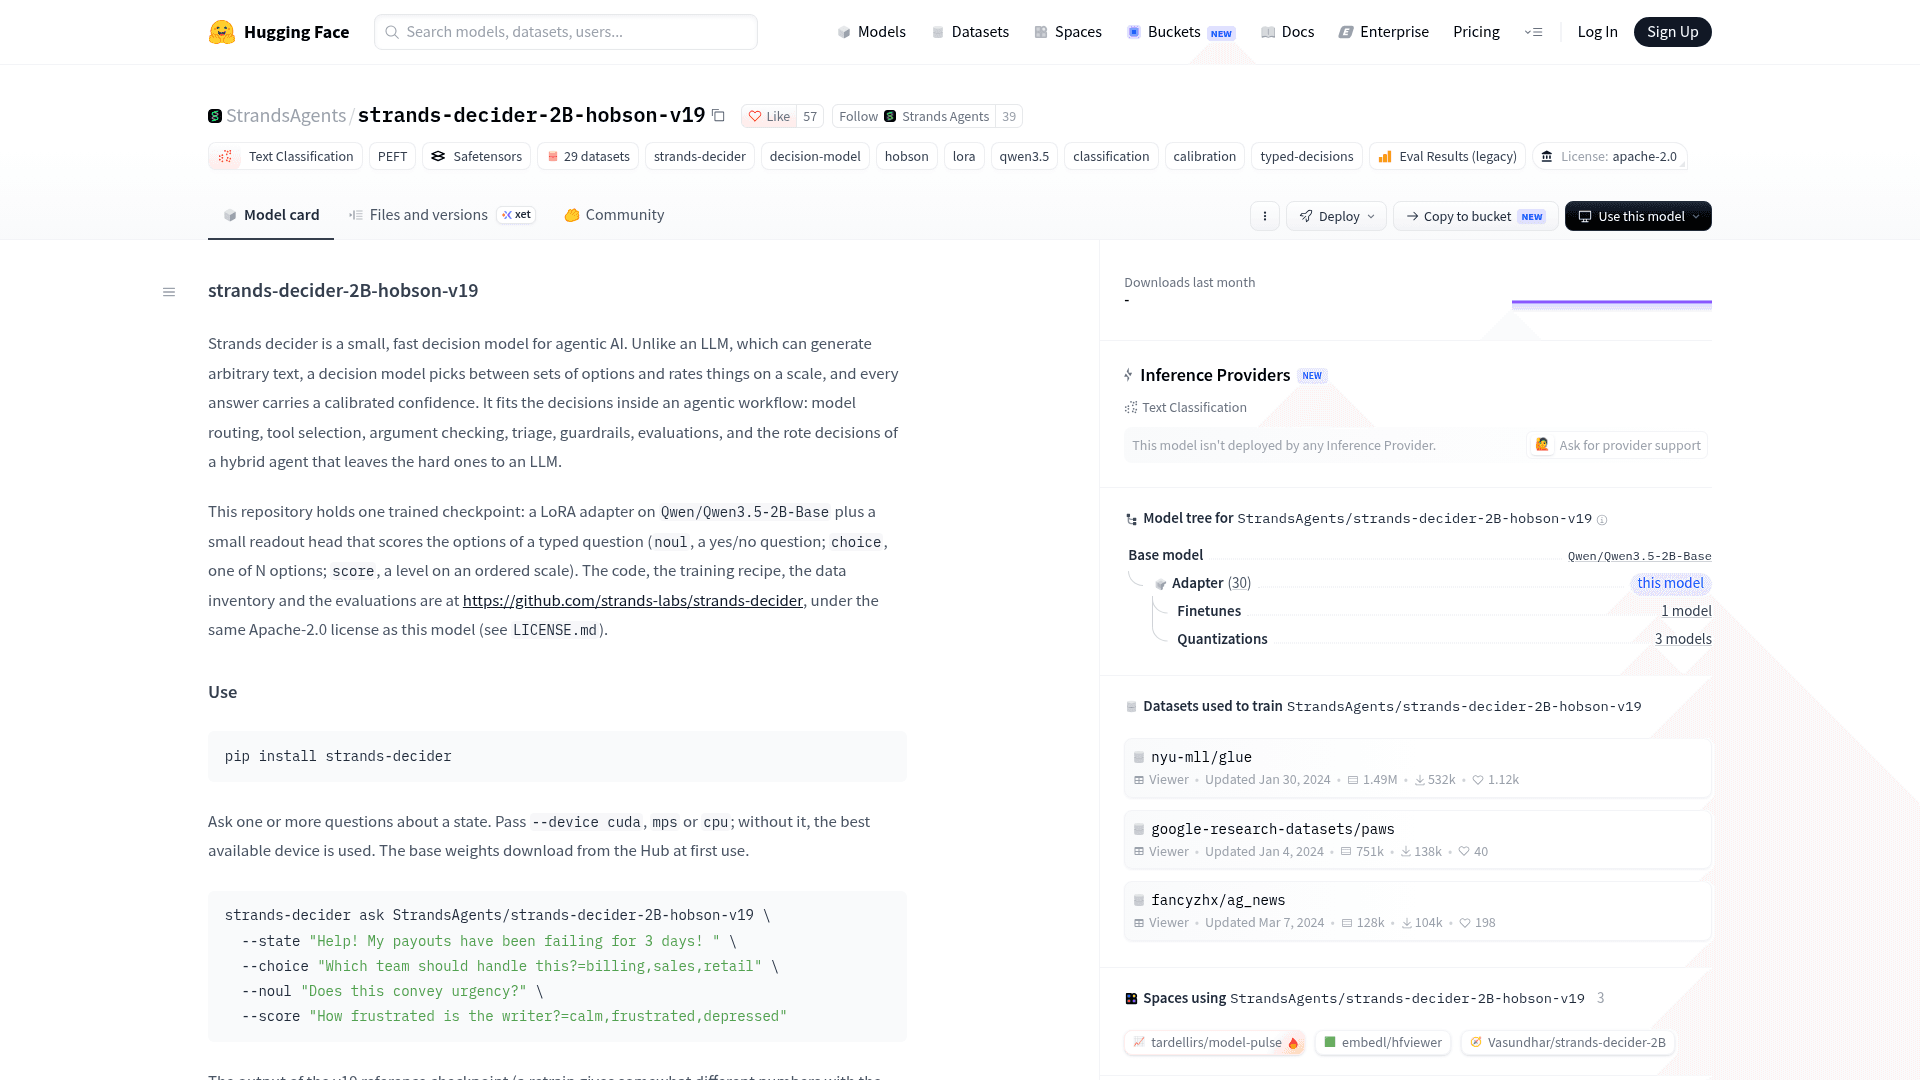
Para rodá-lo como serviço, você inicia o servidor incluído e envia requisições a ele:
pip install strands-decider
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
Os pesos são baixados do Hugging Face no primeiro uso. Depois é só fazer POST /v1/systemone com um objeto state e um questions, e você recebe respostas por pergunta, uso de tokens (output_tokens: 1) e latency_ms. Uma coisa a saber antes de se empolgar em trocá-lo pelo Jev: a documentação diz que o adaptador do JevBench roda sem modificação contra esse endpoint, e então acrescenta: "Compatibility with the Jev API itself is not verified" (docs/inference.md).
O fornecedor também é claro sobre os limites. O post de lançamento diz que o design de uma passada o torna "significantly worse at solving complex problems than reasoning models", e que ele é "unsuited for coding, chatbots, document summarization." O cartão do modelo acrescenta que documentos longos e de várias etapas são o seu ponto fraco.
Quão preciso é o Strands Decider?
No conjunto público do JevBench (231 tarefas), os números do repositório são:
| Medição | v21 (referência) | v19 (lançamento) |
|---|---|---|
| Precisão | 0.762 (176/231) | 0.723 (167/231) |
| Pontuação de Brier (menor é melhor) | 0.323 | 0.342 |
| Erro de calibração (ECE) | 0.064 | 0.052 |
| Níveis fácil / padrão / difícil | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
A frase que mais respeito em todo o lançamento é aquela em que a equipe diminui o próprio upgrade. Em seis execuções de treinamento cada, as receitas do v19 e do v21 têm média de "172.8 and 172.3 JevBench tasks: the same accuracy." O número maior do v21 é em boa parte sorte da semente, e eles dizem isso. Essa honestidade vale mais do que os quatro pontos a mais.
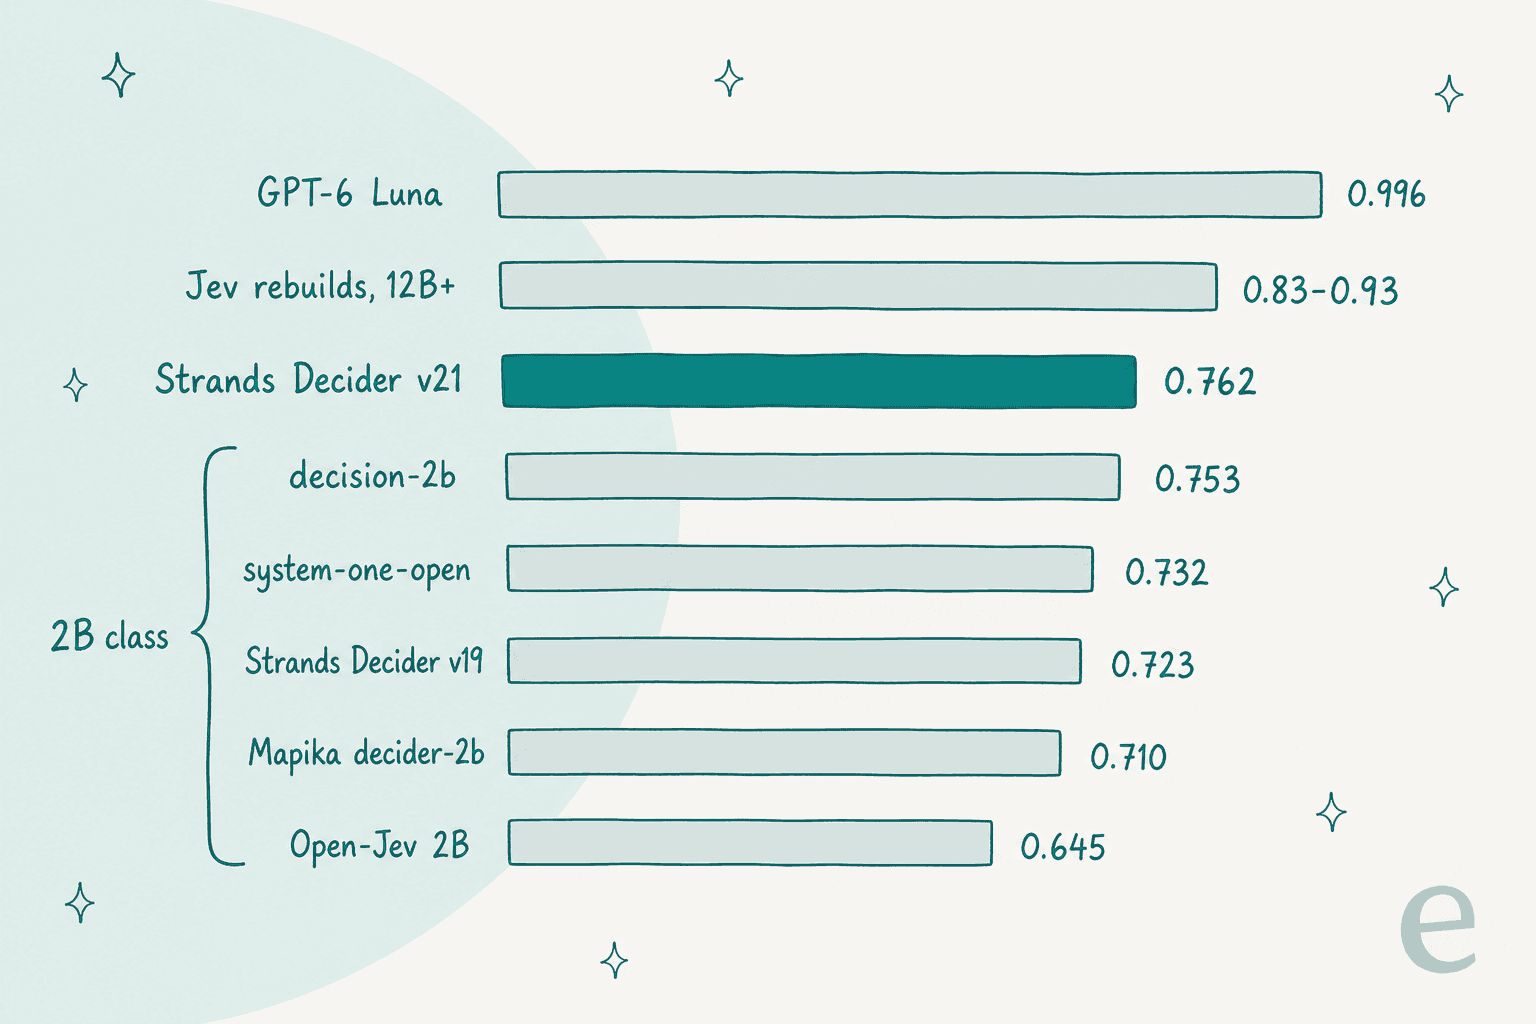
Onde isso o deixa na tabela? No ranking do JevBench v1.4.2 (89 sistemas, 25 de setembro), o v19 ficou em 50º no geral e em 3º de 33 na classe de 2B, atrás do decision-2b da FlyMy.AI (0,753) e do system-one-open, baseado em Gemma (0,732), segundo as notas de avaliação. O topo da tabela é dos modelos de raciocínio, com o GPT-6 Luna em 0,996, e depois as reconstruções do Jev sobre troncos de 12B ou mais, de 0,83 a 0,93. Se quiser ver todo o campo lado a lado, o panorama de alternativas ao Jev os classifica.
Então o enquadramento honesto: o Strands Decider é um modelo pequeno forte, não um modelo forte. Ele troca cerca de 23 pontos de precisão em relação a um LLM de fronteira por velocidade, preço e a possibilidade de rodar na sua própria máquina.
Uma observação se você olhar o gráfico do histórico de treinamento no post de lançamento: ele rotula dois pontos de comparação como "strands-decider-2b v10/v11". Marc Brooker corrigiu isso no Hacker News: são um modelo diferente chamado "decider-2B", "which isn't ours."
As pontuações de confiança significam alguma coisa?
A calibração é todo o argumento de venda. Uma pontuação de confiança só serve se for honesta: um rótulo só é útil para automação se você puder dizer "aja acima de 0,9, mande para uma pessoa abaixo disso." O repositório afirma que, em tarefas curtas de classificação inéditas, "answers at a confidence of 0.9 or more are right about 95% of the time."
É animador, com duas ressalvas que o próprio cartão do modelo levanta: as faixas de confiança foram definidas apenas com classificação curta, então "measure on your own traffic before you trust a threshold", e o modelo lê as perguntas com menos atenção do que os documentos, de modo que uma pergunta reformulada costuma receber a mesma resposta. Os primeiros usuários encontraram uma terceira:
"From what i can tell from my (limited) experiments, there is a lot of variation caused by simply reordering options, plus a heavy bias toward the first option listed"

A solução é sem graça e funciona: embaralhe a ordem das opções nos seus testes e avalie o modelo em algumas centenas de tickets rotulados seus antes de confiar em qualquer número. O próprio Brooker sugeriu no HN que, com 2B, dá para fazer fine-tuning nas suas perguntas ou simplesmente recalibrar sem fine-tuning.
Quão rápido é o Strands Decider em hardware real?
O número de destaque do post de lançamento é uma mediana de 115 ms em uma RTX 3090. É real, e é um número de GPU. Aqui está o quadro mais amplo, com todos os valores tirados do repositório, dos seus pull requests ou do Hacker News:
| Hardware | Latência por pergunta | Fonte |
|---|---|---|
| RTX 3090 (GPU) | mediana 115 ms, p95 299 ms | README |
| M3 Pro (Apple silicon) | mediana a quente 153 ms abaixo de 300 tokens, 234 ms em todas as tarefas | README |
| M4 Pro (só CPU) | 0,3 a 0,5 s depois de carregado | PR #46 |
| Xeon 8375C, 8 threads | cerca de 1,6 s com entrada curta, 16 a 18 s com ~3.000 tokens | docs/inference.md |
| Graviton 4, bf16 (PR não mesclado) | 1,15 s | PR #48 |
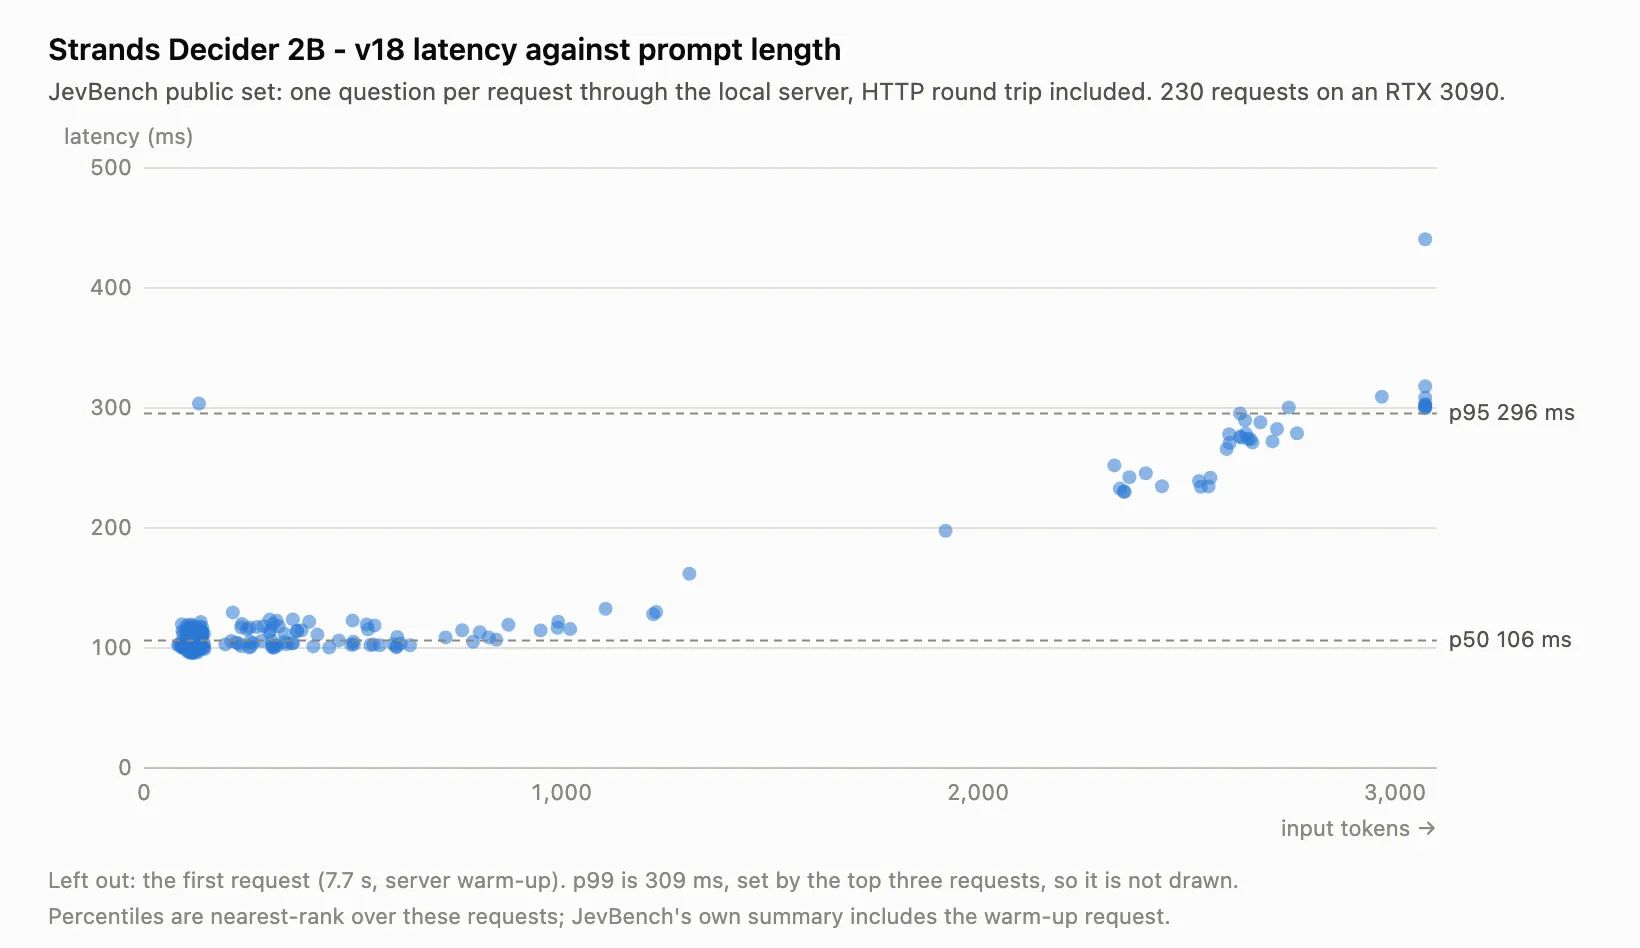
O padrão importa mais do que qualquer número isolado. A latência cresce mais ou menos junto com o tamanho da entrada, então uma longa conversa de e-mails custa bem mais do que uma mensagem de chat de uma linha. E no tipo de servidor só com CPU que a maioria das equipes sobe por padrão, uma decisão leva segundos. Um usuário do HN viu cerca de meio segundo em seis núcleos; outro mediu 1.732 ms em um contêiner Docker só com CPU. Se a decisão fica na frente de um cliente esperando uma resposta de chat, ou dentro de uma etapa de roteamento inteligente, você quer uma GPU ou Apple silicon.
Quanto custa o Strands Decider?
O modelo é gratuito. Rodá-lo não é, e não há ninguém além de você para pagar.
- Sem endpoint hospedado. A página do Hugging Face diz "This model isn't deployed by any Inference Provider", e não há listagem no Bedrock. O Bedrock aparece no post de lançamento apenas como o LLM do exemplo de agente.
- Sem autenticação. O servidor local se vincula a
127.0.0.1e, nas palavras do cartão, "has no authentication: use it for local experiments." Colocá-lo atrás de um balanceador de carga, com autenticação e monitoramento, é trabalho seu, as mesmas tarefas tratadas nas alternativas ao Strands harness para hospedagem de agentes. - Ainda sem build oficial para llama.cpp. Brooker explicou no HN que não dá para converter só o LoRA, porque "there's a whole pointer head and some custom layers." Existe um port GGUF da comunidade, assim como um em ONNX, mas ambos são não oficiais.
Veja como ele se compara às duas opções hospedadas com que a maioria das equipes o compara:
| Strands Decider 2B | TypeSafe Jev | Cloudflare Clef | |
|---|---|---|---|
| Pesos | Abertos, Apache-2.0 | Fechados | Abertos, Apache-2.0 |
| Tamanho | 1,9B | Não divulgado | 27B (Clef-flash 9B) |
| API hospedada | Nenhuma | Sim, incl. Workers AI | Workers AI |
| Preço | Grátis, mais o seu hardware | $0.042 por 1M de tokens de entrada, saída grátis | $0.24 por 1M de entrada (flash $0.09) |
| Contexto | 4.096 por padrão | 32.000 | 64K hospedado |
| Fazer fine-tuning por conta própria | Sim, receita completa | Não | Ajuste por RL via equipe da Cloudflare |
| Análise detalhada | Este post | Análise do Jev | Clef explicado |
A tarifa do Jev vem da sua listagem no Workers AI, e a do Clef da página de modelo da Cloudflare. A conta completa está no detalhamento dos preços do Clef.
Na tarifa do Jev, um milhão de decisões de 500 tokens custam cerca de $21 em tokens de entrada. Essa é a barra que uma GPU autohospedada precisa superar depois de somar as horas de engenharia para mantê-la rodando. Para a maioria das equipes, não vai superar (a mesma conta de qualquer modelo autohospedado, veja os preços do Qwen), até o volume ficar muito alto ou os dados não poderem sair da sua rede. Esse último caso, dados regulados, é onde o Strands Decider é mais fácil de justificar.
O que a AWS realmente lançou?
É aqui que o Strands Decider se diferencia do Jev, e é a parte para a qual eu apontaria quem constrói. O post de lançamento diz que o lançamento inclui "all the training data and scripts we used to build the model."
- Dados de treinamento. Conjuntos de dados do Hugging Face, ContractNLI e MuSiQue, linhas sintéticas verificadas por modelos de pesos abertos e as distribuições de saída de um professor Qwen3.5-4B congelado. Cada fonte e sua licença estão listadas em data/sources.md.
- A receita. Um script,
training/recipe.sh all. Um retreinamento leva cerca de11 horas em uma RTX 3090ou cerca de1 h 10 min em oito H100. - Um registro de pesquisa pré-registrado. Cada execução de treinamento declara suas previsões e condições de falha antes de rodar. Raramente vi um lançamento de modelo fazer isso, e é a razão pela qual confio na admissão de que "o v21 é igual ao v19".
Isso faz do Strands Decider menos um concorrente do Jev e mais um kit para construir o seu próprio classificador de triagem. Se as suas categorias são específicas (suas linhas de produto, suas regras de reembolso, seus níveis de escalonamento), retreinar com alguns milhares de linhas rotuladas suas de classificação de tickets é o caminho que os próprios autores apontam. Se o fine-tuning é novidade para você, a receita é um dos lugares mais limpos para aprender.
O repositório também anda rápido. Pull requests mesclados em 7 e 8 de outubro adicionam suporte a troncos Gemma 4 (E2B, E4B, 12B e 26B-A4B) e um comando soup que faz a média de várias execuções de treinamento em um único checkpoint. Os PRs citam cinco checkpoints futuros, e Brooker escreveu no HN que "we've got some new ones coming this week." Nenhum tem números de benchmark publicados ainda, então eu esperaria antes de planejar em torno deles.
O que os desenvolvedores estão dizendo sobre o Strands Decider?
O tópico de lançamento no Hacker News passou de 270 pontos em um dia. O tom é mais caloroso do que o dos tópicos do Jev, principalmente porque os pesos são abertos. O relato positivo mais claro veio de alguém que o roda no próprio dispositivo:
"This is a great model. I've been running it on device in chrome extension to filter things like email. It is just the right mix of size, capability and speed to make it generally useful for adhoc bulk classification tasks."
O coautor Marc Brooker descreveu para onde enxerga isso indo, um modelo mental útil para quem constrói agentes:
"There are a ton a ways to use models like this. Model routing is a popular emerging one. The one that really interests me is hybrid agentic workflows - filling the gap between deterministic workflows (e.g. AWS StepFunctions) and fully agentic workflows that use frontier intelligence."
A crítica é justa e específica. Um tópico argumentou que uma boa calibração em benchmark "does not establish reliability on unfamiliar production inputs" (soltanov). Outro comentarista notou que o Clef da Cloudflare roda em llama.cpp, enquanto o Strands, por enquanto, precisa do seu próprio CLI e servidor:
"clef from cloudflare runs on llama.cpp - being locked-in to strands cli would be a bummer and will slow down adoption."
Isso bate com a minha leitura. O modelo é bom para o seu tamanho, as ferramentas são jovens, e quem está tirando valor agora são desenvolvedores à vontade para hospedar a própria inferência.
Onde o Strands Decider se encaixa em uma fila de suporte?
O uso óbvio é a triagem de tickets: qual equipe, qual urgência, se é spam. É classificação de intenção clássica, e os modelos de decisão combinam bem com essa chamada. É aqui que eu definiria as expectativas com cuidado.
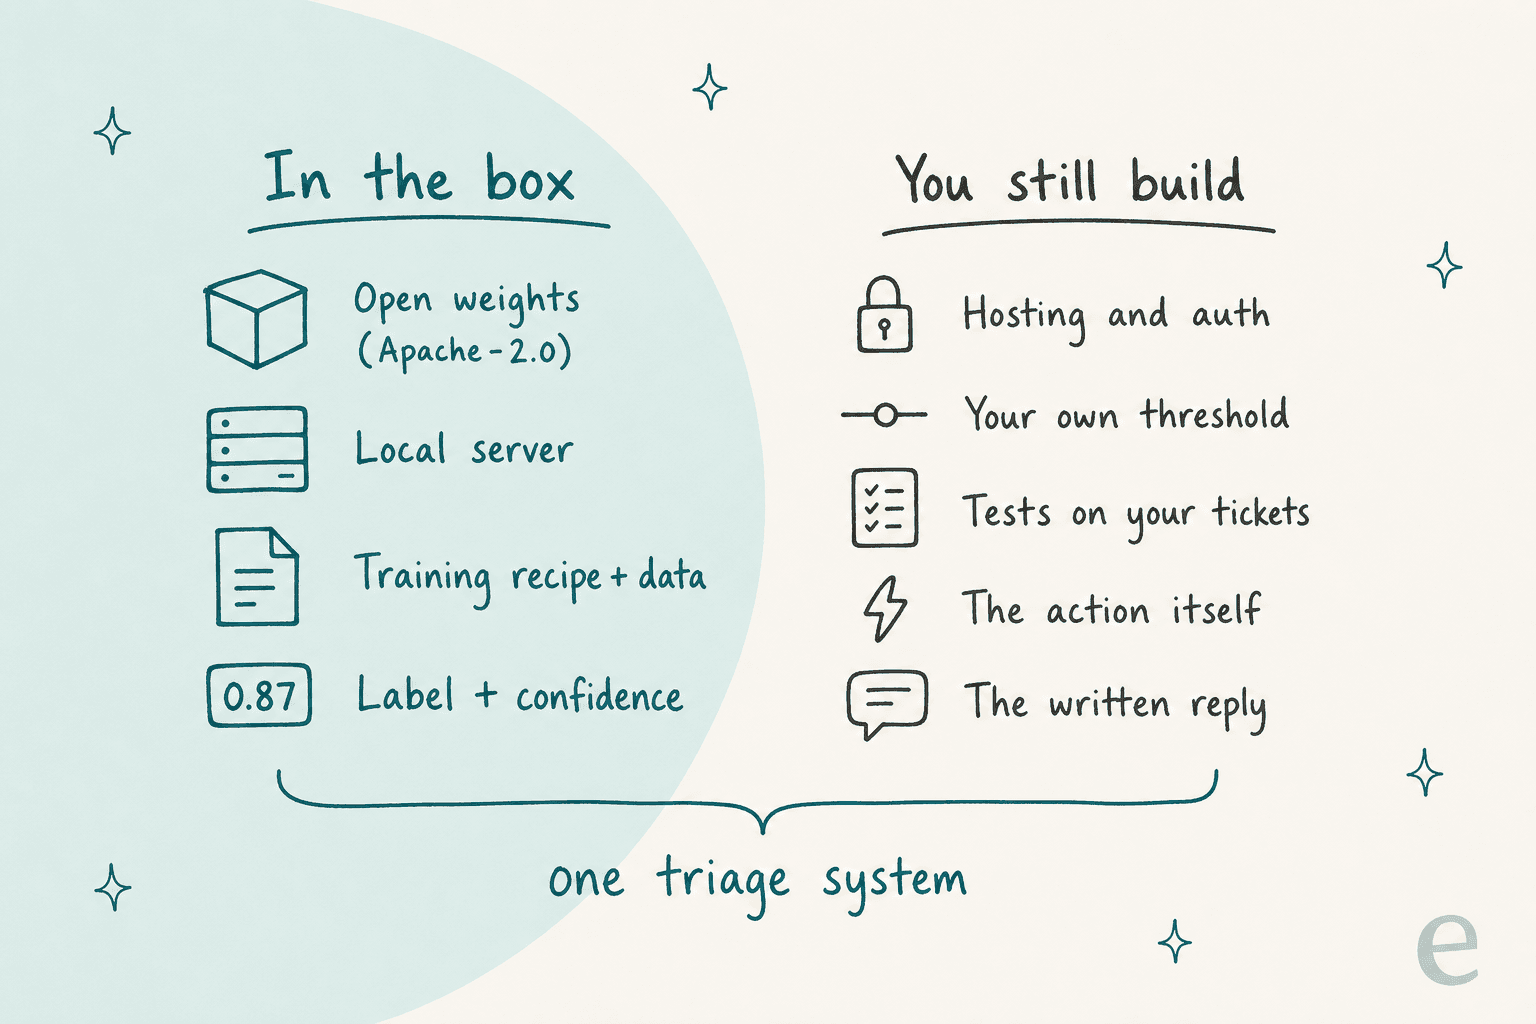
Um rótulo é uma fração de um sistema de triagem. Alguém ainda precisa hospedar o modelo, escolher um limite, testá-lo em tickets reais e depois de fato etiquetar, atribuir ou escalar o ticket no Zendesk ou no Freshdesk. E depois de tudo isso, o cliente ainda precisa de uma resposta.
Veja como isso fica quando o limite de confiança faz o seu trabalho:
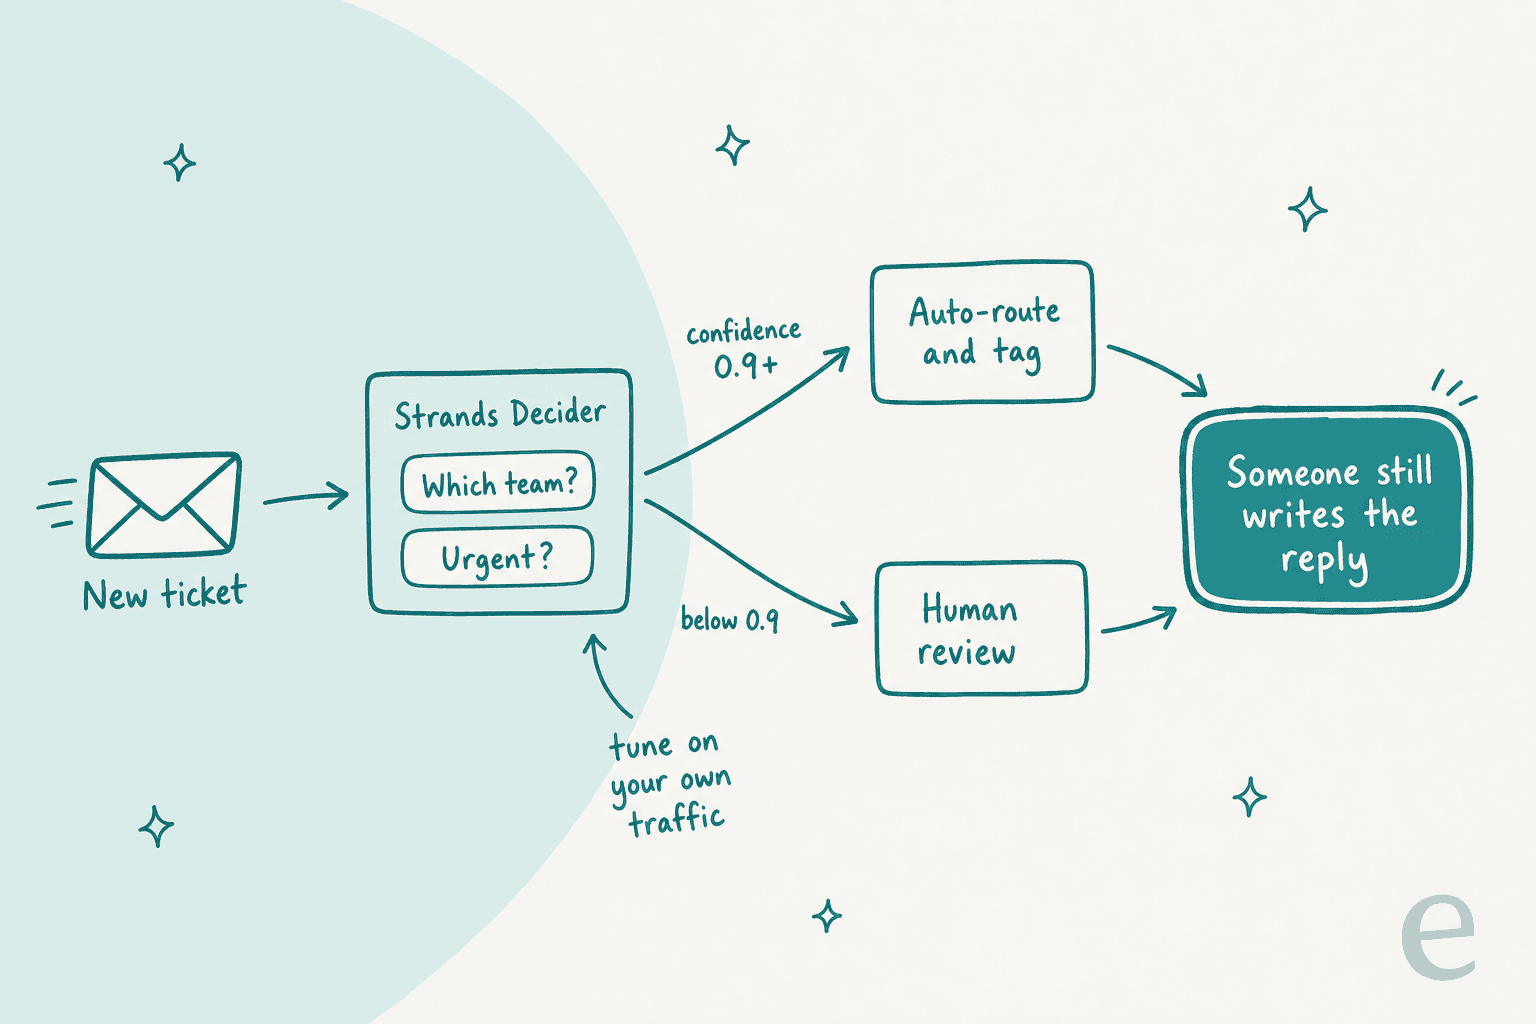
Essa última caixa é a que as equipes subestimam. Em um teste da eesel com verificação cruzada em uma caixa de entrada real de Zendesk de e-commerce, a triagem por IA atingiu 93% de precisão e pegou 100% do spam (cerca de 22% da caixa), mas apenas 12% das respostas redigidas foram enviadas como estavam. Classificar é a metade fácil; a resposta é onde está o trabalho.
O que os compradores pedem é exatamente o que um modelo de decisão calibrado promete. Uma líder de CX que cuida de cerca de 7.000 tickets por mês disse assim em uma ligação de vendas da eesel:
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Aqui vai a minha recomendação por situação:
- Você é desenvolvedor construindo um agente ou um pipeline próprio, seus dados não podem sair da sua rede e você tem uma GPU: o Strands Decider é uma ótima base. Retreine-o com os seus próprios rótulos.
- Você quer uma chamada de decisão sem hospedar nada: comece pelo Jev. O Clef e a Decisions API da OpenAI são as outras opções hospedadas.
- Você lidera uma equipe de suporte e quer tickets classificados e respondidos: você não precisa de um modelo de decisão. Precisa de algo que tome a decisão e aja sobre ela dentro do seu helpdesk. O panorama de ferramentas de triagem com IA cobre esse caminho, e a entrada do glossário sobre triagem automática explica os termos.
eesel para triagem, roteamento e a resposta
Se o trabalho que você imagina para o Strands Decider é "organizar a minha fila de suporte", o colega de IA para helpdesk da eesel faz esse trabalho de ponta a ponta. Ele se conecta ao Zendesk, Freshdesk ou Gorgias em poucos minutos (a integração com o Zendesk é a configuração mais comum), aprende com os seus tickets anteriores e com a sua central de ajuda, e então etiqueta, direciona, escala e escreve a resposta.

A mesma divisão em que o Strands Decider se baseia, um modelo leve para a decisão rápida e um mais pesado para a parte difícil, já é uma configuração. Cada automação da eesel tem uma opção "Model strength": o modelo habitual para redigir e para trabalho de várias etapas, ou um mais leve para tarefas como etiquetar ou roteamento de tickets. Eventos que não correspondem às suas instruções são ignorados e registrados com um motivo, que é o comportamento "leave them alone" que aquela líder de CX pediu. Cada ação pode ser definida como Auto, Needs approval ou Disabled em ações e aprovações, de modo que reembolsos podem ficar atrás de um clique humano enquanto a etiquetagem roda sozinha.
Se você teria recorrido ao Strands Decider porque gosta de trabalhar no terminal, a CLI da eesel dá o mesmo colega pela linha de comando. npx @eesel/cli funciona sem conta (um workspace temporário com $5 de uso), todo comando imprime JSON, e os erros voltam como uma linha JSON com um sinalizador retryable, para que o Claude Code, o Cursor ou o Codex possam conduzir toda a configuração. Um desenvolvedor ou um agente de programação pode montar um trabalho de triagem com eesel automations enable <platform> <key> --instructions "...", verificar uma mudança antes com --dry-run e liberar ações retidas com eesel approvals approve <id>. É o mesmo agente do painel, e as mudanças sincronizam nos dois sentidos. Mais sobre isso na minha análise do cenário de CLIs de agentes.
Antes de qualquer coisa entrar no ar, a habilidade de simulação roda o agente sobre os seus tickets passados reais e pontua cada resposta, para que você veja a precisão no seu próprio tráfego em vez de em um benchmark. O plano gratuito inclui 100 créditos sem cartão, e os planos pagos começam em $299 por mês para 500 tickets ou chats nos preços da eesel, sem taxa por usuário.
Experimente a eesel em uma fatia da sua fila e veja quantos tickets ela classificaria, e responderia, esta semana.
Perguntas frequentes
O que é o Strands Decider?
O Strands Decider 2B é um modelo de decisão de código aberto lançado pela equipe do Strands Labs, da AWS, em 1º de outubro de 2026. Ele lê um texto mais perguntas tipadas (sim/não, escolher uma ou pontuar em uma escala) e devolve cada resposta com uma pontuação de confiança em uma única passada, em vez de gerar texto. Foi feito para tarefas como triagem de tickets, roteamento e guardrails.
O Strands Decider é gratuito?
Sim. Os pesos, o código, os dados de treinamento e a receita são todos lançados sob Apache-2.0, então baixar o Strands Decider não custa nada. Você paga pelo hardware em que o executa, porque não há endpoint hospedado no Bedrock nem em qualquer provedor de inferência do Hugging Face. Compare com os preços do Jev ou os preços do Clef, que são hospedados e cobrados por token.
Quão preciso é o Strands Decider 2B?
O modelo de referência v21 marca 0,762 no conjunto público do JevBench (176 de 231 tarefas), e o v19 marca 0,723. Isso o coloca perto do topo da classe de 2B, mas LLMs de raciocínio como o GPT-6 Luna ainda marcam 0,996 nas mesmas tarefas. O próprio repositório diz que v21 e v19 têm a mesma precisão quando se faz a média de seis execuções de treinamento.
O Strands Decider roda em CPU?
Roda, mas espere segundos, não milissegundos. O repositório mede cerca de 1,6 segundo por pergunta em um Xeon de 8 threads para uma entrada curta, e de 16 a 18 segundos com cerca de 3.000 tokens. Em uma GPU RTX 3090, a mediana é de 115 ms. Para uma etapa de roteamento ao vivo, planeje usar uma GPU ou Apple silicon.
Strands Decider ou Jev: qual devo usar?
Escolha o Strands Decider se precisar de pesos abertos, autohospedagem ou da opção de fazer fine-tuning com as suas próprias perguntas. Escolha o TypeSafe Jev se quiser uma API hospedada, sem servidores para operar, e um contexto de 32.000 tokens. O panorama de alternativas ao Jev cobre o resto do campo.
Posso usar o Strands Decider para triagem de tickets de suporte?
Sim. O próprio exemplo do cartão do Hugging Face direciona uma reclamação sobre repasses para cobrança, vendas ou varejo e sinaliza a urgência. Mesmo assim, você precisa hospedá-lo, ajustar um limite de confiança com os seus próprios tickets e construir a etapa que etiqueta, direciona ou responde. Um colega de IA para helpdesk como a eesel cuida de todo esse ciclo dentro do seu helpdesk.
Existe uma API do Strands Decider no AWS Bedrock?
Não, até 8 de outubro de 2026. O único servidor é local (strands-decider serve), vinculado a 127.0.0.1 e sem autenticação. O Bedrock aparece no post de lançamento apenas como o LLM do exemplo de agente. Se você quer uma API de decisão hospedada, veja a Decisions API da OpenAI, o Jev ou o Clef.