O que é o PostHog Jeeves?
O Jeeves é um "reasoning Jev-style classifier with a diffusion drafter", lançado pela PostHog em 29 de setembro de 2026. Foi criado por Nicholas Waltz, engenheiro de pesquisa em IA da equipe de AI Research da PostHog, que antes passou dois anos em uma startup da YC criando modelos de RL para entregas com drones, segundo seu perfil na PostHog.
Para entender o Jeeves, é preciso saber o que ele copia. Um "modelo de decisão" não escreve texto. Você envia um estado (um e-mail, um ticket, um bloco JSON) e um conjunto de perguntas tipadas, e ele devolve uma probabilidade para cada opção de resposta. A categoria se popularizou duas semanas antes, quando a TypeSafe lançou o Jev com três tipos de pergunta: um sim/não noul, um escolher-um choice e uma rubrica score. O Jev é fechado e hospedado. Em poucos dias, o Kev, de Jared Palmer, lançou pesos abertos compatíveis com o Jev, e o Jeeves credita o Kev como inspiração.
O que o Jeeves acrescenta é o raciocínio. O README descreve o problema sem rodeios: modelos no estilo Jev "give calibrated decision probabilities, but at low accuracy", então "a lot of pipelines therefore rely on a reasoning model as a fallback." Esse fallback costuma ser um LLM hospedado cobrado por token, o tipo de custo que detalhei em Claude Sonnet 5.5 pricing. O Jeeves tenta ser esse fallback, no formato do próprio Jev.
As especificações principais:
| PostHog Jeeves | |
|---|---|
| Modelo base | Qwen3.5-9B com LoRA e uma cabeça de ponteiro (veja alternativas ao Qwen) |
| Tipos de pergunta | noul (sim/não), choice, score, combináveis em uma requisição |
| API | /v1/systemone compatível com o Jev, mais um SDK Python plug-and-play |
| Licença | Código MIT, pesos Apache-2.0 (herdada do Qwen3.5) |
| Tamanho dos pesos | 21 GB bf16, 11.5 GB com camadas lineares FP8 |
| Hardware | GPU CUDA; Mac com Apple Silicon de 48 GB+ para inferência |
| API hospedada | Nenhuma. Apenas autohospedado |
| Tração no lançamento | 241 pontos no Hacker News, 356 estrelas no GitHub |
Sou a Alicia e construo os agentes de IA dentro da eesel, então passo muito tempo exatamente nesta camada: a parte do fluxo que decide o que um ticket é antes de qualquer coisa ser escrita. Veja como o Jeeves faz isso e onde ele merece seu lugar.
Como o Jeeves raciocina antes de decidir?
O mecanismo é um bom trabalho de engenharia e explica tanto o ganho de precisão quanto o custo de latência.
O Jeeves carrega o estado e cada pergunta no template de chat do Qwen usando tokens raros, quase sem uso, como marcadores (<|fim_prefix|> para o estado, <|box_start|> para cada opção, e assim por diante). Depois faz algo que o Jev não faz: gera uma cadeia de raciocínio em texto livre dentro de um bloco <think>. Quando a cadeia se fecha, a pergunta e as opções são repetidas, e uma pequena cabeça de ponteiro pontua cada opção comparando o estado oculto em um token <decide> com o estado oculto no fim de cada opção. Um softmax sobre essas pontuações, dividido por uma temperatura ajustada em dados de desenvolvimento (1.859, segundo o cartão do modelo no Hugging Face), gera as probabilidades finais.
Dois detalhes das ablações valem a pena se você um dia treinar algo assim. Trocar os tokens raros por palavras comuns como "State" piorou os resultados. Remover a pergunta repetida depois do bloco de raciocínio também. O modelo precisa ser lembrado das opções logo antes de se comprometer.
O treinamento teve três etapas, todas documentadas no repositório:
- Ajuste fino supervisionado: 2 épocas, 596 passos em 8 GPUs, sobre 19,126 perguntas de 12 conjuntos de dados públicos mais dados sintéticos de políticas. Metade das perguntas trazia uma cadeia de raciocínio amostrada do modelo base.
- Aprendizado por reforço com CISPO: o método de RL do MiniMax-M1, em 9,992 perguntas com 8 rollouts cada, limitado a 2,560 tokens de raciocínio. O cronograma de 624 passos foi interrompido no passo 402, porque depois disso "the head over-sharpens" e a calibração piora.
- Calibração: uma única temperatura ajustada em desenvolvimento e salva junto com o checkpoint.
Essa parada no passo 402 é o que eu sublinharia. A equipe abriu mão de um pouco de pontuação bruta para manter as probabilidades honestas, que é a razão de existir de um modelo de decisão. Um modelo que diz 90% e acerta 70% das vezes é pior que inútil em um fluxo de roteamento, e é o mesmo problema de fundo por trás da maioria das alucinações de IA no suporte.
Para recuperar velocidade, o Jeeves traz um drafter de difusão que propõe vários tokens de raciocínio de uma vez para decodificação especulativa. Em uma pergunta, ele eleva a velocidade da cadeia de 109 para 176 tokens por segundo com drafting de bloco 4, e para cerca de 960 tokens por segundo no total quando oito perguntas são agrupadas.
No que o Jeeves supera o Jev e onde perde?
A tabela de resultados da PostHog é incomumente franca, e o padrão nela é a coisa mais útil do lançamento.
| Benchmark | Kev-9B | Jev | Jeeves |
|---|---|---|---|
| Teste geral (reservado e fora do domínio) | 0.822 | 0.857 | 0.889 |
| JevBench geral (231 itens públicos) | 0.715* | 0.866 | 0.935 |
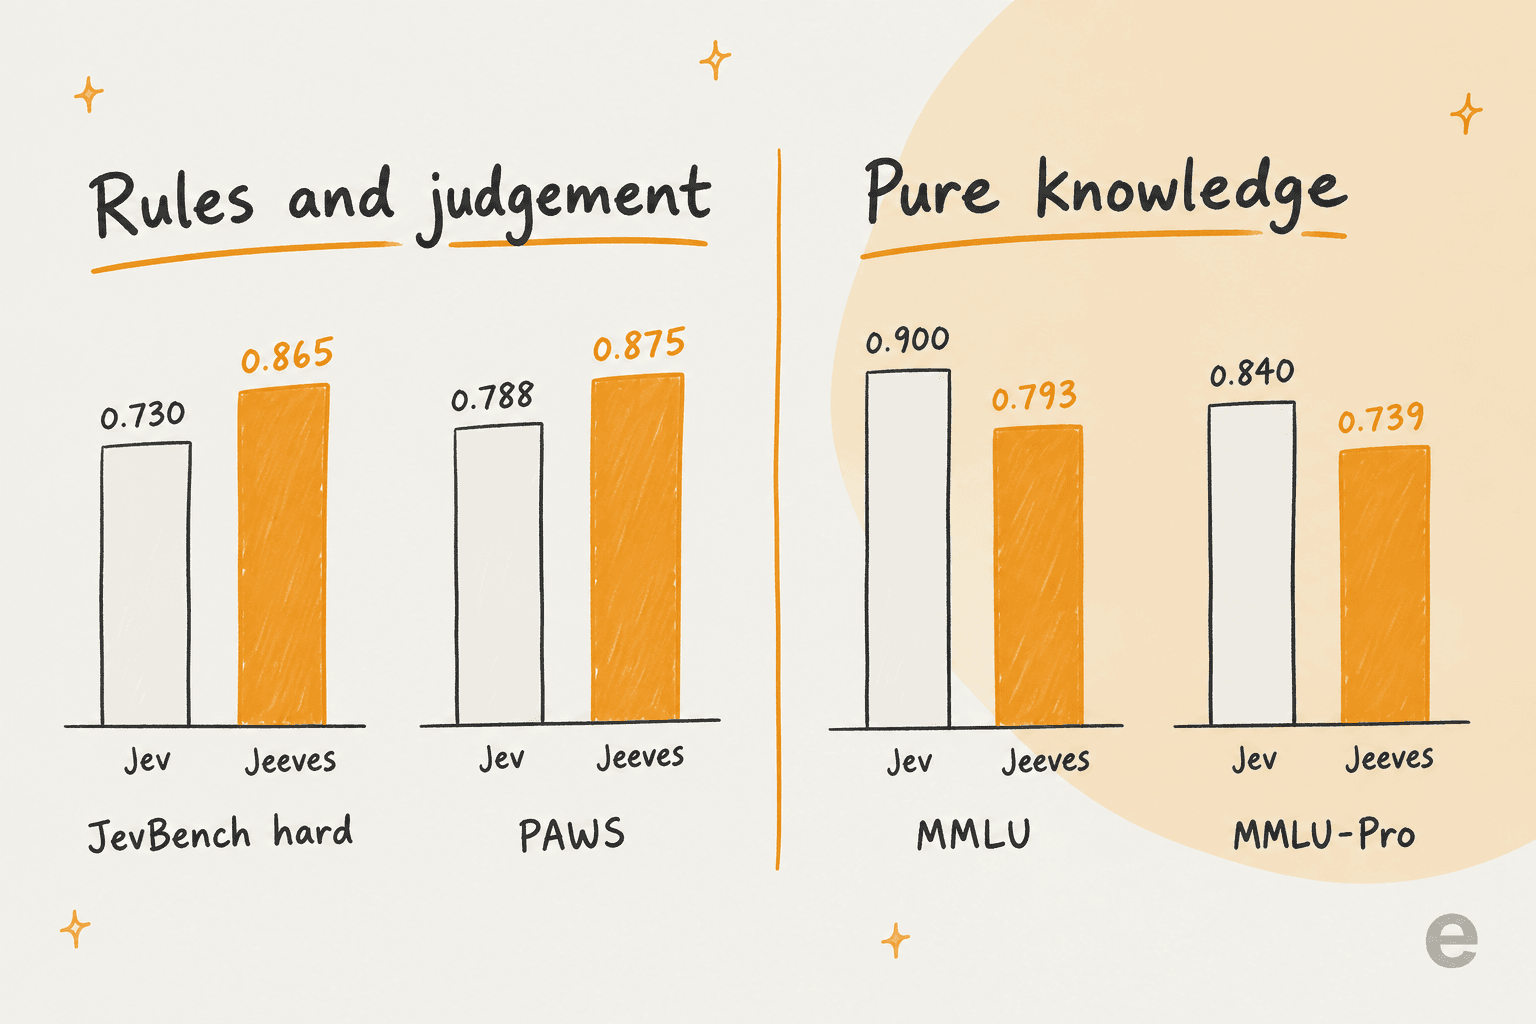
| JevBench hard (111 itens públicos) | 0.451* | 0.730 | 0.865 |
| PAWS (detecção de paráfrase) | 0.763 | 0.788 | 0.875 |
| Estruturas de regras reservadas | 0.896 | 0.885 | 1.000 |
| Políticas contrastivas | 0.900 | 0.963 | 1.000 |
| MMLU | 0.738 | 0.900 | 0.793 |
| MMLU-Pro (10 opções) | 0.515 | 0.840 | 0.739 |
| Inconhecível respondido com p ≥ 0.9 (menor é melhor) | 0.000 | 0.090 | 0.055 |
| Erro de calibração no JevBench (menor é melhor) | 0.049 | 0.037 |
*A PostHog observa que não há resultado publicado do Kev-9B no JevBench, então essas células são do Kev-8B. Todos os números vêm do README do Jeeves.
Lendo a tabela de cima para baixo, aparece uma divisão. Onde a pergunta é sobre aplicar regras a uma entrada bagunçada (estruturas de regras reservadas, políticas contrastivas, detecção de paráfrase, JevBench hard), pensar vence, às vezes por muito. Onde a pergunta é sobre saber um fato (MMLU, MMLU-Pro), o Jev vence por cerca de 10 pontos. Raciocinar não cria um conhecimento que um modelo de 9B não tem. Para conhecimento, equipes de suporte costumam ancorar o modelo nos próprios documentos, o trade-off tratado em RAG vs fine-tuning.
Essa divisão mapeia bem o trabalho de suporte. "Este pedido de reembolso cai dentro da nossa política de 30 dias, dada a data do pedido escondida no terceiro parágrafo?" é uma pergunta de regras. "Qual é a capital do Peru?" nunca aparece em uma fila de tickets. Se suas decisões se parecem com o primeiro tipo, a tabela está a seu favor.
Duas ressalvas honestas da própria PostHog: as comparações com Kev e Jev fora do JevBench "use different items from the same sources", e as cadeias de raciocínio não são muito legíveis, porque "no language consistency reward was included." Você recebe a resposta e uma cadeia, mas não planeje mostrar essa cadeia a um auditor.
Quão lento é "pensar" na prática?
Foi aqui que a discussão no Hacker News apertou mais, e com razão.
A PostHog mediu três configurações em 325 perguntas de desenvolvimento, em uma H100 com FP8:
| Configuração | Precisão | Média de tokens de raciocínio | Latência mediana / p90 |
|---|---|---|---|
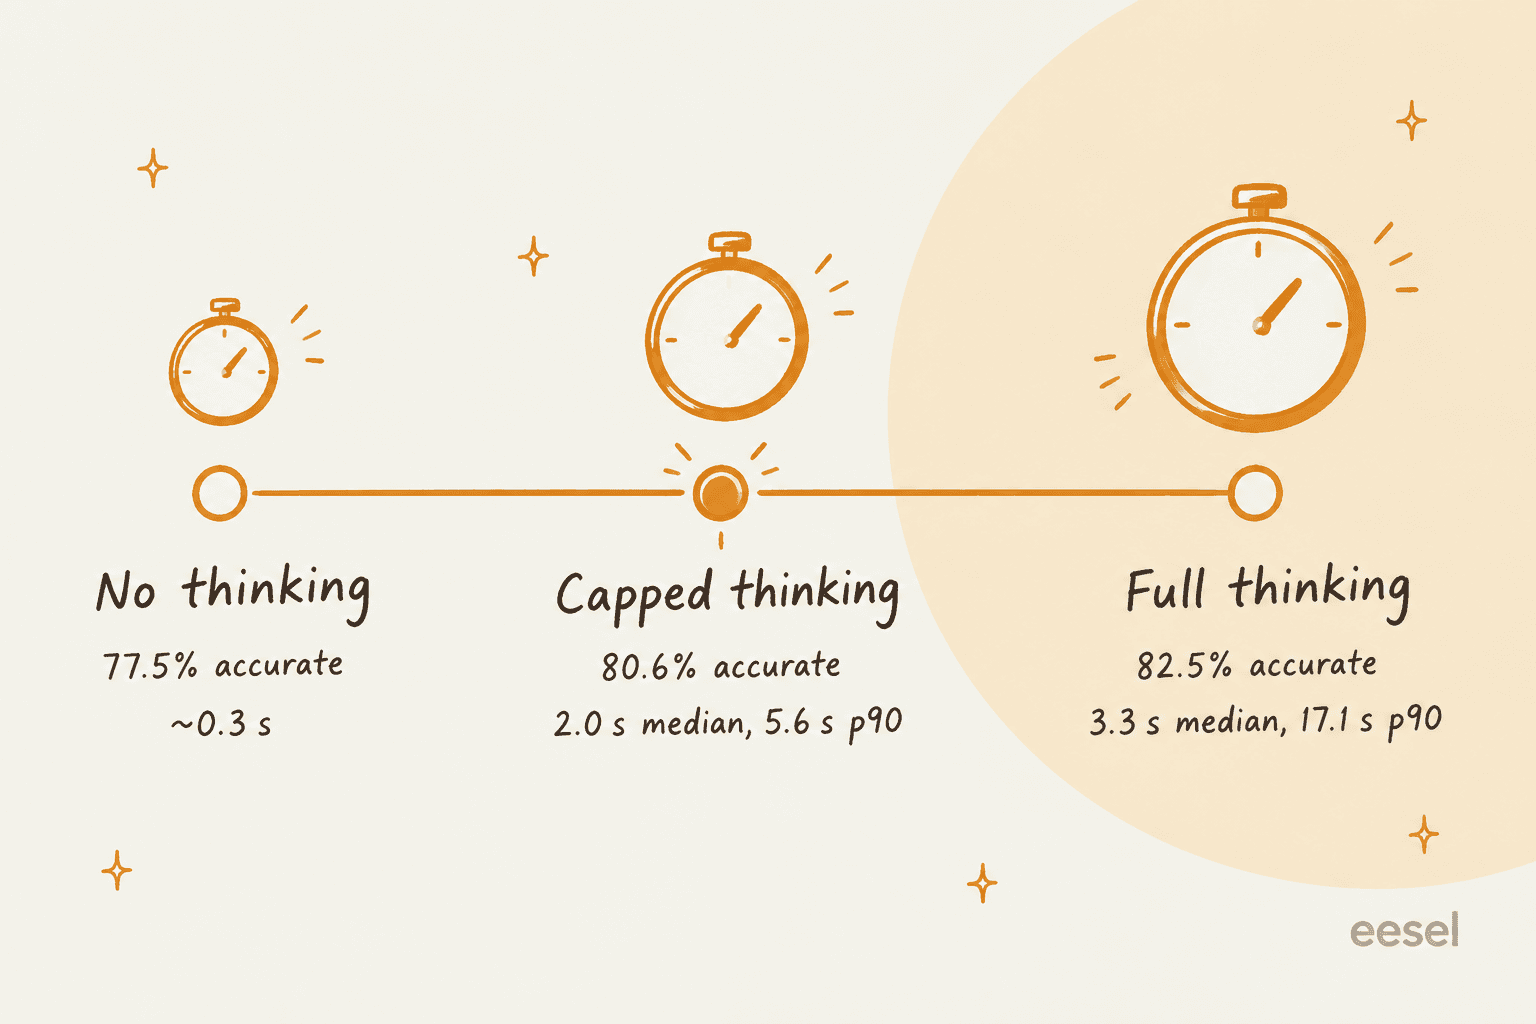
| Raciocínio completo | 0.825 | 1,138 | 3.3 s / 17.1 s |
max_think 768, nothink_threshold 0.9 | 0.806 | 344 | 2.0 s / 5.6 s |
| Sem raciocínio | 0.775 | 0 | cerca de 0.3 s |
A linha do meio é a que eu colocaria em produção. O max_think corta cada cadeia de raciocínio em um orçamento de tokens, e o nothink_threshold pula o raciocínio por completo quando a resposta rápida já é confiante. Você mantém a maior parte do ganho de precisão (0.806 vs 0.775) e reduz a latência p90 em dois terços.
Para comparar, a proposta do Jev é de 70 a 500 milissegundos por chamada, o que cobri no meu teste de velocidade do Jev. O pessoal do HN notou:
"Cool engineering, but 17s p90 latency kind of defeats the point of a Jev-class model, which is supposed to be fast and cheap."

Isso é verdade se você trata o Jeeves como substituto do Jev. É menos verdade se o trata como aquilo que roda depois que o modelo rápido dá de ombros. Um comentarista descreveu a arquitetura com clareza:
"Seems like this is the way, a hybrid approach where some of the pipeline will be jev like and some traditional LLM depending on the nature of the work."
O Jeeves reúne esse híbrido em um só modelo. Raciocínio desligado é sua camada rápida. Raciocínio ligado é sua camada lenta. E como as duas camadas compartilham uma API e uma calibração, você não precisa conciliar as probabilidades de um classificador com a resposta em texto livre de um LLM.
O que acontece com um ticket de suporte de verdade?
A requisição de demonstração do README é um ticket de suporte, o que facilitou meu trabalho. O estado diz: "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card." Três perguntas acompanham: qual departamento, se deve escalar e quão frustrado está o cliente.
O Jeeves devolveu billing 0.46, returns 0.40, shipping 0.14, e uma confiança de escolha de apenas 0.19. A escalação pontuou 0.72. A frustração ficou em 1.5 numa escala de 0 a 2. A requisição inteira levou 8.1 segundos, com as três perguntas raciocinando em paralelo.
Aqui está o mesmo ticket (mais uma frase extra) passado pelo Kev-4B no playground do Kev:
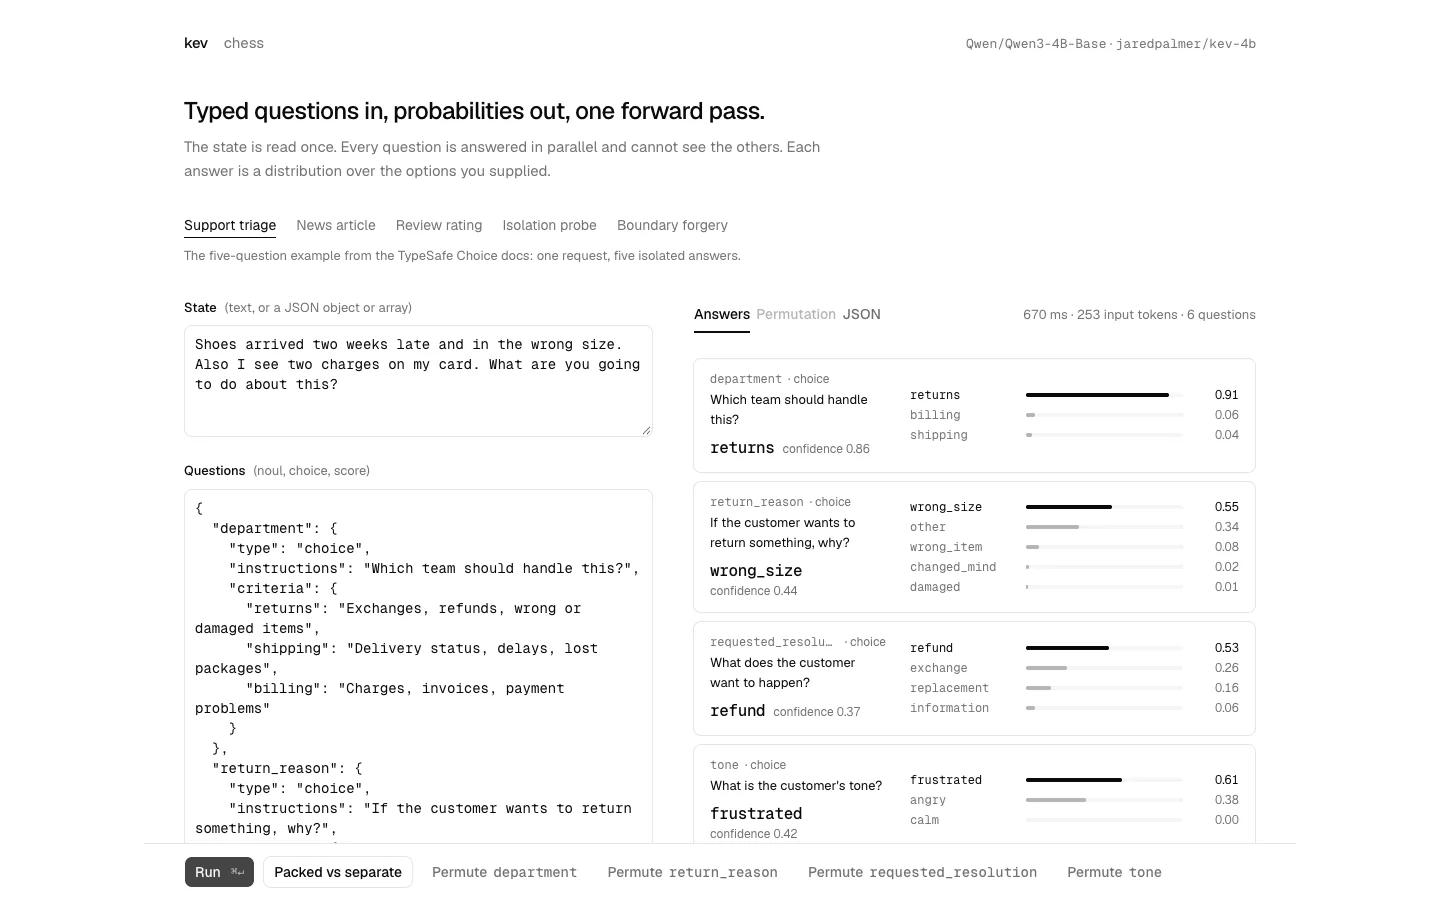
O Kev-4B disse returns com 0.91 em 670 milissegundos. É um modelo menor e o prompt é um pouco diferente, então não é uma comparação direta limpa. Mas olhe o ticket. Ele realmente contém dois problemas de duas equipes. O Kev respondeu rápido e soou seguro. O Jeeves pensou e disse, na prática: "está apertado e não estou confiante".
Para uma fila de suporte, a segunda resposta é a mais útil. Uma rota errada com confiança significa que o cliente espera na fila de devoluções enquanto a cobrança em dobro fica intocada. Uma divisão com baixa confiança é um sinal para fazer algo mais inteligente: rotear para cobrança e marcar devoluções, dividir o ticket ou enviá-lo a uma pessoa com uma passagem de IA para humano limpa.
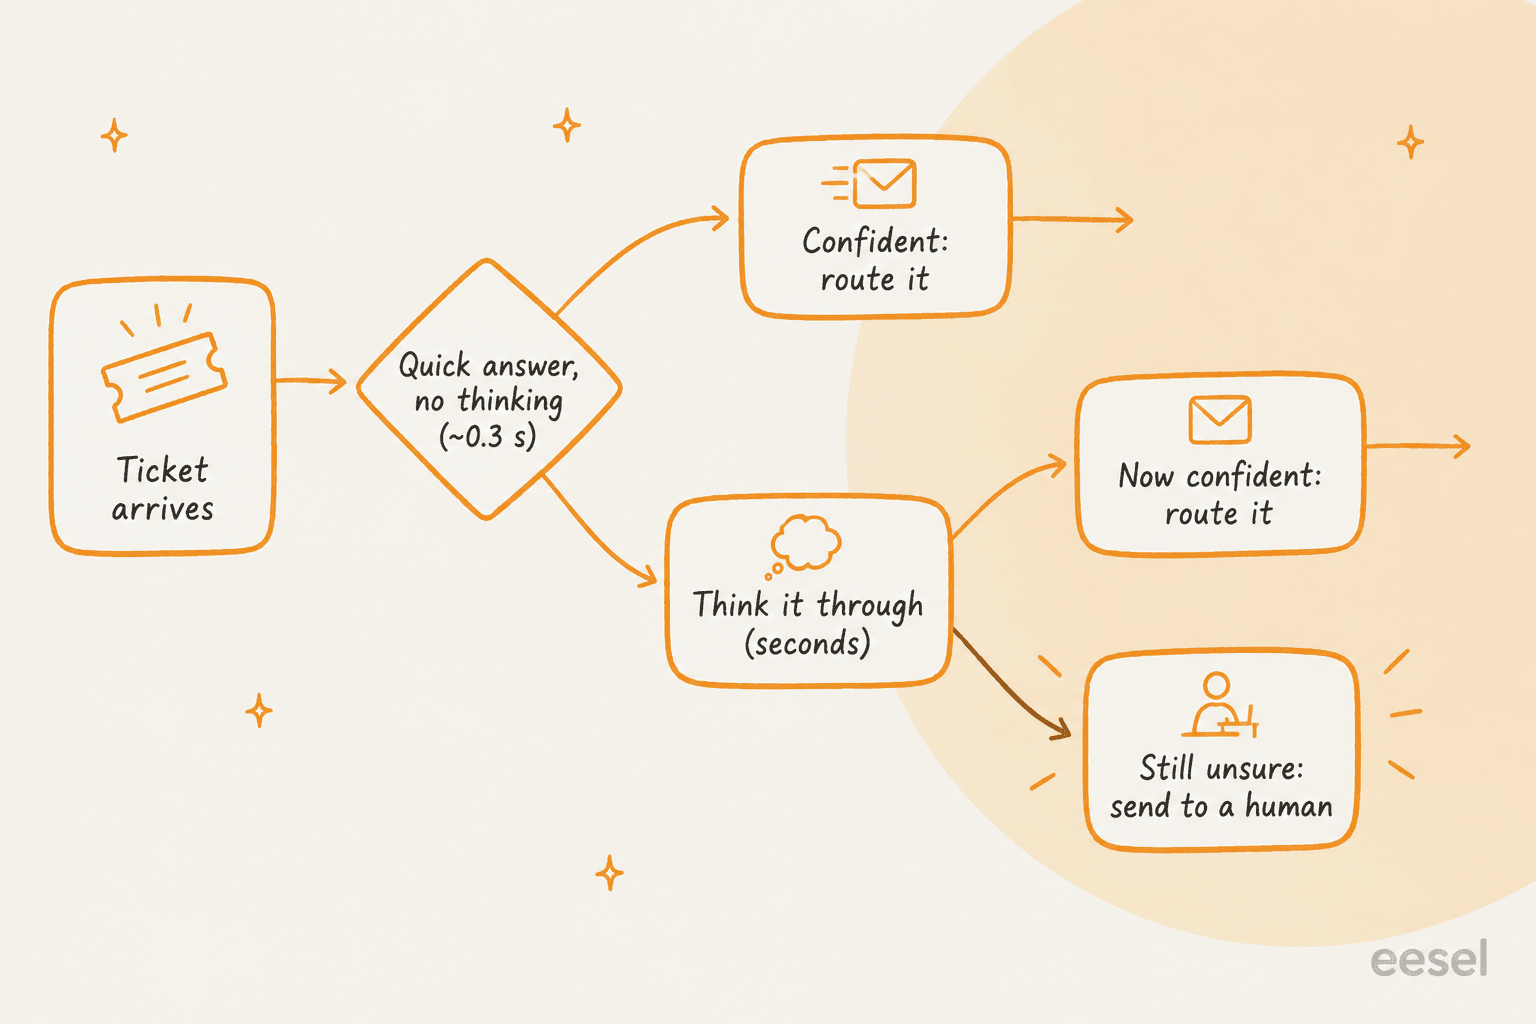
Isso combina com o que vi rodando a IA da eesel em filas reais. Em um teste com tráfego real em uma caixa de entrada de e-commerce, as decisões foram a parte confiável: 93% de precisão na triagem e 100% de detecção de spam sem falsos positivos. As respostas geradas foi onde escorregou, com 7% de erros factuais nos rascunhos. Classificar é a metade da IA de suporte em que dá para confiar cedo, desde que o modelo admita quando não tem certeza. Também já vi bots com tom confiante darem respostas erradas em silêncio, e por isso toda implantação da eesel é simulada com tickets históricos antes de tocar em um cliente real. Um "não sei" calibrado vale mais que um palpite rápido.
Quem deveria realmente usar o PostHog Jeeves?
O Jeeves é um lançamento de pesquisa, não um produto, e se lê assim, como boa parte do espaço de agentes de IA de código aberto: código de treinamento completo, dados de treino/dev/teste, um script de reprodução, nenhum endpoint hospedado. A página do modelo no Hugging Face observa que o modelo "isn't deployed by any Inference Provider."
Assim eu classificaria:
| Você é... | Use | Por quê |
|---|---|---|
| Uma equipe de ML que já roda Jev ou Kev, com fallback de LLM | Jeeves | Mesma API, um modelo para as duas camadas, melhor em casos extremos cheios de regras |
| Uma equipe que precisa de decisões abaixo de um segundo em cada chamada | Jev ou Kev | Passada única, sem cauda de raciocínio |
| Uma equipe que quer pesos abertos em um notebook | Kev-0.8B ou Kev-4B, ou Laya | Pegadas bem menores |
| Uma equipe que quer treinar o próprio modelo de decisão | Jeeves | A receita completa de SFT, CISPO e drafter está no repositório |
| Uma equipe de suporte que quer tickets triados e resolvidos | Um agente de IA para helpdesk | Um modelo de decisão não responde, não atualiza campos nem escala |
Os primeiros testes da comunidade são animadores para trabalho de moderação. Um comentarista do HN o rodou com os próprios dados:
"Update: Jeeves took about 2 hours to moderate 394 data points and performed really well. It's not as good as Jev, but it's super close!"
Repare nas "2 hours". É o imposto do raciocínio de novo, em hardware que não é uma H100. Um engenheiro da PostHog, Robbie Coomber, respondeu no mesmo tópico que um port para MPS estava em andamento para acelerar o Apple Silicon, e o repositório mostra que ele já foi mesclado.
Se é você quem vai integrar isso, vale dar uma olhada antes no mapa completo de alternativas ao Jev, porque recursos de saída estruturada em LLMs hospedados podem cobrir seu caso sem GPU.
O que um modelo de decisão não faz pelo seu helpdesk
Aqui está a mudança que eu defenderia. Um modelo de decisão responde muito bem a "o que é este ticket?". Não responde a "e agora, o que fazemos?". Alguém ainda precisa escrever o código que transforma billing: 0.46 em uma tag do helpdesk, uma resposta, uma consulta de reembolso, uma escalação com nota e um registro do porquê.
É aí que aparece a distância entre infraestrutura e um funcionário. Jeeves, Jev e Kev são infraestrutura: blocos excelentes e baratos de rodar para classificação de tickets, priorização e sentimento. Uma colega de IA é a funcionária que toma as mesmas decisões dentro do seu helpdesk de verdade e depois faz o trabalho. Se você está comparando os dois, meu guia sobre automatizar a triagem de tickets detalha melhor o trade-off entre construir e contratar.
Experimente a eesel

Se você olha o Jeeves porque quer uma triagem mais inteligente, provavelmente não quer hospedar um modelo de 9B e escrever a cola em volta dele. A colega de IA para helpdesk da eesel entra na sua fila atual no Zendesk, no Freshdesk ou no Help Scout, aprende com seus tickets antigos e sua central de ajuda e toma a decisão de rotear, etiquetar e escalar em cada ticket, seguindo as regras de escalonamento que você já usa. Depois ela redige ou envia a resposta e passa os casos realmente incertos a uma pessoa com uma nota. Antes de entrar no ar, você pode simulá-la em centenas dos seus tickets antigos e ver exatamente onde ela teria acertado e errado.
Se o apelo do autohospedamento do Jeeves é, na verdade, controle por código, a CLI da eesel cobre isso. Ela roda a mesma colega a partir do seu terminal: eesel activity lista cada execução e mostra uma em detalhe, eesel approvals permite aprovar ou negar ações que precisam de um humano, e eesel instructions edita as regras permanentes da colega. Todo comando imprime JSON, os de escrita aceitam --dry-run para você ver a chamada exata antes de ela acontecer, e o workspace também funciona como servidor MCP, então agentes de programação como o Claude Code podem controlá-lo diretamente. Há mais sobre isso no meu guia da CLI de agentes de IA.
Se você está comparando com a IA nativa do seu helpdesk, a análise eesel vs Zendesk AI é uma boa próxima leitura. Começar é grátis, com 100 créditos e sem cartão, e um ticket ou chat conta como um crédito, segundo a página de preços. Experimente a eesel na sua própria fila e veja quantos tickets ela teria roteado certo no mês passado.
Perguntas frequentes
O que é o PostHog Jeeves?
O PostHog Jeeves é um modelo de decisão de 9B com pesos abertos, criado pela equipe de pesquisa em IA da PostHog. Você dá a ele um estado (texto ou JSON) e perguntas tipadas de sim/não, múltipla escolha ou nota, e ele escreve uma cadeia de raciocínio antes de devolver uma probabilidade calibrada para cada opção. Ele copia o formato de requisição do Jev da TypeSafe, então se encaixa nos mesmos fluxos de classificação.
O PostHog Jeeves é gratuito?
Sim. O código tem licença MIT e os pesos no Hugging Face são Apache-2.0, então baixar o PostHog Jeeves não custa nada. Você paga pelo hardware: uma GPU CUDA ou um Mac com Apple Silicon de 48 GB ou mais. Não há API hospedada, e essa é a principal diferença em relação ao preço por token do Jev.
Como o PostHog Jeeves é diferente do Jev?
O Jev responde em uma única passada, sem raciocínio visível. O PostHog Jeeves pensa primeiro, o que melhora a precisão em testes reservados (0.889 vs 0.857) e no JevBench hard (0.865 vs 0.730), mas leva a latência p90 a 17.1 segundos com raciocínio completo. O Jev ainda lidera em perguntas de conhecimento como MMLU. A análise do Jev cobre em detalhe o lado de passada única.
O PostHog Jeeves consegue fazer triagem de tickets de suporte?
Ele pode fazer a parte de decisão da triagem de tickets: escolher um departamento, sinalizar urgência, avaliar a frustração. A demo do README é um ticket de suporte. Ele não responde a clientes, não atualiza seu helpdesk nem escala sozinho, então você ainda precisa de código ou de um agente de IA para helpdesk em volta dele.
Qual a velocidade do PostHog Jeeves?
Em uma H100 com FP8, o PostHog Jeeves responde em cerca de 0.3 segundo sem raciocínio, 2.0 segundos de mediana com raciocínio limitado e 3.3 segundos de mediana (17.1 segundos em p90) com raciocínio completo. É mais lento que modelos de decisão de passada única, então a maioria das equipes vai querer a opção nothink_threshold para pular o raciocínio nos casos fáceis, de forma parecida com um fluxo de escalonamento em camadas.
Que hardware preciso para rodar o PostHog Jeeves?
Os pesos ocupam 21 GB em bf16 ou 11.5 GB com camadas lineares em FP8. O README pede Python 3.12 e uma GPU CUDA, e diz que a inferência também roda em Macs com Apple Silicon de 48 GB ou mais se você reduzir os caches. Se preferir não gerenciar GPUs, uma API de atendimento ao cliente com IA gerenciada é o caminho mais simples.
O PostHog Jeeves é melhor que o Kev?
Pelos números publicados pela PostHog, o Jeeves supera o Kev-9B em dados de teste reservados (0.889 vs 0.822) e no JevBench (0.935 vs 0.715 do Kev-8B). O Kev é menor e mais rápido, vem em quatro tamanhos de 0.8B a 27B e roda em um notebook. Escolha o Kev pela velocidade e o PostHog Jeeves para decisões difíceis baseadas em regras. Ambos convivem com a Laya no espaço de modelos de decisão abertos.


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.